Pas de résilience sans recensement des logiciels


Sur un PC, l'ordonnanceur du système (le scheduler en anglais), c'est ce petit bout du noyau qui décide quelle tâche tourne sur quel cœur du processeur, et pendant combien de temps. Plus il est malin, plus la machine est fluide.
Peter Zijlstra, l'un des développeurs historiques du noyau Linux, vient de proposer un patch baptisé "sched: Flatten the pick" qui réorganise la façon dont l'ordonnanceur attribue les priorités. Et les résultats sur le gaming, surtout sur du vieux matériel, sont étonnants.
Pour le test, le développeur a sorti un PC d'époque : un Intel Core i7-2600K, processeur de 2011, accompagné d'une carte graphique AMD Radeon RX 580. Le tout fait tourner Shadows: Awakening, un jeu disponible sur la boutique GOG, lancé via Lutris et Proton, l'écosystème qui permet de faire tourner les jeux Windows sous Linux. Et là, surprise.
Avant le patch, le jeu pédalait à environ 4 images par seconde au minimum et 48 en moyenne. Après application, on monte à 20 images par seconde au minimum et 57 en moyenne. Le temps maximum entre deux images, l'autre indicateur clé pour la fluidité, passe de 107 millisecondes à 37. On passe d'injouable à correct. Sur une machine de 2011, c'est presque un miracle.
Le patch touche à la gestion des cgroups, des conteneurs de processus qui regroupent et hiérarchisent les tâches, sur les systèmes multi-cœurs. Plusieurs niveaux de sélection étaient empilés, et le patch les "aplatit" pour gagner en réactivité.
Les vieux processeurs ont moins de cœurs et moins de marge, donc chaque mauvaise décision de l'ordonnanceur coûte cher. Sur un processeur récent avec dix ou douze cœurs, on ne le remarque presque pas. Sur un quadri-cœur d'il y a quinze ans, ça se voit immédiatement à l'écran.
Attention quand même, on n'est pas encore au point d'être intégré dans le noyau Linux officiel. Il reste des relectures et des validations avant que le code finisse en production. C'est la version 2 du patch, donc la discussion technique a déjà bien avancé.
Pour les distributions Linux orientées jeu, qui chassent la moindre milliseconde gagnée, ce genre de patch est exactement le type d'amélioration qu'on suit de près.
Bref, si vous traînez un vieux PC qui peine, un futur noyau Linux pourrait bien lui offrir une deuxième jeunesse pour le jeu.
Source : Itsfoss

Claude Code est un outil d’IA pour le développement logiciel conçu par Anthropic, pensé pour assister directement dans le terminal. Utiliser Claude Code pour coder avec l’IA permet d’éditer du code, comprendre un projet, générer des fichiers, corriger des bugs et automatiser des tâches de développement à partir d’instructions en langage naturel.
Dans ce guide, l’objectif est de détailler ce qu’est Claude Code, comment l’installer, comment l’utiliser efficacement, dans quels cas il est utile, ses limites, son prix potentiel selon l’environnement, et les bonnes pratiques pour coder proprement avec l’IA. Le contenu s’adresse à un lectorat francophone, débutant ou intermédiaire, qui cherche une méthode concrète et fiable.
Claude Code est l’assistant de programmation d’Anthropic orienté ligne de commande. Contrairement à un simple chatbot accessible dans un navigateur, il est conçu pour travailler au plus près du dépôt de code, dans un environnement de développement réel.
L’idée centrale est simple : au lieu de copier-coller du code dans une interface web, l’outil peut analyser les fichiers du projet, comprendre la structure du dépôt, proposer des modifications, écrire du code, expliquer des erreurs, générer des tests et parfois exécuter certaines actions selon la configuration autorisée.
Claude Code peut être utilisé pour :
- explorer une base de code existante
- expliquer l’architecture d’un projet
- générer des fonctions, composants ou scripts
- corriger des bugs
- refactoriser du code
- écrire des tests
- mettre à jour de la documentation
- proposer des commandes terminal
- aider à la migration entre frameworks, versions ou bibliothèques
C’est donc un outil particulièrement intéressant pour les développeurs qui veulent coder avec l’IA sans quitter leur terminal.
Les internautes qui cherchent “Claude Code” veulent souvent comprendre sa place parmi les autres outils IA pour développeurs.
Voici la différence en pratique :
- ChatGPT : très polyvalent, utile pour discuter, expliquer, générer du code, mais souvent séparé de l’environnement local.
- GitHub Copilot : très intégré à l’éditeur, excellent pour l’autocomplétion et les suggestions inline.
- Cursor : IDE orienté IA avec édition, refactorisation et compréhension de projet.
- Claude Code : plutôt centré sur le terminal et le dépôt, avec une logique d’agent capable d’analyser et d’agir sur le code selon les permissions accordées.
Claude Code se distingue surtout par son usage conversationnel appliqué directement à un projet réel, dans une approche plus proche de l’assistant développeur autonome que de la simple autocomplétion.
L’intérêt de Claude Code dépend du type de travail à accomplir. Dans les bonnes conditions, il peut faire gagner du temps sur des tâches répétitives, accélérer la compréhension d’un codebase inconnu et aider à formuler des modifications complexes.
Claude Code est particulièrement utile pour :
- créer rapidement une base de composant ou d’API
- générer des tests unitaires
- renommer proprement des fonctions ou variables
- documenter des modules
- proposer un plan de refactorisation
Le gain de temps est souvent maximal sur les tâches structurées, répétitives ou bien cadrées.
Sur un dépôt ancien ou volumineux, il peut être difficile d’identifier :
- les points d’entrée
- les dépendances importantes
- les fichiers liés à une fonctionnalité
- la cause d’un bug
Claude Code peut aider à cartographier la base de code et à retrouver rapidement les éléments clés.
Un développeur peut demander :
1. d’implémenter une fonctionnalité
2. d’écrire les tests
3. de mettre à jour la documentation
4. de proposer un message de commit
Cette chaîne de travail est précisément le type de flux où l’IA de développement devient utile.
Il faut rester lucide : Claude Code n’écrit pas toujours du code correct, sûr ou optimal.
Les principaux risques :
- mauvaise compréhension du besoin
- modifications trop larges
- oublis de dépendances ou de cas limites
- code qui compile mais ne respecte pas les contraintes métier
- suggestions fragiles sur la sécurité ou la performance
Une relecture humaine reste indispensable, surtout sur les parties critiques.
L’installation exacte peut évoluer selon les annonces d’Anthropic, le système d’exploitation et la méthode de distribution. Avant toute chose, il faut consulter la documentation officielle Anthropic pour la procédure la plus récente.
Avant d’installer Claude Code, il faut généralement :
- un compte Anthropic ou un accès associé
- une clé API si l’outil repose sur l’API
- un environnement de développement local fonctionnel
- un terminal sous macOS, Linux ou Windows via un shell compatible
- parfois Node.js ou un gestionnaire de paquets selon le mode d’installation
Voici la logique la plus fréquente.
1. Créer ou configurer un compte Anthropic
- Vérifier que l’accès à Claude Code ou à l’API est activé.
- Récupérer les informations d’authentification nécessaires.
2. Installer l’outil
- Selon les cas, l’installation peut passer par un package manager ou un installeur dédié.
- Toujours privilégier la documentation officielle.
3. Configurer les variables d’environnement
- Ajouter la clé API si nécessaire.
- Vérifier que le terminal reconnaît bien la commande.
4. Lancer Claude Code dans un projet local
- Ouvrir le dossier du dépôt.
- Initialiser l’outil ou démarrer une session.
5. Vérifier les permissions
- Contrôler si l’outil peut uniquement lire les fichiers ou aussi les modifier.
- Vérifier les accès réseau et les commandes shell autorisées.
Ne jamais donner un accès large sans contrôle sur :
- des secrets applicatifs
- des clés API en clair
- des fichiers de production
- des répertoires sensibles
- une base de données réelle
Si le projet contient des informations confidentielles, il faut travailler sur un environnement propre, ou anonymiser les données.
L’usage de Claude Code devient pertinent quand les demandes sont claires, structurées et limitées à un objectif précis.
Avant toute requête, il faut se placer dans le bon dépôt local. L’outil sera bien plus utile s’il peut analyser :
- la structure des dossiers
- le framework utilisé
- les fichiers de configuration
- les dépendances installées
- l’historique des conventions du projet
Plus le contexte est propre, plus les réponses sont fiables.
Avant de demander des modifications, il est préférable de poser des questions comme :
- “Explique la structure de cette application”
- “Quels fichiers gèrent l’authentification ?”
- “Où se trouve la logique de validation du formulaire ?”
- “Quels tests couvrent cette fonctionnalité ?”
Cette phase permet de valider que l’outil a bien compris le projet.
Les meilleures instructions sont spécifiques.
Exemples de demandes efficaces :
1. “Ajoute une validation côté serveur pour l’email dans le contrôleur utilisateur, sans modifier l’API publique.”
2. “Crée des tests unitaires pour la fonction de calcul de panier avec les cas limites.”
3. “Refactorise ce composant React pour extraire la logique métier dans un hook personnalisé.”
4. “Explique pourquoi cette route Express retourne une erreur 500 et propose un correctif minimal.”
À l’inverse, une instruction trop vague comme “améliore le projet” produit souvent de mauvais résultats.
Après une proposition, il faut vérifier :
- les fichiers touchés
- les changements exacts
- la cohérence avec les conventions de code
- l’absence de régression
- le respect des règles de sécurité
L’IA doit être pilotée comme un assistant, pas comme un développeur autonome livré sans supervision.
Dès qu’un changement est appliqué :
1. lancer les tests unitaires
2. exécuter les linters
3. vérifier le typage si le projet utilise TypeScript
4. tester le comportement réel en local
5. relire les logs
Cette étape est non négociable.
Certaines tâches se prêtent particulièrement bien à l’assistance par IA.
Claude Code est efficace pour créer :
- des routes CRUD
- des composants UI simples
- des scripts utilitaires
- des schémas de validation
- des classes de service
- des tests répétitifs
Le boilerplate est l’un des usages les plus rentables.
Exemples :
- extraire une logique répétée
- renommer une fonction partout
- simplifier une condition complexe
- convertir une syntaxe ancienne
- séparer une grosse fonction en plusieurs blocs
Le point important consiste à demander un refactoring limité, progressif et testable.
Claude Code peut aider à :
- lire un stack trace
- identifier l’origine probable d’un bug
- repérer une erreur de logique
- proposer des hypothèses de correction
- suggérer des tests de non-régression
Très bon usage également :
- README
- documentation d’installation
- commentaires de fonctions
- notes de migration
- changelog initial
La qualité du résultat dépend fortement de l’instruction.
Un bon prompt contient généralement :
1. le contexte
2. l’objectif
3. les contraintes
4. le format de sortie attendu
5. ce qu’il ne faut pas faire
Exemple de structure :
- Contexte : application Next.js avec TypeScript
- Objectif : ajouter un système de pagination
- Contraintes : ne pas toucher à l’API backend
- Sortie : modification minimale avec tests
- Interdits : pas de nouvelle dépendance
Pour améliorer la qualité de la réponse, il faut préciser :
- le langage
- le framework
- la version
- la convention de nommage
- la contrainte de performance
- la logique métier attendue
- le niveau de tolérance au changement
“Analyse le module de facturation. Ajoute une vérification pour empêcher les montants négatifs avant l’enregistrement en base. Garde l’API actuelle inchangée, écris des tests unitaires pour les cas 0, positif et négatif, et explique brièvement les fichiers modifiés.”
Pourquoi ce prompt fonctionne :
- il fixe le périmètre
- il précise la règle métier
- il impose la compatibilité
- il demande des tests
- il exige une explication
La question du prix est essentielle, mais elle dépend du mode d’accès.
Selon la configuration, Claude Code peut être lié :
- soit à un abonnement ou accès produit
- soit à une facturation API à l’usage
Dans le second cas, le coût dépend généralement :
- du modèle utilisé
- du volume de texte envoyé
- du volume de texte généré
- de la longueur du contexte
- de la fréquence d’usage
Le code source consomme beaucoup de contexte, surtout si l’outil lit plusieurs fichiers ou un grand dépôt. Une session longue peut donc coûter plus cher qu’une simple requête conversationnelle.
Plus le projet est grand, plus il faut être attentif au coût par interaction.
Pour réduire le coût :
1. cibler un sous-dossier au lieu de tout le dépôt
2. éviter les prompts vagues qui relancent plusieurs itérations
3. demander un plan avant de demander une exécution
4. fractionner les tâches
5. limiter les fichiers ouverts au strict nécessaire
Il faut vérifier la grille tarifaire officielle d’Anthropic, car les prix peuvent évoluer.
L’outil n’est pas adapté à toutes les situations.
- pour accélérer un prototype
- pour comprendre un dépôt inconnu
- pour écrire des tests
- pour produire du code standard
- pour aider à la migration ou au refactoring
- pour documenter un projet
- logique métier critique
- code de sécurité
- cryptographie
- conformité réglementaire
- transactions financières sensibles
- systèmes en production sans validation stricte
Dans ces cas, l’IA peut assister, mais ne doit pas décider seule.
Utiliser Claude Code efficacement ne consiste pas seulement à “demander du code”. Il faut intégrer l’outil dans une méthode de développement rigoureuse.
Au lieu de demander une fonctionnalité entière, mieux vaut découper :
1. analyse
2. plan
3. implémentation minimale
4. tests
5. optimisation
Les petits changements sont plus faciles à relire et à valider.
Avant toute modification complexe, demander :
- les fichiers concernés
- les risques
- la stratégie de mise en œuvre
- les tests à prévoir
Cela permet d’éviter les changements incontrôlés.
Une bonne instruction doit souvent inclure :
- tests unitaires
- cas limites
- comportement attendu
- absence de régression
Toujours relire si le code touche :
- authentification
- autorisations
- upload de fichiers
- requêtes SQL
- entrées utilisateur
- secrets
- appels réseau
Même si l’outil paraît convaincant, il peut :
- inventer une API
- mal interpréter une doc
- ignorer un détail métier
- produire un code trop “propre” mais faux
La validation humaine reste la règle centrale.
Les utilisateurs débutants rencontrent souvent les mêmes problèmes.
“Corrige ce projet” n’est pas une demande exploitable.
Il faut préciser :
- le bug
- le fichier
- le résultat attendu
- les contraintes
Plus le périmètre est grand, plus le risque d’erreur augmente.
Un code généré n’est jamais fiable par principe. Il doit être exécuté, testé et relu.
C’est une erreur fréquente en entreprise. Toute politique de sécurité interne doit être respectée.
En environnement professionnel, l’usage de Claude Code doit être cadré.
Il est utile de fixer :
- quels projets sont autorisés
- quelles données peuvent être exposées
- quels types de code peuvent être générés
- quelles validations sont obligatoires avant merge
Claude Code doit s’insérer dans :
- branches Git
- pull requests
- CI/CD
- revues de code
- tests automatiques
Les équipes ont intérêt à documenter :
- ce qui a été généré par IA
- quelles modifications ont été revues
- quels risques ont été identifiés
- quelles validations ont été effectuées
La réponse courte est non.
Claude Code peut :
- accélérer
- assister
- expliquer
- proposer
- automatiser certaines tâches
Mais il ne remplace pas :
- la compréhension métier
- l’arbitrage produit
- la responsabilité technique
- la relecture critique
- la maîtrise de l’architecture
Claude Code augmente la productivité d’un développeur compétent ; il ne remplace pas le raisonnement humain.
Claude Code pour coder avec l’IA est surtout pertinent pour les développeurs qui veulent travailler directement dans le terminal, au plus près de leur dépôt. L’outil est utile pour comprendre un projet, générer du code, écrire des tests, refactoriser et déboguer, à condition de lui donner un cadre précis.
Les points clés à retenir :
- Claude Code est un assistant de développement orienté terminal et projet local
- il fonctionne mieux avec des demandes précises, limitées et contextualisées
- il est particulièrement utile pour le boilerplate, les tests, la documentation et le refactoring
- chaque changement doit être relu, testé et validé humainement
- le coût dépend du mode d’accès et du volume de contexte utilisé
- la sécurité et la confidentialité doivent être traitées avec sérieux
- l’outil assiste un développeur, mais ne remplace pas une expertise technique réelle
Pour obtenir de bons résultats, la meilleure approche consiste à procéder par étapes, demander un plan, imposer des contraintes claires et vérifier systématiquement le code produit. C’est dans ce cadre que Claude Code devient un véritable levier de productivité pour coder avec l’IA.


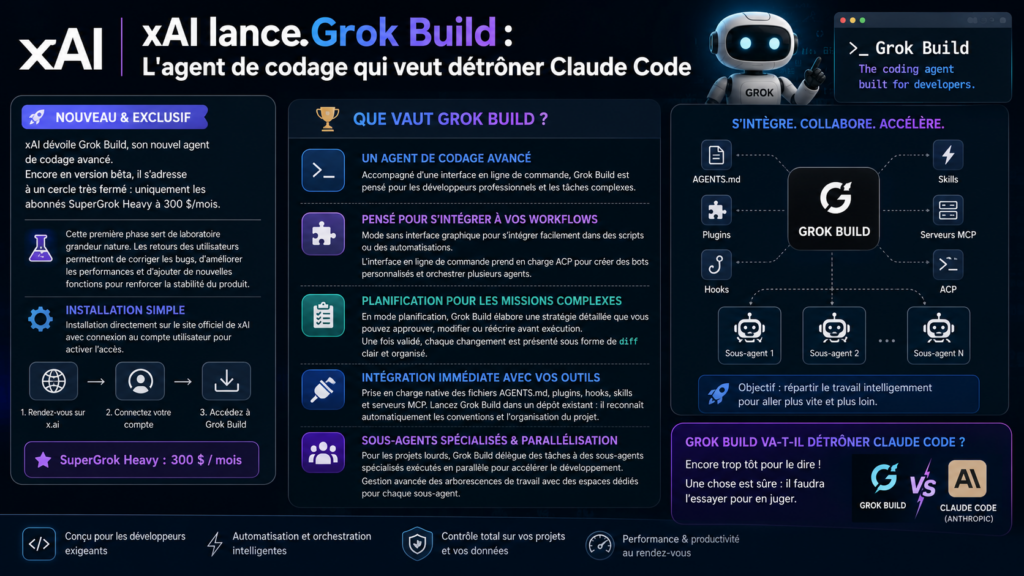
xAI vient de lever le voile sur son nouvel agent de codage, Grok Build. Pour l’instant, l’outil est encore en version bêta. Et il ne s’adresse qu’à un cercle très fermé : uniquement les abonnés SuperGrok Heavy, facturés 300 dollars par mois.
xAI précise que cette première phase servira surtout de laboratoire grandeur nature. Les retours des utilisateurs seront analysés pour corriger les bugs, améliorer les performances et ajouter de nouvelles fonctions. Bref, pour améliorer progressivement la stabilité du produit.
L’installation se fait directement via le site officiel de xAI, avec une connexion au compte utilisateur pour activer l’accès.
Try this early Grok Build (anything) beta and let us know what to improve.
— Elon Musk (@elonmusk) May 14, 2026
Much appreciated! https://t.co/1GgGEQzv3E
L’entreprise décrit Grok Build comme un agent de programmation avancé accompagné d’une interface en ligne de commande. Il est pensé pour les développeurs professionnels et les tâches complexes.
Selon xAI, cet outil est conçu pour s’adapter facilement aux workflows existants. Son mode sans interface graphique permet d’intégrer les agents dans des scripts ou des automatisations.
Quant à l’interface en ligne de commande, elle prend en charge ACP afin de faciliter la création de bots personnalisés et d’applications capables d’orchestrer plusieurs agents.
Pour les missions les plus complexes, Grok Build peut fonctionner en mode planification. Il prépare alors une stratégie détaillée que l’utilisateur peut approuver, modifier ou réécrire entièrement avant le lancement de l’exécution.
Une fois le feu vert donné, chaque changement apparaît sous forme de diff clair et organisé.

xAI promet aussi une intégration immédiate avec les outils déjà utilisés par les développeurs. Les fichiers AGENTS.md, les plugins, les hooks, les skills ou encore les serveurs MCP sont directement pris en charge.
En pratique, il suffit de lancer Grok Build dans un dépôt existant pour qu’il reconnaisse automatiquement les conventions et l’organisation du projet.
Pour les projets plus lourds, l’outil peut déléguer certaines tâches à des sous-agents spécialisés exécutés en parallèle. L’objectif est de répartir le travail pour accélérer le développement.
Il gère également des intégrations avancées avec les arborescences de travail, permettant même d’exécuter certains sous-agents dans leurs propres espaces dédiés.
Mais Grok Build est-il en mesure de faire trembler ses rivaux comme Claude Code d’Anthropic ? Toute la question est là ! Encore faudra-t-il l’essayer.
Cet article xAI lance Grok Build : L’agent de codage qui veut détrôner Claude Code a été publié sur LEBIGDATA.FR.

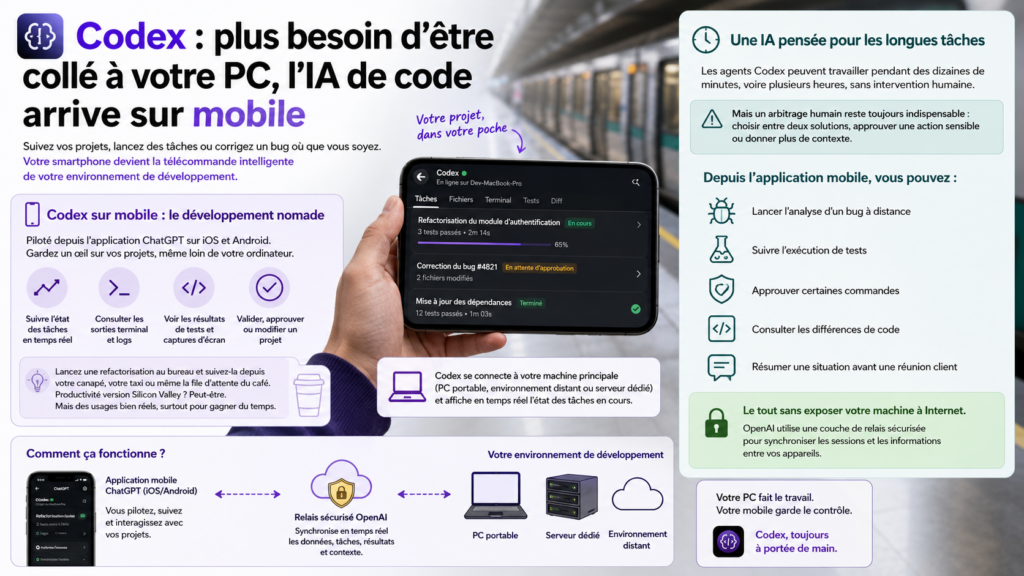
Évidemment, avoir Codex sur mobile a quelque chose de séduisant. Pouvoir suivre un projet, lancer une tâche ou corriger un bug sans rester collé à son PC, ça a de quoi plaire à pas mal de développeurs.
Personne ne voulait bien sûr déboguer une application entre deux stations de métro ou valider un terminal Linux sur un écran de six pouces. Mais avec l’arrivée de Codex sur mobile via l’application ChatGPT, OpenAI tente une approche différente. Le téléphone ne remplace pas l’ordinateur. Il devient la télécommande intelligente de votre environnement de développement. Autrement dit, votre PC continue de faire le gros du travail. Mais votre smartphone vous sert à suivre, corriger ou relancer des tâches à distance.
Avec cette nouvelle intégration, Codex peut désormais être piloté depuis l’application mobile ChatGPT sur iOS et Android. Cela permet de garder un œil sur ses projets même quand on n’est plus devant son ordinateur. Difficile de dire non à ça, n’est-ce pas ?
Concrètement, l’outil se connecte à votre machine principale, qu’il s’agisse d’un PC portable, d’un environnement distant ou d’un serveur dédié. Il affiche ensuite en temps réel l’état des tâches en cours. Les résultats de tests et les captures d’écran peuvent ainsi être consultés directement depuis le téléphone. Idem pour les sorties terminal, les validations ou les modifications de projet.
You've been asking for this one…
— OpenAI (@OpenAI) May 14, 2026
Now in preview: Codex in the ChatGPT mobile app.
Start new work, review outputs, steer execution, and approve next steps, all from the ChatGPT mobile app. Codex will keep running on your laptop, Mac mini, or devbox. pic.twitter.com/9i2Jckjt9z
En principe, le concept ressemble presque à un fantasme de productivité tout droit sorti de la Silicon Valley. L’idée est de lancer une refactorisation avant de quitter le bureau, puis de la suivre depuis son canapé, son taxi ou même dans la file d’attente du café.
Mais derrière le discours marketing, il existe quand même des usages crédibles. Valider rapidement une commande, répondre à une demande de l’IA ou suivre l’avancée d’un correctif sans rouvrir tout son setup peut faire gagner du temps.
Là où OpenAI insiste, c’est sur la gestion des projets de longue durée. L’entreprise explique que les développeurs utilisent de plus en plus des agents capables de travailler plusieurs dizaines de minutes, voire plusieurs heures, sans intervention humaine.
Le problème, c’est qu’un agent autonome finit toujours par avoir besoin d’un arbitrage humain. Choisir entre deux solutions, approuver une action sensible ou donner plus de contexte reste indispensable. C’est précisément là que Codex sur mobile entre en scène.

Depuis l’application, il devient possible de lancer l’analyse d’un bug à distance, de suivre l’exécution de tests ou encore approuver certaines commandes sans retourner immédiatement sur son ordinateur.
Codex permet aussi de consulter les différences de code et même de résumer une situation avant une réunion client. Une manière pour OpenAI de transformer le smartphone en tableau de bord portable pour les projets en cours.
Le plus intéressant ? Le tout fonctionne sans exposer la machine à Internet. OpenAI affirme utiliser une couche de relais sécurisée afin de synchroniser les sessions et les informations entre les différents appareils connectés.
Cet article Codex : plus besoin d’être collé à votre PC, l’IA de code arrive sur mobile a été publié sur LEBIGDATA.FR.
Cursor est devenu en 2026 l’un des outils les plus recherchés pour coder avec l’IA dans un éditeur proche de VS Code. Ce guide explique comment utiliser Cursor pour coder avec l’IA en 2026, de l’installation aux usages avancés, avec des conseils concrets pour gagner du temps sans dégrader la qualité du code.
L’objectif est simple : comprendre ce qu’est Cursor, pourquoi l’utiliser, comment le configurer, quelles fonctionnalités exploiter au quotidien, combien cela coûte, et quelles bonnes pratiques adopter pour rester productif, précis et sécurisé.
Cursor est un éditeur de code assisté par intelligence artificielle, pensé pour accélérer le développement logiciel. Son interface et son ergonomie rappellent fortement Visual Studio Code, ce qui facilite la prise en main pour les développeurs déjà habitués à cet environnement.
En 2026, Cursor est surtout utilisé pour :
- générer du code
- modifier plusieurs fichiers via des instructions en langage naturel
- expliquer une base de code
- déboguer plus vite
- écrire des tests
- refactoriser
- naviguer dans un projet complexe
- automatiser des tâches répétitives
La promesse de Cursor n’est pas seulement l’autocomplétion. L’outil agit davantage comme un assistant de développement intégré capable de comprendre le contexte du projet, d’interagir avec plusieurs fichiers et de proposer des changements cohérents.
La différence principale tient à la profondeur du contexte.
Un outil d’autocomplétion classique suggère surtout la suite logique d’une ligne ou d’une fonction. Cursor, lui, peut :
- analyser plusieurs fichiers d’un dépôt
- prendre en compte la structure globale du projet
- proposer des modifications transversales
- répondre à des questions sur le code existant
- appliquer des changements à partir d’un prompt conversationnel
En pratique, cela transforme l’éditeur en interface de collaboration avec l’IA, et pas seulement en clavier prédictif.
L’intérêt de Cursor en 2026 est surtout pratique. L’outil vise à faire gagner du temps sur les tâches qui ralentissent souvent les équipes techniques.
Cursor peut générer :
- des fonctions
- des composants front-end
- des requêtes SQL
- des scripts d’automatisation
- des tests unitaires
- de la documentation technique
Pour un développeur, cela réduit le temps passé à écrire le code répétitif ou standard.
Sur un projet existant, il est souvent difficile d’identifier :
- où se trouve une logique métier
- pourquoi une fonction a été écrite d’une certaine façon
- quelles dépendances sont concernées
Cursor permet de poser des questions directement sur le code, ce qui est particulièrement utile lors d’un onboarding ou d’une reprise de projet.
Les refontes de code sont coûteuses en temps et risquées. Cursor peut aider à :
- renommer proprement des variables ou méthodes
- harmoniser des patterns
- migrer du code ancien vers une nouvelle architecture
- extraire des fonctions réutilisables
En fournissant un message d’erreur, une stack trace ou un extrait de code, Cursor peut :
- proposer l’origine probable du bug
- suggérer une correction
- expliquer pourquoi l’erreur se produit
- générer un test pour reproduire le problème
Cursor n’élimine pas les risques classiques de l’IA générative. Il faut garder en tête plusieurs points :
- le code proposé peut être faux
- des vulnérabilités peuvent être introduites
- la logique métier peut être mal interprétée
- l’outil peut halluciner des API ou des bibliothèques
- les suggestions ne remplacent pas une revue de code
L’efficacité de Cursor dépend donc fortement de la qualité des prompts, de la clarté du contexte et du niveau de vigilance du développeur.
La prise en main de Cursor reste assez simple, surtout pour les utilisateurs de VS Code.
La première étape consiste à récupérer la version compatible avec le système utilisé :
1. Aller sur le site officiel de Cursor.
2. Télécharger la version adaptée à macOS, Windows ou Linux.
3. Installer l’application comme n’importe quel éditeur de bureau.
Cursor étant proche de VS Code, il est généralement possible d’importer :
- les extensions
- les thèmes
- les raccourcis clavier
- certains paramètres utilisateur
C’est un point important pour limiter la friction à l’adoption.
Selon l’offre choisie, Cursor demande en général :
1. la création d’un compte
2. la connexion à une formule gratuite ou payante
3. éventuellement la configuration d’un mode d’accès aux modèles d’IA disponibles
En 2026, les offres et les modèles évoluent régulièrement. Il faut donc vérifier sur le site officiel les modalités exactes de facturation, de quotas ou d’intégration.
Une fois l’éditeur prêt :
1. Ouvrir un dossier local ou cloner un dépôt Git.
2. Laisser Cursor indexer le projet si nécessaire.
3. Vérifier que les dépendances sont bien installées.
4. Tester une première interaction avec l’assistant IA.
C’est une étape souvent sous-estimée. Pour obtenir de meilleurs résultats, il est utile de préciser :
- le langage principal du projet
- le framework utilisé
- les conventions de nommage
- les règles de style
- les exigences de sécurité
- la structure attendue des tests
Plus les instructions sont claires, plus les réponses de Cursor sont pertinentes.
L’usage le plus efficace de Cursor repose sur quelques scénarios récurrents.
La génération de code est souvent le premier usage testé. Pour qu’elle soit vraiment utile, il faut éviter les prompts trop vagues.
Au lieu de demander :
- “Crée une API”
il vaut mieux demander :
- “Crée un endpoint REST en Node.js avec Express pour récupérer la liste des utilisateurs actifs, avec pagination, validation des paramètres et gestion des erreurs au format JSON.”
Cette précision aide Cursor à produire un résultat plus exploitable.
Cursor est particulièrement utile pour générer :
- des composants React, Vue ou Svelte
- des routes API
- des schémas de validation
- des hooks personnalisés
- des migrations de base de données
- des tests Jest, Vitest ou Pytest
- des fichiers README techniques
- toujours préciser le contexte technique
- indiquer les bibliothèques déjà utilisées
- demander un code compatible avec la structure existante
- exiger une explication si la logique est complexe
L’un des grands intérêts de Cursor est sa capacité à proposer des changements à l’échelle du projet.
- ajouter une nouvelle propriété dans plusieurs couches de l’application
- remplacer une ancienne fonction par une nouvelle API
- migrer une logique de validation vers un schéma centralisé
- harmoniser les types TypeScript
1. Décrire l’objectif global.
2. Indiquer les fichiers ou dossiers concernés.
3. Demander un plan avant application.
4. Examiner chaque modification proposée.
5. Tester localement avant de valider.
Il ne faut jamais appliquer en aveugle des changements massifs sur un dépôt critique.
Cet usage est particulièrement pertinent sur une codebase ancienne ou mal documentée.
- Quel est le rôle de ce module ?
- Quel est le flux d’exécution de cette fonction ?
- Quels sont les effets de bord possibles ?
- Quels fichiers dépendent de ce service ?
- Quelle partie du code est la plus susceptible de causer cette erreur ?
- onboarding d’un nouveau développeur
- audit technique
- reprise d’un projet legacy
- préparation d’une refonte
- compréhension rapide d’un bug de production
Le débogage assisté par IA peut faire gagner un temps réel, à condition de fournir les bons éléments.
Pour obtenir une réponse pertinente, il est conseillé de partager :
- le message d’erreur exact
- la stack trace
- le fichier concerné
- le comportement attendu
- le comportement observé
- les étapes pour reproduire le bug
1. Coller l’erreur complète.
2. Demander une hypothèse priorisée.
3. Faire proposer un correctif minimal.
4. Demander un test de non-régression.
5. Vérifier le résultat en local.
Un assistant IA peut proposer un correctif qui fait disparaître l’erreur visible sans traiter la cause profonde. Le bug peut alors être simplement déplacé.
En 2026, l’un des gains les plus concrets de l’IA dans le développement reste la génération de tests.
- tests unitaires
- tests d’intégration
- cas limites
- mocks
- jeux de données de test
- scénarios de non-régression
Il est préférable de demander :
- les cas nominaux
- les cas d’erreur
- les cas limites
- les dépendances à mocker
- le framework de test exact
Exemple de logique à suivre :
1. Fournir la fonction ou le composant.
2. Demander les scénarios à couvrir.
3. Générer les tests.
4. Exécuter la suite de tests.
5. Corriger manuellement si besoin.
La qualité des résultats dépend énormément du prompt.
Un prompt efficace contient généralement :
1. le contexte : langage, framework, architecture
2. l’objectif : ce qui doit être produit ou modifié
3. les contraintes : sécurité, performance, style, compatibilité
4. le format attendu : patch, explication, liste, test, refactor
5. les critères de validation : ce qui permettra de juger le résultat
- compatible TypeScript strict
- sans dépendance externe supplémentaire
- conforme à ESLint et Prettier
- avec tests unitaires
- sans modifier l’API publique
- optimisé pour la lisibilité plutôt que la performance brute
- demander quelque chose de trop large
- oublier le contexte du projet
- ne pas préciser les contraintes
- demander une refonte complète sans plan intermédiaire
- ne pas exiger d’explication sur les choix faits
Les fonctionnalités exactes évoluent vite, mais certaines familles d’usage restent au cœur de Cursor.
Le chat intégré permet de poser des questions ciblées sur le projet sans quitter l’environnement de développement.
Cursor peut proposer des modifications directement dans les fichiers, souvent avec aperçu des changements.
L’outil s’appuie sur la structure du dépôt pour répondre de manière plus contextuelle qu’un simple chatbot généraliste.
L’autocomplétion prédictive reste utile pour accélérer la frappe sur les portions répétitives ou standards.
Pour les projets qui évoluent vite, cet usage est souvent l’un des plus rentables en temps économisé.
Le prix de Cursor peut évoluer selon :
- la formule choisie
- les quotas d’utilisation
- les modèles activés
- les usages individuels ou en équipe
En 2026, il faut impérativement consulter la page tarifaire officielle, car les éditeurs d’outils IA ajustent régulièrement :
- les plafonds de requêtes
- les performances selon les plans
- l’accès à certains modèles premium
- les options de confidentialité ou d’administration équipe
Une formule payante devient généralement intéressante dans trois cas :
1. usage quotidien professionnel
2. travail sur de gros dépôts
3. besoin de fonctionnalités avancées ou de quotas plus élevés
Pour un usage occasionnel ou exploratoire, la formule d’entrée de gamme peut suffire.
Oui, mais avec nuance.
Cursor peut :
- expliquer des concepts techniques
- proposer du code de départ
- clarifier des messages d’erreur
- aider à comprendre la structure d’un projet
Un débutant peut rapidement tomber dans un piège classique : accepter du code sans comprendre sa logique.
Les risques sont alors multiples :
- apprentissage superficiel
- difficulté à déboguer seul
- accumulation de code fragile
- dépendance excessive à l’assistant
- demander des explications détaillées
- faire commenter le code généré
- réécrire manuellement les parties importantes
- tester chaque hypothèse
- comparer plusieurs solutions
La question de la sécurité est essentielle, surtout en entreprise.
Avant d’utiliser Cursor sur un projet sensible, il faut vérifier :
- les politiques de rétention des données
- le traitement des prompts et du code
- les options de désactivation de certaines remontées
- les garanties contractuelles pour les équipes
- la conformité avec les règles internes de sécurité
- coller des secrets, tokens ou clés API
- exposer des données clients non anonymisées
- envoyer du code propriétaire sensible sans validation interne
- laisser l’IA générer du code sécurité sans revue experte
- authentification
- paiement
- chiffrement
- autorisations et rôles
- gestion des données personnelles
- infrastructure et DevOps critique
Sur ces zones, une revue humaine approfondie reste indispensable.
Cursor est très efficace dans certaines situations, moins dans d’autres.
- démarrage d’une fonctionnalité standard
- écriture de tests
- génération de boilerplate
- refactoring localisé
- compréhension d’un module complexe
- correction d’erreurs bien isolées
- documentation technique
- architecture stratégique d’un produit
- décisions métier sensibles
- sécurité critique
- performances très fines
- code bas niveau très spécifique
- situations où le contexte implicite est trop important
L’IA peut accélérer l’exécution, mais elle reste moins fiable sur les arbitrages complexes nécessitant une compréhension produit, métier ou organisationnelle profonde.
Mieux vaut demander une fonction, un test ou un refactor ciblé plutôt qu’une grosse refonte immédiate.
Le gain de temps ne doit pas supprimer la revue de code.
Demander à Cursor :
- pourquoi ce choix technique ?
- quelles alternatives existent ?
- quels risques sont associés ?
Chaque suggestion importante doit être validée par :
- les tests automatiques
- l’exécution locale
- la revue humaine
Les équipes les plus efficaces finissent souvent par standardiser leurs prompts pour :
- les tests
- les composants
- les migrations
- la documentation
- le débogage
C’est probablement la règle la plus importante. L’outil assiste le développeur, il ne remplace ni la responsabilité ni le jugement technique.
Oui. En 2026, l’écosystème du codage assisté par IA est dense. Selon les besoins, il peut être pertinent de comparer Cursor avec :
- les assistants natifs d’IDE
- les copilotes intégrés à certaines plateformes
- les agents de code autonomes
- les assistants orientés terminal ou pull request
- qualité des suggestions
- compréhension de la codebase
- rapidité
- coût
- confidentialité
- intégration avec l’environnement existant
- facilité de contrôle humain
Cursor se distingue souvent par son expérience centrée sur l’éditeur et par la fluidité de son usage dans le code quotidien, mais le meilleur choix dépend du contexte réel du projet.
Non. Cursor automatise une partie de la production et de l’analyse, mais ne remplace pas la compréhension métier, l’arbitrage technique, la validation qualité et la responsabilité humaine.
Oui, l’outil est généralement utilisé avec les langages et frameworks courants comme JavaScript, TypeScript, Python, Java, Go, PHP ou encore les stacks front-end modernes. Le niveau de pertinence peut toutefois varier selon le langage et la taille du projet.
Oui, et c’est même l’un de ses usages les plus intéressants. Cursor est particulièrement utile pour comprendre et modifier une base de code déjà en production.
Oui, c’est souvent l’un des cas d’usage les plus rentables. Il peut générer rapidement des tests unitaires et proposer des scénarios de couverture souvent oubliés.
Oui, surtout sur le boilerplate, les tests, le refactoring simple et l’exploration de code. En revanche, le gain réel dépend de la discipline de revue, de test et de sécurité mise en place.
Utiliser Cursor pour coder avec l’IA en 2026 permet surtout d’aller plus vite sur les tâches répétitives, de mieux comprendre une base de code et de produire plus rapidement du code, des tests ou des correctifs. L’outil est particulièrement efficace pour la génération de code, le refactoring, le débogage et l’exploration de projet.
Les points essentiels à retenir sont les suivants :
- Cursor est un éditeur de code assisté par IA, proche de VS Code
- il est performant quand le contexte et les prompts sont précis
- il peut faire gagner un temps important sur les tests, le boilerplate et la compréhension du code
- ses suggestions doivent toujours être relues, testées et validées
- la sécurité et la confidentialité du code doivent être vérifiées avant usage professionnel
- le meilleur usage de Cursor consiste à s’en servir comme assistant, pas comme substitut au raisonnement technique
Pour profiter pleinement de Cursor en 2026, la méthode la plus efficace reste simple : donner des instructions claires, travailler par étapes, relire chaque changement et garder un contrôle humain strict sur le résultat final.

![]()
La plupart des algorithmes performants actuels – notamment l’apprentissage profond (deep learning) et ses réseaux de neurones – fonctionnent comme des boîtes noires. On sait qu’ils donnent de bons résultats, mais impossible de comprendre leur logique interne. Ceci pose problème pour de nombreux domaines d’application (médecine, justice…), ce qui incite les régulateurs à exiger des systèmes « explicables ». Plusieurs pistes vers l’explicabilité existent. Zoom sur la « prétopologie ».
Des tendances OpenRouter montrent qu’Elephant Alpha s’est invité tout en haut des classements IA en un temps record. Gratuit, puissant et déjà massivement utilisé, ce modèle intrigue autant qu’il fascine les développeurs.
OpenRouter a lancé Elephant Alpha le 13 avril, sans grande annonce tapageuse. Et pourtant, le résultat a surpris tout le secteur. En quelques jours seulement, ce modèle d’IA s’est hissé en tête des usages mesurés sur la plateforme. C’est un exploit rapide, basé sur l’activité réelle de millions d’utilisateurs. Mais comment une IA aussi récente a-t-elle pu grimper si vite ?
Elephant Alpha ne se contente pas de générer du texte classique. Le modèle vise surtout les usages lourds, là où la longueur et la précision comptent.
Derrière ce nom, on retrouve un système de 100 milliards de paramètres, conçu pour absorber des tâches complexes sans perdre le fil. OpenRouter le décrit comme un modèle textuel pensé pour les workflows d’agents et les environnements techniques.
Ok this is kind of wild.
— Hasan Toor (@hasantoxr) April 17, 2026
A mystery 100B model just appeared at the top of OpenRouter out of nowhere.
No model card. No announcement. No idea which lab made it.
It's called Elephant Alpha and it's already beating half the paid models on the leaderboard. pic.twitter.com/0Z0UdVlrlf
Son point fort se situe dans sa fenêtre de contexte de 256 000 jetons. Concrètement, il peut analyser d’énormes documents ou des bases de code en une seule requête. Cela évite de découper les contenus en plusieurs morceaux, ce qui change la fluidité d’utilisation.
Elephant Alpha intègre aussi des appels de fonctions. Cette capacité lui permet de dialoguer avec des outils externes, comme des API ou des systèmes automatisés. Ainsi, il ne reste pas bloqué dans une simple conversation, il agit dans des chaînes de traitement.
Elephant Alpha n’a pas grimpé au sommet grâce à une annonce spectaculaire ni une campagne marketing massive. Son ascension repose l’usage réel mesuré par OpenRouter.
La plateforme suit les modèles selon le nombre de jetons consommés par les utilisateurs. Autrement dit, plus un modèle est utilisé dans des requêtes réelles, plus il monte dans le classement.
BREAKING: Stealth model Elephant-alpha reaches #1 on OpenRouter Trending.
— Tulsi Soni (@shedntcare_) April 17, 2026
The ranking is based on real token consumption across OpenRouter—reflecting actual developer usage, not benchmarks or subjective evals.
Signal: rapid adoption and growing traction in live environments.… pic.twitter.com/yCyYzOhwij
En plus, son accès immédiat via API et sa gratuité temporaire ont déclenché une adoption massive. Ainsi, des milliers de développeurs ont commencé à le tester en continu. Les intégrations dans des outils comme des environnements de développement et des agents IA ont accéléré ce phénomène.
Ce qui est intéressant, c’est que le modèle cible aussi des usages précis comme le code, la finance ou le droit. Il s’oriente donc vers des tâches structurées, où la logique et la cohérence priment sur la créativité pure.
Un autre point clé est son optimisation qui vise à réduire la consommation de jetons. De ce fait, les réponses arrivent plus vite et coûtent moins de ressources. Enfin, Elephant Alpha reste un modèle textuel pur. Il ne gère ni image ni audio, ce qui le concentre entièrement sur l’efficacité écrite et l’analyse de contenu.
Cet article Elephant Alpha : quelle est cette IA qui a pris la 1ère place en quelques jours ? a été publié sur LEBIGDATA.FR.


L’utilisation d’outils d’IA dans le développement logiciel n’est plus un gadget : bien intégrés, ces outils deviennent de véritables assistants techniques capables d’augmenter la qualité du code, d’accélérer les revues, de simplifier le débogage, de générer des tests pertinents et de maintenir une documentation à jour. Encore faut-il savoir les utiliser correctement, comprendre leurs limites et les intégrer dans un flux de travail rigoureux.
Ce guide détaille des approches concrètes pour exploiter l’IA sur l’ensemble du cycle de vie du code, sans sacrifier l’exigence de qualité ni la sécurité.
---
Les modèles d’IA modernes (type GPT-4, Claude, CodeWhisperer, GitHub Copilot…) sont particulièrement efficaces pour :
- Analyser rapidement de grandes bases de code
Identifier des motifs répétitifs, des duplications, des incohérences de style, des fonctions complexes ou mal structurées.
- Suggérer des améliorations de lisibilité et d’architecture
Proposer des refactorings, simplifier des fonctions, améliorer des noms de variables, réorganiser des modules.
- Repérer des erreurs probables
Erreurs de logique, d’API, de typage, d’edge cases oubliés, cas de concurrence ou d’utilisation de ressources.
- Générer du code auxiliaire
Tests unitaires, scripts de migration, fonctions de log, exemples d’utilisation d’API.
- Produire ou améliorer de la documentation
Commentaires de fonctions, README, guides d’API, notes de conception.
Malgré leurs capacités, ces outils restent :
- Probabilistes, pas infaillibles
L’IA génère ce qui ressemble à une bonne solution, mais ne garantit ni l’exactitude, ni la sécurité, ni la performance.
- Dépendants du contexte fourni
Sans le bon extrait de code, la bonne description métier ou le bon environnement de projet, les suggestions seront incomplètes ou hors sujet.
- Ignorants des contraintes spécifiques
Règles internes de qualité, politiques de sécurité, exigences légales, contraintes de performance ou d’architecture peuvent être ignorées si elles ne sont pas explicitées.
- Potentiellement verboses ou trop sûrs d’eux
Une réponse bien formulée peut donner une impression trompeuse de fiabilité.
La règle d’or : l’IA doit soutenir le jugement du développeur, jamais le remplacer. Chaque suggestion doit être validée, testée et intégrée dans un processus de qualité existant.
---
Plusieurs catégories d’outils peuvent être combinées :
- Assistants de complétion de code dans l’IDE
GitHub Copilot, Codeium, Tabnine, Amazon CodeWhisperer, etc.
Utiles pour : suggestions en temps réel, snippets, complétion de tests.
- Assistants conversationnels généralistes avec capacité code
ChatGPT (avec code interpreter), Claude, etc.
Utiles pour : revues approfondies, refactoring, explications, génération de documentation, débogage guidé.
- Outils spécialisés QA / revue de code
SonarLint, SonarQube, DeepCode (Snyk Code), etc.
Utiles pour : détection systématique de code smells, vulnérabilités, non-respect des règles de style.
- Intégrations CI/CD
Plugins IA pour GitHub Actions, GitLab CI, Azure DevOps, solutions SaaS de revue automatique.
Combiner un assistant génératif avec des outils d’analyse statique classiques offre un bon équilibre entre créativité et rigueur.
Avant d’envoyer du code à un service d’IA hébergé :
1. Vérifier les conditions d’utilisation
- Le fournisseur réutilise-t-il le code pour entraîner ses modèles ?
- Existe-t-il une option “enterprise” avec isolation des données ?
2. Limiter les données sensibles
- Éviter de transmettre des secrets (clés API, mots de passe, certificats).
- Masquer les données personnelles ou propriétaires si possible.
3. Utiliser des environnements self-hosted si nécessaire
- Modèles déployés on-premise ou sur un cloud privé pour le code le plus sensible.
4. Définir des règles internes
- Quand et comment l’IA peut être utilisée.
- Quels types de fichiers ne doivent jamais être partagés.
---
Pour tirer réellement parti d’un assistant IA en revue de code :
1. Fournir un contexte minimal
- Langage, framework, architecture (monolithe, microservices, etc.).
- Objectif du module ou de la fonctionnalité.
- Contraintes (performance, sécurité, compatibilité).
2. Limiter la taille de l’extrait
- Se concentrer sur un fichier, une PR ou un module cohérent.
- Si le contexte est trop volumineux, le découper et fournir un résumé.
3. Préciser les critères de revue
- Lisibilité et maintenabilité
- Respect des conventions de style
- Performance
- Sécurité (injection SQL, XSS, validation d’entrée, etc.)
- Couverture de cas limites
Plus la demande est ciblée, plus les retours sont exploitables.
Pour une revue utile, demander explicitement une structure de sortie, par exemple :
- Résumé général
Points forts et points faibles.
- Problèmes majeurs (blockers)
Bugs probables, failles de sécurité, violations de design critiques.
- Problèmes mineurs
Nommage, duplication, style, petites optimisations.
- Suggestions de refactoring
Fonctions trop longues, responsabilités multiples, patterns mieux adaptés.
- Cas de tests manquants
Scénarios à couvrir (erreurs, limites, volume, concurrence).
Les retours de l’IA peuvent ensuite être triés et intégrés dans le processus de revue classique (pull request, commentaires dans Git, tickets).
- Confronter systématiquement les remarques de l’IA à l’avis humain
Un reviewer humain reste décisionnaire.
- Exiger des justifications
Demander à l’IA d’expliquer pourquoi un point pose problème (normes, patterns connus, risques potentiels).
- Adapter les propositions à la culture du projet
L’IA ne connaît pas les conventions internes à moins de les fournir. Indiquer les règles de style (par exemple PEP8, conventions internes Java, guide frontend maison).
- Éviter la sur-optimisation prématurée
L’IA propose parfois des optimisations micro-performances inutiles au détriment de la lisibilité. Prioriser la clarté.
---
En présence d’un bug, le rôle de l’IA est d’aider à :
- Comprendre le problème
- Formuler des hypothèses
- Proposer des pistes de reproduction et de correction
Approche recommandée :
1. Décrire le contexte du bug
- Ce qui est attendu vs ce qui se produit réellement.
- Environnement (version de langage, framework, OS, base de données).
- Étapes pour reproduire si connues.
2. Fournir les éléments pertinents
- Extrait de code impliqué (fonction, classe, endpoint).
- Log d’erreur ou stack trace.
- Inputs typiques.
3. Demander plusieurs hypothèses
- Demander explicitement : “liste de causes possibles, classées par probabilité”.
4. Demander des stratégies de diagnostic
- Ajouts de logs ciblés.
- Assertions.
- Tests de reproduction isolés.
- Outils de profiling ou de tracing.
Une approche systématique peut être :
1. Identifier le module ou la zone suspecte.
2. Demander à l’IA :
- D’expliquer en langage naturel ce que fait la fonction.
- De pointer des comportements non évidents ou dangereux.
3. Introduire un cas d’entrée problématique et demander :
- Comment le code actuel va le gérer étape par étape.
- Où un décalage avec le comportement attendu apparaît.
4. Faire valider par l’IA la correction envisagée :
- Impact potentiel sur d’autres parties du système.
- Cas limites à tester.
- Rester méfiant face aux “corrections magiques”
Un patch suggéré peut masquer le symptôme sans adresser la cause profonde.
- Vérifier la compatibilité avec l’écosystème réel
L’IA peut proposer des méthodes ou des APIs qui n’existent pas dans la version du framework utilisée.
- Documenter le raisonnement
Noter l’hypothèse validée, la cause racine et les tests ajoutés. L’IA peut aider à rédiger cette note de post-mortem.
---
L’IA est particulièrement utile pour :
- Proposer des cas de tests à partir d’une fonction ou d’une méthode.
- Couvrir des cas limites (valeurs nulles, extrêmes, listes vides, erreurs réseau).
- Écrire la structure de tests (nom des tests, arrange/act/assert, données de test réalistes).
Approche suggérée :
1. Fournir :
- La fonction ou la classe à tester.
- Le framework de test utilisé (JUnit, pytest, Jest, PHPUnit, etc.).
- Les conventions internes (naming, patterns de mocks, use de fixtures).
2. Demander :
- Une liste de scénarios de test décrits en texte.
- Puis, pour les scénarios validés, la génération de tests unitaires correspondants.
3. Réviser et adapter :
- Vérifier que les tests reflètent bien le comportement souhaité, pas celui supposé par l’IA.
- Simplifier ou factoriser si besoin (fixtures, helpers).
Les IA sont souvent plus complètes que les humains pour :
- Imaginer des entrées invalides ou inattendues.
- Tester les comportements en cas de :
- Temps d’attente réseau
- Réponses incomplètes
- Pannes de dépendances (base de données, cache, API externe).
Pour en tirer parti :
- Demander explicitement des tests de robustesse et non seulement des tests du “happy path”.
- Insister sur la gestion des exceptions, la validation des arguments, la résilience aux indisponibilités partielles.
Pour les tests d’intégration :
- L’IA peut aider à :
- Définir les scénarios utilisateurs clés.
- Proposer des jeux de données réalistes.
- Esquisser des scripts de test (par exemple pour Cypress, Playwright, Selenium).
- Limites :
- Nécessité de connaître en détail le contexte de déploiement et l’architecture.
- Besoin de synchronisation avec la réalité (endpoints, routes, schémas de données).
La validation humaine reste essentielle pour éviter des tests trop fragiles ou trop couplés à l’implémentation.
Les outils d’IA ne remplacent pas la mesure de couverture (coverage reports) via les outils habituels, mais peuvent :
- Analyser un rapport de couverture et :
- Pointer des zones critiques non couvertes (authentification, billing, sécurité).
- Proposer des cas de tests supplémentaires pour les couvrir.
- Aider à décider :
- Quels modules doivent viser une couverture plus élevée.
- Où accepter une couverture plus faible (code généré, couches très simples).
---
Utiliser l’IA pour :
- Proposer des docstrings ou commentaires pour fonctions, classes et modules.
- Clarifier des parties complexes, en expliquant :
- Le rôle de la fonction.
- La signification des paramètres et valeurs de retour.
- Les effets de bord éventuels.
- Les préconditions et postconditions.
Bonnes pratiques :
1. Fournir une explication métier en plus du code quand c’est possible.
2. Exiger des commentaires :
- Concis
- Précis
- Orientés sur le “pourquoi” plutôt que le “comment” (que le code montre déjà).
3. Revoir manuellement chaque commentaire :
- Corriger les approximations métier.
- S’assurer que les noms utilisés correspondent à la terminologie du domaine.
L’IA peut accélérer la création de :
- README de projets et de sous-modules.
- Guides d’API (endpoints, payloads, exemples).
- Guides d’installation et de déploiement.
- Notes de conception (design docs, ADR – Architecture Decision Records).
Méthode efficace :
1. Fournir :
- Un extrait représentatif du code ou des fichiers de configuration.
- Une description textuelle de l’objectif du composant.
- Les contraintes clés (scalabilité, sécurité, dépendances).
2. Demander :
- Une première version de documentation structurée.
- Une section “Exemples d’utilisation”.
- Une section “Limitations connues” et “Points d’attention”.
3. Ajuster :
- Adapter le ton et le niveau de détail à l’audience cible (développeurs internes, clients, ops).
- Compléter avec les aspects non visibles dans le code (organisationnels, légaux, SLA, etc.).
La documentation devient vite obsolète. L’IA peut contribuer à limiter ce phénomène :
- En comparant :
- Une version de documentation.
- Le code actuel.
- En identifiant :
- Les différences (noms de fonctions/params, endpoints, comportements).
- Les parties devenues inexactes ou incomplètes.
- En proposant :
- Une mise à jour ciblée des paragraphes concernés, plutôt qu’une réécriture complète.
---
Pour un usage sain et efficace, il est utile d’expliciter :
- Les cas d’usage encouragés
- Aide à la revue de code.
- Génération de tests.
- Documentation.
- Brainstorming d’architectures.
- Les limites
- Pas d’acceptation aveugle de code généré.
- Validation obligatoire pour toute modification de sécurité, de cryptographie, d’authentification.
- Interdiction d’envoyer certains fichiers (config sensibles, données clients).
- Les exigences de traçabilité
- Indiquer dans les PR quand du code a été largement généré ou influencé par IA.
- Discuter en revue des choix suggérés par l’IA, comme n’importe quelle contribution.
Quelques repères :
- Ne pas court-circuiter la revue humaine
L’IA assiste, mais chaque PR doit avoir un ou plusieurs reviewers humains responsables.
- Utiliser l’IA en amont des PR
- Nettoyer le code, clarifier la structure, ajouter des tests.
- Ainsi, les reviewers humains se concentrent sur la logique métier et les choix d’architecture.
- Mettre l’IA dans la CI/CD avec discernement
- Automatiser des retours sur style, duplications, cas évidents.
- Garder les checks bloquants pour les règles les plus importantes (sécurité, standards critiques).
Un usage efficace nécessite des compétences spécifiques :
- Savoir “prompt-er” correctement
- Donner le bon contexte.
- Formuler des demandes précises.
- Demander des alternatives et des justifications.
- Développer un esprit critique renforcé
- Détecter les hallucinations techniques.
- Confronter aux standards du projet, aux docs officielles, aux RFC et aux spécifications.
- Partager les bonnes pratiques en équipe
- Exemples de prompts efficaces.
- Cas où l’IA a permis de trouver un bug subtil ou d’améliorer significativement un module.
- Cas où les suggestions étaient erronées et pourquoi.
---
- L’IA est un multiplicateur de productivité, pas un substitut au jugement humain.
Chaque suggestion doit être revue, comprise et testée.
- Une bonne utilisation commence par un bon contexte.
Préciser le langage, le framework, le rôle du code et les contraintes permet d’obtenir des retours pertinents.
- Pour la revue de code, l’IA excelle sur la lisibilité, les patterns, les cas évidents, mais ne doit pas décider des choix d’architecture ni des compromis métier.
- En débogage, l’IA est utile comme partenaire de raisonnement : génération d’hypothèses, plan de diagnostic, proposition de tests de reproduction.
- Pour les tests, l’IA aide à couvrir plus largement le spectre des cas, notamment les cas limites et les scénarios d’erreur, à condition de garder la main sur les invariants métier.
- En documentation, l’IA est très efficace pour produire des drafts de qualité, mais le contenu métier, les décisions d’architecture et les contraintes non visibles dans le code doivent être ajoutés et validés par les équipes.
- Un cadre d’équipe clair (charte IA) est essentiel pour canaliser l’usage, protéger les données sensibles et intégrer ces outils dans un flux de travail rigoureux.
En intégrant progressivement ces pratiques, l’IA devient un véritable assistant d’ingénierie, capable d’élever la qualité globale du code, de réduire la dette technique et de libérer du temps pour les tâches à plus forte valeur ajoutée : conception, architecture et compréhension approfondie du métier.