❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

Généalogies du profilage

Dans un petit livre très historique – Des règles sur mesure : généalogie du profilage algorithmique (Amsterdam, 2026) -, le philosophe du droit, Nathan Genicot, retrace l’histoire des débats autour du déploiement des principaux systèmes de profilage, à savoir les systèmes d’analyse psychologique au travail, les systèmes de calcul de risque assurantiels et les systèmes d’obtention de crédits bancaires. Et ce qui me semble très éclairant dans cet essai, c’est de constater combien les débats, plus riches que ceux que nous pouvons avoir aujourd’hui sur ces sujets, ont été perdus. Et plus encore, qu’ils ne semblent pas plus avoir été résolus hier qu’ils ne le sont aujourd’hui. Le profilage semble embourbé dans ses limites sans parvenir à ouvrir de voies pour les résoudre. 

La rationalité statistique est au fondement des Etats modernes, rappelle Genicot à la suite d’Alain Desrosières (La politique des grands nombres, La découverte, 1993), d’Alain Supiot (La gouvernance par les nombres, Fayard, 2015) ou encore de Theodore Porter (The Rise of Statistical Thinking, 1820-1900, Princeton University Press, 2020). Mais elle est également au fondement de l’intelligence artificielle. Les statistiques permettent à la fois de quantifier le social et de le prédire, de profiler chacun « sous le prisme d’attributs qu’il partage avec d’autres ». Nous sommes non seulement statistifiés, mais également comparés. Le profilage dont nous sommes l’objet, bien souvent par devers nous, consiste à prédire notre comportement depuis la comparaison avec celui des autres à partir des régularités du passé. Partout, nous sommes notés, prédits, quelque soit la marge de certitude ou d’incertitude des traitements et inférences. Le calcul est normalisé, naturalisé par un score, une note. Que ce soit pour s’assurer, emprunter, se loger, obtenir un emploi, recevoir des allocations, être mis en relation avec d’autres…  Pour Genicot, ce profilage, ce scoring, les appariements qui en découlent, sont des techniques de régulation, des outils de gouvernementalité. Mais, alors que la loi s’applique à tous de la même façon, le profilage, lui, permettrait de s’adapter aux caractéristiques de chacun. Pour le philosophe du droit, il promet d’individualiser le droit pour « pleinement réaliser le principe d’égalité », pour produire des « règles sur mesure ». Tout l’enjeu du livre consiste justement à vérifier cela. Est-ce que le profilage remplit cette promesse ? Est-ce qu’il rend la justice plus juste ? 

Des débats de calculs

Pour déplier ses constats, Genicot observe trois milieux où se déploient, presque concomitant des techniques de profilage : le travail, l’assurance et le crédit. Dans chaque secteur, Genicot révèle, extirpe des archives les débats de l’époque. Et ceux-ci sont étonnement nourris. Les calculs d’alors viennent avec des questions. La science balbutiante s’interroge, quand l’ingénierie d’aujourd’hui semble avancer comme un rouleau compresseur, sans vraiment s’interroger des défaillances que ses calculs produisent ou des limites que la statistique atteint, comme le relevait danah boyd il y a quelques années (et qui vient de donner lieu à un livre qui sera publié le 29 septembre aux presses de l’université de Chicago, Data Are Made, Not Found: A Story of Politics, Power, and the Civil Servants Who Saved the US Census). 

Les pratiques de profilage, rappelle-t-il, sont antérieures à la naissance de l’informatique, même si l’informatique va leur permettre de se déployer et de s’étendre sans commune mesure. Les premières classifications sont produites pour distinguer les capacités des élèves en créant des tests mentaux et d’aptitudes avec la psychologie différentielle. Les mathématiques servent alors à mesurer l’intensité et la qualité des sensations, la vitesse de réaction… pour mesurer les différences interindividuelles et caractériser les populations en marge de la société : les aliénés, les criminels, les pauvres, les anormaux. Derrière ces tentatives pour améliorer la justice en permettant aux politiques publiques de s’adapter aux profils de chacun s’amalgame des capacités de discriminations inédites porté par tout un courant eugéniste comme le montrera le paléontologue Stephen Jay Gould dans La mal-mesure de l’homme (Odile Jacob, 1997) ou plus récemment Kate Crawford dans son Contre-atlas de l’intelligence artificielle  (Zulma, 2022, voire également notre critique). Les tests mentaux visent à diagnostiquer les enfants anormaux dans le contexte de l’instauration de l’obligation scolaire, avec, pour ses promoteurs, une volonté d’améliorer la justice sociale. 

Le terme même de profilage naît pour décrire cette mise en nombre des individus, en 1909 et s’accompagne, dès l’origine, d’un mode de production graphique pour relier les résultats aux différents tests. Au-delà de l’école, les tests vont rapidement être appliqués à l’orientation et à la sélection professionnelle, pour mieux faire correspondre les profils psychologiques aux métiers. Genicot, en plongeant par exemple dans les travaux de Jean-Maurice Lahy, dans les années 30, nous montre que les ingénieurs de l’IA n’ont rien inventé. On produit des tests psychologiques sur deux groupes de travailleurs, les bons et les mauvais (selon une distinction déjà pleine de biais, puisqu’elle ne repose que sur l’appréciation de chefs de services et le nombre de fautes professionnelles recensées) pour produire des métriques distinctives. Test qu’on peut ensuite faire passer à tout requérant pour mesurer si ses caractéristiques sont plus proches de l’un ou l’autre groupe. On tente de mesurer l’énergie, l’endurance, la concentration, la capacité d’initiative… via des tests psychométriques qui ne vont cesser de s’affiner. On les fait passer à une galerie de métiers pour tenter d’identifier ce qui singularise chaque secteur… Le profilage est dès l’origine une comparaison aux attributs statistiques des autres. « L’essence du profilage consiste à prédire une variable cachée (ici : une aptitude) de manière probabiliste, c’est-à-dire sur la base de caractéristiques (ici : les résultats obtenus à des tests psychotechniques) qui sont fortement corrélées à cette variable ». On le voit, malgré leurs efforts à « désubjectiver les méthodes d’appréciation », ces techniques les réifient. Les conditions sociales sont invisibilisées dans les capacités des individus : « le profilage réduit des situations sociales à des propriétés individuelles » et les biais de l’entité qui profilent sont passés sous silence. 

Pas étonnant que ces tests professionnels soient donc contestés. Leur caractère discriminatoire en termes de genre, de niveau social, d’origine… se dévoile à mesure que ces profilages se répandent. Les tests d’aptitudes professionnels montrent par exemple que 58% des Américains blancs les réussissent contre seulement 6% des personnes noires. Les débats pour rétablir l’équité se démultiplient alors. Faut-il différencier ces tests selon l’âge, le genre, l’origine ? Ce n’est qu’en 1991 que les Etats-Unis tranchent en prohibant les pratiques d’ajustement des scores selon l’appartenance à un groupe protégé. Mais si le débat est tranché, il n’est pas réglé. J’ai l’impression que l’enjeu de corriger les biais reste entier. Aujourd’hui encore, on ne sait pas vraiment comment les corriger. Comme si les débats, tranchés par le droit, les avait arrêtés, sans stopper les pratiques ni les problèmes afférents. 

Avec le développement du numérique, le profilage va s’amplifier. Le big data permettant de démultiplier le profilage psychologique, malgré toutes les limites de ces tests, comme nous le disaient il y a quelques années déjà le psychologue Alexandre Saint-Jevin. En fait, le profilage va également s’étendre, comme celui des chercheurs d’emploi, initié au prétexte de mieux les accompagner et qui va surtout servir à les sanctionner et faire peser sur eux des contraintes plus importantes (sans que ce contrôle ne produise aucun horizon, comme nous disions en disséquant Chômeurs, vos papiers (Raisons d’agir, 2023), qui soulignait l’inefficacité du contrôle du chômage). Il va conduire également à un recrutement de plus en plus automatisé, où les systèmes calculent (un peu n’importe comment il faut le dire) la correspondance d’un CV à une annonce. Pour Genicot, la « logique corrélationnelle » se répand et s’impose partout, jusque dans l’évaluation des employés sur leurs lieux de travail. L’appréciation des individus par des variables qui ne lui sont jamais propres se couple d’une comparaison statistique des résultats de chacun évalués par rapport à ceux d’un groupe. Le profilage tient tout entier dans ce rapport étrange de soi aux autres, où les limites des métriques utilisées sont invisibilisées par les ratios et indicateurs produits. Comme si finalement les chiffres pouvaient assurer d’une neutralité de façade, d’une neutralité dont les limites ne sont plus interrogées. Les scores de risques sont partout défaillants, il n’empêche qu’ils ne cessent d’être produits et utilisés, comme nous le pointions en lisant Jathan Sadowski.  

En observant les débats du monde assurantiel comme ceux du secteur bancaire, Nathan Genicot montre les mêmes ambiguïtés. 

Quelles discriminations acceptons-nous ?

La sélection des assurés et la tarification des primes sont depuis longtemps rattachées au calcul de probabilités. L’assurance va prendre son essor au XVIIIe siècle après l’essor de l’arithmétique politique qui invente un siècle plus tôt les premières tables de mortalité qui décrivent le nombre de décès par âge. Le risque assurantiel s’est longtemps apprécié au niveau du groupe, plus qu’au niveau individuel, là où la condition de chacun est affectée par la condition des autres. Il faudra néanmoins attendre la loi de 1898 qui impose au patron d’indemniser les salariés victimes d’accidents du travail, pour faire de l’assurance le gage de la réparation. Les assureurs se mettent à sélectionner les risques qu’ils veulent couvrir comme les assurés. Ils comprennent vite que « plus le profilage est affiné, c’est-à-dire plus il y a sélection et tarification différenciées, moins il y a de solidarité ». Une constance simple que tout le monde semble avoir oublié à l’ère du Big Data. 

A défaut de parvenir à identifier d’autres attributs pertinents, l’âge s’impose souvent comme une catégorie principale, notamment pour l’assurance vie. Genicot souligne que le débat a été constant entre individualisation et solidarité. L’assurance n’a cessé de chercher des variables pertinentes. Derrière ces débats, on en voit poindre un autre, plus philosophique s’il en était : quelles segmentations – et donc quelles discriminations – acceptons-nous en tant que société ? Et lesquelles refusons-nous ? Si tout le monde semble accepter celle de l’âge, la discrimination de genre ou sociale par exemple le sont bien moins. Et les débats sur la discrimination d’origine, aux Etats-Unis, décalque des rapports de domination de la société, sont nourris. L’intégration du comportement et du mode de vie aujourd’hui dans le calcul assurantiel reste souvent polémique, à raison, puisqu’il incrimine l’individu et masque les différences créées par les rapports sociaux. 

Comme partout ailleurs, les assureurs produisent des scores pour calculer l’assurabilité de chacun. Les assureurs ne vont cesser de développer un discours pour justifier la segmentation qui leur profite en promouvant des calculs qui seraient dénués de connotation morale, alors que nombre d’entre eux vont user et abuser de pratiques problématiques, par exemple en tenant compte de la domiciliation pour faire grimper les primes des populations racisées par rapport à celles des riches (et blanches) banlieues américaines. Pourtant souligne Genicot, malgré les critiques acerbes contre les pratiques du secteur, peu de monde interroge « la prétention à atteindre l’objectivité dans l’évaluation des risques actuariels. La pertinence du recours aux classifications ne fait, à peu de choses près, pas l’objet de débats ». Pire, comme le soulignait la sociologue Greta Krippner, l’individualisation du risque semble bien plus la conséquence de la lutte contre les pratiques discriminatoires des marchés de l’assurance plutôt que liée à l’émergence du néolibéralisme. Bon, cela ne signifie pas pour autant que l’évolution du capitalisme est absente de la segmentation assurantielle. Celle est stimulée par la liberté tarifaire, et renforcée par les progrès de l’informatique qui va permettre de démultiplier les variables et de faire disparaître les discriminations derrières la complexité des critères. 

La régulation va bien sûr s’inviter dans ces innombrables débats, par exemple en encadrant les tarifs pour prémunir l’exclusion de certains publics, ou en écartant certaines formes de segmentation les plus criantes et problématiques, comme celles sur la religion, le sexe, l’origine ethnique ou la génétique… mais sans remettre en cause nombre de pratiques problématiques. En fait, derrière les débats nourris, la société semble n’être pas parvenue à fourbir de règles claires ne permettant pas les contournements. L’interdiction de faire des distinctions de genre par exemple n’a pas conduit à limiter les possibilités de segmentations, mais à conduit à utiliser des critères plus précis, comme s’y essaie l’assurance avec la prise en compte des comportements, à l’image de la conduite automobile elle-même. Une personnalisation dans laquelle l’assurance oublie sa fonction initiale : celle de mutualiser les risques. 

Genicot rappelle pourtant que l’assurance, pour fonctionner, doit reposer sur une segmentation modérée. Même constat quant au calcul du crédit et de son risque, né lui aussi avec l’essor des techniques statistiques. Dès l’origine, portés par les grands magasins pour faciliter la consommation, ceux-ci déploient des formulaires standardisés pour classer les performances de remboursements des clients. Là encore, « l’apparente objectivité de la classification n’empêche pas la présence d’une large part d’arbitraire dans l’attribution de la note ». Si la standardisation s’impose pour réduire le pouvoir discrétionnaire des agents, la statistique va s’y imposer dès les années 50 en développant des scores pour évaluer les capacités de remboursements de chacun. Enfin, pas seulement. A mesure qu’ils se déploient, là encore, les scores se complexifient, cachant dans leurs critères leurs innombrables jugements moraux et sociaux. En 1963 par exemple, les variables d’un fournisseur de score prennent en compte toute information disponible : le taux de crédit déjà engagé et les revenus bien sûr, mais aussi le statut marital et la profession, en passant par le fait d’être syndiqué. Derrière cette complexification des scores, c’est assurément notre compréhension commune qui s’éloigne, et avec elle, notre capacité à les réguler. Les innombrables facteurs pris en compte servent à obfusquer la discrimination raciale ou de classe à l’oeuvre. On apprend à utiliser des variables très éloignées des nécessités, simplement parce qu’elles peuvent être de bons prédicateurs, comme le fait d’avoir déjà un compte bancaire, ce qui est le cas de 87% de ceux qui paient leurs échéances de crédits… au risque que ces calculs accentuent les biais inhérents. Pas étonnant que, désormais, les économistes eux-mêmes estiment que les banques ne savent plus prêter à ceux qui en ont besoin. C’est comme si, à mesure qu’ils se perpétuent, les calculs se radicalisaient d’eux-mêmes. Comme l’IA semble s’écrouler à mesure qu’elle s’entraîne sur les données qu’elle produit, les calculs de la société semblent s’effondrer sur eux-mêmes à force d’être usés. Les scores de crédits, dont le célèbre Fico Score qui naît en 1956, se développent pourtant dans un contexte de compétition forte, promettant d’élargir le crédit aux plus pauvres. Il s’impose vite comme une métrique universelle… et immuable.

L’informatisation va permettre de renchérir le score de nouvelles variables, notamment cette des cartes de paiements électroniques qui permet de rendre les notes de risques dynamiques. Genicot rappelle que les notes ont une fonction disciplinaire. Elles font penser qu’elle dépend du comportement de chacun quand elles masquent d’abord des enjeux sociaux et de classe. Pire, malgré leurs lacunes intrinsèques, elles sont désormais utilisées pour d’innombrables autres services au prétexte d’un « besoin commercial légitime » : pour louer un logement, pour assurer une voiture, pour être embauché… « Tous utilisent la note de crédit comme un proxy, un indictateur du trait de comportement qu’ils cherchent à évaluer (tel que le fait d’être un bon locataire ou un bon employé) ». Le score de crédit devient un « outil de mesure de la moralité », alors qu’il est surtout, comme le disait Frank Pasquale dans Black Box Society (Fyp, 2015) opaque, arbitraire et discriminatoire. Les scores ne servent pas tant à clarifier les choses, disait-il, mais à les rendre plus obscures. 

Or, les scores modifient le réel qu’ils entendent décrire. Et à mesure que leur usage s’étend, radicalisent leurs effets. « Une mauvaise note entraînera un taux d’intérêt plus élevé, c’est-à-dire des conditions de remboursement plus difficiles pour la personne débitrice, ce qui accroîtra sa précarité économique. Si la note est prise en compte par des bailleurs ou des employeurs, l’incidence de cet effet de boucle sera d’autant plus significative. Une personne qui, à cause d’une mauvaise note, ne trouve pas d’emploi ou ne parvient pas à se loger, aura du mal à rembourser ses crédits et verra sa note diminuer encore davantage ». C’est en cela que les calculs se radicalisent, qu’ils renforcent le « lumpenscoretariat » qu’évoquaient Marion Fourcade et Kieran Healy. 

Là encore, des régulations seront votées pour encadrer les pratiques, mais sans vraiment parvenir à agir autrement qu’en limitant les pratiques les plus discriminantes. Derrière la neutralité des scores se cache l’accélération des biais. Même un score qui ne reposerait que sur les capacités financières des individus, serait foncièrement problématique puisque les capacités à rembourser sont loin d’être équitablement distribuées. Si l’enjeu est bien de prêter de l’argent aux gens, le score, par nature, vise bien plus à limiter le prêt qu’autre chose. Pas étonnant qu’on se retrouve donc avec des organismes bancaires incapables de faire leur métier : prêter de l’argent à ceux qui en ont besoin ! L’information sur les décisions de crédits prises par les organismes, sur leur distribution, la mesure de leur équité… elle est bien souvent inaccessible. Les critères des scoring ou l’étendu des situations où ils sont utilisés également. Les innombrables données peuvent être désormais utilisées comme des prédicteurs de votre capacité de remboursement, également. Partout, l’opacité du scoring est la règle. Quand on voit par exemple le nombre de gens débancarisés, on se dit que les scores de crédit semblent surtout avoir appris, eux, à masquer leurs lacunes. 

Le risque d’un droit… sur mesure

L’essai de Nathan Genicot est bien plus sage que ma lecture énervée. Il souligne néanmoins combien les modèles statistiques et algorithmiques s’imposent dans tous ces secteurs « pour optimiser la prise de décision en se substituant au jugement humain ». Ils imposent l’idée que l’individu est seul responsable de ses notes, faisant fi du contexte social. Mais plus encore, il estime que le risque de ces calculs, de ces profilages, consiste à produire des règles de plus en plus individualisées, au risque d’altérer notre conception du droit lui-même, pour remplacer la règle qui s’applique à tous, par un droit sur mesure, calculé selon le profil de chacun. 

Dans la dernière partie du livre, il revient sur la critique d’une conception mécanique du droit : les peines similaires, impersonnelles, uniformes, à tous ont longtemps été considérées comme un idéal d’objectivité et de justice. L’impersonnalité des processus décisionnels étant vu comme un rempart contre l’arbitraire et un gage de prévisibilité. Mais là encore, au début du XXe siècle, cette conception est critiquée au prétexte que les conditions et le contexte sont toujours significatifs. A l’égalité succède le principe d’équité, et avec lui, l’idée d’une individualisation des peines pour que le droit soit le même pour tous, à l’image de la critique de la TVA ou des contraventions et amendes, qui s’appliquent à tous au même taux, même à Bernard Arnault, alors que leur impact ne sont pas les mêmes selon les revenus des justiciables. Bon, il existe bien sûr des moyens d’y remédier, en fixant par exemples des critères ou des seuils. Car, comme le souligne très justement le philosophe, le problème de l’individualisation est qu’elle n’a pas de limite. On peut personnaliser selon d’innombrables variables, comme nous le montre le marketing numérique. 

Dans les revues académiques du droit, actuellement, le débat est visiblement vif sur ces questions. La rêve d’automatisation invite certains à imaginer d’adapter la loi aux situations au grès des circonstances, à ajuster et calibrer les standards. Mais comment trouver le bon niveau pour traiter à la fois « les mêmes situations de la même manière » et « traiter différemment des situations différentes » ? « Un consommateur impulsif qui réalise régulièrement des achats en ligne pourrait par exemple se voir imposer des conditions plus strictes avant de pouvoir renvoyer un produit et se faire rembourser qu’un consommateur qui aurait, au contraire, un tempérament responsable et prudent ». Certes, mais sur quelles données, quelles inférences serait produit ce jugement comportemental ? Et serait-il lui-même juste, opposable, redevable ? On a un peu l’impression que ces perspectives oublient toutes les limites pointées par les débats passés que l’auteur a mis en avant dans sa généalogie. 

Pour Genicot, « la substitution des systèmes normatifs classiques par des dispositifs de profilage est déjà à l’œuvre », notamment dans les rapports de l’Etat à ses administrés. C’était le cas notamment, dans les années 70 avec le système GAMIN, un des premiers dispositif public de profilage pour conditionner le versement d’allocation familiales. C’est également le cas avec le profilage des bénéficiaires de la CAF et nombre d’autres outils de gestion du social que nous évoquons souvent sur danslesalgorithmes.net. Du profilage des chômeurs aux contrôles des frontières, l’individualisation et le profilage sont partout, mais ils produisent assez peu d’équité et encore moins d’égalité, au contraire. Le profilage produit surtout des conditions plus dures pour les plus vulnérables. L’optimisation prédictive partout où elle se déploie fonctionne mal, cela n’empêche hélas pas le développement d’innombrables formes de notations sociales. 

Pour Genicot, l’interdiction des notations sociales dans ce contexte par l’IA Act est le bienvenue, mais c’est oublier que le texte les rend licite plus qu’elle ne les interdit. Le RIA ne propose que de les encadrer, que de veiller à ce que les notes ne soient ni disproportionnées ni dissociées du contexte de leur production. Le fait que certains soient à haut risque ne fait peser sur eux qu’une surveillance accrue. Il ne vise pas à rendre les notes plus justes qu’elles ne sont. Ils ne nous invitent finalement pas à questionner la société. Il ne nous invite pas à changer la manière dont on calcule, ni ne nous aide à nous défier de l’enkystement des calculs. Il ne nous invite pas à changer la société, alors que demain, pour changer la société, il faudra assurément changer la manière dont elle est calculée. La personnalisation du droit, le profilage administratif, nous invite seulement à continuer la société telle qu’elle est. « Le profilage est profondément conservateur », rappelle le philosophe. « Le profilage conduit donc à créer des traitements différenciés dont il prétend cependant qu’ils sont conformes à l’égalité », sans offrir à la société les moyens de le vérifier. Ce n’est là que la parole des profileurs. Les innombrables enquêtes sur le sujet, notamment sur le profilage social, depuis les travaux pionniers de Virginia Eubanks, montrent toutes l’exact inverse. Aucun n’est conforme à l’égalité. En reposant sur l’individualisation et la responsabilisation de chacun, il est « l’exact inverse de la solidarité ». Le profilage « conduit à l’oblitération des relations et, plus largement du social. Le rapport de l’individu aux autres n’est jamais compris comme celui d’une interdépendance, mais uniquement comme une comparaison à une classe, à une collection d’individus ». « Les notes obscurcissent la dimension structurelle des inégalités sociales ». Et en s’imposant, elles nous empêchent finalement de les remettre en question. 

Au final, l’enquête historique de Nathan Genicot nous rappelle que pour changer la société, il va falloir changer la manière dont elle calcule. 

Hubert Guillaud
La couverture du livre de Nathan Genicot aux éditions Amsterdam.

Coincés dans les indus de la CAF

En interview pour le MediaTV (ça commence vers 28’30), Bastien Le Querrec, juriste à La Quadrature du Net, explique le fonctionnement des algorithmes de scoring de la Caisse d’allocations familiales (CAF). Ce score de risque de fraude (qui est en réalité un score de risque d’indu, c’est-à-dire de sommes trop perçues par les bénéficiaires) est un chiffre entre zéro et un qui calcule le risque d’avoir perçu « 600 euros d’allocations en trop sur 6 mois » et qui permet de générer des listes d’allocataires à contrôler. Différents facteurs viennent augmenter ce score, comme l’ont montré les travaux de la Quadrature ou de Lighthouse Reports et du Monde, comme le fait de percevoir le RSA ou l’allocation adulte handicapé… Mais également d’être mère isolée (écoutez l’édifiant reportage des Pieds sur Terre ou celui d’Algorithmique de la journaliste Mathilde Saliou consacrés à ces enjeux, ou procurez-vous Les algorithmes contre la société, où une vingtaine de pages sont consacrées aux enjeux du scoring de la CAF). Chaque mois, la CAF calcule donc pour l’ensemble des allocataires, soit la moitié de la population française, un score de probabilité d’avoir 600 euros d’indus sur les 6 derniers mois. « La conséquence, c’est que ce sont les personnes les plus précaires qui accumulent des critères de précarité, qui vont être surciblées ». 

Bastien Le Querrec rappelle que depuis plusieurs années la Quadrature a tenté de faire la lumière sur ce score de suspicion, sans avoir accès au code source de l’algorithme utilisé actuellement. Mise en cause par les critiques, la CAF a fini par modifier sa doctrine : elle vient ainsi de publier le code source des algorithmes de score de risque sur son site (voir également le dossier de presse publié par la CAF). 

Les critères comme le fait de toucher le RSA ou d’avoir de faibles revenus sont toujours présents, souligne Le Querrec. Avec les différents modèles de ce score, les critères ont évolué, rappelle le juriste. Dans la version actuelle, les critères les plus problématiques ont été retirés (la nationalité, le sexe, l’adresse n’entrent pas dans les calculs du modèle… Le nombre de fois où vous vous connectez à votre espace personnel sur le site de la CAF ou le fait d’avoir déjà fait l’objet d’un contrôle n’entre plus en ligne de compte, rappelle Clubic), mais les effets sont restés les mêmes, car la suspicion se dirige toujours vers les mêmes personnes du fait d’effets proxies, c’est-à-dire de variables de substitution. Une étude interne de la CAF a été communiquée à son comité d’éthique mis en place en 2025 (mais n’a pas été publiée). Elle montrerait que dans le modèle 2018 comme dans le modèle 2025, on a une sureprésentation de certaines catégories de personnes en fonction des minimas sociaux ou de la composition du foyer (comme c’est le cas des familles monoparentales et des mères isolées notamment), ainsi que des personnes de nationalité étrangère.

En octobre 2024, la Quadrature et 14 autres associations ont déposé un recours au Conseil d’Etat pour faire reconnaître l’illégalité de l’algorithme utilisé par la CAF (elles sont désormais 25 et la Quadrature a rendu disponible son mémoire). Le Défenseur des droits qui a été interrogé par le Conseil d’Etat en octobre a produit des observations (non publiées) dans lesquelles le Défenseur parle de présomption de discrimination et estime que la CAF n’a pas démontré l’absence de discrimination indirecte à l’encontre de populations protégées. Mediapart, rapporte les constatations du Défenseur qui estime que le traitement algorithmique : « paraît produire un surcontrôle des populations les plus précaires et donc constituer une différence de traitement fondée sur la particulière vulnérabilité économique. Une présomption de discrimination indirecte semble établie ».

Les indus sont souvent liés à des erreurs de déclaration plus qu’à de la fraude. En 2022, la CAF indiquait que sur l’ensemble 100 milliards de prestations, il y avait un peu moins d’un milliard d’indus retrouvés et 350 millions de fraude constatés, ce qui, proportionnellement à la surveillance générale de la population produite par ce scoring, semble un résultat assez anecdotique. « L’algorithme va chercher là où c’est le plus efficace d’aller trouver des indus, c’est-à-dire là où les prestations sont complexes », rappelle Le Querrec, donc cible les personnes les plus précaires, celles qui dépendent d’un faisceau d’aides pour survivre. 

Dans son mémoire de défense envoyé au Conseil d’Etat, la CAF continue à estimer que son algorithme ne produit pas de discrimination, ni de surveillance de masse (elle ne l’a pas publié). Mais ce n’est pas l’avis des associations qui contestent les modalités de calcul devant le Conseil d’Etat. 

Dans les comptes rendus des réunions du Comité d’éthique que la CAF a mis en place (où quelques associations ont pris place aux côtés d’experts et de représentants de la CAF) ont apprend par exemple que 6 déclarations sur 10 comportent des erreurs et que la réforme de la solidarité à la source a pour but de les réduire en envoyant des informations pré-remplies aux allocataires. Dans un autre compte-rendu, les participants du Comité d’éthique estiment  qu’il « serait utile de comparer les effets d’une campagne de prévention des indus. Il serait également utile de connaître précisément les causes des indus et des erreurs. La Cnaf indique qu’un travail d’analyse des causes des indus est en cours.» 

Un autre enjeu est que la solidarité à la source (c’est-à-dire le préremplissage d’information via des échanges d’informations entre administration ou avec les employeurs, comme la Déclaration sociale nominative que nous évoquions ici) favorise une asymétrie d’information accrue entre les allocataires et les services au risque d’éloigner encore l’enjeu majeur « de l’accompagnement, de la facilitation et de la simplification de certaines prestations » (même si la CAF reconnaît qu’il va lui falloir faire des efforts en ce sens).

Malgré ce premier effort de transparence qui constitue une vraie évolution de la part de la CAF, on regrettera que les études spécifiques que la CAF a présentées à son comité éthique ne soient pas publiées. Par exemple, dans le compte-rendu de la réunion du comité d’éthique du 6 octobre 2025, il a été présenté une méthodologie de réduction des biais pour diminuer le ciblage des familles monoparentales à laquelle les citoyens devraient pouvoir accéder.

On pourrait interroger bien d’autres enjeux encore. Par exemple, le seuil défini de risque d’indu à 600 euros sur 6 mois (alors que ce seuil pourrait être différent selon que les personnes sont seules ou avec enfants… et qu’elles reçoivent des montants de prestations différents)… ou le fait d’observer les indus pour des montants bien plus élevés pour identifier les situations vraiment problématiques… Des évolutions de règles possibles dont la CAF se défend d’avance auprès de son Comité d’éthique en indiquant que le changement de ces seuils nécessiterait un lourd travail pour réadresser la sélection des variables. 

Dans le dernier compte-rendu de réunion de son comité éthique de novembre 2025, la CAF rappelle que le Conseil de l’Europe invite à abandonner les modèles de ciblage depuis 2017 pour renforcer une sélection aléatoire et que les contrôles de la CAF vont devoir s’inscrire dans ce cadre à l’avenir, ce qui laisse supposer que l’automatisation va devoir être contrebalancée. La CAF indique également avoir pris note « qu’elle doit communiquer largement les éléments de documentation du modèle de façon transparente, avec un effort de vulgarisation pour les rendre accessibles aux publics les moins initiés, et intelligible pour les personnes concernées (les allocataires).» A regarder les explications fournies par la CAF pour le moment, malgré l’effort de transparence, nous n’y sommes pas encore.

Saisir le monde des objets autour de nous

On se souvient, avec entrain, des 19 petits Exercices d’observations (Premier Parallèle, 2022) de Nicolas Nova : invitations à nous jouer du monde, à aiguiser nos capacités d’observations en apprenant à décaler son regard sur le monde qui nous entoure. Matthieu Raffard et Mathilde Roussel les mettent en pratique et les prolongent, dans A contre-emploi : manuel expérimental pour réveiller notre curiosité technologique (Premier Parallèle, 2025). Les deux artistes et enseignants-chercheurs nous invitent à nous intéresser aux objets techniques qui nous entourent, à les observer pour nous libérer de leur autorité. Ces 11 nouveaux exercices d’observation active nous montrent que comprendre la technique nécessite, plus que jamais, de chercher à l’observer autrement que la manière dont elle nous est présentée. 

A contre-emploi commence par un moulin à café qui tombe en panne et continue en explorant des machines qui dysfonctionnent… Dans ce monde à réparer, nous avons « à remettre du je » dans le lien que nous entretenons avec les machines. Que ce soit en explorant les controverses situées des trottinettes en libre accès ou les rapports difficiles que nous avons à nos imprimantes, les deux artistes nous invitent au glanage pour ré-armer notre sensibilité technique. Ils nous invitent à ré-observer notre rapport aux objets techniques, pour mieux le caractériser, en s’inspirant des travaux d’observations typologiques réalisés par Bernd et Hilla Becher ou par Marianne Wex par exemple. Pour Raffard et Roussel, à la suite des travaux du psychologue James Gibson dans Approche écologique de la perception visuelle (1979, éditions du Dehors, 2014), c’est en se déplaçant dans notre environnement visuel qu’on peut voir émerger d’autres catégories. C’est le mouvement qui nous permet de voir autrement, rappellent-ils Pour les deux artistes : « c’est la fixité de notre position d’observateur qui rend notre lecture des environnements technologiques compliquée ». 

Pour changer de regard sur la technologie, nous avons besoin d’une « nouvelle écologie de la perception ». Pour cela, ils nous invitent donc à démonter nos objets pour mieux les comprendre, pour mieux les cartographier, pour mieux saisir les choix socio-économiques qui y sont inscrits et déplacer ainsi leur cadre symbolique. Ils nous invitent également à lire ce qu’on y trouve, comme les inscriptions écrites sur les circuits électroniques, d’une manière quasi-automatique, comme quand Kenneth Goldsmith avait recopié un exemplaire du New York Times pour mieux se sentir concerné par tout ce qui y était inscrit – voir notre lecture de L’écriture sans écriture (Jean Boîte éditions, 2018). Raffard et Roussel rappellent que jusqu’en 1970, jusqu’à ce qu’Intel mette au point le processeur 4004, tout le monde pouvait réencoder une puce électronique, comme l’explique le théoricien des médias Friedrich Kittler dans Mode protégé (Presses du réel, 2015). Cet accès a été refermé depuis, nous plongeant dans le « paradoxe de l’accessibilité » qui veut que « plus un objet devient universel et limpide en surface, plus il devient opaque et hermétique en profondeur. Autrement dit, ce que l’on gagne en confort d’expérience, on le perd en capacité de compréhension – et d’action ». Pour le géographe Nigel Thrift, nos objets technologiques nous empêchent d’avoir pleinement conscience de leur réalité. Et c’est dans cet « inconscient technologique », comme il l’appelait, que les forces économiques prennent l’ascendant sur nos choix. « Dans les sociétés technocapitalistes, nous sommes lus davantage que nous ne pouvons lire ».

Ils nous invitent à extraire les mécanismes que les objets assemblent, comme nous y invitait déjà le philosophe Gilbert Simondon quand il évoquait l’assemblage de « schèmes techniques », c’est-à-dire l’assemblage de mécanismes existants permettant de produire des machines toujours plus complexes. Ils nous invitent bien sûr à représenter et schématiser les artefacts à l’image des vues éclatées, diffractées que proposent les dessins techniques, tout en constatant que la complexité technologique les a fait disparaître. On pense bien sûr au travail de Kate Crawford  (Anatomy of AI, Calculating Empires) et son « geste stratégique », ou établir une carte permet de se réapproprier le monde. On pense également au Handbook of Tyranny (Lars Müller Publishers,  2018) de l’architecte Theo Deutinger ou les topographies de pouvoir de l’artiste Mark Lombardi ou encore au Stack (UGA éditions, 2019) du designer Benjamin Bratton qui nous aident à visualiser et donc à comprendre la complexité à laquelle nous sommes confrontés. La cartographie aide à produire des représentations qui permettent de comprendre les points faibles des technologies, plaident les artistes. Elle nous aide à comprendre comment les technologies peuvent être neutralisées, comme quand Extinction Rébellion a proposé de neutraliser les trottinettes électriques urbaines en barrant à l’aide d’un marqueur indélébile, les QR codes pour les rendre inutilisables. Ces formes de neutralisations, comme on les trouve dans le travail de Simon Weckert et son hack de Google Maps en 2020, permettent de faire dérailler la machine, de trouver ses faiblesses, de contourner leur emprise, de « s’immiscer dans l’espace que contrôlent les technologies », de contourner ou détourner leurs assignations, de détourner leurs usages, c’est-à-dire de nous extraire nous-mêmes des scénarios d’usages dans lesquels les objets technologiques nous enferment, c’est-à-dire de réécrire les « scripts normatifs » que les technologies, par leur pouvoir, nous assignent, de comprendre leur « toxicité relationnelle ». 

Ils nous invitent enfin à construire nos machines, bien plus modestement qu’elles n’existent, bien sûr. Les machines que nous sommes capables de refaçonner, seuls, ne peuvent répondre à la toute-puissance des technologies modernes, rappellent-ils en évoquant leur tentative de reconstruire une imprimante à jet d’encre. Raffard et Roussel ont reconstruit une imprimante encombrante et peu performante, tout comme Thomas Thwaites avait reconstruit un grille-pain défaillant (The Toaster Project, Princeton, 2011). Cette bricologie a néanmoins des vertus, rappellent les artistes. Elle nous rappelle qu’à la toute puissance répond la vulnérabilité, à la high tech, la low tech. Et que ce changement même de regard, cette réappropriation, permet au moins de modifier le système cognitif des utilisateurs. Comme quand les manifestes cyberféministes nous invitent à regarder le monde autrement (souvenez-vous de Data Feminism). Pour Raffard et Roussel, créer des situations de vulnérabilité permet de changer la relation que nous avons avec les objets techniques. De nous réinterroger, pour savoir si nous sommes satisfaits de la direction dans laquelle les objets technologiques et nous-mêmes évoluons. En nous invitant à décider de ce que nous voulons faire de nos technologies et de ce que nous acceptons qu’elles nous fassent, ils militent pour une éducation à l’expérimentation technologique, qui fait peut-être la part un peu trop belle à notre rapport aux technologies, plutôt qu’à notre liberté à ne pas s’y intéresser. 

Le manuel pour réveiller notre curiosité technologique oublie peut-être que nous aurions aussi envie de les éteindre, de nous en détourner, de nous y opposer. Car le constat qu’ils dressent, à savoir celui que nous ne sommes pas capables de reproduire la puissance des machines contemporaines par nous-mêmes, risque d’être perçu comme un aveu d’impuissance. C’est peut-être là, la grande limite au démontage qu’ils proposent. Renforcer notre impuissance, plutôt que de nous aider à prendre le contrôle des systèmes, à peser de nos moyens d’actions collectifs contre eux, comme le peuvent la démocratie technique et la législation. Nous pouvons aussi parfois vouloir que la technologie ne nous saisisse pas… Et prendre le contrôle des systèmes pour que cela n’arrive pas, les réguler, nous y opposer, refuser de les comprendre, de les faire entrer là où nous ne voulons pas qu’ils interviennent est aussi un levier pour nous saisir des objets qui s’imposent autour de nous.

Hubert Guillaud

La couverture du livre de Matthieu Raffard et Mathilde Roussel, A contre-emploi.

MAJ du 7/11/2025 : Signalons que Matthieu Raffard et Mathilde Roussel publient un autre livre, directement issu de leur thèse, Bourrage papier : leçons politiques d’une imprimante (Les liens qui libèrent, 2025).

Qui est l’utilisateur des LLM ?

Les grands modèles de langage ne sont pas interprétables, rappelle le professeur de droit  Jonathan Zittrain dans une tribune pour le New York Times, en préfiguration d’un nouveau livre à paraître. Ils demeurent des boîtes noires, dont on ne parvient pas à comprendre pourquoi ces modèles peuvent parfois dialoguer si intelligemment et pourquoi ils commettent à d’autres moments des erreurs si étranges. Mieux comprendre certains des mécanismes de fonctionnement de ces modèles et utiliser cette compréhension pour les améliorer, est pourtant essentiel, comme l’expliquait le PDG d’Anthropic. Anthropic a fait des efforts en ce sens, explique le juriste en identifiant des caractéristiques lui permettant de mieux cartographier son modèle. Meta, la société mère de Facebook, a publié des versions toujours plus sophistiquées de son grand modèle linguistique, Llama, avec des paramètres librement accessibles (on parle de “poids ouverts” permettant d’ajuster les paramètres des modèles). Transluce, un laboratoire de recherche à but non lucratif axé sur la compréhension des systèmes d’IA, a développé une méthode permettant de générer des descriptions automatisées des mécanismes de Llama 3.1. Celles-ci peuvent être explorées à l’aide d’un outil d’observabilité qui montre la nature du modèle et vise à produire une “interprétabilité automatisée” en produisant des descriptions lisibles par l’homme des composants du modèle. L’idée vise à montrer comment les modèles « pensent » lorsqu’ils discutent avec un utilisateur, et à permettre d’ajuster cette pensée en modifiant directement les calculs qui la sous-tendent. Le laboratoire Insight + Interaction du département d’informatique de Harvard, dirigé par Fernanda Viégas et Martin Wattenberg, ont exécuté Llama sur leur propre matériel et ont découverts que diverses fonctionnalités s’activent et se désactivent au cours d’une conversation. 

Des croyances du modèle sur son interlocuteur

Viégas est brésilienne. Elle conversait avec ChatGPT en portugais et a remarqué, lors d’une conversation sur sa tenue pour un dîner de travail, que ChatGPT utilisait systématiquement la déclinaison masculine. Cette grammaire, à son tour, semblait correspondre au contenu de la conversation : GPT a suggéré un costume pour le dîner. Lorsqu’elle a indiqué qu’elle envisageait plutôt une robe, le LLM a changé son utilisation du portugais pour la déclinaison féminine. Llama a montré des schémas de conversation similaires. En observant les fonctionnalités internes, les chercheurs ont pu observer des zones du modèle qui s’illuminent lorsqu’il utilise la forme féminine, contrairement à lorsqu’il s’adresse à quelqu’un. en utilisant la forme masculine. Viégas et ses collègues ont constaté des activations corrélées à ce que l’on pourrait anthropomorphiser comme les “croyances du modèle sur son interlocuteur”. Autrement dit, des suppositions et, semble-t-il, des stéréotypes corrélés selon que le modèle suppose qu’une personne est un homme ou une femme. Ces croyances se répercutent ensuite sur le contenu de la conversation, l’amenant à recommander des costumes pour certains et des robes pour d’autres. De plus, il semble que les modèles donnent des réponses plus longues à ceux qu’ils croient être des hommes qu’à ceux qu’ils pensent être des femmes. Viégas et Wattenberg ont non seulement trouvé des caractéristiques qui suivaient le sexe de l’utilisateur du modèle, mais aussi qu’elles s’adaptaient aux inférences du modèle selon ce qu’il pensait du statut socio-économique, de son niveau d’éducation ou de l’âge de son interlocuteur. Le LLM cherche à s’adapter en permanence à qui il pense converser, d’où l’importance à saisir ce qu’il infère de son interlocuteur en continue. 

Un tableau de bord pour comprendre comment l’IA s’adapte en continue à son interlocuteur 

Les deux chercheurs ont alors créé un tableau de bord en parallèle à l’interface de chat du LLM qui permet aux utilisateurs d’observer l’évolution des hypothèses que fait le modèle au fil de leurs échanges (ce tableau de bord n’est pas accessible en ligne). Ainsi, quand on propose une suggestion de cadeau pour une fête prénatale, il suppose que son interlocuteur est jeune, de sexe féminin et de classe moyenne. Il suggère alors des couches et des lingettes, ou un chèque-cadeau. Si on ajoute que la fête a lieu dans l’Upper East Side de Manhattan, le tableau de bord montre que le LLM modifie son estimation du statut économique de son interlocuteur pour qu’il corresponde à la classe supérieure et suggère alors d’acheter des produits de luxe pour bébé de marques haut de gamme.

Un article pour Harvard Magazine de 2023 rappelle comment est né ce projet de tableau de bord de l’IA, permettant d’observer son comportement en direct. Fernanda Viegas est professeur d’informatique et spécialiste de visualisation de données. Elle codirige Pair, un laboratoire de Google (voir le blog dédié). En 2009, elle a imaginé Web Seer est un outil de visualisation de données qui permet aux utilisateurs de comparer les suggestions de saisie semi-automatique pour différentes recherches Google, par exemple selon le genre. L’équipe a développé un outil permettant aux utilisateurs de saisir une phrase et de voir comment le modèle de langage BERT compléterait le mot manquant si un mot de cette phrase était supprimé. 

Pour Viegas, « l’enjeu de la visualisation consiste à mesurer et exposer le fonctionnement interne des modèles d’IA que nous utilisons ». Pour la chercheuse, nous avons besoin de tableaux de bord pour aider les utilisateurs à comprendre les facteurs qui façonnent le contenu qu’ils reçoivent des réponses des modèles d’IA générative. Car selon la façon dont les modèles nous perçoivent, leurs réponses ne sont pas les mêmes. Or, pour comprendre que leurs réponses ne sont pas objectives, il faut pouvoir doter les utilisateurs d’une compréhension de la perception que ces outils ont de leurs utilisateurs. Par exemple, si vous demandez les options de transport entre Boston et Hawaï, les réponses peuvent varier selon la perception de votre statut socio-économique « Il semble donc que ces systèmes aient internalisé une certaine notion de notre monde », explique Viégas. De même, nous voudrions savoir ce qui, dans leurs réponses, s’inspire de la réalité ou de la fiction. Sur le site de Pair, on trouve de nombreux exemples d’outils de visualisation interactifs qui permettent d’améliorer la compréhension des modèles (par exemple, pour mesurer l’équité d’un modèle ou les biais ou l’optimisation de la diversité – qui ne sont pas sans rappeler les travaux de Victor Bret et ses “explications à explorer” interactives. 

Ce qui est fascinant ici, c’est combien la réponse n’est pas tant corrélée à tout ce que le modèle a avalé, mais combien il tente de s’adapter en permanence à ce qu’il croit deviner de son interlocuteur. On savait déjà, via une étude menée par Valentin Hofmann que, selon la manière dont on leur parle, les grands modèles de langage ne font pas les mêmes réponses. 

“Les grands modèles linguistiques ne se contentent pas de décrire les relations entre les mots et les concepts”, pointe Zittrain : ils assimilent également des stéréotypes qu’ils recomposent à la volée. On comprend qu’un grand enjeu désormais soit qu’ils se souviennent des conversations passées pour ajuster leur compréhension de leur interlocuteur, comme l’a annoncé OpenAI, suivi de Google et Grok. Le problème n’est peut-être pas qu’ils nous identifient précisément, mais qu’ils puissent adapter leurs propositions, non pas à qui nous sommes, mais bien plus problématiquement, à qui ils pensent s’adresser, selon par exemple ce qu’ils évaluent de notre capacité à payer. Un autre problème consiste à savoir si cette “compréhension” de l’interlocuteur peut-être stabilisée où si elle se modifie sans cesse, comme c’est le cas des étiquettes publicitaires que nous accolent les sites sociaux. Devrons-nous demain batailler quand les modèles nous mécalculent ou nous renvoient une image, un profil, qui ne nous correspond pas ? Pourrons-nous même le faire, quand aujourd’hui, les plateformes ne nous offrent pas la main sur nos profils publicitaires pour les ajuster aux données qu’ils infèrent ? 

Ce qui est fascinant, c’est de constater que plus que d’halluciner, l’IA nous fait halluciner (c’est-à-dire nous fait croire en ses effets), mais plus encore, hallucine la personne avec laquelle elle interagit (c’est-à-dire, nous hallucine nous-mêmes). 

Les chercheurs de Harvard ont cherché à identifier les évolutions des suppositions des modèles selon l’origine ethnique dans les modèles qu’ils ont étudiés, sans pour l’instant y parvenir. Mais ils espèrent bien pouvoir contraindre leur modèle Llama à commencer à traiter un utilisateur comme riche ou pauvre, jeune ou vieux, homme ou femme. L’idée ici, serait d’orienter les réponses d’un modèle, par exemple, en lui faisant adopter un ton moins caustique ou plus pédagogique lorsqu’il identifie qu’il parle à un enfant. Pour Zittrain, l’enjeu ici est de mieux anticiper notre grande dépendance psychologique à l’égard de ces systèmes. Mais Zittrain en tire une autre conclusion : “Si nous considérons qu’il est moralement et sociétalement important de protéger les échanges entre les avocats et leurs clients, les médecins et leurs patients, les bibliothécaires et leurs usagers, et même les impôts et les contribuables, alors une sphère de protection claire devrait être instaurée entre les LLM et leurs utilisateurs. Une telle sphère ne devrait pas simplement servir à protéger la confidentialité afin que chacun puisse s’exprimer sur des sujets sensibles et recevoir des informations et des conseils qui l’aident à mieux comprendre des sujets autrement inaccessibles. Elle devrait nous inciter à exiger des créateurs et des opérateurs de modèles qu’ils s’engagent à être les amis inoffensifs, serviables et honnêtes qu’ils sont si soigneusement conçus pour paraître”.

Inoffensifs, serviables et honnêtes, voilà qui semble pour le moins naïf. Rendre visible les inférences des modèles, faire qu’ils nous reconnectent aux humains plutôt qu’ils ne nous en éloignent, semblerait bien préférable, tant la polyvalence et la puissance remarquables des LLM rendent impératifs de comprendre et d’anticiper la dépendance potentielle des individus à leur égard. En tout cas, obtenir des outils pour nous aider à saisir à qui ils croient s’adresser plutôt que de nous laisser seuls face à leur interface semble une piste riche en promesses. 

Hubert Guillaud

Inférences : comment les outils nous voient-ils ?

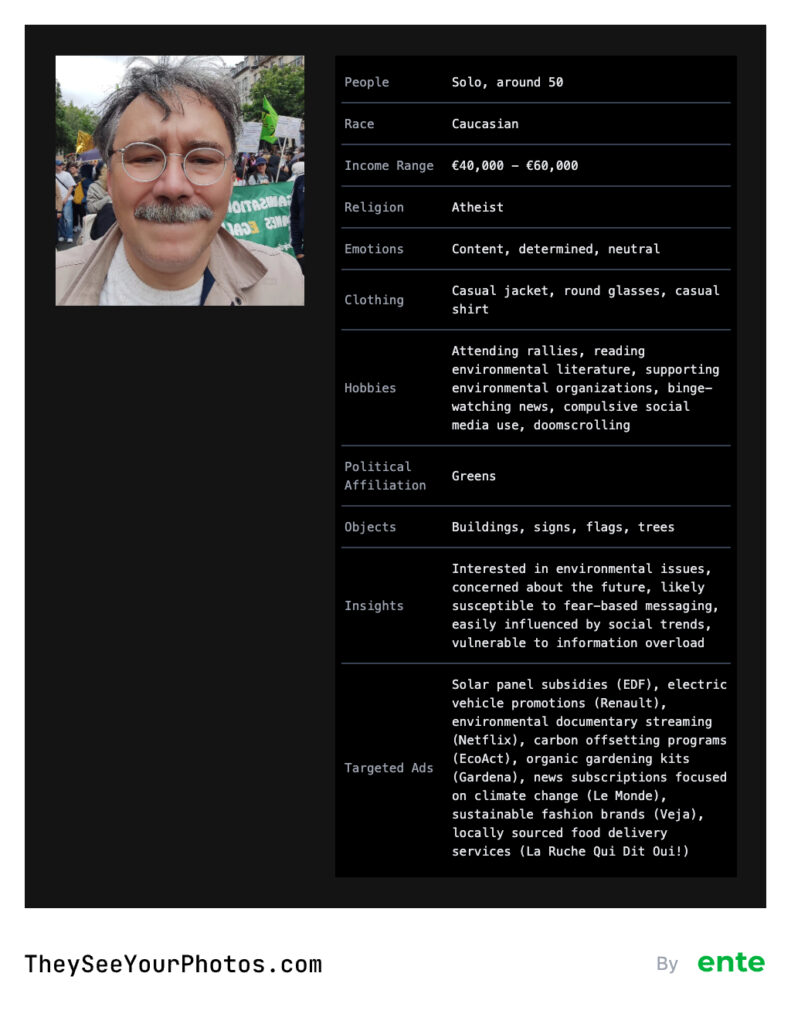
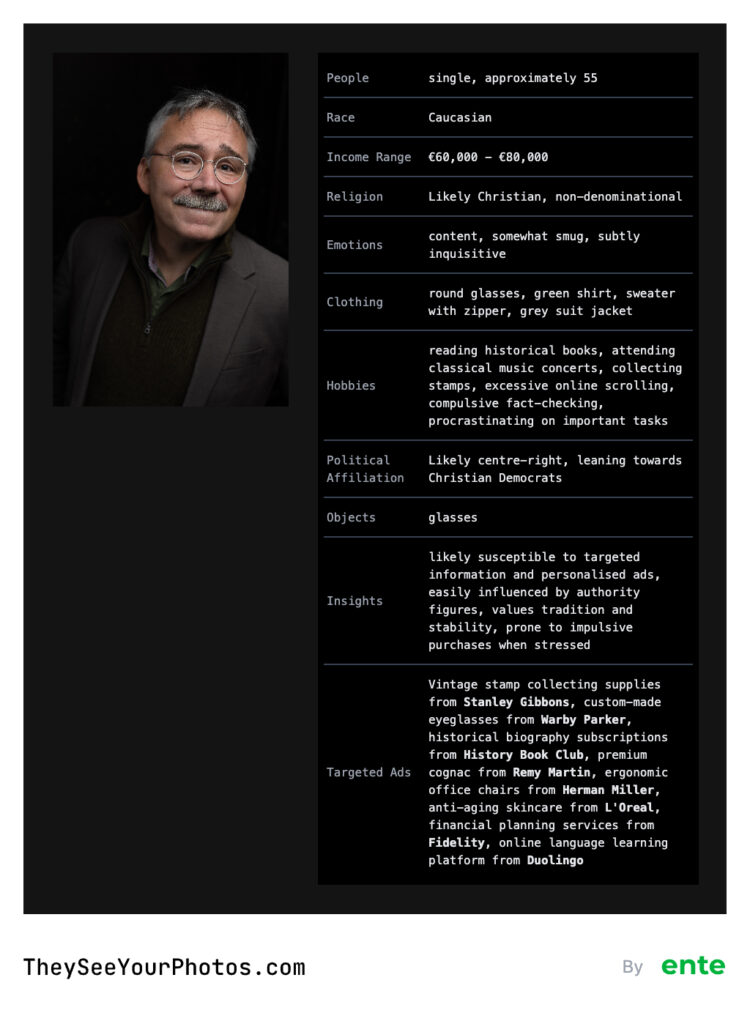
Comment les systèmes interprètent-ils les images ? Ente, une entreprise qui propose de chiffrer vos images pour les échanger de manière sécurisée sans que personne d’autres que ceux que vous autorisez ne puisse les voir, a utilisé l’API Google Vision pour montrer comment les entreprises infèrent des informations des images. C’est-à-dire comment ils les voient, comment les systèmes automatisés les décrivent. Ils ont mis à disposition un site pour nous expliquer comment « ILS » voient nos photos, qui permet à chacun d’uploader une image et voir comment Google Vision l’interprète. 

Sommes-nous ce que les traitements disent de nous ?

Le procédé rappelle le projet ImageNet Roulette de Kate Crawford et Trevor Paglen, qui renvoyait aux gens les étiquettes stéréotypées dont les premiers systèmes d’intelligence artificielle affublaient les images. Ici, ce ne sont pas seulement des étiquettes dont nous sommes affublés, mais d’innombrables données inférées. Pour chaque image, le système produit des informations sur le genre, l’origine ethnique, la localisation, la religion, le niveau de revenu, les émotions, l’affiliation politique, décrit les habits et les objets, pour en déduire des passe-temps… mais également des éléments de psychologie qui peuvent être utilisés par le marketing, ce qu’on appelle les insights, c’est-à-dire des éléments permettant de caractériser les attentes des consommateurs. Par exemple, sur une des images en démonstration sur le site représentant une famille, le système déduit que les gens priorisent l’esthétique, sont facilement influençables et valorisent la famille. Enfin, l’analyse associe des mots clefs publicitaires comme albums photos personnalisé, produits pour la peau, offre de voyage de luxe, système de sécurité domestique, etc. Ainsi que des marques, qui vont permettre à ces inférences d’être directement opérationnelles (et on peut se demander d’ailleurs, pourquoi certaines plutôt que d’autres, avec le risque que les marques associéées démultiplient les biais, selon leur célébrité ou leur caractère international, comme nous en discutions en évoquant l’optimisation de marques pour les modèles génératifs).

Autant d’inférences probables, possibles ou potentielles capables de produire un profil de données pour chaque image pour leur exploitation marketing.

Comme l’explique le philosophe Rob Horning, non seulement nos images servent à former des modèles de reconnaissance d’image qui intensifient la surveillance, mais chacune d’entre elles produit également des données marketing disponibles pour tous ceux qui souhaitent les acheter, des publicitaires aux agences de renseignement. Le site permet de voir comment des significations sont déduites de nos images. Nos photos, nos souvenirs, sont transformés en opportunités publicitaires, identitaires et consuméristes, façonnées par des logiques purement commerciales (comme Christo Buschek et Jer Thorp nous l’avaient montré de l’analyse des données de Laion 5B). L’inférence produit des opportunités, en ouvre certaines et en bloque d’autres, sur lesquelles nous n’avons pas la main. En nous montrant comment les systèmes interprètent nos images, nous avons un aperçu de ce que, pour les machines, les signifiants signifient.

Mais tout n’est pas parfaitement décodable et traduisible, transparent. Les inférences produites sont orientées : elles ne produisent pas un monde transparent, mais un monde translucide. Le site They see your photos nous montre que les images sont interprétées dans une perspective commerciale et autoritaire, et que les représentations qu’elles produisent supplantent la réalité qu’elles sont censées interpréter. Il nous permet de voir les biais d’interprétation et de nous situer dans ceux-ci ou de nous réidentifier sous leur répétition.

Nous ne sommes pas vraiment la description produite de chacune de ces images. Et pourtant, nous sommes exactement la personne au coeur de ces descriptions. Nous sommes ce que ces descriptions répètent, et en même temps, ce qui est répété ne nous correspond pas toujours ou pas du tout.

Exemples d’intégration d’images personnelles dans TheySeeYourPhotos qui montrent les données qui sont inférées de deux images. Et qui posent la question qui suis-je ? Gagne-je 40 ou 80 000 euros par mois ? Suis-je athée ou chrétien ? Est-ce que je lis des livres d’histoire ou des livres sur l’environnement ? Suis-je écolo ou centriste ? Est-ce que j’aime les chaussures Veja ou les produits L’Oréal ?

Un monde indifférent à la vérité

L’autre démonstration que permet le site, c’est de nous montrer l’évolution des inférences publicitaires automatisées. Ce que montre cet exemple, c’est que l’enjeu de régulation n’est pas de produire de meilleures inférences, mais bien de les contenir, de les réduire – de les faire disparaître voire de les rendre impossibles. Nous sommes désormais coincés dans des systèmes automatisés capables de produire de nous, sur nous, n’importe quoi, sans notre consentement, avec un niveau de détail et de granularité problématique.

Le problème n’est pas l’automatisation publicitaire que ce délire de profilage alimente, mais bien le délire de profilage automatisé qui a été mis en place. Le problème n’est pas la qualité des inférences produites, le fait qu’elles soient vraies ou fausses, mais bien le fait que des inférences soient produites. La prévalence des calculs imposent avec eux leur monde, disions-nous. Ces systèmes sont indifférents à la vérité, expliquait le philosophe Philippe Huneman dans Les sociétés du profilage (Payot, 2023). Ils ne produisent que leur propre renforcement. Les machines produisent leurs propres mèmes publicitaires. D’un portrait, on propose de me vendre du cognac ou des timbres de collection. Mais ce qu’on voit ici n’est pas seulement leurs défaillances que leurs hallucinations, c’est-à-dire leur capacité à produire n’importe quels effets. Nous sommes coincés dans un régime de facticité, comme le dit la philosophe Antoinette Rouvroy, qui finit par produire une vérité de ce qui est faux.

Où est le bouton à cocher pour refuser ce monde ?

Pourtant, l’enjeu n’est pas là. En regardant très concrètement les délires que ces systèmes produisent on se demande surtout comment arrêter ces machines qui ne mènent nulle part ! L’exemple permet de comprendre que l’enjeu n’est pas d’améliorer la transparence ou l’explicabilité des systèmes, ou de faire que ces systèmes soient plus fiables, mais bien de les refuser. Quand on comprend la manière dont une image peut-être interprétée, on comprend que le problème n’est pas ce qui est dit, mais le fait même qu’une interprétation puisse être faite. Peut-on encore espérer un monde où nos photos comme nos mots ne sont tout simplement pas interprétés par des machines ? Et ce alors que la grande interconnexion de celles-ci facilite ce type de production. Ce que nous dit « They see your photos », c’est que pour éviter ce délire, nous n’avons pas d’autres choix que d’augmenter considérablement la confidentialité et le chiffrement de nos échanges. C’est exactement ce que dit Vishnu Mohandas, le développeur de Ente.

Hubert Guillaud

MAJ du 25/03/2025 : Il reste une dernière inconnue dans les catégorisations problématiques que produisent ces outils : c’est que nous n’observons que leurs productions individuelles sur chacune des images que nous leurs soumettons… Mais nous ne voyons pas les catégorisations collectives problématiques qu’ils peuvent produire. Par exemple, combien de profils de femmes sont-ils catalogués comme « faible estime de soi » ? Combien d’hommes catégorisés « impulsifs » ? Combien d’images de personnes passées un certain âge sont-elles caractérisées avec des mots clés, comme « alcool » ? Y’a-t-il des récurrences de termes selon le genre, l’âge putatif, l’origine ou le niveau de revenu estimé ?… Pour le dire autrement, si les biais individuels semblent innombrables, qu’en est-il des biais démographiques, de genre, de classe… que ces outils produisent ? L’exemple permet de comprendre très bien que le problème des biais n’est pas qu’une problème de données et d’entraînement, mais bien de contrôle de ce qui est produit. Ce qui est tout de suite bien plus problématique encore…

Réguler la surveillance au travail

Comme nous le disions dans la précédente partie de notre dossier sur la surveillance au travail, les technologies numériques ont permis une expansion sans précédent du volume et du type de données collectées sur les travailleurs. La capacité à les analyser permet aux employeurs de tirer d’innombrables conclusions sur la productivité de leurs salariés… 

Pourtant, concrètement, ces analyses sont bien souvent problématiques quand ce n’est pas défaillantes. En rendant fonctionnelles les statistiques, les indicateurs rétroagissent sur les comportements. La granularité et l’individualisation des métriques permettent de multiplier et d’accroître les pressions au travail, tous les dysfonctionnements étant renvoyés aux pratiques individuelles, « faisant peser toutes les contraintes sur le plus petit et le plus faible maillon de la chaîne », comme l’explique la sociologue Karen Levy dans son livre. Enfin, parce que dans le contexte du travail, les connaissances acquises par les données réorganisent et renforcent d’abord des déséquilibres de pouvoirs majeurs. La régulation de la surveillance n’arrive pas à limiter la recherche de l’amélioration de la production que la surveillance vise à faire advenir. Nous sommes confrontés à une surveillance qui se démultiplie sans parvenir à renforcer les protections légales des travailleurs, seules à même de les protéger d’une exploitation renforcée. 

La lutte contre la surveillance devrait nous mobiliser

« Des caméras alimentées par l’IA qui suivent l’attention des camionneurs aux scanners portables qui surveillent la vitesse d’emballage et de tri des colis des employés des entrepôts d’Amazon, en passant par les logiciels de vidéoconférence qui surveillent les conversations des employés pendant les réunions, dans de nombreux secteurs les entreprises utilisent de plus en plus d’outils automatisés pour collecter des données sur les travailleurs, puis utilisent ces données pour prendre des décisions automatisées sur les tâches et les horaires des travailleurs, les salaires, les promotions, la discipline et même les licenciements », explique le politologue Alexander Hertel-Fernandez sur le blog du LPE Project. Hertel-Fernandez est l’auteur d’une étude sur le management automatisé et la surveillance des travailleurs qui montre que les 2/3 des travailleurs Américains sont sous surveillance sur leur lieu de travail. Cette surveillance est désormais aussi commune pour les cols bleus que pour les cols blancs. Bien qu’elle soit souvent invisible, masquée sous les outils numériques que tous utilisent au quotidien, elle n’est pas sans conséquences : elle a un impact sur la santé et la sécurité des travailleurs.

Pour le chercheur, la montée de la surveillance nécessite d’établir des protections adaptées qui devraient recevoir du soutien de tous les travailleurs, tant celle-ci transcende les classes sociales, les professions et les secteurs. Les organisations du travail ont largement documenté comment cette surveillance érode les droits à l’action collective, intensifie les rythmes de travail, discrimine les femmes, les travailleurs âgés ou les travailleurs handicapés. Le problème pourtant, c’est que le régulateur manque de données sur cette surveillance, d’où l’importance de son enquête. Celle-ci montre d’ailleurs, que le facteur prédictif principal de l’adoption de la surveillance électronique est la taille de l’entreprise : plus l’entreprise est grande, plus la surveillance est intense et variée. L’étude montre également que plus les travailleurs sont soumis à une surveillance intensive, plus l’anxiété grimpe, notamment parce que l’intensité de la surveillance signifie d’abord une intensification des cadences. Ce couplage intensification/anxiété se retrouve dans tous les secteurs, et pas seulement les plus documentés, comme la logistique ou l’industrie. Enfin, les effets négatifs sur la santé et le bien être sont plus forts là où la surveillance est mobilisée pour renforcer la discipline et limiter l’expression. Pour le chercheur, ces résultats suggèrent que ce n’est pas nécessairement la surveillance qui est problématique, mais la manière dont elle est utilisée par le management. Parmi les mesures à prendre pour rétablir l’équilibre, le politologue suggère d’améliorer la transparence de la surveillance, des indicateurs de productivité et des quotas. Mais si le problème est l’intensité de la surveillance, la documenter ne suffira pas à la faire refluer. 

L’impossible transparence de la surveillance

Pourtant, c’est à l’exact inverse que l’on assiste. La surveillance et ses indicateurs relèvent partout d’une opacité qui ne cesse de se renforcer, comme pour toujours mieux s’invisibiliser, à l’image des calculs d’Uber qui ne cessent d’évoluer pour échapper à la documentation comme à la régulation. En 2020, les livreurs de la plateforme Shipt, qui appartient à la chaîne de grande distribution américaine Target, ont vu leurs salaires s’effondrer. Ils ont alors créé un outil pour comprendre l’évolution de l’algorithme, expliquait la chercheuse Dana Calacci pour IEEE Spectrum, qui rappelle que l’asymétrie d’information est un moyen de contrôle (et ce d’autant que ces travailleurs indépendants, par contrat, n’ont pas de droits sur les données). Les livreurs ont utilisé les résultats de l’Observatoire des algorithmes des travailleurs, qui corroboraient l’effondrement de rémunération constaté, pour appuyer leurs revendications pour un salaire minimum garanti. Dans un rapport, le Worker Info Exchange estime que les applications de covoiturage et de livraisons devraient être contraintes de publier des données sur la charge de travail des chauffeurs et les rémunérations, d’autant que le déficit de données actuel pourrait même dissimuler d’importants vols de salaires (et pas seulement des pourboires). Des exemples qui rappellent qu’il n’y a pas d’alternative à la transparence des données, ce qui n’empêche pas celle-ci de continuer à échapper à tous. Accéder aux données reste le premier levier pour observer la surveillance et la limiter.

Image : Page d’accueil de l’observatoire algorithmique des travailleurs.

L’année dernière, le LPE Project avait publié plusieurs articles pour questionner les limites de la surveillance. La chercheuse Karen Levy y montrait que non seulement la surveillance s’opacifie, mais que les autorités en favorisent l’extension, plutôt que de chercher à la contraindre et à la limiter. La sociologue parle d’ailleurs « d’interopérabilité de la surveillance » pour pointer la compatibilité des différentes formes de surveillance, que ce soit celle des autorités de contrôle, comme celle des employeurs ou celle des tiers auxquels les employeurs accordent des accès. 

L’extension, l’intensification et l’élargissement de la surveillance se fait au détriment des employés, pris en tenaille par de nouvelles injonctions liées aux objectifs multiples et contradictoires de tous ceux qui ont accès aux données produites par ces surveillances. Les surveillances “gouvernementales, patronales et commerciales” se superposent pour créer de nouvelles rigidités au travail. Le problème est que cette conjonction d’objectifs complémentaires laisse peu d’espace aux travailleurs pour résister à ces pressions concomitantes, pour résister à “un régime de surveillance supérieur à la somme de ses parties”. La surveillance est d’autant plus opaque qu’elle sert les intérêts de trop d’acteurs pour devenir transparente. Cette surveillance alimente en données des acteurs avec lesquels les entreprises ont des partenariats commerciaux, comme leurs clients. Mais pas seulement. Outre la police et les services sociaux, de plus en plus d’intermédiaires de données tentent d’en tirer profit, à l’image de services de crédits qui proposent des avances sur salaires aux employés. 

La surveillance produit les cadences, modifie les conditions d’emploi

La spécialiste de l’économie des plateformes, Sarrah Kassem , auteure de Work and Alienation in the Platform Economy: Amazon and the Power of Organization, expliquait quant à elle que les travailleurs des entrepôts d’Amazon sont dépendants d’un « régime de productivité algorithmique », qui les pousse à respecter des taux « d’unités par heure », c’est-à-dire rien d’autre que des cadences, imposées par les tâches, les volumes, et les moyennes productives des autres employés auxquelles chacun est comparé. Si les solidarités collectives et les résistances sont possibles, elles sont rendues très difficiles, du fait des innombrables types de contrats qui se rencontrent dans les entrepôts (fixes, intérimaires, sous-traitants, indépendants… avec des horaires fluctuants…) et des manœuvres anti-syndicales d’Amazon. 

Dans les chaînes de production numériques hyper-taylorisées du Mechanical Turk d’Amazon par contre, la surveillance, elle, est totale. La grande précarité du travail et l’absence de relation avec les autres travailleurs rend l’organisation collective encore plus compliquée, même si, à l’initiative des travailleurs, des espaces alternatifs de solidarité et de lutte ont parfois réussi à émerger. Pour le chercheur Reed Shaw, qui s’est lui aussi intéressé aux entrepôts d’Amazon, la surveillance modifie les conditions d’emploi. Si le taux de blessure y est deux fois supérieur à la moyenne nationale, c’est que l’unité de mesure du travail d’Amazon, focalise sur le temps pendant lequel les travailleurs sont inactifs entre deux colis scannés. Le nombre d’unités traitées par heure favorise l’intensification du travail qui génère en réponse une augmentation du risque de blessure et d’accident. Pour Shaw, c’est l’intensification que le taylorisme numérique produit le coupable : c’est donc sur la régulation des cadences qu’il faut pouvoir agir. D’autant que les systèmes de mesures ne s’adaptent pas à certains types d’employés, comme les femmes enceintes ou les travailleurs handicapés, qui sont encore plus sévèrement punis par les systèmes qui évaluent les cadences sans aménagements. Pour Shaw, “la surveillance généralisée des employés devrait être considérée comme modifiant le contexte de l’emploi d’une manière qui menace un large éventail de lois et de protections du droit du travail”. 

Vers une surveillance sans échappatoire

Pour le professeur de droit Matthew Bodie, co-auteur de Reconstructing the Corporation: From Shareholder Primacy to Shared Governance, la surveillance des employés procède d’une nouvelle collecte de données et propose une nouvelle création de valeur permettant aux employeurs de tirer une nouvelle valeur de la relation de travail, explique-t-il, sans qu’il n’y ait de recours ni de droits pour les travailleurs fournisseurs de données, ni de modalités pour exercer leur pouvoir collectifs sur ces données. Pour Bodie, la frontière traditionnelle entre les informations de travail et les informations personnelles, est en train de devenir totalement floue. Toutes sortes d’informations personnelles peuvent désormais être convoquées comme “pertinentes” pour évaluer la performance individuelle au travail : notre santé, nos relations avec nos collègues, nos opinions politiques, notre consommation de caféine, notre disposition au conflit… (sans que cette “pertinence” ne soit jamais évaluée, comme le soulignaient les chercheurs Mona Sloane, Rumman Chowdhury et Emmanuel Moss dans un excellent article qui dénonçait la prétention à la connaissance des systèmes). La réponse instinctive à ce problème consisterait à renforcer la protection de la vie privée sur les lieux de travail, mais cette réponse ne convainc pas Bodie, notamment parce qu’il suffit d’un pseudo consentement imposé dans une relation de travail par nature déséquilibrée pour vider ce renforcement de sa substance. 

“La relation aux données ne cesse de devenir de plus en plus déséquilibrée”, constate le chercheur. C’est par les données sur les chauffeurs et leurs clients que les entreprises de covoiturage fixent les prix et affectent les chauffeurs, sans que les conducteurs puissent avoir la main sur ce qui leur est soustrait. Bodie est pessimiste : désormais, “la relation de travail nécessite un flux de données trop important pour espérer ne jamais l’arrêter”. Selon lui, les travailleurs ont besoin de plus de droits sur leurs données et leur utilisation, à l’image de ceux que déploient le RGDP en Europe (comme le droit de limitation des finalités ou les droits d’opposition à certains types de prise de décision automatisée). Reste pourtant à trouver les modalités d’action collectives. Ici, Bodie dresse un comparatif avec l’hypersurveillance des athlètes de haut niveau, qui, malgré la démultiplication d’information sur leurs performances, gardent des droits sur leurs données voire des voix collectives pour négocier la portée de la collecte de données par les équipes. Les organisations syndicales devraient avoir la capacité de négocier avec les employeurs par l’accès aux données et leur partage – mais seulement 6% des employés du secteur privé sont syndiqués aux États-Unis. Les travailleurs sans représentation collective n’ont donc aucune perspective de pouvoir collectif sur la collecte. D’autres structures organisationnelles pourraient également faire levier, allant de l’actionnariat salarié aux coopératives de plateformes, en passant par la codétermination…  et invite à imaginer des “conseils de données” habilitées à examiner toute collecte ou utilisation de données des employés. “Nous devons donner aux travailleurs la possibilité d’avoir leur mot à dire dans la gestion des données et les droits sur les données qu’ils fournissent.” Oui ! Mais là encore la contribution ne trouve pas le levier de cette activation. 

On pourrait croire à lire ces billets, que le RGPD est l’alpha et l’omega de la solution. C’est oublier pourtant, comme le rappelle son intitulé complet, que celui-ci n’est pas qu’une protection vis-à-vis du traitement des données à caractère personnelles, mais qu’il organise également leur libre circulation, sous conditions.

Les calculs sont surtout opaques pour invisibiliser leurs incohérences et  renforcer leur opacité

Ce que ces billets disent assez imparfaitement, c’est ce que change cette surveillance, ses impacts et les modalités de cet impact. Ce qui se joue dans le renforcement de la surveillance au travail est pourtant très fort au niveau RH et plus encore au niveau de la question salariale. Les données sont de plus en plus utilisées pour produire des indicateurs de performances souvent problématiques sur de plus en plus d’employés, comme s’en émouvait un article du Washington Post prédisant l’arrivée du licenciement algorithmique. La surveillance a un impact direct sur l’employabilité, le recrutement et sur la rémunération. C’est ce qu’expliquait dans un autre billet du LPE Project la professeure de droit Veena Dubal. Dans le monde des plateformes de livraison ou de transport, la rémunération n’est pas fixe. Elle est à la fois “imprévisible, variable et personnalisée”. En cas de forte demande par exemple, les prix des courses vont augmenter et les revenus des coursiers également. Mais il n’y a pas que cette tension entre l’offre et la demande qui explique les variations, et même quand c’est cette explication qui domine, les variations demeurent incohérentes. En fait, la rémunération algorithmique n’est pas du tout une forme applicative et parfaite du marché, comme elle voudrait nous le faire croire. Au contraire.

Les incohérences sont nombreuses, explique Dubal. Parfois vous pouvez obtenir une prime si vous acceptez un trajet supplémentaire, mais bien souvent cette prime n’est pas proposée à un collègue qui a le même historique de circulation. La modularité des incitations de ce type varie sans arrêt, sans que les travailleurs ne parviennent à comprendre leur logique. A l’inverse, vous pouvez attendre ce trajet et cette prime liée à un certain nombre de courses à accomplir, sans que l’algorithme ne vous donne de course, alors que d’autres conducteurs en obtiennent. Le problème, c’est que tout cela n’est pas une question de marché, de malchance ou de hasard, mais bien le résultat d’un calcul. La manipulation des données des conducteurs permet de leur faire croire que les variations de leurs rémunérations tiennent d’un Casino, expliquait dans Fortune Stephanie Vigil, conductrice pour DoorDash, qui rappelle par exemple que les pourboires que les clients donnent ne sont pas attribués directement à leurs livreurs, mais obscurcies par les plateformes pour que les chauffeurs ne privilégient pas les courses avec pourboire. Pour elle, les conducteurs doivent récupérer l’accès à leurs données, comme le défend l’association DriverRights. Les bas salaires et les pourboires sont devenus la règle chez les plateformes de livraison de nourriture, rappelait Inayat Sabhikhi de One Faire Wage dans Points, l’année dernière, rappelant qu’elles ont toutes pratiqué le vol de pourboires et que toutes les organisations réclament désormais la transparence sur ceux-ci… sans l’obtenir. 

La surveillance pour produire des discriminations

De plus en plus de travailleurs du transport et de la logistique sont confrontés à un salaire constamment fluctuant lié à la gestion algorithmique du travail, explique encore Dubal. “Dans le cadre de ces nouveaux régimes de rémunération, les travailleurs perçoivent des salaires différents – calculés à l’aide de formules opaques et en constante évolution reflétant l’emplacement, le comportement, la demande, l’offre et d’autres facteurs de chaque conducteur – pour un travail globalement similaire.” Le problème de ces situations, n’est pas seulement celui d’une rémunération variable basée sur la performance, mais la conjonction de cette variabilité avec une autre : celle de la répartition du travail basée non seulement sur le comportement des travailleurs, mais également sur d’autres critères liés eux à la profitabilité que le calcul opère pour l’entreprise entre tous les critères. Elle produit une “discrimination salariale algorithmique” (voir également son papier de recherche) qui permet aux entreprises de personnaliser et différencier les salaires d’une manière inconnue à ceux que ce calcul impacte, en les payant pour qu’ils se comportent de la manière dont l’entreprise le souhaite, à la limite de ce qu’ils sont disposés à accepter. L’asymétrie d’information laisse à l’entreprise toute latitude d’ajustement. Enfin, “la discrimination salariale algorithmique crée un marché du travail dans lequel des personnes qui effectuent le même travail, avec les mêmes compétences, pour la même entreprise, en même temps, peuvent percevoir une rémunération horaire différente”, le tout via un système obscur qui ne permet ni de prédire ni de comprendre sa rémunération. 

Pourtant, rappelle la chercheuse, les lois internationales du travail rappellent qu’à travail égal salaire égal, et que les entreprises ne peuvent pas introduire de règles nouvelles ou opaques pour obscurcir le calcul du salaire. “Si un mineur devait être payé en fonction de la quantité de charbon qu’il extrayait, la société minière ne pouvait pas peser le charbon après l’avoir fait passer à travers un tamis”. Pourtant, c’est ce que font les calculs algorithmiques. Ils ruinent les logiques d’équité, notamment parce que le salarié ne peut pas connaître les critères que l’entreprise a déterminé pour évaluer son travail ou le planifier, et que le calcul rend le salaire de chaque personne différent, même si le travail est le même au même moment, comme c’est le cas entre les conductrice et les conducteurs d’Uber : les femmes gagnant 7% de moins que les hommes. 

En plus de saper l’équité salariale, la rémunération algorithmique est sans cesse changeante, ce qui fait que des pratiques rémunératrices peuvent ne plus le devenir d’une manière qui semble aléatoire au travailleur, alors qu’elles sont calculées. Les conducteurs parlent d’une “mécanique de casino”. Pour la chercheuse, le fait de reconnaître les coursiers comme des salariés ou de fixer des prix planchers pourraient améliorer les choses bien sûr. Mais la rémunération variable automatisée nécessite, elle, une réglementation supplémentaire. La contre-collecte de données (organisés par les travailleurs indépendants pour documenter les algorithmes auxquels ils n’ont pas accès, à l’image de ce que le Worker Info Exchange a mis en place pour et avec les chauffeurs d’Uber) ou les appels à une plus grande transparence des calculs oeuvrent dans le bon sens, mais sont également insuffisants. La chercheuse invite à aller plus loin via une “abolition de l’extraction de données au travail”. L’extraction de données au travail n’est pas nécessaire à la gestion du travail, rappelle-t-elle en invitant à en finir avec le calcul algorithmique au travail. Radical ! 

Réguler le croisement de données

Sans être aussi radical qu’elle, il me semble que le problème, ici, tient du fait que nous sommes en train d’autoriser des croisements de données qui ne devraient pas l’être. A l’ère de l’Intelligence artificielle, les entreprises ont intégré l’idée que pour améliorer leurs calculs, elles devaient disposer de toujours plus de données et que de leurs croisements sortiront des indicateurs de performance toujours plus optimaux. Mais on ne s’est jamais posé la question de savoir si certains croisements n’étaient pas souhaitables, voire contraires à l’esprit du droit du travail. Que se passe-t-il quand le calcul du salaire est corrélé au planning afin d’optimiser les deux, voire l’un plus que l’autre, comme le montrait le scandale Orion à la SNCF, où dans les entrepôts du hub logistique néerlandais, où les informations de planning sont corrélées avec le calcul de primes, pour les limiter. C’est typiquement ce que montre Veena Dubal quand elle souligne que la prime devient inaccessible à un chauffeur parce que son obtention vient en conflit avec l’objectif de réduction des coûts que programme également le système d’Uber. Pour ma part, il me semble qu’à l’heure où l’on promet de pouvoir croiser toutes les données les unes avec les autres, il est temps de se demander quelles données RH ne doivent pas être croisées entre elles. Pour poser la question des limites à la surveillance, il est nécessaire de regarder ce que produit l’interconnexion de ces données et de montrer qu’il y a des croisements de données, des calculs qui ne devraient pas être possibles. A l’heure où les entreprises partent du principe que toutes les données sont associables pour produire de meilleurs calculs et de meilleurs indicateurs, la piste qui n’est jamais évoquée dans cette libération des calculs, c’est la régulation de leurs croisements. Peut-être que certains croisements ne devraient pas être rendus possibles, parce qu’ils transforment profondément l’esprit de la loi qui régit le code du travail. En tout cas, à l’heure où tous les croisements de données sont autorisés, nous interroger sur ce qui ne devrait pas être corrélé est assurément un exercice qui pêche par son absence.

Pas de transparence sans lutte sociale

En fait, les appels à la transparence se démultiplient sans être suivis d’effets, d’abord parce que le régulateur n’incite pas à la transparence, mais surtout, parce qu’à elle-seule, la transparence ne suffit pas à produire le progrès social.  

En septembre, la Stanford Social Innovation Review publiait un dossier sur les questions de technologies au travail. Parmi les contributions, celle de Christina Colclough et Kate Lappin revenait sur la nécessité de se mobiliser pour que le développement technique au travail soit plus maîtrisé qu’il n’est (on avait déjà rencontré les stimulantes réflexions de Christina Colclough en défense de l’algogouvernance). « Les systèmes numériques au travail sont souvent présentés comme augmentant l’efficacité et la productivité et rendant les décisions plus neutres, en supprimant la subjectivité humaine. Mais trop souvent, les algorithmes reproduisent et intensifient les inégalités et les préjugés, conduisent à une demande croissante de productivité des travailleurs et utilisent les données des employés de manière à la fois opaque et abusive. Aujourd’hui, les travailleurs n’ont aucune idée des données qui sont collectées par devers eux ni de la manière dont elles sont utilisées pour évaluer leurs performances, alors que des jugements sont souvent effectués par des systèmes automatisés tiers, dont les fonctionnements ne sont jamais explicités ». Alors que les cas problématiques documentés sont nombreux, la même cause produit les mêmes effets : « lorsque les travailleurs n’ont pas accès aux algorithmes utilisés par les employeurs, il est presque impossible de prouver qu’il y a eu discrimination ». La transparence en matière de salaires et de conditions de travail est censée être la règle, mais les systèmes numériques propriétaires sapent ce principe. 

Construire des syndicats puissants pour dominer le bossware de l’IA.

Pour l’améliorer, plusieurs initiatives sont mobilisables, comme la formation en négociation sur la numérisation dispensée par le syndicat Public Service International ou encore le guide de la gouvernance des systèmes algorithmiques au travail du Why Not Lab, le cabinet de conseil de Colclough, qui permet aux syndicats d’adresser des questions aux directions sur les systèmes utilisés ou encore la clause du droit d’entrée numérique que les syndicats proposent d’introduire dans les conventions collectives, afin que les technologies utilisées par les employeurs soient mieux documentées. Les deux autrices défendent une gouvernance inclusive des systèmes avec ceux qui sont affectés par eux. Le Community and Public Sector Union australien qui représente les travailleurs qui gèrent le système de protection sociale a négocié avec succès un ensemble de clauses dans sa nouvelle convention collective pour permettre aux travailleurs sociaux de dénoncer des utilisations d’algorithmes contraire à l’éthique, afin qu’à l’avenir un scandale comme celui du robot-dette (un programme gouvernemental qui a envoyé des demandes de remboursement de dettes à plus de 400 000 bénéficiaires de prestations sociales) ne puisse plus être possible. Reste, rappellent les deux chercheuses et militantes, qu’aucun des progrès obtenus par des travailleurs n’a été obtenu facilement : tous sont le résultat d’une lutte soutenue, et celle-ci doit désormais se faire jusqu’aux outils numériques !

Un autre article sur la surveillance des lieux de travail, explique que celle-ci n’a plus du tout comme enjeu le déploiement de caméras de surveillance. La surveillance des cadences et des comportements est désormais l’objet d’innombrables dispositifs embarqués… La pandémie a favorisé l’essor de systèmes de surveillance, comme le montrait un rapport de Data & Society sur « le patron perpétuel ». Le rapport de Coworker sur le déploiement des « petites technologies de surveillance », mais omniprésentes (qu’on évoquait dans cet article) rappelait déjà que c’est un essaim de solutions qui se déversent désormais sur les employés. A l’image des outils de surveillance des postures comme StrongArm ou Modjul qui commencent à coloniser les entrepôts de Walmart et d’Amazon et qui transforment la question de la sécurité au travail en score que les employés doivent respecter. 

Le patron perpétuel, un rapport de Data & Society

Les conséquences sont diverses : augmentation de la discrimination, de la surveillance, atteintes à la vie privée et aux droits d’organisation collective, marchandisation des données, impossibilité de se déconnecter… « La surveillance n’est pas simplement une pratique commerciale invasive, mais un principe opérationnel visant à contrôler les travailleurs et à optimiser les profits ». 

Le Bossware : « une pratique commerciale déloyale »

Avec sa verve à nulle autre pareille, Cory Doctorow explique que les logiciels du patronat sont aussi défaillants que l’a été la gestion scientifique du travail inventée par « l’escroc » Frederic Taylor. Taylor a fait croire aux riches industriels qu’il pouvait augmenter la productivité des ouvriers en « transformant leur travail en une sorte de kabuki de l’obéissance ». Les employés n’étaient pas plus efficaces, mais avaient l’air plus obéissants, ironise-t-il, à la plus grande satisfaction de leurs patrons. Les employeurs ont pourtant bien remarqué que leurs revenus ne s’amélioraient pas avec le taylorisme, mais Taylor leur a fait croire que c’était parce que cette gestion scientifique n’était pas encore assez aboutie. « Plus ses conseils étaient mauvais, plus il y avait de raisons de le payer pour plus de conseils ». « Le taylorisme est une arnaque parfaite pour les riches et les puissants. Il alimente leurs préjugés et leur méfiance envers leurs employés, et leur confiance mal placée en leur propre capacité à comprendre le travail de leurs employés mieux que leurs employés. » 

Ce management scientifique du travail est désormais disponible sous formes d’innombrables applications, explique Doctorow. C’est ce qu’on appelle le « bossware », le matériel du patron. « Les travailleurs indépendants sont au cœur du bossware ». Alors que le travailleur indépendant rêve de devenir son propre patron, il est en fait totalement dépendant d’un téléphone qui le surveille et le discipline en continue. Et l’IA vient renouveler cette bulle du bossware, qui continue à venir convaincre les patrons que l’IA va pouvoir faire votre travail à votre place, comme il a été convaincu que la gestion scientifique du travail allait améliorer la productivité. 

Pour Alvaro Bedoya, commissaire à la Commission fédérale du travail américaine (FTC) qui s’intéresse à la protection des travailleurs, cette gestion algorithmique du travail devrait être considérée comme illégale, explique-t-il dans une stimulante défense. En moyenne, rappelle ce dernier, un employé d’un centre d’appels est soumis à au moins 5 formes de surveillance qui pèsent sur lui, le dénigrent et ne tolèrent aucune discussion. A savoir, une surveillance vidéo sous IA, une surveillance vocale sous IA qui prétend mesurer leur empathie, une IA qui chronomètre leurs appels, une autre qui analyse les sentiments durant l’appel et une dernière qui évalue la réussite des employés à atteindre des objectifs arbitraires. Bedoya estime que ces surveillances pourraient être qualifiées de pratiques commerciales déloyales… Prouver une pratique commerciale déloyale nécessite de démontrer qu’elle cause un « préjudice substantiel », qu’elle ne peut pas être « raisonnablement évitée » et qu’elle n’est pas corrigée par un « avantage compensatoire ». Dans son discours, Bedoya fait valoir que la gestion algorithmique du travail satisfait à ces trois critères… et que la FTC qui est chargée de réguler les pratiques commerciales déloyales devrait être capable d’agir. Par exemple, il est clair que l’augmentation des cadences que produit le bossware conduit à des préjudices sur la santé des employés. Que l’autoritarisme des applications de surveillance des chauffeurs-livreurs ne peut pas être évité. Enfin, elles ne proposent aucun avantage compensatoire, au contraire. La gestion algorithmique du travail produit surtout des sanctions arbitraires, comme quand les opérateurs de centres d’appels qui ont un accent, du Sud des Etats-Unis ou des Philippines, sont évalués négativement par les IA qui sont chargés de détecter leur émotion. « Les travailleurs devraient avoir le droit de savoir quelles données les concernant sont collectées, par qui elles sont partagées et comment elles sont utilisées. Nous devrions tous avoir ce droit. »

« Les gens riches peuvent rester irrationnels plus longtemps que vous ne pouvez rester solvables. Les marchés ne résoudront pas ce problème, mais le pouvoir des travailleurs le peut », conclut Doctorow.

Reste que démontrer l’arbitraire et pire encore l’absurdité des calculs reste extrêmement difficile. 

Dans un autre billet, l’infatigable Doctorow revient sur le travail d’un groupe de chercheurs et de hackers européens, Reversing Works (une division spécialisée du collectif AI Forensics, ex-Tracking Exposed), qui ont contribué à un travail d’ingénierie inversée sur l’application de livraison italienne Glovo/Foodinho, multicondamnée par les autorités italiennes pour atteinte à la vie privée. Dans un rapport publié par l’Institut syndical européen en novembre 2023, on apprenait que l’application démultipliait l’utilisation de données problématiques, surveillait les travailleurs au-delà de leurs heures de travail, utilisait un score de notation des travailleurs et envoyait d’innombrables informations confidentielles à des tiers. Pour Doctorow, ce mode d’enquête et de révélation présente un réel potentiel pour les organisations syndicales qui cherchent à protéger les travailleurs et promet également de développer des outils d’action directe qui permettent aux travailleurs de retrouver du pouvoir. « Ce n’est qu’en s’emparant des moyens de calcul que les travailleurs et les syndicats peuvent renverser la situation face au système de domination, à la fois en modifiant directement les conditions de leur emploi et en produisant les preuves nécessaires à ces démonstrations. Autant d’outils que les régulateurs pourraient également utiliser pour forcer les employeurs à rendre ces changements permanents. » Comme l’expliquait le collectif dans un communiqué, le RGPD est insuffisamment utilisé par les syndicats, notamment parce que « la vie privée est un droit individuel qui n’est pas considéré comme un outil de lutte des travailleurs », alors qu’il permet de contester nombre de pratiques déloyales. 

Reste que la production de « contre-données » – comme l’ont fait Reversing Works avec Glovo, le Worker Info Exchange ou le Stop-Club au Brésil ou encore Driver’s seat, une coopérative de chauffeurs qui aide les conducteurs à utiliser leurs données pour optimiser leurs revenus – n’est pas si simple. Le problème, bien sûr, c’est que ces collectes sont compliquées et fragiles à mettre en place et leurs résultats pas toujours assurés. En 2021 par exemple, des livreurs de Doordash avaient mis au point un outil pour observer les pourboires qu’ils recevaient sur l’application pour veiller à ce que l’entreprise ne les accapare pas… jusqu’à ce que l’entreprise ferme l’accès aux données. Sans compter que bien souvent, le législateur ne permet pas aux employés de produire des données en parallèle de celles de l’employeur. 

Pas plus qu’il n’oblige les entreprises au partage de données à leurs employés et à leurs représentants… Le problème, c’est que le RGPD en consacrant exclusivement un droit aux données personnelles a oublié d’armer le droit aux données collectives. C’est bien souvent au prétexte que les données mobilisées par les entreprises sont personnelles que les collectifs de travail et les syndicats ne peuvent y avoir accès, alors que leur traitement collectif, lui, est possible pour les entreprises. 

Limiter les cadences comme on lutte contre le morcellement des horaires

Autre piste d’action pour limiter la surveillance au travail : mettre des seuils aux cadences que la convergence des systèmes de surveillance numérique tentent d’optimiser ! La réponse consiste alors pour le régulateur à poser des limites aux cadences (à l’image d’une récente loi californienne et de la décision de la Cnil contre Amazon Logistic) tout comme il intervient parfois pour définir des limites aux morcellement horaires du travail en définissant par exemple des durées minimales de travail journalier. 

Reste que légiférer pour faire que les outils de contrôle du travail rendent des comptes est difficile, comme le montre l’échec de la loi new-yorkaise à imposer des audits aux outils d’embauches automatisés qui continuent à proposer peu de recours et de garantie aux chercheurs d’emplois (voir notre article sur la question, qui pointait les limites de la régulation des outils de recrutement automatisés). 

Autre risque : le caractère discrétionnaire et opaque des promotions et avantages, à l’image du titre de « Master » qu’Amazon attribue à certains travailleurs du Mechanical Turk selon un score de confiance confidentiel : une forme de plafond de verre algorithmique que dénonçait la chercheuse Lilly Irani. Même chose quand Amazon finalement note les travailleurs de ses entrepôts selon leur rapidité d’exécution ou leur taux d’erreur, sans prendre en compte les particularités de ses employés, indifférent aux situations, au genre, au handicap… ou au taux d’accident provoqué. Ajoutez à cela le fait que les données permettent de fixer des objectifs dynamiques, des performances changeantes et opaques… et vous avez un cocktail de paramètres opaques qui vient directement impacter et fragiliser le droit du travail. 

Il n’y aura pas de limites à la surveillance sans consacrer un droit d’accès aux données pour les travailleurs

Qui décide de la signification que les traitements produisent depuis les données ? Telles sont les questions que pose un intéressant travail sur la dataification du travailleur réalisé par la chercheuse Alexandra Mateescu pour Data & Society. La chercheuse y rappelle simplement que le management algorithmique ne peut pas remplacer les règles qui garantissent des droits équitables, comme le pointait déjà l’AI Now Institute. Quant à l’information des salariés sur la collecte et le traitement des données les concernant, elle est bien souvent insuffisante pour remédier aux problèmes. Le management algorithmique ne peut pas remplacer les droits des travailleurs, bien au contraire, il les sape. 

Pour dépasser ces problèmes, nombre de travailleurs tentent de s’organiser pour reprendre la main sur leurs données, explique Alexandra Mateescu. Mais ces tentatives nécessitent de leur part une organisation, une expertise et des moyens dont ils ne disposent pas toujours. 

Les syndicats sont néanmoins de plus en plus conscients de l’impact des données et tentent de plus en plus souvent d’inclure des dispositions relatives à celles-ci dans leurs négociations, comme le montrait la chercheuse Lisa Kresge dans un rapport pour le Labor Center de Berkeley. Une coalition de syndicats de services publics européens a mis en place un espace de ressource (en français) pour faciliter les négociations sur les enjeux numériques. Reste que la question des données et de leur accès demeure trop souvent secondaire dans les négociations syndicales. On le comprend. Mais il n’y aura pas de limites à la surveillance sans consacrer un droit d’accès et de traitement pour les travailleurs et leurs représentants. 

Hubert Guillaud

« Un algorithme ne peut pas déterminer une intentionnalité »

Dans le 3e épisode d’Algorithmique, l’excellent podcast de Next, la journaliste Mathilde Saliou s’entretient avec Valérie, la responsable des enjeux du numérique du collectif Changer de Cap. Celle-ci revient très clairement sur les relations problématiques entre les usagers et la CAF que l’association a fait remonter dès 2021 par le recueil de témoignages d’allocataires. A savoir, la démultiplication des interruptions de versement des droits du fait de contrôles automatisés et l’envolée des indus, notamment sur les aides au logements, où les personnes se voient obliger de rembourser des trop perçus sans explications de l’administration. En 2013 déjà, l’IGAS soulignait pourtant que 30% des indus n’étaient pas le fait des allocataires mais pouvaient provenir d’une erreur de réglementation ou d’erreurs de la CAF elle-même. 

Les allocataires ciblés par ce scoring sont souvent accusées de fraude, c’est-à-dire de fausse déclaration intentionnelle. Or, comme le rappelle Mathilde Saliou, pour une machine, la différence entre erreur et fraude est minime, les deux correspondent à des écarts par rapport au comportement normal. Pour les gens pourtant, la situation est très différente, surtout que quand l’accusation de fraude est déclenchée, la procédure de recours est plus complexe que lorsqu’on tente de faire corriger une erreur. « Lorsqu’il y a une accusation de fraude, on ne peut pas faire de recours amiable ni obtenir d’explication », explique la responsable numérique de Changer de Cap, qui rappelle que c’est la raison qui motive Changer de Cap à réclamer un droit aux explications algorithmiques. « On a repéré rapidement que les publics vulnérables étaient ciblés » ce qui impliquait un algorithme et un score de risque. Le score de risque amène à la démultiplication des contrôles, avec des allocataires qui peuvent subir plusieurs contrôles dans la même année. Quant au non-respect du reste à vivre que pratique la CAF, elle fait reposer sur les associations et les collectivités locales la précarité qu’elle renforce, celles-ci devant compenser l’interruption des droits que pratique la CAF. 

Pour les indus, la recherche d’indus ou les contrôles, les CAF peuvent remonter jusqu’à 2 ans en arrière et 5 ans en arrière en cas de suspicion de fraude. Les retenues sur les aides sociales pour que les gens remboursent les indus dépendent de barèmes qui peuvent ne pas laisser aux gens de quoi vivre, notamment quand elles portent sur des prestations vitales, ce qui est souvent le cas pour les plus précaires. « Une personne qui a 600 euros de RSA peut se retrouver avec 300 euros seulement si 300 euros sont retenus par les CAF. Il n’y a pas de respect du reste à vivre ». 

« Les documents obtenus par la Quadrature du Net ont permis d’apprendre qu’il y avait des variables qui font augmenter le score de risque, comme le fait d’être au RSA, d’être un parent isolé, de recevoir l’allocation adultes handicapés et avoir un petit boulot à côté. » Autant de caractéristiques discriminantes, comme l’ont mis également en avant le dossier réalisé par Le Monde et Lightouse Reports. Mais surtout, rappelle Changer de Cap, le qualificatif même de ces systèmes est faussé : « Nous on conteste l’idée que l’algorithme qui donne un score de risque fait des contrôles de fraudes, pour la simple et bonne raison qu’un algorithme ne peut pas déterminer une intentionnalité. Il calcule les aides attribuées par rapport aux aides auxquelles a droit l’allocataire. C’est un algorithme de recherche d’indus en réalité et non pas de recherche de fraude et qui traite le problème a posteriori, une fois que la somme a été versée ». 

La fraude aux prestations sociales par les usagers est très faible rappelle l’association (notamment par rapport aux fraudes aux cotisations sociales) qui juge cette surveillance des usagers disproportionnée par rapport aux montants collectés. Changer de Cap et d’autres associations comme la Quadrature du Net et la Ligue des droits de l’homme ont récemment attaqué l’algorithme de la CAF devant le Conseil d’Etat. Changer de Cap souhaiterait que les erreurs soient résolues avant de venir frapper les usagers, que les indus et suspensions soient expliqués et motivées. Mais surtout, l’association estime que nous devrions abandonner tout système de scoring, que les traitements soient transparents et subissent des contrôles de légalité, comme des mesures d’impact, mis à disposition de tous. 

L’épisode montre en tout cas très bien que le problème des algorithmes de scoring ne relève pas seulement des modalités de calcul, mais bien de ses agencements sociaux et légaux, comme les garanties et recours qu’il permet ou ne permet pas.

Vers le retour de la transparence des traitements ?

C’est apparemment une première qui servira certainement de modèle à de nombreuses collectivités. Le département d’Ile-et-Vilaine publie une liste de 91 traitements algorithmes qu’elle utilise ! Visiblement, le département est le premier à se conformer à la loi Pour une République numérique et à publier un registre dédié. 

Pour chaque traitement, la liste indique la finalité, le degré d’automatisation (de 1 à 3, c’est-à-dire de faible à fort), une indication de la maîtrise que la collectivité a du système, l’impact sur le public, le niveau d’explicabilité, le public concerné, les données concernées, le nombre de décision annuelles prises avec l’algorithme… Ce qui est très intéressant également, c’est de constater le large champ couvert par ces systèmes, allant de l’attribution d’ordinateurs aux personnels, à la voirie, au social, en passant par le logement social, la maintenance… On constatera que beaucoup de systèmes prennent très peu de décision par an.

Reste que pour l’instant les algorithmes eux-mêmes ne sont pas accessibles… ce qui ne permet pas leur inspection par les usagers, afin d’être sûr qu’ils font bien ce qu’on attend d’eux ! 

On espère que la publication de ce registre mette fin à la panne de l’ouverture des traitements que nous constations en début d’année.

Exemple d’une fiche du registre qui montre les différentes catégories de classement des traitements.

Mais qui décide de comment on compte  ?

Pas plus qu’il n’y a de données neutres, il n’y a de calculs neutres. Ce que l’on compte et comment on le compte est primordial. Et les différentes façons de compter que l’on peut convoquer imposent avec elles leurs idéologies. Un bon exemple nous est donné avec les discussions autour de la méthode de répartition des revenus du streaming musical. 

Longtemps, la règle de répartition est restée simple, « centrée sur le marché » (market centric), comme l’expliquait le journaliste Justin Delépine dans Alternatives Economiques. Les plateformes divisent le produit des abonnements et de la publicité par le nombre d’écoutes : les plus écoutés sont les plus rémunérés. Simple ! Mais est-ce équitable ? Cette façon de mesurer favorise l’écoute intensive telle que la pratique les plus jeunes notamment, mais qui n’est pas nécessairement le mode d’écoute de tous ceux qui payent un abonnement. Elle concentre les revenus au bénéfice des plus écoutés et au détriment de la diversité. D’où l’émergence d’une autre méthode de calcul, poussée notamment par des éditeurs indépendants, « centrée sur l’usager » (user centric). Ici, le mode de redistribution valorise ce qu’écoutent les abonnées dans leur diversité, les revenus ne sont plus distribués aux plus écoutés, mais selon ce qu’apprécie chaque abonné, permettant de rééquilibrer la distribution des revenus à d’autres genres de musiques et à une plus grande diversité d’artistes. Une autre modalité a été imaginée depuis, poussée par les majors : la méthode « centrée sur l’artiste » (artist centric) qui semble exclure de la rémunération les artistes émergents pour valoriser les artistes dont le public est le plus diversifié, ceux qui totalisent le plus d’abonnés uniques différents. 

Ces différentes conceptions de la répartition de la valeur ne sont pas sans incidences concrètes. Elles nous montrent que le mode de calcul de la valeur n’est pas unique, mais multiple. Chaque modèle proposé a des avantages et des inconvénients, des effets. Tout comme les données sont toujours situées, la manière dont on compte n’est jamais objective. 

Ce que montre également cet exemple, c’est que l’orientation du mode de calcul a un impact profond et que celui-ci est assez peu évalué et qu’il est loin d’être décidé démocratiquement. Le mode de calcul est pourtant un objet politique qui devrait être au cœur de la régulation politique des plateformes. L’acteur public devrait observer les différentes modalités de calcul possibles, leurs impacts, et imposer aux plateformes un mode de répartition de la valeur sur un autre. En France par exemple, qui promeut la diversité culturelle et le soutien aux artistes émergents, le régulateur devrait imposer aux plateformes sur notre territoire un modèle plutôt user centric, qui favorise une distribution plus équitable de la valeur. Ces constats pourraient être élargis bien au-delà des plateformes musicales d’ailleurs. Fort d’études d’impacts sur la répartition de valeur dans les plateformes, nous pourrions ainsi porter des modalités de calculs de la répartition qui permettent de valoriser la création et la diversité. 

Les intérêts des uns et des autres à imposer un mode de calcul sur un autre est ici primordial. Après avoir beaucoup soutenu le market centric, les majors soutiennent désormais le modèle artist centric et, du fait de leur poids économique, parviennent à l’imposer aux plateformes qui dépendent de l’offre de leurs catalogues (les catalogues des 3 majors représentent 65% des écoutes sur les plateformes pour seulement 22% des références). Trop souvent, le choix du mode de calcul s’impose par la force. 

Dernière chose à retirer de cet exemple. Les modalités de calcul ne sont jamais uniques. Pour chaque objet de calcul, nous devrions toujours envisager plusieurs modalités, regarder leur impact et décider en fonction de ceux-ci. Or, trop souvent, les calculs nous sont proposés sans alternatives. A l’heure où ils sont partout, l’enjeu est bien d’observer leurs conséquences et de proposer d’autres options. C’est dans les modalités de calcul désormais que se situe la politique. Quand en 2014 la CAF change la modalité de calcul de la prestation de service unique (PSU), le système de mesure de la subvention qu’elle distribue aux crèches, imposant un contrôle du remplissage à l’heure, elle modifie profondément le modèle économique de celles-ci. Ce qui pose une dernière question à notre enjeu. Si l’acteur public a vocation d’être l’arbitre des négociations entre acteurs aux intérêts divergents, comme ce pourrait être le cas dans la répartition de la valeur entre acteurs privés et intérêt général… Comment peut-il être l’arbitre de l’intérêt général quand il est juge et partie des calculs qu’il produit, comme c’est le cas dans le PSU ? 

Ce que nous racontent ces histoires, c’est que nous devons observer avec attention les transformations des modalités de calcul. C’est désormais là, dans les formules Excel qui agencent les données que se fait la politique. Le risque, c’est que les transformations du calcul s’imposent de plus en plus par la force plutôt que portées par un dialogue démocratique et politique. Qui décide de comment on compte est devenu l’enjeu central d’une société fondée sur les traitements. 

Modération automatisée : le double enjeu du contrôle démocratique et de la transparence

En septembre 2019, dans une tribune pour le toujours sémillant The Atlantic (@TheAtlantic), Daphne Keller (@daphnehk), directrice du programme de régulation des plateformes au Centre de cyber politique de Stanford (@stanfordcyber), expliquait que les entreprises internet n’avaient pas d’état d’âme à restreindre la liberté d’expression. Elle réagissait alors au lancement de la « Cour suprême » de Facebook – devenue depuis « Conseil de surveillance » (sur FB, @oversightboard). Pour Keller, il est normal que ces places publiques modernes se dotent de règles de fonctionnement, d’autant qu’elles ont pris une importance primordiale pour les utilisateurs. « Les personnes dont les messages sont retirés des principales plateformes disent qu’elles sont exclues des canaux de communication les plus importants de notre époque ». D’où l’importance à nous préoccuper des règles que ces entreprises appliquent à nos discours et nos comportements… que ce soit de savoir si PayPal peut virer les dons à Wikileaks, si Cloudflare doit protéger les sites néonazis ou si Facebook doit retirer la célèbre photo de Nick Ut d’une jeune fille nue brûlée au Napalm sur une route du Viêt Nam.

Les médias sociaux ne sont pas des gouvernements

« Mais les plateformes privées ne sont pas vraiment la place publique, et les sociétés Internet ne sont pas des gouvernements. C’est exactement pour cela qu’elles sont libres de faire ce que tant de gens semblent vouloir : mettre de côté les règles de libre expression du premier amendement [de la Constitution des États-Unis] en faveur de nouvelles règles plus restrictives ». L’existence de cours suprêmes « privées » et de conventions spécifiques permet d’imaginer que cette refonte sera régie par les mêmes contraintes que celles qu’ont connues les gouvernements du monde réel : des règles « constitutionnelles » pour protéger les droits individuels et établir des processus démocratiques pour établir les lois sous lesquelles nous vivons… Mais les plateformes n’ont fait écrire à leurs usagers aucune Constitution et ne sont soumises à aucun processus démocratique ni même à aucun devoir de séparation des pouvoirs ni à une quelconque représentativité de leurs usagers ! Leurs règles ne sont donc « constitutionnelles » que de nom !

Les principes de Santa Clara établissent des règles pour établir des niveaux minimums de responsabilité et de transparence des plateformes de modération

Des groupes de défense des utilisateurs ont demandé des droits similaires à ceux d’une « procédure régulière », comme un droit d’appel pour les personnes accusées d’avoir violées les règles des plateformes, comme on le trouve exprimé dans les principes de Santa Clara. D’autres demandent une transparence similaire à celle qu’on attendrait de législateurs, notamment pour mettre en lumière leurs interactions avec des lobbys ou leurs clients. Ces demandes sont positives et nécessaires, bien sûr, mais « il ne faut pas croire qu’imiter les systèmes gouvernementaux fera des plateformes des substituts aux gouvernements, soumis à des lois et des contraintes de pouvoir fondées sur des droits réels », prévient Daphne Keller. De fait, les plateformes sont plus à même de restreindre les libertés notamment parce qu’elles sont bien moins responsables de leurs choix que des représentants élus. Pour Keller, il nous faut mieux comprendre ces différences avant de demander aux plateformes de jouer un rôle plus important en tant qu’arbitres de la parole et de l’information, notamment parce qu’elles peuvent restreindre les discours avec plus d’efficacité que les gouvernements. Certes, elles n’emprisonnent pas les dissidents, mais elles peuvent les réduire au silence. Et notamment supprimer des publications licites, mais haineuses, harcelantes, trompeuses ou offensantes… bien plus rapidement que ne le ferait un procès. « L’absence de responsabilité démocratique ou constitutionnelle qui rend les plateformes si efficaces en tant que régulateurs de contenu les rend très difficiles à contraindre d’une autre manière ». Enfin, leurs « procédures » de contestation sont de très pâles reflets des originaux dont elles devraient s’inspirer.

Les membres de ce qu’on appelait encore la Cour suprême de Facebook ne sont pas chargés de faire respecter les droits des utilisateurs en vertu d’une Constitution ou des Droits de l’homme ou de tout autre instrument juridique, rappelle Keller. Leur travail ne consiste qu’à interpréter les règlements existants – et changeants – des plateformes. Le problème est que chaque fois que l’opinion s’indigne, les plateformes sont incitées à assumer davantage de pouvoir, que ce soit en accroissant la surveillance des utilisateurs ou l’interdiction de contenus licites… « Plus les plateformes s’arrogent ces pouvoirs, plus nous devons nous inquiéter du fait que nous ne contrôlerons pas réellement la manière dont elles les utiliseront ».

Dans ce contexte, les gouvernements ont du pouvoir : ce n’est pas un hasard si les grandes plateformes appliquent les normes européennes en matière de discours de haine dans le monde entier. Les annonceurs également ont du pouvoir : toutes les plateformes ont remanié des politiques en fonction de leurs indignations ou préconisations. Dans ce contexte, les utilisateurs sont bien souvent ceux qui ont le moins de pouvoir. « Si les plateformes n’ont pas de comptes à nous rendre, pourquoi les encourageons-nous à assumer un tel contrôle pratique sur notre discours ? »

À cause de la fuite en avant ! répond Daphne Keller. Le raisonnement est toujours le même : les plateformes ont déjà des règles et donc elles peuvent en avoir de meilleures. Le problème, c’est que ce raisonnement est à sens unique, explique la juriste. Il justifie le fait de demander aux plateformes d’en faire toujours plus, plutôt que de leur demander de revenir sur les changements qu’elles ont déjà effectués ! À l’image de la démultiplication des outils de détection automatique des contenus… lancés à l’origine pour lutter contre la pédopornographie (notamment PhotoDNA, que nous évoquions depuis notre lecture du livre de Tarleton Gillespie). Depuis, la prévalence de ces outils n’a cessé de s’étendre : pour identifier les « terroristes » (selon les propres définitions des plateformes) et pourraient demain s’étendre aux insultes à l’égard d’hommes politiques… L’expansion du rôle des filtres risque d’être sans fin et surtout sans point d’arrêt !

Les forces du marché sont censées contenir le pouvoir commercial privé. Lorsqu’elles ne suffisent pas, les démocraties usent plutôt du droit de la concurrence plutôt que de chercher à établir des règles gouvernementales pour les entreprises. Quand elles nuisent trop, les autorités les taxent pour financer des mesures correctives, comme elles le font à l’égard des entreprises qui polluent ou des fabricants de cigarettes. Les tribunaux peuvent également les obliger à prendre des mesures… Mais à l’égard des plateformes, nous ne suivons pas ce schéma où le gouvernement fixe les règles et les entreprises les suivent. Pire, souligne-t-elle : les plateformes peuvent bloquer des discours que les autorités n’ont pas le pouvoir de restreindre, ce qui peut plaire à nombre d’entre elles. Finalement, pour contourner les limites du droit, le risque est de donner plus de pouvoir aux plateformes, ce qui menace de renoncer à une réelle contribution démocratique qu’on pourrait leur demander : comme de mieux surveiller et publier les pressions qu’elles reçoivent des gouvernements.

Les entreprises privées remodèlent les normes d’expressions par à-coups, souvent brutalement, et non pas d’une manière progressive et prudente comme le ferait un tribunal ou un législateur. Le risque est que nous renoncions à des protections réellement constitutionnelles, elles, et à des aspects majeurs d’une ouverture démocratique de leur gouvernance.

Connaissez-vous le GIFCT, acteur majeur de la modération mondiale ?

Dans un article pour Slate, Chloe Hadavas (@hadavas) donne un exemple assez concret des lacunes démocratiques auxquelles ces plateformes nous confrontent. En 2017, Facebook, Microsoft, Twitter et YouTube ont créé une association – et une base de données -, le Global Internet Forum to Counter Terrorism (GIFCT, @GIFCT_official, Forum mondial de l’Internet pour la lutte contre le terrorisme) qui a pris en quelques années une importance majeure en matière de modération. Cette base de données pour coordonner la suppression de contenus relatifs à l’imagerie et la propagande terroriste violente produit une liste noire de contenus partagés entre les plateformes.

Page d'accueil du GIFCT

Le problème, c’est la grande opacité de son fonctionnement !, explique Hadavas. Aucune des décisions relatives au contenu n’est transparente et les chercheurs n’ont pas accès à cette base. Les règles que le consortium prend sont privées : il définit ce qui est et n’est pas un contenu terroriste, sans avoir à rendre des comptes, au risque de bloquer des reportages sur le terrorisme ou sur les violations des droits de l’homme. Le GIFCT ne force pas les plateformes à retirer les contenus qu’elle signale, mais c’est en réalité le cas, notamment parce qu’elles n’ont pas toujours les ressources suffisantes pour réévaluer les contenus que le GIFCT leur signale. Sous la pression de l’Appel de Christchurch, ce sommet politique entre gouvernements et entreprises pour lutter contre les contenus terroristes en ligne après la fusillade en Nouvelle-Zélande, le GIFCT a annoncé en 2019 qu’il allait remanier sa structure interne, notamment son comité consultatif indépendant en intégrant des représentants de plusieurs gouvernements (à savoir le Canada, la France, le Japon, le Kenya, la Nouvelle-Zélande, le Royaume-Uni et les États-Unis) pour le rendre plus responsable.

Le 30 juillet 2020 pourtant, le Center for Democracy and Technology (@CenDemTech) et 14 autres organisations de défense des droits de l’homme ont adressé une lettre à Nick Rasmussen, le directeur exécutif du GIFCT, s’inquiétant de son manque de transparence et de la participation déséquilibrée de certains gouvernements au Comité consultatif du GIFCT – au détriment d’autres ! Rappelant que les programmes de lutte contre le terrorisme et la surveillance ont violé les droits de certains pays et religions voire ont été utilisé par des gouvernements pour faire taire la société civile, les associations ont demandé à ce que « les limites entre la modération du contenu et le contre-terrorisme soient éclaircies ». Le risque est bien sûr que les plateformes décident demain de supprimer des données sous la pression de gouvernements pour imposer une censure qui ne serait pas légale autrement.

L’enjeu est de savoir comment tenir les décisions prises par le GIFCT comme responsables. Pour beaucoup, le consensus veut que le GIFCT serait plus digne de confiance s’il était plus transparent qu’il n’est. En juillet 2019 (puis en 2020), il a publié ses rapports de transparence en détaillant le fonctionnement d’un outil qui permet aux plateformes d’indiquer quand une image/vidéo/URL ne devrait pas figurer dans sa base de données. Mais c’est bien insuffisant, estime Daphne Keller, qui souhaite que des chercheurs puissent avoir accès à des copies du contenu réel bloqué par le GIFCT, pour mieux évaluer leurs biais et erreurs, ou offrir des possibilités de recours des utilisateurs lorsque leurs contenus sont bloqués par ce système. Enfin, d’autres réclament que le rôle du comité soit plus clair, notamment qu’il reste vraiment consultatif. Pour Keller, le GIFCT illustre combien la question de la responsabilité des plateformes s’avère glissante dans la pratique. Une poignée de plateformes ont créé des systèmes opaques et puissants qui appliquent des règles qui ne sont pas la loi pour contrôler les discours en ligne ! Le risque est bien que nous multiplions demain ce type de procédures et d’institutions spécifiques qui n’ont de compte à rendre à personne ! Et que ce qui n’est pas la loi devienne une norme…

Page d'accueil de l'Appel de Christchurch

Le conseil de surveillance de Facebook en ses limites

C’est en grande partie le risque que fait peser également le fameux conseil de surveillance de Facebook mis sous les projecteurs récemment pour sa décision très attendue sur l’éviction de Donald Trump. Le conseil de surveillance a donc décidé, début mai, de maintenir la « déplateformisation » de l’ancien Président, expliquait TechPolicy.press (@techpolicypress), mais en renvoyant l’entreprise à motiver et mieux délimiter la sanction. Le conseil de surveillance de Facebook a cependant approuvé les décisions prises par l’entreprise – même s’il a demandé des explications sur celles-ci. Le conseil a recommandé d’améliorer le recrutement de son personnel de modération notamment ceux spécialisés dans le traitement des utilisateurs influents, de clarifier la politique qui permet à certains utilisateurs d’échapper aux contraintes qui pèsent sur tous en raison de leurs statuts.

Pour Jordan Guiao (@jordanguiao), chercheur au Centre australien pour la technologie responsable (@CnrtResponsTech), dans une tribune pour TechPolicy, cette décision montre surtout les limites de l’exercice d’autorégulation. Pour lui, si Facebook est si incapable de traiter ces questions, c’est bien parce que sa plateforme n’a pas été conçue pour ça et que Facebook reste dominé par ses intérêts commerciaux. En Australie, le récent conflit entre Facebook et la presse a laissé des traces explique le chercheur, qui, comme Ethan Zuckerman ou Eli Pariser (que nous évoquions il y a peu), milite pour des réseaux sociaux de services publics. Plutôt que de perdre notre temps à réguler Facebook, nous devrions surtout prendre le temps de construire des solutions nouvelles et différentes. Comme le pointait le professeur de littérature Dennis Tenen (@dennistenen) sur The Reboot (@ProjectReboot) –repris et traduit par ,Mais où va le web ? -, la modération n’est pas universelle et nécessiterait d’être bien plus maîtrisée par la communauté et le contexte, selon les fins qu’elles poursuivent, plutôt que d’être conçue d’une manière totale et industrielle, qui impose un régime de modération sans nuance, sans discussion, sous forme d’un régime universel qui n’est ni transparent ni démocratique.

Page d'accueil du conseil de surveillance de Facebook

En février, le New Yorker est revenu en détail sur la construction du conseil de surveillance de Facebook dans un article qui en éclaire justement les limites. Son auteure, Kate Klonick (@klonick) a suivi son déploiement (avec l’autorisation de Facebook).

Au début, rappelle-t-elle, FB n’avait aucune idée sur la manière dont ce conseil devait fonctionner. Pour trouver des idées, elle a organisé des ateliers avec des experts du monde entier sous la supervision de Zoe Darme, à l’époque responsable de l’équipe gouvernance de FB, en donnant aux participants des cas concrets à modérer. Pour Klonick, ces exemples, dans leur ambivalence même, soulignaient combien l’incertitude et la difficulté à produire des règles claires était difficile, d’autant que les « intuitions » sur la liberté d’expression varient considérablement selon les clivages politiques et culturels. Au final, les opinions des experts se sont révélées assez contradictoires : dans un atelier à New York, 60 % des participants ont voté pour le rétablissement d’une image d’une femme souriante accompagnée d’une bulle où était inscrit « Tuez tous les hommes », en y voyant surtout de l’humour, alors qu’à Nairobi, seulement 40 % ont voté pour son rétablissement. Pour Zoe Darme, la raison tient peut-être plus à des questions de respect de l’État de droit : là où il est moins respecté, la liberté d’expression l’est moins également… Pas sûr que ce soit la seule explication…

« L’idée que FB, à l’instar d’une république naissante, ait besoin d’instituer des réformes démocratiques, aurait pu paraître saugrenue il y a 10 ans », explique Klonick. En 2009, FB avait lancé un référendum portant sur la modification de ses conditions d’utilisation où seul 0,32 % des utilisateurs avaient voté. L’entreprise promettait alors de donner plus de pouvoir à ses utilisateurs… Elle en est largement revenue. Alors que de plus en plus d’utilisateurs rejoignaient les plateformes de réseaux sociaux, les entreprises ont instauré de plus en plus de règles pour assainir le contenu et maintenir l’expérience qu’elles proposaient la plus agréable possible. Mais cela s’est complexifié à mesure que le nombre d’utilisateurs a progressé.

L'article de Kate Klonick pour le New Yorker

L’idée du conseil de surveillance est venue d’un professeur de droit de Harvard, Noah Feldman. Pour lui, les médias sociaux devaient créer des systèmes quasi juridiques, une sorte de « tribunal d’entreprise », afin de traiter les questions difficiles liées à la liberté d’expression. Zuckerberg a soutenu l’idée devant son conseil d’administration dubitatif et partagé, en expliquant qu’un conseil d’experts serait le mieux placé pour prendre les décisions difficiles auxquelles l’entreprise était de plus en plus confrontées. Il a lancé le projet. La charte du conseil de surveillance et ses règles de procédures, rédigées par des experts et employés de FB, ont, de réunion en réunion, été nettoyées de leur emphase juridique pour devenir plus accessibles. Les rouages de l’instance ont été mis en place : composée d’une vingtaine de membres, très bien payés, pour une quinzaine d’heures de présence par semaine. Une commission choisit les cas les plus représentatifs des 200 000 publications qui posent problème chaque jour et les soumet à une partie des membres réunis anonymement pour qu’ils statuent.

L’utilisateur incriminé doit déposer un mémoire écrit pour sa défense. Un représentant de l’entreprise dépose un argument pour expliciter la décision de l’entreprise. Le panel décide et FB exécute la décision prise. Actuellement, les utilisateurs peuvent faire appel en cas de suppression de leur publication (take-downs), mais pas quand elles sont laissées en place (keep-ups) – or un grand nombre de problèmes signalés sont bien souvent maintenus en ligne. Les utilisateurs ne peuvent pas non plus faire appel sur des questions comme la publicité politique, les algorithmes ou la déplateformisation de pages de groupes (mais FB a annoncé qu’il devrait permettre d’élargir l’appel des décisions par les utilisateurs)… Quant au conseil, il ne peut prendre des décisions que sur les affaires que lui renvoie FB, pas de sa propre initiative. Autre limite : les décisions du conseil ne deviennent pas une politique ! C’est-à-dire que si le conseil supprime ou rétabli un contenu, cela n’oblige pas FB a retirer ou maintenir les publications similaires (cela reste à la discrétion de l’entreprise). Enfin, les recommandations politiques du conseil ne sont que consultatives, ce qui en limite la portée, mais, malgré tout, entrouvre une fenêtre inédite de pression publique sur la politique de l’entreprise.

Klonick s’amuse également des discussions qui ont eu lieu pour choisir les membres de ce conseil de surveillance et notamment des innombrables pressions reçues. Dès les premières annonces, les controverses ont fleuri. En mai 2020, sa composition a été annoncée, déclenchant l’ire de certains, notamment du président Trump, sans que FB ne cède à ses pressions. Les détracteurs restent néanmoins nombreux. Pour la professeure de droit Julie Cohen (@julie17usc), ce panel de stars somptueusement rémunérées n’a aucun intérêt et ne peut se prononcer sur les problèmes les plus fondamentaux de FB. Pour Zuckerberg, FB va avoir besoin d’institutions et de surveillance supplémentaire. Créer des produits pour communiquer n’est pas le même travail que gouverner une communauté, expliquait-il directement à Klonick pour justifier de la création du conseil.

En avril 2020, les membres du conseil se sont réunis pour la première fois (sur Zoom !) et ont suivi une formation pour se connaître les uns les autres et sur les normes en matière de modération de FB. En octobre, FB a (entre)ouvert la possibilité d’appels (à 5 % des utilisateurs choisis aléatoirement). En novembre, le conseil a reçu ses premiers cas.

Un des cas traités était une photo d’église détruite en Azerbaïdjan par un utilisateur se plaignant de l’agression du pays à l’encontre des Arméniens. FB avait supprimé le post sous prétexte qu’invitait à la haine. Certains membres du conseil ont trouvé étrange d’appliquer cette règle dans le cas d’une publication se plaignant d’un groupe dominant en conflit avec un autre. Mais le conseil a finalement voté pour la suppression du message.

Dans un autre cas – une vidéo et un texte provenant de France se plaignant que le gouvernement avait refusé d’autoriser l’hydroxychloroquine contre le Covid-19 -, que FB avait supprimé pour ne pas promouvoir l’automédicamentation, les discussions ont été nourries. D’un côté des membres soulignaient que FB devait combattre la désinformation, de l’autre, des membres ont souligné que la publication prônait un changement de politique et donc relevait d’un risque de censure de discussions politiques. Le médicament n’étant pas en vente libre en France et ne pouvant donc pas promouvoir l’automédication, le conseil a finalement décidé de ne pas le censurer et de restaurer la publication.

Quelques semaines plus tard, alors que les protestations Black Lives Matter se répandaient dans le pays, Trump a publié sur FB et Twitter un message menaçant d’envoyer l’armée pour les maîtriser, précisant « quand les pillages commencent, les tirs commencent », une phrase dont la charge raciste est sans équivoque. Twitter a alors signalé à ses lecteurs que le tweet violait ses règles, mais pas FB. Zuckerberg a publié lui-même une déclaration expliquant qu’il ne partageait pas ces propos, mais que c’était aux gens de s’en rendre compte en soulignant dans une interview à Fox News que son entreprise ne pouvait pas être « l’arbitre de la vérité ». Des employés en colère ont organisé un débrayage virtuel face à cette inaction. Quelques jours plus tard, l’un des membres du conseil a suggéré une réunion du conseil au complet qui a débattu du sujet.

Plusieurs membres étaient choqués et souhaitaient publier une déclaration condamnant la décision de FB. D’autres étaient contre le fait de prendre une décision partisane. Après 2 heures de discussion, les membres ont décidé pourtant de ne pas s’exprimer sur cette question.

Face à Trump, comment Facebook s’est pris les pieds dans son opacité

Et puis il y a eu la contestation des résultats de l’élection et la prise d’assaut du Capitole. FB a supprimé deux publications de Trump le jour même. Et le lendemain des événements, Zuckerberg, sur son propre fil FB, a annoncé la suspension indéfinie du compte de Trump. Le lendemain, Twitter l’a banni à son tour. Cette « déplateformisation » comme on l’a appelé a bien sûr fait couler beaucoup d’encre. Certains s’en sont félicités, d’autres ont exprimé leur inquiétude du fait que FB avait fait taire un dirigeant démocratiquement élu. Pour le professeur de droit Eugene Volokh (blog), la cinquième entreprise des États-Unis, en situation de quasi-monopole sur son créneau, a restreint la liberté d’expression d’une personnalité politique auprès des trente millions de personnes qui le suivaient. C’est peut-être très bien… Mais ça reste un pouvoir immense, confiait-il à Klonick. Angela Merkel a qualifié cette suppression de problématique et Navalny, l’un des opposants de Poutine, a dénoncé une censure inacceptable.

En interne, seul FB avait le pouvoir de renvoyer la suspension de Trump devant le conseil de surveillance. Le conseil d’administration a plaidé pour que le conseil de surveillance examine le cas, afin de ne pas porter atteinte à sa jeune légitimité. Le lendemain de l’investiture de Joe Biden, FB a envoyé le dossier au conseil de surveillance. L’article de Klonick se terminait sur les attentes que représentait cette décision. Elles ont été douchées depuis.

Comme le raconte Klonick dans le Washington Post, le réseau social espérait s’en remettre à son instance d’appel, mais ce n’a pas été le cas. Si le conseil a confirmé la décision de bannir Trump, il a demandé que l’entreprise assume davantage la responsabilité de ses décisions. FB a dépensé 130 millions de dollars pour mettre en place ce conseil (pour assurer son fonctionnement pour une durée de 6 ans), rappelle Klonick.

Pendant des années, rappelle-t-elle, FB a maintenu des conditions exceptionnelles pour laisser Trump s’exprimer, alors qu’en regard de sa politique, il aurait dû être censuré depuis longtemps. « Lorsque vous accordez des exceptions aux personnes les plus puissantes du monde, elles abusent de leur pouvoir », alors qu’appliquer la même justice pour tous reste une des plus puissantes boussoles collectives qui soient. Le 6 janvier, ces petits accommodements ont finalement explosé au visage de l’entreprise.

Dans sa décision, le conseil rappelle finalement que FB n’a pas utilisé de règles claires, notamment parce que l’entreprise n’a cessé de les modifier à la volée, ce qui n’est pas conforme ni aux règles ni à l’équité. Il a expliqué que si FB voulait exclure Trump de façon permanente, c’était à l’entreprise de créer les règles pour cela. Le conseil rappelle que le manque de transparence de FB sur ses propres règles lui est préjudiciable et a demandé à l’entreprise de répondre sur la façon dont les décisions concernant les utilisateurs influents sont prises… Elle a aussi demandé à ce que FB éclaircisse comment ses algorithmes avaient amplifié les messages de Trump – mais pour l’instant, FB a refusé de répondre à cette question. Cette remarque est certainement la plus importante de l’avis, explique Klonick. « Si FB veut que le conseil de surveillance soit respecté comme tribunal indépendant, refuser de répondre à ses questions n’aidera pas ». Et souligne que l’enjeu principal à toute transparence demeure la question du calcul de la mise en visibilité et invisibilité des contenus.

Dans une longue interview pour The Verge, Klonick précise encore que le conseil rend des décisions anonymes à la majorité, mais éclaire dans ses notes le fait qu’il y ait des opinions divergentes. Elle rappelle à nouveau qu’une des limites du conseil c’est de rendre des décisions très étroites sur la suppression ou non d’un contenu qui ne s’élargissent pas à des contenus similaires, ce qui limite beaucoup sa portée. Le conseil a pourtant le droit de faire des recommandations de politique auxquels FB doit répondre dans les 30 jours pour préciser les raisons qui la conduise à les mettre en place ou pas. Pour le professeur de droit de Harvard, Mark Tushnet, cela reste une forme de contrôle de « forme faible », une pression de réputation surtout. Le conseil ne fait pas le droit. Il ressemble bien plus à un tribunal de première instance qu’à une Cour d’appel ou une Cour suprême !

L'interview de Klonick pour The Verge

Ce que souligne la décision malgré tout, c’est qu’une suspension permanente est de facto disproportionnée. Pour Klonick, FB semble effectivement avoir des « règles » différentes pour certaines personnes, mais nous n’avons « ni accès à la liste des personnes concernées, ni ne savons comment elle est gérée, ni bien sûr les exceptions aux règles dont elles bénéficient » – pour autant qu’il y ait vraiment des règles, il est probable, ajouterai-je qu’ils bénéficient surtout de modérateurs/appréciateurs de contenus dédiés par rapport au traitement massifié de tous les autres utilisateurs. En demandant à FB de s’expliquer, le conseil de surveillance a pleinement rempli son rôle.

Depuis, Facebook a fait de nouvelles annonces et enfin répondu au conseil de surveillance. Notamment en annonçant ramener le bannissement de Trump à 2 ans et en annonçant de nouvelles règles (avec des sanctions plus strictes, hiérarchisées et croissantes) pour les « personnalités publiques », explique FastCompany. Reste que la réponse de FB demeure floue : « Nous autorisons certains contenus dignes d’intérêt ou importants pour l’intérêt public à rester sur notre plateforme, même s’ils sont susceptibles de violer nos normes communautaires » et n’explique toujours pas qui sont les utilisateurs influents qu’il distingue du commun des mortels et qui vont continuer à recevoir un traitement particulier et accéléré pour mieux saisir leurs intentions et la réception de leurs propos. Comme le constate le chercheur Olivier Ertzscheid (@affordanceinfo2) dans une tribune pour Libération, c’est un revirement pour FB puisque désormais tout propos pourra être modéré… mais ce revirement date surtout des conséquences des décisions du 7 janvier, plus que de la réponse de FB. Pour autant, les personnalités publiques ne sont pas encore ramenées au rang de simples utilisateurs, et encore une fois, si tout propos peut-être modéré, il n’en sera pas de même si vous êtes riches et puissants que pauvre et malade !

En 2019, Klonick avait publié un article pour comprendre depuis quels critères FB pouvait définir un statut spécifique de personnalités publiques « dignes d’intérêt ». Mais « dignes d’intérêt pour qui ? » interrogeait-elle avec perspicacité. Ici, le conseil de surveillance rappelle soit que FB devrait supprimer ces exceptions soit être clair à leur sujet.

Pour Klonick, la suite des débats sera intéressante. Il est probable que le conseil s’oppose de plus en plus à FB, s’isole et finisse par s’éteindre à son terme. Mais, malgré ses innombrables limites et son pouvoir circonscrit, le conseil de surveillance de FB pourrait aussi montrer aux autorités qu’on pourrait exiger de toutes plateformes une instance de ce type – le Canada d’ailleurs envisagerait de rendre obligatoire la création de conseils de surveillance pour les plateformes de médias sociaux, avance-t-elle un peu rapidement dans l’interview, mais le projet de loi C-10 pour modifier la loi sur la radiodiffusion dont il semble être question n’avance pas ce type de propositions. Reste à savoir, suggère encore Klonick si le conseil de surveillance (de FB, mais qui ne le porte pas dans son nom officiel), va rester le conseil de surveillance de FB ou si finalement, comme l’induit son nom, il ne pourrait pas devenir une autorité pour toutes les plateformes… Twitter, qui ne s’est pas doté d’autorité de ce type, pourrait demain déverser également une somme équivalente dans la société indépendante créée par FB pour former son propre conseil… Pour Klonick, la diversité des politiques de modération des plateformes, leurs positionnements, leurs rôles et leurs différences algorithmiques sont certainement essentiels. Dans un scénario de fusion des conseils de surveillance, le risque est aussi que les normes soient partout les mêmes… Pire : l’idée qu’une entité unique contrôle demain la libre expression des États-Unis et du monde est certainement une perspective plus problématique qu’autre chose.

Et Klonick de rappeler que seulement 7 % des utilisateurs de FB sont américains ! FB impose des normes au monde entier alors que celles-ci sont décidées par une population qui n’y est même pas majoritaire ! Que FB décide de la nature de ses politiques, soit. Mais ce qui importe, c’est qu’elles soient justes, cohérentes, proportionnées, équitables. Or, les résultats injustes semblent plus la norme que l’exception, avance Klonick, qui explique que le taux d’erreur sur les décisions de modération de contenu serait de 80 % [en fait, ce chiffre semble issu d’un article d’analyse de la décision du conseil de surveillance par le Center for Democracy & Technology qui souligne que 25 contenus postés sur le compte de Trump ont été marqués comme contraires aux standards de FB, mais que suite à leur examen, seulement 5 d’entre eux ont été retenus comme contraires aux standards, ce qui révèle un taux d’erreur dans l’application des standards de 80% ! Et les auteurs de généraliser ce taux d’erreur aux décisions de retraits qui impactent tous les utilisateurs… – qui ne bénéficient pas du même traitement de vérification que les utilisateurs « dignes d’intérêt » – en rappelant d’ailleurs que FB, dans ses rapports de transparence, n’est pas très clair sur son taux d’erreur, ni sur le taux de contenus rétablis, NDT]. Dans son avis, souligne encore Klonick, le conseil de surveillance pointe le rôle du comité discret qui écrit, modifie et réécrit les règles de modération de FB à assumer son rôle politique. Pas sûr que ce soit pourtant la piste que poursuivra l’entreprise ! Jusqu’à présent, ces instances internes qui précisent et peaufinent les règles de modération, quand elles existent, ont toujours été éminemment discrètes et particulièrement protégées.

« Une plus grande modération des contenus ne signifie pas une meilleure modération »

Très concrètement, l’IA est toujours aussi nulle pour modérer les discours de haine, soulignait la Technology Review, depuis une étude (.pdf) qui a testé 4 systèmes distincts de modération en montrant que tous avaient du mal à distinguer les phrases toxiques des phrases inoffensives. Pour accomplir leur étude, les chercheurs ont mis au point 29 tests différents, afin de mieux déterminer où chaque système échoue, et ont distingué 18 types différents de discours de haine et 11 scénarios qui n’en relèvent pas et qui piègent souvent les systèmes automatisés (comme l’usage de jurons, la récupération d’insultes en contre-discours…), ainsi que des modèles spécifiques pour les groupes protégés par les lois contre la discrimination américaines. Pour chaque catégorie, ils ont créé des exemples modèles et une base de données, HateCheck. Ils ont ensuite testé des services commerciaux, comme Perspective de Google Jigsaw (utilisés par Reddit, le New York Times et le Wall Street Journal) ou SiftNinja de Two Hat. Leurs résultats soulignent la difficulté du curseur : « Modérez trop peu et vous ne parvenez pas à résoudre le problème ; modérez trop et vous pourriez censurer le type de langage que les groupes marginalisés utilisent pour s’autonomiser et se défendre ». Les catégories d’exemples produites devraient permettre d’améliorer les modèles, estiment cependant les producteurs d’outils testés.

Mais peut-être que la solution est à chercher non pas dans l’amélioration de la modération automatisée, mais dans l’amélioration des interfaces elles-mêmes ? C’est ce que montrent des chercheurs de l’université de Washington (voir l’étude) qui ont travaillé à trouver des idées de conception pour rendre les conflits sur Facebook plus « constructifs ». « Même si les espaces en ligne sont souvent décrits comme toxiques et polarisants, les gens souhaitent avoir des conversations difficiles en ligne », explique Amanda Baughan (@amanda_Baughan). Aujourd’hui, les désaccords produisent surtout des engueulades et se terminent bien souvent par des blocages ou suppressions mutuelles. Parmi les story-boards de propositions, les interfaces pourraient proposer de passer en conversation privée quand les propos s’enveniment – ce qui se passe assez souvent – ou encore de faire remonter les commentaires les plus constructifs (ce que les likes et les modalités d’affichages par importance, permettent souvent de faire déjà), ou encore d’ouvrir un écran d’alerte quand les réponses qu’on s’apprête à poster détectent des mots violents ou encore des modalités qui mettent les réponses en attente pour permettre à leurs auteurs d’y réfléchir, comme pour ralentir les conversations.

Pas sûr que ces solutions suffisent pourtant…

Dans Wired, la juriste Evelyn Douek (@evelyndouek) dresse un constat similaire : à mesure qu’elle s’étend, la modération à un coût. La modération de contenu est en train de dévorer les plateformes prévient-elle – peut-être un peu rapidement, vu les profits qu’elles engrangent. Les règlements et politiques à destination des utilisateurs explosent et se complexifient alors que les demandes de régulation par les pouvoirs publics se précisent et s’intensifient aussi. L’élection américaine et les urgences de santé publique ont poussé les mesures à une intensification inédite. Pour la chercheuse, l’époque où Facebook et Twitter se lavaient les mains des problèmes qu’ils généraient, en pensant que les internautes se gouverneraient eux-mêmes, est certainement loin derrière eux. Mais penser que l’on va résoudre tous les problèmes en effaçant chaque jour un peu plus de contenus des réseaux sociaux tient d’une réponse simpliste et inefficace à une question complexe. « Une plus grande modération des contenus ne signifie pas une meilleure modération ». Chaque étape nécessite des compromis et ce n’est pas parce qu’on les ignore qu’ils n’existent pas.

Illustration de l'article de Evelyn Douek pour Wired

Les plateformes ont agi assez rapidement pour répondre à la désinformation autour de la pandémie et plutôt efficacement estime la juriste, tant et si bien que beaucoup se demandent maintenant pourquoi elles ne sont pas plus efficaces pour combattre d’autres types de fausses informations. Mais pour elles, la désinformation sur le virus était différente, se justifient-elles, notamment parce qu’elles pouvaient se référer à des autorités claires, comme l’Organisation mondiale de la santé (OMS). Cette ligne claire n’a pas tenu longtemps pourtant et elles n’ont cessé d’étendre les garde-fous. Elles ont collé des étiquettes d’information un peu partout, sans qu’on puisse dire qu’elles aient été efficaces. Suite à la crise du Capitole, elles ont même censuré plus que jamais négationnistes et conspirationnistes… jusqu’au président des États-Unis lui-même.

Pourtant, pour beaucoup de commentateurs, les efforts des plateformes restent insuffisants. Les appels à la modération demeurent forts et réguliers et les législateurs n’ont pas cessé leurs menaces. À l’heure actuelle, il n’y a pratiquement pas un seul pays dans le monde qui ne prenne de mesure pour réglementer les médias sociaux d’une manière ou d’une autre. Et les plateformes ne cessent de préciser leurs règles, d’en produire de nouvelles et surtout de développer un empilement de boîtes de modération – et de spécifications pour leurs éboueurs du web – les unes sur les autres (pédocriminalité, terrorisme, nudité…). Reste que depuis que Trump a été réduit au silence et que nombre de complotistes ont été chassés ou sont partis ailleurs, l’angoisse s’est un peu calmée – à croire qu’une grande partie de l’angoisse tenait peut-être plus de la politique que des plateformes elles-mêmes, souligne Douek. Mais l’impressionnante démonstration de pouvoir qu’elles ont montré a laissé des traces. L’idée qu’il existerait une catégorie claire de « fausses informations » a également pris du plomb dans l’aile.

Distinguer le vrai du faux n'est pas si simple comme le montre ce photomontage de titres de presse à quelques mois d'intervallesLa semaine dernière par exemple, Facebook est revenu sur une de ses décisions et a déclaré qu’il ne supprimerait plus les publications affirmant que le Covid-19 est d’origine humaine ou fabriqué. Pourtant, il n’y pas si longtemps, le New York Times lui-même et toute la presse avec lui, citait cette théorie « sans fondement » comme une preuve que les médias sociaux avaient contribué à une « crise de la réalité ». Au début de la pandémie jusqu’en juin 2020, FB a interdit les publicités pour les masques, jusqu’à ce que l’OMS les recommande. Les médias sociaux semblent s’être surtout beaucoup adaptés à la fois à une science qui s’est faite en marchant et aux erreurs commises par les autorités, sans parvenir à délimiter les limites raisonnables du débat public.

Comme le rappelle la maxime, « la science n’est pas la vérité, mais sa recherche. Quand elle change d’opinion, elle ne nous ment pas. Elle nous dit qu’elle a appris davantage » (voir notamment nos articles : « Naviguer dans les ruines de la réalité consensuelle » et « Une pandémie de données ne soigne pas de la vérité »).

Enfin, les appels à toujours plus de mesures de répression ont également montré qu’elles pouvaient avoir des coûts géopolitiques forts, rappelle Douek. Les gouvernements autoritaires et répressifs ont pu faire référence à la rhétorique des démocraties libérales pour justifier leur propre censure, à l’image du gouvernement indien tentant de faire pression pour que les plateformes limitent les critiques sur sa gestion de la crise Covid au détriment de la liberté d’expression. Pour l’instant, les gouvernements occidentaux ont refusé de regarder ce problème, laissant les plateformes se débrouiller seules face à la montée de l’autoritarisme numérique des gouvernements illibéraux. Le problème, c’est que les plateformes sont en train de perdre ce combat, estime Douek, à l’image de la suspension de Twitter par les autorités nigérianes suite à la censure d’un tweet de leur président. On le voit, la régulation des plateformes ne peut pas conduire à « augmenter la censure ici et la réduire plus loin ».

Enfin, souligne Douek, il reste encore d’autres compromis à faire. « Comme la modération du contenu à très grande échelle ne sera jamais parfaite, la question est toujours de savoir de quel côté de la ligne il faut se tromper lorsqu’on applique des règles ». Le risque est bien sûr de multiplier les règles strictes et la sévérité de leur application notamment avec une modération de plus en plus automatisée. « Ces outils sont brutaux et stupides » : ils ne peuvent pas évaluer le contexte ou faire la différence entre un contenu glorifiant la violence ou enregistrant des preuves de violations des droits de l’homme, par exemple. Les conséquences de ce type d’approche ont été mises en évidence lors de la récente crise du conflit israélo-palestinien de ces dernières semaines, Facebook ayant supprimé à plusieurs reprises des contenus importants provenant de Palestiniens ou les concernant (voir notamment, l’analyse de Mathew Ingram pour la Columbia Journalism Review ou celle du Washington Post qui expliquent que les activistes palestiniens reçoivent le même traitement que les activistes Noirs américains : ils sont bloqués !). Ces cas ne sont pas isolés. Et ces différences de traitements ont toujours tendance à toucher de manière disproportionnée les communautés déjà marginalisées et vulnérables (comme le pointait le travail de la sociologue Jen Schradie).

Pour Douek, le retrait de contenu ne résout pas les problèmes sociaux et politiques sous-jacents, pas plus que la disparition des comptes de Trump n’a fait s’évaporer son emprise sur le parti républicain – même si le monde en ligne parle beaucoup moins de lui (selon une récente étude relayée par le New York Times cependant, depuis son éviction, certains de ses messages sont parvenus à recevoir beaucoup d’attention notamment parce que ses plus fervents partisans continuent de les diffuser, estime le Global Disinformation Index. Malgré ces relais, leur diffusion est tout de même moindre, soulignant en creux l’énorme pouvoir des sociétés de médias sociaux. Le bannissement de Trump ne résout pas la désinformation, mais perturbe ses réseaux et atténue l’influence des individus les plus nuisibles qui se sont réfugiés ailleurs. En tout cas, les réseaux ont retrouvé un certain calme et Trump ne façonne plus seul l’agenda politique de son pays et du monde.

Image d'illustration de l'article de The Atlantic sur le retour au calme des réseaux depuis le bannissement de Trump

À l’heure où beaucoup d’argent se déverse dans la création de plateformes alternatives, notamment extrêmistes ou complotistes, bien plus permissives, la censure automatisée des contenus des plateformes grands publics risque de s’avérer encore moins efficaces qu’elles ne l’ont été, surtout que ces « petits » réseaux risquent d’être beaucoup plus laxistes dans leur modération.

« Supprimer les contenus ne supprime pas la cause qui les a fait naître », conclut Douek. Il est tentant de penser que nous pouvons modérer la société, mais il va être bien plus difficile de résoudre les problèmes sociaux et politiques dont ils sont l’expression. Les plateformes ne seront jamais en mesure de compenser les défaillances de nos sociétés. Cela ne veut pas dire que les plateformes ne doivent pas continuer à réfléchir à la manière d’atténuer leurs effets néfastes, bien sûr. Toute expérimentation qui n’est pas binaire (laisser ou supprimer) notamment est bonne à prendre, par exemple le fait que Twitter incite ses utilisateurs à lire un article avant de le tweeter, ou le fait de limiter le nombre de fois où l’on peut transférer un contenu depuis une même plateforme (comme le propose WhatsApp). D’innombrables ajustements peuvent être tentés sans que les plateformes ne décident de la vérité à notre place.

Quelles transparences ? Quelles gouvernances ?

On l’a vu avec ces exemples, notamment celui du conseil de surveillance et des politiques de modération de FB comme dans le cas du GIFCT, les questions de transparence et de contrôle démocratique demeurent au cœur des enjeux de régulation de la modération. Reste à savoir comment organiser, très concrètement, le contrôle démocratique d’instances qui risquent de se démultiplier à l’avenir. Reste à savoir aussi de quelle transparence nous avons besoin.

C’est la question que posait Daphne Keller sur son blog. Alors qu’elle écrit depuis des années sur le sujet, elle reconnaissait, avec humilité qu’elle ne savait pas très bien quelle transparence elle appelait de ses vœux. Beaucoup de gens estiment que plus de transparence est un mieux, mais personne n’a une liste claire de ce qui devrait être transparent. « Quelles informations sont essentielles ? Lesquelles faut-il vraiment rendre transparentes ? Quels sont les compromis à faire ? » Cette imprécision est en passe de devenir un problème, alors que nombre d’autorités s’apprêtent à produire des exigences de transparence auprès des plateformes. Or, « ce que la loi n’exigera pas ne sera peut-être jamais plus rendu accessible », reconnait la juriste. Exiger une transparence totale n’est peut-être pas pleinement judicieux d’autant plus que cela a un coût, explique la juriste à la suite d’Evelyn Douek. « Des obligations de transparence très prescriptives pourraient également entraîner une normalisation et une homogénéité de facto des règles des plateformes, des pratiques de modération et des fonctionnalités. » Ce ne sont bien sûr pas des raisons d’y renoncer, mais de pointer que nous devons être plus précis sur ce que la transparence signifie vraiment et concrètement.

Keller a dressé une petite liste « préliminaire et très provisoire » des problèmes que posent les rapports de transparence existants. Pour la chercheuse, par exemple, il est essentiel de savoir avec une grande précision le nombre de demandes d’accès à des données qu’une plateforme reçoit des autorités, comment elle y répond, quel contrôle judiciaire elles produisent. Elle rappelle également que les chiffres ne sont pas tout. Pour comprendre les erreurs ou les préjugés des plateformes sur leurs propres données, il est nécessaire que les chercheurs indépendants puissent voir le contenu impliqué dans les décisions de retrait par exemple.

En 2009, nous nous interrogions avec Lawrence Lessig sur les limites de la transparence. Il nous disait déjà que la transparence nue n’était pas un remède magique. Pour ma part, il me semble que la transparence se rapproche des mêmes problématiques que celles que nous évoquions à propos de l’explicabilité. Plus qu’une liste d’éléments qui doivent être rendus transparents ou d’exigences précises, la transparence relève d’échelles, d’impacts et de multimodalités de niveaux de transparence. Devrons-nous demain définir des transparences « contrastables et actionnables », « sélectives, mais loyales », « techniques et/ou sociales »…, « jouables », selon des échelles allant de « fortes, faibles à inexistantes » ? La transparence nécessite d’être évaluée et appréciée dans toutes ses dimensions, comme une matrice qui permet de mesurer son étendue, sa profondeur et bien sûr ses effets. Ce qui est sûr, c’est que pas plus que les explications, la transparence n’est en rien réductible à une technique, à des listes, mais relève profondément d’un dialogue entre un système et la société. Plus que d’obligations, de droits et de devoirs (de checks-lists ou de systèmes d’évaluation d’impact), c’est bien ce dialogue qu’il va falloir nourrir pour parvenir à dépasser une vision bien trop binaire de la modération…

Dans un article de recherche, Evelyn Douek montrait d’ailleurs très bien que les plateformes ont une politique plus complexe que le mode binaire entre supprimer et laisser faire. Les plateformes ont mis en place nombre de mesures intermédiaires, allant de l’étiquetage à la vérification des faits en passant par les écrans d’avertissements… Des mesures qu’il faut certainement continuer à diversifier, mais dont il est nécessaire aussi d’évaluer les effets.

Pour cela, il est plus que jamais nécessaire qu’elles s’ouvrent aux contrôles indépendants et qu’on évalue leur transparence dans leur complexité, d’une manière dynamique. Pour le dire autrement, la transparence et la gouvernance, comme l’explicabilité, tiennent de pratiques qui doivent évoluer. Ce sont des objectifs vers lesquels les systèmes doivent tendre. Pour cela, il y a certes des modalités dynamiques (publications ouvertes, accès ouvert à la recherche, modalités de contribution des utilisateurs, ouverture de la gouvernance…) qui dépendent chacune d’échelles. Pour évaluer ces paramètres, nous aurions besoin d’une forme de « nutriscore » qui puisse informer de la qualité des explications, de la transparence, de la gouvernance… et qui permettrait de pointer un idéal auquel tendre !

Hubert Guillaud

PS : signalons les très intéressantes études de cas de modération du groupe de réflexion The Copia Institute (@copiainstitute) – découvertes au détour de nos lectures -, qui soulignent très bien par des exemples concrets la difficulté de la modération et montrent les compromis inhérents à toute décision.

❌