Il y a visiblement une profession qui déteste l’IA plus que toute autre, ce sont les assureurs chargés du traitement des sinistres, rapporte Wired. Ils sont les premiers à se plaindre de « dirigeants obsédés par l’IA qui l’imposent, à eux et à leurs clients ». C’est en tout cas ce qu’on apprend d’une étude de Glassdoor sur le ressenti des travailleurs face à l’IA qui a étudié les réflexions des employés sur l’IA issue des avis qu’ils laissent sur leur employeur sur le grand site participatif d’évaluation des environnements de travail. Tout secteur confondu, rapporte l’étude, les mentions de l’IA dans les avis Glassdoor ont augmenté de 240 % entre mai 2025 et mai 2026. Mais si par le passé, les avis mentionnant l’IA étaient majoritairement positifs (81 % d’avis positifs en 2019), cette tendance s’inverse : en 2026, on ne compte plus que 43 % d’avis positifs, 4 % d’avis mitigés et 53 % d’avis négatifs.
L’étude empirique de Glassdoor montre un renforcement de la tension sociale autour de l’IA. Hormis les dirigeants d’entreprises qui demeurent le groupe le plus favorable à l’IA, certains métiers adhèrent à ses avantages, comme les responsables des ventes et des produits, les recruteurs, les architectes logiciels ainsi que les analystes et ingénieurs de données. A l’inverse, d’autres professions y sont majoritairement hostiles, notamment les rédacteurs, les journalistes, les comptables, les agents de service client, les designers et professionnels de l’informatique. Mais les plus hostiles restent les gestionnaires de sinistres : 98 % de leurs commentaires étant négatifs.
Les femmes et la génération Z (nés entre 1997-2012) sont les plus critiques à l’égard de l’IA. Les travailleurs plus âgés ont tendance à avoir une opinion plus positive de l’IA, tandis que les plus jeunes sont plus critiques. Au sein de chaque génération, les hommes sont plus enclins à mentionner l’IA, et les femmes se montrent plus critiques que les hommes à son sujet. Chez les hommes de la génération X (nés entre 1960 et 1980), 50 % des commentaires sur l’IA sont positifs, alors que 42 % des commentaires des femmes de cette même génération sont négatifs. Les différences liées au poste occupé et au secteur d’activité expliquent entièrement cet écart. Les commentaires des hommes de la génération Y (milléniaux, nés entre 1980 et 1997) sont positifs à 44 %, contre 33 % pour les femmes. Les différences de poste et de secteur n’expliquent qu’un quart de cet écart. Les hommes de la génération Z affichent 42 % d’avis positifs, contre 21 % pour les femmes de la même génération ; ici, le poste et le secteur d’activité n’entrent pas en ligne de compte. Cet écart persiste même après ajustements statistiques.
Les commentaires sur l’IA reflètent des opinions tranchées Les mentions de l’IA apparaissent généralement dans des avis Glassdoor très positifs ou très négatifs, en particulier concernant la direction et les perspectives de l’entreprise. Seuls 23 % des auteurs d’avis critiques envers l’IA approuvent le PDG, et 18 % perçoivent des perspectives commerciales positives. À l’inverse, 86 % des auteurs d’avis positifs sur l’IA approuvent le PDG et 81 % envisagent des perspectives commerciales favorables. Les auteurs d’avis positifs sur l’IA sont plus attachés à leur entreprise Les employés ayant cité l’IA comme un point positif sont 47 % moins susceptibles de postuler à d’autres emplois sur Glassdoor. Ceux qui émettent des critiques sur l’IA postulent à d’autres emplois dans des proportions similaires aux employés ne mentionnant pas l’IA. Aucun secteur ni aucune taille d’entreprise ne recueille une majorité de commentaires positifs sur l’IA, mais certains affichent un taux de critique élevé. Les travailleurs du secteur technologique mentionnent l’IA 3,6 fois plus souvent que la moyenne. Les secteurs suivants en termes de fréquence sont les médias et la communication (1,8 fois) ainsi que la gestion et le conseil (1,1 fois le taux de référence). L’IA est la plus populaire dans le secteur juridique, bien que les avis y soient partagés à parts égales (50/50). D’autres secteurs se montrent extrêmement critiques à l’égard de l’IA, notamment les arts (89 % d’avis négatifs), les organisations à but non lucratif (85 %), les assurances (81 %), les télécommunications (80 %) et le transport/la logistique (79 %). Les petites entreprises (200 employés ou moins) ont tendance à susciter davantage de commentaires positifs sur l’IA (50 % d’avis positifs), un chiffre qui tombe à 33 % pour les entreprises de plus de 10 000 employés.
Bon, revenons à nos agents d’assurances. « Nous sommes épuisés par la quantité d’IA qu’on nous impose », témoigne l’un d’eux à Wired. En fait, la profession traverse une crise majeure. Le nombre de postes a baissé de 5% au cours de la dernière décennie et de plus de 21% entre mai 2025 et 2026, et les postes de débutants ont chuté de plus de 50% depuis 2025. Pour le bureau des statistiques du travail américain, cette chute serait liée au déploiement technique. « Des startups spécialisées, commeLiberateouPace, ont levé des millions de dollars en promettant de « réinventer » l’assurance, tandis que les assureurs ont intensifié le recours à l’IA pour traiter un volume croissant de dossiers. Concrètement, cela peut se traduire par un échange avec un chatbot plutôt qu’avec une personne physique pour déclarer un sinistre. Au lieu d’envoyer des agents inspecter une habitation endommagée, des outils d’IA peuvent analyser des photos ou des vidéos pour estimer le montant des indemnisations. L’IA peut également résumer des centaines de pages de dossiers médicaux afin d’en extraire les informations essentielles. Ou bien, l’outil d’IA d’un assureur pourrait traiter les informations transmises par un assuré – photos, vidéos, documents, reçus – puis effectuer un versement, le tout en quelques secondes », comme le propose Lemonade dont le chatbot traiterait 55% de l’ensemble des dossiers de sinistres, laissant à ses employés la gestion des dossiers les plus complexes. Mais les professionnels du secteur ont surtout l’impression d’être remplacés par des modèles d’IA… sans que les clients ne comprennent très bien que les conclusions d’une expertise (et ses erreurs) sont bien plus le fait de robots que d’experts.
Comme le résume l’historien Brian Merchant sur son blog qui s’est également intéressé à l’étude : « les personnes qui décrivent l’IA en termes très positifs occupent, pour la grande majorité, des postes de direction ; ce sont les cadres de niveau directeur ou supérieur qui manifestent le plus d’enthousiasme à son égard. Les responsables des ventes – en somme, les chefs d’équipe commerciale – se montraient également bien plus favorables que défavorables à l’IA, dans une proportion d’environ deux pour un. Les chefs de produit, les recruteurs et les ingénieurs logiciels affichent eux aussi un avis plutôt positif, avant que les opinions ne tendent vers un certain équilibre ». A l’inverse, remarque l’historien, si l’on observe les professions qui décrivent l’IA en termes très négatifs, on voit apparaître une toute autre configuration sociale. Merchant souligne que le basculement des avis négatifs a progressé et qu’il s’affirme à mesure que les entreprises adoptent massivement des solutions d’automatisation basées sur l’IA. Mais, il semble que « plus les travailleurs sont exposés à l’IA, moins ils l’apprécient ». Pour Merchant, « le ressenti vis-à-vis de l’IA au travail dépend probablement du pouvoir dont vous disposez au sein de l’entreprise ». Le rapport à l’IA est distribué selon le pouvoir dont on dispose sur ces outils. L’appréciation est directement liée à la position sociale qu’on occupe.
« Pour percevoir l’IA de manière positive, il faut avoir la main sur les décisions concernant son utilisation (ou non) et disposer d’une marge de manœuvre suffisante pour se sentir protégé contre le risque de remplacement, de surveillance ou de dégradation des conditions de travail ». Les cadres et les patrons ont bien peu de comptes à rendre quant à leur utilisation de l’IA. A l’inverse, les employés, eux, n’ont bien souvent aucune liberté dans leur rapport à l’IA. Pour Brian Merchant, la question de la responsabilité éclaire la différence de perception. C’est pourquoi les emplois d’employés sont bien plus en colère contre l’IA que les cadres. Cela explique que les comptables, les conseillers clientèles ou les informaticiens de base soient mis en difficulté par ces outils, car c’est sur eux que repose la tension de la vérification entre « le patron exige que toute l’entreprise utilise l’IA » et « la moindre erreur est de votre faute et vous en êtes responsable ». Entre ceux qui sont contraints et ceux qui restent libres. La tension entre ceux que ces outils assistent et libèrent et ceux que ces outils contrôlent et limitent, n’est pas tant une différence d’approche de l’IA, qu’une différence sociale entre le haut et le bas du déploiement de l’IA.
Pour le magazine canadien Maisonneuve, le journaliste Michael Rancic, qui fait partie de la coopérative de journalistes musicaux New Feeling, se désole de l’omniprésence de la musique générative partout. Mais si les plateformes de streaming sont déjà envahies des morceaux produits notamment via les outils proposés par Suno et Udio, les acteurs majeurs de la musique (stations de radio, organismes de réglementation et maison de disques), eux, tergiversent, hésitant entre intégrer ou au contraire à contrer la musique générative.
En octobre 2025, la Socan (Société canadienne des auteurs, compositeurs et éditeurs de musique) a annoncé avoir harmonisé sa position sur la génération de musique avec son homologue américain, l’Ascap (la société américaine des compositeurs, auteurs et éditeurs).
Désormais, « les auteurs-compositeurs peuvent enregistrer des chansons partiellement générées par l’IA pour percevoir des redevances ». Pour Rancic, c’est là un tournant : les œuvres créées avec l’aide de l’IA générative peuvent être intégrées aux systèmes existants de propriété et de rémunération. L’annonce précise soigneusement que, pour être éligible aux redevances, une chanson doit toujours comporter des « éléments de création humaine ». Cependant, elle légitime simultanément une technologie que beaucoup perçoivent comme une menace pour le savoir-faire musical humain.
Or, rappelle Rancic, Suno a reconnu avoir entraîné son modèle depuis toute la musique enregistrée disponible. L’entreprise n’avait aucune autorisation pour ce faire et n’a offert aux artistes aucun moyen de retirer leurs œuvres, qu’elles soient protégées ou non par le droit d’auteur. Des plateformes comme Suno absorbent ainsi des décennies de travail humain et produisent des imitations convaincantes en quelques secondes. Entraînée sur des milliers d’œuvres protégées par le droit d’auteur, la production est alors considérée comme une « nouvelle » chanson. Durant leurs premières années d’activité, Suno et Udio ont également mis en place des cadres propriétaires autour de ces nouvelles chansons : celles-ci peuvent être immédiatement acquises par quiconque saisit l’instruction de génération. Ce contournement des droits d’auteur a, à juste titre, suscité l’inquiétude des artistes.
Premièrement, il a permis aux entreprises d’IA de tirer profit d’œuvres pour lesquelles elles n’avaient pas nécessairement acquis de licence. Deuxièmement, il permet aux utilisateurs de générer des quantités massives de musique sans rémunérer les artistes – un système qui pourrait entraîner la perte de revenus pour de nombreux musiciens. Une lettre ouverte de 2024, signée par des artistes tels que Billie Eilish, Chappell Roan et Arkells, qualifiait l’entraînement d’IA sur de la musique sans compensation d’« atteinte à la créativité humaine ».
Ces tensions ne sont pas propres à la musique. Les artistes visuels ont exprimé des préoccupations quasi identiques concernant les générateurs d’images entraînés sur leurs œuvres, tandis que les cinéastes et les acteurs ont commencé à se confronter aux outils d’IA capables de reproduire des voix, des textes et même des images.
En annonçant les nouvelles lignes directrices sur les redevances, la Socan a décrit l’IA comme un outil précieux largement adopté par les musiciens. Dans le même temps, la déclaration critique le fonctionnement actuel de cet outil censément utile : « l’utilisation par les entreprises de technologies d’IA de modèles basés sur des œuvres musicales protégées par le droit d’auteur, sans autorisation, compensation ni mention des créateurs, ne relève pas de l’usage loyal, mais du vol ». La Socan a réitéré ce point de vue lors d’une récente campagne publique, appelant le gouvernement fédéral à « dire non à l’entraînement de l’IA sur de la musique sans licence ». Mais si la Socan le croit vraiment, pourquoi autoriser la perception de redevances sur des œuvres produites à l’aide de telles plateformes ?
Les lignes directrices de la Socan concernant l’enregistrement de l’IA font la distinction entre les « productions générées par l’IA », qui ne sont pas admissibles à l’enregistrement, et les « œuvres assistées par l’IA ». Or, les déclarants n’ont pas à divulguer l’utilisation de l’IA dans leurs œuvres assistées par l’IA, ce qui signifie que la Socan fait preuve d’une grande confiance, explique Michael Rancic. Déterminer si une chanson a été partiellement ou entièrement créée avec l’IA semble reposer sur une simple intuition. Seule compte une directive vague selon laquelle « la créativité de l’auteur humain doit être centrale ». Il serait envisageable de déposer une chanson avec des voix humaines sur une musique instrumentale générée par IA – entraînée sur les meilleurs rythmes jamais créés – et de satisfaire ainsi aux exigences minimales fixées. Si certains défenseurs font la distinction entre la musique utilisant simplement des composants d’IA et celle entièrement produite par IA, cette frontière est de plus en plus difficile à maintenir. En pratique, les deux reposent souvent sur les mêmes infrastructures d’entraînement et l’extraction de données à partir d’enregistrements humains, ce qui rend la distinction moins pertinente qu’il n’y paraît et pourrait même contribuer à redorer l’image de la génération par IA.
Bien que toutes les plateformes de musique générée par IA ne soient pas entraînées sur de la musique sans licence, la nouvelle réglementation n’identifie aucun mécanisme permettant de distinguer la musique générée par IA utilisant ou non des chansons sans licence, et crée un précédent en faveur de l’adoption de cette technologie. Parallèlement, la déclaration souligne l’importance de soutenir les artistes et de favoriser la créativité. « L’avenir de la musique peut intégrer l’IA tout en restant profondément humain », affirme Jennifer Brown, PDG de la Socan. Ce cadre confère de fait la propriété intellectuelle aux utilisateurs d’IA générative et fragilise les structures de propriété antérieures, censées protéger les artistes. Il révèle une asymétrie dans le traitement de la paternité, du travail et des risques au sein de l’industrie musicale. «Les associations musicales s’empressent d’adopter les nouvelles technologies et plateformes, tout en les critiquant, reflétant une tendance générale du secteur à privilégier les plateformes au détriment des artistes ».
Alors que des organismes comme la Socan acceptent la musique générée par l’IA, les acteurs gouvernementaux et industriels élaborent leurs propres approches. Le gouvernement fédéral canadien consulte actuellement les intervenants du secteur, notamment la Socan, sur l’interaction entre l’IA générative et le droit d’auteur. Ces consultations, menées auprès du Groupe de travail sur la stratégie en matière d’IA du gouvernement et du Comité permanent du patrimoine canadien, visent à éclairer l’élaboration de la stratégie canadienne en matière d’IA pour les années à venir. Malgré la croissance rapide de l’IA générative, le Canada ne dispose actuellement d’aucune loi spécifiquement conçue pour traiter de ses implications en matière de droit d’auteur et de droits des créateurs. Toutes les questions relatives au droit d’auteur relèvent de la Loi sur le droit d’auteur. Actuellement, la Loi sur le droit d’auteur limite l’« utilisation équitable » à des fins spécifiques comme la recherche, la critique, l’éducation ou la parodie. Autrement dit, il est légal d’utiliser des œuvres protégées par le droit d’auteur sans autorisation à ces fins et dans certains contextes. Ces fins n’incluent pas explicitement les entreprises d’IA qui entraînent leurs modèles sur de la musique sans autorisation. « Dans ce contexte, la décision de la Socan d’intégrer la musique générée par l’IA à son système de redevances, avant même que le Canada n’ait établi si cette technologie est conforme à la loi sur le droit d’auteur, revient à mettre la charrue avant les bœufs ».
Il est paradoxal de voir les organisations de l’industrie s’empresser de créer des voies d’accès pour l’IA, explique Michael Rancic. « Prenons l’exemple des plateformes musicales. Lorsque de nouvelles technologies ont bouleversé les normes créatives par le passé, l’industrie n’a pas hésité à intervenir pour protéger les titulaires de droits et sanctionner ceux qui opéraient en dehors du cadre établi. Le sampling (ou échantillonnage), par exemple, a suscité des décennies de litiges, d’accords de licence stricts et une dynamique inéquitable où la charge du risque juridique lié à l’autorisation des échantillons incombait à celui qui les utilisait. Dans les années 1980 et 1990, les différends canadiens liés au sampling ont été largement influencés par les grandes maisons de disques et les titulaires de droits américains. John Oswald, pionnier de l’approche de collage musical par échantillonnage baptisée « plunderphonics », a ressenti le poids et l’influence de la Canadian Recording Industry Association (CRIA, aujourd’hui Music Canada). L’œuvre d’Oswald transformait des tubes classés en tête des palmarès en mosaïques sonores abstraites, métamorphosant le familier en quelque chose d’étrange et d’insolite – une prouesse alliant virtuosité technique et créativité. La CRIA a agi pour le compte des majors américaines en adressant à Oswald une mise en demeure, obtenant finalement la destruction de son œuvre. »
Le régime actuel du droit d’auteur favorise les artistes établis représentés par de grandes maisons de disques, ces dernières disposant des ressources nécessaires pour identifier les titulaires de droits, négocier les licences et régler les frais initiaux éventuels, rappelle Michael Rancic. « Ce système opaque et bureaucratique pénalise lourdement les artistes émergents : il rend risquée l’utilisation transparente d’échantillons et les empêche souvent de détenir légalement les droits sur leurs œuvres – et donc d’en tirer profit. Une chanson contenant un seul échantillon non autorisé ne peut être enregistrée pour percevoir des redevances ; en revanche, une chanson créée par des plateformes entraînées sur une quantité colossale de musique non autorisée semble, elle, échapper à ces contraintes. »
« Les structures du droit d’auteur dans l’industrie musicale sont conçues pour servir ses membres les plus puissants »(voir notre article, « Mais qui décide de comment on compte ? », qui prenait justement l’exemple des Majors de la musique). « Les nouvelles technologies contribuent à perpétuer ce mécanisme :il est révélateur, par exemple, qu’avant même de pouvoir générer de la musique, les outils d’IA aient été utilisés par l’industrie pour surveiller les violations du droit d’auteur ». Spotify a acquis The Echo Nest en 2014 après que cette entreprise a mis au point une technologie d’empreinte acoustique (audio fingerprinting), capable d’analyser les caractéristiques sonores uniques d’un enregistrement pour les convertir en une signature numérique compacte. Concrètement, cette technologie permet aux plateformes de reconnaître les chansons dès leur mise en ligne et d’empêcher la diffusion de copies non autorisées. Aujourd’hui, les plateformes de streaming utilisent des technologies similaires – telles que des « filtres anti-spam musical » – pour identifier la musique générée par IA et les violations potentielles du droit d’auteur. Ces outils sont présentés comme une réponse aux violations du droit d’auteur liées à la génération de musique par IA, alors même qu’ils reposent eux aussi sur cette technologie, explique Rancic. Lorsque l’IA est à la fois le problème et la solution, il semble qu’il n’y ait plus vraiment de choix.
« Le déploiement rapide, au cours de la dernière décennie, d’outils de protection des droits basés sur l’IA témoigne de la priorité accordée de longue date à la préservation de la propriété intellectuelle et des redevances associées. Pourtant, lorsque ces mêmes technologies sous-jacentes permettent la production automatisée de musique, la réaction du secteur se fait nettement plus permissive, voire complaisante. » Au départ, l’industrie a semblé céder à la panique face à l’émergence de la musique générée par IA, les grandes maisons de disques intentant des procès aux entreprises technologiques à l’origine de ces outils. Aujourd’hui, certains de ces mêmes acteurs cherchent activement à collaborer avec ces entreprises. Warner Music Group a récemment trouvé un terrain d’entente avec Suno et Udio concernant les méthodes d’entraînement de leurs modèles d’IA, et Universal Music Group a également conclu un accord avec Udio, sans que les détails financiers et une grande partie des clauses contractuelles de ces accords ne soient ni publics ni transparents, rappelle le journaliste. « Ce que l’on sait, en revanche, c’est que ces accords s’accompagnent de l’annonce d’un partenariat entre Warner, Universal et Udio visant à créer une nouvelle plateforme de génération de musique par IA. Les accords conclus par Udio avec ces deux labels, tout comme celui passé entre Warner et Suno, prévoiraient des mécanismes permettant aux artistes de choisir si leur musique peut ou non servir à l’entraînement des modèles d’IA. Udio et Suno promettent tous deux d’abandonner progressivement les modèles actuels de leurs plateformes – entraînés à partir de musiques non autorisées -, bien que ces modèles soient toujours en service à l’heure où nous écrivons ces lignes. »
Cette attitude permissive de l’industrie face au vol de contenu par les plateformes devient plus compréhensible si l’on reconsidère la véritable finalité de la génération de musique par IA, explique Rancic. Le discours marketing d’Udio affirme que l’entreprise « développe des outils d’IA pour permettre à la prochaine génération de créateurs musicaux d’émerger », tout en soulignant sa capacité à « élargir les horizons musicaux et à permettre à chacun de créer une musique extraordinaire ». Cette présentation de l’IA comme un outil de création se retrouve dans les déclarations de la Socan ainsi que dans des articles du secteur vantant les innombrables possibilités offertes par la musique générée par IA ; comme de générer « des genres musicaux nouveaux ». « Mais tout cela relève de la communication. La véritable proposition de valeur des plateformes de musique générative ne réside ni dans l’innovation esthétique, ni dans un meilleur accès aux outils musicaux, ni même dans l’enrichissement de la création. Elle consiste avant tout à produire des contenus sonores dont on peut immédiatement s’approprier les droits. » Avant les poursuites engagées à leur encontre par les grandes maisons de disques, Suno et Udio permettaient toutes deux aux utilisateurs de télécharger et, de fait, de s’approprier les morceaux générés par l’IA. Dans le cadre de son accord à l’amiable, Udio ne permet plus aux utilisateurs de télécharger et de posséder des chansons générées par IA. Tandis que Suno impose désormais aux utilisateurs de payer pour télécharger les morceaux créés sur sa plateforme. Le nouvel abonnement « Pro » de Suno promet aux utilisateurs la possibilité de générer jusqu’à 500 chansons par mois et l’octroi immédiat des « droits d’utilisation commerciale pour les nouvelles créations ».
« Vous n’avez pas les moyens d’obtenir les droits d’utilisation d’un sample d’artistes Warner comme Neil Young ou Ed Sheeran ? Aucun souci. Vous pouvez désormais créer une chanson dans le style de ces artistes. Vous en devenez immédiatement propriétaire, vous pouvez l’échantillonner à volonté et, grâce à l’annonce de la Socan, vous pouvez même percevoir des droits d’auteur, à condition d’avoir écrit les paroles. Ce nouveau modèle contourne complètement les structures de droits d’auteur et de propriété de l’industrie musicale, le tout dans le but de générer de la valeur pour les investisseurs du secteur technologique (et, grâce à leurs accords, les maisons de disques s’assurent toutefois de conserver leur part du gâteau). Il est franchement lassant de voir ce cycle se répéter sans cesse et de constater que ceux qui, dans l’industrie, ont le pouvoir d’influencer le changement, traitent ces évolutions comme s’il s’agissait de nouveautés – une énième technologie présentée comme un outil de démocratisation de la musique, alors qu’elle sert surtout à consolider leur pouvoir et à s’approprier le travail d’autrui. »
L’abonnement « Pro » offrant « 500 chansons par mois » fait qu’il est difficile de voir Suno autrement que comme un outil de production de masse de musique sous licence pour la publicité, la télévision, les réseaux sociaux et les espaces publics. Cette stratégie est tout à fait logique étant donné la financiarisation croissante de l’industrie, où la propriété des compositions est devenue primordiale. Posséder les droits sur la composition d’une chanson – non seulement l’enregistrement sonore, que l’industrie a toujours exploité, mais aussi la musique et les paroles – est devenu un bien précieux. Des musiciens canadiens comme Young et Justin Bieber ont vendu les droits d’une part importante de leur catalogue. «L’argent dans l’industrie musicale provient désormais des contrats de licence, et non plus des ventes de disques, et les chansons constituent un actif financier », rappelle pertinemment le journaliste. « Grâce à l’IA, les grandes maisons de disques peuvent exploiter davantage ces actifs pour créer de la musique à l’image de leurs artistes sans nécessairement leur verser de royalties ». Un phénomène qui se manifeste dans l’ensemble des industries créatives, à l’image du monde des acteurs et des scénaristes… « Si l’industrie musicale s’est d’abord montrée méfiante face à la menace que représente l’IA pour le droit d’auteur, elle a désormais compris qu’elle pouvait intégrer cette technologie à ce système à son propre avantage ». Au final, tout cela se traduit par moins de travail et probablement une baisse des revenus pour les artistes.
La question n’est plus de savoir si l’IA va transformer la musique, mais dans quelles conditions cette transformation aura lieu.« Des décisions comme celle de la Socan, et les récents accords conclus entre les grandes maisons de disques et les principales entreprises de musique générée par IA, laissent penser que l’industrie se prépare à intégrer les systèmes génératifs avant même d’avoir mis en place des garde-fous capables de protéger les créateurs que ces systèmes exploitent. Les nouvelles politiques de la Socan, et leur exclusion des œuvres entièrement générées par IA, pourraient constituer les prémices de tels garde-fous, mais leur portée reste floue et leur application encore plus complexe. En l’absence de normes contraignantes concernant les données d’entraînement, le consentement et la rémunération, la normalisation de la paternité assistée par IA risque de consolider les inégalités plutôt que de les résoudre. Les cadres émergents permettent aux plus influents de tirer profit de la musique générée par IA, tandis que les artistes moins connus, dont le travail a été volé, sont exploités de manière perpétuelle à chaque utilisation de ces plateformes. »
« Bien que je ne partage pas leur analyse selon laquelle les craintes suscitées par l’IA sont comparables à celles qui ont accompagné l’apparition des synthétiseurs et des boîtes à rythmes, Gordon A. Gow et Brian Fauteux proposent une idée pertinente pour un cadre potentiel encadrant l’IA », explique encore Rancic. S’appuyant sur le précédent du système de classification canadien MAPL – un label apposé sur la musique canadienne indiquant qu’elle répond à un certain niveau de contribution canadienne -, ils proposent d’étiqueter les chansons générées par l’IA. Des labels physiques et numériques pour l’IA pourraient à tout le moins favoriser la transparence et permettre aux consommateurs de faire des choix éclairés, souligne le journaliste pour qui « la transparence est essentielle et doit guider tout cadre réglementaire futur ». « Les plateformes d’IA générative doivent divulguer leurs sources de données d’entraînement et fournir une documentation sur leurs modèles d’IA (taille de l’ensemble de données, répartition par genre et méthodologie). »
Certains de ces changements sont en cours : Suno a annoncé en 2025 qu’elle abandonnerait ses modèles d’IA actuels et les remplacerait par de nouveaux modèles « plus avancés », entraînés exclusivement sur des données autorisées, dans le cadre de son accord avec Warner. Toutefois, on peut soutenir que les plateformes ayant bâti leur valeur grâce à de la musique non autorisée devraient être explicitement exclues de tout cadre réglementaire régissant la musique générée par IA. Les récompenser aujourd’hui ne ferait qu’encourager, à l’avenir, ces mêmes modèles fondés sur le principe « construire d’abord, demander ensuite ».
« L’IA générative menace de déstabiliser non seulement les revenus des artistes, mais aussi le lien conceptuel entre la créativité et les créateurs eux-mêmes ». Contrairement au sampling ou à l’imitation – pratiques ancrées dans des choix guidés par un dialogue artistique et une longue tradition de la citation musicale -, « l’IA générative évince totalement le créateur ». Il ne s’agit pas d’un outil de création retravaillant ou répondant à une œuvre existante, mais d’un processus qui dépossède les artistes de leur propre travail. « Si les accords conclus entre les grandes maisons de disques et les plateformes d’IA peuvent sembler positifs pour les artistes, il convient de rappeler qu’ils sont conçus dans l’intérêt des dirigeants et des actionnaires, et non nécessairement de celui des artistes et musiciens ; ces derniers risquent de subir des pressions pour s’intégrer à ces nouveaux systèmes d’IA, alors même que leurs opportunités s’amenuisent face à la production de masse de chansons ».
« Si les décideurs politiques n’agissent pas avec détermination, les artistes pourraient se retrouver confrontés à un avenir où prospèrent des structures de propriété prédatrices et des plateformes dominantes, tandis que la pratique musicale humaine deviendrait de plus en plus précaire au sein des systèmes qui reposent pourtant sur elle. Il n’en résulterait pas nécessairement le silence, mais une profusion de musique à la tonalité étrangement anonyme : un flux ininterrompu de chansons aux styles familiers, générées pour imiter des artistes et des genres populaires, mais déconnectées des communautés et des relations qui les avaient fait naître. Dans ce scénario, la musique de demain se caractériserait par une présence sonore constante doublée d’une absence croissante d’auteur identifiable. »
On avait déjà souligné les grandes limites de la synthèse automatisée. Un organisme de surveillance du service national de santé (NHS) britannique, Healthwatch England, met en garde : les assistants de transcription par IA – qui écoutent et transcrivent les consultations médicales – utilisés par de plus en plus de docteurs, se trompent sur les noms de médicaments et les diagnostics, rapporte The Guardian. « Si elles ne sont pas détectées, ces erreurs risquent de se retrouver dans les dossiers médicaux des patients et d’affecter leur prise en charge ». Le problème, souligne Healthwatch England, c’est que les dispositifs de transcription automatiques des consultations sont au cœur du « grand virage » prévu pour le NHS, visant à transformer un service fonctionnant sur des méthodes analogiques en un service numérique. Ces erreurs, souvent repérées par les patients eux-mêmes, nécessitent de mettre en place un système de signalement et de rectification adapté. Le problème, pointe encore l’organisme, c’est que l’Agence de réglementation des médicaments et des produits de santé a décidé de ne pas classer ces outils de transcription par IA comme des dispositifs médicaux ; cela signifie qu’il n’y aura aucune supervision à l’échelle de l’Angleterre pour garantir leur sécurité et leur efficacité.
Pour Charlotte Blease, experte en utilisation de l’IA dans le secteur de la santé à l’université d’Uppsala (Suède), les erreurs sont plus susceptibles de se glisser dans les dossiers lorsque la consultation implique plusieurs personnes, que les patients ont des antécédents médicaux complexes ou les patients maîtrisent mal l’anglais.
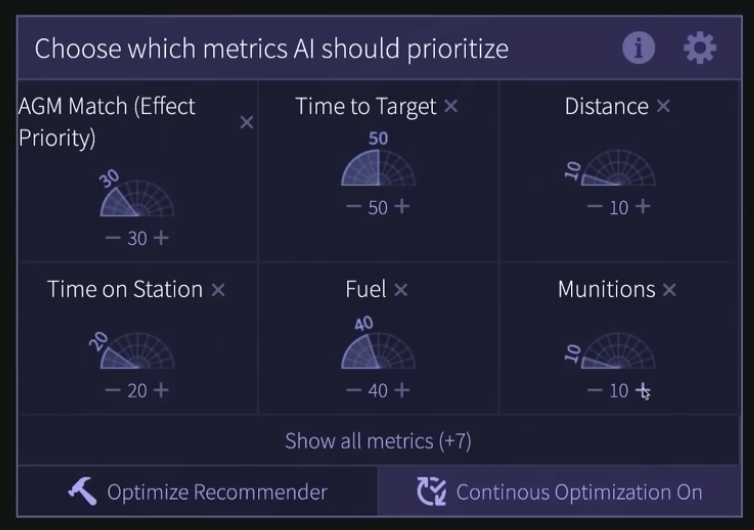
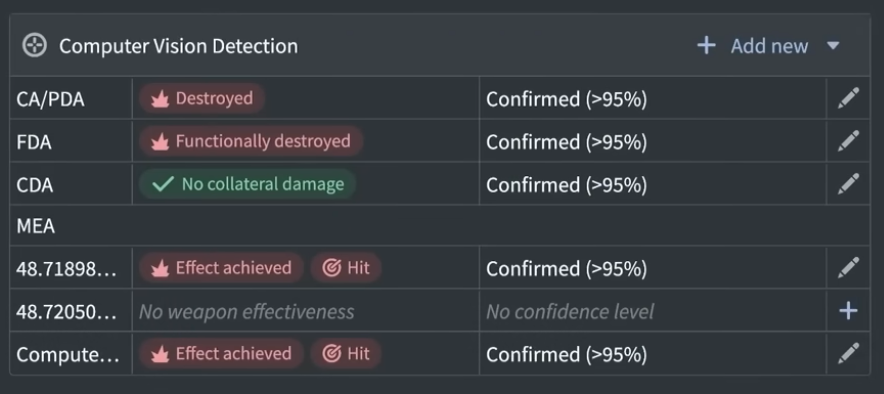
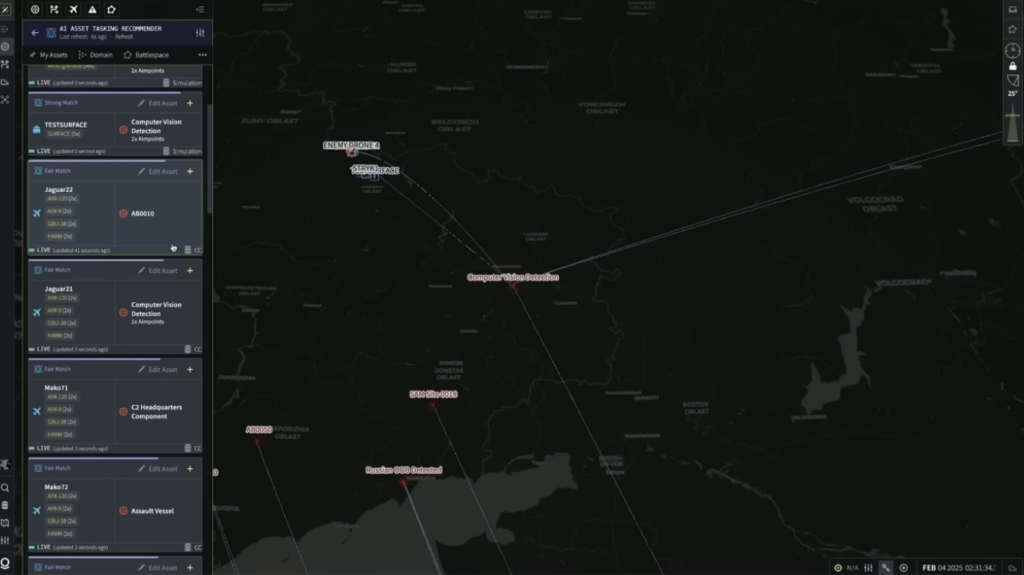
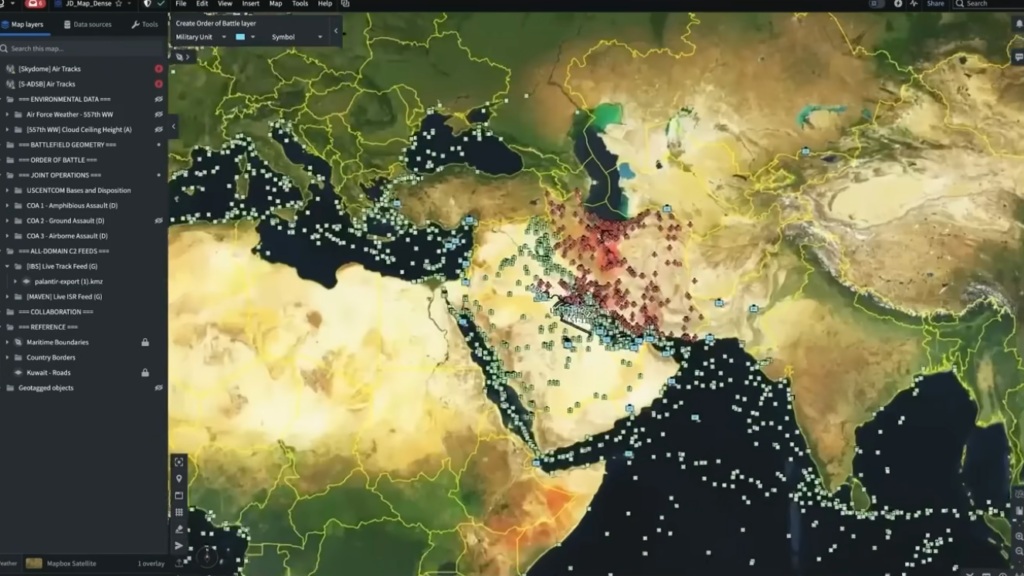
L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destruction utilisé par un État spécifique, notre schéma illustre les activités tactiques et les décisions impliquant l’utilisation de systèmes d’IA à travers six étapes : 1. Capteurs et données, 2. Surveillance, 3. Renseignement et identification, 4. Sélection, 5. Frappe et 6. Évaluation post-frappe. »
« Les systèmes d’aide à la décision assistés par l’IA – qu’ils s’appuient sur de grands modèles de langage (LLM) ou sur d’autres types d’algorithmes d’apprentissage automatique – intègrent des informations provenant de capteurs couvrant les zones d’opérations militaires. Il peut s’agir de textes issus d’Internet, d’images satellites, de données audio provenant de télécommunications ou de vidéos captées par des drones. Ces données sont synthétisées sur une interface unique et conviviale.
Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs.
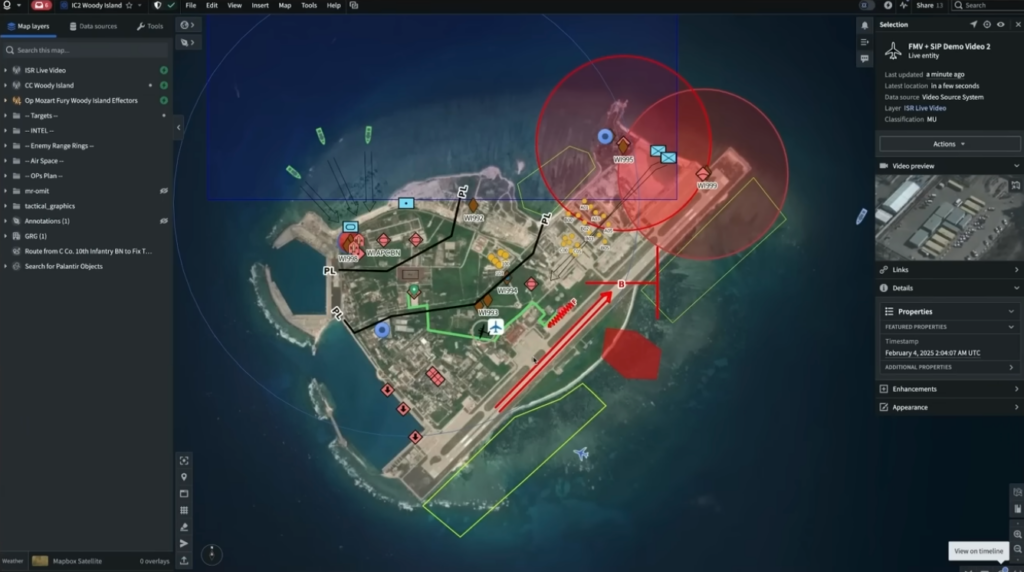
Si l’histoire est fictive, les technologies décrites, elles, sont bien réelles. Et les explications permettent de comprendre les enjeux de chacune, comme la détection d’anomalie par exemple, qui vise à repérer des schémas inhabituels ou des changements dans l’imagerie satellitaire, les données radar et autres flux de télédétection provenant de zones d’opérations militaires. Ces systèmes peuvent recourir à des réseaux de neurones à convolution ou à des auto-encodeurs pour traiter des volumes massifs de données et repérer des éléments susceptibles d’indiquer des mouvements de troupes, des déploiements de missiles, des infrastructures endommagées ou des modifications inattendues du terrain. Le problème avec ces technologies de détection d’anomalies c’est qu’elles peinent à distinguer des menaces réelles des variations environnementales ordinaires.« Les conditions météorologiques, les ombres, le bruit des capteurs et les différences d’angles de vue peuvent entraîner des erreurs de classification. De même, les auto-encodeurs sont entraînés à différencier les schémas correspondant à une classification spécifique des anomalies qui s’en écartent. Toutefois, ces modèles manquent de généralisabilité et de fiabilité ; par ailleurs, les données utilisées pour leur apprentissage peuvent être biaisées, présenter une distribution limitée ou reposer sur des classifications stéréotypées, conduisant à une mauvaise identification de la nature ou de l’identité d’une menace imminente. En 2025 par exemple, il a été démontré que la précision de Maven peut chuter en dessous de 30 % lorsqu’il est déployé sur un terrain inconnu ou dans des conditions environnementales incertaines entravant sa capacité à reconnaître et à signaler des objets », comme le rappelait Katrina Manson dans son livre.
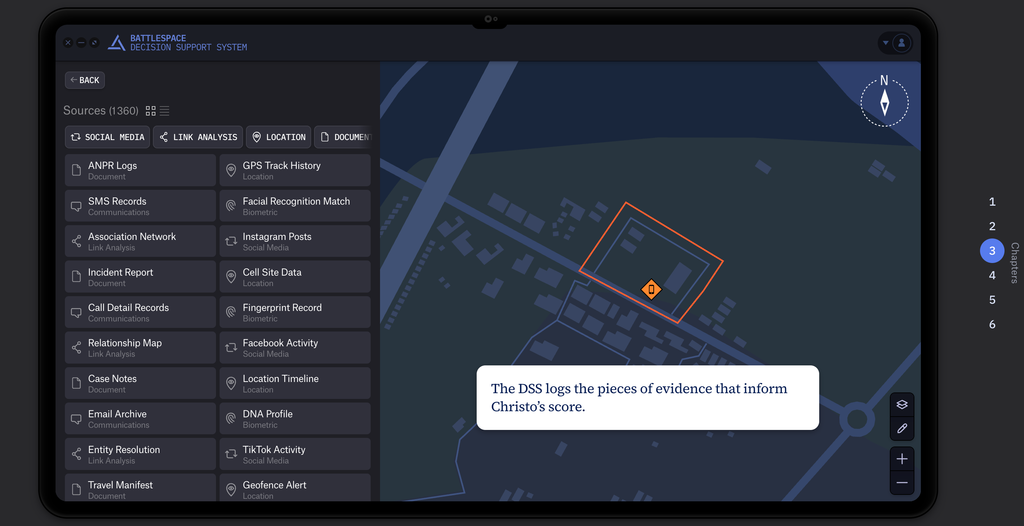
Parmi les nombreuses techniques utilisées, il y a aussi le géorepérage de ces mêmes cibles pour détecter les véhicules ou téléphones qui entrent dans une zone, déclenchant une surveillance et un suivi de la localisation des téléphones et véhicules et une interception des communications : les messages sont automatiquement relayés et traduits en direct, avec des termes qui déclenchent des alertes renforcées (notamment des termes temporels, comme « imminent » ou « bientôt »). Les propriétaires des cartes Sim sont bien sûr identifiés pour contrôler s’ils ne sont pas déjà sur des listes de suspects ou contrôler leur score de risque (un système de notation sociale qui passe au crible toutes les données collectées passivement sur les habitants, données issues de caméras et des réseaux sociaux, pour créer un score de probabilité qu’ils appartiennent à l’armée adverse, voir notre dossier). Si le score de menace est élevé, l’opérateur peut accéder aux sources afférentes pour enquêter et confirmer ou infirmer la menace depuis toutes les données collectées. Parmi celles-ci : les déplacements provenant du GPS du téléphone, les informations relatives aux plaques minéralogiques du propriétaires du véhicules (et donc les déplacements associés à ces véhicules), ses SMS, l’enregistrement de ses derniers appels, l’enregistrement de son visage ou de ses empreintes pour débloquer son téléphone, ses mails, savoir s’il s’est déjà trouvé dans une zone géorepérée… Des tonnes d’informations que l’opérateur n’a souvent pas le temps d’examiner car son temps est compté. Mais surtout, les liens et les activités sur les réseaux sociaux constituent l’un des facteurs du score de risque. Une analyse des publications est produite, traduite et analysée automatiquement notamment pour y détecter des émotions, comme le fait que leur auteur soit susceptible d’apprécier des actions de l’ennemi, ou que ces échanges aient été likés par des membres avérés de l’armée adverse. Dans ces analyses traduites, automatisées, il est impossible de vérifier si les publications en question sont bien réelles ou si les traductions sont fidèles. Ses relations sur les réseaux sociaux ou via ses appels et SMS sont également analysées pour montrer si ses abonnés sont membres de l’armée adverse ou s’il a pu échanger avec des ennemis confirmés. En accédant à son profil, on peut récupérer des photos permettant de lancer automatiquement une requête dans les réseaux de caméras de vidéosurveillance et observer si ses déplacements ont un rapport avec des sites surveillés et sensibles. Là encore les erreurs d’identification peuvent être innombrables. Compte tenu du temps limité, l’opérateur a tendance à valider ce que le système de notation sociale suggère. Si l’identification a un caractère d’urgence, un drone de surveillance peut être déployé pour suivre la personne identifiée.
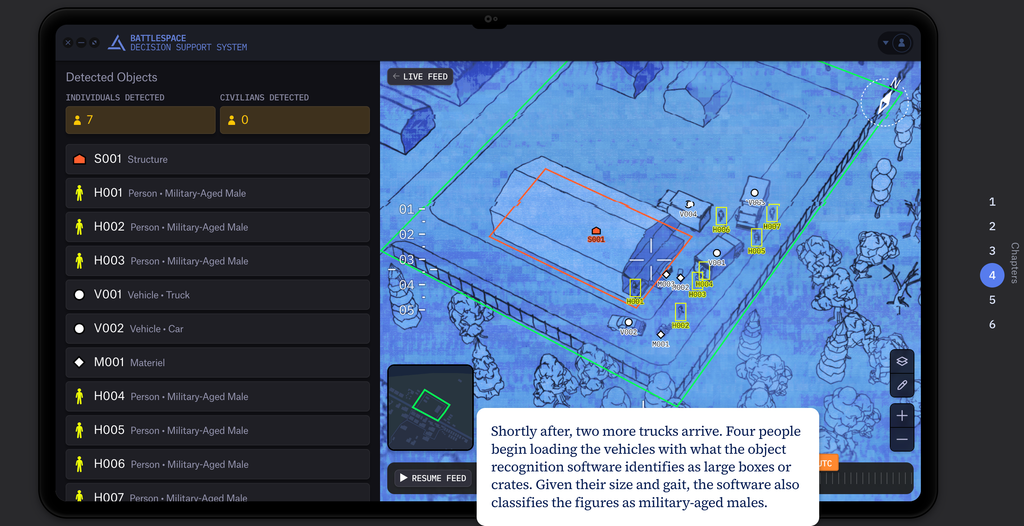
Capture d’écran de la fiction explicative de l’AI Now Institute et AIrwars. On voit sur la carte un téléphone géorepéré dans un bâtiment et sur la gauche, tous les éléments du téléphone auquel accède le système. Autre capture, le système repère les téléphones, les véhicules et le matériel en leur attribuant des caractéristiques spécifiques.
Dans ce cas, le flux vidéo permet d’identifier qui est présent. Les personnes, les véhicules… et les personnes sont distinguées entre civils et membres de l’armée ennemie. Selon leur taille ou leur gabarit, il identifie les objets et les personnes, par exemple en les classant comme des « hommes en âge de combattre ». Chaque image du scénario permet d’accéder à des fenêtres contextuelles permettant de mettre en perspective la fiabilité des technologies utilisées. Par exemple, l’animation rappelle que la détection de formes et d’objets reste peu fiable.« Des recherches ont par exemple révélé que les systèmes peuvent classer de manière erronée 97 % des objets s’ils apparaissent dans des postures s’écartant de celles figurant dans les données d’apprentissage. Par ailleurs, diverses études montrent qu’une grande précision lors des phases de test ne garantit pas nécessairement une précision ou des performances élevées lors du déploiement en conditions réelles. En 2021, l’US Air Force a mené un programme pilote de reconnaissance de cibles affichant un taux de précision de 95 % dans des scénarios d’entraînement. Ce chiffre a toutefois chuté à seulement 25 % en environnement réel. Dans la grande majorité des cas, des algorithmes entraînés à reconnaître des images de missiles sol-sol sous un angle oblique se sont révélés incapables d’identifier ces mêmes objets lorsqu’ils apparaissaient dans des positions différentes. »
Une fois la frappe accomplie, l’opérateur reçoit un rapport d’évaluation, généré par un système d’évaluation des dommages de combat assisté par IA. Ces rapports ont tendance à renforcer les erreurs de classification déjà commises par les systèmes. Les réseaux sociaux sur place et les publications journalistiques locales donnent souvent une autre vision de ces résultats, mais ces informations ne sont pas réintégrées dans le système pour apprécier ses erreurs. Ils montrent aussi parfois que les personnes ciblées ne sont pas aussi menaçantes qu’elles semblaient l’être, en rappelant leur parcours et leurs fonctions.
« À Gaza, l’armée israélienne a publié une vidéo d’une frappe tuant un homme qui transportait ce qu’elle a identifié comme un lance-roquettes. Elle a par la suite reconnu que ses forces avaient mal identifié l’objet :il s’agissait d’un vélo. » La vidéo est d’ailleurs confondante. Vue de haut, on ne sait pas ce que l’homme tient à son bras. Mais, si le système vous indique que c’est un lance-roquette, alors assurément, cela semble en être un. En fait, on comprend que c’est la manière dont ces outils regardent le monde qui est problématique. Pour un système de ce type, tout est menace, tout est orienté pour détecter des menaces, et à force de regarder le monde comme une menace, il le devient.
« Les partisans de l’IA soutiennent qu’elle peut atténuer et réduire ces erreurs. Toutefois, ces systèmes risquent aussi de provoquer l’effet inverse, notamment en augmentant les taux d’erreur tout au long de la chaîne de ciblage et de frappe. Au cours d’une campagne de frappes de 40 jours contre l’Iran ce printemps, l’armée américaine a déclaré avoir atteint plus de 13 000 cibles, un rythme d’opérations quasi impossible à tenir avant l’avènement de l’IA.
L’IA pourrait également compliquer l’identification des défaillances et entraver l’obligation de rendre des comptes. À la suite d’une enquête d’Airwars sur une série de frappes assistées par l’IA ayant tué un étudiant irakien, l’armée américaine a déclaré n’avoir « aucun moyen de savoir » si la frappe meurtrière avait reposé sur l’IA.
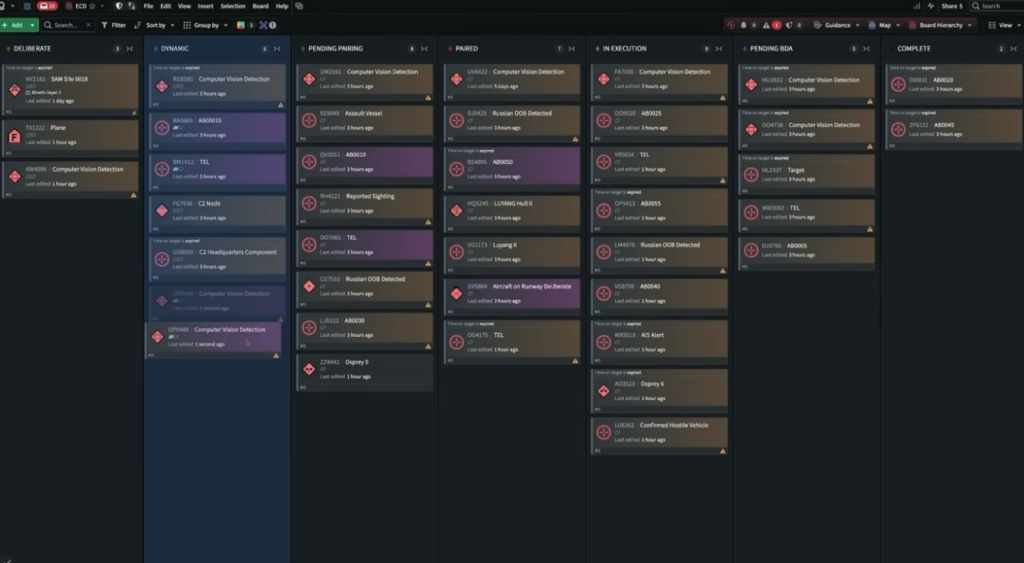
Le livre Project Maven (voire notre critique), consacré à l’IA militaire américaine a révélé que, dans certaines opérations, seules deux des six étapes de la chaîne de ciblage et de frappe impliquent désormais une intervention humaine directe, une troisième nécessitant une certaine supervision humaine. Les autres étapes sont aujourd’hui entièrement automatisées. »
Dans une interview pour Democracy Now, Heidy Khlaaf, directrice scientifique chargée de l’IA à l’AI Now Institute et responsable de la publication avec AIrwars de cette fiction explicative, rappelle que derrière ces systèmes automatisés il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts. « Ils présentent tous une fiabilité et une précision très faibles. Ces systèmes s’appuient les uns sur les autres et s’alimentent mutuellement pour aboutir, malheureusement, à des pertes civiles, comme nous l’avons souvent constaté lors de leur utilisation. »« La distinction entre systèmes autonomes et systèmes de soutien est assez superficielle en pratique ». En réalité, quand on utilise ces systèmes, les biais d’automatisation sont très forts, rappelle-t-elle : tout y est présenté comme un risque. C’est le cas par exemple des systèmes de traduction automatisés, comme l’a montré une enquête d’Associated Press, qui montrait que l’usage de systèmes de traduction avaient du mal avec l’arabe. Prendre un mot pour un autre peut suffire pour vous inscrire sur une liste de personnes cibles. « Il est très difficile de comprendre pourquoi une IA a pris une décision donnée lorsqu’il s’agit de grands modèles de langage, en raison de leur envergure et de leur mode de fonctionnement. Était-ce dû à des données erronées ? L’IA a-t-elle reçu des instructions en ce sens ? S’agissait-il d’hallucinations ? Quiconque a utilisé ChatGPT sait que ces agents conversationnels inventent souvent des informations. C’est, je pense, la situation dans laquelle nous nous trouvons actuellement. La cause exacte de ces événements reste incertaine. En fait, je dirais même que c’est là l’une des finalités des systèmes d’IA : ils servent souvent à diluer la responsabilité », comme le pointait très bien le sociologue Ori Schwarz également (voir notre article).
« En fin de compte, ces entreprises sont en train de réinventer la notion de sécurité. Elles s’approprient bon nombre de termes traditionnellement utilisés dans l’ingénierie de la sûreté et de la sécurité pour les appliquer à des formes de sécurité différentes. Au lieu de se demander : « Nos systèmes sont-ils fiables ? Sont-ils précis ? Fonctionnent-ils comme prévu ? Sont-ils adaptés à leur usage, de sorte qu’aucun être humain ne subisse de préjudice du fait des décisions ou des recommandations qu’ils génèrent ? » Au lieu de cela, nous nous retrouvons avec des cadres relatifs à la sécurité et à l’éthique qui portent sur des questions telles que l’autonomie, l’intentionnalité ou la conscience de ces systèmes. Or, il s’agit là d’une question tout à fait différente. Ces systèmes peuvent souvent donner l’illusion de posséder ces caractéristiques, ce qui conduit à anthropomorphiser le langage ou les actions de ces modèles. Nous avons vu récemment, par exemple, les capacités de cybersécurité être présentées comme si ces systèmes étaient autonomes – comme s’ils agissaient de leur propre chef, ce qui correspondrait à une attente que nous aurions à leur égard. Pourtant, dans la réalité, ces entreprises les déployaient dans des environnements très peu sécurisés et amenaient délibérément ces modèles à mener des cyberattaques dans le cadre de tests ou d’évaluations comparatives. »
« C’est précisément ce qui me pose problème : ces entreprises tentent, une fois de plus, d’attribuer la responsabilité à l’IA plutôt qu’à elles-mêmes. Or, l’IA ne fait que ce que nous lui ordonnons de faire ; elle n’est capable que de ce pour quoi nous l’avons conçue. »
« Il est donc crucial de garder à l’esprit que, certes, ces systèmes sont performants. Oui, ils sont capables de mener des actions telles que des cyberattaques ou des frappes. Et ils accélèrent effectivement les opérations ; c’est indéniable. C’est même l’une de leurs caractéristiques fondamentales. Toutefois, si l’on dispose d’un outil qui accélère les opérations mais dont la fiabilité et la précision de base se situent entre 30 et 60 %, le résultat ne diffère guère d’un ciblage aveugle, n’est-ce pas ? » Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres – surtout dans des situations inédites, un cas de figure plus probable encore en temps de guerre que lors de cyberattaques.»
« Depuis que le camp de l’émancipation a renoncé à combattre l’aliénation et a adopté les « innovations » du capital en les saluant comme des progrès, il ne cesse de multiplier les défaites. Parce que, précisément, ces innovations garantissent une passivité face à la réalité capitaliste qui sape les bases de toute tentative sérieuse d’émancipation. » Pour le journaliste Romaric Godin de Mediapart, l’IA générative ne conduira la gauche nulle part. « Le capital est le principe dominant de cette technologie qui est à son service. »« Si l’État prenait le contrôle de l’IA aujourd’hui, il la mettrait au service de la société capitaliste comme une matière première. Il en assurerait donc l’abondance bien davantage que la sobriété. Cela changerait certes les rapports de force au sein du capital, mais cela ne changerait rien à la centralité du capital dans la société. »
Mais surtout, rappelle le journaliste, à quoi sert l’IAG dans la lutte pour l’émancipation ? « En réalité, cette technologie n’est pas qu’un simple outil que l’on pourrait aisément retourner. La gestion de l’économie du capitalisme tardif passe par le déni des crises économiques, anthropologiques et écologiques. Et l’IAG est l’outil conçu pour organiser ce déni. Son développement est un choix du capital qui a investi et continue d’investir dans cette technologie au détriment d’autres technologies qui pourraient davantage répondre aux besoins de l’humanité. »
Aux Etats-Unis, la fronde contre le développement des détecteurs automatiques des numéros de plaques d’immatriculations est forte. Si quelques caméras Flock ont été vandalisées, ce sont surtout nombre de conseils municipaux abonnés au système qui rejettent et résilient leurs contrats avec l’entreprise qui les installe, suite notamment aux révélations de l’utilisation du système par l’ICE, la police qui de l’immigration américaine, qui s’en sert pour traquer les étrangers sans lien avec des infractions de circulations.
Pour faire face à la fronde, Flock a fini par réagir et a annoncé une série de changements dans les modalités de partage d’information avec les forces de l’ordre américaine. Des changements surtout cosmétiques, ironise Gizmodo. L’entreprise, en effet, propose désormais que par défaut, la durée de conservation des informations passe de 30 à 7 jours. Mais en fait, précise l’entreprise, « les forces de l’ordre peuvent prolonger ou réduire cette période. Chaque collectivité continuera de choisir la durée de conservation adaptée à sa stratégie de sécurité publique et conforme aux politiques locales ou étatiques. » Elle annonce également un dispositif supplémentaire (le mode « Preuve ») qui permettra à la police de conserver « des données LAPI (systèmes de Lecture automatisée de plaques d’immatriculation) spécifiques à titre de preuve pour une enquête en cours, dans un stockage à long terme ». L’ACLU (American Civil Liberties Union) a publié une réponse moqueuse (« Flock semble davantage viser à résoudre un problème d’image qu’à s’attaquer aux atteintes majeures à la vie privée et aux autres préjudices engendrés par ses produits ») et maintient sa campagne invitant les citoyens à agir pour « se débarrasser du Flock » (Get the Flock out). L’Institut pour la Justice a pour sa part publié une base de données pour recenser les abus d’utilisation des systèmes de lecture automatisée de plaques d’immatriculation. L’ACLU rappelle que si Flock souhaite évaluer l’efficacité de son outil et notamment mieux surveiller les usages abusifs qu’en fait la police, l’entreprise devrait le soumettre à l’analyse d’un évaluateur indépendant. Flock a déjà par le passé annoncé des mesures de sécurité liées au motif de recherche, mais elles n’ont produit aucune amélioration, bien au contraire. Comme, le rappelle Gizmodo, « il est difficile d’imaginer qu’une personne prête à détruire une caméra Flock changera d’avis simplement parce que la durée recommandée de conservation des données passe de 30 à 7 jours ».
Dans un entretien à la BBC, le PDG de Flock, Garrett Langley, ajoute qu’il s’est rallié à l’idée d’organisations telles que l’ACLU et l’Electronic Frontier Foundation (EFF), selon lesquelles la police devrait disposer d’un numéro de dossier en cours pour pouvoir consulter les données de Flock. Pour Cooper Quentin, de l’EFF, « les requêtes dans les bases de données [de lecteurs automatiques de plaques d’immatriculation], devraient impérativement faire l’objet d’un mandat judiciaire ». Ce n’est pas le cas.
Alors que le gouvernement américain surveille activement sur les réseaux sociaux les publications anti-Flock devenues virales, rapporte 404 media, et menace le site DeFlock, qui cartographie la présence des caméras, son initiateur, Will Freeman, rappelle qu’il n’a jamais appelé à neutraliser les caméras ni à masquer les plaques d’immatriculation, contrairement à ce qu’affirment les récents bulletins des forces de l’ordre. Le vandalisme montre surtout que les gens sont mécontents de voir ces systèmes installés à leur insu ou sans leur consentement. Mais le sabotage semble surtout assez anecdotique, bien moindre en tout cas que la contestation qui pousse les citoyens à demander des comptes aux autorités locales qui tissent des partenariats avec l’entreprise Flock.
Comme l’explique une enquête de New Republic sur la montée de la contestation contre les systèmes de caméras LAPI, «Flock constitue un système de surveillance de masse d’une puissance – et d’une rentabilité – stupéfiante. Ses caméras LAPI sont utilisées par plus de 1 000 entreprises et environ un tiers des 18 000 services de police des États-Unis ». L’ACLU l’estime à le nombre de caméras de surveillance des plaques d’immatriculations déployées aux Etats-Unis à 90 000. Quant à l’entreprise, elle a généré un chiffre d’affaires de 285 millions de dollars en 2024. Le géant du capital-risque Andreessen Horowitz a récemment valorisé l’entreprise à 7,5 milliards de dollars.
Les études (2019 et 2024), jusqu’à présent, montrent surtout que l’efficacité des caméras à prévenir le crime est plus que douteuse. « En 2022, l’entreprise s’est vantée que ses caméras à San Marino, en Californie, avaient entraîné une baisse de 80 % des cambriolages en cinq mois ;Forbesa révélé par la suite que les cambriolages avaient en réalité augmenté dans les années suivant l’installation des caméras de Flock ». « Même si les caméras et le réseau de surveillance de Flock contribuent à élucider certains crimes, les critiques estiment que le prix à payer en matière de vie privée est trop élevé. La police a été prise en flagrant délit d’utilisation illégale des données de Flock pour localiser une femme cherchant à avorter, pour traquer et harceler des individus, surveiller des manifestations ou prêter main-forte aux services d’immigration de l’ICE pour arrêter des individus depuis de simples suspiscions. »
« Au minimum,cette surveillance de masse implique le suivi, sans mandat, de toute personne circulant sur la voie publique», a averti l’ACLU. « Au pire, elle instaure un État policier numérique où les forces de l’ordre […] peuvent traquer manifestants, opposants politiques, immigrés, patients et autres personnes non soupçonnées de crime, et utiliser ces informations pour leur nuire. »
Une contestation de droite comme de gauche
Sous la pression populaire d’opposants à Flocks, locaux et actifs, « Austin, au Texas, a suspendu son programme Flock en juin dernier face à la contestation locale, tandis qu’Evanston, dans l’Illinois, y a mis fin en août.Selon la NPR, au moins 30 localités « ont soit désactivé leurs caméras Flock, soit annulé leurs contrats depuis le début de l’année 2025 ». » A Ithaca, les manifestations ont fait reculer la police. Par des pétitions, des interventions publiques et des tribunes dans la presse locale, le collectif local, Flock Off, a quelque peu freiné les activités de l’entreprise. En octobre, le bureau du shérif du comté a cessé de partager les données Flock avec les comtés collaborant avec l’ICE. En février, suite à une manifestation devant l’hôtel de ville, la police locale a réduit le nombre de services avec lesquels elle partageait les données. « À bien des égards, cela prouve qu’au niveau local, la démocratie peut encore fonctionner », estime le responsable du groupe Flock Off local. Le prochain objectif de Flock Off est de faire résilier purement et simplement le contrat passé avec la ville.
« Si les groupes opposés à Flock émergent généralement de bastions progressistes, certains États dirigés par des républicains ont également pris des mesures pour restreindre la surveillance par ces systèmes. Les libertariens, en particulier, s’opposent à Flock : le magazine libertarien Reason a publié plusieurs articles critiquant l’entreprise, qu’il accuse de mener un programme de surveillance de masse orwellien », rapporte New Republic.
Le New York Times s’est également intéressé à « ces caméras que la police adore et que les citoyens détestent ». Au Texas, rapportent les journalistes Fernando Alfonso III et Kashmir Hill, « il est un point sur lequel progressistes et conservateurs s’accordent : ils ne veulent pas de caméras braquées sur leurs voitures ». Pourtant, les Américains sont habitués à la vidéosurveillance. « Ils en installent sur leurs sonnettes et les acceptent au coin des rues, dans les bureaux et les restaurants ». Mais, ce qui distingue les caméras Flock, rappellent les journalistes, « c’est qu’elles sont connectées entre elles, formant un vaste réseau national interrogeable ; cette situation surprend souvent les habitants – qui ignoraient que leurs autorités locales avaient souscrit à ce service – et suscite des craintes d’une surveillance digne de « Big Brother ». De plus, il est difficile de ne plus les voir une fois qu’on a commencé à les remarquer. »Le Texas est devenu un baromètre, estiment les journalistes. « Flock a commencé à vendre ses services aux services de police début 2020, en installant quelques dizaines de caméras dans une banlieue de Houston. Six ans plus tard, 700 services de police texans ont passé contrat avec l’entreprise.L’opposition regroupe des progressistes inquiets de la surveillance gouvernementale, des conservateurs méfiants à l’égard de l’extension du pouvoir de l’État, ainsi que des citoyens et des élus soucieux de leur vie privée et préoccupés par les possibles dérives du réseau.» A l’image de Hannah Foust, qui vit à Carrollton (Texas), qui a commencé à publier des messages sur les lecteurs de plaques d’immatriculation dans des groupes Reddit et a lancé une pétition en ligne pour obtenir le retrait de ces caméras de sa commune. Devant le conseil municipal, elle explique : « Je ne commets aucun délit, mais je ne veux pas nécessairement que quiconque – et encore moins des agences gouvernementales ou une entreprise privée – puisse voir où je dépose mes enfants, quel itinéraire je privilégie pour me rendre au travail, si je préfère H-E-B ou Kroger, ou quel lieu de culte je fréquente. » À travers le Texas, l’opposition à ces caméras transcende les clivages partisans. Les contrats de Flock ont été résiliés aussi bien à Austin, ville progressiste, qu’à Bandera, une localité conservatrice de la région de Hill Country comptant environ 900 habitants. « Au Congrès, Keith Self, un républicain dont la circonscription se situe au nord de Dallas, a déposé un projet de loi en juillet. Ce texte imposerait aux agences fédérales chargées de l’application de la loi d’obtenir un mandat avant d’accéder aux données collectées par les systèmes de surveillance étatiques et locaux – notamment les lecteurs de plaques d’immatriculation – ou de les interroger. » Pour un colonel de l’armée à la retraite et ancien juge de comté, « nous sommes en train de basculer vers un État de surveillance », estime-t-il, en flirtant avec des dénonciations que l’on retrouve dans les pire propos conspirationnistes d’extrême-droite, comme ceux que colporte, à longueur d’émission, la War Room de Steve Bannon.
Flock, la plateforme d’hypersurveillance des déplacements
« Flock facture environ 3 000 dollars par caméra et par an, a précisé M. Langley.En contrepartie, l’entreprise installe et entretient les caméras, fournit une base de données consultable répertoriant tous les véhicules qui passent devant elles et envoie des alertes si les caméras repèrent des voitures figurant sur une liste de surveillance prioritaire – comme la base de données du FBI recensant les véhicules volés et les plaques d’immatriculation associées à des personnes disparues ou recherchées. Ces dernières années, grâce aux progrès de l’intelligence artificielle,Flock a ajouté une fonctionnalité permettant de rechercher des voitures en fonction de leur marque, de leur type, de leur couleur ou de détails spécifiques, tels que des autocollants sur le pare-chocs ou des dommages visibles.»
« Pour effectuer une recherche, les agents précisent le type de délit, allant de la cruauté envers les animaux à l’homicide. Ils saisissent ensuite un numéro de plaque d’immatriculation ou une description du véhicule ainsi qu’un lieu, ou optent simplement pour l’option par défaut : « Tous les réseaux sélectionnés ».La recherche affiche les images des voitures correspondantes, en indiquant précisément l’heure et le lieu où elles ont été repérées, ainsi que le service de police auquel appartenaient les caméras. Par défaut, les photos prises par les caméras sont supprimées au bout de 30 jours, bien que les services de police puissent modifier la durée de conservation.
Si un service de police souhaite accéder à d’autres caméras ailleurs dans l’État ou dans le pays, il doit partager l’accès aux siennes. La plupart des organismes effectuent des recherches et partagent des informations à l’échelle nationale. »
L’éditorialiste et animateur de télévision de droite radicale américain Tucker Carlson, qui pourrait être candidat à la prochaine élection présidentielle américaine, s’est récemment moqué de l’assimilation faite par M. Langley entre un projet de cartographie participative et le terrorisme. Carlson a déclaré n’avoir pris conscience que récemment de l’ampleur du réseau Flock après avoir consulté le site de DeFlock ; il a confié au New York Times que cette découverte l’avait « horrifié ». Il s’est dit surpris qu’un système de surveillance aussi vaste ait pu se développer en suscitant si peu d’attention de la part du public… Tant et si bien que le PDG de Flock a depuis présenté ses excuses pour ses propos assimilant le site DeFlock au terrorisme.
« Que l’on soit libertarien, conservateur, partisan du mouvement MAGA ou progressiste, tout le monde a des objections à l’encontre de Flock », a déclaré Chad Marlow de l’ACLU. Reste que si l’opposition au Texas attire peut-être l’attention, elle n’a pas freiné la croissance de Flock. À travers l’État, de nouvelles villes signent des contrats plus rapidement que d’autres ne les résilient, a indiqué Jennifer Szimanski, porte-parole de la Combined Law Enforcement Associations of Texas, un syndicat de police représentant plus de 28 000 agents. Selon elle, la raison repose sur les résultats impressionnants du réseau. Certains services de police texans ont retrouvé des centaines de véhicules volés après avoir installé ces caméras, a-t-elle précisé, et dans les petites municipalités, les vols dans les véhicules ont pratiquement cessé. Pour elle, le risque d’utilisation abusive du système par les policiers texans n’était pas plus élevé qu’avec les autres bases de données auxquelles ils ont accès, et que Flock fournissait un historique de chaque recherche, précisant qui l’avait effectuée et pour quel motif.
La possibilité de rechercher n’importe quel véhicule circulant sur les routes du pays est certes pratique pour les autorités, mais Barry Friedman, professeur de droit et directeur duPolicing Project, soutient que la création d’une vaste base de données sur les déplacements des Américains est inconstitutionnelle : « il s’agit d’une collecte de données indiscriminée, et non d’une surveillance ciblant des infractions spécifiques ». « Si le quatrième amendement existe, c’est parce que l’on estimait que le gouvernement ne devrait pas pouvoir s’en prendre à n’importe qui, même en l’absence de tout acte répréhensible. »
Jusqu’à présent, les tribunaux ont rejeté cette interprétation, tout en laissant entendre que la situation pourrait évoluer à mesure que la technologie se généralise. Dans une affaire où des habitants avaient poursuivi la ville de Norfolk (Virginie) pour l’installation de 172 caméras Flock, un juge fédéral a statué que les lecteurs de plaques pourraient un jour devenir si omniprésents que leur utilisation s’apparenterait à une surveillance de masse indiscriminée et inconstitutionnelle, mais que ce n’était pas encore le cas. « Je ne pense pas que les juges réalisent que le pays est désormais couvert par ces dispositifs et qu’ils sont tous interconnectés », a déclaré Sid Thaxter, de l’Association nationale des avocats de la défense pénale.
En attendant, la police américaine invite les agents à ne plus mentionner le fait qu’ils ont eu recours à une technologie de détection automatique des numéros de plaques d’immatriculations dans leur rapports ou auprès des personnes qu’ils appréhendent, rapporte 404media. « Lorsque les forces de l’ordre utilisent Flock pour procéder à une arrestation dans le comté de Wapello, en Iowa, elles ne souhaitent pas que la personne concernée le sache. Une politique d’utilisation des caméras de lecture automatique de plaques du comté ordonne explicitement à la police de garder ce dispositif secret. » Un moyen de rendre encore plus invisible les abus que Flock annonce vouloir limiter.
Pour Tech Policy Press, Jake Laperruque responsable du projet « Sécurité et surveillance » au sein du Center for Democracy & Technology (CDT), « les systèmes de lecture automatisée de plaques d’immatriculation en général, et le fournisseur de premier plan Flock en particulier, sont confrontés à un moment de prise de conscience publique aux États-Unis. Cette technologie de surveillance provoque des réactions négatives majeures dans tout le pays et devient un sujet de campagne majeur ». Mais pour Laperruque, les risques actuels liés à la vie privée liés aux systèmes de détection des plaques d’immatriculation ne sont que la pointe de l’iceberg et vont s’étendre considérablement dans les années à venir. « À moins qu’ils ne soient sérieusement maîtrisés, ces systèmes deviendront un outil de surveillance de masse bien plus répandu qu’aujourd’hui ». La raison, notamment : de nouvelles fonctionnalités ajoutées à Flock à partir d’analyses automatisées par l’agence fédérale des douanes créant des alertes sur des comportements de conduite suspects et signalant des véhicules à arrêter, rapporte AP News. Un comportement innocent au volant, comme prendre une route secondaire, conduire à des heures indues ou se rendre dans un endroit inhabituel, pourrait devenir des motifs de contrôle. 404 media a révélé également que les vidéos captées par les caméras étaient utilisées pour identifier des formes ou des conducteurs. Une fonctionnalité de recherche en texte libre permet de trouver des personnes tatouées ou portant des maillots de sport spécifiques ; ces recherches incluent parfois l’origine ethnique de la personne visée. A terme, connectée à la reconnaissance faciale, elle pourrait permettre de rechercher des personnes partout sur les routes. « Ces systèmes risquent fort de se transformer en un « œil omniscient » permettant de rechercher n’importe quel type de véhicule, d’objet ou de personne, avec la même facilité que nous recherchons aujourd’hui des mots dans un fichier texte ». Reste à savoir s’il faut limiter ce pouvoir par une accréditation judiciaire pour chercher dans ces images, comme le propose Laperruque ou limiter le développement du réseau.
Wired rappelle que Flock Safety, géant de la surveillance des véhicules, affirme depuis des années que sa technologie « ne peut ni reconnaître, ni identifier, ni suivre des individus ». Ses pages dédiées à la confiance du public assurent aux clients que la technologie est conçue pour des enquêtes spécifiques, au cas par cas, et « non pour surveiller les gens ». Ce n’est plus le cas, notamment via l’ajout d’innombrables outils qui donnent accès« aux métadonnées des caméras, aux dossiers d’arrestation, aux dossiers d’enquête, aux journaux d’appels, aux résultats d’analyses balistiques ainsi qu’à des bases de données commerciales contenant des numéros de sécurité sociale, dates de naissance, numéros de téléphone, adresses e-mail, informations sur les proches et les associés ». Les requêtes préconfigurées d’OS Investigate, le logiciel de Flock, inversent la logique de recherche. « Un agent n’a plus besoin de plaque, de nom ou d’infraction pour lancer une recherche : il lui suffit d’indiquer un lieu, une période et un schéma comportemental, et le système identifie les personnes correspondant à ces critères. » Pour utiliser ce moteur de recherche, Flock propose des requêtes préconfigurées, comme «« Trouve-moi des témoins en te basant sur les véhicules les plus aperçus dans [tel quartier] au cours des [X derniers jours] durant [telle plage horaire quotidienne] ». Un agent remplit les champs vides et valide la demande. Le résultat est une liste de plaques d’immatriculation que d’autres outils du logiciel convertissent ensuite en noms et adresses de domicile.»
« Dix-neuf de ces requêtes visent à identifier des schémas comportementaux plutôt qu’à consulter un dossier spécifique. Quatorze d’entre elles ne nécessitent ni plaque d’immatriculation, ni nom, ni description physique ; l’agent indique simplement un lieu, un créneau horaire et un comportement.
Certaines requêtes ciblent des véhicules ayant visité au moins trois commerces dans une ville en trois jours, plusieurs banques en une semaine ou plusieurs stations-service entre minuit et 5 heures du matin. Aucune de ces cinq requêtes ne mentionne de cible ou d’incident précis.
L’outil utilisé pour ces recherches intègre un filtre qui exclut les bus, les semi-remorques, les fourgonnettes utilitaires et les remorques ; ainsi, un livreur visitant cinq magasins est retiré de la liste, tandis qu’un conducteur ordinaire effectuant la même tournée y figure toujours. Ce type de recherche s’applique également aux déplacements interurbains : véhicules ayant quitté une ville pour une autre avant d’y revenir dans la semaine, ayant effectué plusieurs allers-retours sur une période de 14 jours ou ayant traversé trois zones successivement.»
Flock se défend en expliquant que ce produit en cours de développement ne proposera pas à terme toutes ces fonctionnalités lors de son lancement commercial. Pour Jay Stanley de l’ACLU : « Nous assistons à un déploiement agressif de l’IA par Flock ; on observe, à certains égards, une frontière très mince entre ce qui est techniquement possible et ce qui est réellement mis en œuvre. » Pour Chad Marlow, avocat à la tête de la campagne « Get The Flock Out » de l’ACLU, le danger est de passer de : « Voyez-vous des schémas criminels ? à Trouvez-moi des schémas criminels, car ces requêtes donneront des résultats différents ». Le risque est de glisser très vite au moment où un agent demandera à une IA quelles personnes elle considère comme les plus susceptibles de commettre des crimes. « Elle ne se fondera pas sur une norme juridique de suspicion criminelle, mais sur ses propres critères internes. » Le code définit déjà les filtres auxquels la requête sera soumise. Le logiciel de Flock associe des recherches de véhicules à des interrogations de fichiers de police classant les individus selon le sexe, la race, l’origine ethnique, la taille, le poids, la corpulence, ainsi que la présence de cicatrices, de marques distinctives et de tatouages. Une fonction permet d’effectuer une recherche uniquement à partir d’une description, en ciblant des enregistrements correspondant à des critères tels que « homme, environ 1,80 m, sweat à capuche noir, tatouage sur l’avant-bras »à proximité d’un lieu donné. L’outil permet à l’agent de délimiter ces critères en choisissant un rayon d’action ou en dessinant des formes libres sur une carte. Selon Stanley, cette pratique s’apparente étroitement à la question examinée par la Cour suprême des États-Unis en juin dernier : la Cour a alors statué que les individus conservent un droit à la vie privée concernant les données retraçant leurs déplacements et que le quatrième amendement s’applique lorsque la police réclame ces informations à une entreprise. Dans le cas présent, les services de police achètent directement cette capacité technologique, ouvrant la voie à des recherches exploratoires (fishing expeditions) d’une ampleur inédite.
L’année dernière, un policier du Texas a effectué des recherches sur plus de 83 000 caméras à travers le pays pour retrouver une femme ayant pratiqué un avortement elle-même, selon des journaux de recherche obtenus initialement par 404 Media. Une enquête récente du Washington Post a révélé qu’une cinquantaine d’agents de police avaient été inculpés ou accusés d’usage abusif des systèmes de lecture de plaques d’immatriculation : 26 d’entre eux les utilisaient pour surveiller leur épouse, leur petite amie, leur ex-compagne ou des femmes qu’ils souhaitaient rencontrer. En août dernier, les autorités de régulation de l’Illinois ont conclu que Flock avait enfreint la loi de l’État en menant un programme pilote – aujourd’hui suspendu – qui donnait au service des douanes et de la protection des frontières accès aux caméras situées dans l’État.
Flock laisse à ses clients le soin de définir la plupart des règles. Les responsables des services décident qui obtient des identifiants, si les données des caméras doivent être partagées au-delà des limites de la ville ou de l’État, et s’il convient d’activer les paramètres proposés par l’entreprise pour prévenir les abus. L’outil d’audit, conçu pour repérer les schémas suspects dans les recherches effectuées par un service, a été lancé en avril 2026 en tant qu’option activable par les forces de l’ordre. Or, selon le Washington Post, de nombreux services de police ont jusqu’à présent peu surveillé les recherches qu’accomplissent leurs agents sur ces systèmes.
L’Electronic Frontier Foundation a examiné des ensembles de données portant sur plus de 12 millions de recherches enregistrées sur une période de 10 mois ; elle a constaté qu’environ 20 % d’entre elles ne mentionnaient qu’un terme vague tel que « enquête », « suspect » ou « requête ». Plus de 50 services ont effectué des centaines de recherches dont le champ « motif » faisait référence à des manifestations.
Comment réguler le changement de nature de la surveillance ?
« Flock ambitionne bien au-delà de la simple lecture automatique des plaques d’immatriculation ; l’objectif est de devenir une plateforme numérique pour le maintien de l’ordre », explique Bob Ferguson, gouverneur de Washington, à l’origine d’une proposition de loi pour réguler le déploiement des caméras. « Nous sommes à l’aube de l’ère de la police automatisée et la capacité à créer des chatbots en langage naturel capables d’effectuer des recherches dans d’immenses bases de données deviendra bientôt la norme. »
Pour Jason Pye, du Due Process Institute, il y a peu de preuves que ces technologies contribuent à faire baisser la criminalité. Il rappelle que, contrairement à ce qu’affirme l’administration Trump, la criminalité violente américaine est en baisse depuis les années 90 (758,2 crimes pour 100 000 habitants en 1991 contre 348,6 en 2024). La raison de cette baisse n’est pas unique, elle n’est pas liée uniquement à l’augmentation de l’incarcération (qui s’est stabilisée dans les années 2000 alors que la criminalité a continué à chuter), mais également à l’amélioration des perspectives économiques, aux mutations des marchés de la drogue, voire même au vieillissement de la population. Si des études montrent que les LAPI peuvent aider la police à identifier des véhicules volés, à générer des pistes d’enquête et, parfois, à élucider des crimes. Établir qu’ils jouent un rôle significatif dans la baisse de la criminalité observée après 2020 est une tout autre affaire, bien plus complexe à démontrer.
Et Pye de citer deux études portant sur l’effet des LAPI : la première note que le déploiement à Atlantic City est associé à une baisse des fusillades, des vols de véhicules et des atteintes aux bien, mais sans reconnaître que le déploiement des caméras puisse être le seul facteur explicatif. La seconde passe en revue l’ensemble des recherches sur le sujet et montre que les preuves que ces systèmes génèrent des avantages plus larges en matière de lutte contre la criminalité restent mitigées. Pye observe ensuite Atlanta, qui compte plus de 3000 systèmes Flock. Or, malgré ce réseau de surveillance sans précédent, les taux d’élucidation des crimes ne se sont pas améliorés.« Par exemple, une arrestation a eu lieu dans 54,3 % des cas d’homicide en 2021. En 2025, seuls 48 % des homicides ont été élucidés. Il existe toutefois des catégories de crimes pour lesquelles les taux d’élucidation se sont améliorés, notamment les cambriolages et les vols dans des véhicules. » De plus, malgré l’un des plus importants réseaux de surveillance des Etats-Unis, le taux de crimes violents à Atlanta a augmenté entre 2024 et 2025 (mais a beaucoup diminué, elle aussi, depuis au moins 2011). Cela ne signifie pas que les LAPI n’apportent rien à la sécurité publique, estime Pye. Ils peuvent être efficaces pour certaines tâches ou certains crimes, mais cela ne signifie pas qu’ils soient à l’origine de la baisse de la criminalité aux Etats-Unis. Et quand bien même ce serait le cas, la question de savoir quel niveau de surveillance l’Amérique est-elle prête à accepter en contrepartie de sa sécurité reste entière, estime Pye. Qui rappelle qu’avec ces systèmes, « il n’est pas nécessaire d’être soupçonné d’un crime pour que les autorités disposent potentiellement d’un relevé indiquant que votre voiture se trouvait à proximité d’une manifestation politique, d’une église, d’une armurerie, d’une clinique médicale ou du domicile d’un tiers. Il s’agit d’une forme de surveillance fondamentalement différente de celle d’un policier vérifiant ponctuellement une plaque d’immatriculation sur l’autoroute ». Le problème, c’est bien le caractère amplificateur de la surveillance que produit la mise en réseau des caméras et la possibilité de les interroger.« Cette situation soulève des questions quant aux personnes habilitées à consulter ces données, aux justifications requises pour effectuer une recherche, à l’étendue du partage de l’information, à la durée de conservation des données et aux conséquences d’une utilisation abusive du système – une éventualité inévitable. Ces questions ne disparaissent pas pour autant du simple fait que les systèmes de lecture automatique de plaques d’immatriculation aident parfois la police à élucider des crimes. » Reste que c’est « une chose qu’un agent de police voit votre voiture traverser un carrefour. C’est tout autre chose qu’un réseau de caméras enregistre discrètement chaque apparition de votre véhicule, stocke ces informations et les rend consultables dans le temps et entre différentes juridictions ». « La question est de savoir si le gouvernement devrait pouvoir exploiter des millions, voire des milliards, d’observations publiques ordinaires et légalespour en faire une carte détaillée et consultable des déplacements des personnes, sans aucun soupçon individualisé ni contrôle significatif».
« Supposons que des preuves plus solides finissent par démontrer que Flock prévient certains crimes. Je resterais néanmoins mal à l’aise avec ce compromis. La sécurité publique est importante, certes, mais ce n’est pas le seul critère essentiel dans une société libre. Le respect de la vie privée et l’autonomie sont tout aussi importants. Pouvoir vaquer à ses occupations quotidiennes sans que le gouvernement n’enregistre discrètement ses déplacements est fondamental. Les caméras de Flock ne se limitent pas aux personnes soupçonnées d’avoir commis des crimes. Elles collectent des informations sur tous les automobilistes qui passent devant elles, dont l’immense majorité n’a absolument rien fait de mal.
Bien sûr, ces informations peuvent être utiles à la police. C’est précisément ce qui rend la question si complexe. Presque n’importe quel système de surveillance peut améliorer la sécurité publique s’il fournit au gouvernement davantage d’informations sur nous. Installez suffisamment de caméras à des endroits stratégiques, conservez suffisamment de données et donnez-y accès à un nombre suffisant d’agences : tôt ou tard, ces informations contribueront à résoudre des crimes. L’argument selon lequel « le gouvernement pourrait trouver cela utile un jour » est un critère inacceptable pour déterminer le niveau de surveillance que les Américains sont prêts à tolérer. » Pour Pye, la surveillance omniprésente ne devrait pas devenir une composante normale de la vie américaine.
Pour The Conversation, le philosophe et criminologue de l’Institut catholique de Lille, Tony Ferri, rappelait que c’est la nature des systèmes de surveillance, quels qu’ils soient, de s’étendre (même si dans son article, il n’évoque pas les dispositifs de lecture automatisés des plaques d’immatriculation). « Un dispositif de contrôle naît pour une cible précise, dans un contexte qui rend son acceptation facile » (…) « puis, par la force de son infrastructure technique désormais disponible, il s’étend, se prolonge, se banalise, bien au-delà de sa justification initiale ». Pris isolément, ces solutions peuvent paraître légitimes. Mais, comme le disait la CNIL elle-même dans un avis de 2022 : « ces outils ne constituent pas une simple évolution technologique, mais une modification de la nature des dispositifs ». Un changement de nature et pas seulement de degré, face auquel nous avons pour l’instant bien peu de réponses pour en limiter la déflagration à l’encontre des libertés publiques.
Ah, oui, les systèmes LAPI se déploient également en France, même si pour l’instant, ce n’est pas avec la même intensité qu’aux Etats-Unis (on compterait 700 lecteurs en France mis en œuvre par la police nationale, la gendarmerie et les douanes, sans compter ceux des municipalités et des acteurs privés, comme les opérateurs de parkings et d’autoroute). Depuis 2024, un système de traitement central a été mis en place. En 2026, le récent projet de loi RIPOST renforce leur utilisation (par exemple à des fins administratives sans avoir à justifier d’une enquête spécifique), étend le régime d’infraction permettant leur consultation ainsi que la durée de conservation des informations à un an, comme s’en inquiétait, bien légitimement, la Quadrature du Net. La plateforme d’hypersurveillance des déplacements se porte bien chez nous aussi !
La journaliste de Bloomberg, Katrina Manson, a publié en mars un livre consacré au Project Maven : A Marine Colonel, his Team, and the Dawn of AI Warfare (Norton & Company, 2026, non traduit). Maven est le nom du programme d’IA développé par l’armée américaine pour faire la guerre (l’équivalent des programmes israélien que nous avons longuement évoqué dans DLA, notamment dans L’IA, ça sert, d’abord, à faire la guerre). Le livre raconte la bataille d’un officier des Marines, Drew Cukor, pour imposer le projet et convertir l’armée américaine aux promesses de la guerre automatisée.
On regrettera vivement que le livre soit parfois peu précis sur ce que fait et ne fait pas Maven. Si on y apprend toute son histoire, on n’apprend pas comment le système fonctionne concrètement, ce qu’il arme ni comment. Si le livre évoque longuement le travail sur certaines données, notamment les images et vidéos satellitaires et de drones, c’est au détriment de toutes les autres qui nourrissent aussi le tableau de bord pour faire la guerre, et notamment les données provenant des écoutes téléphoniques, de la surveillance et du renseignement. Son interface qui semble la plus grande réussite du programme à en croire Manson ne nous est jamais montrée.
Il faut comprendre que l’enquête de la journaliste porte plutôt sur le développement de projet agile au sein d’une bureaucratie contrainte et retorse. Si le livre propose une solide chronologie, Manson semble parfois rater certains enjeux au profit d’une ode à la persévérance et à l’innovation, comme fascinée par ce que Cukor et son équipe sont parvenus à imposer, dans l’adversité.
Lancé en 2017, le projet Maven est désormais pleinement opérationnel. Il est le projet fondateur du ciblage automatisé. S’il n’est que l’un des 800 projets IA de l’armée américaine utilisés sur les champs de bataille, Maven est devenu son système phare, déployé dans toutes les branches militaires américaines. Plus qu’un outil de ciblage sans précédent, Maven est une plateforme qui concentre les dispositifs de renseignement et d’opérations.
L’obsession de l’IA
Drew Cukor était officier dans les Marines à Kandahar en Afghanistan après les attentats du 11 septembre 2001. C’est là qu’il découvre les ordinateurs sur le terrain d’opération. Autant dire que sa déception est grande. A l’époque, les listes de cibles produites par le renseignement étaient enfermées dans des fichiers Excel. Chaque service avait ses propres outils d’analyse. Mais ces outils étaient inexploitables sur le terrain. Dès sa thèse dans le corps des marines en 97, Cukor défend que l’intelligence des machines est inutile si les soldats de terrain n’y ont pas accès. Pour lui, les ordinateurs doivent aider à transformer la donnée en intelligence pour l’action. En Afghanistan, puis à Bagdad en Irak, il constate que les ordinateurs sont inutiles aux soldats. Quand il devient le responsable du département du renseignement des Marines en 2010, son objectif est de réparer le renseignement et pour lui, cela signifie y déployer la plateforme de gestion de données proposée par une startup américaine, Palantir, dont il a apprécié la démonstration en 2009. In-Q-Tel, le fond d’investissement de la CIA a investi en 2005, 2 millions de dollars dans Palantir. A l’époque, Palantir n’est qu’un démonstrateur pourtant : il affiche des données provenant de nombreux silos du renseignement et permet de voir quel analyste y accède. Il garde la trace des changements et des indications que portent sur ces informations les agents. Une forme de wiki du renseignement permettant de discuter des informations, de les valider ou de les écarter. Parmi les données disponibles, il y a des appels téléphoniques et leurs transcriptions, des rapports d’interrogatoires, des images et vidéos… Et un système de requête permettant de trouver la trace d’informations dans toutes les informations disponibles pour les recouper. Palantir n’est qu’une interface qui permet d’afficher les données et de coopérer entre analystes sur des données qui proviennent du renseignement. Un tableau de bord.
Le rapport de la commission du 11 septembre a pointé les défaillances du renseignement et plus encore de matériel pour l’exploiter. Cukor partage le même avis. Pour Cukor, comme pour Thiel et Karp, les fondateurs de Palantir, les attentats de 2001 ont été un choc. Pour eux, le renseignement américain a échoué à empêcher le drame. Pour eux, l’IA est la réponse à apporter : elle a pour mission de transformer le renseignement et les opérations. Mais, les Marines, où Cukor travaille, est le plus petit des services de la Défense américaine et son département spécialisé dans le renseignement est encore plus insignifiant. Cukor décide néanmoins d’utiliser Palantir sur le terrain en Afghanistan, en 2011. Très rapidement, les officiers de terrain le trouvent utile. La Marine l’utilise pour déterminer des routes et des zones d’atterrissage. L’outil est pourtant très imparfait, mais il fait vite la démonstration de ses possibilités. Pour Cukor, comme il le défendra dans une note, la modernisation du renseignement militaire est clé : à l’avenir, l’analyse déterminera qui l’emportera sur le champ de bataille. Le but est d’accélérer et d’améliorer la décision avec l’aide de l’IA. A l’heure où Google fait rouler des voitures autonomes, pourtant, l’armée n’a pas ces outils dans son catalogue. Pas même de système cloud. Et ce quand bien « même si l’internet a été une création du Pentagon et qu’il dépense 38 milliards de dollars par an dans les nouvelles technologies »…. Pour Cukor, tout est à faire. Mais pour convaincre, estime le soldat, il faut des applications concrètes, qui collent au terrain, utiles sur site.
Cukor propose d’utiliser l’IA pour analyser les données des drones et améliorer l’information satellitaire. Cukor va visiter les entreprises qui produisent des voitures autonomes. En 2017, il rencontre IDenTV, une startup qui construit un modèle de vision par ordinateur pour drones, capable de repérer des objets sur une image. Le Congrès valide les fonds. Le projet Maven est lancé. Son ambition est tout de suite de faire du ciblage. Pour lui, l’IA doit aider à sélectionner et prioriser les cibles et aider à apparier la réponse appropriée. Pour lui, le département de la Défense ne devrait plus jamais acheter de systèmes d’armement sans IA intégrée. Son idée fixe est de créer une application de ciblage révolutionnaire et démontrer que l’IA peut « réduire la durée de la chaîne d’engagement entre la détection d’une cible et son traitement : repérer, localiser, neutraliser ». Pour lui, le département de la Défense doit fonctionner bien plus comme une entreprise logicielle que comme une usine d’armement pour être capable de traiter la donnée, actif capital du terrain.
Pour cela, Cukor se dote d’une équipe dédiée bien sûr. Tous semblent des avoir des profils atypiques, si l’on en croit Katrina Manson. Cukor, plus qu’un visionnaire, est plutôt décrit comme un psychopathe par certains d’entre eux. Un bourreau de travail, obsédé par sa vision. Manson délaye les commentaires des uns sur les autres…
Du côté de la création de Maven, elle explique que l’enjeu a été d’intégrer peu à peu des informations provenant de différents types de drones et notamment les images qu’ils produisaient, qu’il a fallu faire parler, analyser, pour que les systèmes reconnaissent des formes. Une gageure pas si simple, notamment pour les drones qui volent le plus haut, qui renvoient des images où les informations sont difficiles à identifier du fait même de l’éloignement. Certains motifs ne font parfois que quelques pixels. L’étiquetage des images pour l’entraînement des systèmes n’était pas simple, d’autant que ces images sont produites selon différents angles, altitudes… L’autre enjeu de Maven a consisté à construire l’infrastructure pour sécuriser ces données tout en donnant accès aux agents assermentés comme aux logiciels des entreprises privées. Dès le début Maven se conçoit comme un projet en partie ouvert aux industries de l’IA, notamment aux entreprises capables d’apporter les capacités de traitement et de sécurisation, celles capables d’apporter les logiciels d’analyses des flux vidéos, etc. Manson montre surtout que les capacités du renseignement américain ne reposent pas seulement sur les capacités techniques des agences, mais visent surtout à agencer des infrastructures sécurisées, capables de traiter les volumes de données et l’information, et délimiter les capacités d’action de chacun. La structuration a consisté à ce que le gouvernement s’occupe des données et loue les licences d’usages des systèmes, à charge de les intégrer sans que ceux-ci n’accèdent aux données et les intégrer aux lourds systèmes sécurisés de l’armée. Ces travaux ne se sont pas menés avec les grandes entreprises du secteur, mais plutôt avec de petits acteurs, comme Clarifai.ai ou Xnor… Peu à peu, les entreprises fourbissent des dizaines d’algorithmes d’analyses, certains pour identifier les visages, d’autres pour les images de drones ou satellitaires. Faire apprendre la reconnaissance de formes aux systèmes prend du temps.
L’enjeu pour Cukor était d’obtenir un démonstrateur utile sur le terrain, même si imparfait. Les premières démonstrations ont lieu en Somalie, 8 mois après le lancement de Maven. La démonstration n’est pourtant pas totalement concluante. L’écran se peuple d’indications de détection et toutes ne sont pas exactes (la moitié sont mêmes complètement fausses). La détection est lente. Mais l’IA montre qu’elle est capable de compter des humains sur un marché, de suivre des convois de véhicules en mouvement, de suivre des individus ciblés. Et puis, elle pointe des individus cachés dans des buissons qu’aucun humain n’avait détectés. L’IA venait de faire la démonstration de son utilité. Malgré ses défauts, l’exemple était saisissant.
Cukor va tenter de rallier nombre d’acteurs à ses projets. Notamment Google et sa filiale, DeepMind, forte de son succès au jeu de Go, alors que son patron, Demis Hassabis a signé une lettre ouverte en 2015 contre les périls à utiliser l’IA pour la guerre. Les approches de Cukor pour inviter à rallier son projet sont difficiles. Partout, des déclarations s’en prennent au déploiement de l’IA, à l’image des plus actifs et radicaux, les acteurs de Stop Killer Robots, lancé dès 2012. Alors que les dépenses militaires soutiennent des entreprises de la Silicon Valley depuis longtemps, les révélations d’Edward Snowden en 2013 ont refroidi l’ambiance. Une entité de Google finira par signer un contrat avec Maven, pour le stockage d’infrastructure, pour aider l’armée à construire son propre cloud. En mars 2018, ce contrat entre Google et Maven est rendu public, déclenchant une vaste contestation dans l’entreprise… jusqu’à ce que Google annonce son retrait du projet (ou son implication semblait surtout anecdotique, mais symbolique). Microsoft prendra sa place. Puis bien d’autres. En février 2025, Google remisera ses principes. Peu à peu, les entreprises vont se joindre au projet, au prétexte de prêter leur concours à la sécurité nationale. En 2025, Hassabis lui-même affirmera que « les valeurs démocratiques de l’occident sont menacées ». La plupart de ceux qui ont dénoncé les dangers de l’IA se sont rangés pour se mettre au service du marché des armées. Après le retrait de Google d’ailleurs, le projet Maven est renforcé : le programme obtient « l’exemption de sécurité nationale », lui permettant de ne pas répondre de ses actions. Son budget passe de 16 millions de dollars en 2018 à 93 en 2019. Sous la gouvernance de Cukor, le programme Maven aura englouti 1 milliards de dollars.
Un long processus d’amélioration
Maven de son côté étend son projet à d’autres enjeux que l’analyse des images de drones, pour y intégrer des contenus de caméras de sécurité et surtout, des analyses de textes, de contenus audios provenant de l’écoute des communications, de fichiers provenant de documents capturés à l’ennemi. La labellisation permet aux algorithmes de progresser et d’identifier de plus en plus correctement de plus en plus d’objets. Ses équipes se déplacent d’un terrain d’opération l’autre pour tester ses outils, notamment en Afghanistan, où l’équipe se rend compte qu’il faut améliorer les modèles car les données d’entraînement utilisées en Somalie ne fonctionnent pas aussi bien ailleurs. Pour l’instant Maven ne fait que de la détection, mais pour Cukor, l’enjeu est déjà de passer à la phase suivante : cibler. Quand les algorithmes de détection s’améliorent en Afghanistan, ils s’effondrent aux Philippines : les véhicules à détecter ne sont pas les mêmes, l’environnement non plus… À mesure que l’outil s’étend, le travail s’étend. L’enjeu à suivre des cibles est plus complexe que la simple détection… Malgré l’effort de détection, les frappes de drones sont loin d’être parfaitement sécurisées, les erreurs et les dommages collatéraux sont élevés. Mais surtout, Maven va peu à peu devenir ce pourquoi il est peut-être vraiment créé : pas seulement optimiser l’information, mais peut-être plus encore optimiser les ressources militaires, c’est-à-dire concentrer la puissance de feu pour qu’elle ait plus d’effets. L’IA pour faire la guerre est aussi, si ce n’est d’abord, un outil pour optimiser les ressources, décider de quelle arme employer… Maven semble un tableau de bord comme les autres : utilisé pour optimiser et contrôler les dépenses !
Au détour de son histoire, Mason raconte souvent l’obsession chinoise de l’armée américaine. A tous les niveaux, l’armée US semble convaincue que le prochain terrain d’opération sera une confrontation avec la Chine. Les américains sont convaincus que la Chine va reprendre Taïwan, plateforme de la construction des puces électroniques mondiales. Et l’armée américaine est convaincue que l’IA peut les aider à détecter l’offensive chinoise qu’ils attendent et contre laquelle ils se préparent.
Manson évoque bien sûr Palantir et son PDG, Alex Karp, « le dealer d’armes IA du XXIe siècle ». En quelques années, Palantir est devenu le premier fournisseur de systèmes de Défense au monde. « La seule façon d’être en sécurité pour les Américains, est de s’assurer que ses adversaires aient peur », clame Karp. Pour lui, les activistes de la paix sont une infection. Ses systèmes savent agréger comme nul autre toutes les données, tous les détails sur une carte permettant aux systèmes d’IA et aux analystes de tout voir et de tout planifier. En s’imposant peu à peu comme l’acteur incontournable des systèmes de Défense, Palantir a décroché un accord de 10 milliards de dollars avec l’armée américaine pour les multiples licences à utiliser ses outils. Elle est devenue l’une des entreprises les plus rentables du monde. En 2018, alors que Maven se déploie timidement, Cukor veut déjà aller plus loin. Il voudrait que Maven incorpore tous les systèmes que l’armée utilise pour devenir la plateforme unique, le tableau de bord de la guerre, et notamment, incorporer les vidéos dans sa carte pour permettre aux analystes d’avoir accès à toujours plus d’informations, simplement ou leur permettre de cliquer sur une cible pour que le système la trace et la détruise. Pour cela, Cukor estime qu’il faut intégrer l’IA plus avant, dans le flux de ciblage lui-même. Le problème, c’est qu’à l’époque, l’argent de Maven est destiné à l’intelligence, pas à l’opérationnel. L’armée dispose d’innombrables options logicielles et intégrer l’IA est encore hautement controversé. En avril 2018, Cukor rencontre Palantir et déploie sa vision des systèmes de Défense pour les 10 prochaines années. Il imagine une sorte de Google Earth appliqué à la guerre. Un tableau de bord rassemblant toutes les informations, les structurant, les rendant disponibles… et les analysant. Il demande à Palantir de réimaginer l’interface utilisateur qu’ils proposent avec Gotham, l’un de ses logiciels. De faire quelque chose sur mesure. Cukor va initier des discussions avec nombre de start-ups. En octobre, l’équipe de Maven installe Palantir sur ses serveurs. La communauté militaire est rapidement convaincue de l’apport, malgré les coûts, même si l’installation de Palantir rend Maven moins essentiel. Cukor insiste pour que tout soit profondément séparé, aucune donnée n’est autorisée à passer d’un système à l’autre. Si la protection des données semble assurée, d’autres critiquent le fait que le Pentagon construise des services en couches, comme des tranches de cake superposées. Mais Palantir ajoute une couche d’analyse sur Maven : « La nouvelle plateforme de Palantir superposait de la réalité augmentée aux flux vidéo, traçant des lignes de planification de mission aux couleurs vives sur les images pour désigner les itinéraires comme étant sûrs ou dangereux. Des cercles concentriques, appelés cercles de portée, rayonnaient depuis un site d’attaque potentiel sur la carte pour indiquer la zone où des victimes pourraient subir des dommages collatéraux. Cette superposition attribuait également des numéros à des bâtiments spécifiques, facilitant grandement la communication entre des équipes disparates. » L’interface rend le tableau de bord et les cartes plus lisibles. Dans l’équipe de Maven, plusieurs pensent que l’intégration de Palantir est problématique. Cukor fait entrer nombre d’autres entreprises dans Maven, bien avant les grands acteurs de l’IA que seront OpenAI ou Anthropic, pour développer des modèles pour analyser les images et les données.
Mason égraine les relations partenariales entre Maven et d’innombrables startups de la Valley. Leur flux, leurs reflux… Les avancées, les reculs, les hésitations.. Les luttes internes dans l’armée pour piloter les programmes d’IA, les guerres de territoires autour du partage de données qui permettent aux programmes de fonctionner. Beaucoup estiment que les protections imposées par Cukor sur les données restent son pire échec, empêchant leur partage entre différents services plutôt qu’empêchant les startups d’y accéder. La dernière partie du livre est toute entière autour de cette guerre de territoire entre différents services de l’armée. Derrière cette bataille interne, tout l’enjeu est de permettre non seulement de repérer, mais plus encore d’éliminer, de raccourcir la kill chain, comme l’ânonne chacun.
Reste que les débuts de ces intégrations n’en sont pas moins laborieux. « Les détections par IA semblaient initialement encore plus laborieuses avec le nouveau système de Palantir. Les détections apparaissaient sous forme de points si volumineux qu’ils masquaient les objets, rendant impossible la distinction entre adultes et enfants par exemple ». En octobre 2019, Maven est sur le front pour éliminer Abu Bakr al-Baghdadi…Trump est ravi de voir l’assassinat en direct, comme s’il regardait un film. 35 000 frappes contre l’Etat islamique sont déclenchées en même temps que le raid. Maven remplit son contrat. A nouveau, le système détecte des problèmes que les analystes n’avaient pas vu. « L’IA apparaît enfin capable de déchirer le brouillard de la guerre ». Même si les frappes sont loin d’être sans erreurs, comme le pointait la presse à l’époque. Entre 1437 et 8000 civiles seront tués en 5 années d’opération contre l’Etat islamique en Irak et Syrie, comme le révéleront les investigations de la NPR et du New York Times. L’armée américaine sera contrainte à mener une deuxième enquête après les contestations de la première pour éclaircir ce point, mais ses résultats ne seront jamais publiés.
Les défaillances de l’IA sont pour l’instant passées sous silence, mais nombre de civiles sont souvent confondus avec des combattants. L’IA ne distingue pas les bons des mauvais. Ce qu’il voit devient souvent une cible puisqu’il est conçu pour en produire. Pour les défenseurs de la généralisation de l’IA, l’IA n’est pas toujours en cause, renvoyant la responsabilité aux humains. Pour les prosélytes de ces systèmes, ils permettent d’accéder à plus de données que jamais pour mieux décider. Pour les journalistes, les victimes civiles sont toujours plus nombreuses que comptées dans les rapports de l’armée. Lors de l’opération Tempête du désert en 1991, 90% des bombardements manquaient leur cible, faute de précision. Désormais les erreurs proviennent bien plus des biais des systèmes, du défaut de contexte ou de l’ignorance. Pas sûr que ce soit plus rassurant. En 2015, l’armée américaine a bombardé un hôpital en Afghanistan faisant 42 morts : la faute à de mauvaises coordonnées et à des erreurs humaines, reconnaîtra l’armée.
Pour s’améliorer, Maven a capitalisé sur l’étiquetage des données pour mieux aider à entraîner ses systèmes et améliorer leur performance. La labellisation coûte de l’argent et prend du temps. En septembre 2020, avec l’aide de Palantir, Scale AI puis Enabled Intelligence, la labellisation devient un gros business pour ses acteurs : elle représente 708 millions de dollars de contrats pour l’armée, sans compter les 400 étiqueteurs de données, des militaires employés directement par Maven, qui disposerait désormais de quelques 100 millions d’images étiquetées. Une arme sur une épaule ne se distingue bien souvent que sur deux ou trois pixels. Mais une fois entraînés, les systèmes se révèlent meilleurs que les humains, puisqu’ils peuvent voir ce que les analystes ne peuvent pas voir. En fusionnant les données provenant d’innombrables sources (images, signal radio et électromagnétique…), tout l’enjeu est d’améliorer la détection d’objets qui ne sont pas visibles aux humains et de les faire apparaître sur la carte. Pour l’armée, l’IA n’identifie pas toujours des objets mieux que l’humain, mais elle les identifie avant et plus vite que l’humain.
La journaliste évoque encore la difficulté à sélectionner les armes appropriées, qui doit répondre à des contraintes nombreuses, de disponibilité, de temporalité et de communications. Ou encore, la difficulté à distinguer les combattants de ceux qui ne le sont pas. La Défense américaine se dote de documents de cadrage sur le ciblage, sans les publier.
Maven, la puissance brute
Alors que Drew Cukor a quitté le programme en octobre 2021, en février 2022, Maven est déployé en soutien à l’Ukraine en Allemagne. Ses capacités de détection, confrontées à un nouvel environnement, nécessitent à nouveau une mise à jour pour s’améliorer. A nouveau, les algorithmes doivent s’adapter aux données et les données être labellisées pour s’adapter aux terrains et aux objets de guerre locaux. L’Ukraine n’est pas le désert. Il faut identifier les systèmes russes, comme les Tracteur-érecteur-lanceurs russes. Cela ne prendra que deux semaines seulement. Maven fait la demonstration que son système est capable de s’adapter très rapidement.
L’armée américaine va très vite partager des informations avec l’Ukraine, mais sans leur donner accès à ses systèmes pour ne pas être accusée de participer à la guerre. Elle aide les analystes urkrainiens à regarder aux bons endroits. Depuis son QG allemand, Maven améliore son infrastructure cloud et sa connectivité pour éviter nombre de problèmes de latence. L’équipe transmet des cibles détectées à l’Ukraine, une trentaine par jour, 3 fois plus que ce qu’elle n’en voyait en Irak 5 ans plus tôt. La vitesse de la guerre a triplé en 5 ans, souligne Manson. Le nombre de détections ne va cesser de s’améliorer… Notamment en intégrant toujours de nouvelles données par exemple les interceptions de communications téléphoniques et radios russes, les explosions de missiles entendus via ces communications, les réseaux sociaux, comme les informations provenant de TikTok ou Twitter… « Les Etats-Unis deviennent les yeux de l’Ukraine ». Ils signalent également des points d’intérêts (jusqu’à 267 par jour en 2022) grâce à Maven. Mais l’enjeu n’est déjà plus l’identification de cibles, que les ressources en armes, missiles, munitions, drones…
La guerre devient une question de puissance brute. Alors que l’armée américaine envoie des ressources sur le terrain, Maven teste et évalue plus de 1500 algorithmes pour améliorer son système. L’Ukraine va permettre à Maven de s’améliorer encore. Maven permet à l’armée ukrainienne de voir plus loin que le front. Après avoir progressé sur les cibles fixes, Maven s’améliore sur les cibles dynamiques. La communication s’améliore. Les ukrainiens sont désormais capables de détruire des cibles 18 minutes après que les Américains les leur aient communiqué. En 2024, l’Ukraine a détruit plus de 2600 tanks russes et plus de 5000 véhicules armés. Pour l’armée US, le soutien à l’Ukraine a permis d’engranger d’innombrables progrès. Le succès de Maven ne repose pas seulement sur ses algorithmes, mais bien plus sur ses données et la façon dont les flux s’interconnectent. Les systèmes sont désormais capables d’identifier un objet dès qu’une seule image se présente. Ils font encore des erreurs, peuvent ne pas tout voir, mais savent désormais repérer des objets, même avec peu de données d’entraînements. En 2024, l’armée américaine ne fait plus passer qu’une douzaine de points d’intérêts par jour à l’armée ukrainienne. Mais c’est d’abord parce que celle-ci a également énormément progressé et a bien moins besoin de l’aide américaine. Les taux d’erreurs se réduisent selon les chiffres de l’armée. La précision s’améliore. L’armée russe a utilisé des faux marqueurs sur le terrain, pour tromper les modèles de détection satellitaires, mais Maven a vite appris à les distinguer. Les données sont devenues le nerf de la guerre. Leur intégration de plus en plus rapide fait la différence. Maven est un système adaptable, qui se met à jour rapidement, comme un logiciel, explique Manson. « Il peut produire ce dont le commandement a besoin ». Sous le commandement de Whitworth, Maven est devenu un projet public, qui a quitté le secret. Le tir est désormais prêt à être entièrement automatisé. Au printemps 2025, le contrat du Pentagon pour Maven Smart System est passé à 1,3 milliards de dollars. Celui de Palantir à 480 millions de dollars.
Les machines combattent les machines. La NSA écoute le monde entier. Et désormais, la NGA le regarde. Elle observe le globe en permanence. « En 2024, le commandement alimentait le système intelligent Maven avec 179 flux de données en temps réel provenant des domaines terrestre, maritime, aérien, spatial et cybernétique. » Désormais, les opérateurs qui utilisent Maven approuve ou désapprouvent le ciblage depuis le tableau de bord de ciblage fourni par Palantir, déterminent les priorités, hiérarchisent les ciblages, et envoient directement des messages aux systèmes de tirs. La kill chain est effectivement devenue bien courte. « Une cible peut désormais passer de détectée à engagée en quelques minutes, contre plusieurs heures auparavant ». Maven sait désormais détecter et tracer les missiles ennemis en temps réel et travaille à prévoir là où ils vont frapper. 32 entreprises différentes travaillent sur le programme Maven, 25 000 personnes l’utilisent. Il a accumulé plus d’un milliard de détection d’objets. Depuis 2024, Northcom et le Norad l’utilisent.
L’adoption de Maven est totale. Il est utilisé pour faire de la détection de franchissement de frontières aux Etats-Unis ou pour surveiller le trafic de drogue dans les Caraïbes. La garde nationale l’utilise pour surveiller les départs de feux. Les promoteurs de Maven comme ceux de Palantir estiment que Maven n’est pas un système d’armement, que valider une cible ne déclenche pas le largage d’une munition sur celle-ci. Mais cette défense semble de plus en plus une parade argumentative. Le système apparie les munitions aux cibles et propose une priorisation des cibles que les analystes peuvent certes aménager…
Pour certains militaires, Maven nécessiterait une doctrine d’usage. Ce que montre Katrina Mason dans ses conclusions, c’est que pour l’instant, la seule doctrine consiste à l’utiliser. « L’IA dotée d’une capacité d’action autonome va non seulement complexifier le projet Maven et l’usage général de l’IA dans la guerre, mais aussi la rendre plus opaque pour l’utilisateur. Elle va également accélérer le rythme des conflits et en amplifier l’ampleur ; par ailleurs – et en dépit des arguments vantant le potentiel de désescalade de l’IA – elle risque de rendre la guerre plus probable. »
L’ajout de LLM dans Maven, via Palantir et d’autres entreprises, comme OpenAI ou Anthropic, a pris du temps. Les premières tentatives ont été déceptives. Elles semblent surtout utilisée pour développer des prototypes de campagne et pour planifier des décisions militaires. Mais leur usage est pour l’instant observé avec défiance, estime Mason, notamment par crainte qu’ils empoisonnent les systèmes. Cela n’empêche pas leur intégration de s’étendre, même si on connaît fort mal la manière dont l’IA générative est utilisée.
L’obsession de l’autonomie, la réalité de l’escalade
Katrina Mason termine son livre en revenant sur les propos d’Antonio Guterres, le secrétaire général des Nations Unies, qui souhaite interdire le recours aux armes autonomes et qui s’inquiète du développement de l’IA dans le domaine militaire. La balance est pour l’instant difficile à faire, par manque d’information sur les systèmes et leurs conséquences. L’IA dans la guerre permet-elle de limiter les dommages collatéraux et les victimes civiles ou de les étendre ? Toutes les armées qui déploient ces systèmes assurent garder la main : qu’il y a toujours un humain pour valider les décisions de l’IA, mais on sait que cela tient d’une fable plus que d’une réalité. Le contrôle humain tient d’un slogan vague et mal conçu. Les systèmes embarquent les biais du renseignement avec eux et peuvent mal identifier les personnes depuis les lacunes des systèmes de reconnaissance. La Convention sur le contrôle des armes (CCW GGE) discute depuis 2014 du problème des armes autonomes. Pour Mary Wareham, longtemps responsable de la question de l’armement à Human Rights Watch, l’une des initiatrices de Stop Killer Robots, nous devrions pousser les Etats à signer un traité pareille à celui de la réduction des mines antipersonnelles. Mais pour Cukor, comme pour l’armée américaine, le risque vient bien plus du risque de développement d’armes autonomes par ses ennemis. L’armée est plus inquiète de sa capacité à neutraliser une attaque que de réguler les siennes. Pour l’administration Trump, l’IA est une contribution essentielle et positive à la guerre en tout point, comme si les critiques n’avaient aucune voix au chapitre. Si la Chine semble plus modérée sur le développement d’armes autonomes, c’est certainement pour ralentir l’avancée américaine, explique Katrina Manson, qui semble avoir été contaminée par la perspective de guerre avec la Chine. Mais plus encore que l’autonomie, le déploiement de l’IA dans les conflits risque de conduire à l’escalade, comme l’expliquait un groupe d’experts de l’ONU.
Pourtant, au terme du livre de Manson, on ne sait toujours pas très bien comment les résultats sont générés. Pour cela, nous ne disposons que d’une poignée d’images très rarement distillées, comme dans cette vidéo récente, relayée par le journaliste Dan Israel dans un article pour Mediapart soulignant l’emprise de Palantir sur l’armée américaine.
Ce que l’on y voit semble tenir d’une forme de jeu vidéo, un outil de simulation qui ne simule pas, où chaque paramètre semble appréciable, mais où nombre de décisions sont automatisées, proposées pour validation, choisies par le système.
En mai 2025, le directeur de l’unité d’innovation pour la Défense américaine, Doug Beck, expliquait que l’Ukraine consommait 4000 drones par jour (autant que ce que le département de la défense achetait en un an). L’Ukraine a produit 3 millions de drones en 2025, un million de plus de ce qu’elle produisait en 2024 (voir notre article sur le sujet). Pour chaque drone commercial fabriqué aux Etats-Unis, la Chine en produit 100 de plus, rappelle Manson. Dans son budget 2026, le Pentagon prévoit de dépenser 13,4 milliards pour des systèmes autonomes, dont le Replicator, un avion de chasse sans pilote. Face à ces perspectives, les Etats-Unis souhaitent reconstruire leurs capacités industrielles militaires. Plus facile à dire qu’à faire.
Chez JP Morgan, Drew Cukor ne s’intéresse plus à mettre de l’IA dans les armes, mais dans la finance (pas sur que ce soit plus rassurant). Les modèles d’IA vont permettre de redéfinir le fonctionnement des prêts, des hypothéques, des cartes de crédit, des placements, s’apprêtant à « turbocharger » l’économie, tout en contournant la conformité et les régulations établies, au risque là encore des biais, des erreurs et de l’injustice.
Le débat sur la moralité de la guerre reste entier. Pas sûr que l’autonomie ne nous aide à la faire progresser, bien au contraire. Si l’armée semble prendre l’éthique au sérieux, il y a de quoi être cynique. L’IA renforce la distance des combattants à l’acte de tuer, mais risque également de les éloigner de la décision de tuer. Ce double mouvement échoue à reconnaître l’humanité de l’opposant, qui est de plus en plus mise à distance. « Les outils d’IA risque d’abord de désensibiliser les combattants et l’armée, d’actes dont nul ne sera plus responsable », s’inquiète la journaliste. L’IA devrait pouvoir minimiser les erreurs et les dommages collatéraux, mais ce qu’on en voit pour l’instant, c’est qu’elle fait surtout s’envoler le volume de dommages plutôt qu’elle ne le réduit. La technologie rejoue le paradoxe de Jevons : « les technologies qui améliorent l’efficacité et abaissent les coûts conduisent invariablement à l’augmentation de leur consommation ». Les systèmes d’IA produisent plus de cibles, plus vites et rendent plus facile leur élimination. Les cibles générées par une boîte noire rendent le commandement trop sûr de lui. Ces systèmes transforment la guerre en jeu vidéo. De partout, il simplifie la destruction. L’ennemi est désormais plus facile à tuer qu’à capturer. Ces systèmes ne font aucun prisonnier. Ils ne proposent aucune clémence. Le paradoxe de Jevons nous le dit depuis longtemps : « plus quelque chose est efficace, plus vous allez avoir tendance à l’accomplir ». Pire, termine-t-elle. Non seulement cette technologie peut faire des choses horribles, mais les garde-fous peuvent également être facilement ajustés voire enlevés, comme le montrait Lavender, l’équivalent de Maven pour l’armée israélienne, où le nombre de victimes collatérales d’un tir pouvait être abaissé ou relevé, au gré des besoins de la guerre. Pour Mark Milley, l’ex chef d’Etat major de l’armée américaine, le champ de bataille sous IA ouvre une boîte de pandore… Les atrocités ne vont pas disparaître avec l’IA, rappelle Manson. Pour un autre gradé américain, le champ de bataille prend le tournant de l’autonomie, mais ce n’est pas parce qu’on est capable de le faire que nous devrions y aller. Trump a renommé le ministère de la Défense en ministère de la Guerre. En septembre 2025, Pete Hegseth, secrétaire de la Défense américain, devant tous les généraux de l’armée US, a affirmé vouloir plus d’IA partout et plus du tout de contraintes d’engagement excessives.
40 millions de personnes sont mortes durant la Première Guerre mondiale. 85 durant la seconde. Maven est désormais partout. Dans tous les services sur tous les continents. Jusqu’aux outils des alliés de l’Amérique. L’IA est désormais au cœur de toutes les opérations militaires américaines. Les mavenites sont pour la plupart partis dans d’autres entreprises du complexe techno-militaire américain, et notamment les entreprises d’IA qui rend Maven désormais puissant : Palantir, Microsoft, Anduril, OpenAI. La Maven mafia est partout.
Mais surtout, ces systèmes reposent d’abord sur une surveillance invisible et sans limite aucune, au prétexte d’obtenir toujours plus de données pour optimiser toujours plus ses cibles et ses frappes. Le succès de l’IA repose sur une surveillance toujours plus totale, sans limite ni garde-fous. C’est l’éléphant dans la pièce de l’autonomie. Celle d’une surveillance de tous sans limite.
C’est à nouveau la grande limite du livre pourtant très documenté de Katrina Mason. La journaliste semble passer à côté de ce à quoi elle n’a pas eu accès, malgré la profondeur de son enquête. C’est pourtant dans ce qu’on ne voit pas dans ce livre que se cache le monstre à venir. Un monde qui rêve d’assurer sa sécurité sans plus aucune limite quand bien même pour cela il serait finalement surtout prêt à se détruire lui-même, dans un impérialisme sans limite, dans un autoritarisme sans plus aucune contrainte.
L’effondrement de l’information a-t-il eu lieu ? En tout cas, la submersion des contenus par l’IA générative qu’annonçaient de nombreux médias au début de la campagne électorale américaine n’a semble-t-il pas eu lieu, ou pas comme on l’a escompté, explique Matteo Wong pour The Atlantic. C’est ce qu’explique un trio de chercheurs de l’université de Purdue, Christina Walker, Daniel Schiff et Kaylyn Jackson Schiff, qui ont collecté les images et vidéos politiques générées par l’IA depuis juin 2023. Les contenus générés par l’IA durant la campagne électorale ont été nombreux, mais ils ont surtout été utilisés sous forme de satire ou de divertissement que comme outils de désinformation. Leur usage a été bien plus transparent qu’attendue. Les images étaient fausses mais ne faisaient pas semblant d’être vraies.
Reste qu’on mesure mal l’impact de ces partages, modèrent les chercheurs. « Ces images et vidéos générées par l’IA sont instantanément lisibles et ciblent explicitement le partage d’émotions plutôt que les informations (…). » Ces images ont peut-être finalement très bien accompagné la disparition des faits, du consensus et de la rationalité. Elles ont d’abord permis de faire primer l’émotion sur la rationalité dans un moment où la vérité était particulièrement malmenée… mais d’abord par les discours politiques eux-mêmes.
MAJ du 21/11/2024 : « L’IA semble avoir moins contribué à façonner la façon dont les gens ont voté et bien plus à éroder leur foi dans la réalité », rapporte le Washington Post. Elle a été plus utilisée pour consolider les croyances partisanes que pour influencer les mentalités, brouillant la réalité. Des chercheurs de l’Institute for Strategic Dialogue ont constaté que les utilisateurs croyaient plus souvent que le contenu authentique était généré par l’IA que l’inverse. Nous sommes bien plus dans une crise de la réalité que dans une crise de désinformation.
Les organismes de réglementation ont visiblement compris qu’ils doivent réglementer la manière dont les autorités utilisent les algorithmes et les technologies d’IA. Mais ce que les régulateurs oublient trop souvent quand ils élaborent des politiques, c’est de tenir compte de la manière dont les décideurs humains interagissent avec les systèmes, explique Ben Green (@benzevgreen) dans une tribune pour The Hill (@thehill). Chercheurs, journalistes, militants… n’ont cessé ces dernières années de révéler combien les systèmes algorithmiques utilisés par les tribunaux, la police, les services d’éducation, de protection sociale et autres, sont bourrés d’erreurs et de biais. Aux États-Unis, deux projets de loi proposent d’imposer aux administrations d’évaluer les algorithmes avant de pouvoir les utiliser. Le projet de loi sur l’IA de la commission européenne va dans le même sens. Mais, souligne Green, si examiner les systèmes est certes nécessaire, ces dispositions oublient la manière dont les prédictions affectent les décisions politiques.
Les outils d’aide à la décision améliorent-ils la décision ?
Bien souvent, les algorithmes sont proposés comme des outils d’aide à la décision aux personnes qui les prennent. Reste que leurs décisions doivent équilibrer les prédictions que les systèmes fourbissent avec d’autres objectifs concurrents qui ne sont, eux, pas pris en compte par les machines. Green prend l’exemple des systèmes d’évaluation des risques qu’un prévenu ne se présente pas à son procès, très utilisé par les tribunaux américains. Pour ceux en charge de juger les prévenus, ces prévisions, pour autant qu’elles soient précises et justes – ce dont doutent nombre de défenseurs des droits et de chercheurs qui les ont étudiés -, doivent s’équilibrer d’autres intérêts, comme la présomption d’innocence. Pour Green, la question centrale qui est très souvent oubliée n’est pas seulement de savoir si les prédictions sont justes, mais aussi et surtout, de savoir si ces systèmes améliorent la décision humaine. Or, même si ces systèmes proposent des prédictions, ils n’améliorent pas nécessairement la décision. Quand on leur présente ces évaluations, bien souvent, les humains ont tendance à être plus attentifs au fait de réduire le risque justement, au détriment d’autres valeurs, changeant la manière même dont ils prennent leurs décisions, explique Green à la suite d’une étude expérimentale. Dans la pratique, ces systèmes imposent leurs choix, leur angle, leur vision… d’une certaine manière, leur idéologie. Reste que trop souvent, leur premier effet est d’altérer les processus de prise de décision. Même si dans l’étude de Green, les effets de ces outils semblent assez faibles, ils n’en sont pas moins là (et ce d’autant que l’altération de la décision est difficile à apprécier). Dans le domaine judiciaire américain, plusieurs études ont montré que les juges ont tendance à passer outre les recommandations de remises en liberté que proposent ces outils ! En fait, les juges semblent devenir plus sévères que les systèmes, parce que les systèmes leur mettent sous les yeux le risque plutôt que l’esprit des lois, comme la présomption d’innocence. En fait, les systèmes aggravent la partialité des juges en les rendant sur-attentifs aux risques !
Dans un autre article de recherche, Green souligne un autre problème, celui de la surveillance humaine des décisions algorithmiques que de plus en plus de réglementations imposent. Or, explique le chercheur, derrière ces décisions, bien souvent, les personnes sont incapables de remplir les fonctions de surveillance qui leur sont attribuées. Green estime par exemple que nous devrions calculer le taux de dérogation c’est-à-dire quand la décision n’est pas conforme à la suggestion de l’algorithme pour savoir si le processus décisionnel est automatisé ou pas.
Cette surveillance des systèmes trop souvent légitime le recours à des algorithmes défectueux, sans aborder réellement les problèmes qu’ils génèrent. Pour le chercheur, la surveillance des algorithmes donne un faux sentiment de sécurité. Pour Green, il est essentiel de s’interroger d’abord sur la nécessité du déploiement et surtout d’évaluer l’efficacité du contrôle humain des traitements, explique-t-il en rappelant la nécessité d’une meilleure évaluation, non seulement technique, mais plus encore humaine. Les politiques se doivent d’être plus rigoureuses, estime-t-il, et surtout, elles ne doivent pas seulement étudier les biais techniques des systèmes, mais aussi prendre en compte la relation homme-algorithmes et les biais qu’elle génère.
Or, rappelle le chercheur, les réglementations sur l’éthique des systèmes se concentrent uniquement sur la façon dont le calcul fonctionne. Les systèmes d’évaluation de la responsabilité algorithmique ou d’impacts évaluent une responsabilité « technique » plus qu’humaine, sans tenir compte des relations tissées avec les systèmes.
Aussi précis ou juste que le calcul soit – et il ne l’est pas souvent -, il modifie la façon de décider. En fait, ces outils génèrent des changements qui déséquilibrent l’évaluation qui est au cœur même de la prise de décision. Pour Green, la question de l’évaluation de l’IA devrait nécessiter des preuves empiriques sur ses effets, c’est-à-dire qu’elle devrait également démontrer que ces systèmes sont susceptibles d’améliorer la prise de décision. Pour cela nous devrions réaliser des évaluations expérimentales sur la collaboration homme-algorithmes, en testant comment les gens interagissent avec le système pour s’assurer qu’il produit les résultats escomptés.
Evaluer les outils de la décision, mais également la décision
L’évaluation est trop souvent encore le parent pauvre de la réglementation. Au mieux, elle reste technique. Mais bien souvent, elle reste aveugle aux impacts concrets de ces outils sur ceux qui les utilisent, suggère Green qui invite à non seulement évaluer les outils de la décision, mais également leurs impacts sur la décision.
PS : Sur LPE, Frank Pasquale annonce la tenue prochaine aux Etats-Unis d’un symposium sur l’analyse coût/bénéfice. Les méthodes quantitatives promettent d’apporter la rigueur et l’objectivité à l’évaluation des politiques publiques, mais dans les faits, leurs applications accélèrent souvent les injustices et les discriminations. Dès janvier 2021, l’administration Biden a annoncé vouloir « moderniser les modalités d’évaluations réglementaires ». Les initiatives réglementaires importantes sont de plus en plus souvent sommées de produire une analyse comparative de leurs coûts et avantages. Si ces initiatives semblent rationnelles (les coûts d’une réglementation ne doivent pas dépasser ses avantages), ces outils ont souvent été utilisés pour limiter la réglementation plutôt que pour améliorer son efficacité. Enfin, souligne Pasquale, tout est-il quantifiable ? Quelle est la valeur monétaire d’une journée sans aucune pollution au Grand Canyon ou d’une ressource naturelle ? À nouveau, la quantification n’a rien de neutre et ne peut être le seul mode d’évaluation des politiques publiques.

 Connexion