❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierinformatique général
  • ✇Korben
  • DOOM - Le moteur de 1993 bouffé par DLSS 5
    Dans la série des trucs qui ne servent à rien, mais qui sont bien cools quand même, je vous présente ce bon vieux DOOM de 1993 qui vient de passer au DLSS 5. L'auteur de cette nouvelle prouesse, c'est Nikolai Zhivotenko qui a publié DOOM + DLSS 5 , un port Windows 64 bits de Linux DOOM 1.10 qui conserve le moteur d'origine. Le jeu produit ainsi toujours son image en 320x200 pixels, puis celle-ci est reconstruite dans une fenêtre de 1280x800 en Direct3D 12 par l'upscaler de votre c

DOOM - Le moteur de 1993 bouffé par DLSS 5

Par : Korben ✨
7 octobre 2026 à 17:39

Dans la série des trucs qui ne servent à rien, mais qui sont bien cools quand même, je vous présente ce bon vieux DOOM de 1993 qui vient de passer au DLSS 5. L'auteur de cette nouvelle prouesse, c'est Nikolai Zhivotenko qui a publié DOOM + DLSS 5 , un port Windows 64 bits de Linux DOOM 1.10 qui conserve le moteur d'origine. Le jeu produit ainsi toujours son image en 320x200 pixels, puis celle-ci est reconstruite dans une fenêtre de 1280x800 en Direct3D 12 par l'upscaler de votre choix.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Un upscaler moderne ayant besoin d'autre chose que des pixels pour travailler, le moteur modifié doit inscrire à chaque image la profondeur, les normales et le mouvement, et les touches F2 à F4 affichent ces trois vues à la place du jeu.

L'auteur en a même fait un petit banc d'essai, avec un exécutable par mode : DLSS Ray Reconstruction, DLSS Super Resolution en preset K (DLSS 4) ou L (DLSS 4.5), FSR 2.2 d'AMD, Anime4K, et le bon vieux nearest 4x pour comparer. Ray Reconstruction se contente d'ailleurs de buffers factices (spéculaire noir, rugosité à 1), puisque DOOM n'a aucun éclairage path-tracé à lui donner.

Un couloir de DOOM avec l'étiquette "DLSS 5 On" en bas à gauche et trois vignettes de données en haut de l'image (capture fournie par l'auteur du port)

Et le DLSS 5 dans tout ça ?

Eh bien le mode 5 commence par la même passe que le 4.5, avec le SDK officiel de NVIDIA et ensuite seulement, si l'addon RenoDX du DLSS 5 est placé à côté de l'exécutable, une seconde passe laisse le Neural Rendering retoucher l'image. Et ce Neural Rendering là ne vient pas du port mais de DLSS5-Swapper , un outil communautaire sous licence MIT qui injecte le modèle de NVIDIA dans les jeux. Bref, c'est indispensable comme addon pour passer d'un rendu 4.5 à un rendu 5.

Côté NVIDIA, le DLSS 5 dont je vous parlais en mars n'est sorti que le 3 septembre, avec NBA 2K27, sur les RTX 50 et GeForce NOW mais il avait fuité juste avant via des fichiers trouvés dans une mise à jour de ce même jeu. Du coup, les moddeurs l'ont collé dans The Witcher 3 ou Cyberpunk 2077 sans attendre.

Quant au résultat sur DOOM, n'espérez pas avoir du photoréalisme... niet, le modèle n'a pas été pensé pour des sprites en 320x200, et d'après Wccftech, certains détails reconstruits peuvent même ressortir plutôt bizarrement...

Une créature face au joueur, avec la même étiquette "DLSS 5 On" et mêmes vignettes en haut (capture fournie par l'auteur du port)

Maintenant pour tester, il vous faudra un Windows 64 bits, une GeForce RTX, et compiler tout ça vous-même avec le script build.cmd du dépôt. Vous déposez un IWAD dans le dossier wads (celui de Freedoom fait l'affaire), puis vous déclarez le dossier du mode 5 dans Swapper , en route Native. Côté carte, Swapper annonce les RTX 20 à 50 pour ses routes à base de ReShade, dont fait partie l'addon RenoDX , mais prévient quand même que la compatibilité n'est pas garantie.

Et si vous voulez juste comparer, le script screencast-windoom.cmd rejouera la même démo dans chacun des modes et peut même exporter chaque image en PNG.

Amusez-vous bien !

  • ✇Korben
  • DLSS 5 sur Radeon, ça fonctionne
    DLSS-NR on AMD est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD. Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer.

DLSS 5 sur Radeon, ça fonctionne

Par : Korben ✨
29 septembre 2026 à 12:50

DLSS-NR on AMD est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD.

Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer. Nvidia l'a mis en place sur NBA 2K27 en partenariat avec Visual Concepts et 2K, alors que le mod DLSS-NR on AMD l'applique déjà à Cyberpunk 2077, qui n'a pourtant pas été conçu pour ça. Je me rappelle quand même que la démo du DLSS 5 avait été très mal accueillie en mars parce qu'elle donnait l'impression d'écraser la direction artistique des jeux mais on dirait que ça passe un peu mieux aujourd'hui... Soit les gens se sont habitués, soit le logiciel fait du meilleur taf, je ne sais pas.

D'après le README du projet, pour installer ça sur votre ordi, vous devez placer le programme d'install de la dernière release dans le dossier de l'exécutable du jeu (bin\x64 pour Cyberpunk 2077), à côté d'une DLL de Nvidia . Ensuite vous le lancez, puis vous démarrez le jeu et activez le FSR. La touche Fin ouvrira alors l'overlay du mod, et si vous voulez mettre à jour tout ça ou le virer, il suffit de relancer l'installateur.

Il faut aussi Windows 11 et le pilote Adrenalin 26.1.1 ou plus récent et comme les jeux avec anti-triche bloquent la DLL, vaut mieux pas vous lancer en multi avec ce mod.

Par contre, sachez-le, les résultats en termes de FPS ne sont pas toujours au rendez-vous si j'en crois les benchmarks publiés sur les pages du projet.

Maintenant à vous de voir si vous faites confiance à ce mod puisque le code n'est pas publié. Notez que 2 autres projets similaires pourraient également vous intéresser... Il y a lmxxf , sous licence MIT qui se limite aux RX 9000 et embarque les poids de Nvidia extraits d'une copie locale de la DLL. Et aussi AMDNR de 3zwr1 qui est intégré à OptiScaler.

Mais en tout cas, si vous essayez DLSS-NR on AMD sur une RX 7000, sachez que son auteur demande des retours donc n'hésitez pas à lui envoyer votre fichier dlssnr_on_amd.log si vous rencontrez des bugs.

Source : Tom's Hardware

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 36 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Courrier international] DJ, cocktails et open source: aux États-Unis, des ateliers de cybersécurité se tiennent dans des bars (€) [L'usine Nouvelle] Nvidia confirme acquérir la plateforme de modèles d’IA Hugging Face:

Revue de presse de l’April pour la semaine 36 de l’année 2026

Par : echarp
7 septembre 2026 à 12:21

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Courrier international] DJ, cocktails et open source: aux États-Unis, des ateliers de cybersécurité se tiennent dans des bars (€)

✍ Ellen Ioanes, le samedi 5 septembre 2026.

Après plus d’une décennie de scandales ayant mis en lumière la surveillance numérique de masse à laquelle ils sont exposés, de plus en plus d’Américains se disent inquiets pour leur cybersécurité. Pour apprendre à “reprendre le contrôle de leur vie numérique”, des ateliers, conférences et soirées festives se multiplient dans les grandes villes, raconte le journal britannique “The Guardian”.

[L'usine Nouvelle] Nvidia confirme acquérir la plateforme de modèles d’IA Hugging Face: un rachat pour défendre l’open source… et servir ses intérêts commerciaux

✍ Marion Garreau, le jeudi 3 septembre 2026.

Nvidia, le leader mondial des puces pour l’IA, a confirmé jeudi 3 septembre l’acquisition du franco-américain Hugging Face, une plateforme de distribution de modèles d’IA, pour 12,9 milliards de dollars. Un rachat qui renforce la stratégie dans l’open-source du mastodonte américain, et qui vient aussi servir ses intérêts commerciaux.

Et aussi:

[Silicon.fr] Open source et secteur public: pourquoi ce n'est pas si facile

✍ Clément Bohic, le mercredi 2 septembre 2026.

Les auditions de la commission parlementaire sur les dépendances numériques ont témoigné des défis que pose, dans la sphère publique, le déploiement de l’open source.

[Le Monde.fr] ChatGPT va être la première IA soumise à des règles renforcées au sein de l’Union européenne, Roblox et Reddit également concernés

Le lundi 31 août 2026.

Les trois services disposent de quatre mois, soit jusqu’à la fin décembre, pour se ‌conformer aux obligations ‌supplémentaires prévues par le Digital Services Act.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • ffmpeg - Doubler le framerate d'une vidéo avec votre GeForce
    Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde. La cadence de sortie se paramètre, donc vous po

ffmpeg - Doubler le framerate d'une vidéo avec votre GeForce

Par : Korben ✨
1 septembre 2026 à 14:00

Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.

La cadence de sortie se paramètre, donc vous pouvez aussi faire du 25 vers du 50, du 30 vers 60, ou n'importe quelle valeur intermédiaire. C'est donc beaucoup plus souple que le filtre équivalent côté AMD, frc_amf, qui ne sait que doubler la fréquence et ne fonctionner qu'en DirectX...

Fabriquer ce genre d'images intercalaires n'a rien de neuf, cela dit... L'outil RIFE convertissait déjà du 24 fps en 96 en 2020. Mais ce qui change ici, c'est qu'il n'y a plus de chaîne externe, plus d'aller-retour par des milliers de PNG, puisque tout tient dans le graphe de filtres, entre le décodage et l'encodage.

Le filtre logiciel historique de ffmpeg, minterpolate, existe pourtant depuis des années mais c'était loin d'être du temps réel. Alors que là, le vrai gain avec cette nouvelle feature, c'est qu'on passe en full temps réel. Ça veut dire que sur un catalogue à réencoder, l'interpolation cesse d'être l'élément qui bloque toute la chaîne de conversion.

Pour l'essayer il vous faut une RTX 30 ou plus récente. Il faut aussi compiler une version de développement car ce filtre est arrivé après la sortie de ffmpeg 9.0, ce qui veut dire que pour le moment, il n'est dans aucune release et ne sera dans aucun paquet avant la prochaine.

La commande suit ensuite le motif habituel des filtres Vulkan, qui veulent les images en mémoire GPU :

ffmpeg -init_hw_device vulkan=vk:0 -filter_hw_device vk -i entree.mp4 -vf "format=yuv420p,hwupload,fruc_vulkan=fps=60,hwdownload,format=yuv420p" sortie.mp4

L'auteur du filtre prévient quand même qu'en 2160p24, les réglages par défaut ne suivront pas en temps réel et qu'il faudra alors descendre la qualité d'estimation du mouvement. Ça s'écrit comme ceci :

fruc_vulkan=fps=60:perf=medium:grid=2

En traitement par lots maintenant, la question ne se pose pas, c'est juste plus lent.

Maintenant, les pros de l'encodage, redescendez de votre chaise parce que j'ai quand même quelques mauvaises nouvelles... Tout d'abord, on n'a aucune stat indépendante sur le débit ou la qualité. Et il y a aussi un défaut que l'auteur du patch documente lui-même... En fait, dans les zones sans texture, le moteur invente un mouvement faux mais cohérent, qui laisse des "fantômes" autour des objets. La parade existe heureusement, mais c'est une heuristique, qui demande quelques réglages à la main sur des échantillons.

Et il y a aussi un coût qu'on oublie... Car doubler la cadence, c'est donner deux fois plus d'images à avaler à l'encodeur, donc, il y a toujours une espèce de goulot d'étranglement. Et puis après il y a le rendu... un film de cinéma en 24 images par seconde qu'on monte à 60 prend immédiatement un aspect téléfilm que les cinéastes détestent !! Imaginez l'Odyssée de Nolan avec l'aspect visuel de Plus Belle La Vie... Ahahaha. Après sur de l'animation ou un ralenti, ça se défend bien sûr mais sur du cinéma, c'est un choix à prendre et pas une amélioration. En tout cas, c'est mon avis.

Ah et dernier point, parce que la confusion est déjà partout dans les commentaires sur le net : Tout ça se passe à l'encodage ! Je répète : A L'ENCODAGE ! Le fichier qui sort de ffmpeg est une vidéo NORMALE. Absolument personne n'aura besoin d'une carte graphique GeForce pour la regarder ! OK ? 😘

Source : Phoronix

  • ✇Korben
  • Nvidia s'offrirait Hugging Face pour 12,9 milliards
    Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche. Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intel

Nvidia s'offrirait Hugging Face pour 12,9 milliards

27 août 2026 à 13:52

Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.

Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.

Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.

En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.

Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.

En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.

Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.

Source : Techcrunch

  • ✇LinuxFr.org : les dépêches
  • Aux origines du premier GPU, une bande de copains de l'ENS
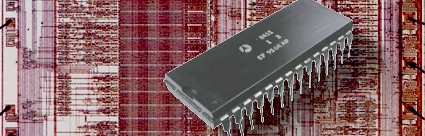
    Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ). Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi. Le circuit intégré Thomson-Efcis EF9365 Contrôleur de visualisation graphique,1980

Aux origines du premier GPU, une bande de copains de l'ENS

Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ).

Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi.

l'EF9365

Le circuit intégré Thomson-Efcis EF9365
Contrôleur de visualisation graphique,1980

Les rédacteurs de cette dépêche collaborative remercient :

  • Philippe Matherat, le concepteur de ce composant ! Il a eu la gentillesse de se prêter au jeu en répondant à nos questions et en apportant de nombreuses précisions et anecdotes –les citations dans la dépêche sont intégralement de sa main– ;
  • PulkoMandy, pour son journal d’archéologie informatique sur la thèse de Jean Gastinel. Sans ce journal, cette dépêche n'aurait jamais vu le jour ;
  • Jean-François DEL NERO, développeur de l’émulation du 365 dans Mame, pour les échanges et les apports techniques ;
  • l'équipe de rédaction du magazine Sciences et Avenir, pour l'autorisation de publier des extraits de l'article "le Silicon labo de la rue d'Ulm", n° 455 (Janvier 1985).

Sommaire

Généalogie des puces EFxxxx

Un GPU est un composant informatique (une puce dédiée dans les cartes graphiques des PC ou intégrée au processeur central (CPU) de votre téléphone (soc)) initialement dédiée à l'affichage d'images.

D'abord limité à l'affichage 2D, il a rapidement pris le relais du CPU pour gérer les calculs parallèles de la 3D. Aujourd'hui, cette puissance brute sert autant au traitement vidéo qu'à des domaines bien éloignés des pixels, comme le minage de cryptomonnaies ou l'IA.

Cette bascule technologique a récemment propulsé nVidia, le principal acteur du marché, au sommet de l'économie mondiale.

Pourtant, bien avant cette folie financière et les géants américains ou asiatiques, c'est en France qu'est née cette architecture moderne.

Cette dépêche vous propose de découvrir l'histoire du 365, le premier GPU sur puce unique.

La génèse

Extraits de l'article

Extraits de l'article "le Silicon labo de la rue d'Ulm" de Dominique COMMIOT
© Sciences et Avenir n° 455 (Janvier 1985)
À gauche, Jean GASTINEL devant le bâtiment historique de l'ENS.
À droite, Philippe MATHERAT et un extrait de l'article.

Philippe Matherat avait résumé ainsi le contexte de cette épopée dans l'article de PulkoMandy :

Nous étions une bande de copains, élèves de l’Ecole Normale Supérieure, de la promotion 1973.

L’informatique était balbutiante, les ordinateurs étaient gigantesques (un bâtiment), très rares et très chers. Personne n’envisageait qu’ils puissent être répandus et bon marché.
Les seuls écrans connus étaient ceux de la télévision. Les terminaux informatiques étaient des machines à écrire mécaniques actionnées par des relais électromécaniques. Ces terminaux étaient reliés à des gros ordinateurs distants, par une ligne téléphonique dédiée.
La fréquence d'horloge des ordinateurs les plus puissants était 12 MHz.

Jean Gastinel était le seul de notre promotion qui connaissait un peu ce qui se passait aux Etats-Unis, grâce à son père : Noël Gastinel, qui était professeur à Grenoble et qui avait fait des voyages dans les universités américaines et chez IBM. Il avait fait équiper l’université de Grenoble d’un ordinateur IBM 360/68.
Jean Gastinel, avec Jean-Marc Frailong et Jean-Luc Richier, ont réalisé un ordinateur 12 bits, à base de circuits MSI de Texas-Instruments, dans les années 1973-1975.

Puis Jean-Gastinel s’est lancé dans la conception du circuit d’affichage alpha-numérique, qui a été commercialisé sous le nom de SFF364 puis EF9364 (le changement de nom correspond au changement de nom de la société Sescosem en EFCIS). Cette conception a fait l’objet de sa thèse de 3è cycle.

Depuis cet article, P. Matherat a détaillé :

Quand je suis entré à l’ENS en 1973, il n’y avait pas de labo d’informatique, ni d’électronique. Les disciplines (en sciences) étaient les disciplines classiques de l’université : mathématique, physique, chimie, biologie, etc. Les chercheurs et les élèves avaient accès à un "Centre de calcul", dirigé par Maurice Vallino, qui consistait en un terminal (lecteur de cartes perforée et imprimante) connecté à un ordinateur Univac de l’université d’Orsay par une ligne à 1.200 bits/s, puis plus tard équipé d’un mini-ordinateur CII Mitra 15. Nous avons eu des cours de programmation Fortran par Jacques Arsac. Nous avions aussi accès à une formation en électronique (analogique), dans un local du labo de physique, fait par F. Lenouvel.

Quand Jean Gastinel a souhaité réaliser un ordinateur, associé à J-M Frailong et J-L Richier, ils sont allés à Jussieu, à l’institut de programmation, où il y avait une équipe qui réalisait des montages électroniques, dirigée par Gérard Noguez. Puis, ils ont souhaité continuer à l’ENS, et M. Vallino leur a cédé une petite pièce annexe du Centre de calcul, ainsi qu’un petit budget annuel de 10.000 F. C’est dans cette pièce que Jean a réalisé la maquette du 364, puis j’ai continué là avec la maquette du 365.

Ce que nous appelions "maquette" était le câblage d'une émulation de la future puce à l'aide de circuits MSI existants (des centaines), afin de pouvoir tester en temps réel la conception logique. Il n'existait aucun outil de CAO. Tout était câblé à la main, sans simulation préalable, et notre principal outil était l'oscilloscope pour vérifier les signaux. Avec des fréquences de l'ordre de quelques MHz, il nous fallait un oscilloscope haut de gamme.

Une question de mémoire

Sans la capacité d'Intel à produire en masse des puces DRAM de plus en plus denses, le 365 n'aurait jamais pu exister :

À la suite du 364, j’ai pensé qu’on pouvait faire du graphique : j'ai commencé cette étude en 1976, à l'occasion de mon DEA d'informatique. Il faut bien voir que ceci n’est devenu possible que grâce aux nouvelles mémoires de 4 Kbits, car un affichage 512 x 512 à 1 bit/pixel nécessite 64 boîtiers mémoires de 4 Kbits. En fait cela ne devient raisonnable qu’avec 16 boîtiers de 16 Kbits (soit 32 K octets). Il n’était donc pas possible de faire un GPU avant ces années-là. Mon mérite a été d’avoir le flair de voir qu’une période nouvelle pouvait s’ouvrir, et que les écrans graphiques pouvaient se démocratiser.

Mais utiliser 32 K octets rien que pour l'écran paraissait délirant, à une époque où la mémoire "centrale" utilisée par le CPU pour son programme et ses données ne dépassait pas 4 ou 8 K octets. Quand à vouloir faire de la couleur avec 3 bits par pixel, là j'étais vraiment pris pour un fou. Songez qu'un adressage sur 16 bits (cas des microprocesseurs de l'époque) ne permet pas de dépasser 64 K (= 216 ).

Dates de sortie des DRAM Intel

Le marché aux puces des seventies
Naissance et évolution des composants DRAM

Notez bien que, à l'époque, la capacité de ces mémoires s'exprime en bits (non pas en octets), et par un simple « K » : ce k majuscule vaut 1 024 bits (le kibibit actuel) et non 1 000. Pour résumer et par exemple, il faut traduire 16K par 2 kio.

Pourquoi cette augmentation de la capacité de la RAM à cette époque ?

Les circuits de RAM nécessitent un très grand nombre de transistors, mais sont très répétitifs : ils coûtent donc relativement peu cher à concevoir, mais demandent une chaîne de production de semi-conducteurs de très bonne qualité. Les fabricants de semi-conducteurs Japonais sont ceux qui vont le mieux maîtriser ce type de produit, fournissant des composants de plus en plus grande capacité à des prix écrasant la concurrence américaine. Intel ne s'en remettra qu'avec de grosses difficultés. Un autre fondeur de RAM américain, Mostek, n'y survivra pas et sera revendu à Thomson-CSF, qui rentabilisera largement son investissement en exploitant les brevets ainsi rachetés.

Le plastique, c'est fantastique

En creusant le sujet de ces premières mémoires vives, on comprend qu'il y a eu une autre évolution importante : le choix du matériau pour le boîtier.

Les boîtiers des premiers CI (dont la référence est préfixée par "C" ou "D") étaient en céramique : c'était coûteux mais dans les début des années 70 seul ce matériau répondait aux besoins de dissipation thermique et d'étanchéité.
Au départ, les fabricants avaient du mal à stabiliser le plastique, car l'humidité finissait par s'infiltrer par capillarité le long des pattes en métal, provoquant la corrosion de la puce.
Pour protéger la puce, il lui a été ajouté une couche (au nitrure de silicium), dite "de passivation", qui permet le contact avec le plastique.
Plus tard dans la décennie (à partir des puces 16K soit vers 1977), la transition vers le plastique s'opère massivement, leur référence est alors préfixée par "P".
Le moulage plastique a permis de produire des puces à la chaîne à un prix dérisoire par rapport au processus artisanal du boîtier céramique multicouche.

La production

L'histoire industrielle du fondeur

  • 1969 : Création de Sescosem (Société Européenne de Semiconducteurs et de Microélectronique), filiale de Thomson-CSF.  
    Selon Wikipedia : Thomson-CSF est le résultat de la fusion réalisée en 1968, du groupe électronique Thomson (filiale de Thomson-Brandt) et de la Compagnie générale de télégraphie sans fil (CSF). Leurs filiales dédiées aux circuits intégrés, respectivement SESCO et COSEM, sont donc fusionnées pour devenir SESCOSEM.
  • 1976 : Sescosem devient EFCIS (Étude et Fabrication de Circuits Intégrés Spéciaux). C'est à ce moment précis que la référence change : le SFF364 devient l'EF9364.
  • 1983 : Thomson-CSF réorganise ses activités. EFCIS est intégrée au sein de la branche Thomson Semiconducteurs. C'est l'époque de la grande offensive sur le marché grand public avec le Minitel et les ordinateurs (Alice, VG5000) utilisant les dérivés comme l'EF9345.
  • 1987 : Thomson Semiconducteurs fusionne avec la branche composants de l'italien SGS (Société Générale Semiconduttori). Naissance de SGS-Thomson Microelectronics.
  • 1998 : SGS-Thomson est renommé STMicroelectronics (ST), le nom que nous connaissons aujourd'hui : une multinationale franco-italienne de droit néerlandais.

Fabrication de transistors à la COSEM

Fabrication de circuits à la COSEM
source https://aconit.inria.fr/omeka/items/show/681 E. Gillet, Les transistors, ces magiciens.
Gamma Presse, 1964. Crédits photo : René Bouillot.

Dates de production

Chronologiquement, Sescosem ou EFCIS ne faisaient pas de tels chips pour écrans avant que les élèves de l’ENS lui en apportent :

  • En premier, Jean Gastinel a conçu le circuit alphanumérique EF9364, de 16 lignes de 64 caractères, qui est sorti vers 1977.
  • Ensuite, j’ai conçu le premier chip graphique EF9365, de 512x512 pixels, qui est sorti vers 1980, avec sa variante EF9366 (balayage non-entrelacé).
  • Le circuit 9367 est une variante du 9365, avec des performances augmentées.
  • Les circuits du genre 9345 sont postérieurs au 9365, ils utilisent les éléments de base des circuits précédents, et ont été demandés par les concepteurs du minitel, qui sont donc des copies, variantes, des circuits conçus par les élèves de l’ENS.

Généalogie des puces EFxxxx

Chronologie de mise sur le marché
des puces EF9xxx et quelques consœurs

La petite famille

L'EF9364, le précurseur

L'année dernière, PulkoMandy a exhumé la thèse de Jean Gastinel "Conception et intégration d'un terminal alphanumérique", qui pose avant l'heure les bases du Minitel et qui est aussi à l'origine de l'aîné de la famille : l'EF9364 est un contrôleur vidéo purement alphanumérique (affichage de 16 lignes de 64 caractères).

Cette thèse est une véritable pépite pour les férus d’archéologie informatique, on y trouve notamment tous les détails sur la réalisation du CI :

Ajout d'un masque

fig 1.10 - Dessin final des cinq masques superposés - Chapitre 1 fig 4.2 Montage des "puces", Chapitre III "Intégration du circuit "VISU" de la thèse

Ce composant est prévu pour réaliser un terminal passif, sans microcontrôleur. Avant son arrivée, toute la logique vidéo des terminaux était implémentée par de la logique discrète: une centaine de puces électroniques étaient nécessaires. Les autres composants d'un terminal, comme le modem et le contrôleur de clavier, bénéficiaient déjà de solutions intégrées. Ce composant rend donc possible la construction d'un terminal à très bas coût avec quelques dizaines de composants.

Il implémente tout de même des fonctionnalités de défilement de l'affichage, de déplacement du curseur, et d'effacement partiel (tout l'écran visible, la ligne courante, depuis le curseur jusqu'à la fin de la ligne). Ces fonctionnalités sont similaires à ce qui se fait sur les terminaux de l'époque (VT52 chez DEC, ADM-3A, …). Cependant, les générations suivantes de terminaux à partir du VT100 choisiront plutôt d'utiliser un microprocesseur.

La génération des caractères proprement dit est effectuée par un composant séparé appelé générateur de caractères. Il s'agit dans le cas le plus simple d'une ROM programmée avec une police bitmap de taille fixe.

Pour les nostalgiques du rendu d'affichage alphanumérique (le seul proposé par cette puce) sur un écran de l'époque, vous pouvez essayer cool-retro-term (lien qui devrait être sponsorisé par le SNOF)

capture cool-retro-term

Simulation d'affichage sur tube cathodique
        par cool retro term, à la EF9364
(alphanumérique, 64 colonnes x 16 lignes)

L'EF9365

Second de la famille, c'est l'objet de notre dépêche : voir la section suivante qui lui est dédiée.
Nous passons souvent sous silence le EF9366, qui est très proche du 365, mais les 2 sorties sont vraiment concomitantes.

En fait, les 9365 et 9366 sont sortis en même temps, c’est moi qui avais fait la modification qui supprime l’entrelacement (pour le 9366), car le premier client (Secapa), qui avait travaillé sur la maquette de simulation du 365, ne supportait pas le clignotement de l’affichage 512x512. Pour moi, l’intérêt était d’avoir une résolution élevée, et je conseillais d’utiliser un CRT avec des phosphores plus rémanents. Mais les CRT les moins chers (TV) avaient des phosphores rapides.

Nous passons aussi sous silence le EF9367, sorti plus tard, proche du 365 mais supportant des résolutions supérieures.

Le NEC µPD7220 : le cousin Japonais

Ce composant n'est pas compatible avec la série EF9365. Cependant, il a un fonctionnement assez similaire. Commercialisé en décembre 1981, il a été développé à partir de 1979, et probablement inspiré par la présentation du travail sur le 365 au SIGGRAPH en 1978.

En plus des lignes, rectanges et textes, il peut tracer des cercles, arc de cercles et autres courbes. Il est également prévu pour s'interfacer avec un contrôleur DMA, ce qui facilite l'échange de données avec le CPU de contrôle.

Le design de NEC a également été produit par Intel, qui continuera à faire évoluer cette famille de composants. C'est donc un ancêtre des GPU Intel toujours en production aujourd'hui.

L'EF9340 et 9341

Ces deux composants sont au cœur des premiers modèles de Minitel, il s'agit d'une adaptation "low cost" et d'un retour au mode alphanumérique. Ils sont conçus en 1980-1981.

Les premiers prototypes du Minitel utilisent des circuits de chez TI (que l'on retrouvera également dans l'ordinateur Exelvision EXL100). Mais les modèles de production se tournent vers une solution "made in France". Thomson EFCIS se charge de la conception de ces circuits qui sont fournis à Alcatel pour la fabrication du Minitel.

Réponse à appel d'offre du Minitel mentionnant les circuits VIN et GEN : la visualisation est confiée à deux circuits spécialisés VIN et GEN, chargés des signaux de base de temps et de la synthèse des caractères.

Ils sont associés à un microprocesseur, faisant du Minitel un terminal "intelligent" capable de réaliser certaines fonctions en autonomie, sans avoir besoin de communiquer chaque appui de touche du clavier au serveur central.

Ils ajoutent également un mode "semi-graphique" : il ne permet pas d'afficher des pixels, mais propose des 'briques', de 2x3 éléments, pré-dessinées dans la ROM du processeur.
On économise ainsi drastiquement la RAM qui coûtait, déjà, cher…
Le prix unitaire d'une RAM Intel 2107 (de 4K, soit 512 octets) était, à sa sortie en 1974, de 50 $ => avec l'inflation cumulée et la conversion, cela représente environ 295€ de 2026.

Exemple de [caractères semi-graphiques](https://en.wikipedia.org/wiki/Thomson_EF9345)

Exemple de caractères semi-graphiques
              autorisés par L'EF9345
       Page 84 du Databook Thomson.

En plus du Minitel, ces composants seront également utilisés par Philips dans les consoles Videopac Plus, ce qui sera la première étape dans la conception du VG5000 dont on reparle au chapitre suivant.

L'EF9345, la cheap chip

Le composant EF9345 regroupe dans une seule puce les fonctionnalités du générateur de caractères et du contrôleur de timing vidéo (GEN et VIN, qui étaient auparavant deux composants séparés).
Cette photo zoomable du cœur de silicium du composant (die shot) montre bien cet assemblage.
Cela a permis de réduire le coût de production du Minitel et a également été utilisé dans quelques micro-ordinateurs personnels : l’Alice chez Matra ou le VG5000 chez Philips.

Captures de US Rallye

Captures de US Rallye, le Gran Turismo de 1984

Ici, la puce ne sait pas ce qu'est un pixel : elle manipule une grille de caractères (25 lignes de 40 ou 80 colonnes).

Pour afficher une lettre ou un bloc de couleur (le fameux mode mosaïque), le processeur principal envoie juste un code d'un octet en RAM. C'est une ROM interne à la puce d'affichage qui se charge ensuite de traduire cet octet en points lumineux à l'écran.

C’était une astuce pour économiser la mémoire, mais impossible de tracer une ligne fine ou de faire bouger un élément au pixel près : on est condamnés à déplacer des blocs rigides sur une grille fixe. Au mieux, certains caractères peuvent être redéfinis, pour afficher un logo ou une image simple.

La suite pour ST

Pour ST Microelectronics, l'histoire des composants graphiques continue encore quelques années après la commercialisation de la série EF936x. Bien que les composants graphiques n'ont pas eu le volume de production de la version alphanumérique (surtout portée par le Minitel), ils ont trouvé une utilisation dans l'informatique scientifique et les appareils de mesure nécessitant la visualisation de données : spectromètres, analyseurs de spectre, ainsi que des réalisations spécifiques (cartes graphiques en kit Elektor pour machines CP/M à bus S-100).

L'offre sera complétée par l'EF9369, un circuit permettant de gérer une palette de 16 couleurs parmi 4096. Ce circuit est conçu au départ pour le micro-ordinateur Thomson TO9, mais finit par rejoindre le catalogue public de EFCIS puis de SGS-Thomson.

En parallèle, SESCOSEM avait signé un contrat avec Motorola lui permettant de produire en France des composants conçus par Motorola (permettant de rassurer les acheteurs qu'il s'agissait de productions locales). SGS-Thomson se retrouve donc à produire à la fois la famille 93xx mais aussi le EF6845, le contrôleur d'écran de la famille 68xx de Motorola. Ce contrat devait comprendre toutes les futures puces de la famille 68xx conçues par Motorola, mais cela finira mal, puisque Motorola refusera de fournir les masques nécessaires à la production du processeur 68020.

En fonction des demandes de clients, de nouveaux composants sont réalisés avec des adaptations simples (changement de timings vidéo pour afficher plus de pixels) ou plus poussés. C'est le cas de la famille TS68483 (surnommé AGAC, Advanced Graphic and Alphanumeric Controller) disponible en 1987.

Il s'agit d'une version améliorée du 9365 avec:

  • une interface 16 bits avec le processeur, adapté à l'utilisation avec un 68000 par exemple.
  • Des fonctions supplémentaires : tracé de courbes, cercles, remplissage de zones…
  • Meilleure intégration : il n'y a plus besoin d'un séquenceur et de registres à décalage externes.
  • Configuration logicielle de la résolution d'écran vidéo

Ce composant trouve également une utilisation dans des systèmes militaires, pour lesquels il existe une version "durcie", plus résistante (gamme de températures acceptables par exemple).

Plus tard (en 1995-1997), c'est également ST qui fabrique les premières puces conçues par nVidia: NV1 STG2000 puis RIVA 128. Pour la première, le principe est similaire à ce qui avait été fait pour le EF9365 : ST assure la production et la commercialisation en son nom propre (on trouve donc des datasheets ne mentionnant pas du tout nVidia). Pour la seconde génération, ST ne se charge que de la fabrication, les datasheets (et les puces elle-mêmes) font apparaître les logos des deux entreprises. Malheureusement pour ST, ce partenariat n'ira pas plus loin, et les puces nVidia des générations suivantes seront produites exclusivement par TSMC.

ST la suite

STG2000 (ST) RIVA 128 (ST) RIVA TNT (TSMC)
logo de ST seul deux logos côte à côte logo nVidia seul

Le génie de l'EF9365

Un vrai framebuffer

Ce composant ne se limite plus à une RAM de stockage des caractères, il dispose d'une RAM de pixels dédiée (le framebuffer) qu'il gère de manière autonome.

De ce point de vue c’est vraiment le premier chip qu’on peut qualifier de "graphique", car les autres étaient appelés "alphanumériques" ou "alpha-mosaïques".

La grosse différence entre les deux est que "graphique" suppose de pouvoir accéder à un pixel particulier, alors que les autres n’accèdent qu’à un "caractère", les pixels d’un caractère étant définis secondairement par une ROM.

Autrement dit, la RAM d’un chip graphique est une RAM de pixels (beaucoup plus grosse, par exemple 512x512), alors que dans le cas alpha-xxx c’est une RAM de caractères (16x80 par exemple).

Il faut bien voir que cette chronologie est liée à la sortie des puces mémoires de Intel : Les puces de 4 K bits ne sont apparues que vers 1974. Avant, il était impossible de faire du vrai "graphique". Il aurait été trop compliqué de stocker chaque point de l’image individuellement : en télévision, le signal vidéo était analogique, et les magnétoscopes à bande magnétique enregistraient le signal video analogique.

L'idée de stocker une image matricielle (point par point) dans une mémoire vive pour l'afficher à l'écran n'était pas nouvelle (par exemple: Evans & Sutherland Shaded Picture System qui faisait déjà du rendu 3D en 1973, premiers "frame buffers" dès 1969 chez Bell Labs, mais ce sont des solutions complexes et coûteuses). On peut également mentionner le CDP1861 de chez RCA: il s'agit d'un framebuffer mais avec une résolution de seulement 64x128 pixels (et encore, il est parfois exploité en 32x64 pixels pour économiser de la mémoire). L'EF9365 marque une rupture historique : c'est le premier processeur graphique commercialisé de manière monolithique (sur une seule puce) conçu pour piloter un framebuffer géométrique de manière autonome. Il gère non seulement le framebuffer et l'affichage à l'écran, mais aussi des fonctions de tracé de lignes et de caractères. C'est donc le premier processeur graphique à proposer une forme d'accélération matérielle sur un système à framebuffer.

L'actualisation de l'image à l'écran utilise seulement 57 % du temps (64 cycles sur 112 cycles de l'horloge externe continue).
Le temps restant est libre pour l'écriture et la mise à jour de l'image : il est possible d'écrire un point par cycle libre, ce qui donne un temps moyen de 1,3 µs par point. Dans les cas où il y a beaucoup d'informations à afficher d'un coup, il est également possible de désactiver l'affichage pendant la préparation de l'image puis de le réactiver ensuite. Malheureusement, cela ne se prête pas trop à la réalisation d'animations complexes.

La décharge du CPU pour certaines tâches

C'est ce qui définit ce composant comme le premier GPU de l'histoire : son auteur lui a câblé des registres pour prendre en charge des fonctionnalités qui déchargent le CPU (processeur central) sur des opérations graphiques !

Exemples de programmes en langage MPL qui montrent la simplicité d'utilisation

Le tracé de lignes

Le CPU peut par exemple demander à l'EF9365 de dessiner un trait d'un point A à un point B et revenir aussitôt à sa tâche. L'EF9365 prend alors le relais de manière totalement autonome. Il calcule les coordonnées intermédiaires en interne et écrit directement les pixels en RAM, à une vitesse folle pour l’époque : jusqu'à un million et demi de points par seconde, traçant une diagonale complète en moins de 700 microsecondes.

Tracer une ligne

L’algorithme de tracé de segment de Bresenham
Présentation SIGGRAPH'78, page 5

Traitements hardware sur les caractères

Redimensionnement matériel (jusqu'à 16x)

Auparavant, pour doubler la taille d'une police ou d'un motif, on demandait au processeur principal de recalculer tous les points. L'EF9365, lui, gère cela en toute autonomie via deux registres internes dédiés aux facteurs d'échelle : CZX (Zoom en X) et CZY (Zoom en Y).

Le processeur graphique possède un compteur de pas pour dessiner le caractère pixel par pixel à partir de sa ROM interne.
Quand le zoom est activé (par exemple à 4×), au lieu d'incrémenter l'adresse de destination dans le framebuffer à chaque pixel lu, l'EF9365 va répéter la même valeur de pixel sur la ligne 4 fois de suite en horizontal avant de passer au pixel suivant. Pour la verticale, il va répéter la même ligne complète du caractère 4 fois de suite dans la mémoire d'écran.

L'avantage : comme les zooms X et Y sont indépendants, on peut appliquer un zoom 2× en largeur et 4× en hauteur. Cela permettait de faire instantanément des effets de texte étiré, condensé ou géant sans aucun calcul pour le CPU.

L'effet Italique

L'inclinaison n'est pas stockée dans une ROM ; elle est calculée « à la volée » lors de l'écriture dans la RAM de pixels.
Pour incliner un bloc de pixels, il faut appliquer un décalage horizontal progressif à mesure que l'on monte en hauteur.
À chaque fois que le générateur passe à la ligne supérieure (Y+1) pour dessiner le caractère, il ajoute automatiquement un offset fixe (un décalage d'un pixel) sur l'axe horizontal (X).

Le caractère est littéralement « cisaillé » géométriquement pendant qu'il est écrit dans le framebuffer. On obtient un effet italique parfait et fluide, directement câblé dans le silicium.

La seule inclinaison possible est 45 degrés (voir la notice page 21).
C’est beaucoup plus simple ainsi à réaliser en hardware. Je m’étais posé la question de faire tous les angles, mais j’avais abandonné.

Autres fonctionnalités

L'EF9365 marque d'autres évolutions technologiques novatrices…

Il intègre notamment un mécanisme de masquage d'écriture par plan.
En verrouillant certains plans de la RAM, il pouvait dessiner ou effacer des éléments au pixel près sans jamais altérer le fond de l'image, jetant les bases de la gestion matérielle des calques.

Il propose un module de pointillés gérés au pixel individuel (une aubaine pour la CAO industrielle).

Son interface de bus universelle est capable de dialoguer nativement aussi bien avec un Z80 qu'un Motorola 6809.

et… concrètement ?

Jean-François Del Nero a produit une démonstration des capacités de rendu du 365 sur le Squale, un micro-ordinateur de 1984 qui exploitait ce composant.
Ci-après quelques extraits, très saccadés (export gif oblige), presque fidèles (cherchez l'intrus !) :

[Une démo du 365 ](https://i.imgur.com/7RXP1ze.gif)

En plus de son travail de conservation du Squale, avec l'association MO5.com (qui tient un musée permanent du jeu vidéo à Arcueil), Jean-François Del Nero a aussi contribué à son émulation dans le projet Mame, et a notamment écrit le driver du 365.
Nous avons pu reprendre le code source de sa démo, la modifier, la recompiler, et simuler le rendu du 365 grâce à Mame. Avis aux développeurs fullstack en manque d'exotisme: ici, pas de conteneurs Docker ni de dépendances npm !

Est-ce vraiment le premier GPU ?

Nous avons retenu les quatre critères suivants pour distinguer le 365 des premiers contrôleurs d'affichage sur une seule puce, comme le Motorola 6845 ou l'Atari Antic, qui gèrent la synchronisation du flux vidéo et le rafraîchissement de l'écran, sans intervenir dans le dessin des formes.
Le processeur 365 :

  1. est une puce unique (LSI/VLSI) : ce n'est pas une carte remplie de circuits TTL discrets comme sur les gros systèmes vectoriels des années 70 (Evans & Sutherland, Imlac) ;
  2. déleste le CPU de tâches coûteuses en ressources : le CPU n'écrit pas les pixels un par un en VRAM. Il envoie une commande de haut niveau au 365 telle que : « trace une ligne de (X1,Y1) à (X2,Y2) », et repasse à autre chose ;
  3. dispose d'un moteur d'exécution algorithmique dédié, hardware (en silicium) : il embarque en dur l'algorithme de tracé/moteur de rendu (rasterizer) ;
  4. gère en toute indépendance la mémoire vidéo (Framebuffer/VRAM) : le 365 contrôle l'accès, le rafraîchissement et la modification de la VRAM de façon indépendante.

Et le libre dans tout ça ?

Quittons la technique pour nous intéresser à un autre aspect des travaux de l'équipe : la diffusion de ses travaux.

Vous pourriez être étonnés qu’un circuit produit par un industriel puisse être public, dans ses moindres détails. Je dois vous raconter une anecdote :

Notre petit groupe d’élèves de l’Ecole Normale Supérieure considérait que ses productions, financées par les pouvoirs publics, devaient profiter à tout le monde. Mais cela posait un problème à l’industriel (Thomson-CSF qui avait pour filiale la société Thomson-EFCIS), qui voulait protéger son produit par des brevets. Il a été convenu que Thomson-CSF déposerait des brevets au plus tard la veille de ma soutenance de thèse. Ainsi, les brevets pouvaient être valides car ne portaient pas sur un design public.

Ma thèse a été soutenue le 19 mai 1978, et les brevets avaient été déposés le 18 mai (US4286264, US4297694, US4311998, US4266253).
Ils décrivent aussi en détails le fonctionnement du circuit, mais dans le langage juridique spécifique des brevets.

En août de la même année, l'architecture du 365 est présentée lors de la conférence SIGGRAPH 78. La liste d'articles soumis à cette conférence permet de se faire une idée des évolutions en cours dans le monde des graphismes générés par ordinateur à l'époque. On y trouve la description d'autres systèmes matériels et logiciels, des algorithmes en 2D ("How to color in a coloring book", un algorithme de remplissage de zones délimitées par des traits) et en 3D, des discussions sur les choix d'espaces de couleurs, ainsi que des exemples de mises en application (par exemple pour les simulateurs de vol de la navette spatiale américaine).

Ensuite, EFCIS a beaucoup utilisé le dessin des masques du 365 pour sa communication car c’était le seul design qui était public.
Nous n’étions pas dans l’état d’esprit de créer une start-up autour de nos designs, dans le but de gagner de l'argent. Nous nous imaginions qu’il était possible de concevoir des circuits dans un contexte académique, en étant juste payés par nos salaires, puis de les céder à un industriel pour la suite. C’était une erreur car ça ne pouvait pas fonctionner, principalement parce que l’industriel a besoin de définir sa stratégie de ligne de produits avec ses arguments marketing.
Le contrat passé entre EFCIS et l’Ecole Normale Supérieure a servi à rémunérer l’ENS, qui s’en est servi pour créer le premier labo d’Informatique de l’ENS (le LIE), et je n’ai rien reçu personnellement. Je considérais que j’avais été payé par mon salaire d’élève de l’ENS.

Dans les années 1970, nous avions l’idée naïve que les innovations techniques entraînaient des innovations sociales au sens d’une amélioration des conditions de vie pour tous, à l’image de la bagnole qui s’était démocratisée et qui était synonyme de libération. Nous ne faisions pas de grande différence entre acteurs publics et acteurs privés, et nous avions l’impression que tout était publié, ne serait-ce que par les brevets, qui ne faisaient que protéger ceux qui avaient davantage investi. En revanche, nous étions sensibles à la question de la propriété industrielle, et nous pensions que ce qui avait été développé par des fonctionnaires était la propriété de l’état (ce qui d’ailleurs est la loi), et que les universitaires ne pouvaient que publier sans restrictions. (En tant qu'élèves de l’ENS, nous étions fonctionnaires et universitaires.)…

Le 365 a-t-il fait un flop ?

Clairement non, car l'EF9365 ne mesure pas ses performances en FLOPS (Floating-point Operations Per Second) : il ne manipule aucune virgule flottante (ni même de calculs en nombres réels).
Blague d'informaticien mise à part, le 365 a certes ouvert la voie à une longue lignée de composants, qui domine aujourd'hui l'actualité de la tech, mais il n'a pas eu le succès commercial de ses descendants, et l'expérience de la rue d'Ulm a tourné court.

En France et à l'époque, il était difficile de faire dialoguer recherche, industrie et financement public.

…Mais nous n’avions pas compris les particularités de ce secteur. D’une part, les usines qui fabriquent des circuits intégrés coûtent extrêmement cher. D’autre part ce secteur était appelé à un développement exponentiel, non anticipé : la plupart des hauts responsables de l’époque pensaient que les ordinateurs seraient achetés par 100 entreprises, voire 1000, mais ne concerneraient pas le grand public. Ensuite, le coût des développements logiciels devenait lui aussi très élevé. À l’époque les plus gros logiciels n’étaient pas très complexes. Et on n’avait pas compris la relation étroite entre les logiciels et les architectures matérielles. On n’avait pas compris non plus que de prendre un monopole sur un OS était un enjeu stratégique.

Toutes ces contraintes (et d’autres que j’oublie), que nous n’avions pas comprises, faisaient que nous pensions naïvement que nous pouvions faire un développement dans notre coin, sans nous occuper du marché, mais uniquement de la performance technique, et le publier, puis dans un second temps le proposer à un industriel qui aurait les moyens de le commercialiser. L’idée sous-jacente étant que si le design était performant alors il y aurait forcément un industriel pour le vendre. C’était une grande ignorance des contraintes industrielles et des questions de marketing.

Le cœur du problème ne résidait pas dans un manque de compétences (le génie des étudiants de l'ENS en est la preuve) mais dans l'incapacité des grands capitaines d'industrie français (notamment chez Thomson) à anticiper la révolution de l'ordinateur personnel et du logiciel. Confortés dans leur monopole, ils ont ignoré le virage que les États-Unis et le Japon prenaient à pleine vitesse :

Je pense maintenant que dans le contexte des années 1970-80 en France, il n’y avait pas vraiment de possibilité pour aller plus loin. Les deux milieux, universitaires et industriels, ne se parlaient vraiment pas. Personne en France, ni chez les gouvernants, ni chez les universitaires, ni chez les industriels, ne voyaient ce qui se préparait. Nous, à 20-25 ans, nous comprenions le retard technologique de la France, ne serait-ce qu'en lisant les docs des puces que nous achetions, mais il était nié par les plus hauts responsables. Les dirigeants de Thomson disaient : "Quand il y aura vraiment un marché pour ça, nous serons en mesure de produire".

En 1984, lors d'un voyage aux États-Unis et d'une visite au mythique Xerox PARC, le chercheur français découvre un autre monde. Un monde où l'innovation de rupture n'est pas confinée aux laboratoires, mais propulsée par le capital-risque, les pépinières d'entreprises et une compréhension systémique du couple matériel/logiciel :

À un moment, au début des années 80, nous parlions avec Gastinel de monter notre boîte. Mais nous étions incompétents pour ça, nous n’avions aucune conscience des difficultés, il n’y avait pas du tout l’esprit "start-up", le capital-risque n’existait pas, les pépinières d’entreprises n’existaient pas, nous n’avions aucune connaissance de la façon dont les boîtes pouvaient se créer et croître aux USAs, nous n’avons appris ce contexte que beaucoup plus tard.

Je suis allé aux USAs en 1984 pour la conférence Siggraph (à Minneapolis) et à cette occasion après je suis passé à Xerox-Parc où j’avais un ami français (Louis Monier, plus tard créateur de Altavista chez DEC). J’y ai découvert un monde insoupçonné chez nous, avec toutes leurs innovations depuis 20 ans, et j’ai rapporté leurs publications. Pourtant cela était connu (mais pas par nous), c’était à la base du Lisa et du Macintosh de Apple, sorti cette année-là. À Parc, j’y ai rencontré Franck Crow, un anglais, un grand nom du graphique (connu en particulier pour l’anti-aliasing) qui m’a félicité pour le 365, je n’en revenais pas. J’ai compris après qu’il avait été un reviewer pour mon article de 1978, avec un avis très favorable. En 1984, il avait connaissance du minitel, sorti peu avant, et m’a dit : "Nous aux USAs, nous n’avons pas été capables de faire ça". Il faut dire que c’était avant qu’Internet se répande, avec des possibilités infiniment supérieures. Internet existait depuis plusieurs années chez Xerox, mais ne pouvait pas se répandre dans le grand public avant l’existence des ordinateurs individuels.

Les pouvoirs publics français se sont parfois immiscés dans ces choix industriels : citons la nationalisation de Thomson-CSF en 1982 et le plan "Informatique pour tous" en 1985 (un investissement énorme, estimé à 1,8 milliard de francs, soit 600 millions d'euros rapportés à aujourd'hui). Pourtant, la théorie du ruissellement n'a pas très bien fonctionné alors avec les labos de recherche ou les pépites industrielles en devenir : en témoignent le départ d'une grande partie de la bande de copains vers les US ou l'échec du Squale, dont la production s'est limitée à quelques centaines d'unités.
La capitalisation boursière de STMicroelectronics (ex-SGS-Thomson) est, en 2026, 70 fois inférieure à celle de nVidia.

En fait je crois que en France, à cette époque, les choses ne pouvaient venir que d’en haut : le nucléaire, le concorde, le minitel. Le minitel a été réalisé par des gens du corps des mines et du corps des télécom (comme son nom l’indique). les choses ne pouvaient venir que des grands corps de l’état.
Notre activité, initiée par Jean Gastinel, était plutôt folle par sa liberté, et transgessive. Le climat à l’ENS, peu après 1968 où cette école avait été au cœur des événements, était très libre, nous avions vraiment la possibilité de faire n’importe quoi, sans contrôle. Jean avait entendu parler par son père de ce qui se passait aux USAs. Et ce qui se passait en Silicon-valley aussi était fait dans un cadre très libre lié à la contre-culture des hippies (mais ça, nous ne le savions pas).

Une anecdote : au début des années 80, nous avons développé un réseau local Ethernet (alors sur câble co-axial de gros diamètre), pour relier nos Thémis réalisées en 10 exemplaires. Et nous avons eu besoin de passer sous la rue d’Ulm pour connecter le laboratoire de biologie. C’était interdit par le monopole des télécoms. En outre, le protocole de transfert par paquets était refusé car concurrent du protocole des P&T. Il nous a fallu enfreindre la loi pour passer un câble en douce.
Tout ça a basculé peu de temps après, après l’explosion de l’usage des ordinateurs individuels et de leurs applications.

Pour être tout-à-fait honnête, et rendre à César…, je dois mentionner que notre équipe a été reconnue par le CNRS en 1982, où nous avons obtenu des postes et des crédits pour continuer. Il y a eu une croissance jusqu'à 10 personnes en 1985, mais la plupart des membres de l'équipe sont partis chez Xerox en 1986.

Avec le recul je dirais : on peut faire de grandes choses quand on est très peu nombreux, ça devient plus difficile lorsqu'il faut gérer la croissance…

Le hasard du calendrier a voulu que la publication de cette dépêche coïncide avec un anniversaire : il y a 50 ans débutait l'étude du 365, avec le DEA de P. Matherat :)
Pour celles et ceux qui s’intéresseraient à ses publications ou à la suite de ses travaux, c'est consultable ici.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • GeForce NOW planque un vrai Windows derrière vos jeux
    Je m'en doutais un peu mais c'est confirmé, derrière chaque session GeForce NOW tourne un vrai Windows, et cette machine virtuelle est moins verrouillée qu'elle en a l'air. En effet, une démo du moddeur Zortos montre le service qui s'ouvre non pas sur un jeu, mais sur un bureau complet, avec barre des tâches, menu démarrer et icônes. La manip passe par le jeu Trove... Pendant le lancement, Zortos ouvre le navigateur web intégré de Steam, se balade dans les dossiers de la machine, récupère un exé

GeForce NOW planque un vrai Windows derrière vos jeux

Par : Korben ✨
10 août 2026 à 10:50

Je m'en doutais un peu mais c'est confirmé, derrière chaque session GeForce NOW tourne un vrai Windows, et cette machine virtuelle est moins verrouillée qu'elle en a l'air. En effet, une démo du moddeur Zortos montre le service qui s'ouvre non pas sur un jeu, mais sur un bureau complet, avec barre des tâches, menu démarrer et icônes.

La manip passe par le jeu Trove... Pendant le lancement, Zortos ouvre le navigateur web intégré de Steam, se balade dans les dossiers de la machine, récupère un exécutable et remplace quelques chemins dans le répertoire du jeu. Au démarrage suivant, Windows s'affiche alors à la place du jeu. Tout ça repose sur SalsaNOW , un outil open source signé dpadGuy.

Une fois le bureau ouvert, la machine encaisse à peu près tout ce qui ne réclame pas de droits administrateur. Zortos y a fait tourner Wallpaper Engine pour les fonds animés et LM Studio avec le modèle Gemma 4. Et pour les logiciels qui exigent une installation privilégiée, ils peuvent sans souci être préparés en version portable sur son propre PC, puis décompressés là-haut.

Reste que ce bureau est un bac à sable. La session tourne en compte utilisateur simple, donc pas de droits administrateur, pas d'anticheat noyau, et beaucoup d'installations qui finissent sur un refus d'accès.

L'autre mur, c'est la persistance. Sans l'option de stockage payante, tout disparaît à la déconnexion. Et même en la prenant, la machine ne conserve que vos Documents, l'AppData du compte, baptisé kiosk, et le contenu du lecteur I:. Tout le reste repart de zéro à la session suivante, et fermer l'explorateur de fichiers coupe la connexion sur-le-champ.

Dernier filtre, et pas le moindre, ça ne fonctionne que sur les abonnements payants, ceux dont je détaillais les formules quand Nvidia a sorti son client Linux natif . L'offre gratuite est hors jeu, tout comme les GeForce NOW opérés par les partenaires alliance.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Maintenant, qu'en est-il du règlement ? Eh bien comme vous vous en doutez, les conditions d'utilisation interdisent formellement de contourner les mécanismes de sécurité ou d'authentification du service, et Nvidia se réserve le droit de suspendre ou de restreindre un compte à sa discrétion. En cas de suspension, la période coupée n'est pas remboursée.

Mais à ce jour, aucun bannissement lié à ces méthodes n'a été rapporté, et Nvidia n'a sorti ni correctif ni communiqué. Voilà, c'est rigolo comme bidouille, mais si vous vous lancez, c'est votre compte que vous mettez en jeu.

Reste maintenant à voir combien de temps la porte restera ouverte.

Source

  • ✇Korben
  • Linux va enfin faire tourner le GA100 de NVIDIA avec un pilote 100% libre
    Petite victoire pour le logiciel libre. Avec la prochaine version du noyau Linux, la 7.2, le pilote Nouveau va enfin prendre en charge le GA100 de NVIDIA. Pour situer, Nouveau, c'est le pilote graphique libre développé par la communauté pour faire fonctionner les cartes NVIDIA sans dépendre du pilote propriétaire maison. Le GA100, lui, n'est pas une carte de gamer. C'est la puce qui anime l'A100, l'accélérateur que NVIDIA vend par camions entiers aux data centers pour entraîner les IA et faire t

Linux va enfin faire tourner le GA100 de NVIDIA avec un pilote 100% libre

29 mai 2026 à 11:03

Petite victoire pour le logiciel libre. Avec la prochaine version du noyau Linux, la 7.2, le pilote Nouveau va enfin prendre en charge le GA100 de NVIDIA.

Pour situer, Nouveau, c'est le pilote graphique libre développé par la communauté pour faire fonctionner les cartes NVIDIA sans dépendre du pilote propriétaire maison.

Le GA100, lui, n'est pas une carte de gamer. C'est la puce qui anime l'A100, l'accélérateur que NVIDIA vend par camions entiers aux data centers pour entraîner les IA et faire tourner du calcul scientifique. Une bête taillée uniquement pour le calcul, sans même de sortie vidéo.

Et c'est justement ce qui posait problème. Nouveau gérait déjà les autres cartes de la génération Ampere grâce au GSP, un petit processeur embarqué sur la carte qui sert d'intermédiaire pour la piloter.

Sauf que le GA100, étant une puce entièrement dédiée au calcul, faisait bande à part et réclamait un traitement particulier, en réutilisant au passage des bouts de code prévus pour la génération précédente. NVIDIA a fini par publier les correctifs nécessaires en février, et ils arrivent donc maintenant dans le noyau.

Attention quand même à ne pas crier victoire trop vite. Le pilote côté noyau est prêt, d'accord, mais la partie logicielle qui permet réellement d'exploiter la carte pour faire du calcul n'est pas encore au point côté libre.

Les outils comme Mesa ou les pilotes OpenCL ne savent toujours pas gérer une carte NVIDIA dépourvue de moteur 3D. Il reste du boulot avant d'avoir une chaîne entièrement open source du début à la fin.

Source : Phoronix

  • ✇Korben
  • NVIDIA CUDA 13.3 fait passer Python en stable et amène un nouveau modèle de programmation pour C++
    Avec la sortie de CUDA 13.3, NVIDIA renforce son écosystème GPU sur deux fronts importants. La version Python passe officiellement en 1.0 (donc considérée comme stable et utilisable en production), et CUDA Tile arrive nativement pour les développeurs C++. Petit rappel pour les non-initiés : CUDA, c'est l'outil que tout le monde utilise pour faire tourner du calcul sur les cartes graphiques NVIDIA, principalement pour l'IA et le calcul scientifique.  Historiquement, c'est du C/C++ à 99%. NVIDIA p

NVIDIA CUDA 13.3 fait passer Python en stable et amène un nouveau modèle de programmation pour C++

28 mai 2026 à 14:34

Avec la sortie de CUDA 13.3, NVIDIA renforce son écosystème GPU sur deux fronts importants. La version Python passe officiellement en 1.0 (donc considérée comme stable et utilisable en production), et CUDA Tile arrive nativement pour les développeurs C++.

Petit rappel pour les non-initiés : CUDA, c'est l'outil que tout le monde utilise pour faire tourner du calcul sur les cartes graphiques NVIDIA, principalement pour l'IA et le calcul scientifique. 

Historiquement, c'est du C/C++ à 99%. NVIDIA pousse depuis quelques années pour rendre tout ça accessible en Python, et ce passage en 1.0 marque une étape importante. À partir de maintenant, l'API ne changera plus brutalement entre les versions mineures.

En pratique, les développeurs peuvent désormais compter dessus pour leurs projets long terme. La version 1.0 ajoute aussi le support des "green contexts" (un système pour réserver une partie de la GPU à des tâches isolées) et du checkpointing CUDA (la possibilité de sauvegarder l'état d'une exécution GPU pour la reprendre plus tard).

L'autre gros morceau, c'est CUDA Tile pour C++. Le modèle de programmation "tile" consiste à découper un calcul en blocs uniformes traités en parallèle, plutôt que de gérer chaque fil d'exécution individuellement (la GPU en fait tourner des milliers en même temps).

Il était déjà disponible en Python via des bibliothèques comme Triton. Il arrive maintenant en C++. L'idée est de monter d'un cran en abstraction : vous décrivez ce que vous voulez faire au niveau du bloc, et le compilateur s'occupe de mapper ça sur les threads. Le support couvre les GPU Hopper (l'architecture haut de gamme de NVIDIA pour les datacenters IA) et toutes les architectures plus récentes.

En bonus, NVIDIA introduit CompileIQ, un framework d'auto-tuning du compilateur qui promet jusqu'à 15% de gain sur des opérations critiques comme la multiplication de matrices ou les mécanismes d'attention utilisés dans les modèles d'IA. Le support du C++23 dans les compilateurs NVCC et NVRTC est aussi de la partie.

Pour les développeurs IA, c'est une nouvelle version importante. La programmation GPU est toujours un domaine très technique, mais NVIDIA réduit progressivement la barrière d'entrée, surtout côté Python. AMD a du boulot pour rattraper son retard avec ROCm, leur équivalent maison qui peine encore à convaincre la communauté.

Source : Phoronix

  • ✇Korben
  • GeForce Now Linux - NVIDIA lâche enfin son client natif pour les gamers manchots
    Ça y est les amis, NVIDIA a enfin lâché son client GeForce Now natif pour Linux ! Après des années à bidouiller avec des solutions non officielles ou à passer par le navigateur (beurk ^^), on a ENFIN droit à une vraie app qui tourne en natif. Pour ceux qui débarquent, GeForce Now c'est donc le service de cloud gaming de NVIDIA. En gros, vous jouez à vos jeux sur des serveurs surpuissants équipés de RTX 5080, et le flux vidéo est streamé sur votre machine. Du coup, même si votre PC date de Mathus

GeForce Now Linux - NVIDIA lâche enfin son client natif pour les gamers manchots

Par : Korben
1 février 2026 à 08:36

Ça y est les amis, NVIDIA a enfin lâché son client GeForce Now natif pour Linux ! Après des années à bidouiller avec des solutions non officielles ou à passer par le navigateur (beurk ^^), on a ENFIN droit à une vraie app qui tourne en natif.

Pour ceux qui débarquent, GeForce Now c'est donc le service de cloud gaming de NVIDIA. En gros, vous jouez à vos jeux sur des serveurs surpuissants équipés de RTX 5080, et le flux vidéo est streamé sur votre machine. Du coup, même si votre PC date de Mathusalem, vous pouvez faire tourner Cyberpunk 2077 en Ultra comme si de rien n'était.

Après y'a quand même un truc important à piger c'est que vos jeux, faut les acheter à côté. GeForce Now ne vend rien, il se connecte à vos bibliothèques Steam, Epic Games Store, Ubisoft Connect et compagnie. Ainsi, si vous possédez déjà des jeux sur ces plateformes, vous les retrouvez directement dans l'interface. Par contre, tous les jeux ne sont pas compatibles, mais il y a un catalogue d'environ 2000 titres supportés.

Ce qu'il vous faut

Côté config, c'est pas trop exigeant vu que c'est votre connexion internet qui fait le gros du boulot :

  • Ubuntu 24.04 LTS (officiellement supporté, mais ça tourne aussi sur d'autres distros via Flatpak)
  • Un GPU compatible Vulkan Video pour le décodage H.264/H.265 (GeForce série 10 minimum, ou Intel/AMD récent)
  • Une connexion internet correcte : 15 Mbps pour du 720p, 25 Mbps pour du 1080p, et 65 Mbps si vous voulez taper dans le 5K à 120 fps
  • Latence réseau inférieure à 80ms (privilégiez l'Ethernet ou le WiFi 5 GHz)

Comment installer le bazar

L'installation est carrément simple puisque NVIDIA distribue l'app via Flatpak, donc c'est universel. La première méthode qui est à mon sens la plus rapide c'est que vous téléchargiez le fichier .bin depuis le site officiel . Ensuite vous le rendez exécutable et vous le lancez :

chmod +x GeForceNOWSetup.bin
./GeForceNOWSetup.bin

Deuxième méthode, si vous préférez tout faire en ligne de commande :

flatpak remote-add --user --if-not-exists GeForceNOW https://international.download.nvidia.com/GFNLinux/flatpak/geforcenow.flatpakrepo

flatpak install flathub org.freedesktop.Platform//24.08

flatpak install -y --user GeForceNOW com.nvidia.geforcenow

Attention, petit piège : si vous êtes sous Wayland et que la fenêtre refuse de s'ouvrir, y'a un fix :

flatpak override --user --nosocket=wayland com.nvidia.geforcenow

Les abonnements... parce que faut bien payer

NVIDIA propose trois formules :

  • Gratuit : sessions d'une heure max, qualité standard 1080p/60fps, et vous aurez des pubs. C'est suffisant pour tester le service.
  • Performance à 10,99€/mois : là ça devient intéressant. Sessions de 6 heures, qualité jusqu'à 1440p/60fps avec le ray tracing activé, et plus de pubs. C'est le sweet spot pour la plupart des joueurs.
  • Ultimate à 21,99€/mois : le Graal. Vous jouez sur des serveurs équipés de RTX 5080, avec du DLSS 4, jusqu'à 5K à 120 fps ou 1080p à 360 fps si vous avez un écran gaming qui suit. Sessions de 8 heures.

Petit détail qui peut piquer, depuis janvier 2026, y'a un cap de 100 heures de jeu par mois sur les abos payants. Si vous dépassez, c'est 2,99€ (Performance) ou 5,99€ (Ultimate) par tranche de 15 heures supplémentaires. Bon, 100 heures par mois ça fait quand même 3h20 par jour... sauf si vous faites des sessions marathon le week-end, ça devrait aller.

En tout cas, avoir le DLSS 4 et le ray tracing natifs sur Linux via le cloud, c'est quand même un sacré pas en avant. D'ailleurs, ça tombe bien au moment où 90% des jeux Windows tournent maintenant sur Linux grâce à Proton... Entre le cloud gaming et la compatibilité native, y'a jamais eu de meilleur moment dans l'histoire de l'Humanité pour lâcher Windows si vous êtes un gamer ^^.

Dépannage rapide

Si l'installation plante avec « Flatpak not found », installez d'abord Flatpak via votre gestionnaire de paquets (sudo apt install flatpak sur Ubuntu).

Si vous avez des saccades, vérifiez que votre GPU supporte bien Vulkan Video. Sur les cartes NVIDIA, passez sur une session X11 plutôt que Wayland... sauf si vous avez une RTX série 30 ou plus récente, là ça devrait passer.

Pour les problèmes de latence, branchez-vous en Ethernet si possible. Le WiFi 5 GHz ça passe, mais attention au 2.4 GHz qui ajoute un sacré jitter.

Bref, si vous voulez jouer à des jeux AAA sur Linux sans vous prendre la tête avec Wine ou Proton, GeForce Now est maintenant une option carrément viable.

Amusez-vous bien !

  • ✇Korben
  • NVIDIA négociait avec Anna's Archive pour entraîner ses IA... et les emails ont fuité
    Bon, celle-là elle est gratinée. NVIDIA, le géant des GPU, a directement contacté Anna's Archive pour accéder à environ 500 To de livres piratés. Contacté, négocié, payé. Comme ça, tranquillou. C'est une class action (dossier n°1:26-cv-00002 au tribunal fédéral de New York, pour ceux qui veulent aller checker) qui a fait fuiter ces fameux emails internes. En gros, un membre de l'équipe "data strategy" de NVIDIA a négocié un accès haute vitesse aux collections piratées de la bibliothèque. Et le p

NVIDIA négociait avec Anna's Archive pour entraîner ses IA... et les emails ont fuité

Par : Korben
28 janvier 2026 à 23:21

Bon, celle-là elle est gratinée. NVIDIA, le géant des GPU, a directement contacté Anna's Archive pour accéder à environ 500 To de livres piratés. Contacté, négocié, payé. Comme ça, tranquillou.

C'est une class action (dossier n°1:26-cv-00002 au tribunal fédéral de New York, pour ceux qui veulent aller checker) qui a fait fuiter ces fameux emails internes. En gros, un membre de l'équipe "data strategy" de NVIDIA a négocié un accès haute vitesse aux collections piratées de la bibliothèque. Et le plus beau dans l'histoire c'est qu'Anna's Archive les a PRÉVENUS que les données étaient illégales. Genre, texto : "Vous avez une autorisation interne pour ça ?"

La réponse est arrivée en moins d'une semaine. Feu vert. Sauf que bon, quand on lit ça avec du recul, c'est quand même sacrément culotté.

Le contexte, c'était surtout la pression de livrer pour la GTC 2023 (la Developer Conference de NVIDIA). Fallait nourrir les modèles d'IA coûte que coûte, et le dataset Books3 (196 000 bouquins issus de Bibliotik), plus LibGen, Sci-Hub, Z-Library... ça faisait un buffet de 500 To et de leur côté Anna's Archive facturait des dizaines de milliers de dollars pour l'accès rapide.

Sérieux, j'aurais aimé voir la tête du service juridique de NVIDIA en lisant cet email...

En parallèle, Anna's Archive se prend un procès complètement délirant puisque Spotify, Universal Music, Warner et Sony réclament 13 000 milliards de dollars (13 TRILLIONS, soit à peu près le PIB de la Chine). C'est en lien avec leur backup de 300 To de Spotify dont je vous avais parlé ici. Le juge Rakoff a émis une injonction mondiale le 20 janvier, ce qui a fait tomber plusieurs domaines du site .

NVIDIA plaide le "fair use" évidemment. Mouais. On verra bien ce qu'en pensera le juge, mais quand les emails prouvent qu'on t'a prévenu que c'était illégal et que t'as quand même dit "go"... c'est pas ouf comme défense.

En attendant, entre le procès Spotify et ces emails, Anna's Archive est devenue l'ennemi public numéro un de toute l'industrie du contenu sur le web.

Affaire à suivre !

Source

  • ✇Korben
  • NVIDIA et Eli Lilly - 1 milliard pour réinventer la médecine avec l'IA
    On sait que l'IA bouffe le monde et la santé n'est pas épargnée... En effet, NVIDIA vient d'annoncer un partenariat massif avec le géant pharmaceutique Eli Lilly pour créer un labo de co-innovation en plein cœur de la Silicon Valley ou pas loin... Ça discute quand même d'un investissement commun qui pourrait grimper jusqu'à 1 milliard de dollars sur les cinq prochaines années. Et le but c'est d'utiliser la puissance de calcul de NVIDIA et ses modèles d'IA pour trouver de nouveaux médicaments plu

NVIDIA et Eli Lilly - 1 milliard pour réinventer la médecine avec l'IA

Par : Korben
13 janvier 2026 à 14:37

On sait que l'IA bouffe le monde et la santé n'est pas épargnée... En effet, NVIDIA vient d'annoncer un partenariat massif avec le géant pharmaceutique Eli Lilly pour créer un labo de co-innovation en plein cœur de la Silicon Valley ou pas loin...

Ça discute quand même d'un investissement commun qui pourrait grimper jusqu'à 1 milliard de dollars sur les cinq prochaines années. Et le but c'est d'utiliser la puissance de calcul de NVIDIA et ses modèles d'IA pour trouver de nouveaux médicaments plus vite et plus efficacement. Jensen Huang, le boss de NVIDIA, est d'ailleurs convaincu que c'est dans les sciences de la vie que l'IA aura son impact le plus profond. Et quand Jensen dit un truc, en général, les serveurs chauffent derrière ^^.

En gros, ils vont monter un système d'apprentissage continu afin de faire bosser en boucle les "wet labs" de Lilly (les vrais labos avec des éprouvettes et des chercheurs) avec des "dry labs" computationnels (les serveurs de NVIDIA). Ce sont des expériences réelles qui vont nourrir les modèles d'IA, qui suggèreront ensuite de nouvelles expériences, et ainsi de suite, 24h/24.

Côté matos, ils vont s'appuyer sur la plateforme BioNeMo de NVIDIA et sur la future architecture Vera Rubin (qui devrait pointer le bout de son nez fin 2026). Et de ce que j'ai compris, ils ne vont pas s'arrêter à la recherche pure puisqu'ils comptent aussi utiliser l'IA, la robotique et les jumeaux numériques (via NVIDIA Omniverse) pour optimiser les lignes de production et la chaîne logistique, histoire d'être sûr que quand ils trouveront un remède miracle afin de le fabriquer à grande échelle sans galérer.

Ahaha, on n'a pas fini d’entendre chialer les complotistes adorateurs de la 5G ^^

C'est fou comme ça avance vite quand même... on est passé de la phase "je demande à ChatGPT c'est quoi ces boutons que j'ai sur les fesses" à la phase "on construit des usines à médicaments pilotées par IA".

C'est prometteur pour la suite !

Source

  • ✇Korben
  • Quand NVIDIA largue les GTX 1000 sur Linux et que ça part en cacahuète sur Arch
    Vous avez une vieille GTX 1060 qui tourne nickel sous Arch Linux ? C'est con, NVIDIA vient de vous mettre un beau coup de pied aux fesses car la boîte au caméléon vert a décidé d'abandonner le support des GPU Pascal (les GTX 10xx) dans son dernier driver 590 et ça crée un joyeux bordel, notamment sur Arch. Le problème, c'est que quand vous faites une mise à jour système sur Arch avec une vieille carte Pascal ou Maxwell, le nouveau driver refuse de charger. Résultat, vous vous retrouvez éjecté ve

Quand NVIDIA largue les GTX 1000 sur Linux et que ça part en cacahuète sur Arch

Par : Korben
28 décembre 2025 à 00:00

Vous avez une vieille GTX 1060 qui tourne nickel sous Arch Linux ? C'est con, NVIDIA vient de vous mettre un beau coup de pied aux fesses car la boîte au caméléon vert a décidé d'abandonner le support des GPU Pascal (les GTX 10xx) dans son dernier driver 590 et ça crée un joyeux bordel, notamment sur Arch.

Le problème, c'est que quand vous faites une mise à jour système sur Arch avec une vieille carte Pascal ou Maxwell, le nouveau driver refuse de charger. Résultat, vous vous retrouvez éjecté vers la ligne de commande sans interface graphique. Sympa pour débugger quand y'a plus d'écran qui fonctionne...

Faut dire que le modèle "rolling release" d'Arch fait que les utilisateurs ont reçu ce driver incompatible automatiquement avec leur mise à jour. Ils n'ont pas eu le temps de dire ouf que leur système était déjà cassé. Et les GTX 1060 et 1050 Ti, c'est pas exactement des cartes de musée... Y'en a encore pas mal qui tournent sur Steam, et même si parmi leurs propriétaires, seule une poignée utilise Linux, et encore moins Arch, ça fait quand même du monde impacté.

Pour s'en sortir, y'a deux solutions. La première, c'est d'installer le driver legacy nvidia-580xx-dkms depuis l'AUR, qui est maintenu par l'équipe CachyOS. Le hic, c'est que ça crée des problèmes de dépendances avec Steam, donc faut aussi installer lib32-nvidia-580xx-utils pour que les jeux 32 bits fonctionnent. La deuxième option, c'est de basculer sur Nouveau, le driver open source fait par reverse engineering. Ça marche, mais avec les limitations que ça implique niveau performances et fonctionnalités.

Ce qui me rend dingue dans cette histoire, c'est que pendant des années, NVIDIA a refusé de fournir de la documentation pour ses GPU, forçant la communauté Linux à utiliser le reverse engineering pour Nouveau. Et depuis 2022, ils ont ouvert les modules kernel pour les architectures Turing et plus récentes, mais les parties user-space et le firmware restent propriétaires. Et surtout, aucune aide pour les vieilles cartes comme Pascal !! Du coup, maintenant que NVIDIA abandonne ces générations de cartes, c'est aux bénévoles de la communauté de maintenir les drivers legacy... Pas cool.

D'ailleurs, l'annonce officielle d'Arch Linux précise que les cartes Turing et plus récentes (RTX 20xx et GTX 1650+) vont automatiquement basculer vers les modules kernel open source, donc pas d'intervention manuelle pour eux. C'est uniquement les propriétaires de vieilles Pascal/Maxwell qui doivent se taper le boulot.

Bref, si vous avez une carte Pascal sous Arch, basculez sur nvidia-580xx-dkms avant votre prochain pacman -Syu. Dans sa grande bonté, NVIDIA a aussi promis des patchs de sécu jusqu'en 2028, mais bon, on a vu ce que valent leurs promesses côté Linux...

Source

  • ✇Korben
  • Nemotron 3 - Nvidia débarque dans l'open source et crache du token comme jamais
    Vous voulez faire tourner un modèle d'IA en local sans avoir besoin d'un serveur de la NASA ? Eh bien Nvidia vient de lâcher une bombe avec Nemotron 3, une famille de modèles open source plutôt impressionnant et surtout, ils ont publié leurs données d'entraînement afin de jouer la transparence totale. Chapeau ! Le modèle phare de cette nouvelle famille s'appelle Nemotron 3 Nano et c'est un modèle de 30 milliards de paramètres, mais attention, il n'en active que 3,5 milliards à la fois grâce à un

Nemotron 3 - Nvidia débarque dans l'open source et crache du token comme jamais

Par : Korben
16 décembre 2025 à 12:42

Vous voulez faire tourner un modèle d'IA en local sans avoir besoin d'un serveur de la NASA ? Eh bien Nvidia vient de lâcher une bombe avec Nemotron 3, une famille de modèles open source plutôt impressionnant et surtout, ils ont publié leurs données d'entraînement afin de jouer la transparence totale. Chapeau !

Le modèle phare de cette nouvelle famille s'appelle Nemotron 3 Nano et c'est un modèle de 30 milliards de paramètres, mais attention, il n'en active que 3,5 milliards à la fois grâce à une architecture hybride qui mélange du Mamba-2 et du Mixture-of-Experts ( MoE ). Ça permet de garder des performances de ouf tout en restant léger niveau ressources.

Sous le capot, Nvidia a également mis le paquet puisque le modèle a été entraîné sur 25 trillions de tokens. J'ai bien dit "trillions"... Pour vous donner une idée, les données d'entraînement incluent du Common Crawl de 2013 à 2025, du code dans 43 langages différents, des articles scientifiques, et une tonne de données synthétiques générées par d'autres modèles. Et tout ça, Nvidia l'a rendu public donc vous pouvez télécharger les datasets sur Hugging Face et vérifier par vous-même ce qui a servi à entraîner le bouzin.

Côté performances, Nemotron 3 Nano se défend plutôt bien . Sur les benchmarks de raisonnement mathématique comme AIME25, il atteint 99,2% quand on lui donne accès à des outils. Sur le coding avec LiveCodeBench, il tape du 68,3%, ce qui le place devant Qwen3-30B. Et pour les tâches d'agent logiciel genre SWE-Bench, il monte à 38,8%. Pas mal pour un modèle qu'on peut faire tourner sur du matos grand public.

D'ailleurs, parlons du matos justement. Nemotron 3 Nano tourne sur des cartes comme la H100, la A100, ou même la future RTX PRO 6000 et supporte jusqu'à 1 million de tokens en contexte si vous avez assez de VRAM. Et niveau vitesse, Nvidia annonce un débit de tokens 4 fois supérieur à la génération précédente, avec 60% de tokens de raisonnement en moins. C'est donc exactement ce que tout le monde demande à saoir du token qui sort vite pour les workflows agentiques.

Maintenant, pour l'utiliser, c'est hyper simple. Il est dispo sur Hugging Face, et vous pouvez le lancer avec Transformers, vLLM, TensorRT, ou même llama.cpp. Y'a même un mode "thinking" qu'on peut activer ou désactiver selon si on veut du raisonnement poussé ou des réponses rapides.

Pour ma part, je l'ai testé à l'aide d'Ollama comme ceci :

ollama run nemotron-3-nano:30b

J'ai trouvé que vitesse de génération était vraiment impressionnante, ça débite beaucoup plus qu'un Llama 3 qui est de taille équivalente. Après, je suis sur un Mac M4 avec 128 Go de RAM, donc je suis plutôt bien loti mais j'ai trouvé ce modèle vraiment très rapide. Je pense que je vais vraiment m'en servir pour des trucs comme de la qualification, du résumé, de l'analyse ce genre de choses.

A voir maintenant si en français il s'en sort bien sur les tournures de phrases. Quoi qu'il en soit pour du développement et des workflows agentiques, il n'y a pas photo, ça va être mon nouveau modèle par défaut quand j'ai besoin de choses en local.

La famille Nemotron 3 ne se limite pas au Nano évidemment. Y'a aussi le Super avec environ 100 milliards de paramètres pour les applications multi-agents, et l'Ultra avec 500 milliards pour les tâches vraiment complexes. Ces deux-là arriveront au premier semestre 2026 donc faudra encore être un peu patient. Nvidia a aussi sorti des bibliothèques comme NeMo Gym pour l'entraînement et NeMo RL pour le fine-tuning.

Jensen Huang, le patron de Nvidia, a aussi dit un truc intéressant lors de l'annonce : "L'innovation ouverte est le fondement du progrès de l'IA." Venant d'une boîte qui a longtemps joué la carte proprio sur ses technos, je trouve que c'est un sacré virage et des entreprises comme Accenture, Deloitte, Oracle, Palantir, ou même Cursor sont déjà en train d'intégrer Nemotron dans leurs produits.

Ce qui est cool aussi, c'est que le modèle supporte 24 langues officielles de l'UE plus une dizaine d'autres comme l'arabe, le chinois ou le japonais et côté code, il gère Python, C++, Java, Rust, Go, et même du CUDA. Bref, c'est plutôt polyvalent.

Voilà, donc si vous cherchez un modèle open source sérieux avec des données d'entraînement transparentes et une vitesse de génération qui arrache, Nemotron 3 Nano mérite clairement le coup d’œil !

Source

  • ✇Opinions Libres
  • Actualités quantiques d’octobre 2025
    Nous voici dans le 74ième épisode de Quantum, le podcast mensuel francophone de l’actualité quantique. Et tant de news, anecdotes et analyse à partager en compagnie de Fanny Bouton. Au menu, nous avons toujours plein d’événements, et surtout la saison des prix Nobel de physique et les dernières annonces de Google. Sans compter diverses actualités […]

Actualités quantiques d’octobre 2025

3 novembre 2025 à 07:37
Nous voici dans le 74ième épisode de Quantum, le podcast mensuel francophone de l’actualité quantique. Et tant de news, anecdotes et analyse à partager en compagnie de Fanny Bouton. Au menu, nous avons toujours plein d’événements, et surtout la saison des prix Nobel de physique et les dernières annonces de Google. Sans compter diverses actualités […]
  • ✇Korben
  • Rust débarque enfin dans le noyau Linux
    La guerre fait rage dans les coulisses du noyau Linux car d’un côté, nous avons les vétérans du C qui hurlent à la trahison, et de l’autre, les évangélistes de Rust qui brandissent leurs promesses de sécurité mémoire ! Et au milieu de tout ça, y’a Linus Torvalds qui joue les arbitres en essayant de calmer tout le monde. Et pendant que les développeurs se chamaillent sur les forums comme des gosses dans une cour de récré, Rust vient discrètement de marquer un point décisif avec la sortie du kerne

Rust débarque enfin dans le noyau Linux

Par : Korben
10 juin 2025 à 11:06

La guerre fait rage dans les coulisses du noyau Linux car d’un côté, nous avons les vétérans du C qui hurlent à la trahison, et de l’autre, les évangélistes de Rust qui brandissent leurs promesses de sécurité mémoire !

Et au milieu de tout ça, y’a Linus Torvalds qui joue les arbitres en essayant de calmer tout le monde. Et pendant que les développeurs se chamaillent sur les forums comme des gosses dans une cour de récré, Rust vient discrètement de marquer un point décisif avec la sortie du kernel Linux 6.15.

  • ✇Opinions Libres
  • Actualités quantiques de mars 2025
    Me voici toujours avec Fanny Bouton, dans le 68e épisode de Quantum, le podcast francophone de l’actualité quantique. Au menu de cet épisode, l’inauguration de CESQ à Strasbourg, l’APS Global Summit d’Anaheim, le NVidia Quantum Day à San Francisco, des actualités concernant Alice&Bob, Pasqal, Quobly, Chipiron, Welinq, ColibriTD puis à l’international sur IBM, IQM, QuamCore, […]

Actualités quantiques de mars 2025

7 avril 2025 à 08:45
Me voici toujours avec Fanny Bouton, dans le 68e épisode de Quantum, le podcast francophone de l’actualité quantique. Au menu de cet épisode, l’inauguration de CESQ à Strasbourg, l’APS Global Summit d’Anaheim, le NVidia Quantum Day à San Francisco, des actualités concernant Alice&Bob, Pasqal, Quobly, Chipiron, Welinq, ColibriTD puis à l’international sur IBM, IQM, QuamCore, […]
  • ✇Opinions Libres
  • Sorting out the confusion on quantum computing utility
    Understanding quantum computing’s pace of progress is not an easy task. Recent months have complicated it with contradictory messages. CEOs like Jensen Huang (Nvidia) and Mark Zuckerberg (Meta) estimated that useful quantum computers were decades away, while others like Satya Nadella (Microsoft) and Sundar Pichai (Google) cast it as being just years from now. Some […]

Sorting out the confusion on quantum computing utility

19 mars 2025 à 09:18
Understanding quantum computing’s pace of progress is not an easy task. Recent months have complicated it with contradictory messages. CEOs like Jensen Huang (Nvidia) and Mark Zuckerberg (Meta) estimated that useful quantum computers were decades away, while others like Satya Nadella (Microsoft) and Sundar Pichai (Google) cast it as being just years from now. Some […]
  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 16 de l’année 2024
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [ZDNET] Commun numérique: Panoramax, une base de photos de vues de terrain immersives [LeMagIT] Recrudescence d’attaques d’ingénierie sociale contre des projets Open Source [ZDNET] Journée du Libre éducatif 2024: 14 pro

Revue de presse de l’April pour la semaine 16 de l’année 2024

Par : echarp
23 avril 2024 à 08:14

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[ZDNET] Commun numérique: Panoramax, une base de photos de vues de terrain immersives

✍ Thierry Noisette, le samedi 20 avril 2024.

Parrainée par l’IGN et OpenStreetMap France, cette alternative libre à des services comme Google Street View contient déjà près de 18 millions de photos.

[LeMagIT] Recrudescence d’attaques d’ingénierie sociale contre des projets Open Source

✍ Alex Scroxton, le vendredi 19 avril 2024.

À la suite de la récente alerte concernant XZ Utils, les responsables d’un autre projet open source se sont manifestés pour dire qu’ils avaient peut-être été victimes d’attaques similaires d’ingénierie sociale.

[ZDNET] Journée du Libre éducatif 2024: 14 projets libres pour la communauté scolaire

✍ Thierry Noisette, le jeudi 18 avril 2024.

La nouvelle édition de la JDLE, créée en 2022 par le ministère de l’Education nationale, a présenté de nombreux projets utiles aux élèves, aux enseignants voire au-delà.

[Silicon] GenAI: face à NVIDIA, Intel se tourne vers l'open source

✍ Clément Bohic, le mercredi 17 avril 2024.

Intel se greffe au projet OPEA (Open Enterprise Platform for AI) et y pousse des implémentations GenAI optimisées pour ses accélérateurs Gaudi.

Et aussi:

[La Voix du Nord] Wimille: inauguration ce samedi d'un atelier numérique citoyen

✍ Olivier Roussel, le mercredi 17 avril 2024.

Dans le cadre de la 1re édition dans le Boulonnais et le Pas-de-Calais de l’événement national «Libre en fête», organisé par l’APRIL association et promouvant la culture et le logiciel libres, la médiathèque de Wimille (espace Pilâtre de Rozier) ouvre les portes de son nouvel atelier numérique citoyen ce samedi à partir de 10h.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Opinions Libres
  • Actualités quantiques de mars 2024
    Dans ce 57e épisode de Quantum, Fanny Bouton et moi-même faisons le tour habituel de l’actualité quantique, en France et ailleurs couvrant le mois de mars 2024. Vous trouverez comme d’habitude le verbatim ainsi que les liens utiles ci-dessous après le podcast. Au programme, quelques événements du mois (Innovacs, Quandela chez OVHcloud, QET-w à TelecomParis […]

Actualités quantiques de mars 2024

8 avril 2024 à 11:33
Dans ce 57e épisode de Quantum, Fanny Bouton et moi-même faisons le tour habituel de l’actualité quantique, en France et ailleurs couvrant le mois de mars 2024. Vous trouverez comme d’habitude le verbatim ainsi que les liens utiles ci-dessous après le podcast. Au programme, quelques événements du mois (Innovacs, Quandela chez OVHcloud, QET-w à TelecomParis […]
❌
❌