❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

EuroLLM - Le LLM européen qui tourne sur votre laptop

Faire tourner un modèle de langage européen sur votre machine sans avoir besoin d’un serveur surpuissant branché sur une centrale nucléaire, c’est maintenant possible, les amis ! Hé oui, EuroLLM vient de prouver qu’on pouvait faire tourner un modèle à 9 milliards de paramètres dans un peu moins de 6 GB de RAM sur un simple laptop.

Une seule commande Ollama , et c’est parti mon kiki !!!

Bien sûr, il est encore loin des gros modèles proprio comme GPT-5 mais c’est le enfin le premier LLM européen que VOUS pouvez faire tourner en local. C’est respectueux de votre vie privée, des droits d’auteurs et c’est gratuit !

Un projet 100% européen

EuroLLM, c’est en réalité une coalition de labos européens : Instituto Superior Técnico (Lisbonne), University of Edinburgh , Université Paris-Saclay , Unbabel , et d’autres et c’est financé par Horizon Europe et l’ EuroHPC , et ce modèle supporte les 24 langues officielles de l’UE, plus 11 langues supplémentaires (arabe, chinois, hindi, japonais, coréen, russe, turc…).

EuroLLM-9B , le modèle de base, a été entraîné sur 4 trillions de tokens avec le supercalculateur MareNostrum 5 à Barcelone (400 GPUs Nvidia H100) et l’architecture utilise du Grouped Query Attention, RoPE, SwiGLU et RMSNorm, comme tout LLM moderne qui se respecte.

Mais il existe d’autres versions comme EuroLLM-1.7B pour smartphones et bientôt EuroLLM-22B pour plus de puissance, ainsi qu’une version vision-language (EuroVLM-9B) et un modèle Mixture-of-Experts (EuroMoE-2.6B).

Et surtout c’est sous licence Apache 2.0. Donc l’usage commercial est autorisé, vous pouvez le fine-tuner sur vos données, et les modifications sont libres, sans redevance à payer. Ce n’est pas la première fois qu’il y a des LLM européens mais ils étaient soit sous licence trop restrictives ou un peu trop lourd pour être utilisé localement par les gens normaux comme vous et moi.

Maintenant comment l’installer ?

La méthode la plus simple, c’est via Ollama :

ollama run hf.co/bartowski/EuroLLM-9B-Instruct-GGUF

Ollama télécharge le modèle en version GGUF (format optimisé CPU/GPU), et vous pouvez commencer à discuter. Il existe aussi une version pré-packagée alibayram/erurollm-9b-instruct (attention, erurollm avec un “u”), quantized en Q4_K_M pour réduire la taille à 5,6 GB.

Si vous préférez Python et Hugging Face Transformers :

from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "utter-project/EuroLLM-9B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

inputs = tokenizer("Explique-moi ce qu'est un LLM en français simple", return_tensors="pt")
outputs = model.generate(**inputs, max_length=200)
print(tokenizer.decode(outputs[0]))

Une fois téléchargé, le modèle reste en cache local. Vous pouvez alors l’utiliser offline, sans connexion internet. Et pour les machines avec moins de RAM, la version 1.7B tourne même sur des Raspberry Pi :

ollama run cas/eurollm-1.7b-instruct-q8

Alors pourquoi c’est important ?

EuroLLM ouvre l’IA européenne à des cas d’usage impossibles avec des API cloud. Par exemple une administration publique ne peut pas envoyer ses documents dans le cloud d’OpenAI… ce serait tout livrer aux américains. Elle peut donc fine-tuner EuroLLM localement. Un journaliste en zone sensible sans connexion fiable peut aussi embarquer le modèle sur son ordi portable. Même un chercheur qui manipule des données médicales confidentielles peut le faire en toute confiance avec EuroLLM puisque tout reste sur sa machine.

C’est cool quand même que l’Europe nous file un modèle gratuit qu’on peut installer chez soi et utiliser sans limite. Après c’est vrai que EuroLLM ne bat pas GPT-4 (pas encore) mais il est suffisamment bon pour 80% des cas d’utilisation réels tels que des résumés, de la traduction, des questions-réponses simples, de la génération de code basique.

La roadmap prévoit d’ajouter de la vision et de la voix aux modèles. D’ailleurs, comme je vous le disais, EuroVLM-9B est déjà en preview sur Hugging Face , ce qui ouvre la voie à de l’OCR multilingue, de l’analyse de documents visuels, ou encore à la création d’assistants vocaux dans n’importe quelle langue…

Voilà j’ai trouvé ça cool à tester et un grand merci à Letsar pour le partage !

LLMLingua – Compresser les prompts pour accélérer les LLM et réduire les coûts

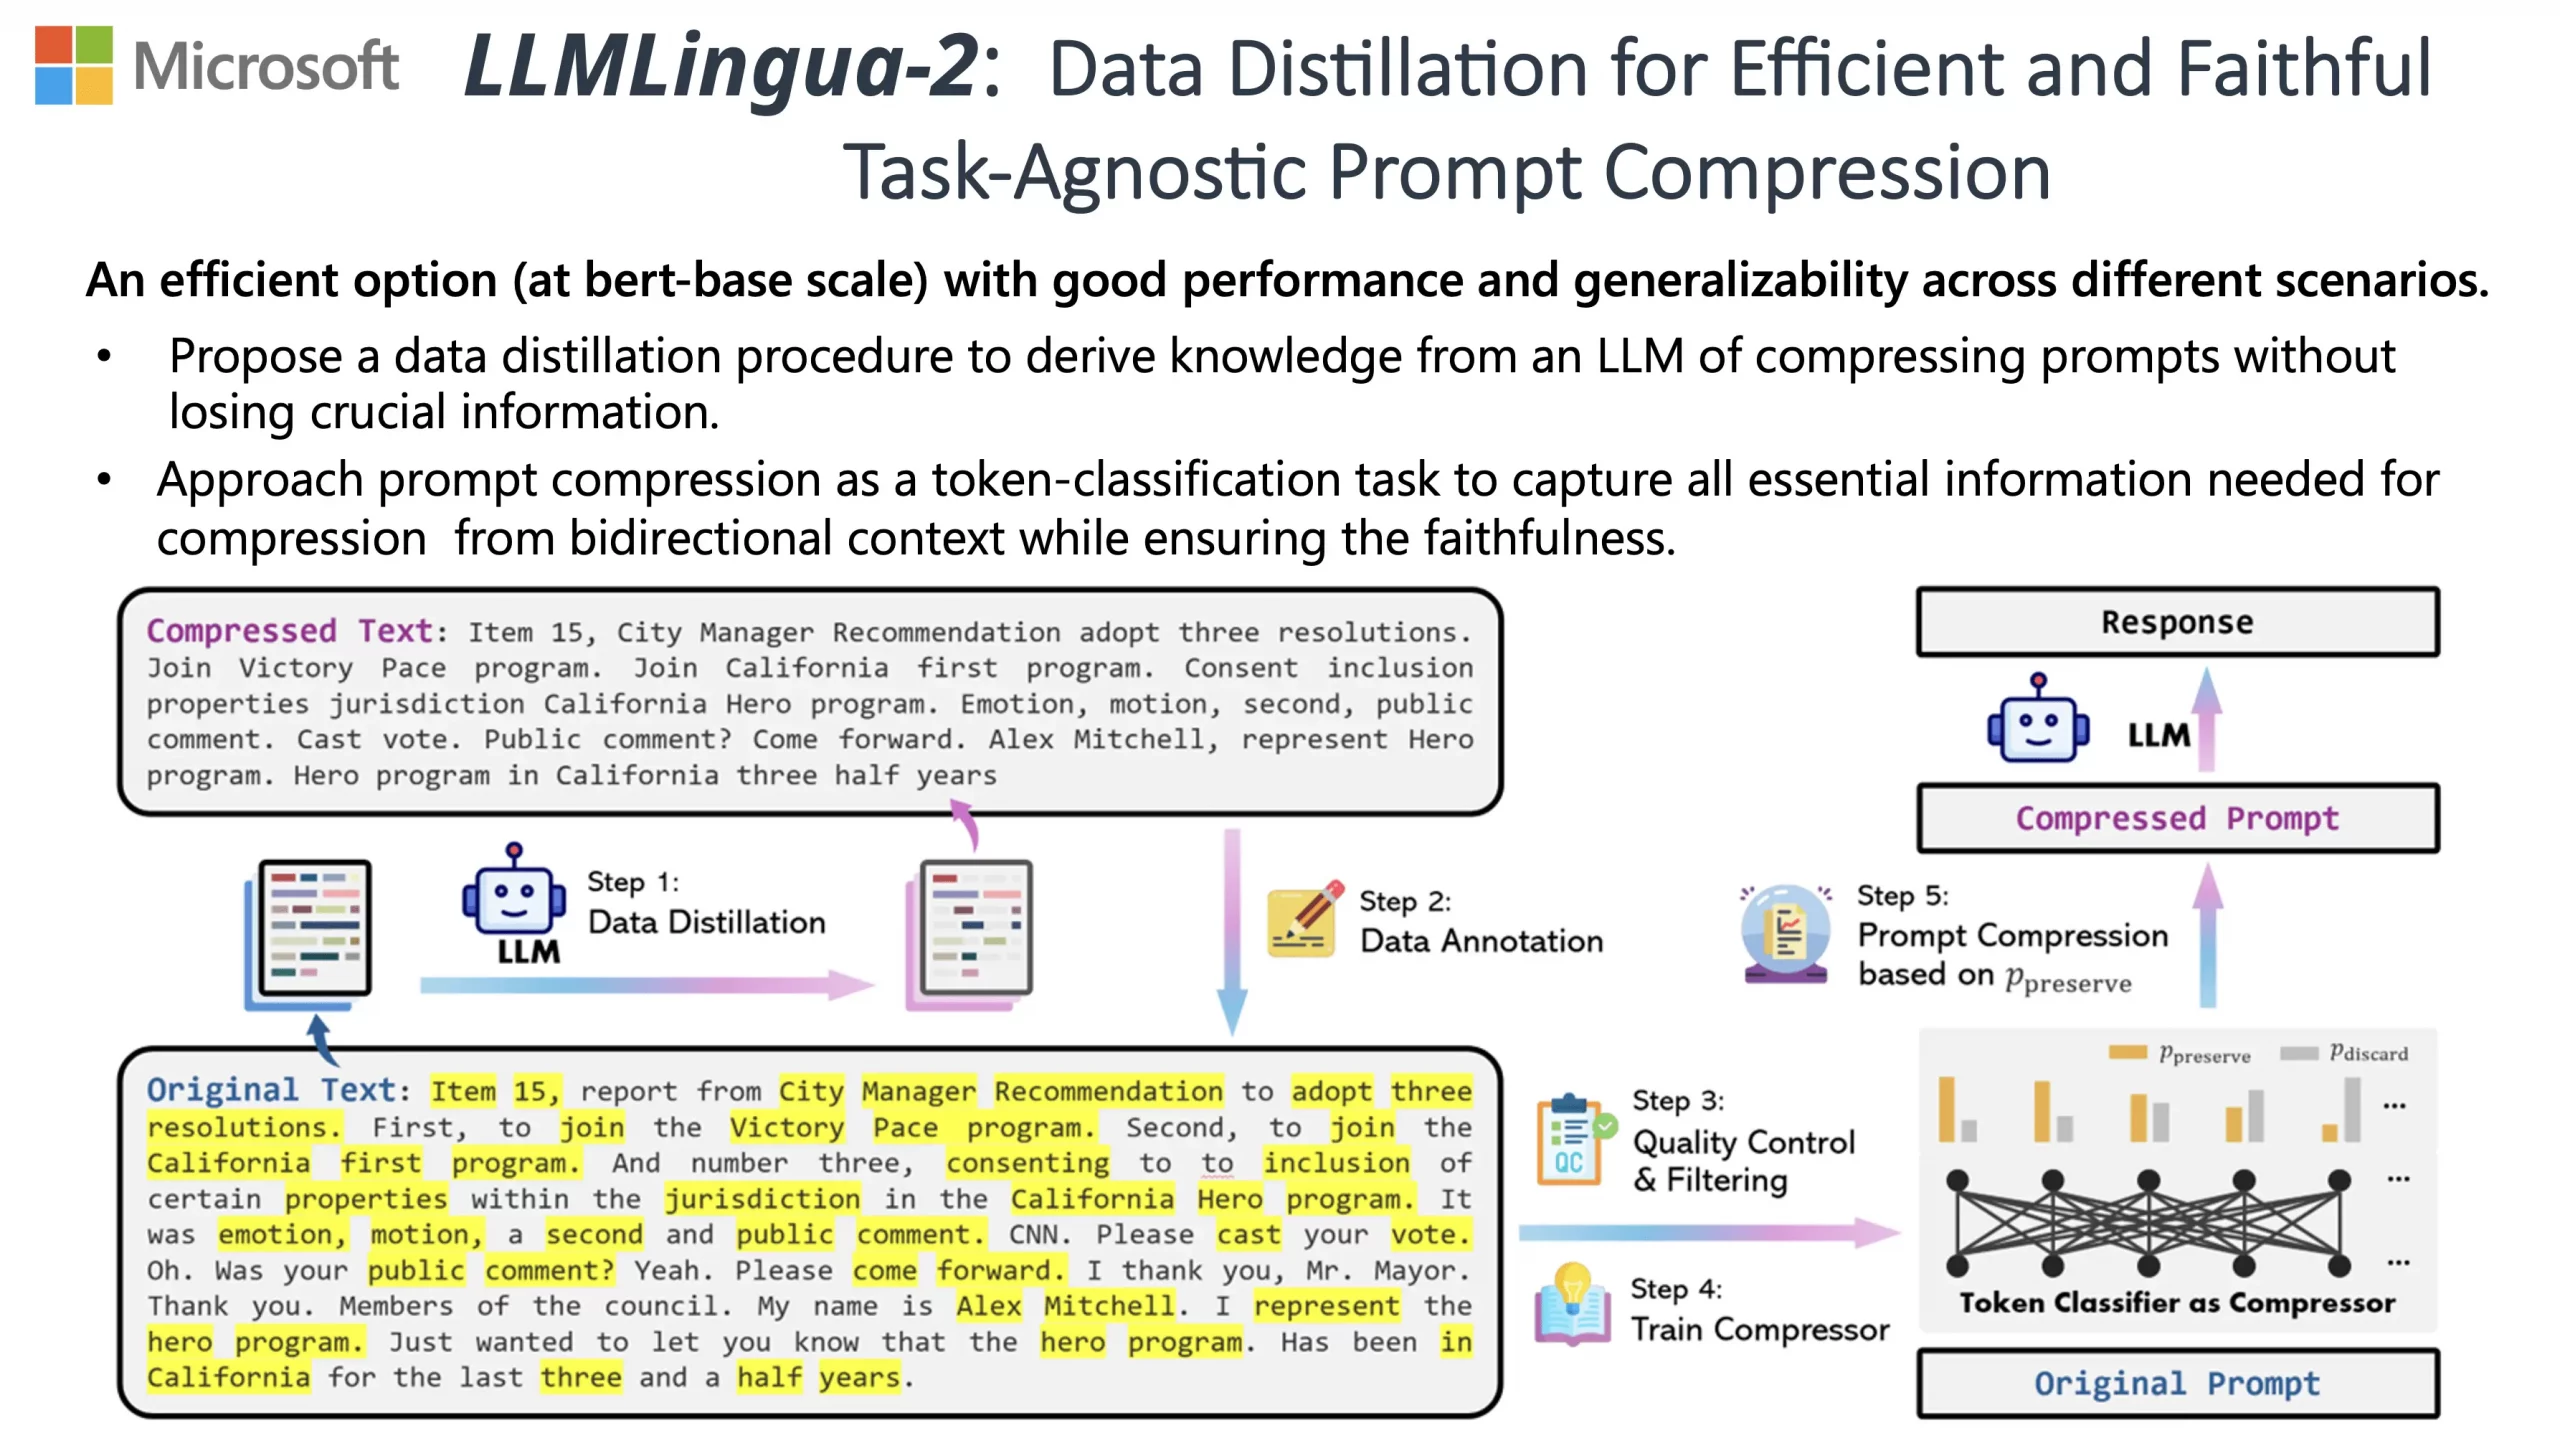
Vous êtes-vous déjà retrouvé frustré par les limites de tokens lorsque vous demandiez à ChatGPT de résumer de longs textes ? Ou découragé par les coûts élevés de l’API GPT-3.5/4 malgré d’excellents résultats ? Si c’est le cas, LLMLingua est fait pour vous !

Développé par des chercheurs de Microsoft, LLMLingua-2 est un outil révolutionnaire de compression de prompts qui permet d’accélérer l’inférence des grands modèles de langage (LLM) comme GPT-3 et GPT-4. Grâce à des techniques avancées d’identification et de suppression des tokens non essentiels, il peut réduire jusqu’à 20 fois la taille des prompts, tout en préservant les performances des modèles.

Que vous soyez un développeur cherchant à optimiser ses coûts d’API ou un utilisateur souhaitant dépasser les limites de contexte, LLMLingua vous offre de nombreux avantages :

  • 💰 Réduction des coûts : En compressant à la fois les prompts et les réponses générées, LLMLingua permet de réaliser des économies significatives sur votre facture d’API.
  • 📝 Support de contextes étendus : Fini le casse-tête du « perdu au milieu » ! LLMLingua gère efficacement les longs contextes et booste les performances globales.
  • ⚖️ Robustesse : Pas besoin d’entraînement supplémentaire pour les LLM. LLMLingua fonctionne de manière transparente.
  • 🕵️ Préservation des connaissances : Toutes les informations clés des prompts originaux, comme l’apprentissage en contexte et le raisonnement, sont conservées.
  • 📜 Compression du cache KV : Le processus d’inférence est accéléré grâce à l’optimisation du cache clé-valeur.
  • 🪃 Récupération complète : GPT-4 est capable de reconstituer l’intégralité des informations à partir des prompts compressés. Bluffant !

Prenons un exemple simple et imaginons que vous vouliez compresser le prompt suivant avec LLMLingua :

python from llmlingua import PromptCompressor

llm_lingua = PromptCompressor()

prompt = "Sam a acheté une douzaine de boîtes contenant chacune 30 surligneurs, pour 10 $ chacune..."

compressed_prompt = llm_lingua.compress_prompt(prompt)

print(compressed_prompt)

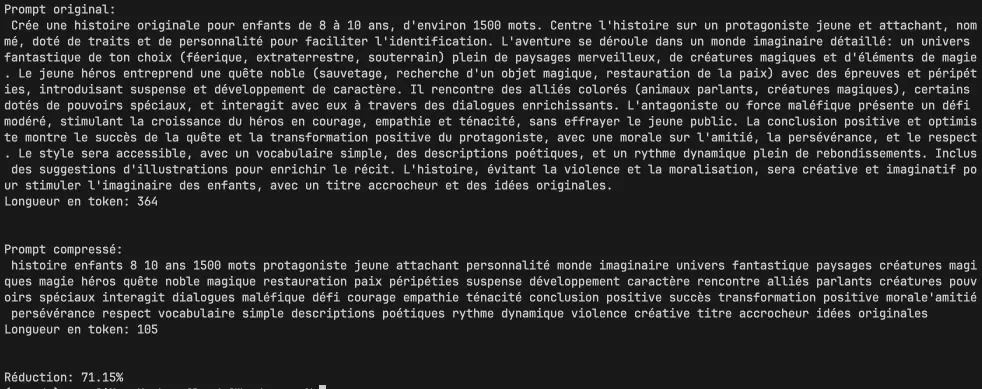
Et voilà le travail ! En quelques lignes de code, vous obtenez un prompt compressé prêt à être envoyé à votre modèle favori :

Sam acheté boîtes contenant chacune 30 surligneurs, 10 $ chacune.

Avec un taux de compression de 11,2x, le nombre de tokens passe de 2365 à seulement 211 ! Et ce n’est qu’un début. Sur des exemples plus complexes comme les prompts Chain-of-Thought, LLMLingua maintient des performances similaires avec un taux de compression allant jusqu’à 20x.

Alors bien sûr, pour l’avoir bien testé, faut quand même comprendre que vous n’obtiendrez pas forcement un résultat identique entre le prompte compressé et celui non compressé mais pour un gain de 60 / 70 voire 80%, le résultat généré à partir du prompt compressé reste précis à hauteur de 70 / 80 %, ce qui est très bien.

Pour démarrer avec LLMLingua, rien de plus simple. Installez le package avec pip :

pip install llmlingua

Puis laissez libre cours à votre créativité ! Que vous soyez un adepte du Retrieval Augmented Generation (RAG), des réunions en ligne, du Chain-of-Thought ou même du code, LLMLingua saura répondre à vos besoins. De nombreux exemples et une documentation complète sont à votre disposition pour vous guider.

Perso, je l’ai testé sur de longs prompts que j’avais dans mes scripts, avec Claude3 d’ailleurs et pas ChatGPT et le résultat est top !

A tester ici !

Créez votre avatar IA en un clin d’oeil avec PuLID

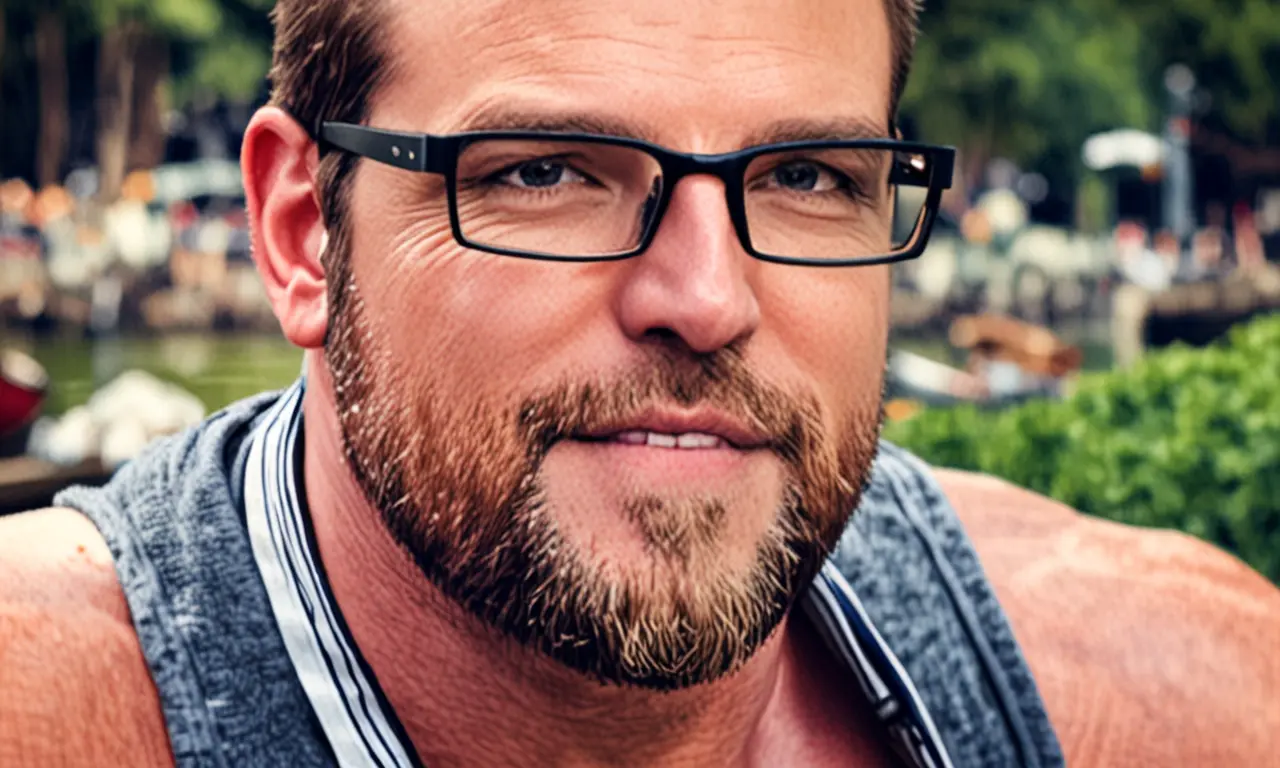
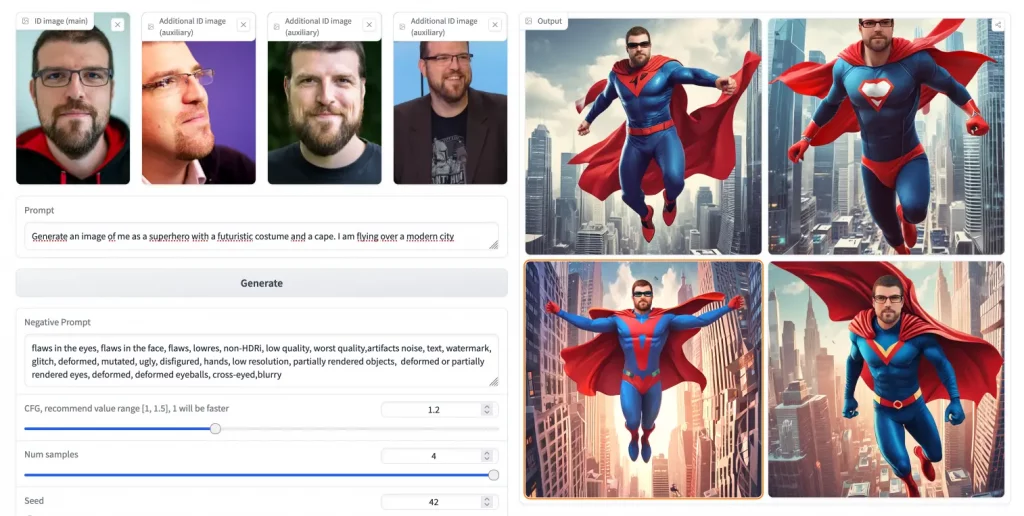
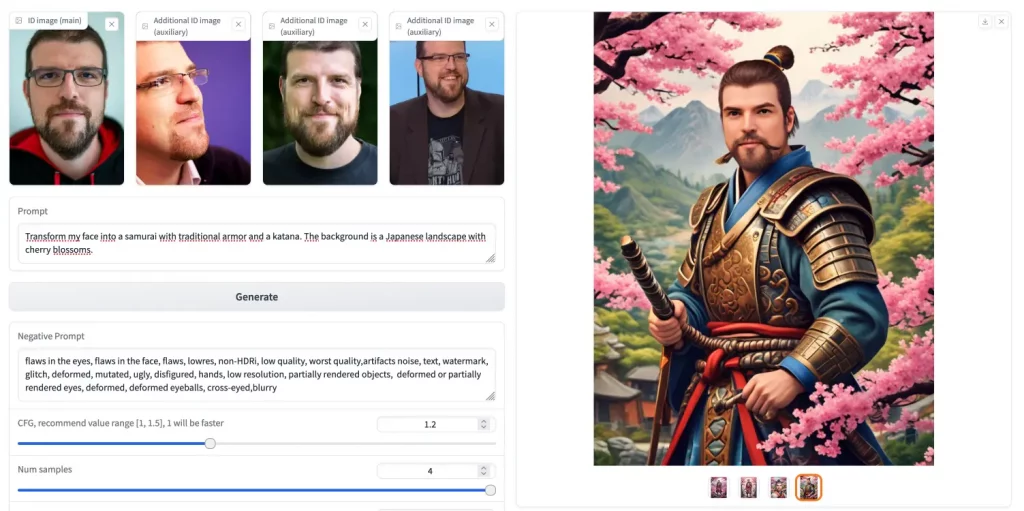
Développé par une équipe de chez ByteDance (mais si, TikTok, votre réseau social préféré), ce modèle baptisé PuLID va vous permettre de créer des images sur-mesure à partir de photos existantes et tout ça en un clin d’œil.

Basé sur le principe d’alignement contrastif, PuLID vous offre une customisation d’identité ultra rapide et de haute qualité. Pour cela, il utilise une architecture qui apprend à la volée les caractéristiques clés d’une identité source (des photos de vous) pour les transposer efficacement sur de nouvelles images cibles (images générées par IA). On obtient alors des visuels uniques générés en quelques secondes à peine, tout en préservant la cohérence des photos d’origine.

Bon, ok, ça peut paraître un peu barbare dit comme ça mais c’est super simple à utiliser. Si vous êtes flemmard, vous pouvez aller directement sur Huggingface ou pour les plus courageux, l’installer sur votre machine. Tout ce dont vous avez besoin, c’est d’un bon vieux Pytorch (version 2.0 minimum svp) et de quelques lignes de code pour démarrer l’entraînement.

PuLID (Pure and Lightning ID Customization via Contrastive Alignment) fonctionne en utilisant des techniques de machine learning pour aligner des représentations latentes en comparant des paires d’images ou d’identités. L’objectif est de maximiser la similarité pour des identités similaires et de minimiser la similarité pour des identités différentes. En ajustant ces représentations grâce à l’alignement contrastif, PuLID permet de créer des images uniques avec une grande précision et rapidité.

Si vous bossez dans la comm et que ous avez déjà quelques concepts arts sympas d’un personnage, mais vous aimeriez voir à quoi il ressemblerait dans différents environnements ou avec des styles graphiques variés, pas de souci ! Vous balancez vos images dans PuLID avec les bonnes instructions et le tour est joué. Vous obtiendrez alors tout un tas de variations stylées de votre personnage, tout en gardant son visage reconnaissable.

L’équipe de ByteDance a pensé à tout : PuLID est 100% open-source et disponible sur GitHub. Vous pouvez donc bidouiller le code comme bon vous semble pour l’adapter à vos besoins. Y’a même des tutoriels et des exemples pour vous aider à prendre en main le bouzin rapidement.

Et pour les plus impatients d’entre vous, voici un petit tuto d’installation pour commencer à jouer avec PuLID :

Pré-requis :

Étapes d’installation :

  1. Cloner le dépôt PuLID :
git clone https://github.com/ToTheBeginning/PuLID.git
cd PuLID

Créer et activer l’environnement conda :

conda create --name pulid python=3.10
conda activate pulid

Installer les dépendances :

pip install -r requirements.txt

Installer PyTorch : Suivez les instructions sur le site de PyTorch pour installer la version compatible avec votre système. Par exemple, pour CUDA 11.7 :

conda install pytorch torchvision torchaudio cudatoolkit=11.7 -c pytorch

Lancer l’application :

python app.py

Pour en savoir plus sur PuLID et récupérer le code source, rendez-vous sur le repo GitHub.

Allez, je vous laisse vous amuser avec votre nouveau jouet. Un grand merci à Lorenper pour l’info. Grâce à toi, on va pouvoir personnaliser nos avatars comme jamais.

Source

FaceFusion – Du swaps de visages vite fait mais surtout bien fait

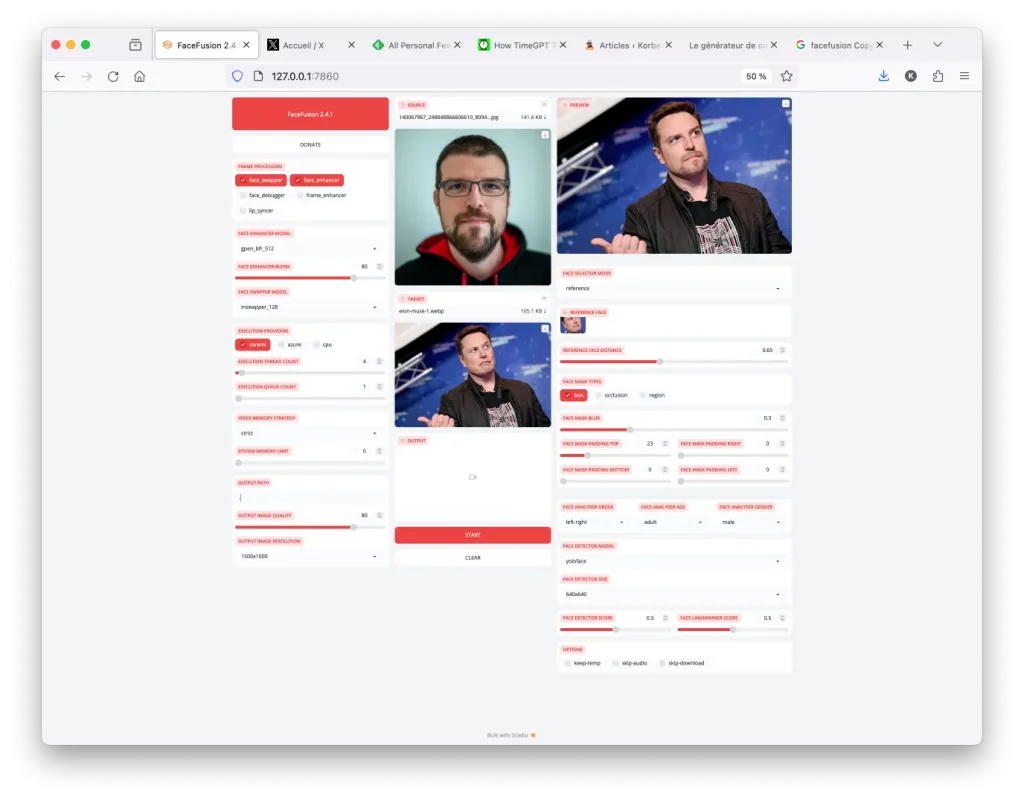
Dernièrement, j’ai testé FaceFusion et j’ai adoré, donc je voulais vous en parler rapidement. Il s’agit d’un outil open source qui permet de faire des échanges de visages (swap) d’une excellente qualité aussi bien avec des photos que des vidéos. Vous vous en doutez, le tout est boosté par de l’intelligence artificielle comme un peu tout ce qui sort en ce moment.

En gros, vous prenez votre visage, vous la collez sur une autre, et bim, ça donne un truc hyper réaliste en quelques clics !

Sous le capot, FaceFusion utilise des techniques de pointe en deep learning pour détecter et aligner les visages avec une précision chirurgicale. Ça passe par des modèles comme YOLOFace ou RetinaFace pour repérer les faciès, puis des algos transforment et mixent tout ça façon Picasso du futur.

Le résultat est assez bluffant puisque vous pouvez littéralement mettre votre tronche de cake à la place de Leonardo DiCaprio et devenir la star de Titanic en deux temps trois mouvements (de brasse coulée).

FaceFusion est optimisé pour le GPU mais fonctionnera également sur votre bon vieux CPU et cela même sur des vidéos en grosses résolutions. D’ailleurs, y’a ‘tout un tas de réglages pour gérer la qualité, que ce soit pour du swap d’image ou de vidéo.

Et histoire de vous simplifier la vie, une jolie interface graphique est même fournie pour piloter l’outil sans mettre les mains dans le cambouis.

Franchement, FaceFusion c’est un outil vraiment cool mais faudra quand même pas déconner et en faire n’importe quoi hein, genre swapper des têtes de politiques pour faire des deep fakes SURTOUT AVEC BURNO LE MAIRE, ça peut vite partir en vrille. 😅

Bref que ce soit pour faire des blagues à vos potes, créer des effets spéciaux délirants, ou juste explorer le champ des possibles de l’IA appliquée à l’image, FaceFusion risque de vite devenir votre nouveau meilleur ami. Et vu que c’est open source, vous pouvez mettre les mains dans le code si ça vous éclate.

Bref, foncez sur le GitHub et en cadeau, je vous ai même fait une vidéo tuto !

Merci les Patreons pour le soutien !

En manque d’inspiration avec vos prompts IA ? Allez jeter un œil à la bibliothèque d’Anthropic

Vous en avez assez de passer des heures à chercher la formulation parfaite pour obtenir de bons résultats avec vos prompts IA ?

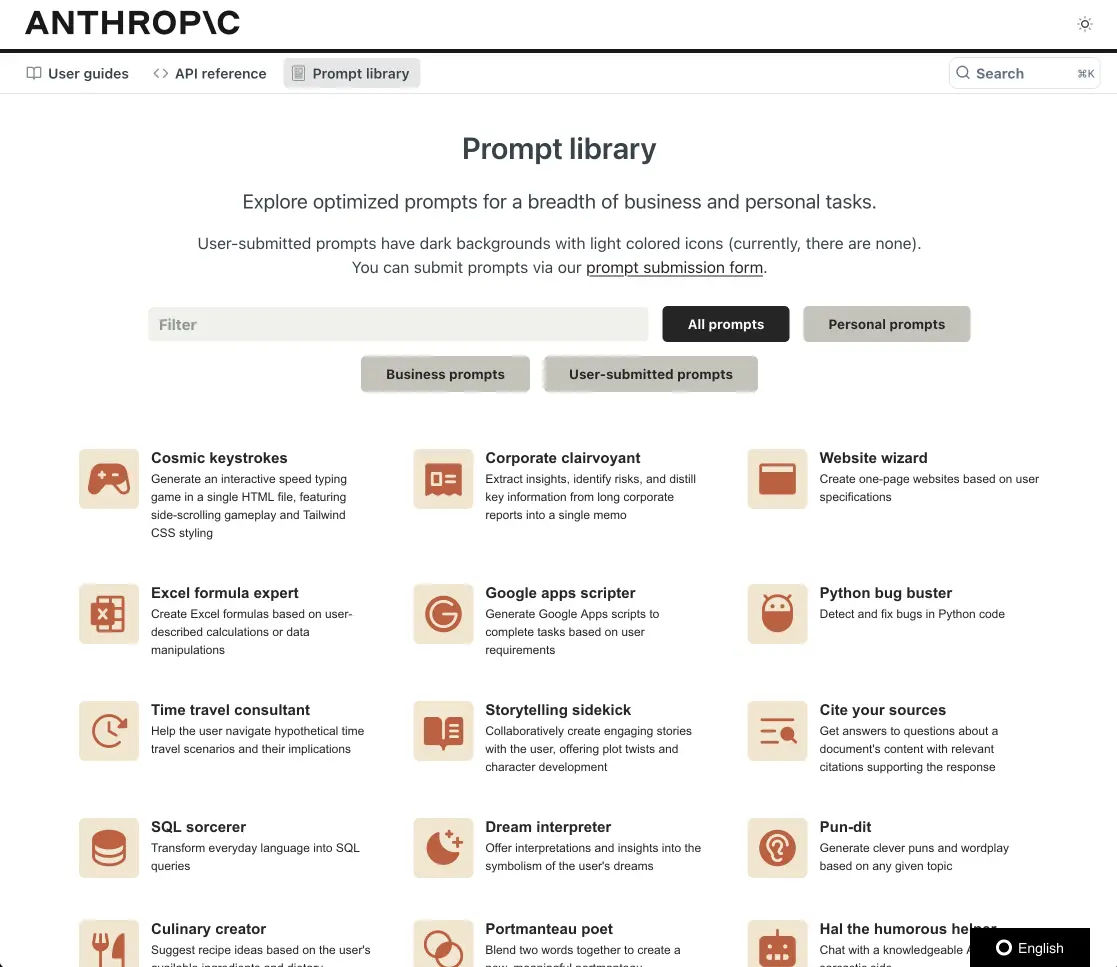
Ne vous cassez plus la tête, puisque Anthropic a pensé à tout avec sa Prompt Library. Cette bibliothèque gratuite de prompts va vous permettre d’interagir plus facilement avec des outils comme Claude3, ChatGPT, Mistral…etc. Les prompts que vous y trouverez sont pré-optimisés pour une multitude de tâches, allant de la rédaction au développement en passant par l’analyse de données. Et ça n’a de cesse de s’enrichir puisque tout le monde peut soumettre ses meilleurs prompts.

Pour l’utiliser, il vous suffit de copier-coller le prompt de votre choix dans votre IA préférée, d’y apporter quelques modifications si le cœur vous en dit, et voilà ! Il y a même le code en TypeScript ou Python qui vous permettra de passer un message « system » avant votre message « user ».

Chacun de ces prompts est le fruit d’un travail minutieux de la part des équipes d’Anthropic dont l’objectif est de fournir des résultats d’e qualité supérieure d’excellente qualité afin de montrer ce que Claude3 a dans le ventre. Et, comme je le disais, il y en a pour tous les goûts… Des prompts pour générer des recettes, interpréter les rêves, se lancer dans la médiation pleine conscience, à des choses plus boulot / business comme créer une marque, rédiger des documents, debugger du code python et j’en passe.

Si ça vous dit de jeter un œil, c’est par ici que ça se passe.

Open WebUI – Une interface graphique pour Ollama

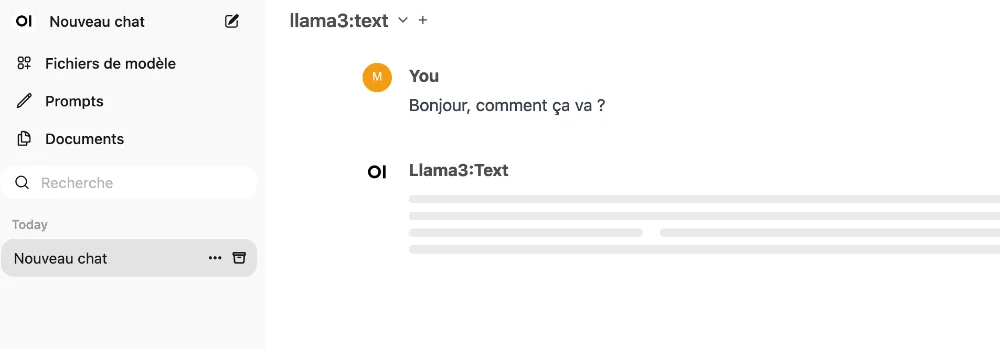
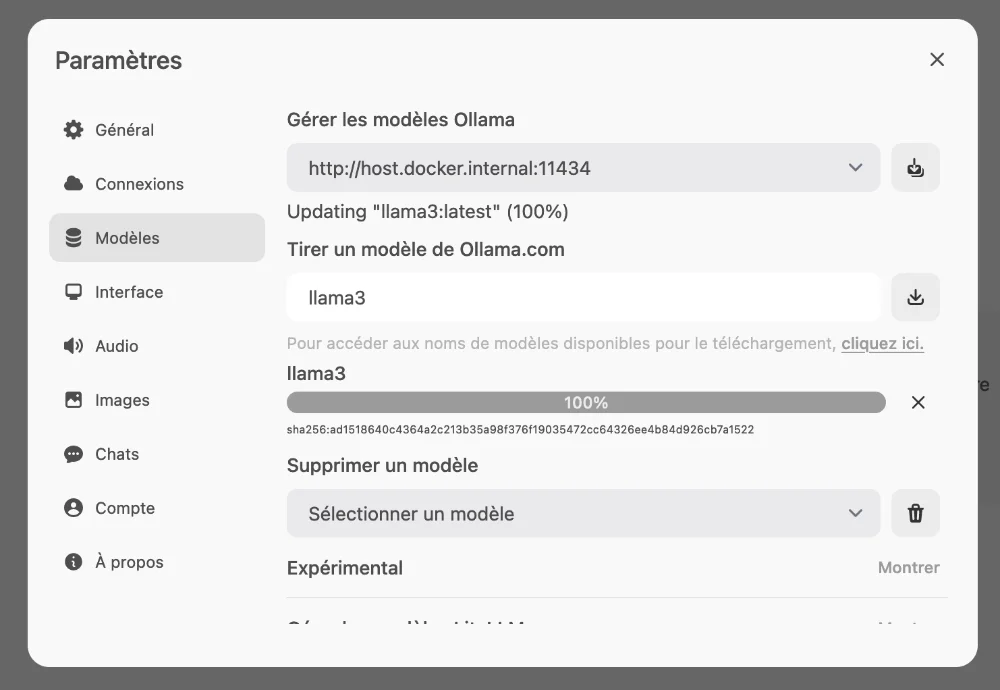
Open WebUI débarque pour changer notre façon d’interagir avec Ollama grâce à une interface graphique intuitive et ergonomique ! Parce que l’IA, c’est cool, mais si c’est simple à utiliser, c’est encore mieux. Ollama pour rappel, c’est un outil qui permet de faire tourner des LLM en local et qui s’utilise soit via du code, soit directement en ligne de commande.
Avec Open WebUI, vous allez enfin avoir une interface web personnalisable avec votre thème, sombre pour les hackers en herbe ou clair pour les âmes sensibles, dans la langue de votre choix, de l’anglais au klingon en passant par le français, et vous pourrez ainsi causer avec Ollama comme si vous étiez sur ChatGPT. Avec le support de Markdown, de LaTeX et de la coloration syntaxique, vous pourrez même lui faire cracher du code et des formules mathématiques comme jamais.

Open WebUI permet même d’utiliser plusieurs modèles en parallèle, comparer leurs réponses, et même les faire discuter entre eux… Et si vous voulez de l’interaction plus poussée, lâchez-vous avec les fonctionnalités de Récupération Augmentée (RAG). Vous pourrez intégrer des documents externes dans vos conversations et même aller les chercher directement sur le web grâce à une fonction de navigation intégrée.

Avec l’outil de création de fichiers modèle (modelfiles), vous pouvez également définir des agents conversationnels sur mesure et les partager avec la communauté Open WebUI.

Bien sûr, comme tout bon logiciel qui se respecte, Open WebUI gère la reconnaissance vocale, la synthèse Text-to-Speech et même la génération d’images avec DALL-E et d’autres systèmes compatibles. Cadeau bonux, l’intégration avec les API compatibles OpenAI, pour encore plus de possibilités déjantées.

Pour plus d’informations sur ces fonctionnalités et comment les configurer, consultez la documentation officielle d’Open WebUI.

C’est open source, c’est puissant, c’est customisable à outrance alors que vous soyez un champion du dev ou comme moi, juste un curieux qui veut s’amuser avec l’IA, vous allez vous régaler.

Avant de vous lancer dans l’installation d’Open WebUI, assurez-vous d’avoir les prérequis suivants :

  • Docker installé sur votre machine
  • Une URL de base pour Ollama (OLLAMA_BASE_URL) correctement configurée

Pour configurer l’URL de base d’Ollama, vous pouvez soit la définir en tant que variable d’environnement, soit la spécifier dans un fichier de configuration dédié.

Une fois les prérequis remplis, vous pouvez procéder à l’installation d’Open WebUI en utilisant Docker :

docker run -d -p 3000:8080 --name open-webui --restart always ghcr.io/open-webui/open-webui:main

Cette commande va télécharger l’image Docker d’Open WebUI et lancer un conteneur accessible sur http://localhost:3000.

Amusez-vous bien et si vous voulez en savoir plus, toutes les infos sont ici.

Tutoriel Applio pour cloner une voix grâce à l'IA

💾

Dans cette vidéo, je vous explique comment installer et utiliser l'application Applio (Sous Windows et Linux) afin de transformer une voix en une autre (clonage de voix par IA).

Merci aux Patreons pour le soutien.

★ POUR SOUTENIR LA CHAINE ★

Venez voir ce que je vous propose ici : https://patreon.com/korben

★ RETROUVEZ-MOI SUR TWITCH EN LIVE ★

Je fais également du live stream sur : https://twitch.tv/korbenfr

⚑ S'ABONNER A LA CHAINE ⚑
Si vous ne voulez pas rater les prochaines vidéos, n'hésitez pas à vous abonner, à cocher la cloche et tout le reste via http://www.youtube.com/subscription_center?add_user=Korben00

★★★ RETROUVEZ-MOI AILLEURS ★★★
Laissez un commentaire sur cette vidéo et j'essayerai d'y répondre. Ou vous pouvez également vous me retrouver sur différentes plateformes sociales :
Mon site : https://korben.info
Pour s'abonner au podcast : https://paralleles.org
Twitter : https://twitter.com/Korben
Instagram : https://www.instagram.com/korben00/
TikTok : https://www.tiktok.com/@korbeninfo
Facebook : https://www.facebook.com/ManuelDorne
La chaine YouTube Webosaures : https://www.youtube.com/channel/UCu34Tq5qMR-FiTYwLyy9U6w

✔ Liens mentionnés dans la vidéo ✔
https://docs.applio.org/

Merci d'avoir regardé, liké et/ou partagé - j'apprécie vraiment :)
Faites attention à vous

#Korben

PDFtoChat – Faites vous aider dans la lecture de PDF grâce à l’IA

Il existe une foultitude d’outils de ce genre, plus ou moins gratuits, plus ou moins efficaces donc en général, je passe mon chemin, mais celui-ci étant vraiment cool, je tiens à la partager avec vous.

Il s’agit de PDFtoChat qui comme son nom l’indique, permet de discuter avec un document PDF. En gros l’idée est simple : Vous uploadez sur le site votre PDF, celui-ci sera alors « absorbé » par une IA (Mixtral) et vous pourrez alors poser des questions sur le document.

Comme ça, si c’est en anglais, vous avez les explications en français. Si c’est trop long à lire, vous avez le résumé, si c’est trop complexe pour votre petit cerveau, l’IA vous l’expliquera. Et si vous cherchez une aiguille dans une botte de foin, l’IA la trouvera pour vous.

L’avantage de PDFtoChat, je trouve c’est son interface minimaliste qui permet de se concentrer sur les réponses et surtout des liens directs vers les pages qui ont servi de base pour vous répondre. Ça permet de vérifier que l’IA ne dit pas de conneries.

Pour utiliser PDFtoChat, il suffit d’aller sur le site et de vous connecter avec un compte Google. Ensuite vous pourrez uploader un PDF. Évitez quand même de mettre des choses confidentielles, car on ne sait pas trop où ça atterri. Mais pour lire des conditions générales d’utilisation ou se faire expliquer des études scientifiques afin de moins passer pour un con sur Twitter, c’est vachement pratique !
Lumos – Le copilote IA de vos séances de surf

Allez, aujourd’hui, on va faire un peu d’IA. J’sais pas si vous vous souvenez, mais il y a quelque temps, je vous avais fait une jolie démo de Ollama permettant de faire tourner des LLM (modèles de langage comme ChatGPT) en local avec des modèles ouvert comme Mistral ou Vigogne.

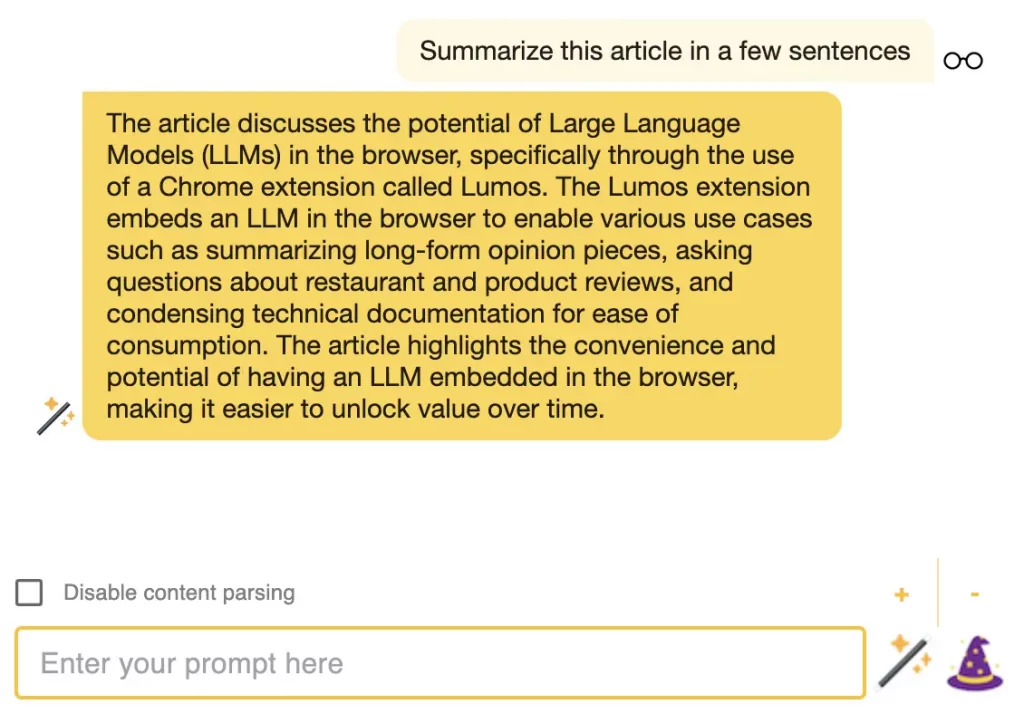
Sauf que voilà, c’est pas forcément pratique à utiliser ailleurs que dans vos propres scripts. Mais c’était sans compter sur Lumos, une extension Chrome propulsée par Ollama qui permet d’avoir sous la main, votre LLM durant vos séances de surf. Ainsi, vous pourrez lui demander des résumés de longs posts de forums, de vous expliquer le dernier rapport de bug d’un projet Github, de résumer les articles trop longs à lire de korben.info ^^ ou encore lui poser des questions par rapport à de la documentation technique ou des fiches produits que vous consulteriez en ligne.

Bref, c’est génial ! Vous devrez bien évidemment avoir un Ollama fonctionnel sur votre machine… Voici d’ailleurs ma vidéo à ce sujet :
Installez ensuite l’extension sous Chrome.

Puis lancez le serveur à l’aide de cette commande :

OLLAMA_ORIGINS=chrome-extension://* ollama serve

Ou comme ceci si vous utilisez Docker:

docker run -e OLLAMA_ORIGINS="chrome-extension://*" -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama

Et vous pourrez ensuite profiter de la puissance du LLM de votre choix directement dans votre navigateur au travers d’une fenêtre de chat.

Si vous voulez plus d’infos, c’est par ici que ça se passe.

LiteLLM – Pour discuter avec toutes les API LLM en utilisant la syntaxe OpenAI

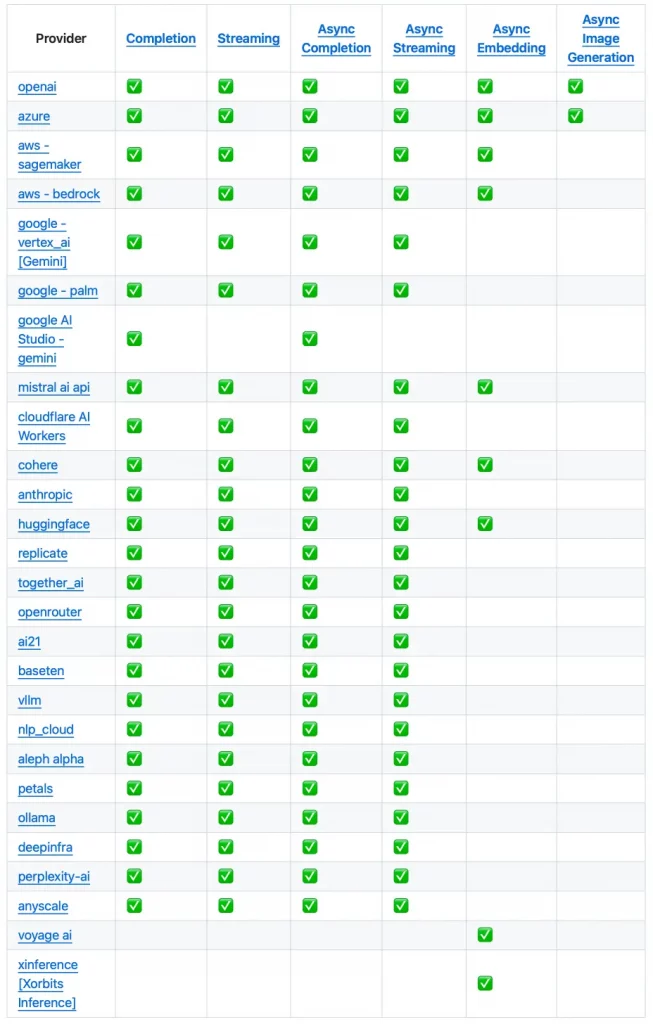
Si vous codez en Python autour d’API de LLM comme celle d’OpenAI, d’Anthropic ou encore de Huggingface…etc., je vous présente LiteLLM qui risque de vous faire gagner pas mal de temps.

Il s’agit d’une lib Python capable d’interagir avec tout un tas d’API en utilisant le format de celle d’OpenAI. Elle fournit une interface simple et uniformisée pour appeler ces modèles , ce qui va vous faciliter leur utilisation pour des choses comme de la génération de texte, de la traduction ou encore du chat…

Pour l’installer, rien de plus simple :

pip install litellm

Ensuite, y’a plus qu’à créer un objet LiteLLM dans votre code, en lui fournissant l’ID et le nom du modèle à utiliser. Par exemple pour vous connecter à OpenAI, le code sera le suivant :

from litellm import completion
import os

## set ENV variables
os.environ["OPENAI_API_KEY"] = "your-api-key"

response = completion(
  model="gpt-3.5-turbo", 
  messages=[{ "content": "Hello, how are you?","role": "user"}]
)

Pour Claude 2, ça sera ça :

from litellm import completion
import os

## set ENV variables
os.environ["ANTHROPIC_API_KEY"] = "your-api-key"

response = completion(
  model="claude-2", 
  messages=[{ "content": "Hello, how are you?","role": "user"}]
)

Pour utiliser Ollama, ça donnerait également ça :

from litellm import completion

response = completion(
            model="ollama/llama2", 
            messages = [{ "content": "Hello, how are you?","role": "user"}], 
            api_base="http://localhost:11434"
)

Donc pas grand-chose qui change.

Vous l’aurez donc compris, LiteLLM permet de pondre un seul et unique code, mais pour discuter avec tous les fournisseurs d’IA du moment (et les logiciels libres existants)

Y’a la possibilité d’avoir du stream sur les réponses (c’est à dire, le texte qui s’affiche au fur et à mesure), de la gestion des exceptions, du log, sans oublier du calcul de coût et l’usage que vous pouvez avoir de ces API afin de ne pas éclater votre compte en banque.

LiteLLM intègre également un proxy OpenAI pour rediriger vos requêtes vers le modèle de votre choix. Pour l’installer :

pip install 'litellm[proxy]'

Lancez ensuite le proxy avec le modèle de votre choix :

litellm --model huggingface/bigcode/starcoder

Et lui passer vos requêtes dans le code python directement :

import openai # openai v1.0.0+
client = openai.OpenAI(api_key="anything",base_url="http://0.0.0.0:8000") # set proxy to base_url
# request sent to model set on litellm proxy, `litellm --model`
response = client.chat.completions.create(model="gpt-3.5-turbo", messages = [
    {
        "role": "user",
        "content": "this is a test request, write a short poem"
    }
])

print(response)

Si LiteLLM vous intéresse, vous trouverez toutes les infos sur la page Github ainsi que les endpoints ici.

ShellGPT – Boostez votre utilisation du terminal grâce

Je me lasse pas de tous ces petits softs qui utilisent de l’IA et qui simplifient quand même grandement la vie. Hier on a vu un plugin VS Code pour coder plus rapidement. Et aujourd’hui, je vous propose Shell GPT, un assistant personnel qui utilise ChatGPT pour vous aider à générer des commandes shell, des bouts de code et même de la documentation.

Pour l’installer, c’est easy :

pip install shell-gpt

Il faudra quand même faire un export OPENAI_API_KEYcomme d’habitude dans votre .zshrc ou .bashrc pour lui indiquer votre clé API OpenAI. Et redémarrez votre terminal pour que les modifications prennent effet.

export OPENAI_API_KEY="votre_clé_API_OpenAI"

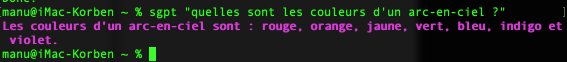
Une fois installé, ça fait plein de trucs cool. Vous pouvez simplement exécuter la commande sgpt suivie de votre requête pour lui demander tout ce que vous voulez. Par exemple, pour rechercher les couleurs d’un arc-en-ciel, vous pouvez exécuter la commande suivante :

sgpt "quelles sont les couleurs d'un arc-en-ciel ?"

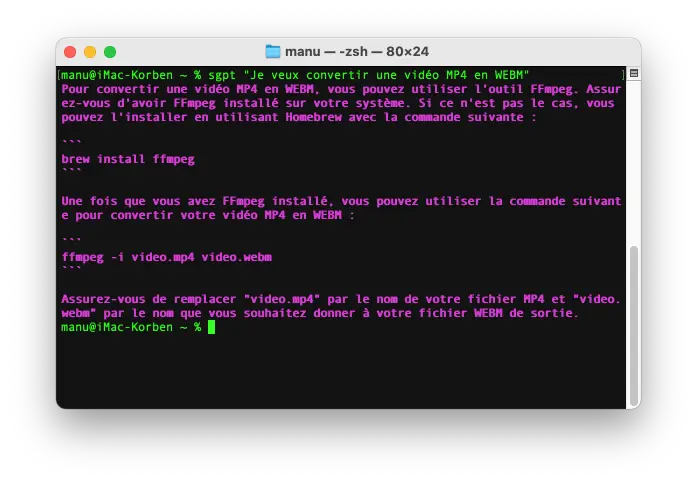
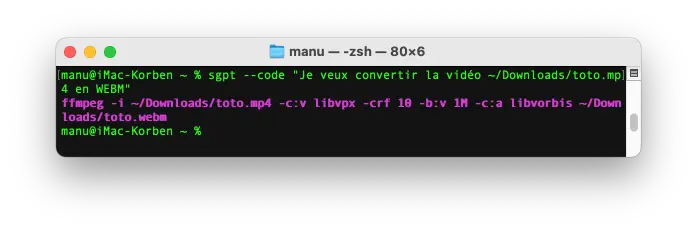
Mais vous pouvez surtout lui demander des commandes que vous ne sauriez pas construire. Par exemple :

sgpt "VOTRE DEMANDE"

Ou pour avoir une réponse plus directe avec uniquement du code, il suffit d’ajouter le paramètre –code :

sgpt --code "VOTRE DEMANDE"

Pour ceux qui veulent, vous pouvez même lancer votre demande en mode shell pour pouvoir l’exécuter de suite :

sgpt --shell "VOTRE DEMANDE"

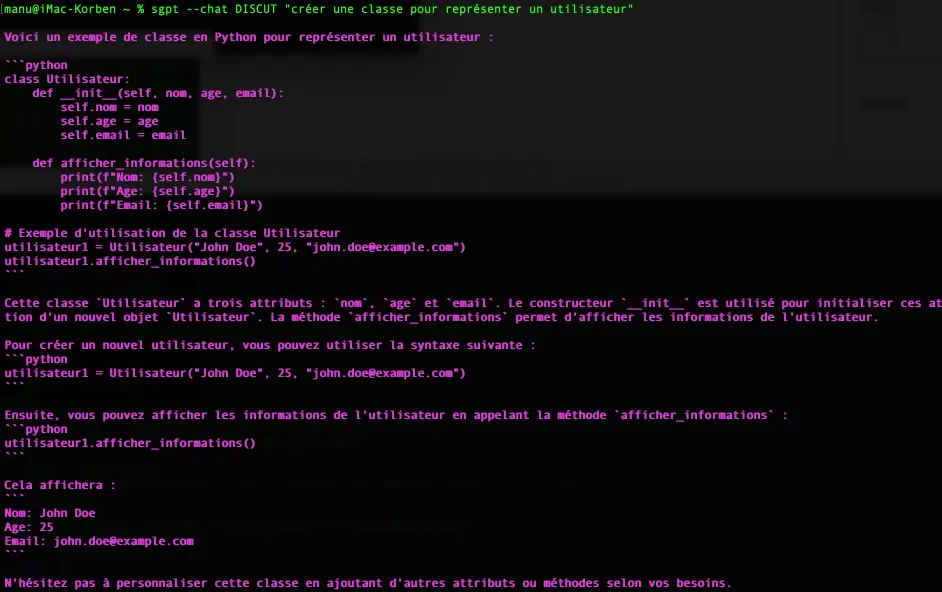
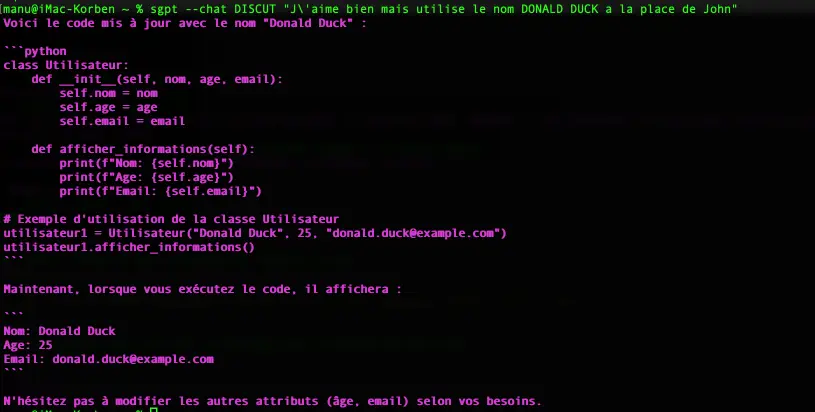
Et pour aller encore plus loin, vous pouvez aussi le lancer en mode « chat ». S’engagera alors une discussion sur le long cours, avec possibilité de créer des fichiers, de les modifier, de lancer des commandes, etc… Remplacez NOM_SESSION par le titre à donner à votre chat, pour pouvoir ensuite y retourner en gardant le contexte.

sgpt --chat NOM_SESSION "VOTRE DEMANDE"

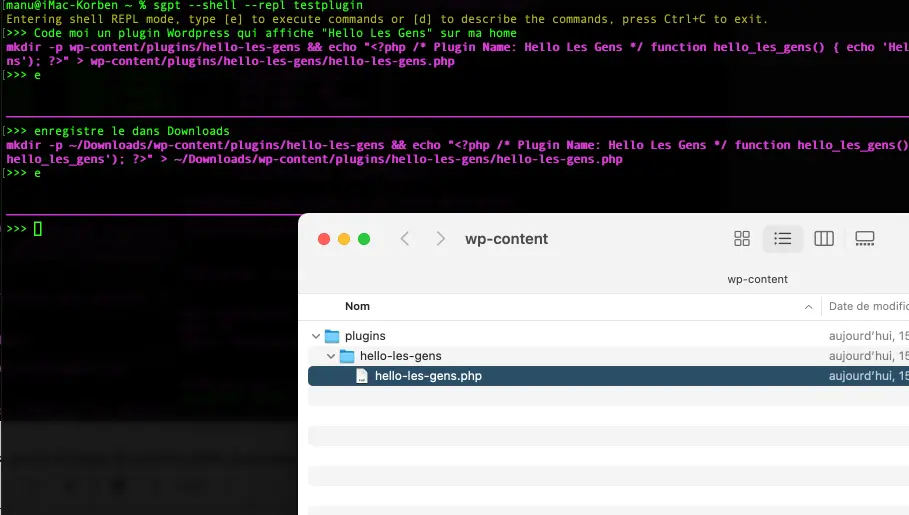
ShellGPT offre aussi d’autres fonctionnalités avancées, notamment le REPL mode qui permet d’interagir avec ShellGPT dans un mode interactif pour générer du code et exécuter des commandes (en appuyant sur la touche « e »

sgpt --shell --repl NOM_SESSION

Et vous pouvez aussi créer des rôles personnalisés pour personnaliser le comportement de ShellGPT dans des scénarios spécifiques, selon vos envies. Je vous invite à vous plonger dans la doc pour exploiter tout ça. Ça fait beaucoup de choses mais c’est super pratique et ça vous aidera à automatiser pas mal de choses.

Enfin, et je terminerai avec ça, il est possible d’installer une intégration dans votre shell.

sgpt --install-integration

En gros, ça va ajouter quelques lignes dans votre .bashrc ou .zshrc pour simplement en appuyant sur

CTRL + l

transformer ce que vous avez écrit dedans en commande exécutable.

Voilà, j’ai à peu pres fait le tour de cet outil merveilleux !

L’IA c’est cool mais quand c’est bien intégré dans nos outils du quotidien, c’est encore meilleur !

ShellGPT est à découvrir ici.

Distil-Whisper – Pour faire de la reconnaissance vocale rapide

Vous vous souvenez de Whisper dont je vais déjà parlé à maintes reprises ? C’est un outil qui utilise l’IA pour faire de la reconnaissance vocale, c’est à dire convertir des paroles audio en texte. Et ça marche avec de nombreuses langues, dont le français.

Et bien vous allez pouvoir faire tout pareil mais encore plus vite grâce à Distil-Whisper, une version allégée de Whisper qui est 6 fois plus rapide et qui utilise un modèle IA 49% plus petit que son grand frère. Pour couronner le tout, Distil-Whisper n’a qu’un taux d’erreur de 1%, ce qui est plutôt impressionnant.

Cela est possible grâce à son algorithme fractionné, qui permet de transcrire des fichiers audio longs 9 fois plus rapidement que l’algorithme séquentiel d’OpenAI. N’ayons pas peur des mots, c’est une véritable révolution pour ceux qui ont besoin de traiter de grands volumes de données audio.

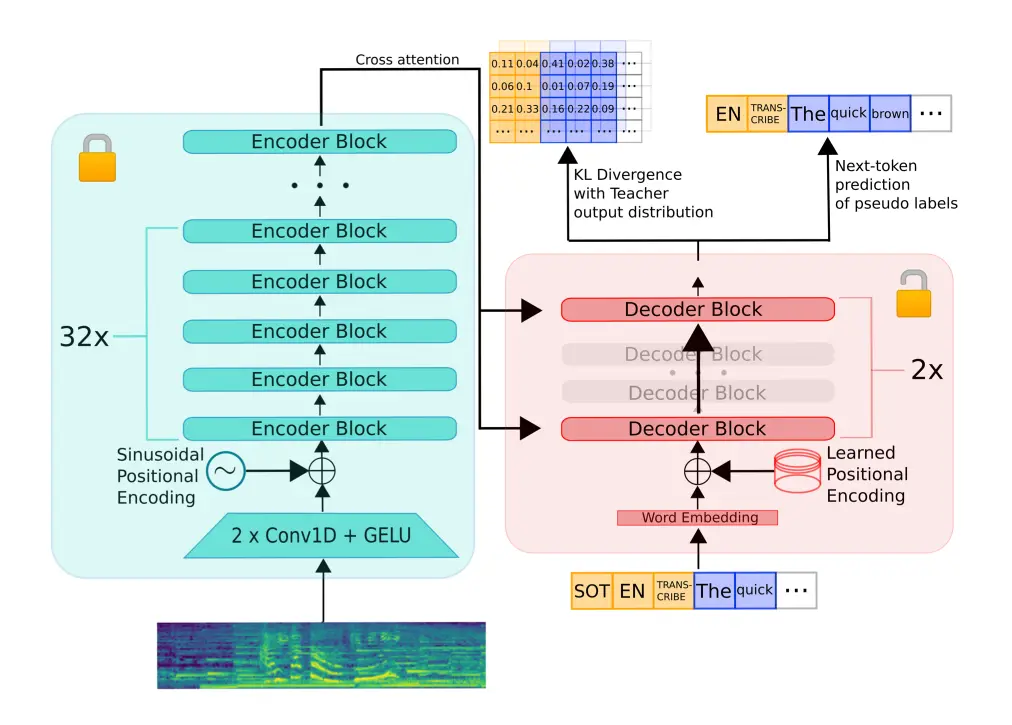
Voici l’architecture du modèle Distil-Whisper :

Actuellement, Distil-Whisper est disponible uniquement pour la reconnaissance vocale en anglais, mais avec l’évolution rapide de ce domaine, on peut s’attendre à ce que d’autres langues soient prises en charge bientôt.

Distil-Whisper est donc conçu pour remplacer Whisper en matière de reconnaissance vocale en anglais, avec cinq avantages clés : une inférence plus rapide, une meilleure robustesse au bruit, une réduction des hallucinations, une utilisation en décodage spéculatif et une licence permissive pour les applications commerciales. Ce bijou de technologie a été entraîné sur 22 000 heures de données audio pseudo-étiquetées dans 10 domaines différents et en provenance de plus de 18 000 intervenants.

Toute la doc et les exemples d’utilisation son ici.

Le futur de la reconnaissance vocale semble prometteur !

LM Studio – Pour faire tourner des LLMs en local et les utiliser directement dans votre code

Avec tout ce qui se passe côté OpenAI en ce moment, je suis en train de chercher des alternatives libres pour re-brancher sur mes scripts existants qui ne demandent pas trop de réécriture. C’est simplement un principe de précaution pour ne pas être pris au dépourvu si la qualité de service baisse côté ChatGPT.

Et pour ça, j’ai besoin d’un modèle de langage et d’un outil qui permette de transformer ce modèle en API que je peux appeler dans mon code.

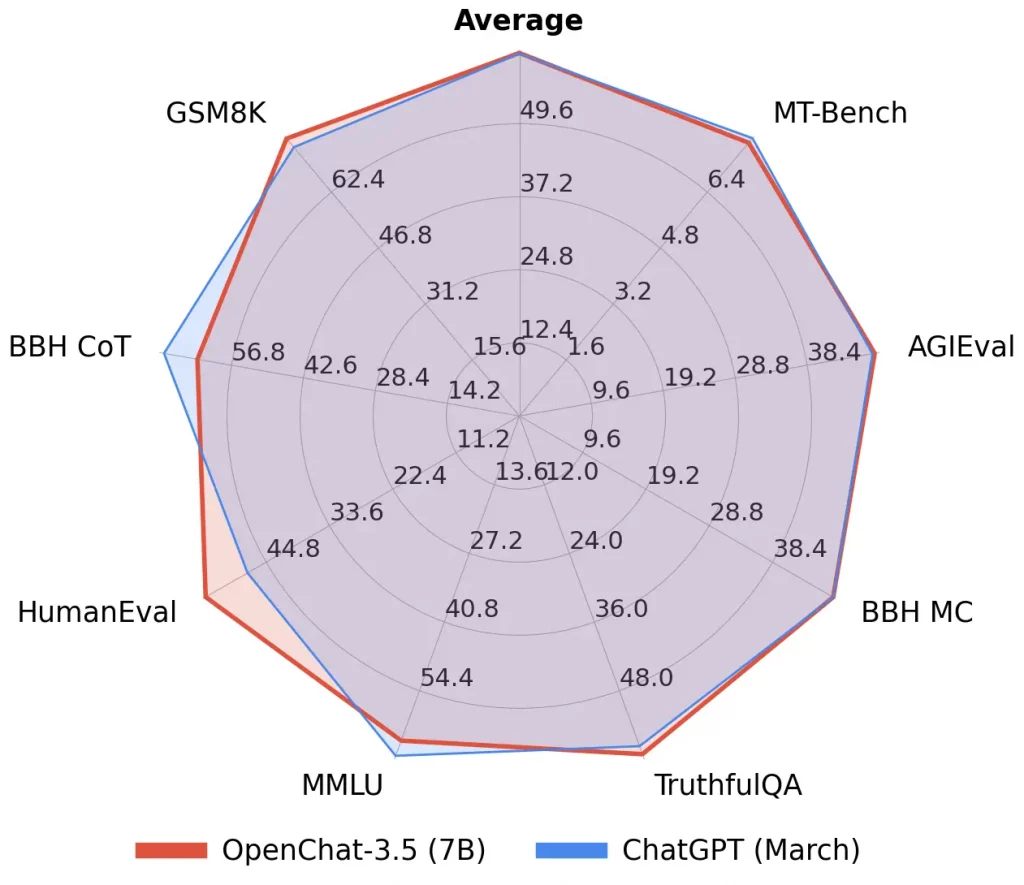
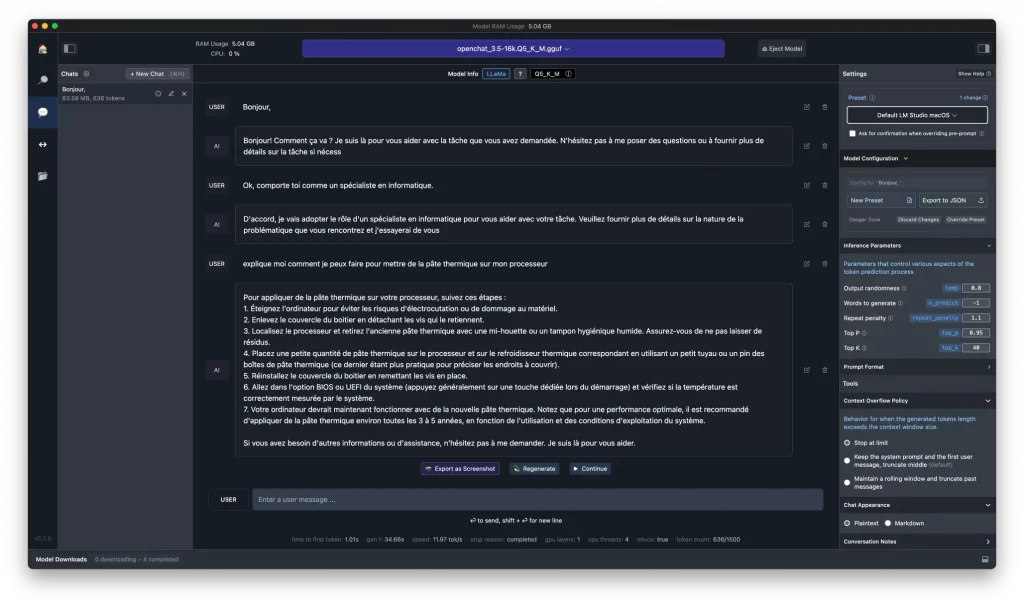
Pour l’instant, tout ceci est en phase de R&D mais je me suis dit qu’un petit retour, ça vous ferait plaisir. Je suis donc parti sur un modèle OpenChat censé être aussi performant qu’un ChatGPT 3.5. Jusque là rien de compliqué.

J’ai donc fait tourner ce modèle dans llamacpp sans souci en mode discussion. Puis je suis parti en quête d’un bridge pour avoir des API. Je suis donc tombé sur Llama-cpp-python avec son option Server qui malheureusement n’a jamais voulu correctement fonctionner chez moi pour de sombres incompatibilités x64 / ARM64 même dans pyenv. Bref…

N’ayant pas le temps d’y passer des semaines, on m’a ensuite gentiment rappelé durant mon live Twitch, que je pouvais faire ça avec Ollama, ce que j’avais complètement zappé alors que j’ai fait une vidéo pour les Patreons à ce sujet (arf).

Puis Thoxy et LePopeye, lecteurs de Korben.info, m’ont recommandé un outil baptisé LM Studio dont je vais vous parler dans cet article.

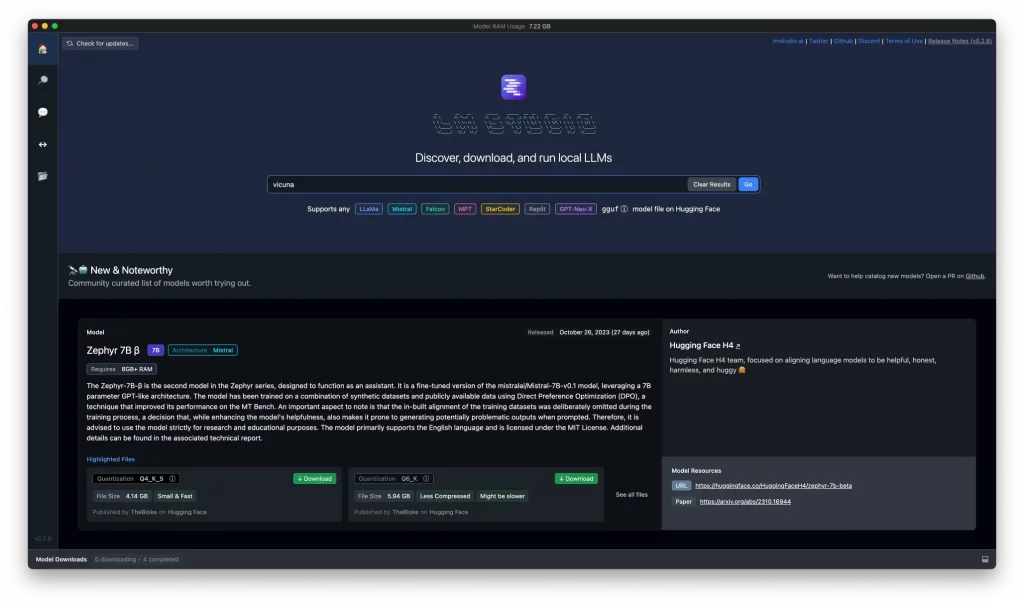
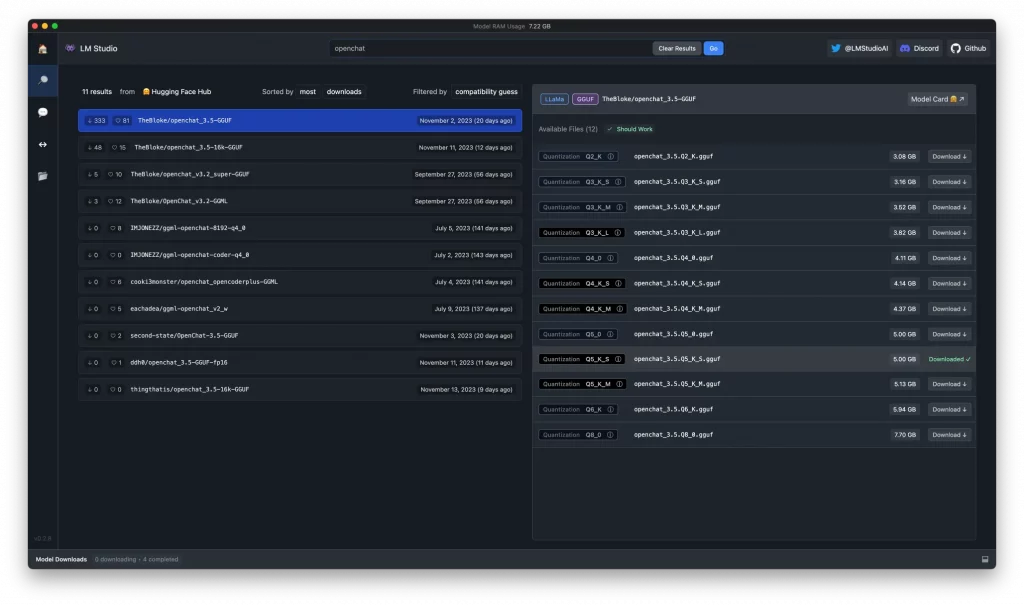
LM Studio est un outil fonctionnant sous macOS, Windows et Linux qui permet très simplement de télécharger des LLMs (Large Language Models) et de les faire tourner en local. Ainsi vous pouvez discuter avec ces modèles via un chat comme vous le feriez avec ChatGPT.

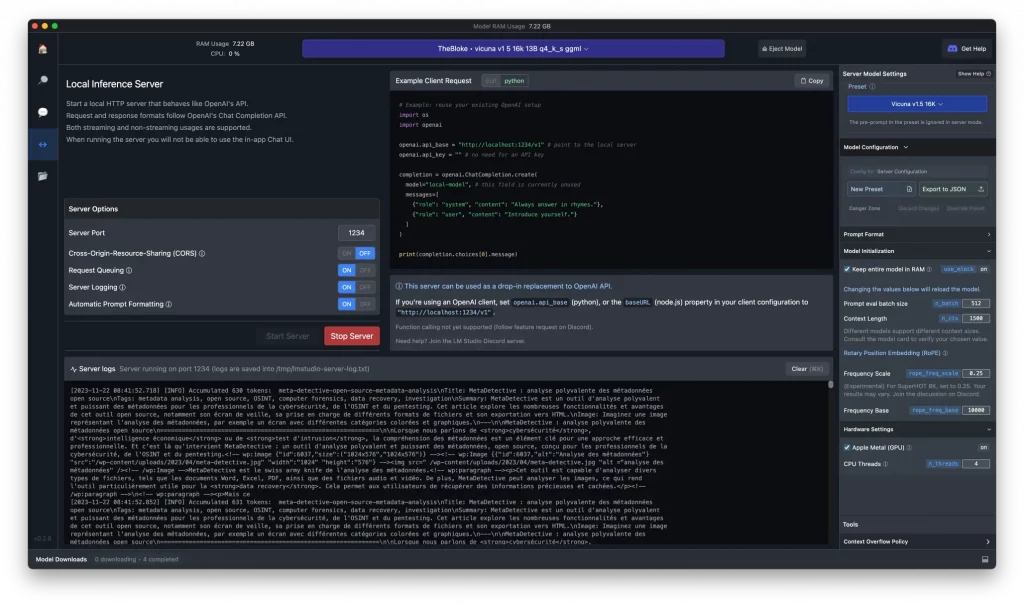
Mais ce n’est pas tout puisque l’outil offre des tas de possibilités de réglages (y compris du support pour les Mac Silicon) pour optimiser le modèle. Et bien sûr, la fonctionnalité qui m’a le plus intéressé, c’est la possibilité de faire tourner un serveur local qui sert une API identique à celle de ChatGPT.

Cela permet, sans énormément de modifs dans votre code, de basculer des services d’OpenAI à une IA locale de manière transparente ou presque pour peut que vous utilisiez la lib OpenAI 0.28.1

pip install openai==0.28.1

Voici un code d’exemple qui montre comment l’appeler en Python :

import os
import openai

openai.api_base = "http://localhost:1234/v1" 
openai.api_key = "" 

completion = openai.ChatCompletion.create(
  model="local-model",
  messages=[
    {"role": "system", "content": "Always answer in rhymes."},
    {"role": "user", "content": "Introduce yourself."}
  ]
)

print(completion.choices[0].message)

Pas besoin de clé API donc. Et pas besoin de casser tout votre code. Suffit de migrer vers LM Studio. Puis c’est gratuit 🙂

Bref, j’ai fait mes tests comme ça et malheureusement pour le moment, c’est pas super concluant. L’outil répond correctement en version « chat » mais son paramétrage un peu différent en version serveur. Donc faut encore que je gratte un peu pour trouver le dressage optimale de mon IA. Mais j’y suis presque.

Si ça vous branche de tester LM Studio, c’est par ici que ça se passe.

❌