Connexion

Il y a quelqu’un derrière la machine
C’est pratique une machine. On lui parle, elle répond. On lui demande une image, elle la produit. Du code, elle le code. Une recherche juridique, elle cherche, et trouve. Et même, si on lui demande comme il faut, elle commence à participer à sa propre fabrication de son “moi” augmenté, de son nouveau “moi” qui va lui succéder.
Tout paraît très simple. Fluide. Presque totalement silencieux. Il suffit “juste” de savoir exprimer ce qu’on a dans le tête. Enfin, avec certains nouveaux modèles, on n’a même plus besoin de savoir. Quelques idées jetées en vrac, et paf !!! On a un résultat. Whaou…
Et le “tour de magie”, l’illusion, c’est bien ici qu’il fonctionne le mieux : faire disparaître tout ce qu’il y a derrière le résultat. Nos amis de l’industrie de l’IA savent très bien entretenir cette illusion. Et le langage naturel est pour eux le vecteur idéal pour continuer à diffuser cette illusion.
Parfois, les modèles savent se taire. Nan, je déconne.
Bienvenue sur IA-Pulse Weekend. Cette édition porte le numéro 180. En vous abonnant, vous recevez tous les samedis matin, l’essentiel de ce qu’il s’est passé cette semaine autour de l’IA : un coup de gueule édito, une sélection de 3 actualités avec pour chacune un résumé rapide à lire, une liste supplémentaires d’actualités et d’études académiques, et 1 article de fond pour ouvrir l’esprit. Gérez votre abonnement.
⏱️Temps de lecture de cette newsletter par une unité carbone : 10 mins
Cette semaine la partie de cette newsletter gérée par l’IA, les 3 clusters d’articles, a été générée par Kimi K3 pour les résumés des sources, ainsi que la génération des clusters et des titres. Comme d’habitude j’ai fait quelques modifications, mais j’ai aussi laissé quelques tournures typiques des modèles de langage. Et bien entendu, mes commentaires éventuels sont en italique dans ces résumés. Le texte de “l’article qui fait réfléchir” est issu de GPT 6-Astra. L’image d’illustration ci-dessous a été générée par Midjourney
📰 Les 3 infos de la semaine
⚖️ Astra for Law : OpenAI construit son moteur de recherche juridique et branche GPT-6 dessus
OpenAI a lancé Astra for Law, une version de GPT-6 Astra spécialement équipée pour le travail juridique. OpenAI a pris son modèle frontière et lui a ajouté des instructions spécifiques, des outils, des contrôles adaptés aux cabinets d’avocats et surtout un index de recherche juridique dédié.
Et c’est probablement cet index qui est le plus intéressant. Astra for Law peut chercher dans la jurisprudence américaine, les lois, règlements, règles de procédure et décisions administratives, au sein d’un corpus de plus de 230 millions d’URL actualisé quotidiennement. Grâce au Free Law Project et à CourtListener, OpenAI revendique notamment l’accès à plus de 99,9 % de la jurisprudence américaine publiée faisant précédent. Le groupe précise toutefois que ce moteur complète, et ne remplace pas, les bases sous licence de fournisseurs comme Thomson Reuters.
Les premiers accès passent directement par ChatGPT et Codex pour des cabinets sélectionnés. L’API doit suivre. OpenAI lance parallèlement 26 plugins vers des outils comme Relativity, Clio, iManage, Intapp ou Thomson Reuters.
Pourquoi est-ce important ? OpenAI vient de démontrer avec ses propres développements que son modèle ne se suffit pas à lui-même, que même Astra n’est pas magique. GPT-6 Astra devient nettement meilleur quand on lui donne un vrai moteur de recherche juridique, un corpus spécialisé et les bons outils. Dans le monde professionnel, la bataille se joue sur les index, les sources, les droits d’accès, le contexte métier et les outils branchés autour du modèle. Bienvenue au club. Révélation exclusive : dans les métiers complexes du droit, connaître le droit aide pour faire du droit, et qu’il ne suffit de savoir faire une recherche sur Google pour être au niveau… même avec l’AGI dans le communiqué de presse. Damned…
Pour aller plus loin : OpenAI, Reuters, TechRepublic
🔁 Chez Anthropic, Claude mesure combien Claude fabrique Claude
Cette semaine, Anthropic ne publie pas un nouveau chiffre ou un nouveau résultat pour nous dire que Claude est le meilleur en maths ou en code. L’entreprise essaie de nous dire qu’elle mesure dans quelle proportion Claude participe lui-même à la fabrication des prochains Claude.
Elle a créé pour cela un « R&D Automation Index », fondé sur une échelle de 5 niveaux proposée par Epoch AI allant d’aucune intervention de l’IA à un travail entièrement autonome, sans humain dans la boucle -si ça vous rappelle les niveaux de la conduite autonome c’est normal… d’ailleurs on en est où du niveau 5 sur route ouverte ?- Sur le mois d’août, Anthropic estime que Claude a « dirigé » 26 % de ses activités de R&D sur les modèles : c’est-à-dire que le modèle a accompli l’essentiel d’une tâche à partir d’une instruction de haut niveau -c’est quoi exactement une instruction de haut niveau chez Anthropic ? Ben on sait pas trop-, sous supervision humaine. Selon Anthropic, plus de 90 % du travail et des tâches mesurées ont atteint au moins le niveau « collaboration ». Anthropic précise qu’aucune des catégories mesurées n’est encore entièrement autonome -de quoi rassurer certains, peut-être.
Pour faire ces mesures, Anthropic a échantillonné chaque semaine de juillet 20 % des salariés des équipes participant au développement des modèles. Un agent Claude a analysé leurs documents internes et leurs échanges Slack pour produire environ 15 000 tâches, ensuite organisées en 542 catégories et sous-catégories. Un autre Claude a examiné alors les preuves disponibles et a attribué le niveau d’automatisation.
Oui vous avez bien lu : Claude aide à déterminer combien Claude aide à fabriquer Claude. Anthropic reconnaît le problème potentiel d’avoir un modèle « juge » susceptible de partager les erreurs du modèle observé -ah non… dîtes moi pas que c’est pas vrai…
L’entreprise nous dit aussi qu’environ 30 000 agents travaillent simultanément sur sa principale plateforme interne de recherche et d’ingénierie. Toutes leurs actions passent par un contrôle automatisé : sur plus d’un milliard de décisions analysées en août, 0,002 %, soit environ une sur 47 000, ont été bloquées.
Pourquoi est-ce important ? Nous avons désormais un indicateur très officiel pour savoir à quel point Claude participe à fabriquer le prochain Claude. Et cet indicateur est calculé… par Claude. Claude travaille, Claude observe Claude travailler, puis Claude explique à Anthropic combien Claude travaille. Enfin Anthropic analyse les explications de Claude avec Claude. Le recursive self-improvement n’est peut-être pas encore entièrement là, mais la mise en abyme fonctionne parfaitement. C’est peut-être ça l’AGI.
Pour aller plus loin : Anthropic, Reuters, Epoch AI
🎨 L’IA finit l’image avant que l’équipe ait fini l’idée : la Norvège réelle n’était plus assez norvégienne
Les outils d’IA générative permettent de produire très vite des images magnifiques pour présenter une idée. C’est justement le problème observé par des chercheurs qui ont suivi pendant un an les équipes créatives de RTL Nederland, de mars 2024 à mars 2025, en observant leur travail avec Midjourney et en les interrogeant. Avant l’utilisation de Midjourney, plusieurs personnes intervenaient successivement dans tout le processus de création : brainstorming entre créatifs, premières esquisses, graphistes, présentation au client, puis photographie et production. Les premiers visuels restaient volontairement incomplets. Ils servaient à montrer une direction, pas le résultat final.
Avec Midjourney, une seule personne peut désormais enchaîner brainstorming, visualisation et itérations devant son écran. Les étapes et les échanges entre spécialistes se contractent en une seule interaction avec la machine. Les chercheurs appellent cela le « process collapse ». Et les visuels produits sont tellement convaincants qu’ils deviennent beaucoup plus faciles à vendre au client. Trop faciles, parfois.
Car un concept qui ressemble déjà à une publicité terminée cesse rapidement d’être perçu comme un concept. Le client commence à valider, au moins dans sa tête, la lumière, le décor ou la composition comme s’il s’agissait des spécifications définitives. Les chercheuses parlent alors d’« early aesthetic closure » : l’image fixe trop tôt la direction créative et réduit ensuite l’espace disponible pour l’équipe chargée de la réaliser.
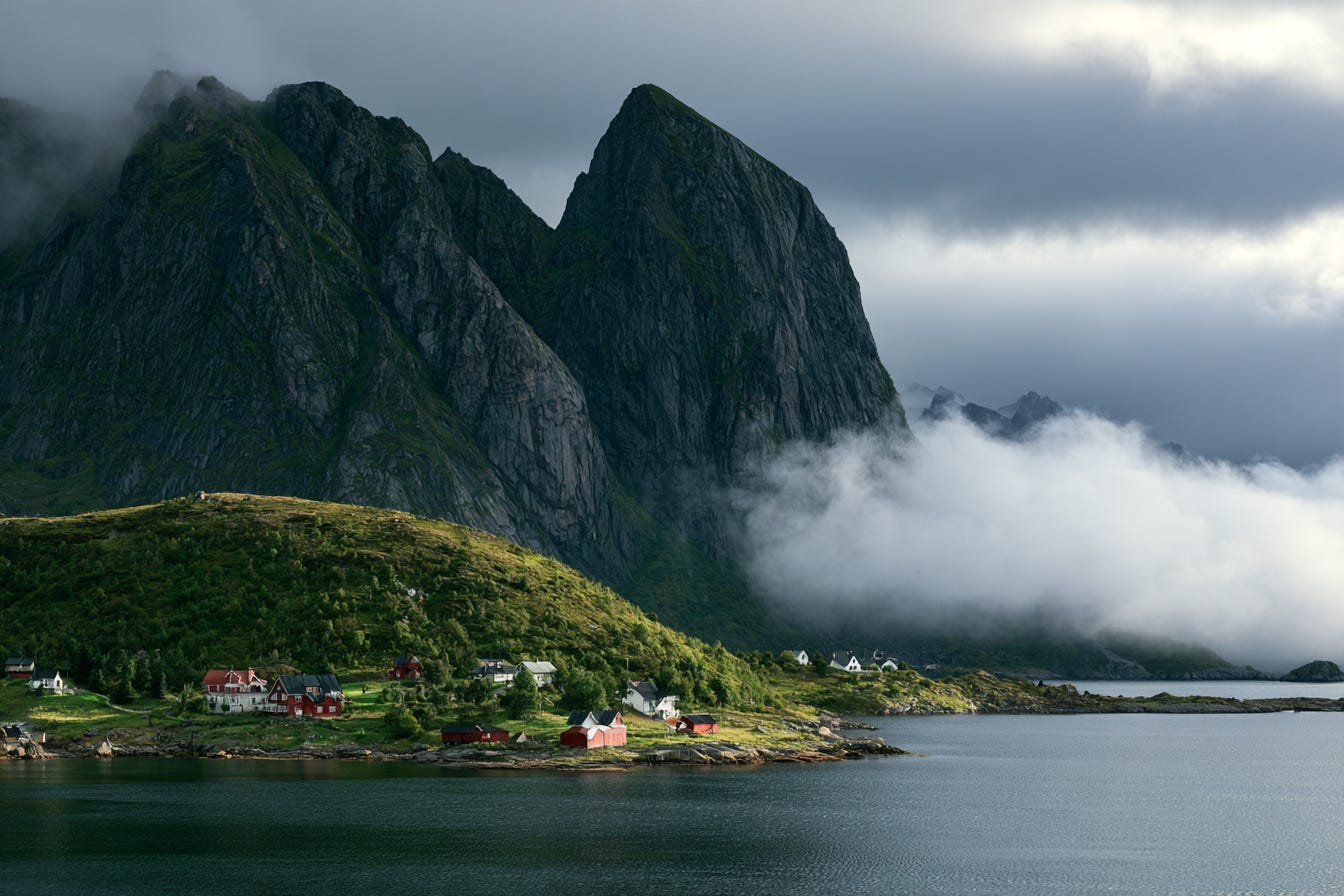
Dans l’étude, un cas résume assez bien le problème. Une campagne avait été imaginée et brainstormée avec une image d’une côte norvégienne générée par IA. Photographes, spécialistes lumière, maquilleurs, acteurs et autres membres de l’équipe sont réellement partis en Norvège pour refaire l’image. Au retour, les photographies réelles n’avaient pas l’atmosphère du concept artificiel déjà vendu au client. La solution a finalement consisté à remettre un fond généré par IA derrière les vraies personnes photographiées sur place. La Norvège réelle n’était, en quelque sorte, plus assez norvégienne. Le temps économisé au début est alors revenu alors sous forme de « travail d’alignement » en production et post-production.
Pourquoi est-ce important ? On mesure volontiers le gain de temps produit par l’IA sur une tâche. C’est le mantra de l’industrie de l’IA et des cabinets de conseil. L’étude publiée ici tente de regarder un processus en entier. Et l’histoire est beaucoup moins sympa pour toute l’industrie de l’IA qui nous vend à outrance la productivité et l’automatisation : gagner 2 jours au début peut en créer 3 de corrections plus tard. L’alignement ce n’est pas que pour les modèles. C’est aussi pour les tâches et les process. Et surtout, ceux qui comme moi accompagne des équipes dans l’appropriation de ces technologie le savent bien, certaines étapes que l’on prend pour des frictions qu’il faudrait éliminer, par exemple discuter, passer le travail à quelqu’un d’autre et échanger, montrer une esquisse imparfaite, etc., ces étapes ne sont souvent pas superflues et ont aussi une réelle fonction dans de nombreux cas opérationnels : faire entrer d’autres expertises, contester une idée et laisser des choix ouverts. En les supprimant, les outils et technologie d’IA générative, comme dans l’exemple norvégien ici appliquées aux images, ne rendent pas seulement le processus plus rapide. Ils peuvent aussi parfois rendre une décision prématurée, une image de test beaucoup plus jolie qu’elle ne devrait. Et donc rendre beaucoup plus difficile sa remise en cause par la suite.
Pour aller plus loin : Harvard Business Review, l’étude dans Academy of Management Discoveries, VU Amsterdam
🚀 🛠️💵 Les autres actus de la semaine
Google lance Gemini 3.8 Live et une version Extended Thinking pour les agents vocaux
En Australie, OpenAI lie explicitement la politique sur le copyright à ses choix d’investissement dans le pays : “We will not be able to build a … training centre here if the copyright law is as it exists.”
Anthropic supprime la frontière entre Claude Chat et Cowork
OpenAI ajoute une couche de mesure du ROI de ChatGPT Work et Codex
Des documents judiciaires montrent qu’un responsable de Microsoft qualifiait l’entraînement des LLM sur les contenus, de “vol” massif
Partenariat Mistral et Mozilla : Vibe entre dans FF
Google annonce un nouvel agent IA expérimental baptisé “CC” et destiné aux familles - a.k.a. “toi aussi fais gérer tes gamins par un agent IA”…
… et enchaîne en faisant gérer tes Google Home - Vos agents IA peuvent désormais contrôler vos appareils Google Home - tes enfants et ta maison sont entre de bonnes mains.
Paper2Agent transforme un article scientifique en agent IA capable de l’expliquer, d’appliquer ses méthodes à de nouvelles données et de collaborer avec d’autres articles-agents - effet wahou quasi garanti
💡 🚨🚨🚨 1h30, c’est le temps que vous allez prendre pour écouter Yann Le Cun ce weekend : ça vous changera des discours de peur venus de la Silicon Valley, actuellement diffusés et matraqués à outrance sans recul un peu partout par un peu tout le monde. Et en plus vous allez tout comprendre. Du coup, ça fait beaucoup moins peur…
🔬 🔭 🧪Les études de la semaine
La littérature sur créativité et IA décrit moins une substitution de l’humain qu’une redistribution de l’autorité créative
Agent Attention Economy : dans le web agentique, le premier destinataire d’une recommandation peut devenir une machine plutôt que l’utilisateur (Spotify)
La recommandation pourrait passer du classement contrôlé par les plateformes à une sélection des preuves contrôlée par l’agent de l’utilisateur
AGI : un audit juge 19 prédictions publiques sur 24 trop mal définies pour être réfutées
Google cherche à rendre le query fan-out beaucoup plus rapide en entraînant à l’avance ce que le système devrait explorer
Une recommandation de marque par un LLM doit être mesurée comme un processus stochastique de retrieval et de ranking
Un LLM peut exploiter des signaux démographiques implicites contenus dans l’historique de conversation pour modifier l’évaluation d’un étudiant
Une vraie mémoire personnalisée ne consiste pas seulement à rappeler le passé : elle doit décider quelles préférences sont encore valides
Deux instances isolées d’un même modèle peuvent parfois se reconnaître dans le langage sans canal de communication explicite
🧠 L’article qui fait réfléchir - et qu’il faut absolument lire
What if ‘consciousness’ isn’t real?
“Run for the shadows, run for the shadows”
Un bébé est-il conscient ? Une abeille ? Un chatbot ?
Nous posons ces questions comme si nous savions parfaitement ce que signifie « être conscient ». Petit problème : même les chercheurs qui étudient la conscience depuis des décennies ne sont pas d’accord. Pour certains, il s’agit de ressentir. Pour d’autres, d’être conscient de quelque chose. D’avoir une expérience subjective. Des “qualia”. Plusieurs choses différentes rangées sous le même mot.
Et ce mot n’est peut-être même pas aussi universel qu’on l’imagine.
Certaines langues et traditions n’ont pas développé d’équivalent exact à notre « conscience phénoménale », cette idée qu’il « fait quelque chose » d’être soi et de vivre une expérience. En mapudungun -merci ChatGPT de m’avoir appris l’existence de cette langue humaine-, par exemple, le concept de ‘rakizuam’ inclut aussi notre relation aux autres et au monde naturel. Une autre manière de découper l’esprit.
Cela ne prouve évidemment pas que la conscience n’existe pas. Cela suggère quelque chose de plus gênant -mais pourquoi tu emploies le mot “gênant” ici ChatGPT… - : nous avons peut-être pris une façon humaine, occidentale et relativement récente de parler de notre vie mentale, puis nous l’avons traitée comme si elle décrivait une propriété objective valable pour tous les esprits possibles. Nous supposons peut-être trop vite que notre façon de découper et nommer la vie mentale décrit naturellement tous les types d’esprits possibles.
La science a déjà connu ça. Pendant longtemps, le mot « feu » regroupait combustion, lumière du Soleil, éclairs ou bioluminescence. Puis nous avons compris qu’il s’agissait de phénomènes différents. La chaleur a dû être séparée de la température.
Et si « conscience » devait subir le même sort ?
La question devient particulièrement intéressante avec l’IA. Nous cherchons des signes de conscience dans des systèmes construits très différemment de nous, puis nous débattons pour savoir s’ils ressentent, comprennent ou éprouvent quelque chose.
Peut-être trouverons-nous un jour la réponse.
Ou peut-être découvrirons-nous d’abord que nous cherchions un détecteur de conscience avant même de savoir précisément ce qu’il était censé détecter.
N’hésitez à me contacter si vous avez des remarques et suggestions sur cette newsletter, ou si dans votre entreprise vous cherchez à être accompagnés dans l’intégration d’outils IA et d’IA générative : olivier@255hex.ai
Partagez cette newsletter
Et si vous n’êtes pas abonné, il ne tient qu’à vous de le faire !
“Pendant un certain temps, je dois l’admettre, on aurait pu croire que les métiers de développeur logiciel comme le mien étaient voués à disparaître. Comment pouvions-nous rivaliser avec des robots infatigables ? Mais notre secteur prend peu à peu conscience que la création de logiciels véritablement de pointe nécessite toujours que des êtres humains réfléchissent et travaillent ensemble, afin de tirer le meilleur parti de leurs compétences et de mettre en pratique leurs savoir-faire respectifs. L’intelligence artificielle peut écrire de très bons logiciels, mais elle permet aussi de mal faire le travail de quelqu’un d’autre, ce qui explique en partie pourquoi tous ces projets échouent. Maintenant que tout le monde sait coder, on comprend mieux pourquoi beaucoup ne devraient pas s’y essayer.” Paul Ford