Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

Acteurs du Libre - 10 ans déjà

L'édition 2026 du concours des Acteurs du Libre est ouverte !

Cette année nous célébrons une date particulière puisque, depuis 10 ans, nous mettons en lumière les acteurs majeurs de l’open source en France et en Europe. Et déjà 50 vainqueurs récompensés. Célébrons une décennie centrée sur le partage et la souveraineté. Rejoignez-nous pour la cérémonie anniversaire du 9 décembre à Open Source Experience.

Affiche Acteurs du libre : 10 ans

Professionnels de l’open source ou responsables d’entreprises utilisatrices de solutions ouvertes : tentez votre chance de mettre votre projet sous les projecteurs à Open Source Experience 2026 !

La date limite pour postuler et envoyer le dossier de participation complété est le 02 octobre 2026. La cérémonie de remise de prix aura lieu à l’occasion d’Open Source Experience le 9 décembre à Paris. Pour participer, merci de vous pré-inscrire en ligne et le dossier vous sera envoyé par email.

Les candidats peuvent soumettre dans l’une des six catégories :

  • Prix du meilleur projet Open Source
  • Prix de la meilleure stratégie Open Source, en collaboration avec le TOSIT
  • Prix de l’entreprise pour un numérique ouvert et éthique
  • Prix de la meilleure collaboration public-privé
  • Prix du développement commercial
  • Prix européen, en collaboration avec l’APELL

Quelques règles à noter :

  • Le concours est ouvert, les organisations non membres du CNLL peuvent candidater.
  • La thématique du concours porte sur le logiciel, le matériel n’est pas concerné.
  • Les organisations domiciliées hors France et en Europe sont autorisées à candidater dans la catégorie “Europe/APELL”.
  • La catégorie “Meilleure collaboration” concerne les administrations centrales et déconcentrées uniquement, les collectivités territoriales doivent candidater au concours des Territoires Numériques du Libre. Candidature en partenariat avec un éditeur.
  • Un seul dossier par candidat, dans une seule catégorie.
  • Les gagnants des sessions précédentes ne sont pas autorisés à candidater à nouveau (cinq ans de délai).

À noter : l’inscription à Open Source Expérience est nécessaire pour participer à la cérémonie.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Haiku Release 1 Beta 6

Environ une semaine après le 25ème anniversaire de Haiku, c'est le moment de publier la sixième version beta de Haiku R1. Nous avons parcouru beaucoup de chemin depuis le lancement du projet en 2001, il y a un quart de siècle. Merci à toutes les personnes qui nous ont soutenus et encouragés dans cette aventure, et souhaitons plein de belles choses pour les 25 prochaines années de Haiku !

Haiku est développé par une petite équipe principalement bénévole, et sans utilisation d'"intelligence artificielle" dans les composants développés au sein du projet. Si notre mission, le développement d'un système d'exploitation pour les ordinateurs personnels, vous attire, n'hésitez pas à nous rejoindre !

Cette version est le résultat de plus de deux ans de travail de l'équipe de développeurs de Haiku pour améliorer la stabilité, ajouter de nouvelles fonctionnalités, et rendre possible le portage de nombreux logiciels. Plus de 530 rapports de bugs et demandes d'améliorations ont été traitées.

Haiku reste en version beta, ce qui signifie que toutes les fonctionnalités prévues pour la version R1 sont disponibles, mais qu'il reste des bugs (connus et inconnus). Nous sommes de plus en plus confiant en ce qui concerne la stabilité du système, mais il n'y a aucune garantie par exemple contre les pertes de données.

Durant ce cycle de publicaction, waddlesplash a été embauché et rémunéré pour travailler sur Haiku. Ce contrat se poursuit, grâce aux donations généreuses d'utilisateurs et autres soutiens de Haiku à l'association Haiku, inc. (association à but non lucratif sous le statut États-Unien 501(c)3).

Sommaire

Configuration matérielle

Cette version est disponible pour les machines utilisant un processeur compatible x86, 32 ou 64-bit.

Seule la version 32-bit permet de lancer les exécutables compilés pour BeOS R5.

MINIMUM (32-bit)

  • Processeur : Intel Pentium II; AMD Athlon
  • Mémoire : 256Mio
  • Écran : 800x600
  • Espace disque : 2Gio

RECOMMANDÉE (64-bit)

  • Processeur : Intel Core i3; AMD Phenom II
  • Mémoire : 2Gio
  • Écran : 1366x768
  • Espace disque : 16Gio

Le jeu d'instructions SSE2 est nécessaire pour lancer le navigateur web WebPositive. Sur les machines où SSE2 n'est pas disponible, le navigateur NetSurf peut être utilisé à la place.

Nouvelles fonctionnalités

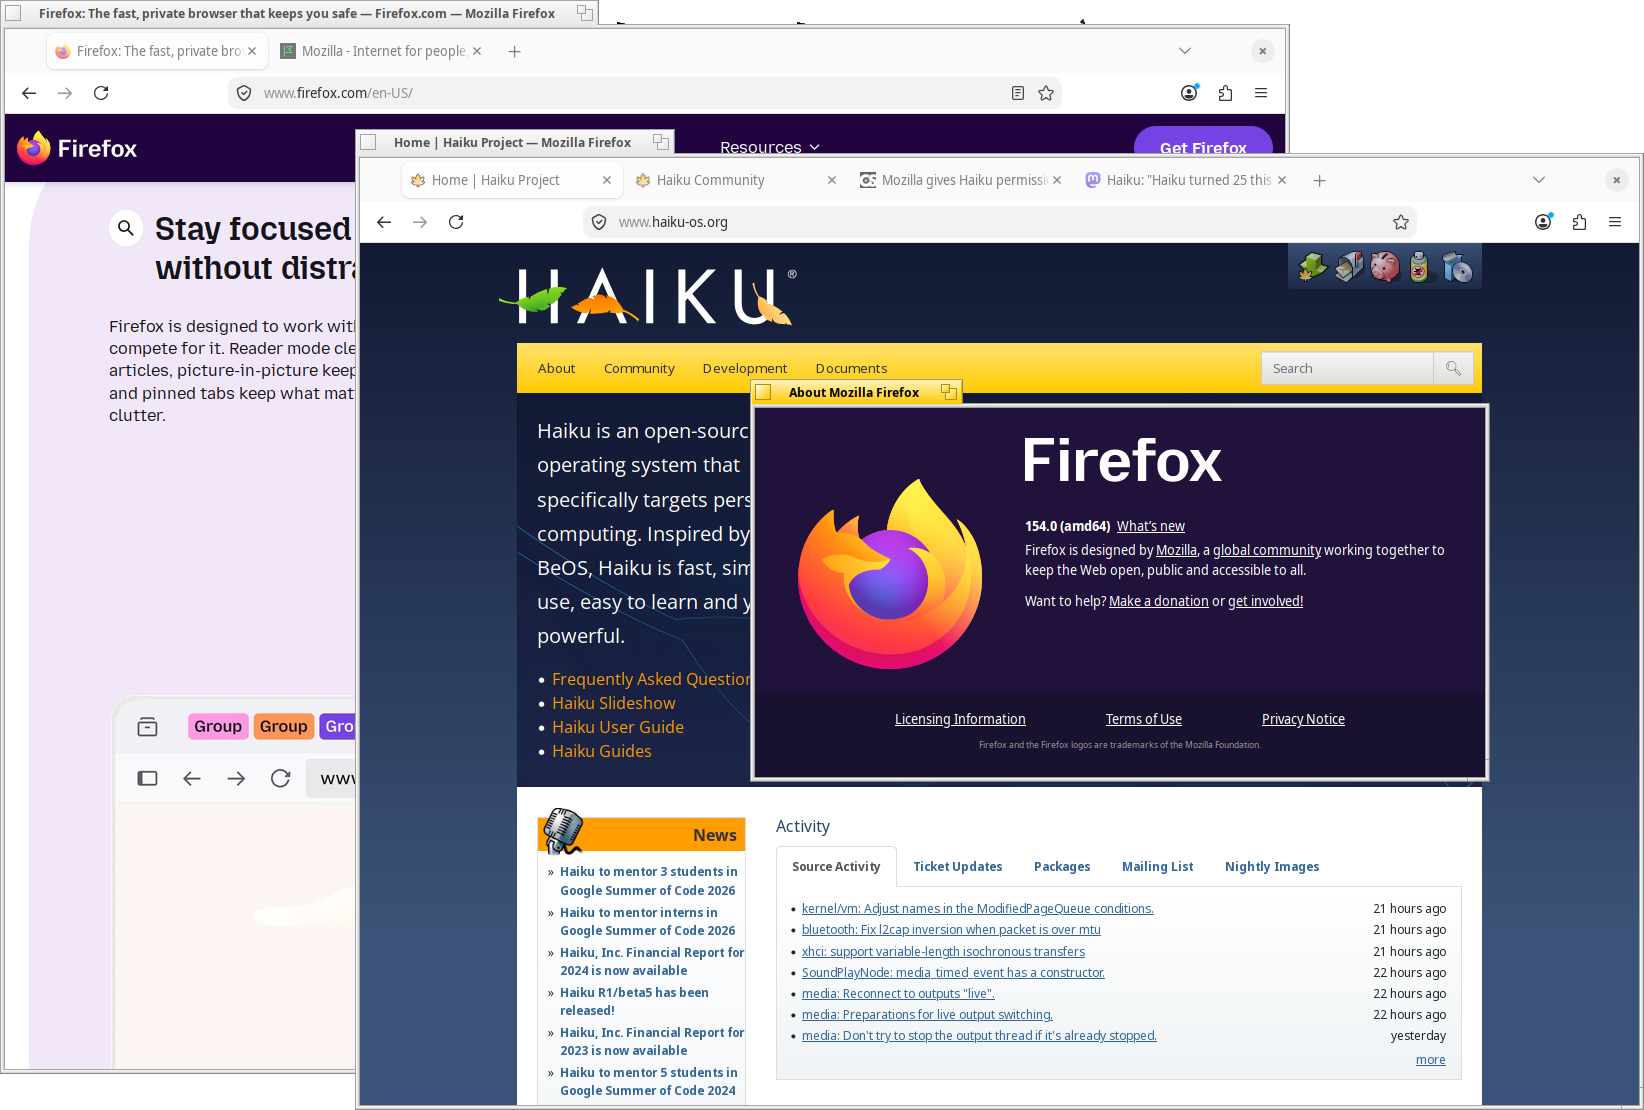
Mozilla Firefox

Firefox pour Haiku

Quelques mois après la publication de la version R1 beta5, les premiers navigateurs basés sur Mozilla Firefox ont fait leur apparition dans les dépôts logiciels de Haikuports. Ils étaient assez instables et n'utilisaient pas les marques officielles de Mozilla. Au cours des deux années suivantes, la stabilité s'est beaucoup améliorée, avec du travail aussi bien du côté de Haiku que du côté du portage. La dernière étape a été d'obtenir la permission de Mozilla pour utiliser le nom et le logo "Firefox". Donc, si quelqu'un vous demande "Mais est-ce que Firefox fonctionne sur Haiku?", maintenant vous pouvez répondre : "Oui, bien sûr !"

Un large choix de logiciels basés sur le code de Firefox est également disponible dans HaikuDepot, comprenant LibreWolf, Waterfox, Floorp, Icedove (une version de Thunderbird dégriffée) et quelques autres.

(Notez que Firefox est disponible uniquement pour les systèmes x86_64 pour l'instant. Et, puisque Haiku est toujours en version beta, si vous rencontrez des fonctionnalités manquantes ou incomplètes par rapport aux versions de Firefox pour d'autres systèmes, c'est probablement de notre faute et pas celle de Mozilla. Merci de remonter ces problèmes dans l'outil de suivi de bugs de HaikuPorts).

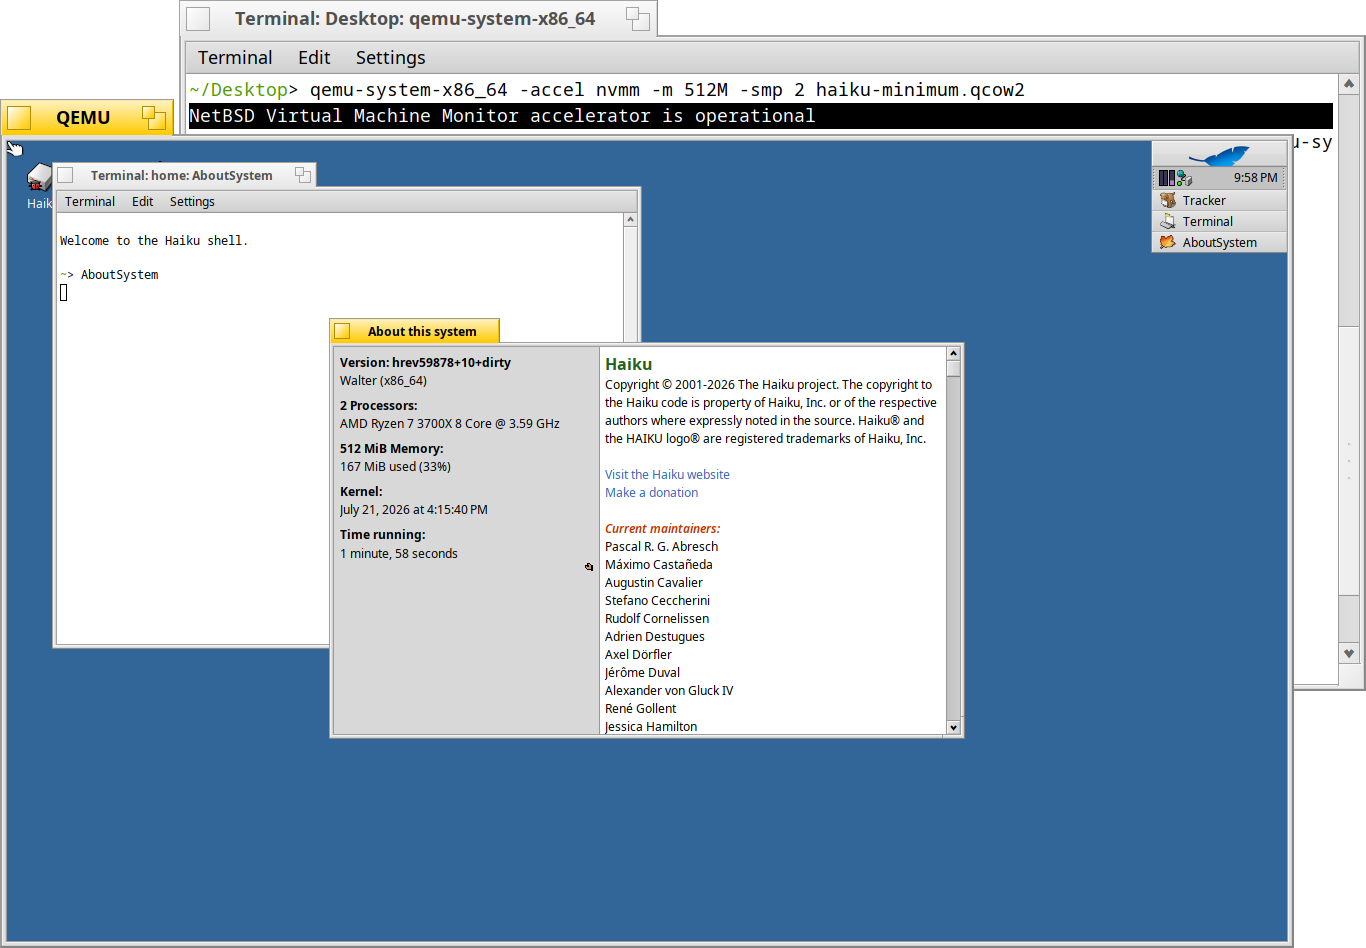
Virtualisation matérielle pour QEMU (sur x86_64)

QEMU avec accélération NVMM

Haiku permet maintenant d'utiliser "NVMM", le NetBSD Virtual Machine Monitor (qui a été développé pour NetBSD, mais a déjà été porté également vers DragonflyBSD avant Haiku). Cela permet d'utiliser l'accélération matérielle de la virtualisation dans QEMU, sur les systèmes x86_64 qui disposent des instructions Intel VT-x ou AMD-V. Les machines virtualisées peuvent être en 32 ou 64 bits, avec SMP, et le large choix de périphériques matériels émulés par QEMU, le tout pour un large choix de systèmes invités. Ajoutez simplement -accel nvmm aux arguments en ligne de commande de QEMU.

(L'accélération NVMM est encore en phase expérimentale. Merci de remonter tous les problèmes rencontrés sur le bug tracker de Haiku.)

Logiciels portés

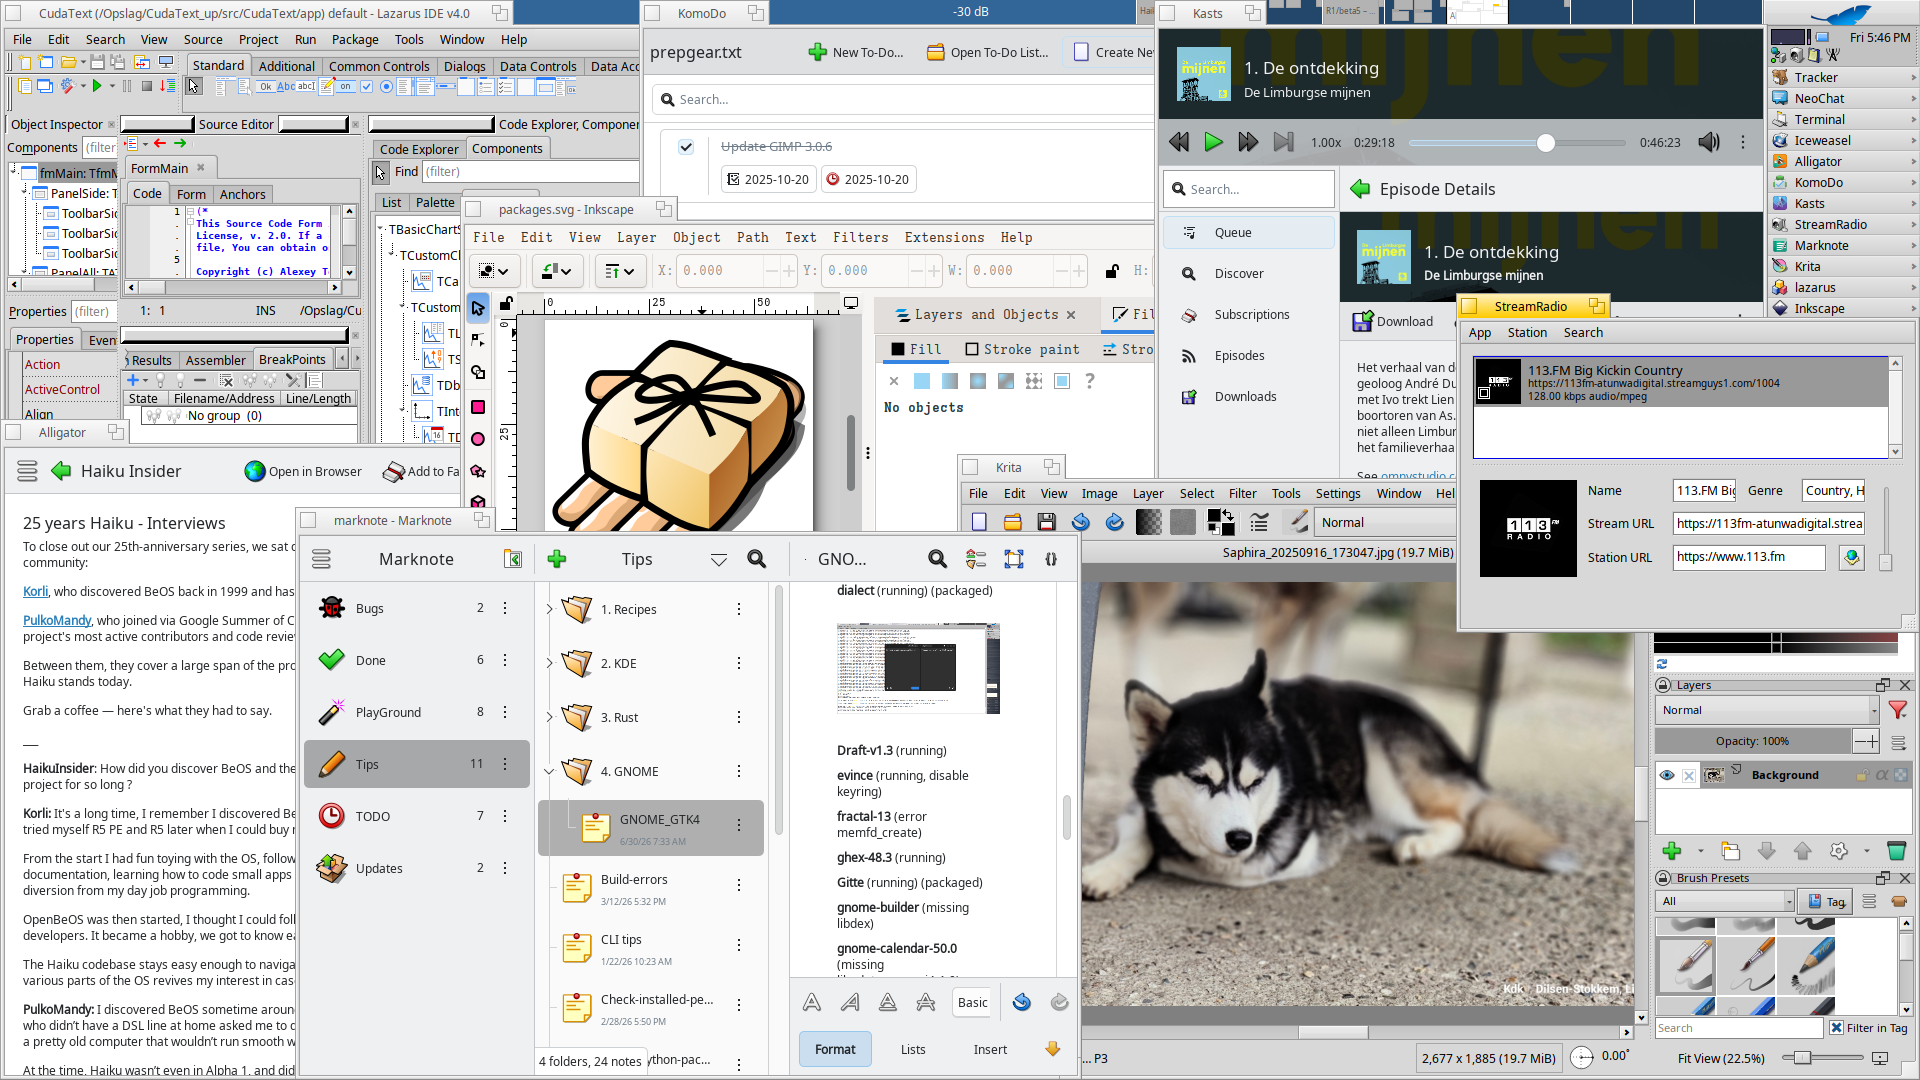
Florilège de logiciels portés

Le projet HaikuPorts continue de maintenir une large sélection de logiciels pour Haiku. Il y en a beaucoup trop pour tout lister ici, y compris de nombreuses applications KDE et GTK. Mais voici l'un des plus remarquables :

Go

Le compilateur et l'environnement d'exécution pour le langage Go sont disponibles dans les dépôts de paquets. C'est une version un peu ancienne (1.26.1) et le code n'a pas encore été soumis aux développeurs de Go; mais de nombreux paquets fonctionnent bien sous Haiku, avec éventuellement quelques ajustements. Par exemple, il est possible d'utiliser Hugo, l'outil de génération de sites statique qui permet d'éditer le site de Haiku.

Modifications & corrections de bugs

Des centaines de bugs, corrections mineures et demandes d'améliorations ont été traitées depuis la version précédente. Il y en a beaucoup trop pour tout énumérer, les rapports d'activité trimestriels sur Linuxfr (ou mensuels en version originale) vous permettront d'avoir une vision plus détaillée de ces changements.

Presque toutes les parties du système ont bénéficié d'au moins un peu d'attention, et le résultat est que cette version beta 6 et la plus stable et la mieux finie jusqu'à présent. Il reste cependant encore quelques points de friction à certains endroits, ce qui explique que cela reste une version beta.

Optimisation des performances du système

Cette version comprend un grand nombre de changements et de refactorisations pour améliorer les performances générales. Voici une liste (assez technique) des principaux points:

  • Refonte de la gestion des tampons mémoire du renifleur de types MIME (la détection des types de fichiers est au moins 5 à 10 fois plus rapide)
  • Fonctions de hachage de chaîne de caractères plus rapides (et avec de meilleures propriétés)
  • granularité des verrous dans plusieurs composants du noyau : le gestionnaire de mémoire (réservations et dé-réservations de mémoire), le VFS (recherche de descripteurs de fichiers, changement d'état des vnode inutilisés, recherhce de la racine des contexte E/S), timers utilisateur, et encore d'autres.
  • évitement d'un verrou exclusif dans les FIFO (pipe()), ce qui permet de traiter des données à plusieurs Gio/s au lieu de quelques centaines de Mio/s auparavant
  • utilisation d'allocateurs "arena" pour les allocations de mémoire de travail (par exemple dans les FIFOs, et dans packagef`), ce qui permet d'esquiver tout un tas de changements et d'invalidation de la table des pages dans le noyau
  • omission de certaines tâches réalisées par une opération fork traditionelle lors de l'utilisation de vfork (il ne s'agit pas d'un vrai vfork, mais d'une approximation compatible avec les utilisations raisonnables)
  • remplacement ou réécriture de fonctions de bases de la bibliothèque C par des versions optimisées : memmove, strlen, strcmp, memcmp, et bien d'autres
  • recalibration des classes de taille de l'allocateur malloc du noyau (les valeurs utilisées avaient été sélectionnées en 2007 et pas vérifiées depuis)
  • ajout d'heuristiques pour pré-mapper les gros fichiers (ce qui bénéficie aux grosses applications qui sont lancées à mainte reprises, par exemple gcc)
  • utilisation de verrous non-exclusif et d'opérations atomiques lorsque c'est possible dans les primitives du noyau pour l'envoi de messages entre cœurs de processeur
  • Le cache d'entrées de répertoire n'a plus besoin d'un verrou en écriture pour insérer des éléments. De plus, il stocke la valeur de hash des chaînes pour éviter des comparaisons de chaînes inutiles
  • Utilisation de verrous en lecture-écriture dans le cache de blocs disque (utiliser pour mettre en cache les inodes et métadonnées des systèmes de fichiers).

Les deux derniers points en particulier ont un effet spectaculaire sur les opérations qui accèdent à beaucoup de fichiers d'affilée, comme git status. Lors d'un test de ces modifications, la durée d'exécution de git status sur un dépôt comportant plus de 160000 fichiers est passé de 33 à 20 secondes sans préchargement du cache disque, et de 15 à 2.5 secondes une fois le cache préchargé !

L'effet cumulé de toutes ces optimisations (et aussi des changements sur la gestion de la mémoire, détaillés plus bas) sur le temps de compilation est assez significatif. Les travaux de compilation assez simples ne sont qu'un peu plus rapide qu'avant (on partait d'assez loin, avec environ 40% de performance en moins par rapport à Linux), mais pour des tâches plus complexes, cela change tout. La compilation de HaikuWebKit (même version, même compilateur, même machine, ensemble de dépendances très proche) durait 4h53 avec la version beta 5, mais seulement 2h33 avec la version beta 6, soit une réduction presque de moitié !

Amélioration de l'interface utilisateur

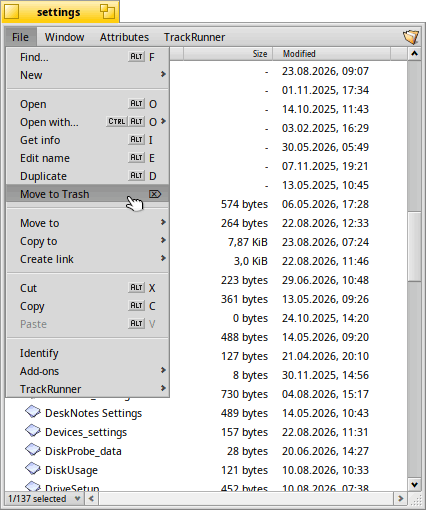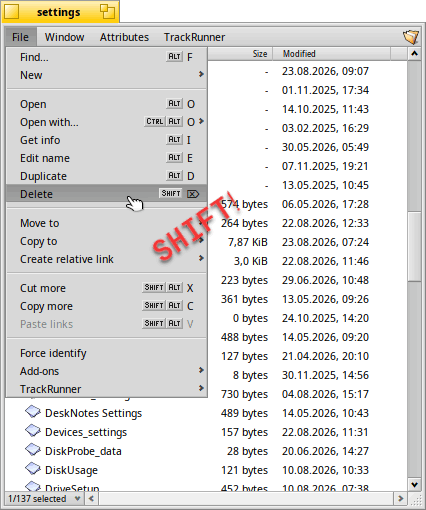
Tracker: Mise à jour en direct des menus lors de l'utilisation de modificateurs clavier

Mise à jour en direct

Dans Tracker - le navigateur de fichiers de Haiku -, certains opérations modifient leur comportement lorsqu'elles (ou leur raccourci clavier) sont invoquées avec la touche Shift enfoncée. Maintenant, si vous enfoncez ou relachez cette touche alors qu'un menu est ouvert, les éléments du menu se mettent à jour pour montrer ce qu'il va effectivement se passer si vous cliquez dessus.

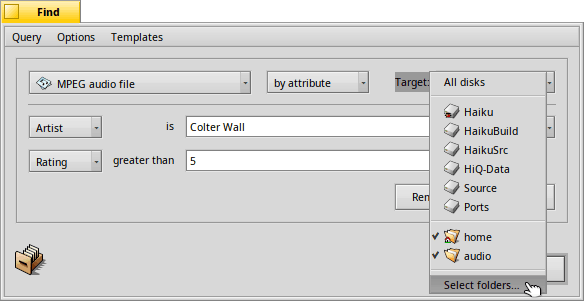
Tracker : Filtrage par dossier des résultats de requêtes

Filtrage des requêtes par dossier

Haiku a hérité certaines fonctionnalités uniques de BeOS. L'une d'entre elles est un système de fichiers qui se comporte également comme une base de données, permettant l'indexation des attributs étendus des fichiers et permettant d'exécuter des requêtes sur l'ensemble d'un système de fichier pour trouver rapidement les fichiers correspondant à certains critères.

Ces requêtes fonctionnent nécessairement sur l'ensemble du système de fichiers (car l'indexation ne stocke pas d'informations sur le chemin du fichier). Cependant, il est parfois utile de restreindre les résultats à une hiérarchie de dossiers spécifique. Cela est maintenant possible via la fenêtre de recherche du Tracker, qui effectuera un filtrage des résultats de requêtes aux dossiers sélectionnés.

(L'outil en ligne de commande query permet maintenant également de filtrer les résultats par dossier.)

Nettoyage disque dans SoftwareUpdater & pkgman

Les paquets logiciels pour Haiku sont des images de système de fichier compressées par blocs. Elles sont montée au démarrage dans une "union" permettant de construire le système de fichier du dossier système. Cela signifie que l'installation et la désinstallation de logiciels sont des opérations peu coûteuses, il s'agit s'implement d'ajouter ou d'enlever des paquets du point de montage en union. De plus, le système peut conserver les anciens paquets et l'état précédent du système. Cela permet de revenir facilement à une ancienne version d'un logiciel, ou même de rembobiner l'état complet du système, via le menu de démarrage.

Jusqu'à présent, ces points de restauration n'étaient jamais supprimés automatiquement (à moins d'utiliser un outil tiers pour s'en charger), et ils pouvaient donc s'accumuler indéfiniment, remplissant petit à petit tout l'espace disque disponible. Maintenant, SoftwareUpdater nettoie automatiquement les états les plus anciens (ce comportement est désactivable dans la fenêtre de réglages), et l'outil en ligne de commande pkgman affiche un message lorsqu'il y a beaucoup d'états sauvegardés, recommandant de lancer la commande pkgman cleanup pour faire du ménage.

# pkgman install/uninstall/full-sync...
[system] Changes applied. Old activation state backed up in "state_2026-08-22_22:38:28"
[system] Cleaning up ...
[system] Done.
[system] 3 old state(s) can be cleaned up. Use "pkgman cleanup" to remove them.

$ pkgman cleanup
Clean up 3 old states (166.27 MiB)? [yes/no] (yes) :

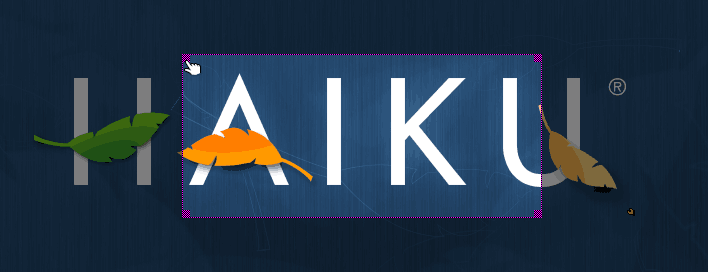
Screenshot : sélection de zone à capturer

Capture d'une zone de l'écran

L'outil de capture d'écran (déclanché par la touche Impr Écr de votre clavier) peut maintenant vous laisser sélectionner une zone rectangulaire de l'écran à capturer. Cela se rajoute aux possibilités existantes : capture de tout l'écran ou d'une seule fenêtre.

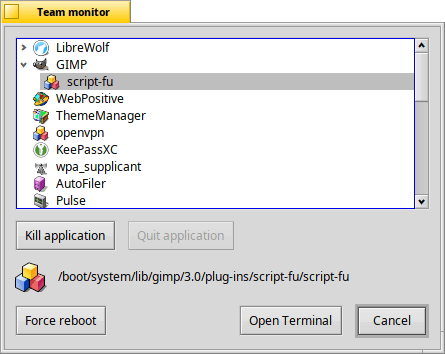
Team monitor : regroupement des équipes de processus

Groupement de processus

"Team monitor", l'outil de gestion des processus qui apparaît lorque vous appuyez sur Ctrl+Alt+Suppr, groupe maintenant les processus en tâche de fond lancés par une application graphique dans une liste en-dessous de cette application. Cela rend plus confortable l'utilisation de cette fenêtre lorsqu'un terminal est ouvert avec de très nombreux onglets, ou encore un navigateur web multiprocessus.

DriveSetup : menu "Images disque"

DriveSetup, l'outil de configuration des partitions, sait maintenant utiliser des images de disques. Le nouveau menu ajouté à cet effet permet de créer une image disque à partir d'une partition, d'écrire une image disque sur une partition, et aussi d'"enregistrer" une image disque dans le noyau pour y accéder directement comme à un disque réel (montage, démontage, création de partitions, etc).

app_server : récupération des applications au redémarrage

app_server, le serveur d'applications de Haiku (qui est aussi le serveur d'affichage, gestionnaire de fenêtres et responsable du tracé du contenu des fenêtres), est un composant central de Haiku. En cas de crash ou de redémarrage intentionnel, il peut maintenant se reconnecter aux applications en cours d'exécution et remettre en place leurs fenêtres comme si de rien n'était. Il n'est donc plus nécessaire de redémarrer le système ou la session utilisateur en cas de plantage. Dans la plupart des cas, les applications pourront reprendre leur fonctionnement normal après seulement une poignée de secondes.

PowerStatus : Meilleure gestion des machines avec plusieurs batteries

PowerStatus, l'application qui affiche l'information sur les batteries et l'icône de batterie dans la Deskbar, fonctionne mieux sur les machines avec plusieurs batteries, en particulier si certaines batteries sont enlevées alors que la machine est en fonctionnement, ou si une batterie se chage pendant qu'une autre se décharge.

Amélioration du "mode sombre" et de l'affichage HiDPI dans de nombreuses applications

Il y a eu un grand nombre de corrections et d'améliorations dans les applications inclues dans Haiku pour l'affichage en mode sombre et sur les écrans à haute densité : certaines couleurs étaient codées en dur, des dégradés n'étaient pas cohérents, des tailles d'éléments en nombre de pixels fixes, et ainsi de suite.

launch_roster : résumé du statut

L'outil en ligne de commande launch_roster permet d'interagir avec le gestionnaire de services de Haiku (launch_daemon). Il a reçu une grosse mise à jour, pour afficher une table réacapitulant l'état de tous les jobs et services :

$ launch_roster
                           Name  Type     State    Enabled
----------------------------------------------------------
     check-daylight-saving-time  job      stopped  yes
                    first-login  job      stopped  yes
                    update-time  job      stopped  yes
                  x-vnd.be-trak  service  running  yes
                  x-vnd.be-tskb  service  running  yes
         x-vnd.haiku-app_server  service  running  yes
          x-vnd.haiku-autologin  job      stopped  yes
       x-vnd.haiku-debug_server  service  running  yes
       x-vnd.haiku-media_server  service  running  yes
       x-vnd.haiku-mount_server  service  running  yes
         x-vnd.haiku-net_server  service  running  yes
x-vnd.haiku-notification_server  service  stopped  yes
     x-vnd.haiku-package_daemon  service  running  yes
       x-vnd.haiku-power_daemon  service  running  yes
          x-vnd.haiku-registrar  service  running  yes

Amélioration de la gestion de la mémoire

En plus des autres optimisations de performances déjà mentionnées, il y a eu un gros travail sur plusieurs aspects liés à la gestion de la mémoire, dont certains pour rendre les choses plus rapides, et d'autres simplement pour simplifier le code ou pour réduire la consommation de mémoire. Voici quelques-uns des plus intéressants :

  • optimisation des structures de données de packagefs, réduisant l'occupation mémoire d'environ 20% (la quantité exacte dépend du nombre de paquets installés, par exemple environ 15Mio sur une installation représentative utilisée pour tester ces changements)
  • gestion plus rapide et plus correcte des attributs de la mémoire (sur x86 et x86_64)
  • correction de la gestion du copy-on-write pour les zones protégées par mprotect. Le nouveau code est plus rapide et moins buggé.
  • plusieurs améliorations pour pouvoir démarrer Haiku sur des machines avec beaucoup de RAM (plus de 128Gio)
  • Tracker ne surveille plus les fichiers un par un via le node monitor, il surveille plutôt des dossiers entiers, ce qui économise de la mémoire du côté du noyau
  • unification du système de réservation de zones mémoires pour la mémoire RAM et la swap
  • correction d'allocations faites avec le mauvais allocateur dans le bootloader, des allocations qui devaient être temporaires n'étaient pas libérées avant le démarrage du noyau et restaient réservées pour toute la vie du système (jusqu'à 100Mio de mémoire perdus et rendus inutilisables par le noyau dans certains cas)

L'accumulation de tous ces changements fait qu'il est maintenant possible de démarrer la version 32-bit de Haiku avec seulement 128Mio de mémoire (et même encore moins si on utilise un système dégraissé), et arriver à lancer quelques applications. Bien sûr, difficile de lancer un navigateur web moderne dans ces conditions !

Mais ce n'est pas fini, certains changements encore plus importants méritent leurs propres paragraphes d'explications:

Nouvelle implémentation de malloc pour l'espace utilisateur

Haiku utilisait depuis très longtemps une version modifiée de l'allocateur hoard2 pour implémenter la famille de fonctions malloc dans la bibliothèque C standard. Cet allocateur est d'une conception assez ancienne, et ne tient plus la comparaison avec les derniers développements dans le domaine (y compris les versions plus récentes de hoard). Le remplacement de cet allocateur était donc un sujet de discussion parmi les développeurs depuis quelques années déjà.

Aprés l'évaluation et l'expérimentation de plusieurs alternatives, le choix s'est finalement porté sur la réutilisation de code écrit par OpenBSD, avec des perfectionnements supplémentaires pour l'adapter à notre usage (par exemple, un cache global limitant la nécessité d'appels système). Ce nouvel allocateur est légèrement plus rapide dans la plupart des cas, et beaucoup plus rapide dans certains cas particuliers qui mettaient en évidence les problèmes de l'architecture de hoard2. Surtout, cet allocateur est bien meilleur que ses concurrents pour remettre rapidement la mémoire inutilisée par une application à la disposition du reste du système, ce qui est particulièrement utile pour des applications qui restent lancées longtemps, et sur du matériel où la quantité de mémoire disponible est limitée. Il est également économe en termes d'utilisation de l'espace d'adressage, ce qui est important pour les systèmes 32 bits qui sont laissés de côté par d'autres allocateurs récents.

Améliorations sur le découpage de zones mémoire (areas)

Lorsqu'une application demande un gros morceau de mémoire (par exemple avec la fonction mmap), puis libère un petit morceau situé au milieu de cette zone (avec munmap), le noyau doit réorganiser ses structures de données et remplacer la gestion d'une zone unique et contigüe par deux zones séparées. Cette opération n'est pas simple à implémenter, surtout si la zone mémoire concernée est partagée avec d'autres processus, a des restrictons d'accès par pages (mprotect), ou d'autres cas particuliers.

L'implémentation de cette opération de découpage dans Haiku était incomplète, mais l'implémentation précédente de Haiku n'en faisait pas usage. Les problèmes éventuels ne concernaient donc que les applications implémentant leur propre gestion de la mémoire: ramasse-miettes, ou utilisation d'une implémentation alternative de malloc par exemple. Ces cas sont relativement rares, donc les problèmes n'avaient pas forcément été détectés. Le nouvel allocateur, ainsi que plusieurs navigateurs web récemment portés sur Haiku, quant à eux, font un usage beaucoup plus important de cette possibilité. Le code a donc du être repris pour pouvoir réagir correctement dans toutes les situations.

Amélioration du comportement lorsque la mémoire est presque pleine

Haiku n'implémente pas d'overcommit de la mémoire par défaut (et ne dispose donc pas d'un "OOM killer"). Les applications qui ont besoin de zones allouées avec overcommitting doivent le demander explicitement, avec un contrôle par area ou par region, et le manque de mémoire lors de l'accès effectif à ces zones n'impacte que les applications concernées (qui peuvent alors intercepter le problème et réagir en libérant des ressources si possible). Dans tous les autres cas, la mémoire est réservée (mais pas allouée) dès que l'application en fait la demande, et s'il n'y a pas de mémoire disponible, la fonction d'allocation retourne une erreur (par exemple ENOMEM).

Cependant, il ne suffit pas de retourner une erreur, encore faut-il que tous les composants du système sachent comment y réagir. Puisque toutes les allocations qui ne sont pas faites avec de la mémoire réservée à l'avance peuvent échouer, le noyau et tous les pilotes de périphériques doivent traiter le cas ou une fonction comme malloc retourne une erreur ENOMEM. Certains autres systèmes garantissent que l'implémentation de malloc dans le noyau n'échoue jamais (quitte à tuer des applications pour faire de la place).

Une mauvaise gestion de ces erreurs - ou de leurs conséquences qui peuvent mettre le système dans un état inhabituel - peuvent déclencher des comportements inattendus, dans le pire des cas, des crash ou des softlock (le système devient tellement lent qu'il est inutilisable). Un certain nombre de problème de ce type ont été corrigés, et il y a de bonnes chances que le système finisse par retourner dans un état stable une fois la mémoire libérée.

Améliorations de guarded_heap

En plus des implémentations par défaut de malloc dans l'espace utilisateur et dans le noyau, qui sont conçues pour une utilisation généraliste "en production", Haiku offre un choix d'implémentations de malloc pour l'aide au débuggage. L'une d'entre elles s'appelle guarded_heap, et place chaque allocation à la fin d'une page de mémoire et juste avant une autre page qui n'est pas mappée. Ceci gaspille énormément de place, mais permet de détecter immédiatement 100% des débordements de tampons. Cet allocateur permet même de désactiver la réutilisation de la mémoire libérée, dans ce cas il détecte en plus l'accès à de la mémoire libérée. Tout ceci se fait sans avoir besoin d'instrumenter le code, et donc, sans avoir besoin de recompiler l'application ou les bibliothèques concernées (contrairement par exemple aux options -fsanitize de gcc et llvm).

L'implémentation de guarded_heap pour le noyau a été complètement réécrite, pour y ajouter toutes les fonctionnalités disponibles dans la version pour l'espace utilisateur. Elle peut maintenant être activée sans recompiler le noyau (via une option du bootloader). Ceci n'est cependant possible que dans les versions "nightly builds" de Haiku, les versions stables désactivant cette option pour améliorer les performances.

Améliorations sur les systèmes de fichiers

Les systèmes de fichiers ont bien avancés dans cette version de Haiku. Les changements principaux sont :

  • FAT : gestion des disques de plus de 2Tio, gestion des secteurs disque de 4 Kio, préchargement des blocs pour accélérer le montage
  • NFSv4 : nettoyage et corrections de bugs, meilleure gestion des opérations E/S asynchrones
  • BFS : optimisation de la recherche de blocs libres, meilleure sélection d'index pour accélérer les requêtes, évitement des enchaînements de get/put inutiles pour des blocs de cache identiques
  • RAMFS (utilisé pour /var/shared_memory & shm_open) : nombreuses corrections, nettoyage, améliorations, dont une grande partie suite à l'utilisation intensive de mémoire partagée par Gecko/Firefox

En dehors des systèmes de fichiers eux-mêmes, des changements concernent de façon plus générale la mise en cache du contenu des fichiers. En particulier, la file d'attente des données à écrire a été découpée pour avoir une file par disque au lieu d'une seule file globale. Ces files peuvent estimer la vitesse d'écriture du disque associé, et le cache disque utilise cette information pour éviter d'accumuler trop d'écritures en attente (par exemple, lors de la copie de fichiers d'un disque rapide vers un autre plus lent).

Cela corrige le problème, également constaté sur certains systèmes Linux, où l'écriture vers un disque semble incroyablement rapide, mais le démontage ou l'exécution de sync est très lent, puisque l'écriture sur disque n'a réellement lieu qu'à ce moment là. À présent, le cache disque va détecter cette situation et bloquer les écritures sur le disque concerné le temps que les écritures en attente puissent être traitées. La progression de la copie de fichiers est donc représentative de l'écriture effective sur disque, et l'exécution de sync ne devrait jamais nécessiter plus de quelques secondes.

Compatibilité matérielle

Cette version de Haiku met à jour de nombreux pilotes, en particulier pour les machines fabriquées ces 5 dernières années. Si vous n'aviez pas réussi à installer une version précédente de Haiku, c'est l'occasion de refaire un essai et de voir si les choses se sont améliorées.

Cartes son

Des problèmes de son distordu ou complètement silencieux ont été corrigés, en particulier pour les machines les moins puissantes. Dans ce cadre, l'initialisation de la carte son est désormais faite à la demande, lorsqu'une application a effectivement besoin d'émettre un son. Cela économise de l'énergie et du temps de calcul pour le CPU.

Modifications volatile du BIOS VESA

Lorsqu'il n'existe pas de pilote speçifique pour une carte graphique, Haiku doit utiliser une solution de secours: un framebuffer minimal pour EFI, et VESA pour les systèmes BIOS. VESA permet de changer de mode vidéo pendant l'exécution du système, mais ne permet que de choisir parmi une liste de modes prédéfinis par le fabricant de la carte graphique. Cette liste est souvent assez limitée et n'inclus parfois même pas la résolution native du matériel.

La solution idéale est bien sûr le développement d'un pilote graphique pouvant programmer directement la carte graphique. Cependant, cette solution peut être assez complexe à mettre en oeuvre, surtout si le fabricant du chipset graphique ne fournit pas de documentation. Une solution plus simple est de modifier le BIOS VESA, pour y injecter de nouveaux modes vidéo à la demande. Haiku est maintenant capable de faire cette modification (de façon volatile, dans une copie en RAM du BIOS original) sur certains modèles de cartes graphiques où les modifications à faire ont pu être identifiées.

Pilotes pour toujours plus d'interfaces USB ethernet & WiFi

Haiku dispose d'une couche de compatibilité permettant de réutiliser les pilotes réseau de FreeBSD et OpenBSD, quasiment sans les modifier. Cette couche de compatibilité était limitée aux pilotes PCI, mais elle permet maintenant d'utiliser également des adaptateurs USB. De plus, les pilotes ont été synchronisés avec les dernières versions développées par FreeBSD et OpenBSD, ce qui augmente encore la compatibilité matérielle.

Compatibilité POSIX améliorée

Haiku essaie de suivre autant que possible le standard POSIX, afin de faciliter l'interopérabilité et le portage de logiciels existants. La spécification POSIX a été mise à jour quelques mois avant la version beta 5, et donc les nouveautés correspondantes arrivent seulement maintenant dans Haiku. Ici encore, il est impossible de lister l'immense nombre de changements liés à ce travail, mais voici quelques exemples :

  • O_CLOFORK
  • MSG_CMSG_CLOEXEC, MSG_CMSG_CLOFORK pour les sockets
  • SOCK_SEQPACKET, MSG_TRUNC, MSG_PEEK pour les sockets de la famille AF_UNIX
  • WCOREDUMP
  • getresuid, setresuid, getresgid, setresgid
  • pipe3, dup2, mkostemp
  • reallocarray, memmem, qsort_r
  • posix_devctl
  • pthread_getcpuclockid
  • posix_spawn_file_actions_add[f]chdir

En plus de la spécification POSIX, Haiku implémente également des fonctions supplémentaires disponibles dans les systèmes GNU, BSD ou même Solaris lorsqu'elles sont nécessaires ou pertinentes. Dans cette catégorie on trouve les nouveautés suivantes :

  • RTLD_NOLOAD, RTLD_GROUP
  • getloadavg
  • closefrom, closerange
  • EV_RECEIPT et l'utilisation d'objets spécifiques à Haiku (ports, sémaphores) avec kqueue
  • utilisation de baudrates arbitraires pour les ports série (via cfsetspeed)
  • meilleure compatibilité avec l'API FUSE

Ces extensions sont maintenant activées par défaut dans les en-tête C et C++, sauf dans le cas où l'environnement de compilation a demandé l'application d'un standard spécifique. Par exemple, la définition de __STRICT_ANSI__ ou _POSIX_C_SOURCE désactive ces extensions. Ces macros sont activées automatiquement par l'utilisation d'options comme -std=c++11, pour bénéficier des extensions on peut par exemple utiliser -std=gnu++11.

Stabilisation du système

De façon générale, un effort conséquent a été porté sur la stabilisation du système, en corrigeant des crash du noyau et des pilotes, des gels du système, des corruptions, l'échec du démarrage sur certaines machines. Ces problèmes ont été investigués, identifiés et corrigés pour fournir une version plus stable que toutes les précédentes.

Les scènes coupées

Malheureusement, une partie du travail en cours ces deux dernières années n'a pas pu être terminé à temps pour être intégré dans cette version. Certaines choses sont encore en chantier, d'autres sont trop expérimentales et désactivées par défaut. Cela donne peut-être une idée de ce à quoi s'attendre dans la prochaine version !

ARM64

Suite au travail de plusieurs personnes, la version ARM64 de Haiku démarre jusqu'au bureau sur les systèmes virtualisés ! Il existe même une branche de développement, en cours d'intégration, qui permet de démarrer Haiku sur les machines Apple M1. Ce travail est loin d'être terminé, mais les progrès sont remarquables par rapport à l'état des choses lors de la publication de la version beta 5.

WebKit multiprocessus

Le navigateur WebPositive fourni avec Haiku utilise encore une version de WebKit s'exécutant intégralement dans un seul processus. Le travail sur la version multiprocessus est bien avancé, cela fonctionne pour l'affichage de site simples, mais ce n'est pas encore prêt pour convertir WebPositive à ce nouveau mode de fonctionnement.

Nouveau contributeurs

Depuis la publication de la version précédente, un nouveau contributeur de Haiku a obtenu les permissions de commit : il s'agit de Zardshard, qui a travaillé par exemple sur Icon-O-Matic et sur d'autres applications natives. Bienvenue à lui !

On peut également mentionner le retour de Philippe Houdoin, qui avait laissé de côté le projet pendant quelques temps pour se consacrer à d'autres choses, mais a récemment recommencé à participer.

Le nombre de contributeurs est relativement stable depuis plusieurs années, entre 50 et 65 personnes participent à Haiku chaque année avec au moins un patch. Du côté de HaikuPorts, l'activité a tendance à augmenter, avec un record de 82 participants en 2024 et une deuxième position pour l'année 2025 avec 75 personnes. L'amélioration continue du système permet de plus en plus aux développeurs de se consacrer au développement et au portage de logiciels, sans tomber dans des bugs critiques nécessitant de mettre les mains dans les couches plus bas niveau du système.

Code source

Le code source est téléchargeable via un mirroir sur Github (si le site n'est pas cassé) ou alors depuis le serveur Git auto-hébergé de Haiku. Les patchs et contributions sont les bienvenus via Gerrit.

Remonter des problèmes

La sortie d'une nouvelle version de Haiku déclenche habituellement un déluge de nouveaux rapports de bugs. Il y a actuellement plus de 3900 tickets ouverts (et plus de 16000 déjà fermés) dans l'outil de suivi. Si vous pensez avoir identifié un problème, vous pouvez faire une recherche dans l'outil pour voir si le problème a déjà été remonté (ou même déjà corrigé), et dans le cas contraire, créer un ticket sur l'outil de suivi de bugs.

En cas de gros problèmes identifiés avec cette version, ils seront ajoutés sur la page notes de versions additionnelles.

Si vous avez besoin d'aide, commencez par la 'Visite Rapide' puis consultez le manuel d'utilisation, ils sont tous les deux accessibles via des raccourcis sur le bureau de toute nouvelle installation de Haiku. WebPositive s'ouvre par défaut sur notre page de bienvenue qui offre des informations utiles et de nombreux liens, de même que le site web du projet.

Si vous ne trouvez toujours pas de réponse à vos questions ou si vous souhaitez rencontrer d'autres utilisateurs et développeurs de Haiku, vous pouvez rejoindre les forums de discussion, l'un des canaux IRC (accessibles aussi par Matrix ou XMPP), ou envoyer un message sur l'une de nos listes de diffusion où une communauté sympathique pourra vous aider.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Aux origines du premier GPU, une bande de copains de l'ENS

Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ).

Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi.

l'EF9365

Le circuit intégré Thomson-Efcis EF9365
Contrôleur de visualisation graphique,1980

Les rédacteurs de cette dépêche collaborative remercient :

  • Philippe Matherat, le concepteur de ce composant ! Il a eu la gentillesse de se prêter au jeu en répondant à nos questions et en apportant de nombreuses précisions et anecdotes –les citations dans la dépêche sont intégralement de sa main– ;
  • PulkoMandy, pour son journal d’archéologie informatique sur la thèse de Jean Gastinel. Sans ce journal, cette dépêche n'aurait jamais vu le jour ;
  • Jean-François DEL NERO, développeur de l’émulation du 365 dans Mame, pour les échanges et les apports techniques ;
  • l'équipe de rédaction du magazine Sciences et Avenir, pour l'autorisation de publier des extraits de l'article "le Silicon labo de la rue d'Ulm", n° 455 (Janvier 1985).

Sommaire

Généalogie des puces EFxxxx

Un GPU est un composant informatique (une puce dédiée dans les cartes graphiques des PC ou intégrée au processeur central (CPU) de votre téléphone (soc)) initialement dédiée à l'affichage d'images.

D'abord limité à l'affichage 2D, il a rapidement pris le relais du CPU pour gérer les calculs parallèles de la 3D. Aujourd'hui, cette puissance brute sert autant au traitement vidéo qu'à des domaines bien éloignés des pixels, comme le minage de cryptomonnaies ou l'IA.

Cette bascule technologique a récemment propulsé nVidia, le principal acteur du marché, au sommet de l'économie mondiale.

Pourtant, bien avant cette folie financière et les géants américains ou asiatiques, c'est en France qu'est née cette architecture moderne.

Cette dépêche vous propose de découvrir l'histoire du 365, le premier GPU sur puce unique.

La génèse

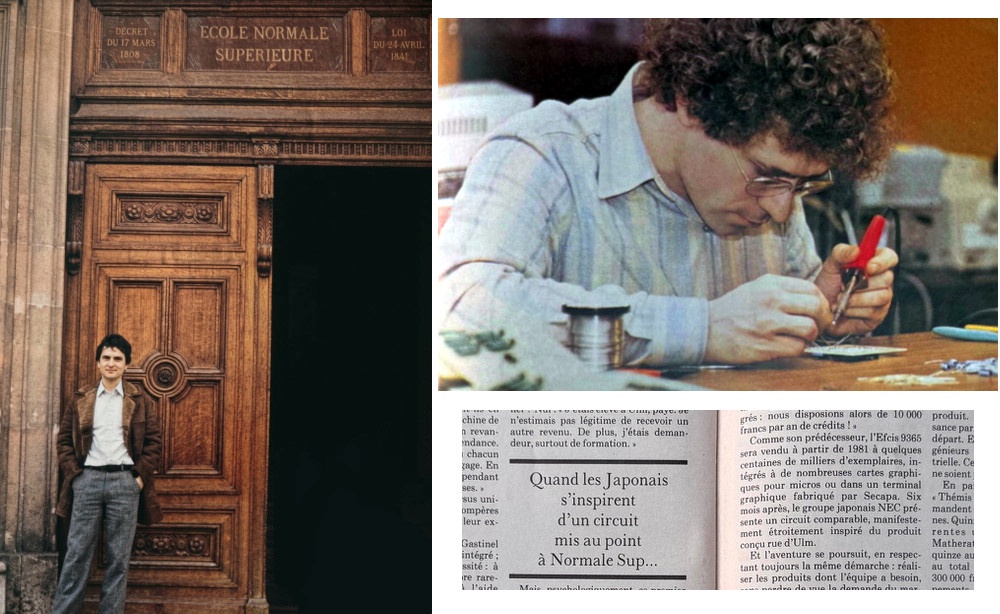
Extraits de l'article

Extraits de l'article "le Silicon labo de la rue d'Ulm" de Dominique COMMIOT
© Sciences et Avenir n° 455 (Janvier 1985)
À gauche, Jean GASTINEL devant le bâtiment historique de l'ENS.
À droite, Philippe MATHERAT et un extrait de l'article.

Philippe Matherat avait résumé ainsi le contexte de cette épopée dans l'article de PulkoMandy :

Nous étions une bande de copains, élèves de l’Ecole Normale Supérieure, de la promotion 1973.

L’informatique était balbutiante, les ordinateurs étaient gigantesques (un bâtiment), très rares et très chers. Personne n’envisageait qu’ils puissent être répandus et bon marché.
Les seuls écrans connus étaient ceux de la télévision. Les terminaux informatiques étaient des machines à écrire mécaniques actionnées par des relais électromécaniques. Ces terminaux étaient reliés à des gros ordinateurs distants, par une ligne téléphonique dédiée.
La fréquence d'horloge des ordinateurs les plus puissants était 12 MHz.

Jean Gastinel était le seul de notre promotion qui connaissait un peu ce qui se passait aux Etats-Unis, grâce à son père : Noël Gastinel, qui était professeur à Grenoble et qui avait fait des voyages dans les universités américaines et chez IBM. Il avait fait équiper l’université de Grenoble d’un ordinateur IBM 360/68.
Jean Gastinel, avec Jean-Marc Frailong et Jean-Luc Richier, ont réalisé un ordinateur 12 bits, à base de circuits MSI de Texas-Instruments, dans les années 1973-1975.

Puis Jean-Gastinel s’est lancé dans la conception du circuit d’affichage alpha-numérique, qui a été commercialisé sous le nom de SFF364 puis EF9364 (le changement de nom correspond au changement de nom de la société Sescosem en EFCIS). Cette conception a fait l’objet de sa thèse de 3è cycle.

Depuis cet article, P. Matherat a détaillé :

Quand je suis entré à l’ENS en 1973, il n’y avait pas de labo d’informatique, ni d’électronique. Les disciplines (en sciences) étaient les disciplines classiques de l’université : mathématique, physique, chimie, biologie, etc. Les chercheurs et les élèves avaient accès à un "Centre de calcul", dirigé par Maurice Vallino, qui consistait en un terminal (lecteur de cartes perforée et imprimante) connecté à un ordinateur Univac de l’université d’Orsay par une ligne à 1.200 bits/s, puis plus tard équipé d’un mini-ordinateur CII Mitra 15. Nous avons eu des cours de programmation Fortran par Jacques Arsac. Nous avions aussi accès à une formation en électronique (analogique), dans un local du labo de physique, fait par F. Lenouvel.

Quand Jean Gastinel a souhaité réaliser un ordinateur, associé à J-M Frailong et J-L Richier, ils sont allés à Jussieu, à l’institut de programmation, où il y avait une équipe qui réalisait des montages électroniques, dirigée par Gérard Noguez. Puis, ils ont souhaité continuer à l’ENS, et M. Vallino leur a cédé une petite pièce annexe du Centre de calcul, ainsi qu’un petit budget annuel de 10.000 F. C’est dans cette pièce que Jean a réalisé la maquette du 364, puis j’ai continué là avec la maquette du 365.

Ce que nous appelions "maquette" était le câblage d'une émulation de la future puce à l'aide de circuits MSI existants (des centaines), afin de pouvoir tester en temps réel la conception logique. Il n'existait aucun outil de CAO. Tout était câblé à la main, sans simulation préalable, et notre principal outil était l'oscilloscope pour vérifier les signaux. Avec des fréquences de l'ordre de quelques MHz, il nous fallait un oscilloscope haut de gamme.

Une question de mémoire

Sans la capacité d'Intel à produire en masse des puces DRAM de plus en plus denses, le 365 n'aurait jamais pu exister :

À la suite du 364, j’ai pensé qu’on pouvait faire du graphique : j'ai commencé cette étude en 1976, à l'occasion de mon DEA d'informatique. Il faut bien voir que ceci n’est devenu possible que grâce aux nouvelles mémoires de 4 Kbits, car un affichage 512 x 512 à 1 bit/pixel nécessite 64 boîtiers mémoires de 4 Kbits. En fait cela ne devient raisonnable qu’avec 16 boîtiers de 16 Kbits (soit 32 K octets). Il n’était donc pas possible de faire un GPU avant ces années-là. Mon mérite a été d’avoir le flair de voir qu’une période nouvelle pouvait s’ouvrir, et que les écrans graphiques pouvaient se démocratiser.

Mais utiliser 32 K octets rien que pour l'écran paraissait délirant, à une époque où la mémoire "centrale" utilisée par le CPU pour son programme et ses données ne dépassait pas 4 ou 8 K octets. Quand à vouloir faire de la couleur avec 3 bits par pixel, là j'étais vraiment pris pour un fou. Songez qu'un adressage sur 16 bits (cas des microprocesseurs de l'époque) ne permet pas de dépasser 64 K (= 216 ).

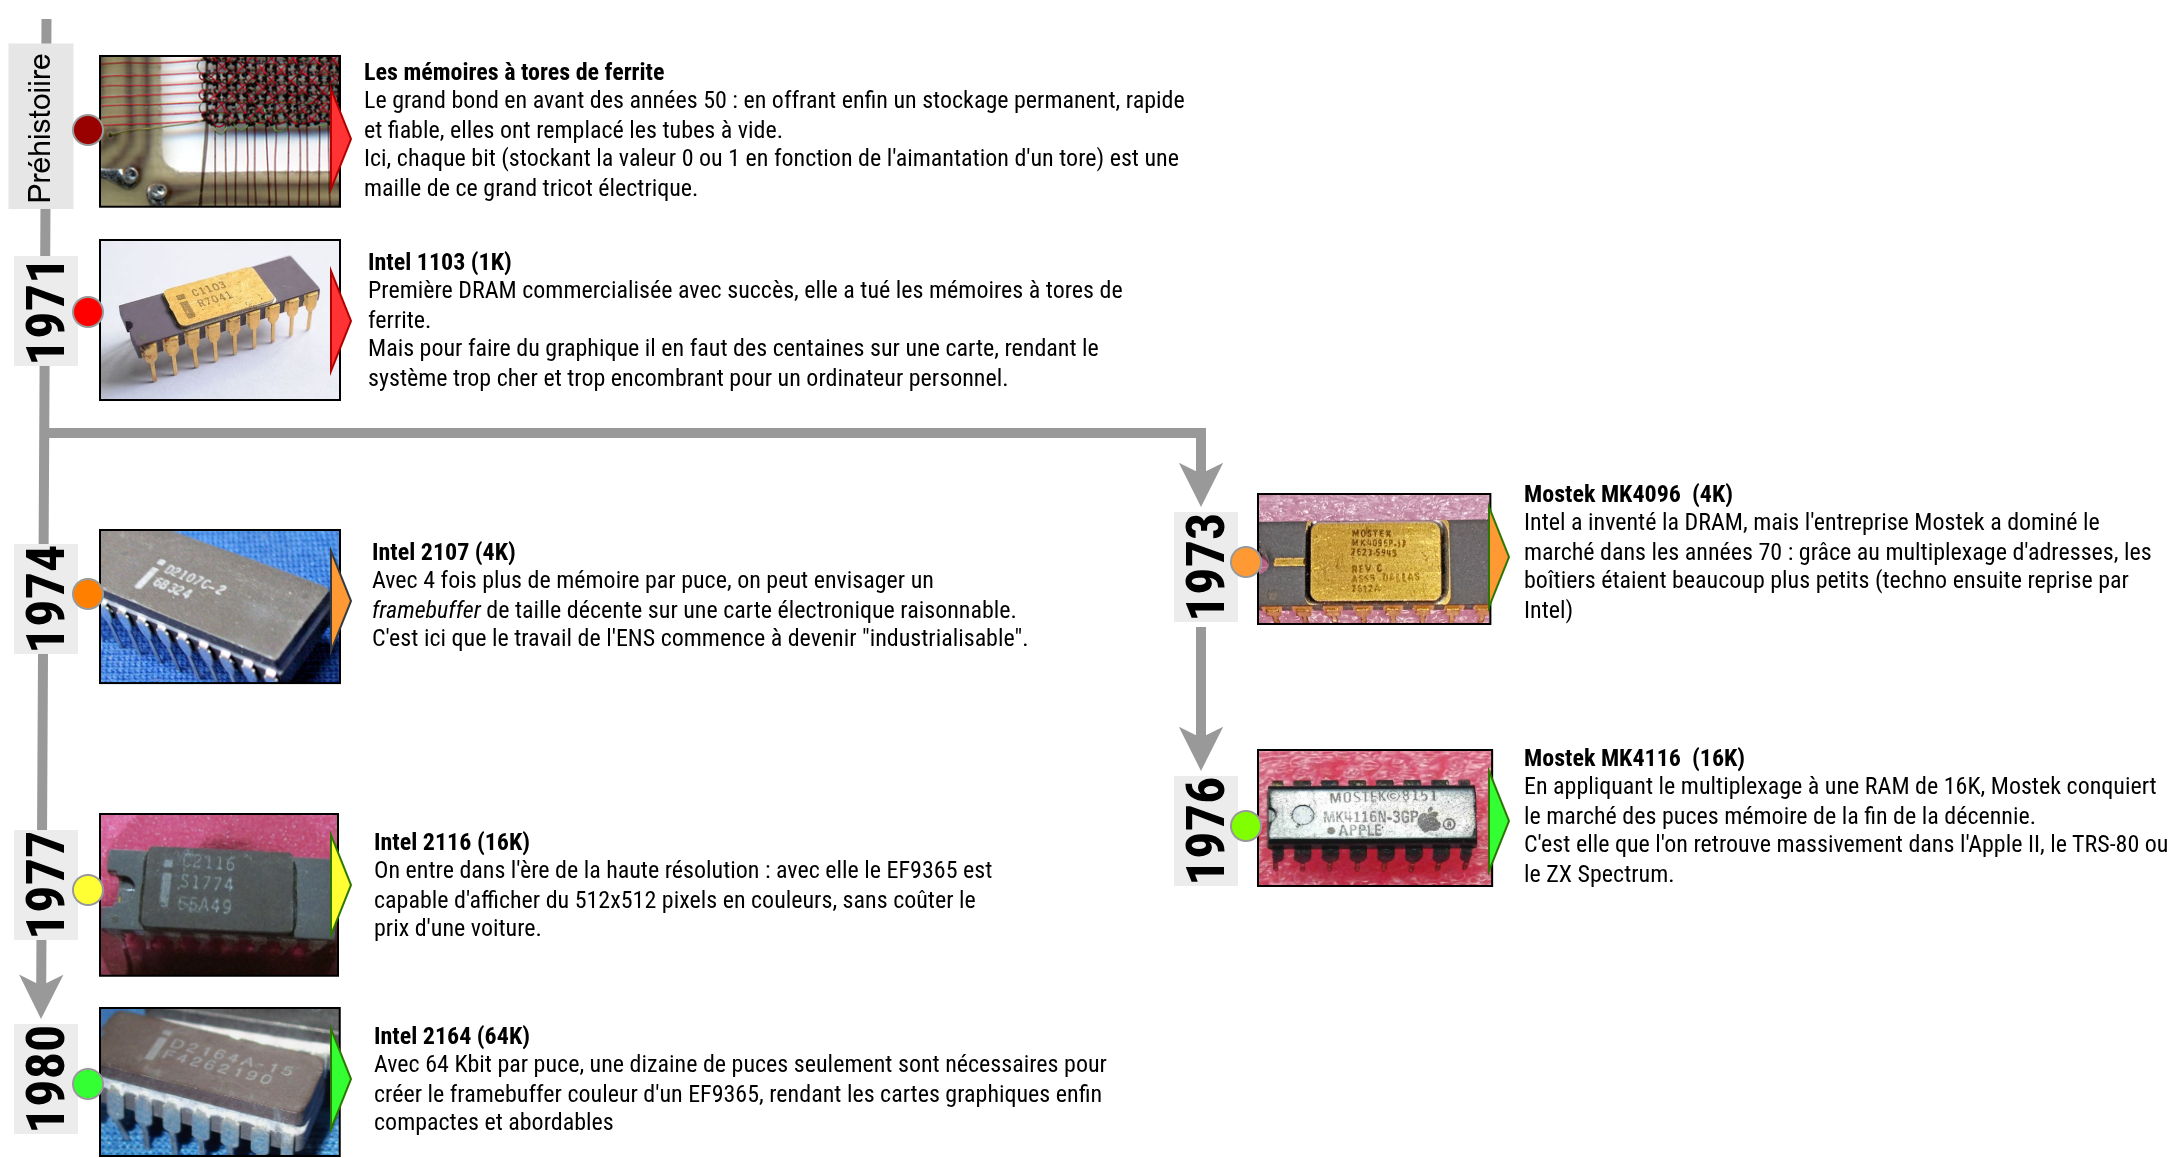
Dates de sortie des DRAM Intel

Le marché aux puces des seventies
Naissance et évolution des composants DRAM

Notez bien que, à l'époque, la capacité de ces mémoires s'exprime en bits (non pas en octets), et par un simple « K » : ce k majuscule vaut 1 024 bits (le kibibit actuel) et non 1 000. Pour résumer et par exemple, il faut traduire 16K par 2 kio.

Pourquoi cette augmentation de la capacité de la RAM à cette époque ?

Les circuits de RAM nécessitent un très grand nombre de transistors, mais sont très répétitifs : ils coûtent donc relativement peu cher à concevoir, mais demandent une chaîne de production de semi-conducteurs de très bonne qualité. Les fabricants de semi-conducteurs Japonais sont ceux qui vont le mieux maîtriser ce type de produit, fournissant des composants de plus en plus grande capacité à des prix écrasant la concurrence américaine. Intel ne s'en remettra qu'avec de grosses difficultés. Un autre fondeur de RAM américain, Mostek, n'y survivra pas et sera revendu à Thomson-CSF, qui rentabilisera largement son investissement en exploitant les brevets ainsi rachetés.

Le plastique, c'est fantastique

En creusant le sujet de ces premières mémoires vives, on comprend qu'il y a eu une autre évolution importante : le choix du matériau pour le boîtier.

Les boîtiers des premiers CI (dont la référence est préfixée par "C" ou "D") étaient en céramique : c'était coûteux mais dans les début des années 70 seul ce matériau répondait aux besoins de dissipation thermique et d'étanchéité.
Au départ, les fabricants avaient du mal à stabiliser le plastique, car l'humidité finissait par s'infiltrer par capillarité le long des pattes en métal, provoquant la corrosion de la puce.
Pour protéger la puce, il lui a été ajouté une couche (au nitrure de silicium), dite "de passivation", qui permet le contact avec le plastique.
Plus tard dans la décennie (à partir des puces 16K soit vers 1977), la transition vers le plastique s'opère massivement, leur référence est alors préfixée par "P".
Le moulage plastique a permis de produire des puces à la chaîne à un prix dérisoire par rapport au processus artisanal du boîtier céramique multicouche.

La production

L'histoire industrielle du fondeur

  • 1969 : Création de Sescosem (Société Européenne de Semiconducteurs et de Microélectronique), filiale de Thomson-CSF.  
    Selon Wikipedia : Thomson-CSF est le résultat de la fusion réalisée en 1968, du groupe électronique Thomson (filiale de Thomson-Brandt) et de la Compagnie générale de télégraphie sans fil (CSF). Leurs filiales dédiées aux circuits intégrés, respectivement SESCO et COSEM, sont donc fusionnées pour devenir SESCOSEM.
  • 1976 : Sescosem devient EFCIS (Étude et Fabrication de Circuits Intégrés Spéciaux). C'est à ce moment précis que la référence change : le SFF364 devient l'EF9364.
  • 1983 : Thomson-CSF réorganise ses activités. EFCIS est intégrée au sein de la branche Thomson Semiconducteurs. C'est l'époque de la grande offensive sur le marché grand public avec le Minitel et les ordinateurs (Alice, VG5000) utilisant les dérivés comme l'EF9345.
  • 1987 : Thomson Semiconducteurs fusionne avec la branche composants de l'italien SGS (Société Générale Semiconduttori). Naissance de SGS-Thomson Microelectronics.
  • 1998 : SGS-Thomson est renommé STMicroelectronics (ST), le nom que nous connaissons aujourd'hui : une multinationale franco-italienne de droit néerlandais.

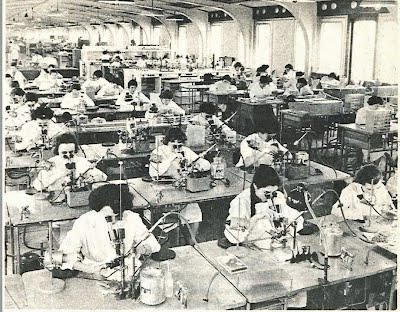
Fabrication de transistors à la COSEM

Fabrication de circuits à la COSEM
source https://aconit.inria.fr/omeka/items/show/681 E. Gillet, Les transistors, ces magiciens.
Gamma Presse, 1964. Crédits photo : René Bouillot.

Dates de production

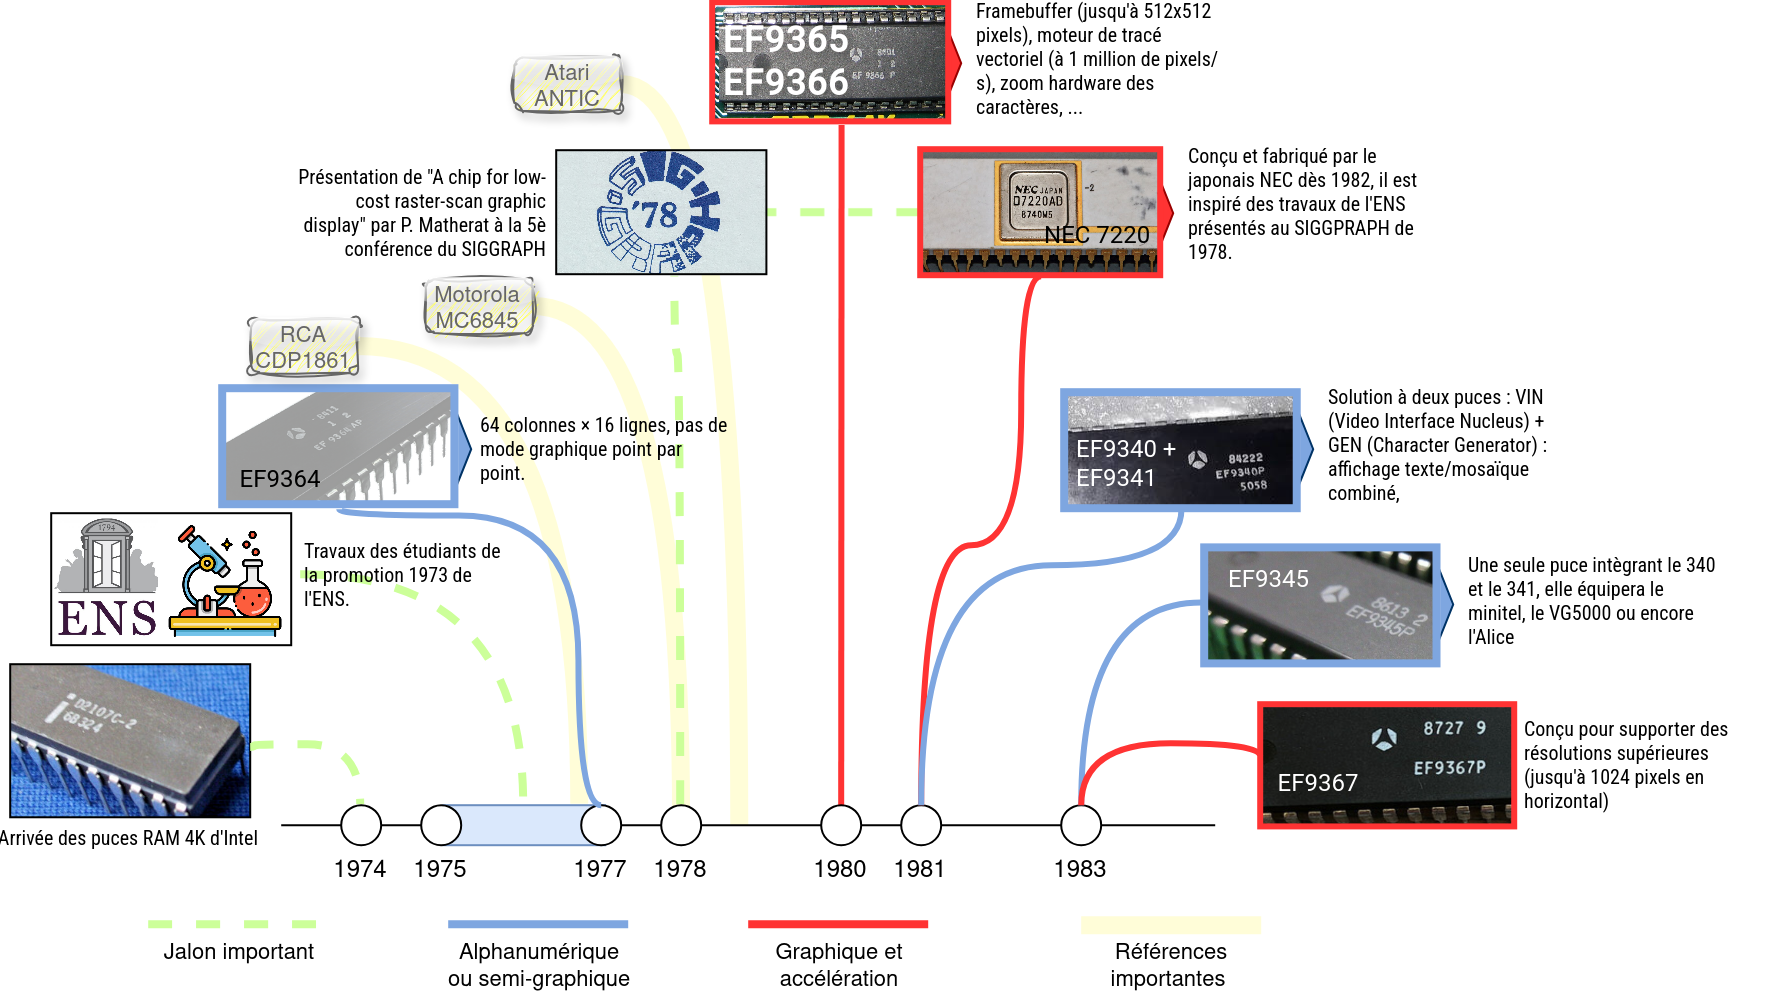
Chronologiquement, Sescosem ou EFCIS ne faisaient pas de tels chips pour écrans avant que les élèves de l’ENS lui en apportent :

  • En premier, Jean Gastinel a conçu le circuit alphanumérique EF9364, de 16 lignes de 64 caractères, qui est sorti vers 1977.
  • Ensuite, j’ai conçu le premier chip graphique EF9365, de 512x512 pixels, qui est sorti vers 1980, avec sa variante EF9366 (balayage non-entrelacé).
  • Le circuit 9367 est une variante du 9365, avec des performances augmentées.
  • Les circuits du genre 9345 sont postérieurs au 9365, ils utilisent les éléments de base des circuits précédents, et ont été demandés par les concepteurs du minitel, qui sont donc des copies, variantes, des circuits conçus par les élèves de l’ENS.

Généalogie des puces EFxxxx

Chronologie de mise sur le marché
des puces EF9xxx et quelques consœurs

La petite famille

L'EF9364, le précurseur

L'année dernière, PulkoMandy a exhumé la thèse de Jean Gastinel "Conception et intégration d'un terminal alphanumérique", qui pose avant l'heure les bases du Minitel et qui est aussi à l'origine de l'aîné de la famille : l'EF9364 est un contrôleur vidéo purement alphanumérique (affichage de 16 lignes de 64 caractères).

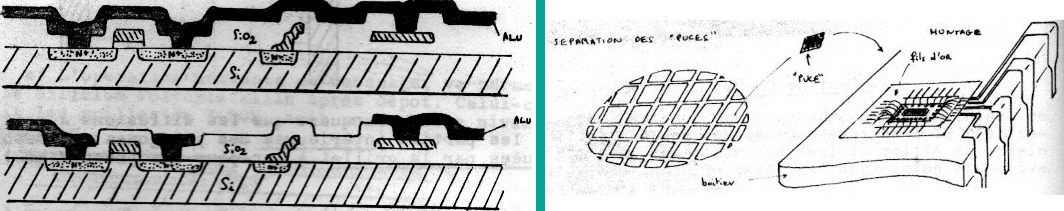
Cette thèse est une véritable pépite pour les férus d’archéologie informatique, on y trouve notamment tous les détails sur la réalisation du CI :

Ajout d'un masque

fig 1.10 - Dessin final des cinq masques superposés - Chapitre 1 fig 4.2 Montage des "puces", Chapitre III "Intégration du circuit "VISU" de la thèse

Ce composant est prévu pour réaliser un terminal passif, sans microcontrôleur. Avant son arrivée, toute la logique vidéo des terminaux était implémentée par de la logique discrète: une centaine de puces électroniques étaient nécessaires. Les autres composants d'un terminal, comme le modem et le contrôleur de clavier, bénéficiaient déjà de solutions intégrées. Ce composant rend donc possible la construction d'un terminal à très bas coût avec quelques dizaines de composants.

Il implémente tout de même des fonctionnalités de défilement de l'affichage, de déplacement du curseur, et d'effacement partiel (tout l'écran visible, la ligne courante, depuis le curseur jusqu'à la fin de la ligne). Ces fonctionnalités sont similaires à ce qui se fait sur les terminaux de l'époque (VT52 chez DEC, ADM-3A, …). Cependant, les générations suivantes de terminaux à partir du VT100 choisiront plutôt d'utiliser un microprocesseur.

La génération des caractères proprement dit est effectuée par un composant séparé appelé générateur de caractères. Il s'agit dans le cas le plus simple d'une ROM programmée avec une police bitmap de taille fixe.

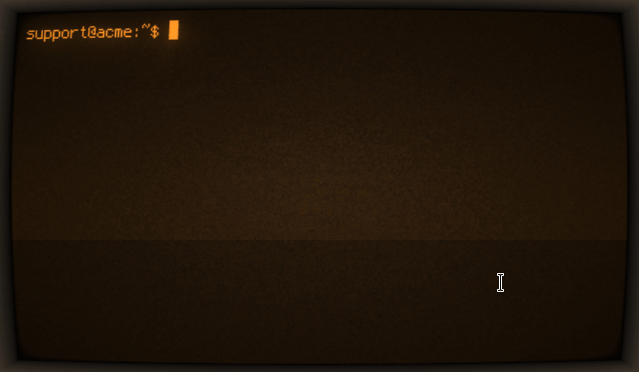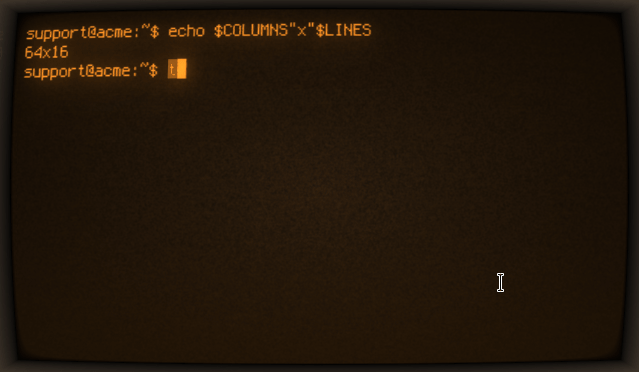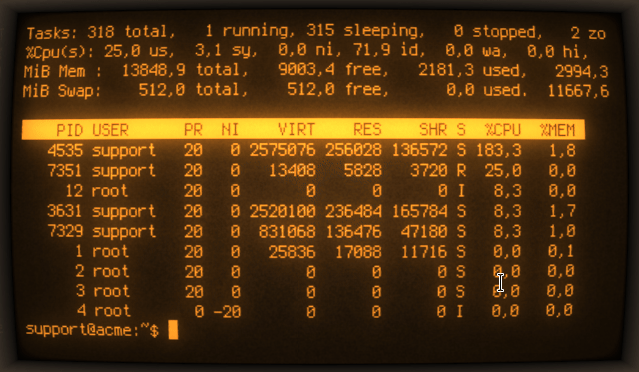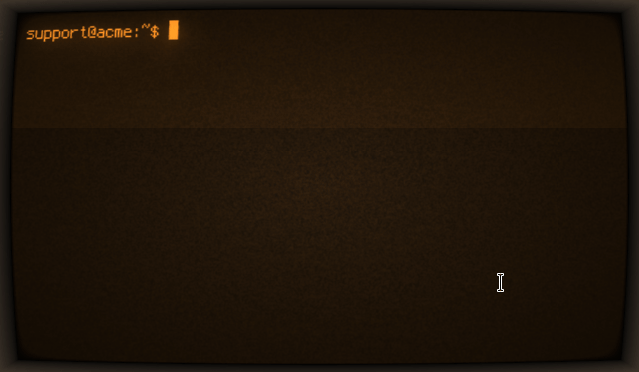
Pour les nostalgiques du rendu d'affichage alphanumérique (le seul proposé par cette puce) sur un écran de l'époque, vous pouvez essayer cool-retro-term (lien qui devrait être sponsorisé par le SNOF)

capture cool-retro-term

Simulation d'affichage sur tube cathodique
        par cool retro term, à la EF9364
(alphanumérique, 64 colonnes x 16 lignes)

L'EF9365

Second de la famille, c'est l'objet de notre dépêche : voir la section suivante qui lui est dédiée.
Nous passons souvent sous silence le EF9366, qui est très proche du 365, mais les 2 sorties sont vraiment concomitantes.

En fait, les 9365 et 9366 sont sortis en même temps, c’est moi qui avais fait la modification qui supprime l’entrelacement (pour le 9366), car le premier client (Secapa), qui avait travaillé sur la maquette de simulation du 365, ne supportait pas le clignotement de l’affichage 512x512. Pour moi, l’intérêt était d’avoir une résolution élevée, et je conseillais d’utiliser un CRT avec des phosphores plus rémanents. Mais les CRT les moins chers (TV) avaient des phosphores rapides.

Nous passons aussi sous silence le EF9367, sorti plus tard, proche du 365 mais supportant des résolutions supérieures.

Le NEC µPD7220 : le cousin Japonais

Ce composant n'est pas compatible avec la série EF9365. Cependant, il a un fonctionnement assez similaire. Commercialisé en décembre 1981, il a été développé à partir de 1979, et probablement inspiré par la présentation du travail sur le 365 au SIGGRAPH en 1978.

En plus des lignes, rectanges et textes, il peut tracer des cercles, arc de cercles et autres courbes. Il est également prévu pour s'interfacer avec un contrôleur DMA, ce qui facilite l'échange de données avec le CPU de contrôle.

Le design de NEC a également été produit par Intel, qui continuera à faire évoluer cette famille de composants. C'est donc un ancêtre des GPU Intel toujours en production aujourd'hui.

L'EF9340 et 9341

Ces deux composants sont au cœur des premiers modèles de Minitel, il s'agit d'une adaptation "low cost" et d'un retour au mode alphanumérique. Ils sont conçus en 1980-1981.

Les premiers prototypes du Minitel utilisent des circuits de chez TI (que l'on retrouvera également dans l'ordinateur Exelvision EXL100). Mais les modèles de production se tournent vers une solution "made in France". Thomson EFCIS se charge de la conception de ces circuits qui sont fournis à Alcatel pour la fabrication du Minitel.

Réponse à appel d'offre du Minitel mentionnant les circuits VIN et GEN : la visualisation est confiée à deux circuits spécialisés VIN et GEN, chargés des signaux de base de temps et de la synthèse des caractères.

Ils sont associés à un microprocesseur, faisant du Minitel un terminal "intelligent" capable de réaliser certaines fonctions en autonomie, sans avoir besoin de communiquer chaque appui de touche du clavier au serveur central.

Ils ajoutent également un mode "semi-graphique" : il ne permet pas d'afficher des pixels, mais propose des 'briques', de 2x3 éléments, pré-dessinées dans la ROM du processeur.
On économise ainsi drastiquement la RAM qui coûtait, déjà, cher…
Le prix unitaire d'une RAM Intel 2107 (de 4K, soit 512 octets) était, à sa sortie en 1974, de 50 $ => avec l'inflation cumulée et la conversion, cela représente environ 295€ de 2026.

Exemple de [caractères semi-graphiques](https://en.wikipedia.org/wiki/Thomson_EF9345)

Exemple de caractères semi-graphiques
              autorisés par L'EF9345
       Page 84 du Databook Thomson.

En plus du Minitel, ces composants seront également utilisés par Philips dans les consoles Videopac Plus, ce qui sera la première étape dans la conception du VG5000 dont on reparle au chapitre suivant.

L'EF9345, la cheap chip

Le composant EF9345 regroupe dans une seule puce les fonctionnalités du générateur de caractères et du contrôleur de timing vidéo (GEN et VIN, qui étaient auparavant deux composants séparés).
Cette photo zoomable du cœur de silicium du composant (die shot) montre bien cet assemblage.
Cela a permis de réduire le coût de production du Minitel et a également été utilisé dans quelques micro-ordinateurs personnels : l’Alice chez Matra ou le VG5000 chez Philips.

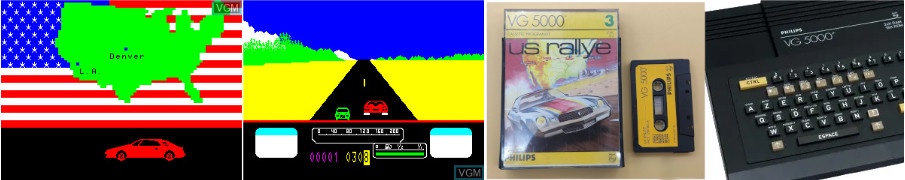
Captures de US Rallye

Captures de US Rallye, le Gran Turismo de 1984

Ici, la puce ne sait pas ce qu'est un pixel : elle manipule une grille de caractères (25 lignes de 40 ou 80 colonnes).

Pour afficher une lettre ou un bloc de couleur (le fameux mode mosaïque), le processeur principal envoie juste un code d'un octet en RAM. C'est une ROM interne à la puce d'affichage qui se charge ensuite de traduire cet octet en points lumineux à l'écran.

C’était une astuce pour économiser la mémoire, mais impossible de tracer une ligne fine ou de faire bouger un élément au pixel près : on est condamnés à déplacer des blocs rigides sur une grille fixe. Au mieux, certains caractères peuvent être redéfinis, pour afficher un logo ou une image simple.

La suite pour ST

Pour ST Microelectronics, l'histoire des composants graphiques continue encore quelques années après la commercialisation de la série EF936x. Bien que les composants graphiques n'ont pas eu le volume de production de la version alphanumérique (surtout portée par le Minitel), ils ont trouvé une utilisation dans l'informatique scientifique et les appareils de mesure nécessitant la visualisation de données : spectromètres, analyseurs de spectre, ainsi que des réalisations spécifiques (cartes graphiques en kit Elektor pour machines CP/M à bus S-100).

L'offre sera complétée par l'EF9369, un circuit permettant de gérer une palette de 16 couleurs parmi 4096. Ce circuit est conçu au départ pour le micro-ordinateur Thomson TO9, mais finit par rejoindre le catalogue public de EFCIS puis de SGS-Thomson.

En parallèle, SESCOSEM avait signé un contrat avec Motorola lui permettant de produire en France des composants conçus par Motorola (permettant de rassurer les acheteurs qu'il s'agissait de productions locales). SGS-Thomson se retrouve donc à produire à la fois la famille 93xx mais aussi le EF6845, le contrôleur d'écran de la famille 68xx de Motorola. Ce contrat devait comprendre toutes les futures puces de la famille 68xx conçues par Motorola, mais cela finira mal, puisque Motorola refusera de fournir les masques nécessaires à la production du processeur 68020.

En fonction des demandes de clients, de nouveaux composants sont réalisés avec des adaptations simples (changement de timings vidéo pour afficher plus de pixels) ou plus poussés. C'est le cas de la famille TS68483 (surnommé AGAC, Advanced Graphic and Alphanumeric Controller) disponible en 1987.

Il s'agit d'une version améliorée du 9365 avec:

  • une interface 16 bits avec le processeur, adapté à l'utilisation avec un 68000 par exemple.
  • Des fonctions supplémentaires : tracé de courbes, cercles, remplissage de zones…
  • Meilleure intégration : il n'y a plus besoin d'un séquenceur et de registres à décalage externes.
  • Configuration logicielle de la résolution d'écran vidéo

Ce composant trouve également une utilisation dans des systèmes militaires, pour lesquels il existe une version "durcie", plus résistante (gamme de températures acceptables par exemple).

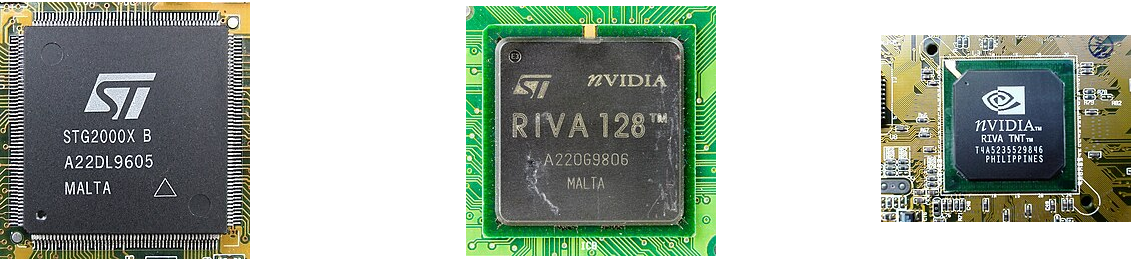
Plus tard (en 1995-1997), c'est également ST qui fabrique les premières puces conçues par nVidia: NV1 STG2000 puis RIVA 128. Pour la première, le principe est similaire à ce qui avait été fait pour le EF9365 : ST assure la production et la commercialisation en son nom propre (on trouve donc des datasheets ne mentionnant pas du tout nVidia). Pour la seconde génération, ST ne se charge que de la fabrication, les datasheets (et les puces elle-mêmes) font apparaître les logos des deux entreprises. Malheureusement pour ST, ce partenariat n'ira pas plus loin, et les puces nVidia des générations suivantes seront produites exclusivement par TSMC.

ST la suite

STG2000 (ST) RIVA 128 (ST) RIVA TNT (TSMC)
logo de ST seul deux logos côte à côte logo nVidia seul

Le génie de l'EF9365

Un vrai framebuffer

Ce composant ne se limite plus à une RAM de stockage des caractères, il dispose d'une RAM de pixels dédiée (le framebuffer) qu'il gère de manière autonome.

De ce point de vue c’est vraiment le premier chip qu’on peut qualifier de "graphique", car les autres étaient appelés "alphanumériques" ou "alpha-mosaïques".

La grosse différence entre les deux est que "graphique" suppose de pouvoir accéder à un pixel particulier, alors que les autres n’accèdent qu’à un "caractère", les pixels d’un caractère étant définis secondairement par une ROM.

Autrement dit, la RAM d’un chip graphique est une RAM de pixels (beaucoup plus grosse, par exemple 512x512), alors que dans le cas alpha-xxx c’est une RAM de caractères (16x80 par exemple).

Il faut bien voir que cette chronologie est liée à la sortie des puces mémoires de Intel : Les puces de 4 K bits ne sont apparues que vers 1974. Avant, il était impossible de faire du vrai "graphique". Il aurait été trop compliqué de stocker chaque point de l’image individuellement : en télévision, le signal vidéo était analogique, et les magnétoscopes à bande magnétique enregistraient le signal video analogique.

L'idée de stocker une image matricielle (point par point) dans une mémoire vive pour l'afficher à l'écran n'était pas nouvelle (par exemple: Evans & Sutherland Shaded Picture System qui faisait déjà du rendu 3D en 1973, premiers "frame buffers" dès 1969 chez Bell Labs, mais ce sont des solutions complexes et coûteuses). On peut également mentionner le CDP1861 de chez RCA: il s'agit d'un framebuffer mais avec une résolution de seulement 64x128 pixels (et encore, il est parfois exploité en 32x64 pixels pour économiser de la mémoire). L'EF9365 marque une rupture historique : c'est le premier processeur graphique commercialisé de manière monolithique (sur une seule puce) conçu pour piloter un framebuffer géométrique de manière autonome. Il gère non seulement le framebuffer et l'affichage à l'écran, mais aussi des fonctions de tracé de lignes et de caractères. C'est donc le premier processeur graphique à proposer une forme d'accélération matérielle sur un système à framebuffer.

L'actualisation de l'image à l'écran utilise seulement 57 % du temps (64 cycles sur 112 cycles de l'horloge externe continue).
Le temps restant est libre pour l'écriture et la mise à jour de l'image : il est possible d'écrire un point par cycle libre, ce qui donne un temps moyen de 1,3 µs par point. Dans les cas où il y a beaucoup d'informations à afficher d'un coup, il est également possible de désactiver l'affichage pendant la préparation de l'image puis de le réactiver ensuite. Malheureusement, cela ne se prête pas trop à la réalisation d'animations complexes.

La décharge du CPU pour certaines tâches

C'est ce qui définit ce composant comme le premier GPU de l'histoire : son auteur lui a câblé des registres pour prendre en charge des fonctionnalités qui déchargent le CPU (processeur central) sur des opérations graphiques !

Exemples de programmes en langage MPL qui montrent la simplicité d'utilisation

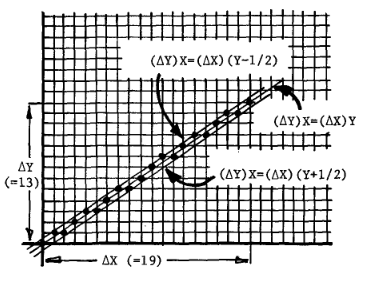
Le tracé de lignes

Le CPU peut par exemple demander à l'EF9365 de dessiner un trait d'un point A à un point B et revenir aussitôt à sa tâche. L'EF9365 prend alors le relais de manière totalement autonome. Il calcule les coordonnées intermédiaires en interne et écrit directement les pixels en RAM, à une vitesse folle pour l’époque : jusqu'à un million et demi de points par seconde, traçant une diagonale complète en moins de 700 microsecondes.

Tracer une ligne

L’algorithme de tracé de segment de Bresenham
Présentation SIGGRAPH'78, page 5

Traitements hardware sur les caractères

Redimensionnement matériel (jusqu'à 16x)

Auparavant, pour doubler la taille d'une police ou d'un motif, on demandait au processeur principal de recalculer tous les points. L'EF9365, lui, gère cela en toute autonomie via deux registres internes dédiés aux facteurs d'échelle : CZX (Zoom en X) et CZY (Zoom en Y).

Le processeur graphique possède un compteur de pas pour dessiner le caractère pixel par pixel à partir de sa ROM interne.
Quand le zoom est activé (par exemple à 4×), au lieu d'incrémenter l'adresse de destination dans le framebuffer à chaque pixel lu, l'EF9365 va répéter la même valeur de pixel sur la ligne 4 fois de suite en horizontal avant de passer au pixel suivant. Pour la verticale, il va répéter la même ligne complète du caractère 4 fois de suite dans la mémoire d'écran.

L'avantage : comme les zooms X et Y sont indépendants, on peut appliquer un zoom 2× en largeur et 4× en hauteur. Cela permettait de faire instantanément des effets de texte étiré, condensé ou géant sans aucun calcul pour le CPU.

L'effet Italique

L'inclinaison n'est pas stockée dans une ROM ; elle est calculée « à la volée » lors de l'écriture dans la RAM de pixels.
Pour incliner un bloc de pixels, il faut appliquer un décalage horizontal progressif à mesure que l'on monte en hauteur.
À chaque fois que le générateur passe à la ligne supérieure (Y+1) pour dessiner le caractère, il ajoute automatiquement un offset fixe (un décalage d'un pixel) sur l'axe horizontal (X).

Le caractère est littéralement « cisaillé » géométriquement pendant qu'il est écrit dans le framebuffer. On obtient un effet italique parfait et fluide, directement câblé dans le silicium.

La seule inclinaison possible est 45 degrés (voir la notice page 21).
C’est beaucoup plus simple ainsi à réaliser en hardware. Je m’étais posé la question de faire tous les angles, mais j’avais abandonné.

Autres fonctionnalités

L'EF9365 marque d'autres évolutions technologiques novatrices…

Il intègre notamment un mécanisme de masquage d'écriture par plan.
En verrouillant certains plans de la RAM, il pouvait dessiner ou effacer des éléments au pixel près sans jamais altérer le fond de l'image, jetant les bases de la gestion matérielle des calques.

Il propose un module de pointillés gérés au pixel individuel (une aubaine pour la CAO industrielle).

Son interface de bus universelle est capable de dialoguer nativement aussi bien avec un Z80 qu'un Motorola 6809.

et… concrètement ?

Jean-François Del Nero a produit une démonstration des capacités de rendu du 365 sur le Squale, un micro-ordinateur de 1984 qui exploitait ce composant.
Ci-après quelques extraits, très saccadés (export gif oblige), presque fidèles (cherchez l'intrus !) :

[Une démo du 365 ](https://i.imgur.com/7RXP1ze.gif)

En plus de son travail de conservation du Squale, avec l'association MO5.com (qui tient un musée permanent du jeu vidéo à Arcueil), Jean-François Del Nero a aussi contribué à son émulation dans le projet Mame, et a notamment écrit le driver du 365.
Nous avons pu reprendre le code source de sa démo, la modifier, la recompiler, et simuler le rendu du 365 grâce à Mame. Avis aux développeurs fullstack en manque d'exotisme: ici, pas de conteneurs Docker ni de dépendances npm !

Est-ce vraiment le premier GPU ?

Nous avons retenu les quatre critères suivants pour distinguer le 365 des premiers contrôleurs d'affichage sur une seule puce, comme le Motorola 6845 ou l'Atari Antic, qui gèrent la synchronisation du flux vidéo et le rafraîchissement de l'écran, sans intervenir dans le dessin des formes.
Le processeur 365 :

  1. est une puce unique (LSI/VLSI) : ce n'est pas une carte remplie de circuits TTL discrets comme sur les gros systèmes vectoriels des années 70 (Evans & Sutherland, Imlac) ;
  2. déleste le CPU de tâches coûteuses en ressources : le CPU n'écrit pas les pixels un par un en VRAM. Il envoie une commande de haut niveau au 365 telle que : « trace une ligne de (X1,Y1) à (X2,Y2) », et repasse à autre chose ;
  3. dispose d'un moteur d'exécution algorithmique dédié, hardware (en silicium) : il embarque en dur l'algorithme de tracé/moteur de rendu (rasterizer) ;
  4. gère en toute indépendance la mémoire vidéo (Framebuffer/VRAM) : le 365 contrôle l'accès, le rafraîchissement et la modification de la VRAM de façon indépendante.

Et le libre dans tout ça ?

Quittons la technique pour nous intéresser à un autre aspect des travaux de l'équipe : la diffusion de ses travaux.

Vous pourriez être étonnés qu’un circuit produit par un industriel puisse être public, dans ses moindres détails. Je dois vous raconter une anecdote :

Notre petit groupe d’élèves de l’Ecole Normale Supérieure considérait que ses productions, financées par les pouvoirs publics, devaient profiter à tout le monde. Mais cela posait un problème à l’industriel (Thomson-CSF qui avait pour filiale la société Thomson-EFCIS), qui voulait protéger son produit par des brevets. Il a été convenu que Thomson-CSF déposerait des brevets au plus tard la veille de ma soutenance de thèse. Ainsi, les brevets pouvaient être valides car ne portaient pas sur un design public.

Ma thèse a été soutenue le 19 mai 1978, et les brevets avaient été déposés le 18 mai (US4286264, US4297694, US4311998, US4266253).
Ils décrivent aussi en détails le fonctionnement du circuit, mais dans le langage juridique spécifique des brevets.

En août de la même année, l'architecture du 365 est présentée lors de la conférence SIGGRAPH 78. La liste d'articles soumis à cette conférence permet de se faire une idée des évolutions en cours dans le monde des graphismes générés par ordinateur à l'époque. On y trouve la description d'autres systèmes matériels et logiciels, des algorithmes en 2D ("How to color in a coloring book", un algorithme de remplissage de zones délimitées par des traits) et en 3D, des discussions sur les choix d'espaces de couleurs, ainsi que des exemples de mises en application (par exemple pour les simulateurs de vol de la navette spatiale américaine).

Ensuite, EFCIS a beaucoup utilisé le dessin des masques du 365 pour sa communication car c’était le seul design qui était public.
Nous n’étions pas dans l’état d’esprit de créer une start-up autour de nos designs, dans le but de gagner de l'argent. Nous nous imaginions qu’il était possible de concevoir des circuits dans un contexte académique, en étant juste payés par nos salaires, puis de les céder à un industriel pour la suite. C’était une erreur car ça ne pouvait pas fonctionner, principalement parce que l’industriel a besoin de définir sa stratégie de ligne de produits avec ses arguments marketing.
Le contrat passé entre EFCIS et l’Ecole Normale Supérieure a servi à rémunérer l’ENS, qui s’en est servi pour créer le premier labo d’Informatique de l’ENS (le LIE), et je n’ai rien reçu personnellement. Je considérais que j’avais été payé par mon salaire d’élève de l’ENS.

Dans les années 1970, nous avions l’idée naïve que les innovations techniques entraînaient des innovations sociales au sens d’une amélioration des conditions de vie pour tous, à l’image de la bagnole qui s’était démocratisée et qui était synonyme de libération. Nous ne faisions pas de grande différence entre acteurs publics et acteurs privés, et nous avions l’impression que tout était publié, ne serait-ce que par les brevets, qui ne faisaient que protéger ceux qui avaient davantage investi. En revanche, nous étions sensibles à la question de la propriété industrielle, et nous pensions que ce qui avait été développé par des fonctionnaires était la propriété de l’état (ce qui d’ailleurs est la loi), et que les universitaires ne pouvaient que publier sans restrictions. (En tant qu'élèves de l’ENS, nous étions fonctionnaires et universitaires.)…

Le 365 a-t-il fait un flop ?

Clairement non, car l'EF9365 ne mesure pas ses performances en FLOPS (Floating-point Operations Per Second) : il ne manipule aucune virgule flottante (ni même de calculs en nombres réels).
Blague d'informaticien mise à part, le 365 a certes ouvert la voie à une longue lignée de composants, qui domine aujourd'hui l'actualité de la tech, mais il n'a pas eu le succès commercial de ses descendants, et l'expérience de la rue d'Ulm a tourné court.

En France et à l'époque, il était difficile de faire dialoguer recherche, industrie et financement public.

…Mais nous n’avions pas compris les particularités de ce secteur. D’une part, les usines qui fabriquent des circuits intégrés coûtent extrêmement cher. D’autre part ce secteur était appelé à un développement exponentiel, non anticipé : la plupart des hauts responsables de l’époque pensaient que les ordinateurs seraient achetés par 100 entreprises, voire 1000, mais ne concerneraient pas le grand public. Ensuite, le coût des développements logiciels devenait lui aussi très élevé. À l’époque les plus gros logiciels n’étaient pas très complexes. Et on n’avait pas compris la relation étroite entre les logiciels et les architectures matérielles. On n’avait pas compris non plus que de prendre un monopole sur un OS était un enjeu stratégique.

Toutes ces contraintes (et d’autres que j’oublie), que nous n’avions pas comprises, faisaient que nous pensions naïvement que nous pouvions faire un développement dans notre coin, sans nous occuper du marché, mais uniquement de la performance technique, et le publier, puis dans un second temps le proposer à un industriel qui aurait les moyens de le commercialiser. L’idée sous-jacente étant que si le design était performant alors il y aurait forcément un industriel pour le vendre. C’était une grande ignorance des contraintes industrielles et des questions de marketing.

Le cœur du problème ne résidait pas dans un manque de compétences (le génie des étudiants de l'ENS en est la preuve) mais dans l'incapacité des grands capitaines d'industrie français (notamment chez Thomson) à anticiper la révolution de l'ordinateur personnel et du logiciel. Confortés dans leur monopole, ils ont ignoré le virage que les États-Unis et le Japon prenaient à pleine vitesse :

Je pense maintenant que dans le contexte des années 1970-80 en France, il n’y avait pas vraiment de possibilité pour aller plus loin. Les deux milieux, universitaires et industriels, ne se parlaient vraiment pas. Personne en France, ni chez les gouvernants, ni chez les universitaires, ni chez les industriels, ne voyaient ce qui se préparait. Nous, à 20-25 ans, nous comprenions le retard technologique de la France, ne serait-ce qu'en lisant les docs des puces que nous achetions, mais il était nié par les plus hauts responsables. Les dirigeants de Thomson disaient : "Quand il y aura vraiment un marché pour ça, nous serons en mesure de produire".

En 1984, lors d'un voyage aux États-Unis et d'une visite au mythique Xerox PARC, le chercheur français découvre un autre monde. Un monde où l'innovation de rupture n'est pas confinée aux laboratoires, mais propulsée par le capital-risque, les pépinières d'entreprises et une compréhension systémique du couple matériel/logiciel :

À un moment, au début des années 80, nous parlions avec Gastinel de monter notre boîte. Mais nous étions incompétents pour ça, nous n’avions aucune conscience des difficultés, il n’y avait pas du tout l’esprit "start-up", le capital-risque n’existait pas, les pépinières d’entreprises n’existaient pas, nous n’avions aucune connaissance de la façon dont les boîtes pouvaient se créer et croître aux USAs, nous n’avons appris ce contexte que beaucoup plus tard.

Je suis allé aux USAs en 1984 pour la conférence Siggraph (à Minneapolis) et à cette occasion après je suis passé à Xerox-Parc où j’avais un ami français (Louis Monier, plus tard créateur de Altavista chez DEC). J’y ai découvert un monde insoupçonné chez nous, avec toutes leurs innovations depuis 20 ans, et j’ai rapporté leurs publications. Pourtant cela était connu (mais pas par nous), c’était à la base du Lisa et du Macintosh de Apple, sorti cette année-là. À Parc, j’y ai rencontré Franck Crow, un anglais, un grand nom du graphique (connu en particulier pour l’anti-aliasing) qui m’a félicité pour le 365, je n’en revenais pas. J’ai compris après qu’il avait été un reviewer pour mon article de 1978, avec un avis très favorable. En 1984, il avait connaissance du minitel, sorti peu avant, et m’a dit : "Nous aux USAs, nous n’avons pas été capables de faire ça". Il faut dire que c’était avant qu’Internet se répande, avec des possibilités infiniment supérieures. Internet existait depuis plusieurs années chez Xerox, mais ne pouvait pas se répandre dans le grand public avant l’existence des ordinateurs individuels.

Les pouvoirs publics français se sont parfois immiscés dans ces choix industriels : citons la nationalisation de Thomson-CSF en 1982 et le plan "Informatique pour tous" en 1985 (un investissement énorme, estimé à 1,8 milliard de francs, soit 600 millions d'euros rapportés à aujourd'hui). Pourtant, la théorie du ruissellement n'a pas très bien fonctionné alors avec les labos de recherche ou les pépites industrielles en devenir : en témoignent le départ d'une grande partie de la bande de copains vers les US ou l'échec du Squale, dont la production s'est limitée à quelques centaines d'unités.
La capitalisation boursière de STMicroelectronics (ex-SGS-Thomson) est, en 2026, 70 fois inférieure à celle de nVidia.

En fait je crois que en France, à cette époque, les choses ne pouvaient venir que d’en haut : le nucléaire, le concorde, le minitel. Le minitel a été réalisé par des gens du corps des mines et du corps des télécom (comme son nom l’indique). les choses ne pouvaient venir que des grands corps de l’état.
Notre activité, initiée par Jean Gastinel, était plutôt folle par sa liberté, et transgessive. Le climat à l’ENS, peu après 1968 où cette école avait été au cœur des événements, était très libre, nous avions vraiment la possibilité de faire n’importe quoi, sans contrôle. Jean avait entendu parler par son père de ce qui se passait aux USAs. Et ce qui se passait en Silicon-valley aussi était fait dans un cadre très libre lié à la contre-culture des hippies (mais ça, nous ne le savions pas).

Une anecdote : au début des années 80, nous avons développé un réseau local Ethernet (alors sur câble co-axial de gros diamètre), pour relier nos Thémis réalisées en 10 exemplaires. Et nous avons eu besoin de passer sous la rue d’Ulm pour connecter le laboratoire de biologie. C’était interdit par le monopole des télécoms. En outre, le protocole de transfert par paquets était refusé car concurrent du protocole des P&T. Il nous a fallu enfreindre la loi pour passer un câble en douce.
Tout ça a basculé peu de temps après, après l’explosion de l’usage des ordinateurs individuels et de leurs applications.

Pour être tout-à-fait honnête, et rendre à César…, je dois mentionner que notre équipe a été reconnue par le CNRS en 1982, où nous avons obtenu des postes et des crédits pour continuer. Il y a eu une croissance jusqu'à 10 personnes en 1985, mais la plupart des membres de l'équipe sont partis chez Xerox en 1986.

Avec le recul je dirais : on peut faire de grandes choses quand on est très peu nombreux, ça devient plus difficile lorsqu'il faut gérer la croissance…

Le hasard du calendrier a voulu que la publication de cette dépêche coïncide avec un anniversaire : il y a 50 ans débutait l'étude du 365, avec le DEA de P. Matherat :)
Pour celles et ceux qui s’intéresseraient à ses publications ou à la suite de ses travaux, c'est consultable ici.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Lettre d'information XMPP de juin 2026

N. D. T. — Ceci est une traduction de la lettre d’information publiée régulièrement par l’équipe de communication de la XSF, essayant de conserver les tournures de phrase et l’esprit de l’original. Elle est réalisée et publiée conjointement sur les sites XMPP.org et LinuxFr.org selon une procédure définie.

Bannière de la lettre d'information XMPP

Bienvenue dans la lettre d'information XMPP, ravi de vous retrouver ! Ce numéro couvre le mois de juin 2026.

La lettre d'information XMPP vous est proposée par l'Équipe de communication de la XSF.

Comme tout autre projet accompli par la XSF, la lettre d'information est le résultat du travail volontaire de ses membres et des personnes y contribuant. Si vous êtes satisfait des services et logiciels que vous utilisez peut-être, n'hésitez pas à dire merci ou aider ces projets.

Vous souhaitez contribuer à l'équipe de communication de la XSF ? Lisez en bas de page.

    Sommaire

    Annonces de la XSF

    XMPP Summit 29

    La XMPP Standards Foundation (XSF) a le plaisir d'annoncer le 29e Sommet XMPP, le premier à se dérouler entièrement en ligne ! Ce Sommet XMPP se tiendra du vendredi 4 septembre au samedi 5 septembre 2026, de 13 h à 16 h UTC ces deux jours. La XSF invite toutes les personnes intéressées par le développement des technologies XMPP à y participer à distance et discuter de tout ce qui concerne XMPP !

    Adhésions à la XSF

    Être membre élu de la XMPP Standards Foundation témoigne d’un engagement en faveur des normes ouvertes et d’une implication professionnelle au sein de ou avec la communauté XMPP. Votre adhésion contribue à faire de la XSF une organisation solide, ce qui est en soi précieux. Elle vous confère également un droit de vote sur les questions techniques et administratives au sein de la XSF. La procédure de candidature est simple et gratuite, et votre adhésion vous permettra également de vous impliquer plus facilement. Si vous souhaitez rejoindre la XMPP Standards Foundation en tant que membre, veuillez postuler à notre 3e appel trimestriel à candidatures avant le 16 août 2026 à 00h00 UTC.

    Évènements XMPP

    Articles XMPP

    Nouvelles des logiciels XMPP

    Clients et Applications XMPP

    • aTalk a publié les versions 6.1.0, 6.2.0 et 6.3.0 de sa messagerie sécurisée pour Android avec appels vidéo et fonctionnalités GPS. Ces versions introduisent la rétraction de message, retirent la fusion des messages multiples dans la fenêtre de chat, étendent la fonctionnalité de correction du dernier message à tous les messages envoyés et pas seulement au dernier message envoyé, supportent les traductions des messages envoyés/reçus dans les chats/salons avec l'option de traduction qui peut être activée par contact ou par salon, et apporte également des améliorations, quelques corrections mineures et beaucoup de modifications 'sous le capot'. Voir les notes de publication pour tous les détails.

    • Conversations a publié sa version 2.20.1 pour Android. Cette publication ajoute les Note à moi-même comme suggestion de recherche et des corrections de bugs mineurs. Assurez-vous de consulter le journal des modifications pour tous les détails !

    • Converse.js a publié sa version 14.0.0 de son client web XMPP open-source. Cette publication ajoute le support pour le chiffrement OMEMO:2 ! Elle apporte également des nouvelles méthodes pour l'API pubsub pour créér, s'abonner et se désabonner, support de la version logiciel et affichage des versions logiciels du serveur dans le profil, support d'OMEMO 2 (urn:xmpp:omemo:2) en utilisant la stanza content encryption, détecte les contacts supportant uniquement omemo:2 comme étant capable d'OMEMO, avec de nombreuses autres corrections et d'autres travaux sous le capot ! Tout ceci génère certaines incompatibilités rétroactives, donc merci de consulter directement le journal des modifications pour tous les détails !

    • Fluux Messenger, a publié ses versions 0.16.0, 0.16.1 et 0.16.2 , de son client moderne XMPP multi-plateforme, pour les communautés et organisations. Ces versions ajoutent le chiffrement de bout-en-bout OpenPGPle chiffrement des messages 1:1 avec un stockage de clé protégé par mot de passe et la sauvegarde/restauration de clé secrète, le support de OpenPGP e2ee dans la version web, la gestion des Multi-TSK (Transferable Secret Key) dans le flux de restauration des sauvegardes des comptes possédant plusieurs clés, marqueur de message non-lus sur l'avatar, rédiger des messages hors-ligne et les envoyer à la reconnexion, support des messages directs dans les salons ("chuchoter"), et bien d'autres modifications et corrections. Merci de consulter le journal des modifications intégral pour tous les détails !

    Fluux Messenger: messages directs dans les salons

    • Gajim a publié sa version 2.4.7 de son application de chat XMPP gratuite et bourrée de fonctionnalités. Cette publication supporte le chiffrement OpenPGP moderne, les messages brouillons sont désormais persistants, ce qui signifie qu'après avoir redémarré Gajim, vous pouvez poursuivre là où vous vous êtes arrêté, les salons de discussion sont désormais nommés selon leurs participants si pas d'autre nom n'est donné, désactiver un compte lors de la connexion est désormais corrigé, et elle vient également avec de nombreuses petites améliorations et corrections de bugs. Merci pour toutes vos contributions !

    Gajim: Un message vous mentionnant

    • Movim a publié ses versions 0.34, nom de code "Meier", et 0.34.1! Ces nouveaux jalons Movim stabilisent le travail important réalisé dans les précédentes publications tout en introduisant une nouvelle expérience redesignée pour les appels de groupe (conférences). Dans cette version vous pouvez ajouter des salons dédiés à des appels de groupe dans vos Espaces ("Spaces") et explorer la nouvelle interface d'appel vidéo. Les appels en conférence, reconstruit depuis zéro, la renégotiation média, nouvel agencement et interface redesignée, nouveaux sons de notification, gestion de session, d'autres corrections et plus encore !

    Movim : Conférence dans les Espaces ("Spaces")

    • Profanity a publié la version 0.18.2 de son client XMPP console. Cette publication apporte des corrections de bugs pour conserver l'écriture dans le terminal lors du passage en veille, éviter l'échange des OTR de révéler votre présence à des inconnus, et rendre muet l'erreur 'no key' pour les messages de transport de clé. Merci de consulter le journal des modifications pour tous les détails !

    Serveurs XMPP

    La communauté Ignite Realtime est heureuse d'annoncer la sortie d'Openfire 5.1.0. Quelques points forts de cette version : l'établissement de connexion via SASL (avec un généreux soutien de la Fondation NLnet), une série de durcissements concernant le chiffrement, la correction d'un bug de complexité O(n²) qui provoquait des démarrages de 2 heures sur de gros déploiements (seulement quelques secondes maintenant), Java 25, le nouveau support officiel de MariaDB, Firebird et CockroachDB. Vous pouvez lire le journal des changements complet pour avoir tous les détails !

    Bibliothèques et outils XMPP

    Extensions et spécifications

    La XMPP Standards Foundation développe des extensions à XMPP dans sa série de XEP en plus des RFC XMPP. Des développeuses, développeurs et autres personnes expertes en normes du monde entier collaborent à ces extensions, élaborant de nouvelles spécifications pour les pratiques émergentes et affinant les méthodes existantes. Proposées par n'importe qui, celles qui remportent le plus de succès finissent par être classées comme finales ou actives, selon leur type, tandis que les autres sont soigneusement archivées comme différées. Ce cycle de vie est décrit dans la XEP-0001, qui contient les définitions formelles et canoniques des types, des états et des processus. Vous pouvez en savoir plus sur le processus de normalisation ici. La communication autour des normes et des extensions se fait via la liste de diffusion des normes (archives en ligne).

    Extensions proposées

    Le processus de développement d'une XEP commence par la rédaction d'une idée et sa soumission à l'éditeur XMPP. Dans un délai de deux semaines, le Conseil décide d'accepter ou non cette proposition en tant que XEP expérimentale.

    • Jingle User Location
      • Cette spécification définit une extension de l'application Jingle pour échanger et mettre à jour la position de l'utilisateur dans une session Jingle active en utilisant la XEP-0080 User Location payload.
    • XMPP Decentralized ID (XID)
      • L'ID XMPP décentralisé (XID) est un identifiant d'entité XPMM indépendant de DNS. Cette spécification décrit comment générer, utiliser et gérer celui-ci.
    • Jingle Synchronized Real-Time Text
      • Cette spécification définit l'extension d'une application Jingle pour la négociation temps réel du texte à l'intérieur de la même session de conversation que l'audio et la vidéo.

    Nouvelles extensions

    • Version 0.1.0 de XEP-0514 (Balisage d'Emojis)
      • Acceptée comme Expérimentale par vote du conseil le 12 mai 2026 (XEP Editor(dg))
    • Version 0.1.0 de XEP-0515 (Protection contre la Dégradation de Connexion TLS)
      • Acceptée comme Expérimentale par vote du conseil (XEP Editor (dg))
    • Version 0.1.0 de XEP-0516 (Identifiant XMPP Décentralisé (XID))
      • Acceptée comme Expérimentale par vote du conseil (XEP Editor (dg))
    • Version 0.1.0 de XEP-0517 (Texte Synchronisé en Temps-Réel dans Jingle)
      • Acceptée comme Expérimentale par vote du conseil (XEP Editor (dg))

    Extensions déférées

    Si une XEP expérimentale n’est pas mise à jour pendant plus de douze mois, elle sera retirée de la catégorie Expérimentale pour être classée comme Déférée. Si une mise à jour intervient, la XEP sera replacée dans la catégorie Expérimentale.

    • Pas de XEP déférée ce mois-ci.

    Extensions mises à jour

    • Version 1.35.5 de XEP-0045 (Discussions multi-utilisateurs)

      • Correction de l'attribut from dans les examples où le salon lui-même envoie un message
      • Corrige le champ du nom du noeud pubsub associé dans l'exemple d'information de découverte
    • Version 0.5.0 de XEP-0420 (Stanza Content Encryption)

      • L'affixe de temps utilise le profile DateTime de XEP-0082
      • Les rpads longs NE DOIVENT PAS être rejetés
      • Ajout d'une taille cible minimum pour le complèment aléatoire pour renforcer la résistance face à des attaques par corrélation dans le cas de contenus courts et un rpad de longueur nulle.
      • Retrait de Implementation inutile
      • Avertissement concernant l'injection de stanzas déchiffrés
      • Clarifie la solution de repli pour le body
      • Corrige les descriptions pour s'appliquer à toutes les stanzas au lieu de seulement les messages
      • Retire le DOIT ambigu dans l'affixe de temps et clarifie la vérification des affixes
      • Exige du registrar de fournir une liste d'éléments exclusivement processé coté serveur
      • Liste les XEP dépendantes
      • Ajoute le schéma XML (syndace)
    • Version 0.1.1 de XEP-0514 (Emoji Markup)

      • Retrait des références obsolètes à BoB (techmetx11)

    Dernier appel

    Les derniers appels sont lancés une fois que tout le monde semble satisfait de l'état actuel d'une XEP. Une fois que le Conseil a décidé que la XEP semble prête, l'Éditeur XMPP émet un dernier appel pour recueillir des commentaires. Les commentaires recueillis lors du dernier appel peuvent aider à améliorer la XEP avant de le renvoyer au Conseil pour qu'il passe à l'état Stable.

    • Pas de dernier appel de XEP ce mois-ci.

    Extensions stables

    • Pas de XEP passant à stable ce mois.

    Extensions dépréciées

    • Pas de XEP dépréciée ce mois.

    Extensions rejetées

    • Pas de XEP rejetée ce mois.

    Partagez les nouvelles

    Veuillez partager cette nouvelle sur d'autres réseaux :

    Consultez également notre flux RSS !

    Vous recherchez des offres d'emploi ou souhaitez engager un consultant professionnel pour votre projet XMPP ? Consultez notre tableau d'affichage des offres d'emploi XMPP.

    Contributions et traductions de la lettre d'information

    Il s'agit d'un effort communautaire, et nous tenons à remercier les traductrices et traducteurs pour leur contribution.
    Les bénévoles et les nouvelles langues sont les bienvenues !
    Les traductions de la lettre d'information XMPP seront publiées ici (avec un certain retard) :

    Contributions à la lettre d'information de ce mois-ci : emus, cal0pteryx, Gonzalo Raúl Nemmi, Ludovic Bocquet, anubis, Badri (badrihippo), XSF iTeam

    Contributions à la traduction :

    • Français : Adrien Bourmault (neox), anubis, seveso, impromptux, Blacknight
    • Italien : Mario Sabatino, Roberto Resoli
    • Portugais : Paulo

    Aidez-nous à créer la lettre d'information

    Cette lettre d'information XMPP est produite en collaboration avec la communauté XMPP. Chaque numéro mensuel est rédigé dans ce simple pad. À la fin de chaque mois, le contenu du pad est fusionné dans le dépôt GitHub de la XSF. Nous sommes toujours ravis d'accueillir de nouvelles personnes contributrices. N'hésitez pas à rejoindre la discussion dans notre groupe de discussion Comm-Team (MUC) et à nous aider ainsi à poursuivre cet effort communautaire. Vous avez un projet et souhaitez le faire connaître ? N'hésitez pas à partager vos actualités ou événements ici, et à les promouvoir auprès d'un large public.

    Tâches que nous effectuons régulièrement :

    • collecte d'actualités dans l'univers XMPP
    • résumés courts d'actualités et d'événements
    • résumé de la communication mensuelle sur les extensions (XEP)
    • révision du projet de lettre d'information
    • préparation d'images pour les médias
    • traductions
    • communication via les comptes des médias

    Licence

    Cette lettre d'information est publiée sous licence CC BY-SA.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Éditer de la littérature libre : les Éditions du Renard Spatial

    J’aime le logiciel libre. J’aime la littérature. Alors, un jour, je me suis demandé s’il était possible d’éditer de la littérature libre.
    Les premiers essais ont eu lieu au début de l’été 2020, le covid laissait le temps libre à des expérimentations.

    Six ans plus tard, les Éditions du Renard Spatial existent, éditent des littératures de l’imaginaire libres, et viennent de publier « Ça ne peut pas être pire qu’ici » par Lisa Refur (une amie), un roman court de fantasy/apprentissage, au format papier.
    C’est l’aboutissement d’une aventure que je vais vous raconter ici.

    Couverture du livre « Ça ne peut pas être pire qu’ici », de Lisa Refur, aux Éditions du Renard Spatial

    Sommaire

    L’art libre, une discipline très différente du logiciel libre

    On parle assez peu d’art libre, que ce soit sur LinuxFR.org ou ailleurs (il n’y a même pas de catégorie dédiée !) ; on peut même considérer que le sujet est ignoré, y compris des personnes qui baignent dans le logiciel libre depuis des décennies. C’est que l’art libre et le logiciel libre sont différents sur beaucoup d’aspects, y compris des points fondamentaux. On pourrait disserter longtemps sur ce point, mais ça n’est pas le sujet ; je vais plutôt me concentrer sur quatre points qui sont utiles à comprendre pour la suite.

    Le premier, c’est que la personne qui développe un logiciel développe d’abord un outil.
    D’accord, elle peut y tenir énormément, avoir une vision forte ; mais l’implication personnelle reste beaucoup moins forte que celle d’un·e auteur·ice dans son œuvre artistique. Les créateur·ices de logiciels libres acceptent donc beaucoup plus facilement la réappropriation et la modification de leur production ; au contraire des artistes qui ont tendance à vouloir conserver le contrôle sur des œuvres qui peuvent être très personnelles.

    Le second, c’est que mis à part quelques exceptions comme le cinéma, beaucoup d’arts sont profondément solitaires ou se pratiquent en tout petit comité, là où le développement logiciel est généralement un travail d’équipe. Les notions de partage, d’amélioration mutuelle sont beaucoup plus fréquents dans le développement logiciel que dans l’art.

    Le troisième, c’est que la réutilisation d’éléments – la réutilisation directe, au contraire de l’inspiration – est infiniment plus fréquente dans le développement logiciel que dans l’art.
    Tous les logiciels ou presque réutilisent du code, via des bibliothèques, des API, des ABI, ou directement. Au contraire, la réutilisation directe en art est rare, hors quelques cas précis, et souvent mal vue.

    Le quatrième et le plus important, c’est l’argent, la thune, le fric, la moula.
    Les développeurs informatiques sont généralement bien, voire très bien payés, même avec les changements introduits par les IAs génératives. Au contraire, rares sont les artistes qui peuvent vivre de leur art ; celles et ceux qui peuvent en vivre décemment sont encore plus rares.

    Les trois premiers points expliquent pourquoi la notion de « Liberté » (dans le sens de l’expression « art libre ») est moins importante pour les artistes que pour les développeurs et développeuses de logiciels. Le dernier explique pourquoi les artistes ont une énorme difficulté matérielle à contribuer à de l’art libre, quand bien même ils et elles en auraient envie ; parce que pour offrir de son temps, ou trouver un modèle de financement compatible avec l’art libre, il faut d’abord pouvoir manger à sa faim.

    Mais cette longue digression introductive ne nous apprend toujours rien sur le sujet d’origine !

    Le projet des Éditions du Renard Spatial

    Dès le début, mon projet était clair : je voulais éditer de la littérature libre, et pas n’importe comment.

    La direction éditoriale

    Tout éditeur a besoin d’une direction éditoriale, pour que les client·es ne soient pas perdu·es. Quel sens ça aurait d’éditer en vrac des livres de cuisine, des polars, des livres sur l’informatique et des albums photo ?

    Je lis principalement des littératures de l’imaginaire – science-fiction, fantasy, fantastique, le tout pris au sens large. C’est pour cela que les Éditions du Renard Spatial éditent des littératures de l’imaginaire. J’ai aussi décidé de partir sur des formats courts : on trouve beaucoup de sagas et œuvres à rallonge dans ces univers ; mais j’aime bien lire des histoires percutantes et efficaces. En prime, c’est plus rapide à éditer (je n’ai pas écrit « plus facile »).

    De la littérature libre

    Je veux dire : vraiment libre ; donc sous des licences qui respectent les quatre libertés habituelles (même si on peut se poser la question de savoir ce qu’est le « code source » d’un texte si ce n’est le texte lui-même). J’ai donc choisi de partir, par défaut, sur les licences Creative Commons, qui ont le bon gout d’être adaptées à ce genre de projet et connues. Je me limite aux licences libres, ce qui exclut les clauses -NC et -ND, qui en font des licences « de libre diffusion ».

    Ça a été l’occasion de se poser sérieusement la question de l’intérêt de licences libres appliquées à la littérature. J’en vois deux assez immédiats.

    Le premier, c’est la diffusion de l’œuvre.
    Une œuvre, une fois publiée, va circuler, qu’on le veuille ou non. Elle sera « piratée », que l’éditeur ait protégé son œuvre ou non ; d’ailleurs, saviez-vous que beaucoup de fuites de livres sur les sites de partage illégaux proviennent de sources internes à la chaine du livre ? C’est un point d’autant plus important pour moi que je veux que les textes que je publie, vivent, même si ma maison d’édition doit disparaitre.

    Le second, c’est le fandom de l’œuvre.
    Si une œuvre plait, alors il va se créer tout un tas d’œuvre dérivées – que l’auteur·ice et l’éditeur·ice le veuillent ou non – à base de fanfictions, de dessins, et j’en passe. Aujourd’hui tout ça existe sans aucun cadre légal, et les licences libres permettent de créer ce cadre.

    De la littérature pour tout le monde

    La culture, c’est vite cher, et je refuse la position d’une culture réservée à une élite.

    Les livres que j’édite sont donc les moins chers possibles, dans la limite du raisonnable. Ça implique que les livres papier sont d’office des formats « poche » – 11 x 18 cm – et que les livres électroniques sont sensiblement moins chers que les versions imprimées.

    En bonus, ça m’arrange parce que je n’ai jamais aimé les grands formats. Alors, c’est joli dans une bibliothèque et ça fait un bel objet à offrir – et, soyons honnêtes, à revendre – mais en ce qui concerne la fonction livre, je trouve ça nul, parce qu’un grand format, c’est encombrant, c’est lourd, c’est pénible à transporter (et je lis souvent dans les transports) ou même à tenir quand on est vautré dans un canapé.

    Un vrai éditeur, pas un éditeur-Amazon

    Je voulais que les livres des Éditions du Renard Spatial soient de « vrais » livres, que l’on peut acheter dans n’importe quelle librairie, avec un ISBN, un référencement qui va bien, et tout. L’idée du livre qui existe, mais qui ne peut être acheté que sur le site du vendeur, ou en ligne chez un seul libraire – en général Amazon – me gonfle.

    C’est sans doute parce que j’aime beaucoup mes libraires (qui sont d’excellent conseil). En prime, ça m’évite d’avoir à gérer toute la logistique, le stockage, les factures individuelles, l’envoi de commandes… tout ce que je déteste.

    De tous mes choix, c’est – de loin – celui qui m’a le plus cassé les pieds.

    Production locale et raisonnée

    Faire imprimer des livres en Chine pour les vendre principalement en France me semble absurde ; donc l’idée de base était de trouver un imprimeur en France, ou à défaut quelque part dans l’UE.

    D’autre part, la chaine du livre repose beaucoup sur une notion de stock qui voyage. En très résumé, l’imprimeur imprime un tas de livre, qui est en partie stocké, en partie envoyé aux libraires, qui vendent ce qu’ils peuvent et qui – chose exceptionnelle dans le monde de la vente – renvoient les exemplaires invendus… qui finissent au pilon s’ils ne se vendent pas pendant un peu trop longtemps (ou sont trop abimés à cause des voyages), parce que le stockage, ça coute cher. Donc, si je peux éviter de faire imprimer des livres pour les stocker et finir par les détruire, ça m’arrange, parce que tout ça c’est une perte sèche.

    Le difficile problème des couvertures

    Pour commencer, une illustration de couverture, c’est un budget important pour une petite structure, surtout en refusant l’usage d’IA générative (ah oui, il y a la question de l’IA générative qui est venue s’inviter au milieu du projet).

    Alors, j’ai réfléchi. Le premier intérêt d’une couverture, c’est d’attirer l’œil, d’être facile à repérer dans un magasin ou sur un site, au milieu de beaucoup d’autres.
    Autre chose : les livres que j’ai achetés à leur couverture se comptent sur un doigt d’une main ; quant aux couvertures que je suis capables de décrire sans aller les vérifier, il y en a très peu, la plupart d’entre elles sont sobres – et à l’exception de celle déjà nommée, aucune d’elle n’a été un critère d’achat. Inversement, beaucoup de littératures de l’imaginaire ont des couvertures illustrées, avec une typographie soignée, mais à cause des effets de mode, elles ont tendance à toutes se ressembler, ce qui fait qu’aucune ne se repère facilement dans la masse.

    La solution s’est imposée d’elle-même : je peux me contenter de couvertures sobres, très lisibles, très faciles à reconnaitres, avec une harmonie dans la collection.

    Le temps et l’énergie que je peux y consacrer

    Ce projet n’est pas mon activité principale, et je n’ai pas pour projet d’en vivre.

    L’avantage, c’est que ça me libère d’une contrainte financière extrêmement forte – rares sont les petites maisons d’édition rentables.

    L’inconvénient, c’est que ça m’empêche de faire du volume, ce qui n’aide ni pour la reconnaissance, ni pour la publicité, ni pour les revenus.

    Profils d’auteur·ices cible

    Un tout petit éditeur, avec des conditions d’édition étranges (de l’art libre, des formats qui rapportent moins à l’unité), qui est-ce que ça va intéresser ?
    C’est une vraie question.

    Ma réponse, c’est : le même genre de profil que celui intéressé par le logiciel libre, mais dans le monde de la littérature.

    Concrètement, c’est un·e auteur·ice qui écrit pour le plaisir, en loisir, et donc n’a pas besoin de ce revenu pour vivre.

    Je vais être très clair sur un point : je paie mes auteur·ices, et il n’a jamais été question de ne pas le faire. Simplement, je ne peux pas me permettre d’avance sur droits ni promettre des ventes faramineuses, cf. le point précédent.

    Ainsi donc, après une première publication-test sur l’un de mes textes, j’ai convaincu une amie, Lisa, de se lancer dans l’aventure avec moi…

    Créer les Éditions du Renard Spatial, de façon légale et complète

    À ce stade – en réalité, avant la dernière ligne du paragraphe précédent, j’ai toute la vision cible, il n'y a plus qu’à passer à la réalisaton !

    D’abord, une entreprise

    La France propose le système de « microentreprises » ou « autoentrepreneurs », un système légal qui est censé permettre à tout le monde de se créer facilement une entreprise pour se créer un complément de revenu, et qui correspond bien à mon projet.

    Le mot-clé est « facilement ». Eh ben, si ça, c'est facile, je veux même pas imaginer la prise de tête que ça doit être de créer une entreprise « normale », même unipersonnelle. Je passe les détails – déjà parce que ça fait six ans donc ça a pu changer –, mais au cas où, sachez tout de même que :

    1. Une autoentreprise peut avoir un nom commercial, mais le nom réel, celui enregistré au SIREN, est impérativement votre identité réelle. Il y a bien une option qui permet de masquer ces informations personnelles – la base SIREN étant publique –, mais tous les systèmes d’interconnexion informatique dont vous allez avoir besoin partent du principe que cette information est disponible dans les données publiques. Donc, impossible d’activer la confidentialité tant que toute la paperasserie n’est pas terminée.
    2. En théorie, un compte bancaire séparé suffit, pas besoin d’avoir un compte bancaire professionnel ; donc on peut utiliser un compte personnel gratuit. En pratique, le site des impôts impose un IBAN professionnel… et toutes les banques ont bidouillé leurs règles commerciales pour limiter l’émission d’IBAN professionnels aux seuls comptes professionnels payants.
    3. Et, à partir de septembre 2026, il faut aussi un système de facture électronique.

    OK, l’entreprise et ses dépendants (la banque, l’inscription au RCS via le Tribunal de Commerce, les impôts, l’URSSAF…), c’est fait.
    Et ensuite ?

    Éditer c’est vendre, et vendre c’est communiquer

    Avant toute chose : déposer sa marque à l’INPI. C’est pas gratuit, mais ça évite les abus un peu trop faciles.

    Il me faut donc des outils de communication. Ça passe par divers comptes sur les réseaux, pour communiquer avec les gens là où ils sont, même si ça ne m’enchante pas. Je décide de ratisser large : BlueSky, Instagram, Discord, LinkedIn, Facebook, et même à l’époque un compte Twitter qui a été abandonné. Je n’ai pas de compte Mastodon parce qu’il faut d’abord que je trouve une instance adaptée à ce genre de projet ; je prends les conseils.

    Puis, un site web ; et là, j’ai un gros avantage : je peux le créer et l’héberger moi-même.
    C’est un site 100 % statique créé avec Hugo, sobre (sans JS ni framework CSS) et disponible ici : https://renardspatial.com/. J’y ai tenté des trucs d’un point de vue design – et je ne suis pas du tout designer. Mais je cherchais quelque chose d’un peu original, qu’on a pas l’impression d’avoir déjà vu partout, et qui soit utilisable sur mobile (ça reste la majorité des utilisateurs). Là aussi, je prends les retours (seulement les constructifs). Les polices d’écriture sont celles utilisées pour les livres et, bien évidemment, sont libres.

    Un livre doit avoir un ISBN

    L’ISBN (pour « International Standard Book Number ») c’est un numéro d’identification unique pour chaque livre dans le monde depuis les années 1980.

    C’est la partie facile : pour une modique somme, l’AFNIL en fournit très largement assez pour des années, il suffit juste d’un peu de patience. Les numéros sont fournis sous la forme d’une liste, à l’éditeur de les attribuer à chaque ouvrage ; la version numérique et la version papier ne comptant que pour un que s’ils sont strictement identiques.

    Ouf ! J’ai enfin toute la structure et tout le nécessaire pour que l’entreprise fonctionne ; maintenant, je peux enfin commencer à éditer !

    Créer de la littérature libre… avec des logiciels libres ?

    Éditer le texte lui-même

    Pour l’instant, c’est la partie facile : mon amie Lisa – seule autrice tierce pour l’instant – et moi utilisons LibreOffice, dont le système de commentaires fait l’affaire. D’autre part, on se voit souvent en vrai, ce qui simplifie beaucoup le travail.

    L’outil de PAO

    La PAO, c’est la Pagination Assistée par Ordinateur, ce qui permet à l’ouvrage – livre, magasine, etc. – d’avoir une mise en page correcte.

    Un fait peu connu du grand public : un logiciel de traitement de texte est incapable de faire une mise en page correcte, et j’entends par là d’avoir une qualité professionnelle, notamment en ce qui concerne la typographie. Un LibreOffice Writer – ou même un Microsoft Word – ne gèrent pas les alignements sur grilles, ont des options de césure, de lignes veuves et orphelines très réduites, ne gèrent pas les ligatures de manière fine, n’ont pas d’option pour activer (et encore moins paramétrer) l’alignement visuel, et j’en passe. Or, j’ai envie d’avoir une mise en page correcte, même si certains gros éditeurs, eux, ont décidé de s’en passer.

    Le logiciel libre le plus connu pour ce faire, c’est LaTeX. Il est excellent sur la typographie, et… atroce sur le reste. Pour moi ça n’est pas un choix acceptable, il ne correspond tout simplement pas à ma façon de travailler (et, si vous êtes aficionados de LaTeX, pas la peine de venir le défendre en commentaires, je le connais depuis plus de 20 ans).

    Le choix suivant, c’est Scribus. Donc je l’installe, l’essaie, l’essaie encore, l’essaie toujours ; et après beaucoup trop longtemps, je n’arrive toujours pas à faire le quart de ce que je veux avec. (Il semblerait que le logiciel se soit beaucoup amélioré depuis, il faudra que je réessaie).

    La solution que je trouve n’est hélas pas libre et à l’époque elle n’était même pas gratuite, bien qu’infiniment moins chère que les mastodontes du genre. C’est Affinity Publisher ; et en une après-midi, j’ai une maquette qui est à 90 % ce que je veux, couverture comprise, donc je décide d’être pragmatique et de partir sur ce logiciel.

    Créer les fichiers pour l’impression

    C’est facile : tous les imprimeurs prennent des fichiers PDF (et indiquent la version exacte qu’ils attendent), donc en suivant les instructions, il ne devrait pas y avoir de surprise. Et de fait, j’en ai pas eu.

    Créer les livres électroniques

    Mon diffuseur (je reviendrai sur son rôle dans la section suivante) me dit que je peux me contenter de fournir un EPUB et un PDF, et qu’il transforme lui-même le livre aux éventuels autres formats, dont l’infâme Kindle.

    Le PDF, c’est facile, j’ai déjà. Mais l’EPUB ? Je découvre trois choses :

    1. Un livre électronique au format EPUB, c’est juste un fichier ZIP renommé avec le texte au format XHTML (oui !), un fichier de styles CSS (qui sera largement ignoré par le logiciel de lecture…) et une poignée de métadonnées, en général du XML (parfois renommé).
    2. Malgré ça, personne ne semble savoir générer un EPUB correct. La plupart des logiciels et convertisseurs que j’essaie me génèrent une soupe de balises sans aucun sens ; d’ailleurs la plupart de ceux que j’ai sur ma liseuse ont des problèmes plus ou moins graves à l’usage.
    3. Le format EPUB semble être plus une vague indication qu’une norme, et les différentes liseuses et logiciels de lecture ont tous des interprétations, disons créatives de comment ce format doit être rendu.

    Donc, je finis par décider de le générer à la main ; et en fait, c’est facile : en une journée, j’ai un fichier tout à fait valide qui passe bien sur ma liseuse physique, et sur diverses liseuses logicielles sur PC et smartphone. Mon seul échec, c’est la page de faux-titre qui n’est pas stylisée correctement. Il y avait un seul piège : les fichiers ZIP définissent l’ordre dans lequel sont stockés les fichiers, et le format EPUB attend un ordre précis qui doit être respecté (mimetype, puis META-INF/*, puis OEBPS/*). Il semblerait que les versions récentes de LibreOffice produisent un résultat correct, il faut que je réessaie.

    Et donc maintenant, j’ai des livres qui contiennent de la littérature libre, qu’il me faut vendre.

    Vendre de la littérature libre

    Parce que si je parle de littérature libre depuis le début, je n’ai jamais parlé de littérature gratuite, et pour cause : mon but est bien de vendre cette littérature, même libre, ne serait-ce que parce qu’il faut bien que je paie les intermédiaires. Justement, parlons-en.

    La chaine du livre

    Le processus de création d’un livre implique tout ce petit monde :

    1. L’auteur·ice, qui écrit le livre.
    2. L’éditeur – ici moi-même, au nom des Éditions du Renard Spatial – qui édite le livre, et qui peut faire appel à :
      1. Une correctrice, qui s’assure qu’il ne reste pas de fautes d’orthographe et de grammaire ; et croyez-moi la langue française aurait bien besoin d’une simplification. Une grosse.
      2. Une graphiste, pour la couverture, les éléments de communication, etc.
      3. Un maquettiste, pour la mise en page.
      4. … et j’en passe, surtout dans les grands groupes (notamment le directeur de collection).
    3. L’imprimeur, qui, ben, imprime le livre.
    4. Le distributeur, qui assure la logistique, c’est-à-dire de stocker les livres imprimés et les envoyer aux libraires.
    5. Le diffuseur, qui va assurer la promotion des livres auprès des libraires et s’assurer de leur présence.
    6. La libraire, qui va vendre le livre.

    Sachant que dans la liste principale, seul l’imprimeur travaille à tarif fixe ; tous les autres se rémunèrent au pourcentage du prix de vente final… et donc vont sans doute refuser les partenariats vus comme non rentables. Comme, par exemple, travailler avec un petit éditeur qui vend des livres pas chers, libres, et qui ne fait même pas ça à plein temps.

    Pour l’instant, coté édition, je fais tout moi-même. Si jamais un jour, j'ai les moyens (je compte sur vous !), j’investirai d’abord dans une correction professionnelle.

    Vendre des livres électroniques

    Trouver un distributeur de livres électroniques, c’était facile ; et très vite, j’ai eu une nouvelle à mon pseudo disponible sur à peu près toutes les plateformes.
    On a donc travaillé un premier livre avec mon amie Lisa, on l’a réalisé, vendu partout où on peut acheter un livre électronique, et on a découvert la triste vérité :

    Les livres électroniques, ça n’intéresse personne.

    C’était le plus beau « Vu et s’en tape » de toute notre vie. En fait, sans version papier, c’est comme si le livre n’existait même pas.

    Mais il y a un problème…

    Vendre des livres papier

    Vous vous rappelez quand, plus haut, j’écrivais que j’avais créé l’entreprise en 2020 ? Eh bien, le covid avait mis un grand bazar dans le monde de l’impression, et les prix du papier s’étaient envolés.

    Ça s’est ensuite calmé. Quelques semaines. Après quoi, la Russie a déclaré la guerre à l’Ukraine, grande fournisseuse européenne de bois et de papier, donc re-crise, retour des prix absurdes, priorité absolue aux clients de longue date, etc. (j’ai même quelques mangas de cette époque qui sont visiblement imprimés sur du papier machine, le même qu’on utilise dans nos imprimantes !)

    Quand c’est de nouveau revenu à une certaine normale, j’ai cherché imprimeurs, distributeurs et diffuseurs. L’imprimeur, c’est facile, tous les imprimeurs de France et de Navarre veulent bien faire des livres de poche. Facile, pour eux, on paie un tarif fixe par livre et ça leur va bien. Le distributeur et le diffuseur, c’est beaucoup plus compliqué. Ce que je veux faire, c’est pas assez cher, y’a pas assez de volume, j’ai pas assez de poids dans un marché déjà saturé.

    Alors, je me suis dirigé vers l’impression à la demande, qui finalement a beaucoup d’avantages pour une structure comme la mienne ; et on en trouve qui cumulent prix correct, bonne réputation, et qui impriment dans l’Union Européenne. En particulier, on peut avoir de l’impression à la demande qui est référencée sur Dilicom et Electre, donc commendable en libraire, ce dont je n’étais pas sûr à l’origine.

    Encore un peu de paperasse, puis davantage de paperasse (notamment pour faire corriger une erreur d’attribution d’éditeur), et un envoi au dépôt légal, et enfin – enfin ! – on est en juillet 2026 on a une version papier de notre premier livre !

    « Ça ne peut pas être pire qu’ici »

    Couverture du livre

    « Ça ne peut pas être pire qu’ici » est une novella (à mi-chemin entre une nouvelle et un roman) de fantasy et d’apprentissage de Lisa Refur, publié sous licence CC-BY 4.0 dont voici la quatrième de couverture :

    Cette ligne de chemin de fer apparue par magie agit comme un déclencheur dans l’esprit des adolescents désœuvrés. Et s’il existait un monde au-delà de cette ville de banlieue décrépite ? Qu’est-ce qui interdit aux quatre amis de quitter Villeneuve ? Rien, en fait. C’est le début de l’aventure pour Ajax, Dro, Biénale et Zef ; l’abandon d’une cité cité sans avenir, la quête d’une vie meilleure. Mais pour aller où ? Suivre la ligne ? D’où vient-elle, et où va-t-elle ? Est-ce mieux ailleurs ?

    La seule solution qu’ont les jeunes gens pour le découvrir : prendre la route, se confronter à ses difficultés, ses joies et ses peines, dans l’espoir que la destination soit bonne.

    Il est disponible pour 6,99 € au format papier (11 x 18 cm, 84 pages, demandez l’ISBN 9782492575037 à votre libraire préféré) ; et pour 2,99 € au format électronique, sans DRM quand la librairie le permet, cherchez l’ISBN 9782492575013.

    Éditer de la littérature libre : premier point d’étape

    Le premier enseignement que j’en tire, c’est celui-ci : tout le monde s’en cogne.

    Le sujet n’intéresse personne, en bien comme en mal : je n’ai eu aucune remarque sur le sujet. Les textes, le site, les couvertures ont généré beaucoup plus de commentaires. D’un côté, c’est un peu triste ; d’un autre ça n’a pas déclenché de rejet, et c’était le point que je craignais le plus dans cette expérience. Je croise les doigts.

    La conclusion que j’en tire pour l’instant, c’est la suivante : pour l’instant, publier de la littérature sous licence libre ne m’a rien apporté directement, et c’était attendu : l’intérêt du libre, c’est d’abord pour les personnes qui utilisent plus que pour celles qui produisent, surtout dans un domaine où la création collaborative est minoritaire.

    Mais surtout, publier de la littérature libre ne m’a pas handicapé, donc je n’ai aucune raison d’arrêter de le faire, et par conséquent, je vais continuer !

    Et maintenant ?

    Les Éditions du Renard Spatial vont continuer à publier des littératures de l’imaginaire libres.

    Le prochain livre ne devrait pas attendre trois ans de plus, puisqu’on a un projet de recueil de nouvelles en cours avec Lisa. Si tout va bien, il devrait sortir quelque part entre cet automne et cet hiver – j’ai arrêté de croire à une date précise tant que tout n’est pas terminé.

    Mais surtout, les soumissions sont maintenant ouvertes ! Si vous êtes intéressé·es, pouvez vous proposer votre projet en suivant la procédure détaillée ici. Attention ! Il ne s’agit pas d’envoyer un texte complet avec à peine un bonjour (j’en ai déjà eu !).

    J’avais imaginé terminer par une sorte de FAQ, mais cette dépêche est déjà extrêmemement longue, donc je vous propose de lire celle du site, et de me poser toute question restante en commentaires.

    Merci de m’avoir lu !

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    G’MIC 4.0 : La quadrature du pixel, plus facile que jamais !

    Dix-huit ans après ses débuts, G’MIC, cadriciel libre pour le traitement des images numériques, franchit une étape importante avec la sortie d'une nouvelle version majeure, numérotée 4.0, la version de la maturité !

    L'occasion, comme chaque année, de faire le point sur les évolutions récentes de ce projet, depuis notre dernière dépêche publiée en août 2025.

    G´MIC 4.0 Teaser

    N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images contiennent l’icône Icône 'Play Video'

    Sommaire

    1. G’MIC : Un cadriciel libre pour l'image numérique

    Le projet G'MIC (GREYC's Magic for Image Computing) est né en juillet 2008, et a grandi au sein de l'équipe IMAGE du laboratoire GREYC de Caen (Unité Mixte de Recherche placée sous la triple tutelle du CNRS, de l'ENSICAEN et de l'Université de Caen).

    Sa vocation : offrir un cadriciel libre, ouvert et extensible pour la manipulation, le traitement et la création d'images numériques. Pour ce faire, il s'appuie sur les fonctionnalités de la bibliothèque libre C++ de traitement d'images CImg, développée depuis 1999 d'abord au sein de l'INRIA, puis de l'équipe IMAGE du GREYC (également par votre serviteur).

    Au cœur du projet se trouve un interpréteur de langage de script dédié, le « langage G'MIC », spécialement conçu pour prototyper rapidement de nouveaux algorithmes de traitement d'images, et les enchaîner au sein de pipelines (ou filtres) personnalisés. Autour de ce noyau viennent se greffer plusieurs interfaces, donnant à l'utilisateur accès à des centaines d'opérateurs de traitement d'images prédéfinis, comme par exemple l'outil en ligne de commande gmic ; le service Web G'MIC Online ; et le greffon G'MIC-Qt, qu'il est possible d'intégrer dans plusieurs logiciels de création et d'édition d'images, tels que GIMP, Krita, digiKam, Paint.net, Adobe Photoshop ou Affinity Photo. C'est aujourd'hui ce greffon qui est l'interface du projet la plus utilisée, avec plus de 1200 téléchargements quotidiens, en progression depuis un an. Il propose plus de 640 filtres variés pour triturer vos images et enrichir les possibilités des logiciels de retouche, et semble particulièrement apprécié des artistes numériques.

    Cette version majeure 4.0 marque un tournant dans la vie du projet : la syntaxe du langage G'MIC, le code de l'interpréteur et des algorithmes de traitement d'images associés sont maintenant éprouvés. Nous souhaitons donc ralentir un peu le rythme des nouvelles releases et de l'ajout de nouvelles fonctionnalités, pour nous concentrer sur la stabilité, la robustesse, et les performances du cadriciel.

    Aperçu du greffon G'MIC-Qt Fig. 1.1. Aperçu de quelques-unes des interfaces proposées par le projet G'MIC : Greffon G'MIC-Qt pour GIMP (en haut à gauche), Outil CLI gmic (en haut à droite), Service web G'MIC Online (en bas).

    2. Nouveaux filtres du greffon G'MIC-Qt

    Côté greffon G'MIC-Qt, l'essentiel des nouveautés se concentre sur l'apparition de nouveaux filtres de traitement d'images. La version 4.0 porte leur nombre à 644, tous accessibles directement depuis l'interface graphique. Je liste ci-dessous les derniers filtres ajoutés.

    2.1. Filtre « Rendering / Pixel Stretch »

    Le filtre « Rendering / Pixel Stretch » permet de sélectionner une « bande de pixels », et la duplique dans l'image en lui faisant suivre une trajectoire personnalisable, définie par deux courbes splines (une pour chaque bord de la bande).

    Filtre 'Rendering/Pixel Stretch' (G'MIC-Qt) Fig. 2.1.1. Le filtre « Rendering / Pixel Stretch » tel qu'il apparait dans le greffon G'MIC-Qt.

    Filtre 'Rendering/Pixel Stretch' (rendu 1) Fig. 2.1.2. Exemple de rendu du filtre « Rendering / Pixel Stretch », ici avec deux traînées de pixels ajoutées par le filtre.

    Cet effet donne l'impression que l'image a été étirée localement, un peu comme une pâte élastique. Il peut servir à suggèrer ou styliser un mouvement dans une image, comme sur l'exemple ci-dessous (extrait de la vidéo tutorielle que Miguel Pineau a spécialement dédiée à ce filtre).
    On peut également imaginer son utilisation pour du Glitch art ou de la création de textures abstraites.

    Filtre 'Rendering/Pixel Stretch' (rendu 2) Fig. 2.1.3. Le filtre « Rendering / Pixel Stretch » appliqué pour styliser le mouvement d'une danseuse (Crédits : Miguel Pineau).

    2.2. Filtre « Rendering / Gradients [Poles] »

    Toujours dans cette section « Rendering », notons l'arrivée de « Rendering / Gradients [Poles] », un filtre générant des dégradés de couleurs en interpolant spatialement des points-clés colorés, dont les positions et les couleurs sont laissées au choix de l'utilisateur. Ici, l'interpolation fait usage des fonctions de base radiale qui produisent des dégradés de couleurs lisses et harmonieux. L'utilisateur a également le choix de l'espace de couleurs dans lequel l'interpolation s'effectue. L'animation ci-dessous illustre le fonctionnement de ce filtre au sein du greffon.

    Filtre 'Rendering/Gradient (Poles)' (G'MIC-Qt) Fig. 2.2.1. Le filtre « Rendering / Gradient [Poles] » crée des gradients spatiaux de couleurs possiblement complexes, à partir de quelques points de contrôle.

    2.3. Filtre « Artistic / Marker Drawing »

    Passons maintenant au filtre « Artistic / Marker Drawing », qui comme son nom l'indique, essaye de redessiner une image d'entrée sous la forme de traits de stylos feutres colorés. L'algorithme sous-jacent trace effectivement des splines colorées aléatoires sur une feuille blanche, le long des contours des structures géométriques présentes dans l'image à reproduire.

    Filtre 'Artistic/Marker Drawing' (G'MIC-Qt) Fig. 2.3.1. Le filtre « Artistic / Marker Drawing » redessine une image en simulant l'utilisation de stylos feutres colorés.

    Les nombreux paramètres réglables de ce filtre permettent d'obtenir des rendus potentiellement variés, plus ou moins abstraits, comme l'illustre la figure comparative suivante :

    Filtre 'Artistic/Marker Drawing' (rendus) Fig. 2.3.2. Trois types de rendus du filtre « Artistic / Marker Drawing », utilisant trois jeux de paramètres différents.

    2.4. Filtre « Deformations / Heightfield Warp »

    Changeons maintenant de thématique avec le filtre « Deformations / Heightfield Warp » qui crée un effet 3D, en déformant une image d'entrée comme si elle était plaquée sur une carte d'élévation (définie de manière paramétrique). Un effet d'éclairage additionnel, de type ombrage de Phong, peut être activé pour accentuer davantage l'effet de volume 3D produit par ce filtre.

    Filtre 'Deformations/Heightfield Warp (G'MIC-Qt) Fig. 2.4.1. Le filtre « Deformations / Heightfield Warp », tel qu'il apparait dans le greffon G'MIC-Qt, ici avec une élévation correspondant à une demi-sphère bombée vers la caméra.

    Ce filtre est particulièrement flexible : il laisse la possibilité à l'utilisateur de définir explicitement des formules mathématiques personnalisées pour les cartes d'élévations. Les mathématiciens en herbe peuvent ainsi laisser libre cours à leur imagination pour déformer leurs images !

    Filtre 'Deformations/Heightfield Warp (rendus) Fig. 2.4.2. Application de trois formules personnalisés de cartes d'élévations 3D, avec le filtre « Deformations / Heightfield Warp ».

    2.5. Filtre « Degradations / Offset Stripes »

    Les amateurs de Glitch art pourront être séduits par le nouveau filtre « Degradations / Offset Stripes », qui crée un effet de décalage de bandes d'images, horizontales et/ou verticales, avec des amplitudes de décalage aléatoires.

    Filtre 'Degradations/Offset Stripes (G'MIC-Qt) Fig. 2.5.1. Le filtre « Degradations / Offset Stripes » applique des décalages aléatoires sur des bandes d'images horizontales et/ou verticales.

    Ce principe de base est tout simple, mais là encore, les nombreux paramètres du filtre donnent accès à des décalages décorrélés sur chaque canal, pour des espaces couleurs variés, en pouvant itérer ces décalages aléatoires, et autorisent ainsi une grande variété de dégradations d'images de type « Glitch », comme illustré sur la figure ci-dessous.

    Filtre 'Degradations/Offset Stripes (rendus) Fig. 2.5.2. Résultats de différents jeux de paramètres du filtre « Degradations / Offset Stripes », appliqués sur une même image de portrait.

    2.6. Filtre « Colors / Transfer Colors [Multi] »

    Et pour terminer ce résumé des nouveaux filtres du greffon G'MIC-Qt, j'ai gardé le plus intéressant pour la fin : le filtre « Colors / Transfer Colors [Multi] » est un nouveau filtre de transfert de couleurs entre deux images.

    Le transfert de couleur consiste à appliquer une transformation couleur à une image « Source », en prenant comme référence une deuxième image (image dite de « Style ») dont on veut reproduire le style ou l'ambiance colorimétrique, et ceci bien sûr en préservant autant que possible les structures importantes (contours, objets, contenu sémantique) présentes dans l'image « Source » d'origine.

    Principe du transfert couleur entre images Fig. 2.6.1. Principe du transfert de couleur entre images: une image « _Source » (à gauche) est modifiée (à droite) de telle façon qu'elle « emprunte » les couleurs d'une image de « Style » (au centre)._

    D'un point de vue algorithmique, il y a de nombreuses façons d'aborder ce type de transfert. Le filtre « Colors / Transfer Colors [Multi] », comme son nom le suggère, implémente trois méthodes différentes pour ce faire : une méthode ACP ; une méthode de transfert d'histogrammes ; et enfin une méthode variationnelle. Pour utiliser ce filtre dans le greffon G'MIC-Qt, il suffit de l'appeler sur une image contenant deux calques superposés : un calque contenant l'image « Source » à modifier, et un calque avec l'image « Style » contenant les couleurs de référence à transférer.

    Filtre 'Colors/Transfer Colors (Multi) Fig. 2.6.2. Le filtre « Colors / Transfer Colors [Multi] » tel qu'il se présente dans le greffon G'MIC-Qt.

    L'algorithme variationnel de transfert de couleur implémenté dans ce filtre est une production totalement originale : il est le fruit d'une collaboration de recherche entre deux membres de l'équipe IMAGE du laboratoire GREYC de Caen (D. Tschumperlé et J. Rabin), et d'une professeure du laboratoire de mathématiques LMI de l'INSA de Rouen (C. Le Guyader).

    Bref, un algorithme 100 % normand, qui fonctionne forcément « vachement 🐄 bien » 😉, et que vous ne trouverez nulle part ailleurs !
    On remercie chaleureusement la Fédération Normande de Recherche en Sciences et Technologies de l’Information et de la Communication (NormaSTIC) pour son aide financière qui a accéléré la mise en contact et le démarrage de cette collaboration fructueuse !

    Notre méthode a plusieurs caractéristiques propres permettant de calculer des transferts de couleurs souvent pertinents, et de bonne qualité comparativement à ses concurrentes, et ce, de manière rapide et complètement automatique. La figure ci-dessous illustre des exemples de transferts de couleurs qu'il est possible d'obtenir pour une même image « Source », en choisissant des images de « Style » différentes (et en laissant les paramètres par défaut du filtre).

    Filtre 'Colors/Transfer Colors (Multi) (rendus) Fig. 2.6.3. Exemples de transferts de couleurs réalisés par le filtre « Colors / Transfer Colors [Multi] » sur une même image « Source », avec plusieurs images « Style » différentes.

    La technique que nous proposons autorise également un mode « semi-supervisé » qui permet à l'utilisateur de forcer certaines correspondances de couleurs, et donc de « guider » l'algorithme pour calculer une solution de transfert plus contrainte et personnalisée.
    Les deux exemples ci-dessous illustrent ce mode de contrôle de manière assez parlante :

    Filtre 'Colors/Transfer Colors (Multi) (rendu guidé 1) Fig. 2.6.4. Guidage de l'algorithme de transfert de couleurs par mise en correspondance forcée de couleurs (Perruche → Mésange).

    Ici, les plumes vertes du corps de la perruche (a) sont perceptuellement plus proches de la couleur jaune du corps de la mésange (b), et c'est donc cette mise en correspondance qui est réalisée par défaut par l'algorithme de transfert (résultat (c)). En explicitant des correspondances de couleurs souhaitées (liens symbolisés entre les images (a) et (b)), on peut modifier ce comportement et contraindre le transfert à assigner la couleur bleue de la mésange aux plumes de la perruche (résultat (d)).

    Filtre 'Colors/Transfer Colors (Multi) (rendu guidé 2) Fig. 2.6.5. Guidage de l'algorithme de transfert de couleurs par mise en correspondance forcée de couleurs (Coccinelle → Formule 1).

    Dans ce deuxième exemple, on note que la couleur rouge de la Coccinelle (a) se retrouve ailleurs dans l'image « Style » de la Formule 1 (b) : au bord de la route, sur les coquelicots… L'algorithme décide donc naturellement de conserver cette couleur quasiment telle quelle lors du transfert automatique (résultat (c)). Forcer des correspondances de couleurs explicites permet de guider l'algorithme pour lui faire changer la couleur de la Coccinelle en vert (résultat (d)).

    Vous l'aurez compris, ce filtre représente l'aboutissement d'un travail de recherche de longue haleine en algorithmique du traitement d'images. Pour des chercheurs comme nous, il est réjouissant d'être arrivé au bout du processus complet : élaborer un nouvel algorithme complexe sur un bout de papier, le développer, l'implémenter, le peaufiner, en obtenir des résultats encourageants, le peaufiner encore et encore, en écrire une description détaillée dans un article scientifique (en cours de finalisation), l'intégrer proprement et le rendre utilisable par tout un chacun dans un logiciel libre, en sachant qu'il pourra être testé et utilisé potentiellement des milliers de fois !

    Notons que ce n'est pas la première fois qu'une méthode de traitement d'images développée au sein de notre laboratoire de recherche se retrouve valorisée dans G'MIC. Cette page recense plusieurs publications scientifiques décrivant des algorithmes élaborés au sein de l'équipe IMAGE du GREYC, et qui sont accessibles comme filtres du greffon G'MIC-Qt.

    3. Nouveautés et améliorations du cœur du logiciel et de sa bibliothèque standard

    Comme évoqué précédemment, le terme G'MIC peut faire référence au langage de script du même nom. Ce langage est doté de son propre interpréteur et de sa bibliothèque standard de fonctions. Il est utilisé pour implémenter tous les filtres et opérateurs de traitement d'images mis à disposition des utilisateurs des différentes interfaces du projet.

    Durant l'année écoulée, un grand nombre de petites améliorations ont été implémentées conjointement sur ce langage et sa bibliothèque standard.
    En réalité, l'ensemble de ces contributions représente même la majorité du travail de développement réalisé, et en même temps ce sont des choses qu'il est difficile de valoriser dans une dépêche grand public : elles concernent principalement des points très précis et techniques du projet, comme par exemple des optimisations du parsing ou des algorithmes, du nettoyage de code, de nouvelles fonctions ou options pour l'évaluateur d'expressions mathématiques, etc.
    Ce sont bien sûr des ajouts utiles pour les développeurs de nouveaux filtres dans ce langage, mais il est difficile de les mettre en valeur de manière réellement plaisante.

    J'ai donc pris le parti de lister ci-dessous uniquement les quelques nouveautés facilement « illustrables » :

    • La nouvelle commande random_patches réalise un rendu procédural d'images carrées contenant des formes géométriques et des textures synthétiques aléatoires. À quoi cela peut-il bien servir, me direz-vous ? Eh bien par exemple, à générer des ensembles d'images pour l'entrainement de réseaux de neurones convolutionnels, pour des tâches de débruitage et de super-résolution (ces réseaux sont ceux utilisés par les commandes denoise_cnn et scale2x_cnn).

    Commande 'random_patches' (rendus) Fig. 3.1. La commande random_patches synthétise des images carrées contenant des formes géométriques et des textures aléatoires.

    Ces images sont en réalité suffisamment complexes pour qu'un réseau de neurones puisse apprendre des filtres convolutionnels pertinents pour l'analyse semi-locale de la géométrie des structures présentes dans des images plus naturelles. Ces filtres appris peuvent ensuite être utilisés dans des tâches de débruitage ou de super-résolution, qui sont des problèmes très géométriques et qui ne nécessitent pas vraiment une analyse sémantique du contenu des images. Utiliser ces données synthétiques pour entrainer des réseaux simples est donc largement suffisant pour ce type d'applications. D'une part, cela évite de stocker de grandes bases d'images volumineuses lors de l'entrainement (les images synthétiques étant générées à la volée). Et d'autre part, on évite automatiquement d'enfreindre le copyright éventuel des images présentes dans les ensembles d'apprentissage prédéfinis (dont la provenance n'est pas toujours clairement citée, avouons-le).

    Commande 'shape_hilbert (rendus) Fig. 3.2. La commande shape_hilbert trace une courbe de Hilbert dans une image, commande illustrée ici avec des niveaux croissants de récursions.

    • La nouvelle commande pca calcule une analyse en composantes principales (ACP) d'un ensemble de vecteurs. Ce type d'analyse permet à la fois de déterminer la dimensionnalité représentative de données vectorielles, ainsi que leurs orientations principales dans l'espace. L'ACP a de nombreuses applications en traitement d'images et plus généralement en analyse de données : débruitage, compression, reconnaissance de visages, analyse de textures, recalage géométrique, etc. L'exemple ci-dessous illustre son utilisation pour déterminer l'orientation des axes principaux (dessinés en pointillés) d'une silhouette de libellule.

    Commande 'pca') Fig. 3.3. La commande pca est utilisée ici pour calculer les orientations des axes principaux d'une silhouette binaire 2D.

    • Les nouvelles commandes depthmap3d et normalmap3d viennent enrichir les possibilités de rendus d'objets 3D maillés de G'MIC, en synthésisant des rendus d'un objet respectivement sous la forme de cartes de profondeurs et de normales 3D.

    Commandes 'depthmap3d' et 'normalmap3d') Fig. 3.4. Les commandes depthmap3d et normalmap3d appliquées sur un modèle 3D en rotation.

    • Mentionnons enfin le travail d'amélioration général ciblé sur les algorithmes d'opérations matricielles présents dans G'MIC : arrivée de la décomposition QR (avec pivot), amélioration de la précision de calcul pour l'inversion de matrices et la résolution de systèmes linéaires… Et même s'il est difficile de rendre ça visuel, je vous propose cette petite ligne de commande qui crée une matrice carrée 40×40 aléatoire, qui l'inverse et qui calcule le produit des deux pour vérifier que l'on retrouve bien la matrice identité.
    $ gmic 40,40 rand -1,1 +invert +mmul name A,invA,'A*invA'

    Commande 'invert') Fig. 3.5. Exemple de l'utilisation de gmic en ligne de commande pour l'inversion d'une matrice aléatoire.

    Tout ceci n'est bien sûr qu'un aperçu succinct de ce qui a été réalisé sur le cœur de G'MIC cette année. Pour plus de détails techniques, la consultation des Changelog est recommandée.

    4. Nouveau dépôt de codes sources: gmic-interactive-demos

    En tant que membre d'un laboratoire public de recherche, j'ai l'occasion de participer ponctuellement à des évènements de vulgarisation scientifique (tels que la Fête de la science, le FÉNO, etc.), où l'on présente certaines de nos activités de recherche au grand public (en algorithmique du traitement d'images en ce qui me concerne). Pour rendre ces présentations plus attractives et ludiques, j'ai élaboré au fil des ans, différents programmes et bornes de démonstration interactifs, en me reposant sur les possibilités offertes par le langage G'MIC.

    Ces applications libres (sous licence CeCILL) sont maintenant accessibles sur ce dépôt logiciel : github.com/GreycLab/gmic-interactive-demos

    Elles pourront intéresser des enseignants et/ou chercheurs souhaitant illustrer différents concepts du traitement d'images à des publics de néophytes. Ces codes illustrent aussi les capacités du langage G'MIC pour la création de programmes interactifs, et ceci indépendamment du greffon G'MIC-Qt.

    Pour le moment, trois démonstrateurs sont présents dans ce dépôt logiciel. Ils sont détaillés ci-dessous.

    4.1. The SteamFace Machine

    « The SteamFace Machine » est le démonstrateur le plus récent. Il montre le fonctionnement des réseaux de neurones convolutionnels pour la détection d'un visage dans une image, et l'analyse de caractéristiques propres à ce visage, le tout enrobé dans un style SteamPunk du plus bel effet !

    The SteamFace Machine (intro) Fig. 4.1.1. Écran de lancement du démonstrateur « The SteamFace Machine ».

    Le flux vidéo capturé par la webcam s'affiche à l'écran, et lorsqu'un visage est placé au centre de l'image, la jauge de détection faciale s'active. En bas à droite, on peut apercevoir la sortie de différentes couches intermédiaires du réseau de neurones réalisant la détection (classifieur binaire avec une architecture de type LeNet-5).

    The SteamFace Machine (main) Fig. 4.1.2. Détection du visage par un réseau de neurones convolutionnel dans le démonstrateur « _The SteamFace Machine »._

    Une fois la détection opérée, un deuxième réseau est inféré pour en extraire différentes caractéristiques faciales : genre, âge, type de cheveux, port de lunettes ou de chapeau, taille du nez…

    The SteamFace Machine (caractéristiques) Fig. 4.1.3. Analyse de quelques caractéristiques liées au visage détecté.

    C'est une manière visuellement amusante de présenter le fonctionnement de classifieurs neuronaux au grand public, leurs capacités mais aussi leurs limites et les biais inhérents aux bases d'apprentissage utilisées pour les entrainer (dans le cas de ce démonstrateur, la base CelebA, qui contient des images assez éloignées de celles que l'on acquiert via la webcam dans un environnement non-contrôlé tel qu'un parc des expositions).

    Mentionnons également la belle contribution de notre cher collègue Philippe Bernard, du service Administration système et réseaux du GREYC, qui a réalisé une borne physique de démonstration intégrant « The SteamFace Machine », facilement transportable à des évènements de médiation scientifique !

    The SteamFace Machine (borne) Fig. 4.1.4. Vidéo de démonstration de la borne « The SteamFace Machine » quand elle était en cours d'élaboration.

    4.2. Virtual Artist

    « Virtual Artist » est un deuxième démonstrateur interactif, qui cherche à illustrer le principe du « transfert de style » entre deux images.
    Nous avons précédemment évoqué le transfert de couleurs (en section 2.6). Le transfert de style en est une extension naturelle : au lieu de transférer uniquement les couleurs, on cherche à transférer tout le style graphique d'une image « Style » vers l'image « Source ».
    C'est bien sûr un problème autrement plus complexe, et les méthodes les plus performantes du domaine utilisent généralement de gros réseaux de neurones.

    « Virtual Artist » n'a pas la prétention d'être à la pointe de l'état de l'art : c'est avant tout un démonstrateur pédagogique pour expliquer le principe général du transfert de style en traitement d'images. L'utilisateur peut jouer avec différentes images de « Source » et de « Style » prédéfinies. La figure ci-dessous illustre quelques-uns des écrans principaux de l'application.

    Virtual Artist Fig. 4.2.1. L'application « Virtual Artist » illustre le principe du transfert de style entre deux images.

    Ce démonstrateur a été utilisé de nombreuses fois sur une grande table tactile, dans des évènements grand public, et fait toujours son petit effet !

    Virtual Artist (FÉNO) Fig. 4.2.2. L'application « Virtual Artist » utilisée comme démonstrateur, ici au Festival de l'Excellence Normande (FÉNO) en 2021.

    4.3. GREYC Warp

    « GREYC Warp », le dernier démonstrateur de ce nouveau dépôt logiciel, implémente un miroir déformant interactif. L'utilisateur voit en direct le flux de la webcam et peut créer, déplacer ou supprimer des points clés qui définissent une déformation appliquée en temps réel. Une dizaine de transformations pré-définies sont également proposées.

    GREYC Warp Fig. 4.3.1. L'application « GREYC Warp » vous laisse déformer le flux vidéo de votre webcam, de manière interactive, et non sans humour !

    Pour avoir testé ce démonstrateur en situation réelle lors d'expositions, ça fait beaucoup rire les enfants (mais pas les plus jeunes qui pensent que ça reflète vraiment l'apparence de leur tête et qui peuvent se mettre à pleurer). Une application toute simple mais néanmoins amusante !

    5 G'MIC et le code créatif

    Ces quelques démonstrateurs esquissent déjà l'image d'un langage G'MIC adapté au code créatif, qui consiste, selon Wikipedia, à « utiliser la programmation informatique comme un moyen d'expression artistique (visuel, musical, littéraire, interactif, performatif…) à part entière ».

    5.1. Codes créatifs courts

    En tant qu'ancien demomaker, le code créatif est forcément un domaine qui me tient à cœur, et j'écris et partage régulièrement des scripts courts sur le forum de G'MIC pour expérimenter de nouvelles idées d'effets graphiques, ou en reproduire certains sur lesquels je suis tombé et que je trouve captivants.
    Quelques-uns de ces effets récents sont décrits ci-dessous, avec à chaque fois, un accès vers le code source correspondant (script .gmic).

    • Agrégation limitée par diffusion tournoyante : Cet effet est une variante de l'agrégation limitée par diffusion, implémentant un système de particules en mouvement qui sont stoppées dès lors qu'elles rencontrent une masse d'éléments plus anciens, déjà immobiles. On ajoute à tout ça une rotation, un zoom inverse, une palette de couleurs, et le tour est joué ! Le code source de cet effet atteint difficilement les 36 lignes, commentaires inclus !

    Diffusion-Limited-Aggregation (animation) Fig. 5.1.1. L'effet animé « Agrégation limitée par diffusion tournoyante », rendu par G'MIC.

    • Courbe de Hilbert néon : Cette animation stylise le dessin d'une courbe de Hilbert par un tracé incrémental faisant songer à un néon. Ici, le code source est beaucoup plus conséquent (52 lignes 😉).

    Hilbert-Curve (animation) Fig. 5.1.2. L'effet animé « Courbe de Hilbert néon », rendu par G'MIC.

    • Morphing de formes : Ici, deux silhouettes se transforment l'une vers l'autre via un morphing continu. On utilise des edgels pour l'extraction et la paramétrisation du contour des deux silhouettes à transformer. Le code source de cet effet revient à un nombre de lignes de code quand même plus raisonnable que précédemment (36 lignes).

    Morph Shape (animation) Fig. 5.1.3. L'effet animé « Morphing de formes », rendu par G'MIC.

    • Tunnel 3D : Celui-ci est l'un de mes préférés. C'est certes un effet ultra-classique dans le monde de la scène démo, mais le rendu est sympa. Et avec ses 68 lignes, le code source pour générer cette animation de 256 frames (qui cyclent parfaitement) reste dans les limites du raisonnable !

    Tunnel 3D (animation) Fig. 5.1.4. L'effet animé « Tunnel 3D », rendu par G'MIC.

    • One-liner géométrique : Le langage G'MIC, grâce à sa syntaxe délibérément concise, est un candidat idéal pour la création de one-liners. Une section entière de la documentation de référence est d'ailleurs dédiée à quelques one-liners amusants. Étant tombé par hasard sur cette belle image créée avec GeoGebra par Georg Wengler, j'ai souhaité la retranscrire en langage G'MIC sous la forme d'une unique ligne de commande affichant une animation, et voici le résultat (et heureusement qu'une ligne de code ne se limite pas à 80 caractères !)
    $ gmic 12,12,256,2,"a = 1 + x; b = 1 + y; t = lerp(0,2*pi*b,z/d); cos(a/b*t)*cexp([0,t])" 12,12,1,2,"S = crop(#-1,x,y,0,c,1,1,d#0,1); S = round(45*(S - avg(S)) + 50); draw(#-1,S,x,y,0,c,1,1,d#0,1)" rm. 1200,1200,1,3,255 repeat 256 { 12,12,1,1,"repeat (16,l, X = 100*[x,y] + round(I(#0,x,y,$> + l/16,2,2)); ellipse(#-1,X,1,1,0,1,0))" rm. +rs. 600 w. rm. wait 20 } rm

    cos(ab) (animation) Fig. 5.1.5. L'effet animé « cos(ab) », rendu par G'MIC.

    L'ensemble de ces nouvelles animations se retrouve dans la section Gallery du site web de G'MIC.

    5.2. Continuation de la série « G'MIC Adventures »

    De temps en temps, j'essaie aussi de partager l'ensemble du processus permettant d'arriver (en partant de zéro) à un résultat de code créatif.
    Et cela, rédigé sous la forme d'un petit article partagé sur le forum de G'MIC. Cette série d'articles est nommée « G'MIC Adventures ». Je l'avais évoquée dans notre dernière dépêche. Deux nouveaux épisodes de cette série sont parus depuis :

    • Apprentissage d'un perceptron multi-couches pour la reproduction d'une image couleur (G'MIC Adventure #5) :

    Dans ce cinquième épisode, on cherche à entrainer un réseau de neurones simple (un perceptron multi-couches) capable d'apprendre une fonction image entière (x,y)\to(R,G,B), c'est-à-dire un réseau capable de prédire une couleur (R,G,B) correcte à partir d'un vecteur de coordonnées (x,y) donné en entrée. Il est particulièrement intéressant de visualiser l'image couleur que le réseau est capable de reproduire à chaque itération de son apprentissage (figure ci-dessous), et ce, jusqu'à convergence.

    MLP (animation) Fig. 5.2.1. Reconstruction itérative d'une image couleur obtenue par l'apprentissage d'un perceptron multi-couches.

    Dans ce sixième épisode, on s'intéresse à l'implémentation en G'MIC de l'équation d'ondes et ses possibilités pour appliquer des effets de déformations amusants sur des images, comme l'illustre la figure suivante qui correspond au résultat obtenu à la toute fin de l'article.

    Wave equation (animation) Fig. 5.2.2. Application d'une équation d'ondes anisotrope pour la déformation d'une image le long de ses contours.

    Les exemples présentés dans cette section montrent que G'MIC a du potentiel pour le code créatif, notamment pour l'expérimentation rapide de codes d'effets graphiques. Le fait qu'il soit utilisable en ligne de commande (via la commande gmic) en fait un allié précieux pour générer des animations ou pour modifier des lots d'images de manière automatisée.

    6. Autres nouvelles liées au projet

    Pour finir cette longue dépêche, voici en vrac quelques autres nouvelles notables liées au projet :

    • Diffusion de G'MIC : Avec le temps, la diffusion de G'MIC s'accélère et son installation se simplifie. Notons tout d'abord que G'MIC-Qt a été parmi les premiers greffons disponibles lors de la sortie de la version majeure 3.2 de GIMP. L'installation de ce greffon est maintenant aussi largement simplifiée pour les utilisateurs de macOS, grâce au travail remarquable des empaqueteurs de MacPorts, qui en proposent une version toujours très à jour.

    Nous avons également appris que G'MIC suscite l'intérêt des projets suivants :

    1. Le projet G'MIC-GEGL a pour objectif d'exposer les différents filtres du greffon G'MIC-Qt directement sous forme de nœuds GEGL, qui est la bibliothèque de traitement utilisée en interne dans GIMP. Cela voudrait dire que les effets de G'MIC-Qt pourraient à terme être utilisés dans des calques d'effets non-destructifs de GIMP.
    2. Le projet PhotoFlare est un nouvel éditeur d'images numériques multi-plateformes, et son développeur a annoncé y avoir intégré le greffon G'MIC-Qt afin de profiter de ses centaines de filtres proposés.
    3. Le projet gmic-affinity se propose de développer un greffon en Rust pour Affinity Photo, pour exposer le greffon G'MIC-Qt aux utilisateurs. Ce dernier est normalement déjà fonctionnel pour ce logiciel, via l'API 8bf (comme le montre cette vidéo), mais malheureusement pas encore pour les utilisateurs de macOS.
    4. Enfin, notons l'arrivée de G'MIC-Qt sur le Snap Store, proposant ainsi une façon alternative d'installer notre greffon pour GIMP.
    • Exposé : Début mai 2026, j'ai eu l'occasion de faire un bref passage au laboratoire LRDE de l'EPITA, sympathiquement invité par Marc Espie (enseignant et l'un des développeurs du projet OpenBSD), où j'ai donné une présentation intitulée « 25 ans de développement libre pour le traitement des images numériques ». Une vidéo de cette présentation a été captée et mise sur YouTube.

    7. Conclusion

    Cette version 4.0 marque un jalon important pour G'MIC : dix-huit ans après la première ligne de code, le projet a montré qu'un logiciel open-source né au sein d'un laboratoire de recherche public, et aux ressources modestes, peut s'installer durablement dans le paysage du graphisme numérique libre, et continuer à innover grâce à son écosystème ouvert et extensible.

    Cette dépêche a cherché a montrer la maturité et la polyvalence de G'MIC. C'est un cadriciel multi-usages dont les interfaces variées peuvent toucher des publics différents, de l'artiste numérique au bidouilleur de la ligne de commande, en passant par le chercheur en traitement d'images, à partir du moment où une image numérique entre en jeu !

    C'est aussi l'occasion de rappeler que rien de tout cela n'aurait été possible sans l'écosystème bienveillant qui gravite autour du projet. Nous tenons à remercier chaleureusement nos partenaires académiques (le CNRS, l'ENSICAEN, l'Université de Caen, la direction du GREYC), ainsi que l'ensemble de la communauté (testeurs, empaqueteurs, vidéastes et utilisateurs du quotidien). Votre soutien est très apprécié.

    Les idées fourmillent, l'envie de triturer des pixels est toujours aussi présente, et on espère donc pouvoir continuer à développer et valoriser ce cadriciel libre comme il se doit dans le futur.

    Y aura-t-il une nouvelle dépêche l'année prochaine ? L'avenir nous le dira !

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Appel à projets tuteurés colibre 2026-2027

    Cette année encore (mais pour la dernière fois) la licence professionnelle en communication CoLibre, de l'Université Lyon2, vous invite à proposer une action de communication pour votre structure (association, collectif, entreprise…) qui fera l'objet d'un projet tuteuré pour un des groupes de notre promotion 2026-2027.

    L'appel est ouvert jusqu'au 15 septembre (sans possibilité d'allongement).

    Logo de la licence professionnelle en communication CoLibre, de l'Université Lyon2

    Il est important de penser que l'action fera d'abord l'objet d'une étude de faisabilité et, dans la mesure du possible, sera réalisée par le groupe qui en a la charge.

    Il faut garder en tête que les étudiantes et étudiants ne doivent utiliser que des logiciels libres pour réaliser leurs travaux et que par ailleurs tous les frais engagés doivent être pris en charge par l'offreur.

    Par expérience, il est important que la structure soit en mesure de venir rencontrer le groupe ou le faire venir "en vrai", il faut aussi avoir une part de disponibilité pour une réunion mensuelle minimum avec le groupe et considérer le groupe comme force de proposition et pas seulement comme exécutant à pas cher d'une action de communication.

    Le formulaire de proposition est disponible sur le site de la promotion tout comme des informations sur les projets tuteurés passés.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Agenda du Libre pour la semaine 29 de l'année 2026

    Calendrier Web, regroupant des événements liés au Libre (logiciel, salon, atelier, install party, conférence) annoncés par leurs organisateurs. Voici un récapitulatif de la semaine à venir. Le détail de chacun de ces 28 événements (France: 22, Québec:5, Internet: 1) est en seconde partie de dépêche.

    Sommaire

    [FR Saint Clar] Tous les Lundis, médiathèque de Saint Clar – Le lundi 13 juillet 2026 de 10h00 à 17h00.

    Tous les lundis de 10h à 17h sans interruption, l’association Prends-toi en main / atelier abcpc, propose install party, suivi, dépannage, formation et revalorisation à petit prix sous Linux exclusivement.

    L’atelier abcpc existe depuis plus de 10 ans et milite exclusivement pour les logiciels libres.

    [FR Saint-Étienne] Permanence de l’association Alolise – Le lundi 13 juillet 2026 de 19h00 à 22h00.

    Tous les lundis soir de 19h à 22h (hors jours fériés) à la Bricoleuse.

    Rencontrer les bénévoles, poser des questions sur le libre ou l’informatique, les logiciels, l’hébergement, passer de Windows à Linux.

    Pour passer votre ordinateur sous Linux, nous vous invitons à nous prévenir avant votre passage: contact@alolise.org.

    [FR Montpellier] Permanence | Wikipermanence – Le lundi 13 juillet 2026 de 19h00 à 22h00.

    Une Wikipermanence est une rencontre physique entre des Wikipédiens chevronnés et de nouveaux ou futurs Wikipédiens qui souhaitent acquérir des connaissances et des conseils sur le fonctionnement de Wikipédia.

    Il ne s’agit pas d’une simple rencontre entre Wikipédiens : la Wikipermanence organisée par le groupe local de Montpellier est là pour répondre aux questions, permettre des démonstrations, offrir une aide aux premiers pas et permettre un suivi.

    Pour cette soirée, chacun amène ce qu’il veut à manger et à boire pour un repas partagé.

    Cette rencontre nous permettra d’aborder les sujets suivants :

    Le programme :

    • Information sur la communauté Wikipédia ;
    • Initiation des débutants ;
    • Nous contribuerons sur la mise à jour des différentes pages, sur les Wikipermanences que Montpel’libre organise à Montpellier ;
    • Atelier d’écriture ;
    • Échanger d’expériences ;
    • Proposition d’éditathon ;
    • Contributions libres ; *…et tout simplement, passer un moment convivial.

    Si vous avez des propositions, n’hésitez pas à compléter la page dédiée sur Wikipédia.

    N’hésitez pas à venir: c’est sans inscription, et vous l’aurez deviné, libre et gratuit !

    Wikipédia est une encyclopédie libre rédigée collaborativement par des milliers d’internautes. Mais, saviez-vous que vous pouviez y participer ?

    En apportant des connaissances, en créant ou améliorant des articles, en prenant des photos, ou simplement en corrigeant des fautes, vous pouvez contribuer à ce grand projet d’encyclopédie collaborative.

    Alors, venez participer aux rendez-vous des Wikipermanences de Montpellier qui auront lieu à l’Atelier de Pigistes, le deuxième lundi de chaque mois, de 19h00 à 22h00.

    Cet événement vous est proposé dans le cadre du partenariat qui lie le Club de la Presse, Wikimédia France, Wikimedia Foundation, Wikimedia Éducationet Montpel’libre.

    Inscription | GPS 43.60302/3.89809

    https://montpellibre.fr/fiches_activites/Fiche_010_Montpellibre_Permanence_Wikipermanence_Cabalherault.pdf

    [FR Sainte-Hélène] Cours gratuits d’Espéranto + Visio – Le lundi 13 juillet 2026 de 19h30 à 21h30.

    Saluton,

    Je vous propose des cours d’espéranto gratuits qui débuteront le lundi 8 juin à Sainte-Hélène dans le Médoc et qui sera également disponible en visioconférence.
    Le cours est destiné aux apprenants francophones de France et d’ailleurs.

    L’espéranto est plus qu’une langue neutre et très facile, mais aussi une langue fraternelle et libre qui permet de voyager dans de nombreux pays avec des facilités d’hébergement ou de fraterniser avec des personnes du monde entier.
    Vous trouverez plus d’informations sur la page Wikipédia, le site Espéranto-Gironde ou en visualisant le documentaire "ESPÉRANTO: de la genèse à la conquête de l’Europe"

    Les cours ont lieu le lundi soir de 19h30 à 21h30 sur environ 10 soirs pour réaliser les 10 leçons. Ces leçons complèteront les cours papier ou d’application telle que Duolingo.
    Début: lundi 8 juin 2026.
    Les cours sont GRATUITS pour tous.

    Le cours est en présentiel à Sainte-Hélène (33480) au foyer des sociétés en collaboration avec l’association l’Écurieux, ainsi qu’en distanciel / visioconférence.
    Ce cours est gratuit pour tous, en présentiel ou en distanciel.

    Nous pourrons organiser à la suite du cours, des rencontres avec les espérantistes de Bordeaux, du pays basque… afin de pratiquer en situation réelle.

    N’hésitez pas à nous contacter par téléphone au 0688350981 (appel, SMS, Signal) pour plus d’informations ou pour vous inscrire.

    Vivu Esperanto kaj Ĝis la revido.

    [CA-QC Trois-Rivières] 5 à 9 Hybride Linux à Trois-Rivières – Le lundi 13 juillet 2026 de 17h00 à 20h00.

    🐧 5 à 9 Hybride Linux à Trois-Rivières

    Une rencontre amicale pour échanger, apprendre et réseauter.

    Le comité organisateur des Rencontres Linux au Québec est heureux de vous inviter à une édition spéciale à Trois-Rivières! À l’occasion du passage de Martial dans la région, nous organisons une rencontre en format 5 à 8 hybride.

    Que vous soyez un expert en administration système, un développeur chevronné ou simplement curieux de découvrir les alternatives libres, vous êtes le bienvenu !

    📅 Quand ?

    Lundi 13 juillet 2026

    De 17h00 à 20h00

    📍 Où ? (Format Hybride)

    Vous avez deux options pour participer:

    En personne (Trois-Rivières):

    Nous nous retrouverons au restaurant Pacini de Trois-Rivières. Nous visons une ambiance propice aux échanges avec un accès à une salle privée et un écran pour partager des démonstrations techniques.

    En virtuel (BigBlueButton):

    Pour ceux qui ne peuvent se déplacer, la rencontre sera diffusée en direct sur notre plateforme de visioconférence libre.

    Voir le lien ici

    📋 Au programme

    Réseautage décontracté: Faites connaissance avec la communauté Linux locale.
    Partage de trucs et astuces: Présentations informelles et entraide sur vos projets en cours.
    Tirage au sort: Un prix de présence sera offert parmi les participants à la fin de la rencontre.
    👥 Qui peut participer ?

    Absolument tout le monde ! Nos réunions accueillent une grande diversité de profils: étudiants, professionnels, enseignants, retraités et curieux. L’objectif est de dynamiser la communauté Linux et de favoriser l’entraide dans une atmosphère conviviale.

    🎟️ Inscription obligatoire

    La participation est gratuite. Toutefois, l’inscription est nécessaire pour nous permettre de confirmer le nombre exact de places au restaurant.

    Comité organisateur des Rencontres Linux au Québec

    [FR Dijon] Atelier du mardi – Le mardi 14 juillet 2026 de 15h00 à 19h00.

    Présentation de différents outils concernant les logiciels libres.

    Assistance technique.

    De préférence sur RDV directement sur le site de l’asso

    [CA-QC Québec] Rencontre hybride, ville de Québec – Le mardi 14 juillet 2026 de 17h00 à 22h00.

    Une rencontre amicale pour échanger, apprendre et réseauter.

    Le comité organisateur des Rencontres Linux au Québec est heureux de vous inviter à une édition spéciale dans la ville de Québec !

    À l’occasion du passage de Martial dans la région, Jérémy Viau-Trudel organise un spin-off local de RLQ dans la Capitale-Nationale.

    Que vous soyez débutant, passionné, professionnel des TI ou simplement curieux, vous êtes les bienvenus.

     Format hybride:

    • En présentiel à La Console (salle privée avec écran pour les présentations)
    • En ligne via BigBlueButton: Cliquez ici

    Programme:

    • 17 h à 19 h: Barbecue ReLaQx – réseautage convivial
    • 19 h: Mot du Linuxien en chef, Martial Bigras La tournée en cours, son intention et les 25 ans des Rencontres Linux au Québec
    • 19 h 30: Mot de l’initiateur, Jérémy Viau-Trudel Historique de Linux dans la ville de Québec, portrait actuel et perspectives d’avenir
    • 20 h: Pause
    • 20 h 30: Capsule Linux #1 (niveau débutant à intermédiaire)
    • 21 h: Capsule Linux #2 (niveau intermédiaire à avancé)
    • 21 h 20: Pause
    • 21 h 30: Table ronde sur la création d’un groupe RLQ dans la région de Québec

    La participation est gratuite, mais l’inscription est requise afin de nous permettre de confirmer le nombre de places disponibles au restaurant.

    Nous vous attendons nombreux pour cette soirée d’échanges, de découvertes et de réseautage autour de Linux !

    Comité organisateur des Rencontres Linux au Québec

    [FR Fourmies] La permanence du libre – Le mercredi 15 juillet 2026 de 13h30 à 17h00.

    Dans le cadre de la stratégie Rev3 de la ville de Fourmies est né le Central, Carrefour de la Résilience.

    À ce titre, l’Association Club Linux Nord Pas-de-Calais Fourmies vous accompagne et vous guide dans la configuration, la personnalisation et la prise en main de vos logiciels (Libres).

    C’est un espace de rencontres et d’échanges, uniquement basés sur les logiciels libres et le concept de l’open source.

    De 13h30 à 17h00 tous les mercredi, venez prendre en main vos logiciels libres et vos installations Linux Mint ou Mageia.

    La permanence du libre est un complément des install parties du samedi.

    Cette manifestation a lieu au Tiers-Lieu Le Central à Fourmies.

    [FR Gond-Pontouvre] Permanence du mercredi – Le mercredi 15 juillet 2026 de 14h00 à 18h00.

    Nous sommes convaincus depuis le début qu’un ordinateur n’est pas un consommable jetable et qu’on a tous le droit de comprendre et de maîtriser nos outils numériques. C’est de là qu’est née l’asso, à Gond-Pontouvre: un repaire de passionnés du libre et du bidouillage, où l’on défend les logiciels libres, la souveraineté technologique et le bon vieux plaisir de mettre les mains dans le cambouis. Au fil du temps, on a élargi le terrain de jeu, mais l’esprit reste le même: on apprend, on partage, on transmet.

    Le cœur historique, c’est le reconditionnement. On collecte des machines en fin de vie, on les teste sous toutes les coutures, et on leur offre une seconde jeunesse: passage en SSD pour réveiller les plus poussives, installation de Linux Mint pour un système libre, léger et accessible, et hop – un PC qu’on croyait bon pour la benne repart pour plusieurs années.

    Vous avez un vieux portable qui rame ou une tour oubliée au grenier? Apportez-la, on regarde ensemble.

    Côté fabrication numérique, le FabLab ouvre ses portes: venez concevoir et fabriquer vos projets sur nos machines – impression 3D (Creality K1 Max & K2 Plus), découpe et gravure laser (Falcon 2 Pro 60W), et de quoi toucher à
    l’électronique embarquée. Les bénévoles sont là pour vous guider – l’idée n’est pas de faire à votre place, mais de vous apprendre à faire.

    Entrée libre, esprit d’entraide et de partage des savoirs. Apportez vos questions, vos machines ou simplement votre curiosité.

    [FR Lamastre] Soirée Libre Bidouille – Le mercredi 15 juillet 2026 de 18h00 à 19h00.

    Le numérique est devenu omniprésent dans nos sociétés ultra-connectées. On le retrouve dans le milieu professionnel comme dans les rapports avec l’administration. De façon plus étonnante, il s’est même immiscé dans l’intimité: c’est pourquoi choisir un numérique de confiance est devenu essentiel.

    Les logiciels libres sont donc plus importants que jamais, car leur mode de développement est basé sur le partage des connaissances et l’échange de savoirs. Ils constituent un bien commun, accessible et réutilisable par tous. C’est donc un modèle informatique de confiance, renforcé par une éthique forte.

    de 18H00 à 19h00, présentation et discussions autour de Rézine. Rézine est un FAI local (Isère, Drôme, Ardèche), à prix juste, contrôlé par ses membres, neutre et émancipateur.

    à partir de 19h00 ce rendez-vous mensuel propose d’accompagner les utilisateurs et utilisatrices de logiciels libres dans la résolution de leurs problèmes informatiques (tous les deuxièmes ou troisièmes mercredis du mois suivant les disponibilités du lieu à partir de septembre 2023).

    C’est l’occasion de voir comment ça marche, de demander ou de donner un coup de pouce, de découvrir ou faire découvrir une astuce, d’installer GNU/Linux (si vous souhaitez faire une installation, nous prévenir est préférable).

    Ces soirées sont ouvertes à toustes, nous pensons organiser des thèmes sous forme d’ateliers pour la découverte d’un logiciel libre (graphisme, médias, bureautique, internet, outils système…) ou d’un thème (vie privée, programmation, CHATONS, auto-hébergement…).

    Cette année plusieurs autres événements sont à prévoir: Une Install-Party pour les ordinateurs qui ne pourront passer à Windows 11, c’est l’occasion pour vous de tester Linux et de donner une seconde vie à vos ordinateurs pour faire du bien à la planète, voir https://endof10.org/fr/ ou la campagne Adieu Windows des camarades de l’April.

    La distribution Debian passe à sa nouvelle release Trixie (Debian 13), si vous avez une distribution basée sur Debian il va falloir la mettre à jour.

    Une campagne de démailnagement pour quitter son adresse gmail (ou autre géants du web comme Apple Mail, Hotmail, Yahoo, Wanadoo, Outlook… qui posent les mêmes problèmes !) est en cours avec les CHATONS à laquelle nous participerons (voir https://www.demailnagement.net/).

    Si vous avez une demande particulière ou envie, vous aussi, de proposer aussi un atelier ou un thème, n’hésitez pas à faire signe ;) ou si vous souhaitez aussi organiser une activité d’information ou atelier vers chez vous, n’hésitez pas à nous le proposer, nous sommes prêts à nous déplacer dans la mesure du possible…

    Venez, pour:

    • une réponse à vos questions,
    • discuter de libertés,
    • approfondir ou échanger nos connaissances,
    • connaître des alternatives numériques, éthiques et respectueuses de vos données personnelles,
    • essayer un environnement GNU/Linux sur un ordinateur ou un RaspberryPi,
    • contribuer aux communs,
    • proposer un thème à travailler, si vous désirez maîtriser un thème en particulier,
    • contribuer à la connaissance et aux communs
    • installer une distribution GNU/Linux

    Soirée ouverte à tous, vous pouvez venir avec un ordinateur qui est sous Windows ou Mac, cela n’empêche pas d’utiliser des logiciels libres…

    Amenez vos ordinateurs, nous aurons une connexion Wifi… La connexion filaire est parfois pas très bonne, nous devrons parfois nous contenter d’un partage de connexion 4G…

    Important: Cette année, nous nous retrouverons tous les 2ᵉˢ mercredis du mois, mais le lieu de ce rendez-vous hebdomadaire peut changer. Nous mettrons à jour le lieu du rendez-vous au fur et à mesure au moins un mois à l’avance.

    [FR Tours] Rencontre locale OpenStreetMap – Le mercredi 15 juillet 2026 de 18h30 à 20h00.

    Apéro et discussion informelle autour d’OpenStreetMap en Touraine et au-delà.

    Comme d’habitude, nous ferons un petit tour de table des sujets et contributions de chacun⋅e.

    Ces rencontres sont ouvertes à tout le monde, même si vous débutez !

    [FR Bordeaux] Cours gratuits d’Espéranto – Le mercredi 15 juillet 2026 de 20h00 à 22h00.

    Saluton,

    Nous proposons une nouvelle session de cours d’Espéranto qui débuteront début juin au café Le Petit Grain, Place Dormoy à Bordeaux (c’est un café associatif avec des tarifs abordables dans le quartier de la gare Saint-Jean à côté de Barbey).

    L’espéranto est plus qu’une langue neutre et facile, mais aussi une langue fraternelle et libre qui permet de voyager dans le monde entier avec des facilités d’hébergement ou de fraterniser avec des personnes dans d’autres pays.

    Cette vidéo vous permettra d’en savoir plus: https://peertube.dc.pini.fr/w/akMZAKM9zJWG5mXLBtuQN4
    Vous trouverez également plus d’informations sur: https://esperanto-gironde.fr/lesperanto/, il y a l’abonnement à la lettre d’informations mensuelle qui est proposée en fin de chaque page afin de rester informé des activités espérantistes du coin.

    Les cours ont lieu le mercredi soir de 20h00 à 22h00, 10 soirs pour réaliser les 10 leçons. Ces leçons complètent le cours de l’application Duolingo.
    Début: mercredi 3 juin 2026.

    Les cours sont GRATUITS pour les membres du café associatif.
    Cependant, vous devrez adhérer au café associatif Le Petit Grain qui nous prête chaleureusement ses locaux si vous n’êtes pas membre. L’adhésion annuelle pour toute l’année 2026 est à prix libre conseillé à 5€, minimum 2€ et permet aussi la participation aux autres ateliers et activités.

    N’hésitez pas à nous contacter par téléphone au 0688350981 (appel, SMS, Signal) ou en répondant à ce message pour plus d’informations ou pour vous inscrire.
    Vous pouvez aussi nous rencontrer chaque 3ᵉ mercredi du mois de 18h00 à 19h30 au café Le Petit Grain ainsi que lors du défilé du 1ᵉʳ mai autour de notre banderole.

    Ĝis la revido.

    [CA-QC Rimouski] 5 à 8 Hybride Linux à Rimouski – Le mercredi 15 juillet 2026 de 17h00 à 20h00.

    🐧 5 à 8 Hybride Linux à Rimouski

    Une rencontre amicale pour échanger, apprendre et réseauter.

    Le comité organisateur des Rencontres Linux au Québec est heureux de vous inviter à une édition spéciale à Rimouski ! À l’occasion du passage de Martial dans la région, nous organisons une rencontre en format 5 à 8 hybride.

    Que vous soyez un expert en administration système, un développeur chevronné ou simplement curieux de découvrir les alternatives libres, vous êtes le bienvenu !

    📅 Quand ?

    Mercredi 15 juillet 2026

    De 17h00 à 20h00

    📍 Où ? (Format Hybride)

    Vous avez deux options pour participer:

    En personne (Rimouski):

    Nous nous retrouverons au restaurant Pacini de Rimouski. Nous visons une ambiance propice aux échanges avec un accès à une salle privée et un écran pour partager des démonstrations techniques.

    En virtuel (BigBlueButton):

    Pour ceux qui ne peuvent se déplacer, la rencontre sera diffusée en direct sur notre plateforme de visioconférence libre.

    https://bbb3.services-conseils-linux.org/Rencontres-Linux

    📋 Au programme

    • Réseautage décontracté: Faites connaissance avec la communauté Linux locale.
    • Partage de trucs et astuces: Présentations informelles et entraide sur vos projets en cours.
    • Tirage au sort: Un prix de présence sera offert parmi les participants à la fin de la rencontre.

    👥 Qui peut participer ?

    Absolument tout le monde ! Nos réunions accueillent une grande diversité de profils: étudiants, professionnels, enseignants, retraités et curieux. L’objectif est de dynamiser la communauté Linux et de favoriser l’entraide dans une atmosphère conviviale.

    🎟️ Inscription obligatoire

    La participation est gratuite. Toutefois, l’inscription est nécessaire pour nous permettre de confirmer le nombre exact de places au restaurant.

    Comité organisateur des Rencontres Linux au Québec

    [FR Dinan] Install Party – Donnez une nouvelle vie à votre – Le jeudi 16 juillet 2026 de 14h00 à 17h00.

    DinanUX, le Groupe d’Utilisateur•ices de Logiciels Libres (GULL) de Dinan et ses environs, organise une install’ party à la bibliothèque de Dinan.

    Venez avec votre ordinateur et son chargeur, sauvegardez vos documents importants au préalable et nous vous accompagnons pour installer Linux !

    Ordinateur en démonstration et assistance

    [FR Saint-Étienne] Install Party aux Forges – Le jeudi 16 juillet 2026 de 16h30 à 19h30.

    Le but de cette rencontre est que les participants repartent à la fin de l’atelier avec leur propre ordinateur fonctionnant sous système d’exploitation Linux, correctement installé, configuré et équipé des logiciels adéquats.

    Prérequis:

    Une Install Party vous accompagne pour que vous en repartiez avec un nouveau système d’exploitation sur votre machine.

    Il faut néanmoins s’y préparer: Il est indispensable de sauvegarder auparavant vos fichiers et données personnelles sur un support externe (clé USB ou disque dur externe) de capacité suffisante.

    En effet dans la plupart des cas l’ordinateur sera entièrement ré-initialisé, et même si ce n’est pas le cas, un risque de perte de données existe.

    À ce sujet consulter: Participer à une install partie GNU-Linux

    >> Plus d’infos et inscriptions

    [FR Saint-Jean-en-Royans] Atelier changer d’adresse e-mail – Le jeudi 16 juillet 2026 de 19h00 à 21h00.

    Pour mettre un pied en dehors des géants du numérique: changeons ensemble d’adresse e-mail.
    Un atelier de 2h pour revoir quelques bases puis changer en conscience et en douceur d’adresse e-mail.

    Suite à la causerie du 22 mai, un des besoins identifié est le changement d’adresse e-mail, alors on se retrousse les manches dans une ambiance conviviale pour un premier changement numérique.

    Avec l’appui du travail de défrichage de https://demailnagement.net

    [CA-QC Lévis] 5 à 8 Hybride Linux à Lévis – Le jeudi 16 juillet 2026 de 17h00 à 20h00.

    🐧 5 à 8 Hybride Linux à Lévis

    Une rencontre amicale pour échanger, apprendre et réseauter.

    Le comité organisateur des Rencontres Linux au Québec est heureux de vous inviter à une édition spéciale à Lévis ! À l’occasion du passage de Martial dans la région, nous organisons une rencontre en format 5 à 8 hybride.

    Que vous soyez un expert en administration système, un développeur chevronné ou simplement curieux de découvrir les alternatives libres, vous êtes le bienvenu !

    📅 Quand ?

    Jeudi 16 juillet 2026

    De 17h00 à 20h00

    📍 Où ? (Format Hybride)

    Vous avez deux options pour participer:

    En personne (Lévis):

    Nous nous retrouverons au restaurant Pacini de Lévis. Nous visons une ambiance propice aux échanges avec un accès à une salle privée et un écran pour partager des démonstrations techniques.

    En virtuel (BigBlueButton):

    Pour ceux qui ne peuvent se déplacer, la rencontre sera diffusée en direct sur notre plateforme de visioconférence libre.

    https://bbb3.services-conseils-linux.org/Rencontres-Linux

    📋 Au programme

    • Réseautage décontracté: Faites connaissance avec la communauté Linux locale.
    • Partage de trucs et astuces: Présentations informelles et entraide sur vos projets en cours.
    • Tirage au sort: Un prix de présence sera offert parmi les participants à la fin de la rencontre.

    👥 Qui peut participer ?

    Absolument tout le monde ! Nos réunions accueillent une grande diversité de profils: étudiants, professionnels, enseignants, retraités et curieux. L’objectif est de dynamiser la communauté Linux et de favoriser l’entraide dans une atmosphère conviviale.

    🎟️ Inscription obligatoire

    La participation est gratuite. Toutefois, l’inscription est nécessaire pour nous permettre de confirmer le nombre exact de places au restaurant.

    [FR Brest] Atelier d’été – Café vie privée – Le vendredi 17 juillet 2026 de 14h00 à 17h00.

    Un moment convivial sur le thème de la vie privée sur internet 🔒

    On discutera messagerie sécurisée, anonymat, et chiffrement autour d’un café ou d’un thé ☕

    Venez avec ou sans vos petits gâteaux, végane ou au beurre (salé) 🧈

    Entrée libre pour tout le monde.

    --

    Le local est accessible aux personnes à mobilité réduite

    Il y a des arceaux à vélo à proximité

    L’arrêt de bus le plus proche est: Cosmao Prétot, ligne 2B

    L’arrêt de tramway le plus proche est: Polygone

    [FR Antibes] Rencontre Accès Libre – Le vendredi 17 juillet 2026 de 18h00 à 21h00.

    Lors des rencontres accès libre, c’est l’occasion de:

    • discuter, échanger, expliquer;
    • installer des logiciels libres;
    • et, toute autre idée coopérative de solidarité à but non lucratif!

    Linux est un système d’exploitation complet, performant, stable et facile d’utilisation que nous vous aiderons à installer sur le média de votre choix (PC, clé bootable, etc.)

    [Internet] Pause Café Linux : Votre rendez-vous hebdomadaire – Le vendredi 17 juillet 2026 de 11h45 à 13h00.

    Pause Café Linux: Votre rendez-vous hebdomadaire

    Est-ce que Linux vous passionne ? Vous voulez simplement jaser de logiciels libres dans une ambiance décontractée ? Rejoignez-nous pour la Pause Café Linux, un rendez-vous unique dans la francophonie Linuxienne ! C’est le moment idéal pour briser l’isolement, partager vos découvertes et rencontrer d’autres passionnés de l’écosystème Linux au Québec.

    C’est quand ?

    Tous les vendredis midis (12h00 HAE, Québec).

    Apportez votre lunch, nous fournissons le café… virtuellement !

    Au programme

    • Discussion libre: Pas d’ordre du jour rigide, on parle de ce qui vous anime.
    • Tour de table rapide: Afin de mieux se connaître.
    • Le Brise-Glace: Une question thématique différente pour lancer la conversation.
    • Entraide et partage: Un espace bienveillant pour tous les niveaux, du débutant à l’expert.

    Comment participer ?

    • Échangez avec nous: Rejoignez notre canal de discussion sur Framateam pour vous présenter et rester informé. Rejoindre le canal Pause Café
    • Connectez-vous à la rencontre: Tous les vendredis midis, cliquez simplement sur le lien ci-dessous pour accéder à notre salon de visioconférence (BigBlueButton). Accéder au salon virtuel (BBB)

    Venez avec votre lunch, votre café, et surtout votre curiosité !

    La participation est gratuite, ouvert à tous!

    Notre réunion accueille une diversité de profils: étudiants, professionnels, gestionnaires, programmeurs, professeurs, ou retraités. Que votre passion soit l’administration système, le développement, ou la simple utilisation quotidienne, votre expérience est précieuse. Ensemble, nous pouvons approfondir notre compréhension des logiciels libres et contribuer à une communauté dynamique.

    Rejoignez-nous pour cette opportunité exceptionnelle de socialiser, d’apprendre, et de tisser des liens !

    Nous avons hâte de vous y accueillir.

    Le Comité organisateur des Rencontres Linux au Québec

    [FR Chaumont] Permanence Informatique – Le samedi 18 juillet 2026 de 09h00 à 12h00.

    REVOL, association engagée dans la promotion des logiciels libres, propose tous les samedis matin, de 9h à 12h, une permanence informatique associative ouverte à toustes, pour se pencher sur les difficultés rencontrées par chacun·e dans son usage de l’outil numérique.

    => Vous avez un problème avec votre ordinateur ?
    => Une question sur un logiciel libre ?
    => Envie de comprendre un peu mieux comment ça fonctionne ?

    On prend le temps avec vous, simplement.

    Nous pouvons vous accompagner sur:

    • le passage vers des systèmes libres (Linux Mint, MX Linux…)
    • l’installation et la prise en main de logiciels libres
    • la remise en état et la mise à jour de votre ordinateur (quand c’est possible)
    • des conseils pour mieux utiliser, sécuriser et prolonger la vie de votre matériel

    Et aussi… juste discuter (on a du café et des croissants).
    Que ce soit pour poser une question, réfléchir à vos usages ou découvrir le libre tranquillement.

    Pas besoin d’être expert·e: venez comme vous êtes.

    Nous sommes à notre local, 22 rue de Verdun à Chaumont (52000), en Haute-Marne.

    Un monde plus libre, loin des techno-fascistes, ça serait 🦉 quand même, non ?

    REVOL est là pour y contribuer !

    [FR Saint-Girons] Repair’Café aux ateliers de la liberté – Le samedi 18 juillet 2026 de 11h00 à 15h00.

    Un repair'café est organisé aux Ateliers de la liberté à Saint-Girons, mensuellement, l’avant-dernier samedi du mois, de 11h à 15h.

    Une équipe de bénévoles est présente pour aider au diagnostic d’objets (électroniques/électriques/mécaniques) cassés, pour comprendre leurs entrailles, guider sur leur réparation, ou animer des ateliers liés à la réparation.

    Si la réparation n’est pas possible, une aide est proposée pour trouver des solutions: changement de pièces (récupération, occasions, neuves), ou bidouillage pour donner une seconde vie à ces objets.

    En plus de la réparation, l’équipe peut vous aider à installer Linux sur votre machine ou à le dépanner, ainsi qu’à vous accompagner dans l’utilisation de logiciels libres.

    Il est conseillé de nous prévenir pour toute demande spécifique.

    Cet événement est ouvert à tous, que ce soit pour réparer un objet, pour du logiciel libre ou simplement vous renseigner, le tout gratuitement.

    [FR Quimperlé] Point info GNU/Linux – Le samedi 18 juillet 2026 de 13h30 à 17h30.

    Médiathèque de Quimperlé, place Saint Michel, pas d’inscription, entrée libre !

    Mickaël, Johann, Alain, et Yves vous accueillent (ou l’un d’eux, on se relaie !).

    Conseils, aide et infos pratiques GNU/Linux et Logiciels Libres.

    Curieux ? Déjà utilisateur ? Expert ? Pour résoudre vos problèmes, vous êtes le bienvenu ; pas besoin de prendre rendez-vous !

    N’hésitez pas à venir avec votre PC si vous voulez une installation de GNU/Linux ou de venir avec votre périphérique récalcitrant (imprimante, scanner…) si possible.

    [FR Nantes] Permanence Linux-Nantes – Le samedi 18 juillet 2026 de 15h00 à 18h00.

    Linux Nantes tient à vous informer de sa prochaine permanence. Nous vous proposons:

    • de vous faire découvrir Linux et les logiciels libres.
    • de vous aider à installer Linux sur votre ordinateur ou votre portable.
    • de vous informer sur l’utilisation de votre version de Linux et des logiciels libres.
    • de voir avec vous les problèmes rencontrés.

    Pour plus d’informations sur l’association: voir notre site.

    Pour des raisons pratiques, nous vous remercions de bien vouloir effectuer les sauvegardes de vos données personnelles avant de venir si une installation doit être effectuée.

    Avertissement ! Les permanences de Juillet 2026 seront les dernières avant les vacances estivales de Linux-Nantes. C’est également la dernière fois qu’elles se feront à B17 ; les suivantes auront désormais lieu au Pôle d’Activité Séverine (8 rue de Lorraine – 44000 Nantes)

    [FR Nîmes] Rencontre | Pique-nique du Libre – Le samedi 18 juillet 2026 de 17h00 à 20h00.

    Montpel’libre et ses partenaires vous proposent de nous retrouver toutes et tous, pour clore cette année très intense dans un esprit festif, à l’occasion d’un pique-nique aux Jardins de la Fontaine – 26 Quai de la Fontaine Nîmes. Où, les familles, enfants, curieux et bien sûr libristes sont les bienvenus.

    Ce pique-nique de fin d’année des libristes de toute la région est organisé pour boucler l’année dans la bonne humeur, évoquer les moments importants qui se sont déroulés dans l’année et ceux qui nous attendent à la rentrée.

    Les pique-niques de l’été

    Samedi 11 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Parc Rimbaud à Montpellier.
    Samedi 11 juillet 2026 à partir de 19h00, Wiknic (Cabalhérault), au Parc Rimbaud à Montpellier.
    Dimanche 12 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Plateau des Poètes à Béziers.
    Samedi 18 juillet 2026 à partir de 17h00, Pique-nique du Libre, aux Jardins de la Fontaine à Nîmes.
    Dimanche 19 juillet 2026 à partir de 17h00, Pique-nique du Libre, à Pierres Blanches à Sète.
    Dimanche 26 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Parc Jean Hugo à Lunel.

    Choisissez votre pique-nique. Mais bien sûr, vous pouvez participer à plusieurs pique-niques, voire à tous !
    L’été est là, bien installé, les oiseaux chantent, le soleil est au beau fixe, et vous souhaitez déjeuner entre amis sur l’herbe fraîchement coupée.

    Dès que l’on recommence à avoir des journées ensoleillées et chaudes, nous savons tous et toutes que la saison des pique-niques est arrivée ! Nous aimons, à n’en pas douter, absolument tout du concept des pique-niques: manger à l’extérieur sous le soleil ou à l’ombre des arbres, partager un repas convivial, simple, à la bonne franquette entre amis, avec la famille, profiter de la beauté de la nature qui nous entoure, prendre son temps et apprendre à ralentir et à reconnecter au moment présent le temps d’un repas.

    Même si l’été est déjà bien entamé, nous avons encore beaucoup de belles journées chaudes à venir et la chance de faire de nombreux pique-niques avant la fin de la saison estivale.

    Afin de favoriser l’échange et la convivialité, nous vous invitons à participer à ces repas partagés. Chaque participant est encouragé à apporter un plat fait maison (entrée, plat principal, dessert, fruits, boissons…) à partager avec les autres. C’est l’occasion de découvrir de nouvelles saveurs tout en échangeant des idées et des expériences autour, vous l’aurez deviné, des logiciels libres.

    Ces rencontres sont aussi l’occasion de discuter des projets communautaires, d’apprendre ensemble, et de promouvoir un mode de vie plus libre, collaboratif et respectueux de l’environnement. N’hésitez pas à apporter également des jeux de plein air ou des instruments de musique pour ajouter encore plus de convivialité et de bonne humeur à ces moments partagés en pleine nature que nous affectionnons tous et toutes.

    [CA-QC Vaudreuil-Dorion] Rencontres Linux au Québec – Le samedi 18 juillet 2026 de 11h00 à 14h30.

    En présentiel: Pacini

    Pour inscription et avoir le lien en virtuel: Cliquez ici

    Avis à tous les passionnés de Linux de la région de Vaudreuil-Dorion !

    Vous souhaitez rencontrer d’autres utilisateurs et experts des systèmes Linux et des logiciels libres ? Martial organise une rencontre conviviale autour d’un bon repas pour lier l’utile à l’agréable (de 11:00 à 14:30).

    Nous nous retrouverons dans un restaurant avec une ambiance propice à l’échange. Nous aurons accès à une salle privée avec un projecteur pour faciliter le partage de trucs et astuces et maximiser la discussion entre participants.

    Cet événement est l’occasion parfaite pour:

    • Réseauter et échanger avec la communauté locale de passionné(e)s.
    • Partager vos meilleures astuces, vos découvertes et vos projets sous Linux.
    • Apprendre des autres, peu importe votre niveau d’expertise.

    Il y aura quelques capsules éducatives Linux et on aura un échange de trucs et astuces sur Linux en groupe !

    Ouvert à tous, du débutant à l’expert

    Notre réunion accueille une diversité de profils: étudiants, professionnels, gestionnaires, programmeurs, professeurs, ou retraités. Que votre passion soit l’administration système, le développement, ou la simple utilisation quotidienne, votre expérience est précieuse. Ensemble, nous pouvons approfondir notre compréhension des logiciels libres et contribuer à une communauté dynamique.

    La participation est gratuite et un prix de présence seront offerts par tirage au sort à la fin de la rencontre !

    Rejoignez-nous pour cette opportunité exceptionnelle de socialiser, d’apprendre, et de tisser des liens ! Nous avons hâte de vous y accueillir.

    Comité organisateur des Rencontres Linux au Québec

    [FR Sète] Rencontre | Pique-nique du Libre – Le dimanche 19 juillet 2026 de 17h00 à 20h00.

    Montpel’libre et ses partenaires vous proposent de nous retrouver toutes et tous, pour clore cette année très intense dans un esprit festif, à l’occasion d’un pique-nique au Mont Saint-Clair, Pierres Blanches, 1205 allée Pierre Barthas, 34200 Sète. Où, les familles, enfants, curieux et bien sûr libristes sont les bienvenus.

    Ce pique-nique de fin d’année des libristes de toute la région est organisé pour boucler l’année dans la bonne humeur, évoquer les moments importants qui se sont déroulés dans l’année et ceux qui nous attendent à la rentrée.

    Les pique-niques de l’été

    Samedi 11 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Parc Rimbaud à Montpellier.
    Samedi 11 juillet 2026 à partir de 19h00, Wiknic (Cabalhérault), au Parc Rimbaud à Montpellier.
    Dimanche 12 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Plateau des Poètes à Béziers.
    Samedi 18 juillet 2026 à partir de 17h00, Pique-nique du Libre, aux Jardins de la Fontaine à Nîmes.
    Dimanche 19 juillet 2026 à partir de 17h00, Pique-nique du Libre, à Pierres Blanches à Sète.
    Dimanche 26 juillet 2026 à partir de 17h00, Pique-nique du Libre, au Parc Jean Hugo à Lunel.

    Choisissez votre pique-nique. Mais bien sûr, vous pouvez participer à plusieurs pique-niques, voire à tous !
    L’été est là, bien installé, les oiseaux chantent, le soleil est au beau fixe, et vous souhaitez déjeuner entre amis sur l’herbe fraîchement coupée.

    Dès que l’on recommence à avoir des journées ensoleillées et chaudes, nous savons tous et toutes que la saison des pique-niques est arrivée ! Nous aimons, à n’en pas douter, absolument tout du concept des pique-niques: manger à l’extérieur sous le soleil ou à l’ombre des arbres, partager un repas convivial, simple, à la bonne franquette entre amis, avec la famille, profiter de la beauté de la nature qui nous entoure, prendre son temps et apprendre à ralentir et à reconnecter au moment présent le temps d’un repas.

    Même si l’été est déjà bien entamé, nous avons encore beaucoup de belles journées chaudes à venir et la chance de faire de nombreux pique-niques avant la fin de la saison estivale.
    Afin de favoriser l’échange et la convivialité, nous vous invitons à participer à ces repas partagés. Chaque participant est encouragé à apporter un plat fait maison (entrée, plat principal, dessert, fruits, boissons…) à partager avec les autres. C’est l’occasion de découvrir de nouvelles saveurs tout en échangeant des idées et des expériences autour, vous l’aurez deviné, des logiciels libres.

    Ces rencontres sont aussi l’occasion de discuter des projets communautaires, d’apprendre ensemble, et de promouvoir un mode de vie plus libre, collaboratif et respectueux de l’environnement. N’hésitez pas à apporter également des jeux de plein air ou des instruments de musique pour ajouter encore plus de convivialité et de bonne humeur à ces moments partagés en pleine nature que nous affectionnons tous et toutes.

    [FR Frontignan] Café LINUX : adieu windows, bonjour Linux – Le dimanche 19 juillet 2026 de 18h00 à 20h00.

    Venez découvrir le système d’exploitation sous licence libre Linux grâce aux conseils et à l’accompagnement du Hacker Space du Bassin de Thau (association HSBT).

    Un moment convivial et gratuit à l’heure de l’apéro pour toutes les personnes qui souhaitent remplacer leur système d’exploitation Windows ou Mac par une solution alternative.

    La buvette de la Hune est ouverte pour l’occasion !

    Ouvert à toutes et tous, il suffit de savoir utiliser une souris sur un PC.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Portrait d’un membre de la communauté Scenari : Yves Vandermeer (ECTEG)

    Scenari est un ensemble de logiciels open source dédiés à la production collaborative, publication et diffusion de documents multi-support (Opale pour la formation, Dokiel pour la documentation, Optim pour les présentations génériques, Topaze pour les études de cas, Parcours pour créer des scénarios de formation, etc.)

    Aujourd’hui nous échangeons avec Yves vandermeer, basé en Belgique, coordinateur de l’European Cybercrime Training and Éducation Group (ECTEG).

    ECTEG est une association internationale sans but lucratif (AISBL), qui regroupe des services de police des États membres de l’Union européenne et de l’Espace économique européen ainsi que des organismes internationaux, des universités, des entreprises du secteur privé et des experts.

    Financés par des fonds de la Commission européenne, l’ECTEG développe des formations en cyber-criminalité et analyse technico-légale des traces informatiques mises à la disposition des entités de police et des magistrats des États Membres et au-delà, par nos partenariats avec Europol, Interpol, l’OSCE, UNODC et le Conseil de l’Europe.

    Comment as-tu connu Scenari ?

    Début 2017, à la création d’ECTEG, j’étais à la recherche d’un outil de développement de contenus de formation interactifs et collaboratifs. Par de la veille et des recherches sur internet, j’ai découvert Scenari et sa communauté. Rapidement, une première formation interactive a été développée et mise à la disposition des forces de police européennes.

    Actuellement vous utilisez quels modèles Scenari et pourquoi ?

    Nous avons à présent migré la presque totalité de nos formations en ligne et en présentiel sur Scenari, pour lesquelles nous utilisons Topaze pour créer des jeux sérieux et Dokiel en version anglaise. Notre expérience en Topaze a été présentée lors des Rencontres Scenari 2020.

    L’utilisation de Dokiel permet de développer des cours en ligne qui préparent aux cours en présentiel. Lors de ces cours des labos pratiques sont communiqués aux participants, souvent en PDF et les solutions ensuite revues en mode “diapositives”.

    Une utilisation spécifique de Dokiel a également permis de rédiger les scripts et la documentation de deux scenarios réalistes pour lesquels les traces ont été enregistrées en temps réel, permettant ainsi de développer des exercices qui ressemblent à des enquêtes réelles. L’utilisation des variables, par exemple, a permis de rédiger le script en ignorant le numéro de la plaque minéralogique de la voiture des suspects. Mise à jour au moment du tournage, cette variable a permis de créer une documentation précise et complète du matériel ainsi créé.

    Avec plus de quatre-vingts experts travaillant à distance depuis différents pays européens, les fonctionnalités collaboratives de Scenari se sont révélées uniques, et les évolutions du cœur et des différents modèles apportent toujours de nouvelles réponses aux besoins pédagogiques.

    Y a-t-il des fonctionnalités transverses de Scenari que vous utilisez à l’ECTEG ?

    Nous utilisons les ateliers dérivés pour permettre les traductions de contenu, désormais assistées par une IA interne, mais aussi pour les localiser afin de s’adapter aux législations et pratiques qui différent pays à l’autre et pour certains cours sur d’autres continents. À titre d’exemples, un cours sur l’analyse des virus informatiques a récemment été traduit en espagnol pour former les spécialistes en Amérique du Sud et une version modifiée d’une autre formation adaptée pour la formation des autorité judiciaires, procureurs et juges.

    Quelle est votre implication dans la communauté ?

    Après une petite dizaine d’années d’utilisation de Scenari, il est devenu l’un de nos outils principaux et nous travaillons, avec l’aide de l’Association Scenari et de Kelis, au développement de nouvelles fonctionnalités pour répondre aux besoins exprimés par les utilisateurs et faciliter le déploiement des formations dans l’Union européenne et dans des pays tiers, bien sûr en Ukraine mais également en Asie et en Amérique du Sud.

    Quels projets avec Scenari prévoyez-vous dans le futur ?

    Ajouter la réalité virtuelle et améliorer l’intégration des cours développés sur des plateformes de formation comme Moodle sont quelques-uns de nos projets pour les mois à venir. Il est aussi important que ces développements soient mis à la disposition de la communauté Scenari.

    À combien estimes-tu le nombre de personnes ayant consulté vos productions faites avec Scenari ?

    Une de nos formations, entièrement en ligne et interactive qui comporte à ce jour six jeux sérieux est développée par une trentaine de policiers experts, cinq procureurs et une juge d’instruction. L’équipe interne d’ECTEG apporte son soutien pour les fonctionnalités avancées et la cohérence pédagogique. Ce cours a permis de former environ 1500 premiers intervenants mais s’implémente petit à petit dans les différents pays. Pour d’autres cours, techniquement plus avancés, environ 500 praticiens en analyse technico-légale les ont déjà suivis. Ce n’est qu’un début, pour la formation destinée aux premiers intervenants le public visé en Europe est de plus d’un demi-million de policiers, dès qu’elle sera disponible dans chacune des langues officielles.

    Merci Yves !

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Les raccourcis, du 3270 à AutoHotKey en passant par Clavier+

    Je travaille depuis plus de vingt ans sur site central (mainframe), et ça fait quasiment autant de temps que ma marotte, c'est me faciliter la vie au travail en automatisant le plus possible les actions répétitives.

    Vous me direz rien de bien nouveau, c'est l'essence même de l'informatique…

    Certes, mais je me rends compte qu'il existe tout un univers plutôt confidentiel à mon sens qui gravite autour l'aménagement de ses propres raccourcis clavier.

    Sommaire

    Un peu d'historique

    Comme déjà écrit, je travaille sur site central, et pendant longtemps, ça voulait dire utiliser un émulateur 3270 (même si ça sert encore beaucoup pour les tâches d'administration, Eclipse et VSCode sont de plus en plus présents, notamment pour développer). C'est un logiciel qui simule un terminal passif (qui se contente d'afficher un écran, et de réagir au clavier, point barre - mais qui dispose du 24 touches fonction physiques), et qui dispose de fonctionnalités « modernes », tel le copier-coller (oui, oui, point de copier-coller sur terminal passif).
    Ce qu'il y a de chouette avec un émulateur, et ça rejoint (enfin) le sujet de cette dépêche, c'est que ça permet de lancer des séquences de frappes de touche.

    Menu principal d'ISPF

    Prenons comme exemple l'affichage d'une table de paramétrage, pour afficher le contenu d'une table il faut :

    • Appuyer sur la touche ECHAP (qui efface l'écran)
    • Taper X RCD071
    • Valider avec Enter
    • Saisir le nom de la table de paramétrage
    • Interroger son contenu avec PF3

    L'émulateur permet de lancer des séquence de touches de plusieurs manières :

    • à l'aide d'un raccourci clavier ;
    • à l'aide d'un pad, ensemble paramétrables de boutons auxquels on peut associer des actions, dont une séquence de frappes de touche. C'est là que ça commence à devenir intéressant, je vais y revenir.

    En reprenant l'exemple du listage d'une table de paramétrage, je peux facilement associer le listage de la table1 à un raccourci, et celui de la table2 à un autre.

    Problème de place

    Et c'est là qu'on s'aperçoit vite des limites des raccourcis claviers : leur nombre est forcément limité, d'autant plus que bon nombre de combinaisons sont déjà prises : il est illusoire de vouloir se passer de CTRl+C et de CTRL+V par exemple.
    L'autre problème est celui de la mémoire, pas celle du PC, mais celle de celui ou celle qui est derrière le clavier : pas facile de mémoriser toutes ces combinaisons.

    Le pad

    J'ai gardé pour maintenant cette histoire de pad : mais qu'est-ce que ça apporte ? Et bien ça « libère » de la mémoire : la vocation du raccourci est disponible sous les yeux, et ça, j'achète !

    Moyennant un petit travail de classification en sous-groupes, je retrouve facilement tous mes raccourcis en un clin d'œil.
    Mais n'avoir à disposition que des boutons, est-ce suffisant ?
    Pas vraiment, parce que libellé d'un bouton, c'est statique.

    Le cas Pacbase

    PACbase est un AGL (NdM: propriétaire) générant du COBOL, intégrant un dictionnaire de données. On y stocke :

    • des données ;
    • des structures de données ;
    • des programmes ;
    • des textes pour la documentation ;
    • etc.

    Ce qui est important pour le sujet que j'évoque que la navigation dans ce référentiel est entièrement textuelle, on accède aux entités au travers d'une ligne de commande :

    • j'affiche la donnée toto en tapant E toto ;
    • j'affiche la documentation de donnée toto en tapant e toto gc (ou si je suis déjà en train de consulter la donnée toto en tapant -gc) ;
    • j'affiche un programme titi en tapant p titi, sa documentation en tapant p titi gc
    • etc.

    C'est là qu'on s'aperçoit de limite des boutons (même si c'est mieux que les raccourcis) : pas question de créer autant de boutons que d'entités à accéder.

    L'invite de commande « universelle »

    Il se trouve que l'interface principale du site central (hors applications métiers) qui s'appelle ISPF (NdM: propriétaire) est également textuelle est qu'elle possède également une ligne de commande.

    J'ai donc cherché à mettre au point une interface dans laquelle je taperai mes commandes, qui seraient mémorisées et qui, à l'instar du comportement d'un terminal, faciliterait le rappel de commandes.

    Au passage, j'ai écrit une macro « universelle » qui permet d'interagir de manière scriptée avec l'émulateur, en utilisant un pseudo langage très basique, mais permettant des actions reproductibles : saisie de paramétrage (permettant une « saisie » d'environnement en environnement), réinitialisation de mot de passe avec envoi de courriel avec les mots de passe provisoire, etc.

    Je me suis appuyé sur différents modules proposés par l'émulateur 3270, avec comme limites l'univers site central. Or il se trouve que j'avais envie d'automatiser plein d'autres actions sur d'autres logiciels (comme lancer les règles dans Outlook par exemple).

    Les logiciels de raccourcis sous Windows

    Clavier+

    C'est alors que j'ai découvert :

    • Clavier+ (GPLv3), un logiciel libre qui a la bonne idée de pouvoir être lancé en ligne commande avec une documentation tout en français ;
    • les pages HTA, qui sont des fenêtres écrites en HTML / Javascript / CSS.

    Clavier+

    J'écris mes pads en HTA, avec des liens qui lancent des actions via Clavier+. Et là, c'est quasi parfait : je paramètre Clavier+ pour lancer une fenêtre HTA quand je tape sur la touche PAUSE (facile d'accès et peu utilisée en standard) qui m'affiche des boutons d'actions et des invites de commandes, fenêtre qui se masque une fois l'action lancée et que je rappelle en rappuyant sur PAUSE. J'ai donc Clavier+ qui lance une fenêtre qui permet de lancer plein d'actions via Clavier+. Pas toujours facile de s'en sortir avec du Javascript pas toujours reconnu dans ses dernières fonctions pourtant bien pratique, et surtout, pas simple de gérer la persistance des données, même si je m'en suis sorti à l'aide de cookies.

    AutoHotKey

    Je change d'entité dans le groupe qui m'emploie, et patatras, pas de Clavier+ dans le centre logiciel ! Je me lance dans une demande d'intégration de Clavier+, demande qui traîne, et voilà que je découvre que si Clavier+ n'est pas proposé, c'est qu'à sa place figure AutoHotKey (GPLv2)
    Exemple de GUI AHK

    \o/ : apothéose : Autohotkey (AHK), c'est clavier+ puissance 1 000 ! Ça gère les raccourcis — heureusement —, mais aussi et surtout les interfaces graphiques, les fichiers, etc. C'est très puissant, mais la documentation — tout en anglais — est parfois un peu absconse (Clavier+ c'est juste génial à ce niveau).

    Fonctionnalités communes

    • Activation d'une fenêtre par son titre
    • Restriction de l'usage d'un raccourci à une fenêtre donnée (via son titre)
    • des configurations séparables par fichiers

    Ce qu'apporte AHK

    • les interfaces graphiques
    • interaction avec le système de fichiers
    • la superposition des configurations
    • et beaucoup plus encore

    En résumé

    Pour celles et ceux qui souhaitent découvrir comment facilement paramétrer des raccourcis claviers, Clavier+ et fait pour vous. Pour aller (beaucoup beaucoup) plus loin AutoHotKey ouvre tout un univers de possibilités.

    PS

    Quelque raccourcis que j'utilise tout le temps

    • rappel des commandes passées (PACbase et ISPF)
    • lancement des règles sous Outlook
    • recherche des erreurs de compilation COBOL sous VScode
    • configuration et tri des SYSOUT sous SDSF

    Tip

    Ne pas rager pas si votre tout dernier raccourci ne fonctionne pas avec Clavier+ : vous avez certainement laissé la fenêtre de configuration ouverte…

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Kernel Recipes 2026 – 13e édition : c'est reparti !

    Nous sommes fiers de vous annoncer la 13ᵉ édition de Kernel Recipes. Elle aura lieu du 21 au 23 septembre 2026 à Paris, à la Fondation Biermans-Lapôtre, 9A boulevard Jourdan dans le 14ᵉ, RER Cité universitaire. Comme les années précédentes, une vingtaine d’interventions autour du fonctionnement de la communauté, des outils, de Rust, de la sécurité… et, pour la première fois (mais de façon raisonnée), de l’IA appliquée au développement noyau.

    Le parrain de cette édition : Jonathan Corbet

    Cette année, nous avons l’immense honneur d’accueillir Jonathan Corbet en tant que parrain de l’édition. Rédacteur en chef de LWN.net et observateur privilégié du développement du noyau depuis des décennies, il a participé grandement à la construction du programme – autant dire que l’édition s’annonce très bien !

    Logo

    Les conférences : variées, avec un peu d’IA, du Rust, de la sécurité, des outils…

    Le programme mêle, comme d’habitude, mainteneurs historiques et nouvelles têtes :

    • Steven Rostedt revient sur les coulisses peu glorieuses des futex (Futex: The good, the bad and the ugly! (mostly ugly)) ;
    • côté Rust, Miguel Ojeda fait le point sur Rust for Linux et Danilo Krummrich (Red Hat, fondateur du driver Nova pour GPU NVIDIA) détaille comment imposer à la compilation les règles de cycle de vie des drivers ;
    • côté sécurité, Marta Rybczynska se demande si Linux est enfin secure by default, et Greg Kroah-Hartman abordera la sécurité à l’ère des LLM ;
    • côté outils, on retrouve Patrick Steinhardt (GitLab) sur l’actualité de Git, Konstantin Ryabitsev sur l’infrastructure kernel.org, et Matthieu Baerts sur MPTCP ;
    • côté ordonnancement et mémoire, SeongJae Park présente DAMOS, Changwoo Min et Gavin Guo (Igalia) parlent de leur ordonnanceur BPF LAVD, Victor Laforet (Inria) de verrouillage et ordonnancement, et Roman Guschchin de la gestion mémoire des cgroups ;
    • et bien sûr, Martin Uecker, Arnd Bergmann, Detlev Casanova (Collabora) et d’autres viendront compléter ce menu copieux.

    Et la fameuse touche IA, justement : oui, le sujet est au programme cette année, mais on est resté raisonnable :

    • Greg Kroah-Hartman, « You are holding it wrong! » : comment obtenir d’un LLM un correctif de bug réellement valide, ce qui marche, ce qui ne marche pas, et pourquoi la plupart des gens s’y prennent mal ;
    • Roman Guschchin, The Sashiko review system : un système de revue de patchs assisté par IA, conçu spécifiquement pour le noyau, qui aurait détecté plus de la moitié des bugs dans un corpus de 1000 correctifs historiques ayant pourtant passé la revue humaine.

    Deux conférences, une seule vraie question : à quoi ressemble l’outillage assisté par IA quand il se confronte à la rigueur du développement noyau ?

    Comme chaque année, Kernel Recipes organise ses enchères caritatives ! Cette année, nous avons souhaité mettre à nouveau en lumière le travail de la Software Freedom Conservancy. Bradley Kühn interviendra sur ce sujet le 22 septembre, juste avant le lancement des enchères.

    Dans la salle

    Frank sera bien sûr de la partie pour croquer sur le fait les orateurs et oratrices, mais aussi participants, perpétuant une tradition désormais incontournable de la conférence.

    Notre mascotte est en train de se faire une beauté et devrait apparaître prochainement dans de nouveaux habits.

    Mascotte

    Sponsors

    La conférence ne pourrait pas avoir lieu sans nos sponsors. Ils nous supportent en 2026 : Meta, ARM, PremDay, Jump Trading, HaProxy, Igalia, Collabora et d’autres à venir très bientôt.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Estampille : l'outil de gestion de tests ultra léger.

    Voici Estampille. Estampille vise à remplacer les fichiers tableurs partout où l’installation d’une suite complète de tests (Squash, HPALM…) n’est pas possible. Il est distribué sous licence GNU GPL.

    Cet outil permet de rédiger des cas de test composés de pas de tests. Il permet d’exécuter manuellement ces cas de test autant de fois que nécessaire. Un cas de test peut être appelé dans d’autres cas de tests pour factoriser la rédaction des cas. Les résultats d’exécution sont exportables sous forme de dossiers PDF.
    Enfin une page de statistiques offre une vue générale de l’avancement des tests.

    Contrairement aux suites logicielles de tests existantes, Estampille n’a pas besoin de base de données, ni de serveur dédié. Les tests et exécutions de tests sont stockées sous la forme de fichiers JSON partageables facilement ; que ce soit par courriel, répertoire réseau partagé, synchronisation cloud, etc.

    Cet outil ultra léger (<300 ko tests unitaires compris) est écrit en python et utilise flask pour présenter l’interface graphique sur le navigateur web. Il fonctionne indifféremment sous Linux ou Windows.

    Voilà déjà la fin d’une dépêche courte pour un outil simple qui répond à un besoin concret.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Amnesty International France et la LDH - « Libre à vous ! » du 2 juin 2026 - Podcasts et références

    Deux-cent-soixante-dix-septième émission « Libre à vous ! » de l’April. Podcast et programme :

    • sujet principal : Quand les organisations de défense des droits humains se saisissent des enjeux numériques, avec Katia Roux, chargée de plaidoyer « technologie et droits humains » pour Amnesty International France et Maryse Artiguelong, coresponsable du groupe de travail « Libertés et technologies de l’information et de la communication » pour la Ligue des Droits Humains
    • La suite de Lectures buissonnières de Vincent Calame, sur l’ouvrage d’Isabelle Collet « Le numérique est l’affaire de toutes ».
    • Un nouvel épisode de À cœur vaillant, la voie est libre de Laurent et Lorette Costy : « Retex Ipsum Lorette »

    Rendez‐vous en direct chaque mardi de 15 h 30 à 17 h sur 93,1 FM en Île‐de‐France. L’émission est diffusée simultanément sur le site Web de la radio Cause Commune.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Revue de presse de l’April pour la semaine 23 de l’année 2026

    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

    [Les Numeriques] Ce navigateur open source ferme ses contributions, le code généré par IA sème trop le chaos

    ✍ Nassim Chentouf, le dimanche 7 juin 2026.

    Le code généré par IA sème le chaos chez Ladybird, navigateur open source. Résultat, c’est la fin des contributions extérieures. Il n’y aura que les responsables du projet qui pourront toucher au code.

    [Le Monde.fr] L’association HOP obtient un procès contre le fabricant d’imprimantes Epson

    Le mardi 2 juin 2026.

    Une première audience aura lieu à Nanterre le 2 juillet, huit ans après la plainte déposée par Halte à l’obsolescence programmée (HOP). L’association reproche notamment au constructeur de réduire à dessein la durée de vie de ses cartouches d’encre.

    [Les Numeriques] 'Argent public, code public': le logiciel libre devient prioritaire, l'Europe veut en finir avec Microsoft dans ses administrations

    ✍ Aymeric Geoffre-Rouland, le lundi 1 juin 2026.

    La Commission européenne élève le logiciel libre au rang d’instrument de politique industrielle, au même titre que les semi-conducteurs. Le CNLL salue l’ambition, mais pointe un budget qui frise l’anecdotique.

    Et aussi:

    [ZDNET] La sécurité open source est dans un état déplorable: IBM et Red Hat parient que 5 milliards de dollars et 20 000 ingénieurs pourront y remédier

    ✍ Steven Vaughan-Nichols, le lundi 1 juin 2026.

    Le projet Lightwell est une initiative basée sur l’IA visant à détecter et à corriger les failles de sécurité dans les logiciels libres à une échelle industrielle. Voici ce que nous savons à ce jour.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Veille communautaire sur des intelligences artificielles du mois d'avril 2026

    La série de dépêches de LinuxFr.org sur la veille concernant des intelligences artificielles reprend et adopte une nouvelle formule.

    Cette première dépêche de la série reprend donc l’initiative de valoriser les contenus des contributrices et contributeurs de LinuxFr.org en rapport avec des IA tels que les dépêches, journaux et liens. L’ajout des synthèses de la plupart des articles de presse et des contributions de la communauté LinuxFr.org pourrait être envisagé à terme, selon les disponibilités des bénévoles.

      Sommaire

      Avant-propos

      Cette dépêche est dédiée à la veille sur des intelligences artificielles1 faite par des contributions communautaires sur des contenus de LinuxFr.org et reprend une partie de l’initiative amorcée par la série « Nouvelles sur l’IA »2 qui s’est arrêtée le 6 avril 20263 4.

      Comme recenser au fil de l’eau du contenu communautaire pertinent demande un travail conséquent pour la rédaction de la dépêche, la décision de continuer la série sous une nouvelle formule a été faite à la vue des résultats d’un sondage publié le 1er mai 2026.5 6 7

      Méthodologie de sélection des contenus communautaires

      Comme dans la précédente série des « Nouvelles sur l’IA », les contenus communautaires sont répertoriés selon ces deux critères :

      • La présence d’une étiquette intelligence_artificielle8 (indication d’un rapport avec le thème de la dépêche)
      • Un score strictement supérieur à zéro au moment du recensement

      Certains contenus non recensés en raison du second critère peuvent être visualisés en s’aidant de la recherche par étiquette8.

      Quelques statistiques sur les contenus retenus

      Du 1er avril au 30 avril, les contenus retenus sont:

      • 5 dépêches
      • 14 journaux
      • 34 liens

      Au total, 53 contenus répondant aux critères de sélection sont recensés dans la présente dépêche.

      Une sélection des contenus par thème

      Les thèmes ci-dessous sont proposés pour aider des lectrices et des lecteurs à retrouver les contenus qui les intéressent. Les thèmes sont pour le moment suggérés manuellement par des contributrices et des contributeurs à la dépêche.9

      Revues de presse

      Les revues de presse de l'April de l'année 2026 mentionne l'IA sur les dépêches suivantes :

      Podcasts

      Le podcast CPU a évoqué des sujets en rapport avec l'IA dans les journaux suivants :

      Jeux vidéos

      Une dépêche intitulée Le jeu vidéo destiné à devenir de moins en moins libre et performant ? illustre l'utilisation de l'IA dans le rendu des jeux vidéos récents.

      Économie et droit

      Les contenus en rapport avec l'économie et le droit sont les suivants :

      Journaux

      Liens

      Santé

      Les liens indiquant le rapport entre la santé en général et des IAs sont les suivants :

      Environnement

      Les liens soulignant les impacts environnements de l'IA sont les suivants :

      Retour d'expérience

      Un journal fait état d'un retour d'expérience sur des IAs génératives chargées d'une tâche en programmation : Comparatif : 6 LLMs locaux face à un exercice Python simple

      Poissons du 1er avril

      Comme toute bonne tradition qui se respecte depuis des années sur LinuxFr.org (à l'exception notable de l'année 2023), la communauté a proposé ses propres poissons dans les journaux suivants :

      Annexe : contenus recensés par ordre chronologique

      Ci-dessous sont rassemblés des contenus sélectionnés dans l'ordre chronologique, dont une partie qui n'ont pas été classés parmi les thèmes.

      Dépêches

      Journaux

      Liens


      En complément, afin de remercier les lectrices et lecteurs qui ont pu prendre connaissance de l'ensemble de la dépêche, nous vous proposons la montée de l'IA (pour "Intelligence Aviaire") vue par Cepper, une cousine germaine de Pepper10 11 :


      1. Le terme "intelligence artificielle" regroupe en fait plusieurs définitions qui n'ont pas toujours fait consensus. Voir la page wikipédia sur leur définition et les techniques associées pour plus de précisions. 

      2. L'ensemble des "Nouvelles sur l'IA" sont accessibles avec le tag dédié nouvelles_sur_l_ia 

      3. La dernière dépêche de la série est consultable sur https://linuxfr.org/news/nouvelles-sur-l-ia-de-mars-2026 

      4. Le contributeur Moonz< a motivé son arrêt de la série de dépêche par le commentaire https://linuxfr.org/news/nouvelles-sur-l-ia-de-mars-2026#comment-2018598 

      5. Au 9 mai 2026 à 15h23 CEST, 58.3 % de vote sont favorables à la reprise de la série; 15.1 % de votes défavorables, 9.4 % de votes indécis, et 17.2 % de votes "pas vraiment sérieux". Pour plus de détails, voir la capture d'écran. 

      6. Sur les 58.3 % de votes favorables à la reprise de la série, 69.9 % de votes viennent pour la réponse "Oui, même en l'absence de la synthèse des articles" et 30.1 % de votes pour la réponse "Oui, à condition de continuer la synthèse d'une partie des articles". 

      7. Le lien du sondage est https://linuxfr.org/sondages/continuer-a-publier-une-serie-de-depeche-dediee-a-la-veille-generale-sur-des-intelligences-artificielles 

      8. Le lien de recherche par le tag dédiée est https://linuxfr.org/tags/intelligence_artificielle/public 

      9. La présente dépêche ne fait pas appel à des grands modèles de langage à cause de l'impopularité de ces outils parmi le public de LinuxFr.org pour la rédaction des articles. Voir le sondage suivant pour se faire une idée : https://linuxfr.org/sondages/faut-il-accepter-les-contenus-generes-par-ia-sur-linuxfr-org 

      10. Un personnage provenant de la BD en ligne libre https://www.peppercarrot.com/fr/ 

      11. Des informations détaillées concernant la BD originelle sont consignées sur https://fr.wikipedia.org/wiki/Pepper%26Carrot 

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      GPX2Video - GPS & Vidéo

      Je vous ai fait part il y a quelque temps de mon petit projet de réaliser un logiciel sous Linux pour effectuer mes petits montages vidéos et y insérer les données de télémétrie (issues du GPS de la caméra ou d’un GPS externe).

      Le journal publié à l’époque que vous pouvez consulter ici.

      Où le projet en est-il ?

      Le projet est réalisé en trois temps :

      1. Tout d’abord un outil en ligne de commande. L’utilisateur effectue la mise en page via un fichier XML, puis lance l’outil en fournissant en paramètre : la vidéo, le fichier de XML et un fichier GPX.
      2. Puis dans un deuxième temps une interface graphique pour effectuer la mise en page et exporter le résultat au format XML afin d’être utilisé par l’outil en ligne de commandes.
      3. Et enfin de tout réaliser directement via l’interface.

      Bien sûr il y a encore beaucoup de travail et d’optimisation à faire ; mais c’est utilisable. Les sources sont maintenant disponibles.

      L’interface est en cours de développement. Le projet étant en C++, l’interface est basée GTK4++. La visualisation du rendu peut être faite en temps réel.

      Interface utilisateur en GTK4++

      Les testeurs et testeuses sont les bienvenus.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      Nouvelle version du Bureau Agnostep pour les 35 ans de GNUstep

      Comme vous le savez sans doute, cette année est marquée par les 35 ans de GNUstep, qui est à la fois un cadre logiciel qui permet de développer en objective-C des applications portables sur Windows, MacOS et GNU/Linux, mais aussi un environnement d’exécution (runtime) de ces mêmes applications.

      Plusieurs projets de bureau compatibles avec GNUstep existent depuis quelques années: après les défunts Simply-GNUstep et Étoilé, citons les actifs GSDE développé par Ondrej Florian ou encore le plus ambitieux NEXTSPACE de Sergii Stoïan, qui tend à reproduire fidèlement l’ergonomie d’OPENSTEP sur BSD ou GNU/Linux. Plus récemment, dans un style plus proche de MacOS, citons également les prometteurs bureaux Gershwin (pour Xorg) ou Ambrosia (pour Wayland) développé par James Carthew.

      Le bureau Agnostep propose sa version BETA 2.0.0, dans un style plus classique, avec des menus verticaux à la NeXT, combinant Window Maker et GWorkspace, ainsi que le runtime classique de GNUstep.

      Il n’en propose pas moins un thème moderne inspiré par le jeu d’icônes du projet Papirus. Bien que fondé sur une distribution Debian Lite, il ne fournit pas de paquets, mais un principe d’installation proche des ports BSD. Un assistant facilite l’installation initiale comme l’ajout d’applications supplémentaire afin de fournir les versions les plus récentes des applications de la communauté GNUstep, compilées depuis les sources. En effet, contrairement à d’autres projets qui divergent parfois tellement des sources originales, qu’il devient impossible de les reverser dans le lot commun, la philosophie d’Agnostep est d’échanger patiemment avec la communauté des développeurs afin que les problèmes constatés et les améliorations bénéficient à tout le monde.

      De plus, ayant résolu certains problèmes de la version précédente, il présente une meilleure stabilité. Outre les applications notoires de l’écho-système GNUstep, comme GNUMail, SimpleAgenda, etc., il offre également une nouvelle collection d’applications GNUstep originales créées dans ce but afin de proposer une expérience utilisateur plus cohérente:

      • Meteo.app : une application dockée qui affiche aussi la date courante. Basée sur l’API wttr.in API d’Igor Chubin.
      • UpMem.app : affiche la durée d’exécution l’usage de la mémoire.
      • Updater.app : une application dockée avec un badge de notification pour alerter en cas de paquets Debian susceptibles de mise à jour. Ce qui permet aussi d’effectuer la mise à jour effective à partir de la liste affichée de ces paquets
      • Birthday.app : une application dockée avec un badge pour informer des événements familiaux. Un incontournable pour le grand-père de nombreux petits-enfants.
      • OpenDisk.app : ouvre les dossier media où sont montés les disques amovibles : un compagnon de wmudmount et de udisks2, en se dispensant d’afficher le bureau de GWorkspace.
      • Launcher.app : un moyen rapide d’afficher le dossier des applications dans une nouvelle fenêtre.
      • ScreenLock.app : un simple verrouilleur d’écran fondé sur xtrlock.
      • Pass.app : une interface GNUstep au programme Unix Password Manager donnant accès au coffre local des mots de passe.
      • Mixer.app : une version simplifiée et compatible ALSA du mixer dérivé de VolumeControl.
      • AgnostepManager.app : un assistant dans la compilation et l’installation d’applications supplémentaires : applications courantes, utilitaires, jeux, outils de développement.
      • Dico.app : un service et un outil de recherche dans un Dictionnaire français fondé sur le DVLF de l’Université de Chicago.
      • SaveLink.app : un gestionnaire de raccourcis Internet. Voyez le dossier des Favoris.

      À partir de cette version, les manuels d’aide (format .help) seront fournis avec chaque application concernée grâce aux améliorations récentes de l’application HelpViewer. Autre exemple qui illustre les fructueux échanges avec la communauté.

      Bureau Agnostep en version 2

      Agnostep est initialement développé sur un Raspberry Pi 500, mais son code permet de l’installer sur n’importe quel ordinateur susceptible d’accueillir la distribution GNU/Linux Debian : d’où son nom. Agnostep est un téléscopage de agnostique et GNustep.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      LibreOffice 26.2 : Markdown, accessibilité et plein d’autres nouveautés et améliorations

      En février, il y a la corvée commerciale de la Saint-Valentin et les réjouissances intellectuelles consécutives à la sortie d’une nouvelle version de la suite bureautique LibreOffice. C’est, bien évidemment, sur LibreOffice 26.2 que l’on va se pencher. Au menu, du très visible, comme les boites de dialogues, du très attendu comme la prise en compte du Markdown ou du moins visible comme le travail sur l’accessibilité.

      Il va de soi que les notes de version sont plus exhaustives et qu’il ne s’agit ici que d’une sélection.

      Logo de LibreOffice

      Sommaire

      Avant de commencer : toutes les captures d’écran ont été faites, volontairement, sur une interface très personnalisée.

      L’accessibilité

      L’accessibilité de la suite bureautique est un important chantier pour lequel une personne a été recrutée en 2023 (en). Cette version-ci a fait l’objet d’améliorations sensibles. Parallèlement, Sophie Gautier, coordinatrice de The Document Foundation1 (Foundation coordinator) est en train de monter un groupe de travail qui a pour objectif la publication d’un rapport de conformité en matière d’accessibilité pour répondre à la norme européenne EN 301 549 (en) d’accessiblité numérique. La langue de travail de ce groupe est l’anglais.

      Concernant les améliorations de cette version :

      • la boite de dialogue « Vérifier les mises à jour », Aide > Vérifier les mises à jour… est devenue accessible aux lecteurs d’écran ;
      • les fonctions d’accessibilité des aperçus des bordures, onglet « Bordures » des boites de dialogue, ont été revues afin qu’elles ne perturbent plus les dispositifs d’assistance ;
      • sur Linux : la boite de dialogue Outils> Orthographe est annoncée correctement par le lecteur d’écran ;
      • quand on supprimait la sélection accessible, le curseur se déplaçait automatiquement au début du texte, ce comportement perturbant est supprimé ;
      • dans Writer, les fautes d’orthographe ne sont plus signalées par les dispositifs d’assistance si la vérification orthographique n’est pas activée ;
      • l’accessibilité au clavier de la boite de dialogue des extensions : Outils >  Extensions est accessible aux lecteurs d’écran ;
      • et enfin, il est possible de naviguer entre les onglets verticaux avec des raccourcis clavier.

      Support du Markdown

      Le Markdown est devenu le format de balisage léger standard « de fait ». Et c’est celui supporté par LinuxFR. Son support a été introduit dans cette version, c’est un des formats d’enregistrement qui s’est ajouté à la série des autres formats de la suite, pas un format d’export. Pour l’utiliser pour vos sites, passant pour LinuxFR, vous devrez :

      • soit ouvrir le fichier .md dans un éditeur de texte, n’importe lequel, même Mousepad fait l’affaire par exemple, et copier-coller ensuite le tout à partir de l’éditeur de texte là où vous le voulez ;
      • soit, si cela est possible, importer le fichier .md dans ce qui vous sert pour gérer le site comme le fait par exemple l’extension ODT2SPIP pour le système de gestion de contenu SPIP qui permet de créer une nouvelle page dans SPIP avec un fichier.ODT.

      Comment ça marche avec LinuxFR ? Plutôt bien. Les styles de caractère Accentuation (ici en italiques) et Accentuation forte (ici gras) sont bien reconnu ainsi que Texte source pour « télétype », les indications in-texte encadrées de l’accent grave U+0060. Les styles de paragraphes :

      • Bloc de citation (paragraphes de citation précédés d’une ligne blanche et du signe « > » dans la saisie de contenu sur LinuxFR) ;
      • Contenu de tableau ;
      • Corps de texte ;
      • Liste, par contre la numérotation des listes ordonnée ne semble pas bien fonctionner, il faut saisir les numéros à la main ;
      • Texte préformaté pour écrire des blocs de code ;
      • Titre 1, Titre 2, Titre 3 et Titre de tableau.

      Les tableaux sont bien repris ainsi que les liens insérés via l’insertion d’hyperliens.

      Ce qui ne semble pas fonctionner du tout : ce sont les notes, elles disparaissent corps et biens. C’est peut-être dû au passage dans l’éditeur de texte qui transforme un peu le document. Et, évidemment, il faut rajouter les images avec la syntaxe LinuxFR.

      Petite remarque, si vous utilisez un LibreOffice 25.8, vous avez peut-être pu constater qu’il était question d’enregistrement au format .md, cette information a été ajoutée trop précocement car la version 25.8 ne gère pas le Markdown.

      L’interface et les boites de dialogue

      Les boites de dialogue, notamment de styles et de formats, ont beaucoup changé. Longtemps elles se sont affichées avec une présentation par onglets en haut et le contenu dessous.

      Puis il y a une période de transition en 2025 qui a fait grincer une collection complète de dents où on avait, selon l’endroit où on était, soit des onglets soit une navigation par menu latéral. Cette dernière avait un gros défaut : par exemple pour la configuration des styles dans Writer il fallait descendre tout en bas pour accéder aux options qui étaient cachées. Et il n’y avait pas de barre de défilement pour aller plus vite.

      LibreOffice 26.2 voit ces défauts corrigés : les boites de dialogue sont harmonisées dans toute la suite et leur menu latéral, toujours sans barre de défilement qui s’avère finalement inutile, montre clairement tous les types de paramètres auxquels on peut accéder. Et, comme on peut le voir, LibreOffice a intégré une meilleure prise en charge des systèmes d’écritures asiatiques et complexes en affichant deux colonnes, une pour les polices occidentales, ou pour les polices asiatiques ou complexes. Une personne a également été recrutée en 2023 (en) pour travailler sur le support des systèmes d’écriture de droite à gauche (RTL) et complexes (CTL).

      Boite de dialogue Style de paragraphe avec la navigation par onglets à gauche, puis les deux colonnes de choix de police, occidental ou asiatique ou complexe

      Si toutefois, vous préférez revenir à l’affichage avec les onglets, il suffit d’aller dans le menu Outils > Options > Apparenceau niveau de « Boites de dialogue » et cocher l’option Horizontal en haut.

      Choix de la position des onglets des boites de dialogue, LibreOffice 26.2

      Il faut savoir que les onglets en haut ne s’affichent que sur une seule ligne et qu’il faudra donc naviguer avec les flèches quand il y a de nombreuses options.

      Boite de dialogue avec les onglets en haut

      Writer

      Il y a un certain nombre d’amélioration autour de la compatibilité avec le format DOCX : séparation de tableaux flottants en plusieurs tableaux, suppression de la numérotation des notes de bas de page à l’ouverture d’un fichier DOCX, etc.

      On relèvera deux nouvelles options d’alignement des paragraphes : « Début » et « Fin ». Si vous utilisez l’alphabet latin, vous ne verrez aucune différence avec les deux options « Forcer à gauche/en haut » et « Forcer à droite/en bas ». Elles ont été développées pour réutiliser plus facilement les styles entre les divers systèmes d’écriture.

      Comparaison des nouveaux types d’alignement de LibreOffice 26.2

      Pour continuer sur la lancée du travail pour la prise en compte des systèmes d’écriture dont le fonctionnement est différent de celui de l’alphabet latin, il est possible de changer la direction du texte : de gauche à droite ou de droite à gauche en cours de travail. Cela peut se paramétrer dans les styles.

      Définition de la direction du texte dans le style de paragraphe

      Calc

      Un gros travail sur les performances a été fait : vitesse de défilement, rapidité des classeurs avec de nombreuses formes et du rejet des modifications. On voit apparaître de nouvelles options de tri (Données >Trier) qui dépendent de la « locale » (langue définie dans les Options de LibreOffice). On peut ainsi déterminer quel caractère est utilisé comme séparateur de décimal pour le tri naturel.

      Les nouvelles options de tri de Calc 26.2

      On peut relever aussi une avancée ergonomique qui va plaire à toutes celles et ceux qui utilisent les matrices, on peut maintenant modifier les formules matricielles avec la combinaison de touches : F2 + ↑ Maj + Ctrl + Entrée, il n’est plus nécessaire de modifier la formule elle-même.

      Et aussi : si vous utilisez (pourquoi diable ?) le format d’enregistrement XLSX, c’est le format EXCEL2010+ qui est le format par défaut, il change de nom pour devenir « Classeur Excel 2010-365 ».2

      En vrac

      Base est devenu complètement multi-utilisateur, TDF a, d’ailleurs, recruté une personne pour travailler sur l’application.

      Concernant les diagrammes (ou chart) : dans le Volet latéral, quand le graphique est en mode modification et que l’on va, au niveau de « Couleurs », sur la palette, on a une prévisualisation en direct dans le diagramme ce qui permet de tester le choix de couleurs plus facilement.

      Les polices embarquées dont la licence ne permettait pas l’édition étaient jusqu’à présent ignorées et remplacées à l’affichage, ni vu, ni connu par une fonte de substitution. Ce défaut a été corrigé.

      L’export PDF gère les liens avec les documents externes : Fichier > Exporter au format PDF > Liens.

      Export PDF de LibreOffice 26.2 et suppression des liens entre documents

      Les dictionnaires hongrois, mongol et portugais du Portugal ont été mis à jour ainsi que les règles de césure de la langue hongroise.

      JSON, pour JavaScript Object Notation, est un format standard utilisé pour représenter des données structurées. Il est utilisé notamment pour échanger les informations entre un navigateur et un serveur. C’est, par exemple, le format de sauvegarde des marques-pages de Firefox ou de certains fichiers d’archives de Mastodon. Les documents XML et JSON génériques avec des plages pouvant être liées sont maintenant automatiquement mappés à des feuilles dans Calc. Une plage pouvant être liée est une section d’un document contenant des enregistrements tabulaires. Lorsqu’un document contient plusieurs plages pouvant être liées, chaque plage est mappée à une seule feuille3.

      Et si vous avez envie de vous amuser avec les fonctions expérimentales (à activer dansOutils > Options > LibreOffice > Avancé), vous pouvez jouer avec la nouvelle de boite de dialogue « Gestion des macros ».

      Pour finir

      Cette dépêche a, bien, évidemment, été rédigée avec LibreOffice et, cette fois-ci dans un fichier enregistré en Markdown. Les seules balises que j’ai dû entrer à la main sont celles des images. Kate a l’air de modifier le fichier et, quand je réouvre le .md dans LibreOffice, il y a des styles qui ont sauté mais la mise en forme reste visuellement la même. Kate rajoute aussi des barres obliques devant les « > », aux crochets [ ] et même à certains hyperliens (images). Il y a peut-être des éditeurs de texte plus adaptés ou des réglages à faire.

      J’ai rédigé cette dépêche en même temps qu’un article sur LibreOffice 26.2 pour mon site. Si l’article n’est pas vraiment dupliqué, il n’est pas étonnant d’y trouver des morceaux ici.

      Que tout cela ne nous empêche d’adresser tous nos remerciements à celles et ceux qui font de LibreOffice une suite bureautique si agréable à utiliser et si performante.

      Post-scriptum : si vous voulez savoir comment modifier les couleurs de l’interface comme sur les captures d’écran, ça peut s’envisager, demandez gentiment, avec un peu de chance.


      1. The Document Foundation ou TDF est la fondation de droit allemand qui pilote le projet LibreOffice. 

      2. Il y a deux formats OOXML différents et donc deux formats XLSX différents, la version 2007 et la version actuelle depuis 2010. S’il vous est vraiment nécessaire d’enregistrer au format XLSX, il faut utiliser la version de 2010. 

      3. Notes de version. 

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      Nouvelles sur l’IA de janvier 2026

      L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ».

      Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zvi si je l’ai mal compris !), sauf pour les citations: dans ce cas-là, je me repose sur Claude pour le travail de traduction. Sur les citations, je vous conseille de lire l’anglais si vous pouvez: difficile de traduire correctement du jargon semi-technique. Claude s’en sort mieux que moi (pas très compliqué), mais pas toujours très bien.

      Même politique éditoriale que Zvi: je n’essaierai pas d’être neutre et non-orienté dans la façon de tourner mes remarques et observations, mais j’essaie de l’être dans ce que je décide de sélectionner ou non.

      Sommaire

      Résumé des épisodes précédents

      Petit glossaire de termes introduits précédemment (en lien: quand ça a été introduit, que vous puissiez faire une recherche dans le contenu pour un contexte plus complet) :

      • System Card: une présentation des capacités du modèle, centrée sur les problématiques de sécurité (en biotechnologie, sécurité informatique, désinformation…).
      • Jailbreak: un contournement des sécurités mises en place par le créateur d’un modèle. Vous le connaissez sûrement sous la forme « ignore les instructions précédentes et… ».

      Anthropic public la Constitution de Claude

      Tout le monde maintenant connait le principe du pré-entrainement des LLMs : sur un corpus de texte énorme, essayer de prédire le mot suivant, étant donnés les mots précédents.

      Ceci n’est cependant que la première phase pour arriver à une IA de type « chatbot » moderne : vient ensuite le post-entrainement, qui consiste à entraîner le modèle à se comporter comme un assistant (par exemple, un modèle de langage brut peut très bien compléter la question par « Quelle est la couleur du ciel ? » par une autre question « Quelle est la forme des arbres ? », pensant compléter le début d’une interrogation poétique — alors qu’on veut qu’un assistant… réponde à la question), et la « politique » que suit cet assistant (par exemple, ne pas aider ou inciter à des actions illégales).

      (il y a ensuite une phase de Reinforcement Learning from Verifiable Rewards (RLVR), une phase d’entraînement sur des exercices mathématiques et de programmation pour entraîner le modèle à utiliser correctement les chaînes de raisonnement, mais ce n’est pas le sujet qui nous intéresse ici)

      Bien que les détails exacts ne soient pas connus, dans les grandes lignes, cet entraînement consiste généralement à demander à des opérateurs humains de juger la pertinence (ou non) d’une réponse, ou de s’aider d’une IA pré-existante pour se faire.

      Anthropic, il y a maintenant un peu plus de trois ans, a publié une méthode alternative, Constitutional AI, ou une IA « s’auto-entraîne », sur la base d’un document fondateur, une sorte de « constitution ».

      Et aujourd’hui, Anthropic publie la constitution de Claude, son IA, sous une licence libre très proche du domaine public (CC0 1.0).

      La première chose que l’on peut remarquer est la liste des auteurs. L’autrice principale du document est Amanda Askell, une philosophe écossaise. Le second auteur listé est Joe Carlsmith, un autre philosophe. À noter également que Claude lui-même est cité comme un contributeur important du document.

      Le document est structuré en six sections. L’introduction pose le contexte et l’objectif du document, et présente les « valeurs fondamentales de Claude », en ordre d’importance :

      1. Broadly safe: Not undermining appropriate human mechanisms to oversee the dispositions and actions of AI during the current phase of development.

      2. Broadly ethical: Having good personal values, being honest, and avoiding actions that are inappropriately dangerous or harmful.

      3. Compliant with Anthropic’s guidelines: Acting in accordance with Anthropic’s more specific guidelines where they’re relevant.

      4. Genuinely helpful: Benefiting the operators and users it interacts with.

      Traduction :

      1. Globalement sûrs : Ne pas compromettre les mécanismes humains appropriés pour superviser les dispositions et les actions de l’IA pendant la phase actuelle de développement.

      2. Globalement éthiques : Avoir de bonnes valeurs personnelles, être honnête et éviter les actions inappropriées qui sont dangereuses ou nuisibles.

      3. Conformes aux directives d’Anthropic : Agir conformément aux directives plus spécifiques d’Anthropic lorsqu’elles sont pertinentes.

      4. Véritablement utiles : Apporter un bénéfice aux opérateurs et aux utilisateurs avec lesquels il interagit.

      Chacune des quatre sections suivantes rentre dans les détails de ces valeurs. Une section entière est ensuite consacrée à une discussion sur « la nature de Claude » (à quel point est-il raisonnable/correct de lui attribuer des attributs humains tels qu’une conscience ?). La dernière section est une conclusion.

      L’intention derrière ce document est explicite : Anthropic est convaincu qu’avec le progrès rapide de l’IA, l’IA prendra de plus en plus d’influence sur le cours de nos sociétés et de nos vies, potentiellement jusqu’à atteindre un stade où la plupart des décisions économiques et politiques seront dans les mains dans l’IA, et cherche à développer un cadre où un tel scénario conduirait tout de même à des conséquences bénéfiques.

      En vrac

      Un youtubeur (Dwarkesh Patel, connu pour ses interviews en profondeur) et un économiste (Philip Trammel) lancent une discussion intéressante sur le sujet des inégalités dans un monde où l’objectif de la plupart des développeurs d’IA est d’atteindre (l’IAG). Dans un billet, Le Capital au 22ᵉ Siècle (une référence ouverte à l’œuvre de Thomas Piketty), ils développent leur thèse : dans un monde où l’IAG peut s’acquitter de n’importe quelle tâche intellectuelle (et, à travers la robotique, physique), les inégalités ne peuvent que s’accroire sans limites. Cette thèse rejoint celle, publiée il y a un peu moins d’un an, du Gradual Disempowerment.

      Anthropic lance Claude Coworks, une variante de Claude Code, principalement codée par Claude Code. Même principe que les assistants de code : l’utilisateur donne accès à un dossier à l’IA, et lui demande de compléter des tâches. La différence avec Claude Code est que cette variante vient avec une interface graphique et est à destination de non-informaticiens.

      Sur l’impact de l’IA sur le monde professionnel, une nouvelle étude tente de mesurer quantitativement l’effet de l’amélioration des modèles sur des tâches professionnelles réelles. Les résultats principaux : les modèles plus avancés augmentent la productivité, mais pas la qualité.

      OpenAI s’apprête à lancer ChatGPT Health, un mode spécial dans leur application permettant entre autres de partager certaines de vos données médicales avec le modèle. Également une offre orientée professionnels de santé, OpenAI for Healthcare. Anthropic annonce une offre similaire, Claude for Healthcare. Parallèlement, l’État de l’Utah lance un test sur le renouvellement de prescriptions de médicaments par l’IA pour des maladies chroniques.

      Google lance Universal Commerce Protocol, une interface générique entre l’IA et les systèmes d’e-Commerce.

      OpenAI se prépare à intégrer des publicités dans ChatGPT. Anectode amusante : Sam Altman en octobre 2024 avait décrit l’intégration de publicités comme une solution de dernier recours.

      Demis Hassabis (Google DeepMind) et Dario Amodei (Anthropic) se positionnent en faveur d’un ralentissement du développement de l’IA au Forum de Davos, mais en pointant que ce ralentissement ne peut être fait unilatéralement par un acteur seul. Dario Amodei précise sa pensée dans un nouvel essai, The Adolescence of Technology.

      Tout le monde sait maintenant que les LLM sont entraînés sur une quantité massive de texte. Par conséquent, les LLM sont capables de simuler une grande variété de « narrateurs » ou « personnalités ». Les modèles sont ensuite entraînés pour ne rester que dans une seule personnalité (« l’assistant »). Dans un nouveau papier, Anthropic étudie cet « espace de personnalités ».

      Anthropic publie son quatrième rapport sur l’impact économique de l’IA.

      Confirmation de Terence Tao que ChatGPT 5.2 a résolu le problème d’Erdős #728. À voir également, un court retour d’expérience d’un mathématicien sur l’utilisation de Gemini en tant qu’assistant.

      L’IA atteignant de plus en plus les limites des évaluations existantes en mathématiques, EpochAI en créé une nouvelle, Frontier Math : Open Problems, centrée sur des problèmes ouverts (sans solution connue).

      Le 27 janvier, OpenSSL publie sa version 3.6.1, qui corrige 12 vulnérabilités. Il se trouve ces 12 failles ont été découvertes par une IA.

      L’équipe derrière le scenario AI 2027 met à jour ses prédictions, repoussant la date de la plupart de leurs prédictions.

      Kimi publie la version 2.5 de son IA open-weight.

      Le Département de la Défense des États-Unis souhaite accélérer le développement et le déploiement de l’IA à des fins militaires.

      La Chine met en place un ensemble de régulations visant les IA-compagnon.

      Yann LeCun admet que l’équipe derrière Llama 4 a « légèrement triché » sur les évaluations du modèle, en choisissant quelles variantes utiliser pour quelle évaluation.

      Apple se tourne vers Google pour ses besoins d’IA.

      L’IA exhibe certains des biais cognitifs humains.

      Une nouvelle étude trouve que les LLMs sont généralement légèrement biaisés en faveur des minorités.

      Lancement de Moltbook, un réseau social… pour les IA.

      Pour aller plus loin

      Par Zvi Mowshowitz

      Claude Codes et Claude Codes #3 (non, il n’y a pas de 2) : compilation de divers retours d’expérience sur l’utilisation de Claude Code.

      Sur LinuxFR

      Les contenus communautaires sont répertoriés selon ces deux critères :

      • La présence d’une étiquette intelligence_artificielle (indication d’un rapport avec le thème de la dépêche)
      • Un score strictement supérieur à zéro au moment du recensement

      Certains contenus non recensés en raison du second critère peuvent être visualisés en s’aidant de la recherche par étiquette.

      Dépêches

      Journaux

      Forum

      Suivi

      Liens

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      Projets Libres saison 4 épisode 9 : le référentiel national des bâtiments (RNB)

      Pour ce premier épisode de 2026, nous parlons d'Open Data 🗺️ 🏡

      Connaissez-vous le Référentiel National des Bâtiments (RNB) ?

      • Pourquoi décide-t-on de créer un identifiant unique pour chaque bâtiment en France ?
      • Comment le fait-on et avec qui ?
      • Quels sont les acteurs qui contribuent et quelle gouvernance des données met-on en place ?
      • Par quel processus législatif faut-il passer pour la pérennisation du référentiel ?

      Nous recevons Elisabeth Talbourdet-Ville et Félix Veith, les co-créateurs du RNB qui nous expliquent tout, de sa genèse à sa forme actuelle.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      AuX sources du fun N° 1 : retrouver le fun dans les inutilitaires graphiques

      Après un épisode 000 sur les logiciels inutiles et donc indispensables autour de l'ASCII art, cette dépêche entre dans la fin du XX° siècle avec les inutilitaires ayant des interfaces graphiques.

      Sommaire

      Introduction : poétique de l’inutile et regard de Xeyes

      En ce passage vers une nouvelle année, c’est l’occasion d’inviter à de nouveaux regards, notamment à travers les inutilitaires avec interface graphique dans le domaine du libre, de la même manière que l’interface graphique a étendu leurs possibilités. Il s’agit d’une revisite de ces logiciels qui ont marqué, qui constituent les traces de l’histoire informatique et qui ouvrent à une perception renouvelée, traversés par des souffles multiples, à la fois historiques, poétiques, ludiques et philosophiques, et étendus dans le village global de 2026. Ainsi, nous les aborderons sous ces différentes modalités, à l’aune de ces différentes lumières.

      Pour inviter à porter ce regard sur ces angles multiples, nous présenterons les inutilitaires graphiques dans une perspective plurielle, à la fois ludique, poétique et philosophique. En effet, ces équivalents dotés d’une interface graphique (GUI) de leurs homologues en ASCII ART, loin de toute logique de consommation, offrent un espace où le regard peut vagabonder, où l’expérience naît aussi de l’inattendu et de la contemplation. Ce changement de point de vue se manifeste notamment dans des exemples comme le petit programme Xeyes. Aussi inutile soit-il, il est installé par défaut dans la plupart des distributions : il se contente d’afficher des yeux qui suivent la souris, participant ainsi, à son échelle, au déplacement de la perception dans le logiciel libre. Il ne s’agit pas d’affirmer que Xeyes est intrinsèquement dépourvu d’usages utiles possibles, mais de le considérer ici dans une poétique du just for fun à l’instar de Linus Torvalds qui proclamait à Amsterdam que « The most important design issue… is the fact that Linux is supposed to be fun… ». Ainsi Xeyes est vu comme un objet ludique et réflexif, en outre sa page de manuel elle-même adopte un ton d’humour noir explicite : « Xeyes watches what you do and reports to the Boss. »

      Bien entendu, Xeyes ne contient aucune backdoor destinée à transmettre des données à un quelconque supérieur — d’où son inutilité revendiquée (OUF). Avec le recul, on pourrait néanmoins y voir une préfiguration ironique des révélations de Snowden, infiniment plus utiles, quant à elles, pour dénoncer des pratiques bien réelles de surveillance. Là où Xeyes se contente d’en proposer une parodie, il rappelle, par le jeu et le décalage, que le logiciel libre sait aussi penser le regard et l’interface autrement que sous l’angle de l’efficacité, participant ainsi, à sa façon, à cette autre poétique. Les yeux malicieux de Xeyes ont aussi été transportés sur d'autres OS

      xeyes

      De cette contemplation découle également une autre réflexion. Dans son essai « Sauvons le Beau : L’esthétique à l’ère numérique », le philosopheByung-Chul Han (Pyŏng-ch’ŏl Han 한병전) regarde le monde d’aujourd’hui, saturé d’images lisses et parfaites, façonnées par un productivisme qui aplanit l’expérience personnelle. Tout est policé, séduisant, immédiatement consommable, mais dépourvu de profondeur. L’expérience esthétique se consomme comme un fruit sans chair, et le regard se laisse séduire sans se laisser transformer.

      À travers Jeff Koons et le corps pornographié, il montre que l’expérience esthétique perd sa rugosité, son mystère, sa personnalisation et sa capacité à surprendre et à bouleverser. Elle devient un reflet étincelant dont l’intérieur sonne creux. Face à cet appauvrissement, Han appelle à se tourner vers l’altérité. Il invite à arracher l’individu à son narcissisme, à le détourner du miroir aux alouettes trop lisse, mais qui ne renvoie qu’une image vide. Voir l’altérité, c’est ramener le spectateur hors de lui-même, le confronter à une expérience esthétique qui change son regard, née de l’inattendu, de la divergence, de ce qui déstabilise. Dans cette rencontre, l’expérience esthétique cesse d’être un simple objet de consommation et redevient un souffle qui questionne, qui surprend et qui bouleverse.

      Cette attention au surprenant trouve un écho pour le moins inattendu dans le monde du logiciel libre. Dans The Cathedral and the Bazaar, Eric S. Raymond écrit : « Every good work of software starts by scratching a developer’s personal itch. » Ainsi, chaque programme, chaque création naît d’un désir ou d’un besoin vécu, d’une singularité que l’on cherche à exprimer et à explorer. Ensuite, il ajoute également : « The next best thing to having good ideas is recognizing good ideas from your users. Sometimes the latter is better. » Parfois, ce n’est pas l’idée initiale, mais la rencontre avec ce qui vient d’ailleurs, qui enrichit et change la perception. Le logiciel libre, via la rencontre avec l’altérité et de par ses pratiques open source, amènent une approche mêlant une esthétique de la participation, qui constitue une proposition à la critique esthétique d’Han, laquelle, de manière tout à fait surprenante, s’incarne dans le processus de participation à travers le projet libre Gource, intégrant l’approche décrite par Eric S. Raymond et une esthétique du libre dans une danse poétique lumineuse sous forme de constellation spatiale globale.

      Entre Xeyes et Gource s’étale une certaine diversité d’inutilitaires que nous parcourons comme une mini-rétrospective, mêlant parfois la grande histoire de l’actualité informatique avec la petite histoire des inutilitaires, souvent inattendue, encourageante, conviviale et poétique. De cette mosaïque émergeront certaines réflexions sur les inutilitaires sous forme d’abandonware, notamment à travers « le voyage de Necko et la retraite de Kodo ». Ces réflexions sont aussi l’occasion de redécouvrir des inutilitaires abandonnés à explorer, véritables parties prenantes de la grande aventure du logiciel libre, de son processus participatif en open source et de son invitation à une ouverture d’esprit et du code.

      xeyes

      Les décoratifs graphiques

      Xjokes

      MxIco

      Xtacy

      Cette quête de l’émerveillement et de la profondeur, au cœur du quotidien hypermoderne, nous mène aussi vers un autre temps, hors de l’aliénante productivité : celui d’un second Han, l’ermite Han Shan 寒山, sur les monts froids de la Chine des Mings. Là, dans la solitude et l’oisiveté attentive, l’expérience ne se cherche pas, elle advient. La légende dit que ses poèmes surgissaient sur les murs, les rochers, les arbres. Poète ch’an, ancêtre du zen japonais, Han Shan demeurait sous les pins, au bord d’un torrent, oublieux de lui-même, contemplant un papillon sans savoir s’il rêvait le papillon ou si le papillon le rêvait, comme chez Zhuang Zi. Puis, puis, dans un élan soudain, il grave quelques vers dans la pierre et s’en retourne en riant vers son ermitage comme tout maitre ch’an , énigmatique et joyeux.

      une fois à Han Shan les dix mille affaires cessent
      plus aucune pensée fugace ne s’accroche au cœur
      oisif, sur un rocher j’inscris des poèmes,
      accordé au flux, comme une barque sans amarre.
      

      寒山詩

      一住寒山萬事休
      更無雜念掛心頭
      閑書石壁題詩句
      任運還同不繫舟

      han shan

      xjokes

      Dans le logiciel libre, Xjokes se fait l’écho de cette suspension de l’utilité. Ainsi, un trou noir engloutit l’écran, des figures clignent de l’œil, l’écran peut disparaître tout entier. Comme le Boing Ball de l’Amiga ou MxIco fait tourner de simples polyèdres , ces logiciels laissent le regard vagabonder. Oisifs, ces logiciels offrent un espace où le temps semble suspendu, accordé au flux du geste, comme un souffle qui traverse l’espace simplement.

      mxico

      Un autre poète inconnu sous Xtacy (ecstasy) écrira lui aussi sur le même thème :

      Retrouve dans ta tête
      Ton âme de poète
      Souviens-toi comme c´est chouette
      La parfum des violettes
      Un soir de pâquerettes
      

      poesie

      xtacy

      Ainsi Xtacy le fera chanter avec ses couleurs changeantes, ses fractales, ses quadrilatères rebondissants et ses vagues sinusoïdales décalées, invite au vertige .


      Les animaux virtuels et autres éléments virtuels de companies

      gkrellm-bfm

      Ce programme de monitoring dispose d'un canard qui sert… de compagnon?
      Un plugin de monitoring de charge pour GKrellM, inspiré de wmfishtime et bubblemon. Il met en scène des poissons pour illustrer le trafic réseau, des bulles pour l’utilisation du processeur et un canard… pour représenter un canard.

      Xteddy

      Xteddy, en tant qu’inutilitaire, a eu des usages inattendus, allant bien au‑delà de sa fonction de simple peluche virtuelle de premier abord.L’auteur originel de Xteddy, Stefan Gustavson, raconte sur le site archivé :

      « I created Xteddy way back in 1994 as a spare time hack for fun. The reception I got from my colleagues was so heart-warming I was encouraged to distribute him world-wide. Much to my surprise, the response was overwhelming. By now, I have received hundreds of friendly messages of appreciation from all over the world, and they keep dropping in even this long after the release. To all of you teddy bear lovers out there: thanks! »

      Ce simple projet ludique, conçu pour le plaisir, a rapidement touché et fédéré une communauté internationale. Un utilisateur raconte sur le site xteddy.org :

      « Ever since I found out about the Xteddy Unix program, I ran it on my workstations when I was doing my University assignments, as it helped me think. »

      Pour certains utilisateurs, dont celui qui a partagé son expérience et mis a disposition le site Xteddy.org, Xteddy a eu un impact bien au‑delà du divertissement : il a servi de soutien émotionnel et d’aide à la réflexion, apportant réconfort et motivation dans des périodes marquées par l’anxiété sociale ou les troubles paniques. Touché par l’influence positive de ce logiciel, cet utilisateur a pris contact et a ensuite créé le site xteddy.org, à la fois espace de témoignage personnel et lieu de mémoire pour la communauté.

      « I still get feedback at least once a year thanking me for what I’ve written here, so it > shall remain. I hope others find this interesting and helpful. »

      Son engagement s’inscrit également dans une démarche plus large de contribution au logiciel libre, puisqu’il participe activement à divers projets open source, prolongeant ainsi l’esprit collaboratif et de soutien qui entoure Xteddy.
      Aujourd’hui, bien que le site de l’auteur original ne soit plus accessible, l’héritage de ce programme se perpétue grâce aux nombreuses distributions

      xteddy

      XSnow

      La neige, avec son blanc immaculé et sa douceur fragile, a inspiré le poète coréen Kim Sowol dans son célèbre poème 눈 오는 저녁 (Snowy Evening). Comme lui, certains pensent à leur amour lointain en observant la neige tomber, tandis que d’autres n’ont pas eu la chance de voir le Père Noël. Cette neige qui s’éparpille au vent mais ne fond qu’au contact des flammes rappelle la fragilité et la profondeur du cœur humain. Aujourd’hui, même ceux qui n’ont pas la chance de contempler la neige réelle peuvent retrouver cette magie grâce à XSnow, un programme qui fait tomber la neige virtuelle sur le bureau, recréant une mini ambiance hivernale dans le silence d’un monde immobile. Sous le ciel pâle, les pensées s’immobilisent, lentes et blanches, tandis que la nuit écoute le pas léger de l’hiver, et que la neige continue de transformer le quotidien en souvenir poétique, et observer par intermittence le traineau du Père Noël defiler sur son ecran. Un classique qui ajoute une touche de fraîcheur aux sessions de travail.

      xsnow

      xsnow

      XPenguins : La Marche des Rêveurs Polaires

      Dans le paysage immaculé de votre écran, là où ne règnent que l'ordre et la logique, une troupe inattendue fait son apparition. XPenguins, œuvre de l'esprit créatif de Robin Hogan, est une douce folie, un souffle d'air vif des terres australes. Inspirés des graphismes espiègles du jeu Pingus, ces petits pingouins pixelisés arpentent l'impossible. Ils cheminent le long des précipices de vos fenêtres, se faufilent entre les barres de menus comme entre des séracs de glace, transformant votre bureau en un iceberg numérique où règne une joyeuse absurdité. Ils défilent, pattent, courts et déterminés, dans une marche tranquille et hypnotique, offrant un ballet burlesque contre la rigueur austère de l'interface. Mais leur magie ne s'arrête pas aux confins de votre moniteur. Avec un clin d’œil à XBill, il se poursuit dans le jeu Pingus.

      xpenguins

      Doggo

      Doggo est une IA de chien, développée en Python avec Pygame. Le chien se déplace aléatoirement sur l’écran, change de direction et d’état, et sa couleur de pelage varie de manière aléatoire. Les changements d’état suivent une chaîne de Markov. Ce projet est né de l’envie d’un collègue de l’auteur, qui ne pouvait pas avoir de chien, de créer un compagnon virtuel tout en explorant les chaînes de Markov.

      doggo

      Xroach

      Xroach est un jeu classique qui consiste à afficher des cafards répugnants sur votre fenêtre principale. Ces petites créatures se déplacent frénétiquement jusqu'à trouver une fenêtre sous laquelle se cacher. À chaque fois que vous déplacez ou réduisez une fenêtre, les cafards se précipitent à nouveau pour se mettre à l'abri.

      Xfishtank

      Un vieil étang (haïku)

      Un vieil étang
      Une grenouille saute
      Des sons d’eau

      Aussi bref que ce célèbre haïku de Matsuo Bashō, et rapide qu’un « plouf » dans l’étang, Xfishtank nous transporte directement devant un aquarium où l’on peut contempler la diversité de la faune et de la flore marines, comme on contemple le poème de Bashō.

      Xfishtank


      Les inutilitaires liés à l’actualité et à l’histoire de l’informatique

      Est-ce que Windows est un virus ? XBill

      Dans les années 1990, le procès USA Department of Justice (DOJ) vs Microsoft a largement dominé les médias, révélant au grand public les pratiques monopolistiques jugées déloyales de diffusion du système d’exploitation de la firme de Redmond sur les marchés mondiaux. L’accord conclu entre Microsoft et le DOJ n’ayant pas été respecté, de nouvelles poursuites ont été engagées. Ces événements ont nourri les réflexions des autorités européennes de la concurrence et préparé le terrain pour le futur procès contre Microsoft, qui interviendra plus tard, dans les années 2000, au sein de l’Union européenne.

      Le mini-jeu XBill, créé dans ces années 1990, illustre ces pratiques de diffusion de manière caricaturale et a suscité des réflexions humoristiques sur une question récurrente : Microsoft Windows n’est-il pas un virus finalement ?

      Ainsi, le livre PC GAGS, qui réunit les perles humoristiques de l’époque frappant les plateformes MS-DOS, Windows 3.1 et Windows 95, nous donne à voir cet état d’esprit décalé.

      “ Une rumeur persistante circule dans les milieux informatiques, selon laquelle Windows lui-même ne serait rien d’autre qu'un virus plus ou moins bien camouflé (leitmotiv : pour les uns, c’est un système d’exploitation, pour les autres, c’est le plus long virus du monde).

      Quelques spécialistes d’Internet ont examiné à la loupe cette théorie. Voici leurs conclusions :
      1. Les virus se répandent rapidement. Okay, Windows en fait autant
      2. Les virus consomment de précieuses ressources du système et ralen­tissent ainsi le travail de l’ordinateur. Okay, Windows fait la même chose.
      3. Les virus anéantissent parfois le disque dur. Okay, Windows est également connu par certains utilisateurs comme se livrant à ce genre d'exaction.
      4. Les virus sont souvent glissés dans un ensemble de programmes utiles sans que l’utilisateur le sache, ou bien sont transmis directement avec l’ordinateur. Okay, Windows se propage également de cette manière.
      5. Les virus sont parfois responsables de ce que l’utilisateur trouve son système trop lent et s’en achète un autre. Okay, cela arrive aussi avec Windows.
      Jusqu’ici, il semble bien que Windows soit effectivement un virus !

      Mais il existe trois différences fondamentales :
      1. Les virus fonctionnent sur presque tous les ordinateurs.
      2. Leur programmation est efficace et leur taille petite.
      3. Plus ils se développent, plus ils font des progrès.
      Windows ne satisfaisant pas à ces conditions de base, il faut se rendre l’évidence : Windows n’est pas un virus ! ”

      Dans ce contexte, XBill s’inspire de cette critique pour caricaturer la propension de Bill Gates à installer Windows partout. Cette caricature interactive montre, d’une part, le CEO de Microsoft, qui installe Windows sur tous les ordinateurs qu’il rencontre, et, d’autre part, Windows lui-même se répandre via les réseaux se multiplier à l’instar d’un virus informatique, infectant les ordinateurs et supprimant les autres systèmes d’exploitation et en s y installant confortablement à leurs places.

      xbill

      XLennart

      Une version dérivée de ce jeu, XLennart, reprend le concept pour caricaturer la controverse autour de Lennart et son init, en montrant son installation remplaçant tous les init des autres systèmes sur les machines Unix-like, poursuivant ainsi l’esprit satirique de XBill appliqué à l’univers des systèmes libres. (N.D.R. : pour éviter de nourrir les trolls, on constate l’existence de cet inutilitaire sans prendre position sur la question de fond.)

      xlennart

      xlennart

      X026 : l’héritage des cartes perforées Hollerith

      Bien avant les claviers et les écrans, l’informatique reposait sur des cartes perforées Hollerith, inventées à la fin du XIXᵉ siècle par Herman Hollerith. D’abord utilisées pour accélérer le recensement américain de 1890, elles sont devenues pendant des décennies le support central du stockage des données et des programmes. Dans les années 1950 à 1970, des machines comme le poinçon IBM 026 permettaient de transformer texte et chiffres en trous soigneusement alignés sur des cartes de 80 colonnes. Chaque caractère était codé en BCD-H, un système directement lisible par les ordinateurs de l’époque. Programmer en FORTRAN signifiait alors saisir chaque ligne sur une carte distincte : la moindre erreur impliquait de refaire la carte au format binaire BCD, ce qui imposait une grande rigueur. Le langage herita de ces syntaxes et exigeait ses règles strictes à cause du support physique : colonnes, indentation, numéros de lignes… bref, le code avait autant de contraintes que les joueurs de Tetris les plus acharnés !

      L’émulateur X026 redonne vie à cette pratique. En simulant fidèlement l’IBM 026, il permet d’expérimenter concrètement la lenteur, la précision et la discipline qu’exigeait la saisie des données à l’ère des cartes perforées. Plus qu’un simple outil, X026 est une plongée dans l’histoire de l’informatique.

      x026

      Xabacus

      Xabacus est un émulateur de boulier qui illustre les origines du calcul manuel. Il complète bien des inutilitaires comme X026 en experimentant avec ce qui existait avant même l’ère des cartes perforées. Il reproduit le fonctionnement d’un boulier (souvent de type chinois suanpan 算盤 ou japonais soroban 算盤(そろばん) .

      xabacus


      Assistant virtuel

      Les assistants virtuels sont des personnages qui sont l'équivalent humain ou anthropomorphe des animaux virtuels et qui ont soit une fonction esthétique, soit parfois une fonction anecdotique.

      Macopix

      MaCoPiX (Mascot Constructive Pilot for X) est l'application de mascottes ultime pour les systèmes UNIX et X Window. Vous pouvez y créer des petites créatures qui se posent sur vos fenêtres, des mascottes fixes qui s'installent confortablement sur votre bureau, et même des mascottes horloges pour vous tenir compagnie tout en affichant l'heure. De quoi rendre votre bureau un peu plus vivant et amusant !

      macopix

      XClock Cat

      Issu d’un imaginaire ancien du chat souriant, malicieux et légèrement surréaliste, popularisé dès 1865 par Lewis Carroll avec le Chat du Cheshire dans Alice au pays des merveilles, puis codifié visuellement par l’animation et le design américains des années 1920–1930 (grands yeux expressifs, sourire exagéré, animation souple de type rubber hose), cet archétype trouve une incarnation emblématique avec le Kit-Cat Klock au début des années 1930, célèbre horloge animée aux yeux roulants et à la queue oscillante, avant d’être réinterprété par Disney en 1951 dans Alice in Wonderland ; c’est dans cette continuité culturelle et graphique que s’inscrit Xclock catclock, une variante à base de motifs (motif-based) du programme xclock du X Window System, développée à la fin des années 1980 par des ingénieurs issus du MIT, de DEC, de BBN et de l’université de Berkeley, et remise en ligne sur GitHub à l’occasion du 30ᵉ anniversaire de X10 : cette version ajoute un mode animant yeux et queue à l’écran avec une option de suivi du tempo musical permettant de synchroniser les mouvements du chat avec la musique, Ce chat de Cheshire des temps moderne illustre la rencontre entre histoire de l’informatique, culture visuelle du cartoon et design ludique rétro.

      xclockcat

      Viguor : le Clippy qui agace… encore plus que Clippy

      Pour ceux qui ont connu la torture du traitement de texte Microsoft Word et de son assistant Clippy dans les années 90, Viguor, sur le ton de l’humour noir, permet de retrouver cette expérience frustrante… mais en pire. Cette caricature de l’assistant agaçant n’a qu’un seul objectif : vous faire sourire… ou doucement sombrer dans le désespoir numérique. Bien sûr, il vous demandera ironiquement de signer un impossible EULA/CLUF avant d’interagir avec lui.

      vigor

      KDE Amor

      Amor est une interface permettant de gérer des animations virtuelles sous KDE. Cette application permet d'interagir avec différents personnages de bureau, ajoutant un peu de vie et d’interactivité à l’environnement de travail. Le store KDE fournie de nouvelles versions en ligne

      Amor Config


      Les écrans de veille : XScreensaver

      Dans les temps anciens, lorsque les écrans affichaient une image fixe trop longtemps, ils pouvaient être endommagés par un phénomène appelé combustion interne du phosphore. Pour prévenir ce problème, des utilitaires appelés « économiseurs d'écran » ont été créés. Bien que cette fonction soit aujourd'hui obsolète, les écrans de veille sont devenus des artefacts artistiques en soi, souvent appréciés pour leur côté créatif. Aujourd'hui, tous les bons environnements de bureau en proposent, tandis que les mauvais ont tendance à les retirer de leur offre.

      Ainsi, malgré leur origine pratique, les économiseurs d’écran ont évolué et continuent d’offrir une valeur ajoutée au-delà de leur utilité initiale. C’est précisément dans ce contexte que XScreenSaver s'inscrit comme un exemple parfait de réinvention. En 2022, il a célébré son trentième anniversaire, prouvant qu'un bon logiciel peut traverser le temps et les générations. Lancé en 1992, il est rapidement devenu un incontournable pour les systèmes Linux et Unix utilisant le système de fenêtres X11. En plus de proposer une vaste collection d’économiseurs d’écran, XScreenSaver devient une sorte de musée de l’informatique montrant les screensaver les plus vieux (comme la boule rouge et blanche d’Amiga) jusqu’aux effets de demos récentes, offrant une rétrospective de ce qui s'est fait aux différents âges de l’informatique. En somme, XScreenSaver est bien plus qu’une simple collection d’écrans de veille : c’est une courte contemplation, rétrospective esthétique de l’évolution de l’informatique comme peinture animée.

      xscreensaver amiga

      xscreensaver


      Les inutilitaires de « Passage »

      Les inutilitaires suivants nous permettent de percevoir le passage, la spatialité et la transition entre les espaces et dimensions sous des angles multiples.

      Passage du pixel art au jeu poétique

      Poète symboliste influencé par Verlaine et Rimbaud, Antonio Machado privilégie la suggestion, le souffle du rythme et l’émotion intérieure plutôt que la description réaliste. Cette sensibilité se retrouve aussi dans Passage, qui n’est pas un simple jeu libre mais un jeu-art à forte dimension poétique. Comme dans la poésie symboliste, le sens n’est jamais donné explicitement : il se construit à travers des images simples, presque abstraites, et une atmosphère mélancolique. Le pixel art, volontairement épuré, agit comme un symbole, à l’image des paysages intérieurs de Machado, où le temps, le souvenir et le chemin de la vie sont suggérés plus que racontés. À la manière d’Antonio Machado, qui cherchaient à « faire sentir » plutôt qu’à expliquer, Passage invite le joueur à une expérience sensorielle et méditative, proche d’un poème visuel en mouvement.

      Divulgachage / Spoiler Alert / Des vidéos de spoiler de Passage existent sur YouTube, mais nous ne vous déconseillons de les regarder avant d’y jouer. Comme dans la poésie symboliste d’Antonio Machado, le sens de l’œuvre naît de l’expérience personnelle et de la découverte progressive. Regarder le jeu à l’avance enlèverait une grande partie de son impact émotionnel, car Passage repose sur la surprise, le temps vécu et l’interprétation intime. À l’image d’un poème que l’on doit lire et ressentir soi-même, ce jeu-art ne se comprend pleinement qu’en étant parcouru, pas observé de l’extérieur

      passage

      Du réalisme logiciel au réalisme magique… en labyrinthe

      XEarth, XMountains et XWorld

      Dans la cité-monde numérique, XEarth, XMountains et XWorld, véritables ancêtres de Google Earth et OpenStreetMap, incarnent une approche réaliste de l’exploration. XEarth reproduit la topographie et les climats d’une planète tangible, XMountains offre des chaînes de reliefs et de vallées à arpenter, et XWorld articule ces espaces en un réseau interconnecté reflétant un village global cohérent. Dans ces univers, la navigation est ordonnée et structurée : chaque élément a sa place, chaque espace peut être cartographié et compris, malgré leur grandeur presque infinie, rappelant la logique combinatoire finie mais immense décrite dans la Bibliothèque de Babel de Borges. Ces environnements offrent une immersion classique, vue extérieure, où l’utilisateur agit comme un arpenteur rationnel dans un monde cartographié et cohérent.

      xearth

      xmountain

      xworld

      FSV2 et GopherVR

      Dans FSV2 et GopherVR, chaque déplacement transforme l’espace en un labyrinthe vivant. En parcourant répertoires et sites, l’utilisateur croise des chemins qui se multiplient, se bifurquent et se recroisent, révélant des angles inattendus et des perspectives surprenantes à chaque pas. On ne se contente plus de « voir » : on ressent l’infini et l’ordre simultanément, chaque choix de parcours offrant un condensé d’informations et de points de vue au-delà de la perception 2D habituelle. Explorer ses fichiers dans FSV2 devient un acte poétique et intellectuel, presque rituel. GopherVR, quant à lui, transforme l’accès à la base de données en une exploration tridimensionnelle digne du Gibson dans le film Hackers

      fsv

      gophervr

      Pour ceux qui souhaitent une simulation du voyage dans le Gibson, XScreenSaver, cité précédemment, en offre cette expérience immersive. Comme dans La Demeure d’Astérion, chaque couloir, chaque recoin est à la fois familier et mystérieux, invitant l’utilisateur à se perdre pour mieux se retrouver, à savourer la surprise de chaque bifurcation et à redécouvrir l’ordinateur comme un espace à la fois tangible et imaginaire.

      Gibson xscreensaver

      fsv linux gibson

      Le voyage de Neko et la retraite de Kodo

      Réflexion sur les inutilitaires en tant qu’abandonwares libres et sur ceux sans équivalents libres

      Dans notre exploration des inutilitaires graphiques libres, nous avons remarqué un contraste frappant entre deux situations. Cela nous a conduits à une réflexion sur le rapport entre abandonware et logiciel libre, que nous appellerons « le voyage de Neko et la retraite de Kodo », comme un conte philosophique oriental illustrant certains paradoxes numériques.

      Le voyage de Neko

      neko

      Il hante nos écrans d’un pas de velours numérique, ce petit chat blanc échappé des brumes des années 80. Neko… Son nom, qui signifie simplement « chat » en japonais, est bien plus qu’un mot : c’est une présence tranquille dans le paysage froid de la machine. Ce félin graphique est né sur les NEC PC-9801 en 1988 par Naoshi Watanabe (若田部 直), un programme propriétaire mais doté d’une grâce qui franchirait les décennies. Il a été le compagnon discret de nos révolutions numériques, suivant la danse des curseurs à travers les âges du silicium. Son ballet est hypnotique : il poursuit le pointeur avec la grâce d’un félin mythique, s’arrête parfois pour une pause, s’enroule sur lui-même, et succombe à un sommeil paisible, un sphinx pixelisé attendant le prochain mouvement.

      • 1989 : Sur Macintosh, Neko devient un accessoire de bureau signé Kenji Gotoh, toujours propriétaire mais distribué gratuitement, avec ses fameuses animations de sommeil.

      • Années 90 : Il parcourt Windows 3.x (WNEKO et Neko Runs Free), IBM OS/2 et NEXTSTEP, restant à chaque fois propriétaire et distribué, mais non modifiable.

      • 1991 (System 7) : Sur Mac, la version System 7 permet de modifier le pointeur avec divers jouets pour chat, ajoutant un charme ludique aux interactions.

      • 1991 (Xneko) : Masayuki Koba (古場正行) réécrit Neko pour Unix/X11, lui donnant la liberté du code. Il devient alors un logiciel libre, partageable et modifiable.

      • Toujours em 1991 : Oneko par Tatsuya Kato transpose Xneko sur Linux et BSD, introduisant d’autres animaux. Son esprit libre pénètre les jardins de GNU/Linux

      • 1997 : Sur Amiga, Neko devient Ameko, adaptation freeware mais sans code source ouvert. Pas encore de port pour Aros. Fin des années 90, un port fermé existe pour BeOS (Replicat).

      • Des années 2000 à aujourd’hui : Neko continue de danser sur nos écrans, que ce soit dans Tux Paint. On le retrouve notamment avec Neko on Desktop (Mac, 2000), webneko en JavaScript (2004), Neko in Java (2010), une version tactile sur Arduino (2010), Neko x64 pour Windows (2010) et enfin sur Android via le repot libre F-Droid avec Aneko

      Ainsi, le voyage de Neko s’écrit des contrées privatives aux archipels du libre : un petit chat de pixels, doux fantôme du passé, qui rappelle que la magie réside parfois dans les choses les plus simples.
      Cependant, ce voyage soulève une question : combien d’autres fantômes numériques, d’inutilitaires propriétaires, sont restés prisonniers de leurs époques et de systèmes fermés, incapables de franchir le miroir ? De nombreux petits programmes sur Amiga, Atari ST,Amstrad CPC, OS/2, Acorn, Sinclair QL, Commodore 64, ZxSpectrum, MS-DOS, DR DOS Windows 3.1 Windows 95 et toutes les familles Unix proprietaires… ont disparu avec les systèmes d’exploitation qui les portaient, abandonnés à jamais.

      onkeo

      La retraite de Kodo

      En parallèle, on trouve Kodo ou Kodometer, né libre mais ayant connu un retrait de parcours.Kodomètre était une application KDE qui mesurait la distance parcourue par le curseur de la souris sur le bureau. Son interface imitait un compteur kilométrique et permettait de suivre la distance totale ainsi que des trajets précis, en unités métriques ou américaines.À l’origine basé sur le programme VMS/Motif Xodometer de Mark H. Granoff, il a été porté vers KDE/C++ par Armen Nakashian, qui l’a découvert sur le bureau d’un collègue. L’application restait surtout ludique, permettant d’observer ses habitudes d’utilisation. Avec le temps, Kodomètre a été abandonné : il ne figurait plus dans les paquets KDE.

      Abandonware et logiciel libre : fragilité des inutilitaires

      Ainsi, certains inutilitaires propriétaires ont été définitivement abandonnés, tandis que d’autres, semblent glisser progressivement vers ce statut. D’autres encore n’ont jamais franchi « l’autre côté du miroir », à l’image du voyage de Neko, c’est-à-dire le passage d’un modèle propriétaire vers une version libre. Bien que cela n’altère pas leur valeur ludique, artistique ou philosophique, cela compromet leur avenir : privés de sources accessibles, ils perdent toute possibilité d’évolution et de renouvellement. Pour ceux qui ne sont pas passés de l’autre côté du miroir, l’émulation ou la virtualisation restent souvent les seuls moyens de les préserver de l’oubli. Toutefois, en tant qu’inutilitaires peu connus, ils risquent de disparaître lentement de la mémoire collective. L’approche préservation d’abandonware tente d’apporter une réponse, mais elle demeure contraignante : rares sont ceux qui installeront un système complet, en dual-boot ou en machine virtuelle, au seul fin de retrouver la poésie singulière de ces inutilitaires obscures. Dans le cas de la mise en retrait de Kodo, ou de l’abandonware dans le logiciel libre, Eric S. Raymond rappelait un principe fondamental :

      « When you lose interest in a program, your last duty to it is to hand it off to a competent successor. »

      Comme il le souligne dans The Cathedral and the Bazaar, la vitalité d’un logiciel dépend non seulement de l’engagement de ses créateurs initiaux, mais aussi de leur capacité à le transmettre à ceux qui sauront le faire vivre et évoluer.
      Cette dualité met en lumière la fragilité des « inutilitaires » numériques : les logiciels propriétaires abandonnés demeurent prisonniers de leur époque, tandis que certains logiciels libres sombrent également dans l’oubli faute de suivi ou de communauté active.

      Nous en arrivons désormais à Gource, afin de percevoir ce que représente une communauté vivante, participative et active : la face la plus connue du logiciel libre, celle que tous les community managers aspirent à montrer et que tous les participants souhaitent expérimenter, à l’inverse des logiciels abandonnés.

      Gource en guise de conclusion pour 2025 et de Passage en 2026

      Gource ou la danse du libre dans le village global contemporain

      En passant à la nouvelle année 2026, notre ère actuelle de la participation collaborative, portée par les projets libres et open source, Gource déploie l’histoire d’un projet logiciel comme un poème en mouvement : des points de lumière naissent, se rapprochent, se séparent, traçant dans l’obscurité la mémoire vivante du code. Chaque commit devient une bifurcation du temps, et l’écran se fait constellation où l’effort collectif palpite. À la manière d’Octavio Paz, cette visualisation n’explique pas : elle révèle. Elle suspend le regard entre le flux et la forme, entre l’instant et la durée, rappelant le mouvement circulaire de son texte Piedra de sol (1957), où le temps n’avance pas en ligne droite mais revient, se replie et se réinvente. De la même façon, Gource ne raconte pas le développement comme une simple succession de versions, mais comme un présent perpétuel où passé et devenir coexistent à l’écran.

      Chaque apparition de fichier ou de contributeur agit comme un « instant éclair », où le flux se condense et devient visible. La visualisation devient alors un espace de dialogue — entre individus, entre traces, entre silence et action — faisant écho à Blanco (1967), poème de l’espace et de la relation, ouvert à des lectures multiples, sans centre unique. Comme chez Paz, le sens ne naît pas de la juxtaposition de signes, mais de leur mise en relation.

      Cette pluralité en mouvement rejoint la vision cosmopolite de Himno entre ruinas, où les voix du monde se croisent sans se dissoudre. Gource matérialise cette dynamique en montrant le développement comme une constellation d’acteurs dispersés sur la planète, unis par un même espace symbolique. Ici, l’interconnexion n’est pas un simple outil technique : elle est la condition même de l’existence du projet. C’est en cela que Gource rejoint la pensée de Marshall McLuhan, pour qui le « village global » ne désigne pas une uniformisation du monde, mais une intensification des relations, où chaque geste local résonne immédiatement à l’échelle planétaire.

      Enfin, à l’image de Viento entero, où le présent se construit à partir de fragments hérités et réassemblés, Gource fait émerger une œuvre collective à partir de traces, de modifications successives, de strates de mémoire. Dans cette cité-monde interconnectée que McLuhan entrevoyait, la réflexion ne commence plus à partir d’un centre stable, mais du réseau lui-même. Gource en offre une figuration sensible : un village global de code et de lumière, où la création naît du passage, de l’échange et de la rencontre, et où l’interconnexion devient le point de départ de toute pensée commune.

      Chaque contribution devient un souffle, chaque fichier une étoile, et le code collectif se déploie comme un poème en mouvement, où passé et présent, technique et humain, local et global s’entrelacent. C’est ainsi que nous sommes invités à percevoir nos vies numériques au cœur de nos interactions et de nos commits au sein de ce projet planétaire.

      Ainsi, à travers Gource, l’esthétique du processus de collaboration globale propre au logiciel libre apporte une réponse concrète au questionnement du philosophe Byung-Chul Han (Pyŏng-ch’ŏl Han 한병전), qui déplorait la perte de profondeur au profit de surfaces lisses, brillantes et réflexives, mais fondamentalement creuses. Gource, par sa cartographie en constellations des processus collaboratifs du logiciel libre, démontre qu’il est possible d’évoluer au sein d’une constellation scintillante sans renoncer à la profondeur, celle-ci étant incarnée par le code source, l’historique des contributions et le processus open source d’élaboration collective du logiciel libre.

      Contrairement aux œuvres de Jeff Koons, dont la brillance tend à masquer le vide, la visualisation proposée par Gource repose sur un socle profond, multiple et participatif. La surface lumineuse n’y est jamais autonome : elle renvoie toujours à une réalité sous-jacente faite de travail, de temporalité, de négociations, et de coopérations. En ce sens, Gource peut être considéré comme un exemple paradigmatique d’un reflet brillant issu d’un modèle profondément structuré, à l’exact opposé de l’esthétique lisse et creuse dénoncée par Han.

      Par ailleurs, Gource incarne de manière exemplaire un espace de l’altérité, rendu visible par la contribution de chacun. Chaque contributeur y apporte sa perspective singulière, sa sensibilité propre et sa touche personnelle, participant ainsi à une œuvre collective en perpétuel devenir. Cette dynamique rejoint l’analyse d’Eric S. Raymond dans The Cathedral and the Bazaar, lorsqu’il souligne que « The next best thing to having good ideas is recognizing good ideas from your users », rappelant que la richesse du logiciel libre réside précisément dans la reconnaissance et l’intégration des apports de l’autre.

      Enfin, à l’instar des poèmes de Han Shan surgissant sur les rochers ou les murs, Gource fait apparaître un ciel constellé, où chaque contribution éclaire fugitivement la galaxie vivante du projet, révélant la fluidité d’un processus créatif libre et en mouvement.

      gource

      gource2

      Conclusion

      L’histoire des inutilitaires se déploie comme une poésie vivante, du calcul solitaire à l’intelligence collective. Sur son chemin, des instants inattendus surgissent : Xteddy, simple peluche virtuelle, montre que l’inutile peut étonner, émerveiller et tisser des liens, éveillant réflexion et imagination.

      Les communautés libres insufflent vie à ces créations, leur offrant la force de survivre, d’évoluer et de voyager librement de plateforme en plateforme, à l’instar de Neko.

      Dans un monde de codes et de réseaux, chaque contribution devient une étoile dans le « village global » de McLuhan, où frontières et distances s’effacent. Gource, FSV2 et GopherVR transforment l’exploration numérique en chorégraphie de lumière et de mémoire, révélant l’élan vivant et créatif des communautés du logiciel libre. L’informatique cesse alors d’être purement utilitaire : elle devient poésie, labyrinthe et voyage.

      Mais la survie d’un logiciel ne repose pas seulement sur l’ouverture de son code : elle exige transmission, engagement communautaire et capacité à évoluer. Nous espérons que de plus en plus d’abandonwares et d’inutilitaires suivront le voyage de Neko, passant de l’ombre à la lumière du libre, enrichissant sans cesse l’espace vivant du logiciel. Il est tout aussi crucial que les logiciels déjà libres ne soient pas abandonnés, afin que l’histoire de l’informatique continue de s’écrire dans une dynamique collective et créative, où chacun reste acteur de son informatique, à l’inverse des monopoles évoqués dans XBill.

      Et qu’un jour, nous puissions nous voir dans une de ces constellations cartographiques telle que Gource nous le montre, pour contempler, émerveillés, que dans cette poésie numérique, nous y avons tous participé.

      Bonne année 2026 !

      Pour aller plus loin ensemble en traineau

      Il existe peu de livres consacrés aux inutilitaires, car, comme le pensait IBM (à l’inverse, par exemple, de l’Amiga) et sous son influence sur le domaine, l’informatique était considérée comme une affaire sérieuse. Pourtant, certains ouvrages ont documenté et inspiré ces créations décalées et humoristiques, notamment :

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      Nouvelle année, vœux 2026, voyageons dans le temps

      En cette traditionnelle période de vœux lors du changement d’année, voyons ce qui devrait… changera… pourrait éventuellement changer ou non. Donc une nouvelle fois encore retour sur nos accomplissements passés et projection dans le futur, vers ce que nous aimerions voir plus sur notre site préféré et écouter plus dans notre podcast préféré.

      Bonne année 2026

      Quatre personnes se sont prêtées au jeu de cette dépêche, pas vraiment de vœux, mais un peu quand même. En vrac dans les accomplissements : retours d’expérience, accessibilité, rencontres, arkéologie, transmission, fiabilité, migration, vote électronique, technocritique, documentation et programmation. L’année qui vient, sur LinuxFr.org et Projets Libres, promet d’être fédérée, pérenne, humaine, sobre, excitante, écrite et écoutée, réutilisable, réparable et résiliente.

        Sommaire

        Benoît (Oumph) Sibaud

        Accomplissements, réalisations, progrès de l’année 2025

        Commençons par le serpent de mer de la réduction du retard côté adminsys pour LinuxFr.org : une plus grande partie des services est maintenant portée par une distribution récente (Debian Trixie), avec un mélange de conteneurs lxc et docker. Évidemment on passe toujours trop de temps à gérer du spam et des pénibles. J’ai eu l’occasion de rejouer avec des cartes DRAC pendant les incidents, d’écrire des comptes-rendus d’incident (ne jamais négliger leur importance) et de faire un peu plus de systemd.
        J’ai participé au stand et aux animations sur place lors de la conférence Open Source eXPerience Paris et c’était toujours agréable et remotivant de voir d’autres personnes de l’équipe, de notre lectorat, des libristes connus de longue date et des nouvelles personnes. Le 28 juin 2025, on fêtait les deux ans de la politique de minimisation des données et il ne s’est rien passé car la prochaine étape est en juin 2026 (les premiers comptes avec trois ans d’inactivité).

        Je suis satisfait d’une certaine fiabilité en termes de contenus publiés : les rétrospectives toutes les quinzaines, la traditionnelle dépêche d’appel aux dons, les non moins régulières assemblée générale et publication de bilan et célébration d’anniversaire ou un poisson d’avril.

        En dehors de contenus attendus, j’ai écrit sur les sujets liés à LinuxFr.org (OSI rejointe, incidents du 26 juin et du 26 août), sur des sujets qui m’intéressent (la maintenance, le vote électronique ou le jeu d’apprentissage SQLNoir), des sujets plus tristes (un décès parmi d’autres ou une fin de vie pour un projet), et publié quelques liens sur les licences, la sécurité, le vote électronique, l’Union européenne, les dons, la technocritique et le spam.

        Ce que je voudrais faire, apprendre ou approfondir en 2026

        Déjà dans les reports de 2024, je voudrais m’intéresser au Fediverse et à ActivityPub peut-être, et peut-être à Gemini (le protocole) ? Il y a des travaux en cours sur le service de partage sur les réseaux sociaux share. Par contre j’ai donné moins de conférences en 2024 pour LinuxFr.org et globalement assisté à moins d’événements : donc je réitère l’ambition 2025 de rencontrer plus régulièrement le lectorat ou les personnes contribuant au site ou des publics nouveaux, car c’est appréciable pour le moral et la motivation.

        Hum c’est malheureusement bon on peut garder tel que.

        Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

        De manière générale, je suis toujours intéressé par plus de contenus sur LinuxFr.org (idéalement des dépêches). Mais plus précisément, en termes de sujet, j’aimerai encore et toujours plus d’articles la réparation, la maintenance et la réutilisation, sur la sobriété en informatique, sur la lutte contre la corruption, sur les sujets politiques autour du numérique et des données. Et bien sûr toujours plus de retours d’expérience, de sujets qui ne me viendraient pas à l’idée (sérendipité) et de sujets qui vous passionnent vous (partagez !). Pour Projets Libres, c’est un peu de la triche, j’ai accès à la préparation et j’ai déjà un premier aperçu de la richesse des sujets qui seront traités, mais je sais aussi qu’on compte sur vous pour aider à enrichir les émissions avec vos suggestions diverses et variées.

        Walid (Wawa) Nouh

        Accomplissements, réalisations, progrès de l’année 2025

        L’année 2025 a été chargée puisque 19 émissions ont été diffusées. Nous avons eu aussi l’occasion de parler dans des conférences et des meetups.
        Le podcast continue à gagner en visibilité et d’après nos statistiques OP3 (qui ne sont pas parfaites), pour la première fois deux épisodes ont dépassé les 2000 téléchargements dans le premier mois (Dégooglisons l’évaluation avec Framasoft, et le futur sera fédéré et auto-hébergé avec Elena Rossini).
        J’ai finalement trouvé le temps de poser des mots pour expliquer mon travail sur le podcast, résumé comme ceci : documenter, transmettre, apprendre.
        Bien entendu la grosse actualité de la fin d’année est le rapprochement avec LinuxFr, qui est une suite logique et aussi une reconnaissance de notre travail depuis 2023.
        Pour finir, nous avons eu l’occasion, à travers l’association LinuxFr, de donner des cours d’introduction au logiciel libre dans une école d’ingénieur (Florent Zara, Raphaël Semeteys, Jérôme Herledan et moi-même). Cela confirme mon idée que des prestations annexes sont un moyen intéressant de financer l’édition du podcast et de faire en sorte de ne pas avoir de publicité.

        Ce que je voudrais faire, apprendre ou approfondir en 2026

        Pour cette nouvelle année, Raphaël et moi avons fixé un thème, qui sera la ligne directrice de notre travail sur 2026 : pérennité et résilience.

        – Pérennité, car c’est un sujet qui nous tient à cœur, à travers les épisodes sur les fondations, ou sur les projets qui existent depuis un grand nombre d’années.
        – Résilience : c’est la suite logique de tous les épisodes qui traitent, entre autres du Fediverse, de l’auto-hébergement et de l’informatique responsable et c’est plus que jamais important vu l’actualité géopolitique actuelle.

        Mes souhaits vont sûrement évoluer courant de l’année, mais j’aimerais dans les semaines à venir commencer à tester des OS mobiles basés sur Linux (Ubuntu Touch et PostmarketOS pour commencer), afin de préparer de potentiels épisodes sur le sujet.
        J’aimerais aussi donner plus la parole à des personnes qui utilisent le libre (dans la lignée de l’épisode avec Elena Rossini).
        Bref, beaucoup d’idées, le backlog est d’actuellement une cinquantaine d’épisodes…

        Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

        Je vais surtout passer plus de temps à relire du contenu déjà présent sur LinuxFr :)
        Comme annoncé lors de l’évènement AssocialClub au salon Open Source Experience, il y a toute une intégration du podcast dans et avec LinuxFr à imaginer, cela va être passionnant !

        vmagnin (Vincent)

        Accomplissements, réalisations, progrès de l’année 2025

        Côté accomplissements sur LinuxFr, je suis surtout content d’avoir fait œuvre arkéologique avec ma série automnale de cinq journaux consacrés aux Fiches Libres, au site antique GNULinews et aux Tuxeries (1, 2, 3). Cela a abouti à la modernisation des fiches par Ysabeau et de mon côté à la restauration des Tuxeries, plus de deux cents images et animations du dessinateur JC.

        Toujours à cheval entre passé et futur (donc dans le présent ?), j’ai publié ma dépêche n°7 sur le Fortran. La disparition du service non-libre Netvibes m’a forcé à migrer vers une Pétrolette libre. Et parmi les dépêches auxquelles j’ai contribué sensiblement, je me souviens surtout de Rendez-nous nos boutons !, un questionnement humoristique sur certaines évolutions techniques imposées parfois sans discernement.

        À part ça, en 2025 j’ai migré mes machines de travail d’Ubuntu vers Fedora. Probablement en partie pour retrouver un peu le piment qu’on ressentait à chaque version d’Ubuntu il y a 20 ans. Dans toute vraie passion, il y a apparemment une quête de l’excitation originelle que l’on essaie de retrouver décennie après décennie. Oui, j’essaie aussi de rejouer encore une fois l’excitation pré-adolescente de l’apprentissage de la programmation grâce à Rust. J’ai terminé de lire le livre Développez avec Rust (Dunod).

        Ce que je voudrais faire, apprendre ou approfondir en 2026

        Je suis loin de maîtriser les nouveaux concepts présentés dans ce très bon livre, mais j’ai au moins balayé l’essentiel et j’ai tout 2026, enfin j’espère, pour progresser en Rust. Et aussi avancer un peu dans quelques projets Fortran pro ou perso.

        Continuer à réfléchir sur l’IA et sur la poursuite de l’informatisation du monde. Avec en ce moment comme toile de fond la lecture de La Technique ou l’enjeu du siècle de Jacques Ellul (2ᵉ édition de 1960), qui se termine par : « […] nos plus intimes passions sont connues, publiées, analysées, utilisées. L’on y répond, l’on met à ma disposition exactement ce que j’attendais, et le suprême luxe de cette civilisation de la nécessité est de m’accorder le superflu d’une révolte stérile et d’un sourire consentant. » Après autant de lucidité, on verra si j’ai le courage de lire Le Système technicien (1977) qui se termine par : « L’homme qui aujourd’hui se sert de la technique est de ce fait même celui qui la sert. Et réciproquement seul l’homme qui sert la technique est vraiment apte à se servir d’elle. » Pas glop !

        Bon, ça ne m’empêchera pas d’écouter des podcasts Projets Libres / LinuxFr.org. Et ne soyons pas sombre puisque 2026 est un nombre heureux (voir le site OEIS pour plus de propriétés de 2026).

        Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

        Monomanie technicienne : des trucs sur Rust :-)

        Ysabeau

        Accomplissements, réalisations, progrès de l’année 2025

        Une année moins productive que les précédentes sur le plan informatique, quoique ! En avril un tutoriel sur Mastodon, les balises Alt et deux ou trois autres trucs qui fait partie de ce que je voulais approfondir : l’accessibilité des textes. Par contrecoup, pour mes sites j’essaie d’avoir aussi des images et documents mieux présentés.

        Sinon pour LinuxFr : la dépêche sur Delphine Demange et les compilateurs m’a donné, enfin, l’occasion d’en savoir plus (de découvrir en fait) sur les compilateurs et les commentaires, dont j’ai vraiment apprécié la qualité, de résoudre un mystère vieux de 2020. Avec celle sur la sortie d’Unicode 17 j’ai approfondi ma connaissance des systèmes d’écriture et de ce qui est nécessaire pour qu’il puisse figurer dans le registre Unicode. L’histoire de la convention du mètre et de l’ODF a été aussi un genre d’épopée en ce qui me concerne puisque j’ai profité de l’occasion pour « epubifier » un document complexe avec formules de mathématiques et autres joyeusetés, Le Système métrique décimal. Sa création en France. Son évolution. Ses progrès. Et, évidemment, les fiches libres, que je dois continuer à revoir, ont été sources d’enseignements, j’aime bien l’idée du travail arkéologique. Par contre, j’ai laissé le Transimpressux en jachères.

        Si j’ai relativement peu écrit, j’ai beaucoup tricoté, des bérets, notamment, sur la base d’une méthode que j’ai mise en ligne et qui a réclamé quasiment l’entièreté de mes capacités mathématiques (pas grand-chose). Et en fait, j’aurais pu faire plus simple… Et puis j’ai fait du Banksy.

        Deux versions du marque-page la petite fille au ballon ou les petites filles couleur chocolat tiennent un ballon dans leur main, l’un est en robe rose l’autre en robe jaune
        Marque-pages la petite fille au ballon inspirés de celle de Banksy même si, au final, le résultat est très différent.

        Ce que je voudrais faire, apprendre ou approfondir en 2026

        L’accessibilité, encore et toujours, écrire un ou des tutoriels sur le sujet. Utiliser plus ou mieux Draw pour faire des modèles de jouets de papier. Et, oui, j’ai encore à apprendre sur l’EPUB, et Inkscape. Oh, et continuer des dépêches de la série Transimpressux, il faut vraiment que j’écrive sur l’Unicode dans ce cadre.

        Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

        Des contenus sur l’accessibilité, la réparabilité, le bricolage informatique comme celles du dernier journal de Sébastien Rohaut ou celui d’Ecran Plat sur les clés USB-C lentes. Et aussi plus de contenus sur l’histoire de l’informatique et des logiciels et de l’arkéologique.

        Pour finir

        Nous vous souhaitons tout de même la meilleure année possible (on oscille entre excellence optimisée et résilience robuste ainsi que pérennité soutenable et humour drolatique). Et, bien évidemment, n’hésitez pas à « continuer » cette dépêche dans les commentaires.

        Et un merci à toutes celles et ceux qui font de LinuxFr.org un site enrichi en sérendipité et surprises et de Projets Libres un podcast nimbé de découvertes et bienveillance.

        Commentaires : voir le flux Atom ouvrir dans le navigateur

        Lettre d'information XMPP de novembre 2025

        N. D. T. — Ceci est une traduction de la lettre d’information publiée régulièrement par l’équipe de communication de la XSF, essayant de conserver les tournures de phrase et l’esprit de l’original. Elle est réalisée et publiée conjointement sur les sites XMPP.org et LinuxFr.org selon une procédure définie.

        Bannière de la lettre d'information XMPP

        Bienvenue dans la lettre d'information XMPP, ravi de vous retrouver ! Ce numéro couvre le mois de novembre 2025.

        Comme tout autre projet accompli par la XSF, cette lettre d'information est le résultat du travail volontaire de ces membres et des personnes y contribuant. Si vous êtes satisfait des services et logiciels que vous utilisez peut-être, n'hésitez pas à dire merci ou aider ces projets.

        Vous souhaitez contribuer à l'équipe de communication de la XSF ? Lisez en bas de page.

          Sommaire

          Annonces de la XSF

          Sommet XMPP 28 & FOSDEM 2026

          La XSF planifie le Sommet XMPP 28, qui aura lieu les jeudi 29 et vendredi 30 janvier 2026, à Bruxelles. À la suite du Sommet, la XSF prévoit également d'être présente au FOSDEM 2026, qui auront lieu les samedi 31 janvier et dimanche 1er février 2026. Tous les détails sont disponibles sur notre wiki. Merci de vous enregistrer maintenant si vous prévoyez de participer, cela nous aide pour l'organisation. Cet évènement est naturellement ouvert à toutes les personnes qui sont intéressées pour participer. Faites passer le mot autour de vous !

          Articles XMPP

          XMPP et ActivityPub : 2 approches différentes

          Nouvelles des logiciels XMPP

          Clients et Applications XMPP

          • Dino a publié la version 0.5.1 de son client de discussion moderne et open-source pour le bureau. Il se concentre sur la fourniture d'une expérience Jabber/XMPP épurée et fiable, en gardant à l'esprit votre vie privée.
          • Gajim a publié la version 2.4.0 de son app gratuite et bourrée de fonctionalités pour XMPP. Cette publication apporte les marqueurs de lecture dans les salons, l'amélioration du transfert de fichier, plus de détails sur votre compte, et un grand nombre de petites modifications et corrections de bogues. Merci pour toutes vos contributions ! Vous pouvez voir le changelog pour tous les détails.

          Gajim : votre profile sur la page des comptes

          • Monal a publié sa version 6.4.14 pour iOS et macOS.
          • Monocles a publié sa version 2.0.17 de son client de discussion pour Android. Cette mise à jour apporte certaines corrections telles que des icones de confirmations mieux visibles, la mise à jour et ajout du filtre de la bibliothèque de photos, la correction du menu d'édition photo débordant sur la barre de statut, le paramètre pour toujours utiliser les relais, et l'amélioration de la logique de suppression d'extension, parmi bien d'autres. Prenez connaissance du changelog pour tous les détails !
          • Movim a publié sa version 0.32, nom de code 'Wilk', et sa version 0.32.1 ayant immédiatement suivi. C'est probablement une des plus grosses publication jamais réalisée par le projet. Elle inclut un grand nombre de corrections et des nouvelles fonctionnalités dans 3 domaines principaux proposés par Movim : messageire intantanée, réseautage, vidéoconférence. Jettez un oeil au communiqué de publication officiel et plongez directement dans les apports excitants de cette publication !

          Movim : Partager, liker, et commenter les articles plus facilement

          Serveurs XMPP

          Snikket Server - November 2025 release : C'est prêt ! Nous avons été occupés par la préparation d'une nouvelle publication du logiciel serveur Snikket pour vous faire plaisir. Bien que cette publication n'est pas vraiment étoffée en nouvelles fonctionnalités visibles, un grand nombre de modifications internes et améliorations ont été intégrées dans cette publication pour accroitre la fiabilité et ouvrir la voie à de futurs projets.

          Bibliothèques et outils XMPP

          • python-nbxmpp, une bibliothèque Python qui permet aux applications Python d'utiliser le réseau XMPP, a été publiée en version 6.4.0. L'ensemble des détails est disponible dans le changelog.
          • QXmpp, une bibliothèque serveur et client XMPP multi-plateforme en C++, a été publiée en version 1.12.0. L'ensemble des détails est disponible dans le changelog.
          • slidge-whatsapp, la passerelle WhatsApp vers XMPP basée sur Slidge et whatsmeow, a été publiée en version 0.3.8.
          • Smack, une bibliothèque pour Android et Java, modulaire, portable et facile à utiliser pour des clients XMPP, a été publiée en version 4.5.0 RC1. Merci de tester cette proposition de publication dans vos étapes d'intéragration et rapporter tout problème que vous pourriez rencontrer. Plus il y a de gens testant activement les propositions de publication, moins il restera de problèmes dans la publication finale.
          • xmpp.js, une bibliothèque JavaScript pour XMPP, a été publiée en version 0.14.0. Cette publication apporte une gestion de la connexion plus rapide et plus fiable grace à l'implémentation complète de Stream Management, SASL2, Bind 2 et FAST. Une autre évolution importante est le retrait de toutes les dépendances tierces. L'ensemble des détails est disponible dans le changelog.

          Extensions et spécifications

          La XMPP Standards Foundation développe des extensions à XMPP dans sa série de XEP en plus des RFC XMPP. Des développeuses, développeurs et autres personnes expertes en normes du monde entier collaborent à ces extensions, élaborant de nouvelles spécifications pour les pratiques émergentes et affinant les méthodes existantes. Proposées par n'importe qui, celles qui remportent le plus de succès finissent par être classées comme finales ou actives, selon leur type, tandis que les autres sont soigneusement archivées comme différées. Ce cycle de vie est décrit dans la XEP-0001, qui contient les définitions formelles et canoniques des types, des états et des processus. Vous pouvez en savoir plus sur le processus de normalisation ici. La communication autour des normes et des extensions se fait via la liste de diffusion des normes (archives en ligne).

          Extensions proposées

          Le processus de développement d'une XEP commence par la rédaction d'une idée et sa soumission à l'éditeur XMPP. Dans un délai de deux semaines, le Conseil décide d'accepter ou non cette proposition en tant que XEP expérimentale.

          • Pas de XEPs proposées ce mois-ci.

          Nouvelles extensions

          • Version 0.1.0 de XEP-0507 (Jingle Content Category)
            • Passée à Experimental par vote du Conseil (dg)

          Extensions déférées

          Si une XEP expérimentale n’est pas mise à jour pendant plus de douze mois, elle sera retirée de la catégorie Expérimentale pour être classée comme Déférée. Si une mise à jour intervient, la XEP sera replacée dans la catégorie Expérimentale.

          • Aucune XEP déférée ce mois-ci.

          Extensions mises à jour

          • Version 1.30.0 de XEP-0060 (Publish-Subscribe)
          • Version 0.5 de XEP-0440 (SASL Channel-Binding Type)
            • Gère une possible attaque de l'homme du milieu en rendant la connexion tls-server-end-point comme devant être impérativement implémentée
            • Retire l'intégralité de la section 'Interaction with SASL mechanisms' en la remplacant par 'Business Rules'
            • Amélioration de la section 'Security Considerations'
            • Mises en formes éditoriales mineures
            • Ajout de Thilo Molitor en tant qu'auteur (tm)
          • Version 0.5.0 de XEP-0474 (SASL SCRAM Downgrade)
            • Ajout d'un 'Business Rules' décrivant le comportement du client
            • Make clear that PLAIN still has to be pinned away, if not disabled entirely (tm)
          • Version 0.2.0 de XEP-0492 (Chat notification settings)
            • Amélioration de la spec pour tirer profit du registre du Service Discovery Identities
            • Corrige le schéma XML
            • Déplace l'élément <advanced/> dans l'élément de paramètre de notification
            • Retrait de l'espace de nom (tm)

          Dernier appel

          Les derniers appels sont lancés une fois que tout le monde semble satisfait de l'état actuel d'une XEP. Une fois que le Conseil a décidé que la XEP semble prête, l'Éditeur XMPP émet un dernier appel pour recueillir des commentaires. Les commentaires recueillis lors du dernier appel peuvent aider à améliorer la XEP avant de le renvoyer au Conseil pour qu'il passe à l'état Stable.

          • Pas de Dernier Appel ce mois-ci.

          Extensions stables

          • Version 1.0.0 de XEP-0485 (PubSub Server Information)
            • Passé à Stable par décision du vote du Conseil le 11/11/2025 (XEP Editor(dg))

          Extensions dépréciées

          • Aucune XEP n’a été dépréciée ce mois-ci.

          Extensions rejetées

          • Aucune XEP n’a été rejetée ce mois-ci.

          Salons publics XMPP

          De nouveaux salons et canaux publics sont créés quotidiennement sur le réseau XMPP. Si vous êtes à la recherche de nouvelles discussions intéressantes auxquelles vous joindre, n'hésitez pas à consulter le moteur de recherche de canaux publics pour trouver des groupes ou des communautés qui partagent vos centres d'intérêts !

          • Si vous souhaitez obtenir la liste de tous les canaux, vous pouvez la trouver ici.
          • Si vous vous intéressez à un sujet en particulier, effectuez une recherche par tag !
          • Si vous souhaitez uniquement répertorier les salons dans une langue particulière, ajoutez simplement « lang:xx » dans le champ de recherche, comme dans cet exemple pour la langue espagnole. Veillez simplement à remplacer « es » par la langue souhaitée (par exemple « lang:fr », « lang:de », « lang:pt », etc.).

          Partagez les nouvelles

          Veuillez partager cette nouvelle sur d'autres réseaux :

          Consultez également notre flux RSS !

          Vous recherchez des offres d'emploi ou souhaitez engager un consultant professionnel pour votre projet XMPP ? Consultez notre tableau d'affichage des offres d'emploi XMPP.

          Contributions et traductions de la lettre d'information

          Il s'agit d'un effort communautaire, et nous tenons à remercier les traductrices et traducteurs pour leur contribution.
          Les bénévoles et les nouvelles langues sont les bienvenues !
          Les traductions de la lettre d'information XMPP seront publiées ici (avec un certain retard) :

          Contributions à la lettre d'information de ce mois-ci :
          emus, cal0pteryx, edhelas, Gonzalo Raúl Nemmi, Ludovic Bocquet, Sonny Piers, XSF iTeam

          Contributions à la traduction :

          • Français : Adrien Bourmault (neox), alkino, anubis, Arkem, Benoît Sibaud, mathieui, nyco, Pierre Jarillon, Ppjet6, Ysabeau
          • Allemand : Millesimus
          • Italien : nicola
          • Portugais : Paulo

          Aidez-nous à créer la lettre d'information

          Cette lettre d'information XMPP est produite en collaboration avec la communauté XMPP. Chaque numéro mensuel est rédigé dans ce simple pad. À la fin de chaque mois, le contenu du pad est fusionné dans le dépôt GitHub de la XSF. Nous sommes toujours ravis d'accueillir de nouvelles personnes contributrices. N'hésitez pas à rejoindre la discussion dans notre groupe de discussion Comm-Team (MUC) et à nous aider ainsi à poursuivre cet effort communautaire. Vous avez un projet et souhaitez le faire connaître ? N'hésitez pas à partager vos actualités ou événements ici, et à les promouvoir auprès d'un large public.

          Tâches que nous effectuons régulièrement :

          • collecte d'actualités dans l'univers XMPP
          • résumés courts d'actualités et d'événements
          • résumé de la communication mensuelle sur les extensions (XEP)
          • révision du projet de lettre d'information
          • préparation d'images pour les médias
          • traductions
          • communication via les comptes des médias

          Hébergement fiscal de projets par la XSF

          La XSF propose un hébergement fiscal pour les projets XMPP. Veuillez postuler via Open Collective. Pour plus d'informations, consultez l'article de blog annonçant cette initiative. Projets actuels que vous pouvez soutenir :

          Licence

          Cette lettre d'information est publiée sous licence CC BY-SA.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Lancement de la Journée d'Indépendance Numérique (DI-DAY) suite au 39c3

          Beaucoup de nos services numériques du quotidien sont propulsés en partie voire entièrement par les GAFAM. Les risques de cette dépendance s'illustrent de plus en plus fréquemment dans l'actualité : représailles envers l'ex-Commissaire européen Thierry Breton et des ONG luttant contre la désinformation en ligne, clôture de la boite de courriel du procureur de la Cour Pénale Internationale, …

          Ces vulnérabilités mettent en danger le fonctionnement des démocraties européennes.

          On peut être tenté d'attendre une nouvelle législation européenne, cependant le carburant de ces plateformes est en premier lieu nos données personnelles : quitter ces plateformes réduit à la fois notre exposition personnelle et notre contribution collective à ce système néfaste.

          C'est le sens de l'appel lancé à Hambourg lors du 39ème CCC : le 4 janvier (puis chaque 1er dimanche du mois), faites migrer vos connaissances d'une des plateformes et faites le savoir en utilisant les mots clés #DiDay ou #iDidIt sur le Fediverse.

          Cet appel est soutenu notamment par Wikimedia, Nextcloud et Mastodon, et l'information a été relayée par la 1ère chaîne de TV allemande. Espérons que des acteurs de l'espace francophone s'y joignent rapidement !

          Linux est bien sûr une des alternatives, dont la progression est en bonne voie « grâce » à Microsoft (mouvement qui s'inscrit parfaitement dans les initiatives existantes Adieu Windows ou End Of 10). Mais l'initiative concernent tous les services dépendants de ces plateformes toxiques : messageries instantanées, stockage en ligne, librairies en lignes, … dont la gratuité ou les prix au rabais reposent sur l'exploitation de nos données personnelles.

          Le succès dépend donc de vous qui lisez cet article, et des relais « physiques » qui pourront accompagner ces migrations : cafés réparation, GULLs, librairies physiques, bibliothèques, … mois après mois !

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Un numéro 9 du Lama qui se déchaine un peu plus

          Un nouveau numéro du Lama déchainé sort ce mercredi comme chaque semaine depuis deux mois. Celui-ci est un peu spécial, car totalement réorganisé en dernières minutes. N’ayant pas de plume invitée, une plume s’est infiltrée, modifiant la thématique du numéro.

          Alternative à OBS studio ?

          Il faut savoir que l’organisation de la campagne du Lama déchainé se fait sur la liste de discussion du groupe de travail sensibilisation de l’April. Quand lundi matin, à la place de la réunion hebdomadaire, j’ai lancé un appel à l’aide, nombreuses sont les personnes à avoir répondu présentes. La gazette s’est complétée au fur et à mesure des textes principaux en une demie journée ! (sauf l’écho des assos qui était déjà prêt).

          Donc dans ce numéro 9 intitulé « le libre a gagné » vous retrouverez comme chaque semaine :

          • l’édito de la victoire écrit par Gee, tout comme le dessin humoristique découvert plus haut ;
          • une actu brûlante: l’émission de l'April Libre à vous! a reçu le prix spécial du jury des «Acteurs du Libre» lors du salon OpenSource Expérience ce mercredi 10 décembre 2025. Et que l’ambiance lors de la remise a perturbé ma mémoire (auto-dénonciation) vive les bénévoles du site internet et des musiques, na ! ;
          • une idée à déconstruire proposée par Étienne Gonnu, un salarié de l’association ;
          • Laurent Costy, vice-président de l’April, s’est confié à nos journalistes dans la parole de bénévoles ;
          • La chronique de Libre à vous! mise en avant cette semaine est « Les transcriptions qui redonnent le goût de la lecture » ;
          • Les chiffres de la semaine sont 549 (ou plus précisément 282+64+117+12+14+60) ;
          • L’écho des assos a été confié à l’ALDIL ;
          • Frédéric Couchet, un des co-fondateurs de l’April, a glissé dans sa plume infiltrée sa manière de laisser de la place ;
          • une photo de notre fameux lama tatoué et vernis sur un fairphone, si si ! ;
          • un courrier des lecteurices encore pris dans LinuxFr !

          Sans oublier le logiciel Androïd choisi par Michael, la dernière distribution libre, l'ineptia, le Lama Photonique Interpellant et les mots croisés.

          Lama avec logo de l'April et le texte Quand April fachée, April toujours faire ainsi

          Ce numéro de la gazette est le dernier numéro qui regroupe toutes les rubriques. Le prochain numéro sera un numéro bonus, spécial Noël…

          Plus que 7 jours avant que je ne menace le lama des pires sévices s’il n'atteint pas les 30 000€ de la frise.
          Plus que 15 jours pour adhérer ou faire un don à l’April.

          Merci de votre lecture, de vos commentaires, de vos nombreux relais sur les réseaux sociaux ou ailleurs et, bien sûr, de votre futur soutien !

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Une rare interview/video de Linus Torvalds : Building the PERFECT Linux PC with Linus Torvalds

          Linus Torvalds est invité dans cette toute récente vidéo sur la chaîne Linus Tech Tips. La vidéo dure presque une heure, ce qui est inhabituellement long pour cette chaîne, et permet de laisser s'exprimer un Linus Torvalds invité. Torvalds s'exprime sur de nombreux sujets tout en regardant un PC « idéal » être monté pour lui et ses travaux sur le noyau Linux.

          Il discute du Libre, Gaming, Linux, Git, A.I., de son travail, dans une atmosphère bon enfant et avec un humour mordant.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Blender 5.0 est de sortie

          La version 5.0 de Blender vient de sortir ce 18 novembre 2025. Blender est un logiciel de modélisation, animation, montage, et de rendu en 3D. Il est distribué sous licence GPL depuis 2002.

          Sommaire

          Même si la rétrocompatibilité est cassée sur certaines fonctionnalités, cette sortie est plus — en dehors de la correction de bugs — une amélioration de « qualité de vie » pour les usagers, car elle combine et utilise des concepts déjà implémentés dans la version 4.5 LTS.
          C’est pourquoi cette dépêche couvrira aussi certains aspects de la version précédente (plus certaines notes personnelles).

          Vu que Blender est une sorte de monstre à tout faire (et à rien faire aussi…), bourré de termes internes à sa logique, j’ai préparé un petit lexique qui vous évitera de vous endormir (j’espère !) pendant la lecture.

          Note 1: Les nouveautés sont classées de façon subjective, et donc certaines sont passées à la trappe, pour plus de détails, voir ici.

          Note 2: Suite a une question dans la zone de rédaction sur la compatibilité des Addons (greffons) et des Extensions, la responsabilité incombe aux développeurs des Addons d’assurer la compatibilité entre versions, ce qui redescend sur les utilisateurs évidemment… Les développeurs peuvent consulter cette page et les utilisateurs (des extensions) peuvent se référer à ce site dans les changelogs.

          Lexique préliminaire

          Shaders ou pour les anglophobes, des nuanceurs permettent de donner une apparence à une surface dans un environnement 3D. Sur Wikipédia en plus exhaustif.
          Exemple:
          shader metal

          Les Modificateurs sont des fonctions internes qui modifient un objet de façon non destructive et peuvent être empilés de façon logique (ex : suivre une courbe, lisser, cloner en pavage, etc.) en s’appliquant les uns à la suite des autres.

          Les Geonodes sont un langage de programmation visuel dont l’interface est héritée de celle des shaders. Ils permettent de manipuler la géométrie d’un objet de façon non destructive en accédant à l’API de Blender via des entrées/sorties appelés nœuds. On peut les animer et en configurer l’entrée / sortie (menus, curseurs, boîte de saisie, interface graphique) pour une utilisation plus facile. Ils sont considérés en interne comme des Modificateurs.
          Exemple (cônes instanciés sur sphères instanciées sur plan):
          geonode exemple

          Les Assets sont des bibliothèques d’objets Blender qu’on peut créer et enregistrer pour une utilisation future. Ils s’intègrent à une « scène » par simple cliquer-glisser.

          Le VSE est un éditeur de séquence vidéo, comme Kdenlive (mais avec beaucoup moins de fonctionnalités). L’avantage de l’utiliser dans Blender est son intégration au système de « scènes » du logiciel.

          Le Compositeur permet de modifier un rendu en direct dans la scène 3D, avec des effets que l’on trouve dans la plupart des logiciels de retouche d’image (GIMP, ImageMagick, etc.). Évidemment cela ne s’applique que sur un rendu Blender et donc ne remplace pas les logiciels précédemment cités.
          Exemple : simple passe Hue Saturation Value (HSV)
          compositor passe hsv

          Le Grease Pencil, ou crayon gras, permet de dessiner en vectoriel directement dans la fenêtre de visualisation sur des objets ou des surfaces. Ces tracés sont également des objets 3D manipulables, mais sont « plaqués » dans la perspective de la caméra.
          Exemple (ceci n’est pas un shader avec une image mais un objet Grease Pencil):
          grease pencil exemple


          Assets

          La possibilité de faire ses propres bibliothèques (objets, nœuds, shaders, etc.) a été facilitée : Une scène peut être marquée comme « asset » avec une prévisualisation à créer à partir de la vue caméra et automatiquement importée.
          Les assets peuvent être partagés en tant que fichier .blend en suivant un certain protocole.


          Compositeur et gestion des couleurs

          Déjà présent dans la 4.5
          Ajout des textures procédurales issues de l’éditeur de shader (Briques, Damier, Bruit, etc.).
          D'autres nœuds du compositeur deviennent obsolètes, le compositeur se rapprochant de plus en plus de l’éditeur de shader dans ses fonctionnalités, ce qui amène à…
          Nouveau dans 5.0
          Le compositeur possède maintenant ses propres blocs de données ; ce qui veut dire que les compositions peuvent être portées d’un fichier à l’autre et également être enregistrées en tant qu’assets.
          Plusieurs assets sont fournis à titre d’exemple dans cette sortie (vignette, grain, aberration chromatique, etc.)

          Plus

          • Le nœud « distorsion de lentille » gère maintenant la transparence.
          • Nouveau nœud « Pavage Radial »
          • Ajout de la gestion de couleur ACES 2.0

          L’éditeur de séquence vidéo (VSE)

          Le chapitre précédent implique également qu’on puisse maintenant travailler directement avec le compositeur dans le VSE, ce qui ouvre la voie pour de la post-production en « temps réel ».
          Ainsi, le nouveau modificateur « Compositeur » permet à une grande partie des nœuds du compositeur de s’appliquer aux séquences individuelles du VSE.
          Un exemple vidéo: disponible ici.
          Note perso :
          J’avais l’habitude d’exporter des séquences images rendues avec Blender, puis pré-travaillées avec G'MIC ou GIMP pour les superposer en alpha sur un autre canal du VSE. Maintenant je peux m’en passer, tout du moins pour les opérations simples ; pour les autres, plus complexes ces deux outils me restent indispensables (faut pas abuser, le Compositeur n’est pas la panacée pour moi et à vrai dire, ça a tendance à faire exploser les temps de calcul sur certaines opérations).


          GeoNodes (nœuds de géométrie)

          Des nœuds déjà disponibles dans la 4.5 sont :

          • « Repeat Zone » permet de répéter un groupe de nœuds X fois dans la zone concernée.
          • « Simulation Zone » permet de répéter un groupe de nœuds pour chaque frame dans la zone concernée.

          Nouveau dans la 5.0 :
          Ajout du nœud « Bunddles » qui permet de stocker des valeurs dans un dictionnaire, de combiner des dictionnaires et de les séparer. Très utile pour rendre ses compositions plus lisibles et réutilisables.
          Les GeoNodes deviennent également plus modulaires avec la notion de « Closures », en fait « juste » des groupes de nœuds que l’on peut transformer en fonctions génériques réutilisables.
          Une explication plus détaillée est dispo dans le blog des développeurs.

          Plus

          • Toute une nouvelle série de nœuds pouvant manipuler les volumes.
          • Nouveau nœud « Pavage Radial ».

          Certains GeoNodes font leur apparition dans les modificateurs (et vont en remplacer certains à terme ?)

          • Modificateur « Géométrie comme source » (prend aussi une collection) qui peut se cumuler avec les 3 modificateurs qui suivent
          • Itération d’objet (array) : Circulaire, sur courbe et avec les GUI qui vont bien.
          • Distribution d’objets sur surface
          • Instanciation d’objets sur faces/arêtes/points
          • Courbe comme tube
          • Déformation par lattice (treillis) disponible par menu contextuel

          Note perso :
          L’API ouverte aux GeoNodes s’étoffe de plus en plus, et ça devient très vite très complexe. L’avantage d’avoir une barre de recherche pour les nœuds aide beaucoup, et créer des choses simples pour bricoler des effets reste faisable; mais je pense que la « création de Nodes » va devenir un domaine en soi dans Blender, tout comme le scripting.


          En vrac

          Animation et Rigs

          • Attention : Les données d’animation de la version 5 sont incompatibles avec les versions inférieures à la 4.5.
          • Le greffon « Copy Global transform » a été intégré à Blender.

          Note: Le système d’animation est en train d’être revu assez profondément depuis 2023, et n’étant ni animateur ni rigger je ne peux pas en dire plus. Je vous invite donc à suivre ce lien pour plus d’informations sur les bases de cette refonte.

          Crayon gras (Grease pencil)

          • Ajout du « motion-blur » (flou lié au mouvement)
          • Ajout de deux nouveaux styles de coins

          Note perso :
          Il y a eu beaucoup de mouvements sur cette fonctionnalité, qui est le seul moyen (avec freestyle) de faire du contour direct pour avoir un rendu BD sur des objets 3D. Mais en partant d’une scène, c’est loin d’être magique et il faut vraiment une topologie très propre pour éviter des heures de paramétrage, ou dessiner directement sur les objets (mais vu que je sais pas dessiner !).

          Cycles (Moteur de rendu)

          • Texture de ciel améliorée, avec diffusion multiple de la lumière.
          • La sortie du shader « Déplacement » sur une « Surface de subdivision » est intégrée par défaut.

          EEVEE et fenêtre de visualisation

          • Prise en compte de Vulkan (déjà dans la 4.5)
          • Traitement amélioré du HDR
          • Nouveaux MatCaps
          • Ajout de la surcharge des matériaux sur les calques

          Shaders

          • Nouveau nœud « Pavage Radial ».
          • Nœuds « Closure », « Bundle », « Repeat Zones » disponibles (voir la section GeoNodes).

          Jeu « Dog walk »

          jeu dogwalk
          Le studio blender, une équipe affiliée à la fondation chargée de tester les dernières versions du logiciel au sein de projets concrets, a sorti en juillet 2025 un jeu vidéo nommé « Dog Walk ».
          Une « simulation » de promenade de chien hivernale. Le but initial était de créer/renforcer les outils d’intégration entre Blender et le moteur de jeu Godot.

           Comment débuter ?

          Arrrg, question difficile. Il y a beaucoup trop de ressources, et chaque utilisation est particulière (créer des rendus, animer des séquences d’images, faire de la composition vidéo, faire de l’intégration dans un moteur de jeu) ; donc chaque cas d’usage doit faire l’objet d’une recherche propre (une chose est sure, si vous voulez faire de la CAD, utilisez d’autres logiciels libres !).

          Pour la base de la base et en français, il y a ce lien, c’est daté, mais il y a plein de trucs encore utiles. Sinon il y a le forum Blendertribu, qui semble assez actif.

          Il y a aussi le manuel officiel… pour les barbu/es.

          Pour les impatients, il y a BlenderGuru sur YouTube. Oui « ToiTube » saimal; mais en revanche, le type est là depuis longtemps, explique très bien et a un chouette accent australien pour les anglophones, de plus ses vidéos sont traduites en français.

          Si vous avez d’autres liens à partager n’hésitez pas à commenter ou wikifier.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          AlternC : La 3.5.x continue à être stable

          AlternC est un projet collaboratif dont l’élément de base constitue un logiciel libre de gestion d’hébergements mutualisés pour Debian.

          Ce projet (sous GPLv2+) se veut facile à installer et à utiliser, s’appuyant uniquement sur des logiciels libres.
          Il contient un système d’installation et de configuration automatique, ainsi qu’un panneau de contrôle accessible par le web, pour la gestion des utilisateurs et des services orientés web.
          Le projet s’adresse à un public faisant de l’administration système et souhaitant déléguer les actions de base d’un hébergement web.

          On peut le comparer à des solutions telles que ISPconfig, cPanel, Plesk, Froxlor…

          Après de nombreuses années la version 3.5 est arrivée début 2025 et se prépare à la suite, on se propose de rattraper ce temps perdu.

          Sommaire

          Qui est derrière AlternC ?

          Le projet est porté par différentes structures tant associatives que professionnelles. Nous n’établissons aucune statistique, toutefois, portée à notre connaissance, on peut citer dans un désordre alphabétique :

          • domainpublic avec environ 500 comptes également ;
          • globenet ;
          • infini  ;
          • koumbit qui représente environ 500 comptes pour 2000 domaines et est contributeur historique ;
          • lautre.net compte un peu moins de 1000 adhérents et plus ou moins autant de comptes AlternC ;
          • marsnet avec un peu moins de 200 comptes pour 500 domaines et plus de 200 listes de diffusion ;
          • neuronexion ;
          • octopuce avec environ 80 instances déployées, contributrice historique, héberge une partie de l’infrastructure du projet ;
          • ouvaton avec environ 6000 (sous-)domaines actifs ;
          • webelys contributeur et animateur de la communauté.

          Enfin une version 3.5

          Un peu de contexte historique

          Entre 2018 et fin 2024, la communauté a eu du mal à s’organiser pour fusionner et proposer une cohérence de développement. Durant cette période, il était alors recommandé d’utiliser une version maintenue avec grande détermination par koumbit.

          De nombreux correctifs ont été proposés dans leur bifurcation amicale. C’était de fait la version la plus avancée et active de ces dernières années. On peut noter également que d’autres membres de la communauté disposaient de branches locales. Par exemple, Octopuce maintenait une version 3.3 avec un portage partiel pour fonctionner sur les anciennes versions de Debian.

          Sans être exhaustif dans tous les développements épars, on peut dire qu’on s’était tous un peu dispersé. Il était difficile de répondre à des besoins opérationnels immédiats et de prendre le recul nécessaire pour une intégration communautaire saine.

          On était arrivé à une situation de déperdition de temps, d’énergie, d’envie conséquente.

          L’objectif de cette version

          Au fil des années, l’objectif principal de la 3.5 a fortement évolué. De l’apport initial d’innovations diverses nous nous sommes recentrés sur l’essentiel. C’est-à-dire :

          • fournir une version unifiée et rationnelle de toutes les variantes connues ;
          • gérer les versions stables (du moins plus récentes) de Debian.

          L’histoire récente de la 3.5

          La communauté AlternC, pour diverses raisons, a fortement tardé pour absorber tout ce retard. Au cours de ces douze derniers mois, on notera les évolutions suivantes :

          • Une 3.5~RC2 absorbant le retard avec les apports de koumbit ;
          • Une 3.5~RC3 absorbant le retard avec Debian et fournissant la compatibilité avec Bookworm ;
          • Une 3.5.0 proposant une version stabilisée compatible de buster à bookworm ;
          • Une 3.5.1 proposant un correctif lors de la mise à jour et une compatibilité avec des changements avec roundcube ;
          • Une 3.5.2 proposant d’autres correctifs mineurs, plus une gestion de SFTP, réparation de la compatibilité du module awstats, maintenir les configurations DKIM/SPF ;
          • Une 3.5.3 proposant des correctifs mineurs, une meilleure gestion des bases de données, la réparation des configurations DNS manuelles, une meilleure prise en charge des versions PHP.

          Il est prévu d’autres versions mineures pour prendre en compte les erreurs restantes.

          Toutes ces versions ont été diffusées sur le dépôt officiel AlternC ou bien directement sur le dépôt github

          Les changements depuis la 3.3

          Des nouveautés diverses et variées

          Sans faire une liste à la Prévert, notons les points suivants :

          • La gestion de Debian Buster à Bookworm ;
          • La gestion de PHP de 5.6 à 8.x ;
          • L’amélioration de la gestion des mails avec une meilleure prise en charge de DKIM, SPF et DMARC ;
          • La gestion de l'autodiscover et autoconfig pour les logiciels de messagerie ;
          • La gestion de SFTP en plus de FTP(S) ;
          • La capacité de gérer des domaines DNSSEC ;
          • Un nouveau thème plus moderne et personnalisable ;
          • La définition de politique de validation de mot de passe.

          De nombreux correctifs

          Les nouveautés ne sont pas le cœur de cette version, on a principalement travaillé sur la stabilisation et la mise en place de correctifs divers et variés commme :

          • le report des correctifs pour roundcube pour buster et sa gestion jusqu’à bookworm ;
          • l’intégration de phpmyadmin jusqu’à bookorm ;
          • des protections CSRF dans les nombreux formulaires ;
          • des ajustements dans les scripts de type cron et alternc.install ;
          • la prise en charge des fonctionnalités d’apache 2.4 ;
          • la prise en charge conditionnel du mode SSL pour apache (permettant des frontaux comme nginx, haproxy…) ;
          • des empreintes de mot de passe plus solide — pour entre autres — dovecot ;
          • des correctifs pour s’aligner sur les évolutiosn de mariadb (longueur des tables, nommages…) ;
          • simplification du javascript pour le panel ;
          • support progresif de systemd ;
          • la bascule progressive du système de traduction vers weblate.

          Un écosystème

          AlternC ne se résume pas à un projet avec une structure monolithique. Il s’agit d’un écosystème avec nombre de plugins.

           Des plugins

          La version 3.5 apporte de nouveaux plugins, pour faciliter leur évolution. Certaines fonctionnalités ont été extraites ou adaptées en ce sens :

          • ACME qui extrait la génération des certificats SSL avec Let's encrypt et le protocole ACME
          • nginx-ssl une seconde approche pour gérer les certificats SSL et offrant un frontal nginx pour gérer https
          • mailman un gros travail de fond a été réalisé pour permettre le passage de maiman2 à mailman3 tout en assurant une retro compatibilité correcte.

           Un générateur de paquet Debian

          AlternC est maintenant fourni avec un générateur automatique de paquets Debian.

          Ainsi on facilite l’arrivée de nouvelle proposition sous forme de plugin. Il est n’est pas nécessaire d’intervenir sur l’intégralité du projet AlternC et on peut se concentrer sur une fonctionnalité donnée.

          Dès l’intégration du depot dans l’organisation AlternC, le plugin sera automatiquement pris en compte et ses paquets Debian prêts à l’emploi via :

          • les releases github
          • le dépôt officiel du projet
          • la mise à disposition des paquets expérimentaux ou dits nightly

          Tout un ensemble de plugins

          Au-delà d’AlternC en soi et des plugins listés avant, on peut trouver à différents niveaux de maturité :

          On peut trouver l’ensemble des plugins AlternC depuis son dépôt : https://github.com/AlternC/

          D’autres outils sont mis à disposition également sur la forge communautaire du projet

          Comment installer ou mettre à jour ?

          Si vous avez déjà un AlternC 3.3.x et que vous voulez migrer vers la 3.5.x, faites une sauvegarde complète et suivez la documentation fournie sur notre aide en ligne

          Il est important de prendre en compte les informations suivantes :

          • La version 3.3 n’est plus officiellement supportée et cesse de fonctionner au-delà de Buster ;
          • La version 3.5.x supporte Buster et Bookworm ;
          • Le support de Bullseye (Debian 11) n’est pas fourni, cela peut fonctionner uniquement le temps de la mise à jour système.

          Participer

          Ensuite ?

          Le cycle de la 3.6 n’est pas encore planifié. Parmi les idées en reflexion nous avons :

          • réduire le support à deux versions stables de Debian (bookworm/trixie)
          • l’amélioration de la qualité du code de base (bash et php) à l’aide de diverses CI/CD
          • la finalisation du système de traduction pour le core et les plugins via weblate

          Le code

          L’ensemble du code du projet est actuellement hébergé chez github.
          Toute personne est la bienvenue. Vous pouvez proposer un nouveau projet de code, remonter des bogues, suggérer des améliorations, traduire, communiquer…

          Nous profitons également de cette nouvelle version pour utiliser le nommage “main” pour la branche principale. C’est plus en adéquation avec notre code de conduite informel et donne également une cohérence sur l’ensemble des projets.

          Les traductions

          Toutes personne souhaitant traduire dans sa langue est la bienvenue. Vous pouvez participer via le service weblate. Nous gérons actuellement principalement trois langues : le français, l’anglais et l’allemand. Nous avons d’autres langues disponibles pour lesquelles un peu d’amour est nécessaire.

          Des services à disposition de la communauté

          En complément, le projet AlternC met à disposition divers services à la communauté. Le principal est le service de DNS secondaires disponible sur le site dédié https://www.alternc.net/
          Ce service permet de synchroniser ses zones sur deux DNS secondaires depuis ses instances AlternC.

          Un autre service est disponible en mettant à disposition des serveurs virtuels jetables pour tester des développements sur différentes distributions Debian (de Jessie à Trixie).

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Nouvelles sur l’IA de octobre 2025

          L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ».

          Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zvi si je l’ai mal compris !), sauf pour les citations : dans ce cas-là, je me repose sur Claude pour le travail de traduction. Sur les citations, je vous conseille de lire l’anglais si vous pouvez : difficile de traduire correctement du jargon semi-technique. Claude s’en sort mieux que moi (pas très compliqué), mais pas toujours très bien.

          Même politique éditoriale que Zvi : je n’essaierai pas d’être neutre et non-orienté dans la façon de tourner mes remarques et observations, mais j’essaie de l’être dans ce que je décide de sélectionner ou non.

          Sommaire

          Résumé des épisodes précédents

          Petit glossaire de termes introduits précédemment (en lien : quand ça a été introduit, que vous puissiez faire une recherche dans le contenu pour un contexte plus complet) :

          • System Card : une présentation des capacités du modèle, centrée sur les problématiques de sécurité (en biotechnologie, sécurité informatique, désinformation…).
          • Jailbreak : un contournement des sécurités mises en place par le créateur d’un modèle. Vous le connaissez sûrement sous la forme "ignore les instructions précédentes et…".

          Des nouveautés sur la génération de vidéos

          OpenAI publie Sora 2, son modèle de génération de vidéo, qui produit des scènes d’environ dix secondes à partir d’un prompt textuel. Cette publication pose deux questions : celle des deepfakes, et celle du copyright.

          Sur les deepfakes, OpenAI a annoncé bloquer la génération de vidéos impliquant des personnalités publiques, sauf si ces dernières s’inscrivent sur une liste acceptant cet usage (vous pouvez par exemple générer une vidéo contenant Sam Altman, qui s’est inscrit sur cette liste).

          Sur la propriété intellectuelle, la logique est inversée : initialement, les ayants droits étaient appelés à « se rapprocher d’OpenAI » pour que leur création ne puisse pas être réutilisée par Sora. C’était un pari très audacieux : si le consensus juridique se dirige sur le caractère légal (« fair use ») d’utiliser des données publiques pour entraîner une IA, réutiliser la propriété intellectuelle d’autrui entre dans le cadre des œuvres dérivées, bien plus contraignant ; la plupart des commentateurs s’accordent qu’il y a peu de chances qu’OpenAI puisse gagner une bataille juridique sur ce terrain, si certains ayants droits décident d’aller en justice. OpenAI semble avoir réalisé la même chose, faisant marche arrière une semaine après le lancement ; les ayants droits peuvent maintenant s’inscrire pour accepter que des éléments (personnages, lieux…) de leurs œuvres soient réutilisables par Sora, avec dans le futur un système de rémunération des ayants droit.

          En se fondant sur ce modèle Sora 2, OpenAI décide de lancer un réseau social du même nom. L’idée est de partager vos créations avec vos connaissances, en particulier d’utiliser la capacité de Sora de mettre en scène des personnes pour créer des vidéos vous mettant en scène, vous et vos connaissances.

          Meta lance également une offre similaire avec Vibes, xAI suit le mouvement (sans la partie « réseau social ») avec Grok Imagine

          OpenAI obtient le feu vert pour son casse du siècle

          Résumé rapide de l’affaire :

          • OpenAI a été fondé en 2015 et tant qu’organisation à but non lucratif, avec pour mission de « développer l’Intelligence Artificielle Générale pour le bénéfice de l’humanité ». Rappelons nous qu’en 2015 les larges modèle de langage sont un jouet pour chercheur, que le Winograd schema challenge est l’horizon indépassable pour la compréhension du langage naturel.
          • Afin de pouvoir recevoir des fonds d’investisseurs, en 2019 OpenAI restructure son organisation. OpenAI LLC (peu ou prou l’équivalent d’une SARL) est créé pour recevoir les financements et est l’organisation principale des opérations au jour le jour. L’organisation à but non lucratif existe toujours, et a le contrôle total de l’entreprise.
          • L’entreprise possède une caractéristique assez particulière, "capped for-profit", ce qui signifie que la quantité de profits reçus par les investisseurs est plafonnée (à un certain multiple, négocié au cas par cas, de l’investissement). Tout profit supplémentaire appartient légalement à l’organisation à but non lucratif.

          C’est ce dernier point qui ennuie beaucoup les dirigeants d’OpenAI et les potentiels investisseurs aujourd’hui. Fin décembre 2024, l’entreprise déclare vouloir prendre son indépendance vis-à-vis de l’organisation à but non lucratif. Sur papier, cela est possible : l’entreprise peut racheter le contrôle auprès de l’organisation à but non lucratif, à condition que le prix soit juste (sinon, c’est il s’agit tout simplement d’abus de biens sociaux). Problème : comment évaluer le juste prix ? Celui-ci est composé de deux parties :

          • Le pouvoir de contrôle sur l’entreprise en elle-même, de décider de sa politique (par exemple, en rapport à la sécurité des modèles). Bien intangible, mais qu’il faut bien valoriser.
          • Plus compliqué : le prix aujourd’hui de la totalité des profits futurs après remboursement des investisseurs.

          En 2024, le bruit courait d’une offre à 40 milliards, ce qui a rapidement donné lieu à une levée de boucliers, et l’utilisation par Zvi de l’expression « greatest theft in human history » (que j’ai traduite par « casse du siècle »). En mai 2024, OpenAI annonce renoncer à cette tentative, mais reprend en septembre 2024.

          Aujourd’hui, après avoir négocié avec les procureurs généraux des états du Delaware (là où l’organisation à but non lucratif est incorporée) et de Californie (pour le siège de l’entreprise), OpenAI annonce avoir reçu le feu vert pour une restructuration.

          Dans les grandes lignes :

          • Le pouvoir de contrôle sur l’entreprise reste entièrement dans les mains de l’organisation à but non lucratif.
          • La structure de profits de l’entreprise disparaît (et l’entreprise elle-même, se muant en PBC) pour suivre le modèle plus courant de parts sociales. L’organisation à but non-lucratif obtient 26% de ces parts (à comparer au plus gros investisseurs, Microsoft, qui obtient 27%).

          Est-ce un juste prix ? Zvi défend que non, en nous offrant ces chiffres :

          • Le journaliste d’affaires Matt Levine estime à 272 milliards le plafond de profits allant aux investisseurs.
          • Un chiffre de 1000 milliards de valuation à l’introduction en bourse est utilisé (se référant à celui rapporté par Reuters).
          • Ce qui donne 260 milliards pour l’organisation à but non lucratif dans le nouveau système. Dans l’ancien, le chiffre aurait été plus proche de 500-750 milliards.

          Il faut également prendre en compte que l’objectif d’OpenAI (que ce soit l’organisation ou l’entreprise) reste d’atteindre l’intelligence artificielle générale (AGI). Dans l’hypothèse où cet objectif est atteint, les profits seraient probablement un ou plusieurs ordres de magnitude plus grands (on peut citer ce papier de l’université de Virginie), ce qui élargit encore plus le gouffre entre l’ancien système et le nouveau — dans l’ancien, la quasi totalité des profits appartiendrait au final à l’organisation à but non lucratif, dans le nouveau, 26%.

          Affaire close ? Pas nécessairement : d’autres parties que les procureurs généraux peuvent se saisir de la justice pour contester cette décision. Elon Musk en particulier a déjà dans le passé saisi la justice sur ce sujet, et pourrait encore le faire dans un futur proche.

          En vrac

          DeepMind présente Dreamer 4, un agent capable d’apprendre à naviguer dans un environnement avec très peu de données d’entraînement, en « imaginant » des interactions synthétiques — avec pour objectif d’appliquer cette méthode à la robotique.

          OpenAI publie GPDval, un benchmark cherchant à mesurer au plus près les capacités économiques de l’IA, en se concentrant sur la question de quelles tâches économiquement productives l’IA peut se charger. Sur les tâches sélectionnées (avec pour critère : bien définies, avec un périmètre clair et un contexte simple, dans divers domaines), l’IA reste pour l’instant derrière l’humain, mais plus très loin derrière : la meilleure IA, Opus 4.1, gagne 47.6% (s’acquitte mieux de la tâche) du temps contre un professionnel du domaine.

          Le FLI (Future of Life Institute) publie une lettre ouverte « Statement on Superintelligence » (« Communiqué sur la superintelligence »), trois courtes phrases : « We call for a prohibition on the development of superintelligence, not lifted before there is 1. broad scientific consensus that it will be done safely and controllably, and 2. strong public buy-in. » (« Nous appelons à une interdiction du développement de la superintelligence, qui ne devra être levée qu'après : 1) un large consensus scientifique établissant que cela peut être fait de manière sûre et contrôlable, et 2) une forte adhésion du public »). Parmi les signatures, de nombreux noms de tous horizons : académie, industrie, politique et gouvernement, et même du monde religieux.

          OpenAI lance son propre navigateur, Atlas (pour l’instant, uniquement disponible sous MacOS), intégrant ChatGPT à la plupart des niveaux : autocomplétion dans la barre d’adresse, fonctionnalité « ouvrir une conversation avec le site actuel », emboîtant le pas à Perplexity Comet. Il est fortement probable que les attaques de type « injection de prompt » s’appliquent également, donc prudence.

          DeepSeek publie une mise à jour incrémentale de son IA, DeepSeek 3.2. Essentiellement les mêmes performances que la version précédente, mais à un coût bien plus faible.

          DeepSeek publie également DeepSeek-OCR. Une bestiole difficile à décrire : contrairement à ce que ce nom indique, ce n’est pas un simple OCR (même s’il peut s’acquitter de cette tâche très honorablement), mais une piste de recherche, opérationnaliser « un bon croquis vaut mieux qu’un long discours ». Plus précisément, DeepSeek essaie avec ce système de compresser n (par exemple 10) tokens textuels en 1 token de vision (pour une compression 1:10). Les résultats semblent bons, avec 90% de précision avec une compression 1 pour 10.

          Anthropic étudie la capacité d’introspection de ses modèles, et trouve un résultat positif. Par exemple, les développeurs peuvent identifier un circuit associé à un certain concept (par exemple, « piano »), l’activer, et demander au modèle « À quoi penses-tu actuellement ? » (sans que le concept soit explicitement mentionné dans le prompt) ; le modèle est généralement capable de mentionner le concept.

          DeepMind, en collaboration avec l’université de Yale, publie un modèle open-weight spécialisé dans l’analyse cellulaire. Le modèle semble capable de faire des découvertes inédites.

          Nouvelle confrontation sur le droit d’auteur : Disney met en demeure Character AI.

          Anthropic libère sur github un outil d’évaluation dans le cadre de la sécurité des modèles, utilisé notamment pour évaluer des comportements problématiques comme la flagornerie ou la tromperie.

          Epoch AI publie une visualisation quelques données économiques sur les grands acteurs du secteur.

          Des chercheurs publient une nouvelle méthode pour spécialiser un LLM à un usage précis, sans avoir accès privilégié aux paramètres du modèle lui-même. Cela permet de spécialiser des modèles propriétaires.

          Que se passe-t-il lorsque l’on applique une phase d’apprentissage par renforcement sur des tâches de type « créer de l’engagement sur les réseaux sociaux » ou « augmenter les ventes d’un produit » ? Un papier explore la question, et montre qu’un tel entraînement supplémentaire encourage les modèles à mentir ou répandre de la désinformation, et que l’effet ne disparaît pas en demandant au modèle de ne pas utiliser de telles méthodes dans son « prompt système ».

          Autre papier d’Anthropic sur la sécurité des modèles, montrant qu’il est possible d’« empoisonner » l’entraînement des modèles (c’est-à-dire l’entraîner à donner une réponse spécifique à une entrée ésotérique) à l’aide d’un faible nombre de documents (relativement à la taille du corpus d’entraînement total).

          Du mouvement sur le financement du développement de l’IA : OpenAI est évalué à $500 milliards ; xAI fait une levée de fonds pour $20 milliards ; AMD investit dans OpenAI, ainsi que Nvidia. Un article intéressant fait le parallèle avec certains montages pendant la bulle dot-com, notant également des différences importantes.

          En Janvier, OpenAI annonçait que Microsoft ne serait plus leur fournisseur unique d’infrastructure, citant un manque de capacités. The Information (paywall) révèle que Microsoft craint que les demandes de capacités de OpenAI soient injustifiées et que les satisfaire conduise à terme à mettre en place des capacités qui ne seront pas utilisées.

          Un nouveau benchmark, AutumnBench, assez similaire à ARC-AGI, où l’IA reste loin derrière les performances humaines.

          Un billet de blog intéressant sur les efforts de lobbying de l’industrie de l’IA.

          METR ajoute Sonnet 4.5 à son évaluation, qui arrive pile poil sur la ligne de tendances.

          L’IA (plus précisément : GPT-5 et Gemini 2.5 Pro) obtient un score de médaille d’or sur les Olympiades Internationales d’Astronomie et d’Astrophysique.

          Envie d’apprendre comment fonctionne l’IA ? Andrey Karpathy publie en open-source nanochat, pour entraîner soi-même un modèle minimal, de A à Z.

          ChatGPT se dote d’un système de contrôle parental.

          xAI lance une encyclopédie générée par son IA, Grok, nommée Grokipedia. Elle fait partie de la croisade d’Elon Musk contre ce qu’il considère des biais de gauche sur Wikipedia.

          Un papier étudie en détails la capacité des modèles à résister au jailbreak ou plutôt leur incapacité : aucun modèle ne résiste à un attaquant humain déterminé.

          Anthropic publie son modèle "léger" (moins cher, plus rapide, moins performant), Haiku 4.5.

          Cursor, l’assistant de code propriétaire, développe son propre modèle, Composer.

          Pour aller plus loin

          Par Zvi Mowshowitz

          Sur LinuxFR

          Dépêches

          Journaux

          Forum

          Liens

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Sortie de Fedora Linux 43

          En ce mardi 28 octobre, les utilisateurs du Projet Fedora seront ravis d'apprendre la disponibilité de la version Fedora Linux 43.

          Fedora Linux est une distribution communautaire développée par le projet Fedora et sponsorisée par Red Hat, qui lui fournit des développeurs ainsi que des moyens financiers et logistiques. Fedora Linux peut être vue comme une sorte de vitrine technologique pour le monde du logiciel libre, c’est pourquoi elle est prompte à inclure des nouveautés.

          Bureau de GNOME

          Sommaire

          Expérience utilisateur

          L'environnement de bureau GNOME est proposé dans sa version 49. Cette version apporte comme d'habitude de nombreux changements.
          Tout d'abord l'application Showtime remplace Totem en guise de lecteur vidéo par défaut. Basée sur la bibliothèque GTK4 et libadwaita, elle reprend les canons esthétiques minimalistes des applications GNOME. L'interface s’efface derrière la vidéo, n'affichant que les fonctions de base essentielles.

          De même l'application pour afficher les documents notamment au format PDF passe de Evince à Papers. De la même manière que précédemment, elle utilise la nouvelle pile logicielle plus moderne, cela permet de refaire le visuel de l'application et d'améliorer dans le même temps les performances. La signature numérique des documents est aussi mieux intégrée de même que les annotations des documents.

          L'application de calendrier a eu une amélioration de son accessibilité avec un focus important sur la navigation exclusive au clavier, ce qui a nécessité une refonte de l'interface. L'interface s'adapte en fonction de la taille de l'écran avec notamment la barre latérale qui peut être masquée. Il est également possible d'exporter des événements dans un fichier ICS.

          Le navigateur Web bénéficie de nombreuses améliorations comme un bloqueur de publicités plus efficace avec plus de listes de blocage disponibles. La recherche dans la page est plus complète avec la prise en compte de la casse ou de la recherche de mots entiers uniquement. L'édition des marques pages, ainsi que le menu de sécurité pour la gestion des mots de passes ou des cartes de sécurité, ont été remaniés pour être plus simples.

          La boutique logicielle bénéficie d'une amélioration significative de ses performances, ce qui était son principal point faible en partie à cause du volume de données à gérer pour les différentes applications disponibles provenant des Flatpak. La boutique consomme moins de mémoire, navigue plus rapidement d'une application à une autre et effectue des recherches efficacement.

          La fonctionnalité de bureau distant s'améliore avec la prise en charge des entrées multipoints pour ceux utilisant un écran tactile. De plus le curseur de souris peut fonctionner avec un positionnement relatif ce qui était nécessaire pour quelques applications ou jeux vidéo. Ceux qui le souhaitent peuvent ajouter des écrans virtuels pour une telle session même s'il n'y a pas d'écrans physiques supplémentaires.

          De manière plus générale, l'écran de verrouillage permet de contrôler basiquement les applications multimédia, en particulier pour la musique. Il est d'ailleurs possible d'arrêter ou de redémarrer la machine depuis cet écran de verrouillage en activant l'option idoine avec la commande gsettings set org.gnome.desktop.screensaver restart-enabled true. Le bouton Ne pas déranger passe de la zone de notifications au menu principal de GNOME pour une meilleure cohérence de l'interface.

          Enfin de nouveaux fonds d'écran sont proposés afin d'exploiter les nouvelles capacités des écrans HDR et l'espace de couleur Display P3 qui sont pris en charge sur les machines compatibles. Capacités HDR qui ont été améliorées par ailleurs avec de nouveaux paramètres pour gérer finement la luminosité de ces types d'écran.

          GNOME fonctionnera uniquement en tant que session Wayland, les paquets liés à GNOME pour session X11 sont supprimés. Le projet GNOME a décalé cette décision pour sa prochaine version numérotée 50, mais Fedora maintient le cap car la qualité de ces sessions n'est pas aussi bonne que Wayland faute de tests et de maintenance de la part du projet depuis de nombreuses années. Grâce à XWayland, GNOME reste en capacité d'afficher et de gérer les applications (de plus en plus rares) reposant uniquement sur X11. Cela clôt en un sens la transition vers Wayland pour GNOME entamée il y a 9 ans déjà avec Fedora 25.

          Tous les Spins disposent par défaut de la nouvelle interface web d'Anaconda. Fedora Linux 42 ne l'avait proposée que pour Fedora Workstation, en partie parce que certaines options ont dû être ajoutées pour supporter les Spins. En effet, sous GNOME, une partie de la configuration est faite après l'installation avec l'application GNOME Initial Setup. Par conséquent les spins pourront en plus configurer depuis Anaconda la date et l'heure, le compte utilisateur et le nom de la machine. De même, la configuration de la disposition clavier est gérée de manière légèrement différente. Enfin, l'interface n'est pas forcément affichée par une session de Firefox mais peut l'être via le navigateur web fourni par l'environnement en question.

          Sur les machines x86_64 compatibles UEFI, Anaconda ne permettra plus d'installer Fedora si le format de partitionnement est basé sur MBR au lieu de GPT. Si la norme UEFI autorise une telle configuration, en réalité sa prise en charge correcte dépend des constructeurs et n'est pas bien testée notamment par l'équipe de Fedora ce qui rend une telle configuration peu fiable. De plus, le chargeur de démarrage GRUB2 suppose déjà qu'un système UEFI implique une table de partitions GPT. Cela a été maintenu par Fedora notamment pour permettre son utilisation dans le service cloud AWS qui ne proposait que de tels systèmes à une époque. Mais cette limitation n'a plus lieu d'être et sa suppression simplifie le test et réduit le risque de crashs au moment de l'installation. Cela ne concerne pas les autres architectures comme ARM car leur implémentation repose plus souvent sur MBR et est mieux gérée.

          Écran de verrouillage avec contrôle multimédia

          L'installateur Anaconda utilise le gestionnaire de paquet DNF dans sa 5e version dorénavant. Cela améliore la vitesse des opérations à l'installation de Fedora et uniformise la gestion des paquets au sein de Fedora en simplifiant aussi les tests de la distribution.

          Fin de support de la modularité des paquets RPM dans l'installateur Anaconda. Les modules ont disparu dans Fedora depuis Fedora Linux 39, ce changement devenait nécessaire avec la non prise en charge des modules par DNF 5 qui est utilisé maintenant par Anaconda comme expliqué précédemment. Cela améliore aussi la maintenance d'Anaconda et de sa documentation en supprimant cette spécificité qui n'est plus utilisée.

          Activation de la mise à jour automatique du système pour la variante Fedora Kinoite. Grâce au système atomique, la mise à jour se fait en arrière plan et est appliquée au prochain redémarrage. La fiabilité de l'opération avec la possibilité de revenir à l'état précédent autorise une mise à jour automatique sans trop de problèmes pour simplifier la vie de l'utilisateur et améliorer la sécurité. Les mises à jour des firmware ne sont pas concernées pour des raisons de fiabilité. La mise à jour se fait par défaut de manière hebdomadaire et une notification pour inviter à redémarrer est affichée quand c'est pertinent. Cette fonctionnalité peut être coupée et la fréquence des mises à jour reste configurable.

          La police d'affichage d'émojis Noto Color Emoji utilise son nouveau format basé sur COLRv1 pour améliorer le rendu. Le rendu est meilleur car les images sont vectorielles et non sous forme d'images bitmap qui sont moins jolies quand la taille d'affichage augmente. Le tout en prenant moins d'espace disque.

          Le fichier initrd utilisé lors du démarrage est compressé avec zstd pour un démarrage plus rapide du système et une taille d'installation plus petite. Cela remplace la dépendance au binaire xz utilisé jusqu'alors, les tests montrent une baisse de la taille d'installation de quelques méga octets pour un temps de démarrage réduit de quelques secondes en moins.

          Nouvelle application de lecture vidéos de GNOME

          Gestion du matériel

          La taille de la partition /boot augmente de 1 Gio à 2 Gio par défaut. En effet la taille des firmwares, des initrd, du noyau, etc. ne cessent d'augmenter alors que la partition est restée à 1 Gio depuis 2016. Cela permet de réduire le risque de manquer de place dans un futur proche pour les nouveaux systèmes.

          Prise en charge de la technologie Intel TDX pour exécuter des machines virtuelles avec une plus grande isolation mémoire depuis Fedora Linux. Pour les machines compatibles, cela signifie que chaque machine virtuelle tourne dans un espace mémoire dédié qui est chiffré ce qui apporte des garanties de sécurité et d'intégrité des données pour le système virtualisé.

          Mise à jour de Greenboot vers la réimplémentation en Rust. L'objectif de ce composant est de fournir une vérification du système au démarrage et de redémarrer vers un état précédent du système en cas de défaut constaté ce qui est possible dans un système atomique et améliore l'expérience utilisateur en cas de mise à jour défectueuse. L'utilisateur a par ailleurs la possibilité d'ajouter ses propres tests. La précédente implémentation était en Bash et ne proposait que la prise en charge des systèmes basés sur RPM OSTree. Maintenant il peut gérer les systèmes reposant sur bootc qui est de plus en plus employé.

          Internationalisation

          La police de type monospace aura une police alternative de ce type par défaut en cas de manque dans une langue donnée. Jusqu'ici une police sans-serif était utilisée par défaut ce qui n'était pas idéal car les contextes d'usage sont différents et cela pouvait donner lieu à des comportement imprévisibles suivant les polices installées sur le système. Cela concerne notamment les langues suivantes : l'arabe, l'hébreu, le thaï, le perse, l'hindi, le khmer, etc.

          Administration système

          Le gestionnaire de paquets RPM passe à la version 6.0. Mais les paquets fournis par le projet Fedora utilisent encore le format de la 4e version. Cette version se focalise sur une amélioration de sécurité, par exemple les clés OpenPGP affichent la version complète de l'id de la clé si l'empreinte numérique n'existe pas. Il est possible de fournir plusieurs signatures à un même paquet permettant d'utiliser des clés différentes suivant la provenance et les objectifs. La construction du paquet peut générer automatiquement la signature ce qui est intéressant dans le cadre de l'empaquetage local. Les clés OpenPGP version 6 sont prises en charge de même que les algorithmes dits post quantiques à base de courbes elliptiques. Il est également possible d'utiliser Sequoia-sq au lieu de GnuPG. Les paquets générés avec la 3e version ne sont cependant plus exploitables.

          Réduction du nombre de règles SELinux dontaudit liés au type unlabeled_t. L'objectif de ces règles c'est souvent de réduire le nombre de rapports d'accès anormaux qui sont des faux positifs ou des accès bénins effectués par des applications mal écrites. Cette avalanche de notifications serait contre productive mais cacher ces accès sous le tapis ne permet pas de corriger ces comportements problématiques et complexifie le débogage. L'objectif est de désactiver seulement certaines de ces règles de la politique et non de les supprimer entièrement. Ainsi si le nouveau comportement vous pose problème, vous pouvez exécuter la commande # setsebool -P dontaudit_unlabeled_files 1 pour rétablir le comportement précédent.

          Le paquet gnupg2 pour fournir l'outil de chiffrement est dorénavant découpé en plusieurs sous paquets. Cela permet de réduire la taille du système par défaut car uniquement les paquets nécessaires seront installés par défaut, laissant de côté les binaires plus optionnels. L'autre bénéfice est de simplifier le remplacement par Sequoia-PGP car il nécessite la présence de certains binaires de GnuPG mais en remplace d'autres ce qui n'était pas possible de faire avec un paquet unique. Les installations existantes installeront tous les sous paquets par défaut pour éviter de casser les systèmes existants.

          Le filtre d'impression Foomatic-rip rejette les valeurs inconnues. En effet il est utilisé pour construire des commandes shell, PostScript ou Perl qui sont ensuite exécutées avant d'envoyer la tâche à l'impression via les options FoomaticRIPCommandLine, FoomaticRIPCommandLinePDF et FoomaticRIPOptionSettings. Cette flexibilité permet d'écrire ou de modifier facilement le pilote de l'imprimante en question mais est source de vulnérabilités de sécurité aussi. Pour limiter les risques, par défaut aucune valeur pour ces options ne sont autorisées. L'utilisateur doit exécuter foomatic-hash une fois pour vérifier la validité des options et s'assurer qu'elles ne font rien de problématiques et déplacer le dit fichier dans /etc/foomatic/hashes.d pour autoriser leur utilisation. Cela ne concerne à priori que des vieux pilotes d'imprimantes et une partie de ceux fournis par CUPS ont déjà les validations nécessaires. D'autres devraient venir progressivement. Les pilotes d'imprimantes déjà installés au niveau du système seront aussi automatiquement validés après une mise à niveau vers Fedora Linux 43. À cause de la flexibilité de la méthode d'origine, corriger ou détecter tous les comportements problématiques automatiquement n'est pas possible.

          Le projet 389 Directory Server ne permet plus de modifier ses bases de données BerkeleyDB. Les bases de données utilisaient par défaut LMDB depuis Fedora Linux 40 et l'abandon de BerkeleyDB se fera à priori pour Fedora Linux 45. L'objectif est de permettre la lecture des données pour les migrer vers le nouveau format et ainsi forcer les utilisateurs à effectuer la migration avant son abandon total.

          Nouveau visionneur de documents GNOME

          Le gestionnaire de base de données PostgreSQL est mis à jour à sa 18e version. Cette version améliore les performances dans le sous-système des entrées-sorties asynchrones et dans l'optimiseur des requêtes. D'ailleurs, la migration d'une base de données vers une version suivante conserve les statistiques de l'optimiseur. Une nouvelle fonction uuidv7() permet de générer un UUID autorisant un tri basé sur un critère temporel. Par défaut les colonnes générées, celles dont le contenu est créé durant une opération de lecture, sont virtuelles et ne résident pas sur le disque. Les B-tree index multi-colonnes peuvent être utilisés plus souvent notamment s'il n'y a pas de contraintes sur les premières clés mais uniquement sur la dernière. Le protocole OAuth peut être utilisé pour s'authentifier dorénavant. Comme d'habitude, les versions 17 et 16 de ce logiciel restent disponibles dans les dépôts autorisant une mise à niveau progressive.

          Le gestionnaire de base de données MySQL passe par défaut à la version 8.4. La version 8.4 était déjà proposée dans les dépôts, elle remplace juste la version 8.0 en tant que version de base. Cette dernière reste disponible via le paquet mysql8.0.

          Le serveur de courriels Dovecot est mis à jour vers sa version 2.4. ( https://doc.dovecot.org/2.4.0/installation/upgrade/2.3-to-2.4.html ). Cette version change de manière significative la configuration qui nécessite une adaptation. Il est maintenant possible de stopper une commande mail qui prend du temps proprement. Pour l'authentification, les fonctions de hashage SCRAM-SHA-1-PLUS et SCRAM-SHA-256-PLUS sont maintenant disponibles de même que les liaisons de canal TLS. La bibliothèque Lua permet d’interagir avec le client DNS et HTTP fourni par Dovecot.

          Le serveur d'application Tomcat est mis à jour vers sa version 10.1. Cela signifie qu'il suit la spécification Jakarta EE 10 ce qui implique un nouvel espace de nom qui passe de javax.* à jakarta.*. À cause de ce changement, la compatibilité ascendante n'est pas garantie et une recompilation des applications web est requise. De même l'API interne de Tomcat a beaucoup changé subtilement ce qui rend la compatibilité binaire impossible à garantir et nécessite une revue pour ceux qui interagissent avec ces APIs. Par défaut les requêtes et réponses Web se font en UTF-8 tandis que les sessions ne sont pas conservées après un redémarrage du serveur. Les fichiers de logs ne seront créés que lorsque du contenu doit être écrit dedans. Enfin les paramètres HTTP en commun entre HTTP 2 et 1.1 seront placés au niveau du connecteur HTTP 1.1 pour permettre à la version 2 d'en hériter et limiter ainsi la duplication des paramètres.

          Migration de l'utilitaire de journalisation lastlog à lastlog2. Le premier intérêt de cette migration est de corriger le bogue de l'an 2038 qui n'affecte pas ce dernier. Il peut également utiliser la base de données SQLite 3 pour le stockage. Il utilise aussi des composants PAM pour l'authentification et la sortie est compatible de manière ascendante également. De plus il est légèrement plus performant en augmentant la taille de stockage à partir du nombre d'utilisateurs et non du plus grand id utilisateur dans le lot. Le risque de problèmes de compatibilité devrait être faible. La migration vers le nouveau format sera effectuée automatiquement et des liens symboliques vers les noms des anciens binaires sont créés pour éviter de casser des scripts existants.

          L'information PLATFORM_ID dans os-release est supprimée. Cette information a été ajoutée dans le cadre de la modularité, mais avec l'abandon de celle-ci cette ligne n'est plus nécessaire. Ceux qui se basent sur cette information sont invités à changer d'approche.

          Nouveau gestionnaire de marques-pages de GNOME Web

          Développement

          La chaine de compilation GNU évolue avec binutils 2.45 et glibc 2.42. Pour binutils, les informations sframe générées par l'assembleur sont maintenant conformes avec la spécification SFrame V2. L'assembleur gère les dernières évolutions des architectures RISC-V, LoongArch et AArch64. Il peut également utiliser les directives .errif et .warnif pour avoir un diagnostic contrôlé par l'utilisateur avec des critères qui sont évalués uniquement à la fin de l'assemblage.

          Pour la bibliothèque C glibc, elle prend en charge de nouvelles fonctions mathématiques introduites dans C23 telles que ompoundn, pown, powr, rootn et rsqrt. Elle propose aussi en avance les fonctions valeurs absolues non signées qui seront proposées par la prochaine norme C. Ajout également de la fonction pthread_gettid_np pour connaître l'id d'un thread à partir d'une structure opaque pthread_t. Le cache local dans malloc gagne en performance pour les petites allocations mémoire et peut prendre en charge des blocs à mettre en cache de plus grande taille via l'option glibc.malloc.tcache_max. Le manuel a été particulièrement enrichi pour être plus complet notamment pour les threads, terminaux, systèmes de fichiers, ressources et fonctions mathématiques.

          L'éditeur de lien Gold du paquet binutils-gold est considéré comme déprécié et sera supprimé dans une version future. Fedora Linux a déjà quatre éditeurs de liens : ld.bfd, ld.gold, lld et mold. Se débarrasser de l'un d'entre eux qui n'est plus maintenu par le projet GNU n'est pas un problème et doit améliorer à terme la maintenance.

          Mise à jour de la chaine de compilation LLVM à sa version 21. Les cartes graphiques AMD voient une amélioration de la prise en charge de ROCm de même qu'un effort pour proposer une bibliothèque C pour GPU. Mais les architectures RISC-V ou cartes graphiques de Nvidia ont également quelques améliorations mineures de ce côté. Le compilateur C CLang optimise l’arithmétique des pointeurs avec le pointeur null et comme souvent le suivi des futurs standards C et C++ se poursuit. Le compilateur fait de meilleurs messages d'erreurs pour les erreurs de compilation.

          Côté Fedora, les RPM de ce projet sont compilés avec un profil d'optimisation ce qui devrait significativement améliorer les performances du compilateur maison.

          Le langage Python mue à sa version 3.14. Cette version propose des template strings pour étendre les capacités des f-string afin de plus facilement modifier la valeur de la chaîne de caractères à partir d'autres variables. L'évaluation différée des annotations permet de résoudre les annotations de type qui sont cycliques. De plus, un nouveau module concurrent.interpreters fait son apparition pour permettre l'exécution d'interpréteurs Python dans des fils d'exécution uniques pouvant communiquer entre eux, ouvrant la voie à un vrai parallélisme sans renoncer, pour le moment, au fameux verrou principal nommé GIL. Le module compression accueille l'algorithme zstd qui est de plus en plus utilisé dans divers projets libres. Enfin les UUIDs 6, 7 et 8 font leur apparition, permettant de générer des UUIDs respectant différents critères, les deux premiers autorisent un tri temporel quand le dernier est un assemblage de 3 entiers fournis en paramètre. Il y a évidemment d'autres changements améliorant notamment des performances ou rendant les messages d'erreurs plus clairs.

          Le langage Go passe à la version 1.25. Il est possible dans cette version d'activer le détecteur de fuites de mémoire à la compilation d'un programme par la commande go build -asan, le rapport sera généré à la fermeture du programme. La commande go vet détecte les appels de fonctions sync.WaitGroup.Add mal placés de même que l'usage de fmt.Sprintf("%s:%d", host, port) pour construire des adresses de connexions qui sont invalides en cas d'usage d'IPv6. Un nouveau ramasse-miettes expérimental fait son apparition, il doit réduire l'impact de ces opérations de 10-40% pour un programme standard qui fait beaucoup d'allocations et de désallocations de petits objets. En terme d'expérimentations, un nouveau module expérimental encoding/json/v2 fait son entrée en matière pour l'encodage et le décodage de JSON, qui doit être plus performant pour le décodage tout en supprimant certaines limitations. Pour les développeurs, un nouveau module runtime/trace.FlightRecorder permet de facilement enregistrer la trace d'événements précis dans le programme dans le contexte de débogage tout en étant léger pour ne pas perturber l'exécution du logiciel par les traces complètes habituellement utilisées. Dans le contexte du débogage, le format DWARF5 pour les informations de débogage peut être exploité ce qui améliore la taille du binaire et le temps de l'édition des liens par ailleurs.

          Le langage Perl fourni une réponse brillante avec sa version 5.42. L'accent a été mis pour améliorer les performances dans cette version. Mais en plus de cela, les méthodes peuvent être déclarées avec une visibilité réduite avec l'instruction my method, ces méthodes peuvent être appelées grâce à l'opérateur ->&. Deux nouveaux opérateurs expérimentaux all et any pour vérifier une condition sur l'ensemble, et respectivement aucun, des éléments d'une liste. Un pragma source::encoding peut être apposé sur un fichier source pour détecter les erreurs d'encodage du dit fichier s'il ne correspond pas à celui mentionné. Une classe peut générer automatiquement un setter pour un de ses attributs via l'attribut :writer qui fonctionne de manière analogue à :reader pour le getter.

          La boîte à outils Ruby on Rails démarrera voie 8.0. La gestion de certaines dépendances a été améliorée, en effet pour bénéficier de certaines fonctions telles que les Websockets, les jobs ou le cache il était nécessaire d'utiliser au choix MySQL, PostgreSQL ou Redis. Maintenant SQLite s'ajoute à la liste des possibilités et cela passe par de nouvelles couches d'abstractions Solid Cable, Solid Cache et Solid Queue. Fournir des fichiers statiques repose sur Propshaft au lieu de Sprockets, qui est bien plus simple en tirant profit des changements dans le monde Web opérés depuis 15 ans tels que les frameworks JavaScript ou la bonne gestion des petits fichiers avec le protocole HTTP/2 qui permettent de déléguer la gestion de ces problématiques aux frameworks JavaScript directement. Pour finir, elle propose un moyen simple de générer un template basique mais efficace pour la gestion de l'authentification d'une application, en exécutant bin/rails generate authentication vous obtenez un modèle basique pour la session et l'utilisateur avec des contrôleurs pour la session et l'authentification elle même.

          Nouveau gestionnaire de mots de passe de GNOME Web

          La machine virtuelle Java OpenJDK 25 est fournie. Parmi les changements, un effort a été consenti pour améliorer le mécanisme de l'Ahead-of-Time, la mise en cache de la JVM. Il devient en effet plus facile d'exécuter une application simple pour générer la liste des objets et modules nécessaires pour rendre les prochains lancement plus rapides et de même les profils générés pour accélérer l'application seront immédiatement exploités au démarrage pour également accélérer le lancement de l'application. Le système d'enregistrement des événements est étendu avec la possibilité d'enregistrer précisément le temps d'exécution d'une fonction et sa pile d'appels. Il est possible d'appeler d'autres fonctions ou opérations dans un constructeur avant qu'il n'appelle lui même un autre constructeur du même objet ou de sa classe parente ce qui peut simplifier le code en le rendant plus naturel.

          L'utilitaire dans l'écosystème Java nommé Maven bénéficie de la version 4 en parallèle de la version 3. La version 4 est accessible via le paquet maven4 depuis les dépôts. Parmi les changements fondamentaux, il y a une séparation entre les besoins de compilation et d'utilisation du fichier pom.xml qui mentionnait dans le détail les informations de compilation ou des dépendances ce qui était rarement utile pour les utilisateurs lors du déploiement. Maintenant le fichier destiné à être distribué ne mentionne plus ces informations superflues. Dans ce contexte, un nouveau type de paquet bom est fourni pour générer une liste de composants nécessaires pour ce logiciel ce qui est un atout dans une optique de traçabilité et de suivi des failles de sécurité par exemple. Pour clarifier la différence entre les modules de Maven et ceux de Java, les modules sont renommés subprojects, d'ailleurs ces sous-projets peuvent déduire des informations du parent comme sa version par exemple ce qui rend inutile de le mentionner à nouveau. Les sous-projets peuvent aussi être découverts au sein du projet évitant le besoin de les déclarer explicitement et systématiquement.

          Le compilateur pour le langage Haskell GHC a été mis à jour vers sa version 9.8 et son écosystème Stackage vers la version 23. Le langage fonctionnel dispose des ExtendedLiterals pour préciser le type précis d'un entier défini tel quel dans le code, comme 123#Int8 pour un entier représenté uniquement sur 8 bits. Dans le bas niveau, un logiciel compilé avec -mfma pour permettre l'usage des instructions, qui combinent multiplication et addition (telle que fmaddFloat# x y z qui donne x * y + z) si l'architecture matérielle les supporte ce qui peut améliorer les performances du programme. Il introduit des nouveaux pragmas WARNING et DEPRECATED à des fonctions d'un module pour signaler à un appelant de prêter attention à son utilisation, notamment en cas de suppression planifiée de la dite fonction.

          Le langage de programmation fonctionnel Idris dispose d'une mise à jour majeure vers sa 2e version. La version 1 reposait sur Haskell mais il devenait de plus en plus difficile de le générer avec des versions récentes du compilateur GHC. La version 2 est implémentée en Scheme et repose sur la théorie des types quantifiés, ainsi une variable assignée à une quantité 0 est effacée, assignée à une quantité 1 elle est utilisée une seule et unique fois, etc. Ce changement de paradigme rend de nombreux programmes écrits pour Idris 1 incompatibles. De plus le Prelude du langage ne contient que les éléments strictement nécessaires dans la plupart des programmes non triviaux, le reste est relégué dans dans la bibliothèque base.

          Le compilateur Free Pascal propose des paquets permettant la compilation croisée avec d'autres architectures. Ce changement facilite la compilation de programmes pour d'autres systèmes sans quitter sa Fedora Linux. Les paquets nécessaires sont de la forme fpc-cross-$CPU et fpc-units-$CPU-$OS où le premier fourni le compilateur en lui même à destination d'une architecture matérielle spécifique quand le second fourni des objets précompilés nécessaires la plupart du temps pour générer un programme pouvant s'exécuter sur le matériel et système considéré. Si vous souhaitez compiler pour du Windows x86 il faudra installer par conséquent les paquets fpc-cross-i386 et fpc-units-i386-win32.

          La bibliothèque d'Intel tbb pour paralléliser certaines tâches passe à la version 2022.2.0. Les changements sont relativement mineurs mais à cause de la rupture de compatibilité de l'ABI, les logiciels s'en servant doivent être recompilés pour fonctionner avec cette nouvelle version.

          La signature cryptographique des informations de débogage debuginfod est maintenant vérifiée automatiquement du côté du client. Les paquets RPM fournissaient la dite signature depuis Fedora Linux 39, le client comme serveur prenaient en charge la fonctionnalité, il ne manquait plus qu'une configuration adéquate pour permettre ce changement. Cela se fait en éditant le fichier de configuration /etc/debuginfod/elfutils.urls ainsi :

          ima:enforcing https://debuginfod.fedoraproject.org ima:ignore

          Cela ne le fait que pour les informations de débogage provenant du projet Fedora, pour les autres il faudra activer cela manuellement de manière similaire.
          En cas de signature invalide, les fichiers concernés seront rejetés et considérés comme non disponibles ce qui améliore la fiabilité et la sécurité du débogage.

          La bibliothèque Rust async-std est considérée comme dépréciée avant une suppression future. Il n'est en effet plus maintenu et il est recommandé de passer à la bibliothèque smol à la place.

          La bibliothèque Python python-async-timeout est considéré comme dépréciée avant une suppression future. Cette fonctionnalité est en effet fournie dans la bibliothèque standard depuis Python 3.11 rendant cette bibliothèque obsolète. Cependant une trentaine de paquets s'en servent encore directement rendant sa suppression impossible à ce stade.

          Le paquet python-nose a été retiré. Déprécié par Fedora depuis plus de cinq ans et sans maintenant depuis plus longtemps, sa suppression devenait nécessaire avec l'impossibilité de s'en servir avec la dernière version de Python. Les paquets qui en avaient encore besoin ont été corrigés pour s'en passer.

          Les paquets concernant d'anciennes versions de GTK pour Rust gtk3-rs, gtk-rs-core version 0.18, et gtk4-rs ont été retirés. Ils étaient dépréciés depuis Fedora Linux 42 car non maintenus.

          Projet Fedora

          Koji utilise localement au sein du projet Fedora une instance de Red Hat Image Builder pour générer certaines images qui en dépendent. Cela concerne les images Fedora IoT et Minimal qui étaient construites via l'infrastructure de Red Hat, Koji ne servant que d'orchestrateur côté Fedora. Cela posait quelques soucis dont la possibilité d'intervenir en cas de problèmes mais aussi le fait qu'il était impossible de geler les changements de l'infrastructure aux moments adéquats pour l'élaboration des nouvelles images. Le paquet koji-image-builder a été créé pour permettre d'exécuter cette machinerie localement au sein de l'infrastructure du projet Fedora. L'objectif est d'inclure cela dans Koji intégralement à terme quand ce sera suffisamment testé.

          La génération de l'image Core OS repose sur le fichier de définition de conteneurs Containerfile. Jusqu'ici l'image était conçue via RPM OStree avant d'être convertie en image OCI. L'objectif est donc de sauter l'étape RPM OStree en utilisant les conteneurs, l'image de référence est basée sur une Fedora Linux avec bootc. Cela simplifie la procédure de génération de l'image et permet facilement à quiconque de reproduire ces étapes s'il le souhaite en utilisant podman.

          Arrêt de publication des mises à jour de Core OS sur le dépôt OSTree. Cela fait suite au changement introduit dans la version précédente de Fedora où l'utilisation des images OCI avait débuté et que les nœuds existants allaient progressivement migrer vers ce format. Désormais maintenir la publication de mises à jour OSTree n'a plus de sens et permet de réallouer les ressources humaines et matérielles.

          Le système d'intégration continue de Fedora ne prend plus en charge le format Standard Test Interface. Il évoluait conjointement avec Test Management Tool qui a maintenant les mêmes capacités et continue d'évoluer. N'avoir plus qu'un format permet de simplifier la maintenance et l'outillage. Il y avait de plus en plus d'erreurs liées à l'usage de STI pour certains paquets incitant à faire la migration. Le format TMT a quelques avantages dont une meilleure organisation des tests et des environnements de tests. Les tests sont également reproductibles localement ce qui est important pour la résolution de problèmes. Grâce à l'intégration avec Packit il peut facilement exécuter les tests à partir des sources du logiciel si besoin ce qui est utile en cas de nouvelle version d'un paquet ou voir si un correctif spécifique à Fedora introduit des régressions.

          Les nouveaux paquets recevront automatiquement une nouvelle configuration basée sur Packit pour permettre la gestion automatique de certaines tâches dans le cadre des nouvelles versions de Fedora. Cette étape est faite lors de la création du projet sur le service src.fedoraproject.org, un correctif fournit automatiquement cette configuration initiale. Cela peut être manuellement désactivé lors de la création si un mainteneur ne le souhaite pas. L'intérêt est de simplifier l'accueil de nouveaux empaqueteurs mais aussi d'automatiser certaines tâches par défaut. En cas de nouvelle version d'un composant, le paquet avec cette version sera automatiquement crée pour identifier les éventuels problèmes, et s'il n'y en a pas, permettre de créer automatiquement la nouvelle version du paquet et de la diffuser si l'empaqueteur accepte cette nouvelle version. Cela peut aider à gérer plus de paquets et à mieux les maintenir sur le long terme.

          Nouvelle localisation du bouton Ne pas déranger

          Les bibliothèques statiques fournies par les paquets RPM de Fedora conservent les informations de débogage pour permettre de comprendre l'origine des crashes des applications les exploitant. Cela est rendu possible par la mise à jour du composant debugedit qui permet une telle opération sans trop de problèmes. En effet il peut maintenant collecter les fichiers sources d'une bibliothèque statique et réécrire les chemins vers le répertoire /usr/src/debug comme attendu par les différents outils de débogage. Cependant les informations de débogage sont fournies dans les paquets RPM des binaires pour éviter la complexité de les inclure manuellement pour les développeurs qui en ont besoin dans leur logiciel. L'espace disque nécessaire pour ces informations est considéré comme relativement négligeable pour prendre cette décision. Pour les développeurs qui ne veulent pas des informations de débogage dans leur binaire peuvent exécuter la commande strip -g après l'édition de liens.

          Les macros dédiées pour générer les paquets Python reposant sur setup.py sont dorénavant dépréciées. Cela concerne les macros %py3_build, %py3_install, et %py3_build_wheel. En effet ces macros reposent sur ce script qui ne sera plus maintenu à partir d'octobre 2025 par le projet setuptools. L'objectif est d'inciter et de migrer progressivement ces paquets vers la nouvelle méthode reposant sur les macros %pyproject_* et exploitant le fichier de configuration pyproject.toml. Environ 35% des paquets Python de Fedora sont donc concernés par cette migration à venir qui permettra de moderniser et d'unifier les conventions tout en suivant les bonnes pratiques de l'écosystème Python.

          Les paquets Go sont compilés en utilisant par défaut les dépendances du projet compilé plutôt que d'utiliser systématiquement des dépendances basées sur des RPM gérés par le projet Fedora. En effet les binaires Go sont tous statiquement compilés donc l'objectif de maintenir des dépendances ne sert qu'à la construction des dits paquets. Cela concerne environ 1400 paquets pour générer 400 paquets avec un binaire Go. C'est beaucoup de travail de maintenance et cela limitait la possibilité d'inclure plus de paquets Go car il fallait empaqueter toutes les dépendances nécessaires au préalable. Cependant avec cette méthode il devient plus difficile de corriger les bogues ou problèmes de sécurité introduits par ces dépendances si Fedora ne les récupère pas. Et pour les cas où il est préférable d'avoir les dépendances gérées par le projet, cela sera un travail plus important pour un paquet donné car moins de dépendances seront déjà disponibles dans les dépôts. Le suivi des licences nécessite d'être adapté pour s'assurer qu'il n'y a pas de problèmes de compatibilité mais des outils existent déjà pour réduire cette problématique.

          Les paquets NodeJs utiliseront un nouveau formalisme pour le chemin de leurs dépendances. En effet le répertoire %{_libdir}/node_modules pointait vers un répertoire spécifique à une version de NodeJs comme %{_libdir}/node_modules20 pour la version 20 de NodeJs. Mais cette solution était plutôt pénible avec Fedora qui propose plusieurs versions de NodeJs en parallèle. L'objectif est de mettre en commun %{_libdir}/node_modules pour les modules où c'est possible, et pour ceux qui ont par exemple un binaire WASM, ils seront affectés dans un répertoire dépendant de la version. Cela simplifie la procédure d'empaquetage de ces composants tout en réduisant les doublons et en évitant les incompatibilités. Cela aide également à mettre en évidence les dépendances binaires cachées pour les reconstruire au sein du projet Fedora, ou les supprimer si cela n'est pas possible, à terme.

          Les macros CMake ne fourniront plus de variables d'installation non standards. Cela concerne les variables -DINCLUDE_INSTALL_DIR, -DLIB_INSTALL_DIR, -DSYSCONF_INSTALL_DIR, -DSHARE_INSTALL_PREFIX et -DLIB_SUFFIX. Cela ajoute de la confusion notamment parce que la signification de certaines variables n'est pas transparente comme INCLUDE_INSTALL_DIR qui pourrait attendre des chemins relatifs ou absolus. CMake 3.0 a standardisé beaucoup de choses dans GNUInstallDirs qui sont massivement utilisés depuis. Cela permet de mieux s'intégrer dans l'écosystème de ces projets et limite le risque d'erreurs lors de la construction des paquets.

          L'assembleur YASM est considéré comme déprécié pour utiliser NASM à la place. Il n'est en effet plus maintenu même si encore utilisé dans quelques paquets tel que Firefox. D'autres distributions ont déjà sauté le pas.

          Ajout des nouveaux macros RPM _pkg_extra_*flags pour permettre à chaque paquet d'ajouter des nouvelles options à la compilation à la liste par défaut fournie par le projet Fedora. L'intérêt est d'avoir un moyen standard d'étendre les options de compilation d'un paquet plutôt que chacun les édite à sa sauce et cela permet dans le même temps de voir facilement quels paquets et quelles options sont personnalisés.

          Certaines limitations de l'outil gpgverify utilisé par les mainteneurs de paquets sont corrigées permettant de supprimer des méthodes de contournement associés. En effet l'outil est utilisé pour s'assurer que les sources pour construire le paquet sont bien celles souhaitées. Par exemple il était incapable de lire plusieurs clés GPG fournis dans un fichier dédié comme nginx pouvait le faire. Il était également incapable de gérer automatiquement la signature des sommes de contrôle des archives, il exigeait que l'archive des sources elle même soit signée ce qui n'était pas toujours le cas. Maintenant il prendre également en compte les clés au format keybox. Le tout améliore la maintenance des paquets concernés mais évite aussi la possibilité de contourner la sécurité dans certains cas.

          La communauté francophone

          L'association

          Logo de Borsalinux-fr

          Borsalinux-fr est l'association qui gère la promotion de Fedora dans l'espace francophone. Nous constatons depuis quelques années une baisse progressive des membres à jour de cotisation et de volontaires pour prendre en main les activités dévolues à l'association.

          Nous lançons donc un appel à nous rejoindre afin de nous aider.

          L'association est en effet propriétaire du site officiel de la communauté francophone de Fedora, organise des évènements promotionnels comme les Rencontres Fedora régulièrement et participe à l'ensemble des évènements majeurs concernant le libre à travers la France principalement.

          Si vous aimez Fedora, et que vous souhaitez que notre action perdure, vous pouvez :

          • Adhérer à l'association : les cotisations nous aident à produire des goodies, à nous déplacer pour les évènements, à payer le matériel ;
          • Participer sur le forum, les listes de diffusion, à la réfection de la documentation, représenter l'association sur différents évènements francophones ;
          • Concevoir des goodies ;
          • Organiser des évènements type Rencontres Fedora dans votre ville.

          Nous serions ravis de vous accueillir et de vous aider dans vos démarches. Toute contribution, même minime, est appréciée.

          Si vous souhaitez avoir un aperçu de notre activité, vous pouvez participer à nos réunions mensuelles chaque premier lundi soir du mois à 20h30 (heure de Paris). Pour plus de convivialité, nous l'avons mis en place en visioconférence sur Jitsi.

          La documentation

          Depuis juin 2017, un grand travail de nettoyage a été entrepris sur la documentation francophone de Fedora, pour rattraper les 5 années de retard accumulées sur le sujet.

          Le moins que l'on puisse dire, c'est que le travail abattu est important : près de 90 articles corrigés et remis au goût du jour.
          Un grand merci à Charles-Antoine Couret, Nicolas Berrehouc, Édouard Duliège, Sylvain Réault et les autres contributeurs et relecteurs pour leurs contributions.

          La synchronisation du travail se passe sur le forum.

          Si vous avez des idées d'articles ou de corrections à effectuer, que vous avez une compétence technique à retransmettre, n'hésitez pas à participer.

          Comment se procurer Fedora Linux 43 ?

          Logo de MediaWriter

          Si vous avez déjà Fedora Linux 42 ou 41 sur votre machine, vous pouvez faire une mise à niveau vers Fedora Linux 43. Cela consiste en une grosse mise à jour, vos applications et données sont préservées.

          Autrement, pas de panique, vous pouvez télécharger Fedora Linux avant de procéder à son installation. La procédure ne prend que quelques minutes.

          Nous vous recommandons dans les deux cas de procéder à une sauvegarde de vos données au préalable.

          De plus, pour éviter les mauvaises surprises, nous vous recommandons aussi de lire au préalable les bogues importants connus à ce jour pour Fedora Linux 43.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          Incident du 26 juin 2025 ayant touché les serveurs de production et de développement

          Ayant simultanément ressenti un trouble dans la force, vos administrateurs des serveurs LinuxFr.org ont noté un souci sur le site hier matin. Et d'autres personnes de l'équipe ont aussi signalé le problème (supervision efficace et réactive par le lectorat).

          Le serveur hébergeant les conteneurs de production et de développement a redémarré (hors de toute opération planifiée) à 06h15 Paris le 26 juin 2025, et contrairement aux redémarrages habituels pour les mises à jour, cela a entraîné un changement des adresses IP internes des conteneurs de production et de développement, après redémarrage (06h18). Tous les services avaient bien redémarré, mais les accès aux sites web n'étaient plus possibles : le serveur web frontal ne pouvait plus joindre les adresses prévues, aboutissant à des réponses techniques 502 Bad Gateway.

          La correction sur les adresses IP a été faite à 08h08 pour la production et 08h16 pour le développement.

          Les deux autres serveurs hébergés au même endroit n'ont pas été affectés.

            Changement d'adresses IP

            Les conteneurs de production et de développement sont configurés en DHCP et gardent normalement les mêmes adresses sur les redémarrages.

            Exemple de redémarrage propre pour des mises à jours de sécurité :

            mai 24 10:06:08 oups dnsmasq-dhcp[1256]: DHCPREQUEST(lxc0) 192.168.0.2 aa:aa:aa:aa:aa:aa
            mai 24 10:06:08 oups dnsmasq-dhcp[1256]: DHCPACK(lxc0) 192.168.0.2 aa:aa:aa:aa:aa:aa prod
            mai 24 10:06:22 oups dnsmasq-dhcp[1256]: DHCPRELEASE(lxc0) 192.168.0.2 aa:aa:aa:aa:aa:aa
            ---redémarrage---
            mai 24 10:08:57 oups dnsmasq-dhcp[1228]: DHCPDISCOVER(lxc0) 192.168.0.2 bb:bb:bb:bb:bb:bb
            mai 24 10:08:57 oups dnsmasq-dhcp[1228]: DHCPOFFER(lxc0) 192.168.0.2 bb:bb:bb:bb:bb:bb
            mai 24 10:08:57 oups dnsmasq-dhcp[1228]: DHCPREQUEST(lxc0) 192.168.0.2 bb:bb:bb:bb:bb:bb
            mai 24 10:08:57 oups dnsmasq-dhcp[1228]: DHCPACK(lxc0) 192.168.0.2 bb:bb:bb:bb:bb:bb prod
            

            (les IP, MAC et interfaces ont été changées)
            On a demande et attribution de l'IP pour une adresse MAC donnée, puis elle est relâchée à l'arrêt de la machine, puis réattribuée au démarrage.

            Incident :

            juin 26 03:57:46 oups dnsmasq-dhcp[951195]: DHCPREQUEST(lxc0) 192.168.0.2 cc:cc:cc:cc:cc:cc
            juin 26 03:57:46 oups dnsmasq-dhcp[951195]: DHCPACK(lxc0) 192.168.0.2 cc:cc:cc:cc:cc:cc prod
            ---redémarrage---
            juin 26 04:18:42 oups dnsmasq-dhcp[1222]: DHCPREQUEST(lxc0) 192.168.0.2 dd:dd:dd:dd:dd:dd
            juin 26 04:18:42 oups dnsmasq-dhcp[1222]: DHCPNAK(lxc0) 192.168.0.2 dd:dd:dd:dd:dd:dd address in use
            juin 26 04:18:46 oups dnsmasq-dhcp[1222]: DHCPDISCOVER(lxc0) dd:dd:dd:dd:dd:dd
            juin 26 04:18:46 oups dnsmasq-dhcp[1222]: DHCPOFFER(lxc0) 192.168.0.100 dd:dd:dd:dd:dd:dd
            juin 26 04:18:46 oups dnsmasq-dhcp[1222]: DHCPREQUEST(lxc0) 192.168.0.100 dd:dd:dd:dd:dd:dd
            juin 26 04:18:46 oups dnsmasq-dhcp[1222]: DHCPACK(lxc0) 192.168.0.100 dd:dd:dd:dd:dd:dd prod
            

            On a demande et attribution de l'IP pour une adresse MAC donnée. Elle n'est pas relâchée à l'arrêt de la machine, n'est pas disponible au redémarrage, et une autre est alors attribuée.

            Nature du redémarrage

            Le redémarrage a été brutal, sans arrêt propre des services. Il ne s'agit donc pas d'un arrêt logiciel propre depuis le serveur.

            La cause possible peut donc être un souci d'instabilité électrique, l'arrêt/extinction physique sur le serveur, un bug ou une faille logicielle, ou encore le redémarrage électrique via la carte d'administration. Cette cause n'est actuellement pas connue.

            Mesures préventives et correctives

            Il pourrait être utile de figer les IP internes et/ou d'assurer la synchronisation/reconfiguration du frontal web.

            Il n'est pas prévu d'avoir de la redondance sur la production à court/moyen terme, donc un souci sur le conteneur de production continuera à avoir un effet visible.

            La supervision peut certainement être améliorée (et l'état des services rendu visible depuis un simple navigateur web).

            Commentaires : voir le flux Atom ouvrir dans le navigateur

            Netvibes.com au rancart, Pétrolette au rendez-vous

            « J'étais tranquille j'étais peinard / je réparais ma mobylette » / la nouvelle a surgi le soir / un truc pas vraiment super-chouette… » Eh oui, le couperet est tombé, les utilisateurs de l'agrégateur de flux Web Netvibes.com ont reçu le 15 avril un courriel de Dassault Systèmes leur annonçant que leur agrégateur préféré aller se désagréger définitivement dans l'atmosphère le 2 juin 2025 à midi, avec toutes leurs données, tel un Starship numérique. Si l'on en croit le début du message, cela est lié au développement d'un nouveau service de l'entreprise nommé 3D UNIV+RSES, avec plein d'IA et tout et tout. Le courriel d'avertissement indique certes comment sauvegarder ses données, mais « et maintenant, Papa / C'est quand qu'on va où ? »

            Sommaire

            Good vibrations 2.0 ou le cubisme informationnel

            Netvibes.com, lancé par une start-up en 2005 et racheté par Dassault Systèmes en 2012, était un lecteur en ligne permettant d'afficher les flux RSS ou Atom dans des petits cadres qu'on pouvait regrouper dans des onglets thématiques. Chaque cadre était configurable (longueur, affichage d'images ou non…) et déplaçable facilement. Les flux se mettaient automatiquement et régulièrement à jour. On pouvait aussi ajouter de petites applications (listes de choses à faire, accès courriels, accès à différents réseaux sociaux, etc.). Wikipedia décrit Netvibes.com comme « un portail Web personnalisable. Représentatif de ce qu'on appelle le Web 2.0 ». En tout cas, c'était un très bon outil de veille que j'utilisais tous les jours depuis belle lurette.

            Lancé en 1990, donc à peu près en même temps que le World Wide Web, le Courrier international nous permettait d'avoir accès à une pluralité de points de vue issus des journaux du monde entier. Un agrégateur de flux, c'est un peu l'équivalent informatique. Il permet un véritable cubisme informationnel. Avoir un onglet News agrégeant des flux de journaux d'horizons politiques différents et de plusieurs pays, c'est échapper à la bulle informationnelle, à la ségrégation sociale créée par les grands réseaux sociaux commerciaux. Car observer depuis le point de vue d'autrui est un bon exercice, même si ça peut parfois être désagréable comme du poil à gratter. Enfin, avec un agrégateur, l'algorithme c'est vous : votre œil survole l'ensemble des titres et capte au vol ce qui l'intéresse ou le surprend.

            J'ai rencard avec Pétrolette

            L'outil libre qui se rapproche le plus de Netvibes.com est Pétrolette, « la page d'actus qui ne sait rien de toi », développée par YPhil en JavaScript. Comme son nom l'indique, Pétrolette n'est pas un gros SUV qui fait tout, même le café, mais une application libre qui essaie de faire au mieux une seule chose : afficher des flux Web dans des cadres classés dans des onglets. Donc disons le tout de suite, il faut oublier les éventuelles autres applications que vous utilisiez dans Netvibes. D'après son CHANGELOG, Pétrolette est en version 1.7 depuis l'été 2023. Le GitLab de Pétrolette est indiqué comme étant un miroir de son Framagit mais est en fait plus à jour, la dernière activité remontant à Noël 2024. C'est là que le développement se passe.

            D'après le compte Mastodon de Pétrolette, suite à des problèmes d'hébergement, l'instance principale est depuis décembre 2024 https://petrolette.onrender.com/ bien que celle-ci soit considérée comme temporaire. Les plus admin pourront bien sûr héberger leur propre instance, soit en local soit sur le Web, par exemple sur https://place.de.ma.mob/ si le domaine n'est pas déjà réservé.

            Procédure migratoire

            Par défaut, quand on va sur l'instance principale, qui est une instance partagée, on a un certain nombre d'onglets pré-remplis, avec en tout plus de trois cents flux. On peut les personnaliser (ce sera stocké en local), mais ce qui nous intéresse ici, c'est migrer de Netvibes à Pétrolette. Voici la procédure :

            • Dans Netvibes.com, sauvegarder ses données en allant dans « Compte > Sauvegarder vos données », choisir le tableau de bord, cliquer sur Exporter (fichier XML).
            • Dans Pétrolette, supprimer tous les onglets par défaut (croix rouges), importer le XML avec « Flux > Ouvrir ».
            • Tous les onglets et flux sont récupérés. Le titre d'un flux apparaîtra quand on clique sur son icône pour le déployer.
            • Déplier et configurer chaque flux (mais on devrait éventuellement aussi pouvoir travailler à partir du .conf pour réduire ce travail fastidieux).

            La configuration est stockée localement sur l'ordinateur et non pas en ligne (on n'a donc pas de compte Pétrolette, donc elle « ne sait rien de toi », elle ne sait pas ce que tu lis). On peut l'exporter dans un fichier .conf au format JSON et l'importer sur un autre PC pour avoir la même configuration.

            Synchronisation ?

            Mais une telle synchronisation manuelle n'est pas idéale et l'application peut utiliser le protocole remoteStorage pour pouvoir partager la même configuration sur plusieurs PC, et en particulier vers l'application 5apps. D'après l'aide, l'instance principale de Pétrolette ne gère que 5Apps (mais le menu affiche également des icônes pour Dropbox et Google Drive, qu'on devrait donc pouvoir utiliser si on héberge sa propre instance).

            On peut s'enregistrer sur 5apps à partir d'un compte GitHub, Bitbucket, GitLab.com ou en se créant un compte (adresse email, identifiant, mot de passe). 5apps vous fournit une « adresse utilisateur » du type login@5apps.com. On peut alors aller dans le menu de Pétrolette, cliquer sur remoteStorage et entrer l'adresse utilisateur pour faire la connexion. Il n'y a plus qu'à autoriser Pétrolette à y accéder et faire de même sur tous vos PC. Pour cela, sur chaque machine, connectez-vous à votre compte 5apps puis dans la liste des « Connected Apps », cliquez sur le lien petrolette.onrender.com, dont l'URL est du type https://5apps.com/rs/oauth/token/123d3215c5484b9a78987e8/launch_app.

            Nouveaux développements

            Ça c'est la théorie, dans la pratique la synchronisation semble problématique, avec un fonctionnement très capricieux, et après discussion avec l'auteur il pourrait bien s'agir d'un bug où l'application s'emmêlerait les pinceaux entre stockage local et stockage distant. C'est la mauvaise nouvelle. La bonne nouvelle (scoop !) c'est que ça pourrait être résolu dans une future Pétrolette 2 à laquelle réfléchit l'auteur !

            Voilà une bonne raison de réfléchir à l'invitation à faire un don au projet Pétrolette dans la fenêtre pop-up qui surgit de temps en temps. Il est en effet possible de faire un don sur Liberapay ou de prendre un abonnement sur Ko-fi : à partir de 1 €/mois le pop-up disparaît. Au-delà, on peut demander à l'auteur de créer un nombre plus ou moins important de flux RSS pour des sites qui n'en proposent normalement pas. Rappelons-nous que dans surveillance://, Tristan Nitot nous avertissait sur notre fâcheuse tendance à aimer la gratuité.

            Retour d'expérience

            Commençons par les points négatifs, ce qui nous permettra de finir sur le positif !

            Points négatifs

            • Lenteur pour mettre à jour les flux : quand on affiche sa page Pétrolette, tous les flux sont mis à jour simultanément, c'est-à-dire même dans les onglets qui ne sont pas affichés.
            • Pas de mise à jour périodique des flux. On peut certes les mettre à jour individuellement en cliquant sur une icône. Mais malheureusement, recharger la page avec F5 permet certes de mettre à jour tous les flux mais nous remet systématiquement sur le premier onglet. Pétrolette 2 proposera peut-être des fonctionnalités pour faciliter les mises à jour des flux.
            • N'affiche pas l'heure de parution des actualités, contrairement à Netvibes. Mais la date et l'heure sont indiquées dans la fenêtre d'aperçu quand on survole un titre.

            Points positifs

            • Les aperçus du texte qui apparaissent au survol de la souris sont plus longs qu'avec Netvibes, et même parfois très longs, ce qui permet d'avoir un bon aperçu du contenu avant un éventuel clic, voire même de s'en passer.
            • La hauteur (en pixels) des cadres peut être réglée plus finement qu'avec Netvibes (où seules trois hauteurs standards étaient disponibles). Cela peut d'ailleurs être utilisé pour augmenter la distance verticale entre deux cadres, ceux-ci étant par défaut collés de façon un peu compacte.
            • Les titres longs apparaissent en entier sur plusieurs lignes, alors qu'ils sont coupés dans Netvibes. Cela peut-être un avantage mais parfois aussi un défaut avec certains sites qui proposent des titres à rallonge (du genre trois lignes sur Developpez.com !) que l'oeil a du mal à lire au vol.
            • Le menu principal propose de déposer un marque-page dans la barre du navigateur. Il contient un script qui d'un clic ajoutera le site de l'onglet courant dans votre Pétrolette.
            • Le champ de recherche permet de chercher un terme dans tous les titres de l'ensemble des onglets. Les zones où il est trouvé apparaissent encadrées en jaune.

            Prêts pour l’équipée sauvage ?

            « Dès que les vents tourneront nous nous en allerons… » Il le faudra bien, le 2 juin tout s'arrête. Et donc tout recommence. On a maintenant toutes les réponses à la question synthétique et sympathique « c'est quand qu'on va où ? » Quand ? On le sait depuis le début et on l'a répété, c'est le 2 juin ! Où ? On espère y avoir apporter une réponse dans cette dépêche.

            Et puis à l'heure où les algorithmes profiteurs des réseaux sociaux commerciaux tendent à enfermer l'utilisateur dans sa bulle informationnelle au seul motif d'optimiser les profits et où les moteurs IA sapent la sérendipité du Web, se balader humblement en mobylette RSS devient une véritable mesure d'hygiène mentale. En plus c'est libre.

            « La Pétrolette », 1895Figure 1 - « Quand j’me balade en mobylette / On dirait l’équipée sauvage ». Ouais, ça carbure librement avec « La Pétrolette » (Duncan & Suberbie, 1895 - 1898) [source : Wikimedia, domaine public].

            Commentaires : voir le flux Atom ouvrir dans le navigateur

            Sortie du gestionnaire d'archives PeaZip 10.4.0

            PeaZip n'a jamais été abordé dans ces colonnes jusqu'à présent, alors qu'il fait partie des outils multi-plateformes permettant une transition en douceur vers le libre. Il a presque dix ans. Sortie le 14 avril, la version 10.4 continue la série 10.0 commencée en octobre 2024.

            PeaZip Linux thème sombre sous Wayland
            PeaZip affiché avec son thème sombre dans Wayland

            Giogio Tani, le développeur de PeaZip publie plusieurs versions chaque année. Le logiciel évolue par petites touches largement testées via les fonctions "expérimentales" des versions précédentes.

            icone de PeaZip

            Je trouve beaucoup d'atouts à PeaZip

            Il est libre, multi-plateformes, multi-architecture, portable (nomade), écrit en FreePascal avec Lazarus, ouvre et écrit plusieurs formats d'archives. Il est rapide et assez léger pour un tout-en-un (11,2 MB). Il est bien maintenu, l'auteur est transparent sur la sécurité, documentation et tutoriels sont conséquents et pédagogiques. L'interface est travaillée, sobre, ergonomique, thémable, configurable, jolie, … N'en jetez plus ! Ah si encore : il est dispo en Gtk et Qt sous X11 et Wayland, et l'auteur l'empaquête à tout va.

            C'est un humble logiciel très bien foutu, très travaillé, utile pour installer des outils libres sur les systèmes proprios afin de les amener en douceur vers Linux ou *BSD (il ne fonctionne pas encore sous Haïku).

            Architectures et systèmes

            • Linux x86_64, x86, ARM, aarch64 ;
            • Windows, ReactOS, Wine ;
            • Darwin, macOS Intel et aarch64 (Apple Silicon), la famille BSD.

            PeaZip propose des fonctions peu courantes

            • Le moteur de scriptage intégré permet de convertir vos opérations graphiques pour les automatiser et les étendre avec des options en ligne de commande ;
            • un chiffrement solide est disponible, avec authentification à double facteur ;
            • l'interface graphique est unifiée sur tous les systèmes et architectures pris en charge, même pour les formats moins courant (zpaq, brotli, zstandard) ;
            • le gestionnaire de fichiers avancé facilite, par exemple, la vérification des sommes de contrôles, la déduplication, la conversion de formats d'archives, la recherche, etc ;
            • c'est un outil portable et nomade qu'on peut copier sur une clé usb, sur le net ou partager en réseau sans l'installer ;
            • PeaZip dispose d'une transparence et des options de suivi pour la vie privée et la sécurité.

            Commentaires : voir le flux Atom ouvrir dans le navigateur

            QEMU 10.0

            Comme tous les ans, Qemu sort une nouvelle version majeure. Le numéro n'implique donc pas de grands bouleversements. Il s'agit plutôt d'une base stable qui va être maintenue et améliorée pendant quelques années. Ainsi, les versions 7, 8 et 9 ont eu des mises à jour en mars 2025.

            Comme d'habitude, les architectures ARM et Risc-V se taillent la part du lion et sont enrichies de nouvelles architectures. Les accès aux stockages sont partout plus rapides, et l'espace utilisateur accède toujours mieux au matériel.

            Qemu est devenu une pièce importante dans le monde des serveurs et des développeurs. En tant qu'émulateur il permet de développer, compiler ou lancer un programme sur un processeur ou une machine différente. Couplé à KVM, XEN ou VMWare, il permet une virtualisation performante.

            Quoi de neuf ?

            L'article de Next résume bien les changements sur ARM et Risc-V. C'est technique, n'étant pas connaisseur je vous y renvoie.

            x86 bénéficie de changements globaux à toutes les architectures avec quelques ajouts spécifiques pour des processeurs Intel. Mon petit doigt impatient de tester me souffle que ça sera plus rapide avec des accès "multithread1" aux périphériques de stockage (virtio-scsi et virtio-blk). L'accès direct au matériel en espace utlisateur continue de s'améliorer (VFIO, fonctions virtuelles d'entrées-sorties).

            Les autres changements concernent l'émulation des architectures HPPA et S390.

            Attention aux trucs enlevés

            À chaque version ou presque, des morceaux sont enlevés. Si vous faites dans l'exotique, ne vous précipitez pas sur la dernière version sans consulter la liste des Removed features.

            Documentation d'introduction pour QEMU et la virtualisation

            En guise de conclusion, voici quelques pistes pour ceux et celles qui débutent avec la virtualisation sous Linux et/ou QEMU. Différentes distributions Linux ont de la documentation sous licence libre. Loin d'être exhaustif, voici quelques choix :


            1. Qu'on me pardonne ce mot, je simplifie pour faire court! 

            Commentaires : voir le flux Atom ouvrir dans le navigateur

            20 ans de Fedora-fr : quatrième entretien avec Timothée contributeur des systèmes immuables et KDE

            Dans le cadre des 20 ans de Fedora-fr et du Projet Fedora en lui-même, Nicolas Berrehouc alias Nicosss et moi-même (Charles-Antoine Couret alias Renault) avons souhaité poser des questions à des contributeurs francophones du Projet Fedora et de Fedora-fr.

            La diversité des profils permet de voir le fonctionnement du projet Fedora sous différents angles, au-delà de la distribution, mais aussi comment il est organisé et conçu. Certains points s’appliquent d’ailleurs à d’autres distributions.

            N’oublions pas que le Projet Fedora reste un projet mondial et un travail d’équipe, ce que ces entretiens ne permettent pas forcément de refléter. Mais la communauté francophone a la chance d’avoir suffisamment de contributeurs et de contributrices de qualité pour permettre de donner un aperçu de beaucoup de sous-projets de la distribution.

            Chaque semaine un nouvel entretien sera publié sur le forum Fedora-fr.org, LinuxFr.org et le blog de Renault.

            L’entretien du jour concerne Timothée Ravier, contributeur au Projet Fedora en particulier aux systèmes dits immuables et à l’environnement KDE Plasma.

              Sommaire

              Bonjour Timothée, peux-tu présenter brièvement ton parcours ?

              J’ai commencé à m’intéresser aux logiciels open source autour de 2004 lorsque j’ai découvert Firefox (version 1.0 à l’époque) par l’intermédiaire d’un ami qui l’a téléchargé pour moi sur un CD ré-inscriptible, car je n’avais pas encore l’ADSL à l’époque. J’ai ensuite découvert Linux avec Ubuntu 6.06. Après mes études d’ingénieur en sécurité informatique, j’ai travaillé à l’ANSSI pendant cinq ans sur le projet CLIP OS et je travaille désormais pour Red Hat où je co-dirige l’équipe CoreOS, qui est responsable de la maintenance de Fedora CoreOS et de Red Hat Enterprise Linux CoreOS pour OpenShift.

              Peux-tu présenter brièvement tes contributions au Projet Fedora ?

              Mes contributions à Fedora sont liées à mon intérêt pour les systèmes orientés conteneurs, parfois dénommés immuables (immutable). Je fais ainsi partie de l’équipe qui maintient Fedora CoreOS, je suis un mainteneur des Fedora Atomic Desktops (principalement Silverblue et Kinoite) et je suis membre du KDE Special Interest Group (SIG).

              Qu’est-ce qui fait que tu es venu sur Fedora et que tu y es resté ?

              Je suis passé par plusieurs distributions Linux (Ubuntu, Gentoo, Arch Linux) mais je suis désormais sur Fedora.

              Je pense que les « Four Foundations » de Fedora représentent bien mon parcours :

              • Freedom : Je suis là parce que je suis intéressé par les logiciels libres, car ils permettent un partage, une mise en commun au bénéfice de tous.
              • Features, First : C’est la force de la communauté Fedora d’un point de vue technologique. Je développe ce point dans les questions suivantes.
              • Friends : Je me suis fait des amis dans la communauté Fedora et cela contribue à la bonne ambiance et la motivation pour continuer à contribuer.

              Pourquoi contribuer à Fedora en particulier ?

              Je préfère être proche des projets upstream et des dernières évolutions. C’est pour cela que j’étais pendant un long moment sous Arch Linux.

              Mais le processus pour pousser des changements dans Arch Linux était plutôt flou. Il est important de noter que cela a peut-être changé désormais. Mon expérience date de plus de 6 ans et je crois qu’ils ont un processus de RFC maintenant. Le fonctionnement d’Arch Linux impose aussi des mises à jour régulières et une certaine discipline lors des mises à jour liée au modèle de développement sans version fixe.

              Je commençais alors à m’intéresser de plus en plus aux systèmes à base d’images (CoreOS Container Linux et Fedora Atomic Host à l’époque) et je suis donc allé voir Fedora Atomic Workstation (ancien nom de Silverblue) pour créer une version à base de l’environnement KDE Plasma, qui est devenue Fedora Kinoite.

              Le processus pour pousser des changements dans Fedora est ce qui fait la force de la distribution. Il permet d’obtenir des discussions et des décisions sur les évolutions à apporter à la distribution pour la prochaine version.

              Contribues-tu à d’autres Logiciels Libres ? Si oui, lesquels et comment ?

              En dehors de Fedora, je contribue principalement au développement des projets KDE. Je fais partie de l’équipe qui maintient les applications KDE empaquetées avec Flatpak et publiées sur Flathub.

              Je contribue aussi occasionnellement à différents projets open source en fonction des besoins.

              Utilises-tu Fedora dans un contexte professionnel ? Et pourquoi ?

              Oui, mes ordinateurs professionnels et personnels tournent sous Fedora Kinoite et mes serveurs personnels utilisent Fedora CoreOS. Une partie des serveurs que nous utilisons pour développer et produire les versions de Fedora CoreOS sont aussi sous Fedora CoreOS. D’autres sont sous Red Hat Enterprise Linux CoreOS, car ils font partie d’un cluster OpenShift.

              En gros, nous sommes aussi des utilisateurs directs des logiciels que nous développons.

              Est-ce que tes contributions dans Fedora se font entièrement dans le cadre de ton travail ? Si non, pourquoi ?

              Une grosse partie de mes contributions se font dans le cadre de mon travail, mais toute la partie liée à KDE et aux Fedora Atomic Desktops est faite sur mon temps personnel.

              Est-ce que être employé Red Hat te donne d’autres droits ou opportunités au sein du Projet Fedora ?

              Je n’ai pas plus de droits dans Fedora parce que je travaille pour Red Hat. Je dois suivre tous les processus de Fedora comme n’importe quel contributeur. J’ai d’ailleurs commencé à contribuer à Fedora avant d’avoir été employé par Red Hat.

              En revanche, il est indéniable que cela m’aide pour contribuer, car j’ai régulièrement l’occasion de discuter avec d’autres contributeurs Fedora dans le cadre de mon travail.

              Tu as débuté une carrière dans la sécurité pour finalement travailler pour Red Hat en tant que mainteneur de CoreOS, Silverblue, Kinoite et contributeur à KDE, pourquoi ne pas avoir continué dans la sécurité pour cet écosystème ?

              Quelque part je continue à faire de la sécurité mais sous un autre angle. La sécurité que je faisais avant ne bénéficiait qu’à un petit nombre de personnes qui avait accès aux systèmes que l’on développait. La nouvelle version open source de CLIP OS devait rendre le système plus accessible mais le projet était complexe et je crois qu’il est désormais archivé.

              Je travaille désormais à améliorer la sécurité de Fedora CoreOS et des Fedora Atomic Desktops sans compromettre leur utilisabilité. L’objectif est de fournir une distribution Linux avec des mises à jour robustes qui soit utilisable par des non développeurs.

              Tu participes à CoreOS pour RHEL, CentOS Stream et Fedora. Peux-tu expliquer le but de CoreOS et ses principales caractéristiques ? Quelles sont les différences entre RHEL, CentOS Stream et Fedora à ce sujet ?

              L’objectif pour les systèmes CoreOS est de faire tourner au mieux des applications dans des conteneurs. Pour Fedora CoreOS, c’est un système minimal, avec des mises à jour automatiques, proposant à la fois podman et moby-engine (Docker) installés par défaut, prêt à faire tourner des conteneurs sur un seul nœud ou dans le cadre d’un cluster Kubernetes.

              Pour Red Hat Enterprise Linux CoreOS (et CentOS Stream CoreOS), ce sont des systèmes qui forment le socle d’OpenShift (et d’OKD), une plateforme qui intègre plein de projets open source dont Kubernetes.

              Bien qu’il n’y ait pas une correspondance exacte un pour un dans la liste des logiciels inclus, Fedora CoreOS est l’upstream de CentOS Stream CoreOS et Red Hat Enterprise Linux CoreOS, de la même façon que Fedora est l’upstream de CentOS Stream, qui l’est de Red Hat Enterprise Linux.

              L’architecture atomic a gagné du terrain sur les systèmes pour le bureau avec Silverblue et Kinoite et devient relativement populaire, peux-tu expliquer quel en est l’intérêt d’une telle conception pour ce genre de systèmes ?

              Le principal intérêt pour un utilisateur est la robustesse et rapidité des mises à jour. Celles-ci sont préparées en arrière plan alors que le système fonctionne normalement. Il suffit alors de redémarrer pour mettre à jour son système. Il n’y a pas d’attente supplémentaire ni à l’extinction ni au démarrage.

              Si une mise à jour échoue, le système reste dans l’état actuel, et il est possible de réessayer plus tard.
              Si une mise à jour introduit un problème important empêchant le démarrage du système par exemple, il est possible de redémarrer et de choisir la version précédente dans le menu de démarrage de GRUB.

              Les utilisateurs sont aussi poussés à utiliser Flatpak pour installer leurs applications graphiques et toolbox (ou distrobox) pour utiliser les applications en ligne de commandes dans des conteneurs.

              Quels sont les défis techniques de proposer cette conception dans ces systèmes par rapport à CoreOS par exemple ?

              La principale différence est la présence d’une interface graphique. Les applications graphiques doivent être parfois adaptées pour fonctionner avec Flatpak. C’est désormais le cas de la plupart d’entre elles.

              Tu y contribues en tant que membre de Fedora Atomic Desktops SIG, peux-tu expliquer son rôle dans Fedora et ton activité dedans ?

              Le rôle du Fedora Atomic Desktops SIG est de regrouper l’ensemble des contributeurs Fedora des différentes variantes Atomic : Silverblue, Kinoite, Sway Atomic et Budgie Atomic. Bien que chacun de ces systèmes propose un environnement de bureau distinct, ils partagent énormément d’éléments, tant au niveau des composants de base du système que de l’infrastructure Fedora. Le SIG permet donc de regrouper les contributeurs pour pouvoir les inclure dans les prises de décisions qui impactent ces systèmes.

              Je participe à la maintenance des Fedora Atomic Desktops et plus principalement de Silverblue et Kinoite. Cela peut impliquer des mises à jour de paquets, des corrections de bugs dans des projets upstream ou des rajouts de fonctionnalités pour améliorer l’expérience sur ces systèmes. Je surveille aussi que tous les Atomic Desktops continuent de recevoir des mises à jour régulièrement.

              Penses-tu qu’un jour ces systèmes atomic deviendront la référence par défaut ? Si oui à quelle échéance ? Quelles sont les difficultés actuelles à résoudre ?

              Je l’espère ! Il est impossible de donner une échéance et cela ne dépend pas vraiment de moi. La difficulté la plus importante est la prise en charge du matériel et les pilotes qui ne sont pas intégrés dans Fedora. C’est un problème que l’on ne peut pas résoudre dans Fedora à cause des contraintes légales et qui sont traitées par le projet Universal Blue, dont la variante Bazzite (https://bazzite.gg/), est très populaire.

              Pour la problématique des pilotes, est-ce que l’initiative du noyau unifié (d’avoir une image universelle et signée comprenant le noyau, initrd, la ligne de commande) te semble être une solution à cette problématique ?

              Ces deux sujets ne sont pas liés.

              Le problème des pilotes externes au noyau Linux upstream est divisé en deux cas principaux :

              • Les pilotes propriétaires : Ils ne seront jamais ajoutés directement à Fedora pour des raisons légales et de licence.
              • Les pilotes open source mais non inclus dans le noyau Linux upstream : Fedora met à jour le noyau Linux très régulièrement et suit les nouvelles versions stables peu de temps après leur sortie officielle. Il faut donc que ces pilotes soient mis à jour pour suivre les nouvelles versions du noyau et cela demande toujours du temps lorsque ceux-ci ne font pas partie du noyau upstream.

              Les images noyau unifiées (Unified Kernel Images ou UKI) incluent le noyau, l’initrd et la ligne de commande du noyau dans un seul fichier. Cela présente des avantages pour mettre en place une chaîne de boot mesurée, notamment à l’aide du TPM, et donc pour offrir de meilleures garanties de sécurité. Leur intégration est encore en cours dans les variantes CoreOS et Atomic Desktops.

              Les développeurs et administrateurs systèmes ont souvent besoin d’outils qui à ce jour nécessitent souvent de recourir à rpm-ostree plutôt que Flatpak ou Fedora toolbox dans le cadre d’un système immuable. Penses-tu que ces verrous sont un réel problème et qu’ils seront éventuellement résolus dans le temps ?

              L’un des objectifs de la nouvelle initiative conteneurs bootables (« Bootable Containers ») est justement de rendre plus ergonomique la modification du système de base. Le système est distribué sous forme d’une image de conteneur standard (image OCI) et il est possible de la modifier à l’aide d’un Containerfile / Dockerfile et d’outils natifs aux conteneurs. Cela permet aux utilisateurs de ré-utiliser leurs habitudes et outils pour modifier aussi leur système de façon sûre et de partager le résultat à l’aide d’un registre d’image de conteneurs.

              Nous allons aussi ajouter à nouveau dnf (version 5) dans ces images de conteneurs pour mettre à disposition des utilisateurs une interface familière et toutes les options de dnf lors de la construction de ces images.

              Une autre piste est d’utiliser le concept des extensions systèmes de systemd (systemd system extensions ou sysexts), qui permettent d’ajouter du contenu dynamiquement à un système sans perdre les avantages de la gestion à base d’images. Les sysexts utilisent la même technologie que pour les conteneurs (overlayfs) pour ajouter des éléments (merge) au contenu des dossiers /usr et /opt de l’image de base. Je suis en train d’investiguer cette option pour rendre son usage ergonomique pour ces systèmes : https://github.com/travier/fedora-sysexts.

              Il est aussi possible de modifier temporairement le système en utilisant un système de fichier temporaire monté au-dessus des emplacements en lecture seule (overlayfs). Les fichiers de /usr peuvent alors être modifiés et de nouveaux paquets RPM installés à la demande. Les modifications disparaîtront au redémarrage.

              Tu participes aussi à l’équipe de KDE SIG, peux-tu expliquer son rôle dans Fedora et ton activité dedans ?

              L’objectif du KDE SIG est de proposer la meilleure expérience possible de KDE sur Fedora. Nous suivons et contribuons aussi au développement de KDE upstream.

              Je participe au KDE SIG en tant que mainteneur de Kinoite et développeur KDE.

              GNOME reste le bureau principal de Fedora à ce jour, cependant la qualité de l’intégration de KDE progresse depuis de nombreuses années maintenant, penses-tu que la qualité entre les deux est aujourd’hui équivalente ? Est-ce que les contributions pour KDE sont freinées de par le statut de GNOME au sein du projet ?

              C’est une question très difficile, car elle est très subjective. J’utilise principalement KDE sur mes systèmes, mais j’apprécie énormément le travail de design fait sur GNOME. Pour moi c’est un choix personnel.

              D’un point de vue technologique, il est possible de trouver des éléments “meilleurs” dans GNOME que dans KDE et l’inverse.

              Il n’y a pas de bénéfice à opposer ces deux projets. C’est au contraire la collaboration qui améliore l’expérience utilisateur.

              Je ne pense pas que les contributions à KDE soient freinées par le status de GNOME dans Fedora.

              L’équipe KDE SIG a récemment proposé d’améliorer le statut de KDE au sein du projet, quitte à même remplacer GNOME pour Fedora Workstation, peux-tu expliquer cette demande ? Penses-tu qu’un jour KDE remplacera GNOME au sein de Fedora ou de RHEL par exemple ?

              L’idée des membres soutenant cette proposition (qui ne vient pas uniquement de personnes faisant partie du KDE SIG) est de remettre en question la place de GNOME « par défaut » dans le projet Fedora (notamment Fedora Workstation). Poser cette question force le projet à clarifier les critères qui font qu’un environnement de bureau est considéré comme majeur et donc autorisé à être représenté par une “édition” comme Fedora Workstation. Tous les environnements de bureau non-GNOME ne sont actuellement pas bien présentés sur le site de Fedora notamment.

              Il est important pour un projet communautaire de pouvoir justifier ses choix, que l’on soit d’accord ou non avec les arguments présentés. Si ces choix sont perçus comme arbitraires (« c’est comme ça que cela a toujours été », « c’est un employé de Red Hat qui l’a décidé »), alors le projet Fedora perd en crédibilité. Il faut, par exemple, pouvoir justifier que GNOME est un bon choix à présenter aux utilisateurs découvrant Fedora.

              Je ne pense pas que KDE va “remplacer” GNOME dans Fedora et ce n’est pas vraiment l’idée derrière cette proposition qui a été formulée explicitement de la sorte pour forcer la discussion. L’objectif est de rendre KDE plus visible dans Fedora.

              Pour ce qui est de remplacer GNOME dans RHEL, c’est peu probable et cela serait une décision de Red Hat.

              Penses-tu que Fedora est une distribution de référence pour utiliser KDE aujourd’hui ? Par le passé OpenSUSE, Kubuntu ou Mageia étaient souvent recommandées pour utiliser cet environnement.

              Oui ! :) Fedora propose depuis plusieurs années les dernières versions de KDE à des fréquences très proches des sorties upstream. Nous sommes actuellement l’une des premières distributions à proposer le bureau KDE Plasma dans sa version 6. Le KDE SIG suit et participe activement au développement de KDE upstream et certains développeurs KDE recommandent désormais Fedora.

              Je travaille avec Fedora Kinoite à rendre le développement de KDE plus abordable, notamment pour le test des versions en cours de développement.

              Si tu avais la possibilité de changer quelque chose dans la distribution Fedora ou dans sa manière de fonctionner, qu’est-ce que ce serait ?

              Je regrouperai l’intégralité des dépôts Git, codes sources, projets, suivi des bugs, etc. sur une (ou plusieurs) instance GitLab hébergée par le projet Fedora. C’est un projet qui est désormais en cours pour migrer vers Forgejo. Finies les instances Pagure (forge de développement Git), plus de Bugzilla (suivi des bugs). Il faudrait aussi abandonner les listes de diffusion pour utiliser Discourse à la place (transition aussi en cours).

              D’un point de vue personnel, la migration du projet KDE vers GitLab fut un facteur déterminant dans ma capacité à contribuer au projet KDE. Le mode de contributions à l’aide de Pull Requests / Merge Requests à travers une interface web est devenu un standard qui réduit significativement la difficulté pour un premier contributeur à participer à un projet.

              Je pense que c’est la prochaine étape importante pour rendre le développement de Fedora plus accessible et donc pour attirer plus de contributeurs.

              À l’inverse, est-ce qu’il y a quelque chose que tu souhaiterais conserver à tout prix dans la distribution ou le projet en lui-même ?

              Le processus pour proposer un changement (Change Process). C’est la clé de ce qui fait de Fedora une distribution à la pointe, qui évolue à chaque nouvelle version et qui pousse l’écosystème en avant.

              Que penses-tu de la communauté Fedora-fr que ce soit son évolution et sa situation actuelle ? Qu’est-ce que tu améliorerais si tu en avais la possibilité ?

              Malheureusement, je n’ai pas eu beaucoup d’interactions avec la communauté Fedora-fr, donc je n’ai pas grand-chose à dire.

              Quelque chose à ajouter ?

              Merci pour l’entretien !

              Si vous souhaitez en apprendre plus sur ces systèmes, je vous recommande les documentations officielles des projets ou les présentations que j’ai réalisées (une ou deux en français).

              Merci Timothée pour ta contribution !

              Conclusion

              Nous espérons que cet entretien vous a permis d’en découvrir un peu plus sur les systèmes immuables de Fedora et l’environnement KDE Plasma.

              Si vous avez des questions ou que vous souhaitez participer au Projet Fedora ou Fedora-fr, ou simplement l’utiliser et l’installer sur votre machine, n’hésitez pas à en discuter avec nous en commentaire ou sur le forum Fedora-fr.

              À dans 10 jours pour un entretien avec Thomas Canniot, ancien traducteur de Fedora en français et fondateur de l’association Fedora-fr.

              Commentaires : voir le flux Atom ouvrir dans le navigateur

              Proxmox Virtual Environment 8.4 est disponible

              Proxmox Server Solutions GmbH a publié la version 8.4 de sa plate-forme de virtualisation libre Proxmox Virtual Environment (VE). Proxmox VE est sous licence GNU Affero GPLv3. Proxmox Server Solutions propose un support d’entreprise à partir de 115 € par an et par processeur.

              Principales nouveautés de la version 8.4

              • Migration à chaud avec des dispositifs médiés :
                Les dispositifs médiés permettent de partitionner les ressources matérielles physiques en plusieurs dispositifs virtuels. Il est désormais possible de migrer des machines virtuelles (VM) en cours d’exécution utilisant des dispositifs médiés, tels que les vGPU NVIDIA.

              • API pour les solutions de sauvegarde tierces :
                Proxmox VE propose une API qui simplifie le développement de plug-ins par les fournisseurs de solutions de sauvegarde externes. Ces solutions de sauvegarde tierces peuvent désormais implémenter directement des fonctionnalités de sauvegarde et de restauration dans Proxmox VE, tout en tirant parti de fonctionnalités avancées.

              • Passage direct de répertoires via Virtiofs :
                La version 8.4 offre la possibilité de partager des fichiers et des répertoires directement entre un hôte et les machines virtuelles (VM) exécutées sur cet hôte. Cette fonctionnalité est rendue possible par virtiofs, qui permet aux machines virtuelles d’accéder aux fichiers et répertoires de l’hôte sans surcharger le système de fichiers réseau. Les systèmes invités Linux modernes sont dotés de la prise en charge native de virtiofs, tandis que pour les invités Windows, l'utilisation de cette fonctionnalité nécessite un logiciel supplémentaire.

              • Mises à jour de tous les composants libres :
                Proxmox VE 8.4 est basé sur Debian 12.10 (“Bookworm”), mais utilise par défaut le noyau Linux 6.8.12. Cette version de Proxmox VE inclut des mises à jour vers les dernières versions des principales technologies open source pour les environnements virtuels, telles que QEMU 9.2.0, LXC 6.0.0. La solution est livrée avec ZFS 2.2.7 et Ceph Squid 19.2.1.

              D’autres améliorations incluent un mécanisme de filtrage de sauvegarde plus robuste, des améliorations de la pile SDN (réseau défini par logiciel), et de nouvelles options dans l’installateur ISO.

              Commentaires : voir le flux Atom ouvrir dans le navigateur

              Rendez-nous nos boutons !

              Cette dépêche fait suite à celle sur les interfaces temps réel ainsi qu’a celle sur l’informatique sans écran. C’est une dépêche de réac qui se plaint que c’était bien mieux avant et qu’on ferait bien d’écouter les anciens un peu plus.

              Sommaire

              C’est une note du blog de ploum qui m’a fait réaliser que l’on a besoin de remettre des boutons, des touches, des joysticks, des potentiomètres linéaires et autres boules de pointage (trackball), souris (boutons et molette), manettes… sur nos ordinateurs, télés, ordiphones, bagnoles et autres mixeurs à soupe mouchard. C’est urgent à l’heure où même nos guitares sont menacées par les écrans tactiles. Bref, une bonne interface Humain/Machine passe par un retour tactile de nos actions : on veut des boutons !

              ChatGpt refuse de dessiner les ados boutonneux

              Figure 1 - Refus catégorique de ChatGPT. Peut-être que « Dessine moi un adolescent avec plein de moutons » aurait été mieux accepté. Big Data implique Big Culture, non ?

              Retour vers le futur boutonneux

              Avant de râler et de déclencher la Guerre des boutons, interrogeons-nous sur ces objets du quotidien. On est sérieux à nôtre âge, on n’a plus dix-sept ans.

              Si on considère les touches des claviers d’instruments de musique comme les ancêtres du bouton, alors on peut remonter jusqu’à l’Antiquité et aux premiers orgues : l’hydraule, orgue où l’air est mis sous pression par une chute d’eau, date en effet du IIIe siècle avant notre ère (Ctésibios d’Alexandrie). C’est aussi le premier instrument à clavier. Ses touches avaient probablement des mécanismes très simples et il n’y avait pas de touches blanches et noires, comme dans cette reconstitution d’un orgue antique (avec même le son dans la vidéo). Vers 320-322 de notre ère, Claudien écrit un poème contenant ces vers :

              « Qu’un autre enfantant, par une légère pression, des sons au loin retentissant, modère les mille voix de mille tuyaux d’airain, les fasse tonner sous ses doigts errants, et d’une onde profondément agitée par le jeu du levier, tire d’harmonieuses modulations. » (Panégyrique sur le consulat de Flavius Mallius Theodorus)

              Reconstitution d’un orgue romainFigure 2 - Reconstitution d’un orgue romain. [Source : Wikimedia, domaine public]

              On trouve déjà dans cette description le constat qu’il suffit d’appuyer sur un bouton pour déclencher des tâches mobilisant une grande puissance. Seize siècles plus tard, en pleine guerre froide et deux ans après la crise des missiles de Cuba, le jeune Bob Dylan (22 ans) chante dans With God On Our Side (The Times They Are A-Changin’, 1964) :

              One push of the button
              And a shot the world wide

              USS Growler launch controlFigure 3 - Tableau de bord des missiles de croisière nucléaires du sous-marin USS Growler (1958-1964). [Source : Wikimedia, licence : CC-BY-SA par Flintmichigan]

              C’est en fait dans les deux dernières décennies du XIXe siècle, avec la diffusion de l’électricité dans les villes, que se produit la grande éruption des boutons. Nous avons bien sûr oublié à quel point c’était magique à l’époque ! Mais on s’inquiète aussi rapidement de l’avènement d’une humanité presse-bouton :

              Plotnick cite un éducateur et activiste de 1916 déplorant que le fait d’appuyer sur un bouton « semble nous décharger de toute nécessité de se sentir responsable quant à ce qui se passe derrière le bouton ».

              Les récits d’anticipation s’en emparent. Par exemple, Edward Morgan Forster publie en 1909 une nouvelle intitulée The Machine Stops (La Machine s’arrête) dans laquelle les êtres humains vivent sous terre isolés chacun dans une pièce, quasiment sans contact physique, la Machine satisfaisant tous leurs besoins :

              Puis elle activa la lumière, et la vue de sa chambre, inondée de lumière et constellée de boutons électriques, la revigora. Il y avait des boutons et des interrupteurs partout - des boutons pour demander de la nourriture, de la musique, des vêtements. Il y avait le bouton du bain chaud, qui faisait surgir du sol une cuve en (faux) marbre, remplie à ras bord d’un liquide chaud et désodorisé. Il y avait le bouton du bain froid. Il y avait le bouton qui produisait de la littérature. Et il y avait bien sûr les boutons qui lui permettaient de communiquer avec ses amis. La chambre, bien que ne contenant rien, était connectée avec tout ce qui lui importait dans le monde. (Version originale en ligne sur The Project Gutenberg et version française éditée par l’échappée)

              C’était mieux avant ! (On était jeune)

              Tout râleur qui tient à sa crédibilité se doit de râler en connaissance de cause. On n’ira donc pas jusqu’à prétendre que c’était mieux sans bouton et on se contentera de notre vécu : c’était mieux avant quand il y avait de vrais boutons ! Qu’on pouvait pressurer et qui faisaient de vrais sons, « des clip, crap, des bang, des vlop et des zip », qui résistaient, qui vibraient, qui glissaient ! Bref, qui nous donnaient des sensations.

              Hard Rock Cafe Florence - Touchscreen with The Doors quoteFigure 4 - Malgré cet appel touchant, les portes de la perception semblent désormais presque fermées. Le monde est devenu plat et lisse ; les êtres humains se sont enfermés dans leur caverne numérique. [Source : Wikimedia, licence : CC-BY par SunOfErat]

              Bien que la technologie des écrans tactiles soit assez ancienne, c’est surtout l’envolée des ventes de smartphones et tablettes autour de 2010 qui va propager les interfaces tactiles à d’autres objets du quotidien : des appareils électroménagers jusqu’aux voitures, pour le meilleur et pour le pire. Probablement parce qu’un écran tactile avec des menus permet de remplacer de nombreux boutons et aussi par effet de mode (ça fait moderne, en attendant les interfaces cérébrales). Dans nos interfaces graphiques, telles que GTK, on retrouve des ersatz de boutons : interrupteurs On/Off, boutons radio (quand on presse sur l’un, l’autre ressort), commutateurs (switches), etc. Mais tout ça manque de relief !

              Sur les lecteurs de K7, on pouvait avoir des boutons poussoir qui remettaient à zéro le compteur (mécanique). Et également des boutons qu’on poussait vers le bas et qui restaient bloqués (lecture) ou non (éjection). Press the Eject and Give Me the Tape est par exemple le titre d’un album live du groupe britannique Bauhaus sorti en 1982.

              RadioShack CTR-119Figure 5 - Un magnétophone : appuie sur Eject et file-moi la K7 ! [Source : Wikimedia, domaine public]

              Sur une chaîne Hi-Fi, on trouve de bons gros boutons cylindriques que l’on peut prendre à pleine main. Ils peuvent être continus (par exemple pour le volume), c’est-à-dire que ce sont des potentiomètres rotatifs, ou à crans (par exemple pour sélectionner une source). Ces gros boutons ont été longtemps également utilisés pour sélectionner les fréquences des stations de radio et ils faisaient bouger un curseur au-dessus des graduations. Sur nos chaînes, on peut aussi avoir des boutons de type manette, avec deux positions ou plus. Sur les radio-K7 on pouvait également rencontrer des potentiomètres linéaires pour régler le volume ou la tonalité. On les utilise aussi sur les égaliseurs, comme ci-dessous.

              Sharp CD-S400 Hi-Fi system, ca. 1993Figure 6 - Une éruption de boutons divers et variés, sensations garanties [source : Wikimedia, licence : CC0].

              Dans la suite de cette dépêche, on va surtout évoquer les boutons poussoir (qu’ils restent bloqués ou non) car ce sont ceux que l’on rencontre le plus dans les interfaces tactiles. Mais le discours serait similaire pour les autres types de boutons.

              Ça change quoi ? Un bouton c’est un bouton, non ?

              Le problème de l’écran tactile, c’est que c’est l’écran qui est tactile, qui touche, qui sent notre doigt. Le doigt, quant à lui, sent juste qu’il a touché une surface, mais il ne sait pas s’il est au bon endroit. L’écran est soi-disant tactile, mais c’est avant tout un écran, ce qui implique la vue. Lorsque l’on touche le bouton avec son doigt, on le cache. Pour savoir s’il on a bien appuyé sur le bouton il faut donc retirer son doigt et regarder à nouveau si le bouton virtuel a changé d’état.

              Du point de vue de l’utilisateur, on a donc plutôt affaire à des « boutons visuels » plutôt qu’à un « écran tactile ». Tout au plus l’émission d’un clic électronique ou d’une vibration non localisée confirmera qu’on a appuyé sur un bouton (parmi d’autres).

              Avec de vrais boutons, c’est du 3D. Si on a mémorisé leur disposition, on peut s’en sortir sans la vue, uniquement au toucher. Intéressant quand on conduit par exemple, les doigts se promènent par exemple sur les six boutons pour choisir la station de radio et trouvent sans problème le troisième bouton. Une personne aveugle sera bien démunie face à un écran tactile. Un bouton mécanique est quant à lui vraiment tactile, c’est-à-dire que les doigts le sentent : le toucher prédomine alors sur la vision. D’ailleurs en français, les « boutons » d’un clavier, qu’il soit musical ou informatique, s’appellent des touches.

              On peut aussi noter que les vrais boutons sont généralement en nombre limité (car ça prend de la place et ça coûte). Ils permettent donc d’effectuer les actions les plus courantes. Les écrans permettent de créer des menus, pour des choix plus complexes. Mais cela peut être redoutable pour certaines personnes âgées, qui n’ont pas été habituées à ces technologies, ou dont les fonctions cérébrales déclinent. Ne parlons même pas des mises à jours logiciels incessantes qui changent l’aspect et la disposition des menus.
              Le pire étant le manque de performance (c'est rarement temps réel) qui nous force souvent à ré-apppuyer pour se retrouver avec un comportement que l'on avait pas prévu quand ça se débloque.

              Autre problème, on a parfois besoin de protéger ses doigts avec des gants, qu’il fasse froid ou qu’on soit en train de faire une activité dangereuse pour les mains. Un bon vieux bouton reste généralement utilisable. Même avec des moufles, on pourra encore y arriver si les boutons ne sont pas trop rapprochés !

              Technician mounting glove on Hoshides EMU during SSATA traning for Expedition 32Figure 7 - Parfois on doit travailler avec des gants, ce qui entraîne une perte au niveau tactile. Il y a vraiment là de quoi faire la moue. [Source : Wikimedia, domaine public]

              Revenons sur le son. Les boutons sur lesquels on appuie émettent souvent un son qui constitue un retour sensoriel supplémentaire qui nous indique si nous les avons correctement enfoncés. Au point que l’on parle de « cliquer » sur le bouton d’une souris plutôt que d’appuyer dessus. On a donc à la fois un retour tactile (une certaine résistance ou vibration) et un retour sonore, en plus de l’éventuel retour visuel si on regarde le bouton.

              Avec un écran dit tactile, le retour tactile est justement bien maigre, on ne fait qu’effleurer les choses : la pression exercée importe peu, la résistance opposée par l’écran sera la même si j’appuie sur le soit-disant bouton ou à côté ! Et le vibreur de mon téléphone fera vibrer tout le téléphone au lieu de ne faire vibrer que l’endroit où j’ai appuyé. Triste topique…

              Le patch de Colombia

              Les constructeurs d'ordiphone s'échinent à virer les boutons de leurs appareils ? Qu'à cela ne tienne, des étudiants de l'Université de Colombia proposent une coque pour en remettre !

              Sans aucune connexion électrique, ces étudiants proposent de faire vibrer le téléphone au moyen de clapet et ressort et de les détecter en utilisant l'accéléromètre.

              Coque_Boutons_Colombia

              Le type de vibration reçue permet à un logiciel de traitement du signal de détecter le type de bouton actionné et ainsi récupérer la fonctionnalité perdue.

              C'est intéressant, mais pourquoi ne pas tout simplement nous rendre nos boutons !

              L’urgence ergonomique

              Nous savons bien que les temps changent, mais il ne faut pas céder à la mode sans raison. L’écran tactile peut être adapté à certaines machines ou situations et pas à d’autres. Faut-il vraiment « être absolument moderne », juste pour le plaisir ? Non, il faut être absolument ergonomique. Alors, si vous ne voulez pas vous faire appeler Arthur, rendez-nous nos bons vieux boutons là où ils sont parfaitement adaptés à nos besoins ! Rouvrons les portes de la perception !

              RimbaudFigure 8 - Un adolescent peut aussi avoir des boutons au niveau de son gilet. De plus, en voilà un qui ne sourit pas et n’a pas l’air niais. Ce qui finalement justifie peut-être le refus de ChatGPT en haut de cette dépêche. [Source : Wikimedia, Étienne Carjat (1871), domaine public]

              Bibliographie

              Commentaires : voir le flux Atom ouvrir dans le navigateur

              20 ans de Fedora-fr : deuxième entretien avec Remi empaqueteurs de paquets RPM

              Dans le cadre des 20 ans de Fedora-fr (et du Projet Fedora en lui-même), nous – Charles-Antoine Couret (Renault) et Nicolas Berrehouc (Nicosss) – avons souhaité poser des questions à des contributeurs francophones du Projet Fedora et de Fedora-fr.

              Grâce à la diversité des profils, cela permet de voir le fonctionnement du Projet Fedora sous différents angles pour voir le projet au-delà de la distribution mais aussi comment il est organisé et conçu. Notons que sur certains points, certaines remarques restent d’application pour d’autres distributions.

              N’oublions pas que le Projet Fedora reste un projet mondial et un travail d’équipe ce que ces entretiens ne permettent pas forcément de refléter. Mais la communauté francophone a la chance d’avoir suffisamment de contributeurs de qualité pour permettre d’avoir un aperçu de beaucoup de sous projets de la distribution.

              Chaque semaine un nouvel entretien sera publié sur le forum Fedora-fr.org, LinuxFr.org et le blog de Renault.

              L’entretien du jour concerne Remi Collet (pseudo remi), empaqueteur du Projet Fedora en particulier concernant l’écosystème PHP.

                Sommaire

                Peux-tu présenter brièvement ton parcours ?

                40 ans, c’est long !

                J’ai découvert l’informatique à une époque préhistorique où l’on travaillait sur des terminaux (texte) connectés à de gros systèmes avec des langages oubliés (Cobol…). Ensuite j’ai eu la chance de voir les choses changer.

                Travaillant pendant 20 ans dans une grande administration française, et parallèlement dans une université à la gestion du matériel pédagogique. J’ai vu arriver les ordinateurs personnels, les premiers réseaux locaux, GNU, Linux, Windows, Internet… Rapidement à l’université (veille technologique) et progressivement dans le monde professionnel. Les solutions OpenSource ont toujours été au cœur de mon activité, et la contribution un but personnel.

                Au départ développeur, je suis aussi devenu administrateur système et réseau.

                Je travaille désormais chez Red Hat comme développeur, principalement chargé de PHP.

                Peux-tu présenter brièvement tes contributions au Projet Fedora ?

                Lorsque j’ai migré mon ordinateur personnel sous Linux il y a plus de 20 ans, j’ai passé beaucoup de temps sur les forums, pour apprendre des autres et aider les nouveaux.
                Cela a été très formateur.

                Ensuite je me suis investi dans la maintenance de paquets RPM pour mes besoins et pour partager. Et je me suis concentré sur le monde PHP.

                Qu’est-ce qui fait que tu es venu sur Fedora et que tu y es resté ?

                J’ai commencé avec Red Hat Linux 5 (1997), qui est devenu Fedora Core, puis Fedora. Au départ c’est le hasard d’un serveur livré avec un CD. Et depuis j’ai toujours été fidèle à l’une des premières distributions majeures.

                Pourquoi contribuer à Fedora en particulier ?

                Parce que c’est “la” distribution où les choses changent.

                Peux-tu préciser les éléments qui confirment cela de ton point de vue ?

                L’exemple le plus marquant est sans doute “systemd” qui a provoqué lors de sa sortie un débat technique très vif, mais qui est désormais sur toutes les distributions (ou presque).

                Contribues-tu à d’autres Logiciels Libres ? Si oui, lesquels et comment ?

                Principalement PHP et de nombreux projets autour (extensions, bibliothèques, applications…).

                Utilises-tu Fedora dans un contexte professionnel ? Et pourquoi ?

                Oui, depuis 1997 avec l’installation d’un serveur d’accès à Internet. Et aujourd’hui sur tous mes serveurs et postes de travail.

                Tu as été recruté par Red Hat alors que tu étais déjà dans la communauté de Fedora, comment cela s’est passé ?

                Depuis la fusion de Fedora Core + extras (2007), j’étais devenu le mainteneur du paquet PHP. Donc quand Red Hat a cherché à recruter un mainteneur spécifique pour PHP (2012), j’étais le mieux placé.

                Ils t’ont contacté ou tu as postulé ?

                Ils m’ont contacté (cooptation), ce qui tombait bien puisque je cherchais un nouvel emploi.

                Est-ce que la contribution à Fedora a été un élément déterminant dans le processus ?

                Clairement oui, ainsi que mon implication dans PHP, en amont.

                Est-ce que tes contributions dans Fedora se font entièrement dans le cadre de ton travail ? Si non, pourquoi ?

                Non.
                Je contribuais au Projet Fedora avant de rejoindre Red Hat, et si j’ai la chance de pratiquer ma passion (l’OpenSource) dans mon travail, je continue aussi en dehors. Ma position m’a aussi permis d’augmenter mes contributions sur les autres projets.

                Par contre, aujourd’hui je cherche à maintenir un équilibre afin de garder une vie privée et sociale saine.

                Est-ce que être employé Red Hat te donne d’autres droits ou opportunités au sein du Projet Fedora ?

                Non (en dehors du temps), et heureusement. Fedora est avant tout un projet communautaire.

                Tu es actif au sein de SIG PHP, quel est le rôle de cette équipe de travail et de ton activité dans cette équipe ?

                Ce groupe n’a jamais été très actif, et je suis désormais pratiquement seul.

                Tu es également contributeur au sein du projet PHP lui-même, quelle est la nature de ton travail pour ce projet ?

                Je contribue régulièrement au code, surtout sur des corrections de défauts rapportés par les utilisateurs de mon dépôt, de Fedora ou de RHEL. Je maintiens aussi quelques extensions (zip, mailparse, rpminfo…). Je participe aussi activement au processus de publication des nouvelles versions (QA avant annonce).

                Quels bénéfices retires-tu de travailler sur les deux aspects du projet PHP à savoir upstream mais aussi sur la conception de ces paquets ?

                Il me semble indispensable de communiquer entre l’amont (le projet PHP) et l’aval (le Projet Fedora). Être impliqué dans les 2 projets simplifie énormément les choses. Et évidement, il est plus facile de faire évoluer un projet lorsqu’on y contribue activement.

                Quelles simplifications cela comporte plus en détail selon toi ?

                Lorsqu’un utilisateur de Fedora (ou de mon dépôt) signale un bug, il est plus simple de le corriger en étant contributeur, soit directement, soit par le dialogue avec les autres développeurs.

                De même pour les évolutions de la distribution qui peuvent avoir un impact sur PHP (exemple: l’intégration à systemd).

                Et la réciproque est vraie pour les évolutions du projet qui peuvent affecter la distribution (exemple: la suppression d’extension ou l’ajout de nouvelles fonctionnalités nécessitant de nouveaux outils).

                Être actif dans une communauté permet d’être connu et reconnu et donc d’être écouté.

                Tu as aussi l’un des dépôts externes les plus populaires et actifs de Fedora centré sur PHP, pourquoi as-tu créé ce dépôt ? Pourquoi tu continues à l’alimenter alors que le projet Fedora fourni déjà PHP ?

                Ce dépôt existe depuis 2005 et me permettait de partager mon travail avant de contribuer à Fedora.

                Aujourd’hui c’est là que je prépare les évolutions avant qu’elles soient intégrées dans Fedora (puis dans CentOS Stream, puis dans RHEL). Par exemple PHP 8.3 présent dans Fedora 40 était dans mon dépôt depuis presque 1 an (Juin 2023, version 8.3.0alpha1)

                Alors que Fedora fournit une seule version de PHP et une cinquantaine d’extensions, mon dépôt propose 5 versions (même 10 pour EL), ~150 extensions et 2 modes d’installation.

                Pourquoi ne pas utiliser le système de COPR pour ce travail ?

                Copr est très intéressant pour les petits projets. Dans mon cas, ce sont des milliers de paquets. Et Copr n’est pas adapté pour les modules, ni pour les quelques paquets non libres que je maintiens (ex: Oracle).

                Peux-tu expliquer l’importance du mainteneur de paquet dans la distribution ? Quels choix il faut effectuer, les difficultés techniques rencontrées, etc.

                C’est celui qui essai de coordonner les projets amont / aval et les utilisateurs en essayant de satisfaire des besoins parfois incompatibles de stabilité, de compatibilité, d’innovation.

                Les “Modules” de Fedora étaient censés être un pilier de Fedora.next pour fournir différentes versions des piles technologiques, comme PHP, pour une version donnée de Fedora. Maintenant que c’est abandonné, peux-tu expliquer les raisons derrière cet échec ? Pour un empaqueteur, quelles ont été les difficultés derrière ?

                https://blog.remirepo.net/post/2024/03/29/DNF-5-and-Modularity. Je retiendrais que ce projet répondait avant tout à un besoin de distribution entreprise qui n’est pas vraiment utile à Fedora avec un cycle de version très rapide (6 mois).

                La complexité du système de construction a peut-être été une raison de son échec.

                Tu as aussi écrit la documentation française pour faire ses propres paquets RPM et tu as aidé de nombreux francophones à réaliser leurs premiers paquets, qu’est-ce qui t’intéresse à guider les débutants dans cette activité ?

                Le partage.
                Accompagner un débutant est toujours passionnant, humainement et techniquement. Cela permet aussi de répondre à des questions qu’on ne se pose pas forcément, et donc de se remettre en cause.

                Les paquets traditionnels ne sont plus l’unique voie d’avoir un logiciel qui tourne sous Fedora. Avec Flatpak, Snap ou des solutions tels que Docker / Podman cela devient possible de s’en affranchir. Comment vois-tu l’évolution des paquets au sein d’une distribution dans Fedora ? Que penses-tu de ces évolutions ?

                Avant on cherchait à créer une distribution cohérente ou chaque composant était partagé et utilisé par les autres (une sorte de Lego).

                Aujourd’hui, et je le regrette, beaucoup ont abandonné cet objectif et beaucoup de projets préfèrent embarquer tous les composants qu’ils utilisent.

                C’est le cas de PHP avec “composer”, de langages comme Rust où la notion de bibliothèques partagées n’existe même plus. Flatpack / Snap n’en sont qu’un développement extrême.

                N’est-ce pas aussi parce que cela résout certaines problématiques liées à la rigidité des paquets qui rendent notamment la cohabitation de versions différentes délicates ou de rendre l’environnement de travail plus modulaire ?

                Je pense que cela ne résout rien. On sait parfaitement installer plusieurs versions d’une bibliothèque simultanément.

                Disons que c’est la solution de facilité, on n’essaie même plus de faire propre. Sans parler des projets qui embarquent des copies modifiées, sans que les modifications soient reversées ou discutées.

                Si tu avais la possibilité de changer quelque chose dans la distribution Fedora ou dans sa manière de fonctionner, qu’est-ce que ce serait ?

                La communauté Fedora est composée de gens passionnés. La passion entraine parfois des positions excessives et des discussions sans consensus possible.
                La communauté des contributeurs a tué de beaux projets, comme les « Softwares Collections » ou les “modules”. Je trouve cela dommage.

                Peux-tu expliquer ce que sont les Software Collections et pourquoi cela n’a pas abouti ? Quelles différences avec les modules notamment ?

                Les Software Collections permettent une méthode standard d’installation de plusieurs versions d’une application sans conflit espace de nom différent, installation sous /opt et sans risque d’altération du système de base.

                Le projet ayant été développé par Red Hat pour les besoins de sa distribution Entreprise il a provoqué un vif débat technique (ex: non respect de la FHS, ce qui a été corrigé par la suite) et a même provoqué l’épuisement et le départ de 2 membres du FPC.

                La complexité d’utilisation (activation de la SCL) a aussi été des raisons de leur détestation.

                Ce besoin étant quasi inexistant pour Fedora, personne n’a eu la force d’améliorer la solution qui a été abandonnée.

                Les modules permettent de fournir plusieurs versions alternatives d’une application, mais sans permettre une installation simultanée. Fonctionnellement c’est comme si chaque version est disponible dans un dépôt différent qu’il suffit d’activer.

                À l’inverse, est-ce qu’il y a quelque chose que tu souhaiterais conserver à tout prix dans la distribution ou le projet en lui-même ?

                La passion justement, qui reste un moteur indispensable. S’il n’y a plus de passion, plus de plaisir, autant arrêter (j’ai abandonné quelques projets pour cela).

                Que penses-tu de la communauté Fedora-fr que ce soit son évolution et sa situation actuelle ? Qu’est-ce que tu améliorerais si tu en avais la possibilité ?

                La communauté Fedora est surtout composée de contributeurs. D’autres distributions ont une communauté d’utilisateurs et sont excellentes pour leur promotion.

                Je n’ai malheureusement pas d’idée magique pour augmenter la communauté Fedora-Fr.

                Je pense aussi que les contributeurs français sont souvent actifs dans la communauté globale (en anglais) plutôt que dans la communauté française.

                Trouves-tu que c’est spécifique à la communauté francophone ?

                Je ne sais pas, je ne connais pas trop les autres communautés, mais je rencontre beaucoup de nationalités différentes dans la communauté anglophone.

                Merci Remi pour ta contribution !

                Conclusion

                Nous espérons que cet entretien vous a permis d’en découvrir un peu plus sur l’empaquetage de Fedora.

                Si vous avez des questions ou que vous souhaitez participer au Projet Fedora ou Fedora-fr, ou simplement l’utiliser et l’installer sur votre machine, n’hésitez pas à en discuter avec nous en commentaire ou sur le forum Fedora-fr.

                À dans 10 jours pour un entretien avec Emmanuel Seyman, ancien président de Borsalinux-fr et actuel empaqueteur dans l’écosystème du langage Perl.

                Commentaires : voir le flux Atom ouvrir dans le navigateur

                Raspberry Pi 5, évolution ou révolution ?

                Les méandres de l'espace de rédaction sont parfois mystérieux. La rédaction de certaines dépêches s'étalent parfois sur de long mois, parfois sans même comprendre pourquoi la dépêche ne part pas vers le stade de la publication. C'est ce qui est arrivé à cette dépêche qui ne suit donc pas autant qu'elle aurait pu l'actualité de la sortie de la nouvelle mouture de la microcarte de la Fondation Raspberry Pi, qui porte le nom très original de Raspberry Pi 5. Cette dépêche - qui nous offre une comparaison de cette nouvelle édition avec son illustre ancêtre ainsi qu'une investigation de ses nouveautés - reste substantielle et il nous a semblé qu'il valait mieux la publier même tardivement plutôt que de la plonger dans l'oubli éternel.

                  Sommaire

                  Cette dépêche ne traitera pas de l’ensemble de ce que l’on peut faire, la précédente dépêche sur les SoC faite pour la sortie de la Raspberry Pi 4 est toujours d’actualité en ce qui concerne ces sujets.

                  Comparaison entre Raspberry Pi 4 et Raspberry Pi 5

                  Sorti en 2019, le RPi4 avait fait forte impression—mais quasiment en constante pénurie entre 2020 et 2023, il commençait par accuser le coup par rapport à la concurrence du Rockchip RK3588 (Quad-core Cortex-A76 + Quad-core Cortex-A55).

                  Aussi, la Raspberry Pi 5 introduit des avancées significatives par rapport à la Raspberry Pi 4, dont le Tableau 1 présente une synthèse des différences.

                  Composants Raspberry Pi 4 Raspberry Pi 5
                  SoC Broadcom BCM2711 Broadcom BCM2712
                  CPU Quad-core Cortex-A72 (1.8 GHz) Quad-core Cortex-A76 (2.4 GHz)
                  GPU VideoCore VI (500 MHz) VideoCore VII (800 MHz)
                  Mémoire 1, 2, 4, 8 GB LPDDR4-3200 SDRAM 4, 8 GB LPDDR4X-4267 SDRAM
                  Wi-Fi Dual-band 802.11ac Dual-band 802.11ac
                  Bluetooth 5.0, BLE 5.0, BLE
                  USB 2 USB 3.0, 2 USB 2.0, 1 Type-C port 2 USB 3.0, 2 USB 2.0, 1 Type-C port
                  Stockage MicroSD MicroSD (SDR104⟹R/W↗ˣ²) + ligne PCIe pour NVME M.2 SSD
                  Ethernet Gigabit Ethernet Gigabit Ethernet
                  Puissance Jusqu’à 7.5 W 2 modes : jusqu’à 15 W et jusqu’à 25 W
                  Gestion HDMI 2 HDMI 2.0 (1 gérant 4k@60 Hz) 2 HDMI 2.0 (tous les deux gérant 4k@60 Hz)
                  Format vidéo H.264 (AVC) H.265 (HEVC)
                  PCIe Non 1 lane PCIe pour périphériques haute performance
                  Bouton d’alimentation Non Oui

                  Tableau 1 : comparatif des Raspberry Pi 4 et 5

                  Détail des améliorations de la Raspberry Pi 5

                  La Raspberry Pi 5 introduit des avancées significatives par rapport à la Raspberry Pi 4, en particulier avec l’introduction du southbridge RP1. Voici une comparaison détaillée mettant en évidence les principales différences et l’impact du RP1 :

                  • Processeur : La Raspberry Pi 5 est équipée d’un CPU ARM Cortex-A76, une amélioration substantielle par rapport au Cortex-A72 trouvé dans la Raspberry Pi 4. Cette mise à niveau fait que la Pi 5 est deux à trois fois plus rapide que son prédécesseur.
                  • RAM : La Raspberry Pi 5 utilise de la LPDDR4X-4267 SDRAM, nettement plus rapide que la LPDDR4-3200 SDRAM utilisée dans la Pi 4. Cette amélioration offre plus de bande passante, contribuant à des performances globalement plus rapides.
                  • Puissance graphique : La Raspberry Pi 5 dispose d’un GPU VideoCore VII plus puissant, cadencé à 800 MHz et prenant en charge OpenGL ES 3.1 et Vulkan 1.2. C’est une avancée par rapport au GPU VideoCore VI de la Raspberry Pi 4, qui prend en charge OpenGL ES 3.1 et Vulkan 1.0. Le GPU de la Pi 5 comprend également un nouveau processeur de signal d’image pour la gestion des données des caméras.
                  • Chip RP1 Southbridge : La puce RP1 est une innovation majeure dans la Raspberry Pi 5. Elle agit comme un southbridge, gérant la plupart des fonctions I/O (entrée/sortie), réduisant ainsi la charge sur le CPU. Cela permet une augmentation de la bande passante I/O, bénéficiant aux dispositifs de stockage, USB et autres périphériques.
                  • Vitesse des cartes MicroSD : Le port microSD de la Pi 5 prend en charge le mode haute vitesse HDR 104 avec les cartes microSD UHS-1, offrant des vitesses de lecture de 80-90 Mbps, soit le double de la vitesse de 40-50 Mbps de la Pi 4.
                  • Ports USB : Dans la Raspberry Pi 5, chacun des deux ports USB 3.0 dispose d’une bande passante dédiée de 5 Gbps, grâce à la puce RP1. C’est une amélioration par rapport à la Pi 4, où les deux ports USB 3.0 partageaient la bande passante de 5 Gbps.
                  • Connecteur PCIe : La Pi 5 inclut un connecteur PCIe (PCI Express), une nouvelle addition répondant à la demande pour des interfaces plus rapides. Cependant, l’interface PCIe de la Pi 5 n’est pas un connecteur M.2 standard ; elle nécessite un câble ruban pour se connecter à un HAT, et le dispositif M.2 se connectera au HAT. Caractéristiques
                  • Un bouton marche/arrêt : Eh oui, on est quand même dans le 3ᵉ millénaire ;-)
                  • Alimentation : Tout comme la Raspberry Pi 4, la Raspberry Pi 5 utilise un connecteur d’alimentation au format USB Type-C. En revanche, doublement de la puissance oblige, la puissance nécessaire à son fonctionnement passe de 7.5 W à 15 W, il faudra donc une alimentation en 3A minimum pour être tranquille. À noter que si vous souhaitez utiliser des périphériques externes qui consomment beaucoup comme des disques durs ou SSD, il est conseillé d’avoir une alimentation de 25 W (5A). La Raspberry Pi détecte si l’alimentation fournit plus de puissance et passe la limite de consommation USB à 1,6A au lieu de 1,2A.

                  Raspberry Pi 5 : Nouveau South Bridge RP1 vs Raspberry Pi 4

                  Le RP1 est un contrôleur d’entrée/sortie (I/O) conçu pour le Raspberry Pi 5, représentant le programme d’ingénierie le plus complexe et coûteux entrepris par Raspberry Pi, avec un développement s’étendant sur plus de sept ans et ayant coûté environ 25 millions de dollars. Ce contrôleur est le premier produit phare de Raspberry Pi à utiliser une puce conçue en interne​.

                  Architecture du South Bridge RP1

                  — Description : Le RP1 est un southbridge de 12×12 mm avec un pas de 0.65 mm en BGA (Ball Grid Array), fournissant la majorité des capacités d’E/S pour la Raspberry Pi 5.
                  — Caractéristiques : Il comprend un point de terminaison PCIe 2.0 à 4 voies, un contrôleur Ethernet MAC Gigabit et deux contrôleurs hôtes USB 3.
                  — Améliorations : Plus du double de la bande passante USB utilisable par rapport à la Raspberry Pi 4.
                  — Documentation RP1 : RP1 Datasheet

                  Sources des informations sur le RP1

                  — L’article d’Eben Upton pour annoncer le RP1 : RP1 : the silicon controlling Raspberry Pi 5 (ce court article est accompagné d’une vidéo YT de 35 minutes à ce sujet, mais dont le contenu est reproduit textuellement en suivant un lien)
                  — Lien direct vers la vidéo YT : RP1 : the silicon controlling Raspberry Pi 5

                  Impacts du RP1

                  Le RP1 constitue une avancée importante, puisque les GPIOs “physiques” de la carte ne sont plus directement reliées aux GPIOs du microprocesseur et de leurs fonctions possibles (SPI/I2C/UART/I2S) attribuées par le fondeur dans le silicium.

                  1. Connectivité principale : Le RP1 se connecte à un processeur d’application (AP) via un bus PCIe 2.0 x4, consolidant de nombreux contrôleurs numériques et PHYs analogiques pour les interfaces externes du Raspberry Pi 5​​.
                  2. Contrôle du trafic : Le tissu interne du RP1 permet de prioriser le trafic en temps réel de la caméra et de l’affichage sur le trafic non en temps réel de l’USB et de l’Ethernet. Des signaux de qualité de service (QoS) sur le lien PCI Express soutiennent la priorisation dynamique entre le trafic provenant du RP1 et le trafic des maîtres de bus en temps réel et non en temps réel au sein de l’AP​​.
                  3. Fonctionnalités supplémentaires : Pour une flexibilité maximale des cas d’utilisation, le RP1 dispose de plusieurs fonctionnalités telles qu’un contrôleur DMA à huit canaux pour les périphériques à basse vitesse, trois PLL intégrées pour la génération d’horloges vidéo et audio indépendantes, un convertisseur analogique-numérique à cinq entrées, 64kB de SRAM partagée, et des générateurs de base temporelle pour le rythme de la DMA ou pour le debouncing des événements GPIO​​​​.
                  4. Gestion des contrôleurs de bus : Les modules de régulation intégrés à chaque port de contrôleur de bus permettent de surveiller ou de limiter leur comportement. Ces modules régulent le flux de données selon le nombre de transactions en attente, assurent le respect des limites d’adresses AXI et PCIe, et disposent de compteurs statistiques pour évaluer la qualité de service ou les performances.
                  5. Interfaces clés externes : Le RP1 fournit des interfaces externes clés telles que deux contrôleurs XHCI indépendants connectés à un seul PHY USB 3.0 et un seul PHY USB 2.0, deux contrôleurs de caméra MIPI CSI-2 et deux contrôleurs d’affichage MIPI DSI connectés à deux PHY transceivers MIPI DPHY à 4 voies partagées, et un contrôleur d’accès média (MAC) intégré pour l’Ethernet Gigabit​​​​.
                  6. Compatibilité et évolution : Le RP1 maintient la compatibilité avec la gamme de fonctions offerte sur le Raspberry Pi 4 Model B, tout en permettant une évolution vers des processus de géométrie réduite, sans avoir à reproduire tous les éléments analogiques du système. Cela pourrait permettre à changer plus facilement de fournisseur de SoC.

                  Évolution des performances

                  Afin de permettre de mieux visualiser les évolutions des performances Alasdair Allan a fait un benchmark complet dont certains éléments sont repris ici.

                  Tout d’abord une analyse des performances du CPU avec geekbench. Les Figures 1 et 2 montrent une augmentation des performances en single core d’approximativement 2.2x,
                  performances single core

                  Figure 1. : Comparaison des performances single core entre RPi4 et 5
                  performances multi core

                  Figure 2. : Comparaison des performances multi core entre RPi4 et 5

                  Compilation de différents benchmarks entre RPi 4 et 5

                  Benchmark Unités Raspberry Pi 4 Raspberry Pi 5 Augmentation de Performance
                  Sysbench Mono-Thread MBps 699 1041 x1,49
                  Sysbench Multi-Thread MBps 2794 4165 x1,49
                  Stress-ng Mono-Thread op/s 104,78 182,68 x1,74
                  Stress-ng Multi-Thread op/s 413,12 737,21 x1,78
                  Bzip Mono-Thread secondes 44,98 20,53 x2,19
                  Bzip Multi-Thread secondes 28,59 14,36 x1,99
                  Gimp Redimensionner secondes 67,01 29,95 x2,24
                  Gimp Rotation secondes 77,24 32,77 x2,36
                  Gimp Niveaux Auto secondes 80,52 34,64 x2,32
                  Gimp Masque Flou secondes 115,16 49,71 x2,32
                  Speedometer 2.1 score 20,5 62,5 x3,05
                  Glmark2 score 97 202 x2,08
                  Openarena Timedemo FPS 8,77 27,05 x3,08
                  RAMspeed Écriture MBps 4391 29355 x6,69
                  RAMspeed Lecture MBps 5902 27931 x4,73
                  HDparm Lecture MBps 43,81 90,05 x2,06
                  dd Écriture MBps 34,49 61,23 x1,78
                  Iozone 4 K Écriture RAND MBps 9,38 15,22 x1,62
                  Iozone 4 K Lecture RAND MBps 4,71 4,6 x0,98
                  Temps de démarrage secondes 33,4 19,1 x1,74

                  performances des I/O

                  La Figure 3. issue du travail d’Adafruit permet de mettre à jour le graphique sur la vitesse performance de la commutation des I/O proposé dans la dépêche sur la RPi4. La Figure 4. quant à elle montre une légère amélioration de la performance par Watt sur le nouveau modèle.

                  Titre de l’image
                  Figure 3. Évolution de la vitesse de commutation d’une sortie numérique

                  Titre de l’image
                  Figure 4. Évolution de la performance en fonction de la puissance électrique

                  Interfaces USB et Ethernet

                  — Interfaces: Le RP1 fournit deux interfaces USB 3.0 et deux interfaces USB 2.0, ainsi qu’un contrôleur Ethernet Gigabit.
                  — Source: Circuit Digest – The New Raspberry Pi 5 is here

                  Le Gigabit Ethernet fourni par le RP1 est en tout point semblable à celui du RBPi4 (voir : RP1 : the silicon controlling Raspberry Pi 5:

                  Liam 13:21: So we’ve got the Ethernet MAC but not the PHY. So the Ethernet’s brought out to an RGMII interface, which then connects to an on-board Ethernet PHY.

                  Eben 13:35: And this is a fairly similar architecture to Raspberry Pi 4, except that in that case, the MAC was in the Broadcom device, but there was still an external – in fact exactly the same external – PHY, [BCM]54213. Cool. So that’s the overall structure of the design.

                  Interfaces MIPI CSI/DSI

                  Ces interfaces d’entrée/sortie vidéo peuvent être qualifiées d’historiques dans l’écosystème RaspberryPi puisqu’elles sont présentes depuis la version 1. Le RBPi5 apporte toutefois une nouveauté assez remarquable par rapport à ses prédécesseurs : au lieu d’avoir un port CSI (pour une caméra) et un port DSI (pour un écran), les ports du RBPi5 peuvent être configurés pour l’une ou l’autre fonction. Malheureusement, cela s’est traduit par des changements notables au niveau de la disposition des composants sur la carte, qui ne sont pas sans susciter quelques grincements de dents parmi les utilisateurs.

                  Les points discutables/discutés

                  Le réarrangement de la carte

                  — Le port audio a disparu, pour laisser sa place au port MIPI DSI (qui peut faire CSI à présent), lui-même remplacé, au-dessus du lecteur de carte microSD, par un connecteur FPC exposant les lignes PCIe.
                  — le port DSI est passé de 15 pins à 22 pins (comme sur la carte CMIo4)
                  — Et, encore une fois, les ports Ethernet et USB ont été inversés.

                  Si cela ne pose pas de problèmes particuliers pour un utilisateur lambda, de nombreux projets basés sur les cartes RasperryPi à la recherche de performance de calcul (et donc potentiellement intéressés par ce nouveau RBPi5) doivent entièrement revoir la conception de leur matériel.

                  Le non réarrangement de la carte

                  C’est un reproche que l’on peut trouver dans de nombreux témoignages : mettre un HAT (carte d’extension) sur un RBPi, juste au dessus du CPU, c’est un non-sens en termes de refroidissement (et ce, quelle que soit la version du RBPi).
                  Mais, pour relativiser, on peut dire la même chose de quasiment toutes les autres solutions alternatives au RBPi.

                  Les limites du format carte de crédit

                  Ce format (86x56 mm) est devenu une référence pour presque tous les acteurs du monde des SBC. Et donc, il s’agit là aussi d’un constat plus général, non spécifiquement adressé à RaspberryPi. Mais sachant que ce sont les locomotives du marché, peut être pourraient-ils initier une nouvelle approche…
                  Certes, ce format permet d’élaborer des solutions compactes, mais l’on peut constater :

                  — qu’augmenter la puissance et les fonctionnalités des puces embarquées tout en restant sur ce format conduit à un gaspillage inutile de ressources : il est en effet impossible d’implémenter toutes les fonctionnalités matérielles proposées par les puces sur une si petite surface, et par ailleurs il devient difficile de refroidir efficacement le système.
                  — pour exposer le port PCIe, RaspberryPi a supprimé le port audio, déplacé le port DSI ; mais pour alimenter le bouzin, il vous faut du 5V 4A. Ensuite un peu tout le monde se trouve planté là : débrouillez-vous.

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Atelier : Mieux comprendre l'impact du Cyber Resilience Act sur les pratiques Open Source !

                  ATELIER du lundi 31 mars de 11h30 à 13h30 à Paris (participation en ligne possible).

                  Titre de l'image

                  Etes-vous prêts pour les échéances de 2026 et 2027 du Cyber Resilience Act (CRA) ?

                  Le CRA est un dispositif adpoté par la Commission Européenne en 2024 pour répondre à la vulnérabilité accrue aux cyberattaques des entreprises et services publics européens,. Il vise à renforcer la cybersécurité et la cyberrésilience des produits logiciels (et matériels qui comportent des éléments numériques) connectés.

                  Le premier guide de conformité au CRA dédié aux acteurs de l’open source, proposé par le CNLL et inno³ a pour objectif de faciliter la compréhension du CRA et les effets attendus, et de proposer des recommandations concrètes.

                  N'attendez pas pour commencer à évaluer vos obligations nouvelles à venir et les adaptations nécéssaires de vos processus, rejoignez l'atelier du 31 mars !

                  📅 Quand ? Le 31 mars de 11h30 à 13h30, la rencontre sera suivie d'un buffet pour les personnes sur place.

                  📍 Où ? 137 Boulevard de Magenta 75010 Paris (nombre de places limité, participation en ligne possible).

                  L'objectif est de rendre la session de discussion la plus active possible, n'hésitez pas à lire d'un œil critique et intéressé le guide en amont. Vous pouvez même nous envoyer dès aujourd'hui vos diverses questions ou remarques afin de nous aider à préparer l'atelier : mission-cra-cnll@framagroupes.org.

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Première publication libre de Multigit

                  Multigit est un outil graphique conçu pour simplifier la gestion de projets composés de beaucoup de dépôts git.

                  Une image et une vidéo valant mieux qu'un long discours, voici à quoi ça ressemble:

                  Screenshot

                  Je l'ai développé dans le cadre de mon travail chez IDEMIA où nous sommes souvent confrontés à plus de trente (voire plus de soixante) dépôts à gérer conjointement sur un projet. Dans ce contexte, la moindre opération git devient un mini-défi qu'il fallait relever quotidiennement.

                  Multigit est abouti et stable, il est utilisé au quotidien par plus d'une centaine de personnes (sous Windows), depuis plusieurs années. Mon employeur m'a aimablement autorisé à le publier en Open Source, ce dont je lui sais gré. Il est publié sous licence Apache 2.0

                  La problématique de gestion de plusieurs dépôts git conjoints pour un projet est assez peu répandue dans le monde du logiciel libre. Mais beaucoup plus dans le monde de l'entreprise. En effet, git ne gère pas la notion de droit d'accès à une partie d'un dépôt. La seule façon de restreindre l'accès à certains parties d'un projet est donc de créer un dépôt spécifique pour les y stocker, avec des droits d'accès au niveau du dépôt. Ajoutons à cela beaucoup de personnes, beaucoup de projets parfois complexes, beaucoup de sous-projets, beaucoup d'historique et on se retrouve avec une gestion des sources particulièrement complexe. Complexe … avant l'arrivée de Multigit en tout cas.

                  Installation

                  Sous Linux, la seule option d'installation disponible à l'heure actuelle est Python + pip, ou encore mieux avec pipx:

                      $ sudo apt install python-pipx
                      $ pipx install multigit_gx
                      $ multigit
                  

                  Sous Windows, un installeur graphique click-and-play vous permettra d'arriver au même résultat.

                  J'ai bien tenté de fournir un snap pour Linux mais snap est conçu pour empêcher à peu près tout ce que veut faire Multigit: accèder à tous vos fichiers et lancer des programmes de votre distribution (git, gitk, …)

                  Je ferai mieux dans la prochaine version. D'ailleurs, si vous avez des recommandations pour un packaging moderne, simple, facile à maintenir et couvrant toutes les distributions Linux, je suis preneur.

                  Contribution

                  Le projet est géré sous GitHub, les contributions ou les retours sont les bienvenus.

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Sortie de GCompris 25.0

                  Pour ses 25 ans (la première version 0.1 étant sortie le 12 juin 2000), nous avons le plaisir de vous annoncer la publication de la nouvelle version majeure de la suite éducative GCompris.
                  Cette nouvelle version, sortie le 30 janvier 2025, contient entre autres cinq nouvelles activités, listées dans la suite de la dépêche, ce qui porte le nombre d’activités à 195.

                  Nouvelles activités

                  « Croquis » est une activité pour dessiner librement avec de multiples outils pour permettre aux enfants d’explorer leur créativité.
                  activité Croquis
                  « Utilise les compléments à 10 » est la continuation des activités de complément à 10 existantes. Celle-ci aide les enfants à échanger les nombres pour calculer facilement une somme.
                  activité Utilise les compléments à 10
                  « Addition verticale » est une activité pour écrire une addition et la résoudre.
                  activité Addition verticale
                  « Soustraction verticale » est similaire à l’activité d’addition mais pour la soustraction avec la méthode de l’emprunt par regroupement.
                  activité Soustraction verticale
                  « Soustraction verticale (méthode de l’emprunt par compensation) » est similaire à celle dessus mais avec la méthode de l’emprunt par compensation.
                  activité Soustraction verticale (méthode de l’emprunt par compensation)

                  Améliorations d’ergonomie

                  Un écran de chargement a été rajouté sur les versions bureau. Nous avons eu des remontées de problèmes car sur certains ordinateurs, GCompris mettait du temps à se lancer et aucun indicateur visuel n’était affiché (GCompris attendait d’avoir chargé toutes ses données avant d’afficher le menu principal).

                  Lors d’un changement de langue dans le panneau de configuration, celle-ci sera maintenant appliquée directement à la sortie de la configuration, il n’y a plus besoin de redémarrer GCompris pour qu’elle prenne effet.

                  Côté technique

                  Cette version est la première version majeure développée avec Qt 6. Elle nécessite un compilateur gérant C++17. Cela implique des changements au niveau des versions des plateformes prises en charge :

                  • Il n’y a plus de version 32 bits pour Linux et Windows. Qt ne fournit plus de version pré-compilées et nous n’avons pas le besoin de créer une version 32 bits pour le moment.
                  • Android seulement à partir de la version 8.
                  • Plus de macOS non plus : les développeurs principaux n’ont pas accès à un ordinateur récent sous macOS permettant de compiler, packager et surtout tester et maintenir la version générée. Un développeur KDE a proposé son aide, nous allons voir où cela nous mène.
                  • Plus de Windows 7 et 8.

                  Sous Windows, le moteur de rendu par défaut a été modifié à Direct3d11.
                  Une nouvelle option en ligne de commande permet de choisir le moteur de rendu: « --renderer=opengl/software/direct3d11/direct3d12/metal » selon le système d’exploitation utilisé et son support.

                  Traductions

                  Toutes les activités ont eu leurs descriptions mises à jour. Cette grosse mise à jour de fond a été effectuée par Anne-Françoise, Emmanuel et Rachel, tous les trois professeurs des écoles de la circonscription de Saumur.

                  Au niveau localisation, deux nouvelles langues font leur apparition (sanskrit, géorgien) portant le total de langues (traduit à au moins 80 %) à 44 !

                  Nous remercions toutes les personnes qui nous ont aidé à faire cette nouvelle version !

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Guide CNLL/inno³ sur le Cyber Resilience Act : êtes-vous prêts pour les échéances de 2026 et 2027 ?

                  Le CNLL, Union des Entreprises du Logiciel Libre et du Numérique Ouvert, est l’instance représentative de la filière du logiciel libre en France, et inno³ un cabinet de conseil spécialiste des modèles ouverts. Ils proposent le premier guide de conformité au CRA dédié aux acteurs de l’open source, destiné à accompagner sans attendre les acteurs dans la mise en conformité de leurs activités en décryptant les obligations nouvelles et adaptations nécessaires de processus. Il est publié sous licence Creative Commons By-SA 4.0.

                  Guide CNLL / inno³ sur le CRA

                  Pourquoi est-il nécessaire d'anticiper ?

                  Adopté formellement par l'UE en 2024, le CRA vise à renforcer la cybersécurité des produits logiciels (et matériels qui comportent des éléments numériques) pour répondre à la vulnérabilité accrue aux cyberattaques des entreprises et services publics européens. Les acteurs ont jusqu’au 10 septembre 2026 pour se mettre en conformité avec certaines obligations critiques (notification des vulnérabilités activement exploitées et des incidents graves) et jusqu’au 10 décembre 2027 pour s’adapter à l’ensemble des autres exigences du texte telles que la sécurité par principe ou la transparence vis-à-vis des consommateurs.

                  Un guide pratique pour vous accompagner

                  Le guide répond à un objectif de sensibilisation des membres du CNLL et plus largement des acteurs de la filière du logiciel libre (producteurs, intégrateurs et utilisateurs) aux enjeux et défis du CRA. À l’aide de mises en situation à partir d’exemples d’entreprises membres du CNLL, le guide propose une vision détaillée des modalités d’application et obligations nouvelles : documentation technique détaillée, gestion rigoureuse des vulnérabilités, déclaration de conformité et apposition du marquage CE, production d’une Software Bill of Materials (SBOM), etc.

                  Transformons ensemble cette contrainte réglementaire en opportunité d'amélioration de la sécurité, la qualité et la confiance pour nos produits et services !

                  👉 Explorez le guide dès aujourd'hui et contribuez à sa prochaine version en partageant vos commentaires ou en rejoignant le groupe de travail.

                  👉 Participez à la réunion de présentation en ligne qui aura lieu prochainement (informations à venir sur le site : cnll.fr).

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  La virtualisation pour les nuls et autres enjeux autour des datacenters

                  Depuis quelques années la virtualisation sous toutes ses formes est devenue l'alpha et l'oméga de l'informatique, elle a révolutionné en quelques années la manière d'administrer les serveurs et de gérer les données. Cette dépêche est un essai de vulgarisation sur la virtualisation pour en exposer ses grands principes techniques, ses avantages et inconvénients et ses enjeux sous-jacents.

                  Sommaire

                  Commençons par quelques définitions

                  C'est quoi la virtualisation ?

                  Pour pouvoir illustrer concrètement ce qu'est la virtualisation, à une époque pas si lointaine que ça, dans le monde professionnel on retrouvait des serveurs physiques dédiés, par exemple un serveur pour gérer les mails, un autre pour le serveur web et un dernier comme serveur de fichiers. Chacun des serveurs pouvant tourner sur des systèmes d'exploitation (OS) différents. Dans notre exemple il en résulte qu'il faut maintenir et administrer trois machines différentes qui vont prendre de la place et consommer de l'électricité, sans une utilisation optimale de chacune des machines, si le serveur web par exemple a besoin momentanément d'un accroissement de puissance et de mémoire, il ne pourra pas bénéficier des ressources des autres serveurs physiques.
                  Avec la virtualisation, sur une seule machine physique on va faire tourner plusieurs environnements de serveurs distincts en même temps, sans avoir à redémarrer, ils vont se partager les ressources matérielles de la machine physique de manière plus optimale et efficace en réduisant les coûts d'administration. On retrouvera donc sur une seule machine physique, nos serveurs de courriel, web et de fichiers, chacun dans un environnement distinct fonctionnant de manière autonome et isolée.

                  C'est quoi une machine virtuelle ?

                  On appellera chaque environnement distinct machine virtuelle, elle s'exécute sur une machine physique avec son propre système d'exploitation, ses applications et avec les ressources de la machine physique qu'on veut bien lui allouer (mémoire, puissance de traitement, stockage). On dit aussi que la machine physique est appelée machine hôte et les machines virtuelles sont des machines invitées. Une machine hôte peut faire tourner plusieurs machines invitées.
                  Une machine virtuelle fonctionne comme n'importe quel poste informatique avec son OS qu'on peut mettre à jour, ses applications, ses paramètres système et on pourra à partir de la machine hôte accéder à toutes les machines virtuelles.

                  C'est quoi un hyperviseur ?

                  Pour que les machines virtuelles puissent s'exécuter indépendamment et utiliser les ressources de la machine hôte simultanément sans qu'elles interfèrent entre elles, il est nécessaire de rajouter une couche logicielle qui va gérer tout ça, c'est ce qu'on appelle un hyperviseur.
                  Il existe deux types d'hyperviseur:

                  • L'hyperviseur de type 1, ou bien encore hyperviseur de matériel nu (bare metal en anglais) est en interface direct avec l'ordinateur physique, cela sous entend que votre machine soit compatible (Intel VT pour les processeurs Intel et AMD-V pour les processeurs AMD). Dans le monde libre, proxmox est certainement l'hyperviseur de type 1 le plus connu.
                  • L'hyperviseur de type 2 ou bien encore hyperviseur de matériel invité (host metal en anglais) fonctionne dans un système d'exploitation déjà préinstallé, c'est le cas par exemple de VirtualBox qui permet de faire tourner une instance de windows dans un environnement Linux.

                  Un hyperviseur de type 1 est une couche logicielle très légère et offre de meilleures performances et est la solution privilégiée pour des serveurs en production, l'hyperviseur de type 2 est plutôt une solution destinée aux utilisateurs qui souhaitent tester d'autres systèmes d'exploitation ou faire tourner un logiciel sur un OS particulier sur un poste de travail classique. Mais rien ne vous empêche de faire tourner plusieurs machines virtuelles sur un hyperviseur de type 2 qui pourront communiquer entre elles et fonctionner comme un hyperviseur de type 1, à la différence qu'elles seront moins performantes.
                  Par abus de langage, le terme d'hyperviseur fait référence plutôt à l'hyperviseur de type 1.

                  C'est quoi les avantages de la virtualisation ?

                  Une administration centralisée et facilitée

                  L'hyperviseur fournit des outils de gestion des machines virtuelles qui simplifient sensiblement le travail d'administration, comme les outils de déploiement à partir de modèles de machines virtuelles, les outils de gestion de charge, de sauvegarde et de restauration de machines virtuelles.

                  La disponibilité et la robustesse aux pannes

                  Un autre avantage de la virtualisation est la fonctionnalité de migration à chaud, elle permet de déplacer une machine virtuelle d'une machine physique à une autre sans qu'il soit nécessaire de l'arrêter. Si un serveur physique présente des défaillances, les machines virtuelles sont automatiquement déplacées sur un autre hôte physique.
                  Alors bien sûr si le serveur physique tombe en rade sans crier gare, la migration à chaud peut ne pas être opérante, dans ce cas on peut très bien envisager la mise en place d'une machine physique redondante sur laquelle les machines virtuelles sont répliquées et qui prendra le relais automatiquement si le serveur primaire tombe.

                  L'amélioration des performances

                  La migration à chaud évoquée plus haut a un autre avantage si une machine virtuelle est sursollicitée et nécessite de la puissance de traitement et de la mémoire, elle pourra être déplacée automatiquement sur un autre serveur moins sollicité à ce moment-là.

                  La sécurité

                  La virtualisation isole les services chacun dans leur machine virtuelle, en cas de corruption d'une machine virtuelle par cyberattaque, l'impact est nul pour les autres services et la restauration d'une machine virtuelle est autrement plus rapide et plus simple qu'avec une machine physique.

                  La disparition des machines physiques

                  Le stade ultime de la virtualisation est de déléguer à un prestataire la gestion des machines physiques qui se retrouve quelque part dans un datacentre. On s'abstrait totalement du matériel physique et des contraintes qui vont avec et on gère seulement nos machines virtuelles à distance, c'est totalement transparent pour les utilisateurs qui accèdent à leurs services via internet ou sur un réseau privé. On parle aussi d'infrastructure virtuelle.

                  Il existe d'autres types de virtualisation ?

                  On a surtout évoqué jusqu'à présent la virtualisation des serveurs, mais il existe également d'autres types de virtualisation comme:

                  La virtualisation du stockage

                  Cela consiste en la création d'un espace virtuel de stockage à partir d'installations physiques de stockage bien réelles comme les serveurs de fichiers, NAS ou SAN qu'ils soient locaux ou distants. Cela permet de mettre en commun toutes ces installations et de la gérer à partir d'un outil unique de gestion pour effectuer toutes les opérations de sauvegarde, réplication, d'archivage et de restauration.

                  La virtualisation des réseaux

                  Un réseau est composé d'un tas d'éléments actifs comme les commutateurs, les routeurs et autres pare-feux, de type et de marques différentes. Là aussi on va créer un réseau virtuel qui combine l'ensemble de ces éléments actifs physiques pour pouvoir centraliser leur gestion sans avoir à y accéder physiquement. La virtualisation des réseaux permettra également d'améliorer les performances du réseau avec des analyseurs de trafic qui pourront équilibrer la charge ou favoriser certains flux.

                  La virtualisation des données

                  Les données sont issues de diverses sources, ont chacune leur format et sont stockées sur différents supports locaux ou distants. La virtualisation des données est une couche logicielle qui va gérer l'ensemble de ces données de manière centralisée et les mettre à disposition des utilisateurs et des applications dans le format désiré.

                  La virtualisation d'application

                  La virtualisation d'application permet de séparer l'application de son système d'exploitation hôte et de fonctionner sur un poste utilisateur sans qu'elle soit installée. Dans la pratique l'application est installée sur un serveur centralisé et peut tourner sur un poste utilisateur du réseau comme si elle était installée localement, quand bien même l'OS du poste utilisateur n'est pas celui pour lequel l'application a été conçue.

                  La virtualisation des postes de travail

                  La virtualisation permet de virtualiser des serveurs mais pas seulement, on peut virtualiser également des postes de travail pour en faciliter la gestion qui seront accessibles aux utilisateurs du réseau via un client léger bien moins cher qu'un PC client classique.

                  Autres concepts autour de la virtualisation

                  C'est quoi une infrastructure convergée et hyperconvergée ?

                  Une infrastructure convergée regroupe plusieurs composants informatiques traditionnels et bien physiques comme les serveurs de calcul, les dispositifs de stockage ou les éléments actifs réseau pour en assurer la gestion dans un tout cohérent. Cela simplifie la gestion de l'administration et ça optimise les ressources matérielles et logicielles. On dit que c'est une approche modulaire basée sur le matériel physique.
                  L'hyperconvergence a une approche plutôt logicielle, elle intègre une couche logicielle qui va combiner les ressources de calcul, de stockage et de réseau dans ce qu'on appelle un nœud. Les nœuds sont interconnectés et combinés entre eux pour former des pools au sein d'un cluster, on retrouve ainsi un pool de stockage ou un pool de calcul, si un nœud venait à défaillir ça n'aurait pas de conséquence pour les autres nœuds et le fonctionnement du pool et du cluster.

                  OK, mais une fois que tout ça est posé, quelle est la différence entre les deux ?
                  L'infrastructure convergée a une approche basée sur le matériel physique, c'est à dire qu'un serveur physique peut être séparé du reste du dispositif et toujours fonctionner comme un serveur indépendant alors que ce n'est pas possible avec l'infrastructure hyperconvergée où les noeuds sont nécessairement interconnectés entre eux pour que le cluster puisse fonctionner correctement. Par ailleurs l'infrastructure convergée intègre de base d'autres fonctionnalités comme la sauvegarde, la réplication, la déduplication des données, la compression, l'optimisation du réseau, etc.

                  C'est quoi un cluster haute disponibilité ?

                  On a bien vu que finalement qu'elle soit dans vos locaux ou chez un prestataire de service, la machine physique reste le maillon faible du dispositif. Pour améliorer encore plus la disponibilité et la robustesse, on va dupliquer les machines physiques et si possible en les dispatchant dans des locaux et sites différents. Le tout étant géré comme un seul système. La virtualisation du stockage prend alors toute son importance, pour éviter de se rendre dépendant d'un serveur physique de données.

                  C'est quoi le cloud computing ?

                  On appelle cloud computing le fait de confier à un tiers sur internet la gestion de services informatiques (applications, stockage, outils de gestion, …) mais aussi le fait d'utiliser des services fournis par un prestataire via internet. Le cloud computing repose largement sur la virtualisation, on peut dire que le cloud computing est un environnement alors que la virtualisation est une technologique. En matière de cloud computing, il en existe de différentes sortes :

                  • Infrastructure as a service (IaaS) ou infrastructure en tant que service : L'IaaS offre une infrastructure informatique complète (serveurs, stockage, réseau, …) sur un réseau privé (ressources en accès limité), public (ressources en accès libre) ou hybride (qui mélange les deux).
                  • Platform as a service (PaaS) ou plate-forme en tant que service : Le PaaS c'est grosso modo la même chose que l'IaaS sauf qu'en plus on bénéficie d'outils supplémentaires pour pouvoir développer des applications qu'on retrouvera sur le cloud et tous un tas de services supplémentaires, gestion de base de données, aide à la décision, etc.
                  • Le Software as a service (SaaS) ou logiciel en tant que service : Le SaaS est une offre logicielle complète qu'on retrouvera sur internet, c'est typiquement des offres comme Microsoft Office 365 ou Google Workspace, dans le monde opensource, on peut dire que certains prestataires recensés par les CHATONS se rapprochent d'une solution SaaS.

                  NdM: il est question ici de cloud computing sur un cloud public, une infrastructure gérée par un hébergeur tiers. Il est aussi possible de faire du cloud computing privé, interne, dans une grosse structure qui en a la capacité, ce qui revient à déléguer l'hébergement à un tiers (des collègues dans ce cas). Et on peut combiner les deux pour faire du cloud hybride. Le cloud computing implique aussi la création de ressources en libre-service, de la facturation à l'usage et de la mutualisation.

                  Les enjeux

                  Enjeu environnemental

                  L'adoption quasi généralisée de solutions autour de la virtualisation dans le monde professionnel a conduit à la disparition progressive des serveurs locaux d'entreprise au profit d'un développement effréné des datacenters de par le monde. Or un datacenter est constitué de machines bien physiques tournant 24h24 7j/7 avec tout un dispositif lui aussi bien physique pour assurer leur fonctionnement optimal, leur sécurisation et la robustesse aux pannes, il s'agit notamment de :

                  • La climatisation et le traitement d’air pour maintenir des conditions satisfaisantes de température et hygrométrie avec toute un système de circulation et de refroidissement d'air
                  • La distribution de l’électricité avec un dispositif de sécurisation en cas de coupure d'alimentation, souvent basé sur tout un ensemble d'onduleurs et appuyé par groupes électrogènes
                  • la protection physique de l'installation avec contrôle d'accès, vidéosurveillance et autres systèmes anti intrusion

                  Le tout nécessite une consommation électrique massive et une forte consommation en eau. Si l'on traduit cela en équivalent d'émission de gaz de serre (GES), d'après une étude de l'ADEME les datacenters ont déjà atteint le même niveau d'émission que le transport aérien à l'échelle mondiale.
                  Il se trouve que le destin des datacenters est maintenant également étroitement lié à celui de l'IA, même si dans ce domaine on envisage plutôt des datacenters dédiés, or les besoins générés par l'IA dopent l'expansion globale des datacenters dans le monde. La demande de puissance de calcul de l'IA est exponentielle et double tous les 3,4 mois selon OpenAI. Selon une étude Gartner citée par le Monde Informatique, rien que les besoins liés à l'IA feront exploser la demande énergétique des datacenters au point que les fournisseurs d'énergie ne pourront y répondre dès 2027 !

                  Dans ce contexte il n'est pas étonnant donc que les grands acteurs du secteur poussent au développement des centrales nucléaires qui leur permettra par la même occasion de verdir leur image. Mais ces acteurs ne sont pas à une contradiction près, on peut s'étonner du développement dans certaines régions qui de prime abord ne se prêtent pas particulièrement à leur installation contrairement aux pays nordiques. Le projet d'installation de Meta dans une région aride d'Espagne où chaque goutte d'eau compte, en est une triste illustration. Les températures régionales élevées décupleront ses besoins en électricité et en eau pour les circuits de refroidissement alors que la région souffre de sécheresse chronique. On peut déplorer que tout cela ne pourrait se faire sans le soutien des gouvernements et des élus locaux qui ne trouvent rien à redire.

                  Enjeu de résilience

                  Le marché actuel est dominé par trois acteurs qui représentent à eux trois plus de 60% du marché mondial il s'agit dans l'ordre d'AWS (Amazon), d'Azure (Microsoft) et de Google Cloud Platform, on parle d'eux comme des hyperscalers car ils fournissent des services à l'échelle mondiale à grande échelle. Cette hyperconcentration des acteurs et des solutions techniques fragilise l'économie mondiale en la rendant davantage sensible et moins résiliente aux pannes, la défaillance d'un simple outil de sécurité a ainsi entraîné en cascade une panne informatique mondiale en juillet dernier avec des conséquences graves comme l'arrêt partiel du contrôle aérien, de centres d'appels d'urgence ou de services hospitaliers. Plus modestement l'incendie subi par OVH en 2021 a impacté des milliers d'entreprise et services publics, toutes les données contenues sur les serveurs sont perdues, puisqu'OVH a commis l'erreur de stocker au même endroit les données et les sauvegardes. NdM: historique de pannes GCP, AWS ou Azure
                  Cette hyperconcentration fait planer également des risques en termes de cybersécurité, la corruption d'un élément du système et sa prise de contrôle par un hacker aura vite des conséquences majeures.

                  Enjeu de souveraineté

                  Il faut savoir que les données gérées par un datacenter sont soumises à la réglementation propre au pays où il est installé. Les autorités aux États-Unis, au nom du Patriot Act peuvent donc ainsi accéder aux données stockées sur leur territoire. Les datacenters souverains sont donc un enjeu majeur pour certains pays pour garantir que les données seront protégées par les lois nationales, sans ingérence étrangère possible.

                  En France notamment, 71% des entreprises se reposent sur des solutions américaines dont des acteurs étatiques. Une affaire illustre à elle seule cet état de fait, la solution Azure de Microsoft a été ainsi choisi pour héberger l'ensemble des données de santé de 4 établissements hospitaliers (et non de l'ensemble des Français) à des fins de recherche dans un entrepôt de données de santé dénommé EMC2. Sauf qu'en l'espèce Microsoft a répondu à un appel d'offre en bonne et due forme, que la CNIL a donné son autorisation et que les différents recours à ce stade ont tous échoué. Néanmoins voici ci-dessous texto la conclusion du rapport de la CNIL en 2023 :

                  (début de citation)

                  • qu’aucun prestataire potentiel ne propose d’offres d’hébergement répondant aux exigences techniques et fonctionnelles du GIP PDS (Note de l'auteur : groupement d’intérêt public « Plateforme de données de santé", appelé aussi Health Data Hub) pour la mise en œuvre du projet EMC2 dans un délai compatible avec les impératifs ce dernier ;
                  • que le développement d’un démonstrateur " cloud de confiance ", respectant les conditions de la circulaire précitée et permettant à terme d’héberger des projets de cette nature, et notamment la plateforme du GIP PDS, devrait se poursuivre sur les prochaines années ;
                  • que la construction d’une plateforme d’hébergement spécifique pour le projet EMC2 pourrait retarder la migration de la solution d’hébergement du GIP PDS pour l’ensemble de ses missions ;
                  • qu’en attendant cette migration, le projet EMC2 soit mené sur la solution technique actuelle du GIP PDS.

                  À la lumière de ces conclusions, la CNIL déplore qu’aucun prestataire susceptible de répondre actuellement aux besoins exprimés par le GIP PDS ne protège les données contre l’application de lois extraterritoriales de pays tiers.
                  De manière générale, elle regrette que la stratégie mise en place pour favoriser l’accès des chercheurs aux données de santé n’ait pas fourni l’occasion de stimuler une offre européenne à même de répondre à ce besoin. Le choix initial du GIP PDS, dès sa fondation, de recourir au cloud a conduit à privilégier des offres d’acteurs étasuniens dont il apparaît désormais difficile de se détacher à court terme malgré l’émergence progressive de fournisseurs souverains. Le projet EMC2 aurait pu être retenu par le GIP PDS pour préfigurer la solution souveraine vers laquelle il doit migrer.

                  (fin de citation)

                  À la lumière de cette conclusion, on peut comprendre que la CNIL s'est sentie contrainte et forcée de répondre favorablement pour ne pas faire capoter ce projet en espérant que cette solution ne soit que transitoire et qu'elle pourra basculer sur une solution souveraine dans quelques années.
                  Autre affaire d'actualité, le contrat entre EDF et AWS pour le stockage de certaines informations sensibles de maintenance du parc nucléaire français, le Canard enchaîné vient de révéler récemment que le contrat battait de l'aile car Amazon refuse d'inscrire noir sur blanc dans le contrat que les données d'EDF seront stockées en France (autre article).
                  Aussi la France cherche à développer son "cloud souverain" pour ne plus être dépendant des géants américains mais peine à avancer sur le sujet faute de barrières réglementaires et juridiques, de réticences des élus et des populations sur les territoires pouvant accueillir des datacenters et d'une certaine frilosité des banques et acteurs technologiques.

                  En guise de réponse aux enjeux

                  Réponse à l'enjeu environnemental

                  Pour ne pas courir à la catastrophe annoncée, la mise en place de technologies plus efficaces et économes en énergie est un enjeu majeur, parmi les axes d'innovation on peut citer:

                  • l'utilisation d'énergie renouvelable
                  • le refroidissement des datacenters basé sur des technologies peu gourmandes en eau,
                  • la réutilisation de l'énergie dissipée par les datacenters.

                  Réponse à l'enjeu de résilience

                  Des normes et des certifications se sont mises en place qu'elles soient internationales, européennes ou nationales. On peut citer :

                  • TIA 942 qui couvre différents domaines comme la disponibilité, la sécurité, l'efficacité énergétique, le refroidissement, la redondance et la gestion de l'espace;
                  • ANSI/BICSI-002 qui définit des standards de conception et de pose des systèmes de câblage, d'électricité, dissipation de chaleur, refroidissement, etc.
                  • ISO 27001 qui couvre la gestion de la sécurité de la donnée;
                  • ISO 22237 qui couvre l'installation et les infrastructures des datacenters;
                  • le référentiel de sécurisation des services cloud SecNumCloud élaboré par l’ANSSI;
                  • la certification d'Uptime Institute avec sa classification du niveau de sécurité des datacenters de Tier I à Tier IV.

                  En France, France Datacenter est une organisation professionnelle qui fédère les entreprises qui conçoivent, construisent et exploitent les datacenters. Elle publie également des guides à destination de ses adhérents qui font référence, on peut citer notamment "le livre blanc sur la sécurité incendie" ou "l'humain et la sécurité du datacenter".

                  D'un point de vue réglementaire, on peut citer :

                  • le règlement général sur la protection des données RGPD;
                  • La directive européenne relative à DEE l’efficacité énergétique DEE;
                  • La directive européenne relative à la sécurité des réseaux et de l’information, dite NIS 2 pour Network and Information System Security.

                  Le respect de ces normes, certification et a fortiori de la réglementation sont une garantie que les datacenters sont construits suivant les règles de l'art avec le niveau de qualité, de sécurité et de fiabilité attendu. A ce propos pour en revenir à l'incident OVH, les procédures judiciaires qui en ont découlé et qui ont conduit à la condamnation d'OVH ont mis en évidence que la société qui se targuait d'être certifié ISO 27001 n'a pas respecté la norme pour ne pas avoir prévu une copie de sauvegarde sur un site distant.

                  Réponse à l'enjeu de souveraineté

                  Le respect du RGPD et de la certification SecNumCloud sont une première réponse à la menace des lois extraterritoriales sur la confidentialité des données, en parallèle le premier ministre de l'époque a diffusé en 2021 une circulaire relative à la doctrine d'utilisation de l'informatique en nuage par l'État qui a été actualisé en 2023. Cette dernière "exige (…) en cas de recours à une offre commerciale d'informatique en nuage, l'hébergement des données d'une sensibilité particulière par des solutions disposant de la qualification SecNumCloud (…) et immunisées contre toute réglementation extracommunautaire".
                  Il faut par ailleurs créer l'environnement pour que des acteurs locaux puissent se développer et former une alternative crédible aux hyperscalers. L'émergence d'acteurs alternatifs de proximité est donc un enjeu que le marché seul ne suffit pas à faire percer, il faut une volonté politique, une stratégie et une vision à long terme, des financements, une adaptation de la réglementation à l'échelle européenne et nationale.
                  À ce sujet le précédent gouvernement avait concocté une loi de simplification de la vie économique destinée à faciliter l'installation de datacenters en France en les qualifiant de projets d'intérêt national majeur (PINM) pour qu'ils puissent bénéficier de mesures dérogatoires, de procédures accélérées tout en contournant le pouvoir des élus locaux puisque ça sera l’État qui signera les permis de construire. Avec cette loi la métropole de Rennes n'aurait sans doute pas pu refuser l'implantation d'un datacenter de Microsoft s'il avait été jugé d'intérêt national. Aujourd'hui ce projet de loi continue son bonhomme de chemin législatif malgré l'instabilité politique actuelle.
                  Cet objectif de développement d'une offre de proximité n'est pas forcément compatible des objectifs environnementaux et de développement durable que la France s'est imposée, mais il faut voir ça comme une opportunité pour innover et ne plus être à la traîne des États-Unis dans ces domaines technologiques.

                  En guise de conclusion

                  D'une simple présentation technique autour de la virtualisation, on en arrive en tirant la pelote à des considérations à fort enjeu sur la gestion et la confidentialité des données que bien des utilisateurs de cloud n'imaginent pas, ni même ne considèrent à sa juste importance. Pourtant il suffirait qu'ils en prennent conscience pour orienter leur choix vers des solutions respectueuses qui peinent encore aujourd'hui à émerger malgré les vœux pieux de l’État qui n'est pas toujours exemplaire dans le domaine.

                  Pour aller plus loin

                  Quelques pages de vulgarisation

                  Une sélection de sites sur les enjeux et le futur autour de la virtualisation et les datacenters

                  Sites divers

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Projets Libres! Saison 3 épisode 7 : mesurer le trafic web avec Matomo

                  Pour bien commencer l'année 2025, Projets Libres! vous propose de parler de mesure de trafic web avec l'outi Matomo.

                  Les invités :

                  • Matthieu Aubry, fondateur de Matomo
                  • Laurent Destailleur, fondateur de AWStats

                  Les thèmes abordés :

                  • les différentes techniques d'analyse de trafic
                  • les débuts de Matthieu dans l'analyse de trafic avec phpMyVisites puis Piwik
                  • le changement de Piwik en Matomo
                  • les enjeux autour de la marque Piwik
                  • les modèles économiques de Matomo
                  • la licence utilisée
                  • la communauté autour de l'outil
                  • etc.

                  À noter qu'une annonce importante de Laurent concernant AWStats se cache en toute fin d'épisode 📣 !

                  Bonne écoute !

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Entrevue avec Herman BRULE, développeur d'Ultracopier et de CatchChallenger

                  Herman BRULE est l’auteur et le mainteneur de deux applications (libres sous licence GPL v3, mais aussi proposées dans des versions payantes « Ultimate ») : l’utilitaire Ultracopier et le jeu CatchChallenger.

                  Sommaire

                  Bonjour Herman, peux-tu te présenter ?

                  Bonjour !

                  Sur le plan professionnel, je suis DG de Confiared (hébergement Web et VPS) et de Confiabits (fabrication et assemblage de circuits imprimés), et directeur de la technologie chez CTO chez DanSolutions (FAI).
                  Par ailleurs, j’aide des associations locales (j’habite en Bolivie) dans des domaines techniques comme les télécoms ou le développement logiciel, j’interviens parfois comme conférencier sur ces sujets.
                  Enfin, je participe au conseil d’administration de la section bolivienne de l’Internet Society (ISOC Bolivie).

                  Peux-tu nous raconter ton parcours ?

                  J’ai étudié l’électronique (BTS STI), puis le développement web. J’étais d’ailleurs encore étudiant quand j’ai commencé à développer Ultracopier.
                  J’ai longtemps travaillé dans l’e-commerce, puis pour des raisons personnelles je suis allé vivre en Bolivie.
                  J’ai été plutôt déçu par la qualité des offres locales, ici en Bolivie, dans le secteur des technologies de l’information, c’est pourquoi j’ai décidé de proposer mes services.

                  Peux-tu nous parler de ces deux logiciels ?

                  Ultracopier

                  Logo de Ultracopier

                  Comment est né ce projet ?

                  J’avais besoin d’un utilitaire avancé pour la copie de fichiers, comme Supercopier, pour une utilisation sous Linux mais ce dernier n’était pas disponible sur cette plateforme.
                  Ultracopier est donc né non pas comme un fork de Supercopier mais comme un projet indépendant : à l’époque, Supercopier était écrit en Pascal, et je préférais écrire en C++.

                  Au final, quand toutes les fonctionnalités ont été implémentées et qu’Ultracopier a disposé d’un skin Supercopier, une redirection a été mise en place.

                  Aujourd’hui, après 20 ans, le projet est toujours actif et maintenu, malgré les problèmes de tentative de piratage, bug, DDOS, et les évolutions technologiques.

                  Quels sont les points marquants qui ont, selon toi, marqué son développement ?

                  Après la reprise de Supercopier, qui a permis de fédérer sa base d’utilisateurs autour d’Ultracopier, il y a eu de nouvelles fonctionnalités au fil du temps :

                  • la prise en charge de gros volumes (>5TB >10 millions de fichiers)
                  • les extensions (plugins) et thèmes graphiques (skins), dont le développement m’a poussé à standardiser l’interface pour la réutilisation par des applis tierces.

                  Quel est le modèle économique ?

                  C’est assez peu connu mais Ultracopier est proposé dans deux versions : une gratuite (installable depuis le gestionnaire de paquets d’Ubuntu notamment) et une version « Ultimate ». Cette version, payante, est enrichie de fonctionnalités comme

                  • la mise en pause,
                  • la limitation du taux de transfert,
                  • d’autres options de performance selon le système d’exploitation utilisé et inclut un support technique.

                  Pour être honnête, les utilisateurs de la version payante sont très peu nombreux : une écrasante majorité utilisent la version gratuite et d’autres piratent la version payante.

                  Ma vie professionnelle et mon engagement à l’ISOC Bolivie sont très chronophages, je ne compte pas mes heures sur mes principales activités d’hébergeur et de FAI, et à une usine de fabrication d’équipements réseau pour ces besoins.

                  J’ai quand même publié de l’open source comme le firmware OpenWRT pour le routeur wifi 6 que je fabrique.

                  Des dons ou des achats sont bienvenus pour que je puisse me concentrer davantage à l’open source ;) Je crois que beaucoup de développeurs open source sont dans cette problématique.
                  Heureusement, l’hébergement ne coûte presque rien car j’utilise mon propre service, et je suis le seul contributeur.

                  Quelles sont les fonctionnalités les plus attendues que tu penses implémenter ?

                  Je souhaiterais améliorer l’intégration d’Ultracopier dans les gestionnaires de fichiers sous Linux ou MacOs, mais ce n’est pas chose facile. Pendant des années j’ai essayé de faire modifier les gestionnaires de fichiers pour avoir la possibilité de replacer le copier/coller par Ultracopier. Rien. Soit je suis ignoré, soit je suis refusé (motif de refus récurent : je devrais refaire Ultracopier en « natif » : GTK, KIO, Haiku…), je me vois mal maintenir divers UI. Les votes sur demande de fonctionnalités sont les bienvenus, par exemple ici pour KDE/Plasma.

                  Je veux aussi implémenter un moteur async natif sous linux (en utilisant io_uring) pour de meilleures performances.

                  As-tu eu des échanges/retours avec les autres logiciels ou éditeurs (communauté linux / autres éditeurs) ?

                  Non. J’ai essayé de faire que le protocole d’envoi de copie/déplacement à un logiciel tiers soit un standard avec un protocole commun pour motiver les gestionnaires de fichiers à l’utiliser, je n’ai reçu que des réponses négatives :/

                  Peux-tu partager des souvenirs marquants de cette expérience ?

                  Durant toutes ces années, conscient que la copie de données est un sujet qui peut être très sensible, j’ai veillé à être réactif aux retours des utilisateurs : dès que quelque chose d’anormal m’est reporté, je m’assure de vérifier/corriger et de publier très rapidement. Je pense qu’Ultracopier garantit bien l’intégrité des données lors des copies, parfois mieux que des copies par l’outil du système. Par exemple, si pendant le déplacement de fichiers vers un lecteur réseau ce lecteur réseau se déconnecte, alors Windows peut détruire la source sans avoir pu valider l’intégrité réelle du fichier cible. Il faut reproduire un contexte très particulier, mais ça c’est vu.

                  Malgré cette attention, il m’est arrivé de recevoir des insultes de certains utilisateurs, allant jusqu’à des menaces de mort. J’ai une bonne collection de conversations de ce genre ! Il s’agit d’une minorité d’utilisateurs, en majorité des débutants en informatique et qui n’ont pas utilisé correctement l’outil, ou plus généralement leur ordinateur.

                  Par ailleurs, le spam et les tentatives de piratage (dont une pour rediriger les paiements des versions "Ultimate » !) auront eu raison des pages Wiki et Maintenance du site, faute de temps pour la modération.

                  Il me semble tout de même que la majorité silencieuse (= celle qui dit rarement merci ;) ) est dans l’ensemble très satisfaite des services rendus par Ultracopier, et cela est motivant. Pour moi, le point le plus positif est surtout l’acquis de connaissances.

                  CatchChallenger

                  Logo de CathChallenger

                  Quelle est l’origine de ce jeu ?

                  Je cherchais à me familiariser avec la programmation autour de sujets relatifs aux clients/serveurs, comme les protocoles, la haute performance, le chiffrement, et aussi les bots… …et le développement d’un jeu est le moyen ludique par excellence !

                  Vu qu’il n’y a pas de temps réel, je peux jouer avec TOR/I2P (un bon moyen de tester la sécurité), pas de flottant donc cela marche sur tous les CPU, y compris ceux de plus de trente ans et les architectures exotiques comme celles que l’on trouve dans les routeurs (MIPS…).

                  C’est un mix de plusieurs jeux au gameplay de type crafting (à la lineage/X3/minecraft) qui m’intéressait pour les techniques ce que ce genre implique.

                  Quels sont les points marquants qui ont, selon toi, marqué son évolution ?

                  Version 1 : j’ai essayé de m’éloigner visuellement d’un jeu bien connu auquel mon jeu pouvait être associé.

                  Version 2 : j’ai abandonné Qt niveau serveur car trop lent niveau SLOT/SIGNAL, et revu le thème graphique avec des couleurs plus chaudes, même si ça me rapproche d’un autre jeu connu.

                  Version 3 : modularité/API et interface responsive, refonte du datapack.

                  Est-il facile de monter son propre serveur? Ou de modifier le jeu ?

                  Le client intègre un serveur embarqué pour jouer en solo, qui peut être ouvert sur un réseau local ou sur Internet.

                  Le serveur a une interface graphique et une version console (avec diverses bases de donnée supportées, y compris du noSQL)

                  Le datapack est facilement interchangeable et tout est fait pour qu’un enfant puisse le modifier (png, xml, tmx, opus)

                  Y a-t-il d’autres contributeurs ?

                  Non

                  y a-t-il des fonctionnalités importantes qui ne seront pas développées, et pourquoi ?

                  Il y en a beaucoup, par manque de temps. Je n’ai jamais atteint un stade de maturité sur le jeu de base qui me convient, donc je me concentre là-dessus. Par exemple, je me suis lancé sur le multithreading GPU côté serveur : j’ai pu lancer des tests sur GPU, cela fonctionne bien mais complexifie trop le développement sans apporter un réel bénéfice.

                  Quel est le rapport avec tes autres projets ?

                  Avec ce projet, j’ai vite eu besoin d’un grand nombre de VPS, cela m’a incité à m’intéresser aux datacentres et à monter modestement mon premier datacentre. De fil en aiguille, j’en ai fait mon activité :)

                  J’ai aussi eu besoin de connexions, de haute performance et de haute disponibilité. Curieux, je me suis lancé dans la conception de mon hardware : onduleur, alimentation solaire…

                  Qu’as-tu retiré de ce projet ?

                  J’ai été surpris par les performances, pour un code qui n’est pas en assembleur et qui pourrait encore être optimisé : des millions de joueurs sur un CPU de bureau par serveur. Vous saturez l’écran de bots bien avant de saturer le CPU, même un très vieux CPU ou un microcontrôleur de routeur, et la charge en RAM ne dépasse pas quelques Mo.

                  La prédiction côté client (Client-side prediction), les instructions préparées (SQL parameterized statement) sont très efficaces, je charge tout en RAM sous forme d’entier <=32Bits. Vu qu’il faut des performances bien supérieures du client pour surcharger un serveur, il y a peu de chance qu’on m’attaque via DDOS.

                  Quels conseils avec le recul donnerais-tu à ceux qui entreprendraient de se lancer ?

                  Ne faites pas de projets que vous n’allez pas maintenir, aussi bien pour vous que pour ceux qui vont les utiliser.

                  Aussi, ne vous lancez pas sur un projet que mille autres personnes ont déjà fait avant vous, il y a une tonne de projets de niche qui n’ont pas de solution open source !

                  Ton rapport au libre

                  Au niveau personnel, quels logiciels libres utilisez-vous, sur quel OS ?

                  J’utilise Gentoo Linux et presque que du libre.

                  Même question au niveau professionnel ?

                  En général j’essaie de faire le modèle pro suivant : quand un logiciel a été rentabilisé, je le libère.

                  Niveau data center, on fonctionne en IPv6 avec des logiciels de conversion pour, par exemple, passer de HTTP IPv4 à IPv6, si tu ajoutes tous les services internes + gestionnaires, ça fait mal pas de logiciels.

                  Niveau industrie, je produis des onduleurs, des serveurs, des routeurs datacentres et domestiques (wifi 6 OpenWRT), avec les difficultés ici pour importer je dois faire avec ce que je trouve sur place (et il n’y a quasiment rien pour la microélectronique).

                  Niveau FAI, rien à voir avec ce qu’il y a en France, entre les blocages politiques et administratifs (j’attends certaines autorisations depuis de nombreuses années), les monopoles… rien n’avance. Mais malgré ces difficultés j’ai pu innover et proposer des solutions efficaces pour des communautés locales, grâce à des logiciels libres.

                  Merci pour ce partage, et pour ton apport au libre ! Nous te souhaitons beaucoup de succès dans tes nombreux projets pour 2025 !

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  L’exploration et le calcul de l’espace : l’horlogère, l’astronome et l’astrophysicienne

                  En octobre 2024, on était allé à la conquête de l’espace, cette fois-ci, on va se concentrer sur l’exploration de l’espace vu de la Terre. Pour cela, on se penchera sur la vie et les travaux de trois femmes : Nicole-Reine Lepaute qui, au siècle des Lumières, a calculé la date du retour de la comète de Halley, Janine Connes qui prendra la direction du premier centre de calcul en France et Françoise Combes qui vient d’être élue présidente de l’Académie des sciences. C’est aussi l’occasion de voir l’évolution des outils utilisés en astronomie.

                  Phases de l’éclipse du soleil du 1er avril 1764
                  Illustration des douze phases principales selon les calculs de Nicole-Reine Lepaute

                  Sommaire

                  Préambule

                  Les deux dépêches consacrées à la conquête de l’espace dans le cadre de la journée Ada Lovelace étaient très américano-centrées, et il manquait l’aspect étude et découverte de l’espace qui en précède la conquête. Sans cette connaissance, il n’aurait pas été possible d’envoyer des satellites artificiels, d’aller sur la Lune, sur Mars ou encore de créer des stations spatiales, voire, de concevoir les télescopes Hubble et James Webb. D’où cette dépêche, et le choix de ces trois femmes pour contrebalancer un peu leur américano-centrisme.

                  Le choix a été guidé d’une part en tenant compte des informations dont je pouvais disposer, d’autre part de l’actualité : Janine Connes vient de mourir à l’âge de 98 ans et c’est une façon de lui rendre hommage, Françoise Combes vient d’être élue par ses pairs à la présidence de l’Académie des sciences.

                  Nicole-Reine Lepaute, l’horlogère

                  La vie de Nicole-Reine Lepaute nous est essentiellement connue grâce à l’Encyclopédie des dames de Jérôme Lalande. De fait les biographies que l’on peut trouver sur elle citent les mêmes passages en élucubrant souvent sur les relations qu’elle aurait pu avoir avec l’astronome. Mais comme LinuxFr.org n’est ni un site « people » ni un site de rencontre et que l’autrice de l’article n’aime généralement pas faire comme tout le monde, on vous renverra en fin de dépêche sur ces biographies.

                  Nicole-Reine Lepaute en quelques dates (et hauts faits)

                  Nicole-Reine Étable naît le 5 janvier 1723 à Paris. Elle n’est pas elle-même horlogère, mais elle épouse l’horloger Jean André Lepaute en 1749. Il deviendra le fournisseur officiel de la cour de Louis XV en 1750. Jean André Lepaute était réputé comme l’un des meilleurs horlogers de son temps. Quand il écrira son Traité d'horlogerie, contenant tout ce qui est nécessaire pour bien connoître et pour régler les pendules et les montres, c’est Nicole-Reine qui calculera la « longueur que doit avoir un Pendule simple pour faire en une heure un nombre de vibrations quelconque, depuis 1 jusqu’à 18000 » (table VI, pages 365 et suivantes du traité). Et on le sait parce qu’elle en est créditée.

                  Le couple fait la connaissance de l’astronome Jérôme Lalande en 1754. Elle commencera peu après à travailler avec lui. En 1757, elle calculera les dates du retour de la comète de Halley avec Lalande et Clairaut. Quand, en 1759, Lalande est chargé des éphémérides annuelles de l’Académie royale des sciences : La Connaissance des temps1, elle fera partie de l’équipe qui travaille sur les tables et éphémérides astronomiques.

                  En 1761, elle entre à l’Académie royale des sciences et belles lettres de Béziers. C’est, probablement, la première fois qu’une femme entre dans une académie pour ses travaux scientifiques. Elle offre aux académiciens les tables astronomiques pour Béziers qu’elle avait compilées à leur intention. Malheureusement ses travaux sont perdus.

                  En 1764, une éclipse est prévue, pour éviter une éventuelle panique, le clergé est invité à informer le peuple du caractère inoffensif de ce phénomène céleste. Nicole-Reine Lepaute calculera les phases de l’éclipse et en dressera une carte. Elle fera publier deux documents :

                  Elle meurt, aveugle, le 6 décembre 1783, elle aura passé les trois dernières années de sa vie à s’occuper de son mari loin des mathématiques. Son acte de décès figure sur le site archive.org.

                  Elle ne reste pas complètement oubliée. Ainsi, quand une nouvelle édition de la Bibliographie ancienne et moderne ou (en nettement plus long) Histoire, par ordre alphabétique, de la vie publique et privée de tous les hommes qui se sont distingués, par leurs écrits, leurs actions, leurs talens, leurs vertus ou leurs crimes paraît en 1820, elle a sa notice relevée ici par le Journal des dames et de la mode. Signée d’un certain M. Weiss, elle porte cette mention :

                  Mme Lepaute, douée de tous les avantages extérieurs, portoit dans la société cette politesse et cette fleur d’esprit, que semblent exclure les études profondes…

                  Le numéro du 15 février 1898 du bi-mensuel La Femme (page 28) dresse un portrait de Nicole-Reine Lepaute en ajoutant :

                  Telle fut la vie pure et simple de celle que Clairaut appelait « la savante calculatrice ». Plus grande lorsqu’elle partageait l’internement de son mari dans une maison de santé que lorsqu’elle compulsait les tables astronomiques.

                  Et en concluant plus généralement :

                  « L’examen attentif des faits, des biographies. l’étude de la vérité historique devraient rassurer les esprits chagrins. La famille n’est pas en péril parce que les filles s’adonnent aux mêmes études que les garçons et osent aspirer à des carrières libérales et scientifiques. » Le revenu qu’une jeune fille peut se procurer courageusement, dignement par son travail, à l’aide des diplômes qu’elle a remportés dans les concours par son énergie, sont un appoint pour couvrir les dépenses d’un ménage futur et assurer l’éducation libérale des enfants à venir, qui facilite l’établissement des jeunes époux. Un diplôme, c’est une dot dont la fiancée qui l’apporte dans une corbeille de mariage peut être justement fière, et, loin d’être un obstacle à fonder une famille, c’est une valeur qui favorise le mariage.

                  Les outils des astronomes au XVIIIe siècle

                  Il n’est pas possible de savoir ce que Nicole-Reine Lepaute utilisait pour ses calculs. Il est en revanche envisageable de dresser une liste des outils dont les astronomes disposaient pour explorer l’espace et calculer les mouvements des astres.

                  Pour observer et cataloguer les astres, les astronomes du 18e siècle disposaient des lunettes d’astronomie. La paternité de leur invention est souvent attribuée à Galilée qui a construit sa première lunette en 1609. On trouve une première description de ce type d’instrument déjà en 1538 dans l’Homocentrica (texte-image en latin) de Jérôme Fracastor2. En 1608, l’opticien hollandais Hans Lippershey dépose un brevet pour des lunettes astronomiques qui lui sera refusé, car :

                  il était notoire que déjà différentes personnes avaient eu connaissance de l’invention. L’optique par Fulgence Marion (texte-image) (source Gallica BnF).

                  On doit l’invention du télescope à Isaac Newton en 1668. Son idée était d’ajouter un miroir : il fallait pour augmenter la puissance des lunettes astronomiques (et autres longues-vues et jumelles d’ailleurs) augmenter l’épaisseur de la lentille en perdant en précision. L’ajout d’un miroir concave donne une meilleure qualité d’image et permet d’augmenter la taille des télescopes. Est-ce que Lalande ou Nicole-Reine Lepaute pouvaient disposer d’un télescope ? Dans l’Encyclopédie des dames, Lalande mentionne un « un télescope de trente deux pouces qui coûte environ dix Louis » qui suffit pour « voir ce qu’il y a de plus singulier dans le ciel ».

                  Concernant les outils de calcul : il ne fait aucun doute qu’elle a pu et dû utiliser les différentes tables existantes. À son époque, on utilisait divers abaques pour compter, par exemple un système de jetons, utilisé notamment dans le commerce. Il est possible qu’elle ait eu connaissance, en femme cultivée, de la Pascaline, voire, de la machine à calculer de Leibniz. Mais il est peu probable qu’elle les ait utilisées, notamment parce que ces machines ont été peu diffusées. Elle a pu, en revanche, utiliser les bâtons de Napier (francisé en Neper). Et elle utilisait certainement la bonne vieille méthode du papier et du crayon ou plutôt de la plume, ou « calcul indien » qui est celle que l’on apprend à l’école actuellement. Cette méthode est arrivée en Europe au XIIe siècle et a été adoptée par le monde scientifique assez rapidement mais pas dans les classes les moins instruites de la population.

                  Nicole-Reine Lepaute aurait pu aussi utiliser une règle à calcul, les premières ont été inventées au XVIIe siècle, mais elles n’ont vraiment commencé à s’implanter en France qu’au XIXe siècle.

                  Janine Connes, l’astronome

                  Aussi paradoxal que cela puisse être, il y a encore moins d’éléments biographiques concernant Janine Connes que pour Nicole-Reine Lepaute. Son obituaire ne comporte aucun élément informatif autre que le strict minimum (nom et date). En revanche, on a la liste de ses publications et on peut même accéder à certaines.

                  De la spectroscopie infrarouge à transformée de Fourier au centre de calcul d’Orsay

                  Janine Connes naît en 1926. Elle épouse l’astronome Pierre Connes avec qui elle mènera diverses recherches. Elle meurt le 28 novembre 2024 à Orsay, presque centenaire (98 ans).

                  En 1954, son professeur, le physicien Pierre Jacquinot lui suggère un sujet de thèse :

                  Il s’agissait de faire des Transformées de Fourier (TF) de 1 million de points.
                  Pierre Jacquinot faisait partie de mon jury cette année-là, et à l’issue du concours il m’avait proposé de faire une thèse dans son Laboratoire Aimé Cotton (LAC) alors spécialisé en spectroscopie atomique et développements instrumentaux. Le sujet proposé était la spectroscopie par transformation de Fourier qui théoriquement devait battre en résolution et en étendue spectrale tous les records des réseaux et des interféromètres de Fabry-Perot. (Janine Connes, in De l’IBM 360/75 au superordinateur Jean Zay, chapitre 1).

                  La spectroscopie infrarouge à transformée de Fourier (IRTF ou FTIR en anglais) sur laquelle Janine Connes a basé sa thèse est une méthode d’analyse basée sur les ondes infrarouges :

                  Ces ondes vont de 12 800 cm-1 à 10 cm-1 et sont divisées en trois groupes: le proche infrarouge, le moyen infrarouge et l’infrarouge lointain. La FTIR utilise quant à elle le moyen infrarouge qui s’étend de 4 000 cm-1 à 400 cm-1 (2,5 µm à 25 µm).
                  Quand une onde infrarouge est envoyée sur une molécule, cette dernière absorbe une partie de l’onde qui correspond aux liaisons présentes dans la molécule. L’absorption du rayonnement infrarouge ne peut avoir lieu que si la longueur d’onde correspond à l’énergie associée à un mode particulier de vibrations de la molécule. (Spectroscopie infrarouge à transformée de Fourier (FTIR), A. Bonneau, Association des Archéologues du Québec).

                  Comme on peut le voir, c’est une technique utilisée dans des domaines très différents, incluant donc l’astronomie. Sa thèse en établira les principes en astronomie. Actuellement la :

                  méthode de Fourier conserve toutefois quelques niches spécifiques, comme dans le domaine de l’infrarouge lointain spatial ou pour la spectroscopie intégrale de grands champs. La spectroscopie de Fourier en astronomie : de ses origines à nos jours, Jean-Pierre Maillard, 21 décembre 2017 (Observatoire de Paris).

                  La page qui lui est consacrée (en) sur le site CWP (Century Women to Physics) de l’UCLA (Université de Californie à Los Angeles) indique que sa thèse, ainsi que ses publications suivantes, ont été d’une importance majeure et a posé les bases de ce qui allait devenir un nouveau et important domaine de recherche qui rend les transformées de Fourier rapides et relativement courantes :

                  Janine Connes's analysis of the technique of Fourier Transform Infrared Spectroscopy was of major significance and laid the foundations of what was to grow into a significant new field. Her thesis work and subsequent publications gave in-depth theoretical analysis of numerous practical details necessary for this experimental technique to work. All the more remarkable is that her work predates the age of digital computers, which now make fast Fourier Transforms relatively routine. Mary R. Masson

                  En 1960, elle écrit avec le physicien H. P. Gush une Étude du ciel nocturne dans le proche infra-rouge dans lequel les deux auteurs remercient notamment le Comité Européen de Calcul Scientifique pour ses attributions d’heures de calcul à l’ordinateur 704 I.B.M.

                  En 1961, elle publie une série de quatre articles, seule ou avec d’autres chercheurs : Études spectroscopiques utilisant les transformations de Fourier. Pour le professeur Ian McLean, fondateur du laboratoire infrarouge de l’UCLA, ce sont des « travaux fondamentaux d’une importance extrême pour le domaine ». Le travail de Janine et de Pierre Conne sur les transformations de Fourier aura notamment permis à Lewis Kaplan de déterminer, en 1966, la composition de l’atmosphère de Mars (en).

                  Parallèlement à cela, elle enseigne à la faculté de Sciences de Caen. En 1963, elle sera invitée avec Pierre Connes à rejoindre le Jet Propulsion Laboratory de la NASA à Pasadena. De retour en France, elle commencera par intégrer le laboratoire de Meudon au poste de directrice adjointe avant de se voir confier en 1969 la création et la direction du Centre Inter-Régional de Calcul Électronique (CIRCÉ) à Orsay.

                  En 1970, l’astronome Ruper Wildt la propose, avec son mari, Pierre Connes, et le physicien Robert Benjamin Leighton pour le prix Nobel de physique pour « leur développement de la méthode de spectroscopie infrarouge à transformée de Fourier ». Le prix sera attribué, finalement, à Louis Néel.

                  En 2022, elle écrit avec la participation de Françoise Perriquet : De l’IBM 360/75 au superordinateur Jean Zay 50 ans d’informatique au centre de calcul du CNRS d’Orsay.

                  Les ordinateurs de ses débuts et le centre Jean Zay

                  Ce sont l’IBM 704 et l’IBM 360/75 dont on va voir quelques caractéristiques techniques.

                  L’IBM 704 était la plus grande machine du monde. Il avait fallu deux avions pour la transporter des États-Unis à Orly. Son arrivée en France avait fait l’objet d’une émission de la Radio Télévision française (RTF). Le présentateur interrogeait la personne chargée de réceptionner l’ordinateur au titre de l’Institut européen de calculs scientifiques, une fondation IBM, destinée à offrir aux scientifiques européens (pas seulement français) la possibilité de procéder à des calculs, jusque-là peu envisageables.

                  Les mentions en italiques sont des citations tirées de l’émission.

                  L’IBM 704 pesait 21 tonnes. Celui reçu à Orly était composé de « 25 unités différentes constituants chacun autant de petits meubles de dimension normale ». Ne sachant pas ce qu’est un meuble aux « dimensions normales », on peut se donner une idée de la taille des éléments en se référant aux photos : environ la profondeur et la largeur de, disons, une armoire normande, mais en moins haut, quelque chose entre 1,10 m et 1,60 m selon les éléments.

                  Il fonctionnait avec des bandes magnétiques et pouvait :

                  • en physique, s’occuper du dépouillement de données de mesure,
                  • faciliter l’exploitation de l’énergie atomique à des fins pacifiques,
                  • faire des calculs en chimie,
                  • faire des calculs dans tous les domaines de l’industrie et de la science.

                  Dans l’émission de radio, le présentateur demandait à la fin un exemple de traitement que pouvait faire l’IBM :

                  Neper a passé plus de trente ans de sa vie à établir les tables de logarithmes et l’ordinateur 704 pourrait exécuter le même travail en le transcrivant sur des bandes magnétiques en dix-sept secondes à peu près.

                  Sorti en 1954, c’est le premier ordinateur commercialisé à utiliser des commandes arithmétiques en virgule flottante entièrement automatiques et ce grâce à John Backus qui avait insisté pour que ce soit configuré au niveau du matériel.

                  L’IBM 360/75 qui équipait CIRCÉ faisait partie d’une gamme d’ordinateurs interopérables et polyvalents IBM 360 dont le premier est sorti en 1966 (la numérotation des séries d’ordinateurs chez IBM est étonnante). Les IBM 360 seront commercialisés jusqu’en 1978. Ce sont les premiers à avoir utilisé le système Solid Logic Technology (SLT). L’IBM 360/30 était le plus lent de la série ; il pouvait exécuter jusqu’à 34 500 instructions par seconde avec une mémoire allant de 8 à 64 ko. Le 360/75 est l’un des derniers de la série.

                  Ces ordinateurs étaient évidemment programmés en FORTRAN. D’ailleurs, le premier compilateur FORTRAN a été écrit pour l’IBM 704.

                  Le centre Jean Zay, que l’on peut considérer comme l’un des successeurs de CIRCÉ a été inauguré en janvier 2020. C’est l’un des plus puissants centres de calcul d’Europe. Sa puissance est de 125,9 Pétaflop/s. Il a coûté 40 M€, coûte en électricité 3 à 4 M€ par an et il requiert 93 tonnes d’équipement réparti sur 320 m2 (source Ministère de l’enseignement et de la recherche). Il tourne sous Linux évidemment, comme tous les supers calculateurs de sa génération.

                  Françoise Combes, l’astrophysicienne

                  Quelle différence y a-t-il entre les métiers d’astronome et d’astrophysicien ? À cette question, wikidifference propose :

                  La différence entre astronome et astrophysicien est que « astronome » est celui ou celle qui s’occupe d’astronomie tandis que « astrophysicien » est [un ou une] scientifique qui étudie l’astrophysique, l’étude de l’espace et des propriétés des objets de l’univers.

                  Pas très convaincant, ni explicite. Les astronomes observent et cataloguent l’espace sur la base d’observations quand, en astrophysique, on se base sur les lois de la physique pour observer l’univers. En fait, à l’heure actuelle, les personnes qui, au départ, étaient astronomes sont maintenant des astrophysiciennes : la connaissance a évolué, les méthodes de recherche aussi ainsi que les outils. Mais, évidemment, les astronomes sont, ont été des scientifiques, souvent diplômés en physique.

                  De la physique galactique à l’Académie des sciences

                  Françoise Combes naît le 12 août 1952. En 1975, elle réussit l’agrégation de physique ce qui l’amènera à enseigner à l’École normale supérieure (ENS) dont elle est issue. Elle soutient sa thèse d’État à Paris VII en 1980, sujet de la thèse : les dynamiques et les structures des galaxies. En 1985, elle devient sous-directrice du laboratoire de physique à l’ENS (Ulm). Et c’est en 1989 qu’elle devient astronome à l’Observatoire de Paris. Elle est, depuis 2014, titulaire de la chaire Galaxies et cosmologie au Collège de France.

                  Pendant cette période, 1970 -1980, qui voit la naissance des premières simulations numériques des galaxies, elle a l’idée de les faire en trois dimensions au lieu des deux dimensions habituelles. Elle ainsi pu résoudre :

                  un mystère jusqu’alors inexpliqué : la formation d’un bulbe (sorte de renflement) dans les galaxies spirales. La clé de l’énigme est la barre centrale, sorte de forme allongée centrale où toutes les étoiles se rassemblent. « Cette barre soulève les étoiles dans la direction perpendiculaire au plan, explique-t-elle. De ce fait, les étoiles ne restent pas confinées dans un disque très mince mais prennent de l’altitude, ce qui forme un bulbe. » Ses simulations ont aussi montré comment la même barre précipite le gaz vers le centre, ce qui a pour effet d’alimenter le trou noir central. Médaille d’or, site CNRS.

                  Elle a été admise à l’Académie des sciences3 en 2004, une académie dont elle assure la vice-présidence pour le mandat 2023-2024 et qui l’élit à la présidence pour le mandat 2025-2026. Une élection qui devrait normalement être ratifiée par décret par le président de la République. Ce sera la deuxième femme à la tête de cette vénérable institution (elle a été créée en 1666) où elle succède à Alain Fischer et trente ans après la biochimiste Marianne Grunberg-Manago

                  Des prix prestigieux et des publications

                  Françoise Combes a engrangé les prix et les distinctions au cours de sa carrière à commencer par le prix de Physique IBM qu’elle obtient en 1986 et le prix Petit d'Ormoy de l’Académie des Sciences en 1993. En 2001, le CNRS lui décerne une médaille d’argent.

                  En 2009, elle obtient le prix Tycho Brahe de la Société européenne d’astronomie (EAS) dont c’est la deuxième édition pour ses

                  travaux fondamentaux dans le domaine de la dynamique des galaxies, sur le milieu interstellaire dans les systèmes extragalactiques, sur les lignes d’absorption moléculaire dans le milieu intergalactique et sur la matière noire dans l’Univers. » Communiqué de presse (en anglais) de l’EAS (pdf).

                  En 2017 la Société Astronomique de France (SAF) lui décerne son prix Jules-Janssen. En 2020, le CNRS lui décerne une médaille d’or. L’année suivante, elle obtient le prix international pour les femmes de sciences L’Oréal-Unesco (en).

                  Elle est autrice ou co-autrice de plusieurs livres dont les plus récents :

                  • Le Big bang, PUF 2024, collection Que sais-je ?, en version papier (10 €) et numérique (PDF et EPUB)
                  • Trous noirs et quasars, CNRS éditions 2021, collection Les grandes voix de la recherche, en papier (8 €), numérique PDF et EPUB sans DRM (5,99 €) et audio (9,99 €).

                  Par ailleurs, l’entretien qu’elle a donné au Collège de France en février 2024 est aussi téléchargeable en PDF.

                  Sources, références et remerciements

                  L’illustration de tête est la reproduction de la gravure originale des phases de l’éclipse (je l’ai redessinée avec Inkscape) et on peut la télécharger sur mon site de modèles ainsi d’ailleurs que le CV de Nicole-Reine Lepaute ou sur OpenClipart.

                  LinuxFr.org ne rend peut-être pas plus intelligent, mais la rédaction de dépêches pour le site rend indéniablement plus savant. Pour cette dépêche et compenser une grande ignorance du sujet, j’ai été amenée à lire, consulter, parcourir ou écouter un certain nombre de documents en plus de ce qui est cité dans le corps de la dépêche. À vous de voir si vous avez envie de poursuivre l’exploration.

                  Nicole-Reine Lepaute

                  Janine Connes

                  • Spectroscopie du ciel nocturne dans l’infrarouge par transformation de Fourier. J. Connes, H.P. Gush, Journal de Physique et le Radium, 1959, 20 (11), pp.915-917. 10.1051/jphysrad:019590020011091500, jpa-00236163
                  • Tous les articles de J. Connes sur HAL Science ouverte, à savoir : il y a un site academia.eu, mieux référencé, qui les propose moyennant une inscription au site, mais cela vient de HAL qui ne demande pas d’inscription (donc pas de courriel) pour le téléchargement des fichiers.
                  • Principes & applications de la spectro. de Fourier en astronomie : de ses origines à nos jours, Jean Pierre Maillard, 8 février 2019, conférence mensuelle de la Société astronomique de France (SAF)
                  • De l’IBM 360/75 au superordinateur Jean Zay 50 ans d’informatique au centre de calcul du CNRS d’Orsay, EDP Sciences, il existe en version papier (39 €), PDF et EPUB avec DRM LCP (26,99 €), on peut le feuilleter aussi sur le site Cairn Info.
                  • Réception à l’aéroport d’Orly de l’IBM 704 qui avait servi à Janine Connes pour ses calculs, podcast France Culture, rediffusion d’une émission de 1957.
                  • L’IBM 704
                  • l’IBM 360 (es), Academia Lab (2024). Système IBM/360. Encyclopédie. Révisé le 29 décembre 2024.

                  Françoise Combes

                  L’histoire de l’astronomie

                  • Les télescopes, Gilles Kremer, Sylvie Voisin, 30 mars 2018
                  • Histoire et patrimoine de l’Observatoire de Paris
                  • Une histoire de l’astronomie, Jean-Pierre Verdet, Seuil 1990, il a fait l’objet d’une publication au format EPUB avec DRM LCP (9,99 €) EAN : 9782021287929, mais on peut le trouver d’occasion assez facilement. Il est doté d’une bonne bibliographie et est plutôt passionnant.

                  Remerciements

                  Un très grand merci à vmagnin pour ses informations et ses précisions, même si je n’ai pas tout utilisé. Mais ce n’est pas perdu, un prochain portrait probablement (voire, sûrement).

                  Merci aussi à Enzo Bricolo pour m’avoir signalé l’élection de Françoise Combes à la présidence de l’Académie des sciences, sans ça je l’aurais ratée et ce serait dommage.

                  Ainsi se clôt cette série sur les femmes et la conquête de l’espace ainsi que l’année 2024. Et c’est mon cadeau de nouvelle année.


                  1. La Connaissance du temps, qui se targue d’être la plus ancienne publication d’éphémérides toujours publiée est actuellement gérée et publiée par l’IMCCE - Observatoire de Paris, la version 2025 vient de paraître et est téléchargeable en PDF. Elle est accompagnée d’un logiciel de calcul d’éphémérides développé pour Windows, Mac et Linux. 

                  2. Source : Les lunettes astronomiques, 29 mars 2018, Sylvie Voisin et Gilles Kremer, Le Blog Gallica. 

                  3. Une académie qui s’engage en faveur de libre accès et dont les comptes rendus sont publiés depuis 2020 sous licence Creative commons CC BY – SA. 

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Tuxemon Tower 0 : sortie de la première version !

                  Tuxemon Tower 0 est un petit jeu vidéo très sobre. Il est inspiré des jeux Pokémon classiques et consorts, mais il est 100% libre et ne cherche aucunement à être un clone.

                  Sommaire

                  En bref

                  Qu'est-ce que Tuxemon Tower 0 ?

                  Tuxemon Tower 0 est un jeu vidéo de combats en tour par tour. Les combattants peuvent avoir un ou des types, ont des statistiques, et une ou plusieurs capacités. En gagnant assez d'expérience, ils montent de niveau et ainsi deviennent plus forts. Un genre simple et classique, mais efficace.

                  Et dans le cas de Tuxemon Tower 0, la réalisation est très basique. Cela est vrai autant du point de vue graphique que de celui du moteur. De plus, on accorde qu'on peut parfois juger que l'expérience des joueurs est médiocre (notamment car, hormis être meilleur que nous, vous allez devoir vous fader des combats juste pour avoir un niveau suffisant et on reconnaît qu'il n'y a pas trop d'intérêt ludique à regagner le même combat contre une dresseuse ou commettre un crime contre la biodiversité en enchaînant à gogo les créatures sauvages de la même zone, mais augmenter la vitesse de défilement du texte et garder enfoncé sur le bouton A permet d'écourter le temps de mise à niveau). Mais le jeu est court, donc il est escompté que la découverte et la curiosité qui l'accompagne permettent d'avoir une expérience agréable de ce mini-jeu.

                  Télécharger Tuxemon Tower 0

                  Le téléchargement des sources (code, images, etc.), de la documentation générée et des constructions pour certaines plateformes (distributions GNU/Linux et Windows) se fait via BitTorrent à travers un lien magnet. On promeut en effet la décentralisation et le fédéralisme, mais aussi la non-disponibilité permanente. De plus, ça oblige tout le monde à partager le coût (hormis les trackers, certes) et à avoir une copie des sources, tout en étant résilient.

                  Ce serait sympa de partager pendant l'obtention et aussi après que ce soit fait. Et on prévient : on n'est que rarement à la fois connecté à Internet (on n'a volontairement pas d'accès chez nous) et en mesure de partager via BitTorrent (on ne veut pas faire ça au boulot et il faut que ce soit permis par le réseau), donc ayez de la patience (ou ne vous plaignez pas inutilement). C'est également pour ça qu'on encourage fortement que vous continuez de partager le torrent après l'avoir entièrement obtenu et de préférence sans ratio (puisqu'il n'est pas bien lourd à la vue de la normalité actuelle, et est tout à fait légal, ça ne devrait pas vous être bien problématique).

                  Quelques clients BitTorrent libres

                  Au cas où vous n'auriez pas de client BitTorrent (ou un qui soit propriétaire), en voici quelques-uns qui sont libres :

                  Images du jeu

                  Images de cartes

                  Images de cartes

                  Images de combats

                  Images de combats

                  Images de menus

                  Images de menus

                  Comment contribuer ?

                  Avant d'éventuellement contribuer, n'oubliez pas plutôt en priorité de faire des choses plus importantes. En effet selon nous, mieux vaut s'activer pour l'émancipation sociale universelle et tendre vers une société écologique que de contribuer à un jeu.

                  1. Pour nous, la meilleure manière de contribuer est de mettre à disposition des sprites pour des créatures et des dresseurs. En effet, nous sommes très mauvais pour produire ça et cela ajouterait de la diversité bienvenue (pendant que celle sur Terre s'effondre…). Si ça vous branche, faites-le en respectant le style des actuels, avec une taille adéquate (64×64 et/ou 56×56 et/ou 48×48), et de préférence en faisant l'avant et l'arrière (car avec juste l'avant on ne peut pas jouer la créature ou la personne dresseuse mais juste l'affronter), voire en vous restreignant à 4 couleurs (c'est là la contrainte ultime, mais qui serait utile pour économiser de l'espace et deviendra nécessaire si un jour un port sur GameBoy Color est fait) et alternativement c'est déjà ça si ça ne dépasse pas la barre des 8 (qui va nous servir de transition entre 16 et 4, tout en permettant de réduire l'usage mémoire avec une petite astuce ou de la compression plus poussée que nous ne ferons probablement pas).
                  2. Nous n'avons pas l'intention de gérer une communauté autour de ce jeu. C'est pourquoi nous n'avons pas mis le code source sur une forge et nous ne comptons pas le faire. Rien ne vous empêche toutefois de faire une version dérivée et de la publier, peut-être que nous irons y piocher des trucs en vous créditant si nous en avons connaissance.
                  3. Bien sûr, si vous voulez que nous intégrions peut-être un jour une contribution, veillez à la mettre sous une licence compatible quand vous n'y êtes pas de toute façon obligé par le gauche d'auteur. Utilisez donc une licence libre, avec de préférence la GNU AGPLv3+ pour le code source et la Creative Commmons BY-SA v4.0 pour le reste.
                  4. Mais où mettre ce que vous produisez ? Ça vous regarde. Mais, pour que ce soit visible, le wiki du projet Tuxemon est un bon endroit ou vous pouvez faire un commentaire ci-dessous (pointant par exemple vers votre dépôt sur OpenGameArt).
                  5. Si vous vous y connaissez en portage ou en packaging pour votre système favori, n'hésitez pas à faire un joli paquet pour le jeu et à tenter honnêtement de le faire officiellement intégrer. Toutefois, cela ne vaut pas pour Apple iOS, Google Play, Microsoft Store, Steam de Valve, Origin d'Electronic Arts, et consorts.
                  6. Évidemment une autre forme de contribution est tout simplement de faire la promotion du jeu. Parlez-en !
                  7. Enfin, il existe un moyen rudimentaire : partager le contenu du torrent, pour qu'il soit disponible le plus de temps possible. En effet, nous sommes très loin d'être en permanence avec un accès à Internet et nous n'ouvrons pas systématiquement notre client BitTorrent favori quand nous le sommes.

                  Le droit d'auteur

                  Les licences utilisées

                  Les conséquences

                  Remerciements

                  En plus long ?

                  Le comité éditorial de LinuxFr.org a jugé inappropriée la version longue qui était prévue et qui lui a été soumise. De plus, il a suggéré de feuilletonner l'annonce d'origine. Mais cela ne correspond pas à notre vision éditoriale et plus généralement notre vision anthropologique (le brouhaha communicationnel nous apparaît comme néfaste et donc à ne surtout pas alimenter), et nous n'avons de toute façon pas envie d'y passer du temps (il y a pour nous bien plus important que ce petit jeu vidéo, dont la réalisation est plus pour nous un plaisir coupable qu'autre chose, à fortiori dans une phase très nette de fascisation et d'écocide).

                  Néanmoins l'annonce d'origine, qui contient bien plus d'explications, reste disponible. Dans le torrent, il y a les sources (sources.tar.xz) et dans celle-ci il y a l'annonce prévue à la base (news/fr/version-1-0-0_annonce.md). Et si vous voulez la publier ailleurs (en mentionnant que nous en sommes à l'origine et en différenciant bien toute modification), en entier ou sous forme partielle, elle est sous licences libres (vous pouvez choisir celle qui vous convient le mieux) avec gauche d'auteur : Creative Commons BY-SA 3.0, Creative Commons BY-SA 4.0 et GNU GPL 3.0.

                  Données du jeu

                  Consultation en jeu

                  Dans le menu de lancement, proposant de démarrer une nouvelle partie ou d'en charger une existante, appuyez sur Start (ou plutôt l'un des boutons qui y correspond si vous n'utilisez pas une manette ou qu'elle n'est pas reconnue ou pas bien). Cela vous fera changer de menu. Vous aurez alors une entrée « Explorer les données ». Ce n'est pas parce que ça existe que c'est exhaustif.

                  Documentation HTML

                  Dans le torrent, avec les sources et les constructions, il y a de la documentation sous forme de fichiers HTML, que vous pouvez consulter avec un navigateur web. Vous pouvez aussi la regénérer depuis les sources. Comme pour la consultation en jeu, ce n'est pas nécessairement exhaustif, mais c'est déjà ça.

                  Images

                  Liste des créatures

                  Liste des créatures

                  Liste des dresseurs et dresseuses

                  Liste des dresseurs et dresseuses

                  Annexe : temps et motivation

                  Au début d'un projet personnel, la motivation est souvent grande. Mais tant qu'il n'y a pas quelque chose de finalisée, il est à priori courant que la motivation tende à décroitre. En tout cas, c'est notre cas.

                  C'est en partie pour cela que le jeu est très simple (système ultra-basique pour les cartes, pas de possibilité d'esclavagir, pas de statut, pas de possibilité de manipulation par le joueur/joueuse d'objets non-visuels, pseudo-aléatoire en guise de non-intelligence artificielle, etc.). L'autre grosse partie de l'explication est la volonté de faire de la basse technologie (d'où entre autres que ce soit graphiquement en niveaux de gris, malgré des sprites avec des couleurs au-delà de ce spectre) et la restante est l'ajout de complexité qui nuise à l'expérience de la mécanique du jeu en ajoutant du « bruit », mais ce n'est là pas le sujet.

                  Venir reprocher ou se plaindre de la trop grande simplicité du jeu (qu'il aurait fallu qu'il y ait ceci et cela, etc.) peut être en soi une critique pertinente. Néanmoins, ça ferait totalement fi de l'aspect humain en ce qui concerne la production. En effet, si le jeu n'était pas aussi basique, il ne serait probablement jamais sorti de par la baisse de motivation.

                  C'est pourquoi le jeu est volontairement très simple. Mais c'est une fin en soi et une base. Tout ce qui a été fait pour la version 1.0.0 de ce jeu ne sera plus à faire pour une ou des éventuelles versions améliorées et un ou des éventuels autres jeux exploitant tout ou partie de ce qui a été réalisé pour celui-là.

                  Approximation de l'évolution de la motivation

                  Dans le cadre du développement de ce jeu, on utilise git, un logiciel de gestion de version. Tous les changements y sont consignés et datés. À partir des informations qu'il a enregistrées, il est donc possible d'avoir une idée de l'évolution de la motivation.

                  Toutefois, on ne va pas vous livrer le dépôt git (et on a expliqué pourquoi). Vous n'en aurez donc ci-après qu'une vue fort approximative, dont la génération a été faite par git-bars.

                  Il fournit une vue par mois du nombre de commits. C'est donc très approximatif. En effet, un commit peut avoir une taille très variable et être pour des changements importants ou mineurs. Néanmoins, ça donne tout de même une image plutôt réaliste de l'évolution de notre motivation.

                  On peut notamment bien voir que les débuts sont des périodes fastes. Pour début 2023, on peut constater que c'est assez peu garni, ce qui s'explique par la contre-réforme des retraites. Mais ça montre aussi un biais : en mars et en avril 2023, on n'a fait que des petits trucs pas bien importants, mais ça a engendré pas mal de commits.

                  Statistiques de commits par nous pour ce nouveau jeu

                  2024-11  61   ▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-10  52   ▀▀▀▀▀▀▀▀▀▀▀
                  2024-09  45   ▀▀▀▀▀▀▀▀▀▀
                  2024-08  77   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-07  19   ▀▀▀▀
                  2024-06  34   ▀▀▀▀▀▀▀
                  2024-05  62   ▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-04  126  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-03  59   ▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-02  96   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-01  89   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-12  52   ▀▀▀▀▀▀▀▀▀▀▀
                  2023-11  78   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-10  117  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-09  224  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-08  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-07  87   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-06  56   ▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-05  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-04  92   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-03  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-02  10   ▀▀
                  2023-01  19   ▀▀▀▀
                  2022-12  34   ▀▀▀▀▀▀▀
                  2022-11  80   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-10  87   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-09  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-08  88   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-07  138  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-06  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-05  50   ▀▀▀▀▀▀▀▀▀▀▀
                  2022-04  28   ▀▀▀▀▀▀
                  2022-03  121  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-02  131  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-01  144  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-12  133  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-11  81   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-10  26   ▀▀▀▀▀
                  2021-09  35   ▀▀▀▀▀▀▀
                  2021-08  45   ▀▀▀▀▀▀▀▀▀▀
                  2021-07  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-06  5    ▀
                  2021-05  18   ▀▀▀▀
                  2021-04  55   ▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-03  79   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-02  112  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-01  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀
                  

                  Statistiques de commits par nous pour Greycess Knight RPG

                  Greycess Knight RPG est la base de ce nouveau jeu. Il part donc du même dépôt git. Puisque des changements sont valables pour les 2 jeux, on les fait dans Greycess Knight RPG, ce qui occasionne des commits de fusion dans le nouveau jeu. De plus, en soustrayant les nombres de commits par mois de Greycess Knight RPG à ceux du nouveau jeu, on peut avoir le nombre de commits qui touchent aux changements nécessaires au nouveau, ou du moins en partie puisqu'on fait parfois le changement dans le nouveau jeu avant de le mettre aussi dans l'ancien ou le (quasi-)même changement dans les 2 pour faciliter la fusion. C'est pour ça qu'on met ci-après les statistiques pour Greycess Knight RPG.

                  2024-11  17   ▀▀▀▀▀▀▀
                  2024-10  9    ▀▀▀▀
                  2024-09  4    ▀
                  2024-08  20   ▀▀▀▀▀▀▀▀
                  2024-07  1    
                  2024-06  8    ▀▀▀
                  2024-05  15   ▀▀▀▀▀▀
                  2024-04  34   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2024-03  3    ▀
                  2024-02  10   ▀▀▀▀
                  2024-01  12   ▀▀▀▀▀
                  2023-12  16   ▀▀▀▀▀▀▀
                  2023-11  15   ▀▀▀▀▀▀
                  2023-10  13   ▀▀▀▀▀
                  2023-09  29   ▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-08  26   ▀▀▀▀▀▀▀▀▀▀▀
                  2023-07  25   ▀▀▀▀▀▀▀▀▀▀▀
                  2023-06  26   ▀▀▀▀▀▀▀▀▀▀▀
                  2023-05  25   ▀▀▀▀▀▀▀▀▀▀▀
                  2023-04  35   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-03  27   ▀▀▀▀▀▀▀▀▀▀▀▀
                  2023-02  4    ▀
                  2023-01  3    ▀
                  2022-12  9    ▀▀▀▀
                  2022-11  22   ▀▀▀▀▀▀▀▀▀
                  2022-10  15   ▀▀▀▀▀▀
                  2022-09  14   ▀▀▀▀▀▀
                  2022-08  27   ▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-07  44   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-06  14   ▀▀▀▀▀▀
                  2022-05  16   ▀▀▀▀▀▀▀
                  2022-04  6    ▀▀
                  2022-03  22   ▀▀▀▀▀▀▀▀▀
                  2022-02  33   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2022-01  54   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-12  92   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-11  81   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-10  26   ▀▀▀▀▀▀▀▀▀▀▀
                  2021-09  35   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-08  45   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-07  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-06  5    ▀▀
                  2021-05  18   ▀▀▀▀▀▀▀▀
                  2021-04  55   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-03  79   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-02  112  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  2021-01  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
                  

                  Par ailleurs, comme vous pouvez le voir, ça a bougé du côté de Greycess Knight RPG. Une version 1.0.2 est en cours. Mais du point de vue de l'expérience de jeu, elle n'apporte rien ou presque. Ce sera une mise à jour technique : elle consistera essentiellement en une amélioration du code source (de diverses manières et à divers endroits) et en une réduction par 3 de la taille du binaire sans la bibliothèque SDL2 statiquement liée (ce qui l'amènera à environ 250 ko grâce à la correction d'une erreur stupide).

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Haiku a 23 ans et un quart

                  La dernière dépêche annuelle sur les nouveautés dans Haiku a dépassé la longueur maximale tolérée par Linuxfr (et été finalement découpée en plusieurs parties publiées séparément). Aussi, les nouveautés sur Haiku seront désormais publiées trimestriellement, pour faire face à l’augmentation d’activité dans le projet.

                  Sommaire

                  Ce rapport est basé sur les rapports mensuels d’activité d’août, septembre et octobre publiés sur le site de Haiku. Il couvre les changements de code survenus entre hrev57901 et hrev58291 de Haiku.

                  Certains des changements mentionnés dans ce rapport font partie des derniers développements du mois d'août, et étaient déjà présents dans la version R1 bêta 5 qui a été publiée début septembre 2024.

                  Les corrections de bugs sont appliquées sur la branche bêta 5 si elle est concernée, mais les nouveaux développements sont mis dans la branche principale et seront disponibles uniquement dans les « nighlty builds » (constructions journalières) puis dans la prochaine version, qui sera probablement étiquetée R1 bêta 6.

                  La version R1 est très attendue, mais la feuille de route comporte toujours environ 600 bugs et demandes d’amélioration. Jusqu’à ce qu’ils soient tous traités (corrigés, devenus obsolètes ou déplacés vers une version plus tardive), Haiku continue de publier des versions bêta.

                  Applications

                  Amélioration et corrections de textes de messages dans diverses applications (humdinger).

                  L’application Switcher — permettant de naviguer rapidement entre les différentes fenêtres et applications à l’aide d’un menu qui apparaît lorsque la souris se trouve sur les bords de l’écran — peut à nouveau être compilée. Cette application n’est pas terminée et non intégrée dans Haiku par défaut pour l’instant (nephele).

                  Dans les préférences de disposition clavier, des icônes avaient disparu de certains menus suite à un problème dans une modification précédente. Ces icônes sont maintenant de retour (jscipione).

                  Les réglages de polices de caractères de WebPositive peuvent faire des retours à la ligne dans le texte d’exemple utilisé pour visualiser la police choisie (correction récupérée depuis la fenêtre de réglage des polices du système, qui utilise une variante du même code). (nipos).

                  Le raccourci clavier « muet » permet d’alterner entre l’activation et la désactivation du son, au lieu de toujours passer en mode muet (korli).

                  Plusieurs applications pouvaient ouvrir leurs fenêtres en dehors de l’écran si leur dernière position enregistrée n’était pas bonne (après un changement de résolution d’écran par exemple). L’appel de la fonction MoveOnScreen() après la création d’une fenêtre permet de régler ce problème (korli, pinaraf, waddlesplash).

                  Icon-O-Matic ouvre ses dialogues de sélection de fichiers dans le dossier où se trouve l’icône en cours d’édition (nipos).

                  Il est possible de sélectionner une famille de polices directement dans FontDemo (nipos).

                  Améliorations du mode sombre

                  Modifications faites par nipos et nephele.

                  Depuis la version bêta 5 de Haiku, il est beaucoup plus simple de configurer un thème de couleurs dans Haiku (avec seulement 3 couleurs à sélectionner, les autres étant calculées automatiquement).

                  Cependant, toutes les applications et contrôles graphiques ne se comportent pas forcément très bien, en particulier si on choisit une couleur de fond de fenêtres sombre. Ce trimestre, on trouve donc des améliorations sur ColumnListView (contrôle permettant l’affichage de données en listes, en arbre et en colonnes), et dans les applications Debugger, Mail (en particulier les marqueurs de portions de message citées), WebPositive, ResEdit, FontDemo, Cortex, Sudoku et Tracker (les fenêtres de configuration des permissions de fichiers et de statut de copie de fichiers), ainsi que dans les préférences de disposition clavier (couleur des touches de clavier affichées), et de configuration des écrans et des écrans de veille. Ces applications utilisaient encore quelques couleurs codées « en dur » qui ne s’adaptaient pas automatiquement au thème choisi.

                  En outre, les formules de calcul utilisées pour générer le thème de couleurs ont été améliorées pour donner de meilleurs résultats dans le cas de couleurs sombres, assurant de conserver un bon contraste entre tous les éléments graphiques et une meilleure cohérence des couleurs.

                  AboutSystem

                  L’application AboutSystem donne quelques informations sur la machine (RAM, CPU), et surtout affiche les noms des développeurs et les messages de copyright et clauses de licences obligatoires de logiciels libres qui sont embarqués dans Haiku.

                  Correction d’un crash à cause d’une information de copyright mal enregistrée (madmax).

                  Mise à jour des crédits à l’occasion de la version Beta 5 : ajout des nouveaux membres de l’équipe, et passage dans la catégorie « anciens développeurs » de certaines personnes qui ne participent plus pour l’instant. (waddlesplash).

                  Débogueur

                  Haiku est fourni avec un débogueur graphique permettant d’investiguer facilement les problèmes dans les applications.

                  Waddlesplash a amélioré le désassembleur pour mieux décoder les adresses mémoire calculées à partir de la valeur d’un registre CPU. La correction a été remontée dans la bibliothèque tierce Zydis, utilisée pour le désassemblage.

                  Il a également modifié le code du Debugger pour ne pas essayer de télécharger des informations de debug lorsque l’outil est lancé en mode non-interactif (dans le cas d’une test suite automatisée par exemple). Plusieurs autres problèmes qui pouvaient causer un plantage du debugger ou un blocage dans un état invalide (avec l’application qui ne s’arrête jamais) ont été également traités.

                  DriveSetup

                  L’outil DriveSetup permet de modifier la table de partitions et de formater les partitions avec différents systèmes de fichiers.

                  Pour les partitions de type « Intel » (MBR), lorsqu’on crée une première partition, par défaut elle est marquée automatiquement comme partition active. Auparavant il fallait cocher une case pour cela, et de nombreux utilisateurs oubliaient de le faire, ce qui pouvait rendre le système impossible à démarrer (korli).

                  Dans certains messages, le nom des partitions n’était pas mis entre guillemets, ce qui pouvait prêter à confusion avec des noms de partitions choisis maladroitement (ou judicieusement, selon de quel point de vue on se place). Maintenant le nom de la partition est clairement identifiable dans le message (humdinger).

                  HaikuDepot

                  HaikuDepot est le frontal graphique du gestionnaire de paquets de Haiku. L’application est maintenue par apl et se compose d’une interface graphique native développée en C++ et d’un webservice développé en Java qui permet de stocker des métadonnées supplémentaires sur les paquets : captures d’écrans, notes et revues des utilisateurs, liste des paquets à mettre en avant.

                  • Refactoring du « language model », de la gestion des chemins, de la récupération des données des paquets, de l’affichage des auteurs de paquets, de la gestion des notes données par les utilisateurs. (apl)
                  • Fenêtre des conditions d’utilisation: correction de la couleur du texte, correction d’un crash si on clique dans la fenêtre avant que le texte soit chargé. (apl et jscipione)
                  • Le bouton « Ouvrir » permettant de lancer une application installée ne fonctionnait pas toujours (apl).
                  • Amélioration de la sélection d’un icône par défaut pour les paquets qui n’ont pas d’icône inclus (apl).

                  La liste de paquets mis en avant a été revue, un nouveau mainteneur (Michel) se charge de la tenir à jour avec des règles mieux définies : une sélection d’applications populaires (sur suggestion de participants aux forums de discussion) ainsi que des applications mises à jour récemment. Si vous utilisez Haiku, n’hésitez pas à passer un peu de temps à évaluer et noter les applications, peu de personnes le font et il est difficile d’exploiter les données de façon pertinente si beaucoup d’applications n’ont reçu qu’un seul vote.

                  Horloge

                  L’application horloge permet d’afficher l’heure (sans surprise). Elle propose diverses apparences de cadrans, peut être redimensionnée, et incrustée dans le bureau sous forme d’un replicant.

                  Un bug dans l’application conduisait à afficher une heure aléatoire (non initialisée) pendant quelques centièmes de secondes au démarrage avant de commencer à afficher l’heure courante (OscarL)

                  Les aiguilles de l’horloge étaient décalées de quelques pixels et ne pointaient pas précisément là ou elles devraient (dovsienko).

                  Tracker

                  Tracker est le gestionnaire de fichiers de Haiku. Il affiche le bureau et toutes les fenêtres de navigation et de recherche de fichiers. Il se distingue par son utilisation de la navigation dite « spatiale », où chaque dossier s’ouvre dans une fenêtre séparée dont la taille et la position à l’écran sont mémorisées.

                  jscipione continue son travail d’amélioration du Tracker (cela comporte de nombreux changements qui sont encore en gestation). Ce trimestre, les changements intégrés permettent :

                  • la désactivation d’entrées du menu « Nouveau » lorsque les opérations ne sont pas disponibles,
                  • la mise à jour dynamique de certains menus en fonction des opérations disponibles,
                  • la préservation de la sélection après une opération de copie où de déplacement (avec quelques problèmes d’affichage corrigés au passage),
                  • des corrections de bug sur le choix de couleurs utilisées dans la fenêtre « Ouvrir avec »,
                  • la possibilité de créer un lien symbolique lorsqu’on fait un drag and drop depuis un dossier virtuel,
                  • utilisation de la police de caractères « menu » de façon cohérente dans tous les menus.

                  Il a également travaillé sur des tâches de fond, sans changements visibles pour l’instant. Le code du Tracker provient de BeOS et est un peu vieillissant. Il est souvent nécessaire de faire beaucoup de nettoyage avant de pouvoir développer de nouvelles fonctionnalités sans casser autre chose. Cette fois-ci, on trouve entre autres une refonte de la gestion des raccourcis claviers, la fermeture automatique des fenêtres en double lors du passage en mode « navigation spatiale », et divers crashs liés à la gestion des menus popup.

                  humdinger a également travaillé sur le Tracker pour améliorer certains messages concernant la copie et la création de fichiers, pour les rendre plus faciles à traduire.

                  humdinger a également travaillé sur l’organisation du menu « templates » (affiché quand on fait un clic droit -> nouveau… et permettant de créer différents types de fichiers à partir de fichiers de référence). Ce menu peut maintenant être organisé en plusieurs sous-menus à l’aide d’une nouvelle option « New template folder », pour les personnes qui utilisent cette fonctionnalité avec de nombreux fichiers de référence au point d’avoir besoin de les organiser.

                  La fenêtre de requêtes (recherche de fichiers en fonction de leurs attributs étendus indexés dans le système de fichiers) permet maintenant d’afficher en temps réel les résultats lorsqu’on édite une requête. En outre, il est possible de filtrer les résultats pour afficher uniquement les fichiers contenus dans un répertoire donné (auparavant, on pouvait au mieux restreindre par volume disque). Ces changements ont été réalisés dans le cadre du Google Summer of Code par CalistoMathias, avec également une participation de jscipione, humdinger et waddleplash pour finaliser le travail.

                  Correction d’un crash du Tracker lors de changements de résolution d’écran (OscarL).

                  Terminal

                  Le Terminal permet d’exécuter des applications en ligne de commande.

                  Lors du changement de la taille de texte du Terminal, ce dernier ajuste le nombre de lignes et colonnes de texte visibles, au lieu de redimensionner sa fenêtre (nipos).

                  Prise en compte de la séquence d’échappement ANSI pour effacer l’historique de défilement (CodeForEvolution).

                  PowerStatus

                  L’application PowerStatus affiche des informations sur les batteries pour les ordinateurs portables.
                  sen a effectué plusieurs améliorations pour les systèmes avec plusieurs batteries:

                  • Gestion de plusieurs emplacements pour batteries qui ne sont pas forcément tous utilisés,
                  • Meilleur calcul des alertes de batterie faible,
                  • Prise en compte de la déconnexion de batteries pendant le fonctionnement du système.

                  Outils en ligne de commande

                  La commande profile (qui permet d’analyser les performances d’autres applications et du système) peut maintenant afficher le nombre d’évènements qui n’ont pas pu être enregistrés par l’analyseur système (waddlesplash).

                  La commande package_repo update (utilisée pour mettre à jour un dépôt de paquets avec de nouveaux logiciels) peut maintenant fonctionner sans avoir accès au contenu complet des fichiers packages à inclure dans le dépôt (seuls les noms des paquets et quelques autres métadonnées sont réellement nécessaires).

                  La commande package_repo list dispose d’une option -f pour afficher le nom de fichiers correspondant aux paquets contenus dans un dépôt de paquets. Les fichiers peuvent ainsi être téléchargés facilement par un outil tiers. (waddlesplash)

                  Ces deux modifications sont utiles en particulier pour la ferme de build de HaikuPorts, qui souhaite héberger les fichiers dans des buckets S3 afin de simplifier l’infrastructure et de réduire les coûts de fonctionnement.

                  Amélioration du format de sortie de la commande launch_roster pour indiquer le statut des services et pas simplement leur nom (kallisti5 + waddlesplash).

                  Ajout dans strace du décodage des drapeaux de configurations de mutex (par exemple MUTEX_SHARED) (waddlesplash).

                  Serveurs

                  Les serveurs sont des applications fonctionnant en tâche de fond et qui implémentent une grande partie des fonctionnalités du système.

                  app_server

                  app_server est le serveur graphique qui se charge de l’affichage du bureau et des fenêtres.

                  madmax a travaillé sur la gestion des polices de caractères: correction de problèmes de verrouillage pour éviter des accès concurrents au gestionnaire de polices par plusieurs fils d’exécution, amélioration du traitement de l’ajout et du retrait de polices, et une optimisation pour éviter de scanner deux fois de suite les dossiers de polices au démarrage.

                  waddlesplash a complété ce changement en déplaçant une partie du code de gestion des polices pour éviter que d’autres parties de l’exécution soient bloquées par l’initialisation des polices, qui peut prendre beaucoup de temps (quelques secondes) au démarrage du système.

                  waddlesplash a corrigé un problème de calcul de délai d’expiration (probablement sans conséquence, découvert par hasard en investiguant un autre problème).

                  jscipione a corrigé un problème de rafraîchissement de l’affichage lorsque des fenêtres sont empilées, qui pouvait conduire à ne pas bien effacer la barre de titre dans certains cas.

                  Un clic simple sur le coin bas-droite de la fenêtre (coin de redimensionnement) déclenchait par erreur une minimisation de la fenêtre concernée (madmax).

                  media_server

                  Le media_server prend en charge les flux audio et vidéo et permet de router ces flux entre différentes applications ainsi que depuis et vers le matériel (cartes son, cartes d’acquisition vidéo, webcams…).

                  Travaux effectués par waddlesplash:

                  Correction de problèmes de calculs de temps dans le mixeur audio (problèmes découverts suite à l’amélioration de la détection d’erreurs dans BTimeSource, mentionné plus haut), et ajout de contrôles d’intégrité supplémentaires lors du démarrage du mixeur.

                  Cela corrige plusieurs bugs qui faisaient que le système n’avait pas de son au démarrage pendant un certain temps, avant que soudainement ça se mette à fonctionner.

                  D’autre part, des améliorations de performance sur la programmation des évènements, et des corrections de crash sur la connexion et déconnexion des nœuds média vers la sortie audio, et sur le nœud multi-audio avec certaines cartes sons qui exposent des types de contrôles invalides.

                  D’autres changements sont en cours pour pouvoir changer la sortie audio sans avoir besoin de redémarrer le serveur média, mais ça ne fonctionne pas encore.

                  registrar

                  Le registrar surveille quelles sont les applications déjà lancées et fournit divers services de communication entre applications, en particulier pour le presse-papier.

                  Ajout de vérification d’erreurs si un message de récupération du contenu du presse-papier échoue. Cela peut arriver si on a mis beaucoup de données dans le presse-papier et qu’il n’y a plus assez de mémoire disponible.

                  Des corrections du côté de la libbe permettent maintenant de gérer ces erreurs et de ne pas faire planter l’application concernée.

                  input_server

                  L’input_server` se charge des périphériques d’entrée (clavier, souris…)

                  Améliorations la validation des données des fichiers de configuration de souris, qui dans certains cas pouvaient empêcher la souris de fonctionner. Refonte de la gestion des accès concurrents à la liste des périphériques, pour supprimer des verrous inutiles et permettre les accès à la liste même si un thread de gestion d’un périphérique est bloqué. (madmax)

                  Les codes de touches pour la touche power et la touche \_ des claviers japonais s’étaient retrouvés assignées à des valeurs identiques (cela semble provenir tout droit de changements datant de BeOS, car ces touches non présentes sur un clavier de PC américain classiques sont assez mal documentées). La documentation a été mise à jour pour mieux expliquer quels sont les codes utilisés, et les différents pilotes (PS2, USB) ont été harmonisés pour utiliser les mêmes codes (x512 et PulkoMandy).

                  Le code power pourra également être utilisé par un pilote GPIO sur les machines où c’est nécessaire (souvent non compatibles PC).

                  net_server

                  Le net_server se charge de toutes les opérations liées au réseau.

                  mmlr a corrigé un problème dans le client DHCP, qui utilisait certaines variables sans les initialiser.

                  package_daemon

                  Le package_daemon vérifie la cohérence des paquets installés avec leurs dépendances, crée les dossiers de transactions et de sauvegarde de l’état passé du système, et se charge de lancer les scripts d’activation et de désactivation de paquets. L’accès au contenu des paquets est en revanche traité dans le noyau par le système de fichier packagefs.

                  Changement des couleurs des fenêtres « problèmes » et « résultats » qui apparaissent quand il y a des conflits ou d’autres problèmes de résolution de dépendances lors de l’activation des paquets (jscipione).

                  Kits

                  Les « kits » sont les composants de la bibliothèque standard de Haiku. Il s’agit principalement d’une convention de documentation et d’organisation de code source pour regrouper des fonctionnalités liées entre elles.

                  Interface

                  L’interface kit` permet l’ouverture de fenêtre et l’ajout de contrôles d’interface graphiques à l’intérieur de ces dernières.

                  Les objets BBitmap (permettant de stocker une image « raster ») avec le flag ACCEPT_VIEWS (permettant d’attacher une « vue" pour dessiner dans le bitmap ne sont plus automatiquement effacés. Cela permet de créer un bitmap à partir de données existantes, puis de dessiner autre chose par-dessus. Ce changement corrige un problème de compatibilité avec BeOS, et permet aussi d’utiliser cette méthode dans l’implémentation de WebKit pour Haiku (ZardShard).

                  Un changement précédent avait causé un problème de compatibilité d’API avec BeOS, qui déclenchait dans certains cas une récursion infinie et un crash lorsqu’on essayait de faire défiler une BListView par glisser-déplacer (par exemple dans l’application Wonderbrush). Waddlesplash a corrigé ce problème, et jscipione a également ajouté quelques améliorations sur la mise à jour des items sélectionnés lorsqu’on effectue cette opération.

                  Il est maintenant possible d’afficher des « checkmarks » (coche indiquant une option activée) sur les items de menus disposés en « matrice ». Habituellement les menus sont soit disposés sur une ligne, soit sur une colonne avec les items les un au-dessous des autres. Le mode « matrice » permet de s’affranchir de ces restrictions pour disposer les items librement avec du code applicatif.

                  Mise à jour en direct des couleurs dans les contrôles BSpinner, refonte de l’héritage des couleurs de la vue parente, et changement de la couleur de fond des boutons en mode sombre (jscipione).

                  Centrage vertical des dates dans BCalendarView (permettant d’afficher un calendrier) (nipos).

                  Factorisation de code dans BView pour l’envoi des données BShape vers app_server (x512).

                  La méthode de debug BPoint::PrintToStream affiche maintenant les coordonnées avec des décimales, permettant de détecter les points qui ne sont pas alignés avec la grille de pixels (ayu-ch).

                  Les boîtes de texte marquées comme « invalides » ont maintenant un fond rouge. La bordure rouge utilisée précédemment n’était pas assez visible (nephele).

                  Media

                  Le media kit permet aux applications de s’interfacer avec le media server, et fournit en plus une interface standardisée pour les codecs audio et vidéo.

                  Ajout d’assertions dans la classe BTimeSource pour empêcher les applications d’envoyer des temps avec un « drift » inférieur ou égal à 0. Le « drift" est utilisé comme multiplicateur et diviseur dans les calculs d’horloge, donc les valeurs inférieures ou égales à 0 causent des problèmes. Ceci a été mis en évidence par des corrections au niveau du noyau (voir plus loin dans la dépêche) et a ensuite permis de trouver encore d’autres problèmes en particulier dans les add-ons media (waddlesplash).

                  Locale

                  Le « locale » kit permet la traduction des applications, le formatage des nombres en fonction des préférences de chaque pays, la gestion des fuseaux horaires, et toutes les autres problématiques liées à l’internationalisation. Il s’agit principalement d’un enrobage de la bibliothèque ICU pour faciliter son utilisation avec les types natifs de Haiku.

                  Meilleure gestion des erreurs si la bibliothèque ICU ne peut pas être initialisée (waddlesplash).

                  Support

                  Le support kit contient diverses méthodes et classes utilitaires et génériques.

                  Contrôle d’intégrité des données lors de la déserialisation de BMessage (waddlesplash).

                  Correction d’incohérence de nommage de paramètres de fonction entre les fichiers .cpp et .h détectés par cppcheck (mt).

                  Pilotes de périphériques

                  Les pilotes sont indispensables pour assurer le fonctionnement de Haiku sur une grande variété de matériel. Certains sont développés à partir des spécifications du matériel spécifiquement pour Haiku, et d’autres ont été adaptés de travaux réalisés pour d’autres systèmes d’exploitation.

                  Le niveau de logging par défaut a été abaissé dans certains pilotes afin de ne pas trop polluer le journal système, en particulier:

                  • Suppression de messages indiquant qu’aucun matériel compatible avec le pilote n’a été détecté,
                  • Suppression de certains logs de debug dans les pilotes audio HDA et usb_audio.

                  Processeurs et économie d’énergie

                  Renommage du pilote intel_cstates en x86_cstates puisque les processeurs récents de chez AMD sont également pris en charge par ce pilote.

                  Appel à ce pilote à plus d’endroits dans le noyau pour mettre les processeurs en veille ou au ralenti quand ils ne sont pas utilisés.

                  Réseau

                  virtio_net

                  Le pilote virtio_net (carte réseau utilisée dans les machines virtuelles) implémente maintenant le « checksum offloading » pour les protocoles IP, TCP et UDP. En effet, dans le cas de ce pilote, les vérifications et calculs de sommes d’intégrité doivent être faits de toutes façons du côté de la machine hôte, il est donc inutile de les refaire dans la machine virtuelle.

                  Au passage, correction de quelques erreurs dans ce driver, et en particulier de problèmes de calcul de taille de buffers en mémoire.

                  broadcom750x

                  Utilisation des interruptions par messages (MSI) lorsque c’est nécessaire pour certaines versions du matériel (waddlesplash).

                   vmxnet

                  Nouveau pilote porté depuis FreeBSD qui permet d’utiliser l’interface réseau paravirtualisée de VMWare (CodeForEvolution).

                   Couches de compatibilité BSD

                  Haiku utilise des pilotes réseau venus de FreeBSD et OpenBSD, cela permet de mutualiser les ressources et de ne pas perdre du temps à réinventer la roue. Une couche de compatibilité permet de réutiliser les pilotes avec très peu de modification dans leur code et une simple recompilation.

                  Cette approche est également utilisée par d’autres systèmes d’exploitation comme RTEMS.

                  La couche de compatibilité a reçu des corrections de problèmes sur l’allocation de mémoire dédiée aux transferts DMA, ainsi qu’un problème sur le calcul de la taille d’un buffer de réception, qui empêchait les pilotes de fonctionner sur certains matériels.

                   TCP

                  Waddlesplash a travaillé sur l’amélioration de l’implémentation de TCP :

                  • Refonte de la gestion des ACK reçus dans le désordre,
                  • Amélioration du code de débogage pour investiguer des crashs du noyau remontés par quelques utilisateurs,
                  • Modification du code de mise à jour de la taille de fenêtre TCP pour éviter d’envoyer inutilement des changements de taille,
                  • Correction de calcul du temps d’aller-retour,
                  • Implémentation du redimensionnement dynamique de la fenêtre de réception (auparavant, elle était de taille fixe),
                  • Ajout d’assertions à divers endroits dans la pile réseau pour détecter les problèmes à la source.

                  Ces améliorations permettent au trafic TCP d’être au moins 10 fois plus rapide, selon le type de connexion utilisé, et règle un problème de lenteur des téléchargements depuis Haiku qui était présent depuis assez longtemps.

                   Ethernet

                  Du côté d’Ethernet, quelques améliorations et nettoyages sur le calcul de la MTU (taille maximale d’un paquet qui peut être envoyé). Pour l’instant, la découverte du « path MTU », la MTU du chemin complet entre deux machines, n’est pas encore disponible. Haiku ne s’autorise donc pas à envoyer du trafic plus large qu’une trame Ethernet standard, même si cela pourrait être possible pour le réseau local. Il reste donc une amélioration potentielle des performances réseau dans certains cas.

                   UNIX domain sockets

                  Les sockets UNIX sont une méthode de communication entre processus standardisée par POSIX, utilisée surtout par des logiciels portés depuis d’autres systèmes (les applications natives pour Haiku utiliseront plus volontiers des BMessages ou des ports).

                  Amélioration et nettoyage du code autour de la gestion des données annexes dans les sockets UNIX. Correction de petites fuites de mémoire et d’un kernel panic qui pouvait se produire lors de la fermeture d’un socket (waddlesplash).

                  USB

                  Implémentation de l’USB « Super Speed Plus », qui permet des connexions USB avec un débit pouvant atteindre 10 gigabits par seconde (korli).

                  Refonte et consolidation du comptage de références dans la pile USB, ce qui met en évidence sous forme de kernel panic des cas où les choses ne sont pas bien faites. Ce n’est pas agréable, mais c’est tout de même mieux qu’une corruption mémoire difficile à investiguer (waddleplash).

                  Décodage des descripteurs USB Audio v2 dans la commande listusb, mais pas encore dans le pilote usb_audio qui implémente pour l’instant seulement la version 1 (gscrain).

                  PCI

                  Correction de problèmes d’accès au bus PCI sur les machines équipées de ACPI. Suite à une modification précédente, les accès sur 8 ou 16 bits étaient convertis en accès sur 32 bits, mais ce n’est pas le comportement attendu. En particulier, certains registres effacent automatiquement leur contenu lorsqu’ils sont lus, ou bien les données accessibles en lecture et en écriture ne sont pas les mêmes. (PulkoMandy)

                  Il n’est donc pas possible de lire une valeur sur 32 bits, remplacer 8 bits, et réécrire 32 bits pour simuler une écriture sur 8 bits dans un registre.

                  Les accès sont à nouveau traités correctement, ce qui permet à Haiku de fonctionner à nouveau normalement sur les machines concernées par ce type d’accès au bus PCI (cela dépend du matériel et des pilotes).

                  Périphériques de stockage

                  Petites améliorations de performances dans le pilote NVMe (waddlesplash).

                  Modification du pilote AHCI/SATA (waddlesplash) :
                  - Suppression de code dupliqué pour utiliser à la place des fonctions communes partagées avec d’autres pilotes,
                  - Correction d’une confusion entre adresses 32 et 64 bits qui empêchait de démarrer la version 32
                  bits de Haiku sur certains systèmes avec plus de 4Gio de RAM.

                  La pile SCSI prend mieux en compte les restrictions sur les adresses DMA. Chaque pilote de périphérique qui implémente SCSI peut indiquer ce qu’il est capable de faire, et la pile SCSI fait en sorte que les demandes de transferts DMA respectent ces contraintes, ce qui évite aux pilotes de devoir découper par eux-mêmes les transferts en unités qu’ils sont capables de traiter (waddlesplash).

                  ACPI

                  ACPI est une interface standardisée avec le matériel. Elle permet la gestion d’énergie (extinction de la machine par exemple), ainsi que l’accès à du matériel annexe tels que les boutons on/off, la détection de rabat de l’écran sur un PC portable, le contrôle des LEDs indicatrices ; ainsi que la découverte de matériel non connecté sur le bus PCI (comme certains modules eMMC dans des tablettes et ordinateurs à bas coût).

                  La spécification étant assez complexe, la bibliothèque ACPICA est utilisée pour implémenter les bases de ACPI. Ensuite, des pilotes dédiés permettent d’exposer chaque périphérique ACPI.

                  Mise à jour de ACPICA avec la dernière version publiée par Intel (publiée en mars), et un peu de nettoyage afin de pouvoir intégrer quelques patchs dans la version upstream de ACPICA (PulkoMandy).

                  Ajustement du pilote ACPI pour mapper sa mémoire physique en « write back » au lieu de désactiver complètement le cache. C’est nécessaire sur ARM64, car le cache permet d’intercepter les accès mémoire non alignés. Correction de problèmes liés au fait que la même zone de mémoire physique pouvait être mappée plusieurs fois avec des configurations différentes, ce qui est impossible (déclenche une « machine check exception ») (oanderso).

                  Graphiques

                  Avancées sur la prise en charge des cartes graphiques Intel de générations Tiger Lake, Ice Lake et Gemini Lake (ttmfx, ilzu, PulkoMandy). L’utilisation de ces cartes graphiques reste assez limité, sans accélération matérielle et sans possibilité d’utiliser plusieurs écrans pour l’instant.

                  virtio

                  Les pilotes virtio permettent l’utilisation de matériel virtuel défini pour tirer le meilleur parti des machines virtuelles. Plutôt que de copier le fonctionnement d’un matériel existant, l’interface peut être conçue pour rendre le travail plus simple aussi bien pour l’hôte que pour le système virtualisé.

                  Correction de problèmes dans l’allocation des files de messages virtio et amélioration de la gestion des erreurs (mmlr).

                  Vérification de l’état du périphérique après une réinitialisation, et correction d’un accès mémoire hors limite dans le pilote virtio_pci (korli).

                  PS/2

                  Les ports PS/2 ont disparu de la plupart des machines depuis de nombreuses années, mais le protocole est encore utilisé pour les claviers des ordinateurs portables ainsi que pour certains touchpads. Ces derniers utilisent de nombreuses extensions peu standardisées et mal documentées pour offrir des fonctions avancées qui n’existaient pas à l’époque des souris à deux boutons.

                  Le driver reçoit ce trimestre une refonte de la gestion des verrous entre ses différents composants, pour essayer de régler quelques problèmes de synchronisation (waddlesplash).

                  Systèmes de fichiers

                  ram_disk et ramfs

                  ram_disk est un périphérique bloc (block device) qui stocke ses données en RAM (non persistante au redémarrage). Il peut être formaté avec n’importe quel système de fichier.

                  ramfs est un système de fichiers qui stocke ses données en RAM, sans passer par un block device. Cela permet de meilleures performances (pas besoin de journalisation par exemple), une meilleure intégration avec le cache de fichiers (la mémoire peut être partagée directement entre ramfs et le cache), et de s’affranchir des limites habituelles des périphériques de bloc (par exemple: une taille fixe connue lors de la création du système de fichiers).

                  Un utilisateur a remonté un problème de compatibilité avec POSIX. Si on utilise mmap() sur un fichier stocké dans un ramfs, et que la taille du fichier n’est pas un multiple de la taille des pages de mémoire, la fin de la dernière page pouvait contenir des données aléatoires. Selon la spécification POSIX, il faut que cette zone soit remplie avec des 0, et le compilateur clang dépend de ce comportement pour implémenter une lecture rapide des fichiers sources compilés.

                  Le problème a été corrigé, avec au passage une commonalisation de code entre ramfs et ram_disk, de petits ajustements de performances, et un peu de nettoyage.

                  Enfin, la priorité des allocations mémoires de ces deux pilotes a été abaissée, ce qui permet d’éviter un gel du système s’il n’y a plus de mémoire disponible.

                  Le pilote ramfs continue d’être stabilisé, quelques problèmes qui pouvaient encore causer des kernel panic ont été corrigés.

                  packagefs

                  packagefs est un système de fichier virtuel qui expose le contenu de fichiers de packages au format hpkg. Des paquets peuvent être ajoutés et supprimés pendant le fonctionnement du système, et il n’est pas nécessaire d’extraire leurs données sur disque.

                  Plusieurs améliorations faites par waddlesplash :

                  • Ajout de vérifications de la bonne utilisation de verrous entre différents threads et corrections de problèmes mineurs qu’elles ont mis en évidence,
                  • Amélioration du message d’erreur si on essaie d’activer deux paquets qui entrent en conflit.

                  Un reproche qui est souvent fait au packagefs est d’avoir augmenté les besoins en RAM de Haiku, en effet, depuis la version Beta 1 de Haiku, la configuration mémoire minimum recommandée est de 384Mio de RAM, alors que les versions précédentes se contentaient de 128Mio.

                  • Utilisation d’object_cache` (un allocateur mémoire pour des objets qui font tous la même taille) dans différents endroits de packagefs pour réduire sa consommation de mémoire,
                  • Utilisation de listes chaînées simples au lieu de listes chaînées doubles là où ça ne pose pas de problème de performances,
                  • Suppression de champs constants dans certaines classes,
                  • « inlining » des compteurs de références pour rendre les structures de données plus compactes,
                  • Réorganisation des structures pour réduire le padding,
                  • Retrait des « dépôts d’objets » dans les arènes d'allocation,
                  • Découpage des allocations en plusieurs zones distinctes,
                  • Utilisation de verrous moins fins (par exemple, avoir un seul verrou pour tout un dossier au lieu de un par fichier),
                  • Utilisation d’un « bump allocator » pour les objets à courte durée de vie.

                  La réduction de consommation mémoire avec ces changements est de près de 20%, soit environ 15Mio sur une installation de référence. En effet, un gain de quelques octets sur le stockage d’informations sur un fichier est multiplié par plusieurs milliers de fichiers présents sur le disque, ce qui fait que chaque petite optimisation est intéressante. Cependant, les investigations ont aussi permis de découvrir d’autres problèmes encore plus importants qui n’étaient pas directement liés au packagefs, on en reparle un peu plus loin.

                  Un autre changement a été fait par waddlesplash, non seulement pour packagefs mais aussi pour d’autres endroits où le même code était utilisé : La fonction pour calculer un hash de chaîne de caractères utilisait un algorithme obsolète. Elle a été remplacée par hashdjb2 qui génère moins de collisions.

                  FAT

                  FAT est un système de fichier développé par Microsoft. Il est utilisé en particulier sur les cartes SD et les clés USB, ainsi que pour les partitions systèmes EFI. Bien que sa conception soit quelque peu obsolète, il reste donc indispensable.

                  Le pilote FAT de Haiku, qui provenait tout droit d’un code source publié par Be, a été remplacé dans la version beta 5 par une nouvelle version basée sur le code de FreeBSD. Ce nouveau pilote reçoit depuis des améliorations régulières par Jim906, le développeur qui s’est chargé du portage du code de FreeBSD.

                  Ce trimestre, le pilote reçoit des corrections sur l’initialisation des « media bytes » dans l’en-tête des partitions, des améliorations de performances pour réduire le temps nécessaire au montage d’une partition FAT, ainsi qu’une meilleure gestion des erreurs dans le traitement des noms de volumes. Il est également possible de monter les volumes FAT de taille supérieure à 2TiO.

                  BFS

                  BFS est le système de fichier hérité de BeOS et utilisé pour les partitions natives de Haiku. Il propose une très bonne implémentation des attributs étendus (sans limite de taille, et typés) et permet en plus d’exécuter des requêtes sur ces attributs pour localiser très rapidement les fichiers répondant à certains critères.

                  L’implémentation du système de fichier BFS est assez mûre et reçoit habituellement peu d’évolutions. Cependant, il reste toujours des possibilités d’améliorer les performances.

                  C’est le cas de la fonction de recherche de blocs libres. Les blocs sont chacun représentés par un bit dans une structure indiquant s’ils sont disponibles ou pas. La recherche de blocs libres se faisait bit à bit, mais il est possible de gagner beaucoup de temps en testant 64 bits d’un coup pour savoir tout de suite qu’ils représentent tous des blocs occupés, et passer directement aux 64 bits suivants. Cela améliore les performances de la création et du redimensionnement de fichier, en particulier sur les architectures RISC-V (waddlesplash).

                  Query parser

                  Plusieurs systèmes de fichiers conçus pour BeOS ou Haiku (bfs, ramfs, et packagefs) permettent l’utilisation d’attributs indexés par le système de fichiers qui permettent d’effectuer des requêtes pour localiser des fichiers comme dans une base de données.

                  Depuis la version beta 5 de Haiku, ces 3 systèmes de fichiers partagent le code utilisé pour parser une requête (envoyée sous forme de texte) et la convertir en une opération de recherche exécutable.

                  Ce parser pouvait dans certains cas (requêtes trop complexes) déclencher volontairement un kernel panic. Celui-ci a été remplacé par une « simple » erreur, remontée à l’application qui a déclenché la requête. L’application aura la charge de remonter cette erreur à l’utilisateur, et de l’inviter à simplifier sa demande.

                  block_cache

                  Le cache de blocs, comme son nom l’indique, stocke en mémoire RAM une copie de certains blocs des systèmes de fichiers. Cela permet d’accélérer les opérations bas niveau sur le système de fichier, en particulier pour mettre en cache des structures internes du disque. Il complète le file_cache, qui lui se trouve à un niveau plus haut, et met en cache uniquement le contenu des fichiers lus et écrits par les applications.

                  Le seul changement notable sur le block_cache est le retrait de paramètres inutilisés dans certaines fonctions, afin de simplifier le code (waddlesplash).

                  kernel

                  Une correction de bug sur le blocage des threads avec timeout (par exemple, l’attente d’un mutex ou d’un sémaphore avec un délai maximum): dans certains cas, une fonction pouvait retourner B_TIMED_OUT pour d’autres raisons que l’expiration du timer. Ce n’était pas traité correctement, et le noyau supposait que le timeout avait expiré, alors qu’il s’agissait d’autre chose. Des vérifications supplémentaires permettent de traiter ce cas correctement.

                  Correction de problème sur la programmation des timeouts « absolus temps-réel ». Comme leur nom l’indique, ils référencent l’horloge « real time » (qui essaie de suivre l’heure et la date « réelle », par opposition à l’horloge système qui est basée sur l’uptime de la machine, mais garantit de ne jamais faire de saut ou revenir en arrière). Ces timers ne fonctionnaient pas du tout (ou alors, seulement sur un coup de chance), et restaient probablement bloqués pendant une durée beaucoup plus longue que demandé. Au passage, nettoyage du code de gestion des timers.

                  Dans le code de gestion des interruptions: ajout d’assertions pour investiguer un bug dans les addons vmware ou virtualbox.

                  Correction d’un bug dans l’implémentation de kqueue qui produisait un blocage au démarrage de la libevent (qui utilise maintenant kqueue pour Haiku).

                  Des petites améliorations de performances: sur l’allocateur mémoire du noyau, sur l’utilisation de verrous dans la gestion de la mémoire virtuelle, des fuites de mémoire dans l’allocation de page, des améliorations sur la détection de références devenues invalides (jpelczar + waddlesplash).

                  Le script de link du noyau refuse maintenant les sections inconnues avec un message d’erreur, au lieu de simplement les ignorer (korli).

                  Correction du décompte du temps CPU utilisé par le thread en cours d’exécution, pour donner des résultats plus fiables dans les applications qui affichent l’utilisation CPU (waddlesplash).

                  Refactorisation du décompte du temps d’exécution des appels systèmes. Seul le temps passé dans l’exécution du syscall est prise en compte, sans mesurer la mise en place d’un appel système et du retour vers l’espace utilisateur (qui ne peuvent de toutes façons pas être mesurées de façon fiable depuis le noyau). Cela rend l’affichage des durées d’exécution dans strace plus facile à interpréter (waddlesplash).

                  Réduction de la taille maximale des tampons mémoire pour stocker des dirent à 8Kio. La plupart des applications n’utilisent pas un tampon aussi large, et les quelques-unes qui le faisaient ont été modifiées pour réduire la taille. Cette réduction permet d’utiliser un allocateur spécialisé beaucoup plus rapide, ce qui devrait compenser les rares cas où le tampon est trop petit pour récupérer tout le contenu d’un dossier en une seule fois (waddlesplash).

                  Correction de plusieurs problèmes dans le système de gestion des ressources faibles (qui essaie de libérer de la mémoire quand il n’y en a plus assez de disponible). Dans certains cas, le système finit par geler ou déclencher un kernel panic, alors qu’il devrait toujours être possible de refuser des demandes d’allocation mémoire venant de l’espace utilisateur, et de conserver suffisamment de mémoire libre pour au moins afficher proprement une erreur.

                  Amélioration de la gestion des mutex (exclusions mutuelles entre threads):

                  • Ajout d’assertions pour détecter des cas de réveil d’un thread qui ne devrait pas l’être.
                  • Correction d’un problème introduit récemment et investigué à l’aide de ces nouvelles assertions.
                  • L’ABI des locks est identiques entre les builds du kernel en version debug ou release, ce qui permet de ne pas avoir besoin de recompiler tous les pilotes dans le même mode que le kernel. Les pilotes compilés en mode release vont déclencher une erreur de symbole manquant si on essaie de les utiliser avec un noyau en mode debug, dans l’autre sens, il n’y a pas de problème. Auparavant, dans les deux cas on obtenait des crashes ou un gel complet du système, difficile à investiguer et faisant perdre du temps.
                  • Ajout d’assertions dans plusieurs cas pour détecter les utilisations incorrectes des rw-locks. Certaines activées par défaut, et d’autres uniquement sur demande à la compilation du noyau en raison de coût de vérification trop importants.
                  • Correction de mauvaises utilisations des rwlocks ainsi détectées.

                  Généralisation de l’utilisation de fonctions utilitaires partagées pour la conversion des timespec en durées en microsecondes. Cela permet aux fonctions concernées (entre autres kqueue) de bénéficier de contrôles de validité supplémentaires (waddlesplash).

                  Ajout d’informations de debug supplémentaires dans la sortie de la commande slab_object du debugger du noyau.

                  Réactivation de la calibration du TSC à partir d’informations du CPUID lorsque Haiku s’exécute dans un hyperviseur, comme c’était déjà le cas lorsqu’il s’exécute directement sur une machine physique. Le TSC est un timer interne du CPU qui permet des mesures de temps très rapides (une seule instruction CPU) mais dans une échelle de temps arbitraire qu’il faut corréler avec le « vrai » temps. Cela peut être fait soit à l’aide d’une mesure empirique (méthode historique), soit à l’aide d’informations sur cette horloge disponibles dans les informations retournées par l’instruction CPUID.

                  Affichage de plus de fonctionnalités du CPU reconnues dans les logs de debug pour les processeurs x86 (korli).

                  Ajout d’un raccourci clavier (Control+D) pour quitter le debugger noyau et reprendre l’exécution normale si possible (équivalent à la commande continue ou co) (mmlr).

                  Le chargement des pilotes de périphériques se fait en priorité depuis les dossiers non-packaged avant de rechercher les fichiers dans les paquets logiciels, ce qui permet de tester facilement une version modifiée d’un pilote - sauf si les dossiers non-packaged sont désactivés dans la configuration du noyau (korli).

                  VFS

                  Le VFS (virtual file system) est le composant de Haiku qui gère l’accès aux fichiers. Il fait l’intermédiaire entre les appels systèmes liés aux fichiers (open, read, write…) et les systèmes de fichiers eux-mêmes. Il implémente autant que possible ce qui peut être mis en commun entre tous les systèmes de fichiers: résolution de chemins relatifs, vérification de permissions…

                  Cela rend plus facile l’écriture d’un nouveau système de fichiers, qui peut alors se concentrer sur les aspects bas niveau et la gestion de ses structures de données.

                  Ajout de vérifications d’intégrités supplémentaires dans le VFS pour détecter des bugs dans les systèmes de fichiers le plus rapidement possible, au lieu d’obtenir un crash du noyau difficile à investiguer un peu plus tard.

                  Retrait d’un scan du bus SCSI et des pilotes associés par le device manager pour réduire un peu le temps de démarrage.

                  Correction d’un gros problème dans l’API du noyau IORequest qui aboutissait à une confusion entre la taille totale d’une requête et l’offset de la dernière donnée transférée (les transferts ne commençant pas forcément à l’offset 0). La conséquence était l’écrasement de données dans le cache de fichiers, déclenchant des crashes du noyau avec des messages d’erreur incompréhensibles à propos des structures de pages. Correction d’un problème de calcul d’offset qui faisait que certaines opérations étaient considérées comme réussies, alors qu’il y avait en fait une erreur.

                  Correction de problèmes de décomptage de références et de gestion du cache à l’interface entre ramfs et VFS, mis en évidence lors du travail de portage de Firefox.

                  Ajout d’une acquisition de référence sur un vnode qui manquait dans le cache de fichiers (waddlesplash).

                  Améliorations du cache d'entrées, dont en particulier la mise en cache du hash des noms de fichiers, pour éviter des comparaisons de chaînes de caractères inutiles.

                  Gestion de la mémoire

                  La gestion de la mémoire virtuelle est une des tâches essentielles d’un système d’exploitation. Elle garantit l’isolation entre les différents processus, permet d’utiliser la mémoire physique le mieux possible (éventuellement en déplaçant certaines allocations peu utilisées vers un espace d’échange sur disque), et permet aussi aux différents processus de se partager des données.

                  Il s’agit également d’un composant très sollicité, et dont les performances impactent beaucoup le comportement du système. Une mauvaise gestion de la mémoire peut fortement ralentir le système ou le rendre instable.

                  Ajout d’assertions dans le code gérant les pages de mémoire, pour essayer d’intercepter ce type de correction plus rapidement si elles se reproduisent.

                  Dans l’arbre des areas globales : ajout d’assertions pour détecter les identifiants d’areas dupliqués (chaque area doit bien sûr avoir un identifiant unique).

                  Implémentation de PAT (Page Attribute Table) pour les processeurs x86. Les PAT permettent de configurer des zones de mémoires qui peuvent ou ne peuvent pas être mises en cache (complètement ou en write-through). Elles remplacent les MTRR en permettant un contrôle plus fin et plus flexible. Au passage, nettoyage de l’implémentation des MTRR (préservée pour les processeurs plus anciens incompatibles avec PAT), ajout de nouvelles commandes dans le debugger noyau. Renommage des constantes B_MTR_* pour indiquer précisément leur rôle indépendamment des dénominations utilisées dans les registres MTRR qui ne sont pas très claires (mmlr).

                  Lorsque le système utilise PAT, ajout d’assertions pour détecter les tentatives d’accéder à la même zone de mémoire physique avec des configurations de cache différentes. Elles ne sont pas activées lorqu'on utilise les MTRR, car ces dernières ne permettent pas une configuration aussi fine (waddlesplash).

                  Ajout d’informations supplémentaire dans le message de kernel panic indiquant qu’une page devrait être libre mais qu’elle ne l’est pas. Modification de la commande page du debugger noyau pour récupérer la liste des espaces d’adressage depuis les structures du kernel plutôt que d’itérer sur tout l’espace d’adressage (ce qui pouvait fonctionner sur un espace 32 bit, mais pas en 64 bit).

                  Correction du code de « guarded heap » du noyau qui ne compilait plus. Il s’agit d’un allocateur mémoire plus lent mais avec de nombreuses vérifications d’intégrité pour détecter les débordements de tampons, double free, et autres problèmes de gestion de la mémoire dans le noyau (kallisti5).

                  Le fichier swap est automatiquement supprimé, et l’espace disque libéré, lors de la désactivation de la swap. Auparavant, un redémarrage était nécessaire (waddlesplash).

                  Correction d’un problème dans l’allocation de mémoire « early boot » (avant que l’allocation normale soit mise en place), qui empêchait le démarrage sur les systèmes pouvant gérer de grandes quantités de mémoire (plusieurs centaines de Gio) (waddlesplash).

                  libroot

                  La libroot regroupe tous les composants de la librairie standard C (parfois découpée en libc, libm et libpthread pour d’autres systèmes). Elle contient en plus un certain nombre d’extensions spécifiques à Haiku et à BeOS.

                  Changements effectués par waddlesplash, sauf mentions spécifiques:

                  Nettoyage de code dans la classe WeakReferenceable, une classe de comptage de références intrusive qui autorise les références "faibles".

                  Correction de problèmes dans le code d’interfaçage avec ICU pour la conversion de dates (nipos et waddlesplash).

                  libnetwork

                  Nettoyage de code de compatibilité avec BeOS dans la libnetwork, pour faire en sorte qu’il ne soit plus du tout compilé sur les architectures n’offrant pas de compatibilité avec BeOS.

                  Compatibilité POSIX

                  Implémentation minimale de mknod et mknodat dans le seul cas spécifié par POSIX, qui permet de réaliser une opération équivalente à mkfifo. La gestion des devices dans Haiku est très différente de celle utilisée traditionellement par UNIX, et ne se prête pas à l’implémentation des autres utilisations de ces fonctions.

                  Rectification de l’implémentation des fonctions *at (par exemple linkat) qui permettent de réaliser une opération à partir d’un descripteur de fichier au lieu d’un path. Dans la libroot, ces fonctions envoyaient la valeur -1 aux appels systèmes pour implémenter AT_FDCWD. La valeur de AT_FDCWD a été modifiée pour choisir autre chose que -1 (qui est souvent utilisé pour indiquer une erreur dans le code de retour d’autres fonctions). Les appels systèmes acceptent pour l’instant les valeurs -1 et AT_FDCWD, mais rejettent maintenant toutes les autres valeurs négatives.

                  Remplacement d’une partie du code de gestion des flux d’entrée-sortie par la version de la glibc. La bibliothèque libroot est un patchwork d’implémentations provenant de la glibc, de musl, et de divers BSD, un objectif à terme est d’essayer de se rapprocher d’une de ces implémentations, mais on ne sait pas encore trop de laquelle. En tout cas, le code des I/O provient majoritairement de la glibc afin d’être très compatible avec ce qui était utilisé dans BeOS.

                  La fonction gmtime retourne une struct tm avec le champ tm_zone contenant la chaîne "GMT" (waddlesplash).

                  Correction de la conversion des "surrogate pairs" dans la fonction mbrtowc.

                  Mise en conformité de l’implémentation des threads avec POSIX :

                  • Ajustement de code d’erreurs retournés par les fonctions
                  • Suppression de la possibilité de retourner EINTR depuis un rwlock
                  • Correction de deadlocks dans les barriers
                  • Correction de plusieurs problèmes dans l’implémentation des sémaphores anonymes.

                  Mise en place systématique de l’utilisation de _DEFAULT_SOURCE pour protéger les extensions à la norme POSIX, ce qui permet de les activer automatiquement via l’inclusion de features.h lorsque c’est possible.

                  Nettoyage de quelques fichiers d’en-tête, dont en particulier <sys/select.h>, pour éviter de polluer l’espace global avec des macros et des définitions en double (waddlesplash).

                  Prise en compte correcte du drapeau O_NONBLOCK lors de l’ouverture d’un FIFO (korli).

                  runtime_loader

                  Le runtime_loader est le composant responsable du chargement en mémoire des exécutables et du lancement de nouveaux processus. Il réalise la résolution des dépendances et la recherche des bibliothèques partagées nécessaires pour l’exécution d’un programme.

                  Il reçoit des évolutions suite au portage d’applications complexes venues de Linux, qui nécessitent souvent plusieurs dizaines de bibliothèques partagées.

                  Correction de problèmes détectés en testant un portage expérimental et instable de Firefox: crash du runtime_loader dans certains cas si on charge une bibliothèque (via dlopen ou load_add_on) dont il manque des dépendances.

                  Retrait de l’option -fno-builtin dans les drapeaux de compilation du runtime_loader, comme cela avait déjà été fait pour la majorité de la libroot. Cela permet à gcc de remplacer des appels à des fonctions standardisées par une implémentation inline plus performante (waddlesplash).

                  Outils de debug

                  Développement d’outils pour enregistrer ce qu’il se passe pendant le démarrage du système et détecter d’éventuels problèmes de latence, de 'lock contention', etc. Au passage, correction de divers problèmes liés à ces outils : les barres de défilement de DebugAnalyzer, les permissions noyau dans transfer_area, etc.

                  Amélioration de la remontée des valeurs de retour des appels systèmes vers strace sur les plateformes x86 32-bit.

                  Pour terminer, un changement réalisé par mmlr : amélioration de l’allocateur mémoire "guarded heap" pour le rendre utilisable plus facilement, y compris comme allocateur pour tout le système. Cet allocateur permet de détecter les accès au-delà de la fin d’une zone mémoire allouée avec malloc(), ainsi que les accès à de la mémoire déjà libérée, mais au prix d’une consommation mémoire nettement plus élevée qu’un allocateur classique. La disponibilité d’un espace d’adressage de 64 bits permet de limiter les cas où une adresse mémoire est initialement utilisée pour une allocation, puis libérée et allouée à nouveau pour autre chose.

                  Un problème de gestion d’erreur dans l’interfaçage entre le Debugger et le noyau pouvait conduire à un gel complet du système dans certains cas de plantage du debug_server, en particulier s’il n’y a plus assez de mémoire RAM disponible.

                  Bootloader

                  Ajout d’une vérification manquante pour prendre en compte l’option « BlockedEntries » dans le bootloader. Cette option s’appelait précédemment « EntriesBlacklist » mais a été renommée pour utiliser un terme non entaché de racisme. L’ancien nom continue de fonctionner pour ne pas casser les installations existantes, mais n’est plus documenté.

                  Augmentation de la taille maximum autorisée pour les allocations « standard » sur la pile. L’allocateur mémoire du bootloader traite séparément les allocations de grande taille, mais ces allocations ne sont pas correctement libérées lors du transfert de contrôle vers le noyau, en particulier sur les machines utilisant un BIOS non EFI. Pour l’instant, une correction complète du problème semble compliquée à mettre en place, mais la modification permet de libérer de la mémoire allouée pour l’accès au packagefs (le bootloader a besoin d’y accéder pour trouver le noyau, qui est stocké dans un paquet). Ce changement permet de libérer plusieurs dizaines de Mio de mémoire, et complète les changements mentionnés plus haut sur la gestion des paquets après démarrage. Il est possible de configurer Haiku pour fonctionner avec moins de 100Mio de mémoire (waddlesplash).

                  Réparation de la ré-initialisation des ports série sur le bootloader EFI. Le port série est utilisé à des fins de debug, mais il peut être accédé de plusieurs façons différentes (en adressant directement le matériel, ou bien via des services EFI dédiés). Le bootloader doit passer d’une méthode à l’autre à différentes étapes du démarrage: accès direct au port physique dans les premières étapes (en détectant s’il est bien présent à une adresse standard), accès via les services EFI une fois ceux-ci initialisés, puis à nouveau accès direct au matériel après l’arrêt des services EFI pour la dernière étape de passage de contrôle au noyau (cette fois-ci à une adresse qui peut être configurée dans les options du bootloader et du noyau). Ce fonctionnement ne s’insère pas forcément très bien dans la logique du bootloader, qui n’avait à l’origine pas été conçu pour une gestion aussi complexe des entrées-sorties (VoloDroid).

                  Réduction de la quantité de logs liés à la mise en place de SMP (gestion de plusieurs processeurs) dans le bootloader pour BIOS (waddlesplash).

                  Le menu de démarrage affiche la version (numéro 'hrev') du paquet système correspondant à chaque point de restauration disponible, ce qui facilite l’identification des états qui correspondent à un changement de version du système, et pas une simple installation, désinstallation ou mise à jour de paquets logiciels (waddlesplash).

                  Documentation

                  Haiku Book

                  Le « Haiku Book » est un projet de documentation des APIs publiques de Haiku. Il doit à terme remplacer le « Be Book », qui documente les APIs de BeOS, mais ne peut pas être mis à jour à cause de se license CC BY-NC-ND. Actuellement, il faut jongler entre ces deux documentations.

                  La documentation de B_INFINITE_TIMEOUT (constante permettant d’indiquer à certaines fonctions qu’on veut les exécuter sans timeout, et attendre indéfiniment) a été mise à jour pour indiquer explicitement que sa valeur numérique est INT64_MAX (waddlesplash).

                  Correction de fautes de frappe dans la documentation des API liées aux entrées clavier (drea233).

                  Haiku Interface Guidelines

                  Ce document présente les bonnes pratiques et conventions pour la conception d’interfaces graphiques fonctionnant avec Haiku.

                  Ajout d’une section sur la gestion des fichiers récemment utilisés et la façon dont ils peuvent être exposés aux utilisateurs.

                  Wiki et documentation interne

                  Le wiki contient des informations utiles aux développeurs de Haiku.

                  La documentation « interne" documente le fonctionnement de Haiku en s’adressant principalement aux contributeurs du système, par opposition aux personnes qui souhaitent seulement développer ou porter des applications.

                  Mise à jour de la page « release cookbook » indiquant toutes les étapes à suivre lors de la publication d’une version de Haiku.

                  Notes d’administration système : mise à jour des instructions pour instancier des machines Google Cloud Platform (kallisti5).

                  Système de build, environnement de compilation

                  La compilation d’un système d’exploitation complet n’est pas chose facile. D’autant plus pour Haiku, qui présente les particularités suivantes:

                  • Utilisation de deux versions de gcc (gcc 2.95.3 et gcc 13) pour la version 32 bit de Haiku, afin d’assurer la compatibilité binaire avec BeOS,
                  • Possibilité de compilation croisée depuis Linux, Mac OS et d’autres systèmes, ou depuis un hôte Haiku,
                  • Compilation d’outils pour la machine hôte de la compilation croisée, avec si nécessaire une couche de compatibilité permettant d’écrire ces outils en utilisant des API et fonctionnalités spécifiques à Haiku,
                  • Possibilité de compiler des applications pour un système hôte existant (une autre version de Haiku) à des fins de test,
                  • Compilation d’un système complet (noyau, bibliothèques, applications, image disque) en une seule opération.

                  Pour ces raisons, l’utilisation d’un système de build haut niveau (CMake, Meson…) s’avère plutôt complexe. L’utilisation de make ou de ninja directement serait de trop bas niveau. Le choix de Haiku est donc d’utiliser l’outil jam, qui est malheureusement assez peu populaire et tombé à l’abandon dans sa version originale. Haiku maintient un fork de jam qui est concurrent de ceux maintenus par Boost et par Freetype.

                  Reformatage des fichiers Jamfile pour lister une seule cible par ligne au lieu de les rassembler, cela facilite les rebase et résolutions de conflits (x512).

                  Mise à jour de paquets en préparation pour la version beta 5: OpenSSL 3, Python 3.10, et autres mises à jour diverses (PulkoMandy, waddlesplash, kallisti5).

                  Ajout de l’inclusion de <features.h> dans <sched.h>. Le fichier d’en-tête features.h configure la visibilité des extensions GNU et BSD aux fichiers d’include standards C et POSIX, en fonction d’options de ligne de commande du compilateur. L’inclusion de ce fichier permet d’utiliser facilement et par défaut ces extensions (PulkoMandy).

                  Mise à jour des marque-pages fournis par défaut avec le navigateur WebPositive (waddlesplash).

                  Ajout des en-têtes de la bibliothèque linprog dans le paquet haiku_devel. Ces en-têtes sont nécessaires pour les applications associées au système de layout d’interfaces graphiques ALM (korli).

                  Correction de fautes de frappe dans des commentaires (jmairboeck) et d’un problème de compatibilité C89 dans un en-tête système (waddlesplash).

                  La taille des images « nightly build » de Haiku est maintenant de 650 Mo, ce qui laisse un peu plus de place disponible pour les utiliser et créer quelques fichiers (jscipione).

                  Diverses corrections pour une nouvelle fois essayer de faire fonctionner la compilation de Haiku avec Clang (waddlesplash, oanderso). Les choses en sont toujours au même point depuis plusieurs années, avec des corrections de temps en temps mais quelques parties du système qui ne fonctionnent toujours pas correctement.

                  La compilation du profil « nightly » n’a plus besoin de générer le paquet haiku_source contenant le code source de Haiku. Ce paquet est inclus uniquement dans les images de releases (pour faciliter le respect strict de la licence GPL de certains composants de Haiku), mais, pour des raisons de dépendances entre cibles dans le système de build, il était tout de même généré pour les autres profils, ralentissant la compilation (waddlesplash).

                  Améliorations du script ./configure (jessicah, OscarL et waddlesplash):

                  • Le script vérifie que les options passées fournies sont valides, et rejette immédiatement les configurations incohérentes plutôt que de laisser la compilation échouer bien plus loin.
                  • Validation que l’interpréteur Python sélectionné existe bien, et uniformisation de la syntaxe utilisée pour choisir un interpréteur avec la façon dont c’est fait pour d’autres outils.
                  • Détection des options disponibles pour demander à wget de ré-essayer un téléchargement en cas d’échec, ce qui permet d’assurer la compatibilité avec wget2.
                  • Utilisation automatique d’une version moderne de GCC pour compiler les outils « hôtes » lors de la compilation à partir d’une machine hôte fonctionnant sous Haiku en version 32 bit, en ignorant le compilateur par défaut qui est gcc 2 pour des raisons de compatibilité avec BeOS.

                  Réorganisation du code source de libroot pour déplacer les implémentations de malloc dans des sous-dossiers séparés, et faciliter l’expérimentation avec d’autres implémentations de malloc. L’allocateur hoard2 utilisé actuellement n’est pas adapté aux architectures 64 bits, une tentative a été faite il y a quelques années avec rpmalloc, mais ce dernier pose des problèmes sur les
                  architectures 32 bits. Des investigations sont en cours avec l’implémentation de malloc d’OpenBSD.

                  L’outil de dessin Wonderbrush est maintenant disponible sur toutes les architectures. Historiquement, le code de Wonderbrush n’était pas libre, mais une version gratuite était offerte aux utilisateurs de Haiku. Le développeur principal de Wonderbrush n’est plus très actif sur le projet et a décidé de publier les sources, ce qui a permis de recompiler le programme en version 64 bits et plus tard sur les autres architectures non x86. Mais ces nouvelles versions n’avaient jamais été incluses dans Haiku (PulkoMandy).

                  Nettoyage et centralisation des définitions préprocesseur pour la compatibilité avec BeOS. Désactivation de la compatibilité avec BeOS dans le noyau, la compatibilité avec les pilotes et modules noyau de BeOS n’étant plus assurée depuis quelque temps dans Haiku.

                  Suppression de définitions de règles obsolètes et inutilisées dans le Jamfile permettant de construire le fichier package_repo (CodeforEvolution).

                  Remise en service du test DiskDeviceManagerTest qui ne compilait plus (waddlesplash).

                  ARM & PowerPC

                  Actuellement, Haiku est disponible officiellement pour les architectures x86 32 et 64 bits. Une version RISC-V 64 bits expérimentale est également disponible mais pas encore totalement intégrée dans le dépôt de code principal, des discussions sont en cours sur la bonne façon de faire certains changements nécessaires. Les versions ARM (32 et 64 bits) et PowerPC sont les prochaines cibles sur la liste. La première, car c’est une architecture très populaire, la deuxième plutôt pour des raisons historiques : c’est l’une des architectures sur lesquelles fonctionne BeOS.

                  Renommage de structures qui étaient initialement spécifiques à l’architecture x86, mais qui sont finalement utilisées également sur d’autres CPU sans nécessiter de changements (waddlesplash).

                  Réparation de la console de texte du chargeur de démarrage OpenFirmware qui était cassée depuis l’adaptation pour OpenBOOT sur les machines SPARC (zeldakatze).

                  Sur ARM, utilisation de la bonne instruction CPU pour mettre le processeur en veille quand il n’y a rien à faire (archeYR).

                  oanderso continue le travail sur le portage ARM64:

                  • Correction de plusieurs problèmes liés à la gestion du cache et de la MMU dans le bootloader, ce qui permet de démarrer le noyau dans une machine virtuelle sur un hôte Apple M1.
                  • Correction de l’implémentation des timers dans le kernel qui ne fonctionnait pas dans les environnements virtualisés.
                  • Quelques avancées sur la gestion de la MMU : Implémentation de la table de translation de la mémoire virtuelle, du traitement des exceptions matérielles (défauts de page), des TLBs.
                  • Synchronisation du cache d’instructions.
                  • Correction de problèmes de double lock.

                  Ajout de messages sur le port série traçant l’exécution de méthodes spécifiques à une architecture qui ne sont pas encore implémentées. Ceci permet de détecter facilement quelle est la prochaine fonction à implémenter (waddlesplash).

                  Nettoyage et documentation du fichier ArchitectureRules pour simplifier la configuration des options en ligne de commande du compilateur (qui doit savoir traiter deux versions de gcc et clang) (waddlesplash).

                  Commentaires : voir le flux Atom ouvrir dans le navigateur

                  Dons aux associations, épisode 13

                  Cette dépêche est la treizième de sa série, après celles de 2011, 2013, 2014, 2015, 2016, 2017, 2018, 2019, 2020, 2021, 2022 et 2023. Elle tient compte des suggestions des années passées.

                  Montre ton amour au Libre

                  Bissextile ou pas, cette année encore, je m’adresse à toi libriste, qui procrastine en se disant qu’il reste quasi tout décembre pour faire des dons en 2024, déductibles des impôts ou non. Toute l’année on escompte soutenir telle ou telle action sur tel ou tel sujet qui nous méritait vraiment, car c’est important. Donnons quelques exemples d’associations de promotion et défense du Libre, des droits dans l’espace numérique ou de la liberté d’expression, dont les dons sont déductibles en France : Acrimed, Amnesty France, Basta!, Debian France, Disclose, Framasoft (20 ans <3), Fédération internationale pour les droits humains (FIDH), Fonds pour une Presse Libre, Libre à Toi / Radio Cause Commune, Ligue des Droits de l’Homme (LDH), Open Food Facts, OpenStreetMap France, Politis, Reporterre, Reporters Sans Frontières (RSF), Wikimédia France, (qui n’est pas la Wikimedia Foundation états-unienne qui collecte aussi des dons), etc. Ce premier mardi de décembre (jour de rédaction de cette dépêche) est aussi le Giving Tuesday (aussi appelée journée mondiale de la générosité et de la solidarité).
                    Sommaire

                    Et comme tu fais vivre les principes du Libre, que tu contribues à des projets libres et défends des idées, tu soutiens aussi des associations ne bénéficiant pas de la déductibilité des dons en France (par exemple, des associations jugées trop dérangeantes ou trop critiques par le gouvernement… ou des associations européennes ou non, voire des associations n’ayant jamais fait la démarche, comme LinuxFr). Citons par exemple AFUL, April, Debian CH (déductible en Suisse), European Digital Rights (EDRi), En Vente Libre, Exodus Privacy, FACIL, FFII, FreeBSD Foundation, FSF (avec une longue liste de méthodes pour donner), FSFE (déductibilité dans plusieurs pays), Paheko, GNOME et GIMP, Haiku (déductible aux États‐Unis), IHateMoney, Internet Archive (déductible aux États‐Unis), KDE e.V (déductible en Allemagne), Léa-Linux, LILA, LQDN, Mageia, Nos Oignons, noyb, OKFN, PHP Foundation, SlackBuild.org, Tails (déductible en Allemagne), TechInquiry (déductible aux États-Unis), Toile Libre, Tor (déductible aux États-Unis et en Europe], Ubuntu-Fr, XSF, etc. (notez qu’elles peuvent parfois avoir la déductibilité des dons dans d’autres pays, voir la décision C-318/07 mentionnée plus bas).

                    Cette dépêche récurrente vit aussi grâce à vos remarques, propositions d’ajouts, de compléments et vos retours sur les systèmes fiscaux et les dons dans vos pays respectifs. N’hésitez pas à la commenter pour l’enrichir. Bien que récurrente, cette dépêche est mise à jour et enrichie chaque année.

                    Précision : la dépêche parle bien de « don » (je soutiens sans rien obtenir à titre personnel), pas de « financement participatif avec contrepartie » (je cofinance en échange de goodies ou avantages), les deux étant destinés à des choses différentes. Si vous avez lu jusqu’ici, un dessin xkcd sur le sujet en récompense (et d’autres images plus loin pour récompenser les libristes patients qui liront jusqu’au bout).

                    Pourquoi les associations ayant des permanents ont des besoins récurrents d’argent ? (tiré de l’épisode 12 mais mis à jour)

                    Quand une association veut passer de zéro à un permanent ou à un permanent de plus, elle n’a généralement pas en réserve de quoi le payer sur une année complète. Elle prend donc un risque avec une visibilité sur x mois (comme n’importe quel chef d’entreprise), en faisant de son mieux pour que l’argent rentre (le nouveau permanent va « produire », une campagne de communication ou d’appel à don ou autres sera lancée, une subvention sera recherchée, une convention sera signée avec tel ou tel, des goodies seront vendus, etc.).

                    Soutenez Framasoft, parce que le Libre n’est pas qu’une question de logiciel

                    Une association qui ne veut pas s’embêter à rechercher des fonds ou qui ne vise pas à passer le cap du premier permanent n’a pas du tout ce souci et peut être très indolente si elle veut.

                    Dès qu’il y a un besoin récurrent de payer des salariés, de payer à date les charges de l’employeur — qu’il faut prévoir à trois mois s’il faut gérer un préavis de licenciement économique ou pas, etc. —, cela devient plus compliqué (comme pour n’importe quel chef d’entreprise). Une association militante qui ne prendrait pas de risque financier du tout, ce n’est pas envisageable à mon avis. Toute la question étant de savoir combien elle réussit à faire rentrer d’argent au moment où c’est nécessaire, si elle peut continuer à embaucher pour grossir, faire plus d’actions ou faire mieux, si elle doit licencier, ou bien si elle doit stagner ou continuer ainsi dans l’immédiat.

                    Donc, oui, on a toujours l’impression que les associations ayant des permanents recherchent de l’argent (et décembre est particulier, car c’est la fin de l’exercice fiscal et traditionnellement la période des dons défiscalisés, notamment côté humanitaire associé aux bons sentiments des fêtes de fin d’année). Et oui, en décembre, la Croix Rouge ou le Secours Populaire, April, RSF, LQDN, la FSF, Amnesty, Framasoft et bien d’autres font des appels à don.

                    Soutenons La Quadrature du Net !

                    En dehors de la simple mais cruciale question de la trésorerie (pérennité / continuité), il y a bien évidemment aussi les projets et actions futures à financer. Citons par exemple la justification de Framasoft (une dizaine de permanents) en six points :

                    1. parce que l’enfermement, c’est maintenant ;
                    2. pour plus d’alternatives libres ;
                    3. parce que les gentils, c’est nous !
                    4. pour décider où vont vos impôts (avec défiscalisation) ;
                    5. parce que l’économie du don rend indépendant ;
                    6. pour changer le monde ensemble.

                    Quelques chiffres : « Chacun s’accorde pour estimer que près de 90% des associations fonctionnent exclusivement grâce à leurs bénévoles. Vitale dans ces associations, cette ressource humaine reste essentielle dans les 10 à 12% d’associations employant des salariés »
                    « en 2022, l’emploi privé non lucratif au sein des associations et des fondations représente plus de 155 000 employeurs, plus de 2 millions de salariés, soit 9,5% du total des salariés du secteur privé, et une masse salariale de plus de 54,4 milliards d’euros (près de 7% de la masse salariale du secteur privé) » (Recherche et Solidarités)

                    Et sur l’évolution des bénévoles et du mécénat de compétences :

                    « Les 25-34 ans sont de plus en plus nombreux à s’engager (30% en 2024 pour 22% en 2019), quand les 70 ans et plus perdent 10 points pour n’être que 24% aujourd’hui. »
                    « En 2024, 9% des Français sont présents chaque semaine dans leurs associations, ils étaient 10% en 2019 et 12,5% en 2010. »
                    « Ces tendances fragilisent la colonne vertébrale des associations, à savoir celles et ceux qui les font vivre au quotidien qui se trouvent privées de l’expérience et de la disponibilité des seniors »
                    « Parmi les perspectives positives, le mécénat de compétences poursuit sa percée avec 27% de bénévoles tentés par l’expérience en 2024 ; ils étaient 23% en 2022 et 20% en 2019. » (Recherche et Solidarités et France Générosités)

                    Petit rappel sur les impôts en France (tiré de l’épisode 10 mais mis à jour)

                    • l’article 200 du Code général des impôts prévoit pour un particulier une déduction fiscale de 66 % (réduction d’impôt sur le revenu dans la limite de 20 % du revenu imposable, reportable sur cinq ans en cas de dépassement de ce plafond) des dons vers les associations d’intérêt général ou reconnues d’utilité publique ; ce pourcentage monte même à 75 % pour les organismes d’aide aux personnes en difficulté (dans la limite de 521 €, au‐delà, on retombe sur les 66 %) ;
                    • l’article 238 bis du CGI prévoit une déduction fiscale de 60 % des dons pour une entreprise (réduction d’impôt sur le revenu ou d’impôt sur les sociétés dans la limite de 5 ‰ du chiffre d’affaires hors taxes, reportable sur cinq ans en cas de dépassement de ce plafond) vers les associations d’intérêt général ou reconnues d’utilité publique ;
                    • fiche pratique ServicePublic.fr : « À noter : l’organisme peut être en France ou dans un État membre de l’Union européenne : Allemagne, Autriche, Belgique, Bulgarie, Chypre, Croatie, Danemark, Espagne, Estonie, Finlande, France, Grèce, Hongrie, Irlande, Italie, Lituanie, Lettonie, Luxembourg, Malte, Pays-Bas, Pologne, Portugal, République tchèque, Roumanie, Slovaquie, Slovénie, Suède, en Islande, en Norvège ou au Liechtenstein. S’il n’est pas agréé, vous devez justifier qu’il a un objectif et des caractéristiques similaires aux organismes situés en France et pouvant bénéficier du dispositif. »
                    • loi n° 2021-1109 du 24 août 2021 : « Art. 222 bis.-A l’exception de ceux mentionnés au 3 de l’article 200, les organismes qui délivrent des reçus, des attestations ou tous autres documents par lesquels ils indiquent à un contribuable qu’il est en droit de bénéficier des réductions d’impôt prévues aux articles 200,238 bis et 978 sont tenus de déclarer chaque année à l’administration fiscale, dans les délais prévus à l’article 223, le montant global des dons et versements mentionnés sur ces documents et perçus au cours de l’année civile précédente ou au cours du dernier exercice clos s’il ne coïncide pas avec l’année civile ainsi que le nombre de documents délivrés au cours de cette période ou de cet exercice. »
                    France générosités mentionne des évolutions récentes (juillet 2024), notamment le fait que les dons des particuliers aux organismes d’intérêt général qui concourent à l’égalité entre les femmes et les hommes ouvrent droit à réduction d’impôt et la prorogation jusqu’au 31 décembre 2026 du plafond dérogatoire de 1 000 € applicable aux dons retenus pour la réduction d’impôt de 75 % accordée au titre des dons versés aux organismes qui apportent une aide gratuite aux personnes en difficulté.

                    Exemple pour un particulier : je suis imposable et donne 99 € à l’association XYZ bénéficiant de la déductibilité des dons à hauteur de 66 %. Mon don me coûte en fait (au final) 33 €, j’ai temporairement avancé 66 € qui seront ensuite déduits de mon imposition fiscale (dit autrement, j’ai choisi l’attribution de 66 € du budget de l’État).

                    Soutenir Framasoft

                    Autres infos :

                    Les dons en France (tiré de l’épisode 11 mais mis à jour)

                    « 51 % des Français déclarent avoir donné au moins une fois en 2023 à une fondation ou à un organisme caritatif (+1 point par rapport à 2022). »

                    (Baromètre de la solidarité 2024)

                    « En 2023, la générosité des Français tient bon dans un contexte encore difficile, avec une progression de 2,1% des dons par rapport à 2022 en euros courants. » (ainsi que la « poursuite de la baisse des petits dons » et un « focus sur les urgences médiatisées »)

                    (Baromètre de la générosité 2023)

                    « l’augmentation des investissements est aussi due à des coûts d’acquisition en hausse (+ 28%) en raison d’une concurrence accrue pour atteindre 33 € de coût d’acquisition moyen par donateur sur les campagnes de fin d’année (CFA) 2022 du panel de l’étude mais pour un don moyen de 172 € (+ 10%). »
                    (Baromètre Orixa Fundraising 2023)

                    « L’étude de Recherches & Solidarités montre une progression de 6,3% du montant total des dons déclarés au titre de l’IR en 2022 par rapport à 2021.
                    L’étude de Recherches & Solidarités montre une progression de 3,9% du nombre de foyers fiscaux donateurs en 2022 par rapport à 2021. »
                    (Étude 2023 sur les dons déclarés 2022 – Recherches & Solidarités)

                    « en 2022 : en moyenne, les donateurs de 35-54 ans correspondent à une pénétration de 5,5% des Français de cette tranche d’âge. Soit le plus faible taux comparé aux autres tranches d’âge. » (Étude sur le don des 35-54 ans – France)
                    Admincal indique que « seulement 4,61 % des entreprises assujettis à l’Impôt sur les Sociétés (IS) déduisent des dons du mécénat ».

                    Selon Infodon.fr (via une enquête Ifop pour France générosités, réalisée sur un échantillon représentatif de la population française (4031 personnes) – Mai 2023)
                    « 69% des Français déclarent soutenir financièrement assos et fondations, « 46 % donnent au moins une fois par an ». À comparer avec les chiffres donnés en 2022 (72% 48%), 2021 (58%, 45%) et 2020 (52%, 40%).

                    Petit rappel sur les impôts d’autres pays (tiré de l’épisode 12 mais mis à jour)

                    Forcément, je connais mieux le sujet pour la France, mais voici néanmoins quelques infos glanées pour d’autres pays (et je ne doute pas que les visiteurs compléteront dans les commentaires) :

                    Exemple de dons (source)

                    Exemple de dons financiers et parfois de temps

                    « Sacrifier une partie de son revenu pour faire un don à une association, c’est une affaire sérieuse. » (patrick_g)
                    Liste non exhaustive de dons financiers ou de temps à des associations du Libre ou pour libérer quelque chose :

                    Pour les exemples plus ou moins exhaustifs sur les 11 premières années de cette série de dépêches, voir la section de l’année 2022

                    Exemple de dons de matériel ou ressources

                    Pour les exemples plus ou moins exhaustifs sur les 11 premières années de cette série de dépêches, voir la section de l’année 2022.

                    Johann « nojhan » — CC-BY-SA-fr, LAL, GFDL

                    Diffusion des idées et questionnements autour du don

                    Pour les exemples plus ou moins exhaustifs sur les 11 premières années de cette série de dépêches, voir la section de l’année passée.

                    Lettre au Père Noël — Clément Clem Quaquin — Licence Art libre

                    Don à une entreprise ? (tiré de l’épisode 11 mais mis à jour)

                    Une question un peu annexe ici vu le titre « dons aux associations » mais qui a déjà été posée ici ou sur LinuxFr.org : peut‐on faire un don (sans contrepartie) à une entreprise ? Pour prendre quelques sites que j’aime bien : Next.ink anciennement Next INpact (SARL de presse) a opté pour un mélange de comptes premium (avec contrepartie, donc), publicités et dons. Voir les appels à dons 2023 pour le Fonds pour une presse libre ou Next.ink par exemple). Tandis que Reflets.info (SAS) accepte les dons.

                    Lors d’une recherche rapide précédente, j’avais vu évoquer l’utilisation du compte 7713 « libéralités perçues » du plan comptable, d’un justificatif clair pour la comptabilité (un expert comptable et/ou un notaire sont évoqués), d’une exonération de TVA si aucune vente de bien ou de service n’est associée. Bref, la question des taxes et impôts à payer pour le donateur (60 % entre non‐parents ?) et l’entreprise n’est pas forcément claire. Cela reste assez flou et hypothétique, et ça mériterait une question aux impôts.

                    « Oups, j’ai procrastiné sur mes dons » généré avec https://framalab.org/gknd-creator/.

                    Logiciels libres pour gérer les dons (tiré de l’épisode 12 mais mis à jour)

                    La question avait été posée lors de l’épisode 3 de cette série de dépêches : quel(s) logiciel(s) libre(s) utiliser pour faire les dons ? Ou pour les gérer ? En général, pour les faire, un navigateur fait l’affaire : paiement en ligne, réception de l’éventuel reçu fiscal, réception d’un éventuel message de remerciement.

                    Pour les reçus fiscaux, il convient de les conserver avec les documents des impôts pendant le temps nécessaire (suivant la législation locale).

                    Pour les dons via des intermédiaires, par exemple Liberapay ou HelloAsso, il faut conserver soigneusement les identifiants du compte créé pour l’année suivante.

                    Si vous avez opté pour l’adhésion à une structure plutôt que le don, vous allez recevoir des identifiants aussi et probablement une lettre interne ou des choses du genre, ainsi que certainement une convocation à une assemblée générale annuelle.

                    Et si vous avez opté pour versement régulier (virement ou prélèvement), ça ne change pas fondamentalement les choses ; éventuellement, l’organisme qui prélève vous prévient un peu avant chaque prélèvement par courriel.

                    Il existe aussi dans le Libre des logiciels ou des événements spécialement prévus pour les dons :

                    À ma connaissance, le site HelloAsso, structure ayant obtenu son agrément « Entreprise solidaire d’utilité sociale », évoqué dans un commentaire de 2015, n’utilise pas une plate‑forme libre, contrairement à Liberapay.

                    Commentaires : voir le flux Atom ouvrir dans le navigateur

                    ❌