Connexion

Comment l’IA peut nous aider à dresser le portrait de la population parisienne d’il y a 100 ans

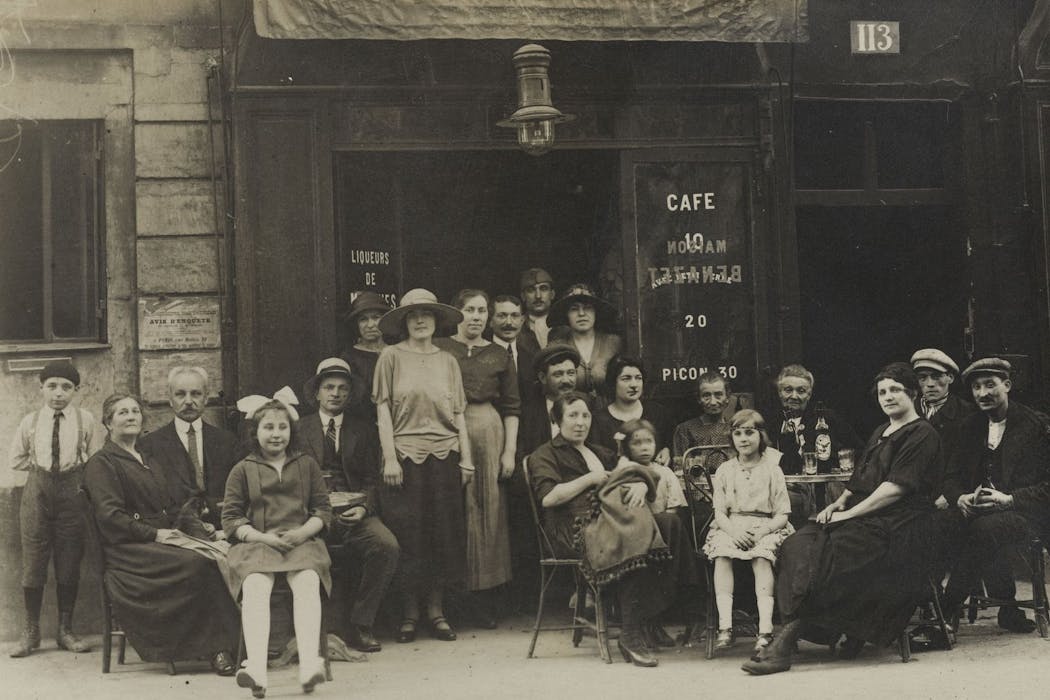
L’exposition « Les gens de Paris, 1926-1936. Dans le miroir des recensements de population », qui se tient actuellement, et jusqu’au 8 février 2026, au musée Carnavalet-Histoire de Paris, s’appuie sur les recensements de la population parisienne de 1926, de 1931 et de 1936, et contribue à renouveler le regard sur le peuple de la capitale dans l’entre-deux-guerres.
En France, des opérations de recensement sont organisées dès 1801, mais ce n’est qu’à partir de 1836 que des instructions spécifiques sont fournies pour procéder de manière uniforme dans toutes les communes du pays. Le recensement de la population est alors organisé tous les cinq ans, les années se terminant en 1 et en 6, jusqu’en 1946, à l’exception de celui de 1871 qui est reporté à l’année suivante en raison de la guerre franco-prussienne, et de ceux de 1916 et de 1941 qui ne sont pas organisés à cause des deux guerres mondiales.
Des données précieuses sur la population parisienne
Le premier but des recensements de la population est de connaître la taille des populations des communes pour l’application d’un certain nombre de lois. Ils permettent également de recueillir des informations sur l’ensemble des individus résidant dans le pays à un instant t pour en connaître la structure. Ces statistiques sont dressées à partir des bulletins individuels et/ou (selon les années) des feuilles de ménage (les feuilles de ménages récapitulent les individus vivant dans le même ménage et leurs liens au chef de ménage) remplies par les individus et publiées dans des publications spécifiques intitulées « résultats statistiques du recensement de la population ».
En plus de ces statistiques, les maires doivent également dresser une liste nominative de la population de leur commune. Mais Paris avait obtenu le droit de ne pas dresser ces listes. C’est le chef du bureau de la statistique parisienne, M. Lambert, qui décide de revenir sur cette exception dès 1926. Les listes nominatives de 1926, de 1931 et de 1936 sont donc les seules, avec celle de 1946, à exister pour la population parisienne.
Si Paris avait obtenu le droit de ne pas dresser ces listes, c’est en raison du coût d’une telle opération pour une population si vaste. La population parisienne compte, en effet, déjà près de 1,7 million d’habitants en 1861, un million de plus en 1901 et atteint son pic en 1921 avec 2,9 millions d’individus. Les données contenues dans ces listes sont particulièrement intéressantes, car elles permettent d’affiner considérablement les statistiques dressées pendant l’entre-deux-guerres.
Une base de données conçue grâce à l’IA
Ces listes, conservées aux Archives de Paris et numérisées puis mises en ligne depuis une dizaine d’années, ont déjà intéressé des chercheurs qui se sont appuyés dessus, par exemple, pour comprendre l’évolution d’une rue ou d’un quartier, mais elles n’avaient jamais été utilisées dans leur ensemble en raison du volume qui rend impossible leur dépouillement pour un chercheur isolé. Voulant également travailler à partir de ces listes – au départ, pour travailler sur la structure des ménages et notamment sur les divorcés –, j’avais moi aussi débuté le dépouillement à la main de certains quartiers.
La rencontre avec les informaticiens du Laboratoire d’informatique, de traitement de l’information et des systèmes (LITIS), Thierry Paquet, Thomas Constum, Pierrick Tranouez et Nicolas Kempf, spécialistes de l’intelligence artificielle, a changé la donne puisque nous avons entrepris de créer une base de données à partir de l’ensemble des listes nominatives de la population parisienne de 1926, de 1931 et de 1936 dans le cadre du projet POPP. Les 50 000 images, qui avaient déjà été numérisées par les Archives de Paris, ont été traitées par les outils d’apprentissage profond et de reconnaissance optique des caractères développés au LITIS pour créer une première base de données.
Les erreurs de cette première base « brute » étaient déjà très faibles, mais nous avons ensuite, avec l’équipe de sciences humaines et sociales – composée de Victor Gay (École d’économie de Toulouse, Université Toulouse Capitole), Marion Leturcq (Ined), Yoann Doignon (CNRS, Idées), Baptiste Coulmont (ENS Paris-Saclay), Mariia Buidze (CNRS, Progedo), Jean-Luc Pinol (ENS Lyon, Larhra) –, tout de même essayé de corriger au maximum les erreurs de lecture de la machine ou les décalages de colonnes. Ces corrections ont été effectuées de manière automatique, c’est-à-dire qu’elles ont été écrites dans un script informatique permettant leur reproductibilité. Ainsi, nous avons par exemple modifié les professions apparaissant comme « benne » en « bonne » ou bien les « fnène » en « frère ».
Adapter la base à l’analyse statistique
Il a ensuite fallu adapter la base à l’analyse statistique. Les listes nominatives n’avaient, en effet, pas pour vocation d’être utilisées pour des traitements statistiques puisque ces derniers avaient été établis directement à partir des bulletins individuels et des feuilles de ménage. Or, l’analyse statistique requiert que les mots signalant la même entité soient inscrits de la même façon. Cette difficulté est exacerbée dans le cas des listes nominatives : les agents avaient peu de place pour écrire, car les colonnes sont étroites. Ils utilisaient donc des abréviations, notamment pour les mots les plus longs comme les départements de naissance ou les professions.
Nous avons dû par conséquent uniformiser la manière d’écrire l’ensemble des professions, des départements ou des pays de naissance, des situations dans le ménage et des prénoms. Pour ce faire, nous nous sommes appuyés sur différents dictionnaires, c’est-à-dire des listes de mots correspondant à la variable traitée provenant de recherches antérieures ou d’autres bases de données. Ainsi, pour corriger les prénoms, Baptiste Coulmont, qui a travaillé sur cette partie de la base a utilisé les bases Insee des prénoms et des personnes décédées. Marion Leturcq et Victor Gay ont, par ailleurs, utilisé les listes des départements français, des colonies et des pays étrangers, tels qu’ils étaient appelés pendant l’entre-deux-guerres, ou encore la nomenclature des professions utilisées par la Statistique générale de la France (SGF).
Enfin, nous avons créé des variables qui manquaient pour l’analyse statistique que nous souhaitions mener, comme la variable « sexe » qui n’existe pas dans les listes nominatives (alors que le renseignement apparaît dans les fiches individuelles), ou encore délimiter les ménages afin d’en comprendre la composition. Ce travail de correction et d’adaptation de la base est encore en cours, car nous travaillons actuellement à l’ajout d’une nomenclature des professions – afin de permettre une analyse par groupes professionnels –, ou encore à la création du système d’information géographique (SIG) de la base pour réaliser la géolocalisation de chaque immeuble dans la ville.
Retrouver des ancêtres
La base POPP ainsi créée a déjà été utilisée à différentes fins. Une partie de la base (comprenant les noms de famille – qui, eux, n’ont pas été corrigés –, les prénoms et les adresses) a été reversée aux Archives de Paris pour permettre la recherche nominative dans les images numérisées des listes nominatives. Ce nouvel outil mis en place au début du mois d’octobre 2025 – et également proposé en consultation au sein de l’exposition « Les gens de Paris, 1926-1936. Dans le miroir des recensements de population » – a déjà permis à de nombreuses personnes de retrouver leurs ancêtres.
Il nous a également été possible de fournir les premiers résultats tirés de la base POPP (confrontés aux résultats statistiques des recensements publiés) pour dresser des données de cadrage apparaissant sous forme d’infographies dans l’exposition (créées par Clara Dealberto et Jules Grandin). Ces résultats apparaissent également avec une perspective plus comparative dans une publication intitulée « Paris il y a 100 ans : une population plus nombreuse qu’aujourd’hui et déjà originaire d’ailleurs » (Ined, septembre 2025).
L’heure est maintenant à l’exploitation scientifique de la base POPP par l’équipe du projet dont le but est de dresser le portrait de la population parisienne à partir des données disponibles dans les listes nominatives des recensements de la population, en explorant les structures par sexe et âge, profession, état matrimonial, origine, ou encore la composition des ménages des différents quartiers de la ville.
L’autrice remercie les deux autres commissaires de l’exposition « Les gens de Paris, 1926-1936. Dans le miroir des recensements de population » Valérie Guillaume, directrice du musée Carnavalet – Histoire de Paris, et Hélène Ducaté, chargée de mission scientifique au musée Carnavalet – Histoire de Paris et les Archives de Paris.
Sandra Brée a reçu des financements du CollEx-Persée, de Progedo, de l'humathèque du Campus-Condorcet et du CNRS.