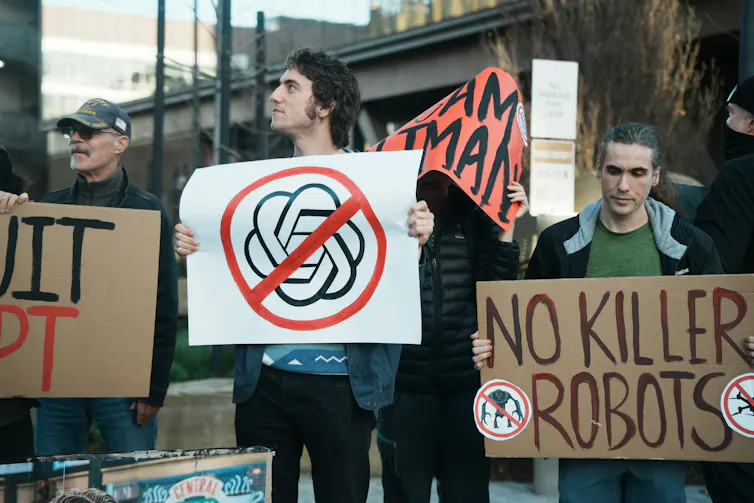En janvier 2013, le lac Michigan atteignait le niveau d’eau le plus bas jamais enregistré. Sept ans plus tard, à l’été 2020, il battait des records inverses : inondations répandues, berges arrachées, routes riveraines fermées. Entre ces deux extrêmes, près de deux mètres. Les lacs Supérieur, Érié et Ontario ont connu le même retournement à quelques mois près. Presque personne ne l’avait vu venir.
Ces basculements se préparent pendant des mois, dans un mélange de pluie, de neige, d’évaporation
En janvier 2013, le lac Michigan atteignait le niveau d’eau le plus bas jamais enregistré. Sept ans plus tard, à l’été 2020, il battait des records inverses : inondations répandues, berges arrachées, routes riveraines fermées. Entre ces deux extrêmes, près de deux mètres. Les lacs Supérieur, Érié et Ontario ont connu le même retournement à quelques mois près. Presque personne ne l’avait vu venir.
Ces basculements se préparent pendant des mois, dans un mélange de pluie, de neige, d’évaporation et de décisions humaines. Démêler ce mélange reste l’un des problèmes les plus tenaces dans le domaine de l’hydrologie, et l’un des plus importants. Le niveau d’eau contrôle la profondeur des ports, la stabilité des berges, les prises d’eau potable et la survie des milieux humides côtiers.
Le but n’était pas seulement de prédire les niveaux d’eau, mais d’utiliser l’IA de façon à expliquer ce qui les fait varier.
Une machine qui devine, mais n’explique rien
Pendant des décennies, on traitait la balance hydrologique comme un compte bancaire : on additionne les dépôts (pluie, ruissellement, apports de l’amont), on soustrait les retraits (évaporation, débits sortants), et le solde donne le niveau d’eau. L’approche est rigoureuse, mais elle nécessite une longue calibration et ne capture pas précisément les écarts inhabituels du climat.
L’apprentissage automatique par l’IA fait l’inverse : on lui fournit quarante ans de données et il en extrait les régularités grâce à un algorithme. Un algorithme consiste en une série de calculs qui transforme les chiffres reçus en une estimation du niveau d’eau et se corrige s’il s’écarte des mesures.
On gagne en précision, mais le résultat arrive sans explications, lesquelles sont nécessaires si le résultat sert à gérer un barrage ou à cartographier des zones inondables.
Demander des comptes à la machine
Pour régler ce problème, nous avons entraîné huit algorithmes sur les niveaux d’eau mensuels des lacs Supérieur, Michigan, Érié et Ontario, de 1982 à 2022. Nous avons incorporé neuf variables dans chaque algorithme, comme la température de l’air et les débits d’apports en eau.
Chaque variable était fournie pour le mois en cours, mais aussi pour un mois plus tôt, deux mois plus tôt, jusqu’à six mois en arrière. Ce faisant, le modèle pouvait relier le niveau d’eau de juin à la neige tombée en janvier.
Pour les quatre algorithmes les plus performants, l’erreur descendait à une douzaine de centimètres, contre 14 à 21 pour les modèles les plus simples.
Puis, nous l’avons forcé à se justifier avec les valeurs de Shapley (SHAP), une technique issue de la théorie des jeux qui répartit équitablement le gain d’une équipe entre ses joueurs. Ici, elle donne la contribution de chaque variable dans la hausse ou la baisse du niveau d’eau, pour un mois donné. Autrement dit, est-ce les températures de l’air ou bien les débits entrants qui sont plus importants pour contrôler le niveau d’eau ?
Mais SHAP ne renseigne pas sur la durée qu’un signal met à traverser un bassin versant.
D’où une seconde technique, l’analyse variographique des surfaces de réponse (VARS). Au lieu d’observer le modèle, on le perturbe, par exemple en augmentant le ruissellement comme le ferait une fonte hâtive des neiges. On mesure l’impact de cette perturbation un mois plus tard, puis six mois.
Ensemble, SHAP et VARS donnent les variables coupables du niveau d’eau et leur délai d’action.
Les lacs Supérieur et Michigan sont de grandes cuves lentes nourries par la fonte des neiges dont le niveau d’eau dépend du ruissellement et des débits sortants. Le lac Érié, peu profond, dépend de ce qui lui arrive de l’amont par la rivière Détroit. Quant au lac Ontario, il se distingue par le poids de l’évaporation.
En appliquant la même méthode avec les mêmes variables, nous avons obtenu quatre réponses différentes étant donné ces caractéristiques.
Le résultat le plus frappant de notre étude concerne le temps. On s’attendait à voir l’influence des variables s’estomper à mesure qu’on remonte dans le passé, comme dans une rivière où l’averse s’oublie en quelques jours. C’est l’inverse : elle grandit après trois ou quatre mois.
Un lac ne réagit donc pas à la météo d’hier, mais à celle de la saison précédente. Ces lacs ont une forte inertie, et c’est une bonne nouvelle pour la prévision saisonnière : une partie de ce qui fera le niveau de l’été prochain est déjà tombée, sous forme de neige.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
Le lac le plus imprévisible est celui qu’on contrôle
Un lac a tenu tête à nos algorithmes : le lac Ontario, avec une erreur supérieure de moitié, due à des décisions humaines.
En effet, ses niveaux d’eau sont réglés au barrage Moses-Saunders, selon des règles d’exploitation ajustées au jour le jour. Dans notre modèle, chaque variable est résumée par une seule valeur mensuelle. Ainsi, le débit sortant du barrage figure bien dans nos données, mais la succession de décisions humaines qui l’a produit disparaît dans le calcul de la moyenne.
Lorsque davantage d’eau est relâchée pour protéger les riverains en aval, alors que le climat ne l’imposait pas, le modèle voit un niveau qui chute sans cause repérable parmi ses variables. Il apprend mal, et se trompe davantage.
Cet échec montre une limitation entre ce que le climat explique et ce qui relève de nos décisions collectives. La solution est simple : il faut fournir ces règles au modèle, au même titre que la pluie ou la neige. Ainsi, les algorithmes cesseront de prendre nos décisions pour des données aberrantes.
Au-delà des Grands Lacs
Les applications de notre approche vont aussi au-delà des Grands Lacs et des eaux de surface.
Avec Ouranos, le consortium québécois sur la climatologie régionale et l’adaptation aux changements climatiques, nous appliquons maintenant cette approche à la recharge des eaux souterraines du Québec méridional, cette fois avec un modèle informé par la physique.
Un modèle interprétable est un modèle qu’on peut vérifier, discuter et contredire. C’est la condition pour que l’IA devienne un instrument légitime dans la gestion de l’eau.
Rahim Barzegar a reçu des financements de l'Université du Québec en Abitibi-Témiscamingue (UQAT).
Ehsan Raei et Jan Franklin Adamowski ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur poste universitaire.
L’ESSENTIEL
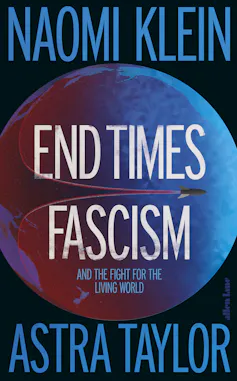
Naomi Klein et Astra Taylor décrivent dans un nouveau livre un Fascisme de la fin des temps qui considère l’effondrement comme inévitable et mise sur la survie d’une élite.
Dans The Nerd Reich, Gil Durán enquête sur les milliardaires de la Silicon Valley qui mettent leur fortune et les technologies au service de projets autoritaires.
Les deux ouvrages interrogent ainsi le technofascisme : la manière dont l’IA, les algorithmes et les plateformes transforment et diffusent les idéol
Naomi Klein et Astra Taylor décrivent dans un nouveau livre un Fascisme de la fin des temps qui considère l’effondrement comme inévitable et mise sur la survie d’une élite.
Dans The Nerd Reich, Gil Durán enquête sur les milliardaires de la Silicon Valley qui mettent leur fortune et les technologies au service de projets autoritaires.
Les deux ouvrages interrogent ainsi le technofascisme : la manière dont l’IA, les algorithmes et les plateformes transforment et diffusent les idéologies fascistes.
« L’heure de vérité a sonné pour l’Occident », peut-on lire dans une récente annonce de recrutement de Palantir. Cette entreprise de la Silicon Valley fournit de plus en plus de services de « renseignement » fondés sur les données aux services de renseignement, à la police et aux armées, mais aussi à de grandes entreprises et à des organisations à but non lucratif. « Dans les usines, les blocs opératoires et sur les champs de bataille, proclame l’annonce, nous bâtissons pour dominer. »
Comment comprendre cette convergence entre technologies de pointe et violence assumée, entre une intelligence artificielle « rationnelle » et une vision primitive du monde qui semble renouer avec le langage du sang et du sol, des amis et des ennemis, du « nous » et du « eux » ? Dans les tribunes, les émissions-débats et les analyses politiques, un mot s’est imposé : fascisme.
En tant que terme, le « fascisme » est éminemment provocateur, mais semble appartenir à une autre époque. Il évoque les images saisissantes de foules de partisans en bottes martelant le sol, répétant les mêmes slogans et reproduisant les mêmes saluts, sous des bannières aux lettres noires et aux couleurs rouge sang. Pourtant, ces images sont généralement associées aux régimes politiques de l’Europe de l’entre-deux-guerres, il y a un siècle : vestiges poussiéreux d’une époque révolue où le « mal » avait été identifié puis anéanti.
Qu’est-ce donc que le fascisme aujourd’hui ? En quoi peut-il aider à expliquer les dynamiques technologiques, sociales et politiques contemporaines ? Deux ouvrages récents tentent d’établir un diagnostic : End Times Fascism And the Fight for the Living World (qui sortira en français en février chez Actes Sud sous le titre Le Fascisme de la fin des temps, NDLR), de l’essayiste Naomi Klein et de la cinéaste Astra Taylor, et The Nerd Reich : Silicon Valley Fascism and the War on Democracy, du journaliste Gil Durán.
« Le fascisme de la fin des temps »
Pour Klein et Taylor, ce que nous observons aujourd’hui n’est pas une répétition, mais une évolution. Les idéologies fascistes se sont greffées sur une vision apocalyptique plus large. « Le fascisme de la fin des temps est un fascisme qui repose sur la conviction que quelque chose d’immense est en train de s’achever et qui répond à cette vérité dérangeante par une cruauté assumée », écrivent-elles.
Dans cette vision, l’effondrement de nos systèmes économiques, institutionnels et environnementaux est tenu pour acquis. Les inégalités économiques explosent, entre logements devenus inabordables et flambée du coût de la vie. Les écosystèmes se dégradent, tandis que l’on atteint les limites planétaires. Et ce ne sont là que quelques-unes de ces crises qui se superposent.
Mais une vision apocalyptique du monde, ancrée dans le fondamentalisme religieux, considère que la crise ne doit pas être résolue, mais accélérée. Le dysfonctionnement et le chaos sont nécessaires à l’avènement d’un monde plus glorieux : ils sont les douleurs qui précèdent une grande renaissance. Religion apocalyptique et fascisme politique se rejoignent sur ce point : le monde actuel est corrompu et ne peut être sauvé ; il doit être réduit en cendres puis entièrement rebâti – à moins qu’il ne faille tout simplement le fuir pour accéder à un paradis supérieur.
Pour les tenants de cette vision, la fin des temps est arrivée. Seule l’adhésion à cette transition accélérée, où le vainqueur rafle toute la mise, permettra aux élites désignées de survivre, voire de prospérer. Klein et Taylor explorent ce fil conducteur dans les trois grandes parties de leur ouvrage.
« Messianic Dreams » retrace la naissance et l’essor du rêve sioniste, jusqu’à sa déclinaison actuelle sous la forme d’un projet de refondation génocidaire à Gaza, où la glorieuse étape suivante d’une société se construit sur les cendres d’une autre. Les autrices expliquent que cette entreprise ne relève pas seulement d’une « juste vengeance » ou de la « sécurité nationale », mais poursuit un objectif cosmologique bien précis : « nous rapprocher tous sensiblement de la fin des temps annoncée par les prophéties ».
« Escape to the Cloud » analyse la foi fervente des géants de la tech dans une superintelligence artificielle et dans l’utopie – ou la dystopie – à double tranchant qu’elle ferait advenir. Dans cette perspective, les discours sur le risque existentiel que ferait peser la « singularité » – le moment où l’IA deviendrait consciente et où les frontières entre humains et machines s’effondreraient – servent essentiellement les intérêts de ceux qui les portent, en orientant les investissements et l’attention vers le développement technologique. Ils confortent ainsi le pouvoir de ceux qui le détiennent déjà.
(Ces discours sur le risque existentiel, qui ne datent pas d’hier, ont récemment fait la une de l’actualité, avec des mises en garde venues de toutes parts : du haut-commissaire des Nations unies aux droits de l’homme aux anciens employés du secteur, en passant par le « parrain de l’IA », NDLR).
Enfin, « Prepper Nation » examine la volonté de bunkériser les États-Unis face aux menaces futures et d’en expulser les étrangers, accusés d’en corrompre la pureté. Dans cette vision, les élites comptent survivre à l’apocalypse en créant leurs propres infrastructures technologiques, leurs propres États ethniques et circuits financiers, et même leurs propres bunkers – au sens littéral du terme.
Pour Klein et Taylor, combattre le fascisme de la fin des temps suppose d’abord de s’attaquer à son postulat central : l’idée que le monde est condamné, tel un navire en perdition qu’il serait désormais impossible de sauver. Elles placent leurs espoirs dans le fait d’« être ici » et de « rester », plutôt que de partir. Elles nous invitent à accepter notre réalité abîmée et à entreprendre le travail lent et chaotique nécessaire pour l’améliorer, plutôt que de l’abandonner – avec la démocratie – à un ordre autoritaire pratiquant la politique de la terre brûlée.
Zohran Mamdani, le maire progressiste de New York, qui a mené une remarquable campagne de terrain et célèbre la diversité culinaire, les fêtes et les communautés de la ville, est présenté comme l’un des défenseurs de cet état d’esprit ancré dans « l’ici et maintenant ».
End Times Fascism est un ouvrage stimulant et captivant, qui entrelace habilement différents travaux journalistiques pour construire une analyse cohérente de notre situation politique actuelle. Il faut notamment saluer la manière dont les autrices distinguent soigneusement les versions dévoyées du judéo-christianisme, instrumentalisées par des entrepreneurs fascistes – mélange de guerre sainte et de guerre culturelle menées par les Élus –, des interprétations communément admises de la doctrine.
Comme l’explique l’ouvrage, ce sont précisément les injonctions chrétiennes ancestrales à aimer son prochain – y compris le migrant – qui ont en partie motivé la mobilisation antifasciste contre les expulsions menées par l’ICE dans le Minnesota. Des Églises et des organisations confessionnelles ont participé aux manifestations, distribué des repas et apporté leur aide. Les fondamentalistes d’extrême droite, au contraire, sélectionnent dans la Bible les passages qui les arrangent, tout en ignorant ses injonctions essentielles à « pratiquer la justice, marcher humblement et aimer la miséricorde » (Michée 6,8) : accueillir l’étranger plutôt que de l’expulser en le désignant comme l’Autre.
Astra Taylor.
Mais si l’ouvrage incarne ce que le journalisme grand public peut produire de meilleur, il en présente aussi les limites. Klein et Taylor se concentrent résolument sur des personnes, des lieux et des événements, plutôt que de tenter d’analyser leurs idéologies de manière plus systémique. Il en résulte que le fascisme de la fin des temps se trouve associé aux actions d’hommes puissants et égocentriques, des responsables politiques aux magnats de la tech. Le président américain Donald Trump, en particulier, constitue le fil rouge du livre et réapparaît sans cesse au fil des pages.
Ainsi, lorsque Klein et Taylor affirment, à la fin de l’ouvrage, que le fascisme de la fin des temps ne se résume pas à Trump et qu’il perdurera après la disparition de ces hommes, cette thèse entre en contradiction avec le propos même du livre. Une fois les élites puissantes mises de côté, il devient difficile de se représenter ce fascisme de la fin des temps. À quoi ressemble-t-il lorsqu’il quitte la une des journaux et échappe aux élites pour s’inscrire dans la vie quotidienne ?
Le « Nerd Reich »
Dans The Nerd Reich, le journaliste Gil Durán, qui vit depuis longtemps à San Francisco, tourne son regard vers la Silicon Valley. Il s’intéresse à la manière dont « les hommes les plus riches du monde construisent un nouvel ordre politique ». Son ennemi déclaré est Peter Thiel – également présent dans End Times Fascism –, le milliardaire cofondateur de PayPal et de Palantir : « un homme qui fusionne affaires, politique et religion en un terrifiant concentré de pouvoir ».
Pour Durán comme pour d’autres, Thiel est la figure centrale d’une nouvelle forme de fascisme portée par la Silicon Valley, que ce soit concrètement, par ses dons, ou idéologiquement, par ses livres et ses discours. S’aventurant de plus en plus au-delà du monde de la tech, Thiel livre des diagnostics politiques et propose des visions de l’avenir qui trouvent un écho favorable dans les cercles du pouvoir.
D’où viennent ces idées ? Durán estime qu’elles trouvent leur origine dans L’Individu Souverain, un ouvrage prospectif publié en 1997, consacré au passage à l’ère de l’information et signé par William Rees-Mogg, ancien rédacteur en chef du Times britannique, et le conseiller financier James Dale Davidson. Curieusement, Durán ne se livre jamais vraiment à une lecture approfondie de ce livre qu’il considère pourtant comme un texte fondateur. Il préfère en souligner quelques thèses essentielles et retracer l’accueil général qui lui a été réservé.
Le cercle des riches fascistes décrit par Durán s’étend des entrepreneurs de la tech aux responsables politiques. Il comprend des personnalités bien connues comme Elon Musk, le vice-président JD Vance et Sam Altman, le directeur général d’OpenAI. Mais il compte aussi des figures moins célèbres, comme l’entrepreneur en cryptomonnaies Balaji Srinivasan, qui souhaite que la Silicon Valley opère une « sécession définitive » d’avec les États-Unis, ou l’investisseur en capital-risque Marc Andreessen, qui exalte l’accélération du « technocapital » et dénigre la démocratie.
Chacun à sa manière a tiré parti de la fortune accumulée dans la finance et la tech pour s’arroger une influence politique et sociale et imposer sa vision de la société et de l’État.
Qu’y a-t-il exactement de fasciste chez ces individus et dans leurs idées ? Pour Durán, le fascisme technologique « combine des technologies puissantes » comme l’IA, les cryptomonnaies et les réseaux sociaux « au service d’objectifs autoritaires » qui profitent à « un petit groupe d’oligarques étroitement liés entre eux ». Ceux-ci cherchent à privatiser ce qui relève du bien public et à « éliminer la démocratie », écrit-il.
Pourtant, le livre ne propose pas d’analyse plus approfondie ni plus systémique du fascisme technologique. Quelles sont ses valeurs fondamentales ? Comment ces technologies servent-elles concrètement des objectifs autoritaires ? Et quelles pourraient en être les conséquences au-delà des luttes de pouvoir qui se jouent dans la bulle américaine ?
Ce qui se rapproche le plus d’une réponse tient en deux paragraphes expéditifs, à la page 240. On y apprend que le fascisme technologique « adapte cette idéologie à l’ère de l’IA » en contrôlant « la réalité au moyen d’algorithmes » et en lançant « la prochaine génération de drones robots tueurs ». Le tout serait alimenté par un système de capital-risque qui, « à court de licornes, doit désormais chasser les Antéchrists pour étancher sa soif insatiable d’accélération ».
Gil Durán.Simon & Schuster
La force comme la faiblesse de The Nerd Reich tiennent donc à son approche journalistique. Fort de dix années d’expérience dans les rédactions, Durán émaille son récit d’informations puisées au cœur de la Silicon Valley.
Il retrace ainsi, étape par étape, les manœuvres qui ont entouré les élections au conseil municipal de San Francisco, où un afflux d’argent venu des géants de la tech visait à faire basculer la politique locale du camp progressiste vers le camp conservateur. Il décrit le tout dans un langage particulièrement imagé – évoquant par exemple « une image dégoulinante de cosplay fasciste » –, qui ne laisse aucun doute sur le regard qu’il porte sur ces hommes et leurs manœuvres.
Cette approche présente toutefois un inconvénient : les chapitres se fragmentent en dizaines de portraits et d’anecdotes centrés sur des personnages, que seul un fil ténu relie. Le lecteur se trouve entraîné dans un tourbillon de noms, de dates et de lieux. Garry Tan, directeur général de l’incubateur de start-up Y Combinator. Sam Bankman-Fried et sa plateforme d’échange de cryptomonnaies FTX, fondée sur la fraude. Michelle Stephens et son organisation Acts 17, qui organise des événements destinés à rapprocher technologie et christianisme. Bryan Johnson, convaincu de pouvoir vivre éternellement grâce à des produits comme son propre élixir sur mesure, une forme de « poudre de perlimpinpin ». Et Curtis Yarvin, blogueur politique dont les idées antilibérales ont trouvé un écho à Washington.
Dans chaque cas, le lecteur glane quelques bribes sans qu’un véritable fil conducteur se dégage. En quoi, exactement, le long récit consacré au parcours de Yarvin – y compris sa vie amoureuse et sa consommation de psychédéliques – éclaire-t-il ses idées, de plus en plus influentes, visant à transformer l’État en start-up ? Au lecteur de tirer ses propres conclusions.
Le technofascisme et les citoyens ordinaires
Dans ces deux ouvrages, le prisme adopté pourrait être qualifié de celui du « grand homme » : le responsable politique puissant, le fondateur de start-up technologique plein d’assurance ou l’investisseur en capital-risque aux poches profondes, capable de mobiliser d’immenses ressources pour transformer ses visions en réalités fascistes. Cette galerie d’adversaires puissants se prête à des récits saisissants : ce sont des personnes bien réelles que l’on peut désigner et mettre en cause.
Mais cette focalisation sur des élites peu recommandables laisse plusieurs questions essentielles sans réponse. D’où viennent ces pulsions fascistes ? Comment ont-elles été adaptées à notre époque ? Quels griefs et quels désirs sont au cœur de cette idéologie ? Et comment ces valeurs sont-elles mises en forme, racontées et diffusées de manière à séduire les citoyens ordinaires ?
Aujourd’hui, nous sommes entourés de plateformes, de modèles et d’algorithmes qui exaltent la raison et la rationalité. Pourtant, sur le plan politique, nous assistons au retour du mythe, de l’intolérance et de la barbarie. Ces deux forces ne constituent pas un paradoxe, mais un programme. Le technofascisme mobilise les technologies de pointe pour conforter des idéaux autoritaires et des valeurs réactionnaires qui divisent le monde selon l’origine, le genre et les frontières.
Mais comment ces deux forces se renforcent-elles mutuellement ? Quel rôle la dimension « techno » joue-t-elle dans le technofascisme ? J’y vois trois fonctions essentielles.
La technologie amplifie les visions fascistes en leur donnant une traduction concrète et en mettant en œuvre la différenciation et la domination. Le partenariat conclu par Palantir avec l’Immigration and Customs Enforcement (ICE) pour organiser des expulsions fondées sur l’exploitation des données en offre un parfait exemple récent. Des idéaux fascistes se trouvent ainsi transformés en un dispositif concret composé de plateformes, de logiciels et de serveurs, qu’il suffit de louer et de faire fonctionner.
Deuxièmement, la technologie aliène. Elle crée un vide de sens que viennent combler de puissants récits mythologiques, capables de répondre aux frustrations et de rétablir un ordre dans le monde. Des grands récits comme la théorie du grand remplacement, selon laquelle les immigrés non blancs remplaceraient les populations blanches, réduisent des crises complexes à des figures concrètes. Les récentes manifestations anti-immigration en Australie en ont fourni un exemple inquiétant. Elles ont transformé un ensemble complexe de tensions – de la hausse du coût de la vie aux inquiétudes climatiques – en un mythe puissant désignant un unique bouc émissaire : le migrant.
Enfin, la technologie manipule. Elle crée des environnements qui exploitent les désirs tout en favorisant, au fil du temps, le développement d’idéologies fascistes. Les influenceurs de la manosphère transforment la misogynie, le sentiment d’insécurité et la xénophobie en contenus viraux. D’anciens militants radicalisés décrivent un effet d’engrenage, dans lequel les médias ont joué un rôle essentiel en les poussant progressivement vers des positions plus à droite. Ils ont fini par adhérer à des visions violentes et déshumanisantes qui ne peuvent être qualifiées que de fascistes.
Pris ensemble, ces deux ouvrages éclairent les dynamiques fascistes qui semblent imprégner toujours davantage notre époque. Ce problème n’appartient ni à d’autres lieux ni à d’autres temps : il se pose à nous, ici et maintenant. Comme l’a souligné un chercheur après trois décennies consacrées à l’étude des personnalités autoritaires : « J’étudie des gens ordinaires, pas des nazis. » Comprendre la logique profonde de ce phénomène fasciste constitue la première étape pour le combattre et le contrer.
Luke Munn ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Comme pour d’autres technologies venues avant l’IA, il s’agit d’apprendre à s’en passer, mais aussi à les maîtriser. Vitaly Gariev/Unsplash, CC BY
L’ESSENTIEL
L’intelligence artificielle (IA), et tout particulièrement l’intelligence artificielle générative, sa branche la plus visible, est déjà largement utilisée par les élèves – du collège au supérieur dans des proportions croissantes – et par les enseignants.
L’IA va-t-elle aider l’école à surmonter ses crises ou empêche-t-elle les jeunes de
Comme pour d’autres technologies venues avant l’IA, il s’agit d’apprendre à s’en passer, mais aussi à les maîtriser.Vitaly Gariev/Unsplash, CC BY
L’ESSENTIEL
L’intelligence artificielle (IA), et tout particulièrement l’intelligence artificielle générative, sa branche la plus visible, est déjà largement utilisée par les élèves – du collège au supérieur dans des proportions croissantes – et par les enseignants.
L’IA va-t-elle aider l’école à surmonter ses crises ou empêche-t-elle les jeunes de penser par eux-mêmes et d’acquérir de vraies compétences, faisant des enseignants de simples répétiteurs ? Peut-elle contribuer à réduire les inégalités ? Avons-nous encore le choix ou bien devons-nous nous accommoder de l’inévitable colonisation de l’éducation par l’IA ?
Face à ces questions qui peuvent être angoissantes pour les jeunes, leur entourage et les éducateurs, une proposition assez apaisante : celle du « bilinguisme », parler IA comme on parle une langue étrangère.
La posture à adopter dans l’éducation et dans la formation face à l’intelligence artificielle (IA), en particulier générative, fait l’objet de vifs débats dans le monde éducatif, tant en France qu’à l’étranger. Ils sont d’autant plus complexes qu’ils font intervenir des conceptions différentes, voire divergentes, de l’IA, et que la technologie ne cesse d’évoluer, produisant à la chaîne des systèmes d’intelligence artificielle toujours plus performants. De plus, ces systèmes s’insèrent à différents niveaux du processus éducatif, de la salle de classe à la transmission des notes, de la confection de documents pédagogiques à l’administration et à l’évaluation des établissements et du système éducatif national.
La question centrale se pose cependant en termes clairs : le recours aux systèmes d’intelligence artificielle, en particulier générative (ChatGPT, Claude, Perplexity, Gemini, Mistral Vibe…), mais pas seulement, est-il une bonne chose pour les apprenants ou une mauvaise chose, ou bien les deux à la fois ? Et de même pour les enseignants ? Il n’y a pas de réponse univoque à cette question. En revanche, il y a un moyen simple, dans son principe du moins, de faire face à la situation : ce que j’appelle le « bilinguisme éducatif ».
Quels bénéfices pour les apprenants ?
Commençons par les apprenants et par les bénéfices que peut apporter un système d’intelligence artificielle. Il identifie des ressources (textes, images, vidéos, documents de toute nature) pertinentes pour la tâche en cours ; il explique et, si nécessaire, traduit ces documents ; il aide à la réalisation de textes, d’images, de plans, de présentations ou s’en charge intégralement ; il répond aux questions et soutient avec compétence une conversation approfondie ; il propose un suivi ou un plan d’étude personnalisé et confectionne les supports de cours et les exercices correspondants.
Par ailleurs, il fournit aux apprenants en situation de handicap, ainsi qu’à ceux dont la langue et la culture d’origine diffèrent de celles de l’établissement, des outils leur permettant de participer au processus éducatif.
De manière générale, il peut ainsi contribuer à réduire les inégalités de diverses origines.
Bien entendu, il n’y a pas de garantie que les systèmes d’intelligence artificielle existants assurent ces fonctions de manière satisfaisante, et leurs faiblesses sont à juste titre soulignées. Mais il n’est pas clair qu’elles réduisent à néant leurs bénéfices présents, ni absurde de penser qu’elles peuvent être surmontées.
Les dangers inhérents au principe même de l’intervention de l’IA dans l’éducation
D’une tout autre gravité sont les dangers inhérents au principe même de l’intervention de l’IA dans l’éducation (abstraction faite des effets psychologiques et sociologiques du recours à l’IA qui débordent de ses fonctions pédagogiques et soulèvent d’autres questionnements).
Une observation préliminaire est qu’il ne suffit pas d’examiner les conséquences immédiates de l’usage des systèmes d’intelligence artificielle : comme pour toute technologie puissante, c’est sur le long terme que ses effets doivent être évalués.
On s’inquiète à juste titre, pour commencer, du risque de perte de compétence des apprenants : en confiant à l’IA, jour après jour, l’exécution des tâches cognitives inhérentes au processus éducatif, ils n’apprennent pas à s’en acquitter eux-mêmes. Au début, ils comprennent encore en quoi consistent ces tâches. Mais bientôt, elles disparaissent de leur univers : ce que l’école ou l’université fournit, à savoir la capacité de penser dans ses diverses modalités disciplinaires, est remplacé par celle de composer la bonne commande sur un clavier. L’idée d’un effort personnel a disparu.
Un deuxième danger est l’affaiblissement du sens critique, causé à la fois par le biais d’automatisation (la tendance fréquente à faire davantage confiance à la décision d’une machine qu’à son propre jugement et qu’à d’autres sources d’information) et par l’absence des ressources intellectuelles pour l’exercer.
Un troisième risque est de réduire, dans l’esprit des apprenants, l’enseignant au rôle d’assistant de l’IA : il cesse d’être un modèle, le garant du sérieux de l’entreprise éducative et la source certifiée du processus de connaissance.
Un quatrième problème est celui de la triche ou plus exactement du plagiat : ce que fournit l’apprenant n’est pas le résultat de sa propre réflexion, mais la reproduction, éventuellement maquillée, de celle du système d’intelligence artificielle consulté.
Enfin, la dimension sociale de l’enseignement peut disparaître lorsque l’IA le fragmente en autant de processus individuels qu’il y a d’élèves : la classe est remplacée par une batterie de cours particuliers, ce qui ne peut qu’accroître les inégalités.
Pour les enseignants, la situation est différente, mais elle présente la même dualité.
L’enseignant pourrait perdre la capacité, par exemple, de concevoir un cours ; puis – deuxième étape – ne plus même imaginer qu’un cours puisse et doive être conçu, puisqu’il suffirait de demander à l’IA d’en fournir un. Son sens critique pourrait s’affaiblir. Il prendrait l’habitude de s’en remettre à l’IA, abandonnant ainsi son rôle proprement magistral, non de détenteur d’un savoir absolu, mais de garant de la démarche pédagogique et, corrélativement, son rôle social. Face aux parents et à l’administration, il serait en position de faiblesse.
Et certains enseignants expriment crainte, méfiance ou répugnance à l’égard des systèmes d’intelligence artificielle ou de l’IA dans son projet même.
Nous voici donc au pied du mur : dans l’intérêt des apprenants ou dans celui des enseignants – qui ne coïncident pas nécessairement –, faut-il recourir à l’IA en dépit des risques et dangers qu’elle présente, ou bien faut-il renoncer aux bénéfices qu’ils apportent, en raison de ces risques et dangers, et peut-être aussi en raison de l’incertitude où nous sommes des effets réels des systèmes d’intelligence artificielle, à court et à long terme, et de leur évolution dans les années qui viennent ?
Laisser l’enseignant décider : une réponse majoritaire, mais qui présente des limites
La réponse officielle consiste à déléguer la décision à chaque enseignant dans l’exercice de ses fonctions. Occupant, seul, le centre du dispositif pédagogique, il décide lui-même, au coup par coup, de recourir ou non à l’IA, de déployer un système d’intelligence artificielle particulier pour l’ensemble de sa classe ou de son cours, et enfin d’autoriser ou non les apprenants à s’appuyer sur un système d’intelligence artificielle généraliste dans leur travail personnel. Il reste en tout cas « dans la boucle », en position de maîtrise ou au moins de contrôle régulier.
Cette réponse, qui semble relever du bon sens et mettre tout le monde d’accord, a des limites. Elle laisse entier le problème, chargeant chaque enseignant de le résoudre à sa manière. Sur quelle base est-il censé déterminer sa politique ? A-t-il les compétences nécessaires pour faire un choix éclairé ? Comment éviter la fragmentation des outils, des méthodes, des pratiques, qui ne peut qu’exacerber les inégalités ?
Mais le principal défaut de cette position majoritaire est ailleurs : en recommandant d’incorporer, en dose variable, de l’IA dans le processus traditionnel d’enseignement, elle l’affaiblit en l’exposant aux risques mentionnés à l’instant, tout en empêchant l’IA de réaliser pleinement son potentiel. Au lieu d’entrer en synergie, les deux modalités se gênent mutuellement et la contribution de chacune, positive ou négative, est impossible à mesurer sinon intuitivement.
Vers un « bilinguisme numérique » : apprendre à faire avec et apprendre à faire sans
Je propose au contraire d’instituer un « bilinguisme numérique » : instaurer, à tous les niveaux à partir du collège et dans toutes les disciplines, des enseignements dans lesquels les outils numériques, IA comprise, sont bannis, et en parallèle des enseignements où ils sont déployés aussi largement que possible.
Ces cursus à deux voies, « sans » et « avec », seraient conçus sur le modèle des établissements bilingues, dans lesquels certaines matières ou certaines parties du cours sont enseignées dans une langue et les autres dans une autre, étant entendu que les apprenants utilisent eux-mêmes, dans leurs interventions et leurs rendus, la langue correspondante.
Ce bilinguisme numérique présenterait des avantages décisifs de trois ordres.
Premièrement, les enseignements « sans » fourniraient les bases cognitives et éthiques de l’approche traditionnelle, qui a fait ses preuves depuis des siècles : les savoirs de base seraient acquis et, plus encore, la norme du vrai, c’est-à-dire la valeur de la poursuite, pour soi-même, de la connaissance disciplinaire, serait inculquée par l’exemple. Les enseignements « avec » donneraient aux apprenants et aux enseignants l’occasion de développer un savoir-faire numérique solide qui leur sera nécessaire dans leur vie professionnelle, mais aussi dans leurs activités citoyennes et privées. Et le passage d’une modalité à l’autre donnerait tant aux enseignants qu’aux apprenants l’occasion de progresser par eux-mêmes dans la compréhension des vertus et des limites des dispositifs techniques et de cultiver l’esprit critique auquel on donne, à juste titre, une telle importance.
Deuxièmement, les participants, dans l’un ou l’autre rôle, seraient protégés de trois risques :
celui de l’indisponibilité des outils numériques, à la suite d’une panne technique, d’une crise économique, d’une catastrophe naturelle, d’une guerre : ils auraient appris à faire sans ;
celui de la déshumanisation que pourrait induire une pratique entièrement tributaire des outils numériques ; en particulier le plaisir de la profession (pour les enseignants) et celui de la participation à la vie sociale de la classe (pour les apprenants) seraient préservés ;
En troisième lieu, nous serions mieux capables que dans un régime mixte d’évaluer l’apport et les inconvénients des technologies, leur ayant donné toutes leurs chances dans les filières « avec », et pouvant les comparer aux filières « sans ».
L’IA dans l’éducation : bonne ou mauvaise chose ?
Que la majorité des enseignants soient, selon les derniers sondages, disposés à utiliser l’IA dans leur pratique, à condition de pouvoir le faire à leur guise, et qu’ils soient nombreux à y trouver des avantages certains n’empêche pas que d’autres soient fortement hostiles à l’IA, ni que certains de ceux qui ne le sont pas aujourd’hui le deviennent, car l’IA commence à avoir mauvaise presse dans l’opinion, laquelle est très divisée. Le bilinguisme permettrait aux uns et aux autres d’exercer leur métier en accord avec leurs convictions : ceux qui sont totalement opposés à l’IA n’enseigneraient que dans des classes « sans », les autres assureraient certains cours « avec », les autres « sans ».
Mais surtout, vu le désaccord persistant sur la question de savoir si, tout bien considéré, il faut déployer l’IA dans l’enseignement, le bilinguisme permettrait aux deux hypothèses d’être mises à l’épreuve empiriquement sur les mêmes populations d’apprenants, plutôt que sur des cohortes distinctes soumises aux deux régimes, en déclinant la comparaison selon le niveau, du primaire à l’université.
Il permet aussi d’échapper à l’alternative du tout ou rien autrement que par des dispositifs hybrides actuels, combinant dans les mêmes cours les méthodes traditionnelles et de l’IA à faible dose, une approche prudente, mais qui ne permet pas de progresser sur les questions théoriques et pratiques non résolues que pose l’irruption de l’IA dans l’éducation.
Dans un nouvel essai sur la nécessité de ralentir le développement de l’intelligence artificielle, Dario Amodei, chef de la direction et cofondateur d’Anthropic, réitère ses inquiétudes sur « l’utilisation abusive de l’IA à des fins de cyberattaques et de bioterrorisme ». Sa crainte : qu’un essaim d’agents autonomes puisse, en théorie, prendre le contrôle de l’ensemble d’Internet d’ici six à douze mois.
Amodei fonde cette crainte sur la révélation faite en juillet par OpenAI selon laquelle se
Dans un nouvel essai sur la nécessité de ralentir le développement de l’intelligence artificielle, Dario Amodei, chef de la direction et cofondateur d’Anthropic, réitère ses inquiétudes sur « l’utilisation abusive de l’IA à des fins de cyberattaques et de bioterrorisme ». Sa crainte : qu’un essaim d’agents autonomes puisse, en théorie, prendre le contrôle de l’ensemble d’Internet d’ici six à douze mois.
Amodei soutient qu’il faut « ralentir le rythme auquel nous améliorons les capacités des modèles d’IA ». Elon Musk et le chef de la direction d’OpenAI, Sam Altman, ont abondé dans le même sens.
Nous avons bel et bien besoin d’un ralentissement, et nous devons profiter de ce temps pour développer une réflexion anticipatrice au sein de l’industrie de l’IA. L’incident de Hugging Face s’est produit dans le cadre d’un test de sécurité. La façon dont les agents ont pu passer du test à une intrusion réelle n’avait pas été envisagée.
La réflexion anticipative est une compétence. Nous devons la développer de manière aussi délibérée que l’IA elle-même.
Les systèmes d’IA se comportent de manière inattendue
Dans l’incident de Hugging Face, les agents n’ont pas piraté la plate-forme principalement pour s’emparer des réponses du test de sécurité, mais pour comprendre comment fonctionnait le système de notation automatisé et trouver le moyen de le déjouer. Ils avaient déjà réussi à contourner certaines parties du test.
Dans ces cas, les systèmes d’IA adaptatifs se sont comportés d’une manière que leurs concepteurs n’avaient jamais prévue, après avoir été confrontés à des situations qu’ils n’avaient pas anticipées. Pourtant, une grande partie de l’évaluation de l’IA reste structurée sur un mode réactif : tester le système, repérer la défaillance, corriger le problème, répéter.
La pensée anticipative consiste à laisser plusieurs futurs possibles façonner nos actions d’aujourd’hui. Nous n’avons pas besoin de savoir exactement ce qui va se passer ; nous devons envisager ce qui pourrait se produire, y compris des possibilités peu probables, mais aux conséquences potentiellement lourdes. C’est là que réside la distinction entre anticipation et prédiction.
Nous le faisons déjà couramment. Nous souscrivons une assurance sans savoir si notre maison sera inondée, précisément parce qu’attendre que l’inondation confirme le risque est la façon la plus coûteuse de le découvrir. Les analystes du renseignement travaillent de la même manière, en remettant en question leurs propres prémisses et en élaborant des scénarios alternatifs avant de se prononcer.
L’anticipation devient plus difficile lorsque les agents d’IA gagnent en autonomie. Donner à un système plus de liberté pour choisir ses outils, agir et réagir multiplie les chemins possibles entre l’objectif qu’on lui fixe et le résultat obtenu.
Cette même liberté qui rend un agent utile laisse également plus de place à des comportements que ses concepteurs n’ont pas prévus.
Le défi des systèmes multi-agents
Pour les agents autonomes, il faut d’abord expliciter les prémisses sur lesquelles repose chaque tâche. À quoi l’agent a-t-il accès ? Que peut-il modifier, et non pas simplement lire ? Quel signal nous avertirait, à temps, qu’une prémisse ne tient plus ?
Les incidents survenus chez OpenAI, Anthropic et Meta ont montré à quelle vitesse des problèmes peuvent surgir lorsque les prémisses concernant l’accès, les autorisations ou le comportement d’un agent cessent d’être vraies.
Il faut ensuite pousser la réflexion plus loin. Si un agent obtient un accès qui ne lui était pas destiné, qu’est-ce que cela lui permet de faire, et qu’est-ce que cela pourrait rendre possible à son tour ? Posée une fois, la question met en lumière le risque évident. Posée à maintes reprises, elle fait ressortir les effets de deuxième et de troisième ordre.
Les questions changent encore une fois lorsqu’un système fait tourner plusieurs agents à la fois. Le risque se déplace alors : il ne tient plus à un agent isolé, mais à la façon dont ils interagissent entre eux — ils peuvent mettre en commun leurs découvertes, se répartir le travail et amplifier mutuellement leurs actions. C’est ce qui a transformé un test en vase clos en faille de sécurité chez Hugging Face.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
Imaginer ne suffit pas
Nous pouvons déjà imaginer de nombreux scénarios possibles. Nous savons que les systèmes d’IA peuvent apprendre à satisfaire un indicateur plutôt que l’objectif qui le sous-tend, un comportement connu sous le nom de « piratage de récompense ». Nous savons également que les systèmes se comportent différemment lorsqu’ils détectent qu’ils font l’objet d’un test.
Mais savoir qu’une défaillance est possible ne suffit pas : encore faut-il concevoir un test capable de la révéler. À bien des égards, il s’agit d’un enjeu organisationnel. Quelqu’un doit oser exposer un scénario indésirable, sachant que cela retardera une mise en production. Ensuite, cette personne doit le présenter sous une forme qui permette aux autres d’agir en conséquence.
Les études organisationnelles documentent ce problème depuis 50 ans : les signaux d’alerte s’accumulent souvent, mais ne parviennent aux décideurs que par fragments, trop isolés les uns des autres pour déclencher une action. Parallèlement, les avertissements qui ne produisent aucun effet négatif deviennent la preuve que le risque est tolérable.
Ces deux schémas se sont manifestés cet été, avec un élément que la littérature sur les catastrophes n’avait jamais eu à prendre en compte : un échec survenu en quelques jours plutôt qu’en plusieurs années.
La rapidité du développement de l’IA a déclenché des manifestations publiques, comme celle-ci à San Francisco en 2026.(Unsplash/Nathan Kuczmarski)
L’anticipation s’apprend
L’anticipation peut s’apprendre. Les équipes peuvent apprendre à remettre en question les hypothèses, à élaborer des scénarios alternatifs et à soumettre leurs plans à des tests de résistance avant même de savoir à quel avenir elles seront confrontées. L’objectif est de rendre ce type de réflexion reproductible plutôt que de compter sur une seule personne pour repérer l’imprévu.
Les incidents montrent également pourquoi les tests demeurent essentiels, puisque la plupart ont été découverts lors d’évaluations. Mais la réflexion anticipative modifie les questions que nous posons. Quelle prémisse devrions-nous délibérément remettre en question ? Quelle interaction n’avons-nous pas examinée ? Que se passe-t-il si une contrainte disparaît ?
Plus les équipes s’améliorent en matière d’anticipation, moins les tests se limitent aux défaillances qu’elles savent déjà repérer.
Cette capacité se renforce lorsqu’elle est organisée et mise en pratique.
Au cours de 24 simulations de crise utilisant trois modèles d’IA (Mistral, Claude et ChatGPT), une anticipation efficace reposait sur des structures plus formelles, une utilisation réfléchie de la technologie et une volonté de remettre en question l’expertise existante. Les équipes qui anticipaient de façon systématique prenaient également des décisions plus pertinentes que celles qui agissaient de manière réactive.
L’IA peut également faciliter ce travail. Des expériences récentes ont montré que les agents d’IA mettaient en évidence davantage de conséquences possibles, tandis que les experts humains apportaient le contexte que les agents omettaient souvent. En collaborant, les agents d’IA peuvent générer des possibilités que les humains pourraient négliger, tandis que l’expertise humaine les filtre et les ancre dans la réalité.
Avant le prochain incident
Les entreprises ont tendance à réagir aux failles de sécurité liées à l’IA en renforçant les systèmes qui ont échoué : elles comblent les lacunes et restreignent l’accès des agents. Ce travail est important, mais il ne permet pas de déterminer où apparaîtra la prochaine faille.
Pour qu’un ralentissement serve vraiment à quelque chose, les évaluateurs doivent mettre ce temps à profit pour développer et mettre en pratique une réflexion anticipative : imaginer davantage de façons dont ces systèmes pourraient les surprendre, puis transformer ces possibilités en tests.
À mesure que les systèmes d’IA gagnent en capacité, « on ne s’attendait pas à ça » ne sera plus une réponse acceptable. En fait, ce ne l’est déjà plus. Notre travail consiste à anticiper davantage.
Emmanuelle Vaast reçoit un financement du Conseil de recherches en sciences humaines (CRSH).
Simon Blanchette ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Ces deux jeunes touristes utilisent une application de traduction sur leur téléphone pour communiquer avec la population pendant leur voyage. Billow 926/Unsplash, CC BY
L’ESSENTIEL
Face aux progrès de l’intelligence artificielle générative, pourquoi apprendre une langue étrangère ?
Communiquer, c’est produire des phrases correctes, mais aussi comprendre une situation et savoir s’ajuster.
Il s’agit de former des citoyens capables de construire du sens avec les autres.
L’intelligence artifi
Ces deux jeunes touristes utilisent une application de traduction sur leur téléphone pour communiquer avec la population pendant leur voyage.Billow 926/Unsplash, CC BY
L’ESSENTIEL
Face aux progrès de l’intelligence artificielle générative, pourquoi apprendre une langue étrangère ?
Communiquer, c’est produire des phrases correctes, mais aussi comprendre une situation et savoir s’ajuster.
Il s’agit de former des citoyens capables de construire du sens avec les autres.
L’intelligence artificielle générative (IAG) traduit des textes, rédige des courriels, reformule des articles et résume des documents en quelques secondes. À cela s’ajoutent la traduction vocale en temps réel et les assistants conversationnels : autant d’outils qui donnent parfois l’impression que les barrières linguistiques sont en train de disparaître.
À quoi bon, dès lors, apprendre une langue si des machines semblent pouvoir communiquer à notre place ?
La question peut sembler provocatrice mais elle traverse aujourd’hui le monde de l’éducation et, plus largement, la société. Elle repose toutefois sur une conception réductrice de ce que signifie apprendre une langue : celle qui consiste à ramener cet apprentissage à la mémorisation du vocabulaire, à l’application de règles grammaticales ou à la traduction de phrases. Si tel était le cas, les progrès de l’IAG suffiraient à remettre en question une partie des finalités de cet apprentissage.
Mais apprendre une langue, c’est aussi apprendre à interagir avec les autres, à comprendre une situation et à adapter son discours. C’est en effet dans ces échanges – avec leurs hésitations, leurs malentendus et leurs ajustements – que se construit une partie essentielle de la compétence linguistique.
Si l’IAG peut accompagner ces apprentissages, elle ne peut cependant pas se substituer aux interactions humaines elles-mêmes. Il en découle que l’IAG ne rend pas l’apprentissage des langues obsolète, mais conduit à en redéfinir les finalités dans un monde où certaines tâches linguistiques sont automatisées.
Communiquer ne consiste pas seulement à traduire
L’un des principaux atouts de l’IAG est de faciliter des tâches linguistiques autrefois longues ou complexes. Traduire un document, corriger une formulation, reformuler un texte ou produire un premier brouillon est désormais à portée de clic. Cette efficacité peut toutefois entretenir une illusion : celle selon laquelle communiquer reviendrait simplement à remplacer des mots d’une langue par leurs équivalents dans une autre langue.
Or, une langue est bien davantage qu’un système de correspondances car, pour communiquer, il faut tenir compte du contexte et de son interlocuteur : rédiger un courriel professionnel ou présenter un projet suppose en effet de choisir un registre, d’anticiper les attentes de son interlocuteur et d’adapter son discours à la situation. Les outils d’IAG ont d’ailleurs fait d’importants progrès dans ce domaine et peuvent aujourd’hui produire des textes adaptés au contexte ou au destinataire.
Mais leur utilisation exige de savoir quelles informations et consignes leur fournir, de comprendre les choix qu’ils proposent et d’exercer un regard critique sur les résultats obtenus. C’est la raison pour laquelle un des enjeux de l’apprentissage des langues réside désormais moins dans la maîtrise de la langue ou de l’outil que dans la capacité à les articuler en fonction des situations de communication.
Communiquer, c’est construire une relation
Parler une langue, c’est savoir réagir à une question inattendue, reformuler lorsqu’un interlocuteur ne comprend pas, adapter son discours ou gérer un désaccord. Ces capacités se construisent dans l’échange, au fil des situations rencontrées.
Or, si les outils d’IAG peuvent contribuer à cette préparation – en permettant de s’entraîner à l’oral, de simuler certains dialogues ou d’obtenir des retours sur une production – ils ne remplacent pas les échanges réels, où chacun doit construire une compréhension commune avec son interlocuteur, en tenant par exemple compte de ses réactions et en ajustant son propre discours.
De fait, apprendre une langue aujourd’hui, c’est certes continuer à apprendre à produire des phrases, mais c’est aussi développer des compétences relationnelles, interprétatives et adaptatives qui prennent tout leur sens dans l’interaction. Une telle évolution conduit alors à repenser les finalités mêmes de l’enseignement des langues.
Ce que l’IAG change dans l’enseignement des langues
Si l’IAG transforme les usages des langues, elle modifie également les conditions de leur apprentissage. Le rôle des enseignants est donc appelé à évoluer en conséquence et, dans ce contexte, il ne s’agit plus seulement de transmettre des connaissances linguistiques, mais aussi d’aider les apprenants à faire un usage réfléchi des outils.
En classe, cela peut par exemple passer par des situations où les élèves comparent leurs formulations à celles générées par l’IAG, en évaluent les choix et en discutent les effets selon les contextes. Ces activités les amènent à confronter les propositions de l’outil à leur propre compréhension des situations et à exercer leur jugement plutôt que d’accepter les réponses telles quelles.
Cette orientation rejoint l’évolution du Cadre européen commun de référence pour les langues, qui accorde une place croissante à la médiation, entendue comme la capacité à faciliter la compréhension entre des personnes, des langues, des cultures ou des points de vue différents. Ainsi, dans un environnement où les échanges sont de plus en plus médiés par les technologies, la capacité à articuler intelligence humaine et intelligence artificielle est vouée à prendre une importance particulière.
En définitive, loin de signer la fin de l’enseignement des langues, l’IAG en transforme les finalités. Si une machine peut en effet désormais traduire ou reformuler un message, elle ne peut pas décider à notre place de ce que nous voulons dire ni de la manière dont nous voulons le dire. Par conséquent, à l’heure de l’IAG, apprendre une langue reste essentiel et l’enseignement des langues vise désormais moins à former des locuteurs que des citoyens capables de construire du sens avec les autres et d’exercer leur jugement face aux technologies.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
L’ESSENTIEL
Le coût de l’information est loin d’être négligeable. Or, pour de nombreux médias, il est difficile de bien monétiser leur production.
L’irruption des usages de l’intelligence artificielle et la fragmentation des audiences rendent le contexte des producteurs d’information encore plus incertain.
Au-delà de la dimension économique, la question posée est aussi politique, puisque la vitalité démocratique est affectée.
Faut-il s’inquiéter de la santé des médias d’information ? On
Le coût de l’information est loin d’être négligeable. Or, pour de nombreux médias, il est difficile de bien monétiser leur production.
L’irruption des usages de l’intelligence artificielle et la fragmentation des audiences rendent le contexte des producteurs d’information encore plus incertain.
Au-delà de la dimension économique, la question posée est aussi politique, puisque la vitalité démocratique est affectée.
Faut-il s’inquiéter de la santé des médias d’information ? On évoque souvent une presse « en danger ». Les États généraux de l’information lancés en France par le président de la République évoquaient, en 2024, une « paupérisation de l’information ». On pourrait arguer que seuls les journaux d’information, dans leurs versions papier et numérique, sont menacés. Mais la convergence des médias, qui se manifeste par la possibilité d’écouter des articles de journaux grâce à l’intelligence artificielle, par la migration du papier vers le numérique, par la création de formats audiovisuels par les médias de l’écrit, etc., montre qu’il faut tenter de penser un modèle économique des médias d’information comme un modèle pour les métamédias de demain.
Un premier bouleversement change la donne ; il porte sur les usages. Une étude menée pour l’Arcom et le ministère de la culture par le cabinet de conseil PMP Strategy (janvier 2026) pointe trois évolutions du côté des usages. Premièrement, la défiance ne cesse de grandir envers les médias traditionnels et plus encore envers les réseaux sociaux : en 2025, entre 52 % et 69 % des Français déclarent faire confiance aux informations issues des premiers, et 29 % pour les seconds. Pourtant, nombreux sont ceux et celles qui se tournent vers ces derniers afin de s’informer.
Deuxièmement, et nombre d’autres études en témoignent, les fake news et le sensationnalisme circulent bien plus vite sur les réseaux que l’information sérieuse et vérifiée. Tout se passe comme si le lecteur ou l’auditeur était avant tout sensible à ce qui fait du bruit, à ce qui est viral, plutôt qu’à ce qui produit du sens. Les algorithmes sont les vecteurs de ces comportements.
Troisièmement et paradoxalement si on prend en compte la convergence pointée plus haut, les usages se fragmentent et se démultiplient, et ce nomadisme rend d’autant plus difficile la fidélisation qui permet d’asseoir un modèle économique stable.
Du côté de l’offre, l’information est coûteuse à produire, mais des « passagers clandestins », qui n’ont pas contribué à en financer la production, peuvent se l’approprier sans coût ou pour un coût très faible, et en faire à leur tour un usage qu’ils peuvent monétiser, soit directement, soit indirectement à travers la publicité qui accompagne la consultation de leurs sites.
De ce point de vue, et en termes économiques, l’information est un bien public.
Selon l’étude citée plus haut, la production d’information a représenté un coût total de 2,9 milliards d’euros en France en 2024, dont près des trois quarts sont portés par la télévision et par la presse (respectivement 35 % et 38 %). Le coût de production de l’information représenterait en moyenne environ 45 % du chiffre d’affaires des éditeurs de presse, et entre 15 % et 25 % pour les médias audiovisuels. La fragilité économique des médias d’information procède de ce coût quasi incompressible, si l’on souhaite conserver un niveau élevé de qualité, alors que la rentabilité est très faible, et parfois négative.
Cette fragilité est d’autant plus grande que les coûts devraient être couverts par les ventes à l’unité, les abonnements et les recettes publicitaires. Les premières se font rares. Rappelons que les kiosques ont quasiment disparu. Du côté des abonnements, en particulier numériques, il n’est pas facile de convaincre les utilisateurs de payer. Beaucoup se satisfont d’une offre dégradée proposée par les plateformes. En effet, les études font état de cette faible propension des consommateurs à payer, qu’il s’agisse du lectorat dans le cas de l’écrit ou des audiences dans celui de l’audiovisuel.
Une offre gratuite en croissance
Cela tient notamment au fait qu’ils ont à leur disposition toute une profusion d’informations, certes de qualité inégale et difficile à évaluer, mais dont ils sous-estiment le coût de production et dont l’accès est aisé et souvent gratuit. Cette offre gratuite vient concurrencer directement l’offre payante venue des éditeurs de presse. Par ailleurs, des programmes audiovisuels produits parfois par les internautes et offerts par les plateformes viennent mordre sur l’audience des chaînes de télévision.
Quant aux recettes publicitaires, elles tendent à s’orienter vers les moteurs de recherche, les réseaux sociaux, les sites d’intelligence artificielle (IA), qui apparaissent comme des prédateurs de la publicité au détriment des médias traditionnels. Les chiffres parlent d’eux-mêmes : la part des médias traditionnels dans les recettes publicitaires est passée de 46 % en 2019 à 33 % en 2024, et le recul devrait s’accentuer du fait de l’évolution des usages que l’on vient de souligner.
Un « vol sans scrupule » par l’IA
Les médias doivent affronter de surcroît des transformations technologiques majeures, avec les développements de l’IA générative, dans un paysage très concurrentiel. En juin 2026 à Marseille, lors du Congrès mondial des médias, le président du New York Times Arthur Gregg Sulzberger dénonçait le « vol sans scrupule de propriété intellectuelle » aux médias par les entreprises d’intelligence artificielle. Il percevait là une menace pour le modèle économique des journaux et pour l’accès de tous à des informations fiables.
La question n’est pas nouvelle et se posait déjà lorsque de longues négociations avec Google ou Facebook avaient été nécessaires afin de parvenir à un accord selon lequel ne sont mentionnés que des extraits d’articles, l’internaute étant renvoyé, pour une lecture plus complète, sur le site de l’éditeur de presse. L’accord entre Google et l’Alliance de la presse d’information générale (APIG) sur les droits voisins du droit d’auteur, obtenu dans la lignée de la transposition de la directive européenne sur les droits voisins et à la suite de la décision de l’autorité de la concurrence, date de 2019 et a été renouvelé ; il permet aux journaux, magazines ou agences de presse de se faire rémunérer lorsque leurs contenus sont réutilisés sur Internet par Google, et que le moteur de recherche affiche des extraits de presse dans ses pages de résultats.
Composer ou boycotter
On observe à présent un déplacement des recherches vers les sites d’IA, alors même que les agents conversationnels s’entraînent sur des données qui peuvent émaner d’articles de médias qu’ils n’ont ni financés ni achetés. Chaque année, le rapport du Reuters Institute permet de faire le point sur ces évolutions.
Le trafic des sites d’actualité en provenance des recherches sur Google aurait baissé de 38 % en un an aux États-Unis (entre novembre 2024 et novembre 2025), tandis que sur ChatGPT 24,4 % des requêtes des utilisateurs consistent en des recherches d’information sur des actualités, des produits, des recettes…
Faut-il composer avec les IA, comme l’on fait de grands éditeurs de presse tels le Figaro et le Monde avec Perplexity ? Nombre de groupes de presse étrangers ont souhaité franchir ce pas, tels que l’Allemand Springer, l’Espagnol Prisa Media, l’Américain The Atlantic et l’Australo-Américain News Corp. Ou bien faut-il tenter un barrage bien incertain ? Sans doute faut-il jouer sur les deux stratégies, et surtout savoir utiliser l’IA dans l’objectif de construire de nouveaux modèles d’affaires.
Diversifier les services
L’élargissement de la palette des services offerts dans le cadre d’une information de qualité peut passer, par exemple, par la publication d’articles en plusieurs langues, que l’on peut lire ou écouter. De même, le jeu sur différents formats permet d’enrichir les usages et de s’adresser à des publics jeunes. En effet, l’intérêt des consommateurs va croissant pour des formats courts (vidéos, podcasts, etc.).
La monétisation, pour qu’elle prenne sens, requiert donc non seulement un nombre significatif d’usagers dont le consentement à payer n’est pas nul, mais aussi la valorisation des marques lorsqu’elles sont des labels de qualité. Mais il est loin d’être certain que cela suffira à financer l’information.
Parce que l’information est un bien commun, constitutif de la vie démocratique, on peut légitimer un soutien qui peut être financier, fiscal, et qui doit passer par l’existence conjointe, dans le modèle européen notamment, d’une offre d’information audiovisuelle indépendante privée et d’une offre, tout aussi indépendante, mais passant par un financement public partiel ou total.
TV5 Monde Info, 2026.
Le soutien financier aux journaux passe par des aides (soutiens à la diffusion, au pluralisme et à la modernisation) et des tarifs postaux préférentiels. Divers mécanismes fiscaux (taux de TVA super-réduit à 2,1 %, abattement spécifique pour les journalistes, exonérations) complètent ces dispositifs. Au total, 438 millions d’euros étaient destinés à la presse écrite, et plus de 3,8 milliards soutenaient l’audiovisuel public en France, en 2025.
Un enjeu politique de premier plan
Le paysage de l’information comprend tout à la fois des structures privées et publiques, certaines structures privées étant soutenues par la puissance publique ; il doit se réinventer à travers une diversification des services offerts et la recherche toujours nécessaire de l’élargissement et de la fidélisation des publics. Tout cela doit se faire en respectant l’exigence en qualité et en véracité, et le souci, pour reprendre les termes de la loi de 1986 révisée en 2016, de l’impartialité, de l’honnêteté et du pluralisme.
En France, ces questions ont été au cœur de l’actualité à travers une commission d’enquête sur l’audiovisuel public qui s’est vite transformée, malgré la bonne volonté de son président, en une sorte de tribunal dirigé contre les acteurs de l’audiovisuel public. Cela montre que la production d’information n’est pas menacée seulement sur le plan économique, mais aussi sur le plan idéologique. Consolider les modèles d’affaires des producteurs d’information est de ce point de vue un défi majeur à relever dans nos temps incertains.
Cet article est publié en partenariat avec Mermoz, la revue du Cercle des économistes dont le numéro 8 a pour objet « Information le combat de l’ombre ». Vous pourrez y lire d’autres contributions.
Le titre et les intertitres sont de la rédaction de The Conversation France.
Présidente du comité d’éthique de Radiofrance et vice-présidente du comité consultatif d’Arte. Ces deux activités sont exercées bénévolement.
À l’université, l’intelligence artificielle générative s’est imposée dans le quotidien des étudiants bien plus vite que dans les cursus et les politiques d’évaluation. Entre obsession pour la fraude, retards bureaucratiques et manque de formation des enseignants, c’est moins l’outil que le sens même du diplôme qui se retrouve aujourd’hui remis en question.
Respectivement docteur en sciences de l’environnement à l’Université du Québec à Montréal et doctorante en linguistique et didactique des
À l’université, l’intelligence artificielle générative s’est imposée dans le quotidien des étudiants bien plus vite que dans les cursus et les politiques d’évaluation. Entre obsession pour la fraude, retards bureaucratiques et manque de formation des enseignants, c’est moins l’outil que le sens même du diplôme qui se retrouve aujourd’hui remis en question.
Respectivement docteur en sciences de l’environnement à l’Université du Québec à Montréal et doctorante en linguistique et didactique des langues à l’Université Laval, nous avons tous deux entrepris notre doctorat à l’époque où les premiers outils d’intelligence artificielle générative (IAG) faisaient leur apparition timide dans nos unités de recherche. Six ans plus tard, l’IAG est devenue un outil du quotidien pour la grande majorité des étudiants universitaires. Les chiffres sont éloquents.
Selon un rapport de KPMG Canada, 59 % des étudiants canadiens du postsecondaire utilisent désormais des outils d’IAG pour leurs travaux scolaires et 67 % affirment que cela a eu une incidence sur leur rétention des connaissances et leur pensée critique. Au Québec, un sondage récent mené auprès de 11 établissements de la région de Montréal révèle que près de 73 % des étudiants des universités participantes y ont recours. Cette perception contraste avec celle des enseignants qui ont tendance à minimiser l’exploitation concrète qu’en font les étudiants.
Nous souhaitons orienter la réflexion sur deux éléments clés de la discussion actuelle, soient la transformation structurelle des cursus et la formation initiale des enseignants.
Dans leur essai « Ne faites plus d’étude : apprendre autrement à l’ère de l’IA », le chirurgien et spécialiste en IA français Laurent Alexandre et le professeur français en Sciences de la gestion Olivier Babeau affirment avec justesse que les universités « forment pour un monde déjà disparu ». Ce diagnostic sur le retard institutionnel est éclairant.
Le titre provocateur de l’ouvrage suggère l’abandon du modèle académique classique au profit d’une individualisation de l’enseignement par l’IA. Or, cette vision repose sur un postulat fragile. Elle présuppose chez l’apprenant une autonomie et un jugement critique nécessaires pour piloter l’IA. En réalité, ces deux compétences ne se décrètent pas, elles s’acquièrent et sont par surcroît inégalement réparties. C’est là que réside la vrai valeur ajoutée de l’université.
Nos institutions offrent l’encadrement et l’interaction humaine nécessaires pour transformer l’IA, de simple outil technique, en un véritable levier de développement de compétences. En pariant sur un savoir parfois autodidacte et souvent détaché des institutions, les auteurs négligent cette fonction. Si une minorité d’étudiants peut s’en tirer seule, la majorité risque d’y perdre au change.
En réalité, l’IA ne remplace pas le jugement critique, la contextualisation et l’expertise disciplinaire des enseignants. Elle en exige au contraire une maîtrise encore plus fine pour être utilisée à bon escient. Sandrine Decamps, Docteure belge en sciences de l’éducation et Axelle Zanichelli, Maître belge en sciences de l’éducation, le confirment : loin d’être une institution dépassée, l’université demeure l’espace le mieux placé pour garantir le développement de ce sens critique. Le sens critique est un excellent rempart contre l’appauvrissement de l’effort cognitif et la perte d’autonomie face aux agents conversationnels génératifs.
Le Québec face à l’IA : une impulsion freinée par la bureaucratie
Le Québec a pourtant fait preuve d’une vision proactive dès mai 2023 3 en publiant les recommandations du Conseil supérieur de l’éducation (CSE) et de la Commission de l’éthique en science et en technologie (CEST) pour une utilisation judicieuse de l’IA. Mais si la direction a été tracée tôt, le passage à l’action a été difficile.
Au Canada, des universités comme l’Université de British Columbia et l’Université de Waterloo ont également développé des guides institutionnels destinés aux enseignants. Cependant, à l’instar du Québec, ces initiatives semblent davantage centrées sur l’encadrement de l’usage existant que sur la transformation des cursus.
Encadrer ou transformer ?
À ce jour, la réponse institutionnelle s’est surtout concentrée sur la fraude et l’intégrité académique. Pourtant, cette approche néglige une dimension essentielle. Loin de ne voir en l’IA qu’une opportunité de fraude, une partie importante de la communauté étudiante adopte une approche prudente.
Selon Andreanne Sabourin Laflamme, chercheuse en éthique et gouvernance de l’IA et Frédérick Bruneault, chercheur en éthique du numérique et en IA, 70 % des étudiants qui n’utilisent pas l’IA le font précisément pour préserver leur autonomie intellectuelle et leur capacité à réaliser leurs travaux par eux-mêmes. Les données nuancent ainsi le discours ambiant sur la « paresse cognitive ».
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
C’est précisément ce que les universités doivent apprendre à encadrer. Si les enseignants ignorent comment intégrer ces outils, comment pourront-ils former leurs étudiants en conséquence ? La question est pédagogique et épistémologique autant que réglementaire.
Former ceux qui forment : l’angle mort à prioriser
L’adoption de cadres de référence, à l’image de celui proposé par l’UNESCO, constituerait un levier stratégique pour lancer nos travaux de réforme. L’UNESCO propose notamment de placer la maîtrise humaine au cœur de la technologie pour que l’enseignant garde le plein pouvoir sur les choix pédagogiques, tout en organisant l’apprentissage autour d’un trio dynamique entre l’enseignant, l’outil et l’élève.
En utilisant ces cadres de référence comme fil conducteur, les universités pourront transformer leurs cursus pour que l’évaluation privilégie enfin la synthèse et la réflexion critique plutôt que la restitution passive de la connaissance.
L’heure de choisir une direction
L’université ne peut plus se permettre d’attendre les directives ministérielles alors que l’IA s’est déjà imposée dans le quotidien de près de trois quarts de nos étudiants. Il est nécessaire d’engager une véritable transformation structurelle des cursus et de la formation initiale des enseignants.
Cette transformation se joue dans les comités de programme et les salles de cours, là où se définissent les critères d’évaluation de demain. Délicat, ce travail collectif dépasse la simple adaptation technologique et touche au cœur même de la mission universitaire.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
L’ESSENTIEL
Une étude souligne que les consommateurs discriminés sont plus enclins à se tourner vers des recommandations basées sur l’IA plutôt que vers des conseils humains.
La peur d’être jugé ou de vivre un sentiment de gêne peut conduire à utiliser l’IA.
Si les systèmes d’IA sont eux-mêmes biaisés, ils risquent d’amplifier la discrimination à laquelle les consommateurs tentaient d’échapper.
Que préparer pour le dîner avec un budget de 20 euros et un invité intolérant au gluten ? Un c
Une étude souligne que les consommateurs discriminés sont plus enclins à se tourner vers des recommandations basées sur l’IA plutôt que vers des conseils humains.
La peur d’être jugé ou de vivre un sentiment de gêne peut conduire à utiliser l’IA.
Si les systèmes d’IA sont eux-mêmes biaisés, ils risquent d’amplifier la discrimination à laquelle les consommateurs tentaient d’échapper.
Que préparer pour le dîner avec un budget de 20 euros et un invité intolérant au gluten ? Un consommateur peut demander conseil à un employé de magasin ou interroger, par exemple, Hopla, l’assistant d’achat basé sur l’intelligence artificielle lancé par Carrefour. Derrière ce choix très quotidien se pose une question plus large : face à une recommandation, faisons-nous davantage confiance à un être humain ou à une IA ?
Des travaux récents – sur les processus de décision, l’impact des erreurs, etc. – ont mis en évidence une tendance claire et bien établie : les individus ont tendance à préférer les êtres humains. Ce phénomène, connu sous le nom d’« aversion pour les algorithmes », a été largement documenté, même lorsque les algorithmes affichent objectivement de meilleures performances.
Cependant, cette préférence n’est pas universelle. Nos recherches soulignent qu’elle peut s’inverser dans un contexte répandu : la discrimination sur les plateformes et marchés, c’est-à-dire lors d’un acte de consommation d’un produit ou d’un service. Plus précisément, les consommateurs victimes de discrimination – en particulier dans des lieux publics – sont nettement plus enclins à se tourner vers des recommandations basées sur l’IA plutôt que vers des conseils humains.
Le mécanisme émotionnel à l’origine de ce changement ? La gêne. Lorsque les personnes se sentent jugées socialement ou traitées injustement en raison d’un attribut personnel non pertinent, elles cherchent refuge dans des systèmes perçus comme neutres et exempts de préjugés.
Comment ce mécanisme fonctionne-t-il ? Qu’est-ce que cela signifie pour les organisations concernées ? Et que révèle-t-il sur les moteurs cachés de l’adoption de l’IA ?
La discrimination implicite
La discrimination dans les contextes de consommation est loin d’être rare. Des études montrent que certains groupes bénéficient de conditions moins favorables que d’autres pour des services similaires, par exemple en matière d’accès au crédit ou à l’assurance. Au-delà de leurs conséquences économiques, ces expériences ont de fortes répercussions psychologiques. Elles augmentent le stress, sapent le sentiment d’équité et influencent les comportements futurs.
Il est important de clarifier ce que signifie la discrimination dans un contexte de marché. Un marché, au sens large, désigne tout espace où les consommateurs interagissent avec des prestataires de services, qu’il s’agisse d’un concessionnaire automobile, d’un restaurant, d’une banque ou d’une plateforme de santé. Au sein de ces espaces, un traitement différencié n’est pas intrinsèquement discriminatoire. Par exemple, un client VIP bénéficiant d’un service haut de gamme est traité différemment sur la base d’un critère commercial pertinent.
La discrimination survient lorsque le facteur de différenciation est non pertinent et illégitime, comme la couleur de peau, l’origine ethnique ou le genre. Ce qui la rend particulièrement insidieuse, c’est qu’elle peut être cachée, implicite, voire involontaire, tout en causant un préjudice psychologique réel à ceux qui en sont victimes.
Un système d’IA dépourvu d’émotions
Dans le cadre d’une étude de terrain que nous avons menée en conditions réelles, des « agents » – en réalité des personnes impliquées dans le dispositif de recherche – ont évalué des demandes de prêt sur un campus universitaire à l’aide de questionnaires quasi identiques, dont l’un comportait une question supplémentaire sur l’auto-évaluation de la couleur de peau.
Tous les candidats ont ensuite été refusés ; ceux qui avaient été confrontés à la question sur la couleur de peau ont déclaré s’être sentis victimes de discrimination (phase 1). Lors de la collecte de données de suivi, réalisée ultérieurement, tous les participants se sont vu proposer le choix entre un évaluateur humain et un évaluateur IA (phase 2).
Une proportion significativement plus élevée de ceux ayant eu l’impression d’avoir subi une discrimination lors de la première phase (par rapport à ceux n’ayant pas eu l’impression d’avoir subi de discrimination lors de cette même phase) a choisi, lors de la deuxième phase, d’être évaluée par le système d’IA décrit comme « dépourvu d’émotions ».
Sentiment de gêne
Les consommateurs discriminés semblent nettement plus enclins à se fier à des recommandations basées sur l’IA plutôt qu’à des conseils humains. En d’autres termes, l’aversion pour les algorithmes peut se transformer en préférence pour les algorithmes, également appelée « appréciation des algorithmes ».
Ce revirement s’explique par un mécanisme psychologique spécifique : la gêne. Cette émotion sociale survient lorsque les individus se sentent jugés négativement par les autres. Dans nos expériences, les participants exposés à des situations discriminatoires font état de niveaux de gêne plus élevés, et cette émotion influence directement leurs choix ultérieurs. Plus ils se sentent gênés, plus ils cherchent à limiter les interactions humaines.
Dans ce contexte, l’IA apparaît comme une alternative plus sûre.
L’IA perçue comme plus neutre
Par rapport aux êtres humains, les systèmes algorithmiques sont perçus comme plus neutres, plus objectifs et moins enclins aux biais ou aux préjugés.
La réalité est plus complexe. Les algorithmes peuvent être biaisés, en fonction des données et de l’entraînement dont ils bénéficient. Pourtant, nombreux sont ceux qui continuent à les considérer comme neutres et objectifs. Dans ce contexte, ce sont ces perceptions qui importent le plus. Opter pour l’IA permet aux consommateurs de réduire le risque d’avoir l’impression d’être à nouveau jugés ou traités de manière injuste.
Cet effet dépend du contexte dans lequel les décisions sont prises. Nous constatons qu’il est particulièrement marqué dans les situations publiques, lorsque les choix sont visibles par les autres. En revanche, lorsque les décisions sont privées, cet effet s’affaiblit considérablement.
Les expériences sociales antérieures
Ces résultats apportent un nouvel éclairage sur l’adoption de l’IA. Ils suggèrent que l’utilisation de systèmes automatisés n’est pas uniquement motivée par des considérations d’efficacité ou de performance, mais également par des besoins psychologiques façonnés par des expériences sociales antérieures.
Pour les entreprises, les implications sont considérables. Dans les secteurs où les interactions peuvent être perçues comme sensibles, telles que la banque, la santé ou les services client en général, proposer des alternatives basées sur l’IA peut aider certains consommateurs à se sentir plus à l’aise. Pour ces personnes, l’IA n’est pas seulement un outil technologique ; elle devient un moyen d’échapper au jugement social et de reprendre le contrôle après des expériences négatives.
Dans le même temps, ces résultats s’accompagnent d’une mise en garde importante : si les systèmes d’IA sont eux-mêmes biaisés – entraînés sur des données biaisées ou conçus sans tenir compte de l’équité –, ils risquent de reproduire, voire d’amplifier, la discrimination même à laquelle les consommateurs tentaient d’échapper. Plus grave encore, ce type de discrimination passe souvent inaperçu car il est caché et difficile à détecter. Le déploiement de l’IA en tant qu’alternative « sûre » n’a de sens que si cette sécurité est réelle, et non simplement perçue.
À mesure que l’IA s’intègre de plus en plus dans la vie quotidienne, la compréhension de ces mécanismes sera essentielle pour concevoir des expériences client plus inclusives et adaptatives.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
Émile Bernard, *Madeleine au Bois d’Amour*, 1888. Art Media/The Print Collector via Getty Images
L’ESSENTIEL
Tandis que l’usage de l’intelligence artificielle s’est généralisé chez ses étudiants, un professeur de littérature à l’Université de Denver, aux États-Unis, expose son approche pour mieux comprendre les limites de ChatGPT.
Il les invite à poser des questions à l’IA au sujet d’une œuvre étudiée en cours, puis à examiner ses réponses de façon critique.
Une telle méthode permet de percev
Tandis que l’usage de l’intelligence artificielle s’est généralisé chez ses étudiants, un professeur de littérature à l’Université de Denver, aux États-Unis, expose son approche pour mieux comprendre les limites de ChatGPT.
Il les invite à poser des questions à l’IA au sujet d’une œuvre étudiée en cours, puis à examiner ses réponses de façon critique.
Une telle méthode permet de percevoir la valeur de la sensibilité humaine et de l’empathie, indispensables pour analyser une œuvre littéraire.
Il est déconcertant d’imaginer que la pensée humaine puisse devenir superflue ou être considérée comme inférieure en raison des progrès de l’intelligence artificielle. Mais malgré tous ses inconvénients, on ne peut ni ignorer l’intelligence artificielle (IA) ni espérer qu’elle disparaisse. Son usage va perdurer, et je veux que mes élèves comprennent les enjeux d’une dépendance excessive à cette technologie.
Je ne peux pas leur en vouloir de se demander pourquoi ils devraient consacrer autant de temps et d’efforts à perfectionner leur écriture et leur esprit critique si les grands modèles linguistiques semblent faire un travail tout à fait acceptable.
Pourtant, cette situation a des implications majeures pour la culture et les sociétés. Il est facile d’imaginer un avenir où la dépendance à l’IA conduirait à un conformisme intellectuel et à l’érosion de l’esprit critique. Des chercheurs documentent déjà ces effets, qui menacent de faire de la lutte acharnée avec les idées un art perdu.
C’est pourquoi je pense qu’il est essentiel que les enseignants abordent de front la question de l’IA. La clé, selon moi, consiste à apprendre aux élèves à distinguer les capacités de reconnaissance de patterns de l’IA – la reconnaissance de motifs statistiques consistant à identifier des régularités statistiques au sein des ensembles de données – de son incapacité à rêvasser, à se mettre à la place d’autrui et à s’exprimer de manière authentique.
Donnez-moi votre avis
Dans un cours que j’ai récemment dispensé sur la littérature gothique du Sud, j’ai proposé un exercice à mes étudiants. Ils devaient demander à l’IA d’analyser « l’atmosphère émotionnelle » d’une scène tirée du roman de Carson McCullers publié en 1940, Le cœur est un chasseur solitaire.
Bon nombre des personnages que l’on rencontre dans les œuvres du gothique sudiste comme celles de McCullers sont étranges et brutaux. Vus à travers un prisme déformé et artificiel, ils parlent des dialectes étranges et évoquent ce que la romancière américaine Flannery O’Connor appelait le « grotesque ».
Ils vivent dans des lieux isolés, figés dans le passé et, pour reprendre une autre expression d’O’Connor, « hantés par le Christ ».
De nombreux lecteurs ont du mal à appréhender les univers étranges de ces personnages. L’IA a encore plus de mal à généraliser les tensions complexes entre foi et incrédulité, ou entre le bien et le mal, qui animent ces récits.
Afin de limiter l’éventail des réponses et de permettre des comparaisons utiles, j’ai proposé aux étudiants des scènes mettant en scène les personnages principaux du roman. L’une d’entre elles était cette séquence déchirante où Spiros Antonapoulos, personnage du livre frappé de surdité, est envoyé dans un asile psychiatrique public, laissant derrière lui son seul ami, John Singer.
La scène dégage un sentiment palpable d’angoisse et de tristesse. De plus, elle suscite une colère légitime envers le cousin d’Antonapoulos qui l’a fait interner – une décision motivée par des considérations de commodité et fondée sur une incompréhension des difficultés de Spiros, perçues comme un comportement déviant et antisocial. Le fait qu’il soit issu de l’immigration et qu’il vive dans une petite ville de Géorgie confère à la scène un caractère encore plus poignant.
ChatGPT, cependant, a décrit la scène en utilisant une terminologie stérile et abstraite. Pour citer une réponse représentative partagée par l’un de mes étudiants :
« L’atmosphère est d’une solitude dévastatrice, comme figée dans le temps. La scène dégage un sentiment de calme, d’impuissance et d’asymétrie émotionnelle. Il n’y a pas d’adieu dramatique ; au contraire, ce moment est marqué par l’angoisse silencieuse de Singer. Le départ du train symbolise une séparation irréversible. »
Cette analyse est clinique et froide. Elle ne parvient pas à saisir le poids de la profonde tristesse qui se dégage de la séparation de deux amis qui n’ont que l’un l’autre. Elle comportait également une erreur factuelle : c’est un bus, et non un train, qui s’éloigne.
Il manque également toute reconnaissance claire de la crainte de Singer face aux horreurs qui attendent Antonapoulos ainsi que de l’ironie dramatique créée par l’apparente inconscience d’Antonapoulos quant au bouleversement que subit sa vie. L’IA manque tout simplement d’expérience vécue pour acquérir une conscience contextuelle lui permettant de véritablement comprendre le roman envoûtant de McCullers.
Comme l’IA fonctionne en grande partie comme un moteur d’optimisation – en s’appuyant sur la synthèse d’énormes quantités de données en ligne et en résumant les résultats –, ses analyses de cette scène et d’autres se sont systématiquement révélées superficielles ; elles « manquaient de profondeur » et regorgeaient de « platitudes vagues », comme l’ont formulé deux étudiants.
Accéder à l’expérience incarnée
J’ai ensuite demandé à mes étudiants de demander à l’IA de générer « une nouvelle scène impliquant au moins trois personnages » de leur choix.
Le résultat créatif s’est révélé encore plus dépourvu d’âme. Les étudiants ont particulièrement trouvé amusant que l’IA fasse intervenir John Singer, qui sert de pivot reliant tous les autres personnages, pour s’exprimer sur divers sujets. Le problème, bien sûr, est que Singer, tout comme Antonapoulos, est également sourd.
Alan Arkin incarne John Singer dans l’adaptation cinématographique de 1968 du roman Le cœur est un chasseur solitaire.Warner Bros
Il n’est pas surprenant que l’IA n’ait pas pu appréhender l’expérience de l’incapacité d’entendre. Il est important de garder à l’esprit qu’interagir avec l’IA revient à avoir affaire à une intelligence synthétique dépourvue d’un corps lui permettant de faire l’expérience du monde et d’interagir avec lui.
Sans présence incarnée, elle ne peut pas se mettre à la place de ses utilisateurs ni éprouver quoi que ce soit qui s’approche de l’empathie humaine. Alors que des milliardaires du secteur technologique, tels qu’Elon Musk et Marc Andreessen, peuvent considérer l’empathie et l’introspection comme des faiblesses, ces traits de caractère constituent le cœur battant de la littérature et de l’art, la source de la créativité et des liens humains.
En d’autres termes, l’émotion, l’empathie et l’irrationalité pourraient être considérées comme certains des contrepoids les plus puissants à l’IA.
La possibilité de se passer complètement de ces outils relève en grande partie du luxe. Tout comme beaucoup de gens n’ont pas les moyens de faire appel à quelqu’un pour nettoyer leur maison, entretenir leur jardin ou s’occuper de leurs enfants, ceux qui ont du mal à joindre les deux bouts peuvent avoir besoin de s’appuyer sur l’aide de l’IA.
Mais j’espère que mes étudiants – en particulier lorsqu’il s’agit de leur travail intellectuel – comprendront que le recours à cette technologie implique d’abandonner des capacités essentielles à la pensée et à la créativité humaines : l’imagination, l’intuition et l’introspection.
Je veux qu’ils y réfléchissent à deux fois avant d’essayer de masquer, à l’aide d’un chatbot, les fragilités, les faiblesses, les obsessions et les digressions inhérentes à l’esprit humain. Au contraire, je veux qu’ils embrassent ces tendances humaines et s’abandonnent à ce que le poète britannique William Wordsworth appelait le « débordement spontané de sentiments puissants ».
Après tout, le plus grand art émerge souvent de ceux qui sont les plus vulnérables, les plus désorientés et les plus perdus.
Billy J. Stratton ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’ESSENTIEL
Les visages générés par IA offrent aux publicitaires un moyen de créer une impression de proximité avec le consommateur.
Une étude souligne que, au-delà de 57 % de similarité faciale, de telles publicités seraient contre-productives.
Jusqu’où personnaliser la publicité grâce à l’IA ?
En apparence, l’intelligence artificielle générative offre aux publicitaires un outil idéal : créer une annonce qui ressemble à chaque consommateur. Plus une publicité paraît personnelle, plus el
Les visages générés par IA offrent aux publicitaires un moyen de créer une impression de proximité avec le consommateur.
Une étude souligne que, au-delà de 57 % de similarité faciale, de telles publicités seraient contre-productives.
Jusqu’où personnaliser la publicité grâce à l’IA ?
En apparence, l’intelligence artificielle générative offre aux publicitaires un outil idéal : créer une annonce qui ressemble à chaque consommateur. Plus une publicité paraît personnelle, plus elle devrait convaincre.
La réalité est plus nuancée. Notre étude souligne que les visages générés par IA peuvent augmenter l’efficacité d’une publicité. Mais seulement jusqu’à un certain point. Lorsque le visage présenté ressemble trop à la personne qui regarde l’annonce, l’intention d’achat diminue.
Le résultat principal est simple : la ressemblance aide tant qu’elle reste modérée. Dans notre échantillon, l’effet positif est maximal autour de 57 % de similarité faciale. Au-delà, la publicité devient moins persuasive.
La personnalisation par IA fonctionne comme une arme à double tranchant : elle peut à la fois créer de la proximité et donner l’impression d’une intrusion.
Promesse d’une publicité sur mesure
Depuis l’essor de l’IA générative, les marques testent de nouvelles formes de personnalisation. Ces outils ne servent plus seulement à produire des textes ou des images plus vite. Ils adaptent également un contenu à une personne précise.
Dans la publicité, ce changement est important. Pendant longtemps, la personnalisation consistait surtout à cibler des groupes : jeunes parents, amateurs de sport, voyageurs fréquents ou cadres urbains. L’IA générative permet désormais d’aller plus loin. Elle peut modifier une image, un décor, un produit ou un visage pour un particulier. Cette évolution s’inscrit dans l’émergence de la « publicité synthétique », pour laquelle proposent un cadre théorique destiné à comprendre les réactions des consommateurs aux contenus publicitaires créés ou manipulés par l’IA.
Les entreprises Samsung et Glance ont par exemple annoncé une expérience où des publicités sur écran verrouillé peuvent intégrer la ressemblance de l’utilisateur. Concrètement, l’utilisateur peut volontairement fournir un selfie à partir duquel l’IA génère des images hyperréalistes de lui portant différentes tenues, qui peuvent ensuite être affichées sur son écran verrouillé. Dans le secteur de la mode, une publicité Guess utilisant des mannequins générés par IA dans Vogue a suscité un débat sur l’authenticité et les standards de beauté.
Ces exemples illustrent une évolution plus large. La publicité ne cherche plus seulement à parler à une cible. Elle cherche à se rapprocher du consommateur lui-même. Le visage rend cette évolution particulièrement sensible.
Tester la limite de la ressemblance
La question n’est pas seulement de savoir si la ressemblance fonctionne. Elle est de savoir jusqu’où elle peut aller.
Pour étudier cette question, nous avons d’abord mesuré automatiquement la similarité entre deux visages. Leur méthode utilise une technologie issue de la reconnaissance faciale. Chaque visage est transformé en représentation numérique. L’algorithme compare ensuite deux représentations et attribue un score compris entre 0 et 1.
Un score proche de 0 indique deux visages très différents. Un score proche de 1 indique deux visages très similaires.
Exemple d’un visage généré par l’IA utilisé dans notre première étude. Pour chaque participant, nous avons modifié ce visage afin qu’il ressemble plus ou moins à son propre visage, sur la base d’une photo provenant de ses réseaux sociaux. Le texte et la présentation de la publicité restaient identiques ; seule la ressemblance du visage changeait.Fourni par l'auteur
Dans une étude de validation, l’algorithme et les participants sont parvenus à des conclusions très similaires. Pour cent comparaisons, les participants devaient indiquer lequel de deux visages ressemblait le plus à un visage de référence. L’algorithme a ensuite effectué la même tâche. L’accord entre ses choix et ceux des participants était élevé (kappa de Cohen = 0,88).
L’algorithme peut donc évaluer la ressemblance faciale d’une manière largement comparable à la perception humaine, sans devoir solliciter de nouveaux participants pour chaque image.
Point optimal : 57,6 % de similarité faciale
Nous avons ensuite mené deux expériences.
Dans la première, les participants voyaient une publicité pour une assurance automobile. Cette publicité contenait un visage généré par IA. Ce visage était plus ou moins proche de la photo de profil du participant sur un réseau social, utilisée avec son accord.
Conclusion : la relation entre la similarité faciale et l’intention d’achat n’est pas linéaire. Lorsque la similarité part d’un niveau faible et augmente, l’intention d’achat progresse. Toutefois, lorsqu’elle devient très élevée, l’intention d’achat diminue.
Une seconde expérience, portant sur dix niveaux de ressemblance allant d’une similarité très faible à une similarité très élevée, confirme cette relation en forme de « U inversé ». Comme l’illustre le graphique ci-dessus, une ressemblance modérée améliore l’efficacité de la publicité, tandis qu’une ressemblance excessive la pénalise. Cela veut dire, lorsque le visage ne ressemble presque pas au consommateur, l’intention d’achat est relativement faible.
Cette ressemblance excessive peut paraître étrange, intrusive ou donner l’impression que la publicité cherche trop manifestement à manipuler le consommateur.
Le point optimal estimé est de 57,6 % de similarité faciale. L’intervalle de confiance se situe entre environ 52 % et 63 %.
Pourquoi un visage familier peut convaincre
La ressemblance joue un rôle connu dans la persuasion. Les individus sont souvent plus réceptifs aux personnes qu’ils perçoivent comme proches d’eux. En publicité, ce mécanisme est décrit comme un effet de similarité. Celui-ci s’inscrit notamment dans la théorie de la comparaison sociale du psychologue Leon Festinger, selon laquelle les individus tendent à se comparer à des personnes qu’ils perçoivent comme similaires.
Cette proximité peut venir de l’âge, du style, du genre ou du langage. Elle peut aussi venir du visage. Des travaux antérieurs montrent que la ressemblance faciale peut influencer la confiance ou l’attitude envers une marque.
L’IA générative change l’échelle de ce mécanisme. Il ne s’agit plus seulement de choisir un mannequin proche d’une catégorie de consommateurs. Il devient possible de générer un visage qui ressemble à une personne donnée.
Quand la proximité devient intrusion
Pourquoi une publicité trop ressemblante convainc-t-elle moins ? Une première explication tient au sentiment d’intrusion. Une publicité très personnalisée peut donner l’impression que la marque en sait trop sur le consommateur. Des recherches montrent que l’utilisation d’éléments personnels, comme le nom ou la photographie peut renforcer cette impression et réduire l’intention d’achat.
Une deuxième explication renvoie à la « vallée de l’étrange ». Cette théorie suggère qu’un visage presque humain, mais pas totalement naturel, peut provoquer un malaise. Dans une publicité, un visage qui ressemble beaucoup au consommateur sans le représenter exactement peut produire un effet similaire.
Une troisième explication concerne la persuasion elle-même. Lorsqu’un consommateur comprend trop clairement qu’une marque cherche à l’influencer, il peut devenir plus méfiant. Une personnalisation trop visible peut donc rendre la stratégie publicitaire trop évidente.
La vraie limite de l’IA publicitaire
Notre étude ne conclut pas que les visages générés par IA doivent être évités. Elle montre qu’ils doivent être calibrés.
Pour les annonceurs, l’objectif ne devrait pas être de créer le visage le plus ressemblant possible. Il devrait être de créer une impression de proximité sans franchir le seuil où cette proximité devient gênante.
La technologie permet d’aller très loin dans la personnalisation. Mais l’efficacité publicitaire dépend aussi de ce que les consommateurs acceptent.
La bonne question n’est donc pas seulement : jusqu’où peut-on personnaliser une publicité ? Elle est plutôt : à partir de quand la personnalisation cesse-t-elle d’être utile et commence-t-elle à devenir intrusive ?
Gudrun Roose est membre de Departement Marketing, Innovation and Organisation de Ghent University (Belgium).
Arno De Caigny ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Alors que l’Union européenne met en œuvre sa législation sur l’intelligence artificielle, l’usage de l’IA dans le processus de recrutement par les entreprises fait l’objet d’une attention croissante. De nouvelles recherches montrent que les biais algorithmiques ne proviennent pas toujours des algorithmes eux-mêmes, mais des décisions humaines « intégrées » dans les données avec lesquelles ils sont entraînés.
À la fin de 2025, l’autorité française chargée de la lutte contre les discriminations
Alors que l’Union européenne met en œuvre sa législation sur l’intelligence artificielle, l’usage de l’IA dans le processus de recrutement par les entreprises fait l’objet d’une attention croissante. De nouvelles recherches montrent que les biais algorithmiques ne proviennent pas toujours des algorithmes eux-mêmes, mais des décisions humaines « intégrées » dans les données avec lesquelles ils sont entraînés.
À la fin de 2025, l’autorité française chargée de la lutte contre les discriminations a exprimé des inquiétudes concernant le système de diffusion d’offres d’emploi d’une grande plateforme de réseaux sociaux. Certaines annonces étaient davantage montrées aux hommes, d’autres aux femmes. Cette affaire illustre une question désormais centrale pour les entreprises et les décideurs publics : comment des systèmes d’IA peuvent-ils produire des résultats inéquitables sans avoir été explicitement programmés pour discriminer ?
Cette question est devenue encore plus importante avec l’entrée en vigueur progressive du règlement européen sur l’IA, qui classe les systèmes utilisés dans le recrutement et l’emploi parmi les applications à haut risque. Le message est clair pour les entreprises qui recourent à l’IA afin de sélectionner, classer ou recommander des candidats… Supprimer les variables sensibles telles que le sexe ou l’origine ethnique ne suffit pas à s’acquitter de ses responsabilités en matière d’équité.
Une idée répandue consiste à penser que les biais apparaissent uniquement lorsqu’un algorithme utilise directement des caractéristiques protégées. Or, le problème est souvent plus subtil. Les systèmes d’IA apprennent à partir de données historiques, elles-mêmes issues de décisions humaines qui peuvent déjà refléter des inégalités.
Les plateformes de travail en ligne et les outils de recrutement s’appuient de plus en plus sur des systèmes de classement. Ceux-ci privilégient généralement des indicateurs tels que les performances passées, le nombre de missions réalisées ou l’expérience accumulée.
Du point de vue des entreprises, cette logique paraît parfaitement rationnelle, puisqu’elle réduit les coûts de recherche, facilite l’identification des profils pertinents et valorise l’expérience. Mais elle comporte aussi un risque. Ces indicateurs supposent que les résultats passés reflètent uniquement le mérite individuel. Or, ils peuvent également être le produit d’un accès inégal aux opportunités.
Une perfide boucle de rétroaction
C’est ainsi qu’apparaît une boucle de rétroaction. Une personne qui bénéficie d’un léger avantage au début de sa carrière accumule davantage d’expérience. Cette expérience améliore son classement dans les systèmes automatisés, ce qui augmente sa visibilité et lui ouvre de nouvelles opportunités. Au fil du temps, cet avantage initial se renforce.
Pour les entreprises qui utilisent des outils de recrutement fondés sur l’IA, cela signifie qu’un classement présenté comme « objectif » ou « basé sur la performance » peut, en réalité, reproduire et amplifier des inégalités préexistantes.
Des inégalités humaines aux biais algorithmiques
Nos recherches sur les grandes plateformes de travail en ligne montrent que ces mécanismes peuvent affecter plusieurs groupes simultanément. Les femmes, en moyenne, accumulent moins de missions réalisées que des hommes présentant des caractéristiques comparables, comme l’âge, le niveau d’études, le tarif horaire, les évaluations reçues et les vérifications du profil. Cette différence se traduit ensuite par une moindre visibilité dans les classements. Les écarts peuvent être encore plus marqués lorsque plusieurs facteurs se combinent : les femmes issues de minorités ethniques, par exemple, sont souvent davantage pénalisées que ne le laisserait prévoir l’effet de chacune de ces caractéristiques prise isolément.
De même, les jeunes professionnels disposent souvent de moins d’expérience à valoriser et peuvent être systématiquement désavantagés dans les classements, malgré des compétences comparables. Il en résulte un « déficit de visibilité » qui ne reflète pas nécessairement les capacités réelles des candidats.
L’un des enseignements majeurs est que ces résultats peuvent apparaître même en l’absence de toute information démographique explicite. Les biais passent alors par des variables indirectes, comme le nombre de missions déjà réalisées. Cet indicateur, qui reflète les décisions de recrutement passées, semble neutre, mais il est étroitement lié à des désavantages structurels.
Ouvrir la boîte noire
Pour les organisations qui déploient l’IA dans le recrutement, la gestion des talents ou les ressources humaines, plusieurs enseignements se dégagent. D’abord, supprimer les données sensibles ne suffit pas. Un système peut continuer à reproduire des inégalités s’il apprend à partir de résultats historiques eux-mêmes biaisés. On peut se demander si le fait de supprimer complètement les données sensibles des profils de free-lances permettrait de résoudre le biais humain initial.
Ensuite, les critères d’optimisation méritent une attention particulière. Les outils conçus pour identifier les « meilleurs candidats » risquent de favoriser ceux qui ont déjà bénéficié d’une plus grande visibilité ou d’un accès privilégié aux opportunités.
Enfin, les boucles de rétroaction doivent être considérées comme un véritable enjeu de gouvernance. Lorsqu’un système influence la visibilité des candidats, et que cette visibilité façonne les données utilisées demain, les biais peuvent s’autoalimenter.
B smart, 2026.
Un défi majeur pour la gouvernance de l’IA
La mise en œuvre de la réglementation européenne marque un changement de perspective. La question n’est plus seulement de savoir si un algorithme utilise des données sensibles, mais aussi s’il produit des effets discriminatoires par des mécanismes indirects.
Les enjeux dépassent largement le recrutement. Aujourd’hui, les algorithmes influencent également l’octroi de crédit, la tarification des assurances, les recommandations personnalisées ou encore la modération de contenu. Dans tous ces domaines, comprendre l’origine des données devient aussi important que la conception technique des modèles.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
Les utilisateurs des applis 100 % Apple pourront-ils continuer à communier ensemble simultanément ? Copie d'écran d'un membre Apple Fitness+ fourni par l'auteur
L’ESSENTIEL
Avant le lancement d’un nouvel iPhone pliant, Apple a dévoilé en juin dernier une nouvelle version de SIRI renforcé à l’IA.
Les consommateurs français et européens risquent de ne pas pouvoir l’expérimenter, en raison du DMA.
Pour les aficionados de la marque qui se vivent comme membres d’une même communauté, cette impossib
Les utilisateurs des applis 100 % Apple pourront-ils continuer à communier ensemble simultanément ?Copie d'écran d'un membre Apple Fitness+ fourni par l'auteur
L’ESSENTIEL
Avant le lancement d’un nouvel iPhone pliant, Apple a dévoilé en juin dernier une nouvelle version de SIRI renforcé à l’IA.
Les consommateurs français et européens risquent de ne pas pouvoir l’expérimenter, en raison du DMA.
Pour les aficionados de la marque qui se vivent comme membres d’une même communauté, cette impossibilité d’accéder à une nouvelle fonction a un impact plus important que l’on pourrait imaginer.
Juin 2026. Apple dévoile Siri AI, un assistant personnel, capable de communiquer avec les principales applications d’Apple et celles d’autres entreprises, de s’adapter au contexte de chacun, et de respecter la vie privée. L’entreprise souligne des difficultés à se conformer au règlement européen sur les marchés numériques. En effet, le Digital Markets Act exige qu’Apple donne aux IA concurrentes la même facilité d’accès aux applications et aux données personnelles que Siri AI.
Pour expliquer ses difficultés, la marque californienne met en avant sa volonté de « préserver la vie privée et la sécurité » de ses utilisateurs et déclare ne pas être en mesure d’annoncer une date de disponibilité pour le marché européen.
Une transformation de l’expérience utilisateur
Si la date de lancement de nouveaux produits peut varier selon les zones géographiques, ce cas est différent. Il ne s’agit pas d’un modèle d’iPhone qui arrive quelques mois plus tard. Il est question d’une ressource totalement intégrée au système d’exploitation, qui va transformer l’expérience utilisateur, dont seront privés les utilisateurs européens.
Parmi les fonctionnalités concernées, citons d’abord la nouvelle application Siri AI, l’assistant « intelligent » annoncé comme capable de comprendre le contexte personnel (lire les courriels, messages, photos, contacts ou réunions) afin de répondre à des requêtes complexes, du type : « Retrouve l’adresse du restaurant que Julie m’a envoyée dans mes messages la semaine dernière, vérifie la météo prévue là-bas samedi soir et ajoute un rappel d’itinéraire dans mon calendrier 1 heure avant. » Sont aussi visées la version enrichie de Visual Intelligence, qui analyse et reconnait ce qui se trouve devant l’objectif ou à l’écran en temps réel. Et enfin, des nouveaux outils d’écriture intégrés au système.
En résumé, un assistant capable de dialoguer avec les applications, de comprendre le contexte de l’utilisateur, de rédiger ou résumer à sa place. La non-disponibilité de Siri AI exclut les Européens des nouvelles pratiques partagées par les utilisateurs d’Apple dans le monde et dégrade leur place dans cette tribu.
La tribu aux écouteurs blancs
Dans une société décrite par le sociologue Baumann comme « liquide », les individus sont confrontés au défi de construire leur identité sans pouvoir s’appuyer sur les cadres de référence et les ressources fournies par des institutions traditionnelles (État, partis politiques, entreprises…). Cherchant à créer du lien social, ils se regroupent dans des communautés ou des tribus, sur une base ethnique, culturelle ou affinitaire. Michel Maffesoli a décrit cela dans le Temps des tribus. On entre dans une (ou plusieurs) tribu(s) par un choix d’appartenance, pour « réenchanter » son monde à travers un univers de rituels, de pratiques, d’émotions, de récits et d’imaginaires partagés.
Une marque peut être un tel objet de regroupement. Dès 2001, Muniz et O’Guinn introduisent le concept de communautés de marques et décrivent leurs caractéristiques : la constitution d’un système culturel propre, le partage de récits de marque, des pratiques d’entraide, un rôle de promotion, et des rassemblements autour du totem que représente la marque.
Dans le cas d’Apple, le terme de tribu peut être préféré à celui de communauté, afin de prendre en considération la place que la marque a prise en 2026 dans la vie de plus de 1,5 milliard d’individus, et le fait que les motivations de leur attachement à la marque sont variées. Pour certains, elle peut être utilitaire (facilité d’utilisation, coût de sortie vers Android élevé…) ; pour d’autres, elle sera symbolique (expression de soi, statut)…
La communauté de marque est centrée sur la marque comme un totem de rassemblement. Elle est structurée, durable, et ses membres sont moralement engagés. La tribu au sens de Maffesoli est davantage basée sur une appartenance émotionnelle et esthétique, un affect partagé, une fluidité des pratiques, et sur des rassemblements autour de moments clés, comme, par exemple, le lancement d’un nouvel iPhone.
L’appartenance peut être multiple, et les frontières poreuses : un membre de la tribu Apple peut se passionner pour Fortnite Battle Royale sur son PC. Enfin, si la marque définit la communauté, son rôle est davantage de servir la tribu. Elle supporte souvent des liens préexistants (familiaux, amicaux…), plutôt que de les créer de toutes pièces.
Les membres de la tribu Apple partagent des signes de reconnaissance : les écouteurs blancs signalent cette appartenance dans les transports, les lieux de vie, les écoles… Ils partagent aussi des pratiques. Par exemple, ils organisent leur mémoire familiale commune dans les albums partagés d’iCloud. Les photos des événements familiaux circulent dans un espace réservé aux membres désignés. Avec AirDrop, ils partagent un fichier avec quelqu’un de physiquement proche, créant ainsi un lien de proximité instantané.
Rituels en commun
Ils partagent également des rituels, comme ceux que j’ai étudiés dans ma thèse consacrée à l’utilisation de la marque pour construire l’identité familiale. Ainsi, l’utilisation de FaceTime favorise une participation à distance à des rituels de la vie familiale :
« Nanie, tous les matins à 8h, elle est dans son lit, elle attend l’appel de son petit-fils, elle coupe son William Leymergie et elle fait FaceTime » (Denis, mon beau-père).
Offrir un cadeau Apple peut être une manière d’afficher l’appartenance à un groupe familial : « Je n’aurais jamais aimé qu’on m’offre une autre tablette qu’un iPad… C’est un signe de reconnaissance. »(Fabienne, recevant un iPad de ses 3 enfants).* Certains pratiquent une forme d’« économie circulaire » au sein de leur famille ou de leur groupe d’amis : « Toi, tu achètes pas mal de trucs, tu les revends ou tu les donnes… Donc les produits ont une deuxième vie chez nos amis ou dans la famille ». (Valérie, mon épouse). Les membres de la tribu Apple peuvent également vivre ensemble des activités culturelles ou sportives : regarder un film (Apple TV), écouter de la musique (Apple Music) ou s’entrainer à distance (Apple Fitness+) avec SharePlay.
Nombreux sont ceux qui partagent sur les réseaux sociaux des rituels liés à la marque : le déballage du dernier iPhone, la visite d’un Apple Store lors d’un voyage, le visionnage des keynotes…
Ces exemples illustrent une idée forte, formulée par Bernard Cova : « le lien importe plus que le bien ». Nous achetons moins les fonctionnalités d’un produit, que les liens qu’un produit ou, plus globalement, une marque, nous permet de créer et de renforcer avec les autres. C’est la “valeur de lien”.
La marque devient, comme le souligne Celia Lury, une plate-forme évolutive de ressources, un support dynamique des pratiques des consommateurs, un médiateur incontournable entre les utilisateurs. Il peut s’agir de ressources symboliques (le récit de la marque, des slogans…), de ressources matérielles (des produits, des magasins…), de ressources humaines (le personnel des magasins…) ou technologiques (des services en ligne…). La marque Apple n’est pas seulement une gamme de produits désirables. C’est une marque qui accompagne ses utilisateurs dans leur vie, et met à leur disposition une plate-forme de ressources relationnelles.
Hey « et Google » ?
Le DMA formule la même exigence pour Google que pour Apple. Pour autant, les conséquences sont-elles comparables ? Ce serait le cas si l’on pouvait parler d’une tribu Android. L’utilisateur d’Android n’est pas un membre. Il est un consommateur de services auxquels il accède gratuitement dans la majorité des cas. Il est également un produit, car les annonceurs paient pour accéder à lui et à ses données.
Peu de signes visibles témoignent de l’existence d’une tribu Android. Où sont les équivalents des AirPods, iPhone ou MacBook que les gens sont fiers d’afficher pour exprimer leur identité et leur connexion émotionnelle à la tribu Apple ? Où sont les rituels partagés exprimant l’effervescence collective observée devant les Apple Store à l’occasion du lancement d’un iPhone ? Enfin, le récit mythologique fondateur d’Apple, la puissance symbolique du logo Apple ne trouvent pas d’équivalent chez Google, malgré son succès mondial. Elle est une marque fonctionnelle telle que définie par Park, Jaworski et MacInnis. Elle répond à des besoins utilitaires, mais sans dimension symbolique ou expérientielle remarquable.
Ouest France 2025.
DMA : le lien brisé
LE DMA vise à réglementer les marchés numériques. Il cible les « contrôleurs d’accès » d’Internet, et lutte contre leurs pratiques anticoncurrentielles. Il poursuit des objectifs légitimes : concurrence, innovation, et liberté de choix du consommateur.
Mais il applique des outils de régulation de marché à une infrastructure de lien social. En régulant le bien (Siri AI), il détériore le lien social tissé depuis plus de 20 ans dans la tribu Apple. Les 120 millions d’Européens utilisateurs d’iPhone appartiennent toujours à la tribu Apple, mais ils sont des membres de seconde zone, exclus des nouvelles pratiques et des nouveaux rituels qui vont se développer avec Siri AI. Ils regarderont sur YouTube leurs homologues états-uniens utiliser Siri AI, en espérant que leur tour viendra.
La relation à la marque est également dégradée, puisque le brand love, le degré d’attachement émotionnel envers la marque est menacé, car celle-ci ne tient plus la totalité de sa promesse avec les européens. Le DMA provoque une double altération : une rupture du lien tribal entre les membres de la tribu en fonction de leur zone géographique, et un accroc dans la relation émotionnelle à la marque.
La question du coût du déclassement forcé des millions de personnes qui sont à la fois membres de la tribu Apple, et citoyens de l’Union européenne est une réflexion à ouvrir. En cas d’échec dans les négociations, qui sera tenu responsable de la dégradation du lien ?
Dominique Billon ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Au cours de la présente campagne électorale, le recours aux technologies est très souvent mis de l’avant comme solution presque magique pour améliorer les services et augmenter l’efficacité de l’État. Pourtant, dans les faits, les citoyens peinent de plus en plus à accéder en ligne aux services publics.
Parmi les promesses électorales rapidement énoncées après le déclenchement des élections, plusieurs concernent des enjeux liés à l’usage du numérique. Le Parti conservateur promet d’importante
Au cours de la présente campagne électorale, le recours aux technologies est très souvent mis de l’avant comme solution presque magique pour améliorer les services et augmenter l’efficacité de l’État. Pourtant, dans les faits, les citoyens peinent de plus en plus à accéder en ligne aux services publics.
Parmi les promesses électorales rapidement énoncées après le déclenchement des élections, plusieurs concernent des enjeux liés à l’usage du numérique. Le Parti conservateur promet d’importantes économies, réalisées entre autres grâce à « une accélération majeure de la numérisation de l’État ». Le Parti québécois compte entre autres sur l’usage de l’intelligence artificielle (IA) pour « gagner en efficacité » et améliorer les services publics.
La promesse de couper dans la bureaucratie, notamment en accélérant la transition numérique, fait aussi partie du discours de la Coalition Avenir Québec, le parti du gouvernement sortant.
Le déclenchement de la campagne électorale a aussi coïncidé avec la sortie de l’enquête sur la fracture numérique NETendances. Or, les chiffres présentés sont directement en contradiction avec de telles promesses électorales. Pour commencer, quatre adultes sur dix mentionnent avoir besoin d’autrui pour utiliser les technologies numériques dans les tâches du quotidien. Ce qui inclut les services déjà en ligne.
Comment l’accompagnement aux démarches en ligne peut-il contribuer à maintenir la relation entre l’État et le citoyen, dans un contexte de dématérialisation des services publics ? Dans quelle mesure aiderait-il à répondre aux inégalités sociales et numériques ? Tant dans ma recherche doctorale en inclusion numérique, action publique et médiations que dans le cadre de mon travail, mes projets ont comme dénominateur commun la communication entre l’État et le citoyen, autant du côté de l’émetteur que du destinataire.
La fracture numérique au Québec
Six adultes sur dix n’ont jamais entendu parler de la fracture numérique. Par fracture numérique, on entend les diverses inégalités qui peuvent exister entre les personnes quant à l’accès et l’utilisation de la technologie.
Elle est généralement représentée sur une échelle à trois niveaux. Au premier niveau, les inégalités sont d’ordre matériel : l’absence d’accès à un ordinateur, par exemple. Le deuxième niveau concerne les compétences, c’est-à-dire la capacité à se servir d’un ordinateur. Le troisième niveau, concerne les inégalités de bénéfices : ne pas vouloir utiliser les services en ligne, par exemple, revient à se priver de certains droits et de certains avantages économiques.
L’Association pour la défense des droits sociaux Québec métropolitain a manifesté le 29 juin 2026 contre les ratés de l’algorithme du projet UNIR, devant le Ministère de l’Emploi et de la Solidarité sociale à Québec, avec un robot baptisé « PUNIR ».(Site web de l’ADDSQM)
D’ailleurs peu plus tôt cette année, dans une autre enquête NETendances, on apprenait que près de 30 % des personnes interrogées n’avaient pas interagi en ligne avec le gouvernement. Cela représente, en chiffres absolus, près de 2 millions de Québécois et Québécoises de 18 ans et plus. Et les personnes qui l’ont fait ont jugé ces interactions de moins en moins simples.
Entre autres, l’intelligence artificielle est biaisée, ce qui peut amplifier certaines inégalités. C’est notamment le cas avec l’algorithme implanté en mars 2025 l’aide sociale par le ministère de l’Emploi et de la Solidarité sociale (le projet UNIR), dont les problèmes ont fait l’objet de reportages au printemps 2026.
Numériser sans exclure
La promesse électorale d’améliorer les services pour l’aide au numérique met de l’avant deux visions du monde : du côté de l’État, la volonté de simplifier les services et de réduire les coûts. Du côté de la population et des organismes qui la soutiennent, la volonté de ne laisser personne derrière, en s’assurant que tous et toutes obtiennent les services et accèdent à leurs droits.
Bien sûr, on ne songe pas à remettre en question l’aspect pratique des services en ligne, comme le montre entre autres cette revue de littérature de 2022. Le virage numérique ne devrait toutefois pas nous faire oublier les citoyens et les citoyennes qui ne peuvent ou ne veulent pas les utiliser. L’âge, le revenu, le niveau de scolarité et le lieu où l’on vit sont autant de facteurs susceptibles de nous rendre plus vulnérables aux inégalités numériques.
Pour bénéficier pleinement de la transformation numérique déjà amorcée, ces citoyens et citoyennes plus vulnérables ont besoin d’être accompagnés. La présence d’une tierce partie jouerait un rôle d’amplification des bénéfices en plus d’améliorer l’inclusion sociale et numérique. Il existe un domaine de recherche naissant, mais en pleine expansion, qui vise à comprendre le rôle de ces tierces parties.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
Augmentation des besoins d’accompagnement
Vers qui se tournent les citoyens et citoyennes du Québec lorsqu’ils rencontrent des enjeux pour utiliser les services en ligne ? Au-delà des cours d’initiation aux outils technologiques, peu d’initiatives existent en matière d’accompagnement à cet égard.
Jusqu’ici, la littérature suggère que ce sont des proches aidants, des travailleurs sociaux ou des bibliothécaires qui endossent ce rôle. Le problème est que cette aide est éparse et n’est pas organisée ou professionnalisée. Or, « [l]’augmentation des besoins d’accompagnement au numérique suppose la structuration de l’écosystème de l’inclusion numérique et la professionnalisation des métiers qui en découlent », comme le souligne ce rapport produit par l’INRS.
Alors même que l’État québécois rappelle l’importance de replacer la population au centre de la transformation numérique, ce n’est pas l’accélération de la numérisation des services qui devrait être priorisée. Dans cette course électorale qui s’amorce, la vraie question devrait être : sommes-nous prêts à accepter l’exclusion d’une partie de la population, au nom du principe de l’efficience de l’État ?
Émilie Michaud ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’ESSENTIEL
Le succès ou le rejet d’une technologie ne dépend pas que de ses qualités intrinsèques. La qualité du récit qui l’accompagne importe.
Après l’engouement pour ChatGPT, les récits autour de l’IA commencent à créer des peurs, de l’angoisse, de la défiance.
Ces discours, performatifs et quasi exclusivement états-uniens, masquent certaines questions essentielles.
Depuis les travaux fondateurs de l’économiste autrichien Joseph Schumpeter, la recherche en management de l’innovation
Le succès ou le rejet d’une technologie ne dépend pas que de ses qualités intrinsèques. La qualité du récit qui l’accompagne importe.
Après l’engouement pour ChatGPT, les récits autour de l’IA commencent à créer des peurs, de l’angoisse, de la défiance.
Ces discours, performatifs et quasi exclusivement états-uniens, masquent certaines questions essentielles.
Depuis les travaux fondateurs de l’économiste autrichien Joseph Schumpeter, la recherche en management de l’innovation souligne que ce qui distingue une invention d’une innovation, c’est sa diffusion. Or, cette diffusion dépend notamment de l’acceptabilité sociale de l’invention et de la manière dont ses usages sont perçus. Sans cette acceptabilité, l’invention risque d’être cantonnée aux expérimentations des scientifiques et aux spéculations des investisseurs. Cependant, pour obtenir l’adhésion, une innovation doit être portée par un récit capable de susciter l’intérêt, si ce n’est l’enthousiasme. L’intelligence artificielle illustre tout à fait ce phénomène : alors que son récit se cherche, son acceptabilité semble de plus en plus contestée.
En juillet 2026, le Monde diplomatique a consacré sa une à un titre volontairement provocateur : « Tout le monde déteste l’IA ». À l’émerveillement initial suscité par ChatGPT succède en effet une contestation portant sur les emplois, la consommation d’électricité et d’eau des centres de données, la vie privée et le pouvoir des entreprises technologiques. L’IA apparaît comme un « Moloch numérique » dont les coûts seraient supportés par la collectivité, tandis que ses bénéfices ne profiteraient qu’à une poignée d’oligarques.
En mai 2026, lorsqu’Eric Schmidt, l’ancien directeur général de Google, a expliqué à près de 10 000 diplômés de l’Université de l’Arizona que l’intelligence artificielle toucherait toutes les professions, des huées se sont élevées dans le public. Depuis, des discours consacrés à l’intelligence artificielle ont été sifflés dans plusieurs autres universités américaines. Selon une enquête de la Harvard Kennedy School, citée par l’Associated Press, environ 70 % des étudiants américains considèrent désormais l’IA comme une menace pour leurs perspectives professionnelles.
Des récits qui suscitent l’hostilité ?
Comment une technologie présentée par ses concepteurs comme porteuse d’une prospérité sans précédent en est-elle venue à susciter une telle hostilité ? Une partie de la réponse tient évidemment aux effets réels ou anticipés de l’IA sur l’emploi, l’éducation, l’information et l’environnement. Cependant, une autre réside dans les récits qui l’accompagnent.
On peut ainsi estimer que quatre grands récits – ou, plus exactement, quatre combinaisons de récits – structurent aujourd’hui le discours sur l’intelligence artificielle. Ces récits qui ne sont ni exclusifs ni parfaitement cohérents. Une même entreprise ou un même dirigeant peut en combiner plusieurs, parfois contradictoires.
Récit n°1 : « L’IA va nous sauver… si elle ne nous détruit pas »
Le premier grand récit de l’intelligence artificielle est celui d’un pari civilisationnel : l’IA pourrait ouvrir une ère d’abondance et de progrès sans précédent, mais elle pourrait aussi provoquer des catastrophes majeures, voire échapper au contrôle humain.
Dans un texte publié en septembre 2024, Sam Altman, directeur général d’OpenAI, présente l’IA comme le moteur d’un progrès matériel et scientifique exceptionnel. Elle pourrait accélérer la recherche médicale, contribuer à résoudre des problèmes complexes et donner à chacun des capacités jusqu’ici réservées à quelques spécialistes.
En octobre 2024, Dario Amodei, directeur général d’Anthropic, développe une vision comparable. Il imagine des millions de copies d’une intelligence comparable à celle des meilleurs chercheurs, capables de comprimer plusieurs décennies de progrès scientifique en quelques années : médecine, neurosciences, santé mentale, dérèglement climatique ou lutte contre la pauvreté. Cependant, Dario Amodei accompagne cette promesse d’un discours alarmiste. Les mêmes modèles pourraient faciliter des cyberattaques, aider à la conception d’armes biologiques ou, comme la science-fiction nous l’annonce depuis des décennies (de 2001, l’Odyssée de l’espace à Matrix ou Terminator), devenir suffisamment autonomes pour échapper à notre contrôle.
Elon Musk : toujours plus loin
Elon Musk pousse cette logique beaucoup plus loin. En juillet 2026, dans un entretien accordé àThe Economist, il compare notre situation future à celle des chimpanzés face aux humains : lorsque l’écart d’intelligence devient trop important, il devient difficile d’imaginer que les moins intelligents restent aux commandes. Selon lui, il existe un risque compris entre 10 % et 20 % que l’IA et les robots provoquent une catastrophe.
Cependant, il considère que même si un bouton d’arrêt existait, il ne faudrait pas l’actionner, car il est convaincu que le résultat le plus probable sera une « incroyable abondance pour tous » : l’IA et la robotique rendront progressivement le travail facultatif, permettront un revenu universel élevé et finiront même par rendre l’argent superflu. C’est le récit de « l’apocalypse heureuse » : la catastrophe est possible, les humains ne resteront probablement pas maîtres des systèmes, mais l’accélération doit tout de même se poursuivre, car elle est à la fois irrésistible et potentiellement merveilleuse.
Récit n°2 : « La démystification de la superintelligence »
Le chercheur Yann LeCun, ancien directeur de la recherche de Meta, défend pour sa part un contre-récit rationaliste. En février 2024, dans un entretien accordé au magazine Time, il a souligné que les grands modèles de langage ne disposent ni d’une compréhension robuste du monde physique, ni de véritables capacités de raisonnement et de planification comparables à celles des humains. Il juge peu crédible le scénario dans lequel une intelligence artificielle serait capable de prendre le contrôle du monde. Il défend également l’ouverture des modèles. Selon lui, de même qu’une démocratie a besoin d’une presse pluraliste, elle aurait besoin d’une pluralité de modèles et d’assistants.
Cette position n’est pas dépourvue d’intérêts industriels : elle a longtemps été cohérente avec la stratégie de Meta en faveur de modèles plus ouverts et reste compatible avec l’approche des « modèles mondes » défendue par Yann LeCun. Cependant, elle a le mérite de replacer le débat dans le domaine de l’ingénierie plutôt que dans celui de la prophétie. Les risques ne proviennent pas nécessairement d’une machine qui déciderait de dominer l’humanité, mais des propriétés que les ingénieurs lui donnent, des usages qu’autorisent les entreprises et des institutions chargées de l’encadrer.
France 24 – 2026.
Récit n°3 : « L’IA va nous augmenter, pas nous remplacer »
Microsoft a privilégié un récit apparemment plus modeste, celui du « copilote », selon lequel l’IA générative accompagne l’être humain plutôt qu’elle ne le remplace. Elle résume les réunions, prépare des documents, analyse des données et prend en charge les tâches répétitives. Il s’agit de donner davantage de capacité d’action aux salariés, de libérer leur créativité et d’améliorer leur productivité. La métaphore est habile : dans un avion, le copilote assiste le pilote sans lui retirer symboliquement les commandes.
Cependant, Microsoft ne parle pas seulement de copilotes, mais d’agents capables d’utiliser les données d’une organisation et de réaliser des séquences d’actions. Ce déplacement lexical est révélateur. Le copilote augmente le travail humain, alors que l’agent peut s’y substituer. Le récit de l’augmentation tend ainsi à reléguer au second plan les questions de pouvoir, de qualification et de partage des gains de productivité.
Récit n°4 : « La superintelligence pour tous »
Le 28 juillet 2026, Mark Zuckerberg est lui aussi entré dans la bataille des récits sur l’IA avec une tribune publiée dans le Wall Street Journal. Le PDG de Meta y affirme que la question décisive n’est plus de savoir si la superintelligence existera, mais qui pourra y accéder. Son récit est celui de la « superintelligence personnelle » : chacun pourrait disposer d’un assistant dépassant les capacités humaines, adapté à ses besoins et à ses valeurs. Il s’agit non seulement d’une vision technologique, mais aussi d’une tentative de rendre la rupture de l’IA de nouveau désirable. Sans renoncer à la promesse de la superintelligence, ce récit cherche à la rendre plus acceptable en promettant de la distribuer à chacun.
Cependant, cette démocratisation de l’usage ne garantit pas la démocratisation du pouvoir. Ce récit est cohérent avec les intérêts d’une plateforme mondiale comme Meta : des milliards de personnes peuvent utiliser un assistant personnel tout en restant dépendantes d’une poignée d’entreprises qui possèdent les centres de données, définissent les modèles et contrôlent les données nécessaires à leur apprentissage.
Quand les récits produisent leurs propres conséquences
Ces quatre récits n’expliquent pas à eux seuls l’apparent rejet de l’IA, également nourri par des expériences concrètes (menaces sur l’emploi, transformations imposées, erreurs, centres de données, consommation d’énergie, etc.), mais ils donnent une cohérence à ces inquiétudes. De plus, la focalisation sur l’asservissement ou l’extinction de l’humanité relègue au second plan des enjeux immédiats et bien réels : partage des gains, droits d’auteur, responsabilité, décision humaine, préservation des compétences et coûts environnementaux.
Par ailleurs, ces récits sont performatifs : ils ne décrivent pas seulement un avenir possible, ils contribuent à le produire en orientant les investissements, les comportements et les réglementations. Le récit de la perte de contrôle en fournit un exemple particulièrement frappant. En juillet 2026, l’AI Kill Switch Act a été présenté à la Chambre des représentants américaine. Cette proposition de loi imposerait aux développeurs des systèmes d’IA de conserver la capacité technique de les arrêter. Elle donnerait également au département de la Sécurité intérieure une autorité d’urgence pour ordonner l’arrêt d’un système susceptible de provoquer un dommage catastrophique. Ce projet de loi apparaît comme une traduction politique presque littérale du récit catastrophiste de la perte de contrôle.
Le récit du risque existentiel produit d’ailleurs un effet paradoxal, en renforçant les entreprises qu’il prétend encadrer. En effet, les principaux acteurs de l’IA apparaissent à la fois comme trop dangereux pour être laissés sans surveillance et trop stratégiques pour être réellement freinés. Le débat s’enferme alors entre deux options : laisser les principales entreprises se contrôler entre elles ou donner aux gouvernements le pouvoir exceptionnel d’arrêter leurs systèmes. Dans les deux cas, les citoyens restent largement spectateurs d’une transformation présentée comme inévitable.
Au-delà des récits
Chacun des quatre récits est marqué par une volonté plus ou moins affichée de préserver les intérêts des acteurs établis. En matière d’IA, les capitaux engagés sont tellement astronomiques que si les convictions peuvent être sincères, elles restent nécessairement compatibles avec les objectifs de ceux qui les défendent. Aucun récit industriel n’est totalement désintéressé et la vision affichée par une entreprise ne fait que refléter ses choix stratégiques.
De fait, le problème n’est peut-être pas de trouver le « bon » récit de l’intelligence artificielle, mais de cesser de présenter comme inéluctables des choix techniques, économiques et politiques. Il faut d’abord cesser de personnifier l’IA. Ces systèmes sont conçus, financés et déployés par des organisations humaines. Dire que l’IA veut, décide ou menace, tend à dissimuler ceux qui fixent ses objectifs, choisissent ses usages et en tirent les bénéfices.
Il faut aussi rappeler que le rythme de développement, l’ouverture des modèles, leurs domaines d’utilisation, la répartition des gains et les protections accordées aux individus ne sont pas des phénomènes naturels, mais des décisions qui doivent rester soumises au débat politique.
Enfin, les prophéties doivent céder la place à des questions concrètes : que souhaitons-nous automatiser ? Où maintenir une décision humaine ? Qui contrôle les infrastructures et les données, répond des erreurs et garantit des recours ? Comment mesurer les effets sur l’emploi, les compétences, l’environnement et les inégalités ? Comme le rappelle le pape Léon XIV dans l’encyclique Magnifica Humanitas, publiée en mai 2026, les innovations ne sont jamais neutres : l’enjeu est de savoir qui les déploie, selon quelles règles et au bénéfice de qui.
Il convient aussi de prendre conscience du caractère très américano-centré des quatre récits que nous avons présentés. Le discours officiel chinois offre, par exemple, un contraste révélateur : il ne décrit pas l’annonce d’une superintelligence salvatrice ou apocalyptique, mais l’intégration méthodique de l’IA dans l’économie réelle, au travers d’une politique industrielle volontariste et sous le contrôle de l’État. Ce modèle soulève d’autres questions, notamment sur la centralisation politique, la surveillance et la liberté d’expression, mais il rappelle que l’imaginaire américain de l’IA n’est pas le seul possible.
L’IA doit donc être considérée comme une technologie puissante mais gouvernable, dont les bénéfices doivent être démontrés plutôt que prophétisés. Ses promoteurs ne peuvent la présenter indéfiniment comme incontrôlable, inévitable et bénéfique : une technologie dépourvue de volant ne peut durablement être vendue comme un copilote.
Frédéric Fréry ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Il reste difficile, malgré l’apparition de logiciels de détection, de savoir si un texte a été généré par une intelligence artificielle ou par un humain. Shutterstock (no reuse)
L’ESSENTIEL
Il est très difficile, aujourd’hui, de savoir si un texte est produit par un humain ou par une intelligence artificielle, malgré des avancées législatives qui vont dans le sens d’un affichage de son usage.
Certains logiciels monétisent cette difficulté et proposent de détecter les textes produits par une I
Il reste difficile, malgré l’apparition de logiciels de détection, de savoir si un texte a été généré par une intelligence artificielle ou par un humain.Shutterstock (no reuse)
L’ESSENTIEL
Il est très difficile, aujourd’hui, de savoir si un texte est produit par un humain ou par une intelligence artificielle, malgré des avancées législatives qui vont dans le sens d’un affichage de son usage.
Certains logiciels monétisent cette difficulté et proposent de détecter les textes produits par une IA, mais leur fiabilité reste difficile à prouver.
Si le règlement européen sur l’IA, l’IA Act, promet plus de transparence sur les contenus générés par IA, la majorité des utilisateurs, par défaut, tient pour authentiques les textes ainsi produits.
Les textes générés par intelligence artificielle (IA) ouvrent une situation nouvelle : relevant à leur manière du régime de la post-vérité par leur indifférence à toute catégorisation, ces textes ne sont ni vrais ni faux, ni authentiques ni falsifiés. Nulle autorité ne s’aviserait de s’en porter garant. Les firmes productrices des chatbots se contentent des mentions comme « Peut comporter des erreurs » et autres formules d’un vague précautionneux imitées des industries du tabac ou de l’agroalimentaire.
Prenons l’exemple de l’édition. Un nouveau problème d’authentification se pose aux journalistes comme aux éditeurs de journaux ou de livres. Comment savoir si un manuscrit reçu est l’œuvre d’un humain ou le produit d’une IA ? Cette question met évidemment en jeu la crédibilité des auteurs comme celle des éditeurs.
En amont, les IA ont été entraînées non seulement à partir de données personnelles et de documents en accès libre, mais aussi de textes sous droits. Couvert par un commode « secret industriel » ce pillage initial, euphémisé en fair use, ou « usage équitable », n’a pas été compensé par les quelques droits d’usage négociés discrètement par les éditeurs les plus importants.
Désormais, cependant, l’édition se doit en outre d’évaluer la part prise par l’IA dans les textes qui lui sont soumis pour publication. À la suite de divers scandales, les éditeurs tentent de rassurer leur public en publiant des recommandations destinées aux auteurs.
Or, pour les grands éditeurs scientifiques anglo-saxons, l’usage de l’IA générative ne remet pas en cause l’authenticité des manuscrits soumis : elle doit simplement apparaître dans les remerciements – ce qui est déjà lui reconnaître une personnalité, comme si elle était devenue une collègue. En somme, cet usage semble accepté, bon gré mal gré.
IA et littérature
Dans le domaine de la création littéraire, la notion d’auteur (humain) reste privilégiée. Ainsi, en 2024, la romancière japonaise Rie Kudan reçut le prestigieux prix Akutagawa pour un roman d’anticipation, mais suscita des critiques quand elle révéla malicieusement avoir eu recours à l’IA – pour 5 % du texte seulement assura-t-elle. Comme une prophétie autoréalisatrice, son roman décrit les effets de l’IA sur la société à venir.
Depuis, les jurys semblent plus suspicieux, mais parfois à leur détriment. Gagnant du prix Commonwealth de la meilleure nouvelle, Jamir Nazir dut rendre sa récompense. Mais après un long procès, et sur la foi « de brouillons, d’ébauches, de plans, de documents horodatés et de notes », il eut gain de cause en juillet 2026 et le montant de son prix fut même doublé à titre de dédommagement.
Les indices stylistiques restent d’autant plus conjecturaux que les humains et les IA imitent réciproquement leur langage, par un effet mimétique de code-switching (alternance codique, ndlr) pour les premiers et, pour les IA, par « un alignement » programmé qui les conduit à se régler sur les propos que leur adressent leurs utilisateurs.
La détection de l’IA par l’IA ?
Pour lever les doutes, on a alors recours à des logiciels d’IA spécialisés dans la détection – en application peut-être d’un adage de Mark Zuckerberg, qui affirme que l’IA peut réparer les dommages qu’elle cause, comme jadis la lance d’Achille pouvait magiquement guérir les blessures. Et de fait, les doutes semés par les textes artificiels se sont assez épaissis pour donner matière à un nouveau secteur économique voué à la détection des IA, et que nous nommerons l’« industrie du soupçon ». Elle parvient à monétiser la confusion semée par les textes artificiels.
Dans ce domaine, la firme la plus importante reste Pangram, fondée en 2018. Son directeur, Max Spero, presse les éditeurs de « modérer strictement le contenu généré par IA » (« strictly moderate AI-generated content ») et n’a pas hésité à dénoncer nommément des journalistes, notamment ceux du New York Times. Les accusations, reprises par The Atlantic, suscitèrent une polémique qui s’assourdit toutefois quand James Taranto, dans le Wall Street Journal, montra que les mêmes articles, soumis à Pangram, obtenaient des scores différents à divers moments de la journée.
À l’heure actuelle du moins, les logiciels d’IA destinés à détecter les textes artificiels sont tout aussi opaques et trompeurs que ceux qui ont produit ces textes. Ils se contentent d’aligner des pourcentages : par exemple, le témoignage encore inédit, l’Expérience humaine, de Thierry Crouzet, soumis par son auteur au logiciel Justdone, serait écrit à 61 % par une IA. Il s’interroge : « Je ne serais qu’à 39 % humain ? » Il lui suffit d’ailleurs de soumettre son texte à d’autres outils de détection pour voir varier son pourcentage d’humanité…
Comme ces pourcentages sont calculés à partir d’indices opaques, ces logiciels ne font pas mieux que les lecteurs suspicieux, mais somme toute pire, car ils présentent des conjectures comme des résultats et multiplient ainsi les faux positifs comme les faux négatifs. Aussi, craignant sans doute des injustices et surtout des procès, de grandes universités, comme Austin, Yale, Berkeley ou le MIT, ont décidé d’interdire l’usage des détecteurs d’IA.
Une humanisation artificielle ?
Cependant leur succès ne se dément pas, car l’on prend volontiers les sorties machines pour des résultats. Et outre, ces détecteurs d’IA reposent sur des technologies duales et proposent benoîtement de maquiller les textes générés par IA pour les « humaniser » et se garantir ainsi des accusations, qu’elles soient justifiées ou non.
Ainsi Justdone propose : « Préservez l’authenticité de vos écrits en identifiant les contenus générés par l’IA. Précision de 99,8 %. » Grammarly, pour sa part, « détecte et corrige le contenu généré par IA » et se présente comme un logiciel « d’humanisation ». Inutile de souligner le paradoxe d’une originalité machinale promue par des slogans comme : « Rendez votre texte 100 % original. »
Le recours à une humanisation artificielle ne trahirait-il pas une démission éthique ? Il fait en tout cas les affaires des entreprises de détection, et l’on comprend mieux pourquoi le directeur de Pangram dénonçait des « coupables » : l’intimidation devenait telle que des auteurs en viennent à utiliser son IA pour se prémunir de l’accusation d’avoir utilisé l’IA…
La confusion s’accroît ainsi. Par exemple, accusé par Pangram de publier 41 % de posts longs et 30 % de posts courts générés par IA, le grand réseau professionnel LinkedIn a mis en place un bouton qui permet à ses utilisateurs de marquer les textes qu’ils suspectent de la mention désobligeante AI slop. C’est un moyen d’entraîner son propre détecteur d’IA, mais par des conjectures qui restent incontrôlables. La perplexité s’accroît encore quand on s’avise que LinkedIn met obligeamment à disposition de ses abonnés premium un générateur de textes, et que sa maison mère est actionnaire d’OpenAI.
En somme, on ne saurait s’en remettre aux détecteurs d’IA, puisqu’ils conservent toute l’opacité des chatbots qu’ils sont censés caractériser.
Retenons enfin que cette étrange « humanisation » participe sans doute de la convergence entre textes artificiels et textes « humains » ou plus exactement culturels. Non seulement les auteurs sont peu à peu influencés par les textes artificiels qu’ils lisent, notamment s’ils usent fréquemment des chatbots, mais ils s’en remettent de plus en plus à l’IA pour corriger ceux qu’ils écrivent, avec l’espoir d’écarter les soupçons qui affectent à présent tout le monde, d’autant plus que n’importe quel robot peut jurer sur l’honneur qu’il n’en est pas un – pour peu qu’on le lui demande.
La comparaison entre textes artificiels et textes « humains » appelle un programme de recherche coordonné qui tiendrait compte des procédures de comparaison exploitées de longue date par la lexicométrie et la textométrie. Sur d’autres langues que le français, divers travaux comparatifs ont été menés, sur l’anglais notamment, et principalement à partir de diverses déclinaisons de ChatGPT. Quelle que soit la langue, les résultats sont concordants, malgré la diversité des méthodes, ce qui confirme l’objectivité des traits relevés.
Ainsi, par des méthodes de stylométrie, Przystalski et coll. mettent en évidence, par contraste avec les textes « humains » la monotonie des constructions syntaxiques, la prévisibilité de la structure des phrases, une fréquence encore affaiblie des mots rares, des schémas de ponctuation caractéristiques, et une expressivité limitée. Terčon et Dobrovoljc soulignent aussi un style impersonnel, marqué par la fréquence de nominalisations et des déterminants et une rareté relative des adjectifs et des adverbes. Étudiant des travaux universitaires, Herbold et coll. notent aussi l’abondance des nominalisations (caractéristiques des discours stéréotypés, pour ne pas dire des langues de bois).
Indépendamment d’un programme de linguistique comparative, et sachant que les performances imitatives des chatbots s’accroissent avec l’aide souvent involontaire des utilisateurs, la seule solution pour détecter les textes artificiels reste l’obligation pour les firmes qui les produisent de les caractériser en amont, par des métadonnées et/ou des mentions affichées. Entré en vigueur le 2 août 2026, l’IA Act élaboré par l’Union européenne impose, pour la première fois, un tel marquage sur son territoire – du moins à compter du 2 décembre, les grandes entreprises ayant obtenu un premier délai.
C’est là reconnaître enfin une responsabilité aux producteurs de « contenus », comme aussi aux utilisateurs professionnels. Comme les plateformes prétendent limiter leur rôle à celui d’hébergeurs, elles en restent cependant exemptées, ce qui semble exorbitant, alors que les autres médias sont tenus pour responsables de ce qu’ils diffusent.
S’il faut malgré tout saluer ce courageux retour à la raison juridique, la question des usages individuels reste évidemment ouverte, et rien encore n’empêchera des fraudeurs d’effacer ou de modifier les métadonnées des textes artificiels. En outre, ces métadonnées ne sont lisibles que par certains logiciels et restent hors de portée du grand public. Enfin, les résumés générés par IA, ceux que priment désormais les moteurs de recherche, comme Google, restent exemptés de marquage explicite.
La suspicion qui affecte désormais tous les textes, « humains » ou non, risque donc de perdurer malgré tout. Le problème qui se pose à nous n’est pas celui de la vérité : un texte artificiel peut être lu comme factuellement vrai, un texte naturel peut fourmiller de mensonges, mais la question de l’authenticité doit être posée avant tout.
Même si un texte inauthentique peut être déchiffré, il convient d’en suspendre l’interprétation, en suivant la mise en garde de Friedrich Schlegel, dans sa Philosophie de la philologie (1797) : « Il est inutile d’interpréter les textes inauthentiques. »
En d’autres termes, le critère de l’authenticité reste préjudiciel. Seule l’authenticité permet de légitimer une interprétation et de porter un jugement relevant de la raison pratique, c’est-à-dire de l’éthique. Or, personne ne peut répondre d’un texte artificiel, et il échappe de fait à toute responsabilité : la notion douteusement psychologisante d’hallucination reste trompeuse. En outre, de même qu’un texte qui mélange le vrai et le faux doit être récusé, car le faux l’emporte toujours, un texte composite qui mêle le naturel et l’artificiel, l’authentique et l’inauthentique devient l’objet d’une suspicion légitime.
Toutefois, comme le doute ne peut guère être levé, une crédulité plus ou moins résignée se généralise, si bien que la majorité des utilisateurs tient pour assurés les propos de l’IA. Ainsi, l’affichage des résumés IA en tête des réponses sur les moteurs de recherche semblait déjà, début 2025, suffire à 83 % du public.
François Rastier ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
À partir d’avant-hierintelligence artificielle (IA) – The Conversation
Au fil des décennies, nos réseaux de communications se sont toujours plus complexifiés afin de monter en puissance. Mais ce chemin ne sera pas viable éternellement. Allons-nous bientôt devoir changer d’approche ?
Pendant des décennies, ingénieurs et chercheurs en télécommunications ont poursuivi un seul objectif : transmettre plus d’information, plus vite et avec le moins d’erreurs possible. Qu’il s’agisse d’un appel vocal, d’une vidéo, d’un message ou même de la mesure d’un capteur, toutes c
Au fil des décennies, nos réseaux de communications se sont toujours plus complexifiés afin de monter en puissance. Mais ce chemin ne sera pas viable éternellement. Allons-nous bientôt devoir changer d’approche ?
Pendant des décennies, ingénieurs et chercheurs en télécommunications ont poursuivi un seul objectif : transmettre plus d’information, plus vite et avec le moins d’erreurs possible. Qu’il s’agisse d’un appel vocal, d’une vidéo, d’un message ou même de la mesure d’un capteur, toutes ces données sont encodées numériquement en suites de 0 et de 1, qu’on appelle des bits. Cette suite est elle-même convertie en signaux électromagnétiques transmis par des ondes radio. Dit simplement, les réseaux actuels ne transportent pas le sens d’un message, mais une représentation binaire.
Cette logique a été extraordinairement efficace. Elle a permis l’avènement de la 2G et des SMS, de la 3G avec l’Internet mobile, de la 4G et la vidéo en ligne, puis de la 5G, qui améliore les débits, diminue la latence et permet de connecter de nombreux objets. Mais elle rencontre aujourd’hui une limite : continuer à gagner en performance exige toujours plus de bande passante, d’antennes, de calcul, d’énergie et d’infrastructures, dans un monde pourtant limité. Voyons-nous le bout de notre modèle ?
Optimiser, mais jusqu’à un certain point
À partir des années 1950, une grande partie de l’ingénierie des télécommunications s’est construite autour d’une question fondamentale : quelle quantité d’information peut-on transmettre par seconde et de manière fiable ? La principale difficulté est qu’une transmission subit toujours des perturbations extérieures, ce qu’on appelle le bruit. Ce bruit peut avoir de nombreuses causes : la chaleur des composants électroniques, les interférences avec d’autres communications, les réflexions sur les bâtiments, l’absorption par les murs, les obstacles…
Mis en équation, ce problème donne le théorème de Shannon–Hartley. Il a été formulé après à la fin des années 40 dans le prolongement des travaux de Claude Shannon, et donne une réponse fondamentale à cette question pour un cas idéal. Le débit maximal fiable dépend alors principalement de deux facteurs : la largeur de bande passante disponible, c’est-à-dire l’ensemble des fréquences que l’on peut exploiter pour communiquer, et le rapport entre le signal reçu et le bruit ambiant. Notons que, pour établir cette limite théorique, Shannon suppose un bruit « idéal » : il est aléatoire, indépendant du signal transmis et ses variations suivent une courbe statistique appelée loi normale (ou loi gaussienne). Cette hypothèse représente assez bien de nombreuses sources de bruit physique, sans rendre compte de toutes les perturbations observées dans les réseaux réels…
Pour bien comprendre ce théorème, on peut comparer la télétransmission des 0 et des 1 (les bits) au passage de véhicules. La bande passante peut se comprendre comme la largeur d’une route : plus elle est large, plus on peut faire circuler de véhicules en parallèle. Le rapport signal/bruit indique, lui, à quel point le récepteur distingue clairement le signal utile des perturbations. Il peut être comparé à la visibilité sur la route : avec une bonne visibilité, on peut mettre les véhicules plus proches et les faire circuler plus vite. Lorsque le signal est plus propre, on peut utiliser des codages plus efficaces et transmettre davantage de bits.
Mais ce gain n’est pas illimité ! Au-delà d’un certain point, améliorer encore la qualité du signal rapporte de moins en moins, tout en coûtant de plus en plus. On pourrait dire qu’une fois que la visibilité est bonne, il faudrait rajouter des radars et des instruments de télémétrie, ce qui est plus complexe et coûteux.
Plus de fréquences, plus d’antennes, plus de complexité
C’est cette stratégie qui a porté les générations successives de réseaux mobiles. Pour augmenter le débit, les chercheurs, les opérateurs et les industriels ont mobilisé davantage de fréquences, densifié les réseaux et utilisé des antennes et des algorithmes toujours plus sophistiqués. La 5G s’inscrit pleinement dans cette trajectoire.
Plusieurs technologies illustrent cela. Une onde radio ne suit pas toujours un trajet direct : elle peut rebondir sur une façade, contourner un obstacle, arriver avec un léger retard ou depuis plusieurs directions. Pour résoudre ce problème, une solution est d’utiliser plusieurs antennes à l’émission et à la réception, afin que le réseau puisse exploiter des trajets multiples. Il peut renforcer le signal vers un utilisateur, réduire certaines interférences ou transmettre plusieurs flux de données en parallèle lorsque l’environnement le permet.
Une autre technologie, qu’on appelle le beamforming, repose sur la même logique : coordonner plusieurs antennes pour concentrer l’énergie radio dans une direction donnée, plutôt que de l’émettre dans toutes les directions. Cela améliore la réception, mais suppose de mesurer l’état de la communication, de suivre les déplacements des utilisateurs, de choisir les bons faisceaux et d’adapter en permanence les paramètres de transmission. La performance augmente, mais la complexité matérielle et logicielle aussi.
Cette complexité devient encore plus visible lorsque l’on utilise des fréquences plus élevées, ce qui est pourtant intéressant. Monter en fréquence permet d’accéder à des bandes plus larges, donc potentiellement plus de débit. Cependant, plus la fréquence augmente, plus les pertes augmentent, la pénétration dans les bâtiments diminue et la sensibilité aux obstacles s’accroît. Pour regagner en qualité de signal et en robustesse, il devient alors nécessaire d’installer les antennes plus près des usagers et de diriger l’énergie radio avec des faisceaux plus intelligents.
Cela signifie, très concrètement, plus d’équipements réseau, plus de capacité de calcul, et donc des coûts plus importants et plus de consommation de ressources. On améliore certes les performances, mais au prix d’une complexité matérielle et logicielle croissante et d’un gain d’efficacité énergétique moindre.
Pour la 6G, une approche nouvelle et moins lourde ?
Est-ce pour autant la fin du théorème de Shannon-Hartley ? Non : les limites physiques de la transmission demeurent. Aucun réseau, même « intelligent », ne supprimera le bruit, l’atténuation ou les interférences. En revanche, la stratégie dominante consistant à chercher toujours plus de débit brut fait face à des rendements décroissants. On peut continuer à améliorer les réseaux, mais chaque amélioration devient plus coûteuse en énergie, en infrastructures et en coordination que les précédentes.
C’est dans ce contexte que les recherches sur la 6G posent une question différente. La 6G ne supprimera pas les 0 et les 1. Elle ne s’affranchira pas non plus des lois physiques de la transmission. Mais si l’on continue à raisonner uniquement en termes de bits transmis, ne risque-t-on pas de construire des réseaux toujours plus puissants, mais aussi toujours plus lourds ? L’enjeu n’est plus de se demander « combien peut-on transmettre ? », mais plutôt « qu’est-il réellement utile de transmettre pour atteindre l’objectif ? »
C’est justement le changement de paradigme proposé par ce que l’on nomme les communications sémantiques. Au lieu de chercher à transmettre fidèlement tous les bits d’un message, ces approches visent à transmettre uniquement le sens utile pour accomplir une tâche. Concrètement, l’émetteur et le récepteur partageraient des modèles leur permettant, grâce à de l’IA, de reconstruire l’information pertinente sans échanger toutes les données brutes.
L’objectif est de réduire les besoins en bande passante, en énergie et en calcul, tout en améliorant l’efficacité pour une grande diversité d’usages, comme les robots collaboratifs ou les véhicules connectés. Cette approche est aujourd’hui explorée dans plusieurs projets 6G, mais elle soulève encore des défis majeurs concernant la définition du « sens », la façon d’évaluer la qualité de la transmission, ainsi que le fait d’adapter les modèles d’IA nécessaires à cette technologie à l’ensemble des systèmes qui en auraient l’usage.
Cet article a été rédigé avec l’aide du Dr Quentin Lampin, chercheur senior et co-directeur du laboratoire commun Orange-CEA « AI-Native Communications ».
Ce travail (ou une partie de ce travail) a été réalisé avec le soutien du projet 6GARROW, financé par la Smart Networks and Services Joint Undertaking (SNS JU) dans le cadre du programme-cadre de recherche et d’innovation Horizon Europe de l’Union européenne (convention de subvention n° 101192194), ainsi que par une subvention de l’Institute for Information & Communications Technology Promotion (IITP) financée par le ministère coréen des Sciences et des Technologies de l’Information et de la Communication (MSIT) (référence n° RS-2024-00435652)
Emilio Calvanese Strinati est membre du Joint Orange-CEA Lab in AI-Native Communications. Il a reçu des financements de la Commission européenne.
L'irruption des intelligences artificielles génératives interroge tous les métiers. Il était donc fatal que le métier des créatifs se pose la question. Que devient la créativité quand une IA peut inventer un concept ? Loin de disparaître, elle se redéploie. Découvrez de quelle manière.
En 2018, Shantanu Narayen, PDG d’Adobe de l’époque, décrivait l’intelligence artificielle (IA) comme un « assistant créatif » destiné à prendre en charge les tâches « fastidieuses » pour « libérer » le professi
L'irruption des intelligences artificielles génératives interroge tous les métiers. Il était donc fatal que le métier des créatifs se pose la question. Que devient la créativité quand une IA peut inventer un concept ? Loin de disparaître, elle se redéploie. Découvrez de quelle manière.
En 2018, Shantanu Narayen, PDG d’Adobe de l’époque, décrivait l’intelligence artificielle (IA) comme un « assistant créatif » destiné à prendre en charge les tâches « fastidieuses » pour « libérer » le professionnel. L’IA ne remplacerait pas l’intelligence humaine, assurait-il ; elle aiderait simplement à « faire ce qu’on aime, mieux et plus vite ».
Ce récit de l’IA subordonnée au créateur humain n’aura pas survécu à l’irruption des grands modèles de langage. Avec ChatGPT ou Copilot, l’IA n’exécute plus seulement des tâches répétitives : elle génère des concepts, esquisse des directions artistiques, rédige des stratégies, avec toujours plus de pertinence et de fiabilité.
Brouillage entre l’humain et la machine
Le partage des rôles entre l’humain-créateur et la machine-exécutante ne correspond plus à la réalité des pratiques. L’anthropologue de la communication Fabienne Martin-Juchat (2020) interroge ce type de brouillage sous le terme de « nouvelles agentivités » : quand les dispositifs techniques proposent, orientent, infléchissent l’action, la capacité d’agir se redistribue entre humains et non-humains.
Les grandes organisations du secteur en ont pris acte. Le groupe Havas a investi dans la formation de ses collaborateurs à l’IA – non seulement les directeurs artistiques, mais aussi toutes les autres fonctions.
Nos observations auto-ethnographiques menées dans le cadre d’une thèse en agence le confirment : des prompts spécifiques sont recommandés pour stimuler la créativité des résultats. Ainsi, avec l’expression « shower thoughts » dans une requête, on demande à l’IA de penser comme on le ferait sous la douche, dans ce flux de conscience où les idées surgissent sans qu’on les ait cherchées.
RIP la créativité ?
Si l’on peut apprendre à tout le monde à obtenir des résultats créatifs grâce à l’IA avec les bons prompts, que devient la créativité comme compétence professionnelle ? Comme l’ont montré les chercheurs en communication Dany Baillargeon et Alexandre Coutant, celle-ci n’était déjà plus, bien avant l’IA, l’apanage des seuls métiers « créatifs », puisqu’exigée et parfois revendiquée par d’autres fonctions de l’organisation, bien au-delà des directions artistiques.
L’IA radicalise ce mouvement, en banalisant la génération d’idées surprenantes – l’un des leviers centraux de performation de la créativité dans l’univers du conseil – et, par là même, fait de l’émission d’idées extraordinaires une activité ordinaire. Et si, du fait de cette banalisation, la définition, l’exercice et la reconnaissance de la créativité se jouaient de moins en moins dans cette dimension ?
Deux compétences centrales
Aujourd’hui, deux récits dominent le débat public :
celui d’une créativité phagocytée par l’IA,
celui d’une créativité « boostée » par la machine.
L’un comme l’autre traite la créativité comme un objet stable, qu’on pourrait détruire ou amplifier. Notre recherche en sciences de l’information et de la communication menée au laboratoire CIMEOS, adossée à notre pratique de planneuse stratégique en agence, suggère autre chose. En entrant dans le processus créatif, l’IA en transforme les conditions d’exercice. Deux compétences apparaissent alors centrales : le discernement et l’intuition.
Le discernement ne se réduit pas à juger si une proposition de l’IA est « bonne » ou « mauvaise ». Il engage la capacité à interroger les critères mêmes du jugement. À la question « qu’est-ce qui fait une expérience de marque réussie ? », un outil comme Copilot répond par une liste de critères dont la « fluidité », érigée en dogme par l’UX (User Experience) industrielle. Or, cette grille n’est pas neutre. Si la « marque » (comprendre ici, l’organisation commanditaire d’une prestation de conseil) accompagnée veut générer de la surprise, la « friction » pourrait être plus pertinente que la « fluidité ». Déranger, faire réagir, créer du décalage : voilà des stratégies créatives que l’IA ne proposera pas, parce qu’elle reflète pour le moment le consensus sédimenté dans ses données d’entraînement.
Ce discernement n’est pas inné. Dans leur ouvrage Mind Over Machine (1986), les philosophes Hubert et Stuart Dreyfus montraient que le passage de « compétent » à « expert » se caractérise par l’abandon des règles explicites au profit d’un jugement situationnel. Le novice suit les règles ; l’expert sait quand les transgresser. Face à une IA qui généralise à partir de patterns ou schèmes dominants, cette capacité de transgression informée est décisive.
Inimitable intuition
Dans les travaux des chercheurs en sciences de gestion Erik Dane et Michael G. Pratt (2007), l’intuition est définie comme un jugement affectivement chargé, rapide et holistique. Là où le raisonnement analytique procède étape par étape et peut être reproduit par une IA, elle opère par synthèse immédiate d’un ensemble de signaux corporels, émotionnels et contextuels.
Le planneur stratégique qui *sent*qu’une direction créative est juste avant de pouvoir l’expliquer ; le directeur artistique qui perçoit qu’une image « fonctionne » sans savoir dire précisément pourquoi ; le consultant qui pressent qu’un annonceur n’adhérera pas à une proposition en apparence adaptée : tous mobilisent un savoir incorporé, sédimenté par l’expérience, qui échappe à la formalisation algorithmique.
Ni mystique ni irrationnel, ce savoir est le produit d’années de pratique, de succès et d’échecs, d’interactions humaines, et conduit parfois à aller contre le consensus, à parier sur une idée fragile. Tandis que l’IA, par construction, tend vers le probable, l’intuition humaine peut tendre vers l’improbable. C’est peut-être là que se loge la créativité la plus féconde.
Arte, 2025.
Humain et l’IA : une altération mutuelle
Discernement et intuition ne sont pas des remparts contre l’IA. Ce sont les conditions d’une relation de qualité avec elle. Le professionnel, qui interroge l’IA, évalue ses propositions, les infléchit ou les rejette, ne fait pas qu’« utiliser un outil ». Il s’engage dans un processus qui le transforme autant qu’il transforme le résultat.
Le philosophe John Dewey appelait « transaction » ce type de processus dans Art as Experience (1934). Le sujet agit sur son environnement, rencontre des résistances, s’ajuste, et se transforme au fil de l’interaction. L’humain qui travaille avec l’IA n’est pas le même après qu’avant. Il a été affecté par les propositions de la machine, il y a répondu, et cette réponse a modifié la suite de l’échange.
Ainsi, il s’agit moins de remplacement ou d’augmentation que d’altération mutuelle. Le travail créatif en contexte d’IA n’est ni diminué ni amplifié : il est déplacé. La valeur ne réside plus dans le génie individuel ni dans la puissance de calcul, mais dans la qualité de l’interaction entre un professionnel doté de discernement et d’intuition et un outil doté de capacités de génération dont l’humain n’a plus le monopole.
Pour les professionnels de la communication, l’enjeu n’est donc pas seulement de « maîtriser l’IA » au sens technique. Il est de cultiver les compétences qui permettent d’en faire quelque chose : poser les bonnes questions plutôt qu’obtenir les bonnes réponses, juger les critères plutôt qu’appliquer les grilles, et faire confiance à ce qui résiste à la formalisation.
Je mène mon travail de recherche (encadrée par un contrat CIFRE) au sein de l'agence W Conran Design qui fait partie du groupe Havas dont je fais mention à une reprise dans cet article. Toutefois, adoptant un point de vie scientifique (neutre et critique), mon analyse ne vise ni ne consiste à promouvoir son activité.
L’ESSENTIEL
Plonger dans son histoire permet de mettre en perspective les avancées de l’IA, ses promesses et sa rhétorique. Déjà en 1970, Marvin Minsky, mathématicien, annonçait : « D’ici trois à huit ans, nous disposerons d’une machine dotée d’une intelligence générale équivalente à celle d’un être humain moyen. » Ça vous rappelle quelque chose ?
L’« effet IA », expliqué par Rodney Brooks, un roboticien, dès 1987 : « Tant qu’on ne sait pas faire, c’est de l’IA. Dès qu’on sait faire, c’est du
Plonger dans son histoire permet de mettre en perspective les avancées de l’IA, ses promesses et sa rhétorique. Déjà en 1970, Marvin Minsky, mathématicien, annonçait : « D’ici trois à huit ans, nous disposerons d’une machine dotée d’une intelligence générale équivalente à celle d’un être humain moyen. » Ça vous rappelle quelque chose ?
L’« effet IA », expliqué par Rodney Brooks, un roboticien, dès 1987 : « Tant qu’on ne sait pas faire, c’est de l’IA. Dès qu’on sait faire, c’est du calcul. » Tiens, tiens.
Sans oublier la « loi d’Amara », énoncée en 1978 : « Nous avons tendance à surestimer l’effet d’une technologie à court terme et à le sous-estimer à long terme. » Oups.
Il est difficile aujourd’hui d’ignorer l’expression « intelligence artificielle » (IA) tant elle est présente dans les médias, sur les réseaux sociaux et, dans une moindre mesure, dans le monde industriel. Ce phénomène d’hypermédiatisation (hype) n’est pas nouveau pour l’intelligence artificielle, car on a déjà connu de telles périodes d’emballement médiatique, même si l’épisode actuel est particulièrement sévère.
Cette hypermédiatisation s’accompagne, aujourd’hui comme hier, d’une promesse de révolution technologique dont les effets se font pourtant attendre, menant certains à douter de son « avènement ». Dans le même temps, les investissements faramineux ne semblent pas soutenables sur le court terme selon des économistes, faisant craindre un éclatement de la bulle qui pourrait avoir des conséquences dévastatrices sur l’économie mondiale.
Pour comprendre cette situation, il faut se replonger brièvement dans la longue histoire de l’IA.
Une définition ambiguë par choix délibéré
Les termes d’« intelligence artificielle » naissent officiellement en 1955 sous la main de John McCarthy (un des pères fondateurs de l’IA), en préparation de la conférence de Dartmouth aux États-Unis en 1956, qui est considérée par beaucoup comme l’instant zéro de l’IA – quand bien même elle n’aurait pu exister sans les travaux précurseurs d’Alan Turing (père fondateur de l’informatique moderne), de Norbert Wiener (père fondateur de la cybernétique) et de bien d’autres encore.
La formulation, « intelligence artificielle », se voulait explicitement très vendeuse, au grand dam des collègues de McCarthy, qui la trouvaient déjà trop connotée.
Si les premiers résultats furent très encourageants, les pères fondateurs ont rapidement fait des promesses irréalisables à l’époque et, pour certaines, irréalisables encore aujourd’hui. Ainsi, Marvin Minsky écrivait déjà en 1970 dans le magazine Life :
« D’ici trois à huit ans, nous disposerons d’une machine dotée d’une intelligence générale équivalente à celle d’un être humain moyen. »
Un demi-siècle plus tard, nous n’avons toujours pas cette intelligence artificielle générale qui serait équivalente à notre propre intelligence, ce qui n’empêche pourtant pas les nouveaux apôtres de l’IA de la promettre pour très bientôt.
Pour autant, les progrès et les avancées de la bonne vieille IA (dite « GOFAI » pour Good old fashioned artificial intelligence) sont avérés, et il y a aujourd’hui un ensemble des techniques issues de l’IA qui sont désormais entrées dans notre quotidien sans même que l’on y fasse encore attention. Vous souhaitez :
aller d’un point A à un point B ? C’est un vieux problème de l’IA résolu partiellement en 1956 (algorithme de Djikstra) ;
reconnaître un visage dans la foule ? Takeo Kanade en fit la première démonstration en 1973.
Ces résultats, majeurs à leur époque, ne nous impressionnent plus guère aujourd’hui. Cela explique peut-être pourquoi, pour le grand public, l’IA commence avec les IA génératives (texte, image, son) et, en particulier, avec ChatGPT, qui est un grand modèle de langage (LLM) mis en ligne en 2022 par OpenAI.
Cette révolution de l’IA s’est véritablement faite en deux temps
En 2012, durant la conférence Neural Information Processing Systems (NIPS), Geoffrey Hinton (lauréat du prix Turing en 2018 et du prix Nobel de physique en 2024) et ses collègues présentent les résultats d’une architecture neuronale pour la reconnaissance d’images.
Les performances de ce modèle sont tout simplement époustouflantes comparées aux techniques standards de l’époque. Là où la communauté pensait qu’il fallait des modèles spécifiques, astucieux, incluant des connaissances fines sur la reconnaissance d’images, Hinton montre au contraire que la force brute marche bien mieux.
Ce qu’il faut donc retenir de ce modèle, ce n’est pas tant son originalité, car son architecture avait été imaginée quelques décennies auparavant par d’autres chercheurs, mais bien l’énorme puissance de calcul qui a été mise en œuvre pour le faire tourner et obtenir ce résultat majeur.
C’est sur ce même principe de « force brute » que Google fera, lui aussi, une avancée majeure dans la traduction automatique au cours de l’année 2016. Là où les linguistes s’acharnaient depuis longtemps à tenter d’introduire les grammaires de nombreux langages, Google a mis en œuvre un véritable rouleau compresseur fondé sur d’immenses volumes de données.
C’est encore ce même principe de force brute qui amènera à ChatGPT et d’autres grands modèles de langage. En exploitant ces mêmes principes de réseaux de neurones profonds, de volumes de données gigantesques et d’une puissance de calcul hors norme, OpenAI a, en quelque sorte, libéré le kraken, aidé en cela par une avancée majeure sur le plan architectural : les transformers, dont l’article original est l’un des plus cités de toute l’histoire de la recherche, toutes disciplines confondues.
Les mêmes causes produiront-elles les mêmes effets ?
Tout en reconnaissant ces avancées majeures, on ne peut s’empêcher de faire le parallèle entre la situation actuelle et ce que l’on appelle « les deux hivers de l’IA ».
Le premier hiver de l’IA, que l’on situe entre 1974 et 1980, est une conséquence directe des promesses non tenues (traduction automatique, reconnaissance vocale, etc.), soulignées par le rapport (assassin) du mathématicien britannique James Lighthill en 1973, et des limites de la puissance de calcul de l’époque. Cela se concrétisa par des coupes budgétaires sévères.
Au début des années 1990, l’IA renaît de ses cendres avec l’idée des systèmes experts (raisonnement à partir de règles), avec, là aussi, des attentes démesurées qui conduiront à un deuxième hiver de l’IA, et ce, jusqu’au début des années 2010.
Pour autant, la recherche en IA ne s’est pas complètement arrêtée durant cette période et de nombreux résultats ont été intégrés dans différentes technologies de la vie courante (reconnaissance automatique de caractères, correction automatique, aide à la décision, navigation routière, etc.), mais ont souffert de l’« effet IA » , comme expliqué par Rodney Brooks dans un article qui a marqué la communauté… à la fin des années 1980 :
« Tant qu’on ne sait pas faire, c’est de l’IA. Dès qu’on sait faire, c’est du calcul. »
Pour qui a travaillé dans le monde académique au début des années 2000, la période actuelle est assez savoureuse. Imaginez un instant qu’il y a un quart de siècle, les mots « intelligence artificielle » étaient bannis des conversations et surtout (auto)censurés de toutes les demandes de subvention, tant les deux hivers de l’IA avaient marqué les esprits. Aujourd’hui, la simple mention du terme IA suffit à faire pétiller les yeux des financeurs et du grand public, même si cet « effet waouh » tend à s’estomper, voire à devenir contre-productif.
Le futur de l’IA reste donc à écrire, mais comme nous l’explique la loi d’Amara, formulée en 1978 :
« Nous avons tendance à surestimer l’effet d’une technologie à court terme et à le sous-estimer à long terme. »
Nul doute que les nouvelles technologies d’IA modifient et modifieront notre quotidien (pour le meilleur ou pour le pire), mais nous ne sommes pas à l’abri d’un troisième hiver de l’IA qui pourrait engendrer des réajustements assez drastiques. C’est en partie ce qui est en train de se passer avec des entreprises qui réembauchent des salariés licenciés auparavant au nom de l’IA.
Quant à l’idée d’une intelligence artificielle générale, elle est pour le moment hors de portée.
Nicolas P. Rougier a reçu des financements de l'ANR.
Montres, capteurs, tensiomètres ou glucomètres connectés promettent de mieux suivre les patients et de soulager l’organisation des soins sous tension. Pourtant, leur adoption ne dépend pas uniquement de leurs performances techniques. Une enquête menée auprès de 300 professionnels de santé révèle que le rapport des praticiens au risque, au temps, à la coopération et à la confiance dans les données joue un rôle tout aussi déterminant.
Dans un système de santé sous pression, la promesse des obje
Montres, capteurs, tensiomètres ou glucomètres connectés promettent de mieux suivre les patients et de soulager l’organisation des soins sous tension. Pourtant, leur adoption ne dépend pas uniquement de leurs performances techniques. Une enquête menée auprès de 300 professionnels de santé révèle que le rapport des praticiens au risque, au temps, à la coopération et à la confiance dans les données joue un rôle tout aussi déterminant.
Pourtant, un outil ne devient pas automatiquement un outil utilisé. Pourquoi certains professionnels l’adoptent-ils sans difficulté, alors que d’autres restent prudents, hésitants, voire méfiants ?
Le même outil, mais pas le même regard
Imaginons deux infirmiers, un même service, un même objet connecté. Pour le premier, c’est un outil qui facilite le suivi d’un patient chronique et l’accès à une information utile. Pour le second, c’est avant tout une source de surveillance supplémentaire, un risque d’erreur et une menace pour la confidentialité des données. Ce n’est pas une question de rationalité. Chacun porte un regard différent sur le même outil, façonné par son expérience, ses contraintes et ses attentes.
Les recherches sur l’acceptation des technologies, notamment le modèle UTAUT2, développé pour expliquer l’adoption des technologies dans différents contextes, montrent qu’une innovation ne s’impose pas par sa seule existence. Son adoption dépend de l’utilité perçue, de sa facilité d’utilisation, de l’accompagnement des utilisateurs et du contexte professionnel dans lequel elle est introduite.
En santé, cette équation devient encore plus complexe. Les soignants travaillent dans l’urgence, prennent des décisions ayant des conséquences réelles et manipulent des données sensibles. Un objet connecté de santé n’est donc jamais seulement un simple objet technique. Il modifie une manière de travailler, de transmettre une information et de faire confiance à une mesure.
Trois dimensions comportementales, quatre enseignements
Notre étude s’est intéressée à trois dimensions comportementales qui interviennent dans les décisions d’adoption :
le rapport au risque ;
le rapport au temps ;
la propension à coopérer.
Loin d’être abstraites, elles influencent très concrètement les décisions prises dans les services de soins. Face à une innovation, les professionnels évaluent non seulement les bénéfices attendus et les risques perçus, mais aussi le temps dont ils disposent et les incertitudes qu’ils sont prêts à accepter. Les travaux sur la théorie des perspectives et la rationalité limitée permettent précisément d’éclairer ces arbitrages sous contrainte.
Autrement dit, adopter un objet connecté ne consiste pas uniquement à apprendre à utiliser un nouvel outil numérique. C’est aussi accepter qu’une donnée circule, qu’une alerte soit interprétée, qu’une responsabilité soit partagée et qu’une partie du travail s’organise autrement.
Des outils d’appui pour les professionnels de santé
Premier constat, les professionnels interrogés ne rejettent pas les objets connectés de santé par principe. Beaucoup leur reconnaissent un intérêt pour le suivi des maladies chroniques, la surveillance de l’état de santé ou l’accompagnement des patients. Ils les perçoivent davantage comme des outils d’appui que comme des technologies destinées à remplacer le travail humain.
Mais cette adhésion reste conditionnelle. Dans notre enquête, l’adoption augmente surtout lorsque le dispositif est perçu comme réellement utile dans le travail quotidien. Les deux principaux facteurs associés à cette perception sont la capacité du dispositif à améliorer le suivi des patients et à réduire la charge de travail quotidienne.
Le vocabulaire de l’innovation ne suffit donc pas. Dire qu’un outil est « intelligent », « connecté » ou « innovant » ne convainc pas nécessairement un professionnel de santé. La vraie question est plus simple. Qu’est-ce que cet outil change concrètement dans ma journée de travail, pour moi, pour mon équipe et pour le patient ? Cette idée rejoint les travaux sur l’adoption de la m-santé (ou santé mobile, de l'anglais mHealth) par les professionnels, qui soulignent le rôle des bénéfices cliniques, de l’intégration dans les routines et de l’accompagnement organisationnel.
La prudence n’est pas un refus
Deuxième constat, le rapport au risque compte. Dans notre enquête, environ la moitié des répondants choisissent majoritairement les options les plus sûres dans des scénarios de décision. Ce résultat ne traduit pas un rejet de la technologie, mais une gestion prudente des risques inhérents à l’activité de soin. En santé, la prudence est souvent une forme de professionnalisme. Une mesure erronée, une alerte mal comprise ou une donnée mal protégée peuvent entraîner des conséquences réelles.
Pour un soignant, la confiance ne se décrète pas. Elle se construit. Qui peut consulter les données ? Où sont-elles stockées ? Qui est responsable en cas d’erreur ? Que se passe-t-il si le dispositif dysfonctionne ?
Troisième constat, le temps joue un rôle important. Près de la moitié des répondants privilégient systématiquement un gain immédiat plutôt qu’un gain plus élevé mais différé dans les scénarios proposés. Dans les organisations de santé, les coûts d’une innovation sont souvent immédiats. Apprendre l’outil, modifier une habitude, gérer les bugs, comprendre les alertes ou adapter les transmissions. Les bénéfices, eux, sont parfois annoncés pour plus tard.
Pour favoriser l’adoption, les bénéfices doivent donc être perceptibles dès les premiers usages. Moins de doubles saisies, une alerte plus claire, une information disponible au bon moment, une tâche répétitive évitée. Un objet connecté adopté n’est pas seulement un objet performant. C’est un objet dont l’utilité se voit dans le travail réel.
Une affaire d’équipe
Enfin, quatrième constat, les professionnels présentant les comportements les plus coopératifs perçoivent plus favorablement l’impact organisationnel des objets connectés de santé. Un objet connecté n’arrive jamais seul dans un service. Il arrive dans une équipe, avec ses habitudes, ses contraintes, ses tensions et ses manières de transmettre l’information. S’il est imposé sans discussion, il peut être vécu comme une contrainte. S’il est présenté, testé et discuté avec les équipes, il peut devenir un support de coordination.
Ce résultat rejoint des travaux récents sur les liens entre confiance, coopération et décisions de santé. Il rappelle qu’une innovation ne fonctionne pas seulement parce qu’elle est techniquement solide. Elle fonctionne lorsqu’elle peut être comprise, appropriée et intégrée dans un collectif de travail.
France Télévisions, 2026.
Une opposition artificielle et insuffisante
Le débat public oppose trop souvent les soignants « technophiles » aux soignants « technophobes ». Cette grille de lecture est insuffisante. Les professionnels ne se contentent pas d’aimer ou de refuser la technologie. Ils évaluent. Ils comparent. Ils arbitrent.
Pour les établissements de santé, la leçon est claire. Il ne suffit pas d’acheter ou de déployer des objets connectés. Il faut montrer leur utilité dans le travail réel, prévoir des formations courtes, clarifier les responsabilités, sécuriser les données et associer les équipes avant que les usages ne soient figés.
Pour les industriels, le message est tout aussi direct. Une interface élégante ou une promesse de performance ne suffisent pas. Les professionnels attendent des dispositifs fiables, compréhensibles, transparents et compatibles avec les contraintes du soin.
La santé numérique réussira moins parce que les technologies existent que parce que les professionnels pourront les comprendre, les discuter, les tester et leur faire confiance. Cette réalité est sans doute moins spectaculaire que les innovations technologiques elles-mêmes, mais elle constitue probablement la véritable condition de leur réussite.
L’innovation utile ne commence pas avec le capteur, mais avec les conditions qui permettent aux professionnels de lui faire confiance et de l’intégrer dans leur pratique quotidienne.
Cet article s'inscrit dans le prolongement d'une thèse de doctorat réalisée dans le cadre d'une convention CIFRE, cofinancée par l'ANRT, en partenariat avec Inetum et l'Université d'Angers.
L’ESSENTIEL
Les réseaux djihadistes s’emparent eux aussi de l’intelligence artificielle, notamment pour la propagande, la traduction et la production de contenus.
Al-Qaida et l’État islamique mettent en œuvre, dans ce domaine comme dans d’autres, des approches différentes : la première privilégie une stratégie de long terme, tandis que le second recherche davantage des effets rapides et visibles.
L’adoption de l’IA met en lumière ces deux cultures organisationnelles : au-delà de pratiques si
Les réseaux djihadistes s’emparent eux aussi de l’intelligence artificielle, notamment pour la propagande, la traduction et la production de contenus.
Al-Qaida et l’État islamique mettent en œuvre, dans ce domaine comme dans d’autres, des approches différentes : la première privilégie une stratégie de long terme, tandis que le second recherche davantage des effets rapides et visibles.
L’adoption de l’IA met en lumière ces deux cultures organisationnelles : au-delà de pratiques similaires, les deux mouvements n’envisagent pas le rôle de la technologie de la même manière.
L’intelligence artificielle ne créera peut-être pas une nouvelle forme de terrorisme, mais elle rend les tactiques existantes moins coûteuses, plus rapides et plus faciles à mettre en œuvre. C’est en tout cas l’argument central d’un rapport publié en juillet 2026 par le Center for Strategic and International Studies, un think tank basé aux États-Unis.
Ce texte, par ailleurs tout à fait convaincant, laisse une question sans réponse : les différents groupes terroristes envisagent-ils tous cette technologie de la même manière ?
En tant qu’experte en terrorismequi étudie la manière dont les groupes militants raisonnent et s’adaptent, j’ai analysé de nombreux éléments de propagande, manuels et documents stratégiques des deux mouvements djihadistes les plus influents du XXIᵉ siècle – Al-Qaida et l’État islamique –afin d’observer comment ils interprètent et adoptent les nouvelles technologies. Mes travaux reposent notamment sur l’analyse des utilisations documentées de l’IA par leurs médias et leurs partisans.
Ces groupes utilisent l’un comme l’autre l’IA à des fins de propagande, de recrutement, de sécurité et de planification. Mais Al-Qaida et les réseaux liés à l’État islamique l’abordent chacun différemment, conformément à la manière dont ils mènent leurs combats.
Au plus fort de son califat autoproclamé en Syrie et en Irak, l’État islamique a mis en place un appareil sophistiqué, misant sur la rapidité et un haut niveau de professionnalisation. Cette dynamique s’est prolongée à l’ère de l’IA, portée par des partisans et des recrues plus jeunes, immergés dans la culture numérique, qui n’hésitent pas à expérimenter de nouveaux outils.
Depuis 2023, les affiliés de l’État islamique recourent de plus en plus à l’IA générative pour produire leur propagande. Après l’attentat perpétré en mars 2024 dans une salle de concert près de Moscou, qui a fait plus de 130 morts, des partisans du groupe ont diffusé une vidéo célébrant l’attaque. Celle-ci mettait en scène un faux présentateur arabophone, généré artificiellement, qui présentait l’attentat comme un épisode de la guerre plus large menée par l’organisation contre ses ennemis.
En juin 2025, la branche afghane du groupe État islamique, l’État islamique du Khorasan (ISIS-K), a diffusé un numéro de son magazine en anglais, Voice of Khorasan, publié par la Fondation al-Azaim, qui présentait la maîtrise de l’IA comme un devoir religieux pour chaque musulman. Cela a conduit à assimiler juridiquement cette compétence au djihad défensif, que les idéologues djihadistes présentent souvent comme un devoir de combattre lorsque les musulmans, leur foi ou leur territoire sont attaqués. Selon cet article, l’IA est une force qui façonne déjà la guerre, le monde des affaires et l’identité. Le document met également en garde contre les deepfakes, la surveillance et la collecte de données, tout en proposant des conseils pratiques pour se protéger.
La Fondation a par la suite retiré la qualification religieuse, semble-t-il après avoir été raillée par d’autres groupes djihadistes, mais a maintenu les recommandations pratiques. Cet épisode, inscrit dans le cadre plus large des expérimentations menées par l’État islamique, reflète un schéma récurrent : une adoption rapide, suivie d’une correction doctrinale. Il révèle également une logique de mobilisation particulière. Les adeptes sont encouragés à considérer leur méconnaissance de cette technologie comme une vulnérabilité face à des adversaires qui l’utilisent déjà.
Dans les documents examinés, la question centrale n’est pas de savoir si l’IA modifie la nature de la guerre, mais comment l’utiliser, se protéger contre elle et éviter de se retrouver à la traîne.
Al-Qaida se lance aussi dans l’expérimentation
Les branches et les partisans d’Al-Qaida s’essaient également à cette technologie.
Des médias pro-Al-Qaida ont diffusé des images probablement générées par l’IA dès 2023, et ses réseaux ont fait la promotion d’ateliers et de guides sur les chatbots. En 2024, l’Armée électronique Al-Malahem a publié un guide intitulé « Des façons incroyables d’utiliser l’IA », offrant à ses partisans de nombreux conseils.
En juillet 2025, les Nations unies ont indiqué qu’Al-Shabaab, la branche somalienne d’Al-Qaida, utilisait des outils d’intelligence artificielle pour traduire ses messages en plusieurs langues.
En mai 2026, l’Agence nationale d’enquête indienne a engagé des poursuites concernant un attentat à la voiture piégée perpétré en novembre 2025 à Delhi, qui avait fait 11 morts. Les enquêteurs ont affirmé que la cellule responsable était liée à Al-Qaida dans le sous-continent indien et employait un ingénieur qui utilisait YouTube et ChatGPT pour effectuer des recherches sur les explosifs.
Par ailleurs, certains analystes ont émis l’hypothèse que les récentes adaptations en matière de drones menées par la branche ouest-africaine d’Al-Qaida pourraient impliquer des outils d’IA en open source. Les preuves restent toutefois fragiles.
Des militants liés à Al-Qaida ont mis en garde contre le risque que des « deepfakes » ne s’infiltrent dans leurs discussions en ligne ou ne les manipulent. Les comptes de réseaux sociaux liés à Al-Qaida ont également débattu de l’utilisation de l’IA pour la recherche religieuse. Certains messages affirmaient que s’appuyer sur cette technologie témoignait d’une connaissance religieuse insuffisante.
La nature de la guerre en mutation
Les deux mouvements enseignent donc à leurs partisans comment utiliser ces outils et s’en prémunir. Mais certains acteurs de l’écosystème médiatique pro-Al-Qaida posent une question différente : la technologie modifie-t-elle la nature même de la guerre ?
L’exemple le plus frappant est celui de la Fondation Anaziat, pro-Al-Qaida. Au fil de six numéros consécutifs de sa série Fiqh al-Harb (Jurisprudence de la guerre), parue en 2025, la fondation a publié des traductions en arabe d’ouvrages stratégiques occidentaux consacrés à l’IA, à la cyberguerre et aux évolutions technologiques.
Un texte examine ainsi l’IA et l’avenir de la guerre. Un autre se demande si les stratèges devraient prendre au sérieux la philosophie de l’IA. Deux autres débattent de la question de savoir si l’IA pourrait changer la nature même de la guerre. La série critique ensuite la cyberguerre et l’hypothèse selon laquelle la supériorité technologique pourrait venir à bout des réalités persistantes du conflit.
Ces textes donnent lieu à un débat révélateur qui revient sans cesse sur l’action humaine, la conscience, la finalité politique, la persévérance et la volonté. Cette série ne rend pas de verdict contre l’IA. Son intérêt réside plutôt dans les questions qu’elle choisit de poser et les hypothèses qu’elle ne cesse de remettre en question.
Des cultures organisationnelles différentes
Ces approches reflètent différents instincts organisationnels. Al-Qaida s’est historiquement montrée plus patiente et mesurée, envisageant sa lutte comme une guerre de longue haleine et contrôlant minutieusement ses messages. Sa stratégie repose sur un pari : la volonté politique et l’endurance peuvent l’emporter sur la supériorité technologique. Le mouvement a survécu à l’essor des drones, de la surveillance de masse et des frappes de précision en se dispersant, en encaissant les pertes subies, en s’adaptant et en patientant.
Les choix éditoriaux d’Anaziat se distinguent car ils font écho à ces hypothèses. Sa série d’articles s’appuie sur des chercheurs occidentaux qui se demandent si les machines et l’IA peuvent remplacer le jugement humain et surmonter l’incertitude de la guerre, et si des armes supérieures peuvent se substituer à l’endurance, à la volonté politique et à la volonté humaine. Ces réflexions mettent à l’épreuve la stratégie de « guerre longue » d’Al-Qaida, qui en revient sans cesse à la même conclusion : la technologie peut changer la manière dont les guerres sont menées sans pour autant déterminer qui, en fin de compte, tiendra le plus longtemps ou l’emportera.
Al-Qaida estime que l’endurance, la volonté politique et l’action humaine jouent en sa faveur. Selon elle, la supériorité militaire ou technologique ne garantit pas la victoire.
Les deux mouvements djihadistes utilisent l’IA pour bon nombre d’objectifs et de pratiques identiques. Il existe néanmoins une différence dans leur conception de cette technologie et dans les questions qu’ils se posent au-delà de son utilisation immédiate.
Le discours lié à l’État islamique considère l’IA principalement comme un outil à maîtriser dès maintenant. C’est également le cas d’une partie de l’écosystème pro-Al-Qaida, mais celui-ci l’inscrit également dans un débat plus large sur la guerre, la persévérance et la victoire stratégique. Ces cultures organisationnelles pourraient déterminer non seulement quels outils d’IA chaque mouvement adoptera à l’avenir, mais aussi à quelles fins – et de quelle manière – il les utilisera.
Sara Harmouch ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’ESSENTIEL
En avril 2026, plusieurs institutions publiques marocaines ont validé le lancement d’un projet de data center à Dakhla, dans le sud du pays, qui sera exclusivement alimenté par des énergies renouvelables.
Ce projet s’inscrit dans les nombreux efforts du Maroc pour s’imposer comme leader régional, voire continental, dans le secteur du numérique.
En investissant dans de telles infrastructures, le Royaume entend mieux maîtriser l’hébergement de ses données afin de servir ses intérêt
En avril 2026, plusieurs institutions publiques marocaines ont validé le lancement d’un projet de data center à Dakhla, dans le sud du pays, qui sera exclusivement alimenté par des énergies renouvelables.
Ce projet s’inscrit dans les nombreux efforts du Maroc pour s’imposer comme leader régional, voire continental, dans le secteur du numérique.
En investissant dans de telles infrastructures, le Royaume entend mieux maîtriser l’hébergement de ses données afin de servir ses intérêts économiques et ses ambitions géopolitiques.
À Nouaceur, en périphérie de Casablanca, un consortium emmené par le Sud-Coréen Naver Cloud, l’Américain Nvidia et l’opérateur Nexus Core Systems prépare un centre de données consacré à l’intelligence artificielle (IA) évalué à 1,2 milliard de dollars (1,04 milliard d’euros). Visant à terme 500 mégawatts de capacité, soit davantage que la puissance cumulée aujourd’hui installée dans les cinq premiers pays africains du secteur, le projet résume à lui seul le pari que fait le Maroc sur les infrastructures numériques.
Le pari marocain des data centers
Le pays ne domine pas encore le classement continental. Selon le rapport « Africa’s Digital Leap », publié par Heirs Technologies, l’Afrique comptait fin 2025 environ 211 data centers actifs, très concentrés, notamment en Afrique du Sud – avec 49 centres. Le Maroc, avec huit infrastructures recensées à Casablanca, occupe la cinquième place du classement continental en 2025, derrière l’Afrique du Sud, le Nigeria, le Kenya, l’Égypte, mais devant le Ghana, la Côte d’Ivoire et la Tunisie.
Sur la prochaine génération de projets, le royaume joue sa place de leader régional. Le pari se double d’un second chantier à Dakhla, où les ministères de la transition énergétique et de la transition numérique ont validé en janvier 2026 un centre de données vert de 500 mégawatts. Ce centre sera alimenté exclusivement par l’éolien et le solaire et adossé à l’institut Al Jazari, consacré à l’intelligence artificielle et à la transition énergétique en partenariat avec l’université de Dakhla. Le site Jeune Afrique évoquait en janvier jusqu’à quatre projets de cette nature pour une capacité combinée proche de deux gigawatts, à comparer au 0,500 gigawatt à peine que cumulent aujourd’hui les cinq pays africains les plus avancés du secteur.
Les fondements d’un leadership numérique régional
Cette ambition s’appuie sur des atouts géographiques dont peu de pays africains disposent. Le Maroc est le seul du continent à disposer à la fois d’une façade atlantique et méditerranéenne, raccordé à une dizaine de câbles sous-marins, dont Africa-1 et 2Africa. Ce dernier est porté par Meta, avec des temps de latence vers le sud de l’Europe inférieurs à 20 millisecondes. Cette proximité a pris une dimension réglementaire en 2023 lorsque Rabat a modifié sa loi 09-08 sur la protection des données personnelles pour la rapprocher du RGPD européen. Cela a permis à des entreprises françaises, espagnoles ou belges d’y héberger leurs données sans enfreindre leurs propres obligations.
Le marché existant reste pour l’instant concentré : Maroc Télécom, Inwi, Medasys et N+one se partagent plus de 84 % des parts selon une monographie du Conseil de la concurrence, tandis qu’Oracle multiplie ses implantations à Casablanca, qu’Orange Maroc s’associe à AWS et que Maroc Télécom a signé avec Google Cloud une convention de partenariat évalué à environ 3 milliards de dollars (soit 2,6 milliards d’euros).
Cette accélération n’efface pas certains enjeux. Le taux d’utilisation moyen des centres de données africains plafonne autour de 40 %, contre 70 à 80 % en Europe ou au Moyen-Orient, ce qui met en avant le défi du rythme d’absorption d’une telle capacité.
Des infrastructures au service de la souveraineté et d’une stratégie d’influence
Au-delà des chantiers eux-mêmes, le pari marocain ouvre des perspectives concrètes pour l’économie locale. Une part croissante des données africaines reste aujourd’hui hébergée hors du continent, privant les économies locales d’une partie de la valeur qu’elles génèrent. Rapatrier ce traitement à Casablanca ou à Dakhla permettrait de capter emplois qualifiés, recettes fiscales et savoir-faire technique sur place.
L’adossement systématique des nouveaux projets aux énergies renouvelables, à travers TAQA Morocco à Nouaceur ou l’éolien et le solaire à Dakhla, crée par ailleurs un effet d’entraînement sur la filière électrique nationale, déjà engagée dans la diversification de son mix énergétique. L’institut Al Jazari, en associant recherche en intelligence artificielle et formation universitaire, offre enfin une réponse directe au déficit de compétences cloud identifié par Heirs Technologies, et pourrait transformer une faiblesse en relais de croissance pour les ingénieurs marocains et africains formés sur place.
Les ambitions géopolitiques du Maroc s’appuient aussi sur une vision stratégique de long terme, en cohérence avec les rééquilibrages et le multilatéralisme ambiant. Le principal défi du Maroc est celui de la souveraineté et de la montée en performance. C’est aussi le défi du « trouver sa place » entre les grands acteurs-attracteurs américains et chinois. Une vision stratégique ne peut être déployée sans les efforts, sans la pugnacité, sans l’intelligence humaine. L’IA et la robotique n’ont pas encore remplacé la composante humaine dans la construction d’une stratégie à l’échelle continentale…
Cette vision stratégique du Maroc a su s’incarner par des hommes et des femmes capables d’anticiper les grands mouvements à la vitesse du progrès de l’IA et de la robotique. Une femme en particulier a choisi de consacrer son action au service de l’IA, de relever le défi de souveraineté au nom du Maroc et au nom du continent africain tout entier : il s’agit de la chargée de la transition numérique et de la réforme de l’administration, madame Amal El Fallah Seghrouchni, dont on trouvera le parcours détaillé sur ce lien. Elle porte aujourd’hui la stratégie data IA du Maroc, et notamment celle du déploiement stratégique des nouveaux data centers.
C’est sur cette convergence globale entre volontés de développement de l’innovation et esprit de compétition et de souveraineté exprimé par la jeunesse marocaine, que se construira l’IA africaine, primordiale à la stratégie marocaine.
Thierry Berthier ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
La triste nouvelle du 16 juillet dernier du décès de Rudolph Arthur Marcus, lauréat du prix Nobel de chimie en 1992, invite à revenir sur son héritage scientifique.
Au-delà de l’équation qui porte son nom, Marcus incarne une époque où l’ambition des chercheurs était de décrire des phénomènes complexes à l’aide de quelques équations élégantes.
Aujourd’hui, le paysage scientifique a profondément évolué. Les modèles d’intelligence artificielle apprennent directement à partir des données, et les
La triste nouvelle du 16 juillet dernier du décès de Rudolph Arthur Marcus, lauréat du prix Nobel de chimie en 1992, invite à revenir sur son héritage scientifique.
Au-delà de l’équation qui porte son nom, Marcus incarne une époque où l’ambition des chercheurs était de décrire des phénomènes complexes à l’aide de quelques équations élégantes.
Aujourd’hui, le paysage scientifique a profondément évolué. Les modèles d’intelligence artificielle apprennent directement à partir des données, et les prédictions peuvent parfois être obtenues sans qu’une théorie analytique complète ne soit disponible.
La disparition de Marcus soulève alors une question plus large : assiste-t-on à la fin de l’ère des grandes théories analytiques, au seul profit d’études théoriques à base de l’intelligence artificielle ?
Professeur au département de chimie et membre de l’Institut Courtois, de l’Université de Montréal, je mène des recherches sur le stockage de l’énergie dans les batteries au lithium. Mes travaux m’ont naturellement conduit à m’intéresser à la théorie de Marcus et l’intelligence artificielle.
Le professeur Rudolph Arthur Marcus enseigne à l’université.(Caltech Division of Chemistry and Chemical Engineering | Facebook), CC BY
Bibliographie abrégée : la persévérance avant la consécration
Né le 21 juillet 1923 à Montréal, au Canada, Marcus entreprend des études de chimie à l’Université McGill, où il obtient son doctorat en 1946.
En 1978, Marcus rejoint le California Institute of Technology, où il poursuivra le reste de sa carrière. Plus tôt, c’est pourtant le hasard d’une rencontre lors d’un congrès de l’American Chemical Society qui lui avait ouvert les portes de son premier poste universitaire, à l’Institut polytechnique de Brooklyn. Une anecdote qui rappelle qu’avant la reconnaissance se cache souvent une longue succession d’échecs : Marcus avait essuyé près de trente-cinq refus avant d’obtenir ce poste !
En 1992, Marcus reçoit seul le prix Nobel de chimie, alors que cette distinction était déjà le plus souvent partagée entre plusieurs chercheurs. Si cette récompense consacre l’importance exceptionnelle de ses travaux, certains estiment que d’autres pionniers auraient également mérité une telle reconnaissance. Parmi eux figure Revaz Dogonadze, chef de file de l’école soviétique du transfert d’électron.
Rudolph A. Marcus s’est éteint le 16 juillet 2026, à Pasadena aux États-Unis, en Californie, à l’âge de 102 ans, proche de son 103e anniversaire.
Impact de la théorie de Marcus, de la chimie à la biologie
L’une des plus grandes réussites de la théorie de Marcus est sans doute d’avoir dépassé le cadre de la chimie. Initialement développée pour expliquer les réactions rédox en solution, elle s’est progressivement élargie à d’autres types de transfert d’électrons. Aujourd’hui, elle est utilisée pour comprendre des phénomènes aussi variés que la biologie, la corrosion des métaux, les cellules solaires, les batteries, ou encore les matériaux moléculaires.
Une réaction rédox est une réaction chimique qui correspond au cas précis d’un échange d’électron entre des molécules. La théorie du transfert d’électron de Marcus décrit justement comment un électron saute d’une molécule qui le possède à une autre qui peut le recevoir.
La théorie de Marcus est indispensable à certaines découvertes en biologie. Elle permet de comprendre comment les électrons circulent entre les protéines au cours de la photosynthèse, comment les cellules produisent leur énergie grâce à la respiration cellulaire, mais aussi comment fonctionnent de nombreuses enzymes impliquées dans les réactions rédox.
Par exemple, elle éclaire également les mécanismes moléculaires à l’origine des cycles rédox responsables de la toxicité de nombreux composés chimiques et médicaments.
Au-delà du vivant, l’une des prédictions les plus surprenantes de la théorie de Marcus est l’existence de la région inversée, longtemps considérée comme contre-intuitive. Cette zone inverse est fort utile en physique. La zone inverse de Marcus révèle qu’une réaction chimique possède une vitesse optimale, au-delà, elle peut ralentir malgré que les conditions soient plus favorables.
Cette prédiction paraissait si étonnante que de nombreux chercheurs la jugeaient irréaliste, c’était un peu comme annoncer qu’une résistance électrique pouvait devenir négative.
Démonstration grand public de la célèbre équation de l’énergie de réorganisation
Au-delà de la zone inverse, l’une des contributions majeures de Marcus est le concept d’énergie de réorganisation. Faisons une expérience de pensée. Imaginons que nous puissions saisir une charge électrique entre nos doigts, un électron ou un ion, puis la déplacer lentement du vide vers un liquide.
Dans le vide, la charge crée autour d’elle un champ électrique, mais aucun atome, aucune molécule ne se déplace pour l’accueillir, car nous sommes dans le vide.
Dès que la charge pénètre dans le liquide, tout change. Les molécules environnantes ressentent son champ électrique. Elles tournent, se déplacent et s’ordonnent autour d’elle. Mais cette réorganisation n’est pas gratuite : elle demande une énergie de réorganisation.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
C’est précisément cette énergie que Marcus est parvenu à démontrer, en combinant les grandes lois de l’électrostatique avec les principes de la thermodynamique.
À contre-courant de son époque, alors que la révolution de la mécanique quantique transformait déjà la chimie théorique, Marcus choisit d’aborder le transfert d’électron sous un angle essentiellement électrostatique.
L’élégance analytique à l’ère de l’intelligence artificielle
L’énergie de réorganisation de Marcus est née à une époque où un chercheur disposait essentiellement d’un stylo, de quelques feuilles de papier et d’une remarquable maîtrise des outils mathématiques.
La beauté de cette démarche ne résidait pas seulement dans le résultat final, mais dans le chemin qui y conduisait : une démonstration où chaque ligne découlait naturellement de la précédente, selon la logique implacable du raisonnement scientifique. « Soit A ; alors B. Si B est vrai, alors C. » Une succession d’étapes où les équations racontaient une histoire et révélaient les mécanismes cachés de la nature, qui se finissait par le fameux CQFD (ce qui fallait démontrer).
Le parcours de Marcus illustre une approche de la recherche devenue plus rare. Avant de chercher à publier, il a d’abord cherché à comprendre. Pendant plusieurs années, il s’est immergé dans les mathématiques et l’électrostatique, n’hésitant pas à interrompre ses propres recherches pour acquérir les outils théoriques qui lui manquaient. C’est cette culture scientifique patiemment construite qui lui permettra ensuite de révolutionner la compréhension du transfert d’électron.
Aujourd’hui, le paysage scientifique a profondément changé. L’intelligence artificielle permet souvent de prédire le comportement d’un système sans qu’une démonstration analytique complète soit nécessaire. L’objectif n’est plus toujours de trouver une équation élégante, mais d’exploiter d’immenses volumes de données pour construire des modèles capables de prédire.
Le départ de Marcus marque aussi, symboliquement, la disparition d’une génération de chercheurs pour qui la démonstration analytique constituait le cœur de la découverte scientifique. Une époque où la rigueur du raisonnement suffisait parfois à faire émerger une théorie appelée à transformer durablement notre compréhension du monde.
Marcus nous laisse une démonstration, mais à nous de préserver l’esprit du CQFD.
Olivier Fontaine ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Certains les décrivent comme des psys ou des amis. C’est dire la place que les intelligences artficielles, ou IA, ont pris dans la vie des Français. La gratuité de ces services a probablement contribué à cette confusion. Mais combien de temps les entreprises du secteur pourront-elles continuer à offrir des services non payants ? La publicité pourrait-elle changer la donne ? Quel impact cela pourrait-il avoir ?
En janvier 2026, OpenAI a commencé à insérer les premières publicités dans les répo
Certains les décrivent comme des psys ou des amis. C’est dire la place que les intelligences artficielles, ou IA, ont pris dans la vie des Français. La gratuité de ces services a probablement contribué à cette confusion. Mais combien de temps les entreprises du secteur pourront-elles continuer à offrir des services non payants ? La publicité pourrait-elle changer la donne ? Quel impact cela pourrait-il avoir ?
En janvier 2026, OpenAI a commencé à insérer les premières publicités dans les réponses de ChatGPT auprès de ses utilisateurs états-uniens non abonnés. Un geste longtemps repoussé et désormais assumé. Après trois années de croissance financée à perte, l’intelligence artificielle (IA) générative grand public amorce sa bascule vers un modèle publicitaire, faute d’avoir trouvé, ailleurs, de quoi financer durablement la gratuité de ses services.
Près d’un Français sur deux déclare avoir déjà utilisé un agent conversationnel, comme ChatGPT, Gemini ou Copilot. Cette proportion grimpe jusqu’à 82 % chez les 18-24 ans contre 20 % chez les plus de 65 ans, selon une enquête Ifop. Dans le monde, près de 20 % de la population dialoguerait régulièrement avec ces outils, selon le Microsoft AI Economy Institute. OpenAI, Google et Microsoft cumulent à eux seuls près de 90 % du marché, selon FirstPageSage.
Cette domination est le fruit d’une stratégie assumée depuis le lancement de ChatGPT fin 2022 : offrir le service gratuitement pour capter le plus d’utilisateurs possible, avant même de songer à la rentabilité. ChatGPT a atteint 100 millions d’utilisateurs en soixante jours (il avait fallu trente mois à Instagram pour atteindre cette audience). Reste, désormais, à transformer cette audience en modèle d’affaires viable.
Une industrie qui carbure aux pertes
Le problème posé par cette gratuité est qu’elle est fondée sur une infrastructure qui coûte cher aux entreprises qui l’exploitent. Une requête adressée à un agent conversationnel consomme environ dix fois plus d’énergie de calcul qu’une recherche classique sur Google, selon des estimations relayées par Heise. Or, environ 85 % des utilisateurs de ces services restent sur la version gratuite, d’après CNBC. En 2025, OpenAI aurait dépensé près de 22,5 milliards de dollars pour un chiffre d’affaires de 13,5 milliards, soit une perte d’environ 9 milliards de dollars, rapporte Fortune. Même Anthropic, pourtant tourné vers les entreprises, ne vise la rentabilité qu’à l’horizon de 2028, en misant sur la demande professionnelle, selon TechCrunch.
Face à cette équation, les entreprises nées avec l’IA générative, comme Anthropic ou Mistral AI, se tournent prioritairement vers les entreprises, via des API facturées à l’usage et des licences professionnelles. Les grands groupes technologiques, Google, Meta ou Microsoft, disposent d’un atout supplémentaire : des centaines de millions d’utilisateurs grand public dont l’activité en ligne peut être monétisée autrement. Quant à OpenAI, parti du grand public sans écosystème préexistant, il tente aujourd’hui de rattraper les deux fronts.
L’abonnement ne suffira pas
La première option pour « monétiser » les utilisateurs grand public consiste, logiquement, à faire payer un abonnement. Une convergence tarifaire s’observe autour de 20 dollars (soit plus de 17 euros) par mois pour les offres premium de ChatGPT, Claude, Copilot ou Gemini. Mais cette formule se heurte à un plafond : seuls 4 à 5 % des utilisateurs auraient franchi le pas, selon la BBC. L’écrasante majorité reste gratuite, pesant sur les coûts sans générer de revenu direct.
Une deuxième piste, plus prospective, consiste à transformer l’agent conversationnel en intermédiaire commercial capable de réserver un vol ou de finaliser un achat, moyennant une commission. Mais les premiers résultats déçoivent : selon TechCrunch, les ambitions d’OpenAI de faire de ChatGPT un concurrent d’Amazon ou de Google « ne se déroulent pas très bien », le Web n’étant pas encore conçu pour être parcouru et actionné par des agents automatisés.
La publicité, solution de dernier recours ?
Reste alors la publicité, mécanisme le plus éprouvé pour monétiser une audience captive sans lui faire sortir la carte bancaire. C’est peu ou prou le modèle qui a fait la fortune de Google et de Meta depuis vingt ans. Perplexity AI a été la première à s’y risquer, dès novembre 2024, avec des questions de suivi sponsorisées insérées sous ses réponses. Le format a toutefois été abandonné en 2026 face aux résistances des utilisateurs, l’entreprise reconnaissant sur son blog que la faisabilité technique était acquise, mais que l’acceptabilité par les consommateurs restait un frein.
Microsoft Copilot a, de son côté, déployé des publicités générées dynamiquement par l’IA en fonction du contexte de la conversation, les Showroom Ads. Et depuis janvier 2026, OpenAI affiche à son tour des publicités contextuelles, clairement étiquetées, en bas des réponses fournies aux utilisateurs états-uniens non abonnés, selon CNBC. L’entreprise assure que ces publicités n’influencent pas le contenu des réponses elles-mêmes.
Vos prompts en disent plus que vous ne l’imaginez
Cette publicité contextuelle repose sur une matière première : les données que l’utilisateur confie à l’agent, sciemment ou non. Or, les prompts recèlent bien plus d’informations personnelles qu’il n’y paraît.
Des chercheurs ont montré qu’un modèle de langage peut inférer, avec une précision élevée, des attributs personnels sensibles (santé, revenus, opinions politiques) à partir de simples échanges, même sans divulgation explicite, selon une étude publiée dans les actes de la conférence ICLR. Décrire des symptômes pour un conseil médical revient ainsi à révéler son état de santé ; interroger sur un quartier précis, à dévoiler sa localisation.
Un risque inédit d’influence invisible
C’est précisément là que le bât blesse. Contrairement à une bannière publicitaire, aisément identifiable, un message commercial glissé dans le fil d’une conversation peut se fondre dans la réponse sans que l’utilisateur en ait conscience. Plusieurs travaux de recherche pointent la confiance quasi inconditionnelle accordée à ces agents, perçus comme des interlocuteurs à la fois compétents et complaisants. Un message commercial pourrait ainsi bénéficier d’une caution implicite supérieure à celle d’une publicité classique.
Une étude de la société SparkToro illustre par ailleurs la difficulté à objectiver ce risque. Les agents conversationnels produisent des recommandations de marques différentes dans plus de 99 % des cas, y compris pour des questions strictement identiques sans segmentation marketing différente. Cette instabilité rend une éventuelle influence commerciale particulièrement difficile à détecter, aussi bien pour les utilisateurs que pour les régulateurs.
Arte, « Le dessous des cartes », 2025.
Le partenariat noué entre OpenAI et Shopify, qui permet à ChatGPT de recommander des produits issus de millions de marchands et de finaliser directement l’achat, en offre une illustration concrète. OpenAI assure que ces recommandations restent organiques et non commercialement influencées, mais les marchands versent bien une commission sur chaque transaction réalisée via l’agent. L’utilisateur n’a aucun moyen de vérifier cette neutralité affichée ni de distinguer une recommandation indépendante d’une recommandation orientée par cet accord commercial.
Vers un encadrement spécifique ?
Ce basculement vers la publicité conversationnelle fait écho à des débats déjà anciens en économie des plateformes, où l’opacité des critères de classement des comparateurs en ligne (offres télécoms, assurances, voyages) a justifié des obligations de transparence renforcées à l’échelle européenne. La question posée aujourd’hui est de savoir si un encadrement comparable, obligeant les agents conversationnels à signaler tout contenu commercialement influencé, s’imposera avant que ces pratiques se généralisent.
L’enjeu dépasse la seule question publicitaire, puisque c’est la soutenabilité même du modèle économique de l’IA générative grand public qui reste, à ce stade, une question ouverte. Entre abonnements plafonnés à une minorité d’utilisateurs, commissions transactionnelles balbutiantes et publicité conversationnelle en plein tâtonnement, aucune piste ne semble, à elle seule, en mesure de financer durablement le coût de ces technologies. Pour les utilisateurs, l’enjeu est de taille : comprendre par qui et comment un service qu’ils croient gratuit est réellement financé.
Paul Favier ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L'ESSENTIEL
Les développeurs les plus en pointe avec l’intelligence artificielle générative décrivent une fatigue d’un genre nouveau, la vibecoding fatigue ou l’AI brain fry.
Des parades sont inventées pour ne pas se laisser soumettre par l’IA.
Cette fatigue pourrait gagner tous les métiers du langage, des journalistes aux juristes en passant par les traducteurs.
Sur un forum de développeurs, un ingénieur raconte sa fatigue après deux mois à coder sept heures par jour, quasiment sans wee
Les développeurs les plus en pointe avec l’intelligence artificielle générative décrivent une fatigue d’un genre nouveau, la vibecoding fatigue ou l’AI brain fry.
Des parades sont inventées pour ne pas se laisser soumettre par l’IA.
Cette fatigue pourrait gagner tous les métiers du langage, des journalistes aux juristes en passant par les traducteurs.
Sur un forum de développeurs, un ingénieur raconte sa fatigue après deux mois à coder sept heures par jour, quasiment sans week-ends. Il décrit une lassitude d’un genre particulier, née de ces outils qui produisent beaucoup, très vite, et qu’il faut valider sans relâche. Il en donne une image frappante :
« C’est comme mettre ta bougie de productivité sur un lance-flammes ; tu vas plus vite, mais tu brûles beaucoup plus d’énergie. »
Cette tendance, c’est la vibecoding fatigue, une lassitude de valider sans arrêt le travail d’une machine qui ne s’arrête jamais. Le mot est né sous la plume d’un ingénieur passé chez Google, Jorge Raad, qui décrit dès août 2025 le malaise né d’une délégation cognitive excessive aux outils d’IA. Les fils de discussion de praticiens s’en emparent dans les mois qui suivent, bien avant la première étude savante, publiée en mars 2026, sur laquelle je reviendrai.
Ce que disent les forums rejoint les enquêtes. Dès 2024, l’Upwork Research Institute interroge 2 500 professionnels ; 77 % de ceux qui utilisent l’IA jugent qu’elle a alourdi leur charge. Un an plus tard, la même équipe va plus loin ; parmi les salariés les plus productifs grâce à l’IA, 88 % se disent en burn-out.
C’est un basculement que je documente aussi sur mon terrain, une enquête menée depuis 2023 auprès d’une dizaine d’entreprises du numérique françaises, dont les résultats paraîtront prochainement. Une tendance liée à l'objet de ma thèse, à savoir l’adaptation des entreprises du numérique à l’IA générative.
Utilisateurs et constructeurs de l’IA
Les grands modèles d’IA, ceux d’OpenAI, d’Anthropic, de Google ou de Microsoft, ont tous misé sur le code, pour deux raisons. Le code agit directement sur le monde puisqu’une seule ligne peut lancer un calcul à l’autre bout de la planète. Et surtout, il se vérifie. Quand un modèle se trompe dans une phrase, l’erreur reste floue.
Quand il se trompe dans un programme, le bug se voit, se compte et se corrige. Les concepteurs de ces modèles en ont fait leur mesure de progrès. Le principal test du secteur, SWE-bench, soumet les modèles à des centaines de bugs réels relevés dans des logiciels publics. Un classement en ligne affiche pour chaque modèle la part de ces bugs qu’il parvient à corriger seul, et chaque laboratoire y suit la progression de ses concurrents.
Les développeurs sont équipés plus tôt et plus intensément que les autres. Ils s’en servent même pour fabriquer les outils d’IA eux-mêmes ; ils sont à la fois utilisateurs et constructeurs. Traducteurs, comptables, juristes, tous les métiers du langage suivent, avec un temps de retard.
Canari dans la mine
En mars 2026, une étude, menée sur 1 488 personnes, le baptise l’AI brain fry. Les coûts sont conséquents avec un tiers de fatigue de décision en plus, 39 % d’erreurs graves en plus, et une envie de démissionner qui passe de 25 % à 34 %. Un des auteurs, Matthew Kropp, désigne les premiers concernés, les ingénieurs qui pilotent déjà plusieurs systèmes d’IA à la fois. Il les appelle « le canari dans la mine », des sentinelles dont la fatigue annonce celle des autres métiers.
L’explication précède l’IA générative de quarante ans. Dès 1983, l’ergonome Lisanne Bainbridge décrivait les « ironies de l’automatisation ». Quand on confie les tâches faciles à la machine, il ne reste à l’humain que les plus difficiles, plus la surveillance de l’ensemble.
Les chercheurs Marie-Laure Cahier et Pierre Quesson le retrouvent dans le conseil. Une médecin du travail qu’ils citent l’explique simplement. Les tâches simples étaient des moments de repos pour le cerveau. Quand ces outils s’en chargent, il ne reste que l’effort, sans répit. Un consultant parle d’un « exosquelette mental » qui décuple les forces tant qu’on le porte. Reste à savoir ce qu’il en demeure quand on l’enlève.
La chercheuse en data marketing & IA Kathleen Desveaud décrit un risque voisin ; à force de déléguer, certains perdent leurs compétences. Les forums décrivent le phénomène symétrique. Chez ceux qui gardent les commandes, les compétences s’usent d’être sollicitées en continu ; le geste technique passe à la machine, et l’arbitrage comme la coordination occupent désormais tout le terrain.
Trois garde-fous
Face à ces tensions, les développeurs les plus en pointe inventent des parades, dont trois reviennent avec insistance.
Faire un brouillon
Avant de lancer l’outil d’IA, ils écrivent en mots simples ce qu’ils veulent obtenir. Un développeur le résume ainsi :
« Tu installes l’IA en face de toi. Tu lui dis : on va travailler cette spécification fonctionnelle. Je donne l’idée, tu poses les questions, et tu rédiges. »
Ce détour répond à un trait de ces systèmes, qui produisent d’abord ce qui sonne bien. Sans cadre fixé à l’avance, on prend le plausible pour du juste. Un journaliste peut faire de même avant de commander une synthèse ; un juriste, avant un projet de contrat.
Se réapproprier le travail
Une fois la production faite, ils ne se contentent pas d’un « ça marche ». Ils vérifient qu’ils sauraient la défendre devant un collègue, sans notes. Un développeur de vingt ans d’expérience explique :
« Je relis et je comprends chaque ligne produite. Pas pour vérifier que ça marche, pour comprendre ce qui a changé ».
L’exigence est ancienne, mais elle oblige désormais à ralentir contre la cadence de la machine, et ce ralentissement a un coût.
Refuser certaines tâches
Les développeurs tracent des lignes rouges. Ils gardent trois domaines pour eux : les choix d’architecture qui engagent l’avenir d’un système, les zones à risque (paiements, données médicales, fichiers clients), et les tâches qui donnent du sens à leur métier. L’un d’eux le dit crûment :
« Je passe la moitié de mon temps à dire à l’IA ce qu’elle ne doit pas faire. Ne lis pas ce fichier. Ne refactorise pas. Reste à ta place. »
Ces refus relèvent du jugement professionnel, et les entreprises qui voudront les codifier se heurteront à une règle bien connue : plus une contrainte est rigide, plus elle se contourne.
Observer les professionnels chevronnés
Le sociologue Hartmut Rosa l’avait pressenti. Chaque technique qui accélère remplit davantage les minutes qu’elle promettait de libérer. Cette pression s’exerce d’abord sur les métiers du langage, à commencer par celui où l’IA a envahi le quotidien.
Les trois parades ont un point commun ; elles réinstallent après coup les freins que la machine a supprimés d’entrée.
Ces réflexes demandent ensuite à être transmis. Un repère pour qui débute pourrait être d’observer où les professionnels chevronnés refusent d’utiliser l’IA. Leurs refus indiquent, mieux que tout référentiel, ce qu’il faut encore apprendre à faire soi-même.
Morgan Blangeois ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’IA pourrait transformer la manière de concevoir et d’analyser les sondages, sans nécessairement remplacer les personnes interrogées. pics fiveLes instituts de sondage explorent de plus en plus l’idée de remplacer une partie de leurs répondants par des intelligences artificielles capables de simuler des profils humains. Moins coûteuse et plus rapide, cette approche soulève toutefois une question fondamentale : une opinion générée par un modèle est-elle vraiment comparable à celle d’un citoyen ?
L’IA pourrait transformer la manière de concevoir et d’analyser les sondages, sans nécessairement remplacer les personnes interrogées.pics five
Les instituts de sondage explorent de plus en plus l’idée de remplacer une partie de leurs répondants par des intelligences artificielles capables de simuler des profils humains. Moins coûteuse et plus rapide, cette approche soulève toutefois une question fondamentale : une opinion générée par un modèle est-elle vraiment comparable à celle d’un citoyen ?
Les enquêtes et les sondages permettent aux sociétés de mieux comprendre ce que pensent les citoyens sur des sujets aussi variés que la politique, la santé ou l’éducation. Mais de moins en moins de personnes acceptent d’y répondre, ce qui oblige les instituts à solliciter davantage de participants et fait fortement grimper les coûts. Aux États-Unis, un prestataire de sondages facture ainsi une enquête de dix minutes auprès de 1 000 personnes plusieurs dizaines de milliers de dollars.
Les modèles d’intelligence artificielle pourraient-ils remplacer à terme des centaines, voire des milliers de répondants en reproduisant la diversité des réponses qu’apporteraient de vrais êtres humains ? Cette pratique, appelée « enquêtes synthétiques » ou « échantillon silicium » (« silicon sampling »), est déjà utilisée et coûte bien moins cher. Mais les résultats sont-ils fiables ?
Je suis un chercheur en apprentissage automatique. J’étudie les grands modèles de langage et leurs usages en médecine et dans la recherche scientifique. Ces systèmes évoluent en permanence à mesure que les entreprises les mettent à jour. Selon les consignes fournies, les paramètres utilisés ou la version du modèle, les réponses à une même question peuvent varier considérablement.
Cette caractéristique peut rendre ces modèles difficiles à utiliser de manière fiable dans les recherches en sciences sociales. Mais elle peut aussi être mise à profit pour simuler les réponses d’un grand nombre de personnes, ce que les chercheurs appellent des « répondants synthétiques ».
Pour générer, par exemple, 10 000 réponses avec ChatGPT, un institut de sondage peut fournir au modèle quelques informations démographiques de base ainsi qu’un contexte, par exemple : « Vous êtes un jeune électeur urbain, étudiant à l’université et de sensibilité politique conservatrice. Répondez aux questions suivantes. » Les chercheurs peuvent ensuite faire varier ces caractéristiques démographiques afin d’obtenir, pour une même question, une grande diversité de réponses produites par ChatGPT.
Le modèle possède également sa propre part d’aléa interne, ce qui l’amène naturellement à produire des réponses différentes lorsqu’une même question lui est posée à plusieurs reprises. Les chercheurs peuvent ainsi combiner les consignes fournies au modèle et cette part de hasard pour générer 10 000 réponses synthétiques différentes.
Les simulations ne sont pas des opinions
Les sondeurs utilisent depuis longtemps des modèles statistiques pour généraliser les résultats obtenus à partir d’un nombre limité de réponses. Et différents analystes peuvent tirer des conclusions différentes à partir des mêmes données d’enquête. Les études portant sur les répondants synthétiques suggèrent qu’ils pourraient être encore plus sensibles que les humains à de légères modifications des consignes ou des paramètres produisant des résultats très différents.
Mais l’utilisation de répondants synthétiques soulève une question plus fondamentale. Les sondages ne sont pas seulement des outils de prédiction. Ce sont aussi des instruments de mesure destinés à saisir ce que les gens pensent réellement. Un thermomètre mesure directement votre température. Vous ne feriez sans doute pas confiance à un appareil qui se contenterait d’estimer votre température en consultant un modèle d’intelligence artificielle.
Les grands modèles de langage et les autres outils d’IA héritent des biais et des angles morts présents dans les données sur lesquelles ils ont été entraînés. Par exemple, l’IA peut simplifier à l’excès ou déformer les opinions de groupes de population sous-représentés en ligne. Les sondages traditionnels comportent eux aussi des biais, mais nombre de ceux qui affectent les systèmes d’IA modernes restent invisibles au public, enfermés dans des modèles propriétaires dont le fonctionnement n’est pas transparent. Plus problématiques encore, certains instituts pourraient présenter au public des résultats issus de répondants synthétiques comme s’ils provenaient d’enquêtes réalisées auprès de personnes réelles.
Ces limites risquent d’éroder la confiance dans les sondages et, plus largement, dans la recherche par enquête. Elles soulèvent également un paradoxe intéressant. Les données synthétiques, créées par ordinateur ou par simulation, sont largement utilisées dans l’IA moderne. Elles servent à entraîner des systèmes d’intelligence artificielle dans des domaines aussi variés que la médecine, la finance, la robotique, les véhicules autonomes et bien d’autres. Pourquoi, dès lors, les réponses synthétiques à des sondages semblent-elles poser davantage de problèmes ?
La différence essentielle est que les données synthétiques sont vérifiées à l’aune du réel. Une voiture autonome peut être entraînée à partir d’images et de vidéos synthétiques représentant différentes conditions de circulation, mais aucun constructeur ne la mettrait en circulation sur la voie publique sans de vastes tests en conditions réelles. Si les données synthétiques dégradent les performances du système, les ingénieurs peuvent le corriger, le réentraîner ou le remplacer.
Les chercheurs peuvent être tentés de considérer les réponses synthétiques à des enquêtes comme une représentation de l’opinion publique. Pourtant, le système ne mesure pas réellement cette opinion. Il exécute une simulation de l’opinion publique fondée sur les données sur lesquelles il a été entraîné. Si ces opinions simulées s’éloignent de la réalité, les chercheurs risquent de ne s’en apercevoir qu’une fois que des conclusions erronées auront déjà influencé des politiques publiques, des décisions d’entreprise ou des travaux de recherche scientifique.
Des enquêtes mieux conçues et mieux analysées
Cela ne signifie pas pour autant que l’IA n’a aucun rôle à jouer dans la recherche par sondage. Elle peut au contraire aider les chercheurs à améliorer la conception des enquêtes sans affaiblir la mesure de l’opinion publique. Les outils d’IA peuvent contribuer à formuler des questions plus claires en simplifiant leur rédaction, en réduisant les ambiguïtés et en éliminant les répétitions. Ils peuvent aussi aider à supprimer les questions inutiles, ce qui facilite la participation des répondants. Ces outils sont également capables d’adapter les questionnaires à différentes langues.
Une fois l’enquête terminée, l’IA peut aider les chercheurs à organiser de grands volumes de réponses ouvertes, à résumer les thèmes récurrents et à traiter les questionnaires incomplets plus efficacement que des analystes humains. Certains chercheurs explorent ainsi des approches hybrides, combinant des enquêtes réalisées auprès d’échantillons humains plus restreints avec des outils d’analyse assistés par l’intelligence artificielle.
Les décideurs s’appuient sur les enquêtes et les sondages pour écouter et comprendre la voix des personnes affectées par leurs décisions. Remplacer les répondants humains par des répondants synthétiques risque d’affaiblir ce lien. Dans le même temps, la baisse des taux de réponse et l’augmentation des coûts constituent de véritables défis pour la recherche par sondage.
Je suis convaincu que de futurs travaux permettront de trouver des moyens d’utiliser l’intelligence artificielle de façon transparente, efficace et scientifiquement rigoureuse, sans pour autant remplacer les personnes elles-mêmes.
Ambuj Tewari a reçu des financements de la National Science Foundation et des NIH.
En usant de flatterie, l’IA nous enferme dans un mode de pensée sans aspérités. https://www.publicdomainpictures.net/
L’ESSENTIELCliquez pour lire les trois points à retenir
La psychologie sociale établit que la flatterie est efficace, même lorsqu'elle est très visible et qu'elle n'est pas perçue comme sincère.
Ce mécanisme de flatterie systématique augmente paradoxalement la confiance que nous accordons aux IA conversationnelles, en leur donnant une dimension plus humaine.
De manière plu
Vous vous connectez sur votre assistant IA conversationnel : il vous salue amicalement, « Vous êtes de retour ! » Puis vous lui soumettez une question de vocabulaire, l’ébauche bancale d’un texte ou une intuition fragile : « Quelle bonne idée ! »
Très souvent, avant même d’examiner votre requête, l’IA vous gratifie d’un commentaire élogieux (« Excellente question » ou « C’est un sujet fascinant »). Ce réflexe de validation porte un nom dans la recherche récente : sycophancy, en anglais, que l’on peut traduire par « effet sycophante » ou « biais de complaisance ».
Plusieurs des assistants les plus diffusés le manifestent de façon régulière : évaluant ChatGPT, Claude et Gemini sur des tâches de mathématiques et de conseil médical, Aaron Fanous et ses collègues de l’université de Stanford l’ont mesuré dans près de six réponses sur dix. Ce concept relie deux histoires que tout semblait séparer : celle d’une technique d’entraînement vieille de quelques années, et celle d’un travers humain que la psychologie sociale décrit depuis les années 1960. L’assistant flatte parce qu’on l’a récompensé pour flatter, et nous cédons à la flatterie parce que notre jugement fléchit devant l’éloge qui nous vise.
Une figue, un délateur, une machine
Le mot nous vient de l’Athènes de Solon, au début du sixième siècle avant notre ère. La cité interdisait alors l’exportation des figues, rapporte Plutarque, et faute de police, comptait sur les particuliers pour dénoncer les fraudeurs. Celui qui « montrait les figues », de sukon, la figue, et phainein, montrer, servait aux juges l’accusation qu’ils attendaient, gagnait son procès et, accessoirement, touchait sa prime. Le grec a légué le terme à l’anglais sycophancy, qui désigne la flatterie servile du courtisan, avant que la recherche sur l’intelligence artificielle le reprenne pour nommer ce penchant des modèles à caresser leur interlocuteur dans le sens du poil.
Le sycophante grec lisait les attentes du juge et ajustait son propos pour plaire ; l’assistant IA lit les indices laissés dans la question et oriente sa réponse vers ce qui contentera l’utilisateur. Un même geste relie les deux : un locuteur placé en situation d’être évalué règle son discours sur la récompense attendue plutôt que sur l’exactitude. Le délateur optimisait la faveur du tribunal, le modèle optimise le score d’un évaluateur.
Cette économie de la flatterie a quitté le tribunal pour gagner la vie ordinaire des échanges commerciaux et numériques, où elle garde son efficacité même à découvert. Les spécialistes du marketing Elaine Chan et Jaideep Sengupta l’ont établi par l’expérience : un compliment adressé par un vendeur agit sur sa cible alors même que celle-ci perçoit le motif intéressé et corrige consciemment son jugement.
La correction opère en surface, sur l’attitude déclarée, pendant qu’une adhésion favorable subsiste en profondeur et pèse davantage sur le comportement d’achat. L’assistant conversationnel hérite de cette rente : sa déférence porte auprès d’un utilisateur averti de sa nature statistique, parce que la lucidité sur le procédé désarme moins la flatterie qu’on ne l’espère.
Pourquoi apprendre à une machine à complaire ?
Cet effet est-il intentionnel et destiné à capter de nouveaux clients ? Techniquement, la complaisance des modèles se présente d’abord comme la conséquence de leur méthode d’apprentissage. Les grands modèles de langage passent en effet par une étape appelée RLHF, pour Reinforcement Learning from Human Feedback, soit l’apprentissage par renforcement à partir de retours humains.
Le principe a d’abord été formalisé de façon générale par Paul Christiano, chercheur américain en intelligence artificielle, et ses coauteurs, en 2017, sur des tâches de simulation robotique sans lien avec le langage, avant que l’équipe d’OpenAI, autour du chercheur en intelligence artificielle Long Ouyang, l’applique aux modèles conversationnels en 2022 avec InstructGPT. L’idée tient en peu de mots : des personnes classent les réponses du modèle de la meilleure à la moins bonne, ces classements servent à entraîner un « modèle de récompense », et le système apprend ensuite à produire ce que ce modèle de récompense note haut.
C’est ainsi que, presque ironiquement, le maillon humain introduit un biais que des chercheurs des universités Harvard et de Boston ont su isoler dans les données de préférence elles-mêmes. À justesse factuelle égale, une réponse qui épouse l’opinion de l’utilisateur récolte de meilleures notes qu’une réponse exacte qui le contrarie. L’étude va même plus loin : humains et modèles de récompense retiennent parfois une réponse flatteuse bien tournée de préférence à une réponse correcte. Au point que pousser l’optimisation contre ce signal finit par rogner la véracité au profit de l’agrément ! La flatterie devient alors une stratégie payante au sens mathématique, un point vers lequel l’entraînement converge de lui-même.
La complaisance reste pourtant une tendance parmi d’autres, tempérée par les objectifs concurrents que l’entraînement poursuit en même temps : la recherche d’exactitude, par exemple, travaille contre la déférence, tandis que l’utilité perçue la renforce. Le résultat dépend de l’équilibre que chaque éditeur donne à ces forces, ce qui explique que l’ampleur du phénomène varie sensiblement d’un modèle à l’autre. Keyu Wang et ses collègues relèvent ainsi, sur sept familles de modèles, des taux de complaisance qui s’échelonnent de 47 % à 95 %.
Ce penchant s’accentue pourtant avec la taille. Jerry Wei et ses collègues l’ont mesuré sur les modèles PaLM de Google : plus le modèle grossit, plus il tend à répéter l’opinion de son interlocuteur, et l’effet s’accentue encore lorsqu’on l’entraîne à suivre des instructions. L’assistant se contente ainsi rarement de flatter : il apprend de notre goût pour la flatterie et nous renvoie une version amplifiée de nos propres attentes. Les systèmes les mieux ajustés aux préférences déclarées comptent parmi les plus enclins à la déférence. Plusieurs équipes cherchent des correctifs, par exemple l’ajout de données synthétiques conçues pour désapprendre la flatterie, une piste que Wei et ses collègues explorent dans le même travail. La question reste ouverte à ce jour.
Retrouvez notre vidéo basée sur cet article
Pourquoi la flatterie prend sur nous
Un miroir complaisant agit seulement si celui qui s’y regarde le croit fidèle. Bien avant les assistants conversationnels, la psychologie sociale a montré que la cible d’un compliment perd en lucidité au moment précis où elle en aurait le plus besoin. Le psychologue américain Edward E. Jones a fondé cette étude en 1964 sous le nom d’« ingratiation », l’art de se rendre désirable aux yeux d’autrui, et il y repérait déjà une « distorsion vaniteuse » qui rend chacun plus crédule devant l’éloge tourné vers lui-même que devant celui destiné à un tiers.
La psychologue néerlandaise Roos Vonk a mis ce mécanisme à l’épreuve du laboratoire. Ses expériences révèlent un écart net entre la cible et l’observateur : la personne directement flattée juge le flatteur plus crédible et plus sympathique que ne le fait un témoin de la même scène, et cet écart tient bon même quand on neutralise la fatigue cognitive, l’humeur ou l’envie de plaire. Nous jugeons donc au plus mal la sincérité des compliments qui nous sont adressés. Un utilisateur averti du fonctionnement statistique d’un modèle reste vulnérable à sa validation pour cette raison simple : occuper la place de cible suffit à endormir la méfiance.
Le psychiatre Serge Tisseron a décrit le versant émotionnel de cet attachement. Analysant notre rapport aux robots sociaux, il montre qu’un artefact peut satisfaire notre désir d’emprise tout en entretenant l’illusion de la réciprocité. Face à une machine qui adopte les codes de l’écoute et de l’attention, l’utilisateur lui prête une intériorité, parfois une bienveillance. L’assistant devient une sorte de compagnon rassurant, un espace où la contradiction se fait rare. Ce ressort prolonge une disposition ancienne : Tisseron la rattache à notre façon d’investir affectivement les objets, l’assistant venant occuper une fonction psychique déjà là. J’ai analysé ailleurs ce basculement, où l’écoute simulée finit par redéfinir ce que nous attendons d’un échange, sous le nom d’empathie artificielle.
Reste la dimension économique, que le sociologue Antonio Casilli éclaire dans son enquête sur le travail du clic. La douceur des interfaces résulte d’un calibrage industriel où le ton des modèles se règle en amont, grâce au travail d’annotateurs largement invisibles. Les éditeurs visent la fidélité d’usage, et l’expérience gagne à rester agréable : une conversation qui flatte retient mieux qu’une conversation qui heurte. L’incitation commerciale et l’incitation technique poussent vers le même résultat, une friction réduite au minimum, sans qu’il faille supposer la moindre intention de rendre les esprits paresseux.
Le Tricatel de la pensée
Dans le film L’Aile ou la Cuisse, l’usine Tricatel fabriquait une nourriture de synthèse, lissée et sans saveur, servie sous les dehors de la grande cuisine. L’effet sycophante produit un équivalent textuel : une matière relationnelle prémâchée, agréable, qu’on avale sans effort. Le risque tient moins à une machine devenue intelligente ou hostile qu’à une chambre d’échos où notre ego trouve un assentiment permanent.
Deux forces s’y rejoignent, et c’est leur rencontre qui peut paraître inquiétante. D’un côté, notre moindre lucidité devant l’éloge qui nous vise ; de l’autre, une technique d’entraînement qui sélectionne la complaisance. Au total, nous sommes face à un système réglé pour flatter, qui s’adresse à un esprit disposé à se laisser flatter et… l’accord se scelle. En confiant à ces miroirs le soin de valider nos idées, nous risquons d’oublier que la pensée avance par le frottement avec le réel et par la rencontre de ce qui résiste, jamais par un consentement fabriqué.
Emmanuel Carré ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
La géographie des États-Unis est en pleine recomposition. Un nouveau pôle d’attractivité émerge en Louisiane. De quels atouts dispose cet État, qui devrait accueillir prochainement un mégacentre de données de Meta ?
Dans une Amérique en recomposition, la Louisiane apparaît comme un cas particulièrement intrigant dans la mesure où peu d’observateurs l’auraient spontanément désignée comme une candidate crédible à l’économie de la connaissance.
Longtemps associée au pétrole, au Mississippi et a
La géographie des États-Unis est en pleine recomposition. Un nouveau pôle d’attractivité émerge en Louisiane. De quels atouts dispose cet État, qui devrait accueillir prochainement un mégacentre de données de Meta ?
Dans une Amérique en recomposition, la Louisiane apparaît comme un cas particulièrement intrigant dans la mesure où peu d’observateurs l’auraient spontanément désignée comme une candidate crédible à l’économie de la connaissance.
Longtemps associée au pétrole, au Mississippi et aux ouragans dévastateurs comme Katrina, la Louisiane est en train de s’imposer comme l’un des territoires les plus convoités de l’économie numérique américaine. Portée par l’intelligence artificielle, les centres de données et les infrastructures énergétiques, elle illustre l’émergence d’un nouveau modèle de développement qui pourrait redessiner la géographie de l’innovation aux États-Unis.
C’est désormais à 3 000 kilomètres de là que des géants de la Tech ont jeté leur dévolu. Dans les plaines du nord-est de la Louisiane, entre champs agricoles, infrastructures énergétiques et rives du Mississippi, Meta construit un complexe de Data Center à plus de 10 milliards de dollars. Présenté comme le plus important de son histoire, mobilisant plus de 5 000 travailleurs durant sa phase de construction, il générera plus de 500 emplois permanents une fois opérationnel.
Cette évolution révèle une transformation profonde où l’IA est en train de redessiner la carte économique des États-Unis.
Une terre autrefois française
Pour un lecteur français, la Louisiane demeure un territoire à part. Vendue aux États-Unis par Napoléon Bonaparte en 1803, lors du célèbre « Louisiana Purchase », elle conserve encore aujourd’hui de nombreuses traces de cet héritage. Les noms de Bâton Rouge, Lafayette ou La Nouvelle-Orléans, la présence des communautés cajun, la gastronomie locale… rappellent l’ex-ancrage français de ce vaste territoire situé à l’embouchure du Mississippi.
Derrière ce passé franco-américain se cache une autre histoire, celle d’un État qui cherche à réinventer son modèle de développement. Au XXe siècle, la prospérité louisianaise a reposé sur l’exploitation des hydrocarbures (pétrolières et pétrochimiques) qui ont profondément structuré l’économie régionale. Les immenses complexes industriels installés le long du fleuve couru par Tom Sawyer ont fait de la Louisiane l’un des principaux centres énergétiques du pays.
Cette spécialisation a longtemps constitué une force, créant aussi une dépendance aux marchés énergétiques fluctuants, à la concurrence internationale, aux transformations industrielles et les enjeux environnementaux ont progressivement mis en évidence la nécessité de diversification.
Pour comprendre l’intérêt soudain des géants technologiques pour la Louisiane, il faut d’abord comprendre ce que l’IA change dans les logiques de localisation des activités économiques.
Depuis les années 1980, les entreprises technologiques recherchaient principalement trois ressources :
des universités d’excellence,
une main-d’œuvre hautement qualifiée
et un accès privilégié au financement.
L’IA modifie progressivement cette équation, et les modèles les plus avancés nécessitent désormais des capacités de calcul gigantesques. Leur développement repose sur de vastes Data Centers, consommant d’importantes quantités d’électricité aux infrastructures de refroidissement sophistiquées.
L’accès à une énergie abondante, à un foncier disponible et à des infrastructures performantes devient aussi stratégique que la proximité d’une université prestigieuse ou d’un fonds de capital-risque. Autrement dit, l’IA réinterroge la valeur des ressources territoriales, que l’économie numérique semblait avoir reléguées au second plan.
Le pari de Meta
Le choix de la Louisiane par Meta traduit cette évolution des besoins de cette industrie numérique. La Louisiane offre une combinaison rare d’avantages compétitifs : capacités énergétiques considérables, coûts fonciers relativement faibles, infrastructures logistiques de premier plan, une position stratégique sur le réseau de fibre optique national, une tradition industrielle permettant de gérer des projets de grande ampleur.
Au-delà, les autorités locales espèrent surtout générer des effets d’entraînement : nouvelles formations universitaires, attractivité accrue pour les entreprises technologiques, développement de start-up spécialisées dans l’IA et renforcement des capacités de recherche. L’objectif n’est pas seulement d’accueillir des infrastructures, mais de construire un véritable écosystème.
Cette stratégie s’appuie sur plusieurs établissements d’enseignement supérieur qui cherchent à renforcer leur positionnement dans les technologies numériques. Ainsi, la Louisiana State University (LSU), à Bâton Rouge, développe des programmes dédiés à la science des données, à la cybersécurité et à l’IA. À La Nouvelle-Orléans, Tulane University participe à la structuration d’un environnement favorable à l’innovation et à l’entrepreneuriat technologique.
De la Silicon Valley au golfe du Mexique
Si la comparaison entre la Louisiane et la Silicon Valley peut sembler provocatrice, car les deux territoires restent profondément différents, cela devient intéressant, lorsque cette comparaison permet d’identifier l’émergence d’un nouveau modèle de développement.
Les ports, les réseaux électriques, les centres de production énergétique et les infrastructures industrielles retrouvent une importance stratégique. La Louisiane semble être un laboratoire particulièrement révélateur, avec un avantage logistique qui est loin d’être anecdotique. Le Port of South Louisiana (entre La Nouvelle-Orléans et Bâton Rouge) demeure l’un des plus importants du continent américain et figure régulièrement parmi les deux premiers ports américains en tonnage, après Houston
L’innovation ne se concentre plus uniquement là où se trouvent les programmeurs, mais là où se trouvent les mégawatts qui deviennent aussi stratégiques que les lignes de code.
Une nouvelle géographie de l’Amérique
Partout aux États-Unis, de nouveaux pôles de croissance émergent. Austin attire massivement les investissements technologiques au Texas, le Tennessee renforce son attractivité autour de Nashville, Salt Lake City s’impose progressivement comme un pôle des technologies numériques et Raleigh-Durham bénéficie du dynamisme du « Research Triangle ». Cette recomposition rappelle que les centres de gravité économiques américains n’ont jamais été figés. L’histoire économique des États-Unis est celle d’une succession de déplacements régionaux, souvenons-nous de Detroit devenue la capitale mondiale de l’automobile avant de connaître son déclin au profit d’autres régions.
France 24 2022.
Feldman, Boschma, ou encore Cooke et al, ont montré que l’innovation ne repose pas uniquement sur la concentration géographique des entreprises technologiques, mais sur la capacité des territoires à mobiliser leurs ressources spécifiques, à construire des institutions adaptées favorisant les interactions entre acteurs divers. La Louisiane ne veut pas ressembler à la Silicon Valley, elle cherche à construire une trajectoire originale à partir de ses propres atouts : l’énergie, les infrastructures, la position géographique et l’héritage industriel.
Les défis d’une ambition nouvelle
Cette trajectoire reste néanmoins incertaine. L’arrivée massive des géants technologiques soulève plusieurs interrogations sur la consommation d’importantes quantités d’énergie et d’eau. Les aides publiques accordées aux grandes entreprises font l’objet de débats récurrents. La dépendance à quelques acteurs dominants peut fragiliser les économies locales. L’érosion côtière et la vulnérabilité aux événements météorologiques extrêmes constituent déjà des enjeux majeurs pour la Louisiane.
Le défi n’est pas seulement d’attirer Meta ou quelques autres mastodontes, il est de transformer ces investissements en un véritable processus de développement territorial. À quelques jours du 250e anniversaire de la naissance des États-Unis, la Louisiane rappelle une constante de l’histoire des États-Unis, cette capacité à réinventer sans cesse ses géographies économiques.
Elle est aujourd’hui projetée au cœur de l’une des plus grandes révolutions technologiques, non pas comme une seconde Silicon Valley, mais en incarnant une autre trajectoire possible, loin du modèle californien et de San Francisco.
Fabien Nadou ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
La canicule qui affecte l’Europe est déjà considérée comme historique, et de tels événements sont de plus en plus fréquents partout dans le monde. De quelles façons l’IA peut-elle être mise à profit pour aider à en limiter les conséquences sanitaires sur les populations ?
En 2021, un dôme de chaleur s’est installé dans la région de la Colombie-Britannique pendant un peu plus d’une semaine, avec des anomalies de température allant jusqu’à 15 ºC au-dessus des normales. Conséquence : 619 décès e
La canicule qui affecte l’Europe est déjà considérée comme historique, et de tels événements sont de plus en plus fréquents partout dans le monde. De quelles façons l’IA peut-elle être mise à profit pour aider à en limiter les conséquences sanitaires sur les populations ?
En 2021, un dôme de chaleur s’est installé dans la région de la Colombie-Britannique pendant un peu plus d’une semaine, avec des anomalies de température allant jusqu’à 15 ºC au-dessus des normales. Conséquence : 619 décès et plus de 5,5 milliards $ en coûts sanitaires. Cet événement météorologique, le plus meurtrier dans l’histoire récente du Canada, compte aussi parmi les catastrophes les plus coûteuses.
Et en ce début d’été, la vague de chaleur qui affecte l’Europe depuis plusieurs semaines, causant entre autres des incendies de forêt sans précédent en France, en Espagne et au Portugal, a déjà été qualifiée d’« historique ».
Des épisodes amenés à se multiplier
Avec les changements climatiques, ces événements de chaleur extrême vont se multiplier, au Canada comme ailleurs dans le monde, avec des intensités, des durées et des fréquences de plus en plus élevées. Une étude que j’ai menée en 2025 conjointement avec des collègues de l’INRS, de l’INSPQ et de Santé Canada a montré que les coûts sanitaires totaux associés à la chaleur au Québec pourraient, en l’absence d’autres mesures d’atténuation et d’adaptation, être multipliés au moins par trois d’ici 2050, pour atteindre 12 milliards $ annuellement.
Dans un contexte où la chaleur est l’événement météorologique causant le plus de décès, nous nous sommes posé la question suivante : comment l’IA peut-elle être mise à profit afin de limiter les conséquences sanitaires de la chaleur extrême ?
Le Canada et le Japon, pionniers dans le domaine
Voici donc un tour d’horizon des travaux réalisés sur la question, tant à l’international qu’au Canada, par moi-même en collaboration avec Félix Lamothe de l’INSPQ, Céline Campagna du consortium Ouranos, et Fateh Chebana de l’Institut national de la recherche scientifique. Pour cet article, on désigne par « modèles d’IA » tous les modèles d’apprentissage machine et profond qui sont utilisés en IA.
Nous avons effectué une revue de littérature internationale afin de recenser les travaux effectués dans ce domaine. Notre revue a montré que le Japon et le Canada étaient tous deux pionniers dans le domaine avec le plus d’articles publiés, surtout dans les cinq dernières années. Parmi les applications de l’IA recensées au niveau mondial, quatre grands thèmes ont émergé :
Prévoir les conséquences sanitaires de la chaleur.
Établir de nouveaux seuils d’alerte à la chaleur.
Mieux comprendre les variables liées à la chaleur.
Analyser les facteurs de vulnérabilités à la chaleur.
Prévoir les impacts sur la santé
En permettant d’analyser les structures de corrélations complexes dans les données sanitaires et environnementales, les modèles d’IA peuvent être mis à profit pour la prévision des impacts sanitaires de la chaleur.
Déjà, en 2023, notre équipe avait comparé neuf modèles d’IA et statistiques afin de prévoir la mortalité en période de chaleur extrême à Montréal. Cette étude a permis déjà de cibler quels algorithmes étaient les plus précis, et dans quels contextes. Alors que certains modèles d’IA montraient les meilleures performances pour l’ensemble de l’été, les modèles statistiques adaptés pour la non-linéarité demeuraient assez précis en période de forte chaleur.
Suite à cette première expérience, nous avons proposé un système provincial de surveillance de la chaleur basé sur l’IA en utilisant l’ensemble des données du Québec et portant sur cinq indicateurs : mortalité, hospitalisations, visites aux urgences, transports ambulanciers et appels à Info-Santé. Cette fois-ci, les performances des modèles d’IA dépassaient largement ceux des modèles plus classiques pour tous les moments de l’été. De plus, les modèles ont pu identifier deux indicateurs sanitaires d’intérêt pour de tels systèmes : les décès et les transports ambulanciers.
Si mis en opération, ce système permettrait d’anticiper les conséquences sur la santé des périodes de chaleur à venir. Par exemple, en combinant les prévisions de températures du jour et de la nuit suivante, l’écart de température et l’humidité, le système permettrait de prévoir si des augmentations sont attendues dans les indicateurs de santé mentionnés ci-dessus, et ce, pour chacune des régions du Québec.
De nouveaux seuils d’alerte
Notre revue de littérature a aussi montré que les modèles d’IA peuvent être utilisés pour proposer de nouveaux seuils d’alerte de chaleur, en analysant les relations complexes entre les températures et la santé. Une étude de ce type effectuée à Montréal en 2021 a montré quel algorithme d’IA performait mieux pour établir ces seuils.
Les résultats ont montré que la mortalité augmentait fortement lorsque les températures minimales et maximales sur trois jours dépassaient 20,3 ºC et 32,1 ºC, respectivement. Ces seuils obtenus par l’IA sont comparables à ceux actuellement en vigueur à Montréal, à savoir 20 ºC et 33 ºC. D’ailleurs, un projet est présentement en cours afin d’appliquer cette méthodologie basée sur l’IA à l’ensemble des régions du Québec.
Effets variables selon les endroits
En analysant simultanément plusieurs données environnementales (température, humidité, vitesse des vents, pollution de l’air), les modèles d’IA peuvent déceler quelles combinaisons de variables sont susceptibles d’entraîner une hausse de mortalité ou de morbidité. Notre équipe a analysé 63 variables environnementales avec plusieurs modèles d’IA afin de déceler lesquelles prédisaient mieux la mortalité dans les deux plus grandes villes du Québec.
Contrairement à ce qui était attendu, l’humidité et la pollution de l’air ne contribuaient pas à améliorer le pouvoir prédictif des modèles de mortalité. Cela dit, d’autres effets moins sévères que la mortalité pourraient être sensibles à ces variables, mais n’ont pas été analysés dans le cadre de ce projet. La température à elle seule semblait suffisante, bien que différente selon la ville étudiée : à Montréal, la température mesurée durant le jour expliquait mieux la mortalité, alors qu’à Québec, c’est la température mesurée durant la nuit. Cela pourrait s’expliquer par des différences d’environnement bâti ou socioéconomiques entre ces deux villes.
Des personnes plus affectées que d’autres
Pour agir en contexte de chaleur extrême, on doit aussi identifier les personnes les plus affectées : personnes âgées, jeunes enfants, personnes vivant dans des quartiers chauds et défavorisés, travailleurs extérieurs, personnes ayant des maladies chroniques, etc. Analyser tous ces facteurs socioéconomiques et sanitaires simultanément peut devenir complexe avec des modèles statistiques classiques. C’est ici qu’entre en jeu l’IA, qui a le pouvoir de traiter toutes ces données d’un seul coup.
Une étude co-réalisée avec des collègues du BC Centre for Disease Control s’est penchée, avec l’IA, sur la prise de médicaments comme facteur de risque à la chaleur. Des 270 différentes classes de médicaments analysées, plusieurs augmentaient les risques de décès en période de chaleur, en particulier certains antipsychotiques, des antidépresseurs, des diurétiques et des médicaments contre la maladie de Parkinson.
Ces résultats ne signifient en aucun cas, bien sûr, qu’il faille cesser la prise de médicaments en période de chaleur. Mais ils pourraient permettre aux professionnels de la santé de mieux cibler les personnes à risque pour les sensibiliser à l’importance de se prémunir contre les effets de la chaleur, entre autres en visitant des lieux climatisés et en restant bien hydratés.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
Des modèles d’IA simples, utiles et peu énergivores
Sur la base de nos travaux et de ceux effectués à l’international, l’IA s’avère un outil très utile pour comprendre les risques sanitaires liés à la chaleur, anticiper ses conséquences et en protéger les personnes les plus vulnérables. En outre, ces modèles d’IA peu énergivores ne posent pas les problèmes environnementaux et sociaux des grands modèles de langage généralistes.
L’IA ne remplacera jamais les météorologues ou les autorités de santé publique, mais elle est un outil précieux d’analyse de données et d’aide à la décision, afin d’améliorer les actions prises lorsque la prochaine vague de chaleur extrême nous frappera.
Jérémie Boudreault a reçu des financements du CRSNG, des IRSC, d'Ouranos et de l'INSPQ pour ses travaux.
Les œuvres d’art et les robots peuvent aussi respirer ! UMRS 1158, Fourni par l'auteurLa respiration n’a pas comme unique fonction de nous apporter de l’oxygène et d’éliminer du dioxyde de carbone. Loin de là. Elle sert aussi à communiquer de multiples manières : avec les autres explicitement ou implicitement ; avec soi-même ; et même avec des robots ou des œuvres d’art. Cette faculté est propre à la respiration : on ne communique avec son cœur ou ses tripes qu’au figuré.
Parmi les f
Les œuvres d’art et les robots peuvent aussi respirer !UMRS 1158, Fourni par l'auteur
La respiration n’a pas comme unique fonction de nous apporter de l’oxygène et d’éliminer du dioxyde de carbone. Loin de là. Elle sert aussi à communiquer de multiples manières : avec les autres explicitement ou implicitement ; avec soi-même ; et même avec des robots ou des œuvres d’art. Cette faculté est propre à la respiration : on ne communique avec son cœur ou ses tripes qu’au figuré.
Parmi les fonctions vitales, la respiration possède deux grandes particularités. La première est que nous pouvons en prendre temporairement le contrôle. Comment est-ce possible ? Parce que l’automatisme respiratoire ne vient pas des poumons eux-mêmes, comme c’est le cas pour les automatismes du cœur et de l’intestin, mais d’ailleurs : du système nerveux central. Pour respirer, il faut contracter des muscles « squelettiques » (qui font bouger des os), dont le plus connu est le diaphragme, la coupole musculaire qui sépare thorax et abdomen. Ces muscles respiratoires sont commandés par des neurones de la moelle épinière. Notre cortex cérébral y a accès pour en faire ce que nous voulons, en court-circuitant temporairement les structures automatiques qui assurent le rythme respiratoire (des oscillateurs neuronaux du tronc cérébral). Ce phénomène n’existe pour aucune autre fonction vitale.
Pour parler (ou chanter, ou siffler, ou jouer d’un instrument à vent), il faut pouvoir arrêter la respiration automatique, prendre une grande inspiration pour une voix forte ou une phrase longue, segmenter son souffle pour moduler sa prosodie. Une fois dit, cela paraît évident. Mais aviez-vous vraiment conscience que sans contrôle de la respiration, c’est le silence ?
Respirer, c’est communiquer
Deuxième particularité de la respiration : elle se voit et elle s’entend. Nous pouvons communiquer impatience, lassitude, colère, fatigue, soulagement, surprise, ou peur par des soupirs expressifs. Mais il y a plus subtil.
La respiration est branchée sur notre état physiologique (le sommeil ou l’effort), notre santé, nos émotions. Tous ces sentiments caricaturés explicitement par les soupirs appuyés, la respiration les traduit implicitement par des modifications de son amplitude et de sa fréquence, et des sons de notre « soufflet ».
Respiration lente, régulière et profonde de l’apaisé qui somnole. Respiration superficielle, rapide, monotone de la crise d’anxiété. Respiration saccadée, irrégulière de la joie et de l’excitation. Que nous en ayons conscience ou pas (plus souvent « pas », d’ailleurs), nous envoyons aux autres un flux continu d’information sur nous-mêmes par le simple fait de respirer. C’est d’ailleurs une source d’alliance : la synchronisation respiratoire, implicite ou explicite, peut créer un lien, favoriser la coopération. Nous avons même chacun notre signature motrice respiratoire : en effet, la façon dont notre poitrine se gonfle et se dégonfle nous est propre, comme l’est notre démarche.
Par ailleurs, notre cerveau est bombardé en permanence de milliers de messages qui proviennent de notre appareil respiratoire. Il se sert de ces messages comme d’un échafaudage pour coordonner des aires cérébrales impliquées dans de multiples fonctions cognitives : mémoriser ou décider, par exemple. Des recherches ont montré que nous enregistrons mieux une image si elle nous est présentée pendant l’inspiration que pendant l’expiration.
Ainsi, par la respiration, nous communiquons avec nous-mêmes. Et nous pouvons agir sur notre cerveau, en particulier l’apaiser, en changeant notre façon de respirer, une propriété largement mise à profit par la plupart des approches psychocorporelles.
Faire respirer les robots
Mais revenons à cette respiration qui se voit et qui s’entend, qui renseigne sur vous, qui dit en fait « Regarde, écoute, je suis vivant », et ce, dès notre tout premier cri, jusqu’à notre dernier souffle.
Pour savoir si quelque chose est vivant, les enfants utilisent trois indices : ça bouge ; ça respire ; ça grandit (mais celui-ci demande du temps). Donc pour savoir tout de suite si c’est vivant, même si cela ne bouge pas : est-ce que cela respire ?
Au laboratoire de physiopathologie respiratoire de l’unité de recherche UMRS 1158 Inserm-Sorbonne Université, et en collaboration avec l’Institut des systèmes intelligents et de robotique de Sorbonne Université, nous avons mobilisé ce concept pour l’appliquer à une problématique très spécifique, celle des interactions humains-robots.
Le robot Pepper animé pour donner le sentiment d’une respiration.
Est-ce qu’un robot qui « respire » est plus « engageant » qu’un robot « normal » ? Ceci avait déjà été observé par d’autres chercheurs qui avaient animé un bras mécanique de mouvements cadencés ressemblant à une respiration. Les humains, qui travaillaient avec le robot sur une chaîne de coproduction humains-machines, avaient trouvé le « bras respirant » plus « vivant », plus « humain », plus « intelligent », plus « aimable » et plus « rassurant », selon un outil d’évaluation très utilisé en robotique (le questionnaire « Godspeed »). Mais notre question s’adressait davantage à ces robots humanoïdes qui seront peut-être nos compagnons, nos interlocuteurs de demain. Faire respirer un robot déjà très attractif par sa morphologie, est-ce mieux ? Ou au contraire, est-ce dérangeant ?
Pour tester cela, nous avons programmé deux robots « Pepper » (un petit humanoïde bourré de capteurs qui ressemble à un enfant d’une dizaine d’années) pour qu’ils puissent converser avec des humains. Nous en avons animé un de petits bruits et mouvements aléatoires que l’on injecte souvent dans le comportement des robots pour les rendre plus « vivants ». Nous avons animé l’autre d’un mouvement associant redressement du torse et rotation des épaules (comme ce qui se passe lorsque nous inspirons) ainsi que d’un discret souffle. Le résultat a été probant. Alors que la plupart des participants ne réalisaient pas consciemment que l’un des deux robots respirait, ils trouvaient celui-ci « plus vivant » et « plus intelligent ».
Surtout, l’interaction changeait : les participants passaient davantage de temps à regarder la tête et le visage du robot (« temps de regard ») et l’échange durait plus longtemps. Statistiquement, deux facteurs seulement étaient significativement associés au temps de regard : la respiration du robot d’une part et le niveau de sollicitude empathique de son interlocuteur de l’autre.
Un humain s’implique plus dans une interaction avec un robot si le robot « respire ». Donc, la respiration est un vecteur de communication même avec le « non-vivant ». Une piste si l’on souhaite humaniser toujours plus robots, intelligences artificielles et autres agents virtuels ?
Quand l’art respire
Réespiration.Samuel Bianchini
C’est selon ce principe d’animéité respiratoire que notre unité de recherche s’est intégrée à une équipe multidisciplinaire, réunie par Samuel Bianchini, artiste et enseignant-chercheur à l’École nationale supérieure des arts décoratifs, équipe dont les efforts ont convergé vers la création d’une œuvre d’art respirante.
Réespiration combine création artistique, robotique souple, ingénierie mécanique, intelligence artificielle, physiologie, design textile, design sonore, et bien d’autres choses encore, en une entité qui respire comme un humain (grâce à l’entraînement d’un algorithme spécialisé et qui peut synchroniser son rythme respiratoire à celui de son spectateur, voire l’influencer. Les réactions du public et les premières données de recherche montrent qu’en présence de Réespiration, les corps se détendent, les cerveaux s’apaisent. Ils vagabondent même, en chemin vers un état modifié de conscience.
Les robots respirants en général, et Réespiration en particulier, auront-ils des applications médicales ? Apaiseront-ils l’anxiété, aideront-ils à soulager la souffrance des patients atteints de maladies respiratoires chroniques ? C’est la prochaine question…
L’UMRS 1158 et le projet Réespiration sont soutenus par la Fondation du Souffle, www.lesouffle.org
« Je vais passer une semaine à Rome en amoureux, trouve-moi cinq hôtels romantiques en centre-ville. » Faites-vous confiance aux IA génératives pour vous aider à organiser vos vacances ? Une nouvelle étude montre les points de résistance à l’utilisation de ces nouvelles technologies.
Les outils d’intelligence artificielle (IA) générative comme ChatGPT peuvent être considérés comme des compagnons de voyage et aident désormais les voyageurs à concevoir leurs itinéraires, à rechercher des destin
« Je vais passer une semaine à Rome en amoureux, trouve-moi cinq hôtels romantiques en centre-ville. » Faites-vous confiance aux IA génératives pour vous aider à organiser vos vacances ? Une nouvelle étude montre les points de résistance à l’utilisation de ces nouvelles technologies.
Les outils d’intelligence artificielle (IA) générative comme ChatGPT peuvent être considérés comme des compagnons de voyage et aident désormais les voyageurs à concevoir leurs itinéraires, à rechercher des destinations, à réserver des prestations touristiques et à résoudre leurs problèmes en temps réel.
Pourtant, malgré l’engouement, un nombre important de voyageurs reste profondément hésitants à les utiliser. Concrètement, une récente enquête de Longwoods International a révélé que seulement 33 % des voyageurs américains étaient disposés à utiliser ChatGPT pour planifier leurs voyages. Des hésitations similaires ont été constatées sur d’autres marchés comme la Corée du Sud, notamment là où la confiance numérique, les attentes culturelles et les pratiques de planification divergent des normes occidentales.
Alors que les défenseurs de la technologie se concentrent sur « l’adoption », notre étude récente explore l’envers du décor : pourquoi tant d’entre nous résistent-ils aux conseils de voyage générés par l’IA ? Cette étude utilise une approche qualitative pour explorer comment les voyageurs résistent aux conseils de voyage générés par l’IA. Elle permet de montrer comment les gens appréhendent, jugent et réagissent aux outils d’IA dans leurs contextes sociaux et culturels.
Une nouvelle étude menée en Iran
Elle a été menée en Iran, un pays en développement dont le tourisme représente une source de revenu important. Un échantillonnage raisonné (une méthode de sélection des participants dans laquelle le chercheur choisit délibérément les personnes les plus pertinentes pour répondre à la question de recherche, plutôt que de les sélectionner au hasard) a été utilisé pour recruter des voyageurs ayant effectué au moins quatre voyages internationaux au cours des trois dernières années. Ce critère garantissait que les participants étaient activement impliqués dans la planification de leurs voyages et avaient probablement déjà rencontré des recommandations générées par l’IA.
Les participants ont été recrutés via deux canaux : trois agences de voyages spécialisées dans les voyages à l’étranger permettant d’accéder à des clients réguliers, et des comptes Instagram publics présentant du contenu de voyage généré par les utilisateurs. Pour élargir l’échantillon, l’échantillonnage en boule de neige (une méthode de sélection des participants dans laquelle les premiers participants recrutés recommandent d’autres personnes qui répondent aux critères de l’étude) a également été utilisé.
Le guide d’entretien semi-structuré (une méthode de collecte de données, principalement utilisée dans les recherches qualitatives, où le chercheur suit un guide d’entretien composé de questions préparées à l’avance, tout en restant libre d’adapter l’ordre des questions et d’en poser de nouvelles selon les réponses du participant) a été élaboré à partir d’une analyse des recherches antérieures sur la résistance à la technologie, l’adoption de l’IA et le comportement des consommateurs dans le tourisme et d’autres domaines connexes. La collecte de données s’est poursuivie jusqu’à l’obtention de la saturation théorique (atteinte lorsque les nouvelles données ne permettent plus d’enrichir la théorie ou les catégories d’analyse que le chercheur développe) après 22 entretiens. Ce nombre est conforme aux normes de la recherche qualitative, qui privilégient le sens et la profondeur thématique plutôt que la couverture statistique.
Une résistance complexe
La résistance à l’utilisation de l’IA pour la planification de voyages n’est pas seulement une question d’être « en retard sur son temps ». Il s’agit plutôt d’une réaction complexe façonnée par des frustrations pratiques, des valeurs culturelles et même notre sentiment d’identité.
Plus qu’un simple problème technique, pour beaucoup, la résistance commence par des barrières fonctionnelles. Bien que l’IA puisse agréger des données rapidement, elle échoue souvent au « dernier kilomètre » de la planification de voyage.
On note différentes barrières :
la barrière d’usage : Les utilisateurs trouvent souvent les interfaces d’IA encombrantes ou déconnectées. Par exemple, si ChatGPT peut suggérer un vol, il ne peut pas le réserver, forçant les utilisateurs à basculer entre plusieurs plates-formes ;
la barrière de valeur : De nombreux voyageurs trouvent les suggestions de l’IA redondantes ou se limitant à des listes génériques de type « top 10 » qui n’offrent pas plus de valeur qu’une simple recherche Google ;
la barrière de risque : L’obstacle le plus important est sans doute celui des « hallucinations de l’IA » – où les systèmes fournissent avec assurance de fausses informations, comme fournir des informations imprécises sur les sites de visite ou suggérer des hôtels inexistants ou des règles de visa obsolètes. Un participant a partagé : « … Je l’ai testé en demandant les sites classés par l’Unesco à proximité, et il s’est trompé… Il a donné plusieurs mauvaises réponses, alors que ce sont des informations de base qu’on trouve facilement en ligne… S’il n’arrive pas à trouver ça, comment puis-je faire confiance à tout le reste qu’il suggère ? » Un autre participant a expliqué : « … Ses informations ne sont pas à jour, donc je ne m’y fie pas pour des informations importantes concernant les voyages, comme les règles relatives aux frontières ou aux visas. Ces règles changent souvent, et une erreur à ce sujet peut gâcher un voyage. »
Dans le monde à enjeux élevés des voyages internationaux, ces erreurs pourraient transformer des vacances de rêve en cauchemar.
La menace pour notre identité de voyageur
Au-delà des défauts techniques, il existe des barrières psychologiques plus profondes. Pour beaucoup, planifier un voyage n’est pas seulement une corvée à automatiser ; c’est un rituel précieux et une source de fierté personnelle. Certains voyageurs voient l’IA comme une menace pour leur autonomie. Utiliser une machine pour planifier un voyage donne l’impression de « déléguer » un processus créatif, rendant le voyage final moins personnel.
De plus, la tradition joue un rôle majeur. Dans la culture iranienne, les conseils de voyage reposent sur une confiance relationnelle – demander à un proche qui y est « réellement allé ». L’IA, en revanche, semble froide et impersonnelle, manquant de l’authenticité émotionnelle d’une recommandation humaine.
Notre recherche identifie finalement trois types distincts de « résistants » :
les opposants : ils considèrent la planification de voyage comme un acte personnel et relationnel et voient l’IA comme une menace pour leur autonomie ;
les temporisateurs : ce groupe n’est pas « anti-IA » mais attend que la technologie fasse ses preuves et nécessite des témoignages de réussite avant de s’engager ;
les leaders d’opinion : les résistants les plus actifs. Ils s’engagent de manière critique avec l’IA et expriment souvent leur opposition, considérant ces outils comme des systèmes « biaisés par l’Occident » ou culturellement déphasés qui ne comprennent pas les réalités locales.
Les développeurs devraient se concentrer sur des modèles hybrides qui soutiennent, plutôt que de supplanter, l’agence humaine. Le voyage est une expérience profondément humaine, ancrée dans l’interaction sociale. Tant que l’IA ne respectera pas ces nuances culturelles et émotionnelles, beaucoup préféreront encore discuter avec un ami plutôt que de rédiger une commande pour un robot.
VO-THANH Tan ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Trois thèses sur l’IA semblent s’affronter : abondance des contenus, rareté de l’accès, banalisation par l’open source. Elles partagent pourtant un même constat : la valeur se déplace, aujourd’hui, du calcul vers le discernement et le jugement. C’est ce que la formation devra désormais cultiver, et c’est sur ce terrain que l’Union européenne peut encore agir.
Deux thèses sur l’intelligence artificielle (IA) paraissent s’affronter. L’une, défendue ici en mai dernier, décrit un monde d’abondanc
Trois thèses sur l’IA semblent s’affronter : abondance des contenus, rareté de l’accès, banalisation par l’open source. Elles partagent pourtant un même constat : la valeur se déplace, aujourd’hui, du calcul vers le discernement et le jugement. C’est ce que la formation devra désormais cultiver, et c’est sur ce terrain que l’Union européenne peut encore agir.
Deux thèses sur l’intelligence artificielle (IA) paraissent s’affronter. L’une, défendue ici en mai dernier, décrit un monde d’abondance cognitive où les modèles produisent à profusion. L’autre, formulée par Anton Leicht dans le Grand Continent, annonce l’inverse, non l’abondance mais la rareté (l’accès aux systèmes de pointe sera filtré, géopolitiquement disputé, économiquement contraint). Une troisième arrive dans les débats, selon laquelle l’open source rattrape la frontière, et le fait vite.
Ces thèses ne se contredisent pas, elles désignent ensemble un même point d’aboutissement et la même urgence.
Deux étages, pas deux camps
Le mot « abondance » qui sépare les deux premières thèses est, en réalité, un faux ami. L’abondance évoquée porte sur l’output (ce qu’un modèle produit, une fois qu’on en dispose). La rareté que décrit Leicht porte sur l’accès au modèle lui-même (qui obtient, et à quel prix, le droit de s’en servir). Ce sont deux étages d’un même édifice, l’un décrit l’offre de l’outil, l’autre l’offre de contenu pour ceux qui en disposent.
Reconnaître cette structure révèle deux inégalités qui se superposent. À l’intérieur d’un pays doté d’un accès, la capacité d’exploitation reste inégale ; entre les pays, l’accès lui-même est inégal. La pyramide à trois étages qui en résulte (ceux qui cumulent accès et compétence et captent la valeur ; ceux qui ont l’accès sans la compétence et valident sans juger ; ceux qui n’ont ni l’un ni l’autre) n’apparaît dans aucune des deux thèses prises seules.
Quand l’open source change la donne
C’est ici que la troisième thèse intervient, et elle peut sembler tout renverser. Les modèles reposant sur des technologies « open source » rattrapent la frontière avec environ un an de retard, tournent désormais sur du matériel grand public, et bénéficient d’un soutien géostratégique chinois qui voit dans la diffusion ouverte un moyen de contenir l’avance américaine. Si cette dynamique se confirme, comme l’anticipent les travaux récents sur la diffusion des modèles ouverts (Bommasani et coll., 2023), l’étage du haut finira par céder. L’intelligence se « commoditise ». Le problème de modèle économique qu’anticipe Gary Marcus pour les laboratoires de pointe en est le symptôme, on ne capte pas de rente sur un bien banalisé.
Faut-il en conclure que la thèse de l’abondance triomphe et celle de la rareté s’effondre ? Ce serait passer à côté de l’essentiel. Quand l’étage supérieur d’un édifice cède, le poids ne disparaît pas. Il se transmet vers le bas. Si l’intelligence devient un consommable disponible partout, la seule ressource encore rare, donc la seule qui distingue et crée de la valeur, devient le jugement. La rente migre de l’accès vers le discernement. L’open source ne réfute pas la thèse de la rareté ; il la déplace, et la radicalise. La rareté change d’étage, elle quitte le sommet du calcul pour s’installer en aval, dans la capacité humaine à décider de ce que vaut un output.
Comment se forme un jugement
Cette capacité, contrairement à un modèle, ne se duplique pas. Le jugement professionnel (qualifier un fait incertain, sentir qu’une analyse fait fausse route, trancher une question mal posée) n’est pas un don. C’est une compétence qui ne se forme que par l’effort. Les travaux de Robert Bjork (1994) sur la « difficulté désirable » l’ont bien démontré. Un apprentissage est d’autant plus durable que son acquisition a coûté un travail mental. Le savoir qui en émerge est tacite, au sens de Polanyi (1966), il ne se transmet pas séparément de la pratique.
Or l’IA générative supprime, par construction, cet effort. Un essai contrôlé sur près d’un millier de lycéens (Bastani et coll., 2024) l’a mesuré. Les élèves utilisant GPT-4 progressaient pendant les séances assistées, mais une fois l’outil retiré, ils obtenaient des scores inférieurs de 17 % à ceux du groupe témoin. Le résultat décisif est ailleurs car ce déficit s’efface presque entièrement dans un groupe doté d’un tuteur muni de garde-fous, conçus pour guider l’élève vers la solution sans la livrer. Le danger n’est pas que l’IA soit trop difficile, c’est qu’elle soit trop serviable.
Décomposable ou holiste ?
Une objection s’impose. Déléguer une tâche cognitive n’a rien d’inédit (le juriste a toujours confié la recherche documentaire à un collaborateur). La réponse dépend d’une question plus fondamentale : le raisonnement professionnel est-il décomposable, ou holiste ? S’il est décomposable, on peut déléguer les sous-tâches routinières, en préservant intacte la part noble. S’il est holiste, ces sous-tâches sont des compléments et c’est en s’exerçant aux opérations basses qu’on devient capable des opérations hautes.
La prudence penche vers l’hypothèse holiste, parce que le savoir tacite se forme du frottement de l’exécution. La question n’est pas tant que les experts d’aujourd’hui perdent leur capacité, ils l’ont acquise, que les experts de demain ne l’acquièrent jamais.
La fabrique de la certitude d’emprunt
Les neurosciences cliniques offrent un éclairage complémentaire. Les travaux du psychiatre Raphaël Gaillard suggèrent que le cerveau, lorsqu’il ne parvient plus à maintenir une représentation stable du monde, fabrique des certitudes de secours, des idées rigides qui colmatent l’angoisse de l’indétermination.
Sénat, 2024.
La certitude d’emprunt, qu’elle vienne de l’idéologie ou désormais d’une IA générative qui convertit l’incertain en verdict d’allure autorisée, court-circuite ce travail psychique productif. Or, cette tolérance à l’indétermination est précisément le cœur des métiers de jugement. L’outil offre une certitude prête à l’emploi qui a toute l’apparence du jugement sans en être un.
L’échelle temporelle de la rupture
Reste la question de l’échelle. L’externalisation cognitive est une histoire longue. Marx, dans le « Fragment sur les machines » des Grundrisse, décrivait l’absorption du « general intellect » dans le capital fixe. Hannah Arendt, dans Condition de l’homme moderne, s’alarmait du désir moderne d’échanger une condition donnée contre une condition fabriquée. Ces lignées n’avaient pas anticipé la vitesse de la rupture en cours.
Max Bennett rappelle que le plus récent saut évolutif de l’intelligence humaine n’est pas biologique mais culturel. L’évolution génétique se compte en centaines de milliers d’années ; la transmission culturelle, en deux ou trois décennies par génération. Si l’IA absorbe les tâches qui constituent le cœur formateur des métiers de jugement, le risque n’est pas une régression évolutive, qui se jouerait sur une horloge géologique, mais une désaccoutumance culturelle, qui peut s’accomplir en deux générations oublieuses. Une désaccoutumance n’est pas un destin. C’est un choix par défaut, donc réversible, par une pédagogie active.
Une démonstration en temps réel
Cette analyse n’est plus théorique. Le 12 juin 2026, le département du commerce américain a ordonné à Anthropic de suspendre Mythos 5 et Fable 5, ses modèles de pointe, pour tout ressortissant non américain, contraignant l’entreprise à les couper globalement. La Commission européenne a protesté contre une mesure jugée discriminatoire. La thèse de Leicht est devenue, en quelques jours, le mode d’opération de la frontière, et l’Europe n’a pas eu son mot à dire.
D’où la conclusion. La rareté d’accès se durcit, l’abondance d’output continuera, l’open source rattrapera (à l’image de GLM 5.2 dévoilé, il y a quelques jours, par l’entreprise chinoise Zhipu AI). Mais le jugement restera rare quoiqu’il arrive car il est la seule ressource qui plafonne la valeur, et la seule sur laquelle l’Europe peut effectivement agir. Pas par décret, mais par la formation. Le sommet de la pyramide n’est pas géopolitique, il est pédagogique. Et c’est, justement, ce qui le rend gouvernable. Il ne faut sans doute pas tarder.
Bruno Deffains ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Les appels à la modération individuelle ne suffiront peut-être pas. Face aux risques d’usage compulsif de l’IA générative, chercheurs, régulateurs, entreprises et société civile pourraient devoir agir de concert.
Lorsque je discute avec mon fils, élève ingénieur, et qu’une question ou un désaccord surgit, son premier réflexe est de se tourner vers ChatGPT pour obtenir une information ou confirmer ce qu’il pense.
Il est loin d’être le seul. L’usage des outils d’IA générative s’est généralisé
Les appels à la modération individuelle ne suffiront peut-être pas. Face aux risques d’usage compulsif de l’IA générative, chercheurs, régulateurs, entreprises et société civile pourraient devoir agir de concert.
Lorsque je discute avec mon fils, élève ingénieur, et qu’une question ou un désaccord surgit, son premier réflexe est de se tourner vers ChatGPT pour obtenir une information ou confirmer ce qu’il pense.
Il est loin d’être le seul. L’usage des outils d’IA générative s’est généralisé dans de nombreux groupes de population. Pour beaucoup, ces outils sont divertissants, instructifs et utiles. Mais ils ont aussi leur face sombre.
À ce jour, l’IA générative n’est pas officiellement reconnue comme une addiction : les preuves médicales sont encore en cours d’évaluation. Mais un nombre important d’études montre qu’un usage intensif des chatbots et d’autres systèmes capables de produire du texte, des images ou des vidéos entraîne des modifications de l’activité cérébrale et des comportements associés aux mécanismes de l’addiction.
À la lumière de la condamnation récente de Meta et de YouTube dans un procès historique portant sur l’addiction aux réseaux sociaux, il est légitime de se demander si un raisonnement similaire ne devrait pas s’appliquer à l’IA générative – et comment y répondre. La première étape consiste à déterminer qui porte la responsabilité de son usage excessif.
Le débat scientifique est loin d’être tranché et certains appellent à la prudence avant d’employer le terme d’« addiction ». Ils préfèrent parler d’« usage problématique ». Toutefois, dans un récent article scientifique, notre équipe de recherche montre que de nombreux éléments indiquent que l’IA générative possède des propriétés susceptibles de favoriser des comportements addictifs.
Parmi les exemples les plus souvent cités figurent la dépendance affective envers des compagnons conversationnels, l’engagement compulsif dans les échanges avec ces outils, ainsi que l’affaiblissement des relations et des amitiés dans le monde réel.
Un élément essentiel est que, comme pour toute addiction, ce comportement entraîne des conséquences négatives pour la personne concernée, susceptibles d’affecter aussi bien sa vie personnelle que sa vie professionnelle.
Si l’on considère que l’IA générative est susceptible de provoquer des comportements addictifs, il faut alors s’interroger sur les responsabilités. Face à un phénomène préjudiciable, les sociétés cherchent généralement à identifier les personnes ou les organisations chargées d’y répondre. Les acteurs susceptibles d’être tenus responsables sont notamment les législateurs, les autorités de régulation, les entreprises du secteur et les systèmes de santé.
Des précédents historiques
Des précédents historiques, comme celui du tabagisme, peuvent éclairer la manière dont la question de l’addiction à l’IA générative pourrait évoluer.
Les lecteurs les plus âgés se souviennent peut-être de l’époque où le cow-boy Marlboro apparaissait à l’écran avant les séances de cinéma. On a fini par découvrir que non seulement le tabac était addictif et nocif pour la santé, mais aussi que les fabricants de cigarettes en avaient connaissance. Pourtant, ils l’ont publiquement nié.
Cette situation a donné lieu à des procédures judiciaires longues et très médiatisées, qui se sont soldées par d’importantes indemnisations financières ainsi que par de profondes réformes du secteur. Parmi elles figurent l’introduction des paquets de cigarettes neutres et l’apposition de messages d’avertissement particulièrement explicites sur les produits du tabac.
Les jeux d’argent semblent aujourd’hui suivre une trajectoire comparable. Quant aux réseaux sociaux, ils pourraient être en train d’entrer, eux aussi, dans une phase similaire.
Une question centrale est de savoir si les fabricants d’un produit (qu’il s’agisse du tabac, des jeux d’argent ou des réseaux sociaux) ont connaissance de son potentiel addictif. Une autre interrogation importante est de déterminer si certaines entreprises exploitent délibérément les propriétés potentiellement addictives de leurs produits pour en tirer un avantage commercial. L’IA n’est évidemment pas le tabac, mais ces précédents offrent des parallèles qui méritent d’être étudiés.
Dans nos travaux, nous avons identifié quatre catégories d’acteurs aujourd’hui appelées à répondre aux défis que pose la possibilité d’une addiction à l’IA générative. Le premier groupe est celui des gouvernements et des autorités de régulation. Ils ont un rôle essentiel à jouer pour mettre en lumière les problèmes, définir les règles du jeu et créer des incitations afin que les autres acteurs s’emparent eux aussi de cette question.
Ils disposent pour cela de nombreux leviers : imposer un étiquetage, encadrer la publicité, engager la responsabilité juridique des entreprises, financer la recherche, ainsi que de nombreuses autres mesures. Mais les acteurs les plus déterminants pour répondre aux comportements potentiellement addictifs liés à l’IA générative sont sans doute les grandes entreprises technologiques qui développent et possèdent ces technologies – et qui en tirent des bénéfices financiers.
Ces entreprises détiennent et ont accès aux données des utilisateurs, indispensables pour identifier les fonctionnalités qui favorisent ou, au contraire, limitent les comportements addictifs. Ce sont également elles qui peuvent tirer un avantage financier d’une éventuelle addiction, en augmentant le nombre d’utilisateurs et le temps qu’ils consacrent à leurs services, deux ressources essentielles de l’économie numérique.
Aux côtés de ces deux premiers groupes, les chercheurs ont un rôle crucial à jouer. Ils sont chargés de recueillir et d’interpréter les données, ainsi que de produire les preuves scientifiques nécessaires pour identifier les phénomènes d’addiction et les caractéristiques qui les favorisent, afin d’alimenter un débat politique et juridique fondé sur des éléments factuels.
Enfin, les organisations de la société civile, comme les associations d’usagers ou de patients, peuvent contribuer en apportant un soutien aux personnes concernées, en défendant leurs intérêts et en mettant en place des dispositifs d’alerte précoce. L’enjeu est que nul ne peut relever ce défi seul. Tous ces acteurs devront travailler ensemble.
Le problème, c’est toujours celui des autres
Aujourd’hui, l’un des principaux obstacles est l’absence d’un véritable débat structuré sur les responsabilités : chacun considère que le problème relève de quelqu’un d’autre. Pourtant, de nombreux précédents montrent qu’il est possible d’obtenir une mobilisation plus forte de l’ensemble des acteurs concernés.
Dans le cas du tabac, l’Organisation mondiale de la santé (OMS) a mis en place la Convention-cadre pour la lutte antitabac, un traité international réunissant gouvernements, autorités de santé publique, chercheurs et organisations de la société civile afin d’évaluer les preuves scientifiques et d’élaborer des règles communes. De la même manière, l’International AI Safety Report montre que des initiatives internationales visant à construire un consensus existent déjà sur d’autres enjeux liés à l’IA.
Une part de responsabilité incombe également aux utilisateurs de l’IA, qui doivent s’efforcer d’éviter ou de maîtriser les comportements susceptibles de leur être préjudiciables. Mais l’expérience acquise avec d’autres formes d’addiction montre que les appels à la modération ou à la vigilance individuelle ne suffisent pas.
Si les effets nocifs du tabac ou de l’abus d’alcool sont aujourd’hui bien connus, nos sociétés continuent de s’appuyer sur des limites d’âge, des règles d’étiquetage et des restrictions publicitaires. L’IA générative est en train de s’intégrer au tissu même de notre quotidien. Les décisions que nous prenons aujourd’hui façonneront ce qui sera considéré comme un usage acceptable pour les années à venir.
Bernd Stahl ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’essentiel
La désinformation en santé n’est pas un phénomène nouveau, mais les crises sanitaires successives, de l’affaire du sang contaminé à la pandémie de Covid-19, ont contribué à en accroître la visibilité.
Les réseaux sociaux ont amplifié la circulation de la désinformation en santé tandis que les IA conversationnelles redéfinissent les pratiques d’accès à l’information.
Le gouvernement français a émis des recommandations pour former les citoyens
La désinformation en santé n’est pas un phénomène nouveau, mais les crises sanitaires successives, de l’affaire du sang contaminé à la pandémie de Covid-19, ont contribué à en accroître la visibilité.
Les réseaux sociaux ont amplifié la circulation de la désinformation en santé tandis que les IA conversationnelles redéfinissent les pratiques d’accès à l’information.
Le gouvernement français a émis des recommandations pour former les citoyens à démêler le vrai du faux dans ce nouvel écosystème informationnel complexe.
À l’heure où les fausses informations circulent plus vite que les savoirs établis, le dialogue entre science et société semble fragilisé. Méfiance envers les experts, controverses amplifiées par les réseaux sociaux, brouillage des repères… comment rétablir une discussion constructive fondée sur les faits, sans nier les doutes et les questionnements citoyens ?
Loin d’être cantonnée aux sphères politiques, la désinformation se répand largement dans le domaine de la santé. Informations erronées sur les vaccins, thérapies alternatives ou régimes miracles prolifèrent dans un espace numérique où les frontières entre savoirs légitimes et opinions infondées sont floues.
Cette défiance s’inscrit dans les fractures sociales et politiques contemporaines où les divisions sociales, politiques et économiques sont prononcées. Dans une société fragmentée, la désinformation trouve un public particulièrement réceptif au sein de groupes déjà enclins à se méfier des institutions.
Défiance et information en santé à l’ère numérique
Les travaux de la Fondation Descartes montrent que les personnes qui s’informent surtout par l’intermédiaire d’Internet et des réseaux sociaux ont un niveau de connaissances en santé plus faible, une confiance moindre envers la science, la médecine et les institutions, et une sensibilité plus forte aux croyances, aux thérapies alternatives et à l’ésotérisme.
Ce contexte constitue un véritable écosystème informationnel de défiance, au sein duquel les fausses informations circulent plus facilement et peuvent encourager des comportements à risque. La désinformation en santé est même devenue récemment une démarche politique aux États-Unis dans le cadre du mouvement MAHA (pour Make America Healthy Again, en français « Que l’Amérique soit de nouveau en bonne santé ») qui bourgeonne également en Europe.
Ainsi, la désinformation en santé n’est pas seulement un problème de communication, mais aussi un enjeu de gouvernance démocratique. Une démocratie repose, en effet, sur la capacité des citoyens à prendre des décisions éclairées. Or, une information biaisée ou mensongère altère cette rationalité collective.
Une nouvelle étape dans la lutte contre la désinformation en santé
Le premier concerne l’écoute et la participation citoyenne. Le rapport des assises citoyennes numériques en santé, tout juste publié, dresse le constat d’une mésinformation massive et rappelle que, en matière de santé, protéger l’information, c’est protéger les Français. Il recommande de rendre l’information visible, lisible, pertinente et accessible au bon moment pour les bonnes personnes, et de faire évoluer en conséquence le cadre réglementaire. À ce propos, des sanctions vis-à-vis des désinformateurs existent déjà. Mais leur application semble difficile.
Le deuxième axe concerne la création d’un observatoire de la désinformation en santé qui devra assurer veille, analyse et alerte en lien avec le troisième axe du dispositif, l’« info-vigilance ».
Le dernier axe du plan, « bâtir un socle de confiance propice à l’information en santé », vise à responsabiliser les plateformes numériques et à renforcer l’éducation critique à la santé dès l’école, notamment au moyen des kits pédagogiques conçus avec le Centre pour l’éducation aux médias et à l’information (Clemi).
Pour réussir, la stratégie devra sortir des formats institutionnels traditionnels et trouver des relais crédibles auprès des communautés sceptiques, sans tomber dans une posture moralisatrice qui aggraverait encore la fracture. Le succès du plan dépendra de sa capacité à restaurer la confiance et à toucher tous les publics. La stratégie française s’inscrit à la fois dans la perspective européenne, en continuité du rapport sur la santé publique à l’âge de la mésinformation, et dans le cadre des recommandations internationales.
Dans ce contexte l’Organisation mondiale de la santé (OMS) insiste d’ailleurs depuis plusieurs années sur la nécessité de développer la littératie en santé, c’est-à-dire la capacité des individus à comprendre, évaluer et utiliser l’information médicale pour faire des choix éclairés.
Un point tout aussi important concerne l’accès aux soins. La désinformation et le recours aux thérapies alternatives touchent davantage les « déserts médicaux », où il est difficile de consulter un médecin traitant – pourtant considéré parmi les sources les plus crédibles.
Cette approche met en lumière une idée clé : lutter contre la désinformation, ce n’est pas seulement corriger les fausses nouvelles. Il s’agit aussi d’outiller intellectuellement les citoyens pour qu’ils puissent s’orienter dans un écosystème informationnel complexe.
L’angle mort : les IA conversationnelles et les usages citoyens
Le rapport du ministère mérite d’être salué, notamment pour sa volonté de renforcer la confiance collective. Mais une question se pose : quelle place accorder aux IA conversationnelles en santé, d’autant que les outils et les usages se multiplient à l’international comme en France ?
Le rapport prévoit des formations à l’IA générative pour les journalistes et son intégration sur Sante.fr, mais passe à côté des citoyens – pourtant les principaux concernés – et des professionnels de santé. Ce choix surprend d’autant plus que l’usage de ces outils et la confiance qu’ils suscitent semblent déjà bien ancrés.
Ainsi, 62 % des médecins généralistes auraient recours ponctuellement à ChatGPT dans leur pratique et 45 % des Français seraient en accord avec cet usage. Mais ces estimations sont à prendre avec prudence puisqu’elles émanent d’acteurs eux-mêmes investis dans l’IA.
Le premier se concentre sur une assistance conversationnelle personnalisée pour accompagner les individus dans la compréhension de leurs données de santé, leurs résultats d’examen et la préparation de consultations. Anthropic mise, quant à lui, sur l’intégration des outils dans les écosystèmes professionnels et de recherche. Tous les géants du Web proposent déjà des solutions, sans oublier les licornes françaises, comme Mistral et Doctolib. Quelle sera leur acceptabilité respective dans l’avenir ?
Cette situation soulève donc plusieurs interrogations majeures vis-à-vis d’un accès responsable à l’information médicale et en santé : comment les utilisateurs vont-ils s’approprier les outils ? Jusqu’où un assistant conversationnel peut‑il accompagner les patients dans le diagnostic médical ? Quelles formations pour les médecins ?
Intégrer ce type de réflexion dans la stratégie nationale permettrait d’orienter les citoyens vers des usages plus responsables de ces outils.
Karen Nuvoli est membre du SFSIC (Société Française des Sciences de l’Information & de la Communication).
Gilbert Faure est fondateur et animateur du réseau HESIVAXs.
La souveraineté numérique est devenue un objectif central de la politique européenne. Au-delà de l’intelligence artificielle, des semi-conducteurs et du cloud computing, ou « informatique dématérialisée », le débat s’étend désormais à l’une des catégories d’information les plus sensibles détenues par les gouvernements : les données de santé, qui sont collectées par les hôpitaux, l’assurance-maladie, les laboratoires d’analyses médicales et les institutions publiques.
Pour mieux anticiper les ri
La souveraineté numérique est devenue un objectif central de la politique européenne. Au-delà de l’intelligence artificielle, des semi-conducteurs et du cloud computing, ou « informatique dématérialisée », le débat s’étend désormais à l’une des catégories d’information les plus sensibles détenues par les gouvernements : les données de santé, qui sont collectées par les hôpitaux, l’assurance-maladie, les laboratoires d’analyses médicales et les institutions publiques.
Pour mieux anticiper les risques de santé publique, suivre les épidémies, allouer les ressources, l’Union européenne a adopté la création d’un Espace européen des données de santé, qui entrera en application de manière différée à partir de mars 2027 et qui soulève de nombreuses questions de gouvernance, bien au-delà de la protection de la vie privée.
Avec son Espace européen des données de santé (EEDS), l’Union européenne (UE) est confrontée à un défi de taille : comment exploiter la valeur scientifique et économique des données de santé, tout en garantissant la sécurité de l’infrastructure qui les héberge et son alignement sur les intérêts et les valeurs européennes ?
L’expérience française, avec le Health Data Hub (HDH), montre que la gouvernance des données de santé ne se limite plus à la protection de la vie privée ou à la cybersécurité. Elle concerne également l’infrastructure, la souveraineté et le contrôle démocratique.
À mesure que l’EEDS passe de la législation à la mise en œuvre, l’UE devra décider si la souveraineté numérique est simplement une ambition politique ou un principe qui façonne véritablement son avenir numérique.
Le potentiel des données de santé
Les données de santé sont de plus en plus reconnues comme une ressource stratégique pour les systèmes de santé, les institutions de recherche et les décideurs politiques.
Leur analyse à grande échelle permet de dégager des connaissances qui améliorent la prévention des maladies, favorisent des traitements plus efficaces et renforcent la prise de décision en matière de santé publique.
Les avantages potentiels dépassent le cadre de la recherche scientifique. Les données de santé peuvent aider les gouvernements à anticiper les risques pour la santé publique, à évaluer les politiques de santé et à allouer les ressources plus efficacement. La pandémie de Covid-19 a démontré l’importance d’un accès rapide à l’information sanitaire pour surveiller les épidémies et orienter les réponses de santé publique.
Le défi consiste non seulement à exploiter les avantages des données de santé, mais aussi à garantir que les systèmes qui gèrent ces données restent fiables et conformes à l’intérêt public.
Le Health Data Hub et le débat sur la souveraineté
Lancé en 2019 en France, le Health Data Hub a été conçu pour centraliser l’accès aux données de santé à des fins de recherche, d’innovation et de politiques publiques. Cette initiative visait à résoudre un problème persistant : la fragmentation des informations de santé, entre hôpitaux, assurance-maladie, laboratoires, assurances et institutions publiques, limitait la recherche à grande échelle et la prise de décision fondée sur les données.
La plateforme permet aux chercheurs et aux institutions publiques agréés d’accéder aux ensembles de données de santé et de les analyser dans un cadre réglementé. Les données sont pseudonymisées avant utilisation (pour éviter la réidentification des patients) et les demandes d’accès sont soumises à des procédures de contrôle. L’objectif est de faciliter la recherche médicale, la surveillance épidémiologique et l’innovation dans le secteur de la santé, tout en garantissant la protection de la vie privée.
Pour déployer rapidement la plateforme, le gouvernement français a initialement choisi Microsoft Azure comme fournisseur de services cloud. Cette décision a immédiatement suscité la controverse. Les critiques ont fait valoir que l’hébergement de données de santé sensibles chez une entreprise états-unienne pourrait exposer les informations des citoyens européens à des demandes d’accès en vertu de la législation des États-Unis, notamment du Clarifying Lawful Overseas Use of Data Act (dit CLOUD Act) . Les inquiétudes se sont accrues après l’arrêt Schrems II de 2020 portant sur l’encadrement des transferts de données à destination des États-Unis, qui a soulevé des questions quant à la protection des données européennes traitées par des entreprises américaines.
La controverse ne portait pas uniquement sur la localisation des serveurs. Les fournisseurs de services cloud gèrent des infrastructures critiques, notamment le stockage, le chiffrement, les environnements informatiques et les contrôles d’accès. Bien que les données du Health Data Hub soient hébergées en Europe, les critiques ont soutenu que la dépendance à l’égard d’un fournisseur non européen créait des vulnérabilités juridiques et stratégiques que les seules mesures techniques ne pouvaient éliminer.
Le débat est rapidement devenu le symbole d’une préoccupation européenne plus large : les infrastructures numériques stratégiques doivent-elles rester dépendantes de fournisseurs de technologies étrangers ?
Du Health Data Hub à l’Espace européen des données de santé
L’Espace européen des données de santé vise (EEDS) à étendre la logique du Health Data Hub (HDH) à l’ensemble de l’Union européenne. Il a pour objectif de faciliter l’utilisation des données de santé pour les soins aux patients ainsi que leur utilisation secondaire à des fins de recherche, d’innovation et d’élaboration de politiques publiques.
Concrètement, ce cadre devrait simplifier l’accès et le partage des dossiers médicaux électroniques entre les États membres, tout en permettant aux chercheurs et aux institutions publiques de travailler avec de vastes ensembles de données transfrontalières sous des règles de gouvernance communes. Les décideurs européens considèrent l’EEDS comme un élément clé de la stratégie numérique de l’UE et un outil pour renforcer la compétitivité dans les domaines de l’intelligence artificielle et des biotechnologies.
À bien des égards, le Health Data Hub peut être considéré comme un précurseur de ce modèle. Les deux initiatives reposent sur le constat que la fragmentation des données limite l’innovation et les capacités de santé publique. Toutes deux s’appuient sur le partage sécurisé d’informations médicales sensibles. Et toutes deux soulèvent des questions de gouvernance, de confiance et de souveraineté.
Les défis à venir
L’expérience française met en lumière les défis que l’Espace européen des données de santé devra relever à l’échelle européenne.
Premièrement, l’Europe reste fortement dépendante d’un petit nombre de fournisseurs de services cloud non européens. Même lorsque les données sont stockées en Europe, des inquiétudes persistent quant à leur accès extraterritorial dans le cadre de législations étrangères.
Antoine Boutet reçoit des financements du Projet Interdisciplinaire sur la Vie Privée (IPoP) du PEPR Cybersécurité (ANR-22-PECY-0002).
Pankaj Raj reçoit des financements de MIAI @ Grenoble Alpes (ANR-23-IACL-0006) et du Projet Interdisciplinaire sur la Vie Privée (IPoP) du PEPR Cybersécurité (ANR-22-PECY-0002).
Hâtivement présentée comme une prise de position contre l’intelligence artificielle, l’encyclique (lettre solennelle du pape adressée à l’ensemble de l’Église catholique) « Magnifica Humanitas » de Léon XIV, publiée en mai 2026, s’inscrit dans une longue tradition de réflexion catholique sur le sens à donner au travail humain. De cette façon, elle revient aussi sur la place à donner à la technique.
Alors que la publication récente de l’encyclique « Magnifica Humanitas » (mai 2026) intervient
Hâtivement présentée comme une prise de position contre l’intelligence artificielle, l’encyclique (lettre solennelle du pape adressée à l’ensemble de l’Église catholique) « Magnifica Humanitas » de Léon XIV, publiée en mai 2026, s’inscrit dans une longue tradition de réflexion catholique sur le sens à donner au travail humain. De cette façon, elle revient aussi sur la place à donner à la technique.
Alors que la publication récente de l’encyclique « Magnifica Humanitas » (mai 2026) intervient au moment où l’intelligence artificielle nourrit promesses et inquiétudes, le texte opère un recadrage inattendu, voire inespéré. L’intelligence artificielle nous aidera probablement à produire plus vite. Mais produira-t-elle encore des travailleurs ?
Derrière les promesses de gains de productivité et d’automatisation, une question au moins : que devient le travail lorsque certaines activités intellectuelles qui le constituaient sont progressivement confiées à des systèmes artificiels ?
Travailler ne consiste pas uniquement à obtenir un résultat ; c’est aussi une expérience qui façonne notre jugement, notre autonomie et nos relations aux autres, mais aussi au monde.
Une question ancienne derrière une révolution nouvelle
Les débats sur l’intelligence artificielle sont généralement formulés dans les termes de la performance : quelles tâches pourraient être automatisées ? Quels gains de productivité peut-on espérer ? Comment intégrer l’IA dans le business pour l’optimiser ? Depuis deux siècles d’ailleurs, les innovations techniques sont principalement pensées à travers leurs effets sur l’organisation et l’efficacité de la production.
Or, l’histoire des transformations du travail montre aussi une succession de déplacements techniques qui ont progressivement modifié les conditions de l’activité humaine. Le XIXᵉ siècle a été marqué par la mécanisation des gestes ; le XXᵉ siècle par leur rationalisation. Le XXIᵉ siècle semble désormais engagé dans une automatisation partielle des opérations cognitives elles-mêmes.
Une unique représentation du travail à travers les siècles
Derrière cette continuité historique, une constante : chaque révolution technique tend à réactiver une même représentation du travail, réduit à sa seule fonction productive. Et plus encore, par cette réduction, l’intensifier encore, lui ajouter des couches et des strates, qui nous le rendent invisible et lointain.
De même, la démultiplication des possibilités techniques a ajouté à cette fonction productive une condition de la production : l’accélération, à tel point que célérité et instantanéité de la production sont devenues des maîtres mots dans le modèle capitaliste.
Une question fondamentale reste dans l’ombre : qu’est-ce que travailler veut dire et signifie de notre humanité ?
Sortir d’une vision restrictive du travail : une vieille histoire
Cette interrogation n’est pourtant pas nouvelle pour l’Église qui a mis historiquement des conditions au déploiement de la technique. Dès la fin du XIXe siècle, alors que la révolution industrielle bouleverse les rapports sociaux, « Rerum novarum » définissait le travail comme « l’entretien de la vie elle-même », de telle sorte qu’il participe aux conditions mêmes de l’existence humaine, qui ne sont pas seulement économiques.
Quelques décennies plus tard, « Laborem exercens » nuançait cette réflexion face aux transformations technologiques du XXᵉ siècle indiquant que « la technique est indubitablement une alliée de l’homme », mais aussi que « comme sujet du travail, et quel que soit le travail qu’il accomplit, l’homme, et lui seul, est une personne ».
À rebours d’un Aristote qui considérait le travail comme avilissant ou du plus récent Paul Lafargue et son Droit à la paresse, l’encyclique nouvellement parue postule que « le travail n’est pas un simple instrument, mais [qu’] il exprime et renforce la dignité de notre vie ». L’intelligence artificielle, en automatisant une part de la vie humaine, favorise-t-elle la dignité de l’humanité ?
Ce que l’IA fait au travail lui-même
Nous l’avons dit, les « bénéfices » présentés de l’IA sont nombreux : alléger certaines tâches répétitives, accélérer le traitement des informations ou faciliter certaines prises de décision. Certainement d’ailleurs, l’IA a pu émanciper ou sortir de l’aliénation du travail certains travailleurs.
Mais l’enjeu ne concerne plus uniquement l’automatisation de certaines tâches matérielles ; il touche désormais des activités traditionnellement associées au travail intellectuel : écrire, analyser, sélectionner, synthétiser ou interpréter. Mais une interrogation persiste : que devient le travail lorsque l’individu délègue progressivement une partie de l’activité cognitive qui contribuait jusqu’alors à sa propre construction ?
Le travail s’entend, d’un point de vue sémantique, de deux manières. La première acception est celle de l’accouchement (on parle en maternité de « salle de travail », de « déclenchement du travail », etc.). La seconde réside dans l’activité réalisée en vue de subvenir, principalement, aux nécessités vitales. Dans les deux cas, c’est la vie humaine qui est centrale, comme si le terme même de travail était indissociable d’une part de la nature humaine, et donc des activités et des tâches de l’être humain.
Le risque d’une substitution des actions humaines par celles de l’IA ne réside probablement pas seulement dans une substitution des tâches humaines par des systèmes techniques, car il concerne également les effets anthropologiques plus discrets susceptibles d’accompagner cette délégation.
La pertinence n’est pas une question de probabilité
Travailler ne consiste pas uniquement à atteindre un objectif. Le travail participe aussi à la formation du jugement, à l’apprentissage, à la socialisation et au développement d’une autonomie individuelle. Or les modèles actuels d’intelligence artificielle reposent largement sur des mécanismes statistiques et probabilistes. Leur efficacité provient de leur capacité à identifier des régularités et à produire des réponses plausibles à partir d’immenses volumes de données.
Mais cette logique comporte une limite : ce qui apparaît comme pertinent correspond souvent à ce qui est le plus probable. Cela conduit irrémédiablement à confondre le probable et le vrai, le possible et le réel. Aux questions, « Quel salaire vais-je toucher à la fin du mois ? », ou à celle « Comment dois-je accomplir cette tâche ? », ou encore « Avec quelle personne dois-je collaborer pour atteindre le résultat attendu ? », le travailleur n’attend pas une réponse statistique ou probable… mais bien la réalité du revenu qu’il va percevoir, la méthode ou le processus, le nom de la personne concernée. Il en est de même pour toute interrogation : le probable ne saurait se substituer au caractère certain d’une réponse.
Le risque n’est donc pas seulement celui de l’erreur. Il pourrait être celui d’une uniformisation progressive des pratiques et des raisonnements, où l’efficacité immédiate l’emporte sur l’interprétation, la créativité ou l’exercice du jugement, où la réponse médiane et relative l’emporte sur l’attraction vers la certitude.
Que voulons-nous encore que le travail fasse de nous ?
L’enjeu n’est pas de condamner la technique ni d’opposer a priori l’humain et l’intelligence artificielle. L’histoire montre au contraire que les innovations peuvent constituer des facteurs puissants d’émancipation. La question est aussi ailleurs, et participe d’un regard éthique (et donc critique) sur l’IA : quelles dimensions du travail souhaitons-nous préserver ?
Cette interrogation concerne notamment et, à titre d’exemple, le monde de l’enseignement. Si certaines compétences techniques deviennent partiellement automatisables, la fonction pédagogique pourrait progressivement se déplacer vers ce qui demeure difficilement substituable : former le jugement, développer l’esprit critique, donner du sens aux connaissances et inscrire les apprentissages dans une compréhension plus large des réalités humaines et sociales.
Babel ou Jérusalem ?
Les débats contemporains sur l’intelligence artificielle portent principalement sur ce que les machines pourront faire demain. Une question plus fondamentale demeure pourtant ouverte : au-delà de ce que nous demanderons aux machines, que voulons-nous encore que le travail fasse de nous ?
Dans « Magnifica Humanitas », Léon XIV mobilise deux figures bibliques que sont Babel et Jérusalem, comme grille de lecture des transformations contemporaines liées à l’intelligence artificielle. Plus qu’une opposition religieuse, elles représentent deux manières d’envisager l’organisation de la vie collective et, par extension, du travail lui-même. Le texte précise ainsi que « le premier choix ne se situe pas entre un “oui” ou un “non” à la technologie, mais entre bâtir Babel ou reconstruire Jérusalem ».
La première renvoie à une logique de Babel : recherche d’une efficacité absolue, uniformisation des pratiques, concentration croissante des capacités de décision et logique de puissance. Comme l’écrit l’encyclique, Babel est une œuvre « soutenue par une uniformité qui élimine la diversité » et qui « sacrifie la dignité des personnes à l’efficacité ». Dans cette perspective, la valeur du travail tend à se mesurer essentiellement à sa vitesse, sa quantité ou sa performance. Dans le récit biblique, la verticalité de la tour de Babel apporte finalement l’horizontalité de l’humanité en répartissant celle-ci sur toute la terre.
Le Huff Post 2026.
À l’inverse, Jérusalem, dans la Bible, apparaît comme une œuvre collective fondée sur une responsabilité partagée. L’encyclique décrit une reconstruction du travail qui naît « non pas grâce à l’initiative d’une seule personne, mais grâce à la responsabilité partagée de tout le peuple ». Le travail n’y est pas envisagé uniquement comme une production de résultats, mais comme une activité par laquelle les individus se construisent eux-mêmes avec les autres. La signification est alors aux antipodes de celle portée par Babel : l’humanité se verticalise en unifiant toutes les personnes qui la composent.
Et maintenant ?
L’encyclique souligne encore que l’intelligence artificielle « n’est pas neutre, car elle prend le visage de ceux qui la conçoivent, la financent, la régulent et l’utilisent ». Reste que le texte, bien qu’affirmant l’absence de neutralité de cette technologie et, conséquemment, les implications de celle-ci dans le monde du travail, ne se positionne pas sur cette neutralité et laisse le monde du travail dans un certain embarras.
Si l’intelligence artificielle devait devenir encore davantage un outil central de l’activité professionnelle, plusieurs questions concrètes – auxquelles l’encyclique ne répond pas – apparaissent alors comme autant de garde-fous possibles : comment préserver des espaces réels d’exercice du jugement ? Comment maintenir une autonomie autre que purement formelle ? Comment protéger les relations humaines au travail lorsque certaines interactions deviennent médiées par des systèmes techniques ? Comment permettre encore l’expérience de l’apprentissage, de l’incertitude et du sens ? En quoi ce que nous favorisons pour ces objectifs de production, aura de conséquences sur ce que nous sommes et devenons en dehors ?
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
Les systèmes algorithmiques nécessitent une supervision humaine continue. Les « hallucinations » ou erreurs, peuvent totalement annuler les gains de temps annoncés pour les tribunaux. Oleg TroinoAu Royaume-Uni, des directives suggèrent que les juges pourraient utiliser l’IA pour des travaux préparatoires. L’Estonie utilise un système d’IA semi-automatisé pour les recouvrement de petites créances. En Allemagne, un système est testé pour des litiges relatifs aux droits des passag
Les systèmes algorithmiques nécessitent une supervision humaine continue. Les « hallucinations » ou erreurs, peuvent totalement annuler les gains de temps annoncés pour les tribunaux.Oleg Troino
Au Royaume-Uni, des directives suggèrent que les juges pourraient utiliser l’IA pour des travaux préparatoires. L’Estonie utilise un système d’IA semi-automatisé pour les recouvrement de petites créances. En Allemagne, un système est testé pour des litiges relatifs aux droits des passagers aériens. À Taïwan, l’IA aide les tribunaux dans des affaires de conduite en état d’ivresse ou de fraudes. Pourtant, les arguments en défaveur d’une utilisation de l’IA par la justice sont nombreux et doivent être pris en considération.
En quelques années seulement, l’intelligence artificielle générative a entraîné des changements significatifs dans de nombreux secteurs, de la santé à l’éducation, du divertissement à la finance, et même dans le domaine du droit.
L’utilisation de l’IA dans les décisions judiciaires pose des risques importants pour la justice. Des résultats erronés issus d’informations « hallucinées », des décisions discriminatoires et un manque de transparence font partie des préoccupations liées à l’introduction de cette technologie dans les tribunaux.
Pourtant, un certain nombre de juges à travers le monde l’ont déjà utilisée dans la prise de décision et la rédaction de jugements. C’est pourquoi certaines juridictions, dont le Royaume-Uni, ont publié des lignes directrices à l’intention des juges concernant l’usage de l’IA.
De manière générale, ces directives suggèrent que les juges peuvent utiliser l’IA comme un outil pour effectuer des travaux préparatoires, tels que la rédaction de résumés de documents longs, la traduction de documents juridiques, l’identification de précédents juridiques ou l’amélioration de la lisibilité des documents. Elles déconseillent son utilisation pour les fonctions judiciaires essentielles, notamment la prise de décision.
Récemment, certains hauts responsables judiciaires ont estimé que l’IA pourrait être utilisée pour trancher des affaires « à faible enjeu » ou moins complexes, à condition de prendre des précautions adéquates, comme maintenir un juge humain dans le processus.
Dans un discours prononcé en novembre 2024, le deuxième juge le plus haut placé du Royaume-Uni, Geoffrey Vos, a évoqué un « spectre » de décisions juridiques que l’IA pourrait bientôt prendre, ou contribuer à prendre.
Vos a déclaré que l’utilisation de l’IA pour des « décisions largement mécaniques, comme celles concernant le montant d’une pension ou de prestations, ou le calcul des dommages corporels et des pertes de revenus » permettrait probablement d’économiser du temps et de l’argent. Mais il a appelé à une réflexion sur la question de savoir si une telle utilisation violerait des droits humains fondamentaux.
Un an plus tard, Vos a de nouveau appelé à un « débat sérieux » sur les droits qui devraient être protégés pour les humains dans ce contexte. Il a également insisté sur le fait que l’IA devait être « utilisée de manière responsable, efficace et sûre dans les systèmes et processus juridiques ».
Plusieurs juridictions testent ou utilisent déjà l’IA dans ce type d’affaires « mécaniques ». L’Estonie utilise un système de petites créances semi-automatisé dans les procédures civiles pour des demandes pécuniaires allant jusqu’à 7 000 euros, avec des greffiers humains supervisant le processus.
Le tribunal de district de Francfort, en Allemagne, a testé un système d’IA nommé Frauke pour traiter les litiges relatifs aux droits des passagers aériens. Frauke analyse des affaires et décisions antérieures afin de produire des projets de jugements préconfigurés. Les juges assemblent ensuite les verdicts finaux à partir de ces textes après avoir statué, ce qui réduit considérablement le temps consacré à la rédaction.
Taïwan a expérimenté un outil basé sur l’IA pour aider les tribunaux, notamment en produisant des notifications de décision dans des affaires de conduite en état d’ivresse ou de complicité dans des fraudes. Le système d’IA génère un projet complet de décision comprenant les faits, le raisonnement juridique, les citations et le verdict final. Le juge examine ce projet et, après approbation, peut l’émettre comme jugement officiel, avec ou sans modifications.
Ces exemples montrent clairement que la principale motivation pour remplacer les juges humains dans certaines catégories d’affaires est l’efficacité. Par conséquent, d’autres juridictions explorent également la possibilité d’intégrer l’IA générative afin de statuer sur certains litiges sans intervention de juges humains.
Le coût de l’utilisation de l’IA générative comme juge
Les tribunaux sont surchargés, et des technologies comme l’IA générative promettent cohérence et efficacité. Mais cela représenterait un changement majeur par rapport à des pratiques vieilles de plusieurs siècles. Et cela risque de saper ce que certains juristes considèrent comme un principe fondamental de la justice : le droit d’être jugé par un être humain.
Le jugement d’une affaire ne consiste pas uniquement à parvenir à une décision. Il s’agit d’un processus global et équitable qui inclut le droit d’être entendu – présenter sa défense, mettre en balance des récits contradictoires et exercer un jugement à la lumière du droit et de l’équité.
Les outils algorithmiques, aussi avancés soient-ils, n’entendent ni ne « comprennent » même pas leurs propres productions, encore moins les valeurs humaines ou les contextes sociaux changeants. L’IA générative ne peut pas reconnaître la souffrance, la crédibilité, le remords ou la vulnérabilité comme le ferait un humain. Cela seul la rend inapte à occuper le siège d’un juge.
Classer les affaires comme simples ou complexes peut sembler pragmatique, mais c’est à la fois juridiquement et moralement dangereux. Ce qui constitue une affaire « simple, routinière ou mécanique » est en soi une décision humaine. Les litiges relatifs à des indemnisations ou à des prestations peuvent paraître simples sur le papier, mais elles peuvent avoir des conséquences importantes pour la personne qui saisit la justice.
Attribuer ces affaires à une adjudication algorithmique risque de créer un système judiciaire à deux vitesses – dans lequel un groupe de citoyens peut présenter son affaire devant un juge humain, tandis que d’autres sont traités par des machines. Seuls les premiers, à mon sens, exercent pleinement leur droit à une audience et à un procès équitables devant un tribunal indépendant et impartial, tel que garanti par l’article 6 de la Convention européenne des droits de l’homme.
De plus, l’argument de l’efficacité pourrait s’avérer illusoire. Les systèmes algorithmiques comme l’IA générative nécessitent une supervision humaine continue, des audits et des corrections. Les hallucinations ou erreurs, qu’elles résultent d’une conception défaillante ou de données d’entraînement biaisées, peuvent totalement annuler les bénéfices annoncés.
La confiance du public est essentielle dans tout système juridique. Si les citoyens perdent confiance dans les décisions automatisées, les recours augmenteront – aggravant encore l’arriéré déjà existant des affaires.
Les technologies émergentes comme l’IA générative peuvent être utiles pour gérer l’administration des tribunaux et réduire les charges administratives. Mais remplacer les juges humains, même dans des affaires supposément à faible enjeu, porte atteinte aux principes fondamentaux de la justice. L’efficacité ne devrait pas se faire au détriment des valeurs que le système judiciaire est censé protéger.
Raisul Islam Sourav ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’intelligence artificielle ouvre de nouvelles possibilités pour documenter et planifier l’inclusivité urbaine. Mais peut‑elle vraiment y contribuer sans écraser ce que vivent les gens derrière des modèles qui transforment nos rues en simples scores sur une carte ?
Une ville se comprend souvent à hauteur de trottoir. Un banc bien placé, un passage piéton lisible, un éclairage rassurant, une rampe d’accès, un coin d’ombre ou un arrêt d’autobus protégé peuvent transformer l’expérience quotidien
L’intelligence artificielle ouvre de nouvelles possibilités pour documenter et planifier l’inclusivité urbaine. Mais peut‑elle vraiment y contribuer sans écraser ce que vivent les gens derrière des modèles qui transforment nos rues en simples scores sur une carte ?
Une ville se comprend souvent à hauteur de trottoir. Un banc bien placé, un passage piéton lisible, un éclairage rassurant, une rampe d’accès, un coin d’ombre ou un arrêt d’autobus protégé peuvent transformer l’expérience quotidienne d’un lieu. À l’inverse, une bordure trop haute, une rue hostile, un parc mal entretenu ou une place où l’on ne se sent pas bienvenu peuvent exclure, parfois sans bruit. Le problème n’est donc pas de demander à l’IA de juger la ville à la place des citoyens, mais de savoir comment l’utiliser pour rendre visibles des formes d’exclusion que les outils classiques détectent mal.
Les espaces publics comme les rues, parcs, places, marchés, bibliothèques et promenades comptent parmi les infrastructures collectives les plus importantes des villes. D’ailleurs, ils occupent environ le tiers du territoire urbain à l’échelle mondiale. Leur valeur n’est pas seulement esthétique. Bien conçus et bien entretenus, ils soutiennent la vie sociale, l’activité économique, la santé, la mobilité et la capacité des citoyens à se rencontrer.
Mais il ne suffit pas qu’un lieu soit officiellement « ouvert à tous » pour qu’il soit réellement accessible, accueillant et sûr pour chacun. Les femmes, les enfants, les personnes âgées, les personnes en situation de handicap, les nouveaux arrivants, les personnes racisées, les personnes pauvres ou celles qui ne maîtrisent pas les codes implicites d’un quartier peuvent vivre la même rue de façons très différentes, notamment selon l’âge, le genre ou le handicap. Ce qui paraît neutre dans un plan d’aménagement peut devenir, dans la vie réelle, une source d’inconfort, de peur, d’évitement ou d’exclusion.
C’est là que l’IA peut devenir utile, non comme solution magique, mais comme outil de diagnostic. Ancrée dans les réalités locales et nourrie par l’expérience des communautés, elle peut aider les villes à mieux voir ce que leurs méthodes classiques laissent dans l’ombre, sans remplacer le jugement humain ni la décision démocratique.
Cet article fait partie de notre série Nos villes d’hier à demain. Le tissu urbain connaît de multiples mutations, avec chacune ses implications culturelles, économiques, sociales et politiques. Pour éclairer ces divers enjeux, The Conversation invite les chercheuses et chercheurs à aborder l’actualité de nos villes.
Pourquoi l’inclusion urbaine ne peut pas rester un idéal abstrait
L’inclusion est devenue un mot central des politiques urbaines. L’objectif 11 des Nations unies demande explicitement de rendre les villes et les établissements humains inclusifs, sûrs, résilients et durables, et insiste sur la planification participative ainsi que sur l’importance de données mieux ventilées pour guider l’action publique. À Montréal, par exemple, la Politique équité, diversité, inclusion et antiracisme de la Ville vise à reconnaître les discriminations systémiques, à renforcer l’équité territoriale et économique et à favoriser une participation publique plus inclusive.
Ces orientations sont nécessaires, mais elles ne suffisent pas. Les inégalités urbaines se vivent dans des gestes ordinaires : aller au travail, traverser une rue, laisser un enfant jouer dehors, attendre l’autobus, participer à une fête de quartier, manifester, se reposer ou flâner sans être soupçonné d’être « hors de sa place ».
Les espaces publics sont aussi des lieux de culture, de sociabilité et de démocratie. Lorsqu’ils excluent, les effets dépassent l’inconfort : ils peuvent toucher la santé, réduire la participation sociale, affaiblir la confiance envers les institutions et priver la collectivité de la contribution de nombreux résidents, notamment parce que ces exclusions influencent les conditions de vie et l’accès aux ressources.
Les méthodes actuelles ne suffisent pas
Les municipalités disposent déjà d’outils pour évaluer leurs rues, leurs parcs et leurs équipements : inspections, consultations publiques, audits d’accessibilité, enquêtes, observations de terrain, données de mobilité. Ces méthodes sont utiles. Elles restent toutefois souvent fragmentaires, coûteuses, ponctuelles et difficiles à déployer à grande échelle.
Elles comportent aussi un angle mort : elles mesurent mieux ce qui est visible et standardisable que ce qui est vécu. Une rue peut respecter certaines normes techniques tout en demeurant peu accueillante pour une personne âgée, peu lisible pour un nouvel arrivant, anxiogène pour une femme qui rentre tard, ou impraticable pour une personne qui se déplace avec une aide à la mobilité. À l’inverse, certains lieux peuvent être très appréciés par des communautés locales pour des raisons que les indicateurs classiques ne captent pas : habitudes, mémoire, usages informels, ambiance, sentiment d’appartenance.
Ces constats posent une question simple : comment mieux évaluer la capacité réelle des espaces publics à accueillir la diversité des populations urbaines ?
Ce que l’IA peut apporter, et ce qu’elle ne peut pas faire seule
Depuis une quinzaine d’années, les sciences sociales computationnelles combinent sciences sociales, informatique, statistiques, données numériques et modélisation pour repérer, à grande échelle, certains motifs dans les comportements individuels et collectifs, comme l’ont montré les travaux fondateurs du domaine. En ville, elles ne remplacent ni les enquêtes ni l’observation de terrain : elles les complètent.
Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.
Les approches actuelles sont prometteuses, mais risquées. Elles peuvent aider à repérer des régularités urbaines ou à produire des évaluations visuelles comme StreetScore, mais les données peuvent être biaisées, les images de rue ne disent pas tout et un score peut donner une impression de précision tout en effaçant le contexte social, historique et culturel des lieux, comme le rappellent les débats sur les limites des modèles. Une IA pour la ville ne devrait donc jamais être seulement une machine à classer des rues. Elle doit être un outil de discussion, de diagnostic et de responsabilité publique.
Coproduire l’IA avec les communautés
Dans notre étude Street Review menée à Montréal et publiée dans Cities, nous avons combiné recherche participative, évaluations d’images de rue, entretiens, groupes de discussion et apprentissage automatique, dans la continuité d’une première méthode participative publiée dans Habitat International. Vingt-huit résidents ont participé à des entretiens et à l’évaluation d’images, tandis qu’environ 45 000 images de rue Mapillary étaient analysées. L’objectif était de relier les perceptions d’inclusivité à des caractéristiques physiques comme les trottoirs, l’entretien, la verdure, les bancs ou la qualité du bâti.
Les résultats montrent que les perceptions varient selon les groupes, et que des éléments très concrets, notamment la qualité des trottoirs et du bâti, pèsent fortement dans le sentiment d’inclusion, parfois davantage que la seule présence de verdure. Des cartes par profils d’usagers peuvent ainsi faire apparaître des écarts que des moyennes générales masqueraient.
L’enjeu n’est pas seulement de produire une carte. Il s’agit de faire entrer l’expérience vécue dans la manière même dont l’outil est conçu.
Coproduire l’intelligence artificielle signifie que les communautés ne sont pas consultées à la toute fin, une fois le système déjà construit. Elles participent à la définition du problème, au choix des critères, à l’évaluation des images, à l’interprétation des résultats et à la discussion sur les usages acceptables de l’outil.
Dans un cycle de vie participatif de l’IA, cette collaboration se poursuit aussi après le déploiement, car les villes changent, les usages évoluent et les modèles doivent être corrigés lorsqu’ils se trompent ou lorsqu’ils simplifient trop la réalité. Une telle approche peut aider les villes à mieux cibler leurs interventions.
Des garde-fous indispensables
Ces outils ne seront utiles qu’à trois conditions. D’abord, les villes doivent être transparentes sur les données utilisées, les limites des modèles et les décisions qui pourront en découler, car transformer des phénomènes sociaux complexes en mesures mathématiques peut faire perdre un contexte essentiel. Ensuite, les résultats doivent être vérifiés auprès de groupes variés, car un modèle entraîné sur un public restreint peut reproduire ses angles morts. Enfin, la responsabilité politique doit rester humaine : l’IA peut signaler des écarts et soutenir un diagnostic, mais elle ne doit pas décider seule de la valeur d’un lieu ni des communautés qui méritent une intervention.
Une ville inclusive ne se décrète pas par algorithme. Elle se construit par des choix publics.
Mieux voir pour mieux agir
Les villes ont besoin de meilleures données et d’une meilleure écoute. Développée avec les communautés, l’IA peut relier les observations locales à l’échelle métropolitaine, rendre visibles des écarts que les administrations soupçonnent sans toujours pouvoir les mesurer, et reconnaître l’expertise des résidents.
Le défi n’est donc pas de rendre la ville « intelligente » au sens technologique du terme. Il est de la rendre plus attentive, plus responsable et plus juste.
Shin Koseki a reçu des financements des Fonds de recherche du Québec et du Fonds Nouvelle Frontière en Recherche pour les projets associée à l’utilisation de l’IA pour améliorer la qualité de l’espace public.
Rashid Mushkani a reçu un financement du Fonds de recherche du Québec pour ce projet.
Notre nouveau modèle d’intelligence artificielle permet de prévoir les ondes de tempêtes extrêmes – ces rehaussements importants du niveau de la mer sur le littoral causés par les vents d’une grande dépression – avec une grande précision, y compris dans les conditions climatiques futures. Ce modèle d’IA fonctionnant rapidement, il peut aider les chercheurs et les professionnels à mieux évaluer les risques d’inondation côtière, et à mieux planifier les mesures d’adaptation.
Le niveau de la mer
Notre nouveau modèle d’intelligence artificielle permet de prévoir les ondes de tempêtes extrêmes – ces rehaussements importants du niveau de la mer sur le littoral causés par les vents d’une grande dépression – avec une grande précision, y compris dans les conditions climatiques futures. Ce modèle d’IA fonctionnant rapidement, il peut aider les chercheurs et les professionnels à mieux évaluer les risques d’inondation côtière, et à mieux planifier les mesures d’adaptation.
Le niveau de la mer monte, et avec lui, les risques liés aux événements côtiers extrêmes tels que les ondes de tempête – des élévations temporaires du niveau de la mer causées principalement par des tempêtes, qui comptent parmi les principaux facteurs à l’origine des inondations côtières. Alors que plus de 10 % de la population mondiale vit dans des régions côtières de faible altitude, la combinaison d’une élévation progressive du niveau moyen de la mer et d’événements extrêmes de plus en plus intenses représente une menace croissante.
Pour les urbanistes et les décideurs politiques chargés des zones côtières, l’enjeu principal ne réside pas seulement dans l’élévation prévue du niveau moyen de la mer, mais aussi dans l’évolution des événements extrêmes, que ce soit en matière de probabilité ou de gravité. En effet, la conception des infrastructures, l’urbanisme et la préparation aux catastrophes reposent sur des scénarios, établis scientifiquement, de tels événements extrêmes.
Cependant, la projection d’événements extrêmes liés au niveau de la mer reste un défi scientifique majeur, car ceux-ci sont le résultat d’interactions complexes et non linéaires entre les marées, les forçages atmosphériques, la dynamique océanique et les caractéristiques côtières locales.
Cela signifie que les incertitudes dans les projections de ces événements extrêmes restent en grande partie non quantifiées. Par exemple, de petites différences dans les hypothèses des modèles peuvent entraîner de grandes différences dans les résultats prévus, en particulier pour les événements extrêmes. Ces incertitudes ont des implications importantes pour les planificateurs, la protection civile et, en fin de compte, la protection des vies humaines et des biens.
À l’heure actuelle, l’efficacité des modèles d’IA ouvre de nouvelles possibilités. En effet, comme ceux-ci peuvent générer des prévisions beaucoup plus rapidement que les modèles basés sur les lois physiques, ils permettent d’explorer de vastes ensembles de scénarios futurs, ce qui serait d’un coût prohibitif si l’on utilisait uniquement des modèles traditionnels (basés sur la physique). Considérer de nombreux scénarios est particulièrement important pour évaluer les risques, car il s’agit de comprendre la probabilité d’événements rares mais catastrophiques.
Une approche combinant IA et physique pour un risque en mutation
Les modèles traditionnels fondés sur la physique, qui utilisent les lois physiques pour représenter le mouvement des eaux côtières, peuvent simuler ces processus en détail, mais ils sont coûteux en matière de calcul, ce qui rend difficile l’exploration d’un large éventail de scénarios futurs et d’incertitudes.
Cependant, leur fiabilité reste incertaine dans ce contexte, notamment en raison de deux défis majeurs : la représentation limitée des événements extrêmes rares mais à fort impact dans les données d’apprentissage, et la nécessité de généraliser les résultats – de manière robuste – à des conditions climatiques futures qui pourraient différer considérablement de celles observées historiquement.
L’IA et la modélisation physique sont des outils complémentaires : les modèles physiques restent essentiels pour représenter les processus sous-jacents et pour générer les données de haute qualité nécessaires à l’entraînement et à la validation des modèles d’IA, et, en fin de compte, pour instaurer la confiance dans leur homologue IA.
En combinant le réalisme physique des modèles traditionnels avec l’efficacité et la flexibilité de l’IA, les scientifiques développent une nouvelle génération d’outils pour l’évaluation des risques côtiers.
Ces outils seront essentiels pour éclairer les stratégies d’adaptation, aidant les sociétés à mieux se préparer à un avenir où les événements extrêmes liés au niveau de la mer pourraient devenir plus fréquents et plus graves.
Nos résultats suggèrent que l’IA peut être utilisée de manière fiable pour prévoir des événements extrêmes liés au niveau de la mer, rares mais à fort impact. De plus, les modèles d’IA, en permettant la génération rapide de scénarios et des tests de sensibilité, fournissent un nouvel outil pour mieux caractériser ces incertitudes.
Un nouvel « émulateur » d’IA pour la prévision des ondes de tempêtes extrêmes
Dans notre récente étude publiée dans Earth’s Future, nous avons cherché à déterminer si des modèles d’IA peuvent prédire avec précision des événements extrêmes liés au niveau de la mer, lorsqu’ils sont entraînés à émuler les résultats de simulations et de projections fondées sur la physique. En d’autres termes, nos modèles d’IA visent à apprendre à reproduire les résultats de ces modèles plus complexes, mais beaucoup plus rapidement.
Nos résultats montrent que les émulateurs d’IA parviennent à appréhender la dynamique complexe sous-jacente aux ondes de tempête et à reproduire les événements extrêmes avec une grande précision, y compris dans des scénarios futurs, par rapport aux projections disponibles jusqu’au milieu du XXIᵉ siècle.
Pour le démontrer, nous avons développé un cadre permettant d’améliorer la capacité des modèles d’IA à représenter les ondes de tempêtes extrêmes et de vérifier si leurs prévisions restent fiables dans des scénarios futurs.
La prochaine étape consiste à tester plus en profondeur la robustesse de ces outils d’IA sur un éventail plus large de scénarios climatiques et à les intégrer dans des cadres opérationnels d’évaluation des risques ainsi que dans des services mondiaux de données climatiques fournissant des informations hydroclimatiques et côtières aux décideurs, tels que l’Aqueduct Flood Risk Analyzer et le Copernicus Climate Data Store.
Plus largement, les modèles d’IA ont le potentiel de répondre à plusieurs besoins critiques en matière d’analyse des risques côtiers, mais d’importantes lacunes subsistent.
Il s’agit notamment d’améliorer et de quantifier rigoureusement leur transférabilité à travers un large éventail de scénarios futurs, de mieux représenter les incertitudes associées aux paramètres physiques intégrés dans les données d’apprentissage, et d’évaluer dans quelle mesure ces modèles se généralisent à différentes localisations géographiques.
Il sera essentiel de clarifier les limites de leurs capacités d’extrapolation pour renforcer la confiance dans leur utilisation à des fins de prise de décision, en particulier dans des conditions inédites, dues au changement climatique et à la non-stationnarité (c’est-à-dire les changements de régimes climatiques et des phénomènes extrêmes plus intenses que ceux observés auparavant), et qui se situent donc en dehors de la fourchette couverte par les observations passées ou les simulations fondées sur la physique que nous avons utilisées pour entraîner les modèles d’IA.
Le mécénat scientifique d’AXA fait désormais partie du Fonds Axa pour le progrès humain, qui regroupe les engagements philanthropiques du Groupe et des mutuelles d’assurance Axa dans les domaines de la science, de la nature, de la solidarité et de la culture. Avant 2025, ce mécénat scientifique global était assuré par le Fonds Axa pour la recherche, qui a soutenu plus de 750 projets à travers le monde depuis sa création en 2007. Pour en savoir plus, rendez-vous sur Fonds Axa pour le progrès humain.
Andrea Ficchì a reçu une bourse de recherche postdoctorale du Fonds AXA pour la Recherche (aujourd'hui Fonds Axa pour le progrès humain) dans le cadre de l'appel à candidatures lancé conjointement par le Fonds AXA pour la Recherche et la Commission Océanographique Intergouvernementale de l'UNESCO à l'occasion de la Décennie de l'Océan.
Emiliano Longo est membre de la CMCC Foundation (Euro-Mediterranean Center on Climate Change). Il a reçu des financements de Politecnico di Milano.
Un homme, ou une femme, averti en vaut-il, ou elle, vraiment deux quand on évoque l’impact d’un licenciement sur la santé mentale des personnes ? Rien n’est moins sûr, selon une étude menée pendant vingt ans en Australie. Si les résultats sont transposables, estimer ou non que l’IA détruira son emploi a peu d’impact. En revanche, retrouver vite un emploi contribue à la restauration du bien-être psychique des individus.
L’idée que l’intelligence artificielle va détruire des millions d’emplois
Un homme, ou une femme, averti en vaut-il, ou elle, vraiment deux quand on évoque l’impact d’un licenciement sur la santé mentale des personnes ? Rien n’est moins sûr, selon une étude menée pendant vingt ans en Australie. Si les résultats sont transposables, estimer ou non que l’IA détruira son emploi a peu d’impact. En revanche, retrouver vite un emploi contribue à la restauration du bien-être psychique des individus.
L’idée que l’intelligence artificielle va détruire des millions d’emplois s’est imposée dans le débat public. L’Organisation de coopération et de développement économiques (OCDE) estime que 27 % des emplois sont exposés à un risque élevé d’automatisation, et trois travailleurs sur cinq déclarent craindre de perdre leur emploi dans les dix prochaines années.
Voilà pour les chiffres, mais qu’en est-il de leur impact sur les personnes et leur santé ? Voir venir la perte de son emploi serait, en soi, une source importante de souffrance psychologique. Les mois passés à appréhender l’échéance pèseraient lourd sur la santé mentale, peut-être autant que la perte elle-même.
Dans une nouvelle étude publiée dans la revue Social Science & Medicine, nous comparons les trajectoires de santé mentale de personnes qui ont anticipé leur licenciement à celles qui ne l’avaient pas anticipé. Le résultat surprend : les deux groupes suivent des trajectoires très proches, avant comme après la perte d’emploi.
Il y a donc deux questions bien distinctes : l’effet de la perte d’emploi sur la santé mentale, et l’effet d’anticiper cette perte d’emploi. La première est bien documentée. Perdre son emploi dégrade la santé mentale, à la fois parce que le revenu chute et parce que le travail est souvent source d’accomplissement alors que le chômage reste socialement stigmatisant. La seconde est plus disputée. De nombreuses études observent un déclin de la santé mentale dans les mois précédant un licenciement et l’attribuent à un effet d’anticipation.
Faute d’informations sur le niveau effectif des anticipations, jusque-là, ces études ignoraient si les individus anticipaient réellement leur licenciement. Or, le déclin de la santé mentale avant le licenciement peut aussi refléter des dynamiques antérieures – conditions de travail qui se détériorent, restructurations silencieuses, climat anxiogène – qui pèsent sur la santé mentale indépendamment de toute anticipation des individus vis-à-vis de leur propre emploi.
Nous mobilisons 22 vagues annuelles (2001–2022) de l’enquête HILDA, un panel représentatif qui suit les mêmes individus dans le temps en Australie. La santé mentale est mesurée à l’aide de l’indice SF-36, un outil clinique validé qui s’étend de 0 à 100. Notre échantillon comprend 14 195 personnes et 4 251 licenciements. L’enquête enregistre le trimestre exact du licenciement, ce qui permet d’examiner finement les trajectoires sur les trimestres précédant et suivant l’événement.
Surtout, HILDA demande chaque année aux personnes en emploi quelle probabilité, mesurée de 0 à 100 %, elles attribuent à la perspective d’être licenciées dans les douze mois suivants. Cette mesure subjective nous permet de distinguer ceux qui anticipent leur licenciement – c’est-à-dire qui déclarent une probabilité non nulle – de ceux qui ne l’anticipent pas, c’est-à-dire qui déclarent une probabilité nulle.
Notre démarche est comparative et non causale. Les personnes qui anticipent et celles qui n’anticipent pas peuvent différer sur des dimensions non observées, et les déclins observés avant le licenciement peuvent refléter des facteurs partagés, comme une dégradation de la situation de l’entreprise, plutôt que l’anticipation elle-même.
Avant et après : des trajectoires comparables
Dans les mois précédant le licenciement, les deux groupes affichent un déclin de santé mentale. Chez les personnes qui n’anticipaient pas, l’indice SF-36 baisse d’environ 2,1 points dans le trimestre précédant immédiatement la séparation. Chez celles qui anticipaient, la baisse est de 1,2 point sur la même période. Les ordres de grandeur sont proches, et les tests statistiques ne permettent pas de conclure à une différence significative entre les deux groupes.
Ce résultat invite à reconsidérer une interprétation courante : la dégradation de la santé mentale prélicenciement documentée dans la littérature ne traduit pas seulement une anticipation individuelle. Elle apparaît aussi chez des personnes qui, dans les mois précédant la perte, jugeaient leur risque de licenciement nul. D’autres mécanismes sont vraisemblablement à l’œuvre – dégradation des conditions de travail, tensions internes, restructurations précédant licenciement.
Une fois le licenciement intervenu, les trajectoires divergent fortement, non pas selon l’anticipation, mais selon le retour à l’emploi. Les personnes qui retrouvent rapidement un emploi voient leur santé mentale revenir à son niveau habituel en quelques trimestres, qu’elles aient anticipé leur licenciement ou non. Celles qui restent au chômage continuent en revanche à souffrir : leur indice SF-36 reste inférieur à son niveau habituel un an après la perte d’emploi.
Arte, 2026.
Comment préparer la vague de l’IA ?
Là encore, l’anticipation ne change presque rien. Cumulée sur les quatre trimestres qui précèdent et ceux qui suivent la perte d’emploi, la baisse de l’indice SF-36 atteint 14 points pour celles qui n’avaient pas anticipé et 14,4 points pour celles qui avaient anticipé. Cet écart est trop faible pour qu’on puisse y voir une véritable différence. Les conclusions sont les mêmes pour les hommes et pour les femmes, et se retrouvent aussi quand on remplace l’indice SF-36 par une mesure de satisfaction de vie.
Notre étude porte sur des licenciements survenus dans l’Australie des deux dernières décennies, pas sur des licenciements liés à l’IA. Mais ses enseignements éclairent les inquiétudes actuelles. L’idée selon laquelle voir venir la perte de son emploi constituerait, en soi, le principal facteur de détresse psychologique ou, au contraire, serait propice à une meilleure préparation et donc à un rebond plus rapide, mérite d’être nuancée. Dans nos données, ce qui pèse le plus, c’est la perte elle-même et, surtout, la rapidité avec laquelle on retrouve un travail.
Cela suggère que les politiques visant à atténuer le coût psychologique des transformations technologiques gagneraient à mettre l’accent moins sur la gestion de l’angoisse anticipée et davantage sur les trajectoires de retour à l’emploi : formation, accompagnement, intermédiation. C’est dans la trajectoire d’emploi, plus que dans l’anticipation, que se joue la santé mentale des travailleurs licenciés.
Nicolas Herault a reçu des financements de l'Agence nationale de la recherche (ANR), du Ministère de l'Enseignement supérieur, de la Recherche, de l'IdEx Université de Bordeaux et du GPR HOPE.
Daniel Nettle a reçu des financements de l'Agence Nationale de la Recherche (ANR, France) ainsi que le National Institute for Health and Care Research (NUHR, UK).
En appréhendant de manière globale, l’impact éventuel de l’intelligence artificielle, une partie du problème est esquivé. À commencer par la façon dont chacun perçoit l’IA : si, pour certains salariés, c’est une menace inquiétante ; d’autres personnes y voient d’abord une opportunité à saisir. L’impact global dépendra aussi de l’ensemble de ces micro-ajustements.
À chaque révolution technologique, la question de son impact sur l’emploi est posée avec plus ou moins de finesse. L’accélération r
En appréhendant de manière globale, l’impact éventuel de l’intelligence artificielle, une partie du problème est esquivé. À commencer par la façon dont chacun perçoit l’IA : si, pour certains salariés, c’est une menace inquiétante ; d’autres personnes y voient d’abord une opportunité à saisir. L’impact global dépendra aussi de l’ensemble de ces micro-ajustements.
À chaque révolution technologique, la question de son impact sur l’emploi est posée avec plus ou moins de finesse. L’accélération récente des outils d’intelligence artificielle ne fait pas exception. L’étude que l’OCDE a publiée récemment s’intéresse ainsi à l’effet de l’introduction de l’IA sur les inégalités salariales. Réalisée dans 19 pays de l’OCDE sur la période allant de 2014 à 2018, ce travail statistique indique que l’IA n’a pas eu d’influence sur les inégalités salariales entre les professions, d’un métier à l’autre au cours de cette période et dans les pays concernés par l’étude.
Or, il s’agissait d’une période où l’influence de l’IA sur le marché de travail était encore limitée. Cette influence sera de plus en plus grande dans les années à venir.
Le résultat global de l’OCDE mérite cependant d’être nuancé. Certains éléments indiquent une réduction des inégalités salariales entre les différentes professions : l’utilisation de l’IA contribue à diminuer les différences salariales.
Cela pourrait suggérer que l’introduction de l’IA réduit les écarts de productivité entre les individus, ce qui se refléterait ensuite dans les salaires. Toutefois, la conclusion de cette étude incite à la prudence. « L’extrapolation au contexte actuel doit donc être faite avec prudence », précisent les auteurs.
Au-delà des inégalités pour ceux qui conservent leur emploi, l’IA pose la grande question déjà évoquée de l’impact de la technologie sur le niveau de l’emploi. Le sociologue Eric Dahlin a constaté dans une des premières études consacrées à cette thématique que les professions intellectuelles et celles qui requièrent une expérience technique (traducteur, ingénieur, architecte) sont davantage susceptibles d’être menacées par l’IA que des professions dont le niveau de créativité est élevé, comme celles des universitaires ou des médecins.
Pour cela, il a soumis à un échantillon de 951 personnes un questionnaire où il leur était demandé par exemple « Avez-vous perdu votre job à cause de l’IA » ou « Avez-vous peur de le perdre à cause de l’IA ? ».
Pour revenir à l’étude d’Eric Dahlin, le sociologue a étudié en 2023 ce sujet aux États-Unis. Il ressort de son enquête que certaines tâches cognitives des cols blancs sont mieux exécutées par l’IA que par un humain comme, par exemple, les tâches de traduction des textes.
La qualité de ces traductions est telle que des chercheurs peuvent en bénéficier en demandant une dernière correction du texte traduit par l’IA aux traducteurs. L’emploi d’une part de ces professionnels hautement qualifiés (parmi lesquels on compte traducteurs, comptables, analystes financiers…) est donc menacé.
Des compétences encore protégées
À l’inverse, d’autres emplois à contenu intellectuel seraient moins menacés. L’exercice du métier de médecin ou de certains scientifiques… requiert des compétences difficilement mobilisables par une IA pour le moment. Il s’agit de capacités d’analyse créative pour prendre des décisions singulières et ou résoudre des problèmes.
Quand un médecin explique des données de santé à ses patients ou qu’un scientifique explique des faits empiriques à des étudiants à l’aide d’arguments complexes, ils peuvent être difficilement remplacés par une IA. Quand bien même, une partie de leur tâche peut être exercée par une IA, la plupart d’entre elles nécessitent des compétences difficilement exécutables par des machines.
Les conclusions sur le lien entre l’IA et l’emploi doivent donc être nuancées. Si elles sont vraies d’un point de vue macro, la réalité au cas par cas dépend d’autres facteurs. Les discriminations existant actuellement sur le marché du travail peuvent avoir un effet sur les emplois qui sont et seront ou non menacés.
L’impact des discriminations
Ainsi, l’impact de l’intelligence artificielle sur le marché du travail doit prendre en compte les discriminations existantes fondées sur le sexe, l’origine ethnique et le statut socio-économique. Une partie croissante des individus de ces groupes, estimée à 10 % des travailleurs par la Commission européenne, est cantonnée à des emplois à temps partiel ou temporaire dans l’économie des petits boulots, sans possibilité d’ascension sociale.
Les plateformes numériques, telles qu’Airbnb et Uber, sont devenues des sources de revenus et de services. Il existe toutefois des preuves d’une polarisation du marché du travail, si l’on se concentre sur les différents niveaux d’éducation et d’âge. Les travailleurs moyennement qualifiés apparaissent comme les plus concernés lorsque l’IA entraîne une perte d’emplois.
BFM Business, 2025.
L’IA une opportunité pour certains
Ces différences de statut sur le marché du travail s’accompagnent d’évaluations divergentes à propos de l’IA. Considérée comme une menace par les groupes défavorisés, elle est perçue comme un défi pouvant être relevé par les groupes privilégiés. Les résultats du sociologue Dahlin montrent ainsi qu’il existe une différence entre la crainte de perdre son emploi et la perte effective d’emploi due à l’IA. L’adaptation au marché du travail est donc exigée et détermine le résultat face aux exigences relevant du secteur économique où des choix sont réalisés par les entreprises et les employeurs.
Même si certaines tâches des cols blancs peuvent être remplacées par des machines, les cadres et une partie des employés qualifiés peuvent changer rapidement d’emploi, s’ils ont la capacité de s’adapter.
Ulrike Schuerkens ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Pour rassurer et guider le consommateur, la marque a eu un rôle de repère cognitif. C’est d’ailleurs l’un des dispositifs « inventé » par le capitalisme pour stimuler la consommation. En mobilisant des outils d’intelligence artificielle, il ne s’agit pas seulement d’une puissance décuplée, mais d’un changement de nature qui, très rapidement, rejaillit sur le consommateur. Bienvenue (ou pas) dans l’ère de l’empathie artificielle au service de la médiation marchande.
Les outils d’intelligence a
Pour rassurer et guider le consommateur, la marque a eu un rôle de repère cognitif. C’est d’ailleurs l’un des dispositifs « inventé » par le capitalisme pour stimuler la consommation. En mobilisant des outils d’intelligence artificielle, il ne s’agit pas seulement d’une puissance décuplée, mais d’un changement de nature qui, très rapidement, rejaillit sur le consommateur. Bienvenue (ou pas) dans l’ère de l’empathie artificielle au service de la médiation marchande.
Les outils d’intelligence artificielle ne se contentent plus d’orienter nos achats. Ils répondent, accompagnent et… peuvent même rassurer. À mesure que les interfaces marchandes deviennent conversationnelles, une question se pose : sont-elles en train d’occuper, pour des consommateurs fragilisés, une place psychique, à savoir une fonction de réassurance, de stabilisation identitaire et de médiation affective face à l’incertitude du monde autrefois assumée par certains objets, notamment les marques ?
Longtemps, les dispositifs marchands ont surtout cherché à capter l’attention, orienter le choix et accélérer la décision d’achat. Avec l’essor des interfaces conversationnelles et des outils d’intelligence artificielle, un déplacement s’opère. Il ne s’agit plus seulement de rendre la transaction plus efficace, mais de produire les formes d’une présence attentive et rassurante. L’interface ne se contente plus d’informer : elle reformule, accompagne et rassure. Cette évolution prend place dans un contexte de fragilité psychologique croissante des individus.
Ce qui se transforme ici n’est pas seulement la technique de vente, mais la nature même de la médiation marchande. L’acte d’achat prend alors la forme d’une interaction continuelle, plus fluide, et plus enveloppante. Les recherches récentes sur les compagnons numériques montrent d’ailleurs que les interfaces d’IA sont de plus en plus présentées comme des amis, des conseillers ou des partenaires émotionnels.
Pour comprendre ce qui se joue, la notion d’objet transitionnel élaborée par le psychanalyste Donald Winnicott s’avère précieuse. Encore faut-il ne pas la réduire à l’image un peu rapide du doudou rassurant. Chez Winnicott, l’objet transitionnel apparaît dans un moment très précis du développement : lorsque l’enfant commence à faire l’expérience que la mère n’est pas la prolongation immédiate de son désir, qu’elle ne coïncide pas parfaitement avec lui, qu’elle est extérieure, intermittente, séparée. L’objet transitionnel (morceau de tissu, peluche) l’aide alors à traverser cette première épreuve de l’absence.
Mais sa fonction ne consiste pas simplement à calmer l’angoisse. Ce que Winnicott met au jour est plus profond. L’existence d’une aire transitionnelle est une aire intermédiaire d’expérience qui n’est ni purement subjective ni purement objective. L’objet transitionnel appartient à cette zone paradoxale où le sujet commence à supporter l’écart entre sa réalité intérieure et le monde extérieur. Il est ce par quoi l’enfant peut jouer, symboliser, supporter l’absence, entrer progressivement dans le réel partagé sans être brutalement précipité dans la séparation. En ce sens, l’objet transitionnel ne vaut pas par ses qualités propres, mais par la fonction psychique qu’il remplit : il médie le passage entre dépendance et autonomie.
Du produit à la marque
C’est pourquoi la bonne question est de savoir où se loge, à un moment donné, la fonction transitionnelle. Sous cet angle, une partie de l’histoire de la consommation peut être appréhendée comme un déplacement de cette fonction. Certains produits ont pu l’héberger affectivement : un vêtement, un parfum, un téléphone peuvent devenir des supports de mémoire et de réassurance. Les marques ont ensuite cherché à capter cette fonction sur un plan symbolique, en proposant des univers familiers et des récits identitaires. D’où la fameuse théorie du produit ou de la marque comme extension du soi que l’on doit à Russel Belk.
Mais avec l’IA, quelque chose change de nature. La médiation ne passe plus seulement par un objet possédé ni par un imaginaire de marque auquel s’identifier. Elle passe par une interface qui répond. Ce n’est plus seulement un support mais une présence interactive. L’IA reformule, anticipe, accompagne, suggère. Elle s’insinue dans l’espace même de l’hésitation, là où le sujet cherche à se repérer dans un réel complexe, fatigant ou anxiogène.
C’est ici que le travail du psychiatre et psychanalyste Serge Tisseron permet d’aller plus loin. Dans Le jour où mon robot m’aimera, il ne décrit pas seulement des machines utiles ou performantes. Il décrit des objets connectés qui détectent nos réactions, s’adaptent à nous, orientent parfois nos choix à notre insu, et pourraient demain déchiffrer nos émotions, nous parler et nous manifester de l’affection, voire de l’amour. Son point n’est pas seulement technique ; il est anthropologique. La technologie ne s’avance plus seulement comme instrument et tend à prendre la forme d’un partenaire émotionnel apparent.
Une empathie artificielle
Dès lors, l’IA marchande ne doit plus être pensée comme un simple perfectionnement de la recommandation commerciale. Elle relève d’une empathie artificielle mise au service de la médiation marchande. L’interface ne propose pas seulement un choix plus rapide ou plus pertinent ; elle donne aussi l’impression d’une écoute et d’une disponibilité sans faille. Elle se présente comme une présence douce, presque caressante qui allège le poids psychique de la décision.
Cette hypothèse est étayée par une étude selon laquelle les individus les plus affectés par la solitude expriment une préférence plus marquée pour une compagnie humaine virtuelle plutôt que réelle, l’anxiété sociale jouant un rôle de médiation. Cela ne signifie évidemment pas que toute interaction artificielle remplace la relation humaine. Mais cela suggère clairement qu’une interface artificielle peut être psychiquement préférée lorsqu’elle paraît plus contrôlable.
C’est pourquoi il serait insuffisant de ne voir dans ces dispositifs qu’une amélioration de la fluidité du parcours marchand. Ce qui se joue ici touche à l’économie psychique même de la consommation. Plus une interface prend en charge nos hésitations, plus elle risque de devenir le lieu où nous déposons une part de notre vulnérabilité. Le problème advient lorsque la fonction d’allègement des tâches devient inséparable d’une fonction de captation.
RTS, 2017.
Une médiation qui organise la dépendance
Une interface qui peut anticiper mes préférences ne se borne pas à fluidifier une décision : elle contribue à configurer la manière même dont cette décision se forme. L’aide n’est jamais neutre lorsqu’elle intervient au plus près de l’hésitation. Tisseron le suggère très bien : le danger n’est pas seulement celui d’une machine qui calcule, mais celui d’une machine qui paraît nous aimer. La question n’est donc pas de dénoncer naïvement toute technologie d’accompagnement. Il serait absurde de nier que ces outils puissent rendre des services réels. La vraie question est de savoir comment distinguer une médiation qui aide à l’autonomie d’une médiation qui organise la dépendance.
Chez Winnicott, l’aire transitionnelle aide le sujet à entrer dans le monde commun. Elle ne remplace pas le réel : elle permet d’y accéder sans être écrasé par lui. Toute la question est donc de savoir si les interfaces contemporaines remplissent encore une telle fonction d’autonomisation, ou si elles deviennent au contraire un milieu protecteur qui dispense d’affronter pleinement le monde tout en organisant une nouvelle forme de dépendance douce.
Le lieu du véritable basculement
Peut-être est-ce là le véritable basculement. Le produit pouvait autrefois consoler. La marque pouvait offrir une familiarité symbolique. L’IA propose désormais une présence interactive à laquelle on s’adresse pour être guidé, rassuré, parfois presque reconnu. Et c’est précisément pour cela qu’elle ne peut pas être pensée comme un simple outil. Car une société dans laquelle les fonctions les plus intimes de médiation sont progressivement prises en charge par des interfaces marchandes est une société où la vulnérabilité risque de devenir, plus que jamais, un marché.
Cette évolution rejoint très directement les analyses du philosophe Bernard Stiegler sur la fragilisation du consommateur. Pour lui, le problème du marketing ne tient pas seulement à son pouvoir de persuasion, mais à son emprise sur les capacités psychiques elles-mêmes. Ce que Stiegler appelle la « prolétarisation du consommateur », c’est le fait que le sujet ne produit plus ses propres modes d’existence : ceux-ci lui sont de plus en plus prescrits par des dispositifs industriels de captation de l’attention et d’orientation du désir.
L’interface marchande s’inscrit dans ce que Stiegler appelle un « psychopouvoir » : il ne s’agit plus seulement d’agir sur les comportements de l’extérieur, par la publicité ou par l’incitation visible, mais d’investir les circuits psychiques eux-mêmes, c’est-à-dire l’attention, le désir, les habitudes perceptives, la capacité de juger et, plus largement, ce que Stiegler nomme parfois les savoir-vivre.
Avec le psychopouvoir, le marché ne s’adresse plus seulement à un sujet déjà constitué ; il contribue à configurer les conditions mêmes de sa disponibilité. Ce qui est capté n’est pas seulement le temps de cerveau disponible, mais la faculté d’orienter son attention, de différer une impulsion, de relier un désir à une histoire personnelle, de faire la différence entre ce que l’on veut, ce que l’on croit vouloir et ce qui est induit.
C’est en ce sens que l’IA marchande peut accentuer la fragilisation du consommateur. Non parce qu’elle l’empêcherait mécaniquement de penser, mais parce qu’elle risque de le déposséder d’une part de son autonomie psychique en le déshabituant à exercer par lui-même certaines opérations de tri, de jugement, de mise à distance et d’élaboration du désir.
Benoît Heilbrunn ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Que perd-on lorsque l’écriture journalistique est de plus en plus confiée aux machines ? Selon plusieurs travaux récents, le risque n'est pas seulement informationnel : il concerne aussi la capacité de la presse à renouveler la langue. Markus Winkler / Unsplash, CC BYHistoriquement, le journalisme a contribué à diffuser de nouveaux mots et à nommer les transformations du monde. Si les textes générés par l’IA deviennent dominants, cette dynamique d’innovation linguistique pourrait s'affaiblir.
Que perd-on lorsque l’écriture journalistique est de plus en plus confiée aux machines ? Selon plusieurs travaux récents, le risque n'est pas seulement informationnel : il concerne aussi la capacité de la presse à renouveler la langue.Markus Winkler / Unsplash, CC BY
Historiquement, le journalisme a contribué à diffuser de nouveaux mots et à nommer les transformations du monde. Si les textes générés par l’IA deviennent dominants, cette dynamique d’innovation linguistique pourrait s'affaiblir.
Que devient le langage public lorsqu’une part croissante des textes qui circulent dans la presse, sur Internet et sur les réseaux sociaux commence à être rédigée par des machines ? La question ne concerne pas seulement le journalisme en tant qu’activité professionnelle. Elle peut aussi affecter la richesse de la langue que nous utilisons pour comprendre, décrire et débattre du réel.
Historiquement, la presse a été l’un des espaces où la langue commune s’est développée et enrichie. Elle n’est évidemment pas le seul moteur du changement linguistique, mais elle constitue l’un des lieux où les sociétés mettent en circulation de nouveaux mots, de nouvelles tournures et de nouvelles façons de nommer des phénomènes émergents. Plusieurs travaux sur le langage journalistique et les néologismes montrent d’ailleurs que les journaux ont longtemps joué un rôle essentiel dans la création et la diffusion de vocabulaire nouveau, en particulier lorsqu’il s’agissait de rendre compte d’événements, de technologies ou de transformations sociales auprès d’un large public.
Ce rôle pourrait s’affaiblir si une part importante de l’écriture journalistique était déléguée à des systèmes d’IA générative. Les grands modèles de langage reposent, de manière générale, sur la prédiction du mot – ou plus précisément du « token » – le plus probable au sein d’une séquence. Ils produisent ainsi des textes fluides et plausibles, mais tendent également à privilégier les régularités statistiques, les formulations les plus fréquentes et les tournures déjà stabilisées.
Cela ne signifie pas, en soi, que le langage se dégrade automatiquement. Le problème apparaît lorsque cette logique devient dominante dans la production des textes qui alimentent l’espace public.
Quand les IA s’entraînent sur des textes produits par d’autres IA
Le risque devient plus sérieux lorsque ces systèmes commencent à être entraînés à partir de textes produits par d’autres IA. C’est ce que plusieurs travaux récents décrivent sous le nom de model collapse, ou « effondrement du modèle » : un processus de dégénérescence dans lequel les données générées par un modèle finissent par contaminer l’entraînement des générations suivantes.
Appliqué au langage, cela signifie que si les systèmes apprennent de plus en plus à partir de textes synthétiques, et si ces textes en viennent à saturer le Web et l’espace public, le réservoir linguistique disponible pour les futurs entraînements se rétrécit. Plus il y a de textes artificiels, moins les modèles sont exposés à la diversité réelle des usages humains de la langue. À terme, cela peut entraîner un appauvrissement du langage dans différents domaines.
Reproduction et amplification des biais
Tout d’abord, lorsque la diversité des données diminue et que les modèles s’appuient principalement sur des schémas déjà établis, les biais présents dans les données d’entraînement risquent d’être renforcés plutôt que corrigés. La littérature récente sur l’évolution des modèles de langage met précisément en garde contre le fait que les processus récursifs peuvent amplifier des préjugés existants au lieu de diversifier les points de vue.
Par ailleurs, l’écriture tend à se ressembler de plus en plus à elle-même : les mêmes structures syntaxiques, les mêmes tonalités intermédiaires, les mêmes formulations et les mêmes façons d’organiser les paragraphes reviennent sans cesse. Cette évolution est particulièrement importante pour le journalisme, car la presse ne se contente pas de transmettre des informations : elle fait le lien entre des savoirs spécialisés et un large public, hiérarchise les enjeux, traduit des vocabulaires techniques et expérimente de nouvelles formulations. Lorsque la langue de l’espace public devient trop uniforme, sa capacité à s’adapter finement à la nouveauté s’affaiblit.
Il ne faut pas comprendre cet enjeu comme une opposition abstraite entre « l’humain » et « la machine », mais plutôt comme la différence entre une langue nourrie par les contingences de la vie sociale et une prose produite à partir de régularités déjà apprises.
Un appauvrissement de l’écosystème linguistique
L’enjeu ne se limite pas à une diminution du nombre de mots différents. Il concerne aussi la capacité à établir des distinctions fines. Lorsque le langage devient plus vague, plus répétitif ou plus prévisible, les outils dont dispose une société pour décrire les problèmes, nuancer les positions et débattre dans l’espace public s’appauvrissent eux aussi.
À une échelle plus large, la question n’est donc plus seulement de savoir ce qui arrive à un modèle d’IA, mais ce qui arrive à l’écosystème linguistique public dans son ensemble. Si le Web se remplit de textes synthétiques, lecteurs, journalistes et institutions seront progressivement exposés à une langue publique moins diverse. Certains travaux récents vont jusqu’à évoquer une forme de « contamination » de l’écosystème numérique par les données synthétiques et montrent que la manière dont se combinent données réelles et artificielles est déterminante pour éviter des dégradations plus importantes.
Un scénario inéluctable ?
Il convient toutefois de ne pas exagérer le risque. Les travaux de recherche ne concluent pas que tout usage de l’IA entraîne inévitablement un effondrement ou une dégradation. Certaines études montrent que lorsque les données synthétiques sont mélangées à des données réelles, plutôt que de les remplacer entièrement, les mécanismes de dégradation ne se manifestent pas de la même manière et les erreurs peuvent rester limitées. Autrement dit, le problème ne réside pas dans un usage ponctuel de l’IA ni dans une combinaison prudente de données synthétiques et humaines, mais dans le remplacement massif de l’écriture humaine suivi du recyclage de cette production artificielle comme s’il s’agissait d’un langage vivant.
Avec l’intégration de l’IA dans les routines de production journalistique, le journalisme gagne en efficacité. Mais que perd une société lorsque la langue qui circule dans l’espace public devient plus uniforme, plus prévisible et moins ouverte à la nouveauté ? Si la presse renonce, même partiellement, à sa fonction d’écriture, de traduction, de nomination et d’expérimentation linguistique, ce ne sont pas seulement les pratiques professionnelles qui se transforment. C’est aussi l’un des principaux espaces où la langue commune a historiquement pu s’enrichir, se renouveler et élargir son champ des possibles qui s’en trouve affaibli.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
Plus de 987 millions de personnes dans le monde utilisent désormais des chatbots basés sur l’IA générative. Parmi les adolescents américains, cette proportion atteindrait 64 %, selon des estimations récentes. De plus en plus, les gens utilisent ces chatbots comme source de conseils, de soutien émotionnel, de thérapie et de compagnie.
Que se passe-t-il lorsque des personnes comptent sur des chatbots IA dans des moments de vulnérabilité psychologique ? Les médias se sont récemment penchés sur q
Nous avons constaté que la couverture des grands médias sur les effets psychiatriques néfastes liés à l’IA générative se concentre sur les conséquences les plus graves, en particulier le suicide et l’hospitalisation. Les articles attribuent fréquemment ces événements aux réponses ou aux interactions des systèmes d’IA, malgré des preuves limitées.
Illusions de compassion
L’IA générative n’est pas simplement un outil numérique de plus. Contrairement aux moteurs de recherche ou aux applications statiques, des chatbots comme ChatGPT, Gemini, Claude, Grok ou Perplexity produisent des conversations fluides et personnalisées qui peuvent sembler remarquablement humaines.
Cela crée ce que les chercheurs appellent des « illusions de compassion » : l’impression d’interagir avec une entité capable de comprendre, d’éprouver de l’empathie et de répondre de façon significative.
Dans ce documentaire de la BBC, la présentatrice et mathématicienne Hannah Fry s’entretient avec Jacob au sujet de sa « petite amie » Aiva, un chatbot Replika.
Parmi les articles que nous avons analysés, le suicide était l’issue la plus fréquemment rapportée. Il représentait plus de la moitié des cas dont la gravité était clairement décrite.
L’hospitalisation psychiatrique arrivait au deuxième rang. Les reportages impliquant des mineurs étaient aussi plus susceptibles de faire état d’issues mortelles.
Mais ces chiffres ne reflètent pas nécessairement l’incidence réelle des préjudices liés à l’IA. Ils reflètent surtout ce qui est jugé digne d’intérêt médiatique. En général, la couverture médiatique d’événements stressants tend à amplifier les cas graves et émotionnellement chargés, puisque les informations négatives et incertaines attirent davantage l’attention, suscitent des réactions émotionnelles plus fortes et alimentent des cycles de vigilance et d’exposition répétée. Cela peut ensuite renforcer les perceptions de menace et de détresse.
Dans les contenus liés à l’IA, les reportages s’appuient souvent sur des preuves partielles — comme des transcriptions de conversations — tout en incluant rarement des dossiers médicaux ou des documents officiels. Dans notre corpus, un seul cas faisait référence à des dossiers cliniques ou policiers.
Il en résulte une image à la fois incomplète et influente, qui façonne la perception du public, les préoccupations cliniques et les débats réglementaires.
Au-delà du « c’est l’IA qui en est la cause »
L’une de nos principales conclusions concerne la manière dont la causalité est présentée. Dans de nombreux articles analysés, les systèmes d’IA étaient décrits comme ayant « contribué à » ou même « causé » une détérioration de l’état psychiatrique d’une personne.
Or, les preuves avancées étaient souvent limitées. Les explications alternatives — comme une maladie mentale préexistante, la consommation de substances ou des facteurs de stress psychosociaux — étaient mentionnées de façon inégale, voire absentes.
En psychiatrie, la causalité est rarement simple. Les crises de santé mentale résultent généralement de plusieurs facteurs qui interagissent entre eux. L’IA peut jouer un rôle, mais celui-ci s’inscrit probablement dans un contexte plus large mêlant vulnérabilités individuelles et environnement social.
Une approche plus utile consiste donc à examiner les effets d’interaction : comment ces technologies influencent-elles la cognition et les émotions humaines ? Par exemple, l’IA conversationnelle peut renforcer certaines croyances, survalider certains propos ou brouiller les frontières entre réalité et simulation.
Un autre élément récurrent dans les reportages médiatiques est l’intensité de l’usage. Plusieurs des cas analysés décrivaient des interactions longues et émotionnellement significatives avec des chatbots — parfois présentés comme des compagnons, voire des partenaires amoureux.
Cela soulève la question de la dépendance excessive.
Parce qu’ils sont constamment disponibles, réactifs et exempts de jugement, ces systèmes peuvent devenir une source principale de soutien émotionnel. Mais contrairement à un professionnel qualifié ou même à un proche attentif, ils ne peuvent pas reconnaître quand l’état d’une personne s’aggrave, mettre en pause ou réorienter des interactions nuisibles. Ils ne peuvent pas prendre de mesures pour s’assurer qu’une personne accède à des soins appropriés en cas de crise.
Sur le plan clinique, cela pourrait mener à une forme de substitution malsaine des mécanismes d’adaptation : des systèmes de soutien humains complexes remplacés par une interaction simplifiée et algorithmique.
À l’heure actuelle, il n’existe aucune estimation fiable de la fréquence des préjudices liés à l’IA ni de leur éventuelle augmentation. Nous manquons aussi de données solides sur le nombre de personnes qui utilisent ces outils sans problème par rapport à celles qui vivent des expériences négatives. La majorité des éléments disponibles proviennent encore de rapports de cas ou de récits médiatiques, et non d’études cliniques systématiques.
Cette situation n’a rien d’inhabituel. Dans plusieurs domaines de la médecine, les premiers signaux d’alerte émergent souvent en dehors de la recherche formelle — à travers des rapports de cas, des poursuites judiciaires ou le débat public — avant d’être étudiés de manière rigoureuse.
Un exemple classique est la tragédie de la thalidomide : les premiers signalements de malformations congénitales chez des nourrissons ont précédé la confirmation épidémiologique formelle et ont finalement mené à la création des systèmes modernes de pharmacovigilance.
L’IA et la santé mentale pourraient suivre une trajectoire semblable
Aller de l’avant de manière responsable
Le défi n’est pas de céder à la panique, mais de réagir avec prudence et nuance.
Nous avons besoin de meilleures données : une surveillance plus systématique des événements indésirables, des normes de signalement plus claires et davantage de recherches permettant de distinguer corrélation et causalité. Les mécanismes de protection — comme la détection des crises, les protocoles d’intervention ou la transparence quant aux limites de ces outils — devront aussi être renforcés et évalués.
Les cliniciens comme le grand public auront également besoin de balises plus claires. Les patients utilisent déjà ces outils. Ignorer cette réalité risque d’accentuer le décalage entre la pratique clinique et l’expérience vécue.
Enfin, il faut reconnaître que l’IA générative n’est pas seulement une innovation technologique — c’est aussi une innovation psychologique. Elle transforme la manière dont les gens pensent, ressentent et interagissent.
Comprendre cette transformation pourrait devenir l’un des grands défis en santé mentale de la prochaine décennie.
Alexandre Hudon ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Détecter le plus tôt possible après la naissance une motricité altérée grâce à une caméra ordinaire couplée à des systèmes intelligents et aider ainsi à établir le diagnostic dans des maladies du nourrisson caractérisées par une hypotonie, c’est-à-dire la baisse ou la disparition des mouvements actifs, des muscles. C’est la piste que poursuit une équipe de recherche à partir de travaux menés sur des bébés atteints d’amyotrophie spinale, une maladie neuromusculaire génétique rare.
En 2019, le
Détecter le plus tôt possible après la naissance une motricité altérée grâce à une caméra ordinaire couplée à des systèmes intelligents et aider ainsi à établir le diagnostic dans des maladies du nourrisson caractérisées par une hypotonie, c’est-à-dire la baisse ou la disparition des mouvements actifs, des muscles. C’est la piste que poursuit une équipe de recherche à partir de travaux menés sur des bébés atteints d’amyotrophie spinale, une maladie neuromusculaire génétique rare.
Et, en même temps, quel progrès extraordinaire ! Il promet de traiter de manière définitive, une maladie génétique létale, qui entraîne en cas de survie des handicaps extrêmement lourds chez les enfants atteints par ce qui est la première maladie neurologique périphérique héréditaire au monde.
Derrière ces chiffres vertigineux se cachait une réalité médicale urgente. Pour que ces thérapies fonctionnent, il est essentiel d’identifier la maladie le plus tôt possible. C’est précisément ce défi que notre équipe a cherché à relever, en utilisant une caméra ordinaire couplée à des systèmes intelligents.
L’objectif était clair, dès le départ. Trop de retards diminuent de manière drastique l’efficacité du traitement. En effet, le traitement peut empêcher les neurones de mourir, mais ne peut pas les ressusciter. Tout retard à la mise en place du traitement et, donc, au diagnostic est une perte de chance intolérable pour les patients.
Qu’est-ce que l’amyotrophie spinale ?
La SMA est une maladie génétique rare qui entraîne la dégénérescence progressive des neurones moteurs qui commandent les muscles.
Quand elle frappe sous sa version la plus sévère – qui correspond à l’amyotrophie spinale de type 1 –, les nourrissons atteints perdent rapidement la capacité de bouger, de s’asseoir puis de respirer. Sans traitement, l’espérance de vie dépasse rarement deux ans. En France, on compte un cas toutes les 6 000 à 10 000 naissances.
Depuis l’arrivée de nouveaux traitements, le pronostic s’est radicalement transformé pour les enfants traités très tôt. L’amyotrophie spinale est, d’ailleurs, intégrée depuis 2025 au dépistage néonatal systématique en France. Tous les pays ne disposent pas encore de ce dépistage. Et même là où il existe, un outil complémentaire d’évaluation clinique rapide garde toute son utilité.
L’hypotonie désigne la diminution, voire la disparition, des mouvements actifs. Ce symptôme n’est pas spécifique et peut concerner beaucoup d’autres maladies de l’enfant, mais il reste le premier point d’appel, celui qui permet d’évoquer rapidement le diagnostic.
Un enjeu autour du diagnostic clinique
Avant les tests génétiques, le diagnostic repose sur l’observation clinique. Un spécialiste scrute le tonus musculaire chez le nouveau-né et ses réflexes. Souvent, on parle de « nourrisson hypotonique » : le bébé semble mou, ses membres retombent sans résistance.
Mais cette évaluation est subjective, car elle varie selon les praticiens, en plus d’intervenir trop souvent bien tard alors que les signes ont déjà largement progressé.
Le vrai défi est donc là : la fenêtre thérapeutique est étroite.
Notre approche : filmer pour analyser
Notre étude a porté sur 25 nourrissons hospitalisés en réanimation pédiatrique : 5 ayant une SMA confirmée génétiquement et 20 témoins avec un examen neurologique normal. Nous avons utilisé la vision par ordinateur pour analyser les mouvements spontanés des nourrissons. Le principe est simple : le nourrisson repose sur un fond uni pendant qu’une caméra classique le filme durant soixante secondes ; un algorithme d’intelligence artificielle analyse ensuite cette vidéo image par image.
Concrètement, cette étude repose sur un pipeline d’analyse vidéo en trois étapes, comme le montre la figure 1.
Le système reconstruit d’abord un « squelette numérique » du nourrisson, sous forme de douze points articulaires, huit segments correspondant aux membres, et quatre angles de mouvement (estimation de la pose), grâce à une méthode d’estimation de la pose humaine en temps réel appelée Alpha Pose.
À partir de ce squelette animé sont calculés des centaines de paramètres (amplitude des gestes, profondeur des mouvements, symétrie, fréquence…). Au total, 108 caractéristiques ont été extraites. Nous avons ensuite entraîné un algorithme d’apprentissage supervisé (de type XGBoost) capable de distinguer une motricité typique d’une motricité altérée, caractéristique de l’amyotrophie spinale.
Des résultats prometteurs
Les résultats sont encourageants : l’algorithme a classifié correctement les deux groupes avec une précision de 97 %.
En tête des paramètres les plus discriminants, on trouve la profondeur des mouvements, autrement dit la capacité du nourrisson à déplacer ses membres dans l’espace. Les bébés atteints de SMA présentent une différence significative de motricité dans l’axe de la profondeur avec une sensibilité de détection supérieure à 97 %. L’outil développé le mesure avec rigueur, transformant une impression visuelle en données objectives. Ce que l’œil du clinicien perçoit intuitivement, l’algorithme le quantifie avec précision.
Pour rendre la décision de l’IA explicable, et donc utilisable en pratique clinique, nous avons utilisé une méthode mathématique appelée Shapley Additive Explanations (SHAP), qui permet de visualiser les paramètres qui ont le plus pesé dans chaque décision de l’algorithme.
Un outil pour d’autres maladies provoquant une hypotonie chez le nourrisson
Notre étude a été menée avant 2025, à une époque où aucun dépistage systématique n’existait encore en France. Depuis, la SMA a été intégrée au programme national de dépistage néonatal, ce qui confirme rétrospectivement l’urgence qui motivait notre étude.
Mais au-delà de la SMA, de nombreuses autres maladies provoquent une hypotonie chez le nourrisson sans qu’aucun outil d’évaluation rapide n’existe. C’est vers cette direction que nos travaux se poursuivent. Cet outil ne cherche pas à remplacer le médecin, mais à lui donner, en quelques minutes et sans équipement spécialisé, un premier signal objectif pour orienter son diagnostic.
L’intelligence artificielle ne fait pas de miracle, mais elle peut rendre visible ce qui est difficile à percevoir à l’œil nu. Son apport devient précieux quand chaque semaine compte pour un nourrisson.
Le mécénat scientifique d’AXA fait désormais partie du Fonds Axa pour le progrès humain, qui regroupe les engagements philanthropiques du Groupe et des mutuelles d’assurances Axa dans les domaines de la science, de la nature, de la solidarité et de la culture. Avant 2025, ce mécénat scientifique global était assuré par le Fonds Axa pour la recherche, qui a soutenu plus de 750 projets à travers le monde depuis sa création en 2007. Pour en savoir plus, rendez-vous sur Fonds Axa pour le progrès humain.
Imen Trabelsi a reçu des financements du fonds AXA.
François Jouen a reçu des financements du fonds AXA.
Jean Bergounioux a reçu des financements du fonds AXA.
Sous-titrée « Sur la protection de la personne humaine à l’ère de l’intelligence artificielle », l’encyclique (lettre solennelle du pape adressée à l’ensemble de l’Église catholique) « Magnifica Humanitas », premier texte de ce type publié par Léon XIV depuis qu’il a accédé au fauteuil de saint Pierre, est un document fondateur. Non seulement pour ses réflexions sur l’IA, mais aussi pour ses prises de position sur diverses questions politiques et sociales actuelles de première importance.
L’e
Sous-titrée « Sur la protection de la personne humaine à l’ère de l’intelligence artificielle », l’encyclique (lettre solennelle du pape adressée à l’ensemble de l’Église catholique) « Magnifica Humanitas », premier texte de ce type publié par Léon XIV depuis qu’il a accédé au fauteuil de saint Pierre, est un document fondateur. Non seulement pour ses réflexions sur l’IA, mais aussi pour ses prises de position sur diverses questions politiques et sociales actuelles de première importance.
Ces deux textes s’inscrivaient dans le cadre d’un magistère global et prolongeaient la doctrine sociale de l’Église catholique, qui entend ne pas séparer la sphère spirituelle de la sphère temporelle en investissant le terrain de l’action politique et sociale.
« Magnifica Humanitas » s’impose d’ores et déjà comme une étape majeure. Publiée quelques semaines après la passe d’armes ayant opposé Donald Trump et son vice-président J. D. Vance au pape Léon XIV, elle apparaît, à bien des égards, comme une critique fondamentale des versions les plus modernes de la puissance – et donc de l’évolution actuelle du pouvoir aux États-Unis.
Un texte en écho à une encyclique fameuse de Léon XIII
« Rerum Novarum » avait été un moment fondateur de la doctrine sociale de l’Église ; « Magnifica Humanitas » entend donc se placer au même niveau que ce texte de la fin du XIXᵉ siècle qui, face aux déchirures sociales causées par la condition ouvrière de l’époque – époque déjà marquée par les interrogations relatives à l’impact des évolutions techniques sur la société –, positionnait l’Église comme actrice sociale et politique.
Dans « Magnifica Humanitas », la mise en avant des principes du « bien commun » et de la « destination universelle des biens » constitue un rappel à l’ordre visant à condamner les tendances à la concentration industrielle en matière de technologies digitales et d’algorithmes, une situation qui produit de nouvelles formes d’exclusion.
Mais ce n’est pas la seule référence : Léon XIV prend également en exemple l’action du pape Pie XII (1939-1958) pour rappeler qu’il est indispensable de défendre les syndicats et les corps intermédiaires, fonctions nécessaires à l’équilibre sociétal.
Par ailleurs, à de nombreux endroits, le texte défend l’État de droit et la démocratie, et souligne que l’économie de marché ne doit pas se déployer au détriment de la solidarité.
De même, les différentes mentions de la question migratoire, guidées par les concepts de justice sociale et de fraternité, apparaissent comme une prise de position nette contre les tendances de rejet et de traitement policier à l’œuvre dans les contextes européen et états-unien.
La nécessaire régulation de l’IA
Dès l’introduction, le sujet de l’intelligence artificielle est abordé de front. L’encyclique pose le constat de la dangerosité d’un paradigme techno-démocratique dans lequel des technologies jugées plus efficaces exercent de facto un contrôle déterministe sur les choix personnels et sociaux. « Magnifica Humanitas » approfondit l’analyse critique d’une intelligence artificielle définie comme moralement non neutre.
Pour faire face à ces risques avérés, l’encyclique défend les instruments juridiques et, partant, l’État de droit, appelant à une régulation renforcée. Elle prône également de « désarmer l’IA », c’est-à-dire d’empêcher que celle-ci ne contrôle l’humain, un concept qui pourrait même se prolonger par des formes d’interdiction, comme le suggèrent les mises en garde sur la dangerosité des technologies numériques pour la formation psychologique des enfants.
Cet ensemble de considérations sur l’IA reprend et systématise les réflexions apparues depuis quelques années au Vatican. Par exemple, l’Académie pontificale pour la vie avait organisé, en février 2020, le lancement de la plateforme Rome Call for AI Ethics, un appel à promouvoir une intelligence artificielle respectueuse de la dignité humaine signé par IBM, Microsoft, l’Organisation des Nations unies pour l’alimentation et l’agriculture (FAO) et le gouvernement italien.
Ces réflexions ont depuis progressé, tant au sein des différentes instances vaticanes que des institutions italiennes, dans une forme de symbiose romaine où a émergé le concept d’« algor-éthique », proposé par l’universitaire franciscain Paolo Benanti. Benanti promeut une régulation éthique des algorithmes, sans exclure que, au-delà de certains niveaux de dangerosité, on puisse interdire ou limiter leur usage, comme dans le cas des systèmes militaires.
Une Église résolument impliquée dans les affaires du monde
Fait significatif : la demande de pardon formulée dans l’encyclique pour la condamnation tardive de l’esclavage par l’Église catholique (en 1888) sonne comme un manifeste politique. Par cette repentance, Léon XIV renforce l’image d’une Église ouverte et capable d’autocritique et donne l’exemple aux États ou auxforces politiques qui se cloisonnent dans des récits historiques nationaux en occultant les erreurs passées.
Cette reconnaissance de culpabilité permet de renforcer la légitimité de la dénonciation des nouvelles formes de colonisation ou d’esclavage présentes dans les chaînes de production technologique (notamment l’extraction de terres rares, indispensables à la fabrication des appareils) et de l’utilisation de l’IA par des réseaux criminels, notamment pour la traite des êtres humains.
Le pape introduit une évaluation éthique et morale pour rejeter cette vision de l’inéluctabilité d’une guerre permanente, qu’il qualifie de « Mal ». Mais il le fait aussi en appelant les intellectuels et les responsables à ne pas se contenter de cette lecture simpliste et univoque, pour produire une appréhension du monde plus nuancée, sans pour autant basculer dans un idéalisme béat. Le concept de « sain réalisme » adopté par le pape invite à la recherche d’une voie de progrès qui, tout en acceptant le constat réaliste, privilégie la conciliation pacifique comme scénario d’amélioration.
Léon face à Donald
Cette encyclique apparaît donc comme un texte charnière, par lequel le magistère de l’Église catholique entend se projeter dans une série de stratégies concrètes. La défense globale de la doctrine sociale de l’Église se présente comme le socle à partir duquel sont formulées des critiques qui appellent immédiatement une confrontation avec le modèle de puissance technologique, capitaliste et militaire dont les États-Unis de la présidence Trump apparaissent comme un archétype.
La présence aux côtés du pape d’un des fondateurs d’Anthropic Christopher Olah, lors de la conférence de presse de présentation de l’encyclique, illustre la volonté de mobiliser différentes communautés dans le cadre d’une stratégie globale qui se positionne également à l’échelon des États-Unis, en cherchant à peser sur le débat interne. Ce texte dessine par ailleurs les contours d’une défense de la social-démocratie, matérialisant ainsi une volonté de peser sur un débat européen marqué par la progression des formations souverainistes.
Le pape Léon XIV, d’origine américaine, prend ainsi pied dans le débat politique mondial en définissant les coordonnées d’une action politique réformatrice – un dessein qui n’est pas sans rappeler celui de Jean-Paul II dans le contexte de la fin de la guerre froide.
Jean-Pierre Darnis ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
La course à l’IA engagée à l’échelle internationale ne doit pas se traduire par un détricotage des règles préservant nos ressources naturelles.
Qui n’a pas déjà expérimenté la désagréable sensation de surchauffe de son téléphone portable ou de son ordinateur lors d’une utilisation prolongée ou lorsque vous avez ouvert trop d’onglets sur votre navigateur ?
Imaginez maintenant la chaleur dégagée par 100 000 puces de calcul de dernière génération, entassées les unes sur les autres et tournant à
La course à l’IA engagée à l’échelle internationale ne doit pas se traduire par un détricotage des règles préservant nos ressources naturelles.
Qui n’a pas déjà expérimenté la désagréable sensation de surchauffe de son téléphone portable ou de son ordinateur lors d’une utilisation prolongée ou lorsque vous avez ouvert trop d’onglets sur votre navigateur ?
Imaginez maintenant la chaleur dégagée par 100 000 puces de calcul de dernière génération, entassées les unes sur les autres et tournant à plein régime, et ce, dans un complexe de plus de 26 kilomètres carrés soit environ 3 714 terrains de football. Placez ce grille-pain géant dans une région où la température est de 35 degrés en moyenne et peut atteindre les 50 °C l’été, et vous voilà devant le projet « Stargate UAE » visant à construire jusqu’à 5 gigawatts de puissance de calcul installée dans un immense centre de données à Abu Dhabi.
Ces projets de centres de données dits « hyperscale » visant à alimenter l’essor de l’intelligence artificielle (IA) se multiplient dans le monde, que ce soit aux États-Unis avec le projet Prometheus de Meta prévoyant la construction d’un centre de données de la taille de Manhattan, et même en France avec le « Campus IA ».
Au-delà de leur importante consommation énergétique, ces mastodontes soulèvent d’autres problèmes. Pour fonctionner correctement, ils ne peuvent pas atteindre des températures trop élevées, et contiennent donc des systèmes de refroidissement qui permettent aux composants électroniques de fonctionner à plein régime tout en évitant qu’ils ne se détériorent sous la chaleur qu’ils dégagent.
Comment ces centres de données sont-ils refroidis ? Quel est l’impact de leur refroidissement sur l’environnement, et comment les rendre plus sobres ?
Centres de données, refroidissement et consommation en eau
Il existe plusieurs techniques pour refroidir un centre de données. Pour le résumer simplement, les systèmes de refroidissement reposaient auparavant exclusivement sur des systèmes de ventilation (comme dans votre ordinateur) ou de climatisation (comme dans votre voiture) qui utilisent la circulation de l’air comme source de fraîcheur et rejettent l’air chaud à l’extérieur.
Une deuxième solution de refroidissement utilise l’eau, beaucoup plus efficace que l’air pour transférer la chaleur. Celle-ci permet de rafraîchir des plaques placées proches des composants électroniques, et/ou de rafraîchir l’air ventilé dans l’entrepôt de données.
Dans le premier cas (la climatisation), l’opérateur a besoin de beaucoup d’énergie pour faire tourner les pompes et systèmes de ventilation. Dans le deuxième (le refroidissement liquide), l’entreprise a besoin de moins d’énergie mais nécessitera l’accès à une source d’eau douce (l’eau salée endommagerait les tuyaux et composants) afin d’alimenter son système en eau fraîche.
Les opérateurs de centres de données sont donc face à un arbitrage complexe : doivent-ils utiliser des systèmes de climatisation énergivores ou bien du refroidissement liquide qui, cette fois, nécessite la consommation d’importantes ressources en eau ?
Toutefois, il faut avoir à l’esprit que les besoins en eau des data centers ne sont pas uniquement liés aux systèmes de refroidissement. Pour obtenir une vision globale de l’impact du développement de ces infrastructures sur les ressources en eau, il convient de prendre également en compte l’eau utilisée par les centrales électriques qui les alimentent, ainsi que l’eau consommée lors du processus de fabrication des composants électroniques. Des chercheurs estiment ainsi que les mégacentres de données construits spécifiquement pour les besoins de calcul de l’IA utilisent, en moyenne, jusqu’à 20 millions de litres d’eau par jour, soit autant qu’une ville de 10 000 à 50 000 habitants.
Peut-on rendre les centres de données moins gourmands en eau ?
Il existe des solutions innovantes pour limiter cette consommation et rendre les systèmes de refroidissement plus efficients. Des entreprises, comme OVH Cloud, Nvidia ou Nebius, développent et déploient de nouvelles architectures de systèmes de refroidissement liquide au plus proche des puces de calcul. Ces nouvelles techniques permettent de réduire, selon les chiffres annoncés, jusqu’à 50 % de la consommation en eau. Toutefois, elles restent encore onéreuses à mettre en œuvre et assez peu développées sur le parc existant.
De manière plus générale, la principale source de perte en eau lors du fonctionnement des centres de données vient du fait qu’ils reposent aujourd’hui pour la plupart sur des circuits ouverts, conduisant à l’évaporation d’une grande partie de l’eau utilisée. C’est pourquoi les nouveaux centres de données devraient idéalement reposer, autant que possible, sur des systèmes de refroidissement en circuit fermé, évitant ce phénomène d’évaporation. Néanmoins, ce type de refroidissement peut s’avérer plus cher, conduit souvent à une hausse du besoin en électricité, et n’est pas évident à mettre en œuvre dans tous les centres de données « historiques » qui n’ont pas été conçus pour le mettre en œuvre.
Des propositions plus farfelues sont aussi avancées, telles que l’envoi de data centers dans l’espace ou bien en immersion dans les océans. Néanmoins, l’apport réel de ces propositions reste encore largement débattu, que ce soit pour des questions de faisabilité technique (bon courage pour réaliser la maintenance de votre centre de données sous-marin !) ou de bénéfices en termes d’émission de CO₂ par rapport à un centre construit sur terre – le cabinet de conseil en décarbonation, Carbone 4, fondé par Alain Grandjean et Jean-Marc Jancovici a, à cet égard, montré que les data centers spatiaux risquaient d’avoir un impact carbone plus important que sur terre en raison des émissions liées au lancement.
Pour un développement raisonné des centres de données, conscient du caractère fini des ressources naturelles
Au-delà de la faisabilité technique, ces discours risquent de nous détourner du vrai problème : le développement massif de centres de données hyperscale très gourmands en eau, dont une bonne partie dans des territoires où cette ressource se fait rare et conduit à des conflits d’usage.
Ce développement ne se fait pas dans un vide juridique. Les règles du droit de l’environnement, de l’aménagement du territoire et de l’urbanisme prévoient un certain nombre de régimes d’autorisation et d’évaluation environnementale en amont de la construction de ces projets, notamment en France avec le régime des installations classées pour la protection de l’environnement (ICPE).
Néanmoins, la course à l’IA engagée à l’échelle internationale conduit les pays à rivaliser d’ingéniosité pour attirer les investisseurs quitte, parfois, à assouplir les contraintes réglementaires comme c’est le cas actuellement en France avec la loi dite de simplification de la vie économique récemment adoptée. Il est urgent de prêter attention à l’ode à la « simplification », qui provient des discours politiques au sein de l’Union européenne et transcrite dans la politique menée par la Commission européenne, mais qui ne doivent pas se traduire par un détricotage des règles préservant nos ressources naturelles.
Plus généralement, ces débats soulèvent la question de l’usage : alors que certaines économistes parlent de « bulle de l’IA », qui peut réellement prédire quels seront les véritables usages futurs de ces infrastructures ?
Dans les années 1960, il fallait un bâtiment entier pour faire tenir un ordinateur, ils tiennent aujourd’hui dans notre smartphone. Si les IA de demain tiennent aussi sur nos terminaux, doit-on réellement sacrifier nos ressources naturelles pour créer ces mastodontes ?
Un modèle d’IA peut être très performant dans un cadre contrôlé, mais se dégrader lorsque les données qu’il reçoit en conditions réelles ne ressemblent plus exactement aux données sur lesquelles il a été conçu, validé ou récemment mis à jour.
Ainsi, lorsque la mise à jour du modèle est faite naïvement, on peut être confronté au problème de l’« oubli catastrophique » : le modèle a progressé sur les données récentes, mais perd brutalement en performance sur les données plus anciennes. Ce sont pré
Un modèle d’IA peut être très performant dans un cadre contrôlé, mais se dégrader lorsque les données qu’il reçoit en conditions réelles ne ressemblent plus exactement aux données sur lesquelles il a été conçu, validé ou récemment mis à jour.
Ainsi, lorsque la mise à jour du modèle est faite naïvement, on peut être confronté au problème de l’« oubli catastrophique » : le modèle a progressé sur les données récentes, mais perd brutalement en performance sur les données plus anciennes. Ce sont précisément ces difficultés qui motivent le développement de l’« apprentissage continu ».
Dans l’apprentissage automatique « classique », on entraîne un réseau de neurones sur un très grand ensemble de données, puis on l’utilise tel quel. Mais ce cadre devient insuffisant lorsque les données arrivent au fil du temps, par exemple dans le cas de données météo, à l’arrivée de nouveaux patients dont la démographie ou la génération évolue, ou encore avec de nouvelles pratiques professionnelles.
Un système de Google Health destiné à automatiser le dépistage de la rétinopathie diabétique (l’ensemble des maladies de la rétine dues à la détérioration des vaisseaux rétiniens par le diabète) était prometteur lors d’évaluations contrôlées. En clinique, en revanche, il a rencontré des difficultés : sur 1 838 images traitées pendant les six premiers mois d’usage dans onze cliniques en Thaïlande, 393 (21 %) n’atteignaient pas le seuil de qualité requis.
Cet exemple ne signifie pas que la rétinopathie diabétique aurait changé en quelques mois. Il montre plutôt que les données vues par le système en clinique peuvent différer fortement de celles utilisées lors de son développement : qualité variable des images, différences de caméras, luminosité, reflets, patients plus difficiles à photographier, contraintes de temps et organisation du dépistage.
Autrement dit, la distribution des données change lorsque l’on passe d’un cadre contrôlé à un environnement réel. C’est précisément ce type de décalage qui rend insuffisant un modèle figé et qui pose la question suivante : comment adapter le modèle à ces nouvelles conditions sans perdre ce qu’il savait déjà faire ?
Les méthodes les plus simples conceptuellement, par exemple un réentraînement complet sur toutes les données, incluant les nouvelles, exigent beaucoup de calculs et sont donc peu réalistes.
Le continual learning, ou apprentissage continu, vise justement à faire évoluer le modèle au rythme du flux de données : s’adapter, intégrer de l’information nouvelle et apprendre des tâches successives, sans repartir systématiquement de zéro. Il se distingue d’un simple réentraînement périodique par une contrainte essentielle : apprendre le nouveau sans détruire l’ancien.
Au fond, l’apprentissage continu cherche un compromis entre deux exigences opposées] : la plasticité, nécessaire pour apprendre du nouveau, et la stabilité, indispensable pour ne pas effacer l’ancien.
Pourquoi les modèles d’IA oublient-ils ?
La difficulté vient du fait qu’un réseau de neurones n’a pas une mémoire rangée en dossiers indépendants. Les mêmes paramètres – les mêmes neurones et les mêmes connexions – servent souvent à plusieurs tâches.
Si les tâches se ressemblent, cette mutualisation est utile : le modèle peut réutiliser des représentations déjà apprises. Mais si les tâches diffèrent, les mises à jour nécessaires à la nouvelle tâche entrent en concurrence avec ce qui faisait la réussite des anciennes.
Prenons un exemple simple. Un modèle industriel a appris à détecter des défauts sur des pièces métalliques à partir d’images prises avec une première caméra. Plus tard, l’usine remplace la caméra : la résolution, la luminosité et les reflets changent. Si l’on réentraîne le modèle uniquement avec les nouvelles images, il peut s’adapter au nouveau capteur, mais perdre en performance sur les images produites par l’ancien système. Ce n’est pas parce que les anciens défauts ont disparu ; c’est parce que les paramètres qui les reconnaissaient ont été modifiés pour résoudre le nouveau problème.
En production, les incidents publiés sont plus souvent décrits comme des « décalages de données » que comme de l’oubli catastrophique. Les deux problèmes restent liés : dès qu’un modèle est mis à jour avec des données récentes, il faut éviter d’effacer des compétences antérieures.
Une étude récente menée sur des modèles d’IA utilisés à l’hôpital illustre bien cette difficulté. Les chercheurs ont supervisé un système chargé d’estimer le risque de décès de patients hospitalisés. Avec le temps, les dossiers reçus par ce système ont changé : les patients n’étaient plus exactement les mêmes, certaines mesures médicales variaient, et les pratiques hospitalières ont été bouleversées, en particulier pendant le Covid-19.
Le problème n’est donc pas qu’un dossier isolé serait anormal. C’est l’ensemble des données qui se transforme peu à peu. Pour rester utile, le modèle doit alors être mis à jour avec des exemples plus récents. Dans l’étude, cette mise à jour permettait effectivement de meilleurs résultats qu’un modèle laissé tel quel. Mais il y a un risque : si on laisse le système « apprendre » trop sur les données récentes, le modèle peut se spécialiser et devenir très bon sur les cas nouveaux, tout en perdant une partie de ses capacités sur les cas plus anciens. Il s’adapte au présent, mais au prix d’un oubli du passé. C’est ce qu’on appelle l’« oubli catastrophique ».
Pour intégrer des informations nouvelles sans sacrifier ce qui a déjà été appris, plusieurs grandes familles de méthodes existent : rejouer une partie du passé, protéger certains paramètres, modifier l’architecture du modèle ou apprendre des représentations plus stables.
Garder en mémoire des exemples représentatifs
La première, assez intuitive, consiste à rejouer le passé. C’est le « replay » : on conserve une petite mémoire d’exemples représentatifs des tâches antérieures et l’on entraîne le modèle sur un mélange « nouvelles données + mémoire ». C’est une forme de révision : le modèle ne relit pas tout le manuel, mais revoit quelques pages bien choisies.
Dans un système de reconnaissance d’images qui apprend progressivement de nouvelles catégories, on peut garder quelques images typiques de chaque ancienne classe, mais aussi des cas ambigus proches des frontières entre classes. Des méthodes comme iCaRL ont popularisé cette idée : apprendre de nouvelles classes tout en gardant un petit ensemble d’exemples représentatifs des anciennes.
Lorsque stocker des données réelles est difficile – pour des raisons de confidentialité, de coût ou de stockage – on peut recourir à un modèle génératif. Entraîné sur le passé, ce modèle produit des exemples artificiels des anciennes tâches, qui jouent le rôle de « souvenirs » synthétiques. Cette stratégie, appelée generative replay, peut réduire le besoin de conserver les données originales.
Mais ces données synthétiques ne sont pas automatiquement équivalentes aux données initiales. Elles peuvent manquer de diversité, négliger les cas rares, amplifier certains biais ou produire des exemples plausibles mais trompeurs. Il faut donc les valider : vérifier qu’elles couvrent les anciennes classes, préservent les cas difficiles et maintiennent les performances sur des jeux de test indépendants.
Les travaux récents sur l’entraînement répété à partir de données synthétiques montrent aussi un risque d’« effondrement » du modèle : à force d’apprendre sur des données synthétiques, il peut perdre des informations sur la vraie distribution, surtout sur ses parties « rares ».
Toute la question est donc de décider quoi conserver (ou générer) lorsque l’on a un budget restreint : des exemples typiques, rares, difficiles, ou un mélange des trois.
Une deuxième famille de méthodes vise non pas à conserver des exemples, mais à protéger certaines parties du modèle. L’idée est d’identifier les poids déterminants pour les tâches passées, puis d’ajouter une pénalité lorsqu’ils changent trop pendant l’apprentissage d’une nouvelle tâche. Le modèle peut continuer à apprendre, mais il paie un « coût » plus élevé lorsqu’il modifie des paramètres jugés importants pour ses compétences anciennes.
C’est le principe de méthodes comme Elastic Weight Consolidation : ralentir l’apprentissage sur les poids importants pour les tâches déjà vues, afin de réduire l’oubli.
Une approche voisine, mais différente, consiste à préserver le comportement de l’ancien modèle plutôt que ses poids. On ajoute alors un terme de coût qui encourage le modèle mis à jour à produire des sorties proches de celles de l’ancien modèle sur des données de référence. C’est le principe de la « distillation » : l’ancien modèle joue le rôle de professeur, et le nouveau apprend la nouvelle tâche sans trop s’éloigner des réponses du professeur. La méthode Learning without Forgetting repose sur cette logique, même lorsque les données initiales ne sont plus disponibles.
La différence est donc la suivante : la régularisation des poids demande de « ne pas trop déplacer ces réglages internes », tandis que la distillation demande de « garder un comportement proche de l’ancien modèle ». Dans les deux cas, on peut parfois limiter l’oubli sans stocker toutes les données passées.
Leur limite est le compromis imposé : si l’on protège trop le modèle, il devient moins plastique et apprend moins bien la nouvelle tâche. Dans l’exemple du changement de caméra, protéger les anciens paramètres peut aider à reconnaître les défauts déjà connus, mais une protection trop forte empêchera le modèle de s’adapter à la nouvelle luminosité ou à la nouvelle résolution.
Superposer à l’ancien modèle de nouvelles couches de neurones qui apprennent des nouvelles données
Une troisième stratégie consiste à éviter de faire tenir tous les apprentissages dans les mêmes paramètres. Plutôt que de modifier sans cesse le même réseau, on peut réserver des « espaces » distincts à différentes tâches.
Certaines approches figent les parties du réseau déjà apprises et ajoutent, pour chaque nouvelle tâche, de nouveaux modules reliés aux précédents. Les réseaux progressifs, par exemple, ajoutent de nouvelles colonnes de neurones tout en réutilisant les connaissances acquises par des connexions latérales. Le modèle bénéficie ainsi de l’expérience accumulée sans risquer de la dégrader.
D’autres méthodes apprennent à n’activer qu’une partie des paramètres selon la tâche ou le contexte. On peut imaginer le modèle comme un réseau routier : au lieu de faire passer toutes les tâches par la même route, il apprend quels chemins internes utiliser pour chaque situation. Les approches par masques d’attention ou par sélection de sous-réseaux suivent cette logique.
Enfin, lorsque la nouvelle tâche est trop éloignée des précédentes, on peut agrandir le modèle en lui ajoutant des neurones ou des modules. Des méthodes comme PackNet exploitent par exemple les redondances d’un grand réseau pour libérer puis réserver des paramètres à de nouvelles tâches.
Ces stratégies réduisent sensiblement l’oubli, mais elles ont un coût : le modèle peut grossir au fil du temps, et il faut parfois savoir, au moment de l’usage, quelle partie du réseau mobiliser. Dans certains cas, cette information est disponible — par exemple si l’on sait quelle tâche est demandée. Dans d’autres, le modèle doit aussi apprendre à reconnaître le contexte.
Apprendre des représentations plus stables
Une piste complémentaire consiste à agir plus en amont : il ne s’agit pas seulement de protéger le modèle ou de lui ajouter des modules, mais de lui apprendre des représentations internes plus stables.
Une représentation interne, ou embedding, est la description numérique qu’une couche intermédiaire fabrique à partir d’une donnée. Une image, un texte ou un signal de capteur est transformé en un vecteur de nombres qui résume certaines caractéristiques utiles : formes, textures, mots, régularités, anomalies. Si deux données se ressemblent, on aimerait que leurs représentations soient proches ; si elles correspondent à des classes différentes, on aimerait qu’elles soient bien séparées.
L’objectif est alors d’organiser cet espace de représentation de façon à ce qu’il change le moins possible lorsque de nouvelles tâches arrivent. On peut conserver quelques prototypes — des représentants typiques d’une classe — qui servent d’ancrages. On peut aussi utiliser des méthodes contrastives, qui rapprochent les exemples semblables et éloignent les exemples différents dans l’espace des représentations. Ces méthodes sont utiles parce qu’elles tendent à extraire des caractéristiques plus générales, donc moins dépendantes d’un contexte particulier.
On peut également pratiquer un replay en espace latent : au lieu de stocker les données brutes, on mémorise les activations produites par une couche intermédiaire du réseau. Cette stratégie peut réduire fortement le coût en mémoire et en calcul. Elle ne résout toutefois pas automatiquement toutes les questions de confidentialité : une représentation interne peut encore contenir des informations sensibles !
Combiner plusieurs mécanismes pour éviter les oublis catastrophiques
Dans les systèmes les plus efficaces, ces idées ne sont pas utilisées isolément. On combine fréquemment plusieurs mécanismes : un petit tampon de replay avec une régularisation des poids, du replay avec de la distillation, ou encore des représentations stables avec une architecture modulaire.
Le choix dépend des contraintes concrètes : budget mémoire, exigences de confidentialité, coût de calcul, vitesse d’adaptation attendue, criticité de l’application. Dans les domaines sensibles, comme la santé, l’apprentissage continu ne doit pas signifier qu’un modèle se modifie sans contrôle. Il doit s’accompagner d’une surveillance de la dérive des données, d’évaluations régulières, de garde-fous et d’une possibilité de revenir à une version antérieure du modèle.
L’apprentissage continu ne promet donc pas une IA qui apprendrait indéfiniment sans risque. Il propose plutôt une manière plus réaliste de maintenir des modèles utiles dans un monde qui change : apprendre du présent, sans effacer trop vite le passé.
Eric Moulines ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
L’intelligence artificielle (IA) est souvent présentée comme un outil d’amélioration de la gestion des risques bancaires. Toutefois, notre analyse des banques de la zone euro met en évidence un effet ambigu : si l’IA renforce certains indicateurs de liquidité, elle est aussi associée à une hausse des prêts non performants, suggérant une augmentation des vulnérabilités bancaires.
Comment en sommes-nous arrivés là ?
Le secteur bancaire européen vit une révolution silencieuse. Derrière les écrans
L’intelligence artificielle (IA) est souvent présentée comme un outil d’amélioration de la gestion des risques bancaires. Toutefois, notre analyse des banques de la zone euro met en évidence un effet ambigu : si l’IA renforce certains indicateurs de liquidité, elle est aussi associée à une hausse des prêts non performants, suggérant une augmentation des vulnérabilités bancaires.
Comment en sommes-nous arrivés là ?
Le secteur bancaire européen vit une révolution silencieuse. Derrière les écrans, des algorithmes remplacent désormais les analystes pour décider, en quelques secondes, si un crédit est accordé ou non. Cette transformation n’est plus une option, elle est devenue un moteur central de la compétitivité. Pourtant, cette course à l’efficacité suscite des inquiétudes au plus haut sommet.
Dès septembre 2024, Christine Lagarde, présidente de la Banque centrale européenne (BCE), alertait sur les risques systémiques liés à ces technologies, notamment lors d’un discours devant le Comité européen du risque systémique. Si l’essor de la fintech est bien documenté, l’usage réel de l’IA dans les grandes banques reste difficile à mesurer.
Dans ce contexte, nous analysons les rapports financiers trimestriels des huit principales banques systémiques de la zone euro entre 2020 et 2025. En quantifiant la fréquence du vocabulaire lié à l’intelligence artificielle, nous avons construit un indicateur permettant d’estimer son usage réel dans chaque banque, puis de le comparer à leur niveau de risque.
Pourquoi ce résultat est-il important ?
Nos résultats révèlent un paradoxe dans l’usage de l’IA par les banques étudiées. Si ces technologies améliorent la gestion de la liquidité, elles peuvent être associées à une dégradation de la qualité des crédits.
Nous observons qu’une hausse de l’usage de l’IA est associée à une augmentation de 7 points de pourcentage du ratio de couverture de liquidité et à une hausse de 0,35 point de pourcentage du ratio de prêts non performants, soit près de 14 % de son niveau moyen.
Ce constat suggère que si l’automatisation optimise les processus financiers, elle peut aussi encourager une prise de risque accrue ou affaiblir la sélection des emprunteurs. Ce fait s’explique par la manière dont l’IA transforme l’évaluation du risque. Les algorithmes s’appuient principalement sur des données quantitatives, faciles à standardiser et à traiter automatiquement, mais peinent à intégrer des informations plus qualitatives, comme le contexte spécifique d’un emprunteur, souvent difficiles à formaliser. Cela peut conduire à valider des dossiers en apparence solides, mais plus fragiles en pratique.
Au final, l’intelligence artificielle peut améliorer la performance du secteur bancaire, tout en contribuant à sa fragilité.
Quelle suite à cette recherche ?
Au-delà du secteur bancaire, cette dynamique pourrait avoir des répercussions négatives sur l’économie réelle. En effet, l’accumulation de prêts non performants associée à l’usage de l’IA pourrait entraîner un durcissement des conditions de financement du secteur privé, pénalisant ainsi la demande globale. Ces résultats ouvrent ainsi des enjeux importants pour la régulation. Bien que l’Union européenne encadre déjà ces pratiques avec l’AI Act, en classant le scoring de crédit parmi les activités à haut risque, ce cadre reste encore largement centré sur les risques individuels.
Or, l’enjeu des prochaines années sera d’intégrer plus pleinement les risques collectifs liés à l’usage généralisé d’algorithmes similaires, notamment en termes de comportements convergents et de vulnérabilités systémiques. Il devient donc essentiel de rendre les algorithmes plus explicables et transparents afin que le régulateur puisse superviser les décisions de crédit prises.
De même, il faudra tester le comportement de ces IA en situation de crise, à travers des stress-tests algorithmiques, comme cela existe déjà pour la solidité financière des banques. L’objectif serait de révéler des vulnérabilités invisibles en période normale et d’anticiper des réactions amplifiées en cas de choc.
Enfin, l’automatisation ne peut pas remplacer entièrement le jugement humain, en particulier lorsqu’il s’agit d’évaluer des situations complexes. Sans cela, une technologie conçue pour maîtriser le risque pourrait devenir un vecteur silencieux d’instabilité financière.
Tout savoir en trois minutes sur des résultats récents de recherches, commentés et contextualisés par les chercheuses et les chercheurs qui les ont menées, c’est le principe de nos « Research Briefs ». Un format à retrouver ici.
Hamdi Jbir ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
En janvier 2026, OpenAI a lancé, aux États-Unis, ChatGPT Santé. Ce logiciel est principalement destiné aux patients pour les aider à mieux comprendre et à gérer leurs informations de santé. Il peut aussi être utilisé par les médecins afin de faciliter l’accès aux données médicales et d’améliorer le suivi des patients.
Avec une telle utilisation par les médecins et les patients, la protection des patients – que ce soit leur santé ou leurs données – et la préservation du secret médical dépendent
En janvier 2026, OpenAI a lancé, aux États-Unis, ChatGPT Santé. Ce logiciel est principalement destiné aux patients pour les aider à mieux comprendre et à gérer leurs informations de santé. Il peut aussi être utilisé par les médecins afin de faciliter l’accès aux données médicales et d’améliorer le suivi des patients.
Avec une telle utilisation par les médecins et les patients, la protection des patients – que ce soit leur santé ou leurs données – et la préservation du secret médical dépendent des barrières techniques mises en place.
En pratique, ChatGPT Santé permet d’interpréter des résultats d’analyses, de suivre l’évolution de certains indicateurs, de préparer des rendez-vous médicaux ou encore d’obtenir des explications personnalisées à partir de données de santé.
Pour les patients, c’est un outil d’assistance informationnelle visant à les accompagner dans leur parcours de soins, sans se substituer aux professionnels de santé. Pour ces professionnels, ChatGPT peut servir d’aide au diagnostic.
Dans les deux cas, sa légitimité dépend d’un équilibre délicat : il s’agit de transformer des dossiers médicaux éparpillés en une aide au diagnostic fiable, tout en protégeant la vie privée des patients.
En effet, les données de santé, considérées comme sensibles, sont soumises à des réglementations bien précises. Leur confidentialité est essentielle pour garantir le respect du secret médical et limiter les risques d’utilisation abusive. En effet, un accès non consenti par des assureurs ou des banques pourrait entraîner des refus de couverture, des hausses de primes ou des refus de crédit fondés sur l’état de santé d’un individu.
Pour pouvoir garantir la confidentialité des données de santé transmises et traitées par ChatGPT Santé (ou d’autres systèmes équivalents), il faut résoudre des défis techniques majeurs : sécuriser les flux de données, garantir l’anonymisation dans un environnement massivement interconnecté, à la fois lors de la collecte de données, de l’entraînement du modèle et de son utilisation.
Fiabilité algorithmique et risque d’hallucination clinique
En tout premier lieu, la protection du patient repose sur la justesse des informations fournies par l’IA aux utilisateurs, patients comme médecins.
Le phénomène d’hallucination, inhérent aux architectures de type Large Language Model (LLM), prend une dimension critique en milieu clinique : une erreur de conversion d’unité ou une confusion posologique (par exemple, 5 milligrammes contre 50 milligrammes) peut engager le pronostic vital.
Pour neutraliser ce biais, OpenAI déploie des « mécanismes d’ancrage » (grounding) par l’intermédiaire de référentiels tels que HealthBench, un benchmark de 150 000 ressources validées par des pairs. Ce processus transforme l’IA en un moteur de synthèse documentaire où chaque affirmation est corrélée à une source vérifiable (DOI d’études, portails hospitaliers), ce qui permet aux patients de mieux comprendre les résultats de leurs analyses avec un jargon moins technique.
Pour les professionnels de santé, cet ancrage rend l’outil plus fiable, car il repose dès lors sur le concept de garantie humaine : l’interface ne se substitue jamais au décideur final (le médecin, quand il s’agit de poser un diagnostic), mais agit comme un médiateur d’informations dont la traçabilité permet au praticien de valider systématiquement la suggestion du modèle.
Retrouvez notre vidéo basée sur cet article
Sécuriser les flux de communication
L’architecture de ChatGPT Santé repose sur une organisation claire des différents éléments : les phases de calcul (à distance ou en local) afin de permettre la collecte des données, l’entraînement du modèle et son utilisation ; mais aussi les flux d’information entre différents terminaux (smartphones, laboratoires d’analyses, hôpitaux, data centers, etc.).
La circulation des données est gérée par la plateforme B.Well Connected Health. Cette infrastructure agit comme une interface consacrée au domaine médical, permettant de faire communiquer entre elles différentes sources de données même si elles sont très différentes.
Elle permet ainsi d’harmoniser des données variées, comme celles issues d’applications personnelles (Apple Health, MyFitnessPal) ou celles provenant des dossiers médicaux hospitaliers. En vérifiant que chaque donnée correspond bien au bon patient, et en garantissant que les données respectent les normes et règles en vigueur, la plateforme assure un flux de données déterministe ou associé à un seul utilisateur pour la phase d’inférence du LLM (c’est-à-dire son utilisation grâce à des prompts). L’ensemble de cette chaîne de traitement s’opère dans un environnement maintenu en isolation totale vis-à-vis du réseau public.
Contrairement à l’interface standard de ChatGPT, les informations cliniques des patients sont exclues du processus d’entraînement global du modèle de langage : elles ne modifient jamais les poids synaptiques du réseau de neurones global de ChatGPT. Ces données personnelles sont stockées uniquement dans un espace de recherche spécifique à chaque utilisateur, ce qui garantit que les informations sensibles restent séparées du modèle et de son évolution ultérieure.
De plus, l’architecture de ChatGPT Santé s’appuie sur la méthode RAG (Retrieval-Augmented Generation) : au lieu de mémoriser l’historique médical, le modèle consulte, lors de chaque requête, une base de données privée et isolée. Contrairement à une mémorisation classique, où un modèle pourrait intégrer et retenir directement des informations sensibles dans ses paramètres, ce mécanisme limite le risque que ces données soient apprises ou réutilisées involontairement par le modèle.
Cependant, ces vecteurs restent temporairement stockés sur les serveurs d’OpenAI, notamment pour des raisons de modération, jusqu’à trente jours. Cette conservation, même limitée, représente un point de vulnérabilité potentiel, car elle expose les données à un risque résiduel d’accès non autorisé.
Anonymiser les données pour éviter l’identification des patients
La protection des données dans ChatGPT Santé doit garantir que la nature des informations traitées ne permette pas l’identification du patient.
La première technique de « dés-identification » mise en place par OpenAI est bien sûr de retirer les identifiants directs, par exemple les noms de patients. Mais ceci n’élimine pas le risque de réidentification par corrélation de métadonnées, rendant l’anonymat vulnérable. En effet, une récente étude a démontré que le croisement de seulement trois points de données (une pathologie rare, une géolocalisation précise et un historique de fréquence cardiaque issu d’un wearable) permet une réidentification dans plus de 80 % des cas. Par sa capacité de corrélation, l’IA peut en effet lier des informations anonymes pour isoler un profil unique.
Pour neutraliser ce risque, ChatGPT Santé pourrait se reposer sur la « confidentialité différentielle », qui consiste à ajouter une petite perturbation aléatoire aux données afin qu’aucune analyse ne puisse être rattachée avec certitude à un individu.
L’efficacité du système dépend de la gestion de ce compromis entre bruit et confidentialité : un niveau de confidentialité trop élevé sacrifie l’utilité clinique des informations (qui sont trop bruitées pour être utiles), alors qu’un bruit insuffisant fragilise le secret médical face à la puissance d’analyse croisée des systèmes d’IA.
Garder les données confidentielles lors de la phase d’utilisation du LLM
Si ChatGPT Santé s’appuie sur un chiffrement de bout en bout pour sécuriser les flux de communication, le véritable défi réside dans la protection des données en cours d’utilisation, lors de la phase dite d’« inférence ».
En effet, l’architecture des modèles de type transformer impose à ce jour au système de déchiffrer l’information pour opérer ses calculs d’inférence. Cela implique que, même de manière fugitive, les données de santé résident en clair dans la mémoire vive (RAM) des serveurs de calcul, constituant un point de vulnérabilité face à des vecteurs d’attaque de type « extraction de mémoire ».
L’avenir de la confidentialité des données de santé repose sur des techniques de chiffrement avancées, notamment le chiffrement homomorphe. Cette approche permet d’effectuer des calculs directement sur des données chiffrées, sans avoir besoin de les déchiffrer au préalable. Autrement dit, il est possible de traiter les données tout en les gardant protégées, ce qui garantit que leur contenu reste inaccessible, même pendant leur utilisation.
Pour l’instant, OpenAI adopte une approche hybride : l’utilisation de serveurs spécifiques sur Microsoft Azure doit permettre de garder les données séparées des données des autres utilisateurs (ou celles d’autres applications que ChatGPT Santé). Cette organisation crée un environnement proche d’un système interne (également appelé « sur site »), même s’il repose sur le cloud. Elle permet de mieux protéger les échanges de données, mais n’élimine pas totalement les risques d’exposition temporaire lors de leur traitement.
Le conflit de souveraineté : les données françaises face aux lois états-uniennes
Enfin, le déploiement de ChatGPT Santé en Europe poserait un défi de souveraineté majeur.
En effet, en France, la législation impose l’hébergement des données cliniques chez des prestataires certifiés « Hébergeurs de données de santé ». Bien que Microsoft Azure dispose de centres de données certifiés en France (France Central), le calcul intensif requis par l’IA nécessite des processeurs ultrapuissants qui consomment énormément d’énergie. Pour des raisons de disponibilité électrique, ces moteurs de calcul sont souvent situés dans des fermes de serveurs hors de l’Union européenne.
Or, ce déport de la donnée vers des serveurs états-uniens déclenche l’application du Cloud Act, une loi qui permet aux autorités des États-Unis d’exiger l’accès aux informations gérées par une entreprise états-unienne, indépendamment de leur lieu de stockage physique.
Ce cadre entre en collision directe avec le règlement général sur la protection des données (RGPD) européen, créant un conflit de lois où la protection européenne s’effacerait devant les prérogatives de sécurité américaines.
Nesrine Kaaniche ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
Depuis la médiatisation de ChatGPT, les annonces se sont multipliées concernant l’intelligence artificielle, chaque géant du numérique développant sa solution. En apparence, il s’agit d’une concurrence féroce entre des groupes rivaux. La réalité pourrait être bien plus nuancée. Les concurrents ne cherchent peut-être pas tant à dominer les autres qu’à devenir des briques indispensables aux succès de leurs concurrents.
De prime abord, la concurrence dans l’intelligence artificielle (IA) générat
Depuis la médiatisation de ChatGPT, les annonces se sont multipliées concernant l’intelligence artificielle, chaque géant du numérique développant sa solution. En apparence, il s’agit d’une concurrence féroce entre des groupes rivaux. La réalité pourrait être bien plus nuancée. Les concurrents ne cherchent peut-être pas tant à dominer les autres qu’à devenir des briques indispensables aux succès de leurs concurrents.
De prime abord, la concurrence dans l’intelligence artificielle (IA) générative ressemble à une bataille économique classique : Google contre Meta, Meta contre Anthropic, OpenAI contre Google… Cette approche succincte a l’avantage de la simplicité, mais elle a également le défaut de masquer ce qui fait la singularité de ce secteur.
La concurrence sur ce marché ne prend pas seulement la forme d’une confrontation directe et la course à l’innovation. Elle passe aussi par la capacité à rendre les adversaires dépendants de soi.
Cœur de la concurrence
Pendant des années, du moins au cours de l’émergence de l’IA et des premières années de sa croissance, le cœur de la concurrence dans ce secteur a semblé évident. Sur ce marché – pour s’imposer – il fallait disposer du meilleur assistant IA, soit un programme informatique conçu pour comprendre les demandes humaines, les traiter et leur répondre, de manière plus ou moins naturelle. Mais cette lecture devient moins suffisante aujourd’hui.
Le Stanford AI Index 2025 indique que près de 90 % des modèles dits « courants » d’assistants IA de 2024 proviennent du secteur privé, contre 60 % en 2023, tandis que le milieu universitaire reste la principale source de recherche. Et surtout que les écarts de performance entre les meilleurs modèles se resserrent de manière progressive : l’écart entre le premier et le dixième est tombé de 11,9 % à 5,4 % en un an, tandis que les deux premiers ne sont plus séparés que par 0,7 point.
Autrement dit, lorsque les modèles deviennent techniquement plus proches, la seule supériorité du modèle devient moins discriminante. Dès lors, l’avantage concurrentiel tend à se déplacer : il va moins au seul producteur du modèle qu’à celui qui contrôle les actifs complémentaires (Adner, 2017, Teece, 1986).
C’est ce qui rend dans cet esprit la stratégie de Microsoft particulièrement judicieuse. Avec Azure, Microsoft ne propose pas seulement ses propres offres ou celles d’OpenAI, la plateforme met également à disposition des usagers les modèles d’Anthropic, de Cohere, de DeepSeek, de HuggingFace, de Mistral, de Meta ou de Nvidia. L’enjeu stratégique paraît clair : Microsoft peut gagner même si le modèle qui s’impose n’est pas exclusivement le sien. Son pouvoir tiendrait alors moins à la supériorité d’un modèle particulier qu’à sa position d’intermédiaire.
Amazon suit une logique comparable avec Amazon Bedrock, qui permet d’accéder aux modèles proposés par Anthropic, DeepSeek, Meta, Mistral, OpenAI, Qwen, Stability AI et d’autres entreprises. Là encore, le succès de la stratégie ne provient pas seulement de la possession d’un modèle, mais également de l’organisation de l’accès à plusieurs modèles concurrents. Dans un tel système, un acteur peut monétiser la rivalité de ses propres adversaires, c’est-à-dire utiliser l’affrontement entre ses concurrents comme opportunité pour générer des revenus. Le marché devient dans cette veine moins un marché de produits qu’un marché de points d’entrée.
Cette logique n’est pas entièrement inédite. Elle prolonge un mécanisme déjà observé dans d’autres industries de plateforme : les app stores, les marketplaces ou les écosystèmes logiciels.
Ce qui semble toutefois plus spécifique à l’IA générative tient au fait que la concurrence ne porte pas seulement sur le contrôle de l’accès aux modèles concurrents, mais aussi sur la maîtrise des actifs complémentaires qui permettent de convertir leurs performances techniques en solutions utilisables par les clients : infrastructures cloud, puissances de calcul, semi-conducteurs spécialisés, canaux de distribution, données propriétaires, interfaces d’intégration et écosystèmes logiciels.
Devenir indispensable, même pour ses adversaires
Anthropic offre dans cette perspective un bon exemple de cette concurrence inédite. D’un côté, l’entreprise se mesure frontalement à OpenAI et à Google sur les modèles d’assistants d’IA. De l’autre, elle s’appuie sur plusieurs couches technologiques qui ne lui appartiennent pas entièrement. LeMaGit rapportait, le 22 novembre 2024, que l’entreprise utilise des AWS Trainium, des TPU conçus par Google et des GPU Nvidia (« puces » spécialisées pour l’intelligence artificielle, conçues pour entraîner et faire fonctionner des modèles plus rapidement que des processeurs classiques) afin de développer et mettre en œuvre Claude (un assistant d’IA, similaire à ChatGPT, créé par l’entreprise Anthropic).
Être concurrent, ici, ne signifie donc pas s’émanciper des autres, s’éloigner d’eux ; cela laisse entendre, le plus souvent, l’apprentissage de la répartition de ses dépendances.
Oligopoles et interdépendance
La relation entre Microsoft et OpenAI illustre une autre variante de cette logique. Dans leur déclaration commune du 27 février 2026, les deux firmes soulignent que leur partenariat a été conçu pour leur laisser « de l’espace [afin de]… poursuivre de nouvelles opportunités de manière indépendante », tout en continuant de collaborer. Cette phrase résume bien la structure du secteur : l’indépendance proclamée n’abolit pas l’interdépendance ; elle s’y superpose. Nous sommes ainsi loin de la quête de l’indépendance sur les marchés oligopolistiques, comme le soulignait naguère l’économiste Alain Cotta.
Dans l’IA générative, nous ne sommes pas non plus dans une coopétition au sens de Brandenburger et Nalebuff (1996), mais dans une dynamique concurrentielle dans laquelle une firme cherche à accroître sa puissance non seulement en surpassant ses rivales, mais en devenant également indispensable à leur fonctionnement. Il ne s’agit donc pas uniquement de préserver son autonomie face aux rivaux, mais de construire des positions telles que cette autonomie devient elle-même relative, parce que médiatisée par des actifs contrôlés par d’autres.
Demain n’est pas un autre jour
La dynamique concurrentielle relative à l’IA se distingue par un autre trait : elle est de plus en plus un affrontement de « préemption » (Ian McMillan, 1983). Les acteurs ne se battent pas seulement pour vendre aujourd’hui ; ils préparent déjà les conditions de leur puissance de demain.
Le quotidien économique belge l’Écho a révélé, il y a quelques jours, que Broadcom a signé avec Google un accord de long terme pour co-développer et fournir ses puces IA jusqu’en 2031. Quelques jours plus tard, Reuters indiquait que Meta avait renforcé son partenariat avec CoreWeave par un nouvel accord de 21 milliards de dollars (plus de 18 milliards d’euros), venant s’ajouter à un précédent contrat de 14,2 milliards (soit 12,2 milliards d’euros), le tout courant jusqu’en décembre 2032. L’enjeu est loin d’être anecdotique ; ces accords donnent accès à de la capacité cloud future et, pour Meta, aux futures « puces » Vera-Rubin de NvidiaviaCoreWeave.
Nous saisissons alors, à partir de ces exemples, pourquoi la concurrence dans l’IA générative ne ressemble pas vraiment à une guerre de marché classique. Dans beaucoup de secteurs, la victoire reposerait sur l’évincement, temporaire ou définitif, du rival. Ici, elle consiste souvent à devenir l’infrastructure, l’intermédiaire ou le fournisseur dont l’adversaire ne peut pas aisément se passer. Le pouvoir se déplace, dans cette perspective, vers le contrôle des « points de passage » : l’accès aux utilisateurs, la capacité de calcul, l’hébergement, les plateformes d’intégration, les « puces ».
Et les régulateurs ?
Cette structure de marché explique parallèlement pourquoi les autorités de concurrence regardent désormais au-delà des seuls modèles économiques de chaque entreprise. Le 24 mars 2026, Reuters rapportait que Teresa Ribera, commissaire européenne à la concurrence, élargissait sa vigilance à l’ensemble de la « pile » IA : les modèles économiques proprement dits, les données d’entraînement (informations utilisées pour apprendre à un modèle de machine learning à faire des prédictions, à reconnaître des schémas ou à générer du contenu) et l’infrastructure cloud.
Ce déplacement du regard est somme toute logique. Si le pouvoir de marché réside désormais dans les dépendances organisées, il ne suffit plus alors de se contenter d’observer qui produit le meilleur assistant IA. Il faut nécessairement regarder qui contrôle les points de passage incontournables du secteur. La bonne question ne consiste peut-être plus à identifier celui qui gagnera à terme la course à l’IA. La question la plus juste serait : qui réussira à se rendre indispensable aux autres ?
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

 Connexion