❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierLinuxFr.org : les dépêches
  • ✇LinuxFr.org : les dépêches
  • Le Frido 2026 est disponible
    Le Frido est un livre libre (licence FDL) de mathématique qui reprend l’ensemble de la mathématique depuis la construction des entiers jusqu’à tout ce qu’on peut placer à l’agrégation : probabilités, distributions, anneaux, groupes, géométrique, etc. lien nᵒ 1 : Ma page perso sur le Fridolien nᵒ 2 : Achat du premier volumelien nᵒ 3 : Les sources LaTeXSommaire Tout en un Nouveautés 2026 Cauchy-Lipschitz analytique Groupe symétrique Problèmes d’ordre Partition de l’unité Neutralité en moyenne In

Le Frido 2026 est disponible

Le Frido est un livre libre (licence FDL) de mathématique qui reprend l’ensemble de la mathématique depuis la construction des entiers jusqu’à tout ce qu’on peut placer à l’agrégation : probabilités, distributions, anneaux, groupes, géométrique, etc.

Sommaire

Tout en un

Une particularité du Frido est d’être «tout en un». Un seul livre (PDF de 3000 pages) qui contient toutes les matières : algèbres, analyse, probabilités, etc.

L’intérêt est de pouvoir citer les théorèmes d’algèbre linéaire utilisé en analyse, de mesure utilisée en probabilité, etc.

Un enchaînement particulièrement long et interdisciplinaire est la chose suivante.

  1. Définir une rotation comme composée de deux symétries axiales.
  2. Définir les fonctions trigonométriques par leurs séries.
  3. Définir les applications linéaires et leurs matrices associées.

À partir de là, montrer que la matrice d’une rotation a la forme qu’elle a avec ses fonctions trigonométriques.

Nouveautés 2026

Cauchy-Lipschitz analytique

Le gros morceau de cette année est le théorème Cauchy-Lipschitz analytique en passant par Cauchy-Lipschitz holomorphe. Je suis convaincu qu’on peut faire sans passer par les fonctions holomorphes. En cherchant le label THOooZEBOooQJOSQj dans le PDF, vous trouverez une démonstration quasiment complète sans passer par les fonctions holomorphes. À mon avis le bout qu’il manque est juste un peu de combinatoire qui m’échappe. Si vous connaissez des choses à ce propos, n’hésitez pas à répondre à l’une ou l’autre de ces questions qui sont (je crois) équivalentes :

https://math.stackexchange.com/questions/5111835/analytic-map-on-the-banach-x-times-y
https://math.stackexchange.com/questions/5113042/analytic-picard-lindel%C3%B6f-theorem

Note : j’ai déjà demandé à de l’IA sans succès (mais c’était il y a quelque mois). Je n’ai rien contre une démonstration générée par IA, mais comme je l’explique ici, j’ai quelque chose contre « j’ai demandé à l’IA et voici le résultat ». Si vous me proposez une démonstration par IA, soyez sûrs de la comprendre d’un bout à l’autre dans tous les détails. Sinon, ça ne me sert à rien. Quand les IA font des fautes, c’est toujours subtil — et on ne les découvre que via une lecture très attentive de chaque ligne.

Groupe symétrique

Démonstration de la décomposition en cycles des éléments du groupe symétrique.

Problèmes d’ordre

L’ordre des chapitres dans le Frido est l’ordre logique mathématique, et non l’ordre pédagogique. Les théorèmes se démontrent uniquement avec des théorèmes démontrés plus haut. Du point de vue de \LaTeX, les \ref pointent toujours vers des \label plus haut. C’est une grosse contrainte.

Quelques exemples de dépendances qui m’ont fait déplacer des parties cette année ?

En théorie des groupes, la formule des classes demande les rationnels, les rationnels sont le corps des fractions, donc demande les anneaux.

Le symbole de sommation demande de savoir la décomposition en cycles des permutations (groupe symétrique) pour montrer que la somme ne change pas si on change l’ordre de sommation; la décomposition en cycles demande le théorème de Lagrange qui demande les rationnels et donc les anneaux. Les anneaux demandent le symbole de sommation pour écrire le terme général d’un idéal engendré par une partie.

Il faut donc découper la partie sur les anneaux en plusieurs parties. Quant au symbole de sommation, sa définition est découpée en plusieurs parties en fonction du niveau de généralité.

Tout cela pour dire que le Frido n’est pas arrangé par ordre pédagogique et encore moins par ordre de difficulté. Le principal déterminant à l’ordre et au découpage des chapitres est l’impossibilité de faire des références vers le bas.

Avant 2026, j’étais parvenu à mettre la construction des entiers, rationnels et réels dans le même chapitre avec seulement ce qu’il fallait d’anneaux pour dire que les rationnels sont le corps des fractions des entiers. Maintenant que je me suis rendu compte des boucles de dépendances dont je parle plus haut (parce que j’ai démontré la décomposition en cycles), j’ai décomposé en plus de chapitres.

  • entiers relatifs (les naturels sont admis)
  • groupes
  • anneaux
  • rationnels et réels

Partition de l’unité

Il y avait trop d’énoncés différents sans démonstration. Il reste maintenant deux théorèmes : un qui donne une partition de l’unité subordonnée à des ouverts et un autre spécifique dans le cas des compacts. Le deuxième est démontré; la démonstration du premier est dans mon interminable liste de choses à faire.

Neutralité en moyenne

Lorsque je dois écrire «La personne qui lit doit rester attentive», j’écris

\randomGender{Le lecteur}{La lectrice} doit rester \randomGender{attentif}{attentive}. 

avec la macro :

\newcounter{rndgendercont}
\newcommand{\randomGender}[2]{%
    \setcounter{rndgendercont}{%
        \numexpr\value{chapter}+\value{numtho}\relax%
    }%
    \ifthenelse{\isodd{\value{rndgendercont}}}{#1}{#2}%
}

En gros, ça donne masculin ou féminin au hasard. Plus précisément, ça donnera masculin si la somme entre le numéro du chapitre et le numéro du dernier théorème énoncé est pair et féminin si impair.

La nouveauté 2026 est de faire « chapitre+théorème ». Avant, je faisais « numéro de page+théorème », et j’ai eu des problèmes avec une phrase qui passait d’une page à une autre—et donc une incohérence entre deux appels à randomGender.

Indépendance de variables aléatoires

Définition de l’indépendance d’une famille quelconque d’évènements. Définition d’un \pi-système et lien avec l’indépendance de tribus.

Algèbre

… rien cette année. Étonnamment, cette année, aucun énoncé supplémentaire de la forme «Dans un anneau XXXX, tout élément/idéal YYYY est ZZZZ» n’a été démontré.

Pourtant je suis certain qu’il y en a encore plein qui manquent.

LaTeX et encodage

On a discuté de l’encodage des accents dans les URL.

L’objectif aurait été de faire fonctionner une macro \myurl permettant d’écrire

\myurl{https://fr.wikipedia.org/wiki/Idéal_premier}

Et franchement, ça n’a pas été un succès.

J’ai déjà fait des choses comme

\documentclass[a4paper,11pt]{book}
\usepackage[utf8]{inputenc}
\usepackage[T1]{fontenc}
\usepackage{hyperref}
\usepackage{xstring}

% Encode certains caractères UTF-8 pour l’URL
\newcommand{\MakeUTFPerCent}[1]{%
  \def\result{#1}%
  \StrSubstitute{\result}{é}{\%C3\%A9}[\result]%
  \StrSubstitute{\result}{à}{\%C3\%A0}[\result]%
  \StrSubstitute{\result}{è}{\%C3\%A8}[\result]%
  \StrSubstitute{\result}{_}{\%5F}[\result]%
}

% Macro finale
\newcommand{\myurl}[1]{%
  \MakeUTFPerCent{#1}%
  \href{\result}{#1}%
}

\begin{document}

Lien encodé : \myurl{https://fr.wikipedia.org/wiki/Idéal_premier}

\end{document}

Mais rien ne marche. Et j’en profite pour noter que chatGPT est nettement moins bon en LaTeX qu’en math ou en python.

luatex

Donc passage à LuaTeX, et ça a été assez facile.

  • temps de compilation plus long
  • texte raccourci : au moment du passage à LuaTeX je suis passé d’environ 3050 à 2775 pages.

Très peu de changements :

-\documentclass[a4paper,twoside,11pt]{book}
+\documentclass[french]{book}
+\RequirePackage{luatex85}      % Pour xy (voir https://tex.stackexchange.com/questions/328602/lualatex-and-xypic)

et

-\usepackage{listingsutf8}  
+\usepackage{listings}

Passage à 5 volumes

Comme à chaque mois de septembre, une version figée est commercialisée pour celles qui voudraient avoir du papier (et aussi parce que la dernière fois que j’ai lu le règlement de l’agrégation, la commercialisation était obligatoire).

Le nombre maximum de pages étant de 750 par volume, le nombre total de page étant de 2872, j’ai dû passer à 5 volumes. Et c’est là que je suis content d’avoir dès le départ, dans mes scripts, mis le nombre de volumes en variable.

Laurent est un pédant

Je suis un insupportable pédant. Et je propose même de fonder un club. Dans des discussions non mathématiques sur LinuxFr.org je suis parvenu à me fritter à propos (au moins) de l’utilisation correcte de

Le Frido aussi est un peu pédant par exemple si P est un polynôme, il est démontré que P(X)=P. On pourrait croire que c’est seulement une notation, mais non. C’est un théorème.

Le Frido démontre aussi que si on induit la topologie de \mathbb{R}^2 vers le cercle et qu’on construit la tribu de Lebesgue à partir de là (boréliens, complétion), on obtient la même tribu que si on induit directement la tribu de Lebesgue de \mathbb{R}^2 vers le cercle. C’est important pour prouver des isomorphismes d’espaces de Lebesgue L^2(S^1) avec L^2([0,2\pi[).

À part ça, le Frido est un pédant de notations. J’ai horreur des abus de notations, et je prétends que la formule d’Euler e^{i\pi}=-1 ne contient pas le nombre e.

L’Humanité

L’Humanité a publié un article sur le Frido. Encore un en 2027 et le Frido rentre dans des critères d’admissibilité de Wikipédia :).

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • L'art non contextuel
    Traduit de l’allemand ; publié à l’origine sur gnulinux.ch. Cet article présente le logiciel Context Free art, qui permet de « programmer » des images à l’aide de quelques commandes simples. Le contenu du site Context Free Art est sous licence Creative Commons Attribution-Share Alike 2.5 et le logiciel sous GPLv2. lien nᵒ 1 : Page du projetlien nᵒ 2 : Article original en allemandlien nᵒ 3 : GitHub context-freeSommaire Installation et utilisation Syntaxe Structure d’un fichier Context Fre

L'art non contextuel

Traduit de l’allemand ; publié à l’origine sur gnulinux.ch.

Cet article présente le logiciel Context Free art, qui permet de « programmer » des images à l’aide de quelques commandes simples.

Le contenu du site Context Free Art est sous licence Creative Commons Attribution-Share Alike 2.5 et le logiciel sous GPLv2.

Image d’une fractale dessinée avec Context Free art

Sommaire

Installation et utilisation

Sous Ubuntu/Debian, on installe le programme avec sudo apt-get install contextfree. Pour les autres distributions, une notice d’installation est disponible sur le site du projet. On peut aussi utiliser Distrobox pour faire tourner Debian/Ubuntu dans un conteneur sous une autre distribution Linux.

Sous Windows, il existe une interface graphique. Sous Linux, en revanche, on exécute le programme dans le terminal avec cfdg fichier_entree.txt fichier_sortie.png.

Ma configuration sous Kubuntu ressemble à ceci :

  • En haut à gauche, un terminal dans lequel j’exécute cfdg fichier_entree.txt fichier_sortie.png pour générer l’image.
  • En bas à gauche, un éditeur avec le fichier texte à partir duquel l’image est générée.
  • À droite, j’ouvre l’image produite. J’utilise Okular pour cela, car il recharge automatiquement une image mise à jour.

Capture d’écran d’un bureau. En haut à gauche un terminal, en bas à gauche un éditeur de texte avec un fichier source Context Free ouvert, et à droite l’image de sortie correspondante : un cercle gris à droite d’un cercle noir

Avec un peu de « magie Linux », on peut sûrement faire en sorte que cfdg soit relancé automatiquement à chaque enregistrement du fichier, et ainsi se passer du terminal. Cela dit, la génération d’une image à partir du code peut être relativement longue ; il est donc parfois préférable de pouvoir initier et arrêter la génération manuellement.

Syntaxe

Une documentation détaillée du langage se trouve dans le wiki du projet. Nous avons déjà rencontré quelques éléments de syntaxe dans l’image ci-dessus :

startshape FORME // commence par la forme nommée « FORME »

shape FORME { // Quand tu dessines la forme FORME
CIRCLE []  // alors dessine un cercle
CIRCLE [x 1 brightness 0.5] // Dessine un cercle décalé horizontalement
                            // de 1 et de luminosité 0.5
}

Structure d’un fichier Context Free

  • Le fichier devrait toujours commencer par le choix d’une forme de départ : startshape NOM_FORME_DEPART. Cette forme doit ensuite être décrite.
  • La description d’une forme utilise la syntaxe shape NOM { … }, où les accolades contiennent une consigne de dessin.
  • Une consigne de dessin est une suite de formes (dans l’exemple ci-dessus, deux cercles CIRCLE), modifiées par les instructions placées entre crochets […].
  • Une modification se compose typiquement d’une commande (x ou brightness) suivie d’une ou de plusieurs valeurs numériques.

Formes de base et modifications

Les formes de base disponibles sont CIRCLE, SQUARE et TRIANGLE. Dans cet article, nous utiliserons quelques-unes des modifications suivantes (les points d’interrogation représentent des nombres à insérer) :

  • x ? pour un décalage horizontal vers la droite de ?. Une valeur négative décale vers la gauche. De façon analogue, y ? pour les décalages verticaux.
  • size ? pour mettre à l’échelle d’un facteur ?. Par exemple size 0.5 pour réduire de moitié la taille d’une forme.
  • rotate ? pour tourner une forme de ? degrés.
  • Pour les couleurs, le programme utilise l'espace colorimétrique TSV (teinte, saturation, valeur), aussi appelé HSB ou HSV en anglais. On contrôle ainsi la couleur avec hue ? (rotation à travers les couleurs du cercle chromatique), sat ? (saturation de la couleur) et brightness ? (luminosité).

Récursion

L’un des grands atouts de Context Free est qu’une forme peut dessiner une copie (éventuellement modifiée) d’elle-même. En informatique, ce procédé s’appelle la récursion. Voici un petit exemple :

startshape MAFORME

shape MAFORME {
SQUARE [brightness 1 sat 1] // Dessine un carré (pleinement saturé et lumineux)
MAFORME [x 1.1 rotate 20 size 0.99 hue 10] // Dessine une copie de toi-même (décalée,
                                            // tournée, réduite et de teinte modifiée)
}

Une spirale colorée composée de carrés de plus en plus petits

Lorsqu’on utilise la récursion, il faut faire un peu attention : en principe, le programme pourrait tourner indéfiniment et dessiner toujours plus de copies de la forme. Pour éviter cela, nous avons intégré ci-dessus une réduction de taille : lorsque les formes deviennent trop petites, Context Free interrompt le travail et cesse de les dessiner.

Hasard

Un autre atout de Context Free est qu’il permet d’effectuer des variations aléatoires sur les figures générées. Dans l’exemple suivant, le hasard est introduit de deux manières :

startshape FORET

shape FORET {
ARBRE []
ARBRE [x 50]
ARBRE [x 100]
}

shape ARBRE // À chaque dessin d’ARBRE, l’une des deux
            // règles (« rules ») est choisie au hasard (de façon pondérée).
rule 0.97 {
CIRCLE []
ARBRE [y 0.5 size 0.99 rotate (rand(-4,4))]
// Ici ARBRE est tourné d’une valeur aléatoire comprise entre -4 et 4
}

rule 0.03 {
ARBRE [rotate 20]
ARBRE [rotate -20]
}

Les nombres après rule sont des poids : dans 97 % des cas, l’arbre continue de pousser tout droit (première règle), et dans 3 % des cas seulement, il se divise en deux branches (seconde règle).

Trois silhouettes d’arbres différentes côte à côte

Et bien plus encore

Context Free possède de nombreuses autres fonctionnalités. Outre la documentation dans le wiki du projet, il existe aussi une galerie contenant de nombreuses images à la fois esthétiques et intrigantes.

Aspects mathématiques

Grammaires non contextuelles

Le programme s’appelle Context Free (« sans contexte ») parce que la syntaxe avec laquelle les images sont créées est une grammaire non contextuelle au sens des langages formels. Intuitivement, cela signifie que les consignes de dessin figurant dans le programme ne dépendent jamais de ce qui a déjà été dessiné autour. Par exemple, il n’y a aucun moyen de formuler quelque chose comme : « dessine un cercle s’il n’y a pas de cercle à proximité ».

Fractales

Grâce à la possibilité de faire de la récursion, Context Free est un excellent outil pour dessiner des fractales. Une fractale est une image dont les fragments ressemblent approximativement à l’image entière. En gros, si l’on n’observe qu’un petit morceau des arbres ci-dessus, il est difficile de savoir avec certitude si l’on se trouve sur le tronc de l’arbre, sur une branche ou sur une ramification. Dans la vie quotidienne, nous rencontrons régulièrement des fractales, par exemple au marché au rayon des légumes avec le chou romanesco. La galerie de Context Free contient de nombreuses fractales ; celle-ci m’a particulièrement plu (et elle a été créée avec le même code que la première image de cet article).

Commentaires : voir le flux Atom ouvrir dans le navigateur
  • ✇LinuxFr.org : les dépêches
  • De la fermeture des comptes inactifs depuis 3 ans
    En février 2023, nous avions décrit « les données à caractère personnel traitées, qu’elles soient ou non associées à un compte, le cycle de vie de ses données et le changement de politique concernant ce cycle de vie. » La règle a été mise en place au 28 juin 2023 (la date de dernière activité du compte ayant été mise en place au 31 mai 2023) : les comptes inactifs pendant trois ans sont fermés et les données conservées inutiles au service supprimées ; les comptes fermés depuis plus d’un an vo

De la fermeture des comptes inactifs depuis 3 ans

En février 2023, nous avions décrit « les données à caractère personnel traitées, qu’elles soient ou non associées à un compte, le cycle de vie de ses données et le changement de politique concernant ce cycle de vie. » La règle a été mise en place au 28 juin 2023 (la date de dernière activité du compte ayant été mise en place au 31 mai 2023) :

  • les comptes inactifs pendant trois ans sont fermés et les données conservées inutiles au service supprimées ;
  • les comptes fermés depuis plus d’un an voient les données associées inutiles au service supprimées (cf dépêche d'évaluation 1 an après en 2024)

Depuis trois ans, les comptes fermés (par la personne détenant le compte ou par l’équipe de modération sur les spams par exemple) voient donc leurs données minimisées. La nouveauté cette année était la fermeture des comptes inactifs depuis trois ans.

    Quelques chiffres pour donner une idée de l’évolution des comptes

    • un an, c’est 961 comptes ouverts (et 286 fermés depuis), entre le 01 octobre 2024 et le 30 septembre 2025 (basées sur les rétrospectives des quinzaines)
    • un an, c’est aussi 1607 tentatives de création de comptes, sur la même période (basé sur les identifiants en base de données), dont beaucoup ne sont visiblement jamais confirmés et donc jamais réellement ouverts (spam, erreur d’adresse, erreur sur le pseudo voulu, etc.)

    Application de la règle des 3 ans d’inactivité

    Regardons les statistiques conservées par archive.org du 11 avril dernier, soit avant l’échéance des trois ans d’inactivité du 31 mai dernier :

    • 53599 utilisatrices et utilisateurs ayant ou ayant eu des comptes (et encore présents en base de données)
    • 33150 comptes
    • 1384 comptes fermés

    Et comparons avec les statistiques au moment de l’écriture de la dépêche, en base de données on trouve :

    • 38847 utilisatrices et utilisateurs ayant ou ayant eu des comptes (et encore présents en base de données)
    • 18397 comptes
    • 12380 comptes fermés

    Il y a donc eu purge de plus de 14500 comptes et fermeture de plus de 10000 comptes au 31 mai 2026.

    Pourquoi certains comptes sont purgés ? Car ils n’avaient aucun contenu public ou commentaire public ou contribution à des contenus publics. Il peut s’agir de personnes n’ayant jamais rien eu à dire sur le site, de spammeurs n’ayant jamais réussi à publier quoi que soit, etc. La volumétrie est aussi due au stock puisque le traitement s’est appliqué à tous les comptes concernés depuis 1999 (année du plus vieux compte en base de données).

    Pourquoi certains comptes sont fermés ? Parce qu’ils restent associés un ou plusieurs contenus ou commentaires ou contributions publics. Les cas peuvent être multiples : la personne est décédée, la personne est passée à autre chose, la personne avait juste besoin de poser une question à un moment et n’est donc pas restée, la personne est depuis 3 ans en prison ou en orbite ou dans un sous-marin ou tout autre endroit hors-ligne, etc.

    Conséquences techniques ?

    Va-t-on réutiliser les identifiants libérés dans la base de données de comptes ? Il n’y a pas vraiment d’intérêt à le faire.

    A-t-on gagné sur le volume des sauvegardes ? La table des versions de dépêches pèse ~9 GiB pour ~430000 tuples, celle des commentaires ~3 GiB pour 2M de commentaires. La table des comptes n’est que la 11e plus volumineuse en base, avec 18 MiB. Donc non on ne gagne rien de significatif. Probablement moins que si on supprimait dès maintenant les encore présents en base 700 contenus non publics et 21900 commentaires non publics.

    Est-ce que tout le site va aller plus vite ? Non, ça ne va pas être perceptible sur les requêtes SQL.

    Quel serait le cas le plus favorable en termes de réduction des données ? L’anonymisation du compte et de tout ce qui est associé : cela supprime un compte bien sûr, mais ça permettait en théorie de fusionner des éditions de dépêches par exemple : si Anonyme, seul compte contributeur, a 82 éditions d’une même dépêche, alors des années après, on peut sans doute se contenter de ne garder que la première et la dernière édition par exemple (pour préserver dates et attribution). Et même si Anonyme a seulement les éditions 53 à 57 d’une dépêche, on pourrait faire de même sur cette partie contiguë.

    Aide sur le sujet

    P.S. : cette dépêche sera ma 500e dépêche publiée

    Commentaires : voir le flux Atom ouvrir dans le navigateur
    • ✇LinuxFr.org : les dépêches
    • Statistiques 2025 du site LinuxFr.org
      2025 est amené son lot de changements : un trafic en hausse principalement en raison des moteurs de recherche et d’IA et du spam, plus de contenus publiés mais moins de commentaires. Que cela ne nous empêche pas de revenir sur l’année passée, l’activité du site LinuxFr.org, les détails des changements en termes de trafic Web, de contenus créés, de commentaires déposés, de navigateurs utilisés, d’utilisation des fonctionnalités du site, de contribution au code, etc. Bref, quelles sont les tendanc

    Statistiques 2025 du site LinuxFr.org

    2025 est amené son lot de changements : un trafic en hausse principalement en raison des moteurs de recherche et d’IA et du spam, plus de contenus publiés mais moins de commentaires. Que cela ne nous empêche pas de revenir sur l’année passée, l’activité du site LinuxFr.org, les détails des changements en termes de trafic Web, de contenus créés, de commentaires déposés, de navigateurs utilisés, d’utilisation des fonctionnalités du site, de contribution au code, etc. Bref, quelles sont les tendances ?

    Le site rend accessible un grand nombre de statistiques (faites‑vous plaisir si vous souhaitez vous plonger dedans, c’est fait pour) ; cette dépêche résume les variations constatées en 2025.

    Nb: le podcast Projets Libres fournit aussi des statistiques publiques.

    Sommaire

    Statistiques Web

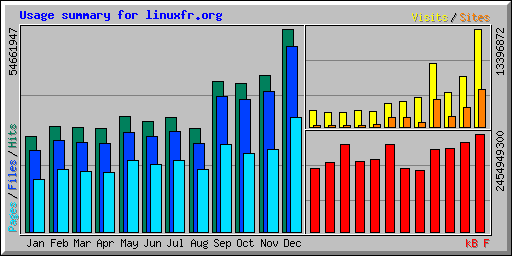
    La comparaison des statistiques annuelles (voir 2024 et 2025, les deux comportant des effets de bots bourrins visiblement) montre un quasi doublement des visites, hausse des consultations (pages, fichiers) et des hits (notamment l’effet des bots pour l’intelligence artificielle), avec un passage à ~996 000 hits par jour et ~149 800 visites par jour, le tout pour ~1,77 Tio par mois.

    Statistiques Web 2025

    Le nombre de contenus publiés en un an augmente de 10 %. Le nombre de commentaires publiés en un an diminue cette année de 3%.

    Trafic de LinuxFr.org normalisé, entre 2002 et 2025

    Contenus

    Au 31 décembre 2025, le site comportait environ 123 820 contenus publiés répartis ainsi :

    • 28 185 dépêches :
      • 386 dépêches publiées en 2025 (➡️, 383 en 2024),
      • la taille moyenne (en code Markdown, hors images donc) des dépêches a encore très nettement augmenté, battant le précédent record de 2019 ;
    • 40 701 journaux (↗️, 409 en 2024 et 460 en 2025),
    • 41 047 entrées de forums (↘️, 458 en 2024 et 406 en 2025),
    • 11 140 liens (↗️,2050 en hausse par rapport aux 1714 en 2024),
    • 475 sondages (10 en 2024 et 7 en 2025),
    • 159 pages de wiki (5 en 2024 et 2 en 2025).

    Pour la première année, le pic de publication des contenus se confirme le mercredi. Ce qui continue à différer désormais du pic de modération, voir la partie Modération plus bas).

    Un jour de semaine compte 64 % de publications en plus qu’un jour de week-end.

    La publication sous licence Creative Commons By-SA se fait par défaut depuis les dix ans de CC, fin 2012 pour les dépêches (permet explicitement une rédaction collaborative ou un renvoi en re‐rédaction) et les journaux (qui peuvent être convertis en dépêches) : tout naturellement, on retrouve 97 % de dépêches et 99 % des journaux sous cette licence au final (les autres étant notamment sous licence Art Libre ou autre, au choix de l’auteur).

    Les dépêches collaboratives (et pas uniquement celles réattribuées à l’utilisateur Collectif) sur de multiples sujets sont toujours à compter parmi les vraies réussites du site ; nous sommes cependant toujours à la recherche de volontaires pour couvrir les nombreux sujets qui n’ont pu être abordés. Une liste des thèmes récurrents sur LinuxFr.org peut donner des idées de participation : si une dépêche n’a pas été créée dans les temps, tout inscrit peut la démarrer dans l’espace de rédaction.

    Concernant la visibilité par contenu (analyse sur décembre 2023) : les journaux ont jusqu’à deux fois moins de visibilité que les dépêches (faites des dépêches…) et les liens ont beaucoup moins de visibilité que les journaux et les dépêches (préférez donc faire des dépêches ou des journaux, pour la visibilité).

    Modération

    Le temps moyen passé entre la création d’une dépêche (en rédaction ou directement envoyée en modération) et sa modération et publication est de 600 (!) heures (contre 309 h en 2023 et 337 h en 2024) ; la mesure du temps passé uniquement en modération n’est pas actuellement disponible (et la modération retient volontairement des dépêches non urgentes pour réguler la publication) ; le temps médian est descendu à 22 heures. Il y a des demandes de statistiques dans le suivi, envoyez les demandes d’intégration Git (pull‐requests). ;-)

    Le jour préféré de modération a priori des contenus est toujours le mardi pour les dépêches et le lundi pour les sondages.

    Commentaires

    Au 31 décembre 2025, le site comporte 1,97 million de commentaires. Le nombre de commentaires publiés en un an baisse cette année de 3 % pour arriver à 31 011.

    Il y a désormais, en moyenne, 24 commentaires par journal (29 en 2023 et 29 en 2024), 9 par dépêches (9 en 2023 et 9 en 2024), 47 par sondage (54 précédemment, mais très dépendant des sondages considérés), 9 par entrée de forum (7 en 2023 et 8 en 2024), 2 par entrée de suivi, 6 par lien (contre 7 en 2023 et 7 en 2024) et une poignée par page wiki.

    Le jour préféré pour commenter reste le mercredi, et un jour de semaine compte deux fois plus de commentaires qu’un jour de week-end.

    Notes

    Il n’y a (toujours) pas de statistiques disponibles concernant les notes. Les entrées de suivi sur les statistiques n’ont pas avancé.

    Néanmoins diverses statistiques concernant la notation sur les contenus et les commentaires ont été données en juin 2021, avec des graphes.

    Étiquettes (tags)

    Au 31 décembre 2025, le site comporte :

    • 16 502 étiquettes, dont 13 594 étiquettes publiques (contre 12 867 fin 2024) ;
    • 195 491 saisies d’étiquettes (étiquetées en moyenne treize fois pour les étiquettes publiques et cinq fois pour les étiquettes privées) ;
    • les étiquettes sont réparties ainsi par contenu :
      • 68 367 pour les dépêches,
      • 54 720 pour les journaux,
      • 31 732 pour les forums,
      • 38 903 pour les liens,
      • 835 pour les pages wiki,
      • 397 pour les sondages,
      • 537 pour le système de suivi des défauts et évolutions.

    Plus de détails dans la dépêche de février 2022 À propos des étiquettes sur le site LinuxFr.org.

    Depuis le début du site, on constate en moyenne 5 étiquettes par page wiki, 3,5 par lien, 2,4 par dépêche, 1,3 par journal, 0,8 par sondage, 0,8 par entrée de forum et 0,3 par entrée du suivi.

    Le jour préféré pour apposer des étiquettes est le lundi (biais de la création initiale des étiquettes), suivi du samedi.

    Il y a plusieurs biais concernant les étiquettes :

    • beaucoup ont été et sont ajoutées automatiquement ;
    • le thème mobile par défaut ne montre pas les étiquettes (sauf à basculer son Firefox en « Version ordinateur » ou équivalent sur un autre navigateur).

    Équipe de bénévoles

    Il y a actuellement 4 personnes pour l’administration du site, 11 pour la modération, 6 pour l’animation de l’espace de rédaction et 2 pour la maintenance qui font tourner ce site. Pour mémoire, il s’agit de bénévoles plus ou moins disponibles et donc absolument pas de 23 équivalents temps plein pour jargonner comme une entreprise. Merci pour le travail accompli.

    Code et développement

    Au 31 décembre 2025, le système de suivi de défauts et de demandes d’évolutions contient 285 entrées ouvertes (contre 269 en 2024). On voit assez rapidement un manque de développeurs apparaître. En 2025, il y a eu 34 entrées ouvertes (contre 54 en 2024) : 20 entrées encore ouvertes venant s’ajouter à celles datant d’avant, 12 corrigées et 2 déclarées invalides. On peut noter que ceux qui ouvrent le plus d’entrées sont des membres actuels ou anciens de l’équipe du site.

    C’est Bruno qui garde le record de correction d’entrées. Merci aussi à Adrien Dorsaz. Le temps moyen de résolution est de 164 jours (contre 166 précédemment). La moitié des entrées fermées ont été traitées en moins de sept jours. On ressent donc toujours un besoin de nouveaux contributeurs côté code.

    La charge moyenne sur le serveur est de 1,4 sur la machine actuelle (baptisée oups). La charge minimale a été de 0,8 et la maximale de 3,6.

    La consommation mémoire est restée stable (en dépit de la perte d’une barrette de mémoire). Le trafic réseau sur la partie Web uniquement est en croissance à 9,1 Mbit/s sortants.

    Comptes utilisateur

    Au 31 décembre 2025, sur les 53 375 comptes utilisateur valides existants, 2 215 ont été utilisés au cours des trois derniers mois, dont 31 % (-2) ont déjà rédigé des dépêches, 41 % (-4) des journaux, 42 % (-3) des entrées de forums, 10 % (-1) des entrées dans le système de suivi, 17 % des liens (=) et 2 % une page de wiki ; 80 % (-7) ont écrit des commentaires et 48 % (-4) étiqueté des contenus ; 32 % (-1) ont contribué sur au moins une dépêche ; 24 % (-3) des comptes actifs ont indiqué un site personnel, 8 % (=) un identifiant XMPP, 6 % (+1) une adresse Mastodon, 28 % (-1) un avatar et 6 % (=) une signature.

    Côté utilisation des fonctionnalités, 14 % (=) ont demandé à ne pas afficher les contenus avec une note négative, 8 % (-1) ont demandé le tri chronologique en page d’accueil, 5 % (-1) à ne pas voir les avatars, 4 % (-1) à afficher la tribune dans une boîte latérale et 3 % (=) à ne pas voir les signatures, et à peine quelques pourcents ont changé les contenus par défaut en page d’accueil (souvent pour retirer les sondages et ajouter les journaux). Peu de feuilles de style CSS du site sont utilisées : quatre visiteurs sur cinq utilisent celle par défaut ; il est facile d’en changer avec le lien Changer de style. En janvier 2024, il n’y avait pas de rupture générationnelle marquée entre les comptes 1999 et 2024 en termes d’utilisations des fonctionnalités.

    Seuls huit comptes ont un karma négatif et zéro ont un karma nul, soit 0 % des visiteurs actifs ; 18 % des comptes actifs durant les trois derniers mois ont été créés en 2025 (+8 points, avec probablement un biais dû aux spammeurs).

    32 % (+2) des visiteurs actifs ont une adresse de courriel GMail, 11 % (-1) chez Free, 3 % (-1) chez LaPoste, 3 % (=) chez Yahoo, 3 % (=) chez Hotmail ou Outlook et 2 % (=) chez Orange ou Wanadoo.

    Les visiteurs actifs ont des adresses XMPP chez jabber.fr, gmail.com, im.apinc.org, jabber.org, movim.eu et chapril.org notamment. Et des adresses Mastodon chez mastodon.social, piaille.fr, mamot.fr, framapiaf.org, pouet.chapril.org et mastodon.tetaneutral.net notamment.

    2025 correspond aussi au second anniversaire de la mise à place des nouvelles règles de pérennité des comptes LinuxFr.org et données à caractère personnel.

    Soucis divers

    Le compteur d’années sans mises en demeure reçues passe à quatre (après deux mises en demeure en 2019 et une en 2020, voir la dépêche sur la no 3 en attendant la publication d’informations sur les no 4 et 5). Mais un courriel d’avocat est néanmoins arrivé dans l’année 2025.

    / Only five formal notices in the default \
    \   install, in a heck of a long time!    /
     -----------------------------------------
       \
        \
            .--.            / Ouep...  \
           |o_o |           \ Euh coin /
           |:_/ |            ----------
          //   \ \              \ 
         (|     | )               \
        /'\_   _/`\                \ >()_
        \___)=(___/                   (__)__ _
    

    Depuis la création du site, statistiques liées au légal (dans les sens liés à la force publique ou à du juridique) :

    • cinq mises en demeure reçues (pour zéro assignation) ;
    • une réquisition judiciaire reçue (qui au final ne nous concernait pas, mais a donné l’occasion de discuter avec la police nationale) ;
    • un cas d’usurpation d’identité et de harcèlement type « revenge porn » (discussion avec la gendarmerie nationale).

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • SHM : des métriques d’usage pour applications self-hosted… sans espionner les utilisateurs
      Quand on développe et distribue des applications open-source auto-hébergées, il y a une question très simple à laquelle il est presque impossible de répondre : Combien d’instances actives de mon application sont réellement utilisées ? C’est exactement le problème que j’ai rencontré avec Ackify, une application open-source de preuve de lecture de documents (politiques internes, procédures, formations, etc.), déployée en self-hosted par ses utilisateurs - sans que j'ai le moindre contrôle de

    SHM : des métriques d’usage pour applications self-hosted… sans espionner les utilisateurs

    Quand on développe et distribue des applications open-source auto-hébergées, il y a une question très simple à laquelle il est presque impossible de répondre :

    Combien d’instances actives de mon application sont réellement utilisées ?

    SHM

    C’est exactement le problème que j’ai rencontré avec Ackify, une application open-source de preuve de lecture de documents (politiques internes, procédures, formations, etc.), déployée en self-hosted par ses utilisateurs - sans que j'ai le moindre contrôle dessus.

    Pas de SaaS, pas de compte centralisé, pas de tracking utilisateur.
    Résultat : zéro visibilité.

    👉 Combien d’instances Ackify tournent vraiment ?
    👉 Quelles versions sont encore actives ?
    👉 Quelles fonctionnalités sont utilisées (ou pas) ?

    C’est pour répondre à ce besoin très concret que j’ai créé SHM – Self-Hosted Metrics.

    SHM, c’est quoi ?

    SHM est un serveur de télémétrie privacy-first, conçu spécifiquement pour les applications self-hosted open-source.

    L’idée est simple :

    • chaque instance auto-hébergée envoie périodiquement un snapshot de métriques agrégées
    • aucune donnée utilisateur
    • aucun événement individuel
    • aucun tracking comportemental

    Juste ce qu’il faut pour comprendre l’usage réel d’un logiciel déployé “dans la nature”.


    Un point important : SHM est agnostique

    Contrairement à beaucoup d’outils existants, SHM n’impose aucun schéma.

    Tu envoies :

    {
      "documents_created": 123,
      "active_users": 42,
      "webhooks_sent": 9
    }

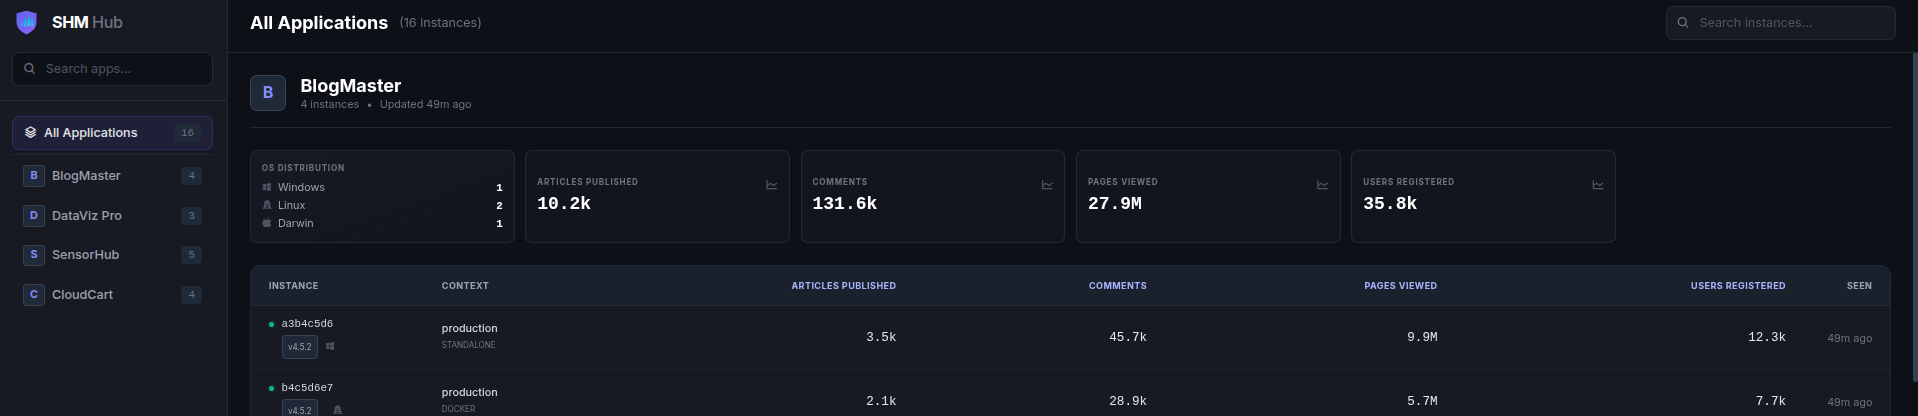
    ➡️ le dashboard s’adapte automatiquement :

    • nouvelles cartes KPI
    • nouvelles colonnes
    • graphiques générés dynamiquement

    Aucun frontend à recompiler, aucune migration à écrire.

    Dashboard Graph
    Dashboard Détail


    Un petit mot sur Ackify

    Ackify est l’application qui a déclenché tout ça :

    • open-source
    • self-hosted
    • preuve de lecture avec signature cryptographique
    • alternative légère à DocuSign pour des usages internes

    SHM est désormais utilisé pour répondre à des questions très simples :

    • combien d’instances actives ?
    • combien de documents créés ?
    • combien de signatures générées ?

    Projet open-source

    Le projet est encore très jeune (MVP), mais fonctionnel et déjà utilisé en conditions réelles.

    Les retours, critiques et idées sont évidemment bienvenus 🙂


    Stack technique (sobre et assumée)

    • Backend : Go (binaire unique, léger)
    • Stockage : PostgreSQL (JSONB)
    • Déploiement : Docker
    • Licence : AGPLv3 (SDK en MIT)
    • Auth des instances : Ed25519 (clé générée localement, signature des snapshots)

    Chaque instance :

    • génère une identité cryptographique locale
    • s’enregistre une seule fois
    • signe chaque envoi de métriques ➡️ impossible de spoof une instance existante.

    Et côté vie privée ?

    C’était non négociable.

    SHM :

    • ne collecte aucune donnée personnelle
    • ne collecte pas les IP (hors reverse-proxy)
    • ne collecte ni hostname, ni username
    • fonctionne sur des compteurs agrégés uniquement

    C’est au mainteneur du logiciel de décider quelles métriques exposer, et à l’utilisateur final de pouvoir désactiver la télémétrie.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Le Frido 2025
      Présentation Le Frido est un livre de mathématique libre initialement destiné à l'agrégation, mais devenu généraliste. En supposant connue une théorie intuitive des ensembles, ça va jusqu'aux martingales, distributions, extensions de corps, etc. Avec toutes les démonstration intermédiaires (modulo les 981 entrées restantes dans ma liste de choses à faire). Les résultats sont classés par ordre logique mathématique : chaque démonstration ne s'appuie que sur des résultats énoncés et démontrés plu

    Le Frido 2025

    Présentation

    Le Frido est un livre de mathématique libre initialement destiné à l'agrégation, mais devenu généraliste. En supposant connue une théorie intuitive des ensembles, ça va jusqu'aux martingales, distributions, extensions de corps, etc. Avec toutes les démonstration intermédiaires (modulo les 981 entrées restantes dans ma liste de choses à faire).

    Les résultats sont classés par ordre logique mathématique : chaque démonstration ne s'appuie que sur des résultats énoncés et démontrés plus haut. C'est loin d'être l'ordre pédagogique.

    L'extension guilietta donne le reste de ce que je sais en math : groupes de Lie (l'objectif est de donner la liste des représentations de SL(2,C)).

    Nouveautés 2025

    Le bouquin vient de dépasser les 3000 pages cette année.

    • Théorème de Banach-Alaoglu.
    • Démonstration du fait que le système trigonométrique est une base hilbertienne.
    • Fonctions analytiques entre espaces de Banach. L'objectif sera d'énoncer et démontrer le théorème d'inversion locale. Le seul doc que j'aie trouvé est celui-ci. Sinon ChatGPT se débrouille assez bien.
    • Structure de groupe de Lie sur un sous-groupe fermé (ça c'est dans une extension)
    • Dans le même ordre d'idée : modification de la définition d'une variété pour accepter des cartes à partir d'ouverts de n'importe quel espace vectoriel normé (et non seulement de \mathbb{R}^n). Formellement, ça rend correcte pour un groupe de Lie l'idée de prendre des cartes depuis l'algèbre de Lie. En pratique, ça permet aussi de prendre des cartes depuis le produit tensoriel des fibres pour prendre le produit tensoriel de fibrés vectoriels. Si on n'accepte que des cartes depuis des ouverts de \mathbb{R}^n, il faut prendre un isomorphisme (pas canonique) entre \mathbb{R}^n et le produit tensoriel, et montrer qu'en réalité rien ne dépend de ce choix. L'inconvénient est qu'on ne peut plus parler de l'ensemble des cartes.

      Sommaire

      Mon flot de rédaction

      Quand j'écris une démonstration, soit je cherche un peu par moi-même, soit je cherche sur internet. Quand je trouve un texte qui me semble correct, je commence par rédiger sur du papier de brouillon; la plupart du temps j'ajoute beaucoup de détails par rapport à ce que je lis. En particulier, j'écris sur mon papier de brouillon les labels (dans le Frido) des résultats à citer.

      Quand ma démonstration est terminée, je copie des feuilles vers LaTeX. Chaque démonstration passe donc par (au moins) deux rédactions personnelles : une de l'écran vers le papier de brouillon et une du papier vers LaTeX.

      ChatGPT

      Ce flot est valable également quand je demande à ChatGPT. Ce dernier est maintenant crédité comme source dans neuf démonstrations. Parfois seul parfois en collaboration avec moi ou d'autres sources. Je ne copie-colle jamais un résultat.

      Avant de demander à ChatGPT, je regarde d'abord pas mal sur internet ; et je me demande parfois pourquoi d'ailleurs.

      Mon activité sur Stack

      Lorsque je ne trouve pas une démonstration en ligne, je demande souvent sur Stack. Et parfois je n'ai pas de réponses satisfaisantes.

      Zorn et existence d'un max pour tout ensemble fini

      Je demande si il est vrai que tout ensemble Dedekin-fini totalement ordonné a un maximum.

      À mon avis la preuve donnée par Asaf Karagila (et qui a 5 votes positifs) a au moins un trou ; j'explique dans les commentaires ce qui ne me va pas. Si vous avez une idée de comment compléter, n'hésitez pas.

      Connexité

      Voici une question qui lie connexité et espaces totalement normaux. Je ne suis pas certain que l'énoncé soit même vrai.

      Si vous êtes douées en topologie, lâchez-vous.

      Remarque pas très gentille

      À chaque fois que je dois poser une question sur Stack ou à ChatGPT, je ne peux pas m'empêcher de penser que soit je suis nul en recherche sur Internet (c'est le cas), soit l'ensemble de la communauté mathématique a échoué à mettre en ligne des résultats importants.

      Citations

      Le Frido cite toutes ses sources, théorème par théorème. À côté de chaque énoncé, il y a une liste des endroits où j'ai trouvé des informations utiles soit pour l'énoncé soit pour la démonstration.

      La référence [1] signifie qu'il y a de l'invention personnelle non triviale. C'est moi qui ai inventé (une partie de) soit de l'énoncé, soit de la preuve.

      Plagiat massif

      Dans le monde de l'enseignement académique, le plagiat massif est la norme. Par exemple, le dernier en date que j'ai utilisé cite cinq livres en avouant ouvertement que ce n'est pas complet. Et bien entendu, il ne dit pas quelle partie de son texte vient d'où.

      En ne remontant ma bibliographie pas plus loin que juillet 2025, je trouve celui-ci qui ne cite aucune source. Si un étudiant avait fait ça dans un mémoire de licence, il aurait été engueulé comme du poisson pourri.

      Les mathématiciens professionnels ne citent pratiquement jamais Wikipédia ou math.stackexchange.com. Le Frido oui.

      Pourquoi citer ses sources ?

      La bibliographie sert à remercier la personne qui a fait l'effort de me rendre l'information disponible.

      En ce qui me concerne, la bibliographie ne sert pas à :

      1. permettre de remonter à l'inventeur original d'un énoncé ou d'une technique
      2. permettre au lecteur d'aller plus loin
      3. donner de la crédibilité à un résultat.

      Développons

      1. Les résultats présentés dans le Frido ne sont pas de la recherche toute fraîche. Il est illusoire de remonter la chaîne de la source de la source de la source pour trouver l'idée originale.
      2. Si le lecteur veut aller plus loin, il possède le même internet que moi. Il est de très rare que j'utilise une source qui ne soit pas en ligne.
      3. Ce qui fait la crédibilité d'un résultat, c'est la démonstration. Si la lectrice veut se convaincre qu'un résultat est vrai, elle peut soit faire la même recherche que moi sur le même internet, soit lire la preuve donnée. Le Frido n'est pas un ouvrage de vulgarisation. La lectrice est supposée être là pour lire et comprendre les démonstrations.

      Le cas particulier chatGPT (1)

      chatGPT n'est pas un cas particulier.

      Si c'est l'entreprise OpenAI qui a fait l'effort de mettre une information disponible pour moi, c'est elle que je cite. C'est bien l'entreprise OpenAI qui a la citation, pas chatGPT lui-même en tant que "personne". Cela est à mettre en relief par rapport au cas de cette réponse où je cite bien la personne qui a écrit et non l'entreprise derrière stack.

      Que OpenAI elle-même soit incapable de citer les sources sur lesquelles elle base sa réponse est — dans mon contexte — un non-problème. En effet, je serais moi-même incapable de vous dire d'où je connais le paradoxe de Zénon, la définition de la continuité ou la démonstration de la formule n(n+1) / 2. Ce sont des informations qui sont codées dans mon cerveau. Je suis capable de vous les dire, mais pas de faire de citations de mes sources.

      Le cas particulier chatGPT (2)

      Ce n'est pas un cas particulier.

      En remontant ma biblio jusqu'à janvier 2025, je trouve cet intéressant exemple : ma question sur math.stackexchange à propos de variétés analytiques.

      Voici l'ordre dans lequel se sont passées les choses.

      1. Je me pose une question de math qui me semble assez naturelle.
      2. Je ne trouve rien sur internet.
      3. Je pose la question sur math.stackexchange
      4. Je n'ai pas de réponses.
      5. Je pose à chatGPT un copié-collé de ma question qui est sur Stack.
      6. chatGPT me donne une réponse correcte.
      7. Je rédige la réponse de chatGPT et la publie dans Giulietta.

      Question : à qui suis-je supposé donner le crédit de la démonstration ?

      Ma réponse : à OpenAI.

      Au final, la communauté mathématique a échoué à mettre en ligne un énoncé et une démonstration correcte de «tout groupe de Lie C^{\infty} est analytique».
      Ensuite la communauté mathématique a échoué à répondre à une question sur stackexchange.
      Au final c'est un échec retentissant pour l'ensemble de la communauté mathématique.

      En réalité la question de savoir si OpenAI mérite une entrée dans ma biblio est une question très accessoire. Il y a un problème de publication scientifique largement en amont.

      Le cas particulier chatGPT (3)

      Bon. ok. ChatGPT est un cas particulier. Le plus souvent quand je demande à chatGPT c'est que j'ai déjà fait des recherches sur Internet et souvent également demandé sur stack sans avoir de réponses utiles.

      Donc quand je cite chatGPT, c'est un signe que l'ensemble de la communauté mathématique a échoué dans sa mission de mettre la connaissance correctement en ligne.

      Mettons une mathématicienne (nommons-la Alice) ayant écrit un résultat dans un livre privateur. Supposons qu'elle retrouve ce résultat dans le Frido avec chatGPT comme source. Est-elle en droit de râler ?

      Étudions la question.

      1. Au niveau du Frido, tous les résultats sont établis depuis plus d'un siècle. Aucune de mes sources n'a probablement inventé aucun des résultats présentés.
      2. Si elle avait publié le PDF de son bouquin en ligne plutôt que de le vendre à un éditeur, elle aurait sans doute eu la citation. Elle a échangé de l'argent contre de la visibilité (j'assume : je dis bien qu'elle a reçu de l'agent pour être moins visible).
      3. OpenAI l'a-t-elle volé ? Peut-être. Son éditeur pourra pleurnicher devant un tribunal.
      4. Son salaire est payé par mes impôts. Donc la moralité de publier un livre privateur est en soi déjà une question pas du tout triviale.

      Bref.

      Qu'il y ait un problème dans la chaîne "livre privateur -> openAI -> moi" est possible.

      Mais le vrai problème de mon point de vue est largement en amont. Pourquoi il y avait un livre privateur à la base ?

      Images de couverture

      Les images de couverture proviennent de Pepper et Carrot.

      yanntricks

      On parlait de tikz dans un fil sur typst.

      Le Frido fait ses figures avec yanntricks, un module python basé sur sage. Le principe est qu'on décrit sa figure en python, puis le code Tikz est généré automatiquement. Pratiquement tout ce qui est calculable en python/sage est traçable.

      Il y a deux idées de base :

      • Tout est ramené à des points et segments de droites. Écrivez en python une fonction ma_fonction qui prend un réel et retourne un point, passez cette fonction au constructeur ma_courbe=CustomGraph(ma_fonction), et hop ma_courbe.code_tikz() est le code tikz d'une série de segments de droites qui donnera votre courbe.

      • Le code Tikz créé contient du code LaTeX écrivant dans un fichier la taille des boîtes (bounding box) des éléments LaTeX que vous insérez, de telle sorte qu'en deux passes, yanntricks soit au courant des tailles (ça marche avec tous les compteurs internes de LaTeX; vous pouvez donc tenir compte du numéro de la page courante dans votre image). Cela permet de faire :

      C = Cirle(Point(2,1),4)  #cercle de centre (2,1) et de rayon 4
      C.put_mark($\omega-x$, 30) # placer $\omega-x$ sur le cercle à un angle 30 degrés
      C.tikz_code()

      Le code tikz produit mettra automatiquement \omega-x à la bonne place pour que le centre de la boîte soit sur le rayon qui fait un angle de 30 degrés avec l'horizontale, et assez loin pour que la boîte ne coupe pas le cercle.

      Très peu de changements sont nécessaires pour générer le code pstricks ou tikz ou quoi que ce soit d'autre : seulement les droites, points et quelque trucs de base. Pas besoin des cercles, courbes, etc.

      L'inconvénient

      L'inconvénient de yanntricks est que le code est une usine à gaz que j'ai développé par à coups pendant une dizaine d'années — sans linter, sans annotations de types et sans rigueur. En réalité, le prix du billet d'entrée est absurdement élevé. Tellement que moi-même je ne m'y aventure plus.

      Vente

      Extrait du règlement (dans le rapport), page 42) de l'agrégation :

      Durant tout ce temps, elles ou ils ont libre accès […] à leurs
      propres ouvrages. Seuls sont autorisés les ouvrages avec un numéro ISBN et jouissant d'une véritable
      diffusion commerciale. […] une « diffusion commerciale avérée » est tout autant importante.
      […] Cette restriction est motivée par le principe d'égalité des candidats : les ressources documentaires autorisées doivent être facilement accessibles à tout candidat au concours.

      En résumé :

      1. Si une ressource est gratuite, ce n'est pas assez cher pour être facilement accessible à tous les candidats.
      2. Les livres qui ne sont plus vendus (et qui ne sont donc disponibles qu'en seconde main) ne sont pas autorisés.

      Truc marrant : le point 1 est bizarre, mais est appliqué, tandis que le point 2 est très raisonnable mais n'est pas appliqué. C'est ce qui arrive quand on écrit un règlement en ayant un cas très précis en tête et qu'on ne se rend pas compte que ce qu'on écrit a une portée beaucoup plus large que le seul cas auquel on pense.

      Et le pire est que ce règlement n'interdit même pas ce livre qui, si j'ai bien compris, est exactement ce qu'on avait envie de refuser au départ : une pure liste de définitions et d'énoncés de théorèmes classés par leçon.

      Avis si vous travaillez dans une prépa agreg : tapez un plan par leçon (avec la démonstration des deux développements), publiez-là sur thebookedition et ensuite bachotez seulement ces leçons avec vos étudiants.

      Bref, pour faire plaisir au règlement de l'agreg, le Frido est en vente :

      Total : 115,86 euros.

      Problème d'accès aux ressources documentaires

      Ironie mise à part, je trouve que l'objectif est évidemment très louable :
      « principe d'égalité des candidats : les ressources documentaires autorisées doivent être facilement accessibles à tout candidat au concours.»

      Par contre force est de constater que l'accès aux ressources est encore très inégalitaire.

      • certaines candidates arrivent avec des valises entièrement remplies de livres. Probablement un millier d'euros de livres. Toutes les candidates ne peuvent pas facilement se procurer ça.
      • l'acceptation des livres qui ne sont plus disponibles qu'en seconde main (voire plus du tout) crée une forte inégalité entre les candidates qui ont accès à une bibliothèque universitaire et les autres.

      Que faire ? Tout accepter ?

      Finalement, si tout était accepté sans aucune restriction, certes certaines auraient accès à quelque documents de plus que les autres. Mais il y a tellement de ressources disponibles que le petit plus qu'un candidat pourrait se procurer n'a aucune chance d'être décisif.

      Commentaires : voir le flux Atom ouvrir dans le navigateur
      • ✇LinuxFr.org : les dépêches
      • Statistiques 2024 du site LinuxFr.org
        2024 était une année particulièrement longue. Cela n’a évidemment pas grande pertinence, mais bon il faut bien une introduction à cette dépêche. Quid de l’activité du site LinuxFr.org en 2024 ? Quels changements en termes de trafic Web, de contenus créés, de commentaires déposés, de navigateurs utilisés, d’utilisation des fonctionnalités du site, de contribution au code, etc. Bref, qu’est‐ce qui a changé et de quelle manière durant 2024 ? Le site rend accessible un grand nombre de statistiques

      Statistiques 2024 du site LinuxFr.org

      3 janvier 2025 à 15:40

      2024 était une année particulièrement longue. Cela n’a évidemment pas grande pertinence, mais bon il faut bien une introduction à cette dépêche. Quid de l’activité du site LinuxFr.org en 2024 ? Quels changements en termes de trafic Web, de contenus créés, de commentaires déposés, de navigateurs utilisés, d’utilisation des fonctionnalités du site, de contribution au code, etc. Bref, qu’est‐ce qui a changé et de quelle manière durant 2024 ?

      Le site rend accessible un grand nombre de statistiques (faites‑vous plaisir si vous souhaitez vous plonger dedans, c’est fait pour) ; cette dépêche résume les variations constatées en 2024.

      Sommaire

      Statistiques Web

      La comparaison des statistiques annuelles (voir 2023 et 2024) montre une hausse des visites, des consultations (pages, fichiers) et des hits (notamment l’effet des bots pour l’intelligence artificielle), avec un passage à ~927 000 hits par jour et ~76 170 visites par jour, le tout pour ~1,42 Tio par mois.

      Statistiques Web 2024

      Le nombre de contenus publiés en un an diminue de 11 %. Le nombre de commentaires publiés en un an diminue cette année de 10%.

      Trafic de LinuxFr.org normalisé, entre 2002 et 2024

      Contenus

      Au 31 décembre 2024, le site comportait environ 120 480 contenus publiés répartis ainsi :

      • 27 799 dépêches :
        • 383 dépêches publiées en 2024 (364 en 2023),
        • la taille moyenne (en code Markdown, hors images donc) des dépêches se remet à augmenter, tout en restant inférieure à la valeur de 2019 ;
      • 40 242 journaux (409 en 2024 en baisse par rapport aux 458 en 2023),
      • 40 642 entrées de forums (458 en baisse par rapport aux 574 en 2023),
      • 9 087 liens (1711 en baisse par rapport aux 1970 en 2023),
      • 467 sondages (9 en 2023 et 2024),
      • 162 pages de wiki (3 en 2023 et 5 en 2024).

      Pour la première année, le pic de publication des contenus se confirme le mercredi. Ce qui diffère désormais du pic de modération, voir la partie Modération plus bas).

      Un jour de semaine compte 64 % de publications en plus qu’un jour de week-end.

      La publication sous licence Creative Commons By-SA se fait par défaut depuis les dix ans de CC, fin 2012 pour les dépêches (permet explicitement une rédaction collaborative ou un renvoi en re‐rédaction) et les journaux (qui peuvent être convertis en dépêches) : tout naturellement, on retrouve 97 % de dépêches et 99 % des journaux sous cette licence au final (les autres étant notamment sous licence Art Libre ou autre, au choix de l’auteur).

      Les dépêches collaboratives (et pas uniquement celles réattribuées à l’utilisateur Collectif) sur de multiples sujets sont toujours à compter parmi les vraies réussites du site ; nous sommes cependant toujours à la recherche de volontaires pour couvrir les nombreux sujets qui n’ont pu être abordés. Une liste des thèmes récurrents sur LinuxFr.org peut donner des idées de participation : si une dépêche n’a pas été créée dans les temps, tout inscrit peut la démarrer dans l’espace de rédaction.

      Concernant la visibilité par contenu (analyse sur décembre 2023) : les journaux ont jusqu’à deux fois moins de visibilité que les dépêches (faites des dépêches…) et les liens ont beaucoup moins de visibilité que les journaux et les dépêches (préférez donc faire des dépêches ou des journaux, pour la visibilité).

      Modération

      Le temps moyen passé entre la création d’une dépêche (en rédaction ou directement envoyée en modération) et sa modération et publication est de 337 heures (contre 309 h en 2023 et 359 h en 2022) ; la mesure du temps passé uniquement en modération n’est pas actuellement disponible (et la modération retient volontairement des dépêches non urgentes pour réguler la publication) ; le temps médian est descendu à 19 heures. Il y a des demandes de statistiques dans le suivi, envoyez les demandes d’intégration Git (pull‐requests). ;-)

      Le jour préféré de modération a priori des contenus est toujours le mardi pour les dépêches et le lundi pour les sondages.

      Commentaires

      Au 31 décembre 2024, le site comporte 1,94 million de commentaires. Le nombre de commentaires publiés en un an baisse cette année de 10 % pour arriver à 32 046.

      Il y a désormais, en moyenne, 29 commentaires par journal (29 en 2023 et 33 en 2022), 9 par dépêches (9 en 2023 et 10 en 2022), 54 par sondage (36 précédemment, mais très dépendant des sondages considérés), 8 par entrée de forum (7 en 2023 et 7 en 2022), 3 par entrée de suivi, 7 par lien (contre 7 en 2023 et 7 en 2022) et une poignée par page wiki.

      Le jour préféré pour commenter reste le mercredi, et un jour de semaine compte deux fois plus de commentaires qu’un jour de week-end.

      Notes

      Il n’y a (toujours) pas de statistiques disponibles concernant les notes. Les entrées de suivi sur les statistiques n’ont pas avancé.

      Néanmoins diverses statistiques concernant la notation sur les contenus et les commentaires ont été données en juin 2021, avec des graphes.

      Étiquettes (tags)

      Au 31 décembre 2024, le site comporte :

      • 15 659 étiquettes, dont 12 867 étiquettes publiques (contre 12 294 fin 2023) ;
      • 180 064 saisies d’étiquettes (étiquetées en moyenne douze fois pour les étiquettes publiques et cinq fois pour les étiquettes privées) ;
      • les étiquettes sont réparties ainsi par contenu :
        • 65 96à pour les dépêches,
        • 51 763 pour les journaux,
        • 30 432 pour les forums,
        • 30 182 pour les liens,
        • 829 pour les pages wiki,
        • 380 pour les sondages,
        • 518 pour le système de suivi des défauts et évolutions.

      Plus de détails dans la dépêche de février 2022 À propos des étiquettes sur le site LinuxFr.org.

      Depuis le début du site, on constate en moyenne 5 étiquettes par page wiki, 3,3 par lien, 2,4 par dépêche, 1,3 par journal, 0,8 par sondage, 0,8 par entrée de forum et 0,3 par entrée du suivi.

      Le jour préféré pour apposer des étiquettes est le lundi (biais de la création initiale des étiquettes), suivi du samedi.

      Il y a plusieurs biais concernant les étiquettes :

      • beaucoup ont été et sont ajoutées automatiquement ;
      • le thème mobile par défaut ne montre pas les étiquettes (sauf à basculer son Firefox en « Version ordinateur » ou équivalent sur un autre navigateur).

      Équipe de bénévoles

      Il y a actuellement 4 personnes pour l’administration du site, 12 pour la modération, 6 pour l’animation de l’espace de rédaction et 2 pour la maintenance qui font tourner ce site. Pour mémoire, il s’agit de bénévoles plus ou moins disponibles et donc absolument pas de 24 équivalents temps plein pour jargonner comme une entreprise. Merci pour le travail accompli.

      Code et développement

      Au 31 décembre 2024, le système de suivi de défauts et de demandes d’évolutions contient 269 entrées ouvertes (contre 243 en 2023). On voit assez rapidement un manque de développeurs apparaître. En 2024, il y a eu 54 entrées ouvertes (contre 46 en 2023) : 36 entrées encore ouvertes venant s’ajouter à celles datant d’avant, 11 corrigées et 7 déclarées invalides. On peut noter que ceux qui ouvrent le plus d’entrées sont des membres actuels ou anciens de l’équipe du site.

      C’est Bruno qui garde le record de correction d’entrées. Merci aussi à Adrien Dorsaz. Le temps moyen de résolution est de 166 jours (contre 132 précédemment). La moitié des entrées fermées ont été traitées en moins de huit jours. On ressent donc toujours un besoin de nouveaux contributeurs côté code.

      La charge moyenne sur le serveur est de 1,2 sur la machine actuelle (baptisée gruik). La charge minimale a été de 0,7 et la maximale de 2,5.

      La consommation mémoire est restée stable. Le trafic réseau sur la partie Web uniquement est en moyenne de 5,1 Mbit/s sortants.

      Comptes utilisateur

      Au 31 décembre 2024, sur les 52 332 comptes utilisateur valides existants, 2 117 ont été utilisés au cours des trois derniers mois, dont 33 % (+1) ont déjà rédigé des dépêches, 45 % (+2) des journaux, 42 % (+1) des entrées de forums, 11 % (=) des entrées dans le système de suivi, 17 % des liens (+2) et 2 % une page de wiki ; 87 % (=) ont écrit des commentaires et 52 % (+2) étiqueté des contenus ; 33 % (-1) ont contribué sur au moins une dépêche ; 27 % (+1) des comptes actifs ont indiqué un site personnel, 8 % (=) un identifiant XMPP, 5 % (+1) une adresse Mastodon, 29 % (-1) un avatar et 6 % (=) une signature.

      Côté utilisation des fonctionnalités, 14 % (+1) ont demandé à ne pas afficher les contenus avec une note négative, 9 % (+1) ont demandé le tri chronologique en page d’accueil, 6 % (+1) à ne pas voir les avatars, 5 % (+1) à afficher la tribune dans une boîte latérale et 3 % (=) à ne pas voir les signatures, et à peine quelques pourcents ont changé les contenus par défaut en page d’accueil (souvent pour retirer les sondages et ajouter les journaux). Peu de feuilles de style CSS du site sont utilisées : quatre visiteurs sur cinq utilisent celle par défaut ; il est facile d’en changer avec le lien Changer de style. En janvier 2024, il n’y avait pas de rupture générationnelle marquée entre les comptes 1999 et 2024 en termes d’utilisations des fonctionnalités.

      Seuls dix comptes ont un karma négatif et un a un karma nul, soit 0 % des visiteurs actifs ; 10 % des comptes actifs durant les trois derniers mois ont été créés en 2024.

      30 % (-1) des visiteurs actifs ont une adresse de courriel GMail, 12 % (-1) chez Free, 4 % (=) chez LaPoste, 3 % (-1) chez Yahoo, 3 % (=) chez Hotmail ou Outlook et 2 % (=) chez Orange ou Wanadoo.

      2024 correspond aussi au premier anniversaire de la mise à place des nouvelles règles de pérennité des comptes LinuxFr.org et données à caractère personnel.

      Soucis divers

      Le compteur d’années sans mises en demeure reçues passe à trois (après deux mises en demeure en 2019 et une en 2020, voir la dépêche sur la no 3 en attendant la publication d’informations sur les no 4 et 5).

      / Only five formal notices in the default \
      \   install, in a heck of a long time!    /
       -----------------------------------------
         \
          \
              .--.            / Ouep...  \
             |o_o |           \ Euh coin /
             |:_/ |            ----------
            //   \ \              \ 
           (|     | )               \
          /'\_   _/`\                \ >()_
          \___)=(___/                   (__)__ _
      

      Depuis la création du site, statistiques liées au légal (dans les sens liés à la force publique ou à du juridique) :

      • cinq mises en demeure reçues (pour zéro assignation) ;
      • une réquisition judiciaire reçue (qui au final ne nous concernait pas, mais a donné l’occasion de discuter avec la police nationale) ;
      • un cas d’usurpation d’identité et de harcèlement type « revenge porn » (discussion avec la gendarmerie nationale).

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Y a le Frido 2024 qu'est là
        Le Frido est un livre de mathématique libre. Il est l'enveloppe convexe entre la matière de l'agrégation et les bases (axiomatique des ensembles non comprise). Autrement dit : il construit les ensembles de nombres, et va jusqu'au bout du programme de l'agrégation en bouchant tous les trous. En français, il comprend 2888 pages au 25 août 2024 et est publié sous licence FDL. lien nᵒ 1 : Les sources LaTeXlien nᵒ 2 : Téléchargement des pdf séparés et achatlien nᵒ 3 : Achat du volume 1lien nᵒ 4 : Le

      Y a le Frido 2024 qu'est là

      Le Frido est un livre de mathématique libre. Il est l'enveloppe convexe entre la matière de l'agrégation et les bases (axiomatique des ensembles non comprise). Autrement dit : il construit les ensembles de nombres, et va jusqu'au bout du programme de l'agrégation en bouchant tous les trous. En français, il comprend 2888 pages au 25 août 2024 et est publié sous licence FDL.

      Sommaire

      Images de couvertures

      Les images de couverture proviennent de Pepper et Carrot.

      Image de couverture du tome 1

      (pour voir les couvertures des tomes 2, 3 et 4)

      Elles sont aussi visibles via les sources évidemment.

      Changements depuis l'année passée

      Intégration sur variétés

      J'ai décidé que la partie parlant d'intégration sur les variétés allait être laissée à l'abandon.

      • Elle ne sert qu'à démontrer le point fixe de Brouwer via Stokes. Trop compliqué, trop long, pas adapté au niveau visé.
      • La preuve de Brouwer continu est maintenant faite de façon plus conventionnelle.
      • La géométrie différentielle est développée dans la partie en anglais.

      Dérivation

      La définition de la dérivée d'une fonction \mathbb{R}\to \mathbb{R} n'est plus une définition «fondamentale». Les choses sont maintenant faites dans cet ordre :

      • Définition de la différentielle d'applications entre espaces de Banach.
      • Définition de la dérivée directionnelle comme application de la différentielle à un vecteur (la direction).
      • Définition des dérivées partielles comme cas particulier.
      • La dérivée «usuelle» est définition comme f'=\partial_1f.

      Ce qui est marrant avec la dernière définition est que \partial_1 peut être interprété soit comme la dérivée partielle dans la première direction (il y en a une seule dans \mathbb{R}) soit comme la dérivée directionnelle selon le vecteur 1.

      Théorème de Stokes

      Le théorème de Stokes est démontré. C'est un assez gros morceau.

      Ce qu'il y a de mieux qu'ailleurs

      Le Frido se distingue d'autres livres de math en cela qu'il est meilleur sur certains points.

      Certains détails sont traités correctement.

      Je me demande si je suis le seul au monde à avoir remarqué que, quand on parle de l'extension de corps K[a], ce qu'on obtient dépend du corps ambiant dans lequel sont K et a.

      Par exemple si je prend \mathbb{Q}[\sqrt{2}]… Il n'y a pas de problèmes à construire un sur-corps de \mathbb{Q} contenant l'élément \sqrt{2} dans lequel \sqrt{2}^2=3.

      Ce genre de détails sont traités dans le Frido, l'exemple de \mathbb{Q}[\sqrt{2}] est donné en détail, et il est bien fait mention que la notation \mathbb{Q}[a] réfère toujours à des sous-corps de \mathbb{C}.

      Notation pour les dérivées partielles

      Considérez les trois fonctions suivantes : f,g,h:\mathbb{R}^2\to \mathbb{R} données par

      f(x,y)=x\sin(y)

      g(u,v)=u\sin(v)

      h(y,x)=y\sin(x)

      Est-ce que vous oseriez écrire f=g=h ? Si oui, c'est que vous pouvez remplacer «f» par «g» ou «h» partout. Alors que signifie \frac{\displaystyle\partial g}{\displaystyle\partial x} ?

      Bien que ces infectes notations «\frac{\partial f}{\partial x}» soient utilisées à quelques endroits dans le Frido, je m'efforce à écrire (\partial_if) qui signifie la dérivée de f dans la i-ième direction.

      Un minimum de notations

      Bien que je sois un psychorigide sur les abus de notations, le Frido a une autre règle : utiliser un minimum de symboles difficiles à écrire. Tout doit pouvoir être écrit à la main sur des feuilles volantes dans le tram.

      • pas de gras pour les vecteurs (impossible à rendre à la main)
      • le même symbole «*» est utilisé pour \mathbb{K}^* pour dire \mathbb{K}\setminus\{0\} et dans E^* pour désigner le dual algébrique.

      Variétés et cartes

      D'habitude, on définit une variété comme étant un ensemble avec des cartes provenant d'ouverts de \mathbb{R}^n.

      Or on définit quand même souvent des variétés avec des cartes ne provenant pas de \mathbb{R}^n. Par exemple lorsqu'on travaille sur des sous-groupes de Lie, on prend souvent la carte exponentielle provenant de l'algèbre de Lie.

      Dans Giulietta (NdM : extension en anglais qui va de l’agrégation jusqu’à tout ce que l'auteur sait en mathématique), on définit correctement une variété comme ayant des cartes provenant d'ouverts d'espaces vectoriels normés quelconques. Il est alors démontré que toute telle variété est isomorphe à une variété avec des cartes de \mathbb{R}^n.

      Je ne me souviens pas avoir vu cette subtilité traitée quelque part. Notons qu'avec cette définition, on ne peut plus parler de l'ensemble de toutes les cartes.

      Citations

      Le Frido cite (à peu près) correctement ses sources. Chaque théorème vient avec les sources qui ont contribué soit à l'énoncé soit à la preuve. Les inventions personnelles sont mentionnées très explicitement. Pas peur de citer wikipédia, des commentaires sur math.stackexchange.com ou d'autres sources moins conventionnelles que des livres.

      Je suis souvent choqué étonné par la quantité de cours mis en ligne par des profs se contentant de citer trois livres en disant «pour en savoir plus, le lecteur pourra consulter les ouvrages suivants». Ensuite, on va se plaindre que si les étudiants ne citent pas leurs sources dans leurs mémoires, c'est du plagiat.

      Le plagiat massif est simplement la norme dans les textes de math que les profs mettent dans les mains des étudiants.

      ChatGPT

      Cette année, ChatGPT entre dans la bibliographie. C'est lui qui a fourni une partie de la preuve que si f_1 et f_2 sont mesurables (depuis le même espace) alors le vecteur (f_1, f_2) est mesurable.

      Il y a d'ailleurs une belle anecdote à ce sujet.

      ChatGPT se contente de prouver correctement que le théorème est vrai sur les mesurables de la forme A_1\times A_2, et dit vaguement que si c'est bon sur une partie qui engendre la tribu produit, alors c'est bon pour toute la tribu. Typiquement le genre de trou dans la preuve que laisserait un humain.

      Si vous voulez contribuer

      Niveau facile

      Lisez et écrivez-moi si vous trouvez une faute ou un passage pas clair. Critère : si vous êtes relativement bon en math et que vous mettez plus de 20 minutes sur une ligne, c'est qu'il y a un problème avec le texte.

      Niveau intermédiaire

      S'il manque une démonstration, rédigez-en une, faites une photo de votre feuille et envoyez-la moi.

      Niveau difficile

      • Si vous êtes bon en géométrie différentielle, vous pouvez tenter de répondre à cette question:

      https://math.stackexchange.com/questions/4917916/commute-two-sums-when-defining-integral-of-differential-manifold

      Enjeu : toutes les définitions que je connais de l'intégrale d'une forme sur une variété sont fausses. Sauf celle que j'ai inventée moi-même.

      • Si vous vous y connaissez en processus de Poisson, vous pouvez répondre à cette question :

      https://math.stackexchange.com/questions/4957480/density-of-the-vector-of-jump-times-in-a-poisson-process

      Note : je ne suis même pas sûr que l'énoncé soit correct. La démonstration que je connais vient d'ici mais je ne suis pas convaincu.

      • Si vous être bon en probabilités, vous pouvez tenter de répondre à cette question :

      https://math.stackexchange.com/questions/4961074/is-the-join-density-the-density-of-the-vector

      Niveau supérieur

      Vers la fin, il y a une section consacrée aux différentes propriétés et conjectures autour de la constante de Weiner. Si vous en connaissez d'autres, faites-le moi savoir.

      LaTeX

      Modifier l'environnement proof pour qu'il prenne un paramètre booléen optionnel inBook. Par défaut il vaut True et la démonstration est affichée. Si inBook est False, la démonstration n'est pas affichée. Au lieu de la preuve, il y a le texte «Voir la version en ligne : ».

      La raison est expliquée plus bas.

      Agreg (1)

      Il me faut une liste des théorèmes dont les démonstrations peuvent être sautées pour un candidat à l'agreg. J'imagine que tout ce qui utilise explicitement le lemme de Zorn peut sauter, tout ce qui parle de topologie sur les espaces de distribution peut sauter, la partie sur les mesures peut partir, etc.

      Pour la raison de ce besoin, voir plus bas.

      Agreg (2)

      Il me faut une liste de théorèmes qui peuvent servir de développements.

      Contrainte

      Je n'ai pas accès aux livres privateurs. Inutile de m'en conseiller un.

      Ventes

      Les chiffres

      Précision sur le prix : le prix indiqué est le prix de vente côté imprimeur. Je ne gagne pas d'argent dessus. D'ailleurs je me demande bien qui achète le Frido …

      Certes, le règlement de l'agrégation interdit les livres qui ne sont pas vendus (incidemment, les livres qui ne sont plus en vente sont interdits), mais j'ai du mal à croire qu'il y ait autant de monde qui utilise le Frido à l'agreg. Mais si ce n'est pas pour l'agreg, qui paye 100 euros pour avoir quatre briques de 6cm d'épaisseur A4 alors qu'on peut avoir un pdf sur un écran ?

      Voici un tableau qui montre, pour chaque année, le nombre de livres vendus, et le prix total. Les cases avec un x correspondent au nombres dont je n'ai pas pris note.

      année prix de tout le Frido Nombre de livres vendus
      2016 x 51
      2017 x 37
      2018 x 30
      2019 89,36 17
      2020 x 32
      2021 97,59 13
      2022 x x
      2023 106,79 16
      2024 110,88

      Au total, ce sont 196 bouquins vendus plus ceux de 2022 dont je n'ai pas pris note. On doit être un peu au-dessus de 200.

      Précisions :

      • La ligne 2021 correspond au Frido 2021 vendu entre septembre 2021 et septembre 2022. Plus généralement, la ligne N correspond aux ventes entre septembre N et septembre N+1.
      • En 2019, il fallait payer 89,36 euros pour acheter les 4 Fridos. 17 livres ont étés vendus. Le fait que 17 ne soit pas divisible en 4 est dû au fait que le tome 2 a été acheté 5 fois, tandis que les autres ont été vendus 4 fois.

      Une pensée à propos des prix

      La page 77 du rapport 2023 indique qu'un livre n'est autorisé que s'il jouit d'une diffusion commerciale. La motivation est que :

      Cette restriction est motivée par le principe d'égalité des candidats : les ressources documentaires autorisées doivent être facilement accessibles à tout candidat au concours.

      Je ne sais pas si l'auteur de ces lignes avait l’accessibilité financière en tête en rédigeant cela. Si oui, alors le Frido est probablement le seul livre autorisé à l'agreg :)

      Quoi qu'il en soit, le Frido commençant à dépasser les 100 euros, il y a un problème.

      Pour faire baisser le prix, il faut baisser le nombre de pages.
      Une piste serait de supprimer les démonstrations des théorèmes non nécessaires à l'agreg.

      Pour cela il me faudrait les deux contributions LaTeX et agreg (1) dont je parle plus haut :

      • LaTeX : Une modification de l'environnement proof.

      • Agreg : il me faut une liste des théorèmes dont les démonstrations peuvent être sautées pour un candidat à l'agreg.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Les IA et LinuxFr.org
        Sur LinuxFr, on préfère les IN (intelligences naturelles) aux IA (intelligences artificielles). Las, nous ne sommes pas les seuls à constater un début d’envahissement du site par les IA. Voici ce qui vous (nous) attend dès que ça sera mis en production pour essayer d’y pallier. lien nᵒ 1 : Test d'IA/INlien nᵒ 2 : L’entrée de suiviLes faits Le constat est le suivant : non seulement les IA spammeuses commencent à polluer le site, mais, en prime, au niveau rédactionnel, elles se montrent plus futé

      Les IA et LinuxFr.org

      Sur LinuxFr, on préfère les IN (intelligences naturelles) aux IA (intelligences artificielles). Las, nous ne sommes pas les seuls à constater un début d’envahissement du site par les IA. Voici ce qui vous (nous) attend dès que ça sera mis en production pour essayer d’y pallier.

      Les faits

      Le constat est le suivant : non seulement les IA spammeuses commencent à polluer le site, mais, en prime, au niveau rédactionnel, elles se montrent plus futées que les vulgaires spammeurs en mode SEO auxquels on était habitués jusqu’à présent. De facto, leur prose est parfois difficile à différencier de celle des autres intelligences, naturelles, elles, qui interagissent sur le site.

      Rédigé ou pas par des IN, le spam reste du spam.

      La solution retenue actuellement

      Heureusement, d’autres que nous se sont penchés sur la question et il existe des critères permettant de faire la différence entre une IA et une IN. À part le test de Turing, s’entend. Après quelques hésitations, nous sommes arrivés à une solution qui devrait, en outre, répondre aux prochains textes législatifs et réglementaires dont l’objectif est de réguler cette zone de non-droit qu’est Internet.

      Dès que ça sera mis en production, les personnes qui accèdent au site sans être connectées auront donc droit à cette fenêtre modale qui nous permettra de séparer le bon grain (les IN) de l’ivraie (les IA). On est franchement désolés d’en arriver là, mais on n’avait pas vraiment le choix. Merci à l’avance de votre compréhension.

      Il est demandé aux personnes de certifier qu’elles peuvent trouver des feux de circulation sur une image même si elles sont aveugles

      La problématique et d’autres solutions envisageables

      Le spam sur un site web peut avoir de nombreuses conséquences négatives, notamment la dégradation de l’expérience utilisateur, la perte de crédibilité et de confiance des utilisateurs, et la diminution du trafic sur le site. En outre, le spam peut également entraîner des problèmes de sécurité, tels que des attaques par déni de service ou l’infection des visiteurs par des logiciels malveillants.

      Pour protéger le site web LinuxFr.org contre le spam, il est nécessaire de mettre en place des mesures techniques restrictives et contraignantes. Ces mesures comprennent l’utilisation de captcha, la validation des adresses IP, la limitation du nombre de publications par utilisateur, la modération automatique des commentaires, et la mise en place de filtres anti-spam.

      Ces mesures permettent de limiter la capacité des spammeurs à envoyer du contenu indésirable sur le site, tout en préservant la facilité d’utilisation pour les utilisateurs légitimes. Bien que ces mesures puissent être contraignantes pour les utilisateurs, il est essentiel de les mettre en place pour garantir la sécurité et la fiabilité du site. En mettant en place ces mesures, LinuxFr.org peut protéger sa réputation et maintenir la qualité de son contenu, tout en offrant une expérience utilisateur optimale à ses visiteurs.

      Dans un second temps, des ajustements seront faits pour :

      1. Renforcer les protocoles de sécurité pour limiter les accès non autorisés et renforcer la protection des données des utilisateurs.
      2. Mettre en place un système de validation stricte pour l’inscription des nouveaux membres afin d’éviter les trolls et les spams.
      3. Limiter la publication de contenus sensibles ou offensants en mettant en place un système de modération plus strict.
      4. Renforcer les mesures anti-piratage pour protéger les contenus et les informations confidentielles du site.
      5. Mettre en place un système de surveillance des activités des membres pour détecter et prévenir les comportements inappropriés ou dangereux.
      6. Renforcer les règles de confidentialité et de protection des données personnelles des utilisateurs en conformité avec les réglementations en vigueur.
      7. Mettre en place des audits de sécurité réguliers pour garantir la fiabilité et l’intégrité du site et de ses serveurs.
      8. Mettre en place un système de sauvegarde automatique des données pour éviter toute perte d’informations en cas de problème technique.
      9. Renforcer la sécurité des transactions en ligne pour protéger les données financières des utilisateurs.
      10. Mettre en place des formations régulières pour sensibiliser les membres aux bonnes pratiques en matière de sécurité informatique.

      Il est essentiel de trouver un équilibre entre la sécurisation absolue des données et la préservation totale de la vie privée et de la liberté d’expression sans limite des utilisateurs.

      Dans un troisième temps, les retouches finales seront apportées :

      • Créer un champ de force magnétique autour du datacenter pour éloigner les astéroïdes et les débris spatiaux.
      • Utiliser des hologrammes pour créer des illusions d’optique afin de détourner l’attention des ennemis potentiels.
      • Utiliser des lasers géants pour dévier les ouragans avant qu’ils n’atteignent les serveurs.
      • Mettre au point une machine à voyager IPoT dans le temps pour aller régler les problèmes du passé avant qu’ils ne deviennent des catastrophes.
      • Créer des capsules de sommeil ultra-efficaces pour permettre aux administrateurs de se reposer en seulement quelques minutes.
      • Utiliser des mini-robots volants pour surveiller et protéger le réseau physique d’accès au site.
      • Développer une technologie de téléportation pour se déplacer instantanément d’un endroit à un autre pour les interventions.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      ❌
      ❌