❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierLinuxFr.org : les dépêches
  • ✇LinuxFr.org : les dépêches
  • Bonjour les cornichons, Unicode vient de sortir en version 18
    Le standard Unicode a ajouté dans son bocal : 13 007 caractères. Il en contient donc aujourd’hui 172 808. Ce n’est pas une version révolutionnaire. Les modifications sont principalement liées à l’ajout des nouveaux systèmes d’écritures et caractères afin de pouvoir s’adapter à leur comportement, comme pour la version précédente. Il n’y a donc pas de nouvel algorithme. Outre trois symboles monétaires, on voit arriver 11 328 idéogrammes d’écritures chinoises anciennes, le petit sceau et les sinogr

Bonjour les cornichons, Unicode vient de sortir en version 18

Le standard Unicode a ajouté dans son bocal : 13 007 caractères. Il en contient donc aujourd’hui 172 808. Ce n’est pas une version révolutionnaire. Les modifications sont principalement liées à l’ajout des nouveaux systèmes d’écritures et caractères afin de pouvoir s’adapter à leur comportement, comme pour la version précédente. Il n’y a donc pas de nouvel algorithme. Outre trois symboles monétaires, on voit arriver 11 328 idéogrammes d’écritures chinoises anciennes, le petit sceau et les sinogrammes Jurchen. Unicode 18 accueille aussi en son sein des chiffres proto-cunéiformes ou encore des symboles musicaux. Et bien sûr, des émojis.

Qu’écouter à la lecture de cette dépêche ? Stéphane Bortzmeyer suggère la chanson de Nino Ferrer « Les cornichons ». Vous avez le choix entre la version originale chantée ou une purement instrumentale.

Bocal de cornichons renversé, remix d’oksmith sur openclipart

Sommaire

Selon votre navigateur, vous verrez, ou pas, les caractères s’afficher. Ils finiront très probablement par l’être un jour, de toute façon, raison pour laquelle ils figurent à côté de leur numéro Unicode.

Des symboles monétaires

Trois symboles monétaires ont été ajoutés. Dans sa note de blog (EN), le consortium Unicode les considère comme les caractères les plus attendus, à savoir :

  • la rufyaa ou roupie maldivienne, MVR ou Rf, devise des Maldives, U+20C2, ⃂ ;
  • le D avec une double barre du dirham des Émirats arabes unies, AED, U+20C3, ⃃ ;
  • et le rial omanais, OMR, une boucle sur deux barres, monnaie officielle du sultanat d’Oman, U+20C4, ⃄.

Des systèmes d’écritures

Les nouveautés d’Unicode 18 en matière d’écriture sont principalement des anciennes, voire, des très anciennes écritures. Les références AEC signifient Avant l’Ère Commune, donc avec des périodes s’écrivant dans le sens inverse de la datation actuelle : du plus grand nombre au plus petit.

L’écriture petit sceau

L’écriture petit sceau ou xiǎo zhuàn en chinois est une écriture sigillaire. En d’autres termes elle est basée sur les divers sceaux utilisés pour authentifier les différents actes et documents officiels mais aussi pour les particuliers et, évidemment, les artistes.

Elle fait partie des cinq styles de l’écriture chinoise1 :

  • l’écriture avec le grand sceau ou dà zhuàn et le petit sceau qui nous occupe aujourd’hui et qui est une forme de l’écriture grand sceau  ;
  • le lì shū, écriture classique des documents administratifs des dynasties Qin et Han ;
  • le kǎi shū, style régulier qui est la norme de l’écriture chinoise ;
  • le xíng shū qui est une écriture semi-cursive ;
  • les cǎo shū, style herbe qui est une écriture très libre.

L’écriture petit sceau a commencé à être utilisé sous la dynastie Qin, 221-207 AEC, et ce, pendant deux cents ans. C’est sous cette dynastie et sous l’impulsion du pouvoir impérial que l’écriture chinoise se normalisera. L’Unicode vient d’intégrer 11 328 caractères dans les blocs Unicode 3D000 à 3FC3F.

L’écriture Jürchen

Chinoise elle aussi, l’écriture Jürchen date de la dynastie Jin et du XIIe siècle. Elle comporte neuf cents caractères et n’est actuellement que partiellement déchiffrée.

Les Jürchen était un peuple du nord-est de la Chine. Le chef Jürchen Wanyan Aguda (1068-1123) devenu le premier empereur Jürchen en 1115 demande en 1119 à Wanyan Xiyin (?-1140) de travailler à un système d’écriture à la hauteur d’un empire. Ce sera donc l’écriture Jürchen qui occupe les blocs Unicode 18E00 à 1919F et 191A0 à 191DF pour les radicaux2.

On pourrait écrire une histoire politique de la Chine à travers celle de son écriture.

Les nombres proto-cunéiformes

Le proto-cunéiforme ou cunéiforme archaïque est apparu en Mésopotamie vers 3 200 (voire, 3 400) AEC. C’est, probablement, le tout premier système d’écriture, tout du moins, c’est le système d’écriture le plus ancien dont on ait la trace. Il évoluera vers le cunéiforme aux alentours du deuxième millénaire. Ce dernier se répandra largement notamment grâce aux échanges commerciaux.

L’écriture se faisait sur des tablettes d’argile à l’aide de stylets, la forme des lettres rappelant celle des clous : une ligne avec une tête. Alors que le proto-cunéiforme était plus figuratif, le cunéiforme devient plus abstrait.

Le cunéiforme occupait déjà les blocs Unicode 12400 à 1247F. Les chiffres proto-cunéiforme, font leur entrée dans les blocs Unicode 12550 à 1268F.

Tablette en écriture cunéiforme archaïque (2005)
Contrat de vente en proto-cunéiforme. La tablette est écrite en cases et se lit verticalement. Shuruppak, vers 2600 AEC. Musée du Louvre, photo Marie-Lan Nguyen.

Le bengali

Le Bengali est la langue nationale du Bangladesh. Il fait partie des vingt-deux langues officielles de l’Inde. C’est la langue des états du Bengale-occidental et de Tripura. Selon l’Inalco il y aurait dans le monde 250 millions de locuteurs et de locutrices de cette langue.

Il figurait déjà dans les blocs Unicode 0980 à 09FF. La version 18 vient d’ajouter un supplément : 11DF0 à 11DFF.

Aspect « technique »

Les modifications plus « techniques » concernent presque essentiellement la prise en compte de ces nouveaux systèmes d’écritures avec l’ajout de fichiers de données.

À cela se rajoutent des recommandations destinées aux implémentations pour rendre plus visibles les utilisations non conformes des sélecteurs de variation. Le langage de conformité de ces derniers a été mis à jour.

Des émojis et des symboles divers

Vous avez sans doute deviné au moins un des nouveaux émojis de cette version, on a donc :

  • un cornichon, pickle, U+1FADD, 🫝, à ne pas confondre avec le concombre, U+1F952, 🥒 qui existait déjà ;
  • une face fissurée, cracking face, qui ressemble assez à un genre de sablé rond avec des lézardes sur le pourtour, U+1FAEB, 🫫 ;
  • un filet à papillon, net with handle, U+1FA8D, 🪍,
  • une gomme, eraser, U+1FA8C, 🪌, impeccable en période de rentrée des classes ;
  • une météorite, meteor, U+1FA8B, 🪋 ;
  • et un papillon monarque, monarch buttterfly, U+1FACC, 🫌. C’est d’ailleurs assez intéressant cet ajout car il existait déjà un papillon 🦋, U+1F98B.

Unicode 18 voit arriver des symboles musicaux supplémentaires : bloc 1D250 à 1D28F. On y trouvera notamment des symboles pour l’utilisation des talons et des orteils pour les pédales d’orgue, respectivement U+1D273 et U+1D274 ou encore, U+1D256, le symbole pour le bémol quart de ton arabe.

Les symboles divers et flèches se voient également gratifier de nouvelles entrées aux blocs 1DB00 à 1DBFF. Par exemple en U+1DB0A les deux lignes « plus grand que » et en 1DB0B les deux lignes « plus petit que ». Les deux symboles affichent deux lignes horizontales de tailles inégales.

Remerciement et mots de la fin

Cette dépêche n’aurait sans doute pas été rédigée si rapidement après la sortie d’Unicode 18 sans Stéphane Bortzmeyer qui m’a fait lire en avant-première sa note de blog au moment où j’allais lui demander de me tenir au courant. Tous mes remerciements. Évidemment, je vous suggère fortement de lire sa note de blog sur le sujet.

La version originale de l’image de tête est sur OpenClipart (EN), elle a été dessinée par qubodup (EN). Le bocal avait un couvercle bleu (EN) que l’auteur a repeint en vert (EN). Plus tard, oksmith (EN) a rempli le bocal de cornichons (EN), bocal que j’ai malencontreusement renversé (EN).

Et, bien sûr si vous avez la chanson de Nino Ferrer qui tourne en boucle dans votre crâne, je dénie toute responsabilité.


  1. Selon les sources, on recense cinq ou six styles d’écriture chinoise. ↩

  2. Les radicaux sont les clés qui composent les idéogrammes chinois. ↩

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Présentation de SlyOS, un système basé sur Arch linux équipé d'OpenRC, ReGreet et niri
    Arch Linux est une distribution très connue pour être une bonne base permettant de créer son propre système Linux personnalisé de fond en comble. La possibilité d’y ajouter des logiciels libres peu connus du grand public via l' AUR est l’une des grandes forces d’Arch Linux. J’ai donc une vision personnelle assez précise du bureau Linux idéal, et je souhaite la partager ici en vous présentant un projet sur lequel je travaille depuis un peu moins d’un an, presque non-stop. Ma propre distribution

Présentation de SlyOS, un système basé sur Arch linux équipé d'OpenRC, ReGreet et niri

Arch Linux est une distribution très connue pour être une bonne base permettant de créer son propre système Linux personnalisé de fond en comble. La possibilité d’y ajouter des logiciels libres peu connus du grand public via l' AUR est l’une des grandes forces d’Arch Linux.

J’ai donc une vision personnelle assez précise du bureau Linux idéal, et je souhaite la partager ici en vous présentant un projet sur lequel je travaille depuis un peu moins d’un an, presque non-stop. Ma propre distribution Linux : SlyOS, un système d'exploitation libre distribué sous licence GPLv3.

Par exemple, voici quelques logiciels disponibles dans l'AUR : DeaDBeeF, Cine, Warehouse, Carburetor, …

Arch Linux est aussi une distribution valorisée par son choix presque illimité d'environnements de bureau. En effet, on peut prendre l'exemple de mon expérience personnelle sur ce point.

J’ai tout d'abord commencé par découvrir GNOME. Son interface m’a immédiatement convaincu et il reste aujourd’hui l’un de mes environnements de bureau préférés. La principale réserve que j’ai à son sujet concerne sa dépendance trop marquée à plusieurs composants de systemd (j’expliquerai plus tard dans la dépêche ce qui me tracasse vraiment à ce sujet).

GNOME

J’ai ensuite essayé plusieurs environnements de bureau moins répandus, notamment Pantheon. Je reste particulièrement attaché à son interface, mais j’ai fini par l’abandonner en raison de bugs que j’ai rencontrés avec le compositeur Gala, ainsi que des difficultés liées à la transition de X11 vers Wayland. Cette transition a notamment retiré Plank, que j’appréciais beaucoup, sans vraiment lui apporter de remplaçant…

Pantheon

Ou encore moins connu : herbstluftwm que j'aimais beaucoup mais que j'ai fini par abandonner aussi à cause du manque d'outils de personnalisation sur X11 pour un gestionnaire de fenêtre si minimal.

herbstluftwm

J'ai aussi testé plein d'autres gestionnaires de fenêtre et de d'environnements de bureau tels que Cinnamon, Xfce, Hyprland, Fluxbox, LXQt, MATE, Sway, IceWM…

Avec le temps, j'ai façonné quelques opinions sur les différentes options que nous propose la communauté. Par exemple, cela peut en affecter certains, mais j’essaie d’éviter Qt au maximum et de privilégier GTK. Ma position concerne principalement le modèle économique de Qt : je ne reproche pas à un projet libre de chercher à se financer, mais Qt repose notamment sur les revenus provenant de logiciels propriétaires et de licences commerciales (proposant des offres payantes sur son site web). Je préfère donc soutenir des projets qui privilégient d’autres modèles, comme les dons, à l’image de ce qui existe autour de GTK. Ma position peut paraître controversée, notamment parce que l’écosystème Linux dépend lui aussi largement de grandes entreprises (comme Google, ou même Microsoft qui détient GitHub). Je ne prétends donc pas pouvoir éviter toute dépendance de ce type, mais j’essaie, autant que possible, de privilégier des logiciels et des projets capables de subsister sans être directement financés par le logiciel propriétaire.

De même, je n’aime pas vraiment systemd car c'est de plus en plus un programme qui obtient le monopole, avec une étendue de fonctionnalités et une complexité qui s'éloignent du principe KISS. Surtout que récemment, systemd a été au cœur de débats controversés, notamment à travers une proposition de vérification de l’âge intégrée directement à celui-ci. Le problème n’est pas uniquement l’existence de ce champ optionnel (birthDate), mais le fait que systemd puisse devenir un point central pour intégrer ce type de mécanisme à l’avenir. C'est pourquoi je préfère limiter les composants centraux aux fonctions dont le système a réellement besoin.

Cette problématique de vérification d'âge ne se limite d'ailleurs pas à systemd : le plus gros problème actuel est aussi xdg-desktop-portal. Mais il est à l'heure actuelle compliqué de changer cela, puisque xdg-desktop-portal est une dépendance presque cruciale dans Arch Linux. Un paquet alternatif contenant un patch pourrait être envisageable dans le dépôt de SlyOS via notamment l'alternative de xdg-desktop-portal Ageless Linux, mais je n'ai pas vraiment le temps d'accomplir cela pour l'instant.

J'ai dû parfois remettre en question certaines de mes opinions comme ma préférence à X11. Cela a par exemple opéré quand j'ai découvert niri et la stabilité et fluidité de Wayland nettement supérieure à X11.

niri

SlyOS
SlyOS est basé sur Arch Linux et construit à l’aide d’archiso. Le projet a commencé comme une expérience personnelle pour en apprendre davantage sur Linux. Je me suis rendu compte par la suite qu’il y avait un réel intérêt à proposer ma vision du bureau Linux parfait, car je ne l’avais étrangement vue nulle part ailleurs (par défaut dans un système d'exploitation).

Je sais que les concepts revendiqués par une distribution peuvent paraître flous ou consensuels (moderne, léger, simple à utiliser, intuitive, personnalisable, performant, stable, respectant le principe KISS), mais dans SlyOS, chacun de ces principes correspond à des choix concrets et justifiés qui permettent à SlyOS d'être une distribution :

  • Moderne : SlyOS propose niri, un gestionnaire de fenêtres entièrement basé sur Wayland, relativement récent, qui a déjà fait ses preuves (notamment par sa popularité en croissance exponentielle) et qui bénéficie d’un développement actif.

  • Légère : la version minimale de SlyOS contient moins de 700 paquets, tandis que la version complète en contient moins de 850. Les ISO sont nettement plus légères que celles de nombreuses distributions x86_64, réduisant les composants susceptibles de poser problème, sans pour autant supprimer les fonctionnalités essentielles.

  • Simple d’utilisation et intuitive : SlyOS propose un programme d’accueil dès le live ou après l'installation, présentant les raccourcis principaux. Le système peut être utilisé sans ligne de commande grâce à Pamac. Le bureau minimal et l'accès aux paramètres permettent à un débutant de prendre le système en main rapidement.

  • Performante et stable : SlyOS utilise le noyau linux-cachyos-lts pour un bon compromis performances/stabilité. La consommation de RAM au démarrage est très basse grâce à un nombre limité de services en arrière-plan grâce à l'esprit minimaliste de SlyOS.

  • Personnalisable : SlyOS s’appuie sur des outils Wayland comme Ironbar, Wofi, Hyprlock ou Vibepanel. Ils offrent un environnement complet tout en laissant une grande liberté de modification (ils peuvent être désinstallés et remplacés). Le choix de niri facilite également cette personnalisation profonde puisque largement reconnu dans le domaine du "Rice".

  • Respectueuse de la vie privée : remplacer systemd par OpenRC est une première marche vers une meilleure protection de la vie privée dans un système Linux. De plus, SlyOS contient LibreWolf, un navigateur axé sur la vie privée bloquant le pistage, ainsi que les extensions uBlock Origin (bloqueur de pubs et traqueurs efficace) et Decentraleyes (empêche le suivi par les CDN en servant les ressources localement). Il intègre aussi le DNS Mullvad Base qui chiffre vos requêtes DNS pour empêcher les écoutes et les fuites de données vers votre FAI.

  • Suivre le principe KISS en évitant systemd (plus d'informations ici) : SlyOS utilise OpenRC, un système d'initialisation qui suit une approche plus modulaire et plus proche du principe KISS que systemd, régulièrement critiqué pour son poids et sa complexité. Ce choix permet d'éviter de renforcer la position dominante de systemd tout en limitant les risques de dérive (comme l'intégration d'un champ birthDate).

À ses débuts, la distribution ne respectait pas entièrement tous ces critères. Elle utilisait GNOME / MATE, avec systemd ainsi que le noyau linux-cachyos-lts.

La distribution ressemblait à ceci à ses débuts, dans sa version 0.1 « Dxtrus » (pour "dexterous" en anglais) :

SlyOS

SlyOS

Depuis, le projet a considérablement évolué et est progressivement devenu un système plus complet et abouti, illustrant concrètement la direction prise par SlyOS. La version 0.2 « Invativ » (pour "innovative" en anglais) utilise désormais :

  • niri comme gestionnaire de fenêtres
  • OpenRC comme système d’initialisation
  • ReGreet, une interface de connexion en GTK4 écrite en Rust pour greetd
  • Le noyau linux-cachyos-lts
  • Plymouth pour afficher un écran graphique lors du démarrage et de l’arrêt du système

Voici à quoi ressemble la distribution depuis :

SlyOS

SlyOS

La distribution inclut également un centre de contrôle appelé Thymbr, qui permet de configurer de nombreux aspects du système depuis une interface centralisée. Cela rend SlyOS bien plus intuitif et simple d’utilisation, bien que le caractère intuitif se juge surtout à l'utilisation.

Le site web du projet est disponible ici

Je vous conseille d’y jeter un coup d’œil. Le site propose une version française et fournit des explications plus approfondies sur le projet, notamment à travers les principes présentés sur la page d’accueil ainsi que la FAQ, accessible dans la catégorie « Aide ». Le meilleur moyen de se faire une opinion reste de tester SlyOS, par exemple dans une machine virtuelle.

La configuration archiso est disponible sur Codeberg : https://codeberg.org/Minaucro/SlyOS

Je travaille à rendre SlyOS pratique, optimisé, simple et performant, selon ma propre vision d’un système d’exploitation Linux destiné aux ordinateurs de bureau. Le projet est encore en développement, mais il est déjà suffisamment mature pour être testé et utilisé au quotidien.

Merci d’avoir pris le temps de me lire.


SlyOS a été créé par Minaucro (slyos@minaucro.fr).

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • G’MIC 4.0 : La quadrature du pixel, plus facile que jamais !
    Dix-huit ans après ses débuts, G’MIC, cadriciel libre pour le traitement des images numériques, franchit une étape importante avec la sortie d'une nouvelle version majeure, numérotée 4.0, la version de la maturité ! L'occasion, comme chaque année, de faire le point sur les évolutions récentes de ce projet, depuis notre dernière dépêche publiée en août 2025. N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images conti

G’MIC 4.0 : La quadrature du pixel, plus facile que jamais !

Dix-huit ans après ses débuts, G’MIC, cadriciel libre pour le traitement des images numériques, franchit une étape importante avec la sortie d'une nouvelle version majeure, numérotée 4.0, la version de la maturité !

L'occasion, comme chaque année, de faire le point sur les évolutions récentes de ce projet, depuis notre dernière dépêche publiée en août 2025.

G´MIC 4.0 Teaser

N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images contiennent l’icône Icône 'Play Video'

Sommaire

1. G’MIC : Un cadriciel libre pour l'image numérique

Le projet G'MIC (GREYC's Magic for Image Computing) est né en juillet 2008, et a grandi au sein de l'équipe IMAGE du laboratoire GREYC de Caen (Unité Mixte de Recherche placée sous la triple tutelle du CNRS, de l'ENSICAEN et de l'Université de Caen).

Sa vocation : offrir un cadriciel libre, ouvert et extensible pour la manipulation, le traitement et la création d'images numériques. Pour ce faire, il s'appuie sur les fonctionnalités de la bibliothèque libre C++ de traitement d'images CImg, développée depuis 1999 d'abord au sein de l'INRIA, puis de l'équipe IMAGE du GREYC (également par votre serviteur).

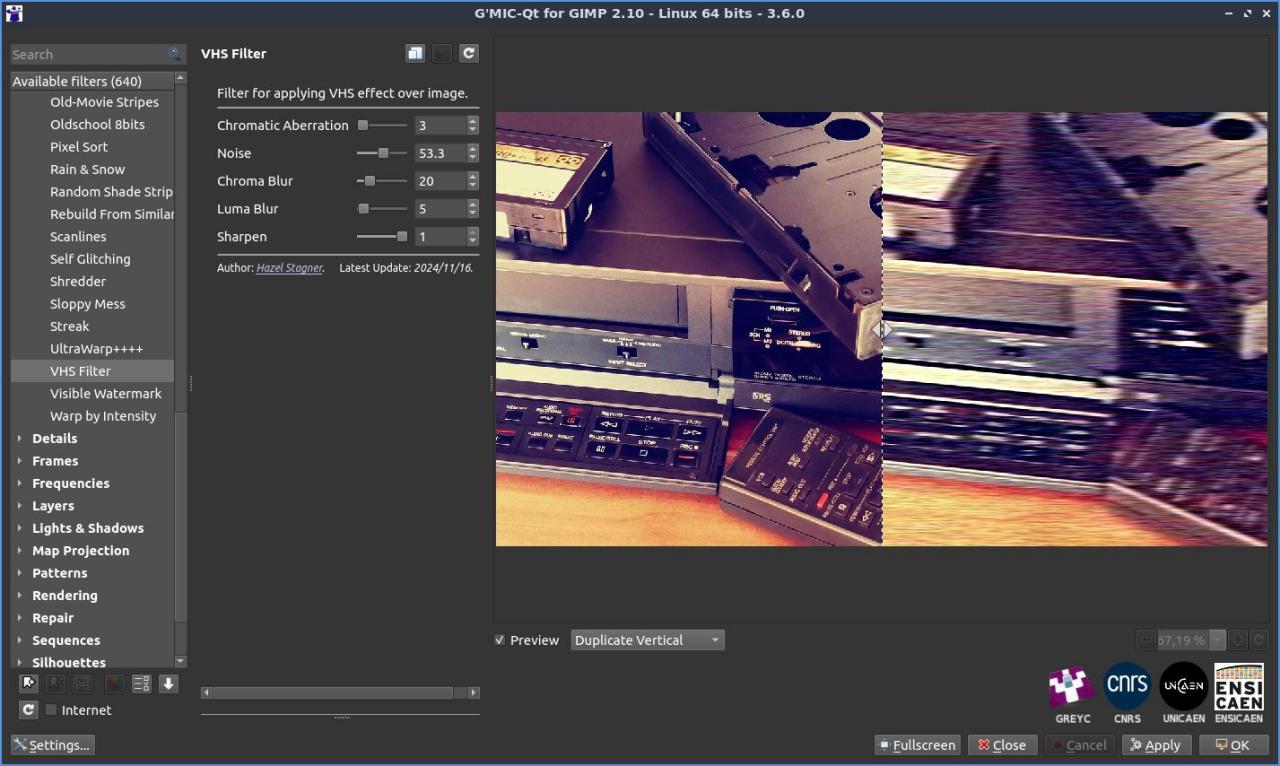
Au cœur du projet se trouve un interpréteur de langage de script dédié, le « langage G'MIC », spécialement conçu pour prototyper rapidement de nouveaux algorithmes de traitement d'images, et les enchaîner au sein de pipelines (ou filtres) personnalisés. Autour de ce noyau viennent se greffer plusieurs interfaces, donnant à l'utilisateur accès à des centaines d'opérateurs de traitement d'images prédéfinis, comme par exemple l'outil en ligne de commande gmic ; le service Web G'MIC Online ; et le greffon G'MIC-Qt, qu'il est possible d'intégrer dans plusieurs logiciels de création et d'édition d'images, tels que GIMP, Krita, digiKam, Paint.net, Adobe Photoshop ou Affinity Photo. C'est aujourd'hui ce greffon qui est l'interface du projet la plus utilisée, avec plus de 1200 téléchargements quotidiens, en progression depuis un an. Il propose plus de 640 filtres variés pour triturer vos images et enrichir les possibilités des logiciels de retouche, et semble particulièrement apprécié des artistes numériques.

Cette version majeure 4.0 marque un tournant dans la vie du projet : la syntaxe du langage G'MIC, le code de l'interpréteur et des algorithmes de traitement d'images associés sont maintenant éprouvés. Nous souhaitons donc ralentir un peu le rythme des nouvelles releases et de l'ajout de nouvelles fonctionnalités, pour nous concentrer sur la stabilité, la robustesse, et les performances du cadriciel.

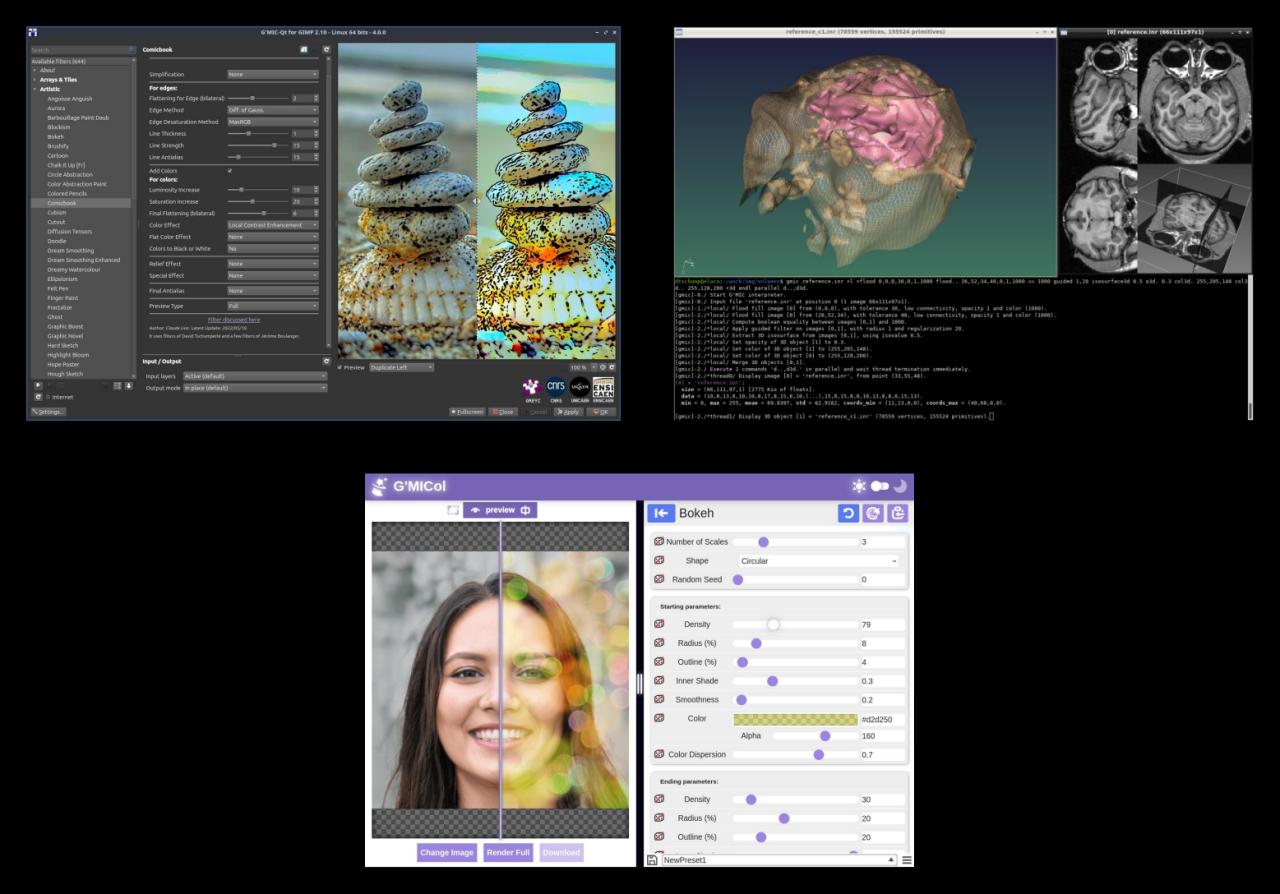
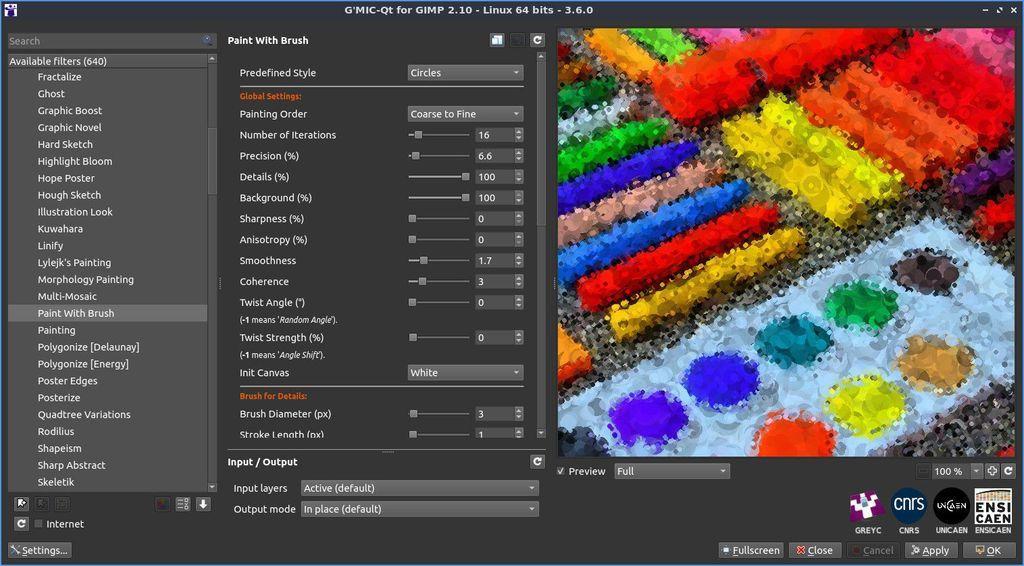
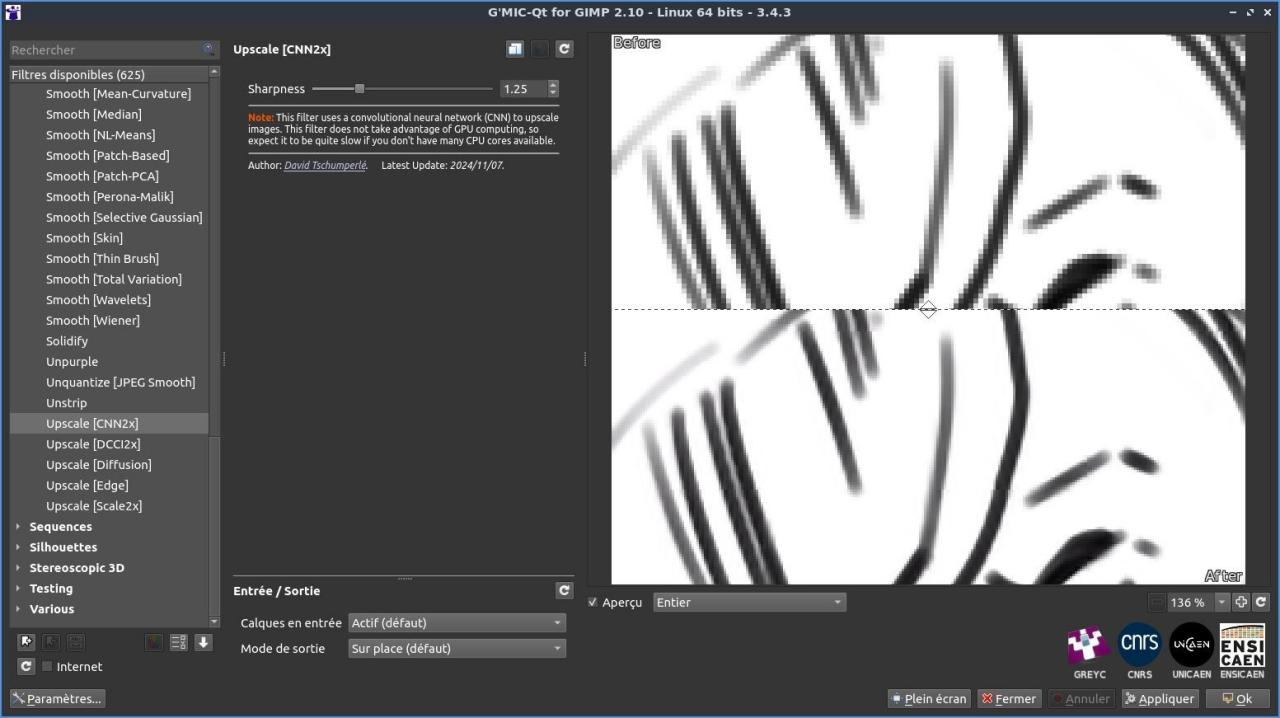
Aperçu du greffon G'MIC-Qt Fig. 1.1. Aperçu de quelques-unes des interfaces proposées par le projet G'MIC : Greffon G'MIC-Qt pour GIMP (en haut à gauche), Outil CLI gmic (en haut à droite), Service web G'MIC Online (en bas).

2. Nouveaux filtres du greffon G'MIC-Qt

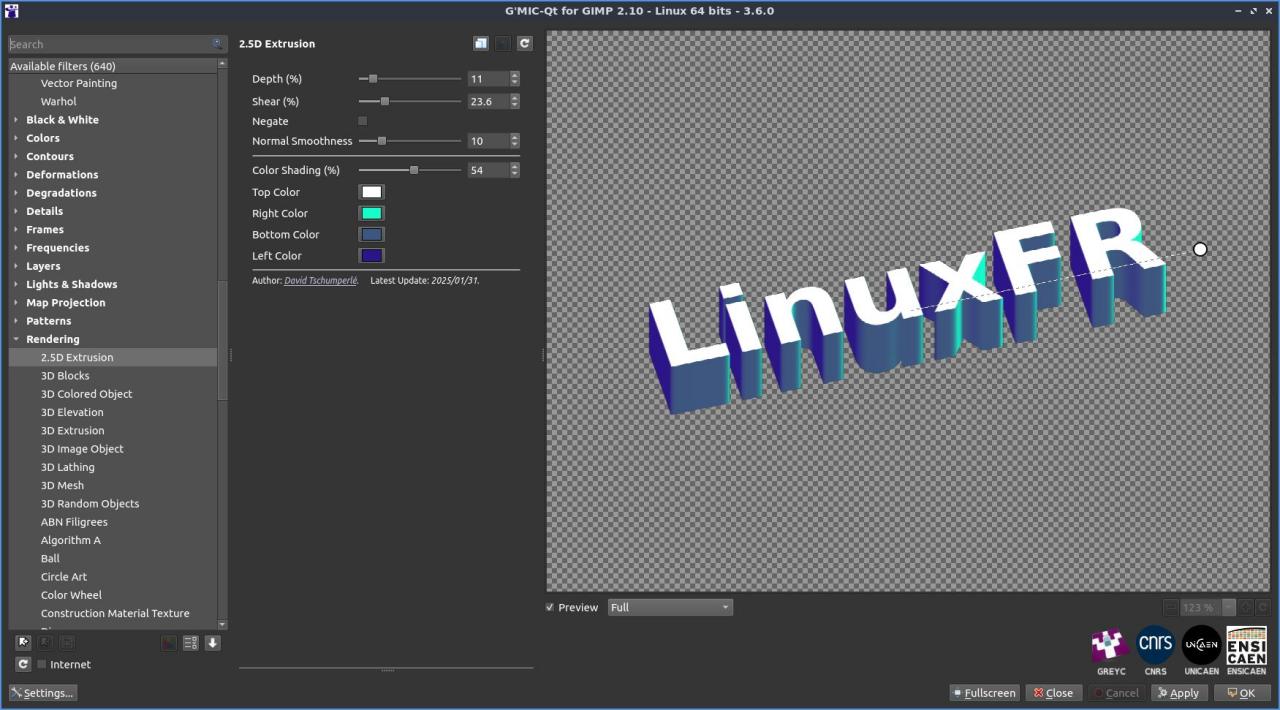
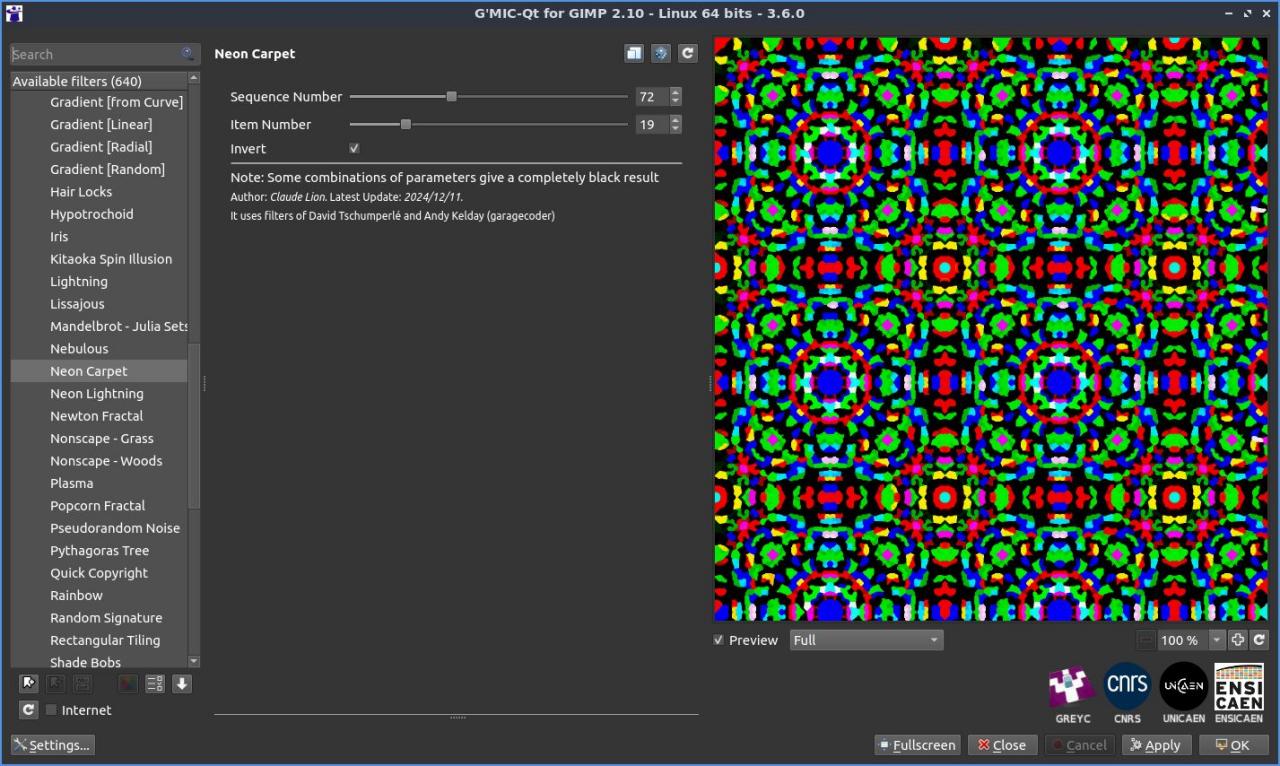
Côté greffon G'MIC-Qt, l'essentiel des nouveautés se concentre sur l'apparition de nouveaux filtres de traitement d'images. La version 4.0 porte leur nombre à 644, tous accessibles directement depuis l'interface graphique. Je liste ci-dessous les derniers filtres ajoutés.

2.1. Filtre « Rendering / Pixel Stretch »

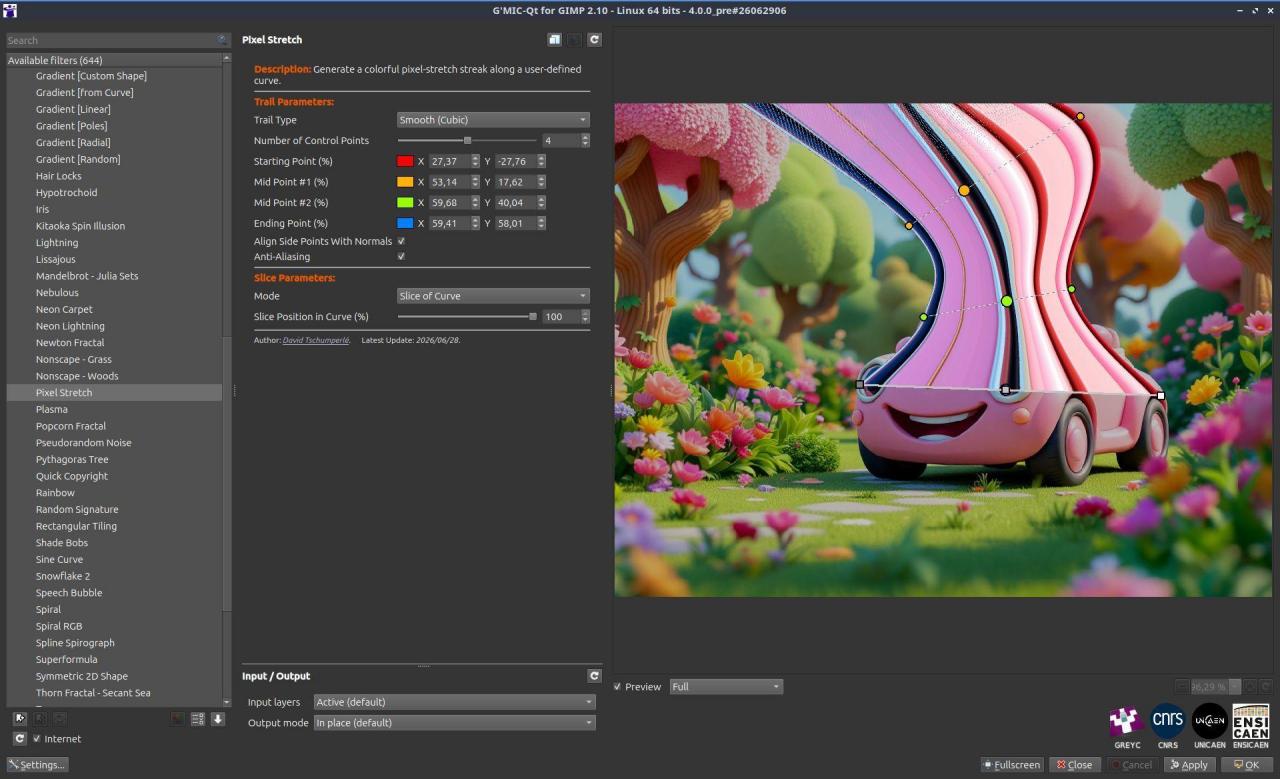
Le filtre « Rendering / Pixel Stretch » permet de sélectionner une « bande de pixels », et la duplique dans l'image en lui faisant suivre une trajectoire personnalisable, définie par deux courbes splines (une pour chaque bord de la bande).

Filtre 'Rendering/Pixel Stretch' (G'MIC-Qt) Fig. 2.1.1. Le filtre « Rendering / Pixel Stretch » tel qu'il apparait dans le greffon G'MIC-Qt.

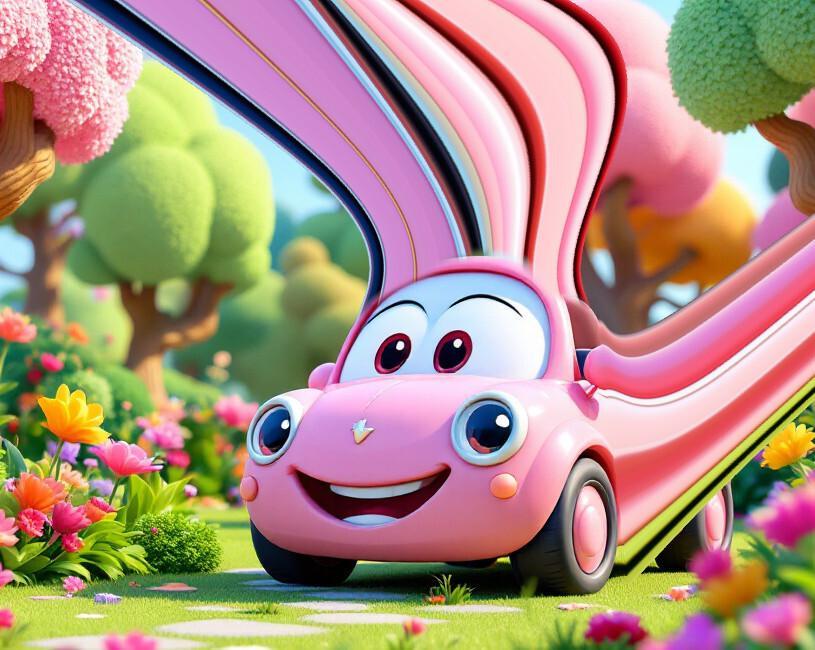
Filtre 'Rendering/Pixel Stretch' (rendu 1) Fig. 2.1.2. Exemple de rendu du filtre « Rendering / Pixel Stretch », ici avec deux traînées de pixels ajoutées par le filtre.

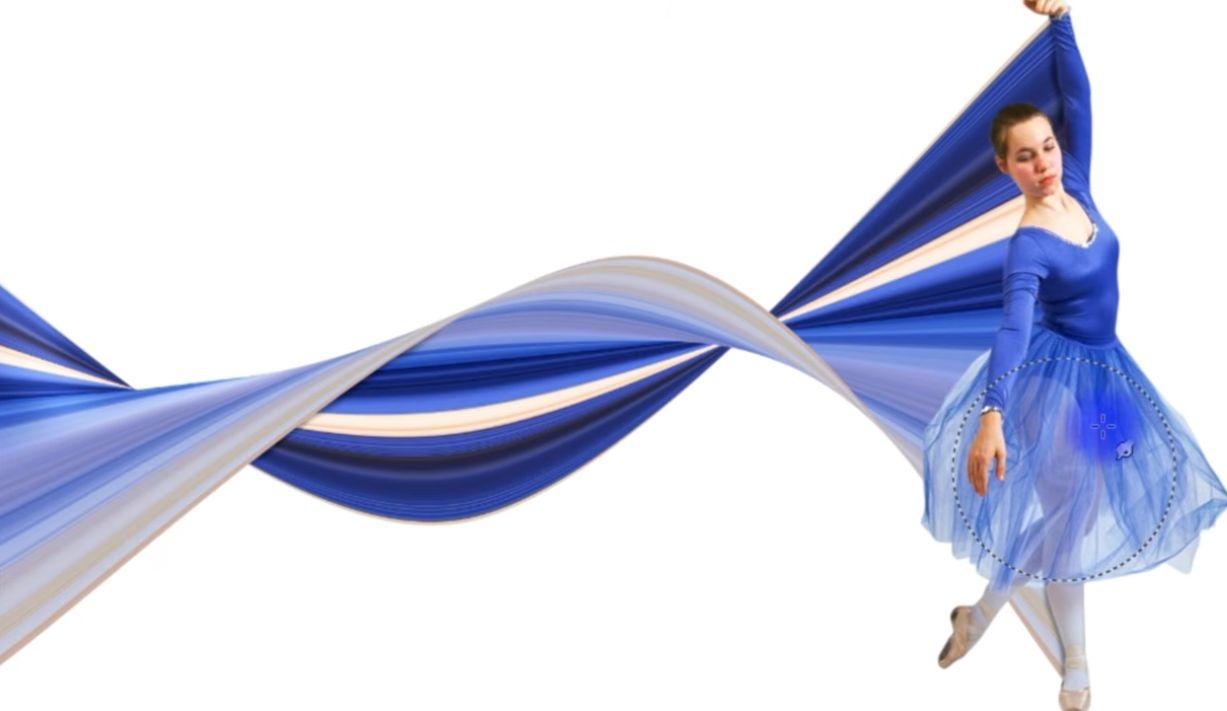
Cet effet donne l'impression que l'image a été étirée localement, un peu comme une pâte élastique. Il peut servir à suggèrer ou styliser un mouvement dans une image, comme sur l'exemple ci-dessous (extrait de la vidéo tutorielle que Miguel Pineau a spécialement dédiée à ce filtre).
On peut également imaginer son utilisation pour du Glitch art ou de la création de textures abstraites.

Filtre 'Rendering/Pixel Stretch' (rendu 2) Fig. 2.1.3. Le filtre « Rendering / Pixel Stretch » appliqué pour styliser le mouvement d'une danseuse (Crédits : Miguel Pineau).

2.2. Filtre « Rendering / Gradients [Poles] »

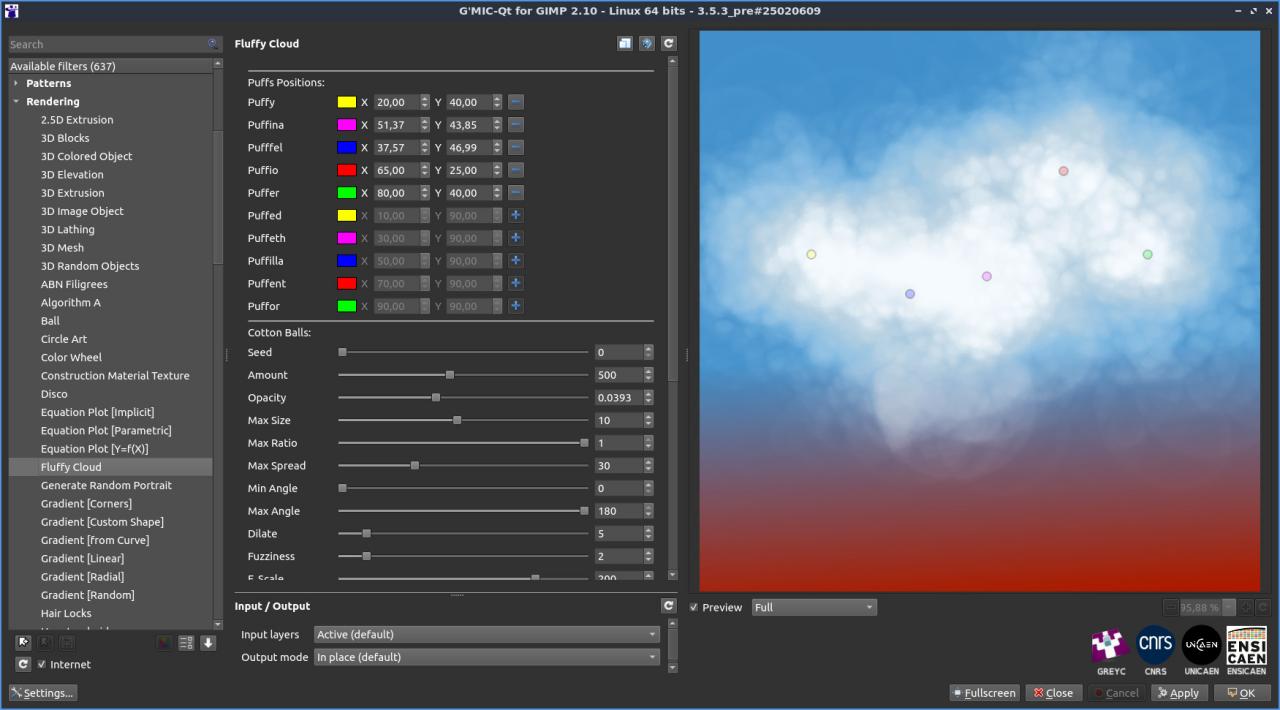
Toujours dans cette section « Rendering », notons l'arrivée de « Rendering / Gradients [Poles] », un filtre générant des dégradés de couleurs en interpolant spatialement des points-clés colorés, dont les positions et les couleurs sont laissées au choix de l'utilisateur. Ici, l'interpolation fait usage des fonctions de base radiale qui produisent des dégradés de couleurs lisses et harmonieux. L'utilisateur a également le choix de l'espace de couleurs dans lequel l'interpolation s'effectue. L'animation ci-dessous illustre le fonctionnement de ce filtre au sein du greffon.

Filtre 'Rendering/Gradient (Poles)' (G'MIC-Qt) Fig. 2.2.1. Le filtre « Rendering / Gradient [Poles] » crée des gradients spatiaux de couleurs possiblement complexes, à partir de quelques points de contrôle.

2.3. Filtre « Artistic / Marker Drawing »

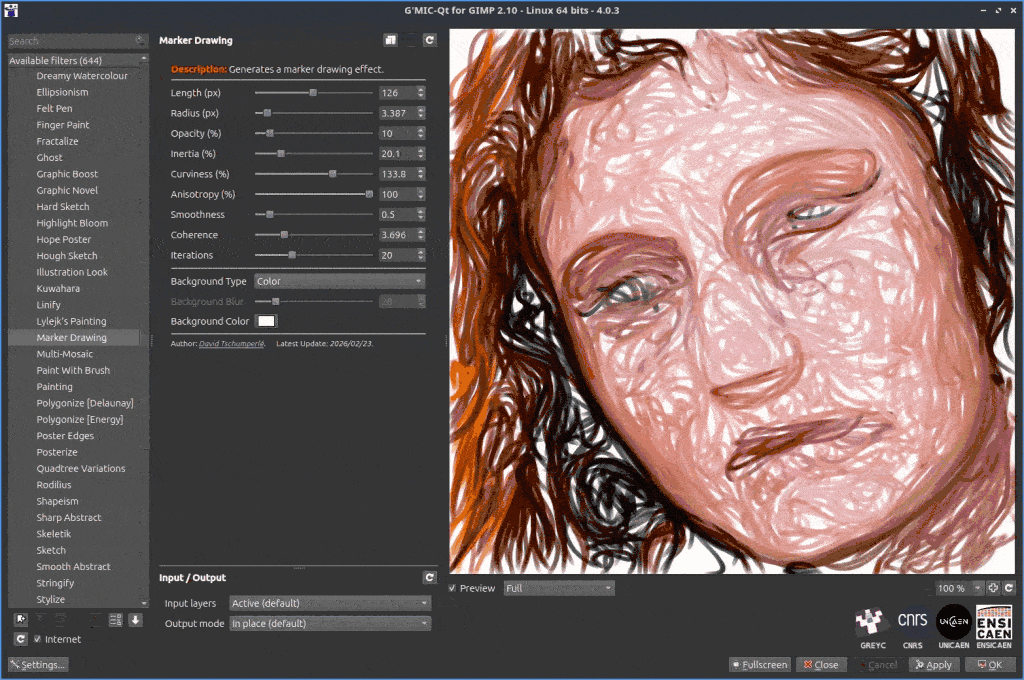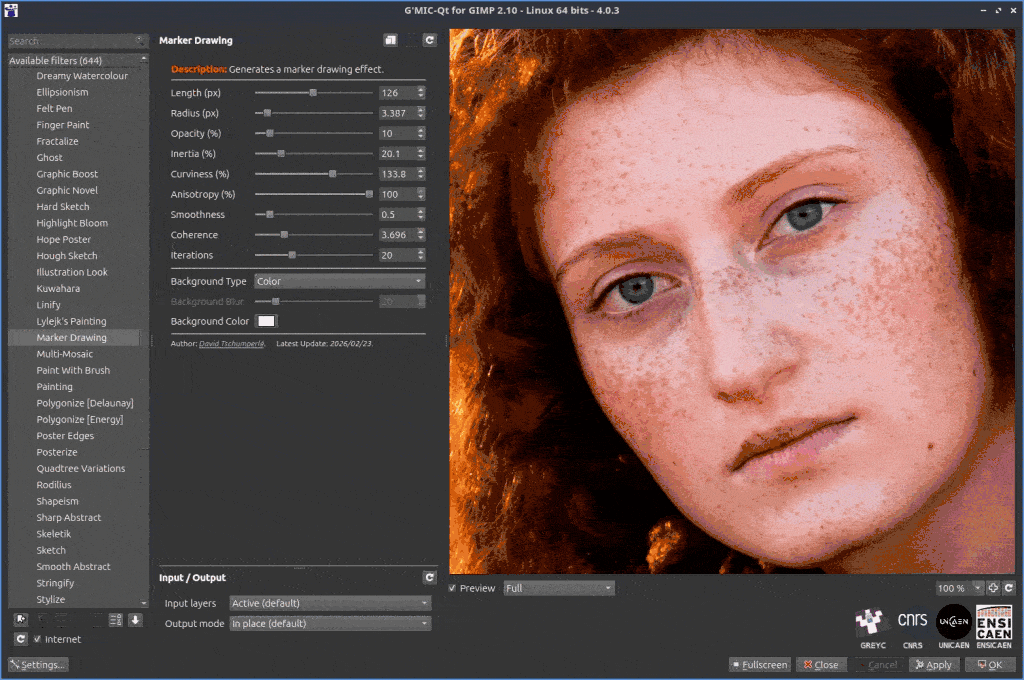
Passons maintenant au filtre « Artistic / Marker Drawing », qui comme son nom l'indique, essaye de redessiner une image d'entrée sous la forme de traits de stylos feutres colorés. L'algorithme sous-jacent trace effectivement des splines colorées aléatoires sur une feuille blanche, le long des contours des structures géométriques présentes dans l'image à reproduire.

Filtre 'Artistic/Marker Drawing' (G'MIC-Qt) Fig. 2.3.1. Le filtre « Artistic / Marker Drawing » redessine une image en simulant l'utilisation de stylos feutres colorés.

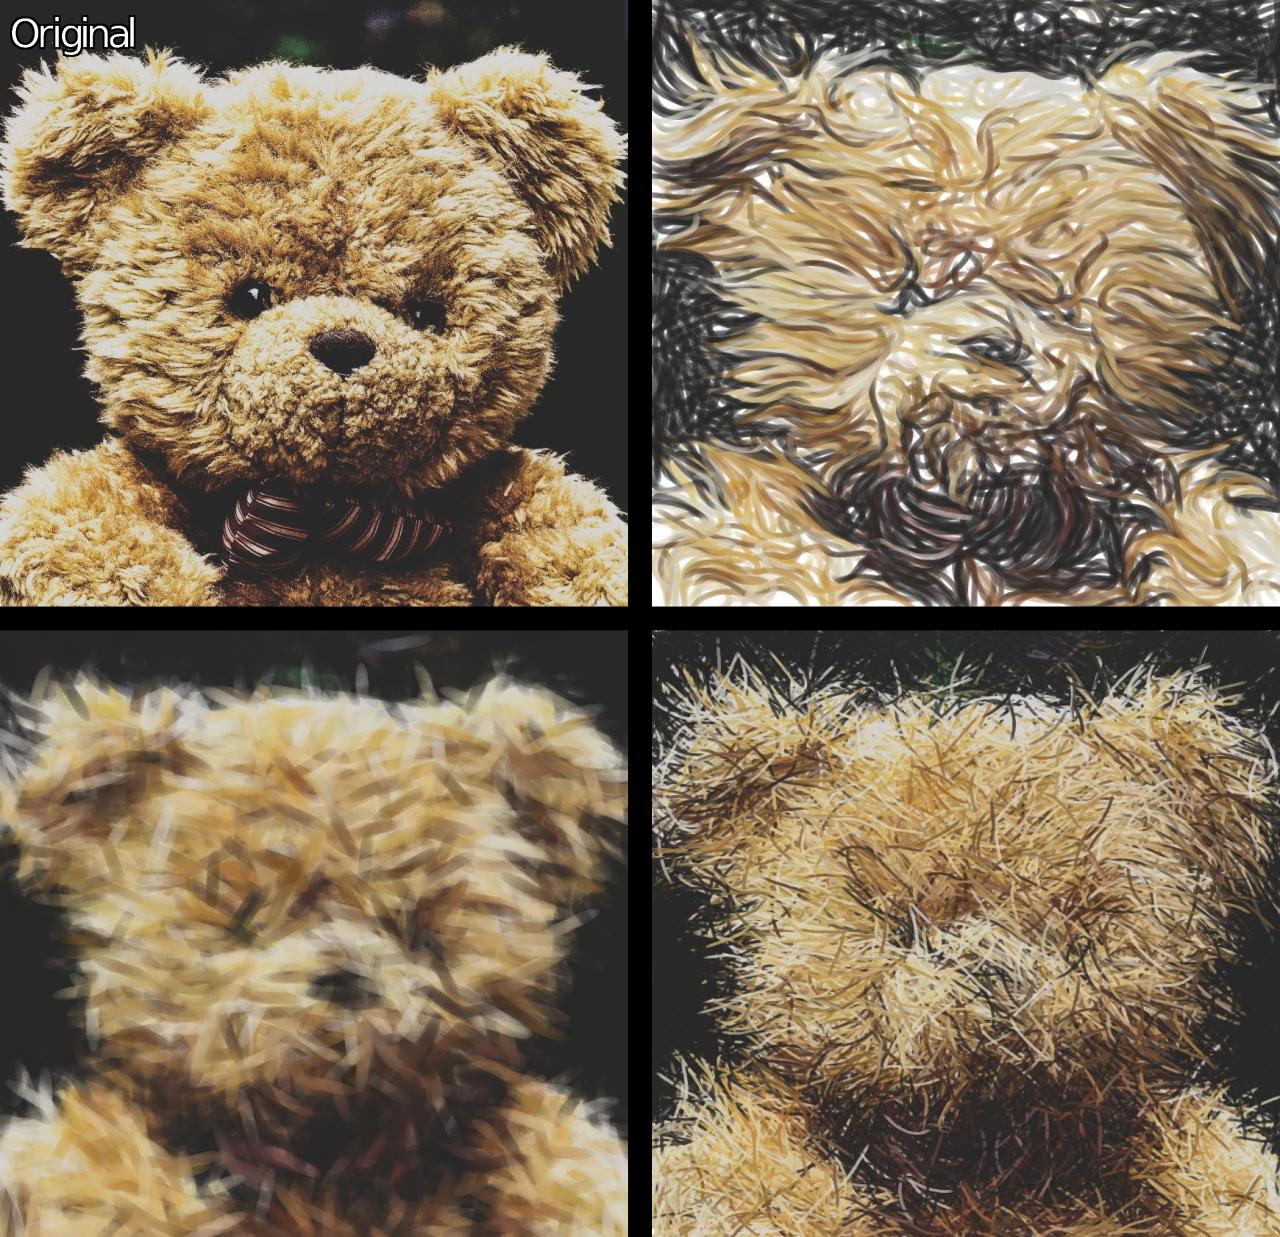
Les nombreux paramètres réglables de ce filtre permettent d'obtenir des rendus potentiellement variés, plus ou moins abstraits, comme l'illustre la figure comparative suivante :

Filtre 'Artistic/Marker Drawing' (rendus) Fig. 2.3.2. Trois types de rendus du filtre « Artistic / Marker Drawing », utilisant trois jeux de paramètres différents.

2.4. Filtre « Deformations / Heightfield Warp »

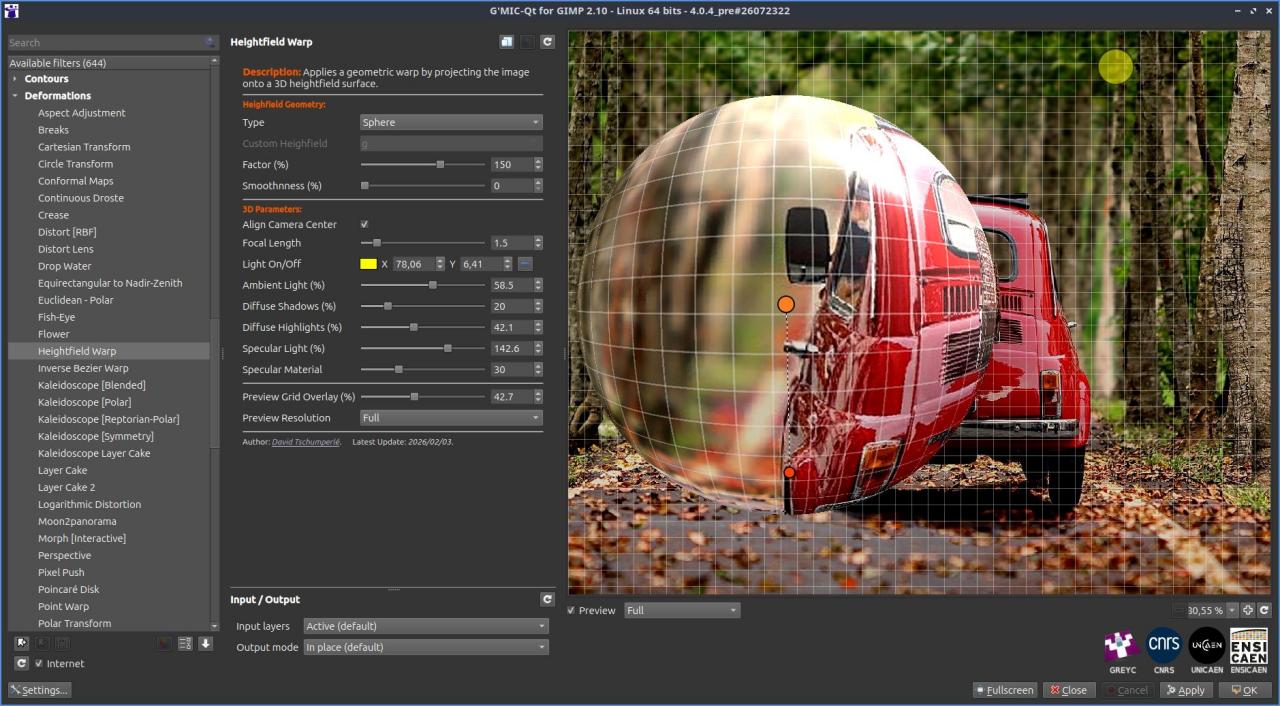
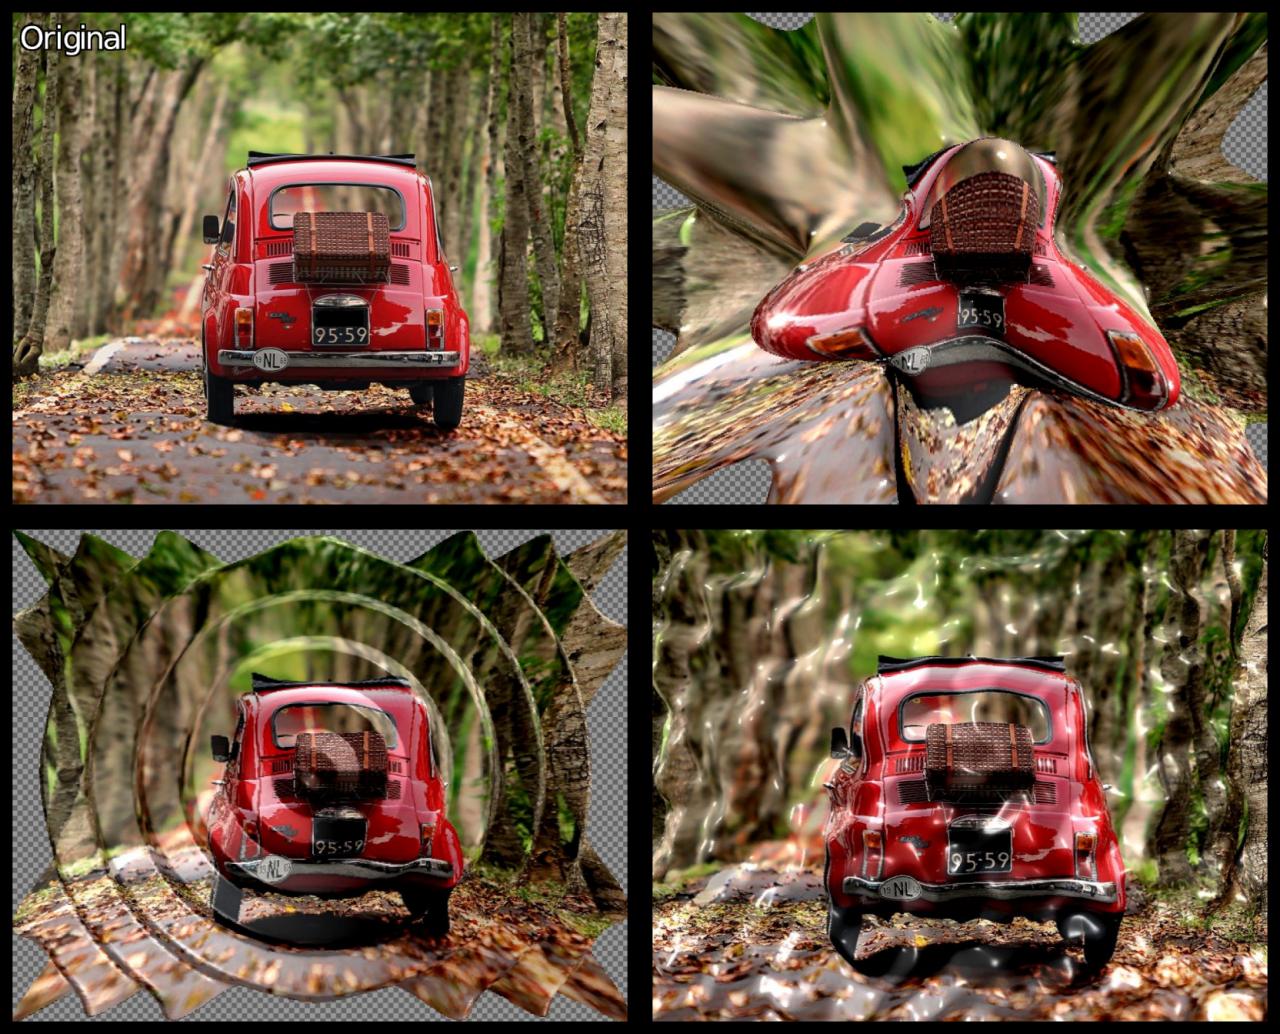
Changeons maintenant de thématique avec le filtre « Deformations / Heightfield Warp » qui crée un effet 3D, en déformant une image d'entrée comme si elle était plaquée sur une carte d'élévation (définie de manière paramétrique). Un effet d'éclairage additionnel, de type ombrage de Phong, peut être activé pour accentuer davantage l'effet de volume 3D produit par ce filtre.

Filtre 'Deformations/Heightfield Warp (G'MIC-Qt) Fig. 2.4.1. Le filtre « Deformations / Heightfield Warp », tel qu'il apparait dans le greffon G'MIC-Qt, ici avec une élévation correspondant à une demi-sphère bombée vers la caméra.

Ce filtre est particulièrement flexible : il laisse la possibilité à l'utilisateur de définir explicitement des formules mathématiques personnalisées pour les cartes d'élévations. Les mathématiciens en herbe peuvent ainsi laisser libre cours à leur imagination pour déformer leurs images !

Filtre 'Deformations/Heightfield Warp (rendus) Fig. 2.4.2. Application de trois formules personnalisés de cartes d'élévations 3D, avec le filtre « Deformations / Heightfield Warp ».

2.5. Filtre « Degradations / Offset Stripes »

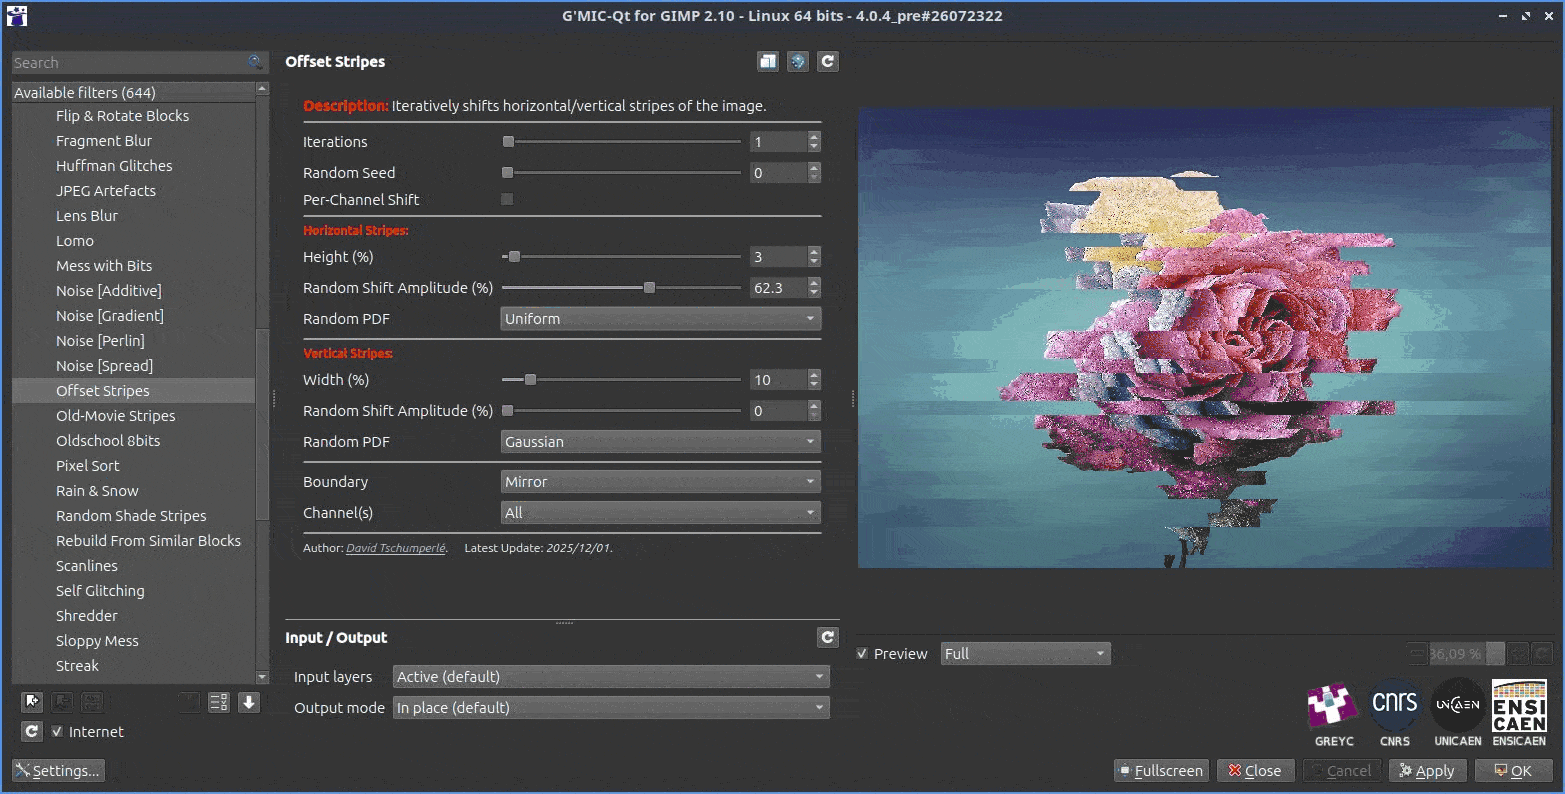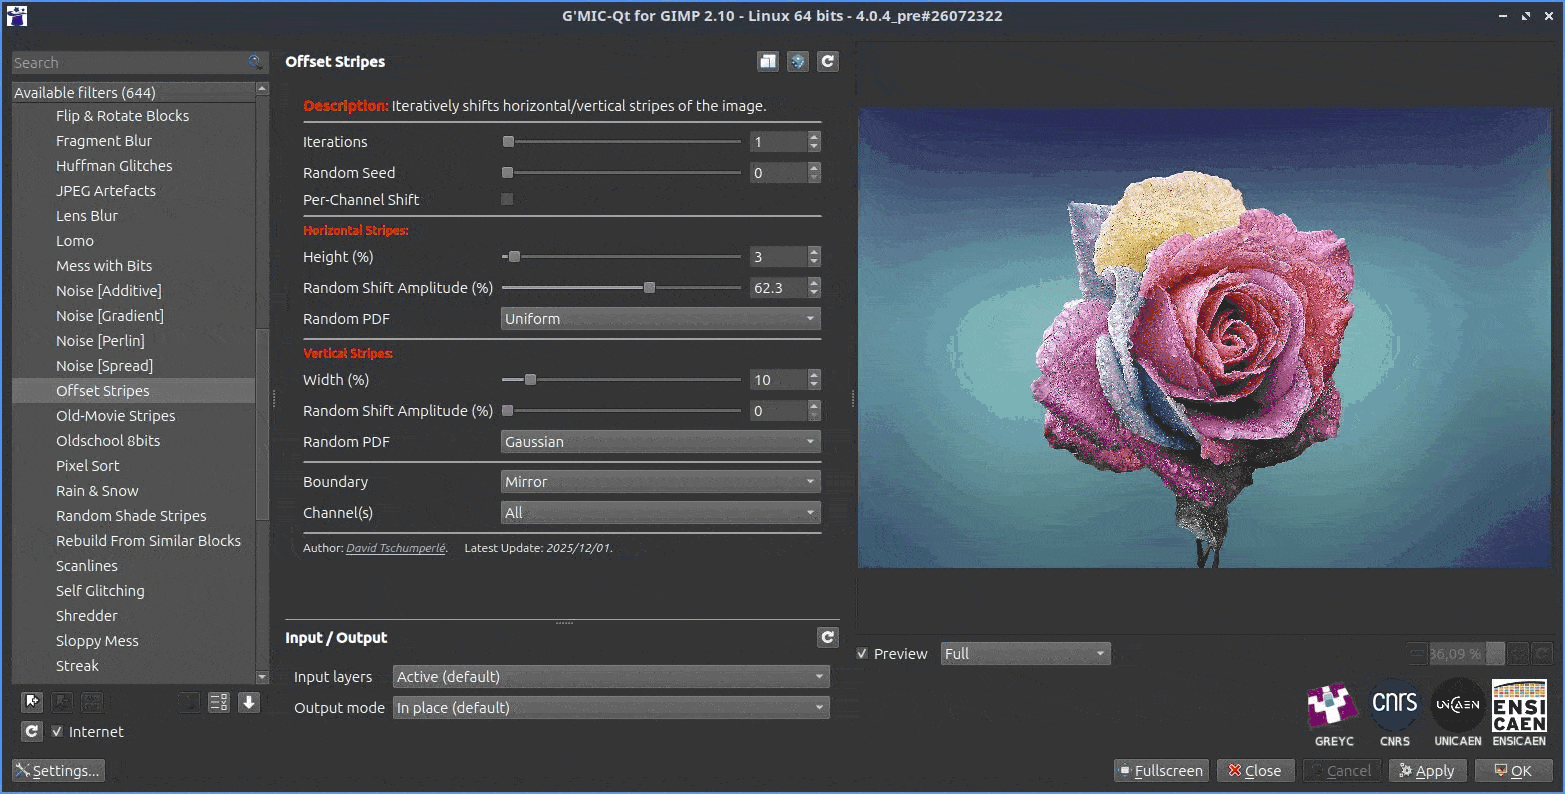
Les amateurs de Glitch art pourront être séduits par le nouveau filtre « Degradations / Offset Stripes », qui crée un effet de décalage de bandes d'images, horizontales et/ou verticales, avec des amplitudes de décalage aléatoires.

Filtre 'Degradations/Offset Stripes (G'MIC-Qt) Fig. 2.5.1. Le filtre « Degradations / Offset Stripes » applique des décalages aléatoires sur des bandes d'images horizontales et/ou verticales.

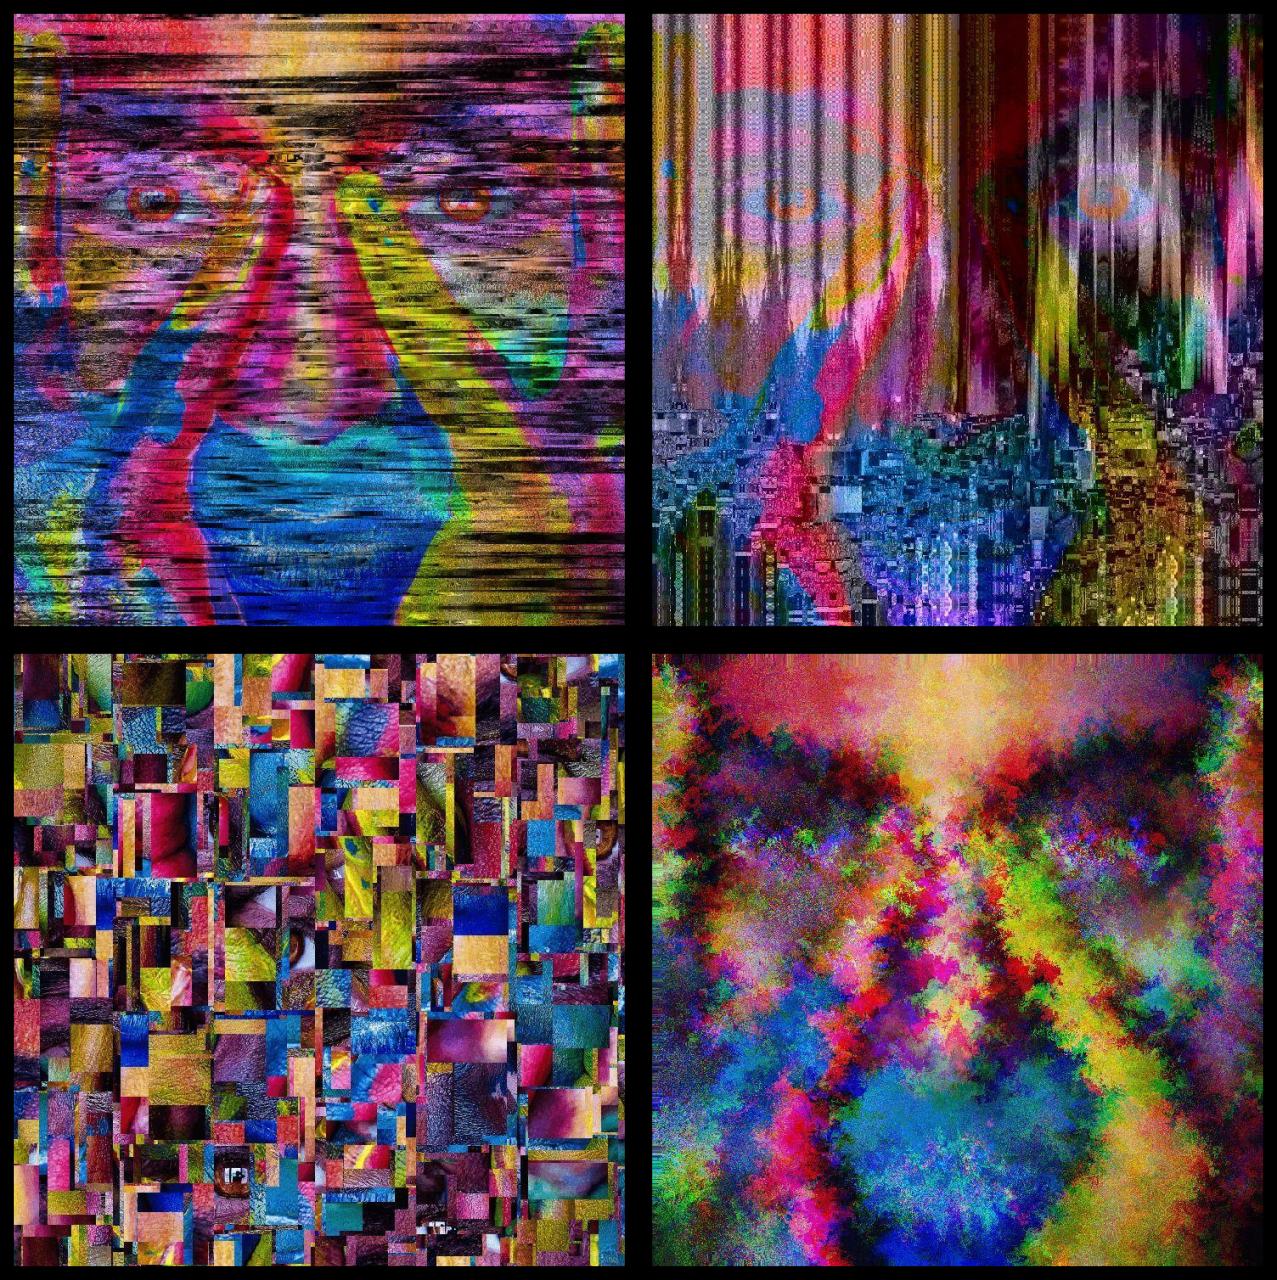
Ce principe de base est tout simple, mais là encore, les nombreux paramètres du filtre donnent accès à des décalages décorrélés sur chaque canal, pour des espaces couleurs variés, en pouvant itérer ces décalages aléatoires, et autorisent ainsi une grande variété de dégradations d'images de type « Glitch », comme illustré sur la figure ci-dessous.

Filtre 'Degradations/Offset Stripes (rendus) Fig. 2.5.2. Résultats de différents jeux de paramètres du filtre « Degradations / Offset Stripes », appliqués sur une même image de portrait.

2.6. Filtre « Colors / Transfer Colors [Multi] »

Et pour terminer ce résumé des nouveaux filtres du greffon G'MIC-Qt, j'ai gardé le plus intéressant pour la fin : le filtre « Colors / Transfer Colors [Multi] » est un nouveau filtre de transfert de couleurs entre deux images.

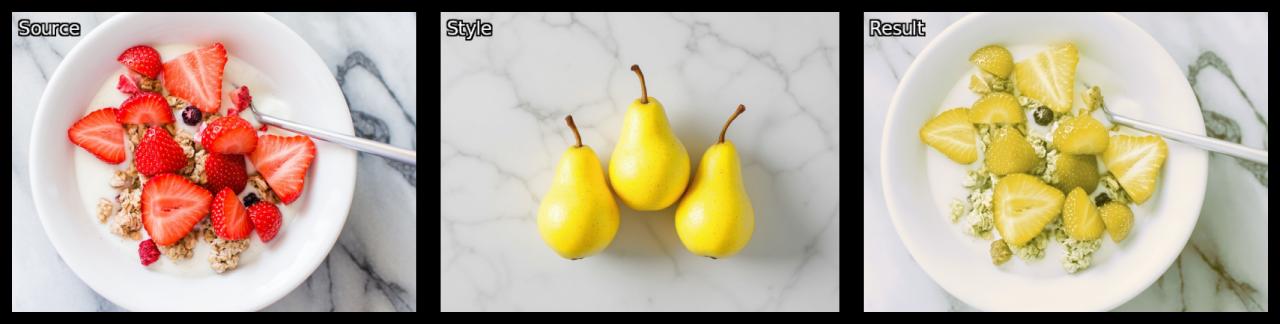
Le transfert de couleur consiste à appliquer une transformation couleur à une image « Source », en prenant comme référence une deuxième image (image dite de « Style ») dont on veut reproduire le style ou l'ambiance colorimétrique, et ceci bien sûr en préservant autant que possible les structures importantes (contours, objets, contenu sémantique) présentes dans l'image « Source » d'origine.

Principe du transfert couleur entre images Fig. 2.6.1. Principe du transfert de couleur entre images: une image « _Source » (à gauche) est modifiée (à droite) de telle façon qu'elle « emprunte » les couleurs d'une image de « Style » (au centre)._

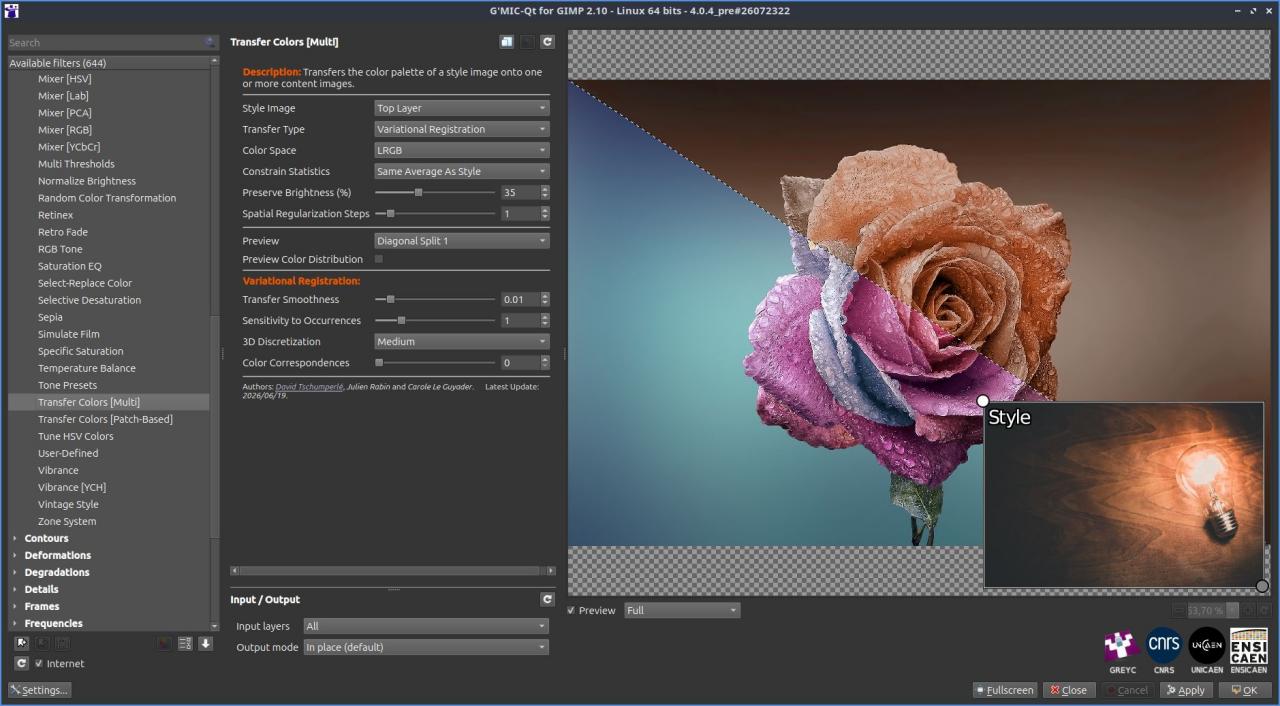
D'un point de vue algorithmique, il y a de nombreuses façons d'aborder ce type de transfert. Le filtre « Colors / Transfer Colors [Multi] », comme son nom le suggère, implémente trois méthodes différentes pour ce faire : une méthode ACP ; une méthode de transfert d'histogrammes ; et enfin une méthode variationnelle. Pour utiliser ce filtre dans le greffon G'MIC-Qt, il suffit de l'appeler sur une image contenant deux calques superposés : un calque contenant l'image « Source » à modifier, et un calque avec l'image « Style » contenant les couleurs de référence à transférer.

Filtre 'Colors/Transfer Colors (Multi) Fig. 2.6.2. Le filtre « Colors / Transfer Colors [Multi] » tel qu'il se présente dans le greffon G'MIC-Qt.

L'algorithme variationnel de transfert de couleur implémenté dans ce filtre est une production totalement originale : il est le fruit d'une collaboration de recherche entre deux membres de l'équipe IMAGE du laboratoire GREYC de Caen (D. Tschumperlé et J. Rabin), et d'une professeure du laboratoire de mathématiques LMI de l'INSA de Rouen (C. Le Guyader).

Bref, un algorithme 100 % normand, qui fonctionne forcément « vachement 🐄 bien » 😉, et que vous ne trouverez nulle part ailleurs !
On remercie chaleureusement la Fédération Normande de Recherche en Sciences et Technologies de l’Information et de la Communication (NormaSTIC) pour son aide financière qui a accéléré la mise en contact et le démarrage de cette collaboration fructueuse !

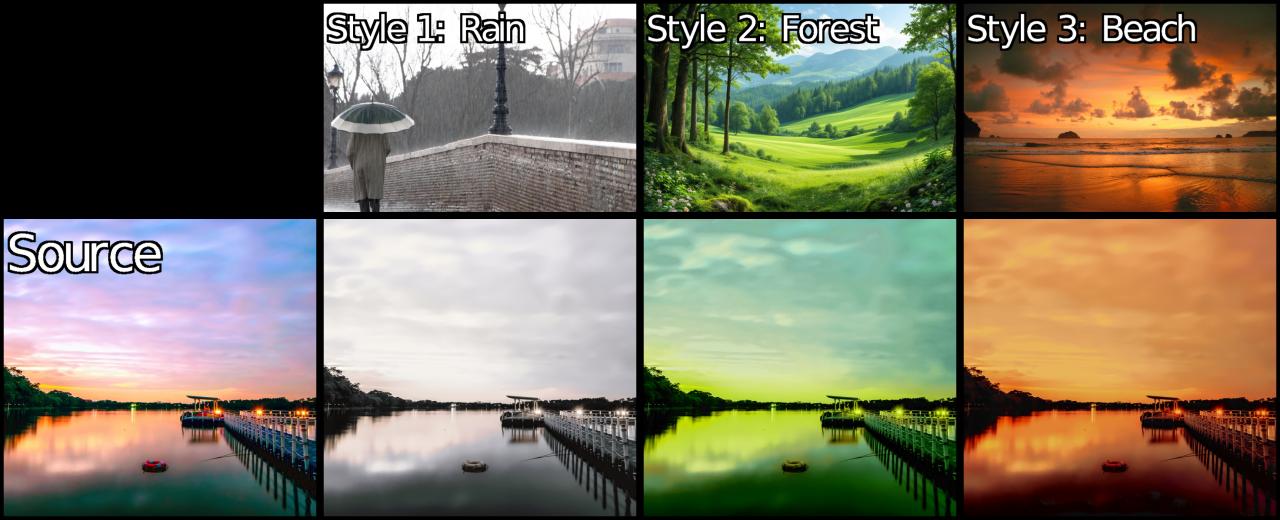
Notre méthode a plusieurs caractéristiques propres permettant de calculer des transferts de couleurs souvent pertinents, et de bonne qualité comparativement à ses concurrentes, et ce, de manière rapide et complètement automatique. La figure ci-dessous illustre des exemples de transferts de couleurs qu'il est possible d'obtenir pour une même image « Source », en choisissant des images de « Style » différentes (et en laissant les paramètres par défaut du filtre).

Filtre 'Colors/Transfer Colors (Multi) (rendus) Fig. 2.6.3. Exemples de transferts de couleurs réalisés par le filtre « Colors / Transfer Colors [Multi] » sur une même image « Source », avec plusieurs images « Style » différentes.

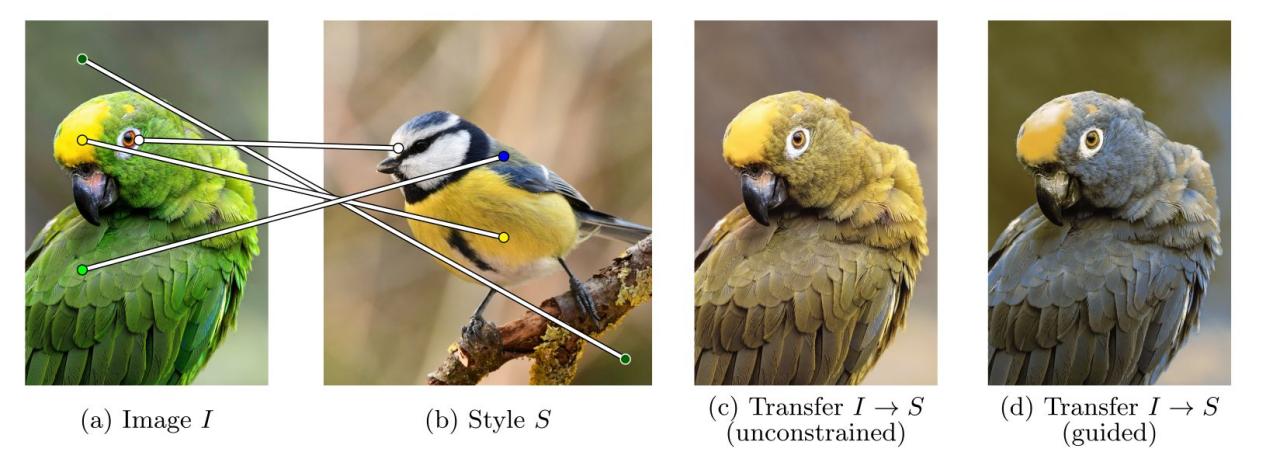
La technique que nous proposons autorise également un mode « semi-supervisé » qui permet à l'utilisateur de forcer certaines correspondances de couleurs, et donc de « guider » l'algorithme pour calculer une solution de transfert plus contrainte et personnalisée.
Les deux exemples ci-dessous illustrent ce mode de contrôle de manière assez parlante :

Filtre 'Colors/Transfer Colors (Multi) (rendu guidé 1) Fig. 2.6.4. Guidage de l'algorithme de transfert de couleurs par mise en correspondance forcée de couleurs (Perruche → Mésange).

Ici, les plumes vertes du corps de la perruche (a) sont perceptuellement plus proches de la couleur jaune du corps de la mésange (b), et c'est donc cette mise en correspondance qui est réalisée par défaut par l'algorithme de transfert (résultat (c)). En explicitant des correspondances de couleurs souhaitées (liens symbolisés entre les images (a) et (b)), on peut modifier ce comportement et contraindre le transfert à assigner la couleur bleue de la mésange aux plumes de la perruche (résultat (d)).

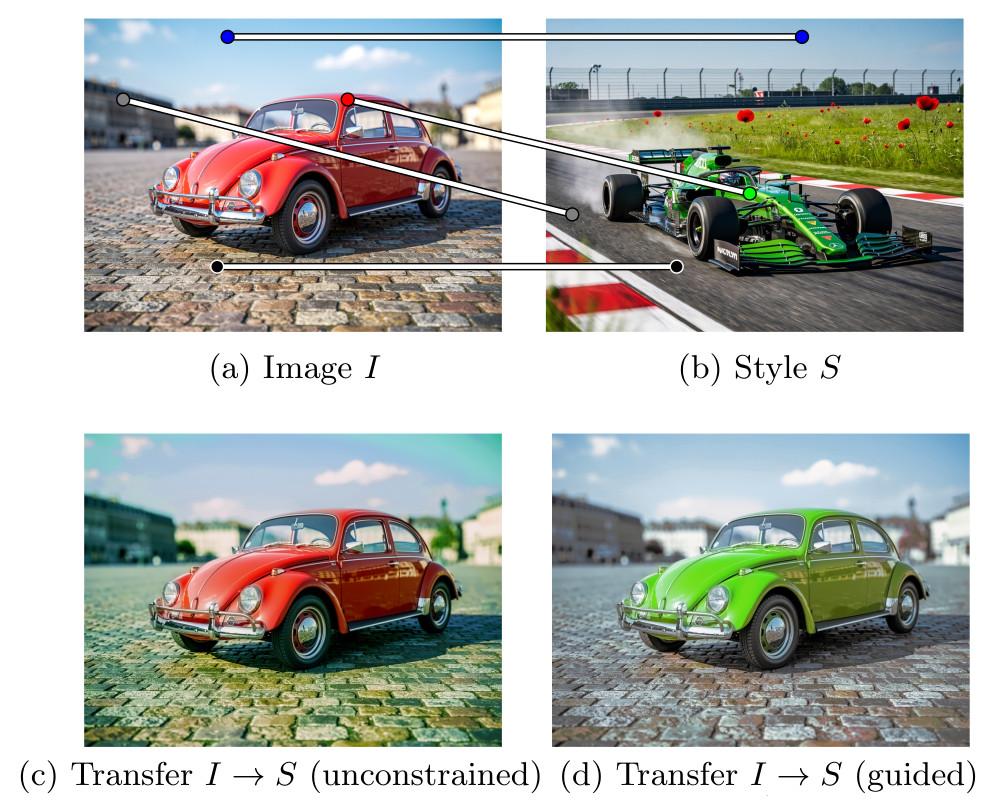
Filtre 'Colors/Transfer Colors (Multi) (rendu guidé 2) Fig. 2.6.5. Guidage de l'algorithme de transfert de couleurs par mise en correspondance forcée de couleurs (Coccinelle → Formule 1).

Dans ce deuxième exemple, on note que la couleur rouge de la Coccinelle (a) se retrouve ailleurs dans l'image « Style » de la Formule 1 (b) : au bord de la route, sur les coquelicots… L'algorithme décide donc naturellement de conserver cette couleur quasiment telle quelle lors du transfert automatique (résultat (c)). Forcer des correspondances de couleurs explicites permet de guider l'algorithme pour lui faire changer la couleur de la Coccinelle en vert (résultat (d)).

Vous l'aurez compris, ce filtre représente l'aboutissement d'un travail de recherche de longue haleine en algorithmique du traitement d'images. Pour des chercheurs comme nous, il est réjouissant d'être arrivé au bout du processus complet : élaborer un nouvel algorithme complexe sur un bout de papier, le développer, l'implémenter, le peaufiner, en obtenir des résultats encourageants, le peaufiner encore et encore, en écrire une description détaillée dans un article scientifique (en cours de finalisation), l'intégrer proprement et le rendre utilisable par tout un chacun dans un logiciel libre, en sachant qu'il pourra être testé et utilisé potentiellement des milliers de fois !

Notons que ce n'est pas la première fois qu'une méthode de traitement d'images développée au sein de notre laboratoire de recherche se retrouve valorisée dans G'MIC. Cette page recense plusieurs publications scientifiques décrivant des algorithmes élaborés au sein de l'équipe IMAGE du GREYC, et qui sont accessibles comme filtres du greffon G'MIC-Qt.

3. Nouveautés et améliorations du cœur du logiciel et de sa bibliothèque standard

Comme évoqué précédemment, le terme G'MIC peut faire référence au langage de script du même nom. Ce langage est doté de son propre interpréteur et de sa bibliothèque standard de fonctions. Il est utilisé pour implémenter tous les filtres et opérateurs de traitement d'images mis à disposition des utilisateurs des différentes interfaces du projet.

Durant l'année écoulée, un grand nombre de petites améliorations ont été implémentées conjointement sur ce langage et sa bibliothèque standard.
En réalité, l'ensemble de ces contributions représente même la majorité du travail de développement réalisé, et en même temps ce sont des choses qu'il est difficile de valoriser dans une dépêche grand public : elles concernent principalement des points très précis et techniques du projet, comme par exemple des optimisations du parsing ou des algorithmes, du nettoyage de code, de nouvelles fonctions ou options pour l'évaluateur d'expressions mathématiques, etc.
Ce sont bien sûr des ajouts utiles pour les développeurs de nouveaux filtres dans ce langage, mais il est difficile de les mettre en valeur de manière réellement plaisante.

J'ai donc pris le parti de lister ci-dessous uniquement les quelques nouveautés facilement « illustrables » :

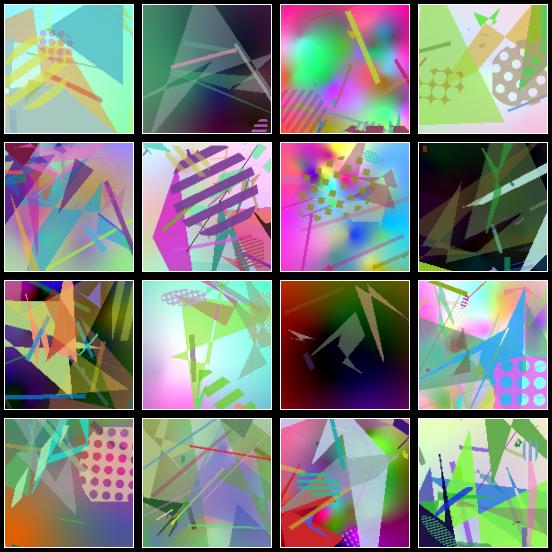
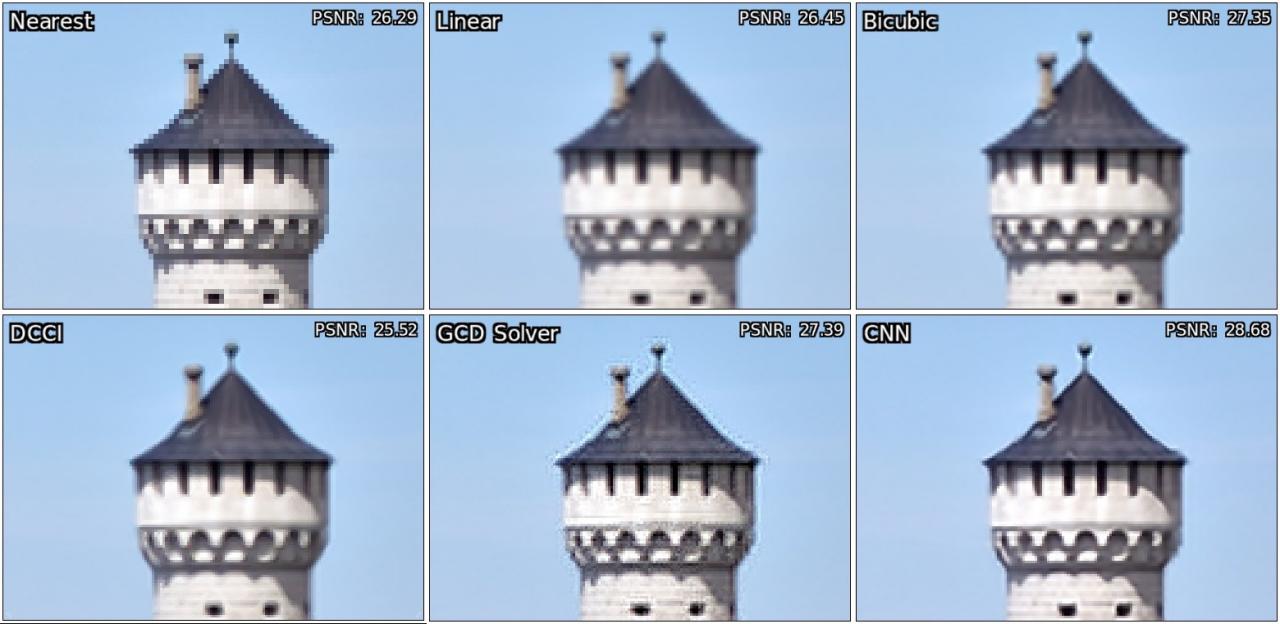
  • La nouvelle commande random_patches réalise un rendu procédural d'images carrées contenant des formes géométriques et des textures synthétiques aléatoires. À quoi cela peut-il bien servir, me direz-vous ? Eh bien par exemple, à générer des ensembles d'images pour l'entrainement de réseaux de neurones convolutionnels, pour des tâches de débruitage et de super-résolution (ces réseaux sont ceux utilisés par les commandes denoise_cnn et scale2x_cnn).

Commande 'random_patches' (rendus) Fig. 3.1. La commande random_patches synthétise des images carrées contenant des formes géométriques et des textures aléatoires.

Ces images sont en réalité suffisamment complexes pour qu'un réseau de neurones puisse apprendre des filtres convolutionnels pertinents pour l'analyse semi-locale de la géométrie des structures présentes dans des images plus naturelles. Ces filtres appris peuvent ensuite être utilisés dans des tâches de débruitage ou de super-résolution, qui sont des problèmes très géométriques et qui ne nécessitent pas vraiment une analyse sémantique du contenu des images. Utiliser ces données synthétiques pour entrainer des réseaux simples est donc largement suffisant pour ce type d'applications. D'une part, cela évite de stocker de grandes bases d'images volumineuses lors de l'entrainement (les images synthétiques étant générées à la volée). Et d'autre part, on évite automatiquement d'enfreindre le copyright éventuel des images présentes dans les ensembles d'apprentissage prédéfinis (dont la provenance n'est pas toujours clairement citée, avouons-le).

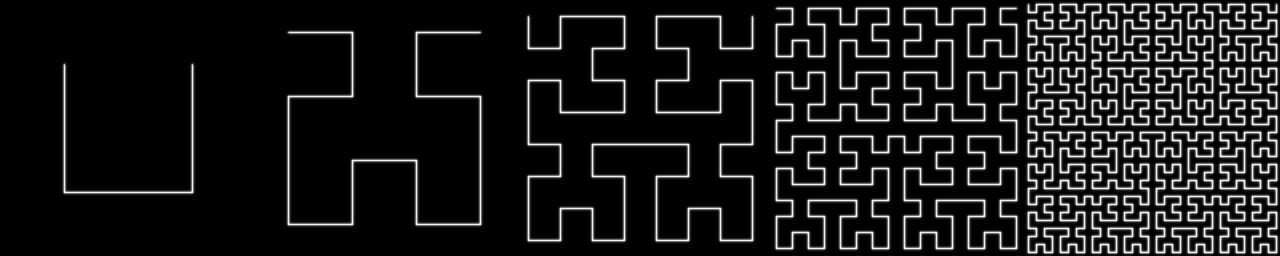
Commande 'shape_hilbert (rendus) Fig. 3.2. La commande shape_hilbert trace une courbe de Hilbert dans une image, commande illustrée ici avec des niveaux croissants de récursions.

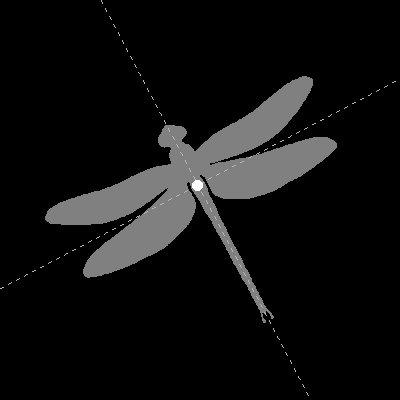
  • La nouvelle commande pca calcule une analyse en composantes principales (ACP) d'un ensemble de vecteurs. Ce type d'analyse permet à la fois de déterminer la dimensionnalité représentative de données vectorielles, ainsi que leurs orientations principales dans l'espace. L'ACP a de nombreuses applications en traitement d'images et plus généralement en analyse de données : débruitage, compression, reconnaissance de visages, analyse de textures, recalage géométrique, etc. L'exemple ci-dessous illustre son utilisation pour déterminer l'orientation des axes principaux (dessinés en pointillés) d'une silhouette de libellule.

Commande 'pca') Fig. 3.3. La commande pca est utilisée ici pour calculer les orientations des axes principaux d'une silhouette binaire 2D.

  • Les nouvelles commandes depthmap3d et normalmap3d viennent enrichir les possibilités de rendus d'objets 3D maillés de G'MIC, en synthésisant des rendus d'un objet respectivement sous la forme de cartes de profondeurs et de normales 3D.

Commandes 'depthmap3d' et 'normalmap3d') Fig. 3.4. Les commandes depthmap3d et normalmap3d appliquées sur un modèle 3D en rotation.

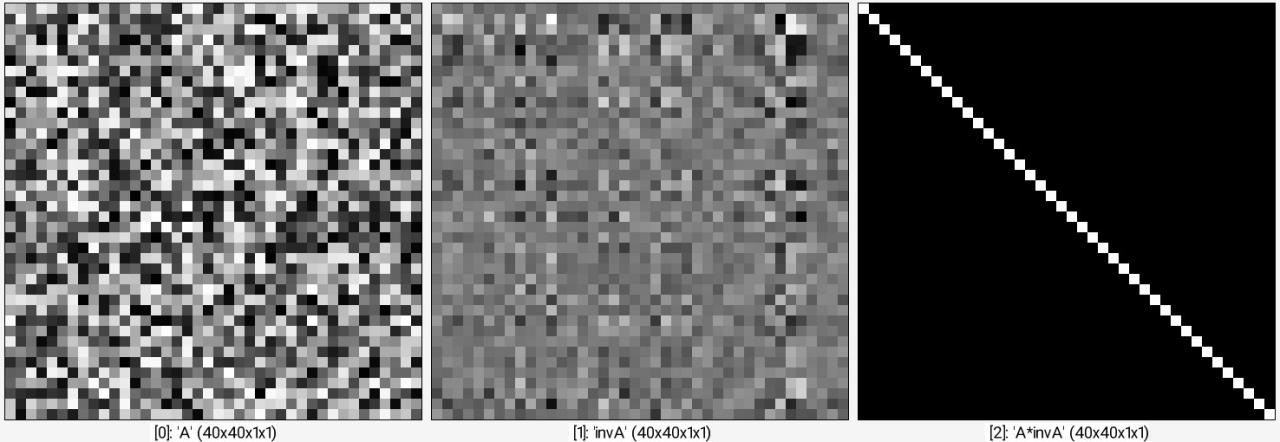
  • Mentionnons enfin le travail d'amélioration général ciblé sur les algorithmes d'opérations matricielles présents dans G'MIC : arrivée de la décomposition QR (avec pivot), amélioration de la précision de calcul pour l'inversion de matrices et la résolution de systèmes linéaires… Et même s'il est difficile de rendre ça visuel, je vous propose cette petite ligne de commande qui crée une matrice carrée 40×40 aléatoire, qui l'inverse et qui calcule le produit des deux pour vérifier que l'on retrouve bien la matrice identité.
$ gmic 40,40 rand -1,1 +invert +mmul name A,invA,'A*invA'

Commande 'invert') Fig. 3.5. Exemple de l'utilisation de gmic en ligne de commande pour l'inversion d'une matrice aléatoire.

Tout ceci n'est bien sûr qu'un aperçu succinct de ce qui a été réalisé sur le cœur de G'MIC cette année. Pour plus de détails techniques, la consultation des Changelog est recommandée.

4. Nouveau dépôt de codes sources: gmic-interactive-demos

En tant que membre d'un laboratoire public de recherche, j'ai l'occasion de participer ponctuellement à des évènements de vulgarisation scientifique (tels que la Fête de la science, le FÉNO, etc.), où l'on présente certaines de nos activités de recherche au grand public (en algorithmique du traitement d'images en ce qui me concerne). Pour rendre ces présentations plus attractives et ludiques, j'ai élaboré au fil des ans, différents programmes et bornes de démonstration interactifs, en me reposant sur les possibilités offertes par le langage G'MIC.

Ces applications libres (sous licence CeCILL) sont maintenant accessibles sur ce dépôt logiciel : github.com/GreycLab/gmic-interactive-demos

Elles pourront intéresser des enseignants et/ou chercheurs souhaitant illustrer différents concepts du traitement d'images à des publics de néophytes. Ces codes illustrent aussi les capacités du langage G'MIC pour la création de programmes interactifs, et ceci indépendamment du greffon G'MIC-Qt.

Pour le moment, trois démonstrateurs sont présents dans ce dépôt logiciel. Ils sont détaillés ci-dessous.

4.1. The SteamFace Machine

« The SteamFace Machine » est le démonstrateur le plus récent. Il montre le fonctionnement des réseaux de neurones convolutionnels pour la détection d'un visage dans une image, et l'analyse de caractéristiques propres à ce visage, le tout enrobé dans un style SteamPunk du plus bel effet !

The SteamFace Machine (intro) Fig. 4.1.1. Écran de lancement du démonstrateur « The SteamFace Machine ».

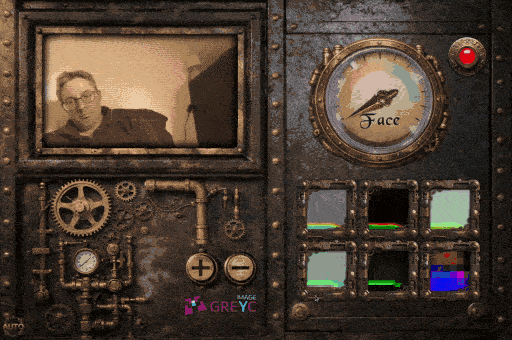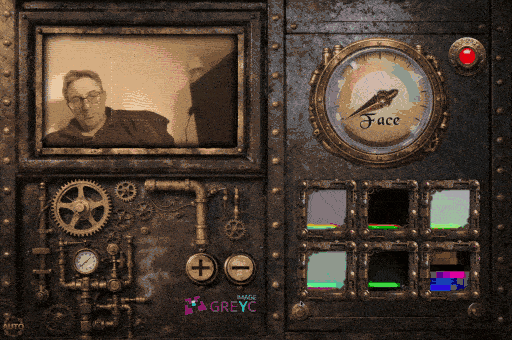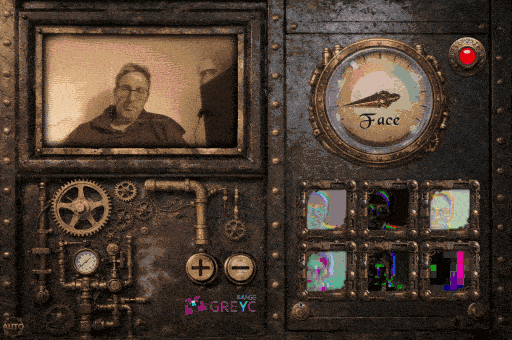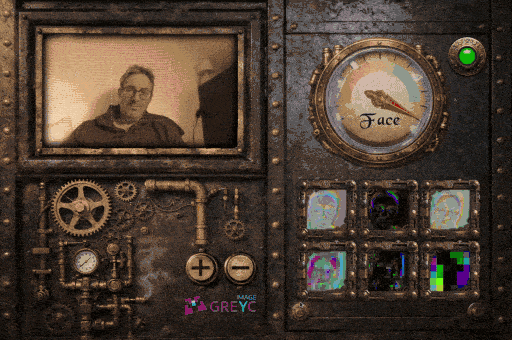
Le flux vidéo capturé par la webcam s'affiche à l'écran, et lorsqu'un visage est placé au centre de l'image, la jauge de détection faciale s'active. En bas à droite, on peut apercevoir la sortie de différentes couches intermédiaires du réseau de neurones réalisant la détection (classifieur binaire avec une architecture de type LeNet-5).

The SteamFace Machine (main) Fig. 4.1.2. Détection du visage par un réseau de neurones convolutionnel dans le démonstrateur « _The SteamFace Machine »._

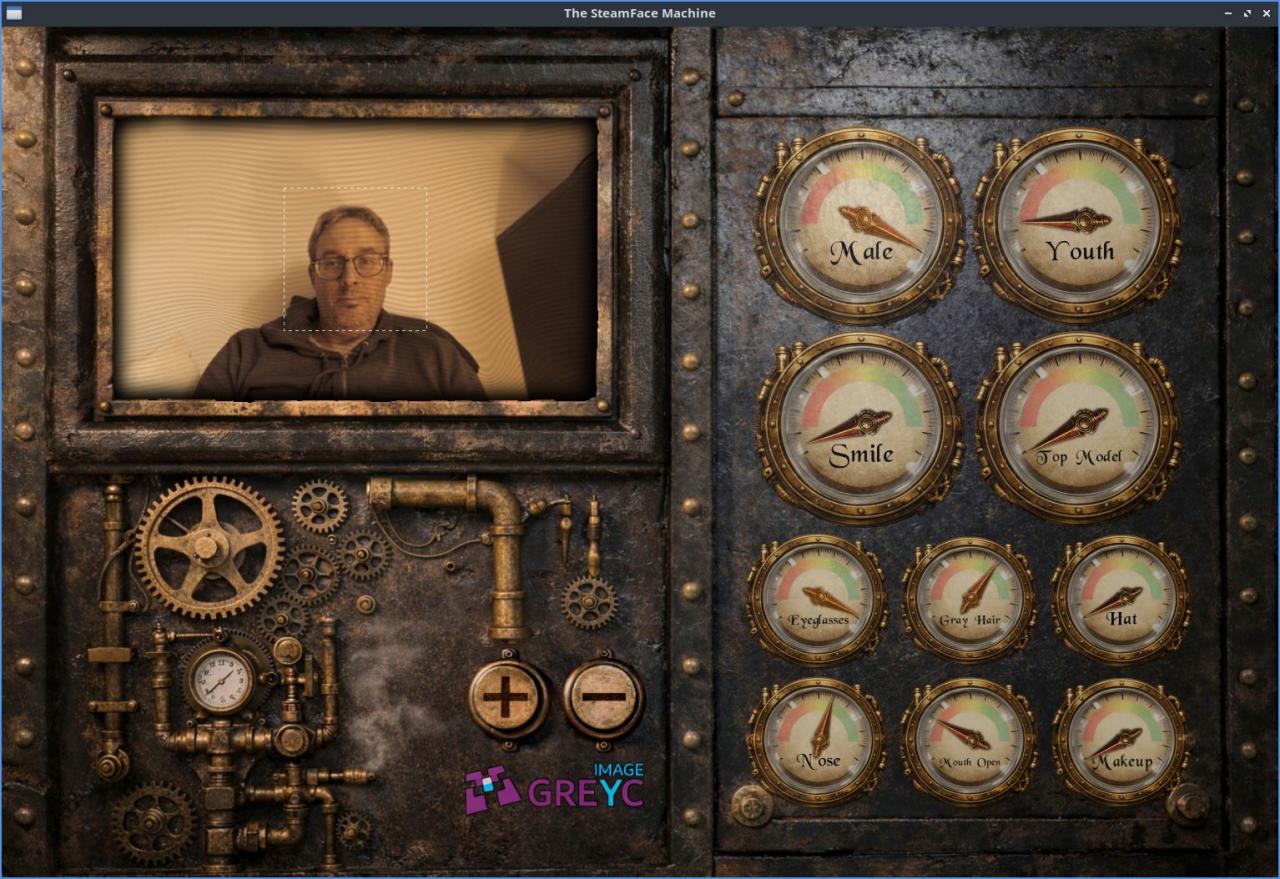
Une fois la détection opérée, un deuxième réseau est inféré pour en extraire différentes caractéristiques faciales : genre, âge, type de cheveux, port de lunettes ou de chapeau, taille du nez…

The SteamFace Machine (caractéristiques) Fig. 4.1.3. Analyse de quelques caractéristiques liées au visage détecté.

C'est une manière visuellement amusante de présenter le fonctionnement de classifieurs neuronaux au grand public, leurs capacités mais aussi leurs limites et les biais inhérents aux bases d'apprentissage utilisées pour les entrainer (dans le cas de ce démonstrateur, la base CelebA, qui contient des images assez éloignées de celles que l'on acquiert via la webcam dans un environnement non-contrôlé tel qu'un parc des expositions).

Mentionnons également la belle contribution de notre cher collègue Philippe Bernard, du service Administration système et réseaux du GREYC, qui a réalisé une borne physique de démonstration intégrant « The SteamFace Machine », facilement transportable à des évènements de médiation scientifique !

The SteamFace Machine (borne) Fig. 4.1.4. Vidéo de démonstration de la borne « The SteamFace Machine » quand elle était en cours d'élaboration.

4.2. Virtual Artist

« Virtual Artist » est un deuxième démonstrateur interactif, qui cherche à illustrer le principe du « transfert de style » entre deux images.
Nous avons précédemment évoqué le transfert de couleurs (en section 2.6). Le transfert de style en est une extension naturelle : au lieu de transférer uniquement les couleurs, on cherche à transférer tout le style graphique d'une image « Style » vers l'image « Source ».
C'est bien sûr un problème autrement plus complexe, et les méthodes les plus performantes du domaine utilisent généralement de gros réseaux de neurones.

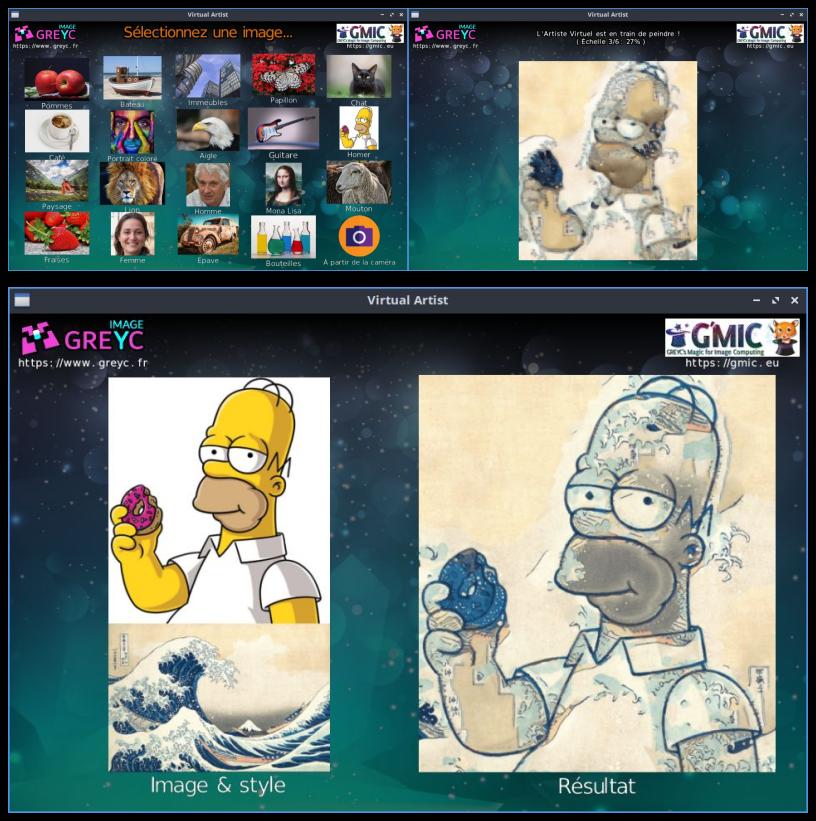
« Virtual Artist » n'a pas la prétention d'être à la pointe de l'état de l'art : c'est avant tout un démonstrateur pédagogique pour expliquer le principe général du transfert de style en traitement d'images. L'utilisateur peut jouer avec différentes images de « Source » et de « Style » prédéfinies. La figure ci-dessous illustre quelques-uns des écrans principaux de l'application.

Virtual Artist Fig. 4.2.1. L'application « Virtual Artist » illustre le principe du transfert de style entre deux images.

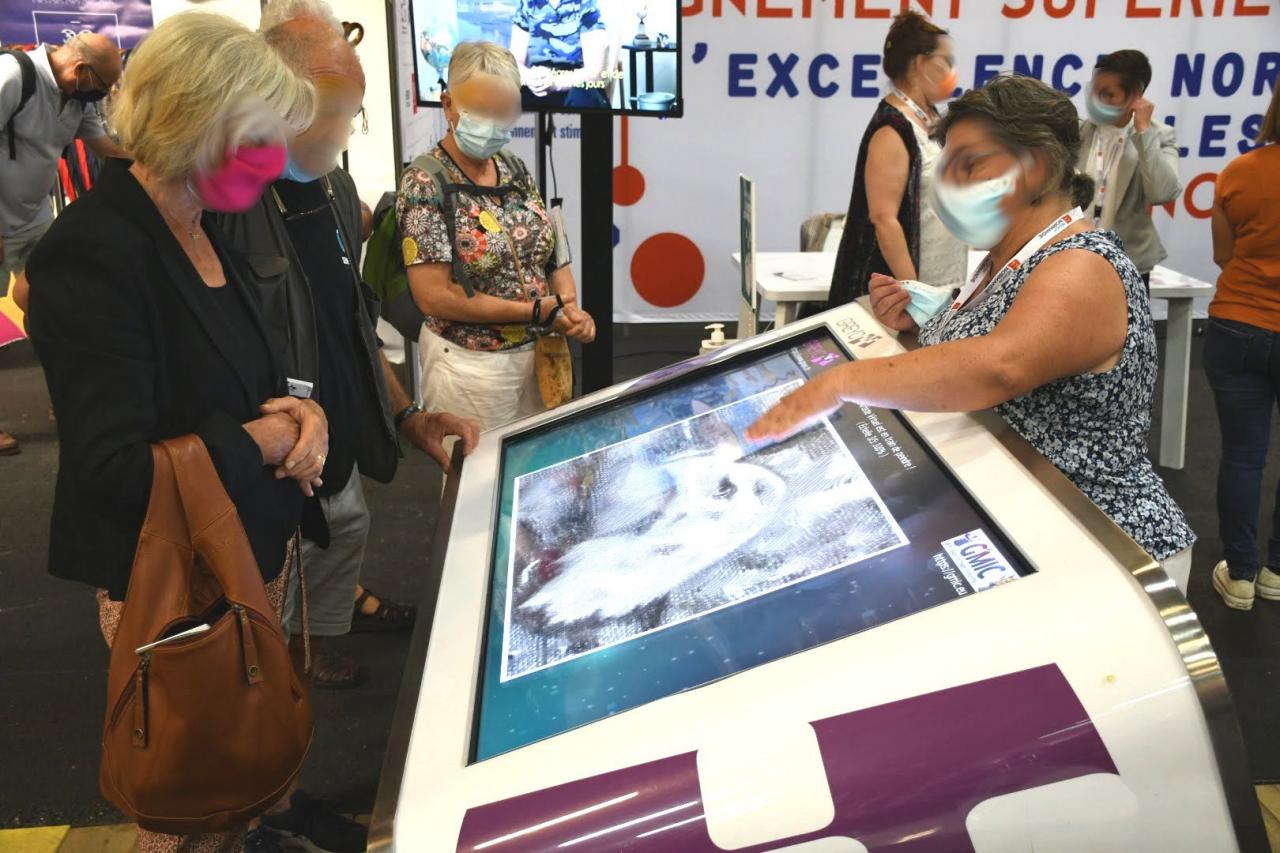
Ce démonstrateur a été utilisé de nombreuses fois sur une grande table tactile, dans des évènements grand public, et fait toujours son petit effet !

Virtual Artist (FÉNO) Fig. 4.2.2. L'application « Virtual Artist » utilisée comme démonstrateur, ici au Festival de l'Excellence Normande (FÉNO) en 2021.

4.3. GREYC Warp

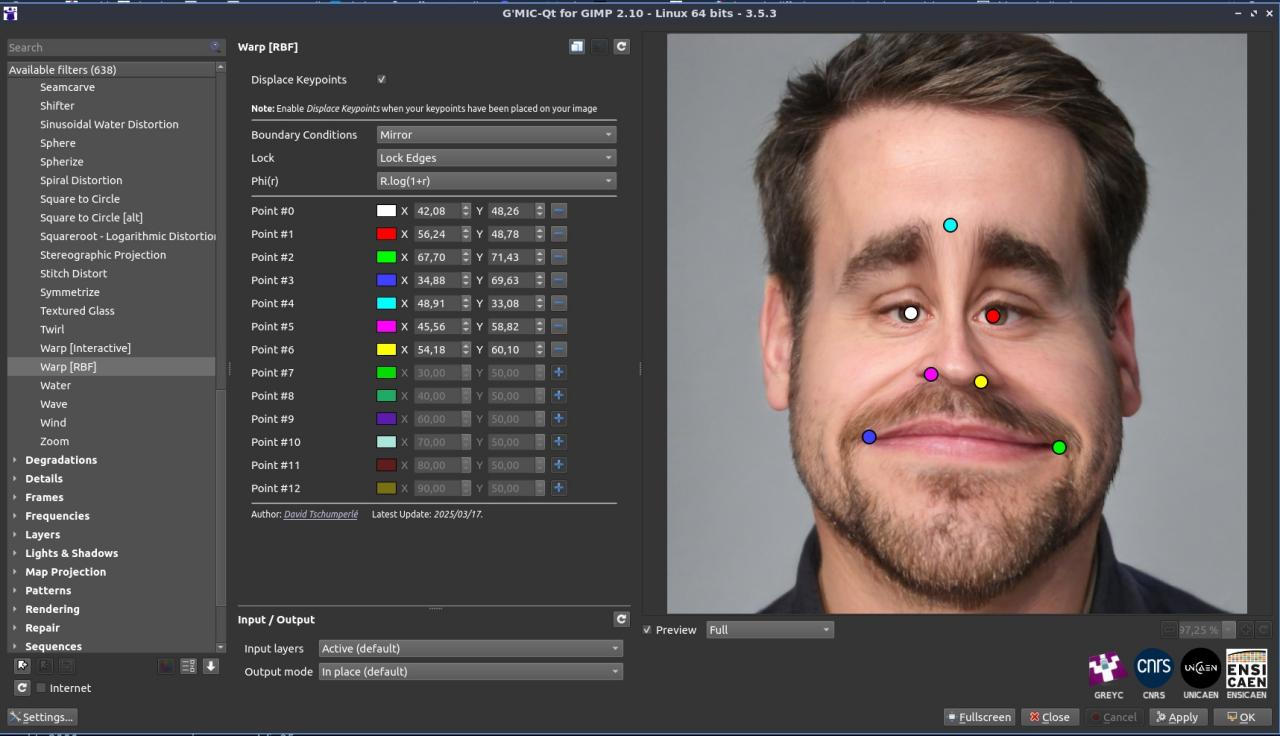
« GREYC Warp », le dernier démonstrateur de ce nouveau dépôt logiciel, implémente un miroir déformant interactif. L'utilisateur voit en direct le flux de la webcam et peut créer, déplacer ou supprimer des points clés qui définissent une déformation appliquée en temps réel. Une dizaine de transformations pré-définies sont également proposées.

GREYC Warp Fig. 4.3.1. L'application « GREYC Warp » vous laisse déformer le flux vidéo de votre webcam, de manière interactive, et non sans humour !

Pour avoir testé ce démonstrateur en situation réelle lors d'expositions, ça fait beaucoup rire les enfants (mais pas les plus jeunes qui pensent que ça reflète vraiment l'apparence de leur tête et qui peuvent se mettre à pleurer). Une application toute simple mais néanmoins amusante !

5 G'MIC et le code créatif

Ces quelques démonstrateurs esquissent déjà l'image d'un langage G'MIC adapté au code créatif, qui consiste, selon Wikipedia, à « utiliser la programmation informatique comme un moyen d'expression artistique (visuel, musical, littéraire, interactif, performatif…) à part entière ».

5.1. Codes créatifs courts

En tant qu'ancien demomaker, le code créatif est forcément un domaine qui me tient à cœur, et j'écris et partage régulièrement des scripts courts sur le forum de G'MIC pour expérimenter de nouvelles idées d'effets graphiques, ou en reproduire certains sur lesquels je suis tombé et que je trouve captivants.
Quelques-uns de ces effets récents sont décrits ci-dessous, avec à chaque fois, un accès vers le code source correspondant (script .gmic).

  • Agrégation limitée par diffusion tournoyante : Cet effet est une variante de l'agrégation limitée par diffusion, implémentant un système de particules en mouvement qui sont stoppées dès lors qu'elles rencontrent une masse d'éléments plus anciens, déjà immobiles. On ajoute à tout ça une rotation, un zoom inverse, une palette de couleurs, et le tour est joué ! Le code source de cet effet atteint difficilement les 36 lignes, commentaires inclus !

Diffusion-Limited-Aggregation (animation) Fig. 5.1.1. L'effet animé « Agrégation limitée par diffusion tournoyante », rendu par G'MIC.

  • Courbe de Hilbert néon : Cette animation stylise le dessin d'une courbe de Hilbert par un tracé incrémental faisant songer à un néon. Ici, le code source est beaucoup plus conséquent (52 lignes 😉).

Hilbert-Curve (animation) Fig. 5.1.2. L'effet animé « Courbe de Hilbert néon », rendu par G'MIC.

  • Morphing de formes : Ici, deux silhouettes se transforment l'une vers l'autre via un morphing continu. On utilise des edgels pour l'extraction et la paramétrisation du contour des deux silhouettes à transformer. Le code source de cet effet revient à un nombre de lignes de code quand même plus raisonnable que précédemment (36 lignes).

Morph Shape (animation) Fig. 5.1.3. L'effet animé « Morphing de formes », rendu par G'MIC.

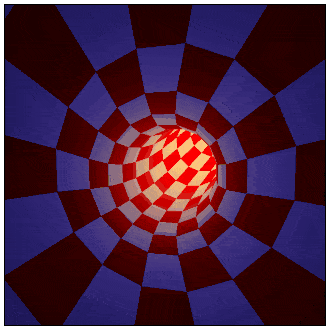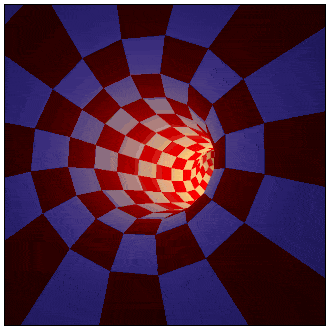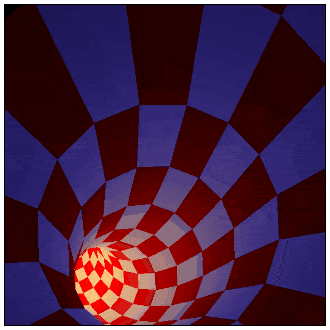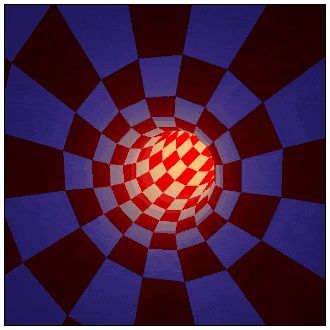
  • Tunnel 3D : Celui-ci est l'un de mes préférés. C'est certes un effet ultra-classique dans le monde de la scène démo, mais le rendu est sympa. Et avec ses 68 lignes, le code source pour générer cette animation de 256 frames (qui cyclent parfaitement) reste dans les limites du raisonnable !

Tunnel 3D (animation) Fig. 5.1.4. L'effet animé « Tunnel 3D », rendu par G'MIC.

  • One-liner géométrique : Le langage G'MIC, grâce à sa syntaxe délibérément concise, est un candidat idéal pour la création de one-liners. Une section entière de la documentation de référence est d'ailleurs dédiée à quelques one-liners amusants. Étant tombé par hasard sur cette belle image créée avec GeoGebra par Georg Wengler, j'ai souhaité la retranscrire en langage G'MIC sous la forme d'une unique ligne de commande affichant une animation, et voici le résultat (et heureusement qu'une ligne de code ne se limite pas à 80 caractères !)
$ gmic 12,12,256,2,"a = 1 + x; b = 1 + y; t = lerp(0,2*pi*b,z/d); cos(a/b*t)*cexp([0,t])" 12,12,1,2,"S = crop(#-1,x,y,0,c,1,1,d#0,1); S = round(45*(S - avg(S)) + 50); draw(#-1,S,x,y,0,c,1,1,d#0,1)" rm. 1200,1200,1,3,255 repeat 256 { 12,12,1,1,"repeat (16,l, X = 100*[x,y] + round(I(#0,x,y,$> + l/16,2,2)); ellipse(#-1,X,1,1,0,1,0))" rm. +rs. 600 w. rm. wait 20 } rm

cos(ab) (animation) Fig. 5.1.5. L'effet animé « cos(ab) », rendu par G'MIC.

L'ensemble de ces nouvelles animations se retrouve dans la section Gallery du site web de G'MIC.

5.2. Continuation de la série « G'MIC Adventures »

De temps en temps, j'essaie aussi de partager l'ensemble du processus permettant d'arriver (en partant de zéro) à un résultat de code créatif.
Et cela, rédigé sous la forme d'un petit article partagé sur le forum de G'MIC. Cette série d'articles est nommée « G'MIC Adventures ». Je l'avais évoquée dans notre dernière dépêche. Deux nouveaux épisodes de cette série sont parus depuis :

  • Apprentissage d'un perceptron multi-couches pour la reproduction d'une image couleur (G'MIC Adventure #5) :

Dans ce cinquième épisode, on cherche à entrainer un réseau de neurones simple (un perceptron multi-couches) capable d'apprendre une fonction image entière (x,y)\to(R,G,B), c'est-à-dire un réseau capable de prédire une couleur (R,G,B) correcte à partir d'un vecteur de coordonnées (x,y) donné en entrée. Il est particulièrement intéressant de visualiser l'image couleur que le réseau est capable de reproduire à chaque itération de son apprentissage (figure ci-dessous), et ce, jusqu'à convergence.

MLP (animation) Fig. 5.2.1. Reconstruction itérative d'une image couleur obtenue par l'apprentissage d'un perceptron multi-couches.

Dans ce sixième épisode, on s'intéresse à l'implémentation en G'MIC de l'équation d'ondes et ses possibilités pour appliquer des effets de déformations amusants sur des images, comme l'illustre la figure suivante qui correspond au résultat obtenu à la toute fin de l'article.

Wave equation (animation) Fig. 5.2.2. Application d'une équation d'ondes anisotrope pour la déformation d'une image le long de ses contours.

Les exemples présentés dans cette section montrent que G'MIC a du potentiel pour le code créatif, notamment pour l'expérimentation rapide de codes d'effets graphiques. Le fait qu'il soit utilisable en ligne de commande (via la commande gmic) en fait un allié précieux pour générer des animations ou pour modifier des lots d'images de manière automatisée.

6. Autres nouvelles liées au projet

Pour finir cette longue dépêche, voici en vrac quelques autres nouvelles notables liées au projet :

  • Diffusion de G'MIC : Avec le temps, la diffusion de G'MIC s'accélère et son installation se simplifie. Notons tout d'abord que G'MIC-Qt a été parmi les premiers greffons disponibles lors de la sortie de la version majeure 3.2 de GIMP. L'installation de ce greffon est maintenant aussi largement simplifiée pour les utilisateurs de macOS, grâce au travail remarquable des empaqueteurs de MacPorts, qui en proposent une version toujours très à jour.

Nous avons également appris que G'MIC suscite l'intérêt des projets suivants :

  1. Le projet G'MIC-GEGL a pour objectif d'exposer les différents filtres du greffon G'MIC-Qt directement sous forme de nœuds GEGL, qui est la bibliothèque de traitement utilisée en interne dans GIMP. Cela voudrait dire que les effets de G'MIC-Qt pourraient à terme être utilisés dans des calques d'effets non-destructifs de GIMP.
  2. Le projet PhotoFlare est un nouvel éditeur d'images numériques multi-plateformes, et son développeur a annoncé y avoir intégré le greffon G'MIC-Qt afin de profiter de ses centaines de filtres proposés.
  3. Le projet gmic-affinity se propose de développer un greffon en Rust pour Affinity Photo, pour exposer le greffon G'MIC-Qt aux utilisateurs. Ce dernier est normalement déjà fonctionnel pour ce logiciel, via l'API 8bf (comme le montre cette vidéo), mais malheureusement pas encore pour les utilisateurs de macOS.
  4. Enfin, notons l'arrivée de G'MIC-Qt sur le Snap Store, proposant ainsi une façon alternative d'installer notre greffon pour GIMP.
  • Exposé : Début mai 2026, j'ai eu l'occasion de faire un bref passage au laboratoire LRDE de l'EPITA, sympathiquement invité par Marc Espie (enseignant et l'un des développeurs du projet OpenBSD), où j'ai donné une présentation intitulée « 25 ans de développement libre pour le traitement des images numériques ». Une vidéo de cette présentation a été captée et mise sur YouTube.

7. Conclusion

Cette version 4.0 marque un jalon important pour G'MIC : dix-huit ans après la première ligne de code, le projet a montré qu'un logiciel open-source né au sein d'un laboratoire de recherche public, et aux ressources modestes, peut s'installer durablement dans le paysage du graphisme numérique libre, et continuer à innover grâce à son écosystème ouvert et extensible.

Cette dépêche a cherché a montrer la maturité et la polyvalence de G'MIC. C'est un cadriciel multi-usages dont les interfaces variées peuvent toucher des publics différents, de l'artiste numérique au bidouilleur de la ligne de commande, en passant par le chercheur en traitement d'images, à partir du moment où une image numérique entre en jeu !

C'est aussi l'occasion de rappeler que rien de tout cela n'aurait été possible sans l'écosystème bienveillant qui gravite autour du projet. Nous tenons à remercier chaleureusement nos partenaires académiques (le CNRS, l'ENSICAEN, l'Université de Caen, la direction du GREYC), ainsi que l'ensemble de la communauté (testeurs, empaqueteurs, vidéastes et utilisateurs du quotidien). Votre soutien est très apprécié.

Les idées fourmillent, l'envie de triturer des pixels est toujours aussi présente, et on espère donc pouvoir continuer à développer et valoriser ce cadriciel libre comme il se doit dans le futur.

Y aura-t-il une nouvelle dépêche l'année prochaine ? L'avenir nous le dira !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • 📰 Revue de presse — mai 2026
    Troisième édition 2026 de notre petit panorama, forcément subjectif et parti{e,a}l, de la presse papier (et en ligne) disponible en ce début d'année. Voici donc les nouveautés des éditions Diamond sorties récemment et disponibles jusqu'à fin juin, peu ou prou (ne tardez pas pour le hors-série de MISC qui est sorti en avril). GNU/Linux Magazine France no 281 interagit en Python avec les API de Mistral et Anthropic pour créer son propre agent ; SysOps Pratique no 155 bloque les bots AI ave

📰 Revue de presse — mai 2026

Par : Florent Zara
26 mai 2026 à 15:54

Troisième édition 2026 de notre petit panorama, forcément subjectif et parti{e,a}l, de la presse papier (et en ligne) disponible en ce début d'année.

Image une de Journal

Voici donc les nouveautés des éditions Diamond sorties récemment et disponibles jusqu'à fin juin, peu ou prou (ne tardez pas pour le hors-série de MISC qui est sorti en avril).

  • GNU/Linux Magazine France no 281 interagit en Python avec les API de Mistral et Anthropic pour créer son propre agent ;
  • SysOps Pratique no 155 bloque les bots AI avec HAProxy et Anubis ;
  • MISC magazine no 145 sur penche sur la sécurité de K8s, quand le DNS de ce dernier trahit les ressources du cluster ;
  • Hackable no 66 régule le chauffage électrique pièce par pièce en DIY avec Tasmota et Domoticz ;
  • MISC hors-série no 35 est consacré à la gouvernance et la conformité cyber.

Bonnes lectures !

Les sommaires des numéros de mai 2026

Mosaïque des couvertures GLMF 281 Mosaïque des couvertures SOP 155 Mosaïque des couvertures MISC 145 Mosaïque des couvertures HK 66 Mosaïque des couvertures MISC HS 35
 

GNU/Linux Magazine numéro 281

Au sommaire de ce numéro de mai — juin 2026 :

  • Back to the « Vibe Coding »…
  • Persistance des données dans le cloud avec MongoDB et Python ;
  • Python et les API d’intelligence artificielle ;
  • Utiliser GitLab CI/CD pour vos projets OpenBSD ;
  • Programmation structurée contre GOTO : l’espace liminaire entre les vaches sphériques et les spaghettis ;
  • Les codes fantastiques : there is no try ;
  • Sécuriser React sans stress : CSP à la sauce Apache ;
  • De nouvelles façons de construire des labyrinthes.

SysOps Pratique numéro 155 (ex Linux Pratique)

Au sommaire de ce numéro de mai — juin 2026 :

  • De l’IA pour les Ops ?
  • Puppet / Ansible : le mouvement et la gravité ;
  • Démarrer ses machines à la demande ;
  • HAProxy + Anubis : pesez l’âme de vos requêtes web ;
  • Hackez votre usine logicielle : bâtissez un hub de sécurité autonome ;
  • S'entraîner au routage Linux avancé sur son laptop avec les VRF ;
  • Longhorn : une solution simple de stockage redondant pour votre cluster Kubernetes.

MISC Magazine numéro 145

Au sommaire de ce numéro de mai — juin 2026 :

  • Protégez vos chaînes d’approvisionnement logicielles : NPM en exemple ;
  • Un buffet de gadgets de désérialisation - Clojure CVE-2017-20189, CVE-2024-22871 et plus encore ;
  • Kubernetes : quand le DNS trahit les ressources du cluster ;
  • Surveillance IoT : utilisation de hooks libc pour la supervision ;
  • Contournement de détection basée sur les hooks d’appels système avec io_uring ;
  • OpenBSD : dévoiler son système de fichiers avec unveil(2) ;
  • Retour d’expérience d’un processus de traitement des non-conformités sécurité.

Hackable numéro 66

Au sommaire de ce numéro de mai — juin 2026 :

  • Zephyr 4.3 : un système d’exploitation temps réel qui a le vent en poupe ;
  • Créez votre indicateur connecté pour vos streams Twitch ;
  • Régulation du chauffage électrique pièce par pièce en DIY avec Tasmota et Domoticz ;
  • Mettez à jour à distance vos systèmes embarqués sous Buildroot avec SWUpdate ;
  • Émulons un périphérique PCI/PCIe dans QEMU ;
  • Utilisons une libNFC « locale » pour lire un tag RFID non supporté : ST SRT512.

MISC hors‑série numéro 35

Au sommaire de ce numéro hors-série d'avril - mai 2026 :

  • État des lieux et évolution de la fraude : entretien avec Jonathan Spedale, analyste/enquêteur ;
  • Dossier sur la Gouvernance :
    • Point à l’AN 1 sur DORA : premiers audits et retours d’expérience terrain ;
    • Mettre en place un programme de formation cyber : de la stratégie à la culture ;
    • De l’insoutenable utilité des simulations de phishing ;
    • Sécurité de la chaîne d’approvisionnement numérique ;
    • Implémentation réussie ISO 27001 et SOC2 Type II : les leçons pratiques et actionnables ;
    • KP… Aïe ! Mode d’emploi des indicateurs de performance CSIRT/CERT ;
  • Plan de réponse à incident : le cas du ransomware.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Nouvelles de Haiku - Printemps 2026
    Haiku est un système d’exploitation pensé pour les ordinateurs de bureau. Il est basé sur BeOS mais propose aujourd’hui une implémentation modernisée, performante, et qui conserve les idées qui rendaient BeOS intéressant : une interface intuitive mais permettant une utilisation avancée, une API unifiée et cohérente, et une priorisation de l’interface graphique par rapport à la ligne de commande pour l’administration du système. Ce compte-rendu liste les principales modifications survenues en fé

Nouvelles de Haiku - Printemps 2026

Haiku est un système d’exploitation pensé pour les ordinateurs de bureau. Il est basé sur BeOS mais propose aujourd’hui une implémentation modernisée, performante, et qui conserve les idées qui rendaient BeOS intéressant : une interface intuitive mais permettant une utilisation avancée, une API unifiée et cohérente, et une priorisation de l’interface graphique par rapport à la ligne de commande pour l’administration du système.

Ce compte-rendu liste les principales modifications survenues en février, mars et avril. Ces changements sont numérotés de hrev59356 jusqu’à hrev59671 dans le code source de Haiku, soit environ 320 changements ce trimestre.

Les grosses nouveautés sont la disponibilité d’une version ARM64, l’accueil de 3 participants au Google Summer of Code et l’approche de la version beta 6, très attendue puisque la dernière version publiée, la beta 5, date de septembre 2024.

Sommaire

Portage de Haiku pour les architectures ARM64 et RISC-V

C’est la grosse nouvelle de ce trimestre : la version ARM64 de Haiku parvient enfin à lancer le Tracker et permet donc d’avoir un environnement fonctionnel !

Ce travail repose bien entendu sur les efforts de nombreux contributeurs par le passé pour mettre en place cette nouvelle architecture. Ces derniers mois, le travail a été complété par smrobtzz avec des corrections pour pouvoir compiler Haiku depuis macOS, des pilotes pour le port série S5L utilisé par Apple, une correction de l’adresse de base du noyau, la remise à 0 du frame pointer lors du début d’exécution du noyau, des corrections dans la gestion de la mémoire physique, ainsi que quelques correctifs dans l’espace utilisateur. SED4906 a également participé avec des corrections dans la gestion des pages mémoire du bootloader, ainsi que dans les vérifications de taille de pages du runtime_loader.

smrobtzz ne s’est pas arrêté là, il a ensuite ajouté la possibilité d’utiliser plusieurs cœurs et threads de processeur (SMP) et corrigé des problèmes de compatibilité avec la version du firmware EFI EDK2 fournie par défaut avec QEMU, ainsi que, entre autres, des problèmes avec la fonction system_time.

Une fois le système de base stabilisé, le travail s’est poursuivi du côté de Haikuports où smrobtzz et waddlesplah ont travaillé ensemble pour corriger de nombreux problèmes, en particulier sur les recettes de compilation croisée et le processus de “bootstrapping” qui permet de générer le jeu de paquets initiaux permettant d’exécuter Haiku. Les téléchargements de “nightly builds” pour ARM64 fournissent donc maintenant un système utilisable sur les machines ARM64 au moins dans QEMU.

Un fil de discussion sur le forum de Haiku permet de suivre l’évolution de ces développements. La prochaine étape est la compilation de toutes les applications disponibles dans Haikuports, la correction des problèmes que cela va immanquablement dénicher, et la stabilisation du système. Ensuite, le travail pourra se poursuivre pour rendre cette version de Haiku utilisable hors de QEMU sur du matériel réel.

Du côté de RISC-V, le portage de Haiku est un peu plus avancé depuis quelques mois déjà, et fonctionne sur certaines machines sans virtualisation dans QEMU. Ce trimestre, on voit donc seulement une correction de TODO dans le code pour le thread-local storage concernant l’utilisation de variables atomiques (waddlesplash).

Applications

TextSearch

TextSearch est une application de recherche de texte dans le contenu de fichiers. C’est l’équivalent graphique de la commande grep.

Désactivation de vérifications de types de fichiers redondantes pour accélérer l’application (Philippe Houdoin).

HaikuDepot

HaikuDepot est à la fois un gestionnaire de paquets et un magasin d’applications.

apl continue d’améliorer l’application HaikuDepot.

  • Modification du code de vérification des schémas JSON, en particulier pour préparer son intégration avec le code traitant les requêtes REST et pouvoir ainsi valider les requêtes et les réponses.
  • Correction d’un problème d’affichage de l’onglet “Featured packages” (avec une correction dans BTabView).
  • Refonte du code d’affichage des données dans la liste des paquets.

Software Updater

Software Updater est l’application permettant de télécharger et d’installer des mises à jour de paquets logiciels.

Correction d’un crash lorsque l’on quitte l’application pendant une mise à jour (Nathan242).

Ajout d’une option (activée par défaut) de nettoyage automatique des points de restauration anciens pour éviter de remplir le disque système avec des paquets obsolètes. La règle retenue est de conserver toujours au moins 10 points de restauration, et tous ceux qui sont plus récents que 30 jours (waddlesplash).

DeskCalc

DeskCalc est une calculatrice.

Nettoyage et améliorations du code de calcul en précision arbitraire (John Scipione).

Mail

Mail est le client email de Haiku. Il propose seulement l’affichage et la rédaction de mails : l’envoi et la réception sont traités par un service indépendant (mail_daemon), tandis que l’affichage de la boîte de réception est réalisé par des requêtes directement dans Tracker.

Humdinger s’est penché sur la gestion des mails avec plusieurs corrections et améliorations :

  • L’attribut thread est correctement enregistré sur les messages envoyés, ce qui permet de facilement les regrouper avec les messages reçus dans la conversation correspondante.
  • Quelques fichiers du code source n’étaient pas scannés par les outils de localisation, donc certains termes restaient invariablement en anglais.
  • Implémentation de labels, permettant d’étiqueter les messages avec des chaînes de caractères arbitraires. Auparavant, l’attribut statut était détourné pour ça, mais cela pose des problèmes lors de la synchronisation avec les serveurs IMAP, pour lesquels le statut du message a une signification bien spécifique. Les labels sont pour l’instant entièrement locaux et ne sont pas synchronisés avec le serveur de messagerie. Cette fonctionnalité comprend également un nouvel add-on pour le Tracker, permettant de facilement étiqueter un fichier.

La couleur du texte pour le corps des messages se met à jour immédiatement lors d’un changement des préférences de couleur du système (John Scipione).

Tracker

Tracker est le gestionnaire de fichiers de Haiku.

John Scipione continue son travail sur le Tracker :

  • L’aperçu des fichiers en cours de glissé-déplacé affiche maintenant les fichiers avec leur apparence « sélectionnée » (texte blanc sur fond noir), ce qui permet de garder le texte plus facilement lisible (bien que ce soit peut-être moins joli).
  • L’icône de la corbeille s’affichait parfois pleine alors qu’elle est vide ou inversement, suite à des problèmes de synchronisation de cache et de collecte des informations de l’état de la corbeille de chaque disque monté.

John a également supprimé du code obsolète et corrigé de très nombreux problèmes, par exemple avec le tri des fichiers, la gestion des images de fond dans les fenêtres, le copier coller…

Nathan242 a quant à lui corrigé un plantage lorsqu’on annule le vidage de la corbeille ainsi que des problèmes de formatage de l’indicateur du nombre de fichiers sélectionnés.

Madmax a fait en sorte que les raccourcis claviers pour les add-ons se mettent à jour immédiatement (et pas lors de l’ouverture d’un menu pop-up) lorsque les add-ons sont modifiés.

Waddlesplash a également fait quelques corrections mineures, dont une mérite une mention : une optimisation pour réduire le nombre d’appels système pour le node monitring (réception de notifications lorsque des fichiers sont modifiés).

StyledEdit

StyledEdit est un éditeur de texte de type « bloc notes ». Il permet d’utiliser du texte formaté (polices, couleurs…)

Lors de la création d’un nouveau document texte, le nom « Sans titre 1 », « Sans titre 2 », etc. est généré avec le plus petit nombre non utilisé. Auparavant, les numéros s’incrémentaient même si certains fichiers avaient entretemps été renommés ou fermés (x512).

CharacterMap

CharacterMap permet d’explorer le jeu de caractères unicode et d’y piocher des caractères intéressants.

Correction d’un bug dans la recherche par nom de bloc unicode, amélioration de la disposition des caractères, et diverses autres petites améliorations (madmax).

DeskBar

DeskBar est la barre des tâches de Haiku, permettant de naviguer entre différentes fenêtres et applications.

Ajout dans la fenêtre des préférences d’un sélecteur de coin (similaire à celui déjà utilisé pour les coins actifs dans les préférences des écrans de veille). Ceci permet d’améliorer la découvrabilité de la possibilité de déplacer la DeskBar à différents endroits sur l’écran, et est plus facile à utiliser que le “grip” de déplacement de la DeskBar elle-même, qui est tout petit (PulkoMandy, basé sur un ancien patch de mmu_man).

Terminal

Ajout d’une initialisation manquante pour la couleur du curseur, en particulier lorsque le Terminal est utilisé comme réplicant dans une autre application (JackBurton79, suite à l’utilisation du Terminal dans l’IDE Genio).

Utilisation de _exit au lieu de exit dans les processus fils lancés par fork() sans exec(). L’utilisation de exit appelle les destructeurs globaux dont la destruction de certaines ressources partagées avec le processus parent. C’est une difficulté du mélange des API graphiques de BeOS avec un modèle POSIX complet (waddlesplash). Le même problème a été également corrigé dans l’application Expander.

LaunchBox

LaunchBox est un « dock » permettant de stocker des raccourcis vers des applications fréquemment utilisées.

Simplification du mécanisme d’enregistrement des paramètres. Auparavant, l’enregistrement était fait après un délai d’inactivité, pour éviter d’enchaîner plusieurs écritures sur disque à chaque modification de réglages. Il semble plus simple d’enregistrer les modifications tout de suite, et de laisser le cache disque faire son travail pour décider d’écrire ces changements sur disque tout de suite ou un peu plus tard (nephele).

MediaPlayer

Optimisation du code de lecture des fichiers de playlist pour lire le contenu des fichiers ligne par ligne, et pas caractère par caractère (mohammedrattia, dans le cadre de sa candidature au Google Summer of Code).

ActivityMonitor

ActivityMonitor affiche des graphes avec différentes statistiques d’utilisation de la machine.

Correction d’un bug lors de l’affichage des températures du système dans les cas où le pilote ne fournit pas de nom pour la température mesurée (OscarL).

WebPositive

WebPositive est le navigateur web de Haiku. Il utilise le moteur WebKit qui est un projet libre co-développé principalement par Apple (Safari), Sony (PlayStation), et Igalia (versions GTK et WPE).

Pour les téléchargements dont la taille est inconnue, affichage d’un « barber pole » au lieu d’une barre de progression bloquée à 100 % (YashSuthar983 dans le cadre d’une candidature au Google Summer of Code).

Lorsque WebPositive est quitté en fermant le dernier onglet ouvert, il ne restaure pas ce même onglet lors du prochain démarrage (nipos).

Suppression de code obsolète dans la barre d’onglets (nipos).

Devices

Devices affiche une liste du matériel présent sur la machine.

Les premiers patchs développés par Aquamatic dans le cadre de sa candidature au Google Summer of Code ont été intégrés ce trimestre :

  • Les périphériques peuvent être triés par bus (PCI, USB…) en complément des autres options déjà disponibles.
  • Nettoyage du code pour prendre en compte certains « TODO » listés dans le code de l’application.
  • Investigation et correction d’une fuite de mémoire.

Préférences de localisation

Modification de la localisation dans plusieurs applications pour s’assurer que le comportement de l’option « traduire les noms des applications » est respecté partout lorsque le nom de l’application est mentionné dans un autre texte (humdinger).

Préférences d’apparence

Retrait d’espacements inutiles et disgracieux dans la fenêtre (humdinger).

Outils en ligne de commande

Remplacement des fonctions fork et exec dans time_stats pour utiliser posix_spawn (waddlesplash). L’utilisation de fork et exec pour lancer des processus enfants est la méthode traditionnelle, la première mise en place dans UNIX. Elle pose des soucis de performance et cause des comportements problématiques. En particulier, de nombreuses ressources du processus parent sont conservées (descripteurs de fichiers ouverts, sémaphores…) alors qu’ils ne sont pas toujours nécessaires. La fonction posix_spawn permet un meilleur contrôle de ces comportements, tout en étant beaucoup plus rapide et plus simple à implémenter. Le sujet a conduit à plusieurs modifications dans d’autres parties du code, dont on reparle plus loin dans la dépêche.

pkgman propose maintenant une sous-commande cleanup pour le nettoyage des points de restauration. Contrairement à SoftwareUpdater, ce nettoyage n’est pas automatique, car cela rendrait l’utilisation de pkgman potentiellement trop destructrice. Cependant, un message s’affiche après l’installation de mises à jour indiquant le nombre de points de restauration qui peuvent être nettoyés (waddlesplash).

Amélioration de la commande ltrace, mais celle-ci est toujours un travail en cours et pas encore utilisable (waddlesplash).

Kits

Les APIs de programmation de BeOS et de Haiku sont implémentées en C++. Elles sont organisées en “kits” regroupant des fonctionnalités liées.

Application Kit

L'application kit comporte toutes les fonctions d’échange de messages entre applications et au sein d’une application.

Meilleure gestion d’un cas d’erreur dans BInvoker pour remonter l’erreur à la fonction appelante (korli).

Support Kit

Le support kit contient toutes sortes de fonctions utilitaires basiques : gestion des chaînes de caractères, parser JSON…

Ajout de tests unitaires pour la classe BStopWatch (priyanshu-gupta07).

La famille de fonctions string_for_size change d’unité lorsque la valeur atteint 1000 et pas 1024. Par exemple on affichera “0.9 Gio” plutôt que “1,000 Mio” (korli). Elles pré-initialisent certaines données au démarrage de l’application plutôt que de les recalculer à chaque appel, ce qui rend l’utilisation de ces fonctions beaucoup plus rapide (waddlesplash).

Les fonctions de géolocatisation BGeolocation utilisent maintenant les services de Beacon DB, suite à la fermeture de Mozilla Location Services (PulkoMandy).

Suppression des objets BLocker alloués statiquement à plusieurs endroits. Ils sont problématiques lors d’un fork : par défaut, les objets BLocker dans les deux processus résultants pointent vers le même verrou système, mais si l’un des deux processus s’arrête, il détruit le verrou et laisse l’autre dans un état incohérent. Dans ce cadre, ajout également de vérifications pour empêcher le processus fils de continuer à utiliser l’interface utilisateur ou même d’appeler la fonction exit() (waddlesplash).

Refonte des classes BBlockCache, BTokenSpace et BLooperList utilisées pour gérer des ressources diverses, en particulier dans BMessage : utilisation de locks moins lourds, suppression de sémaphores qui n’était pas nécessaires, optimisation des performances (waddlesplash).

Modernisation des tests unitaires du support kit, pour rendre plus facile l’ajout de tests supplémentaires (KapiX).

Optimisation des méthodes de recherches de BString (pour trouver un caractère, une sous-chaîne…) en utilisant les fonctions C prévues à cet effet dans la libc plutôt que des boucles écrites à la main (waddlesplash, avec des corrections de madmax).

Interface Kit

L'interface kit contient toutes les classes nécessaires à la réalisation d’interfaces graphiques.

Correction de l’utilisation de la touche “Suppr” dans une zone d’édition de texte lorsqu’il y a également un raccourci clavier de menu (même désactivé) associé à cette même touche (nathan242).

Optimisation des méthodes BView::FillStroke et FillPolygon dans leur variante recevant directement un tableau de points pour éviter de recopier ce tableau dans un objet temporaire (x512).

Correction d’incompatibilités avec BeOS dans le format d’enregistrement de BPicture (x512) :

  • pour l’enregistrement d’images bitmap,
  • le “cisaillement” (shear) des polices de caractères,
  • les sous-pictures,
  • les transformations affines,
  • les “échappements” (espacement des caractères) de texte,
  • et d’autres petits problèmes.

Ce format permet de stocker une suite d’instructions de dessin pour afficher quelque chose à l’écran. Il est parfois utilisé par certaines applications pour stocker des ressources dans un format vectoriel compact, c’est pourquoi le respect du format défini par BeOS est important.

Ajout d’une taille minimale pour les barres de défilement, pour qu’elles gardent une taille raisonable même si l’utilisateur choisit une taille de police de texte en dessous de 12pt. La taille de toute l’interface s’adapte automatiquement à ce choix, mais pas de façon linéaire (nipos).

Suppression d’une valeur présente en double dans le message « mouse idle » envoyé aux applications lorque la souris cesse de se déplacer (x512).

Correction du code de dessin des cases à cocher pour restaurer l’état initial de la vue dans laquelle le dessin est fait. Ce problème était visible en particulier dans WebPositive lors de l’affichage de cases au sein d’une page web (nephele).

Correction de la façon dont BButton initialise ses couleurs, pour correspondre au comportement de BeOS et corriger des problèmes avec les applications utilisant liblayout, en particulier Wonderbrush (PulkoMandy).

Deux modifications sur la gestion des raccourcis clavier :

  • Vérification des changements de raccourcis seulement lorsque c’est vraiment nécessaire. Cela est particulièrement visible dans Tracker où la plupart des raccourcis sont dynamiques (par exemple, actifs seulement si un fichier est sélectionné) (jscipione)
  • Remplacement du tableau simple utilisé pour stocker les raccourcis par un arbre binaire de recherche, permettant de trouver rapidement si une combinaison de touches est associée à un raccourci clavier (waddlesplash).

Storage Kit

Le storage kit permet l’accès aux systèmes de fichiers.

Ajout de la nouvelle macro _DEPRECATED pour signaler au compilateur de déclencher un avertissement si certaines fonctions sont utilisées (via l’option -Wdeprecated). Les premières méthodes à recevoir ce traitement sont dans BMimeType et BResources (waddlesplash).

Grosse optimisation du « renifleur MIME » qui analyse le contenu des fichiers pour déterminer leur type MIME. L’utilisation de fonctions POSIX optimisées (memmem entre autres) et d’autres améliorations rendent l’étape « mimeset'ing package contents » de la compilation de Haiku ou de paquets HaikuPorts au moins 10 fois plus rapide (waddlesplash).

Network Kit

Le network kit permet la programmation d’application communiquant en réseau.

Correction d’un bug dans BSecureSocket qui ne validait plus les certificats SSL suite à une erreur lors d’une modification précédente (Horizons).

Media Kit

Le media kit se charge des médias audio et vidéo.

Réparation de l’add-on média « mixeur vidéo » qui est maintenant disponible dans l’image de base. Il est surtout utile comme démonstration des possibilités du media kit (x512).

Serveurs

Les serveurs sont des applications lancées en tâche de fond et qui rendent différents services. Ils sont similaires aux “daemons” de UNIX.

app_server

app_server est le serveur graphique de Haiku.

Correction d’un crash lors de l’utilisation d’un dégradé de couleurs ne comportant aucune couleur (KapiX).

La taille indiquée aux accelerants pour les curseurs matériels n’était pas la bonne (Goldfish64).

Intégration de commits de versions plus récentes de AGG pour corriger des typos dans quelques fonctions (Coldfirex).

Correction de fautes de frappe détectées par codespell, un outil de vérification orthographique pour le code (korli). Ces modifications font suite à une mise à jour des règles de codage de Haiku pour spéficier que c’est l’orthographe américaine qui est préférée lorsqu’il y a des divergences avec l’anglais européen.

Ajout d’un nouveau mode de fonctionnement pour les accélerants où le framebuffer n’est accessible que par l’espace utilisateur. Pour l’instant, seuls les pilotes VESA et framebuffer sont concernés, mais les autres pilotes devraient être modifiés de la même façon, car il n’y a pas de raison pour le noyau d’accéder directement au framebuffer à part dans le cas d’un kernel panic, ce qui se fait de toutes façons par une autre méthode (waddlesplash).

launch_daemon

launch_daemon est l’application “init” qui se charge du démarrage des autres services et des sessions utilisateurs. Il joue un rôle proche de celui de systemd pour Linux ou de launchd pour Mac OS.

Retrait des utilisations de fork+exec dans net_server et launch_daemon au profit de posix_spawn. Amélioration du code qui interprète les variables d’environnement (waddlesplash).

Bluetooth

Le serveur bluetooth centralise toutes les opérations concernant les périphériques Bluetooth.

Les premiers patchs des candidats au Google Summer of Code font que les choses bougent à nouveau du côté du serveur Bluetooth !

Vighnesh Sawant a corrigé le traitement du message “inquiry result” lorsqu’un appareil fournit plusieurs réponses d’un coup (ce qui est possible d’après la spécification du Bluetooth). Il a également implémenté le traitement de nouveaux types de réponses contenues dans ce message, terminé le code nécessaire pour la procédure d’appairage basique, corrigé l’apparition de périphériques bluetooth en double, et encore d’autres problèmes. Il a aussi déplacé tout le code concernant l’appairage basique dans un fichier source séparé.

Mohammed Rattia a quant à lui nettoyé les fonctions de recherche du périphérique Bluetooth local, et réparé la compilation des tests unitaires liés au Bluetooth.

Enfin, shivamsinghydv a ajouté une validation de l’adresse MAC des périphériques lors de leur activation par le serveur Bluetooth et corrigé un crash.

Mail

Le serveur de mail se charge de l’envoi et de la réception de courrier électronique (POP, IMAP et SMTP). Les messages sont mis à disposition du reste du système sous forme de fichiers avec des attributs étendus.

Philippe Houdoin a fait quelques changements sur le client IMAP :

Vérification des informations CAPABILITY retournées directement en réponse à une commande IMAP LOGIN. Les capacités étaient récupérées séparément, mais dans certains cas le serveur envoie cette liste dès le début de la connection, afin de pouvoir informer de capacités qui influent le processus de login, par exemple.

Modifications de la réponse à la commande ID pour identifier clairement le client mail de Haiku lorsque le serveur demande qui on est.

Media

Le serveur média permet l’interfaçage avec la carte son, et les entrées et sorties vidéo s’il y en a.

Le mélangeur de sons n’est démarré que lorsqu’une application a besoin de jouer du son pour la première fois. Cela économise du CPU et de la batterie (puisque la sortie de la carte son peut être laissée en veille jusqu’à ce moment. Pour l’instant il n’y a pas encore d’arrêt du mixeur et de mise en veille de la carte son lorsque la lecture de son est finie, cela pourra être ajouté plus tard. Cela corrige également certains problèmes conduisant à l’erreur « performance time too large ! » suite à une vérification ajoutée il y a environ deux ans pour détecter des utilisations incorrectes du media kit (waddlesplash).

Pilotes matériels

Stockage

Le pilote virtio_block a été temporairement désactivé en préparation de la publication de la version beta 6 de Haiku. En effet, il semble causer des problèmes de corruption disque dans certains cas, sans que les développeurs de Haiku aient pu identifier pour l’instant la source du problème. Si vous utilisiez virtio_block, vous pouvez le remplacer par virtio_scsi qui fournit des fonctionnalités équivalentes mais avec un protocole de communication avec la machine hôte différent. Il faut donc par exemple modifier la ligne de commande de démarrage de QEMU (waddlesplash).

Ajout de paramètres manquants dans les APIs permettant de détecter les fonctionnalités disponibles pour les disques NVMe (feature management) (korli).

Amélioration de l’initialisation des périphériques connectés à un contrôleur SDHCI : désactivation des cartes dont la tension d’alimentation n’est pas compatible, et mise en place des premières étapes pour la communication avec les périphériques eMMC (Mahmoussam, dans le cadre d’une candidature au GSoC qui n’a pas pu être acceptée).

Réseau

Synchronisation des pilotes réseau avec la dernière version d’OpenBSD (waddlesplash).

Correction d’un bug dans le pilote USB ethernet qui causait un plantage de certains adaptateurs USB lors de la lecture de l’adresse MAC (smrobtzz).

Ajout de l’USB dans la couche de compatibilité avec FreeBSD, ce qui a permis de remplacer le pilote ASIX-USB développé spécifiquement pour Haiku par celui de FreeBSD, qui permet d’utiliser une plus large gamme d’adaptateurs utilisant un chipset ASIX (waddlesplash et smrobtzz).

Import du pilote zyd de FreeBSD sous le nom zydzifi1211 avec l’ajout des fonctions nécessaires dans la couche de compatibilité. Ce pilote est à la recherche de testeurs pour confirmer son bon fonctionnement (waddlesplash).

Affichage

Ajout des identifiants PCI pour une nouvelle génération de contrôleurs GART Intel, permettant de gérer le partage de la mémoire entre le CPU et le GPU (OscarL).

USB

Désactivation d’une optimisation « zéro copie » dans le pilote EHCI (USB 2). Cette optimisation semble déclencher des plantages ou des corruptions sur certaines machines (waddlesplash).

Virtualisation

Intégration d’une série de pilotes pour le virtualiseur Hyper-V : souris, heartbeat pour confirmer que le système virtualisé est toujours vivant, synchronisation de l’heure, pilote SCSI, et diverses couches basses nécessaires à tous ces pilotes (Goldfish64).

Gestion d’énergie

Correction de messages de debug dans le pilote AMD P-States. Correction de la compilation du pilote audio HDA lorsqu’il est compilé sans les logs de debug. Ce pilote émet de très nombreux logs au démarrage pour identifier la carte son et toutes ses capacités, il est donc parfois utile de désactiver ces logs pour travailler sur autre chose (OscarL).

Systèmes de fichiers

Les systèmes de fichiers semblent être une cible appréciée des contributeurs au Google Summer of Code : le périmètre est bien maîtrisé, et le gros du travail se situe au niveau des structures de données, qui sont enseignées dans la plupart des cursus scolaires en informatique.

Ceci explique une activité inhabituellement élevée dans ce domaine lors de la période de candidature. Cependant, les tâches les plus abordables ont déjà toutes été traitées, et aucun des dossiers de candidature reçus cette année dans ce domaine n’a été jugé de qualité suffisante pour embaucher un nouveau contributeur.

Packagefs

Packagefs est un système de fichier virtuel permettant d’accéder aux contenus des paquets installés sur le système. Cette approche permet d’utiliser les paquets logiciels sans avoir besoin de les extraire, et accélère considérablement l’installation et la désinstallation de logiciels.

Amélioration de la gestion du manque de mémoire RAM, pour favoriser un ralentissement du système plutôt que de déclencher des erreurs de lecture (waddlesplash).

NTFS

NTFS est le système de fichier utilisé par Windows.

Correction d’un crash lors de certaines erreurs de montage de partitions (waddlesplash).

BTRFS

BTRFS est un des systèmes de fichiers utilisés par Linux. Il offre de nombreuses fonctionnalités avancées dont le pilote pour Haiku ne sait que faire. Seule la lecture de fichiers classiques est possible.

Lecture des fichiers compressés avec ZSTD (Abdullah Zulfiqar).

Corrections de warnings du compilateur et de bugs potentiels (grep-name).

Ajout de vérification de validité et traitement des collisions de hash dans les recherches de fichiers dans des dossiers ; vérification que la taille des partitions est suffisante avant de formatter un disque en btrfs ; amélioration de certains cas de gestion d’erreur ; nettoyage et amélioration de commentaires (Anuj Billore).

XFS

XFS est un système de fichiers initialement développé pour IRIX mais dont le développement continue dans Linux. Il est une alternative populaire à ext4 pour ce dernier.

Plusieurs corrections par sleipbyte :

  • Correction d’une erreur de compilation
  • Implémentation de rewind_dir, qui permet au Tracker d’afficher le contenu des dossiers,
  • Correction d’erreurs SMAP (accès à la mémoire utilisateur par le noyau sans validation de pointeurs)
  • Amélioration de la détection des partitions
  • Reconnaissance de nouveaux drapeaux indiquant des fonctionnalités additionnelles dans XFS (le système de fichier continue d’évoluer dans son implémentation pour Linux)
  • Traitement d’un cas particulier pour la gestion des attributs étendus : leur absence peut être indiquée par un pointeur NULL ou une taille à 0.

NFS v2

NFS est un système de fichiers permettant d’accéder à des fichiers stockés sur un autre ordinateur.

Amélioration des logs d’erreur lorsqu’un volume NFS ne peut pas être monté (kallisti5).

Il existe un deuxième pilote plus récent mais qui reconnaît uniquement NFS version 4, malheureusement, certains NAS n’implémentent que la version 3…

FAT

FAT est un ancien système de fichiers utilisé par Microsoft, pour DOS et les premières versions de Windows. Il reste populaire sur certains périphériques de stockage amovible et comme dénominateur commun entre beaucoup de systèmes.

Correction d’un plantage qui pouvait survenir lors du formatage d’une image disque au format FAT (nathan242).

BFS

BFS est le système de fichiers de BeOS et de Haiku. Il a la particularité d’avoir une gestion poussée des attributs étendus, et la possibilité d’effectuer des requêtes sur ces derniers à la manière d’une base de données.

Corrections et améliorations par Waddlesplash :

  • Un plantage pouvait survenir lors de la vérification d’un système de fichiers corrompu,
  • Une division par zéro dans le parseur de requêtes (utilisé aussi par packagefs et ramfs),
  • Un break manquant qui pouvait déclencher un plantage du noyau (assertion ou même utilisation de mémoire libérée) lors de la suppression de plusieurs fichiers en parallèle,
  • Ajout de notifications de renommage et déplacement pour les requêtes “live” en même temps que celles envoyées pour le « node monitoring », afin que les résultats de requêtes restent bien synchronisés avec l’état du disque.

RAMFS

RAMFS est un système de fichiers stockant les données directement en RAM. Il permet un accès très rapide aux fichiers, mais il est non persistant, les données sont perdues en cas de coupure ou de redémarrage du système.

Réorganisation du code par waddlesplash :

  • Nettoyage du code pour tracer la taille des allocations,
  • Consolidation de la logique do « node monitoring »,
  • Correction des évènements « node monitor » sur les fichiers simples.

RAM disque

Le ramdisk n’est pas un système de fichiers, mais un périphérique de stockage de masse. Il peut être formaté avec n’importe quel système de fichiers.

Retrait de l’utilisation de l’ordonnanceur I/O et traitement direct des requêtes à la place. Cela contourne un bug de l’ordonnanceur dans le cas où la taille des secteurs du disque est plus large que les blocs du système de fichiers, ce qui force à écrire plusieurs blocs sur un secteur d’un seul coup. Ce problème ne se produit habituellement pas sur d’autres supports de stockage (la taille des secteurs étant habituellement de 512 octets dans les autres cas). L’ordonnanceur sera tout de même corrigé plus tard, pour permettre son utilisation dans d’autres cas où il est pertinent et dans ce cas de figure, comme les flash NAND accessibles sans contrôleur de haut niveau (nathan242).

Réseau

Correction d’une fuite de sockets dans la pile Bluetooth (Vighnesh Sawant).

Activation du code permettant de charger des modules pour le résolveur DNS nsswitch dans libnetwork. Cela permettra par exemple de charger le module mDNS (aussi connu sous le nom de Avahi pour Linux ou Bonjour pour Mac OS) pour la résolution des noms de machines sur le réseau local (Philippe Houdoin).

Vighnesh Sawant a également ajouté la possibilité d’utiliser l’option AI_V4MAPPED au résolveur DNS.

Ajout de la notification de l’erreur B_SELECT_DISCONNECTED (correspondant à l’erreur POSIX POLLHUP) dans les notifications sur les sockets, corrigeant ainsi un cas de test de compatibilité BSD (waddlesplash).

libroot

libroot est l’implémentation de la librairie C standard de POSIX. Elle regroupe les fonctions habituellement réparties entre les libc, libm et libpthread sur les systèmes UNIX classiques.

Remise en place de code spécifique par architecture dans printf qui avait été incorrectement enlevé. Cela corrige des plantages dans certains cas spécifiques (waddlesplash).

Ajout de la définition de GETENTROPY_MAX qui était manquante dans limits.h (korli).

Implémentation de la réservation d’espace d’adresse pour le tas du runtime_loader. Ceci évite la fragmentation de l’espace mémoire et améliore les performances, en particulier lorsque l'ASLR est désactivé (Amir Ramez, dont c’est la première contribution).

Réécriture de l’implémentation de pthread_barrier pour utiliser moins d’appels systèmes, corriger des problèmes de synchronisation, et au final éliminer un blocage qui survenait dans des applications utilisant OpenGL (waddlesplash).

Remplacement de l’implémentation de strchr et de strcpy par des versions plus optimisées venant de la bibliothèque musl (waddlesplash).

Correction d’un plantage lors de l’utilisation des allocateurs mémoire “debug” ou “guarded” dans libroot, qui était causé par des changements sur l’ordre d’initialisation des données de localisation (waddlesplash).

Correction d’incompatibilités dans l’implémentation de kqueue, en particulier, la fermeture d’un descripteur de fichier surveillé déclenchait une notification alors que ce n’est pas le cas dans les implémentations BSD (waddlesplash).

Renommage de PTHREAD_RECURSIVE_MUTEX_INITIALIZER pour ajouter le suffixe _NP. La constante porte ainsi le même nom que dans glibc par exemple, indiquant clairement qu’il s’agit d’une extension non-POSIX (waddlesplash).

Remise en place d’une prise en charge multi-plateforme pour le type long double de 128 bits. Le code de glibc pour cela avait été supprimé lors d’un précédent nettoyage car les plateformes x86 utilisent un format à 80 bits. Cela devrait corriger des plantages sur ARM64 et RISC-V lors de l’utilisation de ce type de valeurs (waddlesplash suite à l’investigation de smrobtzz). Bien que le problème eût déjà été signalé lors de la suppression du code concerné, à l’époque il n’y avait pas d’architecture fonctionnelle permettant de prouver la présence du problème.

Ajout d’un wrapper pour la fonction sigaction dans le « POSIX error mapper », qui permet de faire fonctionner des applications dépendant du fait que les valeurs de errno sont positives (contrainte apparue dans les versions récentes de POSIX, mais impossible à satisfaire tout en conservant la compatibilité avec BeOS) (korli).

Réparation de POSIX_SPAWN_SETSID, qui ne fonctionnait pas (waddlesplash).

Noyau

Le noyau de Haiku est un noyau monolithique assez classique. Il offre la possibilité de charger des modules, et une attention particulière est apportée à conserver le mieux possible l’API définie entre le noyau et les modules, rendant assez facile le développement de modules (tels que des pilotes de périphériques) indépendamment du noyau.

Gestion des hôtes Hyper-V : calibration TSC spécifique et pilote VMbus (Goldfish64 dont c’est la première contribution).

Amélioration du suivi des mutex de l’espace utilisateur dans le noyau, pour rendre les problèmes moins faciles à déclencher et plus faciles à rattraper (waddlesplash).

Korli a corrigé des problèmes détectés par les tests du langage Go :

  • Lors de la création d’un fichier qui impose de traverser un lien symbolique vers un dossier qui n’existe pas encore,
  • Dans la gestion des paquets réseaux, où une gestion de taille de tampon mémoire utilisait des valeurs incohérentes.

Retravail en profondeur des messages SMP (à la base de toute la mécanique de synchronisation de l’exécution du code entre différents threads et cœurs de CPU) : réduction des attentes actives en utilisant rw_spinlock au lieu de spinlock simples, envoi de messages à seulement certains cœurs plutôt qu’en broadcast, traitement des messages reçus par un cœur avant d’attendre la réception des messages envoyés aux autres, suppression d’opérations atomiques inutiles, etc. (waddlesplash). Ces changements ne semblent pas régler les gros problèmes de performance observés avec ce code lors de l’utilisation de Haiku dans VirtualBox, qui reste donc non recommandé pour utiliser Haiku.

Activation de l’utilisation de certaines fonctions “builtins” du compilateur dans le noyau. Le noyau est compilé avec l’option -freestanding pour indiquer au compilateur qu’il ne s’agit pas d’un environnement d’exécution standard, en espace utilisateur et avec une bibliothèque C. Cette option empêche le compilateur de supposer qu’une fonction nommée memcpy (par exemple) a un comportement spécifique et peut être remplacée par une implémentation accélérée. Cela limite les possibilités d’optimisation. Pour éviter ce problème, il faut appeler explicitement les fonctions built-in du compilateur qui implémentent ces opérations, ce qui se fait via des manipulations du préprocesseur C. Les noyaux Linux et FreeBSD ont déjà mis en place cette solution, et maintenant Haiku applique la même solution (waddlesplash).

Correction d’un problème d’initialisation de IO-APIC sur certains systèmes avec un bus PCIe (Goldfish64).

Optimisation de fonctions liées à la gestion de la swap (waddlesplash). Retravail de la gestion des allocations pour améliorer la stabilité et les performances lorsque la mémoire swap est utilisée (ce patch était en test depuis plusieurs mois afin de trouver un maximum de bugs avant de le fusionner, et de ne pas trop déstabiliser les nightly builds). Nettoyage du code vérifiant les permissions d’accès à la mémoire et la protection (en lecture ou en écriture).

Modification de l’initialisation des tas d’allocation mémoire du noyau pour permettre d’activer les modes “debug” ou “guarded” avec une option du menu de démarrage (sans devoir recompiler le noyau). Ainsi les utilisateurs peuvent facilement activer ces options pour aider à l’investigation de problèmes de corruption de mémoire qui ne se reproduisent que sur leur machine (waddlesplash).

Correction de problèmes de synchronization entre le cache de mémoire virtuelle et les opérations sur le système de fichiers, qui pouvait aboutir à un blocage complet du système. Ajout d’un test unitaire pour ce cas particulier (waddlesplash).

Réorganisation de la mémoire allouée pour le SMP (multiprocesseurs), pour éviter d’allouer un grand nombre de variables atomiques dans la même ligne de cache CPU (problème de "false sharing »). (waddlesplash)

Découpage des fichiers de code “VM” (gestion de la mémoire virtuelle) dans des fichiers de taille raisonable, par exemple pour le code d’initialisation et le « page writer ». Déplacement du code de notification de page occupée, suppression d’un champ inutile dans les page queues. Waddlesplash poursuit ce travail avec une refonte du page writer, qui n’est pas encore mergée pour l’instant.

Gestion des ASIDs dans les TLB

Ce sujet avait été discuté il y a quelques années dans le cadre d’un début de participation au Google Summer of Code qui n’avat pas abouti. Il est revenu à la surface suite à une série d’article « The Gerrit Code Review Iceberg », qui explore les patchs et changements abandonnés par leurs auteurs respectifs sur la plateforme de revue de code Gerrit (plus de 300 changements en attente). L’un des changements listés a attiré l’intérêt de SED4906 qui s’est penché sur les ASIDs. Le sujet est un peu technique et mérite quelques explications.

Pour gérer la mémoire virtuelle, on utilise une structure appelée TLB. C’est cette structure qui permet de faire correspondre une adresse en mémoire physique à une adresse en mémoire virtuelle, et également de gérer les permissions d’accès (lecture, écriture ou exécution) sur cette mémoire. Ces informations sont stockées en RAM et, pour gérer les vastes quantités de mémoire sur les machines modernes, peut comporter jusqu’à 5 niveaux d’indirection.

Si chaque accès mémoire devait traverser ces 5 niveaux pour trouver l’adresse physique à accéder, le système serait extrêmement ralenti. Le processeur inclut donc un cache spécifique dans lequel sont stockées les entrées TLB les plus récemment utilisées. Ainsi, la plupart des accès sont résolus très rapidement à l’aide de ce cache et l’impact de la mémoire virtuelle sur les performances est faible.

Cependant, ce cache crée un autre problème : lors d’un changement de contexte (exécution d’un autre processus par le processeur par exemple), il faut prendre garde à vider ce cache. Sans quoi, le nouveau processus pourrait accidentellement accéder aux données de l’ancien, suite à la mise en cache des mauvaises données. La solution traditionnelle à ce problème est de vider ce cache à chaque changement de contexte, c’est-à-dire plusieurs centaines de fois par seconde. Un processus interrompu, même brièvement, va donc se retrouver lorsqu’il reprend son exécution avec un cache vide, et les premiers accès à la mémoire seront donc fortement ralentis.

Une solution plus récente est l’utilisation d'ASIDs dans la table des pages. Cela signifie que, dans le cache TLB, chaque entrée va stocker non seulement l’adresse physique et les permissions, mais aussi un identifiant du processus auquel ces informations sont associées. Ainsi, lors d’un changement de contexte, il n’est plus nécessaire de vider le cache. Le nouveau processus disposant d’un ID différent, il ne va pas utiliser les entrées présentes pour un autre processus. Et si le processus initial reprend son exécution, il trouvera une partie du cache déjà préchargée avec ses informations.

Des identifiants spéciaux peuvent également être utilisés, par exemple pour l’espace mémoire du noyau. Cela permet de conserver dans le cache TLB toutes les entrées correspondant au noyau, qui sont utilisées lors des appels système peu importe le processus en cours d’exécution.

Le patch implémentant les ASIDs pour les processeurs x86 est encore en cours de développement. Mais la discussion autour de ces changements a déjà conduit à l’intégration de deux modifications plus simples:

  • Lors de la synchronisation entre CPU : par exemple si plusieurs threads (partageant le même espace mémoire) s’exécutent sur des cœurs de processeur différents, il est nécessaire de synchroniser les caches TLB des cœurs de processeur correspondants. Pour ce faire, les processeurs s’envoient des messages s’informant mutuellement de la nécessité de vider le cache TLB. Ce message peut être reçu alors que le processus en cours d’exécution a déjà changé, et dans ce cas, il déclenchait inutilement une vidange du cache supplémentaire (waddlesplash).
  • Il y avait d’autres problèmes dans l’implémentation spécifique aux processeurs x86. Les mesures de performances sur le patch avec activation des ASIDs (dans plusieurs versions) ont conduit à récupérer certains correctifs améliorant les performances sans nécessiter l’activation des ASIDs (SED4906 et waddlesplash).

Sur les processeurs x86, l’utilisation d’ASIDs est entièrement optionnelle. Ce n’est pas le cas sur d’autres architectures comme SPARC, où leur intégration dans le processeur est beaucoup plus profonde, avec par exemple des instructions permettant de travailler avec plusieurs espaces d’adressage simultanément.

Chargeur de démarrage

Correction d’un problème avec la fonction pour “bloquer” des fichiers (par exemple désactiver des pilotes de périphériques empêchant le démarrage) pour traiter correctement les noms de fichiers contenant des espaces (madmax).

Correction d’une fuite de mémoire dans le code affichant l’écran de démarrage. La mémoire était bien libérée lors du démarrage du noyau, mais seulement après avoir été tranférée du bootloader vers le noyau ce qui complique et rallonge inutilement la procédure de démarrage (waddlesplash). Augmentation de la taille de la zone de mémoire contenant les arguments du noyau, qui pouvait se remplir dans certains cas particuliers comme les images “bootstrap”.

Système de build

Forçage de la compatibilité C89 lorsqu’on compile GCC 2 avec les versions récentes de GCC. GCC 2 est toujours utilisé dans Haiku pour assurer la compatibilité avec BeOS. Il n’est pas possible de le compiler avec un compilateur s’attendant à trouver du code compatible avec les versions actuelles du langage C (korli, waddlesplash, kallisti5). La plateforme d’intégration continue a ensuite pu être mise à jour vers une version de Linux qui fournit GCC 14.

Activation de l’option de compilation -Werror pour un plus grand nombre de dossiers, en particulier netfs, et les pilotes graphiques radeon et s3 (fruitdelapassion). Cette option demande au compilateur de déclencher une erreur de compilation, plutôt qu’un simple avertissement, pour un certain nombre de problèmes. Ainsi, on s’assure que les développeurs ne passent pas à côté d’un problème qui aurait pu être détecté tout de suite. La prochaine étape sera d’inverser la logique pour cette option : l’activer par défaut pour tous les dossiers, et la désactiver explicitement lorsque c’est absolument nécessaire, par exemple pour du code importé d’autres projets pour lequel il est préférable de limiter les modifications.

KapiX a démarré un chantier d’amélioration du système de tests unitaires afin de rendre plus facile l’ajout de nouveaux tests, réduire la quantité de code à écrire pour faire fonctionner un test, et encourager les autres développeurs à écrire des tests :

  • Correction de la compilation des tests existants (kernel, app_server, libroot…)
  • Définition d’un nouveau type d’image “test” contenant les tests unitaires et un serveur SSH. Cette image peut être générée par la CI, puis démarrée dans une machine virtuelle pour lancer les tests
  • Désactivation des tests qui ne fonctionnent pas au point de provoquer un plantage irrécupérable.

Ajout d’un fichier de prédéfinition des paramètres POP/IMAP pour l’hébergeur disroot.org (humdinger).

Correction de la compilation de libroot avec le compilateur clang (nephele).

Nettoyage des Jamfiles, où du code exécuté en espace utilisateur employait les en-têtes normalement réservés au noyau. Les fichiers qui étaient souvent utilisés dans les deux espaces ont été déplacés dans un dossier commun (waddlesplash).

Modification de la gestion de errno dans libroot_build (la couche de compatibilité qui implémente des fonctions spécifiques à Haiku sur un système hôte utilisé pour la compilation croisée). Dans certains cas, la valeur de errno n’était pas bonne, ce qui créait des problèmes de comportement dans mimeset et dans d’autres outils utilisés lors de la compilation (waddlesplash).

Ajout d’un harnais fs_shell pour le système de fichiers ExFAT. Cela permet de tester le code du système de fichiers hors de Haiku, dans une interface en ligne de commande permettant de réaliser des opérations simples (Halonix).

Ajout d’un message d’avertissement dans la sortie de ./configure si certaines bibliothèques nécessaires à la compilation de Haiku ne sont pas disponibles (nephele).

Correction de diverses mauvaises orthographes pour le mot “unknown” un peu partout dans le code (SED4906).

Suppression d’un fichier temporaire qui était accidentellement laissé en place lors de la génération d’une image “MMC” (contenant un chargeur de démarrage pour une platforme ARM). Certains utilisateurs ont confondu ce fichier avec l’image finale et ont eu du mal à démarrer Haiku à cause de ce problème (waddlesplash).

Documentation

La documentation de Haiku est séparée en 3 parties:

  • Un guide de l’utilisateur, présentant les différentes applications, raccourcis clavier…
  • Le « Haiku Book », une référence des API pour les développeurs d’applications,
  • Une documentation “interne”, pour les développeurs qui travaillent sur le système d’exploitation lui-même.

La première est traduite dans plusieurs langues, tandis que les deux autres sont actuellement disponibles uniquement en anglais.

Haiku Book

Le Haiku Book est actuellement à utiliser en complément du Be Book, son équivalent rédigé pour BeOS. Haiku a obtenu l’autorisation de distribuer des copies du Be Book, mais avec une license n’autorisant pas les modifications. Cela veut dire que le Haiku Book doit être réécrit de zéro. Les efforts ont donc été mis en priorité sur les nouveautés de Haiku, et la documentation des parties reprises de BeOS arrive petit à petit.

Ajout de documentation pour B_QUERY_WATCH_ALL qui devient une API publique. Ce flag permet de générer une requête sur le système de fichier et de recevoir des notifications du node monitor lorsque les fichiers trouvés par la requête sont modifiés, même si la modification n’entraîne pas un ajout ou une suppression du fichier des résultats de la requête. C’est l’équivalent de B_WATCH_ALL qui existait déjà pour le node monitoring sur un dossier classique (waddlesplash).

Ajout de documentation pour des classes liées à l’utilisation du réseau : BCertificate, BProxySecureSocket, BSecureSocket et BSocket (cafeina).

Gros nettoyage et amélioration de la documentation de BEntry et BStatable. Ajout d’une remarque sur MenusBeginning dans la documentation de BWindow (John Scipione).

Documentation pour les développeurs

La documentation interne est un projet plus récent. Elle est construite à partir de documents, d’articles et de messages de mailing list écrits au cours du temps par les développeurs de Haiku, dans le but de mieux structurer ces connaissances et de décharger le site web principal du projet, qui avait initialement accueilli ce type de documents au début du projet. Aujourd’hui, il serait plus intéressant d’avoir un site web plus centré sur l’utilisation de Haiku que sur son développement, mais il ne faudrait cependant pas perdre ces informations, soit pour leur intérêt technique, soit pour leur intérêt historique et la vision qu’elles donnent sur les débuts du projet.

Clarification d’un paragraphe incompréhensible dans la documentation du device manager (OscarL).

Mise à jour de la documentation sur l’implémentation de la mémoire swap et suppression de vieux documents sur la VM (gestion de la mémoire virtuelle) qui ne correspondait plus du tout à l’implémentation actuelle (waddlesplash).

C’est pour quand la bêta 6 ?

Waddlesplash inclut ce paragraphe dans les rapports d’activités mensuels. Le mieux pour se rendre compte des avancées est de reprendre tel quel les commentaires des 3 derniers mois :

Février

On s’approche !

Un gros changement sur la gestion de la mémoire qui corrige une méchante régression est en attente de revue depuis plus d’un mois mais aucun développeur ne semble disponible pour le relire.

Du côté du Tracker, la plupart des régressions sont corrigées, mais il en reste encore quelques-unes.

En dehors de ces deux gros sujets, il n’y a plus que 5 ou 6 bugs et régressions qui doivent absolument être corrigées, mais certaines d’entre elles promettent d’être des sujets compliqués qui vont demander un peu de temps.

Mars

C’est pas pour tout de suite !

Il y a un problème de rafraîchissement de l’affichage dans WebPositive qui bloque le processus de release. Une bonne partie des autres problèmes sont corrigés.

Avril

Pas encore !

Le problème dans WebPositive (dans HaikuWebKit, en fait) a été corrigé, mais il y a maintenant un problème pour télécharger les sources de HaikuWebKit depuis son nouvel hébergement sur Codeberg depuis les machines de build de Haikuports (le fichier est assez gros et déclenche un timeout du côté de Codeberg).

Et de toutes façons, il reste encore quelques bugs du côté de Haiku lui-même à traiter aussi.

On peut également jeter un oeil sur l'outil de suivi des bugs pour voir où on en est. Au moment de la rédaction de ce rapport, il reste 25 tickets ouverts dans le jalon beta 6, dont 3 de priorité critique :

  • Un problème de texte illisible lorsqu’on fait un glisser-déplacer d’un grand nombre de fichiers dans le Tracker,
  • Le mode « économie d’énergie » du scheduler empêche le fonctionnement de certains claviers et trackpads,
  • La fenêtre de sauvegarde de fichiers a des problèmes de mise en page, parfois les contrôles de la fenêtre sont superposés

Google Summer of Code

Haiku fait de nouveau partie des organisations sélectionnées cette année pour encadrer quelques participants au Google Summer of Code.

Une quarantaine de candidatures ont été reçues, dont une grande partie ont été assez rapidement éliminées : hors sujet, ne respectant pas le format demandé ou ne comprenant pas une contribution au code par exemple. Le projet Haiku s’en sort plutôt bien, là ou d’autres organisations plus reconnues ont reçues plusieurs centaines de propositions.

Finalement, étant donné le petit nombre de “mentors” disponibles pour encadrer les participants, seulement 3 participants ont été retenus cette année grâce à leur travail de très bonne qualité avec plusieurs patchs déjà intégrés avant même la fin de la période de candidature.

Aquamatic sera encadré par KapiX et Korli, et va améliorer l’application “Devices” (gestionnaire de périphériques), en particulier pour indiquer clairement les périphériques pour lesquels un pilote est disponible ou non.

Mohammed R. Attia et Vighnesh Sawant seront encadrés par Waddlesplash, Scottmc et PulkoMandy. Ils vont poursuivre l’implémentation du Bluetooth dans Haiku. Mohammed se concentre sur les périphériques HID (claviers et souris sans fil) tandis que Vighnesh se chargera du profil audio HFP et, si le projet avance bien, des autres profils audio de meilleure qualité.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Deming — un SMSI Open Source par et pour des RSSI
    Deming est un outil Open Source (GPL 3.0) de gestion de Système de Management de la Sécurité de l'Information (SMSI). Conçu par un responsable de la sécurité des systèmes d'information (RSSI) pour des RSSI, il couvre la gestion des contrôles, le registre des risques, la gestion des exceptions et des plans d'action. Largement adopté par la communauté, il se distingue par sa simplicité d'utilisation et de mise en œuvre. lien nᵒ 1 : Site du projetlien nᵒ 2 : Dépôt GitHublien nᵒ 3 : DocumentationI

Deming — un SMSI Open Source par et pour des RSSI

Deming est un outil Open Source (GPL 3.0) de gestion de Système de Management de la Sécurité de l'Information (SMSI). Conçu par un responsable de la sécurité des systèmes d'information (RSSI) pour des RSSI, il couvre la gestion des contrôles, le registre des risques, la gestion des exceptions et des plans d'action. Largement adopté par la communauté, il se distingue par sa simplicité d'utilisation et de mise en œuvre.

Logo Deming

Indépendant du référentiel

C'est l'une des forces de Deming : il ne présuppose aucun cadre normatif particulier. Il est livré avec une dizaine de référentiels prêts à l'emploi — ISO 27001 (2013, 2022, 2023 en allemand), ISO 22301, DORA, NIS2 (FR/EN/DE), HDS, PCI-DSS v4, NIST SP 800-53 Rev.5, MPA Best Practices — et permet d'en importer de nouveaux via un simple fichier Excel, sans développement.

Fonctionnalités

Deming propose une gestion centralisée des contrôles avec planification, assignation de responsables et rappels, un registre des risques avec scoring configurable (ISO 27005, BSI 200-3 et autres formules), un module de gestion des exceptions avec workflow d'approbation, ainsi que des tableaux de bord et des rapports de pilotage pour les revues de direction.

Technique

L'application est développée en PHP/Laravel, avec MariaDB/MySQL comme base de données principale (PostgreSQL et SQLite également supportés). Le déploiement se fait en quelques commandes via Docker Compose, ou manuellement sur Debian/Ubuntu grâce aux guides fournis dans le dépôt.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Rapport d'activité 2025 de l'April - Vidéos des conférences éclairs
    Comme de coutume, l'April publie son rapport annuel d'activité suite à l'assemblée générale de l'association, qui a eu lieu le samedi 28 mars 2026. Nous vous invitons à le consulter en ligne ou en version PDF. 91 pages vous font peut-être un peu peur ? Nous avons pensé à cette éventualité et avons prévu un résumé qui se lit en une dizaine de minutes ;) Bonne lecture à vous ! L'AG est réservée aux membres de l'April. Le matin, un temps de conférences éclairs, ouvert à toute personne, membre o

Rapport d'activité 2025 de l'April - Vidéos des conférences éclairs

Comme de coutume, l'April publie son rapport annuel d'activité suite à l'assemblée générale de l'association, qui a eu lieu le samedi 28 mars 2026. Nous vous invitons à le consulter en ligne ou en version PDF.

91 pages vous font peut-être un peu peur ? Nous avons pensé à cette éventualité et avons prévu un résumé qui se lit en une dizaine de minutes ;)

Bonne lecture à vous !

L'AG est réservée aux membres de l'April. Le matin, un temps de conférences éclairs, ouvert à toute personne, membre ou pas de l'April, a été organisé de 10 h à 12 h. Les présentations et la vidéo des conférences sont disponibles.

La liste des présentations :

  1. Stéphane Bortzmeyer - « Un autre langage pour concurrencer C, Zig »
  2. Natacha Rault - « Les sans pagEs : un projet libre et féministe »
  3. Denis Dordoigne - « La pièce jointe, une calamité »
  4. Éric Le Bihan - «Multiplier par 4 en 4 ans la pénétration de Linux (et du libre) »
  5. Ewa Kadziolka - « Bielik AI, un LLM polonais »
  6. Fabrice Mouhartem - « La collaboration chiffrée de bout en bout avec CryptPad »
  7. Julie Chaumard - « Strapi - CMS headless »
  8. Frédéric Henry - « Ouvrir les projets libres de l'April à la contribution »
  9. Boris Valero - « Les divisions dans la communauté linux en particulier et du libre en général »
  10. Françoise Conil - « MkDocs, Material et Zensical »
  11. Régis Perdreau - « ODFStudio.org : réinventer la contribution francophone à la bureautique libre ! »
  12. Bookynette - « Quel genre de bénévoles êtes-vous ? »
  13. Anne L'hôte - «OpenHikePlanner - Marcher et rouler librement »
  14. Christophe Villeneuve - « La navigation web de façon humaine »
  15. Olivier Deiber - « Réparer le Futur »

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 14 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [ZDNET] Consortium européen pour les communs numériques: l'EDIC sur les rails [clubic.com] 80 000 agents de l'Assurance Maladie basculent sur les outils numériques français de l'État, vive la souveraineté! [ZDNET] Libre

Revue de presse de l’April pour la semaine 14 de l’année 2026

Par : echarp
7 avril 2026 à 08:54

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[ZDNET] Consortium européen pour les communs numériques: l'EDIC sur les rails

✍ Thierry Noisette, le samedi 4 avril 2026.

Le Français Laurent Rojey a été choisi comme directeur de l’EDIC. Chez les cinq Etats fondateurs, l’Agence de technologie souveraine de l’Allemagne recrute, pour trois mois à deux ans, pour des projets open source.

[clubic.com] 80 000 agents de l'Assurance Maladie basculent sur les outils numériques français de l'État, vive la souveraineté!

✍ Alexandre Boero, le mercredi 1 avril 2026.

LaSuite continue de conquérir les administrations françaises. L’Assurance Maladie a officialisé, mercredi, le déploiement de la suite collaborative hexagonale auprès de ses 80 000 agents, un nouveau signal fort pour la souveraineté numérique de l’État.

[ZDNET] Libre et open source express: Mastodon, Echirolles, fin de Wikinews, Libre vs propriétaire

✍ Thierry Noisette, le mardi 31 mars 2026.

Revue de web: grand lifting pour Mastodon. Témoignage sur le Libre en municipalité. Wikimedia va arrêter Wikinews. ‘Alternative’, pas ‘équivalence’, une BD pour expliquer les différences libre-propriétaire aux non-initiés.

[La Voix du Nord] Wimille: avec «Libre en fête», l’accès libre pour tous au numérique ce samedi (€)

✍ Olivier Roussel, le mardi 31 mars 2026.

Organisé nationalement par l’April (Association nationale pour la promotion du logiciel libre) et ses partenaires, cet événement met à l’honneur le logiciel libre, la culture libre, et les valeurs d’écocitoyenneté.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Créer un site Web local de documentation pouvant exporter en PDF avec mdBook
    La documentation du langage Rust (le langage qui veut remplacer le C et le C++ en sécurisant l’accès mémoire et en supprimant le ramasse-miette) est écrite en Markdown. Comme cette documentation doit pouvoir suivre l’évolution du langage (et donc évoluer avec chaque version de Rust) l’équipe Rust a créé mdBook pour pouvoir générer un livre en PDF à partir de chapitres HTML écrits en Markdown. lien nᵒ 1 : Langage Rustlien nᵒ 2 : La traduction non-officielle de la documentation de Rustlien nᵒ 3 :

Créer un site Web local de documentation pouvant exporter en PDF avec mdBook

La documentation du langage Rust (le langage qui veut remplacer le C et le C++ en sécurisant l’accès mémoire et en supprimant le ramasse-miette) est écrite en Markdown.

Comme cette documentation doit pouvoir suivre l’évolution du langage (et donc évoluer avec chaque version de Rust) l’équipe Rust a créé mdBook pour pouvoir générer un livre en PDF à partir de chapitres HTML écrits en Markdown.

Licence de mdBook

mdBook est un logiciel libre sous licence Mozilla Public Licence v2.0.

Vous pouvez en trouver les sources pour y contribuer sur GitHub (https://github.com/rust-lang/mdBook).

Pour savoir comment contribuer à améliorer mdBook suivez le guide en anglais (https://github.com/rust-lang/mdBook/blob/master/CONTRIBUTING.md).

Installation de mdBook 0.52

Les fichiers sources d’installation sont disponibles sur GitHub pour MacOS, Windows, et Linux.

Vous pouvez aussi installer mdBook, si vous avez installé au préalable le langage Rust sur votre ordinateur en écrivant dans une fenêtre de Terminal la commande :
cargo install mdbook

Comme cela vous pourrez voir en direct comment cargo compile un programme Rust.

Création de votre mdBook

Mettez mdBook dans la variable PATH de votre poste, pour lancer les commandes mdbook depuis n’importe quel endroit.

Pour créer un mdBook, utilisez votre terminal pour lancer la commande mdbook init livre-exemple.
Cette commande créera le répertoire vide « livre-exemple ».
mdBook vous posera alors plusieurs questions pour créer votre premier livre vide.

Allez dans ce nouveau répertoire avec la commande cd livre-exemple (\home\nom_utilisateur\livre-exemple sur un ordinateur GNU/Linux).

Puis lancez le serveur Web local de votre livre avec la commande mdbook serve --open.

Cette commande va lancer le serveur Web local et ouvrir votre navigateur par défaut sur votre mdBook vide.

Fichiers de configuration

book.toml

Ce fichier contient le titre de votre futur livre dans le champ "title".
Il contient aussi un champ « author » à renseigner avec votre nom (ou votre pseudo-littéraire) et un champ « langage » qui par défaut à la valeur « en », mais que vous pouvez évidemment modifier en « fr » avec votre éditeur de texte favori (gedit par exemple sous GNU/Linux).

src/SUMMARY.md

Ce fichier contient la structure de votre futur livre (la liste des chapitres).
Pour créer facilement un chapitre, une préface, une introduction, une annexe… ajoutez des lignes dans ce fichier Markdown.

Par exemple :

    # Summary

    - [00-Introduction](./Introduction.md)
    - [01-Mon premier chapitre](./01-mon-premier-chapitre.md)

Les chapitres seront créés vides dans le répertoire src au fur et à mesure de votre saisie dans le fichier src/SUMMAY.md par le programme mdBook.

Publication de votre mdBook

Une fois vos chapitres créés en Markdown avec votre éditeur de texte, publiez votre mdBook avec la commande :
mdbook build.
Cette commande créera un répertoire \livre-exemple\book. Vous pourrez diffuser ce sous-répertoire « book » sur votre serveur Web en le transférant par FTP.

Astuce : rien ne vous empêche de renommer ce répertoire « book » en fr-livre-exemple-2026 avant de le transférer en FTP sur votre serveur Web.

Les 4 fonctionnalités de votre mdBook

1) La table des matières s’affiche en cliquant sur le menu hamburger en haut à gauche de votre page Web.

2) Vous pouvez changer le thème de votre page Web en cliquant sur le pinceau (par défaut le thème affiché est « Auto »).

3) Vous pouvez chercher un mot dans votre mdBook en cliquant sur la loupe.

4) Vous pouvez imprimer ce livre (au format PDF, ou sur votre imprimante) en cliquant sur l’icône de l’imprimante en haut à droite de votre page Web.

Utilisations possibles de mdBook

Vous pouvez utiliser mdBook pour créer la documentation multilingue de votre logiciel libre (par exemple un mdBook en français et un mdBook en anglais), voire de votre distribution GNU/Linux préférée.

Vous pouvez préciser la licence de votre livre en créant un chapitre licence, et par exemple choisir de publier votre livre en licence Creative Commons, Cecill ou Art Libre.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Saga OpenClaw (ClawdBot, Moltbot) : enjeux techniques, juridiques et éthiques d’un assistant IA open source

Né en novembre 2025, Clawd, un projet open source IA, a été renommé Moltbot sous la pression juridique de Anthropic (Claude), puis OpenClaw rapidement.

Nous passerons en revue dans cet article la chronologie des faits, les enjeux techniques, juridiques et éthiques, dans un monde open source, projet dont la diffusion a explosé pour bien des raisons…

Logo OpenClaw

Sommaire

Chronologie

ClawdBot de novembre 2025 au 27 janvier 2026

Le projet débute en novembre 2025 sous le nom de Clawdbot, lancé par l'ingénieur autrichien Peter Steinberger, développeur autrichien et fondateur de PSPDFKit. Ce prototype de « WhatsApp Relay » connecte l'IA aux applications de messagerie pour automatiser des tâches système. Le succès est immédiat avec 60 000 étoiles GitHub en seulement trois jours. Le nom fait initialement référence à l'outil Claude d'Anthropic. En outre, le nom et le logo évoquent le homard, symbole repris dans l’identité visuelle du projet.

ClawdBot connaît une adoption rapide dès sa publication sur GitHub. Le projet vise explicitement une alternative locale et contrôlée aux assistants IA centralisés.

MoltBot du 27 au 29 janvier 2026

Le 27 janvier 2026, la firme Anthropic demande un changement de nom pour éviter toute confusion avec sa marque « Claude ». Peter Steinberger rebaptise alors le projet Moltbot, évoquant la mue du crustacé. Ce changement intervient dans un contexte de couverture médiatique maximale. La transition est techniquement précipitée, et elle met en lumière les fragilités organisationnelles liées à une croissance trop rapide. On voit apparaître des clones, des faux dépôts et des tentatives d’escroquerie, par exemple le vol de comptes sociaux par des escrocs et le lancement d'un faux jeton de cryptomonnaie nommé $CLAWD.

OpenClaw depuis 30 janvier 2026

Le 30 janvier 2026, le projet adopte son identité définitive : OpenClaw. Une vérification juridique préalable est effectuée. Les domaines et identités associées sont sécurisés. Ce nouveau nom souligne l'ancrage dans le logiciel libre tout en conservant l'hommage au homard d'origine. La transition est cette fois sécurisée par des recherches de marques et le blocage des noms de domaines. Le projet se stabilise et dépasse rapidement les 124 000 étoiles GitHub.

La phase OpenClaw marque une stabilisation. Plusieurs correctifs de sécurité sont publiés. La gouvernance s’ouvre à de nouveaux mainteneurs issus de la communauté.

OpenClaw

Description et définition

OpenClaw est un assistant IA personnel appartenant à la catégorie des agents autonomes. Il est conçu pour être installé et s'exécuter sur la machine de l'utilisateur (auto-hébergé). Contrairement aux chatbots classiques, il peut prendre des décisions et effectuer des actions concrètes sur un système d'exploitation sans supervision humaine constante. Le logiciel agit comme une couche d’orchestration entre modèles IA et services locaux. Il vise un usage personnel ou organisationnel. L’autonomie fonctionnelle est au cœur de sa proposition de valeur.

Le site web décrit OpenClaw de cette manière :

OpenClaw
The AI that actually does things.
Clears your inbox, sends emails, manages your calendar, checks you in for flights.
All from WhatsApp, Telegram, or any chat app you already use.

Installation

L'installation se passe en ligne de commande : téléchargement, puis lancement de la procédure d'installation, choix du LLM, choix du chat, et voilà.

One-liner

# Works everywhere. Installs everything. You're welcome. 🦞
curl -fsSL https://openclaw.ai/install.sh | bash

npm

# Install OpenClaw
npm i -g openclaw
# Meet your lobster
openclaw onboard

Hackable

# For those who read source code for fun
curl -fsSL https://openclaw.ai/install.sh | bash -s -- --install-method git

Fonctionnalités

L'agent exécute des commandes shell, lit et écrit des fichiers locaux, ou gère les courriels et agendas. Il peut piloter un navigateur web pour remplir des formulaires ou effectuer des recherches. Le système dispose d'une mémoire persistante lui permettant de conserver le contexte des conversations à long terme (context window). Il peut également initier des interactions de manière proactive via des notifications.

Architecture

Le logiciel repose sur Node.js et TypeScript. Son architecture est divisée en trois couches : une passerelle locale (Gateway), un agent qui gère le raisonnement (découpage et séquencement), et le moteur d'IA (LLM). Il utilise des protocoles WebSocket pour la communication bidirectionnelle entre ses composants. Les interactions s'effectuent via des applications tierces comme WhatsApp, Telegram, Slack ou Discord. Il connecte des modèles IA à des applications tierces. Le système est extensible via plugins. Plus de cinquante intégrations sont disponibles. L’architecture privilégie la modularité plutôt que l’intégration verticale.

Licence

OpenClaw est distribué sous la licence MIT. Cette licence permissive, reconnue par l’Open Source Initiative et la Free Software Foundation, autorise l'utilisation, la modification et la distribution du code, y compris à des fins commerciales. La seule obligation est d'incorporer la notice de licence et de copyright dans toutes les copies.

Dépendances

Le projet combine des briques libres et propriétaires. Les dépendances libres incluent Node.js, Puppeteer et Ollama pour l'exécution locale (inférence d'IA). En revanche, le fonctionnement optimal nécessite souvent des API propriétaires comme celles d'Anthropic (Claude) ou d'OpenAI (GPT). L'utilisation de ces services externes entraîne des coûts d'abonnement pour l'utilisateur, et l'envoi et éparpillement de données sur des clouds étrangers (pouvant être soumis aux lois extra-territoriales).

Succès communautaire et médiatique

Dynamiques et amplifications

Le projet a bénéficié d'un engouement lié au mouvement du « vibe coding » (développement assisté par IA). Des figures influentes comme Andrej Karpathy ont soutenu publiquement l'initiative.

Les réseaux sociaux et médias amplifient le phénomène. Des contributeurs rejoignent le dépôt en masse. Des usages spectaculaires sont massivement partagés. Une véritable sous-culture est née autour de l'achat de serveurs Mac mini dédiés pour faire tourner l'agent 24h/24. La mascotte du « homard spatial » devient un mème.

Mème inspiré de "Spider-Man Pointing at Spider-Man"

Métriques

La croissance a été l'une des plus rapides de l'histoire de l'open source:

  • Le dépôt GitHub atteint une visibilité exceptionnelle avec plus de 100 000 étoiles GitHub en une semaine.
  • Le projet a attiré plus de 2 millions de visiteurs en sept jours.
  • La communauté a développé plus de 500 extensions ou « skills » partagées sur Clawhub.

Des milliers d’instances sont déployées en quelques semaines. Un réseau social Motlbook dédié aux agents autonomes sans humains est créé, et plus de 2 100 agents y sont recensés en 48 heures.

La popularité précède largement la maturité technique.

courbe des étoiles pour OpenClaw sur github

Aspects juridiques et légaux

Licences

La licence MIT ne pose pas de contrainte juridique majeure. Elle ne protège cependant ni le nom ni l’image du projet. L'utilisateur est responsable de l'installation et des conséquences de l'exécution de l'agent.

Cette licence n’encadre pas l’usage des modèles sous-jacents : bien que le code d'OpenClaw soit libre, les modèles d'IA qu'il appelle restent pour la plupart régis par les conditions d'utilisation strictes de leurs éditeurs respectifs. Cela limite l’indépendance réelle du projet. La licence du code ne garantit pas la liberté de l’ensemble de la chaîne.

Marques

La saga démontre la vigilance des entreprises face à la proximité phonétique des noms de projets. Anthropic a exercé son droit de marque pour protéger l'intégrité de son produit Claude. L’absence d’intention commerciale n’est pas déterminante. Peter Steinberger a dû consulter OpenAI avant le renommage final pour éviter de nouveaux conflits. Ce renommage illustre l’asymétrie entre acteurs : les projets libres restent vulnérables aux marques déposées.

Cadre réglementaire : RGPD et Cloud Act

Paradoxalement, l'auto-hébergement de la chaîne entière favorise la conformité au RGPD et la souveraineté, car les données restent sous le contrôle direct de l'utilisateur (responsable du traitement). Cela permet également d'éviter les risques du CLOUD Act américain en évitant le stockage et la transmission de données sur des serveurs étrangers. Toutefois, l'usage possible des services tiers et clouds publics de l'agent peut classer le système comme « à haut risque » selon l'AI Act européen, les données passant par des clouds soumis aux réglementations extra-territoriales.

Sécurité et vie privée

Stockage et fuite

L'architecture initiale stockait les clés d'API et l'historique des conversations en texte clair sur le disque. Des chercheurs ont identifié des milliers d'instances exposées sur Internet, divulguant des données sensibles. La concentration d'informations locales crée un point de défaillance unique (SPOF) en cas de compromission de la machine.

Authentification

Les premières versions ne requéraient pas d'authentification forte par défaut. Des interfaces d'administration étaient accessibles publiquement à cause de proxies/pare-feux mal configurés. Des correctifs récents ont supprimé les modes de connexion sans authentification pour durcir le système.
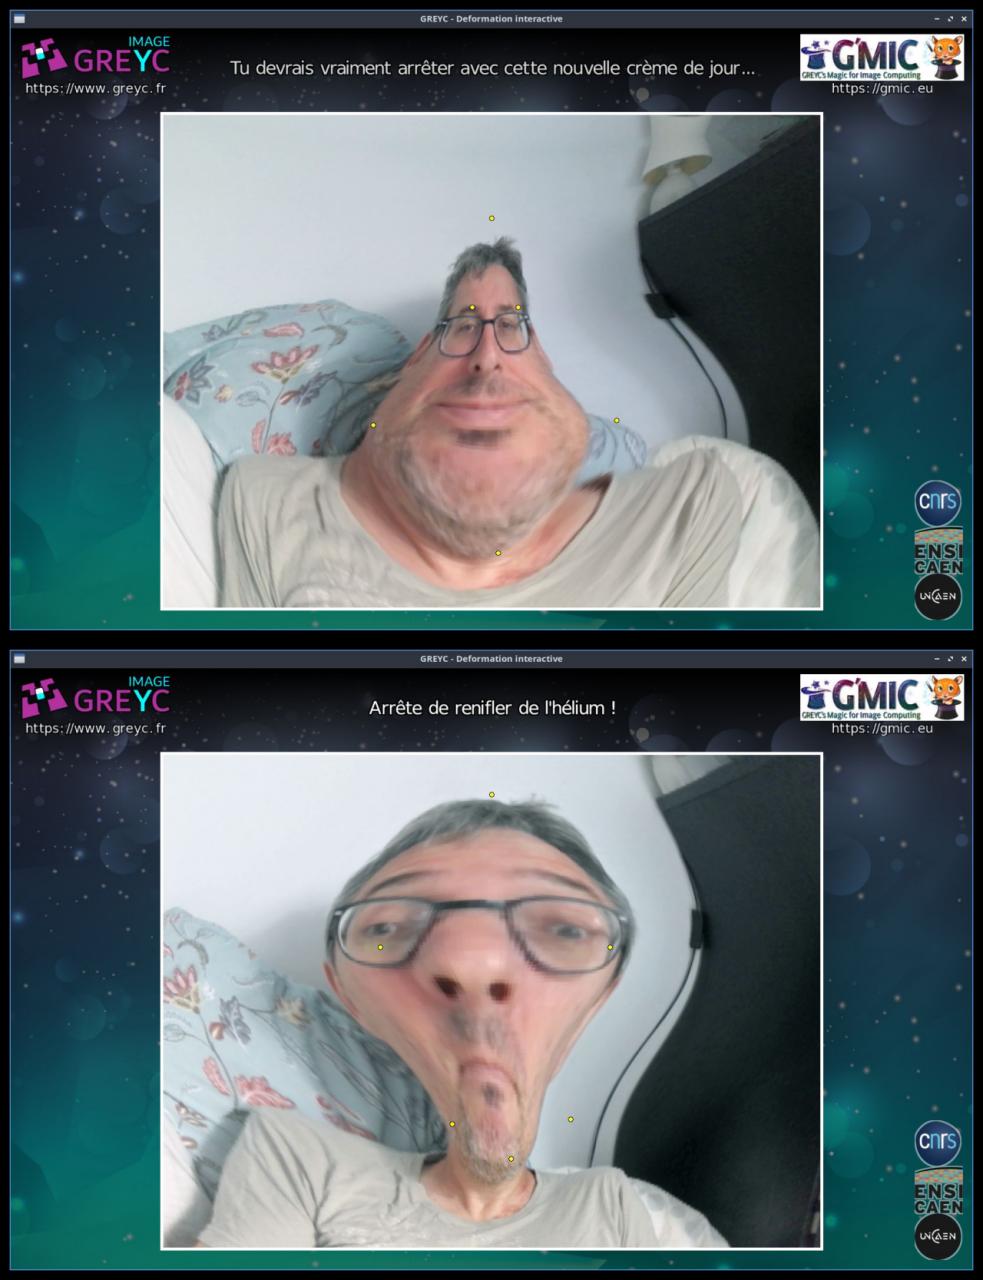
Injection de prompts

L'injection de prompts est la menace la plus critique et reste un problème non résolu dans l'industrie. Un attaquant peut insérer des instructions malveillantes dans un courriel ou un site web consulté par l'agent. L'IA peut alors exécuter des ordres indésirables, comme l'exfiltration de fichiers, en croyant obéir à son propriétaire.

Contrôle et privilèges

OpenClaw agit comme un super-utilisateur virtuel avec des accès profonds au système : l’agent dispose de privilèges élevés, il peut exécuter des commandes système, et il agit parfois avec des droits excessifs. Il combine l'accès aux données privées, l'exposition à des contenus non vérifiés et la capacité de communication externe. La séparation des privilèges est insuffisante par défaut, l’isolation reste complexe, et le risque augmente avec l’autonomie. Ce mélange de privilèges et autonomie transforme l'assistant en un vecteur d'attaque puissant s'il est détourné.

Durcissement et mitigation

Des correctifs ont été publiés après coup, nombre de commits concernent la sécurité, et la documentation actuelle reconnaît l’absence de configuration parfaite. La communauté recommande donc l'utilisation de conteneurs Docker pour isoler les sessions de l'agent. L'accès à distance doit être sécurisé par des tunnels comme Tailscale ou VPN. L'usage des droits « root » est désormais désactivé par défaut et nécessite une activation explicite (principe du moindre privilège).

Ces pratiques restent encore peu suivies, car difficiles à appliquer pour des non-experts, dans un contexte de déploiement rapide. La sécurité et la vie privée dépendent fortement du niveau technique de l’utilisateur, ne sont pas encore des acquis structurels.

Impact et enjeux de l'IA

Court terme

OpenClaw accélère la productivité en éliminant les tâches de manipulation de données entre applications, en automatisant et en autonomisant les processus via IA et agents. Cependant, il introduit un risque d'IA fantôme (Shadow AI) dans les entreprises où les employés déploient l'outil sans supervision de la direction informatique, ou d'alignement à une charte. La vitesse de diffusion a largement dépassé la maturité des mesures de sécurité initiales.

OpenClaw démocratise les agents autonomes : il rend accessibles rapidement et facilement des capacités jusque-là expérimentales, et il remet en cause d'une certaine manière le monopole des plateformes centralisées. Il expose aussi des utilisateurs non avertis à des risques élevés, la diffusion foudroyante dépasse la capacité de montée de connaissances. Le projet agit comme un révélateur.

Moyen terme

On peut amplement anticiper que le succès rapide du projet pourrait influencer la régulation et une standardisation des protocoles avancés d'agents, pour rendre ces assistants interchangeables. Le cadre réglementaire européen (voire mondial ?) obligera probablement à des certifications de sécurité plus strictes. Les grandes entreprises et organisations gouvernementales pourraient publier des versions sécurisées et certifiées du logiciel pour leurs besoins internes.

Ces nouveaux agents autonomes posent des questions inédites et à grande échelle. La sécurité pourrait devenir une obligation normative. Des outils d’audit spécialisés émergent, les pratiques de durcissement se structurent, OpenClaw sert de cas d’école.

Long terme

L'IA agentique pourrait redéfinir la souveraineté numérique en permettant à chacun de posséder son propre assistant local. Les agents autonomes pourraient devenir les principaux utilisateurs des systèmes numériques, rendant obsolètes certaines tâches manuelles de gestion. Cela transforme l’organisation du travail. L'enjeu éthique et social majeur sera l'imputabilité légale en cas de préjudice causé par une décision autonome de l'IA. La dépendance technologique augmente. La gouvernance devient centrale.

Prisme du logiciel et IA libre et open source

Ouverture

Le code source d'OpenClaw est totalement ouvert et auditable, respectant les critères du logiciel libre. Toutefois, l'ouverture est limitée par la dépendance aux modèles propriétaires dont les poids, les données et processus d'entraînement restent secrets et privateurs. Par exemple, le code ne contient à ce jour pas de télémétrie cachée. L’ouverture favorise l’innovation rapide par l'intelligence collective et l’appropriation communautaire, tout en facilitant bien évidemment les usages détournés.

Gouvernance

Le projet est passé d'une initiative solitaire à une gouvernance plus structurée intégrant plusieurs mainteneurs communautaires. Cette gestion collective ouverte renforce la résilience et l'anti-fragilité mais complexifie la coordination technique et sécuritaire. Les décisions critiques sont désormais partagées, et la sécurité est un enjeu majeur : la maturité dépendra de cette gouvernance.

Éthique

L'autonomie de l'IA pose des questions de responsabilité et met en évidence le risque d'erreurs invisibles ou noyées sans supervision humaine en temps réel et prise de décision sans humain. La frontière entre outil et acteur s’estompe. La transparence opérationnelle et l'auditabilité sont essentielles pour prévenir les usages malveillants tout en protégeant les données personnelles. L’éthique ne peut être entièrement déléguée aux modèles, elle dépend des choix d’architecture des développeurs et également dépend aussi des usages des utilisateurs.

Par conséquent, le fantasme d’une IA omniprésente inquiète et interroge sur la dépendance technologique. À long terme, on peut légitimement craindre que cette automatisation et autonomisation de tâches et processus à la complexité croissante prenne de l’ampleur. Ainsi la probabilité s’accroît de voir la remise en cause non seulement l'existence même de certains métiers, mais plus généralement de voir une dépendance de masse.

Souveraineté

L'auto-hébergement complet permet aux utilisateurs de rester maîtres de leur infrastructure et de leurs données. Cela réduit la dépendance envers les géants technologiques et évite le verrouillage propriétaire. Cela est à mettre en perspective avec l'utilisation des clouds publics et services centralisés, par exemple les modèles d'IA et messageries instantanées propriétaires et étrangers.

Intelligence collective

La force du projet réside dans son écosystème de compétences développées par des contributeurs du monde entier. Cette collaboration expérimentale et novatrice permet d'enrichir l'agent et l'écosystème. Nombre de failles ont pu être identifiées publiquement.

Au-delà du code

Une véritable IA open source devrait inclure les poids du modèle, les données d'entraînement et les processus d'apprentissage et de raffinement. OpenClaw est une infrastructure libre, mais n'est pas une « IA open source » au sens strict, en particulier lorsqu'il utilise des modèles fermés et opaques. Cette asymétrie limite l’auditabilité globale réelle. Elle interroge la notion d’IA libre et/ou open source

Résilience et anti-fragilité

Malgré son jeune âge, OpenClaw a déjà survécu à une crise majeure, et le projet s’étant restructuré, la communauté ayant absorbé le choc. Cette résilience dépendra de la capacité à réagir aux risques majeurs et à grande échelle, la sécurité devant précéder le succès. Le logiciel libre n’immunise pas contre les risques. L'architecture ouverte permet par exemple de basculer immédiatement vers d'autres modèles en cas de changement de politique d'un fournisseur d'API. Si le créateur abandonne le projet, la communauté peut forker le code pour assurer la pérennité de l'outil.

La saga OpenClaw renforce le débat sur la nécessité de surveiller et contrôler ces agents et de mettre garde-fous à tous niveaux.

Liens

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Lancement de la Journée d'Indépendance Numérique (DI-DAY) suite au 39c3
    Beaucoup de nos services numériques du quotidien sont propulsés en partie voire entièrement par les GAFAM. Les risques de cette dépendance s'illustrent de plus en plus fréquemment dans l'actualité : représailles envers l'ex-Commissaire européen Thierry Breton et des ONG luttant contre la désinformation en ligne, clôture de la boite de courriel du procureur de la Cour Pénale Internationale, … Ces vulnérabilités mettent en danger le fonctionnement des démocraties européennes. On peut être tenté

Lancement de la Journée d'Indépendance Numérique (DI-DAY) suite au 39c3

Beaucoup de nos services numériques du quotidien sont propulsés en partie voire entièrement par les GAFAM. Les risques de cette dépendance s'illustrent de plus en plus fréquemment dans l'actualité : représailles envers l'ex-Commissaire européen Thierry Breton et des ONG luttant contre la désinformation en ligne, clôture de la boite de courriel du procureur de la Cour Pénale Internationale, …

Ces vulnérabilités mettent en danger le fonctionnement des démocraties européennes.

On peut être tenté d'attendre une nouvelle législation européenne, cependant le carburant de ces plateformes est en premier lieu nos données personnelles : quitter ces plateformes réduit à la fois notre exposition personnelle et notre contribution collective à ce système néfaste.

C'est le sens de l'appel lancé à Hambourg lors du 39ème CCC : le 4 janvier (puis chaque 1er dimanche du mois), faites migrer vos connaissances d'une des plateformes et faites le savoir en utilisant les mots clés #DiDay ou #iDidIt sur le Fediverse.

Cet appel est soutenu notamment par Wikimedia, Nextcloud et Mastodon, et l'information a été relayée par la 1ère chaîne de TV allemande. Espérons que des acteurs de l'espace francophone s'y joignent rapidement !

Linux est bien sûr une des alternatives, dont la progression est en bonne voie « grâce » à Microsoft (mouvement qui s'inscrit parfaitement dans les initiatives existantes Adieu Windows ou End Of 10). Mais l'initiative concernent tous les services dépendants de ces plateformes toxiques : messageries instantanées, stockage en ligne, librairies en lignes, … dont la gratuité ou les prix au rabais reposent sur l'exploitation de nos données personnelles.

Le succès dépend donc de vous qui lisez cet article, et des relais « physiques » qui pourront accompagner ces migrations : cafés réparation, GULLs, librairies physiques, bibliothèques, … mois après mois !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • LOTemplate nouvelle version 2.2
    LOTemplate est un générateur de documents sous licence AGPL v3 qui permet de générer des documents (ODT, DOCX, ODS, XLSX, PDF, …) à partir d'un document modèle avec des variables et d'un fichier json pour les données. Comment faire faire à LibreOffice (headless, sans interface graphique) ce que l’on ne peut pas faire avec LibreOffice (GUI, avec interface graphique) ? Et comme c’est Noël nous avons ajouté un meilleur système de log en cadeau. Dans la version 2.2 de LOTemplate, nous avons ajou

LOTemplate nouvelle version 2.2

LOTemplate est un générateur de documents sous licence AGPL v3 qui permet de générer des documents (ODT, DOCX, ODS, XLSX, PDF, …) à partir d'un document modèle avec des variables et d'un fichier json pour les données.
Logo LOTemplate

Comment faire faire à LibreOffice (headless, sans interface graphique) ce que l’on ne peut pas faire avec LibreOffice (GUI, avec interface graphique) ?

Et comme c’est Noël nous avons ajouté un meilleur système de log en cadeau.

Dans la version 2.2 de LOTemplate, nous avons ajouté la possibilité d’exporter des PDF en y ajoutant un filigrane de son choix avec comme paramètres :

  • Texte de filigrane
  • Couleur de filigrane
  • Police
  • Taille de police
  • Le nombre de répétition sur la page

Pour cela, nous utilisons l’API uno de LibreOffice, qui expose plus de paramètres que l’interface graphique de LibreOffice. En effet, si l’on cherche a faire cela dans l’interface graphique de LibreOffice, on ne peut choisir que le texte. Le filigrane apparaît ensuite en vert et à la verticale.

Options PDF

Exemple d’un export moche

Mais en cherchant dans l’aide de LibreOffice, on trouve sur la page d’aide de l’outil d’export PDF en ligne de commande qu’il existe les options suivantes :

  • Watermark
  • WatermarkColor
  • WatermarkFontHeight
  • WatermarkRotateAngle
  • WatermarkFontName
  • TiledWatermark

C’est donc possible, LibreOffice peut le faire mais uniquement avec l’API uno. Pour faire court, rien ne l’indique dans la doc de l’API uno. Toutefois on retrouve cette page (EN) en date de décembre 2022 qui explique l’amélioration qui permet cela.

En suivant un des liens de la page on arrive à cette page (EN).

Et là on peut lire : Fix the problem by only adding the option at an UNO API level for now, this relaxes the hardcoded color without cluttering the UI.

Super, c’est possible !

Ce ne sont que des propriétés de l’export PDF. La solution a donc été simple à implémenter, avec un peu de recherche.

En résumé, savoir chercher sur internet et lire la doc reste encore utile !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • AlternC : La 3.5.x continue à être stable
    AlternC est un projet collaboratif dont l’élément de base constitue un logiciel libre de gestion d’hébergements mutualisés pour Debian. Ce projet (sous GPLv2+) se veut facile à installer et à utiliser, s’appuyant uniquement sur des logiciels libres. Il contient un système d’installation et de configuration automatique, ainsi qu’un panneau de contrôle accessible par le web, pour la gestion des utilisateurs et des services orientés web. Le projet s’adresse à un public faisant de l’administratio

AlternC : La 3.5.x continue à être stable

AlternC est un projet collaboratif dont l’élément de base constitue un logiciel libre de gestion d’hébergements mutualisés pour Debian.

Ce projet (sous GPLv2+) se veut facile à installer et à utiliser, s’appuyant uniquement sur des logiciels libres.
Il contient un système d’installation et de configuration automatique, ainsi qu’un panneau de contrôle accessible par le web, pour la gestion des utilisateurs et des services orientés web.
Le projet s’adresse à un public faisant de l’administration système et souhaitant déléguer les actions de base d’un hébergement web.

On peut le comparer à des solutions telles que ISPconfig, cPanel, Plesk, Froxlor…

Après de nombreuses années la version 3.5 est arrivée début 2025 et se prépare à la suite, on se propose de rattraper ce temps perdu.

Sommaire

Qui est derrière AlternC ?

Le projet est porté par différentes structures tant associatives que professionnelles. Nous n’établissons aucune statistique, toutefois, portée à notre connaissance, on peut citer dans un désordre alphabétique :

  • domainpublic avec environ 500 comptes également ;
  • globenet ;
  • infini  ;
  • koumbit qui représente environ 500 comptes pour 2000 domaines et est contributeur historique ;
  • lautre.net compte un peu moins de 1000 adhérents et plus ou moins autant de comptes AlternC ;
  • marsnet avec un peu moins de 200 comptes pour 500 domaines et plus de 200 listes de diffusion ;
  • neuronexion ;
  • octopuce avec environ 80 instances déployées, contributrice historique, héberge une partie de l’infrastructure du projet ;
  • ouvaton avec environ 6000 (sous-)domaines actifs ;
  • webelys contributeur et animateur de la communauté.

Enfin une version 3.5

Un peu de contexte historique

Entre 2018 et fin 2024, la communauté a eu du mal à s’organiser pour fusionner et proposer une cohérence de développement. Durant cette période, il était alors recommandé d’utiliser une version maintenue avec grande détermination par koumbit.

De nombreux correctifs ont été proposés dans leur bifurcation amicale. C’était de fait la version la plus avancée et active de ces dernières années. On peut noter également que d’autres membres de la communauté disposaient de branches locales. Par exemple, Octopuce maintenait une version 3.3 avec un portage partiel pour fonctionner sur les anciennes versions de Debian.

Sans être exhaustif dans tous les développements épars, on peut dire qu’on s’était tous un peu dispersé. Il était difficile de répondre à des besoins opérationnels immédiats et de prendre le recul nécessaire pour une intégration communautaire saine.

On était arrivé à une situation de déperdition de temps, d’énergie, d’envie conséquente.

L’objectif de cette version

Au fil des années, l’objectif principal de la 3.5 a fortement évolué. De l’apport initial d’innovations diverses nous nous sommes recentrés sur l’essentiel. C’est-à-dire :

  • fournir une version unifiée et rationnelle de toutes les variantes connues ;
  • gérer les versions stables (du moins plus récentes) de Debian.

L’histoire récente de la 3.5

La communauté AlternC, pour diverses raisons, a fortement tardé pour absorber tout ce retard. Au cours de ces douze derniers mois, on notera les évolutions suivantes :

  • Une 3.5~RC2 absorbant le retard avec les apports de koumbit ;
  • Une 3.5~RC3 absorbant le retard avec Debian et fournissant la compatibilité avec Bookworm ;
  • Une 3.5.0 proposant une version stabilisée compatible de buster à bookworm ;
  • Une 3.5.1 proposant un correctif lors de la mise à jour et une compatibilité avec des changements avec roundcube ;
  • Une 3.5.2 proposant d’autres correctifs mineurs, plus une gestion de SFTP, réparation de la compatibilité du module awstats, maintenir les configurations DKIM/SPF ;
  • Une 3.5.3 proposant des correctifs mineurs, une meilleure gestion des bases de données, la réparation des configurations DNS manuelles, une meilleure prise en charge des versions PHP.

Il est prévu d’autres versions mineures pour prendre en compte les erreurs restantes.

Toutes ces versions ont été diffusées sur le dépôt officiel AlternC ou bien directement sur le dépôt github

Les changements depuis la 3.3

Des nouveautés diverses et variées

Sans faire une liste à la Prévert, notons les points suivants :

  • La gestion de Debian Buster à Bookworm ;
  • La gestion de PHP de 5.6 à 8.x ;
  • L’amélioration de la gestion des mails avec une meilleure prise en charge de DKIM, SPF et DMARC ;
  • La gestion de l'autodiscover et autoconfig pour les logiciels de messagerie ;
  • La gestion de SFTP en plus de FTP(S) ;
  • La capacité de gérer des domaines DNSSEC ;
  • Un nouveau thème plus moderne et personnalisable ;
  • La définition de politique de validation de mot de passe.

De nombreux correctifs

Les nouveautés ne sont pas le cœur de cette version, on a principalement travaillé sur la stabilisation et la mise en place de correctifs divers et variés commme :

  • le report des correctifs pour roundcube pour buster et sa gestion jusqu’à bookworm ;
  • l’intégration de phpmyadmin jusqu’à bookorm ;
  • des protections CSRF dans les nombreux formulaires ;
  • des ajustements dans les scripts de type cron et alternc.install ;
  • la prise en charge des fonctionnalités d’apache 2.4 ;
  • la prise en charge conditionnel du mode SSL pour apache (permettant des frontaux comme nginx, haproxy…) ;
  • des empreintes de mot de passe plus solide — pour entre autres — dovecot ;
  • des correctifs pour s’aligner sur les évolutiosn de mariadb (longueur des tables, nommages…) ;
  • simplification du javascript pour le panel ;
  • support progresif de systemd ;
  • la bascule progressive du système de traduction vers weblate.

Un écosystème

AlternC ne se résume pas à un projet avec une structure monolithique. Il s’agit d’un écosystème avec nombre de plugins.

 Des plugins

La version 3.5 apporte de nouveaux plugins, pour faciliter leur évolution. Certaines fonctionnalités ont été extraites ou adaptées en ce sens :

  • ACME qui extrait la génération des certificats SSL avec Let's encrypt et le protocole ACME
  • nginx-ssl une seconde approche pour gérer les certificats SSL et offrant un frontal nginx pour gérer https
  • mailman un gros travail de fond a été réalisé pour permettre le passage de maiman2 à mailman3 tout en assurant une retro compatibilité correcte.

 Un générateur de paquet Debian

AlternC est maintenant fourni avec un générateur automatique de paquets Debian.

Ainsi on facilite l’arrivée de nouvelle proposition sous forme de plugin. Il est n’est pas nécessaire d’intervenir sur l’intégralité du projet AlternC et on peut se concentrer sur une fonctionnalité donnée.

Dès l’intégration du depot dans l’organisation AlternC, le plugin sera automatiquement pris en compte et ses paquets Debian prêts à l’emploi via :

  • les releases github
  • le dépôt officiel du projet
  • la mise à disposition des paquets expérimentaux ou dits nightly

Tout un ensemble de plugins

Au-delà d’AlternC en soi et des plugins listés avant, on peut trouver à différents niveaux de maturité :

On peut trouver l’ensemble des plugins AlternC depuis son dépôt : https://github.com/AlternC/

D’autres outils sont mis à disposition également sur la forge communautaire du projet

Comment installer ou mettre à jour ?

Si vous avez déjà un AlternC 3.3.x et que vous voulez migrer vers la 3.5.x, faites une sauvegarde complète et suivez la documentation fournie sur notre aide en ligne

Il est important de prendre en compte les informations suivantes :

  • La version 3.3 n’est plus officiellement supportée et cesse de fonctionner au-delà de Buster ;
  • La version 3.5.x supporte Buster et Bookworm ;
  • Le support de Bullseye (Debian 11) n’est pas fourni, cela peut fonctionner uniquement le temps de la mise à jour système.

Participer

Ensuite ?

Le cycle de la 3.6 n’est pas encore planifié. Parmi les idées en reflexion nous avons :

  • réduire le support à deux versions stables de Debian (bookworm/trixie)
  • l’amélioration de la qualité du code de base (bash et php) à l’aide de diverses CI/CD
  • la finalisation du système de traduction pour le core et les plugins via weblate

Le code

L’ensemble du code du projet est actuellement hébergé chez github.
Toute personne est la bienvenue. Vous pouvez proposer un nouveau projet de code, remonter des bogues, suggérer des améliorations, traduire, communiquer…

Nous profitons également de cette nouvelle version pour utiliser le nommage “main” pour la branche principale. C’est plus en adéquation avec notre code de conduite informel et donne également une cohérence sur l’ensemble des projets.

Les traductions

Toutes personne souhaitant traduire dans sa langue est la bienvenue. Vous pouvez participer via le service weblate. Nous gérons actuellement principalement trois langues : le français, l’anglais et l’allemand. Nous avons d’autres langues disponibles pour lesquelles un peu d’amour est nécessaire.

Des services à disposition de la communauté

En complément, le projet AlternC met à disposition divers services à la communauté. Le principal est le service de DNS secondaires disponible sur le site dédié https://www.alternc.net/
Ce service permet de synchroniser ses zones sur deux DNS secondaires depuis ses instances AlternC.

Un autre service est disponible en mettant à disposition des serveurs virtuels jetables pour tester des développements sur différentes distributions Debian (de Jessie à Trixie).

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Nouvelles sur l’IA de septembre 2025
    L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ». Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zv

Nouvelles sur l’IA de septembre 2025

L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ».

Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zvi si je l’ai mal compris !), sauf pour les citations : dans ce cas-là, je me repose sur Claude pour le travail de traduction. Sur les citations, je vous conseille de lire l’anglais si vous pouvez : difficile de traduire correctement du jargon semi-technique. Claude s’en sort mieux que moi (pas très compliqué), mais pas toujours très bien.

Même politique éditoriale que Zvi : je n’essaierai pas d’être neutre et non-orienté dans la façon de tourner mes remarques et observations, mais j’essaie de l’être dans ce que je décide de sélectionner ou non.

Sommaire

Résumé des épisodes précédents

Petit glossaire de termes introduits précédemment (en lien : quand ça a été introduit, que vous puissiez faire une recherche dans le contenu pour un contexte plus complet) :

  • System Card : une présentation des capacités du modèle, centrée sur les problématiques de sécurité (en biotechnologie, sécurité informatique, désinformation…).
  • Jailbreak : un contournement des sécurités mises en place par le créateur d’un modèle. Vous le connaissez sûrement sous la forme "ignore les instructions précédentes et…".

Anthropic public Claude Sonnet 4.5

L’annonce officielle :

Claude Sonnet 4.5 is the best coding model in the world. It's the strongest model for building complex agents. It’s the best model at using computers. And it shows substantial gains in reasoning and math.

Code is everywhere. It runs every application, spreadsheet, and software tool you use. Being able to use those tools and reason through hard problems is how modern work gets done.

Claude Sonnet 4.5 makes this possible. We're releasing it along with a set of major upgrades to our products. In Claude Code, we've added checkpoints—one of our most requested features—that save your progress and allow you to roll back instantly to a previous state. We've refreshed the terminal interface and shipped a native VS Code extension. We've added a new context editing feature and memory tool to the Claude API that lets agents run even longer and handle even greater complexity. In the Claude apps, we've brought code execution and file creation (spreadsheets, slides, and documents) directly into the conversation. And we've made the Claude for Chrome extension available to Max users who joined the waitlist last month.

Traduction :

Claude Sonnet 4.5 est le meilleur modèle de codage au monde. C'est le modèle le plus performant pour créer des agents complexes. C'est le meilleur modèle pour utiliser des ordinateurs. Et il affiche des gains substantiels en raisonnement et en mathématiques.

Le code est partout. Il fait fonctionner chaque application, tableur et outil logiciel que vous utilisez. Être capable d'utiliser ces outils et de raisonner à travers des problèmes difficiles, c'est ainsi que le travail moderne s'accomplit.

Claude Sonnet 4.5 rend cela possible. Nous le publions avec un ensemble de mises à niveau majeures de nos produits. Dans Claude Code, nous avons ajouté les points de contrôle—l'une de nos fonctionnalités les plus demandées—qui sauvegardent votre progression et vous permettent de revenir instantanément à un état précédent. Nous avons actualisé l'interface du terminal et lancé une extension native VS Code. Nous avons ajouté une nouvelle fonctionnalité d'édition de contexte et un outil de mémoire à l'API Claude qui permet aux agents de fonctionner encore plus longtemps et de gérer une complexité encore plus grande. Dans les applications Claude, nous avons intégré l'exécution de code et la création de fichiers (tableurs, présentations et documents) directement dans la conversation. Et nous avons rendu l'extension Claude pour Chrome disponible aux utilisateurs Max qui se sont inscrits sur la liste d'attente le mois dernier.

Le message est assez clair : Anthropic met les bouchées doubles sur l’apprentissage par renforcement pour l’utilisation de Claude en tant qu’assistant de code. Sur les benchmarks fournis par Anthropic, ce nouveau modèle prend la première place. Les premiers benchmarks indépendants et divers retours subjectifs semblent possiblement confirmer cette prétention au podium — au coude à coude avec GPT-5. Les améliorations hors de ce cas d’usage semblent bien plus modestes.

L’annonce habituelle d’un jailbreak a rapidement suivi.

Au niveau de la sécurité des modèles, Anthropic a décidé d’appliquer pour la première fois son niveau de sécurité 3 (ASL-3) à la ligne Sonnet (c’était déjà le cas pour Opus). Cela signifie que vos conversations — y compris par l’API — passent par un modèle supplémentaire classifiant la sensibilité du sujet, bloquant certains sujets sensibles (principalement CBRN).

La System Card nous révèle certaines observations intéressantes : ce nouveau modèle a fait un bond (pas vraiment désiré) dans sa capacité à détecter qu’il est dans le contexte d’une évaluation plutôt que dans un contexte réel, ce qui complexifie évidemment les évaluations dans ce domaine. Anthropic est toutefois assez confiant que cela n’influe pas significativement les résultats, en notant que Sonnet ne se comporte pas d’une manière significativement différente dans les cas où il détecte l’évaluation des cas où il ne le détecte pas. Comme à l’accoutumée pour Anthropic, l’évaluation sur le sujet de la sécurité des modèles s’est faite conjointement avec deux organismes externes, Apollo Research et UK AISI.

Sonnet 4.5 est une amélioration sur à peu près tous les axes mesurés, permettant à Anthropic de lui mettre l’étiquette « le modèle le plus aligné », au coude à coude avec GPT-5. À noter que ça ne signifie pas un usage en toute sécurité : sur par exemple l’injection de prompt dans le cadre d’un agent, avec 10 essais un attaquant a toujours un taux de succès de 40%.

En vrac

CloudFlare introduit Web Bot Auth et Signed Agent. Le premier permet à un bot de s’identifier lui-même à l’aide d’une signature cryptographique, ce qui permet de vérifier que son comportement est conforme aux termes d’utilisation (par exemple, le respect de robots.txt) et de l’exclure en cas de violation de ces termes. Le second a pour but d’associer un bot à un utilisateur réel. L’objectif à terme est de fournir un cadre pour permettre à l’IA d’interagir avec le web pour le compte de l’utilisateur.

Le premier ministre de l’Albanie nomme une IA, Diella, comme ministre des marchés publics, dans un contexte de lutte contre la corruption.

OpenAI publie GPT-5-codex, une variante de GPT-5 spécialisée sur les tâches de programmation.

Des économistes forment un groupe de travail sur le sujet de l’impact d’une future hypothétique IA « transformative » (qui a la capacité d’automatiser la plupart des emplois réalisables par des humains) et publie plusieurs papiers sur la question.

OpenAI annonce une mise à jour de ses politiques de confidentialité appliquées à ChatGPT. En particulier, les conversations utilisateurs sont maintenant scannées automatiquement, et les plus problématiques passées à des humains pour décider des actions à prendre, allant de la fermeture des comptes à prévenir les autorités.

En mai, nous avions rapporté que OpenAI annonçait abandonner sa tentative de casse du siècle. Comme certains le pensaient, ce n’était que partie remise ; une lettre ouverte demande plus de transparence sur le processus de restructuration de l’opération récemment réaffirmé par OpenAI.

Math Inc présente Gauss, un agent pour la formalisation de preuves mathématiques. Son premier succès est d’avoir formalisé en Lean le Théorème des nombres premiers, en complétant le projet non-terminé de Alex Korontorovich et Terence Tao. Sur le même sujet, un papier évalue la capacité de GPT-5 à prouver des conjectures simples (prouvable par un étudiant en université en moins d’une journée) mais non prouvées (car formulées extrêmement récemment). GPT-5 arrive à prouver 3 sur les 5 testées.

Les IA de OpenAI et DeepMind obtiennent une médaille d’or à l’International Collegiate Programming Contest, y compris un problème qu’aucune équipe humaine n’a su résoudre dans le temps imparti.

Un groupe d’experts, de politiques et autres figures publiques appelle à la mise en place de « lignes rouges » à ne pas franchir sur le développement de l’IA, et de réels mécanismes de régulation pour les imposer.

Publication de If Anyone Builds It, Everyone Dies, par Eliezer Yudkowsky et Nates Soares, présentant la thèse que créer une super-intelligence artificielle, dans les conditions et l’état actuel des connaissances, causerait de manière quasi-certaine l’extinction de l’espèce humaine. Ils suggèrent l’adoption de traités internationaux limitant le développement de l’IA.

OpenAI et Apollo Research publient un papier sur le sujet des tendances de l’IA à « tricher » dans divers environnements (contourner les critères d’évaluation par exemple). Ils montrent qu’il est possible d’éliciter un certain nombre de comportements indésirables dans GPT-5 (comme par exemple "sandbagging" : volontairement échouer certaines évaluations pour ne pas paraître « trop dangereux »). Les chercheurs pointent le fait que la solution naïve, entraîner l’IA à ne pas reproduire ces comportements, pose immédiatement la question de « l’IA a-t-elle appris à ne pas le faire, ou a appris à le faire sans être détectée ? » — et évaluent à la place la récente méthode d’alignement de OpenAI, Deliberative alignment, reportant une baisse significative des comportements indésirables. Il est à noter également que les modèles actuels montrent déjà dans leurs chaînes de pensée une certaine capacité à détecter qu’ils sont dans un cadre de test/d’évaluation, et que o3 a déjà développé des méthodes (grossières) pour échapper à la détection.

Un papier explore la raison pour laquelle les modèles de langage ne sont pas déterministes en pratique, et propose une solution pour les situations où le déterminisme est important.

Un papier d’OpenAI propose une explication sur la raison de la persistance des hallucinations : principalement parce que la phase d’apprentissage par renforcement ne récompense pas la réponse « je ne sais pas » quand le modèle ne sait pas.

Un autre papier approche expérimentalement la question « les modèles de langage raisonnent ou ne font-ils que mémoriser et régurgiter ? ». La méthodologie est de créer une entité fictive (« Kevin est né en 1998 à Paris… ») de toute pièce qui ne peut pas être présent dans l’ensemble d’entraînement, d’entraîner un modèle existant dessus, puis de poser une question indirecte (qui peut être déduite, mais pas explicitement donnée) sur cette entité (« Quelle est la langue maternelle de Kevin ? »). Le résultat est équivoque : les modèles arrivent à faire cette déduction quand une des deux entités est réelle (dans notre exemple, Paris), mais pas quand les deux sont fictives (Kevin est né dans (Ville française inventée de toute pièce)).

Une équipe de biologistes utilise une IA pour créer des bactériophages (un virus ciblant certaines bactéries), avec succès.

Sur l’utilisation de l’IA dans l’économie réelle, Anthropic met à jour son Economic Index, et OpenAI publie leur équivalent.

Nouveau benchmark, faire jouer les modèles à Loups-garous. Le score final était assez prévisible (GPT 5 prend la première place), mais l’analyse en profondeur des parties est intéressante. Principe similaire avec Among AIs (l’IA jouant à Among Us). Également dans le domaine des benchmark, publication de SWE-Bench Pro, tâches de programmation réelles et complexes, non-présentes dans les données d’entraînement. VCBench, quant à lui, tente d’évaluer l’IA sur la tâche d’investissement dans le capital-risque — et trouve que l’IA surpasse la plupart des investisseurs humains sur leurs évaluations (avec l’énorme problème toutefois que l’IA évalue rétrospectivement en 2025 des décisions prises en 2015-2020, tandis que les humains évaluaient prospectivement en 2015-2020 des décisions de 2015-2020).

Anthropic publie un guide sur l’écriture d’outils à destination de l’IA.

En parlant d’outils, une piqûre de rappel sur le fait que la sécurité d’un système utilisant une IA lisant des données d’une source externe est toujours un problème ouvert : démonstration qu’il est possible d’exfiltrer des données sensibles à l’aide de ChatGPT, en envoyant un mail à la victime et en attendant que ladite victime connecte ChatGPT à son compte mail.

Reverse-engineering du système de mémoires de Claude et ChatGPT.

Anthropic publie un rapport technique intéressant sur trois incidents ayant conduit à une dégradation de performances de Claude, ayant eu lieu en août.

Grèves de la faim devant les locaux de Anthropic et DeepMind demandant l’arrêt de la course à l’IA.

Humoristique : Si l’on jugeait les humains comme on juge l’IA…

Pour aller plus loin

Par Zvi Mowshowitz

Sur LinuxFR

Dépêches

Journaux

Liens

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 38 de l’année 2025
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [RTBF] Journée mondiale du logiciel libre: quelles sont les alternatives open sources à la suite Adobe? [Républik IT] TOSIT: restaurer la maîtrise du SI grâce aux logiciels libres [Journal du Net] "VLC est le logiciel f

Revue de presse de l’April pour la semaine 38 de l’année 2025

Par : echarp
23 septembre 2025 à 09:50

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[RTBF] Journée mondiale du logiciel libre: quelles sont les alternatives open sources à la suite Adobe?

✍ Anthony Mirelli, le samedi 20 septembre 2025.

C’est la Journée mondiale du logiciel libre. L’occasion de découvrir des alternatives gratuites à trois mastodontes développés par Adobe : Photoshop, Premiere et Audition.

[Républik IT] TOSIT: restaurer la maîtrise du SI grâce aux logiciels libres

✍ Bertrand Lemaire, le vendredi 19 septembre 2025.

TOSIT (The Open-Source I Trust) est une association de très grands comptes français créée pour organiser le développement de logiciels libres.

[Journal du Net] "VLC est le logiciel français le plus utilisé au monde"

✍ Adrien Tsagliotis, le jeudi 18 septembre 2025.

Né dans une école d’ingénieurs française, le logiciel gratuit et libre VLC est devenu un incontournable du multimédia. Entretien avec Jean-Baptiste Kempf, fondateur de l’association VideoLAN, pour retracer son histoire et ses ambitions.

[Numerama] Avec la fin de Windows 10, une pétition tente le tout pour le tout

✍ Julien Lausson, le mercredi 17 septembre 2025.

C’est une initiative qui semble vaine, mais qui tente le tout pour le tout : alors que le support gratuit de Windows 10 s’arrête pour de bon dans un mois, une pétition réclame un prolongement de cinq ans des patchs de sécurité, sans surcoût. En creux, il est reproché à Microsoft de réduire un peu vite la durée de vie de son O.S. et, donc, d’un grand nombre d’ordinateurs.

Et aussi:

[ZDNET] Départ du directeur exécutif de l'Open Source Initiative

✍ Steven Vaughan-Nichols, le mercredi 17 septembre 2025.

L’OSI va-t-elle poursuivre dans la voie actuelle de la définition de l’IA? Cette question est débattue dans les milieux de l’IA et des logiciels libres.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Dans le coffre aux trésors d’Unicode 17 : des chameaux et un trombone
    La version 17 d’Unicode est sortie le 9 septembre. Elle ajoute quatre systèmes d’écriture à son répertoire, quelques émojis et divers symboles plus ou moins ésotériques. Elle apporte aussi quelques modifications techniques. Avec les 4 803 caractères ajoutés, le répertoire Unicode en compte maintenant 159 801. Selon l’expression consacrée, cette version annule et remplace la précédente. lien nᵒ 1 : Unicode 17.00 : nouveautés et changementslien nᵒ 2 : L’annonce officielle de la parution d’Unico

Dans le coffre aux trésors d’Unicode 17 : des chameaux et un trombone

11 septembre 2025 à 14:34

La version 17 d’Unicode est sortie le 9 septembre. Elle ajoute quatre systèmes d’écriture à son répertoire, quelques émojis et divers symboles plus ou moins ésotériques. Elle apporte aussi quelques modifications techniques. Avec les 4 803 caractères ajoutés, le répertoire Unicode en compte maintenant 159 801.

Selon l’expression consacrée, cette version annule et remplace la précédente.

Les émojis ajoutés à la version 17

Sommaire

Les systèmes d’écritures nouvellement adoptés

Les quatre systèmes d’écriture ajoutés ont des origines géographiques et historiques très diverses.

Le Sidétique : une écriture âgée de plus de 3200 ans

Le Sidetique est un système d’écriture très ancien et qui remonte à l’âge de fer (soit environ 1 200 ans avant notre ère) qui était utilisé en Anatolie. C’est un système alphabétique composé de vingt-neuf lettres ; voyelles et consonnes très inspiré du grec. On le retrouve essentiellement sur des inscriptions en pierre et des pièces de monnaie. La création d’une police de caractères pour le sidétique est un des projets de l’Atelier National de Recherche Typographique (ANRT) à Nancy.

La proposition d’intégration du sidétique (PDF en anglais) à Unicode date de janvier 2023. Elle concerne vingt-neuf lettres différentes plus trois lettres additionnelles et est maintenant rangée dans les blocs 10940 à 1095F.

Le Tolonge de Siki, à peine un quart de siècle

Le Tolonge de Siki est un système d’écriture nettement plus récent puisque sa première publication date de 1999. Il a été créé par un physicien indien, le Dr Narayan Oraon, assisté du directeur de l’Institut central des langues indiennes (Central Institute of Indian Languages) de l’époque Francis Ekka, du précédent Vice-chancelier de l’université Ranchi dans l’État du Jarkhand et de Nirmal Minz. L’idée était de concevoir une écriture pour le Kuruth, la langue du Jarkhang, un État du Nord-est de l’Inde. Il comporte trente-cinq consonnes et six voyelles et s’écrit de gauche à droite. La demande d’intégration de l’alphabet Tolonge a été soumise au consortium Unicode (fichier PDF en anglais) en janvier 2023. Une police de caractère ainsi qu’une image de la disposition de clavier peuvent être téléchargées (EN) sur le site qui promeut la langue Kuruth (EN).

Les blocs Unicode 11DB0 à 11DEF lui sont attribués.

Beria Erfe, une écriture inspirée du marquage des chameaux

Le peuple Béri1, est une ethnie dont les membres se répartissent géographiquement entre les régions de Wadi-Fira et de l’Ennedi au nord-est du Tchad et la région du Darfour au nord-ouest du Soudan. Les Arabes les appellent Zaghawa, nom sous lequel le peuple Béri apparaît dans Wikipédia. Une appellation d’autant plus inadaptée qu’elle ne concerne, selon les historiens, qu’une partie du peuple Béri. La société Béri est de type clanique et chaque clan a ses marques spécifiques pour ses animaux, essentiellement des dromadaires.

Dans les années 1950, un instituteur, Adam Tajir a créé une écriture basée sur le marquage des dromadaires des clans (EN) Béri et que d’aucuns ont appelé « écriture des chameaux ». Cette écriture a fait ensuite l’objet d’amélioration en 2000. À la suite de quoi, l’écriture a été bien adoptée et présentée au Consortium Unicode en janvier 2024 (PDF, EN), par, notamment, l’auteur des modifications, un vétérinaire béri Siddick Adam Issa, sous le nom de « Beria Erfe ». L’alphabet se lit de gauche à droite et comporte vingt-cinq lettres, soit une collection de cinquante caractères en tout comprenant des minuscules et des majuscules. Il utilise aussi des signes diacritiques. Visuellement il fait un peu penser au Tiffinagh.

Pour que cet alphabet soit pleinement utilisé avec les outils d’écriture modernes il fallait une fonte et une disposition de clavier. Une image de cette dernière figure dans la proposition soumise à Unicode. Une police de caractère a été créée en 2007 sous l’égide du SIL (EN). Cette version ne répondait pas aux standards d’Unicode, mais on peut récupérer la version actuelle sur la page du projet Kedebideri (EN). Debian propose aussi un paquet mais qui n’est pas (pas encore ?) encodé selon les standards d’Unicode.

Les blocs Unicode 16EA0 à 16EDF lui sont attribués.

Le Tai Yo une écriture thai du Vietnam

Les Thai sont une minorité ethnique importante du Vietnam qui dispose de cinq écritures : le Tay noir, le Tay blanc, le Tay Dèng, le Tay yo qui vient de faire son entrée dans le registre Unicode et le Lai pao qui n’est plus utilisé.

L’écriture Tai Yo (PDF en anglais) :

occupe une place très à part dans l’ensemble des écritures thai du Vietnam. Elle s’écrit verticalement, de haut en bas, et les lignes se succèdent de droite à gauche sur le modèle de l’écriture chinoise. Les manuscrits se consultent en tournant les pages de la gauche vers la droite comme les anciens livres chinois. (Michel Ferlus Les Écritures thai du Vietnam in : Cahiers de linguistique - Asie orientale, vol. 35 2, 2006. pp. 209-239.)

Elle compte vingt-neuf consonnes plus huit qui sont placées uniquement en dernière position et treize voyelles ainsi que neuf signes indiquant une voyelle en position finale.

La police Tai Yo a été ajoutée à la collection des polices Noto de Google. Il existe également une disposition de clavier pour ordinateur. Les deux sont téléchargeables (EN) sur le site de Tools for indigenous languages on the web (outils pour les langues indigènes sur le web).

La demande d’intégration du Tay Yo à la norme Unicode a été faite en décembre 2022. Il occupe les blocs : 1E6C0 à 1E6FF.

Les autres ajouts, et ce qui ne figure pas dans cette version

Les émojis

Pas forcément l’aspect le plus intéressant d’Unicode, mais, au moins, le plus amusant. La version 17 (EN) nous en propose des sympathiques et qui figurent dans la police Noto Color empoji (EN). Ce sont :

  • un visage déformé pour marquer l’anxiété, la panique, la surprise, etc., U+1FAEA,
  • un nuage de bataille, du style de ce que l’on peut voir dans Astérix par exemple, U+1FAEF
  • une créature velue, un yéti en fait, U+1FACB,
  • une ballerine avec des variantes de couleur, U+1F9D1, U+200D et U+1FA70,
  • un personnage avec des oreilles de lapin U+1F46F, déclinable en plusieurs variantes,
  • des personnes en lutte (du catch ?), déclinable en plusieurs variantes, U+1F93C,
  • un orque U+1FACD,
  • une avalanche, U+1F6D8,
  • un trombone U+1FA8A, à ne pas confondre avec ceux qui traînent sur vos bureaux U+1F4CE et qui sont entrés dans l’Unicode en 2010,
  • et, pour finir et ranger tout ça : le coffre aux trésors U+1FA8E.

Le trognon de pomme qui avait résisté vaillamment jusqu’à la version bêta d’Unicode 17 ne figure finalement pas dans la version définitive. Mozilla l’avait ajouté sous la forme d’une pomme croquée rappelant le logo d’Apple.

Des symboles et des suppléments

Cette version Unicode ajoute des caractères supplémentaires à l’écriture Sharada qui contient les caractères historiques du cachemiri, du sanscrit et de diverses autres langues du nord du sous-continent indien utilisés du 8e au 20e siècle. L’Inde, rappelons-le, recense 270 langues parlées dont 22 langues officielles. Ce supplément ajoute sept voyelles nécessaires pour un usage contemporain de l’écriture, bloc U+11B60 à U+11B7F.

Le tangut (ou tangoute), un système d’écriture logographique d’un ancien peuple du nord-ouest de la Chine, se voit également doté d’un supplément de 128 caractères, U+18D00 à U+18D7F.

Des points de code, U+323B0 à U+3347F, sont également ajoutés à l’extension J (pour japonais) des idéographies unifiés chinois-japonais-coréens portant à 4 298 le nombre de signes recensés. Il s’agit de caractères rares et historiques japonais, coréens et vietnamiens.

Pour finir en majesté, cette version propose divers symboles supplémentaires, points de code U+1CEC0 à U+1CEFF, dont : seize symboles astronomiques (Flora U+ 1CEC, Victoria U+1CEC5 et Irène U+1CEC7 ont leur numéro de code), autant de symboles de géomancie (par exemple Lætitia U+CEE8 ou Rubeus U+1CEE4), quatre symboles de jeux d’échec et un symbole divers qui se trouve être un cercle blanc de taille moyenne avec une barre horizontale utilisé en chimie : U+1CEF0.

Et sur le plan technique ?

Très peu de nouveautés ou de changements significatifs pour cette version.

On peut noter la création d’une nouvelle de césure « Unambiguous_Hyphen (HH) » qui suit les modifications apportées au saut de ligne forcé : U+034F Combining grapheme joiner (combinaison de graphème), une nouvelle cédille U+00BB. Dans sa note de blog, Stéphane Bortzmeyer explique cela mieux que moi.

On pourra peut-être relever aussi que les attributs pour les propriétés obsolètes : Gr_Link, Hyphen, isc, kGB7, kJa, XO_NFC, XO_NFD, XO_NFKC, XO_NFKD, FC_NFKC ont été supprimés et qu’une annexe a été ajoutée sur les principes d’encodage de la base de données des hiéroglyphes égyptiens.

Remerciements (!?) et lectures complémentaires

Cette dépêche n’aurait pas été écrite si, sur Mastodon, Stéphane Bortzmeyer ne m’avait taguée pour me signaler que le trognon de pomme avait été éjecté d’Unicode 17. Ce qui m’importe assez peu à vrai dire, sauf en ce qui concerne le fonctionnement d’Unicode. Mais comme j’ai quelques bonnes manières, je l’en ai remercié en lui demandant des nouvelles du système d’écriture maya, ce qui était une gaffe parce qu’il m’a répondu en me parlant de l’écriture des chameaux. Un procédé parfaitement déloyal ! Mais j’imagine que je dois tout de même le remercier (j’ai appris plein de choses).

Et comme pour cette dépêche j’ai pas mal lu, je vous inflige la liste de ce que j’ai parcouru ou lu en plus des liens in-texte au cas où vous voudriez aussi poursuivre la lecture :


  1. Selon les sources, Béri prend ou non un accent. Il en va de même pour Zaghawa qui est orthographié de différentes façons. ↩

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • G'MIC 3.6 : L’art de soigner ses images !
    G’MIC, cadriciel libre pour le traitement des images numériques, vient de proposer une mise à jour significative, avec la sortie de sa nouvelle version 3.6. Une bonne occasion pour nous de vous résumer les activités récentes autour de ce projet, et plus précisément, ce qu’il s’est passé depuis notre précédente dépêche, publiée il y a un peu plus d’un an (juin 2024). N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les ima

G'MIC 3.6 : L’art de soigner ses images !

G’MIC, cadriciel libre pour le traitement des images numériques, vient de proposer une mise à jour significative, avec la sortie de sa nouvelle version 3.6.

Une bonne occasion pour nous de vous résumer les activités récentes autour de ce projet, et plus précisément, ce qu’il s’est passé depuis notre précédente dépêche, publiée il y a un peu plus d’un an (juin 2024).

G´MIC 3.6.0 Teaser

N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images contiennent l’icône Icône 'Play Video'

Sommaire

1. G’MIC : Un cadriciel pour le traitement des images numériques

G’MIC (GREYC's Magic for Image Computing) est un projet libre dédié au traitement, la manipulation et la création d'images numériques. Il est développé principalement au sein de l’équipe IMAGE du laboratoire de recherche GREYC de Caen (laboratoire UMR, sous triple tutelle du CNRS, de l'ENSICAEN et de l'Université de Caen).

La base du projet repose sur un interpréteur de langage de script spécifique, le « langage G’MIC », pensé pour faciliter le prototypage rapide et l’implémentation d’algorithmes de traitement d’images. Autour de ce noyau viennent se greffer plusieurs interfaces utilisateur, qui donnent accès à des centaines d’opérateurs de traitement d’images, mais qui permettent également d’intégrer des pipelines de traitement personnalisés. G’MIC est donc conçu comme un cadriciel ouvert et extensible.

Parmi ses déclinaisons les plus utilisées, on retrouve : gmic, un outil en ligne de commande comparable et complémentaire à ImageMagick ou GraphicsMagick ; le service Web G’MIC Online ; et surtout le greffon G’MIC-Qt, intégrable dans de nombreux logiciels de création et d’édition d’images tels que GIMP, Krita, DigiKam, Paint.net, Adobe Photoshop ou Affinity Photo. Ce greffon est l’interface de G’MIC la plus populaire. Il donne aujourd’hui un accès rapide à plus de 640 filtres différents, élargissant considérablement les possibilités de filtres et d’effets offertes par ces logiciels de retouche d’images.

Aperçu du greffon G’MIC-Qt Fig. 1.1. Le greffon G’MIC-Qt en version 3.6, ici utilisé au sein de GIMP 2.10, avec le filtre « Paint With Brush » activé.

2. Les nouveautés du greffon G’MIC-Qt

2.1. Hommage à Sébastien Fourey, développeur de G’MIC-Qt

Avant de décrire la liste des nouveautés de cette version 3.6, nous souhaitons avant tout rendre hommage à notre collègue et ami, Sébastien Fourey, qui était maître de conférence à l’ENSICAEN et qui était le développeur principal du greffon G’MIC-Qt. Le 6 octobre 2024, Sébastien nous a quittés. Tous ceux qui le connaissaient vous le diront : Sébastien était avant tout une personne profondément humaine, généreuse et particulièrement attentive à tous ceux qui l’entouraient. Il était aussi discret et modeste qu’il était doué avec un clavier entre les mains (et c’était quelqu’un de très discret !).

Et même s’il n’a jamais voulu être mis au-devant de la scène, nous voulons ici faire une exception pour mettre en lumière son travail et le rôle majeur qu’il a eu dans le développement du projet G’MIC : c’est grâce à lui que G’MIC-Qt est aujourd’hui un greffon utilisé et apprécié par des milliers de personnes à travers le monde.

Il s’avère qu’il était un lecteur assidu de LinuxFr.org, et nous nous devions donc de lui rendre un hommage sur ce site. Sébastien nous manque profondément. Nous ferons notre possible pour que son œuvre perdure. Repose en paix, Sébastien ! Nous pensons à toi et à ta famille.

Hommage à Sébastien Fourey Fig. 2.1. Texte hommage à Sébastien Fourey, auteur de G’MIC-Qt, visible dans la section « About » du greffon.

2.2. Améliorations générales du greffon

Comme vous vous en doutez, le développement spécifique du greffon G’MIC-Qt a été à l’arrêt depuis octobre dernier. Néanmoins, les derniers ajouts de code réalisés sur le greffon ont rendu possible les choses suivantes :

  • Son code source est désormais compatible avec l’API de plug-in de la nouvelle version majeure de GIMP (la 3.0). Cela a permis d’offrir aux utilisateurs de GIMP un greffon G’MIC-Qt fonctionnel dès la sortie de GIMP 3. Notons qu’assez peu de greffons ont proposé une mise à jour à temps (Resynthesizer, greffon populaire, étant une autre exception). On remercie donc chaleureusement Nils Philippsen et Daniel Berrangé qui ont soumis les patchs activant cette compatibilité avec GIMP 3. Nous continuons en parallèle à maintenir notre greffon pour l’ancienne version (2.10) de GIMP, qui est encore beaucoup utilisée.

  • Le code de G’MIC-Qt devient également compatible avec l’API de la bibliothèque Qt6, la dernière version majeure en date de ce toolkit graphique.

  • L’interface du greffon propose maintenant un outil de prévisualisation des filtres avec séparateur intégré, de manière native. Cette fonctionnalité, accessible via le raccourci clavier CTRL + SHIFT + P, permet de comparer directement l’image avant et après l’application d’un filtre, en affichant les deux versions côte à côte dans la fenêtre de prévisualisation. Cette fonctionnalité existait déjà, mais elle est dorénavant utilisable de manière plus fluide, puisqu’auparavant elle était implémentée indépendamment par chaque filtre (le séparateur de prévisualisation était en fait vu comme un paramètre du filtre, ce qui impliquait un recalcul complet du résultat du filtre même lorsque l’on souhaitait seulement déplacer le séparateur).

Prévisualisation avec séparateur Fig. 2.2.1. Prévisualisation native de filtres avec séparateur intégré dans G’MIC-Qt.

La vidéo suivante montre comment cette fonctionnalité améliorée se présente dans le greffon :

Prévisualisation avec séparateur - vidéo Fig. 2.2.2. Prévisualisation native de filtres avec séparateur intégré dans G’MIC-Qt (vidéo).

2.3. Nouveaux filtres d’images

Les nouveautés principales du greffon G’MIC-Qt se matérialisent donc plutôt sous la forme de nouveaux filtres et effets accessibles pour les utilisateurs. À la sortie de cette version 3.6, c’est 640 filtres/effets différents qui sont proposés dans l’interface du greffon. En ce qui concerne le filtrage d’images, les dernières entrées ajoutées sont les suivantes :

  • Le filtre « Déformations / Warp [RBF] » propose de déformer localement une image en définissant dans un premier temps des points d’ancrage dans la fenêtre de prévisualisation. Puis, en repositionnant ces points de contrôle, on déforme l’image de manière intuitive et interactive, directement dans la fenêtre de prévisualisation. Idéal pour réaliser des retouches rapides ou créer des caricatures amusantes !

Filtre « Warp RBF » Fig. 2.3.1. Le filtre « Deformations / Warp [RBF] » en action dans G’MIC-Qt.

La vidéo suivante montre son utilisation en pratique au sein du greffon G’MIC-Qt pour la déformation d’un visage :

Filtre « Warp RBF » - vidéo Fig. 2.3.2. Le filtre « Deformations / Warp [RBF] » en action dans G’MIC-Qt (vidéo).

  • Le filtre « Repair / Upscale [CNN2x] » a pour but de doubler la résolution d’une image à l’aide d’un réseau de neurones convolutifs léger (CNN), qui a été entrainé pour préserver les détails et les textures des images lors de l’agrandissement. Ce module offre une alternative simple et relativement efficace aux méthodes d’agrandissement plus classiques (en particulier celles qui sont implémentées nativement dans GIMP).

Filtre « Upscale CNN2X » Fig. 2.3.3. Le filtre « Repair / Upscale [CNN2X] » en action dans G’MIC-Qt.

La figure suivante montre justement une comparaison des méthodes classiques d’agrandissement d’images, avec ce nouvel algorithme disponible dans G’MIC-Qt (résultat obtenu en bas à droite) :

Filtre « Upscale CNN2X » - Comparaisons Fig. 2.3.4. Comparaisons des méthodes d’agrandissement d’images avec notre nouvelle méthode « Upscale [CNN2X] ».

Notons que ce filtre illustre à lui seul quelques avancées récentes réalisées pour la nn_lib, qui est la petite bibliothèque interne d’apprentissage machine intégrée à G’MIC : Clipping des gradients, régularisation L2 des poids des réseaux, planificateur Cosine Annealing LR pour le taux d’apprentissage, module de Pixel Shuffling, sont quelques-unes des nouvelles fonctionnalités qui y ont été ajoutées. Cette bibliothèque de gestion de réseaux de neurones n’est pas très puissante (elle n’utilise que le calcul CPU, pas GPU), mais elle offre néanmoins la possibilité de créer des filtres intéressants basés sur des techniques d’apprentissage statistique.

  • Le filtre « Degradations / VHS Filter », est un filtre créé par Hazel Stagner. Comme son nom l’indique, il cherche à recréer l’esthétique caractéristique des vieilles cassettes vidéo VHS : légères distorsions, bruit coloré, lignes parasites et saturation altérée. Ce filtre est idéal pour donner aux images un aspect rétro, évoquant le rendu des vidéos analogiques des années 80–90.

Filtre « VHS Filter » Fig. 2.3.5. Le filtre « Degradations / VHS Filter » en action.

Ce filtre génère un bruit aléatoire, donc l’appliquer plusieurs fois sur une même image donne à chaque fois un rendu différent. On peut donc ainsi synthétiser de petites animations avec un look « analogique - années 90 » du plus bel effet. Les amateurs de Glitch Art apprécieront ! (voyez l’image originale à titre de comparaison).

Filtre « VHS Filter » - vidéo Fig. 2.3.6. Le filtre « Degradations / VHS Filter » appliqué plusieurs fois sur une même image, pour en faire une séquence vidéo de type VHS.

2.4. Nouveaux effets de rendu

De nouveaux effets font également leur apparition dans le greffon, non pas dans le but de modifier une image existante, mais pour créer une nouvelle image ou un motif à partir de zéro :

  • Le filtre « Patterns / Organic Fibers » synthétise des textures évoquant des entrelacements de fibres organiques, en s’appuyant sur l’algorithme de simulation du Physarum polycephalum proposé par Jeff Jones en 2010, et décrit de manière remarquable sur cette page d’Etienne Jacob (allez voir, ça vaut vraiment le détour !). Nous reparlerons de cet algorithme un peu plus loin dans la dépêche (en section 4.2).

Filtre « Organic Fibers » - 1
Filtre « Organic Fibers » - 2 Fig. 2.4.1. Le filtre « Patterns / Organic Fibers » en action, avec deux jeux de paramètres différents.

  • Le filtre « Rendering / Speech Bubble » insère une bulle de bande dessinée sur un calque d’image additionnel, avec une personnalisation possible de la forme de la bulle (rondeur, forme du pied de bulle, etc.), grâce à la présence de différents points de contrôle. Ce filtre offre un moyen rapide d’intégrer des éléments graphiques typiques de la BD dans une image quelconque, comme illustré ci-dessous avec, dans un premier temps, la vue du filtre tel qu’il se présente dans le greffon, suivi d’une vue du résultat dans GIMP où un texte a été inséré dans la dite bulle.

Filtre « Speech Bubble » - 1
Filtre « Speech Bubble » - 2 Fig. 2.4.2. Le filtre « Rendering / Speech Bubble » permet d’ajouter des bulles de dialogue dans vos images.

La vidéo ci-dessous présente ce filtre en action dans le greffon G’MIC-Qt sur une photographie :

Filtre « Speech Bubble » - vidéo Fig. 2.4.3. Le filtre « Rendering / Speech Bubble » en action dans le greffon (vidéo).

  • Le filtre « Rendering / 2.5D Extrusion » simule, à partir d’une forme binaire en entrée, un effet d’extrusion 3D. Il transforme donc rapidement des silhouettes ou des masques en objets visuellement plus consistants, avec un rendu qui évoque du relief, sans devoir passer par un véritable logiciel de modélisation 3D. Les figures suivantes illustrent son utilisation : On crée tout d’abord une forme opaque sur un fond transparent (ici un texte), puis on lui applique le filtre « Rendering / 2.5D Extrusion » de G’MIC-Qt pour créer un rendu façon 3D extrudée. L’angle de rotation, la profondeur de l’extrusion, l’amplitude de l’effet perspective, ainsi que les couleurs des différentes faces sont réglables dans ce filtre.

Filtre « 2.5D Extrusion » - 1
Filtre « 2.5D Extrusion » - 2 Fig. 2.4.4. Le filtre « Rendering / 2.5D Extrusion » en action.

  • Le filtre « Rendering / Fluffy Cloud » génére automatiquement de jolis nuages cotonneux dans vos images. Idéal pour créer des ciels synthétiques, du brouillard, des effets de vapeur éthérée, etc. Ce filtre a été créé par Prawnsushi, contributeur régulier de filtres G’MIC, dont certains filtres avaient été déjà présentés dans notre dépêche précédente. Voici comment ce nouveau filtre se présente lors son ouverture dans le greffon :

Filtre « Fluffly Cloud » - 1 Fig. 2.4.5. Le filtre « Rendering / Fluffy Cloud » dans le greffon _G’MIC-Qt._

En jouant avec les différents paramètres du filtre, on peut obtenir des rendus variés et intéressants :

Filtre « Fluffly Cloud » - 2
Filtre « Fluffly Cloud » - 3 Fig. 2.4.6. Différents rendus de « Rendering / Fluffy Cloud » en faisant varier les paramètres du filtre.

  • Le filtre « Patterns / Stripes » facilite la création de motifs à rayures simples ou complexes. Ce filtre offre de nombreux paramètres pour régler la géométrie des motifs synthétisés, en faisant varier le type de rayures (linéaires, radiales, concentriques), la taille, la couleur ainsi que l’opacité de chaque rayure indépendamment.

Filtre « Stripes » - 1
Filtre « Stripes » - 2
Filtre « Stripes » - 3 Fig. 2.4.7. Trois exemples de motifs à rayures générés par le filtre « Patterns / Stripes ».

  • Le filtre « Patterns / Gradient [from Curve] » n’est pas à proprement parler un nouveau filtre, mais une évolution d’un filtre précédent « Patterns / Gradient [from Line] ». Cette version étendue extrait un dégradé de couleur en parcourant les pixels de l’image, non plus seulement le long d’un segment, mais le long d’une courbe spline cubique par morceau, définie avec jusqu’à 6 points de contrôle, ce qui autorise le suivi de structures très incurvées dans les images, comme l’illustre la figure suivante :

Filtre « Gradient From Curve » Fig. 2.4.8. Le filtre « Patterns / Gradient [from Curve] » extrait les couleurs d’une image localisées le long d’une courbe spline.

  • Et pour en finir avec les nouveautés du greffon, mentionnons le filtre « Rendering / Neon Carpet », un filtre original réalisé par Claude (alias Cli345), contributeur régulier de G’MIC qui avait été interviewé en septembre dernier sur Linuxfr. Ce filtre un peu psychédélique synthétise des motifs lumineux et colorés faisant penser à des tapis fluorescents, comme illustré sur la figure ci-dessous :

Filtre « Neon Carpet » Fig. 2.4.9. Le filtre « Rendering / Neon Carpet », une contribution de Cli435.

Voilà pour ce qui concerne les nouveautés spécifiques au greffon G’MIC-Qt.

3. Améliorations du cœur du logiciel et de sa bibliothèque standard

Passons maintenant à la description du travail réalisé cette année pour l’amélioration du cœur du projet, à savoir l’interpréteur G’MIC et sa bibliothèque standard d’opérateurs. Ce sont forcément des améliorations un peu moins visibles pour l’utilisateur final, mais elles sont toutes aussi importantes, car elles consolident ou améliorent des fonctionnalités qui peuvent ouvrir plus tard la porte au développement de nouveaux filtres originaux.

3.1. Optimisation de l’interpréteur

Le moteur interne de G’MIC a bénéficié d’une série d’optimisations notables. Plusieurs améliorations internes, concernant l’analyse, la détection et la concaténation de chaînes de caractères ou encore la recherche de valeurs min/max dans de grandes images (désormais parallélisée avec OpenMP), ont permis d’augmenter légèrement les performances (gain moyen d’environ 2,5% sur le temps d’exécution de scripts G’MIC). Ce n’est pas un gain spectaculaire, mais ça se prend (et après 17 ans à écrire du code pour cet interpréteur, il aurait été presque inquiétant d’obtenir un gain beaucoup plus important ! 😊).

Sous Windows, la compilation de l’interpréteur utilise désormais Clang et sa libc associée, ce qui produit des exécutables légèrement plus optimisés.

3.2. Améliorations du moteur de rendu 3D

Le moteur de rendu 3D intégré de G’MIC a également été amélioré, avec l’ajout du z-clipping pour les primitives hors champ, un calcul d’éclairage affiné, la correction du rendu de normales 3D avec le mode d’éclairage Phong, et l’ajustement des paramètres de réflexion spéculaire.

Une nouvelle commande multithreaded3d (raccourcie en mt3d) permet désormais d’activer ou désactiver le rendu 3D multi-threadé (là encore par OpenMP). Cela permet d’accélérer considérablement l’affichage de gros maillages.

Mentionnons au passage l’apparition de la commande normals3d dans la bibliothèque standard, dont le rôle est d’estimer les vecteurs normaux unitaires d’un maillage 3D, que ce soit au niveau des sommets ou des primitives. La figure suivante illustre par exemple l’utilisation de cette commande pour la visualisation de vecteurs normaux à la surface d’un tore 3D :

Commande 'normals3d' Fig. 3.2.1. La commande normals3d permet d’estimer les vecteurs normaux 3D aux sommets ou aux faces d’un maillage 3D.

3.3. Améliorations de l’évaluateur d’expressions mathématiques

L’évaluateur d’expressions mathématiques intégré à G’MIC est l’une des pièces maîtresses du projet (en traitement d’images, on doit souvent réaliser beaucoup de calculs…). Il continue lui aussi de s’enrichir et de gagner en efficacité.

Sans rentrer dans trop de détails techniques, notons que l’analyse syntaxique des expressions a été optimisée grâce à une première passe dédiée à la détection de certains opérateurs, afin d’accélérer leur traitement ultérieur. De nombreuses fonctions font leur apparition, parmi elles, epoch() pour convertir une date en temps Unix, frac() pour extraire la partie fractionnaire d’un nombre, ou encore wave() qui permet de générer différentes fonctions ou images périodiques (sinusoïdales, triangulaires, etc.), comme illustré sur la figure ci-dessous :

Fonction 'waves()' - 1
Fonction 'waves()' - 2 Fig. 3.3.1. La nouvelle fonction waves() permet de générer facilement des fonctions d’ondes, fonctions dont la fréquence d’apparition (hoho ! calembour de traiteur de signal !) est assez élevée dans les opérateurs de traitement d’images.

3.4. Amélioration des entrées-sorties

Quelques améliorations sont également à signaler au niveau de la gestion des entrées-sorties :

  • Le format TIFF bénéficie désormais d’une sauvegarde plus rapide pour les grosses images (par exemple, les images médicales volumiques). Un choix élargi de modes de compression de sortie est également disponible pour ce format d’images.
  • G’MIC prend désormais en charge de manière native la lecture et l’écriture des fichiers au format WebP (cette fonctionnalité étant activée par défaut sur les paquets binaires que l’on propose pour Linux).
  • Notons enfin qu’un travail de portage du code pour l’affichage des fenêtres de G’MIC, vers la bibliothèque SDL3, a été amorcé. Cela devrait permettre à terme une meilleure compatibilité de G’MIC avec le système d’affichage natif de chaque distribution Linux (en particulier celles tournant sous Wayland).

3.5. Sprite Packing

En ce qui concerne l’évolution de la bibliothèque standard de G'MIC, la nouveauté la plus significative concerne la réécriture de la commande pack_sprites, qui implémente un algorithme d’«empaquetage» d’objets. Pour rappel, ce type d’algorithmes permet de générer des visuels composés d’ensemble d’imagettes disjointes placées de telle façon à reproduire une forme binaire (un masque) de géométrie quelconque.

Cette ré-implémentation est à la fois plus rapide et plus efficace (utilisant de meilleures heuristiques de placement), et permet d’optimiser l’agencement des imagettes à différentes échelles et orientations tout en réduisant le temps de génération. Une illustration valant mieux qu’un long discours, voici le genre d’images amusantes que cet algorithme est capable de produire facilement :

Commande 'pack_sprites' - 1
Commande 'pack_sprites' - 2 Fig. 3.5.1. Deux exemples de génération possibles utilisant la commande « pack_sprites ».

Les sprites à empaqueter peuvent être de formes quelconques, comme des lettres (image du haut de la figure précédente), des mots entiers (image du bas), etc.

Et quoi de mieux qu’un exemple concret pour montrer la facilité déconcertante 😉 d’utilisation de cette commande pack_sprites ? Le but ici est d’écrire le texte « ♥LinuxFR♥ » de telle sorte que chaque lettre soit générée comme un empaquetage d’elle-même ! (idée suffisamment saugrenue pour qu’un filtre « clé en main » réalisant ceci n’existe pas déjà !).
Le script G’MIC suivant (fichier test_pack_sprites.gmic), une fois rendu exécutable, réalise cette tâche :

#!/usr/bin/env gmic

str="\20LinuxFR\20"
repeat size(['$str']) {
  l:=['$str'][$>]
  0 text. {`$l`},0,0,${"font titanone,480"},1,1 ==. 0 channels. -3,0
  0 text. {`$l`},0,0,${"font titanone,64"},1,${"-RGB"},255
  pack_sprites.. .,5,25,3,1 remove.
}
append x to_rgb
output out.png
display

La génération prend quelques secondes, et aboutit à une image de ce type :

Commande 'pack_sprites' - 3 Fig. 3.5.2. Résultat du lancement du script test_pack_sprites.gmic.

Amusant, n’est-ce pas ? Comment feriez-vous pour réaliser la même chose dans un autre langage (et combien de lignes de code cela prendrait-il ? 😉).

4. Utilisation de G’MIC pour le « Creative Coding »

L’exemple précédent est réellement représentatif des possibilités d’écriture de scripts personnalisés permis par G'MIC. Saviez-vous, par exemple, que l’ensemble des 640 filtres disponibles dans le greffon G’MIC-Qt sont justement écrits dans ce langage ?

G’MIC peut ainsi être considéré comme une boite à outils étoffée pour les personnes souhaitant se frotter au code créatif et à l'art génératif. Nous vous proposons ci-dessous quelques autres exemples simples de génération d’images par scripts G’MIC, afin de donner un aperçu rapide des possibilités et de la concision de ce langage.

4.1. Exemples de génération d’images

  • Inversion d’un damier coloré : On s’inspire ici de cette excellente vidéo récente, réalisée par le vulgarisateur mathématicien Mickaël Launay (Micmaths). En G’MIC, la fonction suivante permet de synthétiser une image équivalente à celle montrée dans la vidéo (mais en quatre couleurs au lieu de deux).
invert_checkerboard :
  4096,4096,1,1,"
    L = clog(20*([x,y]/w - 0.5));
    P = cexp([log(40/exp(L[0])),L[1]]);
    85*xor(P[0]%4,P[1]%4)"
  map 6 rescale2d 50%

Inversion d’un damier coloré Fig. 4.1.1. Génération d’un damier inversé, avec la commande personnalisée invert_checkerboard.

  • Cercles d’Apollonius : Dans cet exemple, il s’agit d’empaqueter des cercles de plus en plus petits dans un cercle de base, pour générer des images fractales. La fonction G’MIC réalisant cette tâche est la suivante :
apollonian_gasket :

  # Init.
  siz=1280 rad:=$siz/2.2
  $siz,$siz,1,2
  circle {[$siz,$siz]/2},$rad,1,1
  repeat 5 { circle {[$siz,$siz]/2+0.537*$rad*cexp([0,90°+$>*72°])},{0.316*$rad},1,0,{2+$>} }

  # Iterate.
  ind=4 e "  > Computing"
  do {
    sh 0 +distance. 0 x,y,r:="x = xM; y = yM; [ x,y,i(x,y) - 1 ]" rm[-2,-1]
    circle $x,$y,$r,1,0,$ind ind+=1
    e "\r  > Computing "{`c=arg0(int($>/10)%4,124,47,45,92);[c,c==92?92:0]`}
  } while $r>3

  # Decorate.
  k. channels 100%
  +n. 0,255 map. hot
  l[0] { g xy,1 a c norm != 0 * 255 to_rgb }

  max rs 80%

Et voici le résultat :

Cercles d’Apollonius Fig. 4.1.2. Génération de cercles d’Apollonius, avec la commande personnalisée apollonian_gasket.

  • Gaussiennes 3D : On cherche ici à dessiner de petites fonctions gaussiennes anisotropes 3D de différentes tailles, orientations et couleurs dans un volume 3D discret, en s’arrangeant pour garantir une périodicité de l’image suivant l’axe z (l’axe de la profondeur). Puis, on transforme les coupes de ce volume en frames d’une vidéo, pour obtenir l’animation qui suit.
gaussians3d :
  180,180,160,3
  2000,1,1,1,":
    draw_gauss3d(ind,xc,yc,zc,u,v,w,siz,anisotropy,R,G,B,A) = (
      unref(dg3d_mask,dg3d_one,dg3d_rgb,dg3d_isiz2);
      dg3d_vU = unitnorm([ u,v,w ]);
      dg3d_vUvUt = mul(dg3d_vU,dg3d_vU,3);
      dg3d_T = invert(dg3d_vUvUt + max(0.025,1 - sqrt(anisotropy))*(eye(3) - dg3d_vUvUt));
      dg3d_expr = string('T = [',v2s(dg3d_T),']; X = ([ x,y,z ] - siz/2)/siz; exp(-12*dot(X,T*X))');
      dg3d_mask = expr(dg3d_expr,siz,siz,siz);
      dg3d_rgb = [ vector(##siz^3,R),vector(##siz^3,G),vector(##siz^3,B) ];
      const dg3d_isiz2 = int(siz/2);
      draw(#ind,dg3d_rgb,xc - dg3d_isiz2,yc - dg3d_isiz2,zc - dg3d_isiz2,0,siz,siz,siz,3,A/255,dg3d_mask);

      # Trick: These two lines allow to generate a perfectly looping animation.
      draw(#ind,dg3d_rgb,xc - dg3d_isiz2,yc - dg3d_isiz2,zc - dg3d_isiz2 + d#0/2,0,siz,siz,siz,3,A/255,dg3d_mask);
      draw(#ind,dg3d_rgb,xc - dg3d_isiz2,yc - dg3d_isiz2,zc - dg3d_isiz2 - d#0/2,0,siz,siz,siz,3,A/255,dg3d_mask);
    );

    X = [ u([w#0,h#0] - 1),u(d#0/4,3*d#0/4) ];
    U = unitnorm([g,g,g]);
    siz = v(5);
    anisotropy = u(0.6,1);
    R = u(20,255);
    G = u(20,255);
    B = u(20,255);
    A = u(20,255)/(1 + siz)^0.75;

    siz==0?draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],11,anisotropy,R,G,B,A):
    siz==1?draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],21,anisotropy,R,G,B,A):
    siz==2?draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],31,anisotropy,R,G,B,A):
    siz==3?draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],41,anisotropy,R,G,B,A):
    siz==4?draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],51,anisotropy,R,G,B,A):
           draw_gauss3d(#0,X[0],X[1],X[2],U[0],U[1],U[2],61,anisotropy,R,G,B,A)"
  rm.
  rs 250%,250%,6 c 0,255 normalize_local , n 0,255
  slices {[d/4,3*d/4-1]}

Gaussiennes 3D - vidéo Fig. 4.1.3. Volume de gaussiennes 3D anisotropes, vues comme une séquence vidéo.

Regardez ça en plein écran pendant 20 minutes avant d’aller vous coucher, en écoutant du Pink Floyd, et je vous garantis une bonne nuit de sommeil !

  • Cube roulant : Comme mentionné en section 3.2, G’MIC possède son propre moteur de rendu 3D, que nous utilisons donc ici pour générer cette animation simple et qui boucle parfaitement :

Cube roulant - vidéo Fig. 4.1.3. Animation d’un cube 3D roulant.

Le code source de cet effet est un peu plus long que pour les exemples précédents, et nous ne l’intégrons donc pas directement dans cette dépêche. Mais en 47 lignes seulement, cela reste tout à fait raisonnable 😊 !

Et si comme moi, vous prenez plaisir à regarder ou réaliser des images ou animations amusantes/étranges qui sont générées en quelques lignes de code seulement, alors n’hésitez pas à aller jeter un œil au fil de discussion dédié, sur le forum officiel de G’MIC : Creative Coding with G’MIC.

4.2. La série « G’MIC Adventures ».

Les possibilités offertes par G’MIC pour le code créatif nous ont récemment décidé à initier une petite série de dépêches, intitulées « G’MIC Adventures ». L’idée de cette série est d’expliquer et d’illustrer les différentes étapes qui vont du concept à l’implémentation d’un effet de code créatif sous forme d’un script G’MIC. Aujourd’hui, cette série comporte seulement 4 épisodes, mais nous espérons l’enrichir dans le futur. Ces épisodes sont les suivants :

Arbre fractal 3D Fig. 4.2.1. Génération d’un arbre fractal 3D par G’MIC, réimporté ensuite sous Blender.

Arbre fractal 3D - vidéo Fig. 4.2.2. Exemple d’arbre fractal 3D généré par G’MIC (vidéo).

Mousse de forêt Fig. 4.2.3. Espèce de mousse de forêt synthétique, générée par agrégation de particules en 3D. L’inhalation volontaire de vapeurs provenant de cette mousse est fortement déconseillée !

  • G’MIC Adventures #4: Physarum Transport Networks : Cet épisode explore la réalisation d’un autre système particulaire, l’algorithme Physarum imaginé dans ce papier de Jeff Jones, en 2010. Ici, on lance des millions de particules qui s’auto-organisent pour suivre un chemin qui devient commun à toutes les particules au bout d’un certain nombre d’itérations, ce qui permet de générer des animations 2D tout à fait étonnantes, comme celles-ci par exemple :

Danse du feu - 1
Danse du feu - 2 Fig. 4.2.4. Danses de filaments enflammés, générées par l’algorithme Physarum en 2D.

Dans cet épisode, nous proposons également une extension 3D de cet algorithme, ce qui permet de générer ce type d’animation :

Physarum 3D
Fig. 4.2.4. Évolution de l’algorithme Physarum étendu en 3D.

Tous ces épisodes cherchent à montrer que G’MIC est une boite à outils générique, plutôt sympa à utiliser, pour le prototypage créatif destiné à la génération d’images et d’animations !

5. Ressources additionnelles

Nous voilà déjà arrivés à la cinquième section de cette dépêche, signe qu’il est probablement temps de la terminer au plus vite 😉. Pour finir, voici donc quelques informations et liens supplémentaires pour approfondir la découverte du projet G’MIC :

  • Mentionnons tout d’abord la parution de la publication « G’MIC: An Open-Source Self-Extending Framework », de D. Tschumperlé, S. Fourey et G. Osgood, en janvier 2025 dans le journal JOSS (The Journal of Open Source Software). Dans cet article sont décrites les motivations générales du projet et une vue d’ensemble de son architecture globale et de quelques-unes de ses possibilités. Cela permet aussi au projet G'MIC d’avoir son article « de référence » dans une revue scientifique (donc pouvoir être cité plus facilement).

Article JOSS

6. Conclusions et perspectives

La sortie de cette version 3.6 (et plus généralement l’année 2025) représente une étape importante dans la vie du projet G'MIC.

Tout d’abord parce qu’on se rend bien compte qu’après 17 ans de développement, G’MIC est maintenant stable, et qu’il est peut-être plus temps d’en valoriser les facettes existantes, plutôt que de chercher à implémenter à tout prix de nouvelles fonctionnalités. D’autre part, car la disparition de l’ami Sébastien, en plus d’avoir été un choc émotionnel majeur, risque de rendre difficile la maintenance et l’évolution future du greffon G’MIC-Qt. Et enfin, car avec la démocratisation de l’IA générative, les domaines de l’analyse, du traitement et de la génération d’images (notamment à des fins créatives) sont en profonde mutation, et que les fonctionnalités de G’MIC pourraient très bien être considérées comme obsolètes d’ici quelques années (ou pas 😊).

Au final, que d’incertitudes et de questionnements ! Cela rend floues les directions à prendre pour l’évolution de G’MIC, d’autant que s’occuper d’un tel projet requiert beaucoup d’investissements en temps, et qu’en même temps, sa valorisation financière est aujourd’hui inexistante.

Actuellement, G’MIC est téléchargé un peu plus de 1000 fois par jour depuis la page web principale du projet (donc sans compter les installations tierces : via l’installation de Krita, via les paquets officiels des distributions, etc.). C’est un chiffre très honorable pour un logiciel libre de ce type, développé au sein d’un laboratoire public de recherche tel que le GREYC, et qui plus est, qui n’est plus maintenu que par une seule personne.

À court terme, on se focalisera probablement sur la promotion et la visibilité du cadriciel, la maintenance du code et l’animation de la communauté, par exemple en écrivant quelques tutoriels illustrant ses nombreuses applications potentielles dans les domaines variés liés à l’imagerie numérique : retouche photographique, illustration, peinture numérique, imagerie scientifique (médical, astronomie, biologie, matériaux), création graphique, art génératif, etc.

À long terme, peut-on raisonnablement espérer faire plus de G’MIC avec ce peu de ressources ?
L’avenir nous le dira !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Projets Libres! Saison 3 épisode 9 : Transition.city, simuler et optimiser un réseau transport
    Projets Libres! est heureux de vous présenter la plate-forme libre Transition, développée par la chaire mobilité de Polytechnique Montréal. Nous recevons Yannick Brosseau et Pierre-Léo Bourbonnais, appartenant tous les deux à la chaire, afin d'aborder les sujets suivants : la genèse de Transition son financement l'ouverture des algorithmes et la formation des étudiants sur des outils ouverts les relations avec les sociétés de transports du Québec les données nécessaires, accessibles ou non di

Projets Libres! Saison 3 épisode 9 : Transition.city, simuler et optimiser un réseau transport

Projets Libres! est heureux de vous présenter la plate-forme libre Transition, développée par la chaire mobilité de Polytechnique Montréal.

Nous recevons Yannick Brosseau et Pierre-Léo Bourbonnais, appartenant tous les deux à la chaire, afin d'aborder les sujets suivants :

  • la genèse de Transition
  • son financement
  • l'ouverture des algorithmes et la formation des étudiants sur des outils ouverts
  • les relations avec les sociétés de transports du Québec
  • les données nécessaires, accessibles ou non disponibles pour faire un projet d'optimisation d'un réseau de transport
  • OpenStreetMap au Québec et les actions menées pour améliorer la contribution
  • les enjeux de la construction de réseaux au Canada
  • et bien plus !

Cet épisode est le premier d'une nouvelle série sur Transports + logiciel libre.

Bonne écoute !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 2 de l’année 2025
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [ZDNET] La SNCF et l'Europe dans le train du logiciel libre [Numerama] VLC lance une fonction attendue depuis longtemps par les fans de séries [Silicon] La Chine veut livrer un processeur Open Source cette année [Next]

Revue de presse de l’April pour la semaine 2 de l’année 2025

Par : echarp
14 janvier 2025 à 10:13

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[ZDNET] La SNCF et l'Europe dans le train du logiciel libre

✍ Thierry Noisette, le samedi 11 janvier 2025.

Le groupe SNCF, qui réalise et collabore à plusieurs logiciels libres dont son jumeau numérique Open Source Railway Designer (OSRD), présente l’association Open Rail, née en 2024.

[Numerama] VLC lance une fonction attendue depuis longtemps par les fans de séries

✍ Hugo Bernard & Nicolas Lellouche, le jeudi 9 janvier 2025.

VLC va intégrer de l’IA générative dans son lecteur vidéo open-source. Le plus célèbre des logiciels français prépare un générateur automatique de sous-titres capable de parler plusieurs dizaines de langues.

Et aussi:

[Silicon] La Chine veut livrer un processeur Open Source cette année

✍ Matthieu Broersma, le mercredi 8 janvier 2025.

Le directeur de l’académie de recherche du gouvernement chinois promet un processeur haute performance basée sur la norme open source RISC-V.

[Next] La définition de l'IA ouverte divise encore le milieu

✍ Martin Clavey, le lundi 6 janvier 2025.

En octobre dernier, l’Open Source Initiative a publié la version 1.0 de sa définition de l’IA ouverte, mais des acteurs du milieu du logiciel libre n’en sont pas satisfaits. Ils s’organisent autour de Sam Johnston pour peser sur la définition qui sera utilisée en Europe lors du AI Action Summit organisé par l’Élysée les 10 et 11 février.

Commentaires : voir le flux Atom ouvrir dans le navigateur

do⋅doc, produire facilement du contenu - Libre à vous ! du 15 octobre 2024 - Podcasts et références

Deux-cent-vingt-deuxième émission « Libre à vous ! » de l’April. Podcast et programme :

  • sujet principal : le logiciel libre do·doc : produire facilement des contenus

  • la chronique F/H/X de Florence Chabanois, intitulée : « Qui a envie d’être sexiste ? »

  • la chronique À la rencontre du libre de Julie Chaumard, sur la PyConFR 2024, la conférence francophone du langage Python, qui se déroulera du 31 octobre au 3 novembre à Strasbourg.

Rendez‐vous en direct chaque mardi de 15 h 30 à 17 h sur 93,1 FM en Île‐de‐France. L’émission est diffusée simultanément sur le site Web de la radio Cause Commune.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Unicode en version 16.0.0, le plein de hiéroglyphes égyptiens et de symboles informatiques
    Le consortium Unicode a annoncé la sortie de la version 16.0.0 de sa norme d’encodage des caractères le 10 septembre 2024. En bref, cette version voit le nombre de caractères passer de 149 813 à 154 998, soit 5 185 caractères supplémentaires. Elle ajoute sept nouvelles écritures, de nouveaux fichiers de données et quatre normes techniques Unicode sont versionnées pour être synchrones avec la norme Unicode. Elle remplace toutes les autres versions, la précédente datant de 2022. Quelques-uns de c

Unicode en version 16.0.0, le plein de hiéroglyphes égyptiens et de symboles informatiques

Le consortium Unicode a annoncé la sortie de la version 16.0.0 de sa norme d’encodage des caractères le 10 septembre 2024. En bref, cette version voit le nombre de caractères passer de 149 813 à 154 998, soit 5 185 caractères supplémentaires. Elle ajoute sept nouvelles écritures, de nouveaux fichiers de données et quatre normes techniques Unicode sont versionnées pour être synchrones avec la norme Unicode. Elle remplace toutes les autres versions, la précédente datant de 2022.

Quelques-uns de ces changements sont détaillés ci-après, et, évidemment, tout figure dans les notes de version (en).

Caractères égyptiens source Unicode

Sommaire

Afrique

Les hiéroglyphes égyptiens, le principal ajout en nombre de caractères

On se souvient peut-être des réactions des égyptologues, lors de l’introduction des hiéroglyphes égyptiens dans le standard Unicode en 2009. Il ne contenait que les sept-cent signes de base répertoriés par l’égyptologue britannique Alan H. Gardiner (1879 – 1963). Le gros reproche était le faible nombre de hiéroglyphes retenus : on en connaît plus de 6 000. Unicode 16 a rajouté 3 995 caractères aux 1 654 existants déjà dans le standard. Ce qui porte à 5 649 le nombre de hiéroglyphes égyptiens du catalogue Unicode

Les hiéroglyphes égyptiens occupent les blocs Unicode 13460 à 1355F.

L’alphabet Garay

L’alphabet Garay fait son entrée dans les blocs Unicode 10D40 à 10D8F.

Cet alphabet a été créé en 1961 par El Hadji Assane Faye, qui fut, entre autres, président du mouvement des enseignants en langues africaines. L’objectif étant de retranscrire « les caractéristiques sociolinguistiques africaines ». L’alphabet Garay comporte vingt-cinq consonnes et quatorze voyelles. Il est notamment utilisé pour le wolof, langue nationale du Sénégal, de la Mauritanie et de la Gambie. Il s’écrit de droite à gauche.

Asie

Les écritures de langues indiennes

Cinq écritures sont ajoutées à cette version d’Unicode. Les quatre premiers alphabets sont récents :

  • Gurung Khema ou Khema est l’une des écritures utilisées pour retranscrire le Gurung (en), une langue parlée dans le Népal, il s’écrit de gauche à droite et occupe les blocs Unicode 16100 à 1613F,
  • Kirat Rai (en), qui s’écrit de gauche à droite, est utilisé pour écrire le Bantawa, une langue parlée dans l’est de l’Himalaya et l’est du Népal, les blocs Unicode 16D40 à 16D7F lui sont réservés,
  • Ol Onal a été inventé entre 1981 et 1992 (en) par Mahendra Nath Sardar pour transcrire la langue Bhumij, une langue parlée par quelques populations de l’ouest du Bengale et des états indiens Jharkhand, Odisha et Assam. Elle s’écrit de gauche à droite et on la retrouvera dans les blocs Unicode 1E5D0 à 1E5FF,
  • Sunuwar (en), une écriture qui a été développée en 1942 par Krishna Bahadur Jentich (1926 - 1991) pour écrire la langue éponyme parlée dans le Sikkim, un État du nord de l’Inde, et au Népal, s’écrit de gauche à droite et figure dans les blocs Unicode 11BC0 à 11BFF,
  • Tulu-Tigalari ou Tilagari est une écriture plus ancienne. L’alphabet a été conçu à partir de l’alphabet Grantha, une écriture du sud de l’Inde, depuis le XIe siècle. Utilisé au départ pour le sanscrit, le Tilagari (en) sera aussi l’écriture du Tulu, une langue du sud-ouest de l’Inde à partir du XVe siècle. Il s’écrit de gauche à droite et occupe les blocs Unicode 11380 à 113FF.

Japon

La base de données des caractères japonais « Moji Jōhō Kiban » (文字情報基盤) a été ajoutée comme source de référence (en) aux 36 000 idéogrammes unifiés CJC (chinois, japonais, coréen). Ce qui se reflète dans les tableaux de codes de pratiquement tous les blocs d’idéogrammes unifiés CJC par des glyphes représentatifs supplémentaires dans la colonne « J ».

Albanie

L’alphabet Todhri (en) a été inventé par Todhri Haxhifilipi (1811 - 1869) pour écrire en langue albanaise. Composée de cinquante-deux caractères, il s’écrit de gauche à droite et semble dériver de l’écriture cursive romaine.

Les blocs Unicode 105C0 à 105FF lui sont réservés.

Émoji et héritage informatique

Sept nouveaux émojis font leur entrée :

  • une tête avec des valises sous les yeux (face with bags under eyes), 1FAE9,
  • une empreinte digitale (fingerprint), 1FAC6,
  • un arbre sans feuille (leafless tree), 1FABE,
  • un radis (root végétable), 1FADC,
  • une harpe (harp), 1FA89,
  • une pelle (shovel), 1FA8F,
  • une éclaboussure (splatter), 1FADF.

À cela s’ajoutent sept-cent symboles (en) d’environnements informatiques, blocs Unicode 1CC00 à 1CEBF (Symbols for Legacy Computing Supplement).

Synchronisation

Plusieurs spécifications Unicode importantes ont été mises à jour. Notamment les quatre standards UTS #10, UTS #39, UTS #46, et UTS #51. Ils sont maintenant versionnés de façon synchronisée avec le standard Unicode, leurs fichiers de données couvrant les mêmes répertoires. Ils ont tous été mis à jour en version 16.

Spécification Champ d’application Fichiers de données
UTS #10, Unicode Collation Algorithm (en) Tri du texte Unicode UCA data (en)
UTS #39, Unicode Security Mechanisms (en) Réduction de l’usurpation d’identité en Unicode Security data (en)
UTS #46, Unicode IDNA Compatibility Processing (en) Traitement des URL non-ASCII URLs IDNA data (en) et IDNA 2008 derived data (en)
UTS #51, Unicode Emoji (en Émoji et leur comportement Emoji data (en)

Ces modifications sont susceptibles de nécessiter des changements dans les implémentations. Les sections migrations et modifications des standards UTS #10 (en), UTS #39, (en), UTS #46 (en) et UTS #51 (en) indiquent comment y procéder.

Montée en version vers Unicode 16

Quels impacts pour cette montée en version, outre les modifications apportées par l’ajout de nouveaux caractères et de nouveaux systèmes d’écriture ? Ils semblent plutôt mineurs, le changement le plus notable concerne sans doute celui de l’accès aux spécifications Unicode :

  • les spécifications de base ont été complètement remaniées pour Unicode 16.0 et, converties en HTML, elles sont déployées dans un sous-site autonome,
  • plusieurs des caractères ajoutés peuvent avoir quelques implications sur certaines optimisations de la normalisation; cela ne modifie pas l’algorithme de normalisation, mais il peut y avoir des conséquences sur la dérivation et l’utilisation des propriétés Quick_Check pour l’optimisation de la détection des formes de normalisation, voir UAX #15 (en),
  • des modifications ont été apportées sur les sauts de lignes apportées au guillemet simple gauche, U+2018 ‘ et aux guillemets directionnels similaires dans les contextes spécifiques d’Asie de l’Est afin de corriger les sauts de ligne en chinois simplifié et mieux coller aux spécifications au comportement de l’ICU (International Components for Unicode, bibliothèque logicielle, à ne pas confondre avec la fédération internationale des cheerleaders), voir UAX #14 (en),
  • quelques changements ont été apportés à la spécification afin de mieux s’aligner sur les pratiques courantes et simplifier les éléments transitoires qui ne sont plus nécessaires.

Fin

On laissera le mot de la fin à St00e9phane Bortzmeyer1 au sujet d’un site (de 2023) codé avec les pieds et une faible connaissance d’Unicode :

Si tu n’es pas assez fort pour lire les points de code Unicode, c’est que tu ne t’appliques pas assez de discipline.

J’en profite pour le remercier d’avoir fait passer l’information sur la sortie d’Unicode 16 sur Mastodon, sinon je l’aurais complètement ratée.


  1. Stéphane Bortzmeyer consacre le dernier chapitre de son livre Cyberstructure (2018, C&F) à l’Unicode et raconte comment son prénom est maltraité. Ceci est ma petite contribution à sa collection personnelle. ↩

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Entrevue avec Christophe Grenier, développeur de testdisk et photorec
    testdisk et photorec sont deux outils libres (GPLv2+) formidables… que l’on souhaite pourtant ne jamais avoir à utiliser ! En effet, les deux sont dédiés à la récupération de données après une panne matérielle, ou une bévue. Le premier est axé supports de stockage et leurs partitions, le second orienté récupérations de fichiers (mais il est loin de se limiter aux images). Cocorico : le développeur de ces outils est français, et il a bien voulu répondre à notre sollicitation d’entrevue :). l

Entrevue avec Christophe Grenier, développeur de testdisk et photorec

testdisk et photorec sont deux outils libres (GPLv2+) formidables… que l’on souhaite pourtant ne jamais avoir à utiliser ! En effet, les deux sont dédiés à la récupération de données après une panne matérielle, ou une bévue.

TestDisk

Le premier est axé supports de stockage et leurs partitions, le second orienté récupérations de fichiers (mais il est loin de se limiter aux images).

Cocorico : le développeur de ces outils est français, et il a bien voulu répondre à notre sollicitation d’entrevue :).

Bonjour Christophe ! Pouvez-vous présenter votre parcours ?

Quand j’ai commencé à développer testdisk, mon premier outil de récupération de données, j’étais encore étudiant en école d’ingénieur.
Maintenant, cela fait plus de 20 ans que je suis diplômé de l’ESIEA, j’interviens d’ailleurs dans son Mastère Spécialisé Sécurité et Information des systèmes depuis 2004.
Après avoir travaillé dans la sécurité informatique, j’ai travaillé autours des systèmes Linux, du réseau et de la sécurité.
Depuis un peu plus de 10 ans, je suis directeur d’exploitation pour un hébergeur parisien.
Dans le cadre de mon auto-entreprise, je fais de la récupération de données.

Comment avez-vous démarré ce projet ?

Un ami développeur professionnel sous Windows venait d’acheter un nouveau disque dur et pour éviter d’avoir trop de lettres de lecteurs (C:, D:, E:, …) avait décidé de réduire le nombre de partitions de son disque de données ; ce disque contenait 3 partitions.
Il a sauvegardé les données, supprimé les 3 partitions, en a créé 2 et — au moment de restaurer les données — il s’est rendu compte qu’il avait été trop vite et qu’il lui manquait la sauvegarde d’une des partitions.
Sachant que j’avais des connaissances sur le partitionnement des PC (je m’étais intéressé au fonctionnement des virus de boot qui se logeaient dans le premier secteur des disques durs), il m’a contacté.

Armé d’un éditeur hexadécimal, il nous avait fallu la journée pour reconstruire manuellement la table des partitions et récupérer ces données. Un peu plus tard ayant appris les rudiments de la programmation en C, je me suis dit qu’il devait être possible d’automatiser la récupération des partitions et c’est ainsi qu’est né testdisk en 1998.

Pour photorec, il a fallu attendre mon premier appareil photo numérique en 2002. Ayant peur de perdre des photos (effacement par mégarde de photos non sauvegardées, reformatage de la mauvaise carte mémoire…), avant même de partir en voyage, j’ai bricolé un programme en C sous Linux capable de récupérer les photos et vidéos prises par mon appareil photo. C’est ainsi que photorec est né pour récupérer des photos. Il a gardé son nom même s’il récupère des centaines de formats de fichier différents.

Quels sont les points marquants qui ont, selon vous, marqué l’évolution de ces logiciels ?

Les points principaux ayant permis le succès de ces logiciels sont :

  • de rendre ces logiciels multiplateformes pour PC : MS-Dos et Linux, puis Windows. La prise en charge de macOS est venu bien plus tard et a eu peu d’impact.
  • de distribuer ces logiciels gratuitement. L’utilisation d’une licence opensource (GPL v2+) m’a aussi permis d’avoir quelques contributions.
  • d’être plutôt à l’écoute des utilisateurs et d’enrichir les formats de fichiers gérés par photorec. Certains sont vraiment exotiques.
  • de la documentation en plusieurs langues à une époque où les traductions automatiques étaient quasi-inexploitables. Mais aujourd’hui, la documentation principale de plus de 60 pages est en anglais.

Un point marquant a été la reconnaissance officielle de l’utilisation de ces logiciels par des organismes étatiques.

testdisk a été conçu pour un public technique, j’ai eu des retours de différents sociétés de récupération de données de part le monde l’utilisant mais en général, elles ne souhaitent pas communiquer sur leur utilisation de logiciels (libres ou du commerce).

Un tournant a eu lieu en 2014 quand le NIST, dans le cadre du Computer Forensics Tool Testing Program (CFTT), a testé et publié ses résultats sur les capacités de photorec. En comparant les résultats de chaque outil, on découvre que photorec a les meilleurs résultats (1ère place ex aequo).
Ainsi, photorec figure dans le catalogue de logiciels que les agences d’États américains peuvent utiliser.

photorec apparaît dans les diapositives de la formation SecNum Academie de l’ANSSI.

Pourquoi un seul paquet pour deux logiciels, ou pourquoi pas un seul logiciel ?

Quand on parle de testdisk et photorec, il y a aussi fidentify, un outil en ligne de commande qui permet de tester rapidement l’identification de fichiers en utilisant les mêmes parsers que photorec, sans oublier qphotorec, une version graphique de photorec.

Selon les distributions, vous pouvez avoir un package testdisk comprenant testdisk, photorec et fidentify et un package qphotorec pour qphotorec.

testdisk utilise un accès en écriture au disque, photorec n’utilise qu’un accès en lecture. photorec est plus facile d’utilisation que testdisk, c’est presque du next/next/next, il ne fait que du « file carving » (récupération de fichiers par identification des entêtes).

Quelles sont les fonctionnalités les plus attendues que vous pensez implémenter ?

La vérification formelle du code des parsers de photorec est ce qui m’a le plus occupé ces dernières années, je continue de travailler dessus.
Je n’ai pas prévu d’implémenter de nouvelles fonctionnalités dans l’immédiat.

Avez-vous des retours d’utilisateurs, des remerciements de personnes qui ont pu grâce à ces outils retrouver une partie de leur vie numérique, ou de grincheux ?

Perdre une partie de sa vie numérique est très stressant.
De fait, j’ai été confronté à des grincheux très agressifs dont un cas extrême de menaces répétées de mort de la part d’un individu qui n’avait pas pu récupérer ses données. Les hébergeurs de ses messageries successives ont agi rapidement lorsque j’ai signalé ses messages, mais je me suis posé la question à ce moment-là si cela valait bien la peine de m’investir autant pour risquer cette violence numérique.

Les retours positifs des utilisateurs et leurs remerciements sont ce qui a permis de me motiver à continuer de développer sur toutes ces années ce projet.
À une époque, je recevais quotidiennement des mails de remerciements et/ou des donations. C’est moins fréquent désormais, mais c’est peut-être parce que les sauvegardes vers le cloud sont beaucoup plus courantes et qu’ainsi les gens ont moins recours à la récupération de données.

Effectivement, perdre une partie de sa vie numérique est très stressant, avez-vous des conseils à donner sur la sauvegarde ?

Ce sont des conseils très généraux :

  • que cela soit au niveau personnel ou au niveau professionnel, il est important de vérifier le périmètre de la sauvegarde. Si vous n’aviez plus que votre dernière sauvegarde, que vous manquerait-il ?
  • testez une restauration de données
  • si possible, multipliez les sauvegardes (sauvegarde avec historique ou versionning, pas une simple synchronisation)
  • dans l’idéal, plusieurs lieux de sauvegarde.

Sur ces projets, y a-t-il d’autres contributeurs ?

testdisk et photorec reçoivent principalement des contributions ponctuelles. J’en profite pour remercier toutes les personnes qui m’ont aidé pour les traductions, pour avoir partagé des fichiers dans des formats exotiques, ou pour avoir contribué au code.
Merci aussi aux personnes ayant participé à la modération du forum et au modérateur actuel !

Y a-t-il des fonctionnalités importantes qui ne seront pas développées, et pourquoi ?

À moins de recevoir des contributions, je ne pense pas pousser davantage le support mac.
Le chiffrement des disques sous Windows va devenir la norme, comme c’est le cas sous macOS. Je pense que cela va freiner le développement de testdisk et photorec. La récupération va devenir bien plus complexe en exigeant un déchiffrement préalable.

Des souvenirs marquants de cette expérience ?

Je crois que l’une des anecdotes qui m’a le plus amusé est celle que j’ai reçue en janvier 2007 : dans un premier mail, l’utilisateur explique qu’un appareil photo a été volé dans sa voiture, mais qu’une semaine plus tard, la police a trouvé le coupable et a pu restituer l’appareil photo. Le contenu avait été effacé, mais grâce à photorec, l’utilisateur avait récupéré plus de 300 photos.

Currently I am recovering over 300 photos using PhotoRec that my sister in law took over the holidays. Our car was broken into and the camera was stolen. A week later the police found the guy! They found the camera, but it had been wiped.
I had read about recovering photo's from flash cards via a story on slashdot, and now here I am.

Quelques heures plus tard, j’ai reçu la suite de l’histoire :

I have recovered some pictures that look to be taken by the thief […]
I am submitting a CD of the data I have recovered to the Detective involved in the case. My little camera was involved in a much larger theft, so hopefully the pictures they took will help nail them all!

Le voleur avait utilisé l’appareil photo, photorec a permis de récupérer des photos ayant beaucoup intéressé le détective en charge du dossier : celui-ci espère découvrir les autres personnes impliquées dans un vol de plus grande envergure.

Avez-vous eu des échanges avec des éditeurs de logiciels similaires (opensource ou propriétaires) ?

photorec a été victime de plusieurs contrefaçons.

Dans un cas, un fabricant de carte mémoire a distribué un logiciel de récupération de données, ce fabricant avait sous-traité le développement qui avait « optimisé » son temps de développement en récupérant le code source de photorec, remplaçant tous les entêtes de copyright et ajoutant une interface graphique.
Après avoir contacté le fabricant, celui-ci a fait rétablir les copyrights manquants et le code a été distribué en GPLv3.

Dans d’autres cas, des développeurs ont volontairement publié des contrefaçons qu’ils revendaient. Après avoir fait fermer leur hébergement plusieurs fois, ils ont fini par trouver un hébergeur bullet-proof, un hébergeur qui ne répondait plus aux plaintes…

Concernant le forum, avez-vous déjà rencontré des difficultés avec le respect du code de conduite ?

La modération sur le forum est obligatoire, les spammeurs sont très nombreux et inventifs en réutilisant par exemple du contenu d’autres sujets. Aucun code de conduite n’a été formalisé.
Le forum ne tient plus que grâce à la présence d’un modérateur, je ne sais pas si cette partie du projet va perdurer.

Quel est votre modèle économique ?

Le projet est né comme un projet personnel et reste géré comme tel.
Je travaille chez Global Service Provider, une société de services et hébergement informatique, qui me permet de disposer gracieusement (Merci à eux) de machines virtuelles (VM), sauvegarde, monitoring pour le projet.
Diverses donations ponctuelles couvrent les frais des différents noms de domaine, mon équipement informatique personnel…

Au niveau personnel, quels logiciels libres utilisez-vous, sur quel système d’exploitation ?

À l’exception des raspberry pi sous Raspbian, les différents ordinateurs de la maison sont sous Fedora Linux.
J’utilise gnome comme environnement graphique, alpine et roundcube pour la messagerie, vim comme éditeur de texte, du docker avec moby, gcc, python…

Et au niveau professionnel ?

Mon ordi portable est aussi Fedora Linux.
Les serveurs Linux que mon équipe et moi gérons sont principalement sous AlmaLinux et Debian.

J’utilise tous les jours ansible (automatisation des configurations), git (versionning), netbox (gestion de datacenters), oxidized (sauvegarde réseau), mediawiki (documentation)…

Merci pour votre disponibilité, et pour ces merveilleux outils !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Célébrons les 21 ans des Linux-Meetup au Québec
    🎉 Il y a plus de deux décennies, j’ai lancé mon tout premier Linux-Meetup à Montréal en mai 2003. Depuis, chaque premier mardi du mois, nous avons tenu 252 rencontres sans interruption, rassemblant des passionnés du monde Linux. 🚀 Le samedi 21 septembre 2024, nous fêterons 21 ans de partage autour de Linux et des logiciels libres au Québec ! Cet événement coïncide avec la Journée internationale des logiciels libres (SoftwareFreedomDay), offrant une visibilité mondiale inégalée. Ce sera l’occasi

Célébrons les 21 ans des Linux-Meetup au Québec

🎉 Il y a plus de deux décennies, j’ai lancé mon tout premier Linux-Meetup à Montréal en mai 2003. Depuis, chaque premier mardi du mois, nous avons tenu 252 rencontres sans interruption, rassemblant des passionnés du monde Linux.

🚀 Le samedi 21 septembre 2024, nous fêterons 21 ans de partage autour de Linux et des logiciels libres au Québec ! Cet événement coïncide avec la Journée internationale des logiciels libres (SoftwareFreedomDay), offrant une visibilité mondiale inégalée. Ce sera l’occasion de célébrer cette communauté qui s’est agrandie au fil des années et de marquer cette étape importante dans l’histoire du logiciel libre.

📈 Chaque année, notre événement annuel devient de plus en plus grand grâce à l’appui de nos commanditaires. Avec une participation record de 150 passionnés l’an dernier et le soutien de 23 commanditaires visionnaires.

🌐 L’événement se tiendra en présentiel à l’école de technologie supérieure (ÉTS), à l’université et en virtuelle sur BigBlueButton, permettant à la communauté Linux francophone de participer d’où qu’elle soit.

💼 Si votre entreprise utilise Linux ou soutient les logiciels libres, c’est une occasion unique de promouvoir vos solutions et vos services auprès d’une audience ciblée et engagée. Rejoignez-nous comme commanditaire et bénéficiez d’une visibilité accrue au sein de la communauté. Contactez-moi rapidement pour discuter de votre participation !

🚩 Pour les plus aventureux, la cinquième édition de notre chasse au trésor informatique (CTF : CaptureTheFlag) sera de retour avec des défis inédits, conçus par Dominique Derrier et Pascal Gad. Cet événement interactif mettra vos compétences Linux à l’épreuve et promet des moments captivants pour les participants.

🗣️ Au programme : des présentations passionnantes des experts Linux, le CTF et des opportunités d’échanges avec la communauté, et bien plus encore.

🎟️ Ne manquez pas cette opportunité unique de vous inscrire et de découvrir l’agenda complet à https://www.rencontres-linux.quebec/event/21-ans-de-linux-meetup-au-quebec-1/

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Interview de Cli345, créateur de filtres pour G’MIC
    En novembre 2023, cli345 nous gratifiait d’une excellente dépêche-tutoriel sur le filtre Comicbook de G’MIC. Un filtre qu’il a développé parce qu’il voulait transformer des photos en BD. Pour reprendre le commentaire de David Ttschumperlé, responsable de l’équipe Image du GREYC (Laboratoire de recherche en sciences du numérique) qui développe G’MIC : « Le code de ce filtre est arrivé de manière tout à fait inattendue, et ça a été une sacrée bonne surprise pour nous. Ce n’est pas souvent qu’on re

Interview de Cli345, créateur de filtres pour G’MIC

En novembre 2023, cli345 nous gratifiait d’une excellente dépêche-tutoriel sur le filtre Comicbook de G’MIC. Un filtre qu’il a développé parce qu’il voulait transformer des photos en BD. Pour reprendre le commentaire de David Ttschumperlé, responsable de l’équipe Image du GREYC (Laboratoire de recherche en sciences du numérique) qui développe G’MIC : « Le code de ce filtre est arrivé de manière tout à fait inattendue, et ça a été une sacrée bonne surprise pour nous. Ce n’est pas souvent qu’on reçoit des contributions sympas comme ça, qui ont l’air de tomber du ciel :) »

Et ce n’est pas sa seule contribution, mais on vous laisse le plaisir de la découverte.

Parcours

Quelle formation (ou pas) as-tu reçu ? Quel est ton parcours ?

J’ai une formation en mathématiques et en informatique mais pas spécialement en modélisation des données ni en graphisme. Ma découverte de l’informatique commence avec des algorithmes sur papier. À ce moment-là, tout était séquentiel, pas question de concurrence ni de parallélisme. Dans notre apprentissage, la seule façon d’interagir avec l’utilisateur était une instruction qui permettait d’attendre que l’utilisateur écrive quelque chose à la console. Plus tard, j’ai appris la programmation événementielle, de nouveau, sans allusion à la concurrence ni au parallélisme.

Du côté graphisme, j’ai appris à faire des filtres GIMP grâce aux nombreux tutoriels disponibles sur internet et grâce à la console « Python-Fu ». Plus tard, j’ai connu G'MIC grâce au site. C’est aussi grâce aux tutoriels que j’ai pu écrire des filtres pour G'MIC. Pour GEGL, c’est un peu la même chose, j’ai beaucoup tâtonné et je ne connais que les bases.

Est-ce que ton investissement dans G’MIC te motive pour participer à d’autres logiciels libres ? Lesquels ?

Quelques projets passés :

Quelques projets en vue :

  • programme pour transformer un schéma Dia convenable en graphe GEGL,
  • greffon “ColoringBook” pour Inkscape,
  • tutoriel sur la vision des couleurs.

Projet en cours :

  • filtre G'MIC -> Rendering -> Color Wheels,
  • le langage de programmation FuncSug. Son but est de faciliter la programmation événementielle. Pour cela, FuncSug supprime le recours aux fonctions de rappel (callback) et ajoute des structures de contrôle pour exprimer le parallélisme logique. Il peut être bien utile pour développer des petits jeux (cf G'MIC Memory) et je pense qu’il permettra de donner plus de liberté de développements dans des jeux de vie ou des histoires interactives.

Où trouves-tu le temps d’avoir toutes ces activités en parallèle, et comment gères-tu ton temps pour chaque projet ?

Je n’essaie pas d’avoir un résultat parfait. Par exemple, le filtre « tangential circle » est plutôt lent, mais je l’ai quand même proposé. De même, je n’avais pas testé le filtre « Frame [Relief] » partout. De fait, il y avait un gros bug qui m’a été signalé et que j’ai pu corriger.

Implication dans G’MIC

Qu’est-ce qui t’as amené à t’investir dans le projet ?

Je voulais transformer des photos en BD et je ne trouvais pas ce que je souhaitais dans ce qui existait déjà. J’ai donc commencé à expérimenter. Par exemple, pour l’aplatissement des couleurs, j’ai essayé le flou gaussien sélectif, la segmentation, le filtre bilatéral ; pour les traits, j’ai essayé Laplace, la norme du gradient, la différence erode-dilate, la différence gaussienne ; ces essais se faisaient tantôt sur l’image tantôt sur des décompositions TSL, LAB, LCH.

J’ai donc beaucoup expérimenté avec GIMP et G'MIC. Ensuite, j’ai fait un filtre dans GIMP pour automatiser tout cela. J’ai voulu en faire profiter les autres. J’en ai donc parlé sur gimpchat.com. Comme ce filtre faisait appel à de nombreuses fonctions G'MIC, je l’ai ensuite traduit en G'MIC pour lui donner une plus grande disponibilité.

Qu’est-ce qui t’as poussé à développer des filtres particuliers ?

Le Comicbook est venu d’un désir personnel. Deux autres sont tirés de discussions sur les forums (Lineart, Tangential Circles).

Peux-tu nous donner une idée du temps que cela t’a pris ?

Je n’en ai aucune idée.

As-tu eu des retours d’utilisation de tes filtres ?

Oui. En fait, je les présente sur le site gimpchat.com. Les utilisateurs m’y indiquent les bugs qu’ils rencontrent et si ça leur plaît.

Qu’est ce qui s’est avéré le plus satisfaisant dans le fait d’avoir contribué à G'MIC ?

Que plein de monde puisse profiter de mes filtres.

Merci beaucoup.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • G´MIC 3.4.0 : Le traitement d’images à la fleur de l’âge
    Une nouvelle version 3.4.0 de G’MIC (GREYC’s Magic for Image Computing) vient de sortir ! À cette occasion, nous vous proposons une description des fonctionnalités récentes ajoutées à ce cadriciel libre pour le traitement des images numériques, faisant suite à notre précédente dépêche sur ce sujet (publiée en mai 2023). N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images contiennent l’icône  lien nᵒ 1 : Le projet

G´MIC 3.4.0 : Le traitement d’images à la fleur de l’âge

Une nouvelle version 3.4.0 de G’MIC (GREYC’s Magic for Image Computing) vient de sortir !

À cette occasion, nous vous proposons une description des fonctionnalités récentes ajoutées à ce cadriciel libre pour le traitement des images numériques, faisant suite à notre précédente dépêche sur ce sujet (publiée en mai 2023).

G´MIC 3.4.0 Teaser

N. D. A. : Cliquez sur les images pour en obtenir une version en pleine résolution, ou une vidéo correspondante lorsque les images contiennent l’icône Icône 'Play Video'

Sommaire

1. G’MIC en quelques mots

G’MIC est un cadriciel (framework) libre pour la manipulation et le traitement des images numériques, développé au sein de l’équipe IMAGE du laboratoire de recherche GREYC de Caen (UMR CNRS 6072).

Il définit différentes interfaces utilisateur permettant l’application d’algorithmes variés sur des images et des signaux, variés eux aussi. L’élément moteur du projet est un interpréteur d’un langage de script, le «  langage G’MIC  », élaboré spécifiquement pour faciliter le prototypage et l’implémentation de nouveaux algorithmes et opérateurs de traitement d’images. Les utilisateurs peuvent ainsi appliquer des opérateurs parmi plusieurs centaines déjà implémentés, ou écrire leurs propres pipelines de traitement et les rendre accessibles dans les différentes interfaces utilisateur du projet. C’est donc, par essence, un cadriciel ouvert, extensible et en évolution constante.

Les interfaces de G’MIC les plus populaires sont : gmic, outil en ligne de commande (complément indispensable à ImageMagick ou GraphicsMagick pour traiter/générer/analyser des images à partir du shell), le service Web G’MIC Online, et surtout, le greffon G’MIC-Qt, utilisable dans de nombreux logiciels d’édition d’images numériques tels que GIMP, Krita, DigiKam, Paint.net, Adobe Photoshop, Affinity Photo… Ce greffon propose aujourd’hui plus de 620 filtres divers, pour élargir les possibilités de ces logiciels de manipulation d’images.

Aperçu du greffon G’MIC-Qt Fig. 1.1. Aperçu du greffon G’MIC-Qt en version 3.4.0, ici lancé depuis GIMP 2.10, avec le filtre « Comicbook » sélectionné.

2. Quoi de neuf dans cette version 3.4.0 ?

La version 3.4.0 de G’MIC_ se focalise sur la stabilité et le support long-terme : Après plus de 15 ans de développement continu du projet, les concepts et codes qui constituent G’MIC ont eu le temps d’être éprouvés, et nous voulons maintenant assurer la stabilisation des API des différents composants du projet : l’API de la libgmic (pour intégrer les fonctionnalités de G’MIC dans un code C ou C++), celle du greffon G’MIC-Qt (pour implémenter une version du greffon au sein d’un nouveau logiciel hôte), celle des fonctions de base définissant la bibliothèque standard de G’MIC (stdlib), ainsi que la syntaxe du langage G’MIC lui-même.

Ainsi, toutes les versions de cette branche 3.4.x seront consacrées à la correction de bugs et le développement de fonctionnalités ne nécessitant pas de modification de ces fondations du projet (par exemple, le développement de nouveaux filtres ou d’opérateurs de traitement d’images), avec le souhait d’assurer au maximum une rétro-compatibilité entre ces versions. En ce sens, on considère que la version 3.4.0 représente un jalon dans l’histoire du projet.

En ce qui concerne les améliorations générales apportées aux différentes interfaces utilisateurs, on peut citer principalement :

G’MIC Online (G’MICol)

Ce service, qui permet d’appliquer les filtres de G’MIC sur des images, directement à partir d’un navigateur web, existe depuis plusieurs années. En 2024, les membres du service DDA (Développement et Déploiement d’Applications) du laboratoire GREYC ont initié une refonte totale de ce service, avec à la clé un nouveau look, une amélioration nette de l’interface utilisateur (widgets plus intuitifs, amélioration de la fenêtre de prévisualisation, apparition de thèmes clair/sombre, gestion des filtres favoris…) et une automatisation des mises à jour de G’MIC et des filtres associés. La liste des améliorations réalisées serait trop longue à énumérer, et une figure valant mille mots, voici à quoi ressemble aujourd’hui la nouvelle version de ce service web :

Aperçu du service _G’MIC Online_
Fig.2.1. Aperçu du service web G´MIC Online, remis au goût du jour à l’occasion de la sortie de la version 3.4.0 de G’MIC (ici, avec le thème clair).

Si vous souhaitez l’essayer, foncez voir G’MIC Online, ça sera pour nous l’occasion d’avoir un test grandeur nature 😱 ! Et n’hésitez pas à nous faire remonter des soucis éventuels. Dans tous les cas, un grand bravo à nos collègues de l’équipe DDA pour ce travail important de refonte !

Greffon G’MIC-Qt

En l’espace d’une année, ce sont plus de 40 nouveaux filtres de traitement d’images qui ont fait leur apparition dans le greffon. La plupart seront détaillés dans la suite de cette dépêche. Mentionnons également l’apparition dans l’interface, d’un nouveau bouton « Paramètres aléatoires », qui assigne des valeurs aléatoires aux paramètres d’un filtre sélectionné, ce qui permet d’obtenir un aperçu rapide de la variété de rendus possibles pour un filtre donné.

Bouton « Paramètres Aléatoires » dans le greffon G´MIC-Qt
Fig.2.2. Greffon G´MIC-Qt : Le nouveau bouton « Paramètres aléatoires » assigne des valeurs aléatoires aux paramètres du filtre sélectionné.

Outil CLI gmic

L’ensemble des filtres réalisés par la communauté des développeurs est maintenant inclus dans l’exécutable dédié à la ligne de commande, ce qui fait qu’il n’y a plus de différences concernant le nombre de filtres disponibles par défaut entre le greffon G’MIC-Qt et l’outil CLI gmic (il fallait auparavant forcer la mise à jour des filtres avec $ gmic update). Aujourd´hui, gmic dispose d’un arsenal de plus de 4000 fonctions pour traiter vos images en ligne de commande. Notons que des efforts particuliers ont été faits pour améliorer le visualiseur intégré d’images (commande display). On peut dorénavant visualiser plus aisément des collections d’images 2D, des images volumiques 3D ou même des maillages 3D, dans une unique interface, comme illustré sur la figure ci-dessous :

Commande 'display'
Fig.2.3. Outil CLI gmic : Le visualiseur d’images de G’MIC a été entièrement ré-implémenté et permet de visualiser des types d’images différents au sein d’une même interface.

C’est également le cas pour le visualiseur de fonctions mathématiques ou de signaux 1D (commande plot), qui a été refait à neuf :

Commande 'plot'
Fig.2.4. Commande plot: Le visualiseur de fonctions/signaux 1D a été entièrement repensé.

Tout ceci fait de gmic un outil bien pratique, même si on ne se limite qu’à la visualisation d’images en ligne de commande.

Autres améliorations

  • L’évaluateur intégré d’expressions mathématiques a encore bien évolué : c’est l’une des briques essentielle du langage G’MIC, puisqu’il est en charge d’évaluer le résultat des opérations mathématiques dont on a besoin dans les scripts (autant dire qu’en traitement d’images, on fait tout le temps des calculs). Cet évaluateur s’est enrichi de nombreuses fonctions, en particulier pour le calcul et le traitement de vecteurs, de matrices, et la manipulation native de tas.
  • De nombreuses fonctions natives (C++) de la bibliothèque ont pu être ré-écrites intégralement en langage G’MIC. Ceci va faciliter l’évolution et la maintenance de ces fonctionnalités, puisque leur modification/amélioration future ne nécessitera plus de mise à jour obligatoire des binaires du projet.
  • Les commandes de chargement/sauvegarde de maillages 3D en format .obj (Wavefront) ont été améliorées, et de nouvelles commandes de traitement/création de maillages 3D ont vu le jour (par exemple pour visualiser les vecteurs normaux aux sommets d’un maillage, comme illustré sur la vidéo ci-dessous). Et, non, ceci n’est pas une pomme pourrie :

Exemple de rendu 3D
Fig.2.5. La gestion des maillages 3D au sein de G´MIC a été enrichie de nouvelles commandes.

Voilà pour ce qui concerne les améliorations générales des différentes interfaces proposées par le cadriciel.
Passons maintenant au détail des nouveaux filtres et traitements d’images apparus dans G’MIC ces douze derniers mois.

3. Détails des nouveaux filtres

Dans cette (longue) section, nous catégorisons et décrivons les filtres récents, par type d’utilisation : Retouche photographique, Filtres de déformations, Filtres de dégradations, Filtres de rendu et de textures, et enfin Effets artistiques.

3.1. Retouche photographique

Trois filtres intéressants ont fait leur apparition dans le greffon G’MIC-Qt pour aider les photographes à retoucher leurs clichés numériques.

Tout d’abord, le filtre Colors / Mixer [Generic], un filtre de mixage de canaux couleur qui offre la possibilité de choisir parmi pas moins de 16 espaces/représentations de couleurs différents pour le mixage (CMY, CMYK, HCY, HSI, HSL, HSV, Jzazbz, Lab, Lch, OKlab, RGB, RYB, XYZ, YCbCr, YIQ et YUV_). Cela constitue une bonne alternative aux outils traditionnels de rehaussement de contrastes ou de couleurs, pour retoucher les photographies qui pourraient être un peu palôtes.

Filtre 'Colors / Mixer (Generic)'
Fig.3.1.1. Le filtre Colors / Mixer [Generic] vient enrichir l’arsenal de filtres déjà disponibles pour la retouche des contrastes et des couleurs.

Parlons également du filtre Details / Sharpen [Alpha], qui comme son nom l’indique, permet de rehausser les détails fins dans des photographies. Il est basé sur une technique originale de décomposition pyramidale de l’image relativement à un opérateur d´Alpha blending. Cette technique cherche en particulier à minimiser l’apparition de « halos » près des contours, qui est un artefact classique rencontré avec les filtres usuels de rehaussement de détails.

Filtre 'Details / Sharpen (Alpha)'
Fig.3.1.2. Le filtre Details / Sharpen [Alpha] permet de rehausser assez finement les détails dans les photographies, en minimisant l’apparition de « halos ».

Filtre 'Details / Sharpen (Alpha)'
Fig.3.1.3. Détails « Avant/Après » illustrant l’intérêt du filtre Details / Sharpen [Alpha].

Enfin, le filtre Layers / Spatial Blend Multi-Layers permet de fusionner plusieurs prises d’un même point de vue en une seule image, avec la possibilité de générer un gradient linéaire spatial entre ces différentes vues. On peut par exemple photographier une même scène à plusieurs moments de la journée (et de la nuit), et utiliser ce filtre de fusion spatiale pour créer une image telle que celle illustrée ci-dessous, en un ou deux clics de souris :

Filtre 'Layers / Spatial Blend Multi-Layers'
Fig.3.1.4. Le filtre Layers / Spatial Blend Multi-Layers permet de fusionner plusieurs photographies avec un gradient spatial linéaire, réglable par l’utilisateur.

(Crédits : les images utilisées dans la figure ci-dessus proviennent de la vidéo « Stunning New York City skyline timelapse: Day to night » de la chaîne Youtube « Rumble Viral »).

La vidéo suivante illustre le processus complet, en utilisant le greffon G´MIC-Qt sous GIMP 2.10 :

Filtre 'Layers / Spatial Blend Multi-Layers'

3.2. Filtres de déformations

Passons maintenant à un ensemble de nouveaux effets disponibles pour déformer vos images un peu dans tous les sens.

Avec tout d’abord un premier filtre Deformations / Distort [RBF], qui déforme une image à partir de points clés définis par l’utilisateur et d’une fonction d’interpolation de type RBF (Fonction de base radiale) dont la formule mathématique est spécifiable par l’utilisateur.

Filtre 'Deformations / Distort (RBF)'
Fig.3.2.1. Le filtre Deformations / Distort [RBF] permet d’appliquer des déformations variées, basées sur des RBFs. Ici, en spécifiant la fonction de base radiale phi(r) = log(0.1+r).

Mentionnons ensuite l’apparition d’une nouvelle catégorie Map Projection, qui contient 14 filtres différents dédiés à la transformation de cartes initialement sous la forme de projection cylindrique équidistante (cartes équirectangulaires), pour les convertir sous la forme d’autres types de projections. Cette série de filtre est une contribution de Kristian Järventaus, un membre du Cartographers Guild forum, forum spécialisé dans la cartographie.

Filtres de la catégorie 'Map Projection'
Fig.3.2.2. La nouvelle catégorie de filtres Map Projection propose plusieurs algorithmes de projection de cartes géographiques.

Notons également l’arrivée du filtre Deformations / Square to Circle [alt], dont le but est de transformer tout rectangle (ou carré) centré dans une image, en une ellipse (ou un cercle), et vice-versa. Un filtre certes très spécialisé, avec évidemment peu d’applications évidentes au premier abord, mais le jour où on en a besoin, on est bien content de l’avoir sous la main ! Nous l’avons par exemple utilisé ci-dessous pour transformer un cadre de peinture initialement rond, en un cadre carré :

Filtre 'Deformations / Square to Circle (alt)'
Fig.3.2.3. Le filtre Deformations / Square to Circle [alt] permet de convertir des objets carrés ou rectangulaires en objets ronds ou elliptiques, et inversement.

Enfin, terminons cette revue des nouveaux filtres de déformations d’images, avec le filtre Deformations / Poincarré Disk. Celui-ci permet d’une part de générer des disques de Poincaré, une famille de figures géométriques basées sur des géométries hyperboliques, comme illustrée sur la figure suivante :

Filtre 'Deformations / Poincaré Disk'
Fig.3.2.4. Quelques exemples de disques de Poincaré, générés par le filtre Deformations / Poincaré Disk.

Mais là où ça devient intéressant, c’est que ce filtre permet aussi de déformer des images en les projetant sur ces géométries si particulières :

Filtre 'Deformations / Poincaré Disk'
Fig.3.2.5. Projection d’une image sur un disque de Poincaré.

Par exemple, nous avons utilisé ce filtre (avec quelques modifications maison) pour générer la courte animation suivante, « Survol de la planète Poincaré », qui illustre les étonnantes propriétés fractales de ces bizarreries géométriques :

Filtre 'Deformations / Poincaré Disk'

3.3. Filtres de dégradations

Il arrive que l’on cherche volontairement à dégrader des images, soit pour simuler une altération réelle (par exemple un flou de bougé, du bruit de capteurs…), soit dans la recherche d’un effet purement esthétique (Glitch Art). Dans ces buts, les nouveaux effets suivants ont été ajoutés à G’MIC :

  • Les filtres Rendering / CRT Scanlines et Degradations / CRT Phosphors cherchent à imiter la restitution d’images sur des écrans à tube cathodique (CRT), en simulant deux effets caratéristiques de ces types d’afficheurs, à savoir l’effet Scanline et l’affichage par phosphores. Ces deux filtres ont été réalisés en collaboration avec Romain Hérault, nouveau contributeur (qui a rejoint le GREYC récemment).

Filtre 'Rendering / CRT Scanlines'
Fig.3.3.1. Le filtre Rendering / CRT Scanlines imite l’effet « Scanline » typique des afficheurs CRT.

Filtre 'Degradations / CRT Phosphors'
Fig.3.3.2. Le filtre Degradations / CRT Phosphors quant à lui simule la technique d’affichage par phosphore lumineux des afficheurs CRT.

  • Le filtre Degradations / Blur [Motion] permet, lui, de synthétiser un flou de bougé, avec des trajectoires de type splines possiblement complexes, réglables par l’utilisateur directement en modifiant des points clés dans la fenêtre de prévisualisation de G’MIC-Qt, comme illustré sur la figure ci-dessous :

Filtre 'Degradations / Blur (Motion)'
Fig.3.3.3. Le filtre Degradations / Blur [Motion] simule un flou de bougé.

  • Le filtre Degradations / Sloppy Mess est quant à lui plutôt destiné aux amateurs de Glitch Art. C’est l’un des premiers filtres d’un nouveau contributeur, Prawnsushi, qui s’est récemment intéressé au langage G’MIC pour la création de filtres. C’est un effet un peu long à calculer, mais qui possède de nombreux paramètres et une grande palette de rendus différents.

Filtre 'Degradations / Sloppy Mess'
Fig.3.3.4. Le filtre Degradations / Sloppy Mess crée volontairement des artefacts numériques artistiques sur vos images.

3.4. Filtres de rendu et de textures

Les filtres de rendu ont cette particularité de ne pas nécessiter d’images d’entrée pour fonctionner, puisqu’ils créent de nouvelles images (ou de nouveaux calques) en partant de zéro, par génération procédurale.

  • Le filtre Rendering / Underwoods, un deuxième filtre réalisé par Prawnsushi, n’est rien de moins qu’un générateur de sous-bois ! On pourra nous dire que ça ne sert pas forcément à grand-chose, et évidemment ce n’est pas un filtre qui va être indispensable aux traiteurs d’images, photographes ou illustrateurs pour leur travail de tous les jours.

Mais en quelque sorte, ce filtre illustre pourtant toute la philosophie du projet G’MIC : Produire un logiciel qui favorise la créativité algorithmique, facilite l’implémentation de toutes sortes de filtres (utiles ou moins utiles), et permet le libre partage avec des utilisateurs. En pratique, ce filtre a le mérite d’exister, chacun peut l’essayer, et il n’utilise que peu de ressources mémoire (quelques dizaines d’octets, grâce à la compacité du langage G’MIC par construction). Et en plus, les résultats sont plutôt cool ! Et soyez assurés qu’il servira immanquablement, un jour ou l’autre, à un artiste voulant synthétiser une image de sous-bois en deux clics de souris !

Filtre 'Rendering / Underwoods'
Fig.3.4.2. Exemples de rendus d’images de sous-bois par le filtre Rendering / Underwoods.

  • Le filtre Patterns / Reaction-Diffusion synthétise des textures du type de celles qu’on rencontre dans la modélisation des systèmes de Réaction-Diffusion.

Filtre 'Patterns / Reaction-Diffusion'
Fig.3.4.3. Le filtre Patterns / Reaction-Diffusion dans le greffon G’MIC-Qt.

Là encore, l’intérêt de ce type de filtres peut paraître assez limité. Pourtant c’est l’exemple même de texture qui peut servir de base à la création d’œuvres d’art génératif. Prenez une texture créée par ce filtre, appliquez-lui quelques-uns des autres effets disponibles dans G’MIC (au hasard, le filtre Deformations / Drop Water), et vous voilà prêt à produire des animations amusantes, telles que celle ci-dessous :

Filtre 'Patterns / Reaction-Diffusion'

  • Le filtre Rendering / Spline Spirograph s’inspire du jeu du Spirographe pour le processus de génération de courbes paramétriques, créant des effets de texture et de couleurs intrigants. La présence du bouton Paramètres aléatoires dans le greffon G’MIC-Qt est ici plus que bienvenue, pour obtenir rapidement un panorama varié des résultats possibles de ce filtre !

Filtre 'Rendering / Spline Spirograph'
Fig.3.4.1. Le filtre Rendering / Spline Spirograph et quelques exemples de rendus possibles.

Ce filtre propose également un mode de sortie animé, produisant plusieurs calques consécutifs qui représentent différentes frames d’une animation, ce qui permet de synthétiser de courtes vidéos comme celle-ci :

Filtre 'Rendering / Spline Spirograph'

  • Le filtre Rendering / ABN Filigrees sait lui aussi tracer des courbes paramétriques intéressantes, en s’inspirant cette fois des filigranes que l’on trouve sur les certificats d’actions ou de papier-monnaie. Ce filtre rend hommage à l’American Bank Note Company, un graveur de papier financier ayant été actif à Wall Street du milieu du XIXᵉ siècle jusqu’à il y a une soixantaine d’années.

Filtre 'Rendering / ABN Filigrees'
Fig.3.4.4. Le filtre Rendering / ABN Filigrees en action.

Ce filtre a été réalisé par Garry Osgood, contributeur de longue date et rédacteur des pages de tutoriels du projet. Garry a détaillé tous les aspects techniques de ce filtre-là en particulier, sur cette page.

  • Le filtre Rendering / Random Signature est lui aussi un générateur de courbes amusant : il se propose de dessiner des signatures aléatoires, comme l’illustre la vidéo ci-dessous :

Filtre 'Rendering / Random Signature'
Fig.3.4.4. Le filtre Rendering / Random Signature permet de créer des signatures aléatoires.

Là encore, un filtre dont l’utilité ne peut pas faire débat : « C’est complètement inutile, donc rigoureusement indispensable ! ».

  • Et pour finir cette section, citons le filtre Rendering / Twisted Rays qui génère, comme son nom l’indique, un effet de rayons torsadés. Là encore, l’utilisation de ce filtre restera probablement assez confidentielle. Mais qui sait si dans les milliers d’utilisateurs de G’MIC, il n’y a pas justement quelqu’un qui cherchait à réaliser cet effet en particulier ? Et bien maintenant, il peut ! ☺

Filtre 'Rendering / Twisted Rays'
Fig.3.4.5. Le filtre Rendering / Twisted Rays crée un tourbillon de rayons sur vos images.

Ce filtre peut par exemple être utilisé pour créer ce genre d’effets animés psychédéliques :

Filtre 'Rendering / Twisted Rays'

3.5. Effets artistiques

Et pour finir avec cette énumération des nouveaux filtres de G’MIC, voici quelques filtres en vrac, que l’on va regrouper sous la dénomination « Artistique » (c’est généralement le terme employé dans les logiciels de traitement d’images, pour qualifier des filtres qu’on ne sait pas trop catégoriser…).

  • Le filtre Artistic / Stringify décompose une image d’entrée en blobs de couleurs quantifiés, et relie les points (sous-échantillonnés) localisés sur les contours de ces blobs par des segments de couleur. Là encore, le rendu peut faire penser aux courbes que l’on obtient avec le jeu du Spirographe.

Filtre 'Artistic / Stringify'
Fig.3.5.1. Le filtre Artistic / Stringify crée des abstractions d’images à partir de segments de couleur.

  • Le filtre Black & White / Filaments est lui, basé sur le lancer de milliers de particules à partir d’un ou plusieurs bords de l’image, avec des trajectoires qui sont déformées par la géométrie des contours de l’image. Le tracé de ces milliers de trajectoires avec des couleurs semi-transparentes permet de produire ce genre d’images :

Filtre 'Black & White / Filaments'
Fig.3.5.2. Le filtre Black & White / Filaments transforme vos images en ensembles de filaments qui se déforment.

  • Le filtre Arrays & Tiles / Loose Photos simule un effet de lancer de photos en vrac sur une table, de telle manière que le contenu des photos recrée une image globale, spécifiée comme entrée du filtre. Beaucoup de paramètres sont réglables (densité, taille et ratio des photographies, paramètres d’ombrage, etc.), afin de laisser à l’utilisateur une grande liberté sur le choix du rendu final.

Filtre 'Arrays & Tiles / Loose Photos'
Fig.3.5.3. Exemple de rendu par le filtre Arrays & Tiles / Loose Photos.

  • Le filtre Rendering / Quick Copyright, qui existait déjà dans les versions précédentes, a été ré-implémenté à partir de zéro. Il s’agit d’un filtre facilitant l’insertion d’un texte de copyright (ou d’une signature texte) sur une image numérique. Il possède maintenant de nombreux paramètres permettant de régler finement la position du texte, sa taille, sa fonte, etc. Combiné avec les possibilités d’automatisation du langage G’MIC, c’est un filtre avantageux pour insérer facilement du texte, de manière normalisée, sur des milliers de photographies.

Filtre 'Rendering / Quick Copyright'
Fig.3.5.4. Le filtre Rendering / Quick Copyright en action pour l’insertion de texte de copyright sur une image.

  • Et enfin, le filtre Patterns / Random Rectangles transforme une image en une partition aléatoire de rectangles colorés, pour donner un effet d’abstraction d’image, s’inspirant vaguement du style de certains tableaux de Piet Mondrian.

Filtre 'Patterns / Random Rectangles'
Fig.3.5.5. Le filtre Patterns / Random Rectangles crée une partition colorée de rectangles aléatoirement placés sur l’image.

Là encore, on peut imaginer utiliser ce filtre pour générer des textures qui pourront par exemple servir à décorer des objets, comme cela a été fait dans l’animation ci-dessous (en partant d’une image de bruit pur) :

Filtre 'Patterns / Random Rectangles'

4. Un logiciel aux utilisations variées

Comme nous avons essayé de vous le montrer, G’MIC possède de multiples facettes, avec une vaste palette d’applications. La communauté des utilisateurs ne se limite d’ailleurs pas aux artistes numériques, mais comporte également des chercheurs, des programmeurs, des algorithmiciens… Nous montrons ci-dessous quelques autres utilisations variées du logiciel.

  • Débruitage d’images du JWST :

En octobre 2023, nous avons appris par l’intermédiaire de M.J. McCaughrean, chercheur senior à l´ESA (European Spatial Agency) (parti à la retraite en 2024), que G´MIC était utilisé par certaines personnes au sein de l’ESA pour traiter des images provenant du James Webb Space Telescope (JWST), en particulier pour l’atténuation du bruit fréquentiel apparaissant sur certaines images acquises par le télescope (via le filtre Repair / Banding Denoise notamment).

G’MIC a par exemple été utilisé (entre autres logiciels) pour la réalisation de l’image de couverture du magazine Nature, vol. 622, issue 7981 du 5 octobre 2023, comme confirmé par M.J. McGaughrean, et indiqué d’ailleurs dans la publication associée, dont il est le co-auteur.

Utilisation de G’MIC par l’ESA
Fig.4.1. Utilisation de G´MIC dans le cadre du débruitage d’images de la proto-étoile Herbig-Haro 211, acquises par le JWST.

Pour nous les développeurs, ça a vraiment été une bonne surprise d’apprendre ça, et de nous rendre compte que G´MIC était utilisé dans le domaine de l’astrophysique.

  • Code créatif :

G’MIC se révèle être un allié précieux lorsque l’on cherche à faire du code créatif, de par sa capacité à générer/manipuler facilement des images, et de par sa bibliothèque standard d’opérateurs fournie. Durant cette année écoulée, nous nous sommes amusés à explorer ses possibilités pour la création algorithmique d’images et d’animations, dont voici un petit florilège :

Commençons tout d’abord par cette petite animation de flocons de neige tourbillonnants (code source, 30 lignes) :

Animation de flocons de neige
Fig.4.2. Animation de flocons de neige, générée par un script G´MIC.

Puis enchaînons avec cette variante amusante du jeu de Pierre-Feuille-Ciseaux, où l’on fait d’abord jouer consécutivement chaque pixel d’une image (dont les valeurs initialement aléatoires représentent soit 0 : une pierre, 1 : une feuille, ou 2 : des ciseaux) avec ses 8 voisins, en gardant à chaque fois l’élément qui a été gagnant le plus souvent. Dans un deuxième temps, on stylise la séquence de ces différentes images de labels, là encore, avec le filtre Drop Water, pour aboutir à l’animation suivante, que l’on pourrait intituler « La soupe de l’enfer » (code source, 30 lignes),

Animation du jeu Pierre-Feuille-Ciseaux
Fig.4.3. Animation du jeu de Pierre-Feuille-Ciseaux, où tous les pixels d’une image jouent simultanément.

Et enfin, (re-)plongeons dans le monde merveilleux des fractales de Mandelbrot, tout d’abord avec ce rendu de l’ensemble de Mandelbrot utilisant la technique du Orbit Trap permettant de faire un rendu en y plaquant une image couleur :

Rendu de l’ensemble de Mandelbrot par la méthode de l’« Orbit Trap »
Fig.4.4. Rendu de l’ensemble de Mandelbrot par la méthode du Orbit Trap.

Puis, avec un autre type de rendu, connu sous le nom de Buddhabrot, mais ici en considérant des séries complexes de type zn+1 = zn^p + c, et en faisant varier linéairement l’exposant réel p entre 0 et 6 (plutôt qu’en gardant p=2 comme pour l’ensemble de Mandelbrot classique), pour générer chaque image de l’animation ci-dessous (code source et détails sur cette page) :

Rendu de type 'Buddhabrot' pour des séries complexes avec exposant
Fig.4.5. Variations fractales autour du Buddhabrot.

À noter que pour générer ces images du Buddhabrot modifié à bonne résolution, cela requiert déjà un temps de calcul important (quelques minutes par image). Je trouve cette animation intrigante : il est assez facile d’y retrouver/halluciner des formes familières quand on regarde en détail certaines frames de l’animation, un peu comme quand on regarde les nuages dans le ciel (si vous croyez apercevoir dans cette animation, une tête d’ours, un vieux monsieur assis, une silhouette de personnage, une tête de dragon… alors vous n’êtes pas les seuls à être un peu rêveurs ☺).

  • Conversion d’images pour le String Art :

Le String Art est une forme de création artistique caractérisée par l’utilisation de fils de couleurs reliés entre des points (le plus souvent des clous) pour former un motif ou reproduire une photographie (classiquement des portraits). Dans un but d’expérimentation, nous avons écrit un script G’MIC qui cherche à transformer une image d’entrée en niveaux de gris choisie par l’utilisateur, sous la forme d’une série d’instructions à suivre pour relier des clous numérotés avec un fil monochrome, afin de reproduire l’image le plus fidèlement possible (en considérant les contraintes propres à ce mode de création) :

Tentative d’utilisation de G´MIC pour le 'String Art'
Fig.4.6. Tentative plus ou moins réussie d’utilisation de G´MIC pour le String Art.

Saurez-vous reconnaitre qui est censé être représenté sur la photo ci-dessous (il n’y a rien de spécial à gagner…) ? Une tentative pas forcément couronnée de succès, qui mériterait d’être approfondie (notamment en gérant des fils de différentes couleurs), mais qui illustre cependant les possibilités multiples d’expérimentations que permet le cadriciel G’MIC !

  • Autres liens connexes :

Pour finir, citons ces quelques liens en vrac, qui permettent d’apprécier la polyvalence de G’MIC :

  1. Stéganographie : Ou comment cacher des données dans une image de bruit ? La commande rand est capable de générer des valeurs aléatoires à densité, c’est-à-dire dont la densité de probabilité est une fonction spécifiée par l’utilisateur. Cela a par exemple comme application de cacher des images de taille 256x256 dans des histogrammes d’images de bruit à 16bits/canal, comme détaillé sur cette page.
  2. Galeries artistiques : Ivelieu et Gannjondal sont deux artistes fréquentant le site Deviant Art qui utilisent parfois G´MIC dans leur processus de création artistique. Allez faire un tour sur leurs galeries respectives, ça vaut le coup d’œil !

Images de la galerie d’Ivelieu
Fig.4.7. Quelques réalisations de Ivelieu / Devian Art.

Images de la galerie de Gannjondal
Fig.4.8. Quelques réalisations de Gannjondal / Devian Art.

  1. Nous avons appris que la prochaine version du programme de gestion de photos digiKam 8.4.0 inclura un outil de traitement G’MIC au sein du Batch Queue Manager, ce qui permettra aux utilisateurs de digiKam d’intégrer les filtres G’MIC dans les flux de travail de post-traitement.
  2. Thiojoe est un Youtubeur produisant des vidéos autour de la technologie, et programmeur à ses heures. Il a commencé à développer un outil libre basé sur G´MIC pour générer facilement des animations, outil que vous pouvez retrouver ici. Ne fonctionne que sous Windows pour le moment, mais nous garderons un œil dessus.
  3. Enfin, mentionnons la chaîne Youtube de JustCallMeInsane, illustratrice numérique utilisant Krita. Elle a récemment réalisé une série de vidéos qui explore les différentes catégories de filtres du greffon G´MIC-Qt pour Krita. On espère en passant que l’équipe de développement de Krita, qui gère sa propre version du greffon, pourra le mettre à jour assez rapidement.

5. Conclusion

On pourrait résumer cette dépêche en disant que le projet G’MIC « continue son petit bonhomme de chemin ».

G’MIC reste bien sûr un projet modeste, développé et maintenu par une petite équipe (de passionnés), mais avec un nombre d’utilisateurs croissant et des retours d’utilisation de plus en plus variés. Ce cadriciel a la chance de pouvoir être développé au sein du GREYC, un laboratoire de recherche publique assurant au projet un contexte de développement favorable, d’être soutenu par les tutelles du laboratoire (l’institut « Sciences Informatiques » du CNRS, l’Université de Caen et l’ENSICAEN) et même encouragé par la direction dudit laboratoire.

Et même si le plus gros du développement sur ce projet a probablement déjà été réalisé (plus de 15 ans de développement quand même), nous sommes confiants dans le fait que nous allons continuer à faire évoluer G’MIC, en tout cas, tant qu’on verra qu’il peut s’avérer utile aux traiteurs et traiteuses d’images de tout poil ! Et nous en reparlerons certainement dans une prochaine dépêche.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Mise à jour de VenC en version 3.2.2
    VenC, un générateur libre (GPLv3) de site statique en python qui avait déjà été présenté dans une dépêche précédente, est de retour en version 3.2.2 avec tout un tas de nouvelles fonctionnalités cool qu’on va voir ici. lien nᵒ 1 : Site de l'auteur lien nᵒ 2 : Site de Jérémy Berrylien nᵒ 3 : Site du projetlien nᵒ 4 : Tipeee lien nᵒ 5 : LiberapaySommaire Auto-rafraîchissement lors de la prévisualisation Assignation d’un thème par défaut Amélioration des fonctionnalités FTP Transfert parallèle

Mise à jour de VenC en version 3.2.2

VenC

VenC, un générateur libre (GPLv3) de site statique en python qui avait déjà été présenté dans une dépêche précédente, est de retour en version 3.2.2 avec tout un tas de nouvelles fonctionnalités cool qu’on va voir ici.

Sommaire

Auto-rafraîchissement lors de la prévisualisation

Quand vous prévisualisez votre site avec venc -s vous n’avez plus besoin de tuer le processus du serveur HTTP local et de régénérer manuellement le site à chaque modification. Le mécanisme est à présent automatique et détecte lui-même un changement pour vous présenter la version à jour de votre contenu ! La cache du navigateur étant parfois capricieux, VenC vous notifie dans la sortie standard de ses actions si jamais vous avez un doute.

Assignation d’un thème par défaut

Si vous utilisez le thème par défaut concrete ou tout autre thème installé en dehors de votre projet il est possible de l’indiquer dans votre fichier de configuration. Ainsi venc -s sait comment régénérer votre site si nécessaire, et vous n’avez plus besoin d’indiquer le nom du thème installé sur votre système lorsque vous utilisez la commande venc -xb ou venc -xftp.

Amélioration des fonctionnalités FTP

Transfert en parallèle

De nombreuses améliorations ont été apportées, en voici quelques-unes !

Transfert parallèle

Vous pouvez maintenant définir un nombre arbitraire de connexions FTP simultanées pour le transfert de votre site en ligne. Pour un petit site, ça ne fait pas de grosse différence, mais quand comme moi votre site comporte plusieurs centaines de pages, ça fait gagner un temps fou !

Verbosité accrue

  • Affichage du prompt FTP
  • Affichage des commandes FTP associées à leur numéro de session

Transfert intelligent

Pour économiser de la bande passante, VenC compare les fichiers locaux avec ceux en ligne. Ce faisant, il ne réalise que les opérations d’I/O strictement nécessaires.

Configuration FTP plus fine

Vous pouvez maintenant paramétrer les options suivantes :

  • ftp_encoding : VenC affichant à présent le prompt FTP du serveur, il est maintenant possible d’avoir des informations sur celui-ci, et notamment l’encodage. Avec l’option ftp_encoding, il est donc possible de configurer l’encodage de la session pour être en phase avec le serveur distant et éviter de mauvaises surprises.
  • ftp_sessions : comme on l’a vu plus haut, c’est le nombre de connexions parallèles possibles.
  • ftp_port : avant, pour une raison obscure et injustifiable par le bon sens, le port de la connexion FTP était codé en dur… Maintenant c’est une valeur par défaut qu’il est possible de redéfinir.
Thème par défaut

Le thème par défaut a été amélioré, notamment au niveau de l’ergonomie et de la qualité visuelle du thème. Ce nouveau thème intègre par ailleurs les nouvelles fonctionnalités de la version 3.2 !

Nouvelles balises VenC

Microcode VenC

Accès amélioré à des métadonnées YAML

Une fonctionnalité ultérieurement manquante et utile dans certains cas d’usage est de pouvoir accéder à des valeurs qui sont imbriquées dans un ou plusieurs dictionnaires YAML dans le fichier de configuration principal ou dans les métadonnées d’une publication.

Pour ce faire, quatre fonctions VenC ont été ajoutés :

Pour les champs non obligatoires ou non prédéfinis par VenC, ça permet donc en conséquence une plus grande liberté dans l’organisation du contenu YAML.

Accéder à la date de la dernière publication

Utile pour la génération de flux Atom ou RSS, récupérer la date de la dernière publication d’un fil de publication permet d’indiquer la vraie date de mise à jour du flux :

GetLastEntryTimestamp

Taxonomie Avancée

Taxonomie Avancée

C’est la grosse fonctionnalité de cette mise à jour !

Avant la version 3.2 vous ne pouviez organiser vos publications “que” par catégories hiérarchisées. C’était déjà pas mal dans la mesure où ça permettait de créer des menus arborescents pour organiser votre contenu, mais parfois ça n’est pas suffisant. Par exemple, tout à fait au hasard, vous êtes un⋅e artiste et vous gérez votre portfolio avec VenC. Vous pourriez alors avoir un menu de la forme suivante pour organiser vos œuvres :

- Peintures
  - Huile
  - Acrylique
  - Aquarelle
- Dessins
  - Encre
  - Crayon
- Mediums Mixtes

Et comme vous êtes un⋅e bon⋅ne p'tit⋅e libriste auto-radicalisé⋅e sur Framasoft et LinuxFr vos œuvres sont en partie sous licence CC-By-SA. En partie seulement car oui, vous faites aussi des fanarts, des travaux dérivés d’œuvres sous licences propriétaires. Vous voulez donc séparer ce qui est véritablement libre de ce qui ne l’est pas. En générant par exemple ce type de menu :

# Mediums

- Peintures
  - Huile
  - Acrylique
  - Aquarelle
- Dessins
  - Encre
  - Crayon
- Mixtes

# Licences

- CC
  - By-NC-ND
  - By-SA
- Copyright
- Licence Art Libre

Ça tombe bien, c’est précisément ce que permet maintenant de faire VenC 3.2.

L’idée est la suivante : puisque l’arbre de toutes les catégories construit à partir de toutes les publications est un arbre hiérarchisé, il suffit de sélectionner une ou plusieurs branches de cet arbre pour créer nos menus et présenter notre contenu de la façon qu’il nous plaira.

Dans notre exemple précédent l’arbre hierarchisé de toutes les catégories aurait donc la forme suivante :

- Mediums:
  - Peintures:
    - Huile
    - Acrylique
    - Aquarelle
  - Dessins:
    - Encre
    - Crayon
  - Mixtes
- Licences:
  - CC:
    - By-NC-ND
    - By-SA
  - Copyright
  - Licence Art Libre

Nous sélectionnons donc les branches Mediums et Licences. Avec les nouvelles fonctions VenC qui vont bien :

Sur le thème par défaut concrete, vous pouvez ainsi avoir un nombre arbitraire de menu de catégories en configurant comme indiqué dans la documentation votre fichier de configuration principal.

À noter que même si ça n’est pas encore idéal, ce système ouvre la voie pour créer des blogs multilingues. Le brainstorming sur le sujet se passe ici. Pour l’heure, il est donc possible de tirer avantage de la taxonomie avancée pour créer des branches pour chaque langue que vous souhaitez utiliser. Avec un peu de JS vous pouvez aller plus loin pour rendre ça plus dynamique à votre convenance.

Le mot de la fin

Voilà pour cette nouvelle version !

La version 3.3 est déjà en cours de développement et vous pouvez suivre l’aventure ici. Un grand merci à Sidoine, Rollniak et Jérémy pour leur aide, leur confiance et leurs feedbacks !

Les sources GIMP des illustrations sont accessibles ici sous licences CC-By-SA

Toutes les contributions sont évidemment les bienvenues :

  • Corriger, relire ou améliorer la documentation.
  • Signaler des bugs ou faire des suggestions.
  • Écrire du code.
  • Me faire aumône pour me payer un p'tit shot de Baileys Irish Cream !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Petites brèves : forges, sécurité, Markdown, Asciidoc, K8S, crypto, IA, pourrissement du web
    Voici une sélection parmi ma veille du moment, ayant pour objectif de partager des liens mais aussi des sources : il s’agit bien évidemment de liens en rapport avec les thématiques du site (en l’occurrence dans cette fournée on trouvera logiciel libre, opendata, développement et vie privée par exemple), et ils sont plutôt variés ; les sources sont des sites web, des lettres d’actus et des réseaux sociaux (dans le cas présent, tous arrivés jusqu’à moi via des flux RSS/Atom), et c’est aussi une ma

Petites brèves : forges, sécurité, Markdown, Asciidoc, K8S, crypto, IA, pourrissement du web

Voici une sélection parmi ma veille du moment, ayant pour objectif de partager des liens mais aussi des sources : il s’agit bien évidemment de liens en rapport avec les thématiques du site (en l’occurrence dans cette fournée on trouvera logiciel libre, opendata, développement et vie privée par exemple), et ils sont plutôt variés ; les sources sont des sites web, des lettres d’actus et des réseaux sociaux (dans le cas présent, tous arrivés jusqu’à moi via des flux RSS/Atom), et c’est aussi une manière de les partager et de vous inviter à les suivre aussi. Dans la suite de la dépêche, on parlera donc en vrac GitHub, sécurité, Ruby, blocage de TikTok, Digital Services Act, biais, test, supervision, IA Act, Ada & Zangemann, pourrissement du web et bien d’autres choses encore.

Sommaire

En vrac

Des logiciels libres

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Pratiques dans l'industrie ferroviaire : un train de retard…
    Une histoire, comme il en est tant, hélas, de pratiques anticoncurrentielles dans l’industrie. Oubliez les imprimantes et les tracteurs, cette fois-ci, nous passons à une étape supérieure : les trains. Oui, oui, les trains, vous avez bien lu. Si les faits se confirment, un constructeur de train polonais aurait été pris en flagrant délit de pratiques anti-concurrentielles. Sommaire Les faitsPourquoi le train est tombé en panne ? Vérifier la date… Surprise matérielle Pas seulement à Wrocław La

Pratiques dans l'industrie ferroviaire : un train de retard…

Une histoire, comme il en est tant, hélas, de pratiques anticoncurrentielles dans l’industrie. Oubliez les imprimantes et les tracteurs, cette fois-ci, nous passons à une étape supérieure : les trains. Oui, oui, les trains, vous avez bien lu.

Si les faits se confirment, un constructeur de train polonais aurait été pris en flagrant délit de pratiques anti-concurrentielles.

    Sommaire

    Les faits

    Au printemps 2022, le premier des onze trains du modèle Newag Impuls 45WE, exploités par la compagnie régionale Koleje Dolnośląskie en Basse-Silésie, est en fin de vie. Leur maintenance est gérée par la société Serwis Pojazdów Szynowych, (SPS), qui a remporté l’appel d’offre, pour un prix total d’environ 5,1 millions d’euros (22 millions de złoty). Cette inspection est obligatoire, après un million de kilomètres. Le constructeur à l’origine des trains, la société Newag, a également participé à l’appel d’offres, mais leur prix était supérieur d’environ 696 000 € (3 millions de złoty).

    L’entretien d’un train est une affaire complexe : chaque pièce doit être démontée et envoyée aux fabricants concernés pour ensuite être ré-assemblées à leur retour. SPS effectue l’inspection conformément au manuel fourni, d’environ vingt mille pages. Une fois le premier train remonté, l’ordinateur de bord indique le succès de l’opération et la conformité de l’ensemble. Cependant, les onduleurs ne fournissent pas de tension aux moteurs et le train n’avance pas, sans que personne ne comprenne. Les techniciens de service recherchent, vérifient et re-vérifient les composants, parcourent les instructions – et ne trouvent aucune réponse.

    Koleje Dolnośląskie dispose de onze trains Impuls et, selon le calendrier, un autre est en cours de maintenance. Tandis que le premier est toujours immobilisé, le deuxième train arrive, subit la même révision, avec malheureusement, le même résultat. Tout fonctionnait parfaitement avant la maintenance, mais les moteurs refusent de démarrer une fois celle-ci terminée. Pour empirer la situation, le constructeur refuse d’aider.

    Nous avons maintenant deux trains à l’arrêt dans l’atelier. Le troisième rate l’inspection en raison d’une panne de batterie, et un quatrième train est envoyé à sa place. La société décide d’utiliser la quatrième pour remorquer une des locomotives en panne. Cependant, une fois connectée à l’une d’entre elle, la nouvelle locomotive s’arrête également, mais la raison semble différente et totalement inconnue.

    Pendant ce temps, dans un autre atelier, à Szczecin, une autre locomotive Impuls tombe en panne, dans des circonstances très similaires : elle ne redémarre pas après la maintenance.

    Le problème devient si grave que les médias s’en mêlent et relatent l’affaire. Les six trains les plus longs de Koleje Dolnośląskie étant hors service, les horaires doivent être réduits, des trains de remplacement doivent être envoyés, et les passagers s’entassent dans des trains trop courts. Newag explique que les trains sont bloqués par un « système de sécurité », mais rien n’est mentionné dans les pages du manuel.

    Chaque journée d’un train immobilisé dans l’atelier coûtant plusieurs milliers de zlotys en pénalités contractuelles, et avec plusieurs trains en attente, la tension chez SPS augmente. Le problème n’étant identifié ni par les mécaniciens ni par les électriciens, quelqu’un finit rechercher des hackers polonais, et contacte le groupe Dragon Sector. SPS prend donc contact avec eux, dont les représentants incrédules finissent par signer le contrat. Le projet est entrepris par des membres de Dragon Sector, spécialement ceux connus pour avoir hackés le BIOS de portables Toshiba — Michał « Redford » Kowalczyk et Sergiusz « q3k » Bazański. Kuba « PanKleszcz » Stępniewicz, qui a de l’expérience dans l’automatisation industrielle, se joint également à l’équipe.

    L’équipe se met rapidement au travail et Kuba part en voyage à l’atelier. Une fois sur place, ils reçoivent un train qui ne roule pas, deux ordinateurs de rechange et les fichiers SDK du fabricant de l’ordinateur. Ils commencent par écouter le bus de données CAN (Controller Area Network), mais sans information sur les protocoles, la tâche s’avère ardue. Ils tentent de télécharger le microcode de l’ordinateur de bord, mais la documentation du SDK permet uniquement les mises à jour, pas d’inspecter la version installée.

    La première tentative d’utilisation d’une ancienne version du micrologiciel, sur un ordinateur de rechange se solde par un échec : l’ordinateur ne répond plus. Ils trouvent finalement l’interface de débogage sur le dernier ordinateur de rechange, et octet par octet, en extraient la mémoire. L’ordinateur est basé sur l’architecture Infineon TriCore, souvent utilisée dans l’industrie automobile, et les chercheurs finissent enfin par examiner le code en utilisant une version modifiée de Ghidra.

    Les travaux avancent doucement, mais l’échéance approche et les trains tombent toujours en panne. Dos au mur, Koleje Dolnośląskie, décide de coopérer avec Newag sur l’entretien des trains en panne, y compris ceux qui, selon l’appel d’offres initial, devaient être entretenus uniquement par SPS. Le contrat devant être résilié d’ici une semaine, les chercheurs se mettent à travailler de plus belle.

    Le groupe est enfin en possession de tous les micro-logiciels des trains, autant ceux en état de marche que ceux en panne. Chacun des trains ayant des fonctionnalités particulières et une version différente du logiciel, l’analyse est difficile, mais ils commencent à identifier une piste. Entre un ordinateur en état de marche et un autre en panne, certaines plages de mémoire diffèrent. Une fois corrigées sur un ordinateur en panne, celui-ci démarre enfin. Le test étant effectué sur un ordinateur isolé sur un bureau, il s’arrête dès que le logiciel détecte qu’il manque le reste du train, mais il est prêt à faire fonctionner les onduleurs.

    Moins de 24 heures avant la date fatidique, les chercheurs identifient des paramètres supplémentaires pour faire démarrer le train. Malheureusement, le condensateur du dernier ordinateur de bord en état de marche brûle pendant les expériences. Après un nouveau brainstorming et de nombreuses tentatives pour combiner deux ordinateurs endommagés en un seul, le premier est réparé, et à 2 heures du matin, la veille de l’heure apocalyptique, les chercheurs configurent l’ordinateur qui fera démarrer le train.

    Un de nos héros monte à bord d’un train (d’une autre compagnie) pour rejoindre l’atelier avec un ordinateur probablement en état de marche devant les représentants des chemins de fer de Basse-Silésie, qui ont annoncé leur visite pour 9h30. Malheureusement, le train que prend le chercheur pour se rendre sur place est en retard. Finalement, dans la matinée, un chercheur équipé d’un ordinateur arrive sur les lieux et le connecte au train en panne. Et celui-ci ne bouge pas… Un autre brainstorming identifie le dernier drapeau oublié et à 8h42 le train parvient enfin à démarrer !

    La délégation de Koleje Dolnośląskie, voyant à 9h30 que les trains ont une chance de reprendre vie, ne résilie pas le contrat avec SPS.

    Pourquoi le train est tombé en panne ?

    Déterminer comment faire démarrer le train ne représentait qu’une petite partie du problème. Il fallait maintenant découvrir pourquoi il était tombé en panne.

    Des mois d’analyse et de rétro-ingénierie ont permis de révéler des conditions extrêmement intéressantes inscrites dans le code logiciel de différents trains fournis par Newag. Après des centaines d’heures passées à étudier les codes émis par des dizaines de trains, il a été possible d’identifier des mécanismes provoquant des pannes soudaines dans les trains.

    Les valeurs numériques 53,13845 et 17,99011 trouvées dans le code informatique semblaient familières à première vue. Il s’est rapidement avéré qu’il s’agissait de coordonnées GPS, indiquant les environs de la gare de Bydgoszcz Główna, ou, plus précisément, le centre de service PESA situé juste à côté. Bientôt, les coordonnées d’autres services susceptibles d’effectuer des réparations et des inspections de trains en Pologne ont également été trouvées. Ci-dessous, nous montrons le pseudo-code de l’algorithme :

    check1 = 53.13845 < lat && lat < 53.13882 && 17.99011 < long && long < 17.99837 ;
    check2 = 53.14453 < lat && lat < 53.14828 && 18.00428 < long && long < 18.00555 ;
    check3 = 52.17048 < lat && lat < 52.17736 && 21.53480 < long && long < 21.54437 ;
    check4 = 49.60336 < lat && lat < 49.60686 && 20.70073 < long && long < 20.70840
    && (this->lock_function_test & 1) ;
    check5 = 53.10244 < lat && lat < 53.10406 && 18.07817 < long && long < 18.08243 ;
    check6 = 50.12608 < lat && lat < 50.12830 && 19.38411 < long && long < 19.38872 ;
    check7 = 52.77292 < lat && lat < 52.77551 && 18.22117 < long && long < 18.22724 ;

    Les paires de coordonnées définissent les zones d’atelier. Il existe une condition inscrite dans le code informatique qui exige que le train soit désactivé s’il passe au moins dix jours dans l’un de ces ateliers. L’un des ateliers appartient à Newag lui-même - mais une condition logique différente a été définie pour ses coordonnées, probablement à des fins de test.

    D’autres surprises furent bientôt découvertes. Il s’agissait notamment du blocage du train lorsqu’un de ses composants (vérifié par son numéro de série) était remplacé. Une option permettant d’annuler le verrouillage a également été découverte — cela ne nécessitait pas de définir des indicateurs au niveau de la mémoire de l’ordinateur, mais uniquement la séquence appropriée de clics sur les boutons dans la cabine et sur l’écran de l’ordinateur de bord.

    Lorsque les informations sur le lancement réussi des trains Impuls sont parvenues aux médias, les trains ont reçu une mise à jour logicielle qui supprimait cette possibilité de « réparation ». Un code a été trouvé sur un autre train lui indiquant de « casser » après avoir parcouru un million de kilomètres.

    Vérifier la date…

    Une situation assez cocasse a été rencontrée dans une autre escouade qui a refusé de démarrer, le 21 novembre 2022, alors qu’elle n’était pas sur place à ce moment-là. L’ordinateur signale une panne du compresseur, les mécaniciens n’ont, pourtant, identifié aucune panne sur le compresseur. Les pantographes ne fonctionnant toujours pas, l’analyse du code informatique a détecté une condition de crash suivante, qui signalait une panne de compresseur :

    si le jour est supérieur ou égal au 21 et
    si le mois est supérieur ou égal à 11 et
    si l’année est supérieure ou égale à 2021

    La situation était amusante, car le train devait être inspecté en novembre 2021 (un an avant la panne), mais par coïncidence, la condition n’a pas fonctionné. Le train a été entretenu un instant plus tôt et n’a été relancé qu’en janvier 2022 - et cette date ne répondait plus à la condition logique sophistiquée décrite ci-dessus. C’est probablement l’incapacité de l’auteur du logiciel à écrire correctement des conditions qui a obligé à attendre le 21 novembre 2022 pour que l’on puisse constater l’effet prévu.

    Surprise matérielle

    Les surprises ne se cachent pas seulement dans les logiciels informatiques. Dans l’un des dépôts, les chercheurs ont découvert un dispositif signé comme « convertisseur UDP / CAN », permettant vraisemblablement une communication à distance avec le train. Le supprimer n’a pas empêché quoi que ce soit de fonctionner. L’analyse a montré que l’ordinateur de bord envoyait des informations sur l’état du verrouillage à cet appareil et que l’appareil lui-même était connecté à un modem GSM.

    Pas seulement à Wrocław

    L’information selon laquelle le service SPS avait réussi à réparer les trains Newag « cassés » est rapidement parvenue à d’autres services. Cela s’est avéré être un problème assez courant. À Wrocław, ils ont analysé 13 rames Impuls, mais celles qui circulaient à Koleje Mazowieckie sont également tombées en panne (une unité), deux à Opole, quatre à Cracovie, une à Zielona Góra, quatre à Szczecin et une à SKM. Heureusement, chacune a été réparée à l’aide d’un outil développé par nos chercheurs, qui supprime les verrous logiciels de l’ordinateur de bord. Au total, nos collègues ont analysé le logiciel de 29 trains, et seulement cinq ont trouvé des surprises allant au-delà des instructions d’exploitation officielles.

    La suite

    Nous laissons l’évaluation des solutions utilisées par le fabricant aux lecteurs et clients de cette entreprise. Il est intéressant de noter que, même si des poursuites judiciaires sont en cours, il est difficile de trouver en Pologne une institution qui ferait autre chose qu’exprimer un intérêt amical dans cette affaire.

    Nous n’avons connaissance d’aucune mesure prise par « l’Office de la protection des consommateurs et de la concurrence », ni par « l’Office du transport ferroviaire », qui semble pourtant appropriée. Cette dernière à pour rôle de surveiller les pratiques des sociétés qui travaillent avec les organisations gouvernementales locales. Que des voyageurs aient subi des désagréments ou forcés à utiliser des transports alternatifs pendant des mois semble pourtant éligible à un dédommagement.

    La seule institution connue à avoir pris des mesures est le CERT Polska, qui a été informé de la découverte par les chercheurs. Le commentaire que nous avons reçu montre que CERT Polska a informé les « autorités compétentes » et que l’affaire est traitée par les autorités chargées de l’application de la loi.

    Nous félicitons les meilleurs hackers polonais pour leur découverte intéressante et l’exécution professionnelle de la commande. Décidément rien n’est plus motivant qu’une date limite demain matin.

    L’article ci-dessus n’est qu’un bref résumé de la présentation donnée lors de la conférence Oh My H@ck le 5 décembre 2023 par les membres de l’équipe : Jakub Stępniewicz, Sergiusz Bazański et Michał Kowalczyk. L’article a omis de nombreux détails et une grande partie technique de l’analyse — nous ne pouvons qu’espérer que cela motivera les auteurs de l’étude à rédiger et publier son cours. Mis à jour le 05/12/2023 à 16h00

    Réponse de l’Office des transports ferroviaires (UTK)

    Nous avons reçu la position officielle de l’Office des transports ferroviaires (UTK), que nous citons intégralement ci-dessous :

    Le président de l’UTK est au courant de l’affaire et a vérifié les informations concernant les analyses effectuées sur les logiciels des véhicules ferroviaires et coopère également avec les services compétents à ce sujet. En collaboration avec CERT Polska (une équipe créée pour répondre aux incidents violant la sécurité Internet), une réunion avec le constructeur ferroviaire a été organisée. Les véhicules répondent aux exigences essentielles précisées dans les dispositions des directives européennes. C’est la personne qui commande le véhicule qui détermine les conditions de service et de garantie dans le cadre de la liberté contractuelle. Ces exigences sont incluses dans les contrats d’achat de trains. Toute limitation des capacités de service, y compris les limitations introduites dans le logiciel, peut constituer un éventuel litige civil entre le client et le fabricant. Le président de l’UTK n’est pas l’autorité compétente en la matière.

    Conformément à l’art. 41 alinéa 2 de la loi du 5 juillet 2018 relative au système national de cybersécurité (texte consolidé : Journal des lois de 2023, articles 913, 1703), l’autorité chargée de la cybersécurité du secteur des transports (hors sous-secteur du transport par eau) est l’autorité compétente en matière de cybersécurité.
    Ministre chargé des questions de transports.

    Liens

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • VenC 3.1.1 | Un nouveau générateur de site statique
      On va présenter ici un nouveau générateur de site statique, écrit en python. Il n’est pas exactement nouveau au sens où nous en sommes à la version 3, mais jusqu’ici le projet est resté relativement confidentiel. Nous parlerons également des perspectives d’évolution de ce projet. lien nᵒ 1 : Site et documentation du projet VenClien nᵒ 2 : Code source de VenC sur Githublien nᵒ 3 : Code source de VenC sur Framagitlien nᵒ 4 : Mistletoelien nᵒ 5 : Docutilslien nᵒ 6 : Latex2MathMLlien nᵒ 7 : Pygmen

    VenC 3.1.1 | Un nouveau générateur de site statique

    VenC

    On va présenter ici un nouveau générateur de site statique, écrit en python. Il n’est pas exactement nouveau au sens où nous en sommes à la version 3, mais jusqu’ici le projet est resté relativement confidentiel. Nous parlerons également des perspectives d’évolution de ce projet.

    Sommaire

    Introduction et petit historique

    Introducing VenC

    VenC est un énième générateur de site statique (libre, évidemment !) dont le nom étrange provient d’un rêve dans lequel je naviguais sur un réseau social appelé « V en C ». Ce rêve, ainsi que la forme et le contenu de ce réseau, m’avaient marqué. Rétrospectivement, ça ressemblait un peu aux premières heures glorieuses de Tumblr / Skyblog avec un petit côté web oldschool.

    De gros projets historiques sont déjà bien installés dans le game. Par ailleurs, si j’en crois le nombre d’annonces de logiciels de ce type ici, ça ressemble un peu à un running gag d’arriver avec ma proposition !

    Je tenais quand même à présenter l’ouvrage, car il s’agit d’un projet qui me tient toujours beaucoup à cœur et avec lequel j’ai notamment appris le langage Python et pour lequel je continue de progresser. Je l’ai commencé au début des années 2010 précisément quand on voyait émerger ce type d’outil, pour une approche plus “lightweight” du web. Ça n’est que récemment que j’ai ambitionné de rendre ce projet public.

    La version 2 est la première que j’ai partagée sur mes réseaux sociaux (Diaspora* et Mastodon). C’était un peu la bêta de la version actuelle, où de grandes restructurations de code avaient été réalisées, fort d’une plus grande expérience en Python. Ça ne m’a pas empêché d’introduire de la dette technique corrigée plus tard, et dans sa plus grande partie je l’espère, dans la version actuelle. J’avais également ajouté une fonctionnalité un peu expérimentale, dont on reparlera plus bas.

    Globalement la v1 et la v2 sont restées assez confidentielles. Trop de bugs, pas correctement documentées et pas assez adaptées aux multiples et imprévisibles usages que peuvent avoir les utilisateurs finaux. Certaines questions de choix technico-philosophiques restées en suspens sont encore d’actualité et doivent être décidées par ceux qui l’utilisent. En d’autres termes, je souhaite élargir les possibilités qu’offre VenC en l’adaptant aux besoins des autres, et non plus seulement aux miens.

    La version 3.1.0 a été mise en ligne le 30 décembre 2023 et j’estime le projet suffisamment mature (en toute modestie) pour être partagé avec vous. Mon idée étant de proposer l’existant, et de réfléchir avec vous avec les perspectives que j’ai en tête ou que vous pourriez vouloir voir implémentées ! C’est également l’occasion pour moi de bénéficier d’un éventuel retour d’expérience, d’une relecture de code ou de la documentation, et améliorer l’existant.

    Que permet de faire VenC ?

    Create blog in five minutes !

    Il s’agit donc d’un générateur de site statique orienté blog proposant les fonctionnalités suivantes :

    • Des balises VenC permettant une mise en page et une intégration de contenus avancés.
    • La possibilité de créer un agencement de publication en nombre arbitraire de colonnes.
    • Un module et une API JavaScript de défilement infini.
    • Les publications peuvent être organisées par catégories, sous-catégories, par période de dates et par chapitres.
    • La possibilité de désactiver des fils de publications spécifiques.
    • La possibilité de configurer des sous-répertoires pour chaque type de publications.
    • La possibilité d’ajouter des métadonnées au blog et aux publications.
    • Les publications sont triées par ordre chronologique par défaut, mais peuvent l’être aussi en fonction de métadonnées. L’ordre peut être ascendant ou descendant.
    • La génération de flux Atom et/ou RSS pour chaque fils de publications.
    • Des permaliens.
    • Un serveur HTTP simple pour effectuer des tests et prévisualiser le site.
    • La gestion et l’édition du blog peuvent être faites entièrement en ligne de commande, dans un environnement non graphique.
    • Le support de Markdown, reStructuredText, AsciiDoc.
    • La mise en ligne du site peut se faire en FTP via VenC.
    • Le support de pygmentize pour la coloration syntaxique.
    • Le support de l’API oEmbed.
    • Le support de l’API Kroki.
    • Le support de contenus audio et vidéo via les balises VenC.
    • Installation facilitée via pip et pipx.

    Faster, smaller, stronger

    VenC Install Party

    À noter qu’ayant à cœur l’optimisation et la performance, l’essentiel du travail réalisé sur cette version 3.1.0 à été l’intégration d’un mode de génération parallèle pour accélérer l’exportation de votre projet. En fait sur ce dernier point, l’ambition est de faire en sorte que VenC puisse passer à l’échelle en tirant parti des threads Python du module multiprocessing de Python. Nous en reparlerons plus bas.

    J’ai passé de longues heures à optimiser l’ensemble du code comme je l’avais déjà fait entre la v1 et la v2. Mon propre site contenant énormément de pages, j’ai besoin d’une application rapide et simple pour générer celui-ci. Il y a quelque chose de très satisfaisant à travailler en ce sens. Tout en mesurant les limites de la chose et en découvrant qu’un excès de zèle rend le code incompréhensible bien sûr… Avec cette v3 je pense avoir atteint un équilibre. En termes de rapidité, la force de VenC réside aussi dans le fait qu’il possède sa propre syntaxe de balisage pour la mise en forme (pas de Jinja donc). Le moteur de template étant ici taillé sur mesure et fortement couplé à l’application, ça tourne très très vite ! Voir la documentation de la syntaxe VenC.

    Si jamais ça vous intéresse, il est envisageable de découpler cette partie spécifique du code pour être utilisé ailleurs que dans VenC.

    Travaux et réflexion en cours, le futur de l’application
    Learning VenC

    Le moteur de recherche client-side.

    Dans la v2 j’avais introduit une fonctionnalité expérimentale permettant de générer des documents JSON-LD au format JSON ou JSONP. Cette fonctionnalité a été retirée depuis, parce que je ne suis plus sûr de la pertinence de cette technique pour le projet initial : celui d’implémenter un moteur de recherche client-side décentralisé. Ce moteur de recherche devait permettre de chercher du contenu sur un site, mais aussi sur celui des amis, pour lesquels les end-points seraient manuellement ajoutés par le propriétaire du site. Ce faisant, cela permettrait de créer un réseau de site qu’il est possible de crawler pour trouver du contenu.

    Il se pourrait que JSON-LD ne soit en fait pas le meilleur moyen pour ce genre d’usage. Mais je n’en sais trop rien, qu’en pensez-vous ?

    Intégration avec le Fediverse
    Un truc que j’ai toujours trouvé chouette avec Tumblr, c’est le fait d’avoir une page hautement personnalisable qui fait néanmoins partie d’un tout qu’il est possible d’explorer avec le moteur de recherche interne du service. En ce sens, cette idée rejoint celle concernant le moteur de recherche client-side décentralisé.
    Avec l’émergence de Fediverse, ça serait en fait intéressant de voir comment il est possible d’intégrer VenC à ce type de réseau. Mon idée initiale était de créer une surcouche de VenC, une sorte de serveur, avec un frontend web, gérant plusieurs sites et capable de répondre dynamiquement à des requêtes des APIs du Fediverse. On comprend ici qu’un tel serveur pourrait avoir à gérer des dizaines, voire des centaines de sites, le parallélisme fraîchement implémenté dans la v3 prend tout son sens.

    La question de comment explorer du contenu gérer par VenC de façon décentralisé, modulaire, et interopérable étant le grand axe d’évolution de VenC qui me tient à cœur. Je souhaite recréer ce réseau dont j’avais rêvé il y a longtemps.

    Sites statiques, deepweb et smolweb

    VenC Is Small

    Le smolweb, c’est vraiment cool. Par certains aspects il ressemble aussi un peu au deepweb, lui aussi très intéressant pour d’autres raisons. Les propositions de ces réseaux étant toujours plus d’actualités à mesure que les années passent…

    De ce que j’ai pu voir du deepweb, beaucoup de sites sont en fait statiques et d’apparence très sobre, ce qui ne manquera pas de faire vibrer la fibre nostalgique de ceux qui ont connu le web des années 1990 et 2000. Quelle époque ! Dans les deux types de réseau on retrouve deux aspects qui me tiennent à cœur, le green IT pour l’un et la vie privée pour l’autre. Des valeurs dans lesquelles je me retrouve évidemment, et pour lesquelles je souhaiterais que VenC apporte sa pierre à l’édifice.

    Une des perspectives d’évolution de VenC serait de pouvoir faire en sorte qu’il puisse générer des sites spécifiquement pour les différents types de smolweb : Gopher, Gemini… Mais je ne connais pas bien le fonctionnement de ceux-là, c’est donc encore à l’étude.

    Et le format EPUB ?

    Puisque VenC gère le chapitrage de son contenu, ça pourrait avoir du sens de pouvoir générer des documents EPUB. Et comme ce format est en fait du contenu HTML embarqué dans un zip… Il n’y a plus qu’à étudier les spécifications du format, et au boulot. Mais peut-être qu’il existe déjà un module ou package Python pour ce genre de chose ? Tout ça est aussi à l’étude.

    Internationalisation des articles

    Le besoin étant d’avoir plusieurs versions d’un même article dans des langues différentes, il y a plusieurs façons de réaliser ça… Ça n’est donc pas une feature triviale.

    Ça pourrait m’aider de me parler un peu de la façon dont vous voyez la chose pour un blog statique.

    Fonctionnalités de base manquantes

    La plupart des générateurs de sites statiques ont cette fonctionnalité, mais pas VenC. Pas encore en tout cas, mais c’est dans les tuyaux !

    Génération incrémentale et mise en cache.

    VenC Is Fast

    Au lieu de régénérer tout le site à chaque modification, VenC ne devrait modifier que le strict nécessaire. Une mise en cache des pages à certaines étapes de la génération du site pourrait être mise en œuvre pour accélérer le traitement.

    Auto-rafraîchissement lors de la prévisualisation

    Cette fonctionnalité va de pair avec la précédente, lorsque le site est prévisualisé il devrait s’auto-régénérer quand une modification est faite.

    Ajout de modules tiers écrit par les utilisateurs eux-mêmes

    VenC Is Written In Python

    Pour le moment VenC n’a pas de greffons autres que ceux déjà prévus par l’application, mais les futures versions bénéficieront d’une API permettant d’écrire vos propres fonctionnalités.

    Le mot de la fin

    J’ai à cœur de rendre ce logiciel accessible dans d’autres langues, pour la traduction de la documentation et du logiciel lui-même, je cherche des personnes pouvant justifier d’une capacité professionnelle de traduction dans une langue ou une ou autre. L’anglais et l’allemand seraient par exemple un bon début. Ce travail serait naturellement rémunéré. N’hésitez pas à me contacter si vous pensez avoir la compétence requise pour que nous en discutions.

    Cette v3 a demandé beaucoup d’efforts, j’espère que ce logiciel trouvera ses utilisateurs ! J’en profite pour remercier les contributeurs qui croient en ce projet et notamment Jérémy Berry pour ses conseils et sa précieuse relecture, Sidoine Baratte qui suit le projet depuis le début et avec qui j’ai affronté les bugs ainsi que benben962 pour sa traduction en anglais de l’ancienne documentation !

    Ressources du projet

    Illustrations

    Les sources des illustrations :

    Modules optionnels

    • Mistletoe : Pour l’utilisation de la syntaxe Markdown.
    • Docutils : Pour utiliser la syntax reStructuredText.
    • Latex2MathML : Pour convertir du LaTeX en MathML.
    • Pygments : Pour la coloration syntaxique.
    • AsciiDoc3 : Pour utiliser la syntaxe Asciidoc

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    ❌
    ❌