Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierLinuxFr.org : les dépêches
  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 36 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Courrier international] DJ, cocktails et open source: aux États-Unis, des ateliers de cybersécurité se tiennent dans des bars (€) [L'usine Nouvelle] Nvidia confirme acquérir la plateforme de modèles d’IA Hugging Face:

Revue de presse de l’April pour la semaine 36 de l’année 2026

Par : echarp
7 septembre 2026 à 12:21

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Courrier international] DJ, cocktails et open source: aux États-Unis, des ateliers de cybersécurité se tiennent dans des bars (€)

✍ Ellen Ioanes, le samedi 5 septembre 2026.

Après plus d’une décennie de scandales ayant mis en lumière la surveillance numérique de masse à laquelle ils sont exposés, de plus en plus d’Américains se disent inquiets pour leur cybersécurité. Pour apprendre à “reprendre le contrôle de leur vie numérique”, des ateliers, conférences et soirées festives se multiplient dans les grandes villes, raconte le journal britannique “The Guardian”.

[L'usine Nouvelle] Nvidia confirme acquérir la plateforme de modèles d’IA Hugging Face: un rachat pour défendre l’open source… et servir ses intérêts commerciaux

✍ Marion Garreau, le jeudi 3 septembre 2026.

Nvidia, le leader mondial des puces pour l’IA, a confirmé jeudi 3 septembre l’acquisition du franco-américain Hugging Face, une plateforme de distribution de modèles d’IA, pour 12,9 milliards de dollars. Un rachat qui renforce la stratégie dans l’open-source du mastodonte américain, et qui vient aussi servir ses intérêts commerciaux.

Et aussi:

[Silicon.fr] Open source et secteur public: pourquoi ce n'est pas si facile

✍ Clément Bohic, le mercredi 2 septembre 2026.

Les auditions de la commission parlementaire sur les dépendances numériques ont témoigné des défis que pose, dans la sphère publique, le déploiement de l’open source.

[Le Monde.fr] ChatGPT va être la première IA soumise à des règles renforcées au sein de l’Union européenne, Roblox et Reddit également concernés

Le lundi 31 août 2026.

Les trois services disposent de quatre mois, soit jusqu’à la fin décembre, pour se ‌conformer aux obligations ‌supplémentaires prévues par le Digital Services Act.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Présentation de SlyOS, un système basé sur Arch linux équipé d'OpenRC, ReGreet et niri
    Arch Linux est une distribution très connue pour être une bonne base permettant de créer son propre système Linux personnalisé de fond en comble. La possibilité d’y ajouter des logiciels libres peu connus du grand public via l' AUR est l’une des grandes forces d’Arch Linux. J’ai donc une vision personnelle assez précise du bureau Linux idéal, et je souhaite la partager ici en vous présentant un projet sur lequel je travaille depuis un peu moins d’un an, presque non-stop. Ma propre distribution

Présentation de SlyOS, un système basé sur Arch linux équipé d'OpenRC, ReGreet et niri

Arch Linux est une distribution très connue pour être une bonne base permettant de créer son propre système Linux personnalisé de fond en comble. La possibilité d’y ajouter des logiciels libres peu connus du grand public via l' AUR est l’une des grandes forces d’Arch Linux.

J’ai donc une vision personnelle assez précise du bureau Linux idéal, et je souhaite la partager ici en vous présentant un projet sur lequel je travaille depuis un peu moins d’un an, presque non-stop. Ma propre distribution Linux : SlyOS, un système d'exploitation libre distribué sous licence GPLv3.

Par exemple, voici quelques logiciels disponibles dans l'AUR : DeaDBeeF, Cine, Warehouse, Carburetor, …

Arch Linux est aussi une distribution valorisée par son choix presque illimité d'environnements de bureau. En effet, on peut prendre l'exemple de mon expérience personnelle sur ce point.

J’ai tout d'abord commencé par découvrir GNOME. Son interface m’a immédiatement convaincu et il reste aujourd’hui l’un de mes environnements de bureau préférés. La principale réserve que j’ai à son sujet concerne sa dépendance trop marquée à plusieurs composants de systemd (j’expliquerai plus tard dans la dépêche ce qui me tracasse vraiment à ce sujet).

GNOME

J’ai ensuite essayé plusieurs environnements de bureau moins répandus, notamment Pantheon. Je reste particulièrement attaché à son interface, mais j’ai fini par l’abandonner en raison de bugs que j’ai rencontrés avec le compositeur Gala, ainsi que des difficultés liées à la transition de X11 vers Wayland. Cette transition a notamment retiré Plank, que j’appréciais beaucoup, sans vraiment lui apporter de remplaçant…

Pantheon

Ou encore moins connu : herbstluftwm que j'aimais beaucoup mais que j'ai fini par abandonner aussi à cause du manque d'outils de personnalisation sur X11 pour un gestionnaire de fenêtre si minimal.

herbstluftwm

J'ai aussi testé plein d'autres gestionnaires de fenêtre et de d'environnements de bureau tels que Cinnamon, Xfce, Hyprland, Fluxbox, LXQt, MATE, Sway, IceWM

Avec le temps, j'ai façonné quelques opinions sur les différentes options que nous propose la communauté. Par exemple, cela peut en affecter certains, mais j’essaie d’éviter Qt au maximum et de privilégier GTK. Ma position concerne principalement le modèle économique de Qt : je ne reproche pas à un projet libre de chercher à se financer, mais Qt repose notamment sur les revenus provenant de logiciels propriétaires et de licences commerciales (proposant des offres payantes sur son site web). Je préfère donc soutenir des projets qui privilégient d’autres modèles, comme les dons, à l’image de ce qui existe autour de GTK. Ma position peut paraître controversée, notamment parce que l’écosystème Linux dépend lui aussi largement de grandes entreprises (comme Google, ou même Microsoft qui détient GitHub). Je ne prétends donc pas pouvoir éviter toute dépendance de ce type, mais j’essaie, autant que possible, de privilégier des logiciels et des projets capables de subsister sans être directement financés par le logiciel propriétaire.

De même, je n’aime pas vraiment systemd car c'est de plus en plus un programme qui obtient le monopole, avec une étendue de fonctionnalités et une complexité qui s'éloignent du principe KISS. Surtout que récemment, systemd a été au cœur de débats controversés, notamment à travers une proposition de vérification de l’âge intégrée directement à celui-ci. Le problème n’est pas uniquement l’existence de ce champ optionnel (birthDate), mais le fait que systemd puisse devenir un point central pour intégrer ce type de mécanisme à l’avenir. C'est pourquoi je préfère limiter les composants centraux aux fonctions dont le système a réellement besoin.

Cette problématique de vérification d'âge ne se limite d'ailleurs pas à systemd : le plus gros problème actuel est aussi xdg-desktop-portal. Mais il est à l'heure actuelle compliqué de changer cela, puisque xdg-desktop-portal est une dépendance presque cruciale dans Arch Linux. Un paquet alternatif contenant un patch pourrait être envisageable dans le dépôt de SlyOS via notamment l'alternative de xdg-desktop-portal Ageless Linux, mais je n'ai pas vraiment le temps d'accomplir cela pour l'instant.

J'ai dû parfois remettre en question certaines de mes opinions comme ma préférence à X11. Cela a par exemple opéré quand j'ai découvert niri et la stabilité et fluidité de Wayland nettement supérieure à X11.

niri

SlyOS
SlyOS est basé sur Arch Linux et construit à l’aide d’archiso. Le projet a commencé comme une expérience personnelle pour en apprendre davantage sur Linux. Je me suis rendu compte par la suite qu’il y avait un réel intérêt à proposer ma vision du bureau Linux parfait, car je ne l’avais étrangement vue nulle part ailleurs (par défaut dans un système d'exploitation).

Je sais que les concepts revendiqués par une distribution peuvent paraître flous ou consensuels (moderne, léger, simple à utiliser, intuitive, personnalisable, performant, stable, respectant le principe KISS), mais dans SlyOS, chacun de ces principes correspond à des choix concrets et justifiés qui permettent à SlyOS d'être une distribution :

  • Moderne : SlyOS propose niri, un gestionnaire de fenêtres entièrement basé sur Wayland, relativement récent, qui a déjà fait ses preuves (notamment par sa popularité en croissance exponentielle) et qui bénéficie d’un développement actif.

  • Légère : la version minimale de SlyOS contient moins de 700 paquets, tandis que la version complète en contient moins de 850. Les ISO sont nettement plus légères que celles de nombreuses distributions x86_64, réduisant les composants susceptibles de poser problème, sans pour autant supprimer les fonctionnalités essentielles.

  • Simple d’utilisation et intuitive : SlyOS propose un programme d’accueil dès le live ou après l'installation, présentant les raccourcis principaux. Le système peut être utilisé sans ligne de commande grâce à Pamac. Le bureau minimal et l'accès aux paramètres permettent à un débutant de prendre le système en main rapidement.

  • Performante et stable : SlyOS utilise le noyau linux-cachyos-lts pour un bon compromis performances/stabilité. La consommation de RAM au démarrage est très basse grâce à un nombre limité de services en arrière-plan grâce à l'esprit minimaliste de SlyOS.

  • Personnalisable : SlyOS s’appuie sur des outils Wayland comme Ironbar, Wofi, Hyprlock ou Vibepanel. Ils offrent un environnement complet tout en laissant une grande liberté de modification (ils peuvent être désinstallés et remplacés). Le choix de niri facilite également cette personnalisation profonde puisque largement reconnu dans le domaine du "Rice".

  • Respectueuse de la vie privée : remplacer systemd par OpenRC est une première marche vers une meilleure protection de la vie privée dans un système Linux. De plus, SlyOS contient LibreWolf, un navigateur axé sur la vie privée bloquant le pistage, ainsi que les extensions uBlock Origin (bloqueur de pubs et traqueurs efficace) et Decentraleyes (empêche le suivi par les CDN en servant les ressources localement). Il intègre aussi le DNS Mullvad Base qui chiffre vos requêtes DNS pour empêcher les écoutes et les fuites de données vers votre FAI.

  • Suivre le principe KISS en évitant systemd (plus d'informations ici) : SlyOS utilise OpenRC, un système d'initialisation qui suit une approche plus modulaire et plus proche du principe KISS que systemd, régulièrement critiqué pour son poids et sa complexité. Ce choix permet d'éviter de renforcer la position dominante de systemd tout en limitant les risques de dérive (comme l'intégration d'un champ birthDate).

À ses débuts, la distribution ne respectait pas entièrement tous ces critères. Elle utilisait GNOME / MATE, avec systemd ainsi que le noyau linux-cachyos-lts.

La distribution ressemblait à ceci à ses débuts, dans sa version 0.1 « Dxtrus » (pour "dexterous" en anglais) :

SlyOS

SlyOS

Depuis, le projet a considérablement évolué et est progressivement devenu un système plus complet et abouti, illustrant concrètement la direction prise par SlyOS. La version 0.2 « Invativ » (pour "innovative" en anglais) utilise désormais :

  • niri comme gestionnaire de fenêtres
  • OpenRC comme système d’initialisation
  • ReGreet, une interface de connexion en GTK4 écrite en Rust pour greetd
  • Le noyau linux-cachyos-lts
  • Plymouth pour afficher un écran graphique lors du démarrage et de l’arrêt du système

Voici à quoi ressemble la distribution depuis :

SlyOS

SlyOS

La distribution inclut également un centre de contrôle appelé Thymbr, qui permet de configurer de nombreux aspects du système depuis une interface centralisée. Cela rend SlyOS bien plus intuitif et simple d’utilisation, bien que le caractère intuitif se juge surtout à l'utilisation.

Le site web du projet est disponible ici

Je vous conseille d’y jeter un coup d’œil. Le site propose une version française et fournit des explications plus approfondies sur le projet, notamment à travers les principes présentés sur la page d’accueil ainsi que la FAQ, accessible dans la catégorie « Aide ». Le meilleur moyen de se faire une opinion reste de tester SlyOS, par exemple dans une machine virtuelle.

La configuration archiso est disponible sur Codeberg : https://codeberg.org/Minaucro/SlyOS

Je travaille à rendre SlyOS pratique, optimisé, simple et performant, selon ma propre vision d’un système d’exploitation Linux destiné aux ordinateurs de bureau. Le projet est encore en développement, mais il est déjà suffisamment mature pour être testé et utilisé au quotidien.

Merci d’avoir pris le temps de me lire.


SlyOS a été créé par Minaucro (slyos@minaucro.fr).

Commentaires : voir le flux Atom ouvrir dans le navigateur

Podcast Projets Libres épisode 73 : Kernel Recipes, la conférence technique autour du noyau Linux en France

Podcast Projets Libres épisode 73 : Kernel Recipes, la conférence technique autour du noyau Linux en France

Depuis 13 ans, Kernel Recipes est la conférence technique sur le noyau Linux en France.

Nous avons invité Anne Nicolas, créatrice de l'évènement, à venir raconter l'histoire de Kernel Recipes, de son idée née autour d'un barbecue à son édition 2026.
Vous découvrirez aussi ce qui rend cette conférence différente des autres !

L'édition 2026 aura lieu du 21 au 23 septembre 2026.

Une transcription complète, agrémentée de vidéos, est, comme d'habitude disponible pour cet épisode.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !
    Bonsoir à toutes et à tous ! Après un démarrage « maladroit » en avril dernier (en clair on s’est pris une volée de bois vert 😂), nous avons revu drastiquement notre « copie » et nous sommes fiers de vous présenter notre nouveau site et ses nouvelles ressources. Notre objectif reste le même : multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier ! Le Libre, on en parle beaucoup tout comme la souveraineté numérique mais concrètement la route est longue, trop longue et parfois in

Multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !

Bonsoir à toutes et à tous !

Après un démarrage « maladroit » en avril dernier (en clair on s’est pris une volée de bois vert 😂), nous avons revu drastiquement notre « copie » et nous sommes fiers de vous présenter notre nouveau site et ses nouvelles ressources.

Notre objectif reste le même : multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !

Le Libre, on en parle beaucoup tout comme la souveraineté numérique mais concrètement la route est longue, trop longue et parfois inaccessible pour des populations loin des grandes métropoles où l’on trouve désormais de nombreuses associations et collectivités qui promeuvent et qui portent assistance à la population pour faire revire leur PC et entrer dans un monde numérique plus « juste » et plus respectueux de notre vie privée et de notre planète.

Certains disent que le PC est mort, mais nous, nous le pensons pas ! Cette machine à écrire des temps modernes a du sens : le partage des savoirs et des savoir-faire, la création. De part leur essence, la plupart des distributions GNU/Linux respectent l’utilisateur, ne sont pas intrusives et permettent d’utiliser des machines devenues obsolètes aux yeux des GAFAM. D’après HOP, 55 % des PC sous Windows 10 sont directement concernés par l’incompatibilité quant à l’utilisation de Windows 11. Nous souhaitons prouver qu’une alternative existe et qu’elle n’a rien à envier aux GAFAM !

Notre modèle est basé sur une association et, OUI on parle « argent » dès la page d’accueil du site, car nous rémunérons nos linuxAngels pour leur travail qui consiste à aller chez le particulier et à effectuer une migration de Microsoft Windows vers Linux Mint qui est la distribution que nous avons choisie avec son environnement Cinnamon.

Bien évidement, nous recherchons des linuxAngels, des ami·e·s (assos, gulls, collectifs…) qui parlent de nous et qui nous aideraient à relever ce défi mais aussi des collectivités pour réaliser des projets à grande échelle, etc.

Voilà !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Éditer de la littérature libre : les Éditions du Renard Spatial
    J’aime le logiciel libre. J’aime la littérature. Alors, un jour, je me suis demandé s’il était possible d’éditer de la littérature libre. Les premiers essais ont eu lieu au début de l’été 2020, le covid laissait le temps libre à des expérimentations. Six ans plus tard, les Éditions du Renard Spatial existent, éditent des littératures de l’imaginaire libres, et viennent de publier « Ça ne peut pas être pire qu’ici » par Lisa Refur (une amie), un roman court de fantasy/apprentissage, au format pa

Éditer de la littérature libre : les Éditions du Renard Spatial

J’aime le logiciel libre. J’aime la littérature. Alors, un jour, je me suis demandé s’il était possible d’éditer de la littérature libre.
Les premiers essais ont eu lieu au début de l’été 2020, le covid laissait le temps libre à des expérimentations.

Six ans plus tard, les Éditions du Renard Spatial existent, éditent des littératures de l’imaginaire libres, et viennent de publier « Ça ne peut pas être pire qu’ici » par Lisa Refur (une amie), un roman court de fantasy/apprentissage, au format papier.
C’est l’aboutissement d’une aventure que je vais vous raconter ici.

Couverture du livre « Ça ne peut pas être pire qu’ici », de Lisa Refur, aux Éditions du Renard Spatial

Sommaire

L’art libre, une discipline très différente du logiciel libre

On parle assez peu d’art libre, que ce soit sur LinuxFR.org ou ailleurs (il n’y a même pas de catégorie dédiée !) ; on peut même considérer que le sujet est ignoré, y compris des personnes qui baignent dans le logiciel libre depuis des décennies. C’est que l’art libre et le logiciel libre sont différents sur beaucoup d’aspects, y compris des points fondamentaux. On pourrait disserter longtemps sur ce point, mais ça n’est pas le sujet ; je vais plutôt me concentrer sur quatre points qui sont utiles à comprendre pour la suite.

Le premier, c’est que la personne qui développe un logiciel développe d’abord un outil.
D’accord, elle peut y tenir énormément, avoir une vision forte ; mais l’implication personnelle reste beaucoup moins forte que celle d’un·e auteur·ice dans son œuvre artistique. Les créateur·ices de logiciels libres acceptent donc beaucoup plus facilement la réappropriation et la modification de leur production ; au contraire des artistes qui ont tendance à vouloir conserver le contrôle sur des œuvres qui peuvent être très personnelles.

Le second, c’est que mis à part quelques exceptions comme le cinéma, beaucoup d’arts sont profondément solitaires ou se pratiquent en tout petit comité, là où le développement logiciel est généralement un travail d’équipe. Les notions de partage, d’amélioration mutuelle sont beaucoup plus fréquents dans le développement logiciel que dans l’art.

Le troisième, c’est que la réutilisation d’éléments – la réutilisation directe, au contraire de l’inspiration – est infiniment plus fréquente dans le développement logiciel que dans l’art.
Tous les logiciels ou presque réutilisent du code, via des bibliothèques, des API, des ABI, ou directement. Au contraire, la réutilisation directe en art est rare, hors quelques cas précis, et souvent mal vue.

Le quatrième et le plus important, c’est l’argent, la thune, le fric, la moula.
Les développeurs informatiques sont généralement bien, voire très bien payés, même avec les changements introduits par les IAs génératives. Au contraire, rares sont les artistes qui peuvent vivre de leur art ; celles et ceux qui peuvent en vivre décemment sont encore plus rares.

Les trois premiers points expliquent pourquoi la notion de « Liberté » (dans le sens de l’expression « art libre ») est moins importante pour les artistes que pour les développeurs et développeuses de logiciels. Le dernier explique pourquoi les artistes ont une énorme difficulté matérielle à contribuer à de l’art libre, quand bien même ils et elles en auraient envie ; parce que pour offrir de son temps, ou trouver un modèle de financement compatible avec l’art libre, il faut d’abord pouvoir manger à sa faim.

Mais cette longue digression introductive ne nous apprend toujours rien sur le sujet d’origine !

Le projet des Éditions du Renard Spatial

Dès le début, mon projet était clair : je voulais éditer de la littérature libre, et pas n’importe comment.

La direction éditoriale

Tout éditeur a besoin d’une direction éditoriale, pour que les client·es ne soient pas perdu·es. Quel sens ça aurait d’éditer en vrac des livres de cuisine, des polars, des livres sur l’informatique et des albums photo ?

Je lis principalement des littératures de l’imaginaire – science-fiction, fantasy, fantastique, le tout pris au sens large. C’est pour cela que les Éditions du Renard Spatial éditent des littératures de l’imaginaire. J’ai aussi décidé de partir sur des formats courts : on trouve beaucoup de sagas et œuvres à rallonge dans ces univers ; mais j’aime bien lire des histoires percutantes et efficaces. En prime, c’est plus rapide à éditer (je n’ai pas écrit « plus facile »).

De la littérature libre

Je veux dire : vraiment libre ; donc sous des licences qui respectent les quatre libertés habituelles (même si on peut se poser la question de savoir ce qu’est le « code source » d’un texte si ce n’est le texte lui-même). J’ai donc choisi de partir, par défaut, sur les licences Creative Commons, qui ont le bon gout d’être adaptées à ce genre de projet et connues. Je me limite aux licences libres, ce qui exclut les clauses -NC et -ND, qui en font des licences « de libre diffusion ».

Ça a été l’occasion de se poser sérieusement la question de l’intérêt de licences libres appliquées à la littérature. J’en vois deux assez immédiats.

Le premier, c’est la diffusion de l’œuvre.
Une œuvre, une fois publiée, va circuler, qu’on le veuille ou non. Elle sera « piratée », que l’éditeur ait protégé son œuvre ou non ; d’ailleurs, saviez-vous que beaucoup de fuites de livres sur les sites de partage illégaux proviennent de sources internes à la chaine du livre ? C’est un point d’autant plus important pour moi que je veux que les textes que je publie, vivent, même si ma maison d’édition doit disparaitre.

Le second, c’est le fandom de l’œuvre.
Si une œuvre plait, alors il va se créer tout un tas d’œuvre dérivées – que l’auteur·ice et l’éditeur·ice le veuillent ou non – à base de fanfictions, de dessins, et j’en passe. Aujourd’hui tout ça existe sans aucun cadre légal, et les licences libres permettent de créer ce cadre.

De la littérature pour tout le monde

La culture, c’est vite cher, et je refuse la position d’une culture réservée à une élite.

Les livres que j’édite sont donc les moins chers possibles, dans la limite du raisonnable. Ça implique que les livres papier sont d’office des formats « poche » – 11 x 18 cm – et que les livres électroniques sont sensiblement moins chers que les versions imprimées.

En bonus, ça m’arrange parce que je n’ai jamais aimé les grands formats. Alors, c’est joli dans une bibliothèque et ça fait un bel objet à offrir – et, soyons honnêtes, à revendre – mais en ce qui concerne la fonction livre, je trouve ça nul, parce qu’un grand format, c’est encombrant, c’est lourd, c’est pénible à transporter (et je lis souvent dans les transports) ou même à tenir quand on est vautré dans un canapé.

Un vrai éditeur, pas un éditeur-Amazon

Je voulais que les livres des Éditions du Renard Spatial soient de « vrais » livres, que l’on peut acheter dans n’importe quelle librairie, avec un ISBN, un référencement qui va bien, et tout. L’idée du livre qui existe, mais qui ne peut être acheté que sur le site du vendeur, ou en ligne chez un seul libraire – en général Amazon – me gonfle.

C’est sans doute parce que j’aime beaucoup mes libraires (qui sont d’excellent conseil). En prime, ça m’évite d’avoir à gérer toute la logistique, le stockage, les factures individuelles, l’envoi de commandes… tout ce que je déteste.

De tous mes choix, c’est – de loin – celui qui m’a le plus cassé les pieds.

Production locale et raisonnée

Faire imprimer des livres en Chine pour les vendre principalement en France me semble absurde ; donc l’idée de base était de trouver un imprimeur en France, ou à défaut quelque part dans l’UE.

D’autre part, la chaine du livre repose beaucoup sur une notion de stock qui voyage. En très résumé, l’imprimeur imprime un tas de livre, qui est en partie stocké, en partie envoyé aux libraires, qui vendent ce qu’ils peuvent et qui – chose exceptionnelle dans le monde de la vente – renvoient les exemplaires invendus… qui finissent au pilon s’ils ne se vendent pas pendant un peu trop longtemps (ou sont trop abimés à cause des voyages), parce que le stockage, ça coute cher. Donc, si je peux éviter de faire imprimer des livres pour les stocker et finir par les détruire, ça m’arrange, parce que tout ça c’est une perte sèche.

Le difficile problème des couvertures

Pour commencer, une illustration de couverture, c’est un budget important pour une petite structure, surtout en refusant l’usage d’IA générative (ah oui, il y a la question de l’IA générative qui est venue s’inviter au milieu du projet).

Alors, j’ai réfléchi. Le premier intérêt d’une couverture, c’est d’attirer l’œil, d’être facile à repérer dans un magasin ou sur un site, au milieu de beaucoup d’autres.
Autre chose : les livres que j’ai achetés à leur couverture se comptent sur un doigt d’une main ; quant aux couvertures que je suis capables de décrire sans aller les vérifier, il y en a très peu, la plupart d’entre elles sont sobres – et à l’exception de celle déjà nommée, aucune d’elle n’a été un critère d’achat. Inversement, beaucoup de littératures de l’imaginaire ont des couvertures illustrées, avec une typographie soignée, mais à cause des effets de mode, elles ont tendance à toutes se ressembler, ce qui fait qu’aucune ne se repère facilement dans la masse.

La solution s’est imposée d’elle-même : je peux me contenter de couvertures sobres, très lisibles, très faciles à reconnaitres, avec une harmonie dans la collection.

Le temps et l’énergie que je peux y consacrer

Ce projet n’est pas mon activité principale, et je n’ai pas pour projet d’en vivre.

L’avantage, c’est que ça me libère d’une contrainte financière extrêmement forte – rares sont les petites maisons d’édition rentables.

L’inconvénient, c’est que ça m’empêche de faire du volume, ce qui n’aide ni pour la reconnaissance, ni pour la publicité, ni pour les revenus.

Profils d’auteur·ices cible

Un tout petit éditeur, avec des conditions d’édition étranges (de l’art libre, des formats qui rapportent moins à l’unité), qui est-ce que ça va intéresser ?
C’est une vraie question.

Ma réponse, c’est : le même genre de profil que celui intéressé par le logiciel libre, mais dans le monde de la littérature.

Concrètement, c’est un·e auteur·ice qui écrit pour le plaisir, en loisir, et donc n’a pas besoin de ce revenu pour vivre.

Je vais être très clair sur un point : je paie mes auteur·ices, et il n’a jamais été question de ne pas le faire. Simplement, je ne peux pas me permettre d’avance sur droits ni promettre des ventes faramineuses, cf. le point précédent.

Ainsi donc, après une première publication-test sur l’un de mes textes, j’ai convaincu une amie, Lisa, de se lancer dans l’aventure avec moi…

Créer les Éditions du Renard Spatial, de façon légale et complète

À ce stade – en réalité, avant la dernière ligne du paragraphe précédent, j’ai toute la vision cible, il n'y a plus qu’à passer à la réalisaton !

D’abord, une entreprise

La France propose le système de « microentreprises » ou « autoentrepreneurs », un système légal qui est censé permettre à tout le monde de se créer facilement une entreprise pour se créer un complément de revenu, et qui correspond bien à mon projet.

Le mot-clé est « facilement ». Eh ben, si ça, c'est facile, je veux même pas imaginer la prise de tête que ça doit être de créer une entreprise « normale », même unipersonnelle. Je passe les détails – déjà parce que ça fait six ans donc ça a pu changer –, mais au cas où, sachez tout de même que :

  1. Une autoentreprise peut avoir un nom commercial, mais le nom réel, celui enregistré au SIREN, est impérativement votre identité réelle. Il y a bien une option qui permet de masquer ces informations personnelles – la base SIREN étant publique –, mais tous les systèmes d’interconnexion informatique dont vous allez avoir besoin partent du principe que cette information est disponible dans les données publiques. Donc, impossible d’activer la confidentialité tant que toute la paperasserie n’est pas terminée.
  2. En théorie, un compte bancaire séparé suffit, pas besoin d’avoir un compte bancaire professionnel ; donc on peut utiliser un compte personnel gratuit. En pratique, le site des impôts impose un IBAN professionnel… et toutes les banques ont bidouillé leurs règles commerciales pour limiter l’émission d’IBAN professionnels aux seuls comptes professionnels payants.
  3. Et, à partir de septembre 2026, il faut aussi un système de facture électronique.

OK, l’entreprise et ses dépendants (la banque, l’inscription au RCS via le Tribunal de Commerce, les impôts, l’URSSAF…), c’est fait.
Et ensuite ?

Éditer c’est vendre, et vendre c’est communiquer

Avant toute chose : déposer sa marque à l’INPI. C’est pas gratuit, mais ça évite les abus un peu trop faciles.

Il me faut donc des outils de communication. Ça passe par divers comptes sur les réseaux, pour communiquer avec les gens là où ils sont, même si ça ne m’enchante pas. Je décide de ratisser large : BlueSky, Instagram, Discord, LinkedIn, Facebook, et même à l’époque un compte Twitter qui a été abandonné. Je n’ai pas de compte Mastodon parce qu’il faut d’abord que je trouve une instance adaptée à ce genre de projet ; je prends les conseils.

Puis, un site web ; et là, j’ai un gros avantage : je peux le créer et l’héberger moi-même.
C’est un site 100 % statique créé avec Hugo, sobre (sans JS ni framework CSS) et disponible ici : https://renardspatial.com/. J’y ai tenté des trucs d’un point de vue design – et je ne suis pas du tout designer. Mais je cherchais quelque chose d’un peu original, qu’on a pas l’impression d’avoir déjà vu partout, et qui soit utilisable sur mobile (ça reste la majorité des utilisateurs). Là aussi, je prends les retours (seulement les constructifs). Les polices d’écriture sont celles utilisées pour les livres et, bien évidemment, sont libres.

Un livre doit avoir un ISBN

L’ISBN (pour « International Standard Book Number ») c’est un numéro d’identification unique pour chaque livre dans le monde depuis les années 1980.

C’est la partie facile : pour une modique somme, l’AFNIL en fournit très largement assez pour des années, il suffit juste d’un peu de patience. Les numéros sont fournis sous la forme d’une liste, à l’éditeur de les attribuer à chaque ouvrage ; la version numérique et la version papier ne comptant que pour un que s’ils sont strictement identiques.

Ouf ! J’ai enfin toute la structure et tout le nécessaire pour que l’entreprise fonctionne ; maintenant, je peux enfin commencer à éditer !

Créer de la littérature libre… avec des logiciels libres ?

Éditer le texte lui-même

Pour l’instant, c’est la partie facile : mon amie Lisa – seule autrice tierce pour l’instant – et moi utilisons LibreOffice, dont le système de commentaires fait l’affaire. D’autre part, on se voit souvent en vrai, ce qui simplifie beaucoup le travail.

L’outil de PAO

La PAO, c’est la Pagination Assistée par Ordinateur, ce qui permet à l’ouvrage – livre, magasine, etc. – d’avoir une mise en page correcte.

Un fait peu connu du grand public : un logiciel de traitement de texte est incapable de faire une mise en page correcte, et j’entends par là d’avoir une qualité professionnelle, notamment en ce qui concerne la typographie. Un LibreOffice Writer – ou même un Microsoft Word – ne gèrent pas les alignements sur grilles, ont des options de césure, de lignes veuves et orphelines très réduites, ne gèrent pas les ligatures de manière fine, n’ont pas d’option pour activer (et encore moins paramétrer) l’alignement visuel, et j’en passe. Or, j’ai envie d’avoir une mise en page correcte, même si certains gros éditeurs, eux, ont décidé de s’en passer.

Le logiciel libre le plus connu pour ce faire, c’est LaTeX. Il est excellent sur la typographie, et… atroce sur le reste. Pour moi ça n’est pas un choix acceptable, il ne correspond tout simplement pas à ma façon de travailler (et, si vous êtes aficionados de LaTeX, pas la peine de venir le défendre en commentaires, je le connais depuis plus de 20 ans).

Le choix suivant, c’est Scribus. Donc je l’installe, l’essaie, l’essaie encore, l’essaie toujours ; et après beaucoup trop longtemps, je n’arrive toujours pas à faire le quart de ce que je veux avec. (Il semblerait que le logiciel se soit beaucoup amélioré depuis, il faudra que je réessaie).

La solution que je trouve n’est hélas pas libre et à l’époque elle n’était même pas gratuite, bien qu’infiniment moins chère que les mastodontes du genre. C’est Affinity Publisher ; et en une après-midi, j’ai une maquette qui est à 90 % ce que je veux, couverture comprise, donc je décide d’être pragmatique et de partir sur ce logiciel.

Créer les fichiers pour l’impression

C’est facile : tous les imprimeurs prennent des fichiers PDF (et indiquent la version exacte qu’ils attendent), donc en suivant les instructions, il ne devrait pas y avoir de surprise. Et de fait, j’en ai pas eu.

Créer les livres électroniques

Mon diffuseur (je reviendrai sur son rôle dans la section suivante) me dit que je peux me contenter de fournir un EPUB et un PDF, et qu’il transforme lui-même le livre aux éventuels autres formats, dont l’infâme Kindle.

Le PDF, c’est facile, j’ai déjà. Mais l’EPUB ? Je découvre trois choses :

  1. Un livre électronique au format EPUB, c’est juste un fichier ZIP renommé avec le texte au format XHTML (oui !), un fichier de styles CSS (qui sera largement ignoré par le logiciel de lecture…) et une poignée de métadonnées, en général du XML (parfois renommé).
  2. Malgré ça, personne ne semble savoir générer un EPUB correct. La plupart des logiciels et convertisseurs que j’essaie me génèrent une soupe de balises sans aucun sens ; d’ailleurs la plupart de ceux que j’ai sur ma liseuse ont des problèmes plus ou moins graves à l’usage.
  3. Le format EPUB semble être plus une vague indication qu’une norme, et les différentes liseuses et logiciels de lecture ont tous des interprétations, disons créatives de comment ce format doit être rendu.

Donc, je finis par décider de le générer à la main ; et en fait, c’est facile : en une journée, j’ai un fichier tout à fait valide qui passe bien sur ma liseuse physique, et sur diverses liseuses logicielles sur PC et smartphone. Mon seul échec, c’est la page de faux-titre qui n’est pas stylisée correctement. Il y avait un seul piège : les fichiers ZIP définissent l’ordre dans lequel sont stockés les fichiers, et le format EPUB attend un ordre précis qui doit être respecté (mimetype, puis META-INF/*, puis OEBPS/*). Il semblerait que les versions récentes de LibreOffice produisent un résultat correct, il faut que je réessaie.

Et donc maintenant, j’ai des livres qui contiennent de la littérature libre, qu’il me faut vendre.

Vendre de la littérature libre

Parce que si je parle de littérature libre depuis le début, je n’ai jamais parlé de littérature gratuite, et pour cause : mon but est bien de vendre cette littérature, même libre, ne serait-ce que parce qu’il faut bien que je paie les intermédiaires. Justement, parlons-en.

La chaine du livre

Le processus de création d’un livre implique tout ce petit monde :

  1. L’auteur·ice, qui écrit le livre.
  2. L’éditeur – ici moi-même, au nom des Éditions du Renard Spatial – qui édite le livre, et qui peut faire appel à :
    1. Une correctrice, qui s’assure qu’il ne reste pas de fautes d’orthographe et de grammaire ; et croyez-moi la langue française aurait bien besoin d’une simplification. Une grosse.
    2. Une graphiste, pour la couverture, les éléments de communication, etc.
    3. Un maquettiste, pour la mise en page.
    4. … et j’en passe, surtout dans les grands groupes (notamment le directeur de collection).
  3. L’imprimeur, qui, ben, imprime le livre.
  4. Le distributeur, qui assure la logistique, c’est-à-dire de stocker les livres imprimés et les envoyer aux libraires.
  5. Le diffuseur, qui va assurer la promotion des livres auprès des libraires et s’assurer de leur présence.
  6. La libraire, qui va vendre le livre.

Sachant que dans la liste principale, seul l’imprimeur travaille à tarif fixe ; tous les autres se rémunèrent au pourcentage du prix de vente final… et donc vont sans doute refuser les partenariats vus comme non rentables. Comme, par exemple, travailler avec un petit éditeur qui vend des livres pas chers, libres, et qui ne fait même pas ça à plein temps.

Pour l’instant, coté édition, je fais tout moi-même. Si jamais un jour, j'ai les moyens (je compte sur vous !), j’investirai d’abord dans une correction professionnelle.

Vendre des livres électroniques

Trouver un distributeur de livres électroniques, c’était facile ; et très vite, j’ai eu une nouvelle à mon pseudo disponible sur à peu près toutes les plateformes.
On a donc travaillé un premier livre avec mon amie Lisa, on l’a réalisé, vendu partout où on peut acheter un livre électronique, et on a découvert la triste vérité :

Les livres électroniques, ça n’intéresse personne.

C’était le plus beau « Vu et s’en tape » de toute notre vie. En fait, sans version papier, c’est comme si le livre n’existait même pas.

Mais il y a un problème…

Vendre des livres papier

Vous vous rappelez quand, plus haut, j’écrivais que j’avais créé l’entreprise en 2020 ? Eh bien, le covid avait mis un grand bazar dans le monde de l’impression, et les prix du papier s’étaient envolés.

Ça s’est ensuite calmé. Quelques semaines. Après quoi, la Russie a déclaré la guerre à l’Ukraine, grande fournisseuse européenne de bois et de papier, donc re-crise, retour des prix absurdes, priorité absolue aux clients de longue date, etc. (j’ai même quelques mangas de cette époque qui sont visiblement imprimés sur du papier machine, le même qu’on utilise dans nos imprimantes !)

Quand c’est de nouveau revenu à une certaine normale, j’ai cherché imprimeurs, distributeurs et diffuseurs. L’imprimeur, c’est facile, tous les imprimeurs de France et de Navarre veulent bien faire des livres de poche. Facile, pour eux, on paie un tarif fixe par livre et ça leur va bien. Le distributeur et le diffuseur, c’est beaucoup plus compliqué. Ce que je veux faire, c’est pas assez cher, y’a pas assez de volume, j’ai pas assez de poids dans un marché déjà saturé.

Alors, je me suis dirigé vers l’impression à la demande, qui finalement a beaucoup d’avantages pour une structure comme la mienne ; et on en trouve qui cumulent prix correct, bonne réputation, et qui impriment dans l’Union Européenne. En particulier, on peut avoir de l’impression à la demande qui est référencée sur Dilicom et Electre, donc commendable en libraire, ce dont je n’étais pas sûr à l’origine.

Encore un peu de paperasse, puis davantage de paperasse (notamment pour faire corriger une erreur d’attribution d’éditeur), et un envoi au dépôt légal, et enfin – enfin ! – on est en juillet 2026 on a une version papier de notre premier livre !

« Ça ne peut pas être pire qu’ici »

Couverture du livre

« Ça ne peut pas être pire qu’ici » est une novella (à mi-chemin entre une nouvelle et un roman) de fantasy et d’apprentissage de Lisa Refur, publié sous licence CC-BY 4.0 dont voici la quatrième de couverture :

Cette ligne de chemin de fer apparue par magie agit comme un déclencheur dans l’esprit des adolescents désœuvrés. Et s’il existait un monde au-delà de cette ville de banlieue décrépite ? Qu’est-ce qui interdit aux quatre amis de quitter Villeneuve ? Rien, en fait. C’est le début de l’aventure pour Ajax, Dro, Biénale et Zef ; l’abandon d’une cité cité sans avenir, la quête d’une vie meilleure. Mais pour aller où ? Suivre la ligne ? D’où vient-elle, et où va-t-elle ? Est-ce mieux ailleurs ?

La seule solution qu’ont les jeunes gens pour le découvrir : prendre la route, se confronter à ses difficultés, ses joies et ses peines, dans l’espoir que la destination soit bonne.

Il est disponible pour 6,99 € au format papier (11 x 18 cm, 84 pages, demandez l’ISBN 9782492575037 à votre libraire préféré) ; et pour 2,99 € au format électronique, sans DRM quand la librairie le permet, cherchez l’ISBN 9782492575013.

Éditer de la littérature libre : premier point d’étape

Le premier enseignement que j’en tire, c’est celui-ci : tout le monde s’en cogne.

Le sujet n’intéresse personne, en bien comme en mal : je n’ai eu aucune remarque sur le sujet. Les textes, le site, les couvertures ont généré beaucoup plus de commentaires. D’un côté, c’est un peu triste ; d’un autre ça n’a pas déclenché de rejet, et c’était le point que je craignais le plus dans cette expérience. Je croise les doigts.

La conclusion que j’en tire pour l’instant, c’est la suivante : pour l’instant, publier de la littérature sous licence libre ne m’a rien apporté directement, et c’était attendu : l’intérêt du libre, c’est d’abord pour les personnes qui utilisent plus que pour celles qui produisent, surtout dans un domaine où la création collaborative est minoritaire.

Mais surtout, publier de la littérature libre ne m’a pas handicapé, donc je n’ai aucune raison d’arrêter de le faire, et par conséquent, je vais continuer !

Et maintenant ?

Les Éditions du Renard Spatial vont continuer à publier des littératures de l’imaginaire libres.

Le prochain livre ne devrait pas attendre trois ans de plus, puisqu’on a un projet de recueil de nouvelles en cours avec Lisa. Si tout va bien, il devrait sortir quelque part entre cet automne et cet hiver – j’ai arrêté de croire à une date précise tant que tout n’est pas terminé.

Mais surtout, les soumissions sont maintenant ouvertes ! Si vous êtes intéressé·es, pouvez vous proposer votre projet en suivant la procédure détaillée ici. Attention ! Il ne s’agit pas d’envoyer un texte complet avec à peine un bonjour (j’en ai déjà eu !).

J’avais imaginé terminer par une sorte de FAQ, mais cette dépêche est déjà extrêmemement longue, donc je vous propose de lire celle du site, et de me poser toute question restante en commentaires.

Merci de m’avoir lu !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 31 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [ZDNET] Logiciels libres et collectivités au congrès de l'Adullact [01net.] Fini WhatsApp: la France choisit sa propre messagerie et veut convertir l'Europe [InformatiqueNews.fr] Open Secure AI Alliance veut sécuriser l

Revue de presse de l’April pour la semaine 31 de l’année 2026

Par : echarp
4 août 2026 à 08:37

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[ZDNET] Logiciels libres et collectivités au congrès de l'Adullact

✍ Thierry Noisette, le vendredi 31 juillet 2026.

Retour sur le congrès de Montpellier de l’association libriste des collectivités territoriales: la transition vers le Libre d’Échirolles, l’adoption de Linux dans le département du Rhône (et une chanson).

[01net.] Fini WhatsApp: la France choisit sa propre messagerie et veut convertir l'Europe

Le mardi 28 juillet 2026.

Alors que Tchap est devenue la messagerie sécurisée de référence de l’État, la France cherche désormais à étendre sa stratégie de souveraineté numérique à l’échelle européenne en promouvant le protocole Matrix auprès d’autres pays.

[InformatiqueNews.fr] Open Secure AI Alliance veut sécuriser l'IA ouverte

✍ Loïc Duval, le mardi 28 juillet 2026.

L’incident Hugging Face a fait trembler tout le monde. Il est l’heure de passer à l’action. Nvidia, Microsoft, IBM, Cisco, Hugging Face, la Linux Foundation et une trentaine d’autres acteurs lancent une coalition destinée à bâtir une pile de sécurité ouverte pour les modèles et agents d’IA. Derrière le discours sur la transparence, l’initiative cherche surtout à éviter que la cyberdéfense ne dépende de quelques plateformes propriétaires impossibles à inspecter ou à déployer localement.

[atlantico] Open source vs. sécurité: pourquoi Washington hésite et ce que cela change pour l'Europe

✍ Bernard Benhamou, le mardi 28 juillet 2026.

Trump voudrait réserver les modèles d’IA aux Etats-Unis, les principaux intéressés lui demandent de ne rien en faire. Derrière ce paradoxe se joue un enjeu essentiel autour de la domination mondiale de l’IA. Et pour l’instant, la Chine semble bien partie pour rafler la mise. Décryptage.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • EmmaDE6 1.02 améliore encore l’accessibilité aux déficients visuels
    Ce 27 juillet 2026, le collectif Emmabuntüs vient d’annoncer la sortie de sa nouvelle version Emmabuntüs Debian Édition 6 1.02, basée sur la Debian 13.6 Trixie et supportant les deux environnements de bureau XFCE et LXQt. lien nᵒ 1 : 11 représentants des structures spécialisées prennent en main l’informatique inclusivelien nᵒ 2 : Interviews réalisées suite à la première formation sur l’accessibilitélien nᵒ 3 : Manuel des fonctions d’accessibilité dans Emmabuntüslien nᵒ 4 : Page sur l’accessibi

EmmaDE6 1.02 améliore encore l’accessibilité aux déficients visuels

Ce 27 juillet 2026, le collectif Emmabuntüs vient d’annoncer la sortie de sa nouvelle version Emmabuntüs Debian Édition 6 1.02, basée sur la Debian 13.6 Trixie et supportant les deux environnements de bureau XFCE et LXQt.

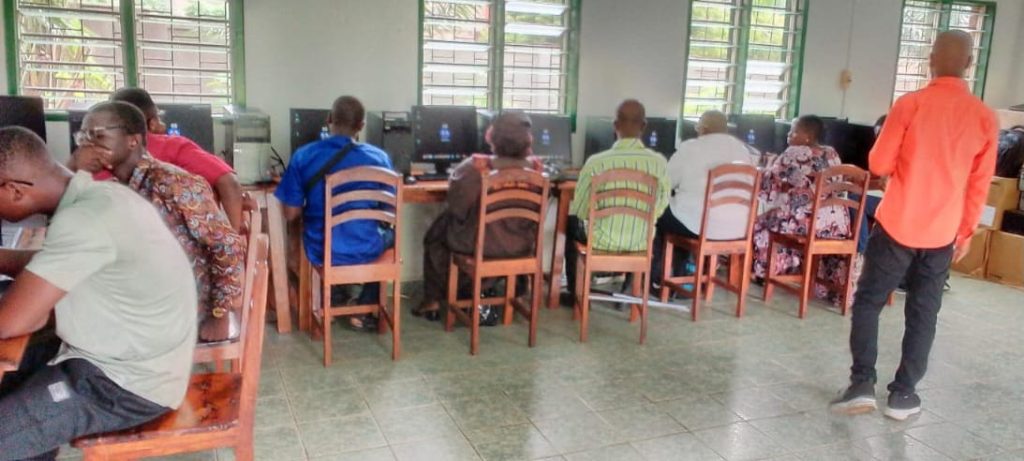
Première séance de formation au Centre  Polyvalent Saint-Augustin de Lomé, du 9 au 10 juillet 2026

Rappelons que cette distribution est née au sein du Mouvement Emmaüs, pour faciliter le reconditionnement des ordinateurs donnés aux associations, notamment humanitaires, mais aussi pour favoriser la découverte de GNU/Linux par les débutants, tout en prolongeant la durée de vie du matériel informatique, ce qui réduit le gaspillage lié à la surconsommation de matière première.

La nouvelle évolution de cette distribution concerne essentiellement des améliorations en matière d’accessibilité avec notamment un retour à la version stable d'Orca 48.1.1 ainsi qu’une meilleure prise en charge de la synthèse vocale Piper, ce qui améliore notablement le confort d’écoute du système.
Cette distribution a été utilisée lors de la première séance de formation dispensée au Centre Polyvalent Saint-Augustin de Lomé, à l'intention des futurs référents représentant les 10 structures spécialisées pour les personnes déficientes visuelles du Togo.

Pour mémoire ces actions se font en collaboration étroite avec l’A.S.I. YOVOTOGO qui prévoit aussi l’installation d’une première salle informatique au Cameroun, marquant une nouvelle étape dans l’expansion géographique de ses actions dans cette région d’Afrique.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Kernel Recipes 2026 – 13e édition : c'est reparti !
    Nous sommes fiers de vous annoncer la 13ᵉ édition de Kernel Recipes. Elle aura lieu du 21 au 23 septembre 2026 à Paris, à la Fondation Biermans-Lapôtre, 9A boulevard Jourdan dans le 14ᵉ, RER Cité universitaire. Comme les années précédentes, une vingtaine d’interventions autour du fonctionnement de la communauté, des outils, de Rust, de la sécurité… et, pour la première fois (mais de façon raisonnée), de l’IA appliquée au développement noyau. Le parrain de cette édition : Jonathan Corbet Cette a

Kernel Recipes 2026 – 13e édition : c'est reparti !

Nous sommes fiers de vous annoncer la 13ᵉ édition de Kernel Recipes. Elle aura lieu du 21 au 23 septembre 2026 à Paris, à la Fondation Biermans-Lapôtre, 9A boulevard Jourdan dans le 14ᵉ, RER Cité universitaire. Comme les années précédentes, une vingtaine d’interventions autour du fonctionnement de la communauté, des outils, de Rust, de la sécurité… et, pour la première fois (mais de façon raisonnée), de l’IA appliquée au développement noyau.

Le parrain de cette édition : Jonathan Corbet

Cette année, nous avons l’immense honneur d’accueillir Jonathan Corbet en tant que parrain de l’édition. Rédacteur en chef de LWN.net et observateur privilégié du développement du noyau depuis des décennies, il a participé grandement à la construction du programme – autant dire que l’édition s’annonce très bien !

Logo

Les conférences : variées, avec un peu d’IA, du Rust, de la sécurité, des outils…

Le programme mêle, comme d’habitude, mainteneurs historiques et nouvelles têtes :

  • Steven Rostedt revient sur les coulisses peu glorieuses des futex (Futex: The good, the bad and the ugly! (mostly ugly)) ;
  • côté Rust, Miguel Ojeda fait le point sur Rust for Linux et Danilo Krummrich (Red Hat, fondateur du driver Nova pour GPU NVIDIA) détaille comment imposer à la compilation les règles de cycle de vie des drivers ;
  • côté sécurité, Marta Rybczynska se demande si Linux est enfin secure by default, et Greg Kroah-Hartman abordera la sécurité à l’ère des LLM ;
  • côté outils, on retrouve Patrick Steinhardt (GitLab) sur l’actualité de Git, Konstantin Ryabitsev sur l’infrastructure kernel.org, et Matthieu Baerts sur MPTCP ;
  • côté ordonnancement et mémoire, SeongJae Park présente DAMOS, Changwoo Min et Gavin Guo (Igalia) parlent de leur ordonnanceur BPF LAVD, Victor Laforet (Inria) de verrouillage et ordonnancement, et Roman Guschchin de la gestion mémoire des cgroups ;
  • et bien sûr, Martin Uecker, Arnd Bergmann, Detlev Casanova (Collabora) et d’autres viendront compléter ce menu copieux.

Et la fameuse touche IA, justement : oui, le sujet est au programme cette année, mais on est resté raisonnable :

  • Greg Kroah-Hartman, « You are holding it wrong! » : comment obtenir d’un LLM un correctif de bug réellement valide, ce qui marche, ce qui ne marche pas, et pourquoi la plupart des gens s’y prennent mal ;
  • Roman Guschchin, The Sashiko review system : un système de revue de patchs assisté par IA, conçu spécifiquement pour le noyau, qui aurait détecté plus de la moitié des bugs dans un corpus de 1000 correctifs historiques ayant pourtant passé la revue humaine.

Deux conférences, une seule vraie question : à quoi ressemble l’outillage assisté par IA quand il se confronte à la rigueur du développement noyau ?

Comme chaque année, Kernel Recipes organise ses enchères caritatives ! Cette année, nous avons souhaité mettre à nouveau en lumière le travail de la Software Freedom Conservancy. Bradley Kühn interviendra sur ce sujet le 22 septembre, juste avant le lancement des enchères.

Dans la salle

Frank sera bien sûr de la partie pour croquer sur le fait les orateurs et oratrices, mais aussi participants, perpétuant une tradition désormais incontournable de la conférence.

Notre mascotte est en train de se faire une beauté et devrait apparaître prochainement dans de nouveaux habits.

Mascotte

Sponsors

La conférence ne pourrait pas avoir lieu sans nos sponsors. Ils nous supportent en 2026 : Meta, ARM, PremDay, Jump Trading, HaProxy, Igalia, Collabora et d’autres à venir très bientôt.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 21 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Slate.fr] La France se prépare à larguer les géants américains de la tech, l'Europe pourrait suivre [Les Numeriques] Bye bye Microsoft Office: Euro-Office, l'alternative gratuite qui a séduit 2 millions d'Européens, ar

Revue de presse de l’April pour la semaine 21 de l’année 2026

Par : echarp
26 mai 2026 à 13:22

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Slate.fr] La France se prépare à larguer les géants américains de la tech, l'Europe pourrait suivre

✍ Juliette Boyer, le dimanche 24 mai 2026.

La France semble être la cheffe de file d’un mouvement croissant en Europe, cherchant à atteindre au plus vite la souveraineté numérique pour ne plus dépendre des États-Unis, ni de l’humeur de son président, Donald Trump.

[Les Numeriques] Bye bye Microsoft Office: Euro-Office, l'alternative gratuite qui a séduit 2 millions d'Européens, arrive cet été

✍ Aymeric Geoffre-Rouland, le mercredi 20 mai 2026.

Chaque matin, des millions d’Européens ouvrent Word, Excel ou PowerPoint sans y penser. Ce réflexe quotidien alimente une dépendance colossale à Microsoft. Neuf entreprises du continent ont récémment lancé Euro-Office, une suite bureautique gratuite et open source, pour y mettre fin. En France, 330 000 agents de l’Éducation nationale l’ont déjà adoptée.

[Solutions Numeriques & Cybersécurité] Souveraineté numérique: une coalition européenne de l'open source veut imposer l'examen systématique des alternatives ouvertes

✍ Charlotte Rabatel, le mercredi 20 mai 2026.

Plusieurs acteurs européens de l’open source demandent à Bruxelles d’inscrire dans la loi un principe «Open Source First». Leur proposition: obliger les administrations à évaluer et documenter l’existence d’alternatives open source avant tout recours à une solution propriétaire.

[Les Numeriques] “C'est ingérable”: Linux, pilier de l'open source mondial, fait face à la plus grande crise de son histoire à cause de l'IA

✍ Aymeric Geoffre-Rouland, le lundi 18 mai 2026.

La mailing list sécurité du noyau Linux, l’une des infrastructures les plus critiques de l’open source mondial, est en train de craquer sous le poids des rapports de bugs générés par intelligence artificielle. Linus Torvalds a pris la parole ce dimanche 17 mai pour dénoncer une situation devenue, selon lui, ingérable.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 19 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Les Numeriques] Le pingouin de Linux fête ses 30 ans, voici l'histoire incroyable de Tux [ZDNET] 10 000 milliards de téléchargements submergent désormais les référentiels open source: voici la nouvelle stratégie [Next]

Revue de presse de l’April pour la semaine 19 de l’année 2026

Par : echarp
11 mai 2026 à 21:40

[Les Numeriques] Le pingouin de Linux fête ses 30 ans, voici l'histoire incroyable de Tux

✍ Nassim Chentouf, le dimanche 10 mai 2026.

Tux fête ses 30 ans. Le pingouin emblématique de Linux est né le 9 mai 1996. La mascotte créée par Larry Ewing est, depuis, l’image du logiciel libre. On la retrouve sur des systèmes d’exploitation, des produits dérivés et des dizaines de memes Internet qui dépeignent sa rivalité avec Windows. Retour sur l’histoire de ce pingouin légendaire.

[ZDNET] 10 000 milliards de téléchargements submergent désormais les référentiels open source: voici la nouvelle stratégie

✍ Steven Vaughan-Nichols, le jeudi 7 mai 2026.

Les entreprises traitent ces référentiels comme s’il s’agissait de CDN. La Linux Foundation et ses partenaires estiment que cela suffit. Voici le plan.

[Next] Souveraineté: les acteurs du libre plaident pour une meilleure organisation des financements

✍ Martin Clavey, le jeudi 7 mai 2026.

Devant la commission d’enquête sur la souveraineté numérique de l’Assemblée nationale, plusieurs acteurs du libre (Mastodon, l’April, Framasoft, France Numérique libre…) ont poussé les parlementaires à prendre notamment exemple sur le modèle allemand de financement des projets de logiciels libres.

[Le Figaro] Nicolas Carpi (Deltablot): «Le logiciel libre n'est plus un choix technique, c'est un acte de gouvernance»

Le lundi 4 mai 2026.

Face à la domination des grands éditeurs technologiques américains, un nombre croissant d’organisations européennes réévaluent leurs choix en matière d’infrastructures numériques. Au cœur de cette réflexion, le logiciel libre, longtemps cantonné à des usages techniques, s’impose…

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Projets Libres saison 4 épisode 16 : Linux dans ton smartphone : où en est-on ?
    On continue la série sur les smartphones et le logiciel libre. Après avoir parlé de vie privée dans l'épisode précédent, aujourd'hui : peut-on faire tourner Linux sur son téléphone ? 📱📱 Dans cet épisode technique, nous rentrons en détail dans le sujet : quels sont les obstacles techniques à surmonter (caméra, VoLTE, vérification de l'intégrité, etc) ? quels projets se penchent sur la question et comment collaborent-ils ? qui finance ces travaux ? le problème d'une app pour chaque besoin c

Projets Libres saison 4 épisode 16 : Linux dans ton smartphone : où en est-on ?

Titre de l'image
On continue la série sur les smartphones et le logiciel libre.
Après avoir parlé de vie privée dans l'épisode précédent, aujourd'hui : peut-on faire tourner Linux sur son téléphone ? 📱📱

Dans cet épisode technique, nous rentrons en détail dans le sujet :

  • quels sont les obstacles techniques à surmonter (caméra, VoLTE, vérification de l'intégrité, etc) ?
  • quels projets se penchent sur la question et comment collaborent-ils ?
  • qui finance ces travaux ?
  • le problème d'une app pour chaque besoin
  • comparaison des évolutions de Linux sur mobile par rapport à Linux sur le desktop

Pour y répondre, nous avons invité Arnaud Ferraris, fondateur de la distribution Mobian.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 16 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [clubic.com] Sécurix et Bureautix, voici à quoi ressemble vraiment le Linux qui va remplacer Windows en France [Numerama] Cal abandonne l'open source face aux failles de sécurité liées à l'IA [Next] Fin de support annon

Revue de presse de l’April pour la semaine 16 de l’année 2026

Par : echarp
20 avril 2026 à 20:44

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[clubic.com] Sécurix et Bureautix, voici à quoi ressemble vraiment le Linux qui va remplacer Windows en France

✍ Guillaume Belfiore, le samedi 18 avril 2026.

Début avril 2026, la DINUM officialisait sa migration vers Linux. Derrière cette décision, deux projets open source portent des noms qui fleurent bon Astérix : Sécurix et Bureautix. Tour d’horizon d’une initiative qui dépasse largement le simple changement d’OS.

[Numerama] Cal abandonne l'open source face aux failles de sécurité liées à l'IA

✍ Amine Baba Aissa, le vendredi 17 avril 2026.

Cal, application de planification parmi les plus importantes de l’écosystème open source, abandonne sa licence ouverte. En cause: la capacité des IA à analyser du code à la recherche de failles. Un signal qui en dit long sur l’état du logiciel libre.

[Next] Fin de support annoncée pour le Fairphone 3, deux ans de sursis offerts avec /e/OS

✍ Alexandre Laurent, le mercredi 15 avril 2026.

Lancés en 2019, le smartphone Fairphone 3 et sa déclinaison 3 + prendront officiellement leur retraite à compter d’août 2026, a annoncé le constructeur mercredi 15 avril. L’appareil aura donc profité d’un support total de sept ans, supérieur aux cinq années promises initialement par l’entreprise.

[Goodtech] Deutschland-Stack: l'Allemagne impose les formats ouverts

Le mardi 14 avril 2026.

Adieu Microsoft Office, bonjour l’ODF. Deutschland-Stack est le nouveau socle technologique souverain de l’administration allemande.

[InformatiqueNews.fr] La DINUM largue Windows en faveur de Linux… mais quel Linux?

✍ Loïc Duval, le lundi 13 avril 2026.

La DINUM a officialisé sa sortie de Windows au profit de Linux. Une décision historique pour ses 234 agents. Derrière le symbole, un nouveau plan interministériel pourrait redessiner le paysage numérique de l’administration française. À condition de ne pas réinventer la roue chacun dans son coin.

Et aussi:

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Le jeu vidéo destiné à devenir de moins en moins libre et performant ?
    Pour qui s’intéresse au jeu vidéo, il y a quelques menus détails qui ont changé ces dernières années. On ne va pas parler du prix des composants — GPU et RAM notamment — qui a littéralement flambé avec l’avènement de l’IA, devenant une véritable valeur refuge au même titre que l’or ou le palladium ; non, on va s’intéresser à la partie technique des jeux (ou du moins de leurs moteurs de rendu). lien nᵒ 1 : Realtime Raytracing in Bevy 0.18 (Solari)lien nᵒ 2 : Le rendu 3D, rétrospective (par sm

Le jeu vidéo destiné à devenir de moins en moins libre et performant ?

Pour qui s’intéresse au jeu vidéo, il y a quelques menus détails qui ont changé ces dernières années.

On ne va pas parler du prix des composants — GPU et RAM notamment — qui a littéralement flambé avec l’avènement de l’IA, devenant une véritable valeur refuge au même titre que l’or ou le palladium ; non, on va s’intéresser à la partie technique des jeux (ou du moins de leurs moteurs de rendu).

Sommaire

Raytracing / Path tracing

Il doit être difficile en 2026 de ne pas avoir entendu les termes Raytracing et Path tracing. Mais concrètement, qu’est-ce que c’est et en quoi cela affecte les jeux vidéos ?

Pour en parler, il faut déjà revenir aux fondamentaux, c’est-à-dire la Rastérisation.
En modélisation 3D on a besoin d’afficher en deux dimensions (nos écrans) des objets en 3 dimensions. Étant loin d’être un expert de ces sujets, je dirais au doigt mouillé que ça doit remonter aux premiers rendus 3D.

Dans le contexte de la rastérisation, les objets à l’écran sont créés à partir d’un maillage virtuel de triangle ou de polygones (un mesh). Les coins de nos triangles sont appelés des vertices, et contiennent un paquet d’informations, comme leur position dans l’espace, ou bien leur couleur ou encore des données dite de « normale » qui permettent de déterminer la façon dont les faces d’un objet se présentent.

L’ordinateur convertit ensuite les triangles et les données des vertex en pixels affichés en 2D.

C’est la base de la rastérisation, on peut ensuite chaîner d’autres modifications sur nos pixels (des shaders : des programmes spécialisés qui fonctionnent en parallèles sur un GPU) pour modifier le rendu. C’est à cette étape que l’on fera de la magie noire pour simuler des effets de lumière, de réfraction, de réflexion, d’occlusion et j’en passe.

Pour les ombres il y a différentes techniques, la plus commune est la carte d’ombrage, qui permet de pré-calculer ou de calculer en temps réel ce qui est dans l’ombre (et doit donc être assombri) et ce qui ne l’est pas. Mais ces ombres sont dites « dures », pour des ombres diffuses (dites « soft ») il faut procéder un peu autrement.

On s’en sort en pratique fort bien, et d’autres techniques viennent compléter le tableau comme :

  • les lightmaps,
  • l’occlusion ambiante (SSAO, GTAO, etc.),
  • les sondes de réflexions,
  • les réflexions planaires qui — bien que gourmandes — donnent des réflexions claires comme le cristal en rendant la scène deux fois,
  • le SSR qui tente de reconstruire des réflexions à partir des informations déjà affichées,
  • les systèmes d’illuminations globales (SDFGI, Lumen)
  • les systèmes d’antialiasing
  • et une véritable myriade de joyeusetés toutes plus complexes et délicates les unes que les autres.

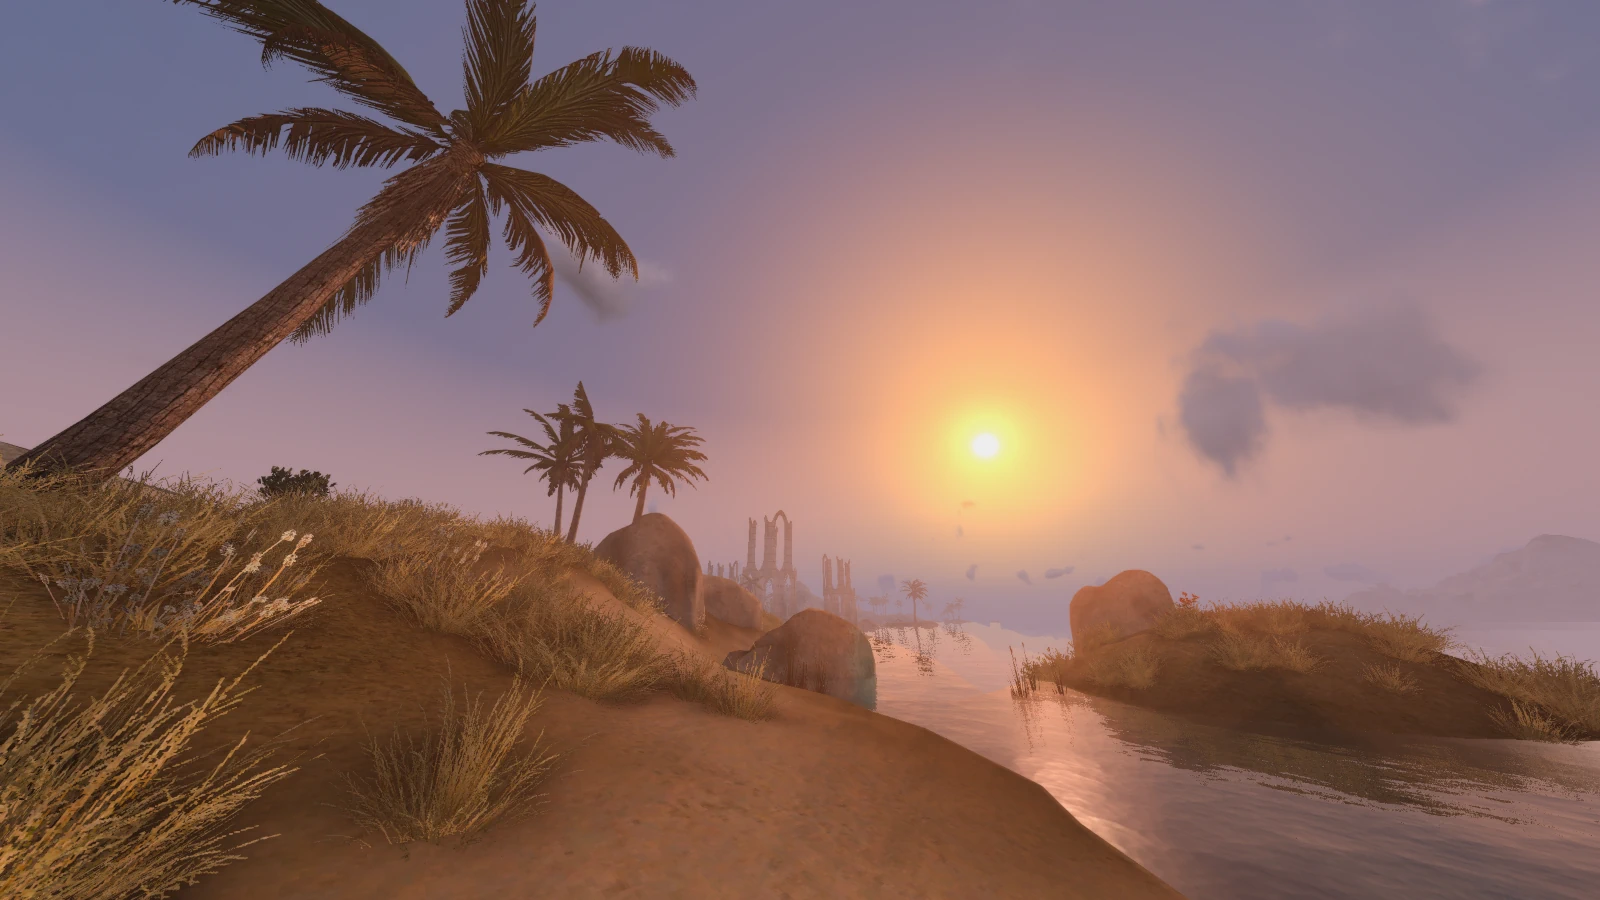
OpenMW avec les données de Morrowind
Source : OpenMW

Avec pour chaque technique des limites et inconvénients avec lesquels le développeur devra composer pour atteindre son objectif.

Ces liens donnent des informations pertinentes et compréhensible sur ces sujets :

Aussi, ce journal de small_duck est particulièrement intéressant et facile à lire, en plus de présenter l’évolution des techniques de rendue antérieures à la rastérisation.

Et ce sera fait pour chaque pixel de l’écran. Pour un rendu en 4K on a 8 millions de pixels, et on cible de 30 à 90 images par seconde en moyenne. Mais les GPU modernes sont très forts à ce jeu-là.

Bon très bien, et le raytracing me direz-vous ? Attention à ne pas confondre avec le Raycasting, dont nous parlait jtremesay dans son journal en 2022.

On l’a vu avec la rastérisation, on procède de la manière qui nous a parue la plus efficace avec les moyens donnés. Mais si on visait des rendus plus réalistes, et par réaliste j’entends physiquement réaliste, il y a d’autres approches.

Dans le domaine de l’illumination globale citée plus haut, le raytracing (« lancer de rayon »), permet de remplacer quantité d’effets simulés par les autres techniques et ce avec une qualité et une fidélité supérieure. Le ray tracing est conçu dans les années 60 par Robert Goldstein, Roger Nagel de MAGi et Arthur Appel d’IBM.

Turner Whitted introduit le raytracing récursif dans un papier en 1980. Il décrit comment l’information de rendu est stockée dans un arbre, se propageant vers les surfaces puis vers les sources lumineuses, permettant de simuler fidèlement réflexions, ombres et réfractions.

Cette technique de rendu procède différemment de la rastérisation. Il faut imaginer que depuis chaque pixel de l’écran, un rayon va être envoyé dans le monde 3D, et quand ce rayon va toucher une surface, on va récupérer sa couleur. On pourra ensuite en fonction des données de la surface, lancer d’autres rayons, qui iront toucher d’autres surface et ainsi affiner la couleur de notre pixel.

C’est très similaire dans l’idée à l’ancienne théorie de la vision émissive.

Image d’une scène 3D constituée de trois sphères, obtenue par path tracing

Source : Path tracing sur Wikipedia

De ce fait, on calcule par un seul moyen, non seulement les couleurs des surfaces, mais aussi leur émission, leurs réflexions, leur ombrage et ce en tenant compte d’objets en dehors de l’espace visible à l’écran. C’est un moyen extrêmement puissant de rendre un monde en 3D, et ce n’est ainsi pas pour rien qu’il est utilisé pour le rendu des films d’animation par Pixar et Dreamworks dès les années 80 (avec une approche hybride) et plus généralement dans les années 2000.

Car il faut dire, et je pense qu’on peut s’en douter, que le raytracing est horriblement peu performant. Le lancer de rayon à lui seul est un goulot d’étranglement monstrueux.

Mais pourquoi s’arrêter en si bon chemin ? Le Path tracing, introduit par James Kajiya en 1986, plus moderne, est une forme de raytracing. À chaque rebond, au lieu de lancer plusieurs rayons déterministes, on tire une seule direction aléatoire selon une distribution statistique. Cela permet de simuler fidèlement la lumière indirecte, les caustiques, les surfaces translucides, au prix d’un bruit important.

D’apparence moins performante et complexe, cette méthode permet toutefois un résultat plus granulaire, en changeant le nombre de rayons initiaux. Le pathtracing doit accumuler suffisamment d’échantillons aléatoires pour que la moyenne converge vers une image propre. Avec peu d’échantillons, l’image est bruitée. Pour réduire ce bruit il faut soit plus d’échantillons (plus lent), soit un bon débruiteur.

Certaines parties d’une scène comme les miroirs ou les surfaces en verre nécessiteront plus de rayons pour rester cohérentes, se rapprochant de la version raytracing plus classique.

Un rendu en pathtracing sur le blog de nVidia
Source: nVidia

Dans le domaine du jeu vidéo, il a ainsi fallu attendre jusqu’à récemment pour que cette technique devienne viable pour du rendu temps réel. C’est nVidia qui a ouvert le bal en 2018 avec une conférence pour le lancement de leurs cartes RTX. AMD suivra avec les RX6000 et surprenamment, Intel avec les Arc.

Cette démo de THREE.js tourne dans le navigateur et affiche une boite de Cornell avec du Path Tracing.

Ces nouvelles cartes utilisent des unités matérielles dédiées au lancer de rayon, opération autrefois purement logicielle. Mais ça ne suffit pas à atteindre la vitesse suffisante pour une expérience fluide.

Ces cartes embarquent donc également une autre technologie, au moins aussi importante que le raytracing. Le DLSS.

Histoire de se faire une idée rapidement, ce mod de DOOM 2 supporte le raytracing et ça change vraiment, avec un rendu atmosphérique !

Capture du mod Doom 2: RAY TRACED

Source : Le mod Doom 2: RAY TRACED sur moddb par shirokii

DLSS, FSR, XeSS, Reflex, Anti-Lag

nVidia présente donc en février 2019 le Deep Learning Super Sampling (DLSS) ou Super Échantillonnage en Apprentissage Profond. C’est une technologie de redimensionnement visant à produire une image plus grande à partir de la sortie du pipeline graphique.

Le défi étant de fabriquer ou de retrouver des détails à partir de pas grand-chose. Le DLSS utilise un réseau de neurones pour produire un résultat plutôt convaincant, surtout à mesure que les versions du DLSS se sont enchaînées. À tel point que le DLSS affiche parfois un meilleur rendu que le rendu natif.

En effet, si le but premier du DLSS et des autres technologies concurrentes est de réduire la résolution de rendu pour gagner en performance, le traitement du réseau de neurones peut être si bon qu’il parvient à reconstituer des détails plus fins que ce que produit le rendu natif.

Pour cela, il se base sur les images affichées, mais également sur des données fournies par le moteur, comme le vecteur de mouvement de l’image.

Il permet également de produire un rendu qui a virtuellement une résolution supérieure au natif qui est ensuite réduit à la résolution native. À la manière d’un Oversampling, mais sans le surcoût occasionné par le fait de rendre en 2 ou 4 fois plus grand.

Le DLSS est une technologie propriété de nVidia, qui utilise (sauf pour les premières versions) des éléments matériels pour fonctionner, des accélérateurs d’IA dédiés appelés Tensor Cores.
Les cœurs Tensor et autres accélérateurs IA peuvent entre autre utiliser des données de type FP16, INT8, INT4 et INT1, retenez-les bien, ça sera important.

Il n’a pas fallu longtemps avant qu’AMD ne se lance également sur le sujet avec son FidelityFX Super Resolution. Avec une approche différente, leurs cartes Radeon n’embarquant pas d’unités dédiées contrairement aux RTX de nVidia.

La première version du FSR est plus proche d’un shader d’upscalling comme ceux utilisés dans l’émulation retro que de ce que fait le DLSS.
Mais il a le mérite d’exister et de s’exécuter sur pratiquement n’importe quoi. Il a aussi le bon goût d’être libre. Il faudra attendre la version 2 pour voir quelque chose de plus intéressant, toujours agnostique du matériel utilisé et libre, et utilisant cette fois les vecteurs de mouvement également.

Cette fois-ci, si on est pas à la hauteur du DLSS on a quand même un gain de qualité par rapport à une résolution inférieure. Aux prix d’une image plus instable. Le FSR 3 (toujours libre et agnostique) améliorera un peu cette situation, mais sans régler tous les problèmes.

DLSS vs FSR 2 vs Native)

Sources : Notebook Check et Digital Foundry

Mais, car il y a un mais. Mais, donc, ces technologies ont un coût. En effet, même en faisant le rendu à une résolution plus faible que le natif et donc plus rapidement, il n’en reste pas moins que la mise à l’échelle prend du temps. Accélérateurs dédiés ou non. Dans un cas où on essayait de ramener des performances perdues lors de l’activation du Raytracing, on se retrouve à augmenter la latence.

Mais, car il y a de nouveau un mais, à chaque nouveau problème technologique, une solution (technologique elle aussi) existe ! nVidia se fend alors de la technologie Reflex, là ou AMD saupoudre son Anti-Lag et distille son Anti-Lag +. Ces solutions logicielles, propriétaires, fonctionnent uniquement sous Windows et à peu près de la même manière. Apparemment de base, le CPU peut préparer plus d’images que le GPU ne peut en afficher, remplissant alors un tampon ou une liste d’attente de rendu.
Plus il y a d’images dans la liste, plus la latence augmente, l’idée est donc de mieux synchroniser le rendu CPU et GPU, pour minimiser la taille de cette liste et donc la latence.

Suffisant ? Je ne sais pas.

Dans le même temps, Intel, qui se tâtait à se relancer sur le marché des GPU dédiés, se fend d’une première gamme de cartes graphiques, les Arc. Les cartes sont en dessous matériellement et logiciellement par rapport à leurs concurrentes, mais parviennent tout de même à faire tourner la plupart des jeux du moment. Si les pilotes ont des soucis de jeunesse, la prise en charge de Linux est de base très bonne et libre.

De manière générale, ces dernières années, le pilote libre des cartes Intel et AMD sous Linux est très bon et celui de nVidia s’améliore et s’ouvre un peu plus très peu mais reste basé sur un socle qui bien que performant est propriétaire.

Bref, Intel à la sortie de ses premières cartes (depuis un bail) les lance avec la gestion du raytracing et un équivalent aux DLSS et FSR : le XeSS. Il est plus proche du DLSS que du FSR, mais est agnostique du matériel comme le FSR. Il n’utilise d’accélérateur IA que sur les cartes Arc (cœur XMX), sur les autres il bascule sur les instructions DP4a pour exécuter son réseau de neurones. Il est souvent meilleur que le FSR en termes de stabilité, parfois pire. Si un SDK est disponible, il n’expose que des bibliothèques compilées. Le code reste donc fermé.

En parallèle de tout ça, arrive la génération d’image.

Maintenant, en plus d’augmenter la taille d’une « vraie » image générée virtuellement à l’ancienne, on va intercaler 1, 2, voir 3 images interpolées. Générées soit de façon analytique, soit via un réseau de neurones. C’est vendu sous le nom de Frame Generation par nVidia et AMD.

Côté AMD, il faut attendre le FSR 4 pour voir une utilisation d’un réseau de neurones.

Comparatif FSR3 et FSR4
Sources : Notebook Check et Digital Foundry

Le FSR fournit alors de bons résultats, et s’il reste légèrement moins qualitatif que le DLSS 4, il représente un saut appréciable par rapport au FSR 3. AMD ferme cette technologie aux cartes RX9000 en RDNA4, évoquant lui aussi l’usage d’instructions dédiées (FP8). Le code source n’est pas officiellement disponible, mais suite à une erreur de publication, le code d’une version du FSR 4 est publié en août 2025.

C’est plutôt ballot et cocasse pour AMD, car en plus de ne pas être voulu, cette version libérée comporte une implémentation fonctionnant sur INT8 du FSR 4. Or, nul besoin de la dernière génération de carte AMD pour les avoir. Ce qui veut dire, et les joueurs vont vite le démontrer en compilant eux-mêmes leur version, qu’il fonctionne en fait sur les cartes d’anciennes générations. Les cartes RDNA2 par exemple, plus vieilles de deux générations que les RX9000 en RDNA4, l’exécutent sans problème. Les cartes RTX 30 de nVidia également. Et si le gain en performance est inférieur aux cartes plus récentes, il reste présent et la qualité — surtout — augmente.

On peut d’ailleurs se demander si cette version du FSR 4 n’est pas la base technique du PSSR de Sony, développé par AMD à destination de la Playstation 5 qui embarque une architecture proche des cartes RDNA2 (elle est hybride). AMD est de son côté resté très silencieux sur le sujet.

On peut imaginer une décision court-termiste pour tenter de gonfler les ventes de la génération 9000, l’avenir dira si c’est un pari payant ou si les joueurs perçoivent cela comme une grossière insulte.

Il en reste la sensation d’un rendez-vous manqué, où le FSR4 aurait pu devenir de fait la méthode de mise à l’échelle universelle, car libre et indépendante de l’architecture. Mais sans qu’on sache exactement pourquoi, elle restera propriétaire et fermée à une gamme de carte.

Bref, à l’heure actuelle, seul les FSR 1, 2 et 3 sont libres et intégrables dans les moteurs de rendu libres comme Godot. Le DLSS et le XeSS restent utilisables pour qui en a la volonté. Le projet J.E.N.O.V.A qui permet notamment de coder en C++ sans passer par les GDExtenssions, utilise le DLSS par-dessus Godot et implémente le raytracing via le kit RTX de nVidia, mais cette portion est propriétaire pour le moment.

Ah ! Et bien entendu, à l’exception des FSR 1, 2 et 3, toutes ces technologies ne gèrent que DirectX. Sous Linux il faut donc passer par Wine / Proton / DXVK pour les exécuter.

DLSS 5

Annoncé en 2026, le DLSS 5 n’est pas une itération du DLSS au sens classique du terme, ce n’est ni de l’upscaling ni de la génération d’image. Le DLSS 5 prend en entrée la couleur et les vecteurs de mouvement d’une image, et utilise un modèle d’IA pour y injecter un éclairage et des matériaux photoréalistes, de façon déterministe et stable temporellement d’après nVidia.

Le système est a l’état de preuve de concept, nécessitant deux RTX 5090 : l’une pour jouer, l’autre exclusivement pour faire tourner le DLSS 5. L’utilisation d’une seule carte reste l’objectif pour la sortie prévue à l’automne 2026. On bascule d’une amélioration de rendu, à une génération de rendu. Ce changement de paradigme est loin de faire l’unanimité. Si l’image que vous voyez est en grande partie inventée par un réseau de neurones, s’agit-il encore du jeu que les artistes ont conçu ?

Dira-t-on bientôt à un assistant dans Unreal : « Voilà mon niveau de test fait de boîtes simples, transforme-le en cathédrale. » ? Cela mènera-t-il à une uniformisation des graphismes ? À une crise pour les artistes 3D ?

Présentation du DLSS 5 par nVidia
Source : nVidia

Tout est possible. Il est également possible que les joueurs ne veuillent pas de cette technologie. Mais si actuellement les rendus peuvent se trouver dans la vallée dérangeante, il y a fort à parier que ça va rapidement devenir indiscernable d’un rendu classique de très haute qualité. Une fois la boîte ouverte, difficile de la refermer.

Reste le problème de confier la direction artistique à une machine, et le fait que cette technologie est encore une fois propriétaire.

Et ça c’est un problème plus important qu’on ne le penserait, car il concerne en fait plus d’utilisateurs que les libristes convaincus. En effet, si nVidia avec son DLSS 5 altère à ce point le rendu des jeux avec un réseau de neurones, il y a fort à parier qu’AMD et Intel vont suivre.

Mais pas avec le même modèle, pas avec la même technique. Et donc produiront un résultat différent. On peut donc craindre que selon la carte de l’utilisateur, le rendu soit variable.

La méthode enjolive l’image à un tel point qu’on peut également imaginer se passer de toute autre technique d’illumination pour revenir à de la pure rastérisation. Le raytracing étant alors relégué aux oubliettes des méthodes de rendu. Beaucoup de questions et peu de réponse, on verra bien.

Après cette première présentation du DLSS 5 qui a laissé les joueurs assez mitigés, nVidia a tenu à montrer d’autres usages du rendu neural, avec une présentation au GDC 2026 faisant la démonstration du NTC (Neural Texture Compression). Un système de compression de texture basé sur un réseau de neurone.

Implémentation par moteurs

L’intégration des technologies d’upscaling et de rendu avancé dans un moteur est une tâche qui peut être complexe.

Sur les moteurs propriétaires, Unreal Engine 5 intègre nativement le raytracing, le DLSS, le FSR et le XeSS. Epic a les moyens pour maintenir ces intégrations à jour et a un soutien de nVidia, AMD et Intel.

Unity les gère également. Ne les utilisant pas je ne saurais en parler avec pertinence, ça a l’air de très bien fonctionner. Il est intéressant de noter qu'Intel ne publie plus son plugin Xess pour Unity, pendant que le DLSS est implémenté au travers du High Definition Render Pipeline

Pour les moteurs libres comme Godot, la situation est différente.

Le raytracing n’était pas forcément une technologie très pertinente ni très facile à implémenter pour des jeux indépendants il y a quelques années. Il n’y a donc pas eu de vrai volonté de l’implémenter, d’autant que d’autres techniques plus classiques existent et fonctionnent sur toutes les cartes, permettant un rendu très qualitatif.

Mais cette situation qui est restée au point mort pendant quelques années a changé assez rapidement, avec une PR pour « mettre en place la plomberie nécessaire au raytracing ». Elle a été intégrée début 2026 dans la version 4.7, et dans la foulée nVidia a publié un fork de Godot supportant le pathtracing et le DLSS. Cette expérimentation ne prend en charge actuellement que les cartes nVidia, mais se base sur la PR mentionnée plus haut, et devrait à terme permettre un pathtracing agnostique de la carte utilisée.

À voir cependant si elle sera intégrable en l’état, ayant été codée avec l’aide de Claude et de Cursor. Elle permet en tout cas de montrer ce qui est actuellement possible en utilisant les briques bas niveaux de Godot, et permet d’espérer voir le tracé de rayon officiellement utilisable avec le moteur dans un avenir proche. Pour rester indépendant d’un vendeur de carte, il faudra aussi intégrer un débruiteur en remplacement de celui utilisé, spécifique à nVidia. Cette vidéo de Leroy Sikkes de chez nVidia au GDC 2026 présente toute la méthodologie du projet.

Le FSR 3 (le dernier à être resté libre et agnostique) est intégrable, mais actuellement seul le FSR2 est disponible sans compiler une PR. Le DLSS et le XeSS le sont aussi techniquement, via des greffons communautaires ou officiels, mais requièrent une acceptation de licences propriétaires. Ils ne seront certainement jamais intégrés directement dans le moteur, pas sans changement de licence. Le FSR 4 tombe dans la même catégorie pour le moment du fait de l’incertitude sur sa licence, même si l’implémentation publiée par erreur par AMD était utilisable, elle concerne DirectX, et non Vulkan, et ne pourrait être exécutable que sous Windows (ou éventuellement via Wine/Proton/DXVK).

Si on regarde du côté de Bevy, des contributeurs ont proposé des implémentations du DLSS, du FSR et même un début d’implémentation du raytracing avec Solari. Les articles rédigés par l’auteur de Solari sont d’ailleurs fabuleux.

Au-delà de tout ça, dans le but de réduire l’impact sur les performances et de produire un meilleur résultat, les technologies de raytracing se voient souvent complétées par des dé-bruiteurs et une pelletée de technologies propriétaires assistées par IA.

Comparaison raytracing et debruiteur
Source : Dépôt NRD

L’image brute d’un rendu par lancer de rayon est un champ de points colorés aléatoires. Pour en faire une image propre, il faut la débruiter, et c’est là que l’écosystème de technologies se remet à foisonner.

On peut les classer en deux familles : les débruiteurs analytiques (qui utilisent des algorithmes et du filtrage) et les débruiteurs neuraux (qui utilisent des réseaux de neurones entraînés sur des données de rendu). Les premiers ne nécessitent généralement par une carte particulière alors que les seconds ne sont compatibles qu’avec certaines gammes de cartes.

L’écosystème construit par nVidia est le plus propriétaire de tous, mais c’est de loin le plus complet et le plus documenté. C’est le RTX Kit, il propose le NRD — NVIDIA Real-time Denoiser, un débruiteur analytique qui fonctionne par accumulation temporelle de pixels sur plusieurs frames, et interpolation spatiale entre pixels voisins. Le NRD (une fois n’est pas coutume) est disponible en source ouverte, agnostique de l’API (DX12 et Vulkan), et peut donc être intégré dans n’importe quel moteur.

nVidia fournit également le Ray Reconstruction, un débruiteur neural. Il reconnaît les différents types d’effets raytracing pour prendre de meilleures décisions sur l’utilisation des données temporelles et spatiales, et conserve des informations haute fréquence que les débruiteurs classiques ont tendance à lisser.

Enfin le NRC (Neural Radiance Cache) utilise des réseaux de neurones pour estimer la lumière indirecte avec plus de précision. Extrapolant un éclairage indirect avec moins de lancer de rayons.

AMD a longtemps été en retard sur toute cette gamme de techniques de débruitage et d’amélioration, de même qu’avec l’implémentation et les performances en raytracing. La situation s’améliore avec FSR Redstone, qui veut agréger les technologies dévelopées par AMD dans le but de proposer un équivalent au RTX Kit, mais le retard reste mesurable.

Ainsi l’équivalent AMD du Ray Reconstruction de nVidia est le FSR Ray Regeneration. Un débruiteur basé sur un réseau de neurones qui prédit et restaure les détails raytracing. Il ne nécessite pas d’être lié à un framework de rendu spécifique, ce qui est un avantage pratique. La qualité est apparement en dessous de ce que propose nVidia.

Le FSR Radiance Caching est conceptuellement proche du NRC de nVidia, mais AMD est encore en phase de déploiement — la mise en production était prévue pour 2026.

AMD n’a pas de débruiteur analytique grand public équivalent au NRD, ce qui laisse encore un trou dans sa raquette pour les cartes qui ne peuvent pas utiliser le FSR Redstone.

Intel est le moins avancé des trois sur ce front. Son offre se concentre autour de XeSS 2.

XeSS 2 comprend trois technologies : XeSS Super Resolution (la mise à l’échelle AI), XeSS Frame Generation (interpolation de frames), et Xe Low Latency (XeLL), qui s’intègre au moteur de jeu pour réduire la latence d’entrée.

Intel n’a pas de débruiteur neural dédié au raytracing comparable au Ray Reconstruction ou au FSR Ray Regeneration. Pour le débruitage, les jeux utilisant les cartes Arc sont tributaires des débruiteurs intégrés aux moteurs (NRD si le développeur l’a intégré, débruiteurs propriétaires des moteurs comme Lumen, etc.).

Il faut mentionner que depuis des années, Intel et la communauté open source proposent Open Image Denoise (OIDN), un débruiteur libre basé sur des réseaux de neurones, utilisé notamment dans Blender et d’autres applications de rendu offline.

Également des algorithmes comme ReSTIR visent à réutiliser les tracés d’une image précédente pour réduire le temps de rendu.

Impact sur les performances

Pour se faire une bonne idée de l’impact du raytracing, il peut être intéressant de comparer des titres usant de cette technologie et de la rastérisation plus classique.

Cyberpunk 2077 est par exemple une vitrine du raytracing et du pathtracing.

Cette vidéo donne un bon aperçu technique, pour un rendu en 1440p, avec DirectX12 et en qualité utra. Une RTX 4070 Ti passe ainsi de 100 IPS en rastérisation à 80 en raytracing puis à 51 en pathtracing. La RX 7900 XTX d’AMD elle part de 134 IPS, puis 59 en raytracing et 20 en pathtracing. Et les deux carte utilisent DLSS/FSR pour atteindre ces chiffres.

La perte d’IPS est abyssale chez AMD, la faute à une première implémentation du raytracing alors que nVidia en était déjà à sa troisième itération. La situation s’est un peu améliorée avec les générations suivantes.

Techspot propose un comparatif très complet, avec non seulement l’écart de performance entre rastérisation pure et raytracing mais aussi avec les visuels pour constater (ou non) l’apport du raytracing.

Ce qu’on voit immédiatement c’est que dans beaucoup de jeux, la différence visuelle est minime. Les techniques classiques sont en effet terriblement efficaces pour imiter les effets de lumières, d’occlusion ambiante, d’éclairages indirects, etc. Sur d’autres titres (comme Cyberpunk), l’impact est beaucoup plus visible. Il y a donc une différence liée à l’utilisation du raytracing. La plupart des jeux présentés dans le comparatif utilisent le lancer de rayon dans une approche hybride, en complément de la rastérisation.

L’impact sur les performances est réduit, de même que la différence visuelle. Par ailleurs, la direction artistique change également la donne. Si un niveau ne comporte aucune surface réflective, on aura du mal à constater l’apport du raytracing.

De manière générale, si le lancer de rayon est pleinement utilisé, on table sur environ 30-50% de performances en moins. Et c’est déjà fantastique si on se rappelle d’où on vient.

Dans sa publication THE RENDERING EQUATION, Kajiya présente deux images qui font 256 × 256 pixels, générées sur un IBM-4341. La première ayant pris 401 minutes de temps CPU et la seconde 533 minutes.

On arrive aujourd’hui, 40 ans plus tard, à rendre des images en 4K avec une fluidité suffisante pour le temps réel. En outre, il est probable de voir les performances de rendu augmenter dans les prochaines années.

Impact sur le développement

Le raytracing et le pathtracing, c’est génial, mais pour le développeur qui doit sortir un jeu, ça représente un sacré paquet de nouvelles contraintes.

Déjà, le matériel supporté. Si vous développez un jeu avec le pathtracing comme pilier central, vous excluez de fait une bonne partie de votre audience potentielle. Les cartes avec des unités matérielles dédiées au lancer de rayon restent, en 2026, loin d’être universelles. D’après les enquêtes de Valve, la moitié des cartes les plus utilisées ne le gère pas ou pas très bien.

Les joueurs sur des machines plus modestes, ou sur des cartes trop anciennes, ne pourront pas jouer à votre jeu — ou joueront dans des conditions dégradées. Pour un studio qui vise la plus large audience possible, c’est compliqué.

C’est d’ailleurs pourquoi la plupart des jeux qui utilisent le raytracing le font de manière hybride. On conserve la rastérisation comme base, et assaisonnent avec du lancer de rayon sur certains effets précis : les reflets, les ombres, l’occlusion ambiante. Le raytracing est un bonus visuel pour ceux qui ont le matériel pour en profiter, pas une fondation sur laquelle repose tout le rendu. Mais certains jeux comme Indiana Jones et le Cercle Ancien utilisent explicitement et uniquement le lancer de rayon, rendant leur utilisation impossible sans une carte récente au grand dam des joueurs les moins bien lotis.

Pour le développeur, cela signifie qu’il faut souvent maintenir deux méthodes de rendu en parallèle : la rastérisation (et toutes ces techniques raffinées), et le raytracing. Deux approches très différentes, deux séries de bugs potentiels, deux validations distinctes. Conduisant inévitablement à un surcoût appréciable.

Le raytracing a besoin d’accéder à l’intégralité de la géométrie de la scène pour fonctionner, y compris ce qui n’est pas visible à l’écran. Là où la rastérisation peut se permettre d’ignorer allègrement tout ce qui est hors champ (autant que faire se peut). Le lancer de rayon, lui, doit potentiellement rebondir sur n’importe quelle surface. Cela implique de gérer des structures d’accélération (les BVH, Bounding Volume Hierarchies) qui doivent être mises à jour à chaque image pour les objets en mouvement. Un coût supplémentaire, là encore, même si c’est ce qui permet notamment d’afficher des réflexions complètes.

Du côté des artistes 3D, le passage au raytracing change aussi les habitudes de travail. Une part fascinante de ce métier consiste justement à tricher habilement : placer des sources de lumière pour compenser l’absence d’illumination globale, peindre à la main des cartes de lumière, jouer avec des sondes de réflexion, développer des shaders en araméen à la limite de la prestidigitation et du pacte diabolique. Des techniques qui demandent de l’expérience et un certain sens artistique du bricolage et de l’adaptation.

Avec une propagation de la lumière physiquement réaliste, certaines de ces astuces deviennent complètement inutiles — ce qui peut être un soulagement — mais certaines habitudes et flux de travail doivent être abandonnées ou repensées. Une lumière placée à un endroit étonnant pour une raison purement artistique va se comporter différemment dans un moteur qui simule la physique réelle de la lumière.
D’un autre côté, le fait de pouvoir visualiser le comportement réaliste de la lumière et des réflexions dans une scène permet aussi de s’en approcher plus finement avec les techniques classiques.

Le raytracing peut simplifier certains aspects du travail (plus besoin de calculer à l’avance des lightmaps, les réflexions et les ombres se génèrent automatiquement; tout ceci avec un coût en termes de performance. Un coût d’autant plus pesant que le prix des composants s’est envolé à cause de l’intelligence artificielle.

La question du DLSS 5 et plus généralement du rendu neural mentionnée plus haut ajoute une couche de complexité supplémentaire. Si le rendu peut être altéré (voir complètement généré) par un réseau de neurones, la notion même de direction artistique devient discutable.

Les artistes conçoivent une ambiance, une intention visuelle. Disent des choses au travers les images, la musique. Mais si tout passe ensuite dans une boîte noire qui réinterprète différemment ses entrées selon la carte du joueur, qui est vraiment responsable du résultat final ?

Sera-t-il encore satisfaisant pour les créateurs et les joueurs de concevoir des mondes virtuels dans ces conditions ?

C’est une question que l’industrie commence à peine à se poser sérieusement, et elle se pose pour toutes les œuvres artistiques depuis l’avènement de l’IA.

Enfin, si le développement se fait avec un moteur libre comme Godot ou Bevy, la situation est encore un peu particulière. On l’a vu plus haut, l’écosystème du raytracing et ce qui gravite autour est aujourd’hui dominé par des technologies propriétaires. Et les moteurs libres, par définition, ne peuvent pas les intégrer directement sans franchir des lignes qui iraient à l’encontre de leurs principes — et au moins de leur licence.

Concrètement, ça veut dire que le développeur qui choisit Godot aujourd’hui pour faire un jeu avec du raytracing va défricher un territoire sauvage. Les briques de base existent mais rien n’est prêt à être utilisé sans se retrousser les manches sérieusement.

Pour la mise à l’échelle, le FSR 2 est disponible, le FSR 3 intégrable. Les DLSS ou XeSS peuvent être implémentés, mais avec des licences à accepter, ce qui rend improbable toute intégration officielle dans le moteur. Le développeur qui veut tout ça devra donc assembler lui-même sa chaîne, en acceptant de dépendre de solutions tierces dont la maintenance n’est pas garantie par l’équipe de Godot.

Le plugin Solari de Bevy est pour le moment réservé aux cartes nVidia également, ça changera certainement rapidement.

Si on regarde du côté de Wicked Engine par contre on a bien un moteur supportant le raytracing et fonctionnant sur toutes les cartes. Il est un peu plus niche que Godot ou Bevy mais très impressionnant.

Pour revenir à Godot, ce n’est pas forcément un drame. Il dispose de techniques d’illumination globale très capables comme le SDFGI, le VoxelGI, les sondes de reflexion, etc, qui permettent d’atteindre des rendus très convaincants sans lancer un seul rayon. Et pour beaucoup de styles artistiques (jeux stylisés, pixel art, low poly) la différence entre raytracing et rastérisation ne se justifie pas vraiment.

Il y a eu d’autres approches ces dernières années qui ont eu un impact sur les moteurs, les techniques de géométrie virtuelle par exemple. Nanite, disponible dans l’Unreal Engine en est un bon exemple.

Les maillages sont découpés en hiérarchies de clusters de triangles lors de l’import, puis ces clusters sont échangés à la volée selon la vue caméra, sans couture visible. Remplaçant les techniques plus communes de LOD. En pratique, ça veut dire qu’on peut importer directement des scans photogrammétriques de plusieurs millions de polygones, sans passer par les étapes habituelles de re-topologie et d’optimisation. Permettant de ne plus se soucier du budget de polygones et des LODs.

Du moins dans certaines limites. Si cette approche permet d’avoir des transitions inexistantes entre différents niveaux de détails, il n’en reste pas moins que dans beaucoup de cas, une utilisation des LODs et un bon travail d’optimisations des ressources et du maillage permet d’atteindre de meilleures performances. Importer les yeux fermés des object 3D de plusieurs millions de polygones sans même s’en soucier implique forcément des cas sous optimisés. Mais la technologie est là et mature tranquillement.

Introduction To Modern Rendering présente d’une façon digeste et intéressante les technologies du raytracing et des mesh shader.

Du côté des moteurs libres, c’est en chantier. La proposition pour Godot date de 2021, ouverte peu après l’annonce d’Unreal Engine 5, et est toujours ouverte. Rien de concret n’a atterri dans le moteur à ce jour. Bevy est plus avancé sur le sujet : son contributeur JMS55 (encore lui, c’est la personne derrière Solari) travaille activement sur une implémentation, et son article sur la version 0.16 détaille les avancées récentes — notamment l’amélioration de la qualité du DAG (la hiérarchie de clusters). C’est encore une fois très agréable de lire ces articles riches de détails et accessibles.

Bref, pour qui veut être à la pointe de la technique sans passer par du code propriétaire, la route est encore longue. La bonne nouvelle, c’est qu’elle est libre.

De nouveaux venus (Moore Threads, Lisuan Technology)

Le marché des GPU est depuis très longtemps un duopole de fait entre nVidia et AMD, avec Intel en troisième position encore fragile. Bon, OK, nVidia rafle l’essentiel du marché. Mais AMD tire son épingle du jeu (et sous Linux ils jouissent d’une réputation bien plus reluisante que nVidia).

Mais depuis quelques années, avec le contexte géopolitique tendu, la Chine a accéléré le développement de ses propres fabricants de cartes graphiques. Les restrictions américaines à l’exportation de composants avancés vers la Chine, qui concernent notamment les GPU nVidia les plus puissants, n’y sont pas pour rien.

Deux sociétés font parler d’elles : Moore Threads et Lisuan Technology.

Moore Threads est la plus ancienne des deux, fondée en 2020 par Zhang Jianzhong, ancien vice-président de nVidia Chine. Ses cartes actuelles, les MTT S80 et S90, existent depuis quelques années déjà, mais sont restées assez loin derrière la concurrence. Pour la prochaine génération, basée sur l’architecture Huagang, Moore Threads annonce pour sa puce Lushan des gains de 15x en performance dans les jeux AAA, 50x en raytracing, et 16x en traitement géométrique. Des chiffres spectaculaires, mais sans spécifications ni données de benchmarks à l’appui pour l’instant. Et bien sûr, tout dépend d’où on part.

À prendre avec des pincettes donc, mais l’ambition est là et les moyens aussi. La MTT S90 serait au coude à coude avec la RTX 4060.
Ce qui n’est pas une mince affaire pour un fabricant qui n’existait pas il y a 6 ans.

Lisuan Technology est un peu plus récente encore puisque fondée en 2021. Aucune carte n’est encore sortie (même si les envois auraient commencé).

La carte gaming LX 7G106, fabriquée par TSMC en 6nm, est prévue pour le 18 juin 2026 en Chine. En termes de performances synthétiques, elle se situerait dans les parages d’une RTX 4060.

En revanche, la carte ne supporte pas le raytracing.

Ce qui est notable pour nos sujets, c’est que ces deux acteurs, à des stades différents de maturité, arrivent dans un écosystème où les technologies de rendu avancé sont dominées par des standards propriétaires. Pas de DLSS, pas de FSR 4, pas de Ray Reconstruction. Ils devront soit implémenter leurs propres équivalents, soit s’appuyer sur les technologies agnostiques comme le FSR 2/3 ou le NRD d’nVidia.

Leur impact sur le marché mondial restera sans doute limité à court terme, les joueurs ayant de solides alternatives. Mais pour le marché chinois, qui représente une part considérable des joueurs PC mondiaux, ces alternatives domestiques ont une pertinence réelle, et représente des enjeux en termes d’autonomie. Si l’un d’eux parvient à produire une carte compétitive avec des pilotes stables, ce sera un signal fort que le quasi-monopole de nVidia n’est pas éternel.

Espérons que les pilotes seront libres et les technologies développées aussi, ce serait bien.

Et les performances dans tout ça

On a vu défiler beaucoup de technologies dans cet article. Des acronymes abscons, des architectures, des promesses de gains en tous genres. Mais si on prend un peu de recul : est-ce que tout ça rend les jeux plus agréables à jouer ?

Non. Bien sûr. Évidemment.

Attention, je suis aussi sensible que n’importe qui à de beaux graphismes, mais le nerf de la guerre n’est pas là. Surtout quand on voit que le prix des GPU, du stockage, de la RAM et par effet de bords, de tous les éléments d’un PC, ont flambé ces dernières années. Sous l’effet de la demande apparemment infinie de l’industrie de l’IA. Les cartes qui permettent de profiter correctement du raytracing et des technologies qui l’accompagnent se situent dans des gammes de prix de plus en plus élevées.

Leur consommation ne cesse de grimper (une RTX 5090 est une grosse brique tant son radiateur est gros), de même que leur impact écologique. On parle tout de même de composants PC tellement énergivores qu’ils forcent à changer toute l’alimentation de la machine et amènent avec eux une nouvelle norme de connecteur d’alimentation (qui n’a pas forcement très bonne presse).

Et même à des niveaux plus raisonnables, une carte milieu de gamme récente représente un investissement conséquent pour un résultat qui, on l’a vu, n’est pas toujours spectaculairement supérieur à ce qu’on obtenait avant.

L’augmentation des prix est telle que la demande pour des cartes mère en DDR3 poussent certains fabriquant à renouveler leurs stocks.

Ensuite, le Raytracing, les DLSS, FSR, débruiteurs neuraux, la génération d’images, la géométrie virtuelle. Chacune de ces technologies a été conçue pour résoudre un problème (parfois causé par la technologie qui le précède), et chacune en a introduit de nouveaux. Des artefacts visuels, de la latence, des incompatibilités entre fabricants, des exigences matérielles toujours plus élevées, des licences propriétaires. L’empilement de solutions finit par former une pile fragile, le jeu vidéo est un assemblage hétéroclite de techniques barbares et sauvages depuis ses débuts, mais on commence — avec ces nouvelles technologies biberonnées à l’IA — à s’éloigner de la recherche algorithmique pure, de cet esprit MacGyver qui caractérise si bien le développement de jeux vidéos, pour arriver sur une logique de boîte noire.

Ou bien c’est dans la droite ligne de l’héritage des pionniers du jeu vidéo, et ce sentiment n’est en fait qu’une incompréhension face à une révolution trop rapide pour être assimilée correctement.

Face à ça, aller à contre-courant est non seulement possible, mais peut être couronné de succès. Des jeux comme Celeste, Hollow Knight, Vampire Survivor ou plus récemment Balatro, n’ont aucun raytracing, géométrie virtuelle ou débruiteur neural. Ils tournent sur des machines modestes, parfois vieilles de dix ans ou plus, et se jouent avec un plaisir non moins vif.

À l’autre bout du spectre, des productions AAA ultra-techniques ont déçu leurs joueurs malgré — ou parfois à cause de — leur sophistication technique. Comme Pokémon Legends: Z-A qui (au-delà son contenu vidéoludique) souffre d’un manque flagrant d’optimisation, ce qui est un comble quand on parle de la licence Pokemon. Une licence dont les premiers jeux repoussaient les limites de leur support physique.

La technique se remarque essentiellement quand elle est mauvaise. Une conception ancienne mais bien réalisée sera souvent plus agréable qu’une autre plus récente mais à l’implémentation faillible.

De plus en plus de joueurs en ont marre de devoir investir dans des composants toujours plus puissants et réclament des jeux plus optimisés. Mais les grandes compagnies ont apparemment d'autres préoccupations.

La rastérisation bien maîtrisée, avec les techniques classiques évoquées en début d’article, permet encore en 2026 de produire des rendus magnifiques et des expériences fluides sur le parc matériel le plus large. Des moteurs comme Godot, même sans SDFGI ou sondes de réflexion, permettent d’atteindre des résultats visuellement très convaincants sans toucher les limites du matériel.

Je ne doute pas que le raytracing apporte énormément au jeu vidéo, ses qualités sont indéniables. Seulement dans le contexte actuel, je ne cracherais pas sur plus d’optimisation.

Possédant un Steam Deck de Valve, j’aime le fait de pouvoir baisser la consommation du SOC de la console à 3 ou 5 watts.
Ça rend la machine silencieuse, efficiente, et la batterie tient plus longtemps.

Jouer à Batman: Arkham Knight dans ces conditions permet d’atteindre 60 image par secondes quasiment tout le temps. Ce qui est impressionnant, car en plus le jeu est vraiment très beau.
Il a déjà 11 ans, mais reste magnifique. On pourra se rappeler qu’en 2015 il avait souffert de sa mauvaise optimisation.

La grogne des joueurs poussant Rocksteady Studios à mettre la distribution en pause, le temps de résoudre les problèmes techniques avec l’aide d’AMD et nVidia. Problèmes qui auraient évidemment pu être remontés et corrigés en phase de test.

Aujourd’hui on voit des jeux sortir sans la prise en charge de certaines cartes, comme Crimson Desert (qui recevra finalement plus tard la gestion d’Intel), des performances désastreuses à l’image de Borderlands 4 qui semble avoir réussi à transformer ses joueurs en bêta-testeurs, ou bien découpés à la tronçonneuse pour le vendre petits bouts par petits bouts : (Les Sims 4 on parle de toi).

Alors, quand en plus de ces problèmes que les industriels du jeu vidéo nous ont apportés, on ajoute du raytracing uniquement pour surfer sur la vague, ça ne fait qu’enfoncer le clou dans le cercueil de nos machines.

D’un autre point de vue, et en mettant de côté le raytracing, les technologies comme le DLSS et le FSR permettent de prolonger la durée de vie d’un matériel vieillissant. En tout cas, si ce n’est pas utilisé comme un pansement pour palier des performances passables.

Heureusement, des productions comme Resident Evil 4 ou Red Dead Redemption 2 montrent qu’il est encore possible de faire des jeux visuellement magnifiques (et surtout de bons jeux) qui tournent avec trois fois rien. Split Fiction (qui possède un gameplay en perpétuelle évolution), est visuellement superbe et tourne au poil sur une RX580.

Capture d’écran de Split Fiction, qui n’utilise pas le raytracing
Source : The Gamer

On aura sûrement le meilleur des deux mondes un jour ! Enfin j’espère, sinon on pourra toujours se réfugier dans le jeu de rôle papier.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Sortie de la Primtux 9
    Sortie de la Primtux 9 le 1er mars 2026 L’équipe Pritmux est fière d’annoncer la sortie officielle de Primtux9, la nouvelle version de la distribution GNU/Linux dédiée à l’usage éducatif dans la francophonie. Introduction La Primtux 9 fait suite à la Primtux 8, sortie deux ans auparavant (avril 2024). Nouveautés principales Une Primtux basée sur la dernière Linux Mint 22.3. Support jusqu’en 2029. Mise à jour des applications et ajouts. Installation de la suite Thymio possible. Activation pos

Sortie de la Primtux 9

Sortie de la Primtux 9 le 1er mars 2026

L’équipe Pritmux est fière d’annoncer la sortie officielle de Primtux9, la nouvelle version de la distribution GNU/Linux dédiée à l’usage éducatif dans la francophonie.

Introduction

La Primtux 9 fait suite à la Primtux 8, sortie deux ans auparavant (avril 2024).

Nouveautés principales

  • Une Primtux basée sur la dernière Linux Mint 22.3. Support jusqu’en 2029.
  • Mise à jour des applications et ajouts.
  • Installation de la suite Thymio possible.
  • Activation possible d’un filtage DNS afin de protéger les enfants de contenus inappropriés.
  • Un formulaire dédié à la remontée de bugs et la suggestion d’améliorations.

Plus de détails

Le passage à la forge des communs numériques éducatifs : https://forge.apps.education.fr/

De nouvelles applications intégrées

  • Ajout d’enseignements artistiques : Histoire de la musique, Orchestre symphonique, découverte du timbre, ton, mode, hauteur, durée, etc.
  • Ajout de jeux éducatifs : Hanah's Horse (Pacman), Quadrapassel (Tétris), Quatre à la suite (Puissance 4) etc.
  • Ajout d’applications d’apprentissage de l’anglais
  • Ajout d’un exerciseur « maison »
  • Accès à https://duck.ai/.
  • Accès facilité au site « les fondamentaux » du Réseau Canopé : https://lesfondamentaux.reseau-canope.fr/.

Le Primtuxmenu

375 commits avec une grande part de bugs corrigés.

  • Ajout de statistiques sur l’utilisation des applications.
  • Ajout d’un formulaire de report de bugs, fonctionnalités, suggestions.
  • L’ajout/suppression d’une application via apt va rafraichir le menu.
  • La création de thèmes de Noël et de Pâques.

Création de contenu d’aide

  • Diaporama général pour découvrir Primtux.
  • Diaporama détaillé pour les enseignants et ERUN.
  • Mise à jour d’un tableau des logiciels.

Des améliorations techniques

  • Mise en place de chaines automatisées dans la CI : tests de non régression, génération du primtuxwebmenu, etc.
  • Le Primtuxmenu 0.2 est rétrocompatible : on peut l'utiliser sur la Primtux 8.

Configuration système requise et iso

PC récent datant d’au moins 2010 et doté d’au moins 2 Go de mémoire vive, 4 Go recommandés, secureboot désactivé, avec ou sans UEFI, 40 Go libres sur disque dur, SSD recommandé.
Cette version est basée sur Linuxmint 22.3, supportée jusqu’en 2029.

Téléchargement ici : https://primtux.fr/telecharger-primtux/

Les axes d’amélioration pour l’avenir ?

À court terme :

  • Premières briques d’internationalisation (pour être prêt à des besoins européens par exemple).
  • Un moteur de recherche directement intégré dans notre Primtuxmenu.
  • Un Primtuxmenu pilotable en ligne de commande.
  • Un enrichissement autour de l’apprentissage de l'Histoire.
  • Développement d’une version basée sur Debian.

A plus long terme :

  • Une meilleure intégration de la synthèse vocale et de la reconnaissance vocale.
  • Un store pour l’installation de logiciels.
  • Un storybook de présentation de notre design system et des composants réutilisables.
  • La possibilité d’adapter le nombre de sessions aux usages d’un établissement ou d’un foyer.

Remerciements

Merci à l’équipe de développement :

  • Etienne Charignon
  • Stéphane Deudon
  • Jérémie Ferry
  • Philippe Ronflette

À nos créateurs de contenu :

  • Sylviane Deudon
  • Marianne Hurbain
  • Philippe Ronflette

À notre product designer et product manager :

  • Romain Ronflette

À nos testeurs :

  • Pierre Labarbe
  • Olivier Le Borgne
  • Thierry Munoz

A nos partenaires :

  • équipe Jclic : Cyril Pasteur (Besançon 2), Corinne Brutillot et Monique Moizan
  • équipe Gcompris

Liens utiles

Notre documentation : https://documentation.primtux.fr/
Vous désirez contribuer ? https://primtux.fr/participer-au-projet/

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • JemaOS : un système d’exploitation français et souverain pour lutter contre l'obsolescence
    JemaOS est un projet de système d’exploitation français, développé à Sophia Antipolis, qui propose une réponse concrète aux enjeux de souveraineté et de numérique responsable. Le contexte est marqué par l’arrêt imminent du support de Windows 10, une transition qui menace de mettre au rebut près de 400 millions de PC encore fonctionnels à travers le monde. Face à cette obsolescence matérielle massive, JemaOS permet de réhabiliter ces parcs informatiques (machines de 2010 à 2025) en offrant une a

JemaOS : un système d’exploitation français et souverain pour lutter contre l'obsolescence

JemaOS est un projet de système d’exploitation français, développé à Sophia Antipolis, qui propose une réponse concrète aux enjeux de souveraineté et de numérique responsable.

Le contexte est marqué par l’arrêt imminent du support de Windows 10, une transition qui menace de mettre au rebut près de 400 millions de PC encore fonctionnels à travers le monde. Face à cette obsolescence matérielle massive, JemaOS permet de réhabiliter ces parcs informatiques (machines de 2010 à 2025) en offrant une alternative fluide et sécurisée.

Architecture Open-Core et Optimisation Cible

Sous le capot, JemaOS s’appuie sur un modèle Open-Core combinant des briques de Gentoo Linux, Arch Linux et Chromium. Pour garantir des performances maximales sur du matériel ancien, le système mise sur une optimisation par compilation pour l’architecture cible. Cette approche permet de tirer le meilleur parti de chaque processeur, là où des distributions génériques peuvent accuser des lenteurs.

Sécurité par immuabilité et sandboxing

La sécurité du système repose sur deux piliers majeurs :

  • L’immuabilité : Le système de fichiers racine est verrouillé en lecture seule, protégeant le cœur de l’OS contre les corruptions accidentelles ou les écritures malveillantes.
  • Le sandboxing : Toutes les applications et processus sont isolés nativement dans des « bacs à sable ». Cette isolation stricte empêche une faille dans une application de compromettre l’intégralité du système, rendant l’usage d’antivirus tiers obsolète.

Pour l’interface, le choix s’est porté sur Aura Shell (Ash) afin d’offrir une expérience utilisateur réactive et épurée.

Le « dispositif Jema » : le Plug & Play pour s’affranchir des configurations complexes pour les non-initiés

L’aspect le plus original de JemaOS est son mode de déploiement via le dispositif Jema (NdM (rectifiée le 22 mars suite à mise à jour de la doc du projet): qui est au format clé USB mais est « un véritable système embarqué complet. Faisant l'objet d'un brevet, (…) Intégrant son propre processeur, sa mémoire vive (RAM) et son espace de stockage interne). » L’idée est de supprimer toute la complexité habituelle : plus besoin de créer des clés USB bootables, de partitionner des disques ou de modifier des réglages BIOS/UEFI complexes.

On branche le dispositif, et le système démarre. Grâce à un chargeur d’amorçage compatible Secure Boot (via « Enroll MOK »), JemaOS tourne en isolation complète. Il exploite les ressources (CPU/RAM) de la machine hôte sans jamais toucher aux données du disque dur interne.

Écosystème applicatif : PWA et P2P

Pour rester léger, le système déporte la partie logicielle vers des Progressive Web Apps (PWA), dont beaucoup fonctionnent en Peer-to-Peer (P2P) pour garantir la confidentialité :

  • Anima & Nephtys : Messagerie et visioconférence en P2P.
  • JemaNote : Prise de notes avec assistance IA (Mistral).
  • OsiVibe : Un éditeur vidéo 4K multi-pistes qui s’exécute directement dans le navigateur.

Gestion de parc et souveraineté

Le modèle économique semble s’appuyer sur une offre SaaS pour les entreprises, permettant une gestion centralisée assez complète :

  • Pilotage de parc : Suivi des machines, sauvegardes et gestion des droits d’accès.
  • Administration : Gestion des dispositifs Jema et support technique.
  • Souveraineté : L’infrastructure Cloud est hébergée en France, ce qui permet de rester sous protection du RGPD et d’échapper au Cloud Act américain.

Une initiative française intéressante à suivre pour ceux qui s’intéressent au numérique responsable.

NdM: les offres Pro/Ultime/Premium sont orientées entreprises avec un paiement mensuel par utilisateur. Les mises à jour OTA majeures sont payantes. Il est possible d'utiliser JemaOS sans payer (cf la documentation) en désactivant les mises à jour automatiques et installant manuellement les nouvelles versions.
Sur les 14 dépôts publics : la licence varie suivant les dépôts (MIT, AGPLv3, BSD avec clause publicitaire (dont une concernant Google (sic), un dépôt avec le logiciel WidevineCdm propriétaire de Google). La plupart des dépôts n'ont qu'un seul contributeur johnkryptochain, visiblement intéressé par les cryptomonnaies, Telegram et les NFT ; l'autre contributeur a deux commits sur un unique dépôt. L'entreprise qui porte le projet a 10 salariés d'après le site.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • MeshCentral, alternative à TeamViewer et RustDesk
    Ce qui suit est une mise en œuvre basique de l’outil de prise en main à distance MeshCentral. Adapté pour les petits dépannages mais conçu pour les organisations, c’est une solution à évaluer face aux logiciels plus connus comme TeamViewer, AnyDesk ou RustDesk. Je (NdM: YvanM) me garderai cependant de faire un comparatif des fonctionnalités, car je ne connais pas assez cet outil et ses « concurrents ». lien nᵒ 1 : Documentationlien nᵒ 2 : Site officiellien nᵒ 3 : Vidéos de présentationSommaire

MeshCentral, alternative à TeamViewer et RustDesk

Ce qui suit est une mise en œuvre basique de l’outil de prise en main à distance MeshCentral. Adapté pour les petits dépannages mais conçu pour les organisations, c’est une solution à évaluer face aux logiciels plus connus comme TeamViewer, AnyDesk ou RustDesk. Je (NdM: YvanM) me garderai cependant de faire un comparatif des fonctionnalités, car je ne connais pas assez cet outil et ses « concurrents ».

Capture d’écran

Sommaire

MeshCentral c’est quoi ?

MeshCentral propose des fonctionnalités similaires à TeamViewer ou AnyDesk. C’est à ma connaissance le seul outil complètement libre de ce type (il est sous licence Apache 2.0). RustDesk est également régulièrement cité sur LinuxFR, mais c’est un logiciel « open core », on peut donc être rapidement limité avec la version libre selon les usages souhaités.

Le projet était, si ma mémoire est bonne, sponsorisé par Intel dans ses débuts. Il est toujours en développement, mais il n’y a visiblement qu’un seul mainteneur actif. Cette personne semble proposer le développement sponsorisé de fonctionnalités.

Malgré cette confidentialité, MeshCentral propose presque toutes les fonctionnalités qui me semblent nécessaires pour une utilisation en entreprise. Il est également adapté à mes besoins en tant que particulier qui dépanne ponctuellement la famille et les amis :

  • La partie serveur est libre et s’installe sur un serveur Linux (on peut aussi sur Windows) ;
  • Le client supporte Windows, Linux, MacOS, FreeBSD et Android, sur plusieurs architectures matérielles ;
  • La personne qui « prend la main » n’a pas de client à installer, tout se fait par l’interface web du serveur (ce n’est pas forcément un avantage, c’est juste pour expliquer comment ça s’utilise) ;
  • Il n’y a pas besoin de configurer le client pour qu’il pointe vers votre serveur, il suffit de le lancer ou de l’installer ;
  • Quand on prend la main sur les clients, on a accès :
  • Au bureau ;
  • À un shell ;
  • À une fonctionnalité de transfert de fichiers ;
  • Des informations sur le matériel ;
  • On peut se servir d’une machine sur laquelle le client est installé comme « rebond » pour accéder en RDP, VNC, HTTP et HTTPS aux autres machines qui sont sur le réseau du client ;
  • Le client permet un accès permanent ou à la demande ;
  • On peut créer des groupes de machines ;
  • On peut avoir plusieurs utilisateurs sur le serveur, avec des permissions différentes ;
  • Il permet l’authentification multi-facteur ;
  • Il supporte l’authentification locale, SAML, JumpCloud, Azure, GitHub, Google, SSO avec OpenID Connect… ;
  • On peut personnaliser le client et l’interface web ;
  • Il est multitenant ;
  • Il peut utiliser Intel AMT (je n’ai jamais essayé) : « when available, administrators can remotely power on, boot to BIOS and manage a system regardless ofthe operating system state. ». Je m’étais d’ailleurs dit que ça devait être une raison du support d’Intel pour ce projet ;
  • Et un paquet d’autres choses que je ne détaillerai pas.

J’ai une utilisation très restreinte de l’outil, mais j’ai quand même constaté des limitations embêtantes :

  • Il n’est pas possible d’accéder au bureau distant si celui-ci utilise Wayland. Si je comprends bien il faudrait un développeur C qui connaisse Wayland, à bon entendeur ;-). Plusieurs contournements sont possibles :
  • Utiliser l’accès en ligne de commande uniquement, c’est parfois suffisant ;
  • Expliquer à l’utilisateur de rouvrir sa session sous Xorg ;
  • Lancer un serveur RDP ou VNC sur le client, et utiliser le client RDP ou VNC intégré à l’interface web de MeshCentral (voir les suggestions en bas de cette dépêche).
  • En mode « à la demande » sous Windows, je n’arrivais pas à avoir la main sur les fenêtres lancées en tant qu’administrateur. Ça a peut-être changé depuis la dernière fois où j’ai testé (en 2023) ;
  • Je trouve que la documentation n’est pas super, il ne faut donc pas hésiter à aller voir les vidéos qui couvrent beaucoup de sujets.

Installation du serveur

La méthode d’installation dépendra forcément du contexte. Voilà le mien :

  • Je veux que le serveur soit sur mon ordinateur portable (actuellement sous Debian 13). Je n’ai pas de serveur à la maison et je n’ai pas envie de gérer une machine en plus. L’inconvénient c’est que je ne pourrais utiliser MeshCentral qu’à la maison, car j’aurais un enregistrement DNS qui pointera vers l’IP de ma box ;
  • Je veux faire tourner le serveur avec Podman dans un conteneur « utilisateur » (parce que même si j’ai pris l’habitude de Docker, j’ai envie de tester Podman).

En termes de RAM et d’utilisation CPU je ne me fais pas de soucis : pour les petites installations c’est censé tourné sur Raspberry Pi. Effectivement, le serveur démarré et un client connecté, le serveur consomme 90 Mo de RAM et 1 % de CPU (j’ai un i5-4300U, soit 4 cœurs à 1.90GHz)

Premier lancement

On installe podman :

sudo apt install podman

On crée l’utilisateur dédié nommé meshcentral (je trouve intéressant sur le principe d’avoir un utilisateur par service) qui fera tourner le conteneur, et on en profite pour mettre son home dans /srv (car ce n’est pas un utilisateur « normal ») :

sudo useradd --base-dir /srv \
--create-home \
--shell /bin/bash \
--user-group \
meshcentral

On note que par défaut useradd (tout comme adduser d’ailleurs) ajoute automatiquement une plage de sous-UID et sous-GID dans /etc/subuid et /etc/subgid : ces plages seront utilisées par les conteneurs que l’utilisateur meshcentral lancera (voir man 5 subuid).

Dans mon cas je démarrerai le service à la main quand j’en ai besoin, mais si on voulait que notre service puisse démarrer automatiquement à l’allumage de la machine il faudrait en plus exécuter la commande suivante :

sudo loginctl enable-linger meshcentral

On se connecte en tant que meshcentral :

sudo --login --user meshcentral

Il existe sur le Docker Hub des images de MeshCentral, mais je n’en vois pas d’officielles et j’ai envie de bricoler :-). En me basant sur la documentation d’installation, on crée donc un fichier /home/meshcentral/Containerfile (équivalent d’un Dockerfile) avec le contenu suivant :

# On se base sur Debian Trixie en version slim
FROM docker.io/library/debian:trixie-slim

# On définit que la version « latest » de MeshCentral sera installée par défaut
ARG MESHCENTRAL_VERSION="latest"

# On fait les mises à jour, on installe les logiciels nécessaires, puis on
# supprime le cache des paquets
RUN apt-get update \
&& DEBIAN_FRONTEND=noninteractive apt-get full-upgrade --assume-yes \
&& DEBIAN_FRONTEND=noninteractive apt-get install --no-install-recommends --assume-yes nodejs npm tini \
&& rm -r /var/cache/apt/*
# On crée un utilisateur dédié pour lancer le service
RUN useradd --shell /usr/sbin/nologin --user-group --create-home meshcentral
# On utilise ce nouvel utilisateur
USER meshcentral
# On se place dans le bon répertoire
WORKDIR /home/meshcentral
# On installe les dépendances de MeshCentral dans ce répertoire
RUN npm install meshcentral@${MESHCENTRAL_VERSION}
# On définit la variable d’environnement conseillée pour faire tourner node
# en production
ENV NODE_ENV=production
# On lance tini pour qu’il prenne en charge et relaie SIGTERM
ENTRYPOINT ["tini","--"]
# Et finalement on lance meshcentral
CMD ["node","./node_modules/meshcentral"]

On construit ensuite l’image, ici en précisant la version stable de MeshCentral qu’on veut récupérer du dépôt NPM et en appliquant un tag :

podman image build --build-arg MESHCENTRAL_VERSION=1.1.55 --tag meshcentral:1.1.55.

L’image est stockée dans ~/.local/share/containers/storage/overlay/. podman image ls m’indique qu’elle fait 976 Mo.

On crée les volumes :

podman volume create meshcentral-files # pour les fichiers qu’on veut transmettre depuis ou vers les clients
podman volume create meshcentral-data # pour la configuration, les certificats, etc.

Ils se trouvent comme on peut s’y attendre dans ~/.local/share/containers/storage/volumes/.

On fait un premier lancement à la main, ce qui permet de créer le fichier de configuration par défaut et de tester si ça marche. On n’est pas root, donc on ne pourra pas utiliser le port 443. De plus, dans le conteneur MeshCentral ne tourne pas en tant que root et utilisera donc par défaut le port 1025 :

podman run --rm \
--volume=meshcentral-data:/home/meshcentral/meshcentral-data \
--volume=meshcentral-files:/home/meshcentral/meshcentral-files \
--publish 1025:1025/tcp \
--hostname meshcentral \
--name meshcentral \
localhost/meshcentral:1.1.55

Depuis le navigateur web, on peut aller sur https://127.0.0.1:1025 pour s’assurer que le service est accessible. Mais revenons pour l’instant dans le terminal et arrêtons notre conteneur avec Ctrl+C

Comme MeshCentral n’est pas joignable sur le port 80, on ne peut pas utiliser le client Let's Encrypt intégré pour obtenir un certificat. On va donc obtenir un certificat manuellement avec certbot.

Configuration DNS et IP

Sur mon nom de domaine, j’ajoute un enregistrement A aide.domain.example qui pointe vers l’adresse IPv4 de ma box. J’aurais bien aimé faire de l’IPv6 aussi, mais avec le pare-feu IPv6 de ma box Free c’est soit on ouvre tout, soit on ferme tout…

Côté box, j’ajoute une redirection de ports pour que les ports TCP 80 et 1025 arrivent sur l’adresse IPv4 de mon laptop. J’ai également configuré un bail statique sur ma box pour que mon ordinateur portable ait toujours la même adresse IP.

Installation du certificat TLS

On reprend notre utilisateur standard pour installer certbot :

sudo apt install certbot

On lance la commande suivante pour tester l’obtention d’un certificat. Il faudra renseigner une adresse e-mail (utilisée pour prévenir lorsque le certificat expire bientôt) et valider les conditions d’utilisation :

sudo certbot certonly --standalone --domain aide.domain.example --dry-run --test-cert

Si ce premier essai marche, on peut demander un certificat de test. C’est utile pour s’assurer qu’on a bien tous les bons paramètres, car Let's Encrypt applique des limites pour les demandes de certificats valides. On doit demander un certificat RSA (et non ECDSA par défaut) car MeshCentral ne sait pas encore gérer ECDSA. On va aussi utiliser l’option --deploy-hook pour copier le certificat au bon emplacement et avec les bonnes permissions. Le propriétaire de ces fichiers doit correspondre avec l’UID de l’utilisateur à l’intérieur de notre conteneur, sinon la clé privée ne sera pas lisible par MeshCentral. On peut pour cela regarder quel est l’UID des fichiers dans notre volume (/srv/meshcentral/.local/share/containers/storage/volumes/meshcentral-data/_data/), pour le reporter 4 fois dans la commande ci-dessous (dans mon cas 232071). Attention également à adapter le nom de domaine (à 3 endroits) :

sudo certbot certonly --test-cert \
--key-type rsa \
--standalone \
--domain aide.domain.example \
--deploy-hook 'install --verbose --owner=232071 --group=232071 --mode=644 /etc/letsencrypt/live/aide.domain.example/fullchain.pem /srv/meshcentral/.local/share/containers/storage/volumes/meshcentral-data/_data/webserver-cert-public.crt; install --verbose --owner=232071 --group=232071 --mode=600 /etc/letsencrypt/live/aide.domain.example/privkey.pem /srv/meshcentral/.local/share/containers/storage/volumes/meshcentral-data/_data/webserver-cert-private.key'

Si tout se passe bien, on peut exécuter la même commande mais sans l’option --test-cert et on aura cette fois un certificat valide. Celui-ci est valable 3 mois, et par défaut est renouvelé automatiquement par le service systemd certbot.service déclenché par le timer certbot.timer. Comme je suis sur un laptop et que ce renouvellement ne peut fonctionner que si je suis chez moi, je désactive l’exécution automatique :

sudo systemctl disable certbot.timer

Quand j’aurais besoin de renouveler le certificat et que je serai à la maison, j’aurais simplement à faire sudo systemctl start certbot.service (enfin c’est comme ça que j’ai compris le mécanisme, je n’ai pas testé).

Configuration textuelle de MeshCentral

On va maintenant modifier le fichier de configuration qui a été généré au premier démarrage de MeshCentral. Depuis l’hôte, en tant que l’utilisateur meshcentral, la solution la plus simple est de lancer podman unshare vim ~/.local/share/containers/storage/volumes/meshcentral-data/_data/config.json. Ça permet d’être dans le bon namespace pour avoir les droits d’écriture sur le fichier. On pourrait aussi utiliser notre compte root de l’hôte mais c’est intéressant de connaître l’existence de podman unshare qui semble bien utile pour comprendre et résoudre des problèmes.

Dans mon cas j’ajoute simplement les directives suivantes sous settings. On peut laisser les commentaires déjà présents dans le fichier. Les curieux iront lire la documentation (par exemple ici) pour voir tout ce qu’il est possible de faire :

  • "cert": "aide.domain.example" pour indiquer comment MeshCentral est joignable ;
  • "port": "1025" pour spécifier le port plutôt que de prendre le premier disponible ;
  • "WANonly": true parce que les fonctionnalités de LAN ne m’intéressent pas ;
  • "amtManager": false parce que je ne vais pas me servir d’AMT (je ne sais pas si ça marche vraiment parce qu’il écoute toujours sur le port 4433, mais ça n’est pas gênant, car le port n’est pas exposé sur l’hôte).

On peut relancer MeshCentral pour s’assurer que ça fonctionne.

Création du quadlet

Bien que Podman supporte les fichiers docker-compose.yml (si on installe le paquet Debian podman-compose), il cherche avant tout à s’intégrer au mieux avec systemd. Pour ça il propose les quadlets (voir man 5 quadlet), qui sont un type d’unités systemd qui permettent de faire à peu près la même chose qu’un fichier docker-compose.yml. On va utiliser cette méthode pour faciliter le lancement ultérieur de notre conteneur. Ici, je vais placer mon unité systemd dans le répertoire de mon utilisateur meshcentral. On crée le bon répertoire :

mkdir --parents ~/.config/containers/systemd/

Et on y crée le fichier ~/.config/containers/systemd/meshcentral.container avec le contenu suivant :

[Unit]
Description=Meshcentral in a Podman container
# C’est déjà une dépendance implicite, mais je la mets pour que ce soit explicite
After=networking.target

[Container]
Image=localhost/meshcentral:1.1.55
ContainerName=meshcentral
HostName=meshcentral
PublishPort=1025:1025
Volume=meshcentral-files:/home/meshcentral/meshcentral-files
Volume=meshcentral-data:/home/meshcentral/meshcentral-data
# Je ne sais pas si c’est c’est vraiment utile mais ça ne coûte rien
DropCapability=all

On indique à systemd de prendre en compte ce nouveau fichier :

systemctl --user daemon-reload

Et on peut démarrer notre service simplement :

systemctl --user start meshcentral.service

Utilisation de MeshCentral

Première connexion
Passons enfin à l’utilisation de MeshCentral. Depuis la page d’accueil de l’interface web, cliquer sur le lien pour créer un premier compte utilisateur.

Une fois connecté, cliquer sur le lien « Créer un nouveau groupe d’appareils ». Pour mon usage basique, je laisse comme type « Gérer à l’aide d’un agent logiciel ».

Installation de l’agent

Il faut maintenant obtenir et installer le client (ici appelé « agent ») sur les postes, et quand on clique sur « Ajouter un agent » à côté du nom du groupe il y a pléthore de choix.

Pour Windows

Pour Windows, je ne saurais pas dire exactement quels choix permettent quelles fonctionnalités (installation en tant que service, assistance à la demande sans que l’utilisateur ait les droits d’administration…) car je n’ai plus de machine pour tester, désolé.

À noter que par défaut l’agent n’est pas signé, donc Windows demande une confirmation avant d’exécuter le binaire.

Pour Linux

Pour Linux, on obtient un agent à installer en tant que service en choisissant « Exécutable d’installation Linux / BSD / macOS », avec « Type d’installation » « Ligne de commande & bureau distant » ou « Ligne de commande uniquement », puis en cliquant sur le lien nommé « MeshAgent ». Il faudra alors faire une commande du type chmod +x && sudo./meshagent pour l’installer (ajouter l’option -install à meshagent pour éviter la pop-up graphique qui demande quoi faire).

L’agent sera installé dans /usr/local/mesh_services/meshagent/meshagent et sera lancé automatiquement par le service meshagent.service. Pour le désinstaller il est possible de supprimer ces fichiers, ou d’utiliser le binaire de désinstallation téléchargeable également depuis l’interface web, toujours via le lien « Ajouter un agent », ou de lancer le binaire installé avec l’option -uninstall.

On obtient un agent que l’utilisateur sans droit root pourra utiliser en choisissant « Exécutable d’installation Linux / BSD / macOS », avec « Type d’installation » « Interactif seulement » (pas vraiment instinctif…). Il faudra dans tous les cas bien expliquer à cet utilisateur comment démarrer ce binaire (car ça dépend de l’environnement qu’il utilise et parce qu’il faut ajouter les droits d’exécution), mais une solution est de lui donner par e-mail une commande toute prête à copier-coller dans son terminal, du type :

cd /tmp/ && wget -O meshagent « https://aide.domain.example:1025/meshagents?id=pYWSORfgTMN%2IdKohzytKQePtv8DzNzbTZcqB2m%24h7MuA4bzXSWJRt6vLN9VBILW&installflags=1&meshinstall=6 » && chmod +x meshagent &&./meshagent

Pour une utilisation à la demande, je m’étais créé un paquet Debian qui une fois installé, permettait par un clic de l’utilisateur de télécharger le binaire et de le lancer, le tout avec une interface graphique basique. C’était de loin le plus simple pour les utilisateurs, mais c’est pas mal de travail.

Avec une invitation

Les méthodes d’installation ci-dessus nécessitent que vous transmettiez le binaire (ou le lien de téléchargement précis) aux utilisateurs. Une autre méthode consiste à inviter les utilisateurs ce qui crée une URL spécifique, accessible sans identifiant, pour qu’ils puissent eux-mêmes télécharger le binaire et obtenir les instructions d’installation. Pour cela, depuis la page d’accueil, cliquer sur le lien « Inviter » à côté du nom du groupe.

C’est à mon sens particulièrement intéressant pour les utilisateurs Windows, puisqu’il suffit de leur transmettre le lien par courriel. (NdM: attention à ne pas habituer les utilisateurs à installer tout et n'importe quoi en un clic sur un lien, en particulier un outil de prise en main à distance. Optez pour un canal de confiance, un courriel signé, etc.)

Mise à jour de l’agent

La mise à jour des agents se fait automatiquement (si nécessaire) après redémarrage du serveur sur une nouvelle version.

Utilisation avec Wayland

Comme dit plus haut, l’agent MeshCentral n’est pas encore compatible Wayland. Voici quelques idées de contournement qui peuvent convenir à votre cas d’usage, ou pas.

Pour avoir accès au gestionnaire de session, j’imagine qu’il suffirait de lancer ce dernier avec Xorg, mais je n’ai jamais testé.

Pour avoir accès à la session on peut en général indiquer à l’utilisateur comment rouvrir sa session avec Xorg. Mais rappelons-nous également que MeshCentral peut se connecter à un serveur RDP ou VNC qui tourne sur la machine, ce qu’on peut faire assez facilement.

Avec Gnome

Si c’est Gnome qui tourne on peut simplement lancer le serveur VNC intégré. On peut indiquer à l’utilisateur de le faire, mais on peut aussi le faire nous-même depuis l’accès en ligne de commande proposé par MeshCentral. À noter que ce serveur VNC écoute sur toutes les interfaces réseau et que même si un mot de passe aléatoire est défini, il est recommandé de l’arrêter lorsque l’accès distant au bureau n’est plus nécessaire :

# on enregistre comment accéder à dbus (nécessaire pour dconf et systemctl
export DBUS_SESSION_BUS_ADDRESS=unix:path=/run/user/"$(id --user)"/bus
# on désactive l’accès RDP qui est activé par défaut
dconf write /org/gnome/desktop/remote-desktop/rdp/enable false
# on active l’accès VNC qui est désactivé par défaut
dconf write /org/gnome/desktop/remote-desktop/vnc/enable true
# on démarre le service utilisateur de partage du bureau
systemctl --user start gnome-remote-desktop.service

Avec KDE

Une solution est d’utiliser le serveur VNC Krfb, qu’on installera avec une commande du type sudo apt install krfb. Il suffit ensuite de demander à l’utilisateur de démarrer ce logiciel depuis le menu (il se trouve dans la rubrique « Internet » et qu’il vous communique le mot de passe.

Comme pour le cas de Gnome juste au-dessus, je recommande également d’arrêter Krfb une fois la prise en main à distance terminée (depuis le menu « Fichier -> Quitter », parce que cliquer sur la croix ferme juste la fenêtre).

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Revue de presse de l’April pour la semaine 2 de l’année 2026
    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Le Monde.fr] «Les Gafam ont colonisé progressivement nos imaginaires» (€) [Le Monde.fr] «La domination de la Chine dans l'IA open source est un défi pour les Etats-Unis» (€) [EurActiv] La Commission européenne veut com

Revue de presse de l’April pour la semaine 2 de l’année 2026

12 janvier 2026 à 14:29

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Le Monde.fr] «Les Gafam ont colonisé progressivement nos imaginaires» (€)

✍ Fabrizio Defilippi, le samedi 10 janvier 2026.

TRIBUNE. L’essor de l’intelligence artificielle, et avec elle d’images produites rapidement, a entraîné un appauvrissement de la créativité en ligne, au point de susciter une vague de nostalgie pour le Web tel qu’il existait auparavant, souligne Fabrizio Defilippi, spécialiste des cultures numériques, dans une tribune au «Monde».

[Le Monde.fr] «La domination de la Chine dans l'IA open source est un défi pour les Etats-Unis» (€)

✍ Alexandre Piquard, le jeudi 8 janvier 2026.

CHRONIQUE. La concurrence entre modèles propriétaires et modèles ouverts et gratuits d’intelligence artificielle est au cœur de l’affrontement économique et idéologique entre l’Amérique de Trump et la Chine de Xi Jinping, explique Alexandre Piquard dans sa chronique.

Et aussi:

[EurActiv] La Commission européenne veut commercialiser l'open source pour en faire un levier de souveraineté numérique FR

✍ Maximilian Henning, le mercredi 7 janvier 2026.

La Commission européenne entend renforcer la souveraineté numérique de l’UE en favorisant la commercialisation des logiciels open source développés en Europe, selon une consultation publiée mardi 6 janvier.

[ZDNET] Linux sera invincible en 2026

✍ Steven Vaughan-Nichols, le lundi 5 janvier 2026.

Linux et l’open source s’apprêtent à connaître une année faste, avec la croissance de PDM sur les ordinateurs de bureau, la montée en puissance de Rust et toujours plus de sécurité.

[France Info] Arrêter la dépendance à Google: Côte-d'Or Street, première numérisation des routes proposée par un département, 'un véritable enjeu de souveraineté'

✍ Auberi Verne, le mercredi 31 décembre 2025.

Le Département de Côte-d’Or a lancé, fin décembre, son propre service de navigation virtuelle sur le réseau routier. Une façon d’assurer son indépendance face à l’hégémonie du géant Google Street View.

Et aussi:

[ZDNET] Libre et open source express (1/2): dons aux assos, exclusion numérique, Acteurs du Libre, Science ouverte, collectivités

✍ Thierry Noisette, le mardi 30 décembre 2025.

En bref. Et vous, qui soutenez-vous? Ce que peuvent faire les entreprises contre l’exclusion numérique, par Emmaüs Connect. Lyon, Grenoble et d’autres villes, retours d’expérience sur l’adoption de solutions libres

Et aussi:

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • Nouvelle année, vœux 2026, voyageons dans le temps
    En cette traditionnelle période de vœux lors du changement d’année, voyons ce qui devrait… changera… pourrait éventuellement changer ou non. Donc une nouvelle fois encore retour sur nos accomplissements passés et projection dans le futur, vers ce que nous aimerions voir plus sur notre site préféré et écouter plus dans notre podcast préféré. Quatre personnes se sont prêtées au jeu de cette dépêche, pas vraiment de vœux, mais un peu quand même. En vrac dans les accomplissements : retours d’expé

Nouvelle année, vœux 2026, voyageons dans le temps

En cette traditionnelle période de vœux lors du changement d’année, voyons ce qui devrait… changera… pourrait éventuellement changer ou non. Donc une nouvelle fois encore retour sur nos accomplissements passés et projection dans le futur, vers ce que nous aimerions voir plus sur notre site préféré et écouter plus dans notre podcast préféré.

Bonne année 2026

Quatre personnes se sont prêtées au jeu de cette dépêche, pas vraiment de vœux, mais un peu quand même. En vrac dans les accomplissements : retours d’expérience, accessibilité, rencontres, arkéologie, transmission, fiabilité, migration, vote électronique, technocritique, documentation et programmation. L’année qui vient, sur LinuxFr.org et Projets Libres, promet d’être fédérée, pérenne, humaine, sobre, excitante, écrite et écoutée, réutilisable, réparable et résiliente.

    Sommaire

    Benoît (Oumph) Sibaud

    Accomplissements, réalisations, progrès de l’année 2025

    Commençons par le serpent de mer de la réduction du retard côté adminsys pour LinuxFr.org : une plus grande partie des services est maintenant portée par une distribution récente (Debian Trixie), avec un mélange de conteneurs lxc et docker. Évidemment on passe toujours trop de temps à gérer du spam et des pénibles. J’ai eu l’occasion de rejouer avec des cartes DRAC pendant les incidents, d’écrire des comptes-rendus d’incident (ne jamais négliger leur importance) et de faire un peu plus de systemd.
    J’ai participé au stand et aux animations sur place lors de la conférence Open Source eXPerience Paris et c’était toujours agréable et remotivant de voir d’autres personnes de l’équipe, de notre lectorat, des libristes connus de longue date et des nouvelles personnes. Le 28 juin 2025, on fêtait les deux ans de la politique de minimisation des données et il ne s’est rien passé car la prochaine étape est en juin 2026 (les premiers comptes avec trois ans d’inactivité).

    Je suis satisfait d’une certaine fiabilité en termes de contenus publiés : les rétrospectives toutes les quinzaines, la traditionnelle dépêche d’appel aux dons, les non moins régulières assemblée générale et publication de bilan et célébration d’anniversaire ou un poisson d’avril.

    En dehors de contenus attendus, j’ai écrit sur les sujets liés à LinuxFr.org (OSI rejointe, incidents du 26 juin et du 26 août), sur des sujets qui m’intéressent (la maintenance, le vote électronique ou le jeu d’apprentissage SQLNoir), des sujets plus tristes (un décès parmi d’autres ou une fin de vie pour un projet), et publié quelques liens sur les licences, la sécurité, le vote électronique, l’Union européenne, les dons, la technocritique et le spam.

    Ce que je voudrais faire, apprendre ou approfondir en 2026

    Déjà dans les reports de 2024, je voudrais m’intéresser au Fediverse et à ActivityPub peut-être, et peut-être à Gemini (le protocole) ? Il y a des travaux en cours sur le service de partage sur les réseaux sociaux share. Par contre j’ai donné moins de conférences en 2024 pour LinuxFr.org et globalement assisté à moins d’événements : donc je réitère l’ambition 2025 de rencontrer plus régulièrement le lectorat ou les personnes contribuant au site ou des publics nouveaux, car c’est appréciable pour le moral et la motivation.

    Hum c’est malheureusement bon on peut garder tel que.

    Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

    De manière générale, je suis toujours intéressé par plus de contenus sur LinuxFr.org (idéalement des dépêches). Mais plus précisément, en termes de sujet, j’aimerai encore et toujours plus d’articles la réparation, la maintenance et la réutilisation, sur la sobriété en informatique, sur la lutte contre la corruption, sur les sujets politiques autour du numérique et des données. Et bien sûr toujours plus de retours d’expérience, de sujets qui ne me viendraient pas à l’idée (sérendipité) et de sujets qui vous passionnent vous (partagez !). Pour Projets Libres, c’est un peu de la triche, j’ai accès à la préparation et j’ai déjà un premier aperçu de la richesse des sujets qui seront traités, mais je sais aussi qu’on compte sur vous pour aider à enrichir les émissions avec vos suggestions diverses et variées.

    Walid (Wawa) Nouh

    Accomplissements, réalisations, progrès de l’année 2025

    L’année 2025 a été chargée puisque 19 émissions ont été diffusées. Nous avons eu aussi l’occasion de parler dans des conférences et des meetups.
    Le podcast continue à gagner en visibilité et d’après nos statistiques OP3 (qui ne sont pas parfaites), pour la première fois deux épisodes ont dépassé les 2000 téléchargements dans le premier mois (Dégooglisons l’évaluation avec Framasoft, et le futur sera fédéré et auto-hébergé avec Elena Rossini).
    J’ai finalement trouvé le temps de poser des mots pour expliquer mon travail sur le podcast, résumé comme ceci : documenter, transmettre, apprendre.
    Bien entendu la grosse actualité de la fin d’année est le rapprochement avec LinuxFr, qui est une suite logique et aussi une reconnaissance de notre travail depuis 2023.
    Pour finir, nous avons eu l’occasion, à travers l’association LinuxFr, de donner des cours d’introduction au logiciel libre dans une école d’ingénieur (Florent Zara, Raphaël Semeteys, Jérôme Herledan et moi-même). Cela confirme mon idée que des prestations annexes sont un moyen intéressant de financer l’édition du podcast et de faire en sorte de ne pas avoir de publicité.

    Ce que je voudrais faire, apprendre ou approfondir en 2026

    Pour cette nouvelle année, Raphaël et moi avons fixé un thème, qui sera la ligne directrice de notre travail sur 2026 : pérennité et résilience.

    – Pérennité, car c’est un sujet qui nous tient à cœur, à travers les épisodes sur les fondations, ou sur les projets qui existent depuis un grand nombre d’années.
    – Résilience : c’est la suite logique de tous les épisodes qui traitent, entre autres du Fediverse, de l’auto-hébergement et de l’informatique responsable et c’est plus que jamais important vu l’actualité géopolitique actuelle.

    Mes souhaits vont sûrement évoluer courant de l’année, mais j’aimerais dans les semaines à venir commencer à tester des OS mobiles basés sur Linux (Ubuntu Touch et PostmarketOS pour commencer), afin de préparer de potentiels épisodes sur le sujet.
    J’aimerais aussi donner plus la parole à des personnes qui utilisent le libre (dans la lignée de l’épisode avec Elena Rossini).
    Bref, beaucoup d’idées, le backlog est d’actuellement une cinquantaine d’épisodes…

    Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

    Je vais surtout passer plus de temps à relire du contenu déjà présent sur LinuxFr :)
    Comme annoncé lors de l’évènement AssocialClub au salon Open Source Experience, il y a toute une intégration du podcast dans et avec LinuxFr à imaginer, cela va être passionnant !

    vmagnin (Vincent)

    Accomplissements, réalisations, progrès de l’année 2025

    Côté accomplissements sur LinuxFr, je suis surtout content d’avoir fait œuvre arkéologique avec ma série automnale de cinq journaux consacrés aux Fiches Libres, au site antique GNULinews et aux Tuxeries (1, 2, 3). Cela a abouti à la modernisation des fiches par Ysabeau et de mon côté à la restauration des Tuxeries, plus de deux cents images et animations du dessinateur JC.

    Toujours à cheval entre passé et futur (donc dans le présent ?), j’ai publié ma dépêche n°7 sur le Fortran. La disparition du service non-libre Netvibes m’a forcé à migrer vers une Pétrolette libre. Et parmi les dépêches auxquelles j’ai contribué sensiblement, je me souviens surtout de Rendez-nous nos boutons !, un questionnement humoristique sur certaines évolutions techniques imposées parfois sans discernement.

    À part ça, en 2025 j’ai migré mes machines de travail d’Ubuntu vers Fedora. Probablement en partie pour retrouver un peu le piment qu’on ressentait à chaque version d’Ubuntu il y a 20 ans. Dans toute vraie passion, il y a apparemment une quête de l’excitation originelle que l’on essaie de retrouver décennie après décennie. Oui, j’essaie aussi de rejouer encore une fois l’excitation pré-adolescente de l’apprentissage de la programmation grâce à Rust. J’ai terminé de lire le livre Développez avec Rust (Dunod).

    Ce que je voudrais faire, apprendre ou approfondir en 2026

    Je suis loin de maîtriser les nouveaux concepts présentés dans ce très bon livre, mais j’ai au moins balayé l’essentiel et j’ai tout 2026, enfin j’espère, pour progresser en Rust. Et aussi avancer un peu dans quelques projets Fortran pro ou perso.

    Continuer à réfléchir sur l’IA et sur la poursuite de l’informatisation du monde. Avec en ce moment comme toile de fond la lecture de La Technique ou l’enjeu du siècle de Jacques Ellul (2ᵉ édition de 1960), qui se termine par : « […] nos plus intimes passions sont connues, publiées, analysées, utilisées. L’on y répond, l’on met à ma disposition exactement ce que j’attendais, et le suprême luxe de cette civilisation de la nécessité est de m’accorder le superflu d’une révolte stérile et d’un sourire consentant. » Après autant de lucidité, on verra si j’ai le courage de lire Le Système technicien (1977) qui se termine par : « L’homme qui aujourd’hui se sert de la technique est de ce fait même celui qui la sert. Et réciproquement seul l’homme qui sert la technique est vraiment apte à se servir d’elle. » Pas glop !

    Bon, ça ne m’empêchera pas d’écouter des podcasts Projets Libres / LinuxFr.org. Et ne soyons pas sombre puisque 2026 est un nombre heureux (voir le site OEIS pour plus de propriétés de 2026).

    Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

    Monomanie technicienne : des trucs sur Rust :-)

    Ysabeau

    Accomplissements, réalisations, progrès de l’année 2025

    Une année moins productive que les précédentes sur le plan informatique, quoique ! En avril un tutoriel sur Mastodon, les balises Alt et deux ou trois autres trucs qui fait partie de ce que je voulais approfondir : l’accessibilité des textes. Par contrecoup, pour mes sites j’essaie d’avoir aussi des images et documents mieux présentés.

    Sinon pour LinuxFr : la dépêche sur Delphine Demange et les compilateurs m’a donné, enfin, l’occasion d’en savoir plus (de découvrir en fait) sur les compilateurs et les commentaires, dont j’ai vraiment apprécié la qualité, de résoudre un mystère vieux de 2020. Avec celle sur la sortie d’Unicode 17 j’ai approfondi ma connaissance des systèmes d’écriture et de ce qui est nécessaire pour qu’il puisse figurer dans le registre Unicode. L’histoire de la convention du mètre et de l’ODF a été aussi un genre d’épopée en ce qui me concerne puisque j’ai profité de l’occasion pour « epubifier » un document complexe avec formules de mathématiques et autres joyeusetés, Le Système métrique décimal. Sa création en France. Son évolution. Ses progrès. Et, évidemment, les fiches libres, que je dois continuer à revoir, ont été sources d’enseignements, j’aime bien l’idée du travail arkéologique. Par contre, j’ai laissé le Transimpressux en jachères.

    Si j’ai relativement peu écrit, j’ai beaucoup tricoté, des bérets, notamment, sur la base d’une méthode que j’ai mise en ligne et qui a réclamé quasiment l’entièreté de mes capacités mathématiques (pas grand-chose). Et en fait, j’aurais pu faire plus simple… Et puis j’ai fait du Banksy.

    Deux versions du marque-page la petite fille au ballon ou les petites filles couleur chocolat tiennent un ballon dans leur main, l’un est en robe rose l’autre en robe jaune
    Marque-pages la petite fille au ballon inspirés de celle de Banksy même si, au final, le résultat est très différent.

    Ce que je voudrais faire, apprendre ou approfondir en 2026

    L’accessibilité, encore et toujours, écrire un ou des tutoriels sur le sujet. Utiliser plus ou mieux Draw pour faire des modèles de jouets de papier. Et, oui, j’ai encore à apprendre sur l’EPUB, et Inkscape. Oh, et continuer des dépêches de la série Transimpressux, il faut vraiment que j’écrive sur l’Unicode dans ce cadre.

    Des contenus que je voudrais voir plus sur LinuxFr.org ou écouter plus dans le podcast Projets Libres (type de contenu, sujet, etc.)

    Des contenus sur l’accessibilité, la réparabilité, le bricolage informatique comme celles du dernier journal de Sébastien Rohaut ou celui d’Ecran Plat sur les clés USB-C lentes. Et aussi plus de contenus sur l’histoire de l’informatique et des logiciels et de l’arkéologique.

    Pour finir

    Nous vous souhaitons tout de même la meilleure année possible (on oscille entre excellence optimisée et résilience robuste ainsi que pérennité soutenable et humour drolatique). Et, bien évidemment, n’hésitez pas à « continuer » cette dépêche dans les commentaires.

    Et un merci à toutes celles et ceux qui font de LinuxFr.org un site enrichi en sérendipité et surprises et de Projets Libres un podcast nimbé de découvertes et bienveillance.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Projets Libres : de OpenAI à Open Source AI, entre propriété commerciale et ouverture collaborative

    Pour cette dernière parution de l'année, Projets Libres vous propose la diffusion d'une conférence de Raphaël Semeteys, co-animateur du podcast à Devoxx France en avril 2025 :

    Explorons l'évolution de l'IA générative en examinant la dynamique entre intérêts commerciaux, éthique et collaboration ouverte.

    En se basant sur une analyse approfondie des niveaux d'ouverture de différent modèles d'IA générative (LLM), illustrons les (changements de) positionnements de certains acteurs commerciaux (OpenAI, Google, Meta, Mistral, Apple…) comme communautaires et collaboratifs.

    Navigons à travers les eaux complexes de la propriété intellectuelle et des licences pour clarifier, via des exemples concrets, les notions de modèles Open ou Open Source .

    Enfin, imaginons ensemble comment la (dé)centralisation de la puissance informatique et de la technologie pourrait façonner l'avenir de l'IA.

    Bonne fin d'année à toutes et tous.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Une rare interview/video de Linus Torvalds : Building the PERFECT Linux PC with Linus Torvalds
      Linus Torvalds est invité dans cette toute récente vidéo sur la chaîne Linus Tech Tips. La vidéo dure presque une heure, ce qui est inhabituellement long pour cette chaîne, et permet de laisser s'exprimer un Linus Torvalds invité. Torvalds s'exprime sur de nombreux sujets tout en regardant un PC « idéal » être monté pour lui et ses travaux sur le noyau Linux. Il discute du Libre, Gaming, Linux, Git, A.I., de son travail, dans une atmosphère bon enfant et avec un humour mordant. lien nᵒ 1 : Vid

    Une rare interview/video de Linus Torvalds : Building the PERFECT Linux PC with Linus Torvalds

    Linus Torvalds est invité dans cette toute récente vidéo sur la chaîne Linus Tech Tips. La vidéo dure presque une heure, ce qui est inhabituellement long pour cette chaîne, et permet de laisser s'exprimer un Linus Torvalds invité. Torvalds s'exprime sur de nombreux sujets tout en regardant un PC « idéal » être monté pour lui et ses travaux sur le noyau Linux.

    Il discute du Libre, Gaming, Linux, Git, A.I., de son travail, dans une atmosphère bon enfant et avec un humour mordant.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Revue de presse de l’April pour la semaine 46 de l’année 2025
      Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [clubic.com] GAIA-X est mort, vive EuroStack [01net.] Souveraineté européenne: ces 40 organisations appellent à miser sur l'IA open source [Sud Ouest] Pessac: un dimanche de convivialité et d'échanges dans l'emblématiqu

    Revue de presse de l’April pour la semaine 46 de l’année 2025

    Par : echarp
    17 novembre 2025 à 17:49

    [clubic.com] GAIA-X est mort, vive EuroStack

    ✍ Guillaume Belfiore, le dimanche 16 novembre 2025.

    Face aux tensions entre les États-Unis et l’Union européenne et à la crainte d’une dépendance technologique américaine, Nextcloud a vu ses demandes de clients tripler au premier semestre. Son PDG nous explique comment cette plateforme open source, désormais adoptée par des dizaines de millions d’utilisateurs en Europe, symbolise aujourd’hui la souveraineté numérique face aux géants du cloud américain.

    [01net.] Souveraineté européenne: ces 40 organisations appellent à miser sur l'IA open source

    ✍ Stéphanie Bascou, le vendredi 14 novembre 2025.

    45 organisations dont Mozilla et Mistral AI demandent aux dirigeants français, allemand et européen de miser sur l’intelligence artificielle open source pour réduire leur dépendance aux modèles d’IA propriétaires et favoriser la construction d’une souveraineté numérique.

    [Sud Ouest] Pessac: un dimanche de convivialité et d'échanges dans l'emblématique salle des fêtes du quartier de France

    ✍ Didier Velasco, le mardi 11 novembre 2025.

    Le Syndicat de quartier de France a organisé une journée conviviale autour du logiciel libre GNU-Linux, avec les associations Terre d’Adeles et Abul, pour les Pessacais

    [Sud Ouest] Rochefort: si vous choisissiez un logiciel libre après l'arrêt de Windows 10?

    ✍ Kharinne Charov, le lundi 10 novembre 2025.

    Samedi 15 novembre, des experts du numérique responsable vous apprendront à adopter un logiciel libre pour prolonger la vie de vos ordis et vous détacher des Gafam

    [Le Monde.fr] Wikipédia: vilipendée par les conservateurs, ébranlée par l'IA, l'encyclopédie sous pression (€)

    ✍ Morgane Tual, le lundi 10 novembre 2025.

    A bientôt 25 ans, l’encyclopédie est confrontée à plusieurs difficultés: accusations de biais «wokistes», contributeurs menacés, contenus générés par intelligence artificielle, baisse de fréquentation… Face à ces problèmes, Wikipédia tient bon. Jusqu’à quand?

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Revue de presse de l’April pour la semaine 43 de l’année 2025
      Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Le Monde.fr] David Monniaux, directeur de recherche au CNRS: «Que se passerait-il si Trump ordonnait aux Gafam de cesser leurs services cloud à l'égard de nos gouvernements?» (€) [Next] Municipales: une dizaine d'assoc

    Revue de presse de l’April pour la semaine 43 de l’année 2025

    Par : echarp
    29 octobre 2025 à 08:55

    Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

    [Le Monde.fr] David Monniaux, directeur de recherche au CNRS: «Que se passerait-il si Trump ordonnait aux Gafam de cesser leurs services cloud à l'égard de nos gouvernements?» (€)

    ✍ David Monniaux, le dimanche 26 octobre 2025.

    TRIBUNE. Dans une tribune au «Monde», le chercheur souligne les dangers de la dépendance numérique européenne à l’égard des géants du Web, soumis à la législation américaine.

    L’auteur de l’article a publié le texte de sa tribune avec des notes de bas de page donnant plus de contexte https://filesender.renater.fr/?s=download&token=4e04dc3a-d695-40ec-9515-762694126479

    [Next] Municipales: une dizaine d'associations proposent 10 mesures de «désescalade numérique»

    ✍ Mathilde Saliou, le jeudi 23 octobre 2025.

    Aux côtés de l’ingénieur Philippe Bihouix, de la journaliste Célia Izoard ou du neuropsychiatre Boris Cyrulnik, des associations, des coopératives et divers spécialistes des enjeux de sobriété numérique appellent les candidats aux municipales 2026 à se positionner en faveur d’une «désescalade numérique».

    [clubic.com] La France, premier pays à investir dans Matrix, le protocole libre sur lequel repose sa messagerie sécurisée

    ✍ Alexandre Boero, le mardi 21 octobre 2025.

    La Direction interministérielle du numérique annonce mardi devenir le premier État partenaire de la Fondation Matrix, qui est derrière le protocole open source qui fait fonctionner Tchap, la messagerie instantanée sécurisée des agents publics.

    [Les Echos] Le cloud et l'open source au secours de la conception des puces électroniques

    ✍ Frank Niedercorn, le mardi 21 octobre 2025.

    Kepler une jeune entreprise francilienne développe une nouvelle approche pour concevoir les circuits intégrés sur un marché aujourd’hui contrôlé par trois mastodontes du logiciel.

    [01net.] Fin de Windows 10: les naufragés de Windows 11 migrent vers Linux

    ✍ Geoffroy Ondet, le lundi 20 octobre 2025.

    La fin officielle du support de Windows 10 a poussé les naufragés dont le PC est incompatible avec Windows 11 à se tourner vers Linux. Et certaines distributions rencontrent un succès inespéré.

    Et aussi:

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Sortie du noyau Linux 6.17
      Nous vous avons entendu. Les dépêches noyaux me manquent aussi. Et entre Google qui veut les attraper tous, sudo qui n’est plus sudo sûr que ça, des pays qui sortent d’Internet, les chats qu’on veut surveiller parce qu’ils ne miaulent pas droit et le rythme de travail pour bien vivre, il est temps de revenir aux fondamentaux. Alors sans plus attendre, quoi de neuf dans la 6.17 ? D’après Linus Torvalds lui-même, It's not exciting — ce n’est pas intéressant. Ce qui, pour lui, est un gage de qua

    Sortie du noyau Linux 6.17

    Nous vous avons entendu. Les dépêches noyaux me manquent aussi. Et entre Google qui veut les attraper tous, sudo qui n’est plus sudo sûr que ça, des pays qui sortent d’Internet, les chats qu’on veut surveiller parce qu’ils ne miaulent pas droit et le rythme de travail pour bien vivre, il est temps de revenir aux fondamentaux.

    Alors sans plus attendre, quoi de neuf dans la 6.17 ? D’après Linus Torvalds lui-même, It's not exciting — ce n’est pas intéressant. Ce qui, pour lui, est un gage de qualité. Le noyau Linux 6.17 a été officiellement publié le 28 septembre, après la RC7.

    Points marquants de la version

    • Des corrections de sécurité et de stabilité dans la pile Bluetooth (beaucoup de bugs de type use-after-free).
    • Des corrections pour les pilotes GPU et réseau (beaucoup de petites corrections).
    • Prise en charge de patch à la volée (live patching) sur ARM 64 bits.
    • Meilleur contrôle sur les atténuations de Spectre/x86.
    • Suppression officielle de la gestion des architectures monoprocesseur, (nous y reviendrons).
    • Introduction de nouveaux syscalls file_getattr() et file_setattr(), permettant la manipulation directe des attributs d’inodes via l’espace utilisateur.
    • Gestion du protocole DualPI2 pour la gestion de congestion TCP.

    Sommaire

    Architecture

    Résumé

    • Intégration et mise à jour de la prise en charge de nombreux SoC ARM, Intel, AMD et RISC-V, dont :
    • Ajout de nouveaux contrôleurs mémoire, avec prise en charge étendue de divers matériels industriels.
    • Pilotes GPU : beaucoup de patchs pour amdgpu, i915/xe (options de debug et prise en charge de nouveaux formats colorimétrique).
    • Les cartes Realtek 8851BU/8852BU sont désormais prises en compte sur le bus USB.
    • Suppression officielle de la gestion des architectures monoprocesseur.

    En détails

    La suppression de la gestion spécifique des architectures monoprocesseur dans Linux 6.17 concerne toutes les architectures (x86, ARM, RISC-V, MIPS, etc.) où le noyau pouvait jusqu’ici être compilé et exécuté en mode UP (pour Uni Processor), opposé au mode SMP (Symmetric MultiProcessing).

    Désormais, même les machines avec un seul cœur ou un seul processeur utiliseront des noyaux compilés avec gestion SMP activée. Cette modernisation simplifie le code de l’ordonnanceur (scheduler) et d’autres sous-systèmes internes du noyau, qui peuvent désormais partir du postulat que le système est au moins SMP, même si physiquement un seul cœur est présent. Cela permet un énorme nettoyage du code spécifique à cette fonctionnalité, et donc, à terme, une meilleure maintenance et une plus grande cohérence.

    Néanmoins, l’impact, même très léger et invisible sur beaucoup de systèmes modernes, est réel. Le coût mémoire et processeur (dû à la gestion des locks) va augmenter légèrement, et impactera plus fortement les systèmes embarqués très contraints.

    Pour les chiffres (et des explications), les tests effectués sur des systèmes monoprocesseurs avec un noyau SMP ont montré une baisse de performance de 5 %, et une augmentation de 0,3 % de la taille. Ingo Molnar, à l’initiative de ce changement, avait pointé le fait qu’il y avait, dans l’ordonnanceur actuel, 175 #ifdef dépendant de #CONFIG_SMP qui ont pu être nettoyés, et avec, plus de 1000 lignes de code supprimées.

    Systèmes de fichiers et stockage

    Résumé

    • Btrfs : la gestion de large folios est ajoutée (expérimental), tout comme des options étendues pour la défragmentation et la compression intelligente des extents. Les premiers tests de performance montrent un gain de 20 % pour la création de fichiers et diverses améliorations…
    • Ext4 : introduction du flag RWF_DONTCACHE permettant la purge automatique des données du cache après écriture, ce qui améliore certains workloads orientés I/O.
    • NFS : prise en charge des délégations d’écriture même en mode write-only, accélérant des cas d’usage précis.
    • Introduction de nouveaux syscalls file_getattr() et file_setattr(), permettant la manipulation directe des attributs d’inodes via l’espace utilisateur.
    • Bcachefs : Les relations entre le développeur de ce système de fichiers (Kent Overstreet) et les autres mainteneurs du noyau se sont largement dégradées. Plusieurs mainteneurs ont fait part de leur refus de travailler à l’avenir avec Kent ce qui a conduit Linus a ne plus accepter les demandes de mises à jour (pull requests). Bcachefs est donc figé dans cette version 6.17 du noyau (et il a été complètement retiré de la future version 6.18). Un module DKMS externe est maintenant disponible pour les utilisateurs voulant continuer à utiliser ce système de fichiers.

    En détails

    Pour ceux qui s’intéressent aux performances et comparatifs des différents systèmes de fichiers avec le kernel, Phoronix a testé ces FS sur ce noyau 6.17. Pas de comparatif avec les précédents noyaux, mais un comparatif entre les FS.

    Le flag RWF_DONTCACHE permet des opérations de lecture ou d’écriture passant par le cache mais où les données lues ou écrites ne sont pas conservées dans ce cache une fois l’opération terminée. Autrement dit, les données ne « polluent » pas le cache mémoire, ce qui est utile pour certains types d’I/O où l’on ne veut pas fatiguer le cache avec des données temporaires ou volumineuses qui ne seront pas réutilisées rapidement. Ce flag est une option pour les appels systèmes preadv2() et pwritev2()

        ret = pwritev2(fd, &iov, 1, 0, RWF_DONTCACHE);

    En ce qui concerne les délégations d’écriture, cela permet de réduire les appels réseaux (jusqu’à 90 % dans certains cas d’usages — rapport)

    Les syscalls file_getattr() et file_setattr() introduits dans Linux 6.16/6.17 permettent la manipulation directe des attributs d’inode depuis l’espace utilisateur, avec une interface plus simple et plus complète que les méthodes existantes.

    Réseau et connectivité

    Résumé

    • Plusieurs nouveaux flags et options : SO_INQ pour AF_UNIX, extension de la gestion de MSG_MORE pour les paquets TCP volumineux et application plus stricte de la fenêtre TCP.
    • Introduction de la prise en charge du protocole de congestion DualPI2 (RFC 9332) pour TCP/IP, notamment sur IPv6.
    • Nouveau sysctl force_forwarding sur IPv6 permettant l’activation du mode forwarding.
    • Remplacement progressif de la gestion des pages réseau par des descripteurs spécialisés (struct netmem_desc), préparant l’évolution vers les folios.

    En détails

    Le nouveau sysctl force_forwarding permet de forcer l’activation du forwarding indépendamment d’autres configurations potentiellement conflictuelles. (En particulier sur des profils limitatifs ou locaux)

        sudo sysctl -w net.ipv6.conf.all.force_forwarding=1

    Petits rappels sur les folios (aussi utilisés dans ce noyau pour Btrfs). Historiquement, le noyau Linux gère la mémoire en unités appelées « pages » (généralement 4K octets). Un folio est un regroupement logique de pages (souvent 2^N pages, comme 16 pages de 4K pour former un folio de 64K). Les folios permettent une gestion mémoire plus efficace, évitent les appels redondants liés aux pages individuelles et optimisent les copies. netmem_desc sert d’abstraction générique pour la mémoire réseau, et utilisant les folios, remplace progressivement le struct page d’origine.

    L’algorithme DualPI2 est un exemple d’algorithme de gestion active de file d’attente à double file couplée (AQM) spécifié dans la RFC 9332. Il sert de composant de base AQM au sein du cadre DualQ Coupled AQM conçu pour gérer deux files d’attente : une file « Classique » pour les contrôles de congestion compatibles Reno et une file « L4S » pour les contrôles de congestion Scalables. Vous trouverez plus de détails dans l'article en lien, avec, page 6 un ensemble de tests de performance en ce qui concerne DualPI2.

    Virtualisation

    Résumé

    • Gestion de GSO (Generic Segmentation Offload) sur tunnel UDP dans virtio
    • KVM : Unicité des enregistrements irqfd
    • vhost-net : Prise en charge de VIRTIO_F_IN_ORDER
    • vsock : Introduction de la prise en charge ioctl SIOCINQ
    • iommu : Révision complète de la prise en charge des IRQs postées
    • vfio/qat : Prise en charge des function virutelle Intel QAT 6xxx

    En détails

    La prise en charge des GSO permet d’améliorer les performances des machines virtuelles en réduisant la charge CPU liée au traitement des paquets UDP.

    L’irqfd (interrupt request fd) a été modifié pour être globalement unique, ce qui améliore la gestion des interruptions virtuelles et évite des collisions ou conflits dans la gestion des événements d’interruption, renforçant la stabilité et sécurité des VM.

    VIRTIO_F_IN_ORDER permet de gérer un ordre strict pour les paquets pour les cartes réseaux virtuelles.

    vfio, qui expose des périphériques aux machines virtuelles, ajoute la prise en charge des fonctions virtuelles des accélérateurs Intel QAT 6xxx (QuickAssist Technology), améliorant ainsi les capacités de calcul cryptographique et compression dans les environnements virtualisés.

    Sécurité et cryptographie

    Résumé

    • AppArmor peut désormais contrôler l’accès aux sockets AF_UNIX.
    • Ajout de nouvelles fonctions pour SHA-1, SHA-256 et SHA-512 dans la bibliothèque crypto.
    • Optimisation de CRC32c sur les CPU récents (AVX-512).
    • La gestion de la profondeur de pile via GCC/Clang permet désormais l’effacement automatisé de la stack (voir SafeStack pour plus de détails).
    • Meilleur contrôle sur les atténuations (mitigations) de Spectre/x86.
    • Ajout d’un délai de 5 secondes sur /sys/fs/selinux/user.
    • Introduction des types neversaudit dans le contexte SELinux.

    En détails

    Pour rappel, AF_UNIX est une classe de socket Unix permettant la communication interprocessus. Avant cet ajout, AppArmor ne gérait pas la sécurité avec ce niveau de finesse pour ces sockets. Désormais, il est possible de restreindre dans les profils AppArmor, la communication via ces sockets, entre deux applications.

    Phoronix a testé les améliorations sur CRC32C sur différentes architectures récentes, qui sont résumées dans le graphique ci-dessous.
    Performances CRC32C

    Le noyau 6.17 introduit un meilleur contrôle sur les atténuations Spectre, grâce à un mécanisme appelé Attack Vector Controls (AVC). Le principe est simple, plutôt que d’activer ou désactiver des dizaines de protections individuelles contre les bugs d’exécution spéculative (Spectre, variantes de Meltdown, etc.), il est désormais possible de les piloter par groupes, selon la portée des attaques. Le noyau classe les atténuations en cinq catégories :

    • attaques utilisateur-vers-noyau (user-to-kernel)
    • attaques utilisateur-vers-utilisateur (user-to-user)
    • attaques invité-vers-hôte (guest-to-host)
    • attaques invité-vers-invité (guest-to-guest)
    • attaques inter-threads (cross-thread)

    Avec un seul paramètre de démarrage mitigations=, il devient possible d’exclure une catégorie entière d’attaques (par exemple, désactiver toutes les protections invité-vers-invité si aucune VM non fiable n’est utilisée) et ainsi récupérer des performances.

    Example: disable user-to-kernel attack mitigations, keep others at auto defaults
    GRUB_CMDLINE_LINUX="... mitigations=auto,no_user_kernel ..."
    

    Cette page liste l’ensemble des vulnérabilités CPU, et est une bonne source d’informations à ce propos.

    Changements internes et outils

    Résumé

    • L'ordonnanceur ajoute le cgroup v2 cpu.max pour gérer de manière plus fine l’utilisation du CPU.
    • Ajout de DAMON_STAT pour le monitoring.
    • Le montage automatique de tracefs sur /sys/kernel/debug/tracing est devenu obsolète au profit de /sys/kernel/tracing.
    • La migration vers des outils plus modernes : l’outil gconfig bascule sur GTK3.
    • Toujours plus de Rust avec de nouvelles abstractions pour la gestion du matériel et des propriétés firmware.

    En détails

    cpu.max est plus précis et global que les précédentes méthodes (utilisant cpu.cfs_quota_us et cpu.cfs_period_us ou cpu.shares), en s’appuyant sur l’extension CFS Bandwidth Control de CFS (Completely Fair Scheduler)

    # Limite de 50ms d’utilisation CPU toutes les 100ms (50%)
    echo "50000 100000" > /sys/fs/cgroup/cpu.max

    DAMON_STAT est un module noyau statique de surveillance de l’espace d’adressage mémoire beaucoup plus léger que les précédentes méthodes

        # Si DAMON_STAT est compilé en module
        $ sudo modprobe damon_stat
    
        # Activation du monitoring 
        $ echo 1 | sudo tee /sys/kernel/mm/damon/stat/enable
    
        # lecture des informations
        $ cat /sys/kernel/mm/damon/stat/statistics
        damon_latency_avg: 23 ms
        damon_bandwidth_bytes_per_sec: 5242880
        damon_coldness_percentile_75: 40%
        # Désactivation
        echo 0 | sudo tee /sys/kernel/mm/damon/stat/enable

    Le bilan en chiffres

    Statistiquement, ce n’est certes pas le noyau le plus calme de la série 6.x, comme nous pouvons le voir sur les graphiques ci-dessous, néanmoins, il reste plutôt tranquille, avec du nettoyage et peu d’ajouts.

    Statistique des noyaux 6.x

    Statistique des RC du noyau 6.17

    Statistique des noyaux 6.x

    Statistique des noyaux 6.x

    Appel à volontaires

    Cette dépêche est rédigée par plusieurs contributeurs dont voici la répartition :

    Mainteneur Contributeur(s)
    Architecture Aucun
    Développeurs Aucun
    Systèmes de fichiers Aucun patrick_g
    Réseau Aucun
    Virtualisation Aucun
    Sécurité Aucun
    Changements internes Aucun
    Édition générale Aucun BAud - vmagnin - orfenor

    Un peu de vocabulaire :

    • le mainteneur d’une section de la dépêche est responsable de l’organisation et du contenu de sa partie, il s’engage également à l’être dans le temps jusqu’à ce qu’il accepte de se faire remplacer ;
    • un contributeur est une personne qui a participé à la rédaction d’une partie d’une section de la dépêche, sans aucune forme d’engagement pour le futur.

    Nous sommes particulièrement à la recherche de mainteneurs pour toutes les parties.

    Si vous aimez ces dépêches et suivez tout ou partie de l’évolution technique du noyau, vous pouvez contribuer dans votre domaine d’expertise. C’est un travail important et très gratifiant qui permet aussi de s’améliorer. Il n’est pas nécessaire d’écrire du texte pour aider, simplement lister les commits intéressants dans une section aide déjà les rédacteurs à ne pas passer à côté des nouveautés. Essayons d’augmenter la couverture sur les modifications du noyau !

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Lancement de la démarche NIRD
      À l’heure où la fin du support de Windows 10 nous oblige à faire des choix, un collectif enseignant de la forge des communs numériques éducatifs invite les établissements scolaires à s’engager progressivement vers un Numérique qui soit davantage Inclusif, Responsable et Durable (NIRD). Condition nécessaire mais non suffisante, l’adoption concrète et graduelle du système d’exploitation libre GNU/Linux au sein de l’établissement scolaire constitue à la fois le socle et le levier de la démarche. P

    Lancement de la démarche NIRD

    À l’heure où la fin du support de Windows 10 nous oblige à faire des choix, un collectif enseignant de la forge des communs numériques éducatifs invite les établissements scolaires à s’engager progressivement vers un Numérique qui soit davantage Inclusif, Responsable et Durable (NIRD).

    Condition nécessaire mais non suffisante, l’adoption concrète et graduelle du système d’exploitation libre GNU/Linux au sein de l’établissement scolaire constitue à la fois le socle et le levier de la démarche. Pour équiper le parc informatique (mais aussi les familles ou les écoles aux alentours) en y menant notamment des projets de reconditionnement si possible avec les élèves. Pour engager petit à petit l’ensemble de l’établissement scolaire vers un usage du numérique qui soit davantage aligné avec ses missions de service public.

    « La démarche NIRD est un projet très ambitieux car non seulement elle souhaite voir à terme une majorité d’écoles, collèges et lycées équipés majoritairement en Linux, mais elle souhaite aussi et surtout s’intégrer pleinement dans la stratégie numérique et écologique des établissements scolaires, ce qui implique notamment la mobilisation des collectivités et le soutien de l’institution. »

    Logo NIRD

    La démarche tire son nom d’une expérience réussie au lycée Carnot de Bruay-la-Buissière témoignant que c’est possible.

    La forge des communs numériques éducatifs est un projet soutenu par le ministère de l’Éducation nationale mettant à disposition des enseignantes et enseignants une instance GitLab CE pour qu’ils créent et partagent eux-mêmes leurs propres logiciels et ressources éducatives libres. Ouverte en avril 2024, la forge compte à ce jour plus de 5000 dépôts.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • 2,2 millions d'utilisateurs de Linux sur ordinateur en France
      Une récente analyse détaillée s’est attachée à quantifier la population d’utilisateurs de systèmes d’exploitation Linux sur ordinateur (hors serveurs) en France. En se basant sur les données publiques de trafic web de Cloudflare Radar et en appliquant une modélisation des comportements, l’étude aboutit à une estimation d’environ 2,2 millions d’utilisateurs uniques. La méthodologie ne se contente pas d’une moyenne globale (3,1 %), mais distingue les usages en fonction des moments de la semaine et

    2,2 millions d'utilisateurs de Linux sur ordinateur en France

    Une récente analyse détaillée s’est attachée à quantifier la population d’utilisateurs de systèmes d’exploitation Linux sur ordinateur (hors serveurs) en France. En se basant sur les données publiques de trafic web de Cloudflare Radar et en appliquant une modélisation des comportements, l’étude aboutit à une estimation d’environ 2,2 millions d’utilisateurs uniques. La méthodologie ne se contente pas d’une moyenne globale (3,1 %), mais distingue les usages en fonction des moments de la semaine et de leur volume de trafic respectif. La conclusion principale est que cet usage est massivement personnel : le taux d’usage à domicile (soir et week-end) atteint 4,3 %, soit plus du double du taux observé en environnement professionnel et scolaire (2,15 %).

    Un communiqué du CNLL commente cette dynamique et appelle à l’amplifier. La fin de support annoncée de Windows 10 en octobre 2025 agit comme un catalyseur, menaçant de transformer des millions d’ordinateurs parfaitement fonctionnels en déchets électroniques. Ce non-sens écologique et économique va encore pousser de nombreux utilisateurs à considérer des alternatives, et Linux, par sa capacité à redonner vie à ce matériel, apparaît comme l’un des principaux bénéficiaires potentiels de ce mouvement de fond.

    Cette croissance, bien que significative, place cependant la France en deçà de la moyenne européenne (3,7 %), et loin derrière des pays comme la Finlande (7,1 %) ou l’Allemagne (5,2 %), comme le révèle le récent Indice Européen de Résilience Numérique (EDRIX). Cette communauté de plus de deux millions de personnes représente donc un levier de souveraineté numérique sous-exploité et une opportunité stratégique pour les entreprises et les pouvoirs publics.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Lancement de l'EDRIX : un indice pour mesurer la souveraineté numérique européenne
      Un rapport récent a introduit l’Indice Européen de Résilience Numérique (EDRIX) dont l'objectif est de mesurer de manière chiffrée et objective la capacité des 27 États membres de l'Union européenne à « construire, maintenir et contrôler leur propre destinée numérique » et vise à fournir un outil d'analyse pour guider les politiques industrielles vers un « EuroStack » souverain. L'indice agrège les scores de cinq piliers, dont quatre reposent sur des données mesurables concrètes, plutôt que de

    Lancement de l'EDRIX : un indice pour mesurer la souveraineté numérique européenne

    Un rapport récent a introduit l’Indice Européen de Résilience Numérique (EDRIX) dont l'objectif est de mesurer de manière chiffrée et objective la capacité des 27 États membres de l'Union européenne à « construire, maintenir et contrôler leur propre destinée numérique » et vise à fournir un outil d'analyse pour guider les politiques industrielles vers un « EuroStack » souverain.

    L'indice agrège les scores de cinq piliers, dont quatre reposent sur des données mesurables concrètes, plutôt que de se contenter de simples déclarations d'intention.

    • Politiques Publiques : maturité des stratégies Open Source nationales (basé sur les rapports OSOR de la Commission européenne).
    • Écosystème de Développeurs : densité de développeurs par habitant (données GitHub, à défaut de disposer des données des autres plateformes) et nombre de solutions souveraines référencées dans les principaux annuaires (données agrégées issues de l'annuaire EuroStack).
    • Adoption par la Société Civile : part de marché des navigateurs "souverains" (Firefox, Brave, Opera) et part de marché des ordinateurs sous Linux (moyenne de 3,7 % dans l'UE27).
    • Résilience du Secteur Privé : souveraineté de l'infrastructure (web, mail, DNS) des domaines nationaux à fort trafic.
    • Résilience du Secteur Public : souveraineté de l'infrastructure des institutions publiques clés (Présidence, Gouvernement, capitale).

    Le rapport introduit également un indice complémentaire plus spécifique au logiciel libre, l'EOTRIX (European Open Technology Readiness Index).

    Concernant la France, qui se classe seulement 6ème, le rapport révèle un tableau contrasté qui illustre le fossé entre politique et pratique, avec un écosystème de développeurs et une adoption par la société civile qui n'obtiennent que des scores moyens (respectivement 4,08/10 et 5,09/10).

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Typst, un système de composition de document qui grandit
      Vous en souvient-il ? En deux mille vingt-cinq, qpad nous présentait Typst, un nouveau système de composition de documents qui se posait en concurrent de LaTeX. Depuis, Typst semble avoir grandi, en s’assortissant d’une galaxie (pardon, un univers) de paquets tiers. En fait, j’ai surtout l’impression qu’il a gagné en notoriété, ou en quantité de mouvement, pour le dire comme les anglophones. C’est l’occasion de présenter à nouveau ce système de composition. lien nᵒ 1 : Typstlien nᵒ 2 : Tutoriel

    Typst, un système de composition de document qui grandit

    Vous en souvient-il ? En deux mille vingt-cinq, qpad nous présentait Typst, un nouveau système de composition de documents qui se posait en concurrent de LaTeX.

    Depuis, Typst semble avoir grandi, en s’assortissant d’une galaxie (pardon, un univers) de paquets tiers. En fait, j’ai surtout l’impression qu’il a gagné en notoriété, ou en quantité de mouvement, pour le dire comme les anglophones. C’est l’occasion de présenter à nouveau ce système de composition.

    Sommaire

    Un système de composition de documents

    Typst est donc un système de composition de documents. Comme LaTeX, il est non-visuel, c’est-à-dire qu’on code son document qui est ensuite compilé en PDF.

    Concrètement, l’outillage se compose, au choix :

    Concurrent à LaTeX

    Typst partage plusieurs caractéristiques avec LaTeX dont il est ouvertement inspiré :

    • c'est un système non visuel avec un langage dédié ;
    • il est conçu pour permettre d’écrire des documents scientifiques.

    Bien que je n’aie pas vérifié ce point, il me semble probable qu’il utilise également quelques algorithmes de mise en page assez incontournables, définis par Donald Knuth pour TeX, par exemple pour la coupure des lignes d’un paragraphe.

    Il s’écarte évidemment de LaTeX sur plusieurs aspects, sinon ce ne serait pas vraiment un nouveau système de composition :

    • c’est un système autonome, contrairement à LaTeX qui est construit sur TeX ;
    • il est conçu dès le départ avec des préoccupations actuelles (Unicode, PDF…) ;
    • il est conçu comme un langage humainement compréhensible, là où TeX semble franchement ésotérique.

    Impressions d’un LaTeXnicien

    Quand on arrive de LaTeX, l’impression est assez partagée, entre des différences significatives, de gros avantages et quelques inconvénients.

    Le langage de texte

    Le langage de base pour le texte est différent de LaTeX, mais ce n’est pas vraiment dérangeant dans la mesure où on parle seulement de paragraphes, de titres, de mise en emphase, de listes, etc. Bref, le genre de chose qu’on fait aussi bien en Markdown. D’ailleurs, Typst étant né après le développement des langages de balisage léger, sa syntaxe Typst est justement assez proche de Markdown, ce qui n’est pas désagréable :

    = Titre de section
    
    Voici du texte avec _une emphase_, *une emphase forte* et un `peu de code`.
    

    À noter que cette syntaxe légère n’est en fait que du sucre syntaxique, et qu’on peut écrire la même chose en faisant explicitement appel à des fonctions nommées.

    La compilation

    Pour celles et ceux qui n’ont pas l’habitude de LaTeX, compiler un document un peu costaud, qui fait appel à quelques extensions, ça demande un temps de l’ordre d’une ou plusieurs secondes, et cela produit des centaines, voire des milliers de lignes de log. Pour avoir des références internes (sommaire, références à des images…) et externes (bibliographie), il faut lancer plusieurs fois la compilation.

    Pour qui vient du monde LaTeX donc, la compilation par Typst est hallucinante. Une seule passe, même si en interne, Typst fait certainement au besoin plusieurs itérations. Quelques dizaines de millisecondes. Ok, c’était pour un document ultra-simple, mais les commentaires lisibles sur les Interwebz font généralement état d’un rapport d’un ou deux ordres de grandeur par rapport à LaTeX.

    Le langage de configuration et d’extension

    Là où ça change vraiment, c’est pour tout ce qui relève des réglages, des modèles, de la personnalisation ou de la programmation d’extensions. Là, ça n’a plus rien à voir avec TeX et LaTeX. À mon avis, ce n’est pas un mal dans la mesure où le langage TeX et les conventions utilisées pour le développement en LaTeX sont assez complexes, voire incompréhensibles.

    Cela se ressent dans le code des extensions. À titre de comparaison, celui de la classe LaTeX lettre fait quelques milliers de lignes. Et c’est assez illisible pour qui ne connaît par TeX. Le code du modèle formalettre, qui n’est certes pas aussi complet mais qui fait très bien le travail de base d’une telle classe, fait une centaine de lignes, que je trouve relativement lisibles pour un béotien.

    L’utilisation de paquets tiers

    Les paquets tiers, hébergés sur l’univers Typst, sont téléchargés à l’utilisation. Par rapport à une distribution LaTeX qui pèse facilement plusieurs centaines de mébioctets, ça donne une vraie impression de légèreté.

    La francisation

    L’adaptation aux conventions en usage en langue française, ou dans les différents pays francophones, me semble encore assez incomplète.

    Lorsqu’on passe un document en français, les changements de base s’effectuent bien : un sommaire s’appellera bien « Tables des matières » et les césures respecteront l’usage de la langue.

    En revanche, cela n’adapte pas la mise en forme des paragraphes avec alinéa, et on attendrait en vain que des mots comme 1ᵉʳ, 2ᵉ ou Mme soient automatiquement mis en forme selon l’usage attendu. Et non, il n’y a pas de commandes définies pour cela. Pas encore, en tout cas, parce que je serais surpris que personne ne publie un jour un paquet proposant tout cela.

    Les modèles

    L’équivalent d’une classe LaTeX est un modèle Typst. Cela correspond à un type de document, par exemple un article, un rapport ou une lettre.

    Typst ne semble pas proposer de modèles officiels. Il y en a en revanche par mal dans l’univers Typst, et le langage est conçu pour rendre la création d’un modèle assez accessible. Le troisième chapitre du tutoriel officiel traite justement de la création d’un modèle.

    Un bel avenir ?

    Typst a été conçu à partir de 2019 et a vraiment vu le jour en 2023. J’en ai entendu parler pour la première fois en mars 2023, dans le journal de qpad.

    Les lacunes que j’avais alors remarquées et qui me retenaient de commencer à l’utiliser pour mes propres documents, semblent avoir été comblées pour l’essentiel. L’univers Typst, qui est le dépôt de paquets tiers, s’est largement rempli et semble bien jouer son rôle pour permettre aux utilisateurs de partager les extensions et modèles.

    Le langage semble bien conçu :

    • il joue correctement son rôle pour la mise en forme de documents et de contenu scientifique ;
    • il est beaucoup plus humain que TeX et LaTeX lorsqu’il s’agit d’écrire des modèles et des extensions.

    L’écosystème est également bien conçu et bien fourni et semble bien répondre aux attentes de la communauté, avec une légèreté bienvenue. Dans l’ensemble, j’ai l’impression que Typst est bien parti pour proposer un successeur sérieux à LaTeX. Je formule tout de même quelques interrogations :

    • la distribution de paquets tiers, incontournable, semble intégralement centralisée et dépendante de l’univers Typst ;
    • ce dernier, ainsi que Typst en général, est maintenu par l’entreprise allemande Typst GmbH dont le financement dépend de la vente d’abonnements aux formules premium de l’application Web : espérons que cela s’avère pérenne.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Revue de presse de l’April pour la semaine 30 de l’année 2025
      Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Basta!] «Comment résister aux Gafam»: l'écosystème du logiciel libre montre la voie [Courrier international] Un piratage massif menace des dizaines de milliers de serveurs Microsoft [Journal du Net] Pour consolider la

    Revue de presse de l’April pour la semaine 30 de l’année 2025

    28 juillet 2025 à 21:31

    [Basta!] «Comment résister aux Gafam»: l'écosystème du logiciel libre montre la voie

    ✍ Rachel Knaebel, le mercredi 23 juillet 2025.

    Des associations proposent des services pour dire au revoir à Google et Microsoft; des entreprises choisissent de ne travailler qu’avec des logiciels libres. L’écosystème du numérique libéré des Gafam et des licences privées se développe en France. Focus sur quelques initiatives bretonnes.

    [Courrier international] Un piratage massif menace des dizaines de milliers de serveurs Microsoft

    Le lundi 21 juillet 2025.

    Les victimes potentielles sont partout dans le monde. Les hackeurs s’en sont pris à une “importante vulnérabilité” de SharePoint, un logiciel collaboratif du géant américain qu’utilisent des millions d’entreprises et d’administrations dans le monde.

    Et aussi:

    [Journal du Net] Pour consolider la souveraineté numérique, l'open source est indispensable

    ✍ Rémy Mandon, le vendredi 18 juillet 2025.

    L’open source offre un équilibre bénéfique entre innovation et souveraineté, grâce à l’autonomie stratégique que cette approche apporte.

    [Usbek & Rica] Au fait, que sont devenus les fab labs?

    ✍ Pablo Maillé, le jeudi 17 juillet 2025.

    «Que sont-ils devenus?» Pour fêter ses 15 ans, Usbek & Rica revient tout au long de l’été sur des concepts pionniers dans nos pages qui ont pris un coup de vieux… ou pas. Cette semaine, retour sur les fab labs, ces tiers-lieux chargés de réinventer la fabrication de proximité.

    [Les Numeriques] C'est enfin arrivé: Linux dépasse un seuil historique que Microsoft pensait intouchable

    ✍ Aymeric Geoffre-Rouland, le jeudi 17 juillet 2025.

    Le mot “LINUX” formé de blocs noirs, posé devant une loupe et un carnet fermé. Une image qui symbolise la montée en visibilité du système d’exploitation libre.© SsCreativeStudioEn juin 2025, Linux a dépassé les 5 % de parts de marché sur les ordinateurs de bureau aux États-Unis (contre 1,84 % en juin 2020), et 4,1% à l’international (1,69 % en 2020), selon les dernières données de StatCounter.

    Et aussi:

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Aeryth : Intégrer une AppImage dans un paquet et le bureau
      Convertir proprement une AppImage en paquet ? Aeryth le fait en une commande : ce script Bash GPL v3 emballe votre AppImage en .deb ou .tar.zst, ajoute icône et lanceur, et s’installe/désinstalle via apt ou pacman. lien nᵒ 1 : DépôtPourquoi Aeryth ? Le format AppImage simplifie la distribution d’applications Linux, mais pose deux soucis : Intégration bureau (menus, icônes) absente au sein de l'environnement. Mises à jour invisibles pour le gestionnaire de paquets. Aeryth règle ces points 

    Aeryth : Intégrer une AppImage dans un paquet et le bureau

    Convertir proprement une AppImage en paquet ? Aeryth le fait en une commande : ce script Bash GPL v3 emballe votre AppImage en .deb ou .tar.zst, ajoute icône et lanceur, et s’installe/désinstalle via apt ou pacman.

    Pourquoi Aeryth ?

    Le format AppImage simplifie la distribution d’applications Linux, mais pose deux soucis :

    1. Intégration bureau (menus, icônes) absente au sein de l'environnement.
    2. Mises à jour invisibles pour le gestionnaire de paquets.

    Aeryth règle ces points : il transforme toute AppImage en véritable paquet Debian (.deb) ou Arch (.tar.zst) prêt à être executé, et offre des options d'intégration d'un AppImage complet ou extrait au sein du paquet. 🤝

    La documentation est très explicite sur le dépôt git sur GitLab, l'outil peut être au choix totalement ou partiellement interactif, ou 100% CLI utilisable des arguments et intégrable. 🙂

    Il est en outre pensé multi-platforme, avec une gestion chroot et deboostrap pour pouvoir générer des paquets deb ou archlinux sur les deux familles de distributions, il est même possible de forcer le chroot pour ne pas devoir "polluer" la distribution actuellement utilisée même si elle peut générer nativement les paquets.

    Il est pensé pour s'adapter à des utilisateurs néophytes ou confirmés. 😉


    Fonctions principales

    Fonction Description
    Double cible Génère un paquet .deb ou .tar.zst
    Multilingue Interface interactive : FR · EN · ES · IT · DE
    Respect FHS Copie l’AppImage sous /opt/<app>/, wrapper dans /usr/bin
    Licence GPL v3

    Installation rapide

    git clone https://gitlab.com/pepinature/aeryth.git
    cd aeryth
    chmod +x aeryth.sh

    Feuille de route

    • Détection automatique des nouvelles versions AppImage.
    • CI : tests sur Debian 12, Ubuntu 24.04, Arch stable.

    Ressources


    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • La pile graphique d’AMD sous Linux est désormais complètement libre
      À l’occasion de la sortie de la version 25.10.1 de la suite Radeon Software for Linux du 21 mai 2025, AMD a annoncé que la série 25.10 est la dernière à livrer des composants logiciels propriétaires. Ces composants propriétaires étaient déjà optionnels depuis bien longtemps, la plupart des utilisateurs de cartes AMD ne s’en servait déjà pas, et le plus grand nombre ignorait peut-être jusqu’à l’existence de certains d’entre eux… Ce jalon est l’accomplissement de 18 années d’un travail acharné c

    La pile graphique d’AMD sous Linux est désormais complètement libre

    À l’occasion de la sortie de la version 25.10.1 de la suite Radeon Software for Linux du 21 mai 2025, AMD a annoncé que la série 25.10 est la dernière à livrer des composants logiciels propriétaires.

    Ces composants propriétaires étaient déjà optionnels depuis bien longtemps, la plupart des utilisateurs de cartes AMD ne s’en servait déjà pas, et le plus grand nombre ignorait peut-être jusqu’à l’existence de certains d’entre eux…

    Ce jalon est l’accomplissement de 18 années d’un travail acharné commencé en 2007 avec la publication de documentations des cartes graphiques ATI après le rachat par AMD… Les plus anciens se souviendront de RadeonHD… Et désormais, ce sont les derniers bouts de logiciel propriétaire qui sont poussés vers la sortie.

    Autocollant LinuxFr.org cartes AMD par Thomas Debesse Nos logiciels libres sont plus sereins lorsqu’ils reposent sur des pilotes libres…

    Sommaire

    L’offre complètement libre de pilotes graphiques AMD sous Linux

    Voici comment se composera très bientôt l’offre officielle de pilotes graphiques AMD pour Linux :

    Noyau Vulkan OpenGL HIP OpenCL
    Linux amdgpu AMD AMDVLK ou Mesa RADV Mesa radeonsi AMD ROCm AMD ROCm

    OpenGL et Vulkan sont des interfaces de programmation (API) graphiques, VA-API est une interface de programmation multimédia, et HIP et OpenCL sont des interfaces de programmation pour le calcul spécialement conçues pour satisfaire aux particularités architecturales des cartes graphiques.

    Il est à noter que même si vous n’utilisez pas la suite Radeon Software for Linux, votre distribution vous fournit déjà le pilote Linux et les pilotes Mesa mentionnés.

    • Pilote noyau
      • Linux amdgpu pour les cartes GCN1 et suivantes (pilote officiel).
    • Pilote graphique Vulkan
      • AMD AMDVLK pour les cartes RDNA1 et suivantes (pilote officiel) ;
      • Mesa RADV, pour les cartes GCN1 et suivantes (pilote officiel).
    • Pilote graphique OpenGL
      • Mesa RadeonSI pour les cartes GCN1 et suivantes (pilote officiel).
    • Pilote multimédia VA-API
      • Mesa RadeonSI pour les cartes GCN1 et suivantes (pilote officiel).
    • Pilote de calcul HIP
      • AMD ROCm pour une sélection de cartes RDNA2 et suivantes (pilote officiel),
        il n’existe pas d’autre implémentation de pilote HIP pour les autres cartes.
    • Pilote de calcul OpenCL
      • AMD ROCm pour une sélection de cartes RDNA2 et suivantes (pilote officiel) ;
      • Mesa RustiCL pour les cartes GCN1 et suivantes.

    Ces pilotes concernent donc les cartes GCN et RDNA. La famille de cartes GCN pour « Graphics Core Next » sont les cartes sorties à partir de la série HD 7000 en 2012, aussi nommées « Southern Islands » et qui ont inspiré le nom du pilote RadeonSI. La famille RDNA pour « Radeon DNA » (ADN Radeon) est une évolution de cette micro-architecture GCN et les cartes RDNA1 commencent avec les modèles RX 5000 en 2019 et les cartes RDNA2 avec les modèles RX 6000 en 2020.

    Le tableau suivant se limite aux générations de cartes graphiques pour lesquelles il existe au moins un pilote fonctionnel faisant partie de la suite officielle Radeon Software for Linux. Il s’agit donc seulement de compatibilité technique. Les générations et modèles officiellement pris en charge par le support commercial d’AMD est évidemment plus restreint, et plus fluctuant, et puis ça dépend de l’API… La compatibilité technique effective intéressera probablement plus le lecteur.

    GCN1 GCN2 GCN3 GCN4 GCN5 RDNA1 RDNA2 RDNA3
    Noyau Linux amdgpu ⭐️ 🐧️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️
    Vulkan AMD AMDVLK ⭐️ ❌️ ❌️ ❌️ ❌️ ❌️ ✅️ ✅️ ✅️
    Vulkan Mesa RADV ⭐️ 🐧️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️
    OpenGL Mesa RadeonSI ⭐️ 🐧️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️
    VA-API Mesa RadeonSI ⭐️ 🐧️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️
    HIP AMD ROCm ⭐️ ❌️ ❌️ ❌️ ❌️ ❌️ ❌️ 🧐️ 🧐️
    OpenCL AMD ROCm ⭐️ ❌️ ❌️ ❌️ ❌️ ❌️ ❌️ 🧐️ 🧐️
    OpenCL Mesa RustiCL 🐧️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️ ✅️

    ✅️ = Pilote fonctionnel.
    🧐️ = Pilote fonctionnel pour une sélection de modèles.
    ❌️ = Pilote non-fonctionnel.
    ⭐️ = Pilote faisant partie de la suite officielle Radeon Software for Linux (pour RADV : après les versions 25.10).
    🐧️ = Pilote empaqueté en standard dans les distributions Linux usuelles.

    La famille de cartes RDNA4 venant tout juste d’être mise sur le marché, conjecturer sa prise en charge est un exercice périlleux. On sait que le pilote ROCm n’est pas encore prêt, par exemple. Il est évident que les prochaines versions de tous ces pilotes les prendront en charge dans un futur proche.

    Les derniers pilotes graphiques AMD propriétaires qui subsistaient encore étaient donc les pilotes OGLP, AMDVLK-Pro, et AMF.

    Maintenant que tout est libre, ce qu’on attend désormais d’AMD est de faire fonctionner leur pilote de calcul HIP et leur pilote de virtualisation graphique GIM sur plus de matériel…

    RADV officiellement supporté

    La phrase est explicite, à partir de la sortie de la suite Radeon Software for Linux en version 25.20, « The Mesa Vulkan driver will be officially supported ». Autrement dit, le pilote Vulkan de Mesa sera officiellement supporté par AMD.

    Le pilote Mesa pour les cartes AMD est RADV, initié originellement par Valve alors qu’AMDVLK était encore propriétaire.

    Cette formulation n’exclut pas le pilote Vulkan libre AMDVLK d’AMD. AMDVLK sera donc très certainement encore supporté comme il l’est déjà.

    Ce qui va changer pour Vulkan concerne AMDVLK-Pro, c’est ce que signifie la phrase « The AMD proprietary OpenGL and Vulkan drivers will no longer be included in the release », qui signifie aussi que le pilote OGLP pour OpenGL est également poussé vers la sortie.

    Ce que support veut dire

    Ce terme de support couvre les paquets de pilotes qu’AMD propose eux-mêmes, par exemple pour Ubuntu, Red Hat Linux Entreprise ou SUSE Linux Enreprise, ce sont les paquets dans le dépôt repo.radeon.com.

    Mais AMD participe déjà activement au développement de pilotes Mesa comme le pilote OpenGL RadeonSI. Apprendre qu’AMD ne fera pas que redistribuer mais supportera officiellement le pilote Mesa RADV dans sa suite de pilotes permet d’espérer une contribution similaire à RADV. En d’autres termes, si un bug affecte RADV, ils pourront considérer qu’il est de leur responsabilité de le corriger dans RADV directement.

    De plus, cela encourage désormais AMD à implémenter la prise en charge des futures cartes directement dans RADV avant que les cartes elles-mêmes ne soient mises sur le marché, ce qui était le principal argument en faveur d’AMDVLK-Pro et AMDVLK comparé à RADV.

    Ainsi, si vous utilisez une carte AMD et quand bien même vous utiliseriez le pilote RADV fourni par votre distribution, vous profiterez des effets de ces travaux de maintenance d’AMD comme vous en profitez déjà pour RadeonSI.

    C’est une très bonne nouvelle pour tout le monde car RADV est le pilote Vulkan installé par défaut (car faisant partie de la suite Mesa) par toutes les distributions Linux… et ce pilote devrait désormais profiter directement des efforts d’AMD.

    Le départ des derniers

    Il est important de noter que parce que ces pilotes en espace utilisateur sont écrits pour fonctionner par-dessus le pilote noyau amdgpu, il reste toujours possible d’utiliser ces pilotes désormais abandonnés, que ce soit OGLP, AMF et AMDVLK-Pro qui nous quittent désormais, ou les plus anciens PAL et ORCA, pour ceux qui recherchent un environnement spécifique tout en utilisant une distribution très récente. Et ce sera probablement encore vrai pendant des années, à condition de conserver votre ancien matériel compatible avec ces pilotes désormais obsolètes.

    En réalité ça fait longtemps qu’il n’est plus nécessaire d’employer un logiciel propriétaire pour utiliser ses cartes graphiques AMD sous Linux. Toutes les API supportées par AMD avaient déjà des implémentations libres depuis longtemps.

    Ce qu’AMD est en train de faire est de se débarrasser définitivement des rares alternatives propriétaires qui survivaient encore…

    Adieu OGLP

    OGLP était jusqu’à maintenant le pilote OpenGL propriétaire d’AMD sous Linux. AMD recommande le pilote libre Mesa RadeonSI pour OpenGL sous Linux depuis très longtemps. Le pilote libre Mesa RadeonSI lui est très supérieur, que ce soit en termes de fonctionnalité, de performance, et de qualité, et AMD contribue directement à ce pilote RadeonSI. Il est très probable que la majorité d’entre vous n’ait même pas connaissance que le pilote OGLP existait, ni même connaissait son nom.

    OGLP proposait une implémentation OpenGL et OpenGL ES.

    Mon expérience dans l’évaluation de pilotes graphiques pour le jeu Unvanquished m’a fait constater que le pilote OGLP présentait les mêmes bugs que le pilote propriétaire AMD pour Windows, Adrenalin. Il est donc extrêmement probable que c’était une simple recompilation du même pilote, mais pour Linux, comme à l’époque de Catalyst et fglrx.

    En effet déjà à l’époque de fglrx pour ATI, et encore aujourd’hui pour Nvidia, les pilotes propriétaires graphiques de ces concepteurs de cartes graphiques sont généralement exactement le même pilote quel que soit le système, avec une couche de compatibilité pour le système, ce qui est logique dans une optique de réduction des coûts de développement.

    OGLP était donc très certainement le pilote OpenGL de la suite fglrx, le pendant Linux du pilote Windows Adrenalin, mais porté pour le pilote noyau libre amdgpu au lieu du pilote fglrx abandonné il y a déjà des années.

    On pourra s’étendre en conjectures sur pourquoi AMD maintenait encore le pilote OGLP jusqu’en 2025, il est probable que celui-ci répondait à des exigences contractuelles professionnelles. Sur le plan technique pendant longtemps le pilote Mesa s’était limité à implémenter seulement le « core profile » d’OpenGL et pas le « compatibility profile » qui pouvait être requis par certaines applications industrielles, et cela justifiait alors l’existence d’un pilote propriétaire pour satisfaire la clientèle. Mais Mesa a depuis implémenté ce « compatibility profile » et ce depuis longtemps désormais, il est donc possible que ne subsistait plus que des exigences contractuelles — peut-être même pas techniques — pour justifier la fourniture de ce pilote OGLP.

    Adieu AMDVLK-Pro

    Le pilote AMDVLK-Pro était en fait le pilote libre AMDVLK amalgamé de composants propriétaires.

    Le pilote AMDVLK est un pilote libre qui implémente l’API graphique Vulkan.

    Contrairement au pilote OpenGL officiel RadeonSI qui est développé en collaboration avec Mesa, le pilote Vulkan AMDVLK est développé exclusivement par AMD, mais c’est tout de même un pilote libre.

    Au tout début AMDVLK était aussi un pilote propriétaire mais conçu dès le départ pour devenir un pilote libre plus tard, avec la promesse qu’il soit libéré un jour. Le pilote AMDVLK, alors qu’il était encore propriétaire, avait permis à beaucoup d’utilisateurs de Linux de profiter des fonctionnalités Vulkan de leurs cartes graphiques AMD sans avoir à attendre un pilote libre, que ce soit AMDVLK lui-même une fois libéré, ou le pilote RADV développé par Mesa.

    Le pilote AMDVLK-Pro était donc en quelque sorte la continuité de ce pilote qui distribuait au plus tôt les fonctionnalités aux utilisateurs, en remettant à plus tard la libération de ces fonctionnalités. Quand AMDVLK avait été libéré, AMDVLK-Pro en était donc devenu la variante propriétaire qui implémentait et distribuait les dernières nouveautés.

    Là encore, il est pertinent de supposer que le pilote AMDVLK est construit sur la même base de code que le pilote Windows. Quand bien même existe désormais le pilote Mesa RADV pour Linux, il est peu probable que le pilote libre AMDVLK disparaisse de l’écosystème Linux de si tôt.

    Peut-être un jour AMDVLK, bien que libre, suivra le sort d’OGLP si un jour AMDVLK n’apportera rien de plus que RADV et ce depuis un temps certain ? L’avenir nous le dira.

    Adieu AMF

    AMF (Advanced Multimedia Framework) s’en ira également, c’est une bibliothèque d’accélération matérielle pour le décodage et l’encodage de formats vidéo. AMD recommande d’utiliser à la place l’implémentation VA-API de Mesa.

    Souvenir des pilotes AMD abandonnés sur le bord du chemin

    Parmi les pilotes AMD propriétaires conçus pour tourner sur le pilote noyau amdgpu, AMD a déjà abandonné ORCA et PAL. C’était des pilotes de calcul OpenCL (conçus pour les cartes GCN 2 à 4 pour ORCA, et GCN 5 pour PAL) qui ont été remplacés par ROCm.

    On peut aussi supposer que PAL et ORCA étaient des portages du pilote OpenCL de Windows mais conçus pour tourner sur le pilote noyau amdgpu à la manière d’OGLP et d’AMDVLK.

    Pour les plus pointilleux, PAL (Platform Abstraction Library) était en fait le nom de la bibliothèque d’abstraction entre le code propriétaire commun et le système Linux, et par métonymie on appelait PAL le pilote OpenCL qui utilise PAL comme interface. Dans la même veine, certains parlent parfois de ROCr OpenCL pour l’implémentation actuelle de OpenCL de la suite ROCm, ROCr étant le ROCm Runtime. Le nom ORCA n’échappe probablement pas à cette règle d’usage, mais je n’ai jamais trouvé d’explication de ce nom (je ne suis même pas sûr que ce soit un acronyme), la chaîne orca était simplement utilisée dans le nom du paquet (par exemple : opencl-orca-amdgpu-pro-icd).

    PAL et ORCA ont longtemps été regrettés, car ils prenaient en charge la totalité des cartes de leurs générations, contrairement à ROCm. On peut lire à ce sujet sur LinuxFr.org l’article de 2022 « OpenCL sous Linux : l’état des pilotes AMD est désormais pire que ce qu’il était à l’époque de fglrx ». Heureusement, Mesa fournit désormais RustiCL qui leur est désormais supérieur sur bien des points. Cela pourrait faire l’objet d’une dépêche à venir… 😉

    Et avant cela, il y a bien longtemps avant de s’embarquer dans son aventure amdgpu, AMD fournissait la suite Catalyst entièrement propriétaire, qui exécutait au-dessus du pilote noyau propriétaire fglrx des pilotes propriétaires OpenGL et OpenCL pour le graphisme et le calcul.

    Mais… et les firmwares ?

    Les micrologiciels (firmwares) des cartes graphiques ne sont toujours pas libres, mais ceux-ci ne s’exécutent pas avec le système d’exploitation de votre ordinateur dans le processeur principal de votre machine, ils s’exécutent dans la carte graphique directement, c’est donc un tout autre sujet.

    Certains réclament aussi la libération de ces micrologiciels, mais d’ici à ce que ce rêve devienne un jour réalité, si ce jour vient un jour, vous savez déjà que votre Linux, lui, il peut déjà prendre en charge toutes les fonctionnalités de votre carte avec des logiciels libres sous Linux.

    Préférer le DisplayPort à l’HDMI pour les très hautes définitions…

    Un petit couac cependant… Les pilotes AMD sous Linux ne peuvent légalement pas implémenter la version 2.1 du protocole HDMI, donc si vous avez besoin d’utiliser des définitions telles que le 4K à 120 Hz ou le 5K à 240 Hz, il faut privilégier le DisplayPort. Ce n’est pas la faute d’AMD : AMD avait en fait implémenté cette prise en charge mais n’a légalement pas le droit de la publier dans un pilote libre. Le HDMI Forum a restreint l'accès public aux spécifications en 2021, et publier cette partie du code du pilote serait contraire à ces nouvelles conditions. Ce code de prise en charge HDMI 2.1 est censé être implémenté dans le pilote noyau amdgpu, et AMD n’a aucune intention d’abandonner son pilote libre, alors que sa stratégie est précisément de tout libérer !

    Prochain objectif : l’universalité du calcul et de la virtualisation ?

    Enfin, je dis que « Linux peut déjà prendre en charge toutes les fonctionnalités de votre carte avec des logiciels libres » mais si vous souhaitez profiter de ROCm et GIM ce n’est vrai qu’à condition de bien choisir votre carte. 😬

    AMD a la volonté d’améliorer la situation de ROCm, tel qu’en témoigne un sondage il y a quelque mois invitant les utilisateurs à exprimer leurs souhaits dans le cadre de l’effort d’AMD d’étendre la prise en charge. Mais ça prend du temps ! Et si, se faire attendre, c’est se faire désirer, il ne faudrait pas trop attendre pour AMD au risque que le désir se détourne vers d’autres propositions.

    Et du côté de la virtualisation de carte graphique (GPU-IOV), le pilote GIM est libre aussi mais la situation est encore pire : il ne prend en charge que deux accélérateurs (ces produits n’ont pas de sortie vidéo)… Certains diront que c’est un progrès car la version précédente ne prenait en charge qu’un seul accélérateur… Il a été annoncé qu’une prise en charge matérielle plus large serait « sur la feuille de route » mais si ça prend le même temps que ROCm ou plus, il faudra se montrer très patient. 😄

    En attendant, on peut célébrer cette victoire : La pile graphique d’AMD sous Linux est désormais complètement libre !

    🥂🍾

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Elpe, un compromis entre NixOS et Ubuntu
      Je travaille depuis quelque temps sur Elpe, un projet qui vise à obtenir les bonnes propriétés de Nix/NixOS (les mises à jour atomiques, la reproductibilité), mais avec des paquets Ubuntu. Le code : https://nest.pijul.com/pmeunier/elpe L'idée est de définir des recettes de compilation en OCaml et de les envoyer à un backend Rust, qui se charge de les exécuter dans un conteneur sans réseau, en exposant uniquement le contexte nécessaire à la bonne exécution de la compilation. Les produits du bui

    Elpe, un compromis entre NixOS et Ubuntu

    Je travaille depuis quelque temps sur Elpe, un projet qui vise à obtenir les bonnes propriétés de Nix/NixOS (les mises à jour atomiques, la reproductibilité), mais avec des paquets Ubuntu.

    Le code : https://nest.pijul.com/pmeunier/elpe

    L'idée est de définir des recettes de compilation en OCaml et de les envoyer à un backend Rust, qui se charge de les exécuter dans un conteneur sans réseau, en exposant uniquement le contexte nécessaire à la bonne exécution de la compilation. Les produits du build sont indexés par le contenu de la recette du build, et indexés une deuxième fois par le résultat : c'est ce deuxième hash qui est utilisé dans les dépendants du paquet, ce qui permet de construire un arbre de Merkle du système complet (et non seulement de ses sources), qui rend toute modification ultérieure facilement détectable.

    De plus, le système de base provient des dépôts de paquet Debian ou Ubuntu. Cependant, tous les chemins sont hard-codés (comme dans Nix), ce qui permet de garantir la reproductibilité, au détriment toutefois du coût de mise à jour en termes d'espace et opérations disque.

    Si le choix de Rust devient relativement consensuel par les temps qui courent, OCaml est plus surprenant. Après divers essais avec plusieurs langages, je l'ai choisi parce que c'est le seul langage avec à la fois :

    • Une bonne approximation du système de types dont j'avais besoin: typage nominal et aussi structurel, entre autres.
    • Un système de types relativement simple (pas de typeclasses ni de monades comme en Haskell, de borrow checkers comme en Rust ni de types dépendants comme en TypeScript).
    • Du late binding, nécessaire pour exprimer des "overrides" et des "hooks", courants quand on veut compiler des choses (autoconf et make ont plein d'options de ce type, par exemple).
    • Un compilateur ultra-rapide.
    • Un bytecode, pour (dans le futur) contrôler aussi l'isolation du code de build de façon très légère.

    La simplicité et l'expressivité d'OCaml sont bien adaptés à ce projet: les fonctions simples à concevoir y sont relativement claires à énoncer.


    Pourquoi pas NixOS, me direz-vous ? En tant qu'utilisateur et contributeur depuis environ 10 ans, un certain nombre de problèmes plus ou moins récents m'ont motivé à explorer une alternative:

    • En termes de gouvernance, la communauté a traversé dans la dernière année plusieurs crises de différentes tailles (Anduril, Devenv…). On pourrait y voir un signe de maturation ou au moins de croissance du projet, mais plusieurs éléments me permettent d'en douter, dont les réactions répétées de la fondation Nix, qui semble avoir beaucoup de mal à comprendre les messages pourtant clairs des contributeurs.

    • Je vois aussi les choix de design imposés par les fondateurs du projet depuis quelques années comme un bien mauvais signe: les flakes (en 2020) étaient une première incarnation de cette tendance, et plus récemment la "distribution propriétaire" de Nix est clairement une mauvaise idée, alors que la qualité de code de Nix n'est pas au niveau où on l'attendrait et que le gros du projet repose depuis plusieurs années sur le travail pharaonique des contributeurs de Nixpkgs.

    • On pourrait parler longtemps de la sécurité de Nix, qui me fait de plus en plus peur y compris pour mon usage personnel. Les process de gestion des rapports ne me conviennent pas, de même que l'opacité de certains choix techniques (les flags de compilation désactivés sur certaines plateformes, entre autres), souvent bien cachés dans les entrailles de Nixpkgs.

    • Enfin, le langage trop complexe à utiliser (principalement par manque de typage statique et de messages d'erreurs pertinents) rend Nix difficile à utiliser au sein d'une organisation d'une taille importante, et encourage les comportements peu inclusifs (éviter d'écrire de la doc, inventer des casse-têtes pour faire des choses simples…). Je suis bien sûr conscient que des entreprises (comme Anduril) et des ONGs (comme Médecins Sans Frontières) l'utilisent, mais je ne pense pas que ce soit généralisable aux situations où j'aimerais voir ce genre de projet utilisé.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • (Début de) la fin de Windows (10)
      La prise en charge de Windows 10 se termine le 14 octobre 2025, forçant ses utilisateurs à passer à Windows 11 qui requiert des performances beaucoup plus élevées tout en poursuivant la prise de contrôle de ses utilisateurs. La campagne « End of 10 » (fin de [Windows] 10) initiée il y a quelques mois vise à dénoncer le gaspillage de ressources (en forcant le remplacement anticipé de machines), et incite à un passage à Linux. Le lancement de la campagne sur les réseaux sociaux (i.e. Mastodon) a

    (Début de) la fin de Windows (10)

    La prise en charge de Windows 10 se termine le 14 octobre 2025, forçant ses utilisateurs à passer à Windows 11 qui requiert des performances beaucoup plus élevées tout en poursuivant la prise de contrôle de ses utilisateurs.

    La campagne « End of 10 » (fin de [Windows] 10) initiée il y a quelques mois vise à dénoncer le gaspillage de ressources (en forcant le remplacement anticipé de machines), et incite à un passage à Linux.

    Le lancement de la campagne sur les réseaux sociaux (i.e. Mastodon) a démarré le 28 mai.

    De bonnes raisons

    La campagne est axée sur cinq arguments principaux :

    • les économies financières : pas de coût de licence, pas d'obligation de renouveler son matériel de manière anticipée.
    • l'amélioration du respect de la vie privée : s'affranchir des publicités et logiciels espions intégrées de force dans Windows.
    • l'écologie : éviter un remplacement d'ordinateur a un impact carbone direct.
    • bénéficier d'un support adapté : communautaire ou professionnel, en ligne ou en physique.
    • reprendre contrôle de son ordinateur : bénéficier des libertés des logiciels libres pour utiliser votre ordinateur comme vous le souhaitez.

    La philosophie de la campagne

    La campagne est née du groupe de travail KDE Eco réfléchissant sur les impacts environnementaux des logiciels, cependant il est important de noter que dans le cadre de cette campagne la communication doit promouvoir « Linux » de manière générale et non promouvoir telle ou telle distribution. L'objectif premier est de quitter Windows.

    Le partage sur les réseaux sociaux vise à faire connaître l'initiative de manière plus large, cependant le succès est principalement attendu en s'appuyant sur des acteurs locaux existant : cafés réparation, boutiques informatiques, …

    Le site de la campagne fourni à la fois un registre des lieux et des dates où il est possible de se renseigner et se lancer. Plusieurs dizaines de possibilités ont déjà été ajoutées.

    Participer !

    De nombreuses façons de participer sont possibles :

    • prendre contact avec les structures locales (repair cafés, GULL, associations, …)
    • aider lors d'une install party ou en organiser une près de chez vous (et déclarer l'évènement sur le site)
    • en parler avec vos proches
    • relayer les messages Mastodon

    Microsoft a ouvert la porte pour faire de 2025 l'année Linux ! À nous de mettre le pied dans la fenêtre !

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇LinuxFr.org : les dépêches
    • Photos et traces gps dans un blog statique
      Cette dépêche va présenter une méthode pour afficher sur un site personnel les traces, récits et photographies de balades (pédestres, cyclistes par exemple). Comme le contenu à afficher est diversifié (texte, photographies, cartes), la solution retenue sera un blog. Dans un soucis de sobriété numérique, le site sera sans base de données. Pour l'aspect esthétique, la barre de navigation et les cartes seront situées dans la partie gauche des pages et surtout, la carte ne bougera pas avec la navi

    Photos et traces gps dans un blog statique

    Cette dépêche va présenter une méthode pour afficher sur un site personnel les traces, récits et photographies de balades (pédestres, cyclistes par exemple).

    Comme le contenu à afficher est diversifié (texte, photographies, cartes), la solution retenue sera un blog. Dans un soucis de sobriété numérique, le site sera sans base de données.

    Pour l'aspect esthétique, la barre de navigation et les cartes seront situées dans la partie gauche des pages et surtout, la carte ne bougera pas avec la navigation dans la page.

      Sommaire

      N'ayant pas trouvé d'alternative libre à Polarstep, la solution retenue se base sur les briques logicielles libres suivantes :

      • un moteur de blog static : pelican (AGPL v3.0)
      • des thèmes pour le blog
      • des bibliothèques cartographiques : leaflet (BSD 2)

      1 - Préparation de pelican

      Pelican propose d'écrire chaque billet de blogs dans un fichier texte indépendant (au format markdown ou reStructuredText).

      Pelican les convertit en html et l'organisation du site ainsi généré (catégories, mots-clefs, archivage) se fait par le biais de gabarits (qui sont dans un sous-répertoire templates)

      a) Le moteur

      L'installation ne sera pas développée ici, pelican étant disponible dans de nombreuses distributions.

      Il faut créer la structure de travail (dans le répertoire personnel de notre choix) :

      pelican-quickstart
      

      b) Installation du thème graphique

      En allant sur le dépôt des thèmes de pelican, il est possible de trouver le style graphique qui nous convient le mieux.

      Nous allons utiliser le thème pelican-blue (sous licence MIT 2.0), qui a l'avantage d'être simple, et commençons son installation :

      • création du répertoire theme dans notre structure de travail
      • décompression de l'archive du thème dans le répertoire « theme »
      • modification du fichier pelicanconf.py pour configurer notre site. Il faut adapter quelques variables :
      SITENAME = 'Mon blog'
      SITEDESCRIPTION = 'Mes souvenirs de vacances'
      THEME = "./theme/pelican-blue"
      STATIC_PATHS = ['images', 'gpx']
      
      • modifications propres au thème. Souvent l'auteur d'un thème propose de le personnaliser à partir de variables déclarées dans le fichier de configuration.

      c) Écriture du premier billet

      On va créer notre premier billet

      Title: Première sortie
      Date: 2025-05-01
      Modified: 2025-05-01
      Category: Lieux
      Slug: depart
      Tags: bonjour, balade
      
      Bonjour tout le monde ! Quelle chouette sortie j'ai faite.
      

      d) Génération de notre site

      On lance la première compilation :

      make clean
      make html
      

      On peut voir le résultat :

      • soit en ouvrant directement le fichier index.html (présent dans le répertoire output)
      • soit en lançant un mini serveur web (make serve) et lancer son navigateur web à l'adresse http://localhost:8000/

      Pour plus de renseignements sur pelican, je vous invite à vous rendre sur la documentation du projet.

      2 - Peaufinage de base

      On va maintenant nettoyer le code des gabarits, en supprimant les choses que l'on trouve inutiles ou qui nous déplaisent. Tout se passe dans le répertoire templates de notre thème.

      • il y a les fichiers analytics.html et disqus.html
      • une recherche par mot nous informe des éventuelles références à Google, Twitter, Facebook

      On supprime les parties qui ne nous conviennent pas.

      3 - Gestion cartographique

      Nous attaquons désormais notre objectif : rendre visibles sur des cartes des fichiers de trace.

      a) Gestion des cartes

      On va maintenant configurer la gestion des cartes, par l'intermédiaire de leaflet. Comme l'indique sa page wikipédia, leaflet est très largement utilisé et très pratique.

      On va donc

      • le télécharger,
      • le décompresser dans le répertoire static de notre thème
      • modifier les entêtes de nos gabarits (cela se fait le plus souvent dans le fichier base.html) pour y ajouter au niveau <head> les références à leaflet :
          <link rel="stylesheet" href="{{ SITEURL }}/theme/leaflet/leaflet.css"   integrity="sha256-p4NxAoJBhIIN+hmNHrzRCf9tD/miZyoHS5obTRR9BMY="  crossorigin=""/>
          <script src="{{ SITEURL }}/theme/leaflet/leaflet.js"  integrity="sha256-20nQCchB9co0qIjJZRGuk2/Z9VM+kNiyxNV1lvTlZBo="  crossorigin=""></script>

      Comme on a récupéré en local les fichiers, on met des chemins propres à notre arborescence (via {{ SITEURL }}/theme/).

      b) Gestion des fichiers de trace (gpx)

      Elle va se faire par l’intermédiaire d'un module supplémentaire https://github.com/mpetazzoni/leaflet-gpx (BSD 2).

      De la même manière qu'on a intégré dans nos entêtes l'intégration de leaflet, nous allons ajouter une ligne pour faire référence à leaflet-gpx (bien vérifier le nom du fichier javascript) :

      <script src="{{ SITEURL }}/theme/leaflet-gpx/gpx.js"></script>

      Par rapport à la documentation officielle, on retire l'attribut defer (puisque nous utilisons les fichiers locaux et non distants).

      Pour tester notre environnement, on va déposer dans notre répertoire gpx un fichier de trace, puis on va ajouter dans notre billet les éléments de cartographie de notre voyage :

      <div id="map" style="width: 600px; height: 400px;"></div>
      <script>
              var map = L.map('map');
              L.tileLayer('http://{s}.tile.openstreetmap.org/{z}/{x}/{y}.png', {
                attribution: 'Carte et données : <a href="http://www.osm.org">OpenStreetMap</a>'
              }).addTo(map);
              var gpx = '/gpx/FICHIER.gpx';
              new L.GPX(gpx, {async: true}).on('loaded', function(e) {
                  map.fitBounds(e.target.getBounds());
              }).addTo(map); 
      </script>

      On regénère notre site web, et on peut visualiser notre billet

      Première version de notre billet

      Globalement, ça fait le boulot.

      Mais on peut améliorer la chose : on peut par exemple cacher les marques de début et de fin d'itinéraire en insérant la ligne suivante après le async: true

      markers: {startIcon: null, endIcon: null, }

      Mais surtout, nous souhaitons que pelican génère automatiquement la partie consacrée au fichier de trace (alors que dans notre test, nous avons dû l'ajouter nous-même) !

      c) Modification des gabarits

      Si l'on veut simplement ajouter notre fichier de trace et que notre gabarit le traite, on va ajouter cette information dans les entêtes de notre fichier markdown ! En effet pelican permet de créer des variables qui seront utilisables dans nos gabarits.

      Nous allons donc créer et utiliser une variable (qui s'appellerait… Gpx par exemple), qui stockera le nom du fichier gpx à afficher (les chemins sont relatifs à notre site web)

      Title: Première sortie
      Date: 2025-05-01
      Modified: 2025-05-01
      Category: Lieux
      Gpx: /gpx/monfichier.gpx
      Slug: depart
      Tags: bonjour, balade

      Nous modifions ensuite notre gabarit article.html pour qu'il génère la carte à partir de notre variable.

      Pelican est très souple : basé sur Jinja2, il permet les boucles, les conditions et les variables.

      Tous les éléments qu'il utilise sont insérés dans des accolades. Le fonctionnement est facilement lisible et compréhensible.

      On va donc conditonner (avec if) l'insertion de leaflet.

      {% if article.gpx %}
          <div id="map" style="width: 600px; height: 400px;"></div>
      <script>
          var map = L.map('map');
          L.tileLayer('http://{s}.tile.openstreetmap.org/{z}/{x}/{y}.png', {
            attribution: 'Carte et données : <a href="http://www.osm.org">OpenStreetMap</a>'
          }).addTo(map);
      
          var gpx = '{{ article.gpx }}';
          new L.GPX(gpx, {async: true,
                             markers: {startIcon: null, endIcon: null, }
            }).on('loaded', function(e) {
               map.fitBounds(e.target.getBounds());
            }).addTo(map); 
      
      </script>
      {% endif %}

      Bien entendu, nous supprimons ces références du fichier markdown correspondant à notre billet de test.

      On regénère notre site web, et on peut visualiser notre billet… qui n'a pas changé : tout fonctionne. Pour chacune de nos sorties, il suffit donc d'indiquer le fichier de trace dans les entêtes pour que la carte soit insérée automatiquement dans notre billet.

      Passons maintenant à l'intégration de nos photos.

      4 - Gestion des photographies associées à notre cartographie

      Nous avons besoin :

      • d'une image
      • de ses coordonnées géographiques (latitude et longitude)

      Pour cela, nous allons procéder de la même manière que pour le fichier trace : nous allons créer et utiliser des variables dans les entêtes des fichiers markdown.

      a) Fichier des billets

      Nous modifions encore une fois les entêtes en ajoutant autant d'informations (image, latitude et longitude) que de photos à afficher en miniatures.

      Title: Première sortie
      Date: 2025-05-01
      Modified: 2025-05-01
      Category: Lieux
      Gpx: /gpx/monfichier.gpx
      Slug: depart
      Img: /images/image1.jpg
      Lat: 49.895517
      Lon: 2.295983
      Img: /images/image2.jpg
      Lat: 49.89443
      Lon: 2.30137
      Tags: bonjour, balade
      

      On remarque ici que l'on a mis plusieurs images avec les mêmes noms de variables.

      b) Modification des gabarits

      Nous allons ensuite modifier les gabarits de pelican pour qu'ils positionnent des miniatures des photos sur notre trajet.

      Nous allons à nouveau modifier notre fichier article.html, en y ajoutant (à la suite de notre précédente modification, dans la condition {% if article.gpx %}) le code suivant :

      Nous commençons par indiquer l'icône qui s'affichera sur la carte à chaque photo mise en valeur

      var MonIcone = L.icon({
          iconUrl: '/images/app-photo.png',
          iconSize: [36, 36]
      });
      

      Puis nous codons l'affichage du marqueur (qui sera géré par leaflet).

      {% if article.img %}
        {% if article.img is string %}
           imageTxt = 'Description';
           L.marker([{{ article.lat }}, {{ article.lon }}], {icon: MonIcone}).bindPopup(imageTxt + '<br><img src="{{ article.img }}" width="200px"><a href="#bal5">plus de détail</a>').addTo(map);    
        {% else %}
          {% for n in range(article.img| length) %}
             imageTxt = 'Description';
             L.marker([{{ article.lat[n] }}, {{ article.lon[n] }}], {icon: MonIcone}).bindPopup(imageTxt + '<br><img src="{{ article.img[n] }}" width="200px"><a href="#bal5">plus de détail</a>').addTo(map);
          {% endfor %}    
        {% endif %}
      

      La difficulté réside dans la gestion des éléments répétitifs :

      • s'ils sont plusieurs, on peut utiliser les méthodes python des listes.
      • s'il n'y en a qu'un seul, cette méthode renvoie toutes les lettres de notre variable ! Il a donc fallu tester si celle-ci est une chaine de caractères ou une liste.

      Les choix sont ici purement personnels ou démonstatifs :

      • on a laissé une variable imageTxt en dur, elle pourrait être passée dans les entêtes de nos fichiers markdown
      • le texte du popup peut être adapté (on pourrait y ajouter un lien direct vers notre image par exemple)
      • le lien (ancre) est à créer dans notre fichier markdown
      • la taille de l'image du popup est en dur (on peut passer par une feuille de style css)

      On regénère notre site web, et on peut visualiser notre billet :

      Carte avec icones indiquant des lieux visités

      Et lorsqu'on clique sur une icône d'appareil photo, on voit bien notre popup :

      Popup avec la miniature

      c) Gestion des photographies

      Comme indiqué plus haut, la taille des miniatures affichées peut se gérer :

      • par CSS
      • ou créer des miniatures (avec imagemagick) pour diminuer la charge de notre serveur (afficher une photo de 3000 pixels à 200 pixels n'est pas optimal). Dans ce cas, il suffira d'adapter notre gabarit pour lui indiquer où aller chercher les petites images (/images/miniatures/ par exemple)

      Par contre, le point le plus compliqué est la gestion des coordonnées des photographies : il faut les rentrer à la main !

      • Pour les photographies qui n'intègrent pas les coordonnées dans leurs métadonnées, il n'y a pas d'autre solution que d'aller chercher sur une carte (openstreetmap par exemple) et de trouver le lieu de la prise de vue et de repérer les coordonnées.

      • Pour les photographies qui contiennent leurs coordonnées géographiques, on peut utiliser l'outil exiftool pour les récupérer. On peut éventuellement faire un script bash qui affiche les lignes d'entête pour notre billet (on n'a plus qu'à les recopier ou les rediriger vers un fichier texte) :

          for photo in $(ls ./content/images);
          do
              echo ""
              echo "Img: /images/"$photo
              LAT=$(exiftool -n -s3  -gpslatitude ./content/images/$photo)
              echo "Lat: "$LAT
              LONG=$(exiftool -n -s3  -gpslongitude ./content/images/$photo)
              echo "Lon: "$LONG
          done

      Nous avons utilisé les options -n qui affichent les valeurs numériques au format décimal (celui utilisé par openstreetmap pour les coordonnées) et -s3 pour avoir la valeur du champ sans le nom de son attribut.

      5) Dernières modifications

      Nous venons de voir les différentes techniques qui permettent d'avoir le rendu que nous souhaitions. Et le résultat est déjà agréable à regarder.

      Nous pourrions nous arrêter ici, mais vous voulons que la carte reste en permanence dans le menu latéral. La solution est de la mettre dans une balise <aside>.

      a) Modifier les gabarits

      Notre thème comporte déjà une telle balise : elle est dans le fichier base.html… ce qui signifie qu'il ne peut pas voir les informations sur les articles (donc nos entêtes) !

      La solution va donc consister à déplacer, à l'intérieur du fichier article.html, tout notre code dans une section (que nous appellerons mamap :

      {% block mamap %}
          Mettre ici tout le code sur notre gestion cartographique
      {% endblock %}
      

      Et dans le fichier base.html, on va insérer à l'intérieur des balises <aside> son appel (qui ne tient que sur deux lignes) :

      {% block mamap %}
      {% endblock %}
      

      b) Ajuster les feuilles de style

      Il faut surcharger le comportement de la carte gérée par leaflet :

          .leaflet-container {
              width: 400px;
              height: 300px;
              max-width: 100%;
              max-height: 100%;
              margin: auto;
          }

      Et vérifier que les largeurs de la carte, et de <aside> soient compatibles.

      Le résultat avec nos dernières modifications est désormais le suivant

      Site avec la carte à gauche

      6) Conclusion

      Il est temps de finir cette dépêche, dans laquelle nous avons pu découvrir la souplesse et la richesse des gabarits gérés avec jinja2, ainsi que la facilité d'utilisation de leaflet.

      Désormais, dans notre flux de travail, nos répertoires sont organisé ainsi :

      content 
          + gpx : les fichiers de trace
          + images : les photos que l'on veut afficher sur notre blog
          fichierXX.md : les billets
      output : notre site web (généré par pelican)
      theme
          + pelican-blue  : le thème choisi
              + static
                  + css
                  + leaflet
                  + leaflet-gpx
              + templates
      

      Et la rédaction de nos billets consiste à :

      • ajouter le fichier gpx de notre trace dans les entêtes
      • ajouter les informations sur chaque photo que l'on veut voir (toujours dans les entêtes)
      • écrire notre billet normalement (en y ajoutant éventuellement d'autres photos ou des ancres de navigation)

      Cette dépêche démontre qu'il est possible d'avoir, avec les outils actuels, un rendu intéressant pour partager ses sorties. Et totalement utilisable en auto-hébergement.

      Les outils utilisés sont très personnalisables et je vous invite à lire leurs documentations ou à parcourir leurs extensions respectives et de vous les approprier selon votre usage.

      Malheureusement, la solution présentée ne conviendra qu'à une minorité d'utilisateurs. En effet, elle se base sur des éléments qui sont le plus souvent rendus invisibles (site web, transfert de fichiers, métadonnées) et elle est inutilisable sur téléphone.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Au café libre - « Libre à vous ! » du 29 avril 2025 - Podcasts et références
        Deux-cent-quarante-cinquième émission « Libre à vous ! » de l’April. Podcast et programme : sujet principal : Au café libre, débat autour de l’actualité du logiciel libre et des libertés informatiques Chronique À cœur vaillant, la voie est libre de Laurent et Lorette Costy : « Range tes affaires dans la PirateBox » Une nouvelle Pituite de Luk : « À nous de jouer » Rendez‐vous en direct chaque mardi de 15 h 30 à 17 h sur 93,1 FM en Île‐de‐France. L’émission est diffusée simultanément sur le s

      Au café libre - « Libre à vous ! » du 29 avril 2025 - Podcasts et références

      Deux-cent-quarante-cinquième émission « Libre à vous ! » de l’April. Podcast et programme :

      • sujet principal : Au café libre, débat autour de l’actualité du logiciel libre et des libertés informatiques
      • Chronique À cœur vaillant, la voie est libre de Laurent et Lorette Costy : « Range tes affaires dans la PirateBox »
      • Une nouvelle Pituite de Luk : « À nous de jouer »

      Rendez‐vous en direct chaque mardi de 15 h 30 à 17 h sur 93,1 FM en Île‐de‐France. L’émission est diffusée simultanément sur le site Web de la radio Cause Commune.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Revue de presse de l’April pour la semaine 17 de l’année 2025
        Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [Le Monde Informatique] Econocom mise sur Proxmox en interne [01net.] Du flop au hack: l'Ai Pin retrouve une nouvelle vie avec l'open source [Le Monde.fr] La Commission européenne inflige d'importantes amendes à Meta et

      Revue de presse de l’April pour la semaine 17 de l’année 2025

      29 avril 2025 à 10:42

      Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

      [Le Monde Informatique] Econocom mise sur Proxmox en interne

      ✍ Benoît Huet, le vendredi 25 avril 2025.

      «Est-ce que je dois payer tous les ans des licences de solutions propriétaires toujours plus élevées avec des inflations délirantes? Quand vous disposez d’un budget restreint, il faut trouver des idées intelligentes»

      [01net.] Du flop au hack: l'Ai Pin retrouve une nouvelle vie avec l'open source

      ✍ Mickaël Bazoge, le jeudi 24 avril 2025.

      Ne jetez pas votre Ai Pin tout de suite! Certes, le badge connecté de feu-Humane a tiré sa révérence en début d’année, après seulement quelques mois d’existence et une acquisition par HP. Mais l’appareil pourrait trouver un second souffle grâce à un projet open source…

      Note: la licence du projet est BY-NC-SA, ce qui est considéré non libre.

      [Le Monde.fr] La Commission européenne inflige d'importantes amendes à Meta et Apple, les premières dans le cadre du règlement visant à limiter le pouvoir des géants du numérique

      Le mercredi 23 avril 2025.

      Les sanctions sont les premières prises dans le cadre du nouveau règlement européen sur les marchés numériques, entré en vigueur l’an dernier pour mettre fin aux abus de position dominante des géants de la tech.

      [Journal du Net] L'open source, une réponse stratégique aux incertitudes et menaces de la guerre tarifaire

      ✍ Dimitri Casvigny, le mardi 22 avril 2025.

      Aujourd’hui, des considérations géopolitiques et macroéconomiques s’invitent à la table du DSI. Face à ces défis, une solution émerge avec force: l’open source.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • WoPiX, un serveur WOPI libre, indépendant, simple et léger
        Un serveur WOPI (Web application Open Platform Interface) permet à un logiciel client de modifier un fichier stocké sur un serveur. C'est la couche indispensable pour qu'OnlyOffice, LibreOffice (Collabora Online) et d'autres suites bureautiques puissent être utilisés sur le web. Ainsi, lorsque vous réclamez l'ouverture d'un document depuis votre navigateur web, vous vous connectez à la suite bureautique en ligne avec une URL particulière, contenant, entre autres, le nom du fichier à ouvrir. La s

      WoPiX, un serveur WOPI libre, indépendant, simple et léger

      Un serveur WOPI (Web application Open Platform Interface) permet à un logiciel client de modifier un fichier stocké sur un serveur. C'est la couche indispensable pour qu'OnlyOffice, LibreOffice (Collabora Online) et d'autres suites bureautiques puissent être utilisés sur le web. Ainsi, lorsque vous réclamez l'ouverture d'un document depuis votre navigateur web, vous vous connectez à la suite bureautique en ligne avec une URL particulière, contenant, entre autres, le nom du fichier à ouvrir. La suite bureautique peut alors discuter avec le serveur WOPI pour récupérer le document. Les lectures, écritures et modifications d'un document sont gérées par le serveur WOPI, à la demande de la suite bureautique. Le protocole a été créé par Microsoft en 2012, la révision 14.5 de WOPI est sortie le 18 février 2025.

      Les serveurs WOPI libres de Nextcloud, Seafile, Tracim… ne sont pas indépendants. Comme je voulais utiliser Collabora Online sans déployer un NextCloud complet, j'ai écrit un serveur WOPI très simple. Il est utilisé depuis plus d'un an sans problème et il est libre. Il est écrit en Java.

      J'ai commencé ce développement car je travaille sur deux lieux privés différents avec un ordinateur à chaque endroit, un NAS dans l'un d'eux et je communique entre les deux machines à l'aide d'un dépôt git sur le NAS. Ça fonctionne relativement bien pour des fichiers qui n'ont pas vocation à rester ouverts dans des applications, mais pour des fichiers ODS ou ODT qui restent ouverts, c'est plus compliqué car je me retrouve souvent avec des versions concurrentes sur les deux machines. J'ai donc regardé du côté des suites de collaboration en ligne.

      À une époque , je me servais d'Etherpad et de son équivalent tableur Ethercalc. Mais ces logiciels manquent de fonctionnalités, surtout le tableur. Problème supplémentaire : j'ai déjà beaucoup de fichiers aux formats LibreOffice.

      Ça tombe bien, il y a la suite LibreOffice online, éditée par Collabora Online (CODE). Le problème — comme souligné par une dépêche — c'est qu'une fois CODE installé, tu te retrouves à poil avec rien qui marche : il faut un serveur utilisant le protocole WOPI.

      Pour éviter d'installer tout un NextCloud, j'ai écrit un petit serveur WOPI. C'est du Java avec Spring Boot. Le serveur est très simple, sur le principe que plus un système est simple, moins il a de chances de tomber en panne.

      Par exemple, il n'y pas de droits d'accès et on ne peut pas avoir plusieurs utilisateurs simultanés. Il faudrait mettre en œuvre le système de verrous et le système de droits d'accès (faire reposer les droits d'accès sur les droits du système de fichier, implique d'avoir un utilisateur sur la machine pour chaque utilisateur du logiciel). Cela n'a pas été implanté parce que je suis le seul utilisateur sur ma machine. Mais ce ne serait pas long à développer.

      Le serveur une fois lancé expose des services REST, accessibles par la suite bureautique, mais aussi un service https qui permet d'afficher la liste des fichiers. Cette liste de fichier est cliquable et permet de se connecter à Libre Office avec la bonne URL. C'est la raison des paramètres proxyHost et code URL de l'application : être en mesure de générer la bonne URL.

      Liste des fichiers

      Le code est prévu pour avoir plusieurs backends à l'aide d'une interface. Le seul mis en œuvre pour l'instant c'est un stockage sur disque local (avec auto discovery : on lui donne un répertoire et il expose tout les documents du répertoire).

      Il consomme peu de ressources, la charge dépendra plus de Collabora Online ou d'OnlyOffice. Le serveur WOPI se contente de lire un fichier à l'ouverture et de l'écrire de temps en temps (comme lors des enregistrements automatiques).

      Il n'est pas testé avec OnlyOffice. En principe WOPI est une norme et ça devrait fonctionner.

      On peut le lancer avec java -jar. C'est du Spring Boot. On pourrait utiliser systemd. De mon côté, je l'ai mis dans un container docker qui lance la commande suivante

      java -Dlogging.level.root=INFO \
           -Dlogging.level.org.wopiserver=INFO \
           -Dserver.port=8880 \
           -jar /opt/app/app.jar \
           --baseDir /mnt/docs \
           --disableTLSCheck \
           --codeURL https://172.17.0.8:9980 \
           --proxyHost 192.168.124.252

      Le code de WoPiX est dispo sur github et je suis ouvert à toute requête :-)

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Le Musée Replay en danger : appel à soutien pour préserver notre patrimoine informatique
        Le Musée Replay (sur Bordeaux) œuvre pour la préservation du patrimoine informatique et vidéoludique. En juin, il perd son espace de stockage, ce qui menace sa collection. Il recherche donc un nouveau local et fait appel à financement participatif. lien nᵒ 1 : Journal à l’origine de la dépêchelien nᵒ 2 : Musée Replaylien nᵒ 3 : Campagne de financement participatif via HelloAssoIntroduction Depuis plusieurs années, le Musée Replay (sur Bordeaux) œuvre pour la préservation du patrimoine informati

      Le Musée Replay en danger : appel à soutien pour préserver notre patrimoine informatique

      Le Musée Replay (sur Bordeaux) œuvre pour la préservation du patrimoine informatique et vidéoludique. En juin, il perd son espace de stockage, ce qui menace sa collection. Il recherche donc un nouveau local et fait appel à financement participatif.

      Introduction

      Depuis plusieurs années, le Musée Replay (sur Bordeaux) œuvre pour la préservation du patrimoine informatique et vidéoludique. Machines anciennes, consoles, ordinateurs rares, accessoires, documentation… une collection unique en France est en constante évolution grâce à un travail de passionnés, notamment via des expositions itinérantes et des actions de sensibilisation.

      Mais aujourd’hui, l’avenir de cette collection est sérieusement menacé.

      En juin, le Musée perd son espace de stockage

      Le local de 150 m² qui abrite actuellement les machines va devoir être libéré. Ce qui pose plusieurs problèmes urgents et concrets :

      • trouver un nouveau local sécurisé et adapté ;
      • organiser le déménagement d’un volume très conséquent (plusieurs allers-retours en camion de 20 m³ seront nécessaires) ;
      • et continuer, malgré tout, à faire vivre ce patrimoine à travers des animations et événements partout en France.

      Une collecte est lancée

      Vous pouvez en savoir plus, et participer financièrement si vous le souhaitez, via la page suivante :

      https://www.helloasso.com/associations/musee-replay/collectes/un-nouveau-local-pour-musee-replay

      Même quelques euros peuvent faire la différence. Et si vous ne pouvez pas contribuer financièrement, le simple fait de relayer l’information est déjà un soutien précieux.

      Une chaîne YouTube pour découvrir leur travail

      Le projet est également porté (et documenté) à travers la chaîne Olipix, qui publie des contenus orientés histoire de l’informatique, restauration de machines, présentations de matériel rétro, etc.

      À découvrir ici : https://www.youtube.com/@Olipix

      Les autres ?

      D’autres initiatives, musées et associations œuvrent également pour la préservation du patrimoine informatique, vidéoludique et numérique.
      Parmi elles, on peut citer l’association MO5, installée en proche banlieue parisienne, qui possède l’une des plus importantes collections européennes, et participe régulièrement à des expositions culturelles.
      À Bussy-Saint-Georges, le projet Odyssée prévoit pour 2028 l’ouverture d’un vaste musée consacré au jeu vidéo et à la pop culture, articulé autour de la collection personnelle de Ludovic Charles (plus de 2 500 consoles).
      En Belgique, le musée NAM-IP, situé à Namur, est dédié à l’histoire de l’informatique, tandis que le Pixel Museum de Bruxelles a malheureusement fermé ses portes fin 2024.

      La diversité de ces projets, chacun avec son approche, contribue à mieux préserver et valoriser un patrimoine riche et multiple.
      Pour aller plus loin, l’article Musée de l'informatique propose une liste (non exhaustive) des musées consacrés à l’informatique et au jeu vidéo… Peut-être devrions-nous aller y faire un tour, et le bonifier à l’aune de l’actualité ?

      Témoignage personnel

      En 1985, j’étais moi-même à côté d’un Commodore PET 2001. C’est cette mémoire, cette passion, ces machines qui nous ont fait rêver, apprendre, bricoler, que le Musée Replay aide à sauvegarder.

      Photo en 1985 à côté d’un PET 2001

      Merci à toutes celles et ceux qui prendront le temps de lire, partager, ou soutenir cette initiative.

      Le patrimoine numérique n’est pas virtuel : il est bien réel, et mérite qu’on le protège.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Proxmox Virtual Environment 8.4 est disponible
        Proxmox Server Solutions GmbH a publié la version 8.4 de sa plate-forme de virtualisation libre Proxmox Virtual Environment (VE). Proxmox VE est sous licence GNU Affero GPLv3. Proxmox Server Solutions propose un support d’entreprise à partir de 115 € par an et par processeur. Principales nouveautés de la version 8.4 Migration à chaud avec des dispositifs médiés : Les dispositifs médiés permettent de partitionner les ressources matérielles physiques en plusieurs dispositifs virtuels. Il est dé

      Proxmox Virtual Environment 8.4 est disponible

      Proxmox Server Solutions GmbH a publié la version 8.4 de sa plate-forme de virtualisation libre Proxmox Virtual Environment (VE). Proxmox VE est sous licence GNU Affero GPLv3. Proxmox Server Solutions propose un support d’entreprise à partir de 115 € par an et par processeur.

      Principales nouveautés de la version 8.4

      • Migration à chaud avec des dispositifs médiés :
        Les dispositifs médiés permettent de partitionner les ressources matérielles physiques en plusieurs dispositifs virtuels. Il est désormais possible de migrer des machines virtuelles (VM) en cours d’exécution utilisant des dispositifs médiés, tels que les vGPU NVIDIA.

      • API pour les solutions de sauvegarde tierces :
        Proxmox VE propose une API qui simplifie le développement de plug-ins par les fournisseurs de solutions de sauvegarde externes. Ces solutions de sauvegarde tierces peuvent désormais implémenter directement des fonctionnalités de sauvegarde et de restauration dans Proxmox VE, tout en tirant parti de fonctionnalités avancées.

      • Passage direct de répertoires via Virtiofs :
        La version 8.4 offre la possibilité de partager des fichiers et des répertoires directement entre un hôte et les machines virtuelles (VM) exécutées sur cet hôte. Cette fonctionnalité est rendue possible par virtiofs, qui permet aux machines virtuelles d’accéder aux fichiers et répertoires de l’hôte sans surcharger le système de fichiers réseau. Les systèmes invités Linux modernes sont dotés de la prise en charge native de virtiofs, tandis que pour les invités Windows, l'utilisation de cette fonctionnalité nécessite un logiciel supplémentaire.

      • Mises à jour de tous les composants libres :
        Proxmox VE 8.4 est basé sur Debian 12.10 (“Bookworm”), mais utilise par défaut le noyau Linux 6.8.12. Cette version de Proxmox VE inclut des mises à jour vers les dernières versions des principales technologies open source pour les environnements virtuels, telles que QEMU 9.2.0, LXC 6.0.0. La solution est livrée avec ZFS 2.2.7 et Ceph Squid 19.2.1.

      D’autres améliorations incluent un mécanisme de filtrage de sauvegarde plus robuste, des améliorations de la pile SDN (réseau défini par logiciel), et de nouvelles options dans l’installateur ISO.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Unvanquished 0.55, enfin là !
        Après une longue attente la version 0.55 du jeu Unvanquished a été publiée le 20 octobre 2024. Deux mises à jour mineures se sont succédées le 3 novembre et le 15 décembre pour peaufiner cette version, juste à temps pour être déposée sous le sapin de Noël ! Unvanquished est un jeu vidéo libre et gratuit mêlant stratégie en temps réel et actions à la première personne dans un univers futuristique où deux factions (humains, aliens) combattent pour leur survie. S’inscrivant dans la continuité de

      Unvanquished 0.55, enfin là !

      Après une longue attente la version 0.55 du jeu Unvanquished a été publiée le 20 octobre 2024. Deux mises à jour mineures se sont succédées le 3 novembre et le 15 décembre pour peaufiner cette version, juste à temps pour être déposée sous le sapin de Noël !

      Unvanquished est un jeu vidéo libre et gratuit mêlant stratégie en temps réel et actions à la première personne dans un univers futuristique où deux factions (humains, aliens) combattent pour leur survie.

      S’inscrivant dans la continuité de Tremulous (révélé en 2006) et basé sur ce dernier, Unvanquished développe cette expérience de jeu nerveuse et exigeante depuis 2013, en améliorant continuellement le moteur et explorant des variantes et ajustements de jouabilité.

      Un Tyrant Laisse-moi goûter à cette version !

      Sommaire

      Cette version avait été promise dans le dernier article Des nouvelles de Unvanquished, et 10 mois après la version 0.54, voici la version 0.55.

      Pendant cette année 2024, le jeu a fait l’objet d’un développement soutenu et vu l’arrivée de nouveaux contributeurs.

      Gameplay

      • La portée du « rocket pod » a été réduite: 2000qu → 1300qu (62m → 40m).
      • Il n’est plus possible de désévoluer vers la même classe, ce qui permettait de recharger ses projectiles sans attendre.

      Bots

      • Les bots aliens savent désormais éteindre les bases en feu.
      • Ils peuvent aussi utiliser le granger avancé pour atteindre des plate-formes élevées et y construire.
      • Les classes sachant marcher sur les murs le font de manière plus fiable, et le saut de mur du maraudeur est plus précis lorsqu’il escalade des murs.

      D’autres améliorations sont plus subtiles, les bots peuvent naviguer dans les cartes de façon plus efficace depuis que la taille des tuiles du maillage de navigation est configurable. Les mappers (ceux qui créent ou modifient des cartes) peuvent aussi configurer d’autres aspects de la navigation.

      Un déséquilibre qui rendait les bots aliens moins bons que les bots humains a été retravaillé.

      La navigation dans la carte perseus a été améliorée. C’est un des patchs de la mise à jour mineure 0.55.1, c’était déjà prêt pour la 0.55 mais avait été oublié (oups !).

      La 0.55.2 a donné aux bots la capacité de voler et la capacité de danser autour des ravins sans tomber.

      Interface utilisateur

      Il est désormais possible de se déplacer et d’utiliser certaines touches d’action alors que certains menus circulaires sont ouverts : évolution, construction, balises (beacons). Cela permet d’ouvrir le menu de construction en tant que granger avancé sans tomber. On peut aussi évoluer tout en courant ou en sautant, etc.

      Les nouveaux menus Les nouveaux menus avec les options de réticules.

      Traductions

      La version 0.55 est la première version majeure d’Unvanquished à distribuer de nouveau des traductions ! Nous avions déjà distribué quelques traductions avec la version de correction 0.54.1, elles étaient en quelques sorte en prévisualisation. Cette version apporte les traductions pour le Français, l’Allemand, l’Italien, l’Espagnol, le Finlandais, deux variantes de Portugais, et trois variantes de Chinois.

      Dans les premiers jours d’Unvanquished nous avions des traductions, mais il y a longtemps nous avons changé la technologie utilisée pour implémenter l’interface utilisateur et la prise en charge des traductions a dû être réimplémentée. Les voici de retour et nous sommes heureux de vous les distribuer de nouveau. Pour contribuer plus de traductions et les affiner, le mieux est de le faire sur Weblate.

      Nouveaux visuels

      De nouveaux modèles sont là : la « painsaw » d’Alex Tikkoiev et le Chaingun d’extreazz. Ils ont été intégrés au jeu par Ishq. Cela semble simple à faire mais nous n’avons pas de modeleur ni d’animateur actif et cela nous freine beaucoup, vous pouvez nous rejoindre.

      Le chaingun Le nouveau chaingun d’extreazz.

      La painsaw produit désormais des étincelles quand elle impacte des surfaces dures, agissant comme le Grand Communicateur de vos désirs de disperser des tripes extra-terrestres.

      La painsaw La nouvelle painsaw d’Alex Tikkoiev.

      Il y a dix ans nous avons reçu une fonctionnalité bien sympathique appelée particules douces (soft particles). Cela empêche certains effets comme le brouillard ou les nuages d’acides d’être affichés de manière disgracieuse lorsqu’ils touchent des murs. Initialement l’effet n’était configuré que pour une poignée de shaders. Rapidement des programmeurs paresseux se sont dits : « configurer les shaders est ennuyeux, et si nous activions la fonctionnalité pour toutes les particules ? ». Malheureusement, cela rend certaines particules invisibles, spécialement les effets d’impacts qui sont très proches de murs ou de sols. Apparemment personne n’a remarqué ça pendant 9 ans, jusqu’à ce que nous retournions à la configuration manuelle de shaders à cause de changements architecturaux liés à autosprite2. Après une revue méticuleuse de tous les systèmes de particules du jeu, nous avons corrigé, retiré ou amélioré certains effets graphiques. Par exemple le souffle du canon lucifer produit désormais une onde de choc, causant une distorsion visuelle. Un tel effet était déjà présent dans les données, mais il ne fonctionnait pas à cause d’un problème de tri des shaders. Le tir secondaire produit aussi un flash violacé à l’impact, effet qui était souvent invisible à cause des particules douces automatiques.

      Un humain en cours de soin sur la médistation Le nouvel effet de soin de la médistation.

      Reaper a repensé l’effet de soin de la medistation et l’a rendue plus transparente, pour que les joueurs en cours de soin puissent voir à travers.

      Sweet a ajouté un nouvel effet visuel au champ de force de la carte plat23. Cela utilise l’effet de mirage de chaleur (heat haze) qui était initialement conçu pour les armes et les effets de feu, mais il se trouve que ça peut également produire des effets très sympathiques dans les cartes. Nous remercions Masmblr pour la manière dont il nous fait avancer en démontrant dans ses propres cartes communautaires comment il est possible d’exploiter de façon créative et nouvelle des fonctionnalités que nous proposons déjà !

      Fichier d’entité

      Le moteur prend désormais en charge les fichiers d’entité. Cela est particulièrement utile pour les cartes (niveaux de jeu) sans source (il y en a des centaines !). Un fichier d’entité permet certaines personnalisations de comment certaines entités fonctionnent (portes, ascenseurs, téléporteurs…). Il est possible d’extraire une description d’entités avec q3map2 et le fichier extrait peut être édité avec un éditeur de texte et lu par le moteur lorsqu’il charge une carte. Le fichier d’entité peut aussi être utilisé pour modifier comment la lumière d’une carte sera appliquée (il est possible d’y renseigner des variables qui configurent le moteur de rendu pour cette carte).

      Le futur est lumineux

      Comparaison de rendu de lumière Une vidéo démontrant la compatibilité des lumières de diverses cartes historiques (voir la vidéo complète).

      Un effort aux long cours est fait pour que le moteur affiche de meilleures lumières en jeu. Les investigations ont commencé à livrer des résultats significatifs en 2020 avec l’affinage du procédé de compilation des lumières. Cet effort est multi-facettes et touche à de multiples aspects de la chaîne de production et de rendu. Ces dernières années, Illwieckz s’est assuré que différents types d’éclairage soient pris en charge. L’éclairage par vertex (vertex lighting) a été ajouté en plus de l’éclairage par grille (grid lighting) et de l’éclairage par texture (lightmap). Ainsi les cartes qui mélangent éclairage par vertex et éclairage par texture sont désormais correctement affichées. Illwieckz a aussi débuggué les styles de lumières, une sorte de lumière dynamique pré-calculée qui fusionne plusieurs textures de lumière (lightmap) au moment du rendu.

      Comparaison de suréclairage Comparaison entre l'ancien suréclairage (à gauche) et le nouveau suréclairage (à droite). Comparer avec un curseur.

      Après cela Illwieckz a réimplémenté le mécanisme de suréclairage (overbright) pour éviter la troncature des lumières (light clamping). Il se trouve que le moteur de rendu de Quake 3 souffrait d’une limitation qui atténuait les lumières autant qu’il les éclaircissait… Le nouveau code non-buggé est désormais activé par défaut. Cela a suscité des débats puisque comme le moteur id Tech 3 avait un suréclairage buggé depuis plus de 20 ans, utiliser un moteur de rendu non-buggé peut révéler des bugs que les créateurs de niveaux n’ont jamais vu avant, et il était même possible d’introduire des bugs dans certains logiciels de production sans que les gens ne s’en rendent compte ! Certaines personnes peuvent argumenter que l’affichage buggé est la façon dont le créateur du niveau s’attend à ce que son niveau soit vu… Cette histoire va si loin que cela mériterait un article dédié !

      La prochaine étape sur ce chemin vers un meilleur éclairage sera de faire de la colorimétrie correctement et de faire de la fusion linéaire de lumière (quelque chose qu’id Tech 3 n’a jamais fait), mais cette tâche est pour le futur.

      Corrections du moteur de rendu

      Un battlesuit se regardant dans des miroirs Une vidéo montrant la récursion de miroirs et de portails et leur fusion (voir la vidéo complète).

      • Sprites : Les surfaces utilisant le mot clé de shader autosprite2 sont correctement affichées, c’est parfois utilisé pour afficher des effets de symétrie axiale, par exemple pour une flamme de bougie. Ce travail a été réalisé par Slipher.
      • Portails et miroirs : Reaper a terminé l’implémentation de la récursion de portail et de miroir, a implémenté la fusion de portails et la fusion alphaGen (une technique qui permet d’obscurcir un portail selon la distance à celui-ci), et a rendu possible d’avoir des portails mobiles. Il a corrigé la rotation de portail ainsi que des bugs de portails liés aux lumières, et s’est assuré que du creep extra-terrestre de taille 10 millions de fois la taille de l’univers observable n’apparaissent pas dans les portails…
      • Vidéo : Nous pouvons à nouveau jouer des vidéos sur les surfaces. Avec le temps le code s’était gâté (rotten code), était devenu cassé et avait même été enlevé tandis qu’il était cassé. Il fut ressuscité et a fait l’objet d’une profonde réécriture par Slipher, et la fonctionnalité fonctionne de nouveau — et même mieux qu’avant (avec moins de limites arbitraires) ! Cette nouvelle implémentation était déjà visible dans la version 0.54.1, la voici désormais dans une version majeure. Le seul format pris en charge est l’antique format RoQ utilisé par Quake 3 qui, par mesure de compatibilité avec les données de jeu existantes, est le codec que nous devons prendre en charge avant tout autre codec. Nous ne fermons pas la porte au fait de prendre en charge d’autres codecs, mais pour cela il faudrait que la fonctionnalité soit utilisée plus souvent pour justifier cet effort supplémentaire.
      • Brouillard : Reaper a corrigé l’effet de brouillard, qui était cassé dans la version 0.45. Oups !
      • Lumières : Les lumières dynamiques sont désormais moins pixelisées, quand bien même ce problème n’est pas encore complètement corrigé.
      • PBR : La prise en charge de textures prétendues « basées sur la physique » est désormais dans un état viable grâce à Ishq (plus d’artefacts noirs). C’est déjà utilisé avec un nouveau modèle de chaingun. Pour le rendre bon, nous avons besoin de le faire fonctionner avec les réflexions spéculaires (réflexions statiques).

      Un dretch regardant Big Buck Bunny Une vidéo montrant la lecture de vidéo sur les surfaces du jeu (voir la vidéo complète).

      En corrigeant le shader autosprite2, la fusion de portails et la lecture de vidéos, nous avons corrigé 3 régressions du moteur original de Quake 3 et qui étaient liées à la prise en charge de format de fichiers anciens et de techniques tout aussi anciennes. Parce que notre moteur de rendu n’est plus celui de Quake 3, corriger certaines de ces régressions requiert parfois d’écrire du code neuf plutôt que de corriger un code existant, et c’est exactement ce qui s’est produit pour les portails.

      Performance améliorées

      Un granger à Noël Unvanquished 0.55.2 a été publiée pour Noël !

      Le moteur et le jeu sont plus rapides que jamais !

      • Simplification du ciel : Reaper a purifié par le feu le code de rendu du ciel qui était archaïque et… étrange. Ce code pouvait générer plus de 1000 triangles par trame rien que pour dessiner le ciel. Une skybox n’a pas besoin d’une géométrie aussi fine, elle est simplement modélisée comme l’intérieur d’un cube. En plus le code faisait des allers-retours mémoire entre la mémoire principale et la mémoire graphique… 🤦‍♂️️ Nous dessinons donc le ciel maintenant avec seulement 12 triangles. Inutile de dire que les performances sont significativement améliorées, et ça aurait toujours dû être comme ça.
      • Culling : Il s’agit du procédé qui élague les surfaces non-visibles pour éviter de les dessiner. Illwieckz a optimisé l’implémentation générique pour processeur central (CPU), Slipher a ciselé à la main un code SSE pour les processeurs x86, et Reaper a permis d’utiliser la carte graphique (GPU) quand le pilote et le matériel sont compatibles.
      • Réduction des délais IPC par du traitement par lots et de la mise en cache : Ces travaux accélèrent des choses comme les particules, les marques d’impact, et les ombres. Illwieckz a réduit le temps d’attente pour ces communications interprocessus en ajoutant des alternatives à nos interfaces de programmation (API) qui fonctionnent par lot. L’IPC est comme un service postal qui transporte les messages entre le processus du jeu Unvanquished et le moteur Dæmon. Pour un facteur, l’important n’est pas le nombre de pages que vous écrivez mais le nombre d’enveloppes à livrer. Vous pouvez donc alléger sa charge de travail en mettant toutes vos lettres dans une seule grande enveloppe. Pour un cas d’utilisation (déjà livrée dans la version 0.54.1), Slipher a implémenté une mise en cache côté code de jeu. Pour filer la métaphore, il n’est pas nécessaire de ré-envoyer le même courrier si le contenu est déjà connu. Sur du matériel actuel, ces optimisations peuvent augmenter le taux de trame (framerate) de plusieurs centaines de FPS quand il y a de nombreuses particules et autres choses de ce genre à l’écran (spam de grenade incendiaires, par exemple !).
      • Code de vertex flottant plus rapide : L’implémentation de vertex plein-flottant écrite par Slipher pour étendre la compatibilité à du matériel plus ancien ou de plus basse gamme qui ne prennent pas en charge les demi-flottants a aussi doublé le taux de rafraïchissement sur du matériel qui fonctionnait déjà ! La réécriture a aussi apporté de menues optimisations dans le code de modèles.
      • Placage de relief : Reaper a corrigé un bug dans le code des cartes de relief (relief mapping), ce qui a débloqué quelques centaines de FPS sur des cartes graphiques de génération actuelle.
      • Usage mémoire des images : Illwieckz a implémenté le mécanisme fitScreen pour les textures d’interfaces utilisateur : c’est une alternative à l’antique implémentation noPicMip de Quake 3 : noPicMip instruisait le moteur de ne jamais réduire la taille d’une image, fitScreen s’assure qu’elle soit réduite d’une façon qu’elle ne devienne jamais plus large que l’écran. Par exemple une capture d’écran d’une carte (niveau) utilisée dans la liste des cartes et au chargement d’une carte ne sera plus jamais chargée en pleine résolution dans la mémoire graphique si elle doit être affichée sur un écran 640×480 (pour donner un exemple extrême)… Combiné avec le mécanisme r_maxImageDimension que nous avons ajouté en version 0.52 pour les textures qui ne sont pas utilisées pour les interfaces utilisateurs comme alternative à r_picmip, ce nouveau mécanisme donne au jeu une empreinte mémoire en VRAM très très faible quand on utilise un écran avec une résolution toute petite.
      • Plus de pré-calcul : De nombreuses décisions étaient préalablement prises à chaque trame en rendant telle ou telle surface, Illwieckz s’est assuré que ces décisions soient désormais prises une fois pour toute lorsque le shader est parsé. Ce que nous appelons « shader » ici est un format de définition de matériaux utilisé par id Tech 3 et ses dérivés, ainsi que de nombreux outils d’édition de cartes. Ne pas confondre avec un « shader GLSL » qui est un programme exécuté sur la carte graphique.
      • SSAO : Le shader GLSL SSAO (Screen Space Ambient Occlusion) a été rendu un peu plus rapide par Reaper.

      Le moteur et le jeu ont été profilés intensivement par Illwieckz en utilisant Orbit. Cet effort a permis d’identifier des goulots d’étranglement (bottleneck) et du code non-optimal. Au final cela nous a aidé à implémenter de nombreuses optimisations à de nombreux endroits dans le code.

      Le chargement de carte a aussi été amélioré de plusieurs façons :

      • Le moteur ne calcule plus la somme de contrôle des images CRN au chargement.
      • Le moteur ne compile plus certains shaders GLSL qui sont détectés comme inutilisés.
      • De la même façon nous avons réduit le nombre de permutations de shader GLSL à compiler.
      • Les joueurs qui aiment jouer seul apprécieront notre génération « multithread » de maillage de navigation de bot (bot navigation mesh), grâce à Ishq et Slipher. Cela fait partie de la phase de chargement lorsque vous jouez une carte pour la première fois dans un jeu local. Cette génération n’utilisait avant qu’un seul fil d’exécution (thread), désormais toute la puissante de votre processeur est exploitée en mettant tous les cœurs à contribution. Les hébergeurs de serveurs peuvent également en profiter et peuvent configurer cette fonctionnalité avec la variable g_bot_navgenMaxThreads (utiliser moins de fils utilise moins de mémoire, ce qui peut être préféré sur certains serveurs).

      Il y a aussi tout un ensemble de choses qui n’ont pas de lien avec le moteur de rendu qui rendent le jeu plus rapide :

      • Le préréglage « le plus bas » (lowest) pour les appareils de très bas de gamme a été optimisé encore plus.
      • Nous distribuons des modèles optionnels en faible qualité – pour le moment seulement pour les constructions, avec la seule différence que ces modèles ont moins d’articulations. Cela permet de traiter l’animation de ces modèles sur des GPUs plus bas de gamme (au lieu de basculer sur le code CPUs quand le GPU est trop bas de gamme).
      • Il a été découvert que certaines variables de configuration (cvar) étaient utilisées par le code de jeu pour envoyer des informations à l’interface du code du jeu dans le but de les afficher à l’écran. Cela signifie que le jeu s’envoyait une lettre à lui-même à travers le moteur à chaque trame… En fait cela demandait même deux lettres : une pour envoyer la donnée au moteur, une pour la récupérer depuis le moteur, tout ça pour une donnée déjà connue ! Cette horreur a été atomisée avec un préjudice extrême.
      • L’accès à une cvar de jeu par son nom depuis le jeu utilise désormais un cache local, réduisant encore le nombre de messages que le jeu et le moteur doivent échanger, accélérant de beaucoup l’interface utilisateur.

      Ceux qui aiment faire tourner des benchmarks seront heureux d’apprendre que le taux de trame de la fonctionnalité timedemo n’est plus plafonné à 999 fps.

      De plus, l’interface Curses peut désormais afficher les FPS.

      Bien entendu que ça fait tourner Unvanquished !

      Toujours du côté du moteur de rendu, l’exigence minimale est désormais OpenGL 2.1 sans extension spéciale. Cela signifie que le matériel le plus limité qui puisse faire tourner Unvanquished inclue les ATI R300, les Intel GMA 3 et 4 (sous Linux) et les Nvidia NV40. Parfois même un OpenGL 2.1 incomplet pourrait suffire !

      Votre carte graphique est prise en charge. Si cela ne fonctionne pas alors qu’elle est censée prendre en charge OpenGL 2.1 (ou plus), c’est très probablement un bug de pilote.

      Par exemple même le VC4 du Raspberry Pi 3B+ peut soutenir 60 fps avec la préconfiguration la plus basse (lowest) et une résolution faible. Cependant le pilote a encore besoin d’être amélioré pour être compatible avec tous les niveaux jouables.

      La carte plat23 Un Raspberry Pi 3B+ dessinant la carte plat23 à 60 fps avec le préréglage « le plus bas »…

      Jouer à Unvanquished sur un RPI3 n’est vraiment pas recommandé (la mémoire vive disponible sera aussi très limitante), mais si un RPI3 arrive à tenir le rang, c’est que le jeu tourne sur vraiment n’importe quoi, y compris sur un topinambour (parce que même une patate ça serait du luxe 🤭️).

      Voici quelques optimisations qui ont été faites pour étendre la compatibilité du moteur :

      • L’extension GL_ARB_half_float_vertex n’est plus requise. Cela s’ajoute au fait que l’extension GL_ARB_framebuffer_object n’est plus non-plus requise depuis la version 0.54 pour être compatible avec plus de matériel. La réécriture faite par Slipher pour prendre en charge à la fois les vertex demi-flottants ou les vertex plein-flottants a même amélioré les performances du moteur (code plus concis, code plus performant, et qui permet plus de chose… tout ça à la fois) !
      • Les textures 3D ne sont plus requises. C’est quelque chose qui est obligatoire en OpenGL 2.1, mais le moteur peut faire sans lorsque l’implémentation est incomplète. De telles implémentations incomplètes peuvent être trouvées avec certaines puces graphiques embarquées conçues pour OpenGL ES, et Mesa se permet de fournir « autant qu’il peut » d’OpenGL pour faire fonctionner les compositeur de bureau. Le moteur Dæmon sait désormais se satisfaire lui-aussi d’une telle implémentation incomplète.
      • Une collection de codes de détection a été implémentée pour identifier des pilotes buggés ou lent, ainsi que des matériels lents. Quand c’est possible, un code moins buggé ou plus rapide est activé lors de l’exécution. Par exemple lors de ce cycle de développement nous avons mis le pied dans ce que les développeurs Intel caractérisent comme un défaut matériel de l’architecture Iris (l’actuelle…), et ont suggéré un contournement qui limite les défauts visuels la plupart du temps. Il y a quelques années nous avions identifié que le dernier pilote Nvidia pour toute une génération de carte donnée ment sur la présence d’une extension, et plante si on tente de s’en servir, et ne sera jamais mis à jour… donc depuis un moment déjà on le détecte pour corriger ses prétentions. Il y a aussi une génération de vieilles cartes ATI qui sont plus rapides en flottants qu’en demi-flottant (la prise en charge annoncée par le pilote est très probablement une émulation pour permettre de faire fonctionner d’autres logiciels qui n’ont pas d’implémentation alternative), donc on détecte et on utilise le code le plus adapté à cette architecture. Il y a d’autres types de contournements mais ces trois-là sont représentatifs. Nous avions déjà quelques-uns de ces contournements implémentés (comme celui pour certaines Nvidia), mais désormais nous avons un procédé standardisé pour implémenter de tels contournements et pour pouvoir les désactiver (pour que les fabricants de matériel et/ou développeurs de pilotes puissent reproduire les bugs, par exemple).

      Bien sûr toutes les améliorations de la vitesse d’exécution ont étendu la compatibilité en transformant des équipements « capable de faire le rendu » en « quelque chose avec lequel on peut jouer ».

      Nous avons aussi ajouté la possibilité de compiler et exécuter un moteur Dæmon natif sur FreeBSD. Les binaires NaCl exécutés dans le bac à sable tournent toujours dans le mode de compatibilité Linux, mais le moteur peut désormais être natif FreeBSD. Une telle astuce doit probablement être utilisable sur d’autres systèmes qui ont une compatibilité Linux intégrée (NetBSD par exemple, mais nous n’avons pas testé), en utilisant un binaire natif pour le moteur et la compatibilité Linux pour la machine virtuelle du code du jeu.

      Un point que nous aimerions améliorer dans le futur au niveau du moteur est l’utilisation mémoire.

      Nouveaux joujoux

      Reflets sur des tuyaux dans la carte Chasm Remarquez les reflets sur les tuyaux !

      Placage de reflet (très expérimental) : Tandis que notre moteur de rendu progresse, les reflets statiques qui étaient complètement cassés sont désormais en meilleur état. Une fois activés, vous pourrez apercevoir votre environnement dans les matériaux réfléchissants, comme des tuyaux métalliques, des plastiques brillants, et des surfaces excessivement polies… Puisque cela est statique, seule la géométrie stationnaire de la carte est pour le moment reflétée, bien que cela soit suffisamment subtil pour que les différences ne soient pas trop évidentes, surtout au beau milieu de l’action. En outre, les données de reflets sont enregistrées et chargées depuis le disque quand vous activez la mise en cache dans les options. Le code du moteur en charge de sélectionner les reflets pour chaque surface a aussi été amélioré, apportant des reflets plus corrects et de grandes améliorations de performance.

      Système de matériaux (très expérimental) : Une autre étape vers la modernisation du moteur est l’ajout d’un système de matériaux. Lorsque le matériel et les pilotes sont compatibles, cela déplace de nombreuses tâches de rendu depuis le CPU vers le GPU, produisant ainsi un flux de travail centré sur le GPU. Bien que cela ajoute un peu plus de travail au GPU, cela élimine une forte pression mise sur le CPU, ainsi que de nombreux aller-retours entre le moteur et le pilote et entre le CPU et le GPU. Sur les cartes les plus exigeantes pour le CPU (en particulier celles avec un “vis” mauvais, le vis est une représentation de la carte générée par le compilateur de carte qui détermine quelle partie devrait être visible selon le point de vue) cela peut doubler le taux de trame comparé au moteur de base. Ce système est encore incomplet et de nombreuses améliorations sont à venir.

      Reaper est celui qui se cache derrière la réalisation de ces chantiers impressionnants.

      Pour pouvoir en profiter il vous sera nécessaire d’avoir OpenGL 4.6 et (en plus) l’extension GL_ARB_bindless_texture. Il reste cependant des problèmes avec certains matériels et pilotes : tout devrait fonctionner avec Nvidia, le système de matériaux et le « frustum culling » devraient fonctionner avec Mesa (radeonsi pour AMD, etc.) quand la dernière version de Mesa est utilisée (l’ « occlusion culling » ne fonctionne pas encore et pourrait planter avec un Mesa qui ne vient pas de la branche de développement main…). Cela ne fonctionne pas avec le pilote propriétaire AMD à cause de bugs. Des contournements pour ces problèmes sont planifiés, mais tous n’ont pas été implémentés à temps pour la sortie de cette version.

      À venir

      Parmis les développements qui sont déjà testables sur certains serveurs et qui seront disponibles dans la prochaine version, il y a le mode « vampire », qui est un mode alternatif de gestion des ressources : plutôt que de miner du point de construction, chaque équipe se voit dotée d’un lot déterminé de points en début de partie et lorsqu’une équipe détruit une construction adverse elle s’approprie les points de construction associées. Ce mode « vampire » est évalué comme une solution potentielle au problème de certaines parties qui sont trop longues ou semblent bloquées avec des équipes trop bien fortifiées de chaque côté. Ce mode de jeu peut être testé en avant-première sur des serveurs comme Map&Bot Testing, Der Bunker, ou Bug Squash Central.

      Il est temps de jouer !

      Le jeu Unvanquished se télécharge ici et les parties en cours sont listées ici !

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Nouvelle année, vœux 2025 et accomplissements passés et futurs
        Traditionnelle période de vœux lors du changement d’année. Voyons ce qui devrait… changera… pourrait éventuellement changer ou non. Donc revenons cette année encore sur nos accomplissements passés et futurs et de ce que nous aimerions voir plus sur notre site préféré. Cinq personnes se sont prêtées au jeu de cette dépêche pas vraiment de vœux, mais un peu quand même. En vrac dans les accomplissements : hurl, cadran solaire, programmes électoraux, Amstrad CPC, financement européen, Haiku, CV,

      Nouvelle année, vœux 2025 et accomplissements passés et futurs

      Traditionnelle période de vœux lors du changement d’année. Voyons ce qui devrait… changera… pourrait éventuellement changer ou non. Donc revenons cette année encore sur nos accomplissements passés et futurs et de ce que nous aimerions voir plus sur notre site préféré.

      Bonne année 2025

      Cinq personnes se sont prêtées au jeu de cette dépêche pas vraiment de vœux, mais un peu quand même. En vrac dans les accomplissements : hurl, cadran solaire, programmes électoraux, Amstrad CPC, financement européen, Haiku, CV, Transimpressux, visualisation scientifique, XMPP, commentaires de code, docker, menstruation, vélo, documentation, éditeur pixel art, assembleur, OSXP, Smalltalk. L’année qui vient, sur LinuxFr.org, promet d’être (fe)diverse, événementielle, ferroviaire, bureautique, réparable, un peu rouillée, résolue et motivée.

      Sommaire

      Benoît Oumph Sibaud

      Accomplissements, réalisations, progrès de l’année 2024

      Le retard côté adminsys pour LinuxFr.org se réduit, de même pour celui sur le code (évidemment ça ne va jamais assez vite, c’est le principe) (voir les dépêches sur nos services img et epub). J’ai eu l’occasion de jouer un peu avec Hurl pour des tests HTTP (voir les dépêches précédemment mentionnées et celle sur Hurl 6.0.0) et docker et docker compose, en plus de faire un peu de Go. J’ai pu de nouveau être présent pour le stand et les animations sur place lors de la conférence Open Source eXPerience Paris et c’était bien de revoir d’autres personnes de l’équipe, de notre lectorat, des libristes connus de longue date et des nouvelles personnes (et de goûter la bière de nos 25 ans aussi). Le 28 juin 2024, la politique de minimisation des données mise en place un an plus tôt (pour les 25 ans du site) s’est appliquée pour les comptes déjà fermés préalablement (prochaine étape en juin 2026).

      Je suis aussi content de ma dépêche sur le contenu programmatique lors des élections européennes de juin. Je mentionnerais aussi dans les sujets importants la question du programme de financement européen Next Generation Internet (NGI) et la dépêche sur le décès de lunar, un hacktiviste pédagogue.

      Ce que je voudrais faire, apprendre ou approfondir en 2025

      Déjà dans les reports de 2024, je voudrais m’intéresser au Fediverse et à ActivityPub peut-être, et peut-être à Gemini (le protocole) ? Il y a des travaux en cours sur le service de partage sur les réseaux sociaux share. Par contre j’ai donné moins de conférences en 2024 pour LinuxFr.org et globalement assisté à moins d’événements : donc je réitère l’ambition 2025 de rencontrer plus régulièrement le lectorat ou les personnes contribuant au site ou des publics nouveaux, car c’est appréciable pour le moral et la motivation.

      Des contenus que je voudrais voir plus sur LinuxFr.org (type de contenu, sujet, etc.)

      Je peux reprendre in extenso mon propos de l’année dernière : je serais intéressé d’avoir plus de contenus (idéalement des dépêches) sur la réparation et la réutilisation, sur de l’informatique sobre, sur des sujets qui ne me viendraient pas à l’idée (sérendipité), sur les politiques autour du numérique et des données, sur des retours d’expérience et sur les sujets qui vous passionnent vous.

      Ysabeau

      Accomplissements, réalisations, progrès de l’année 2024

      Quelque chose dont je suis plutôt franchement fière c’est d’avoir parlé d’un sujet typiquement féminin sur LinuxFr.org tout en restant parfaitement dans le thème du site et celui de la Journée internationale des droits des femmes. Le dessin de l’illustration, qui met les points sur les « i » m’a beaucoup amusé. La qualité de l’accueil de la dépêche sur LinuxFr.org et ailleurs m’a ravie. Dans la série réalisations : les portraits que j’ai faits, quelque chose que j’entends continuer, ont été une grande source de connaissances en ce qui me concerne. Pour finir le modèle-tutoriel de CV – Fiche de candidature qui me trottait dans la tête depuis un certain temps.

      Concernant les progrès : je pense avoir atteint, en matière d’EPUB, le niveau pour mes besoins. Un jour il faudra que je fasse une dépêche sur ce sujet et sur Sigil. Et j’ai bien progressé avec Inkscape, et même en XML hourra !

      Ce que je voudrais faire, apprendre ou approfondir en 2025

      Je n’ai pas fini la série Transimpressux, je vais continuer à travailler dessus. En 2024, j’avais aussi pour objectif, désir, de me pencher sur l’informatique et le handicap, l’exploration de l’espace, entre autres sujet, m’en a éloignée. À voir si j’arrive cette année à mieux explorer le terrain. J’ai aussi dans l’idée de rédiger quelque chose sur l’art la manière de faire des modèles pour LibreOffice et le site des extensions de LibreOffice. Parce que ce n’est pas si évident. Peut-être même, si je trouve comment faire, transformer en extension certaines de mes séries de modèles.

      Quoi d’autre ? Ah oui et faire des modèles de jouets et miniatures (pour maisons de poupée par exemple) pour Draw et Inkscape qui pourraient être faits soit en imprimant le modèle sur papier et en utilisant des matériaux de récupération (cartons divers) pour la réalisation, soit en utilisant un graveur (découpeur ?) laser. Améliorer peut-être ma connaissance du XML et finir de lire les spécifications de l’ODF peut-être.

      Des contenus que je voudrais voir plus sur LinuxFr.org (type de contenu, sujet, etc.)

      Comme pour l’année dernière, j’aimerais qu’on explore plus les questions de réparabilité très concrètement et sur les plans techniques et juridiques. Il y a aussi la question du handicap et de l’informatique qui mérite d’être plus mise en avant. Et plus de tutoriels.

      vmagnin

      Accomplissements, réalisations, progrès de l’année 2024

      J’ai publié en mars 2024, avec mon coauteur Ali, une bibliothèque en Fortran orienté objet nommée ForColormap qui propose des palettes de couleurs pour la visualisation scientifique. Côté hobbys, j’ai bien progressé dans mes projets musicaux ForMIDI et ForSynth (qui génère des WAV), avec à nouveau l’introduction de l’orienté objet. C’est une façon d’étudier la musique : programmer c’est comprendre. J’ai aussi avancé sur mon projet de cadran solaire ForSundial, le seul que j’ai hébergé pour l’instant sur Codeberg. J’espère avoir le temps un jour d’aller au-delà du prototype en peuplier (il paraît que la découpe laser peut graver du marbre). Ah oui, je me suis aussi acheté une carte Greaseweazle 4.1 pour récupérer le contenu de disquettes des années 80 (en particulier au format Atari ST, non lisible sur PC), mais je n’ai toujours pas eu le temps de faire ce que je voulais. Chacun de ces points pourrait faire l’objet d’un journal, mais le temps, c’est ça le problème…

      Sur LinuxFr.org, je n’ai publié que ma dépêche pseudo-périodique « Des nouvelles de Fortran n°6 » pour Noël, ainsi que deux journaux, dont un long qui est la suite de celui de novembre 2021 sur le pulsar iconique CP 1919 et qui parle de beaucoup de choses : histoire de l’informatique, musique électronique, plongée dans les décennies 70 et 80 et ce qu’elles ont à nous dire sur le monde d’aujourd’hui (similarités et différences), etc.

      Mais j’ai en fait aussi participé plus ou moins à d’autres dépêches qui m’intéressaient : relecture, discussion ou rédaction. C’est sympa à faire et c’est un peu comme y avoir accès en avant-première. N’hésitez pas à franchir le pas (onglet Rédaction) si ce n’est déjà fait.

      Ce que je voudrais faire, apprendre ou approfondir en 2025

      Je commence à apprendre le Rust, non pas tellement parce que j’en aurais un quelconque besoin côté professionnel ou côté hobby, mais avant tout pour étudier de nouveaux (pour moi) concepts comme les génériques, les traits, les motifs, la possession et la durée de vie, les fermetures, etc. J’ai emprunté un bon livre : Développez avec Rust traduit récemment chez Dunod. La dernière fois que j’avais vraiment été excité d’apprendre un nouveau langage, c’était avec Python il y a quinze ans (et les expressions régulières en même temps). Après le serpent, je prendrais bien un peu de crabe…

      Sinon, j’aimerais bien avoir le temps de faire en 2025 ce que je n’ai pas eu le temps de faire en 2024 :-) Mais j’ai peut-être tort, je devrais peut-être vouloir faire moins de choses pour avoir plus de temps… à ne rien faire (en plus c’est écologique). Être idle.

      Des contenus que je voudrais voir plus sur LinuxFr.org (type de contenu, sujet, etc.)

      Donc des journaux ou dépêches sur Rust :-) J’aime bien aussi ce qui concerne l’histoire de l’informatique, et ce qui sort des clous comme l’histoire des sciences, les arts, en particulier la musique, etc. L’informatique étant quasiment partout, on trouve facilement un prétexte pour parler de n’importe quoi… On pourrait publier des critiques de livres autour de l’informatique ou de la science et la technologie, et pourquoi pas de films ou autres œuvres. Enfin, des bricolages en FabLab peuvent être intéressants.

      gUI

      Une version très raccourcie pour moi, je voudrais me concentrer particulièrement sur une chose cette année :

      Ce que je voudrais faire, apprendre ou approfondir en 2025

      De la documentation !

      Plusieurs points dans ce sens :

      • Améliorer mes commentaires (j’y documente déjà tous les pièges à cons, mais je continue d’avoir du mal à me comprendre quand je déterre des vieux bouts de code)
      • Améliorer mes notes perso : aujourd’hui j’utilise nb pour ça. C’est pas mal, mais c’est un peu le foutoir, c’est pas centralisé, bref… peut mieux faire
      • Améliorer la doc de mon infra domestique : oui en bon vieux gros Geek c’est pas simple chez moi. Alors déjà quand je dois remettre les mains sur un truc qui tourne sans soucis depuis des années j’ai des gouttes de sueurs, je n’ose imaginer s’il m’arrive quelque chose (eh oui, soyons prévoyants) comment ma famille (pourtant pas des manches) va s’en sortir.
      • Quelques autres projets de doc un poil hors-sujet ici (livret d’accueil dans mon association sportive par exemple)

      PulkoMandy

      Accomplissements, réalisations, progrès de l’année 2024

      J’ai continué à travailler sur l’adaptation de vbcc et vasm pour la console de jeux VTech V. Smile. L’assembleur et le compilateur C sont fonctionnels et on peut compiler le système d’exploitation Contiki avec. Le code généré n’est pas du tout optimisé pour l’instant.

      J’ai un peu avancé sur mon interpréteur pour les fictions interactives du jeu Lectures Enjeu mais il y a des fonctionnements que je n’arrive pas à comprendre: si je fais fonctionner un jeu, j’en casse un autre :(

      J’ai publié une nouvelle version de l’éditeur pixel art GrafX2, il n’y en avait pas eu depuis 2021. Je ne fais plus grand-chose pour ce projet, je pense que le logiciel est assez complet.

      Je continue bien sûr à travailler pour Haiku: entre autres sur les dépêches Linuxfr, le navigateur web WebPositive, et le client XMPP Renga. Je n’ai jamais le temps et la motivation de participer autant que je le voudrais.

      Enfin, j’ai entrepris la réalisation d'un interpréteur Smalltalk pour Amstrad CPC. Il fonctionne, mais il est beaucoup trop lent.

      Et comme il n’y a pas que l’informatique dans la vie, j’ai traversé la France en vélo pour me rendre de Toulouse à Avranches, soit environ 900km en une douzaine de jours. J’ai eu plus de problèmes au retour en train qu’à l’aller en vélo.

      Ce que je voudrais faire, apprendre ou approfondir en 2025

      Du côté des problèmes techniques: le système de sauvegarde externe de mon serveur auto hébergé est cassé. Il faut que j’investigue les scripts perl fournis par le service de sauvegarde que j’ai choisi (qui a l’avantage d’être vraiment pas cher, et les inconvénients qui vont avec).

      Je vais sûrement continuer à travailler sur les projets mentionnés ci-dessus (et quelques autres) et essayer de ne pas en commencer de nouveaux avant d’avoir fini quelque chose. J’ai beaucoup d’idées mais pas le temps pour tout faire.

      Je vais essayer de lire les livres que j’ai gagnés grâce à mes contributions à LinuxFr.org et que je n’ai pas tous eu le temps d’ouvrir :(

      Je vais également essayer de faire du vélo plus régulièrement, ces derniers temps la motivation m’a beaucoup manqué pour ça.

      Des contenus que je voudrais voir plus sur LinuxFr.org (type de contenu, sujet, etc.)

      J’aimerais lire des choses sur d’autres systèmes d’exploitation: Linux, BSD, mais aussi Serenity, ReactOS ou Redox OS et sûrement plein d’autres dont je n’ai pas entendu parler.

      (mais ce serait en plus des contenus existants sur plein de sujets, et des débats dans les commentaires, qui sont passionnants).

      Pour finir

      Nous vous souhaitons tout de même la meilleure année possible (on oscille entre être rebelles et conformistes). Et, bien évidemment, n’hésitez pas à « continuer » cette dépêche dans les commentaires.

      Et un merci à toutes celles et ceux qui font de LinuxFr.org un site enrichi en sérendipité et surprises.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Nouveautés de janvier 2025 de la communauté Scenari
        Scenari est un ensemble de logiciels open source dédiés à la production collaborative, publication et diffusion de documents multi-support. Vous rédigez une seule fois votre contenu et vous pouvez les générer sous plusieurs formes : site web, PDF, OpenDocument, diaporama, paquet SCORM (Sharable Content Object Reference Model)… Vous ne vous concentrez que sur le contenu et l’outil se charge de créer un rendu professionnel accessible et responsive (qui s'adapte à la taille de l'écran). À chaque m

      Nouveautés de janvier 2025 de la communauté Scenari

      Scenari est un ensemble de logiciels open source dédiés à la production collaborative, publication et diffusion de documents multi-support. Vous rédigez une seule fois votre contenu et vous pouvez les générer sous plusieurs formes : site web, PDF, OpenDocument, diaporama, paquet SCORM (Sharable Content Object Reference Model)… Vous ne vous concentrez que sur le contenu et l’outil se charge de créer un rendu professionnel accessible et responsive (qui s'adapte à la taille de l'écran).

      À chaque métier/contexte son modèle Scenari :

      • Opale pour la formation ;
      • Dokiel pour la documentation ;
      • Optim pour les présentations génériques ;
      • Topaze pour les études de cas ;
      • et bien d'autres…

      🥳 Bonne année 2025

      L'association Scenari te souhaite une belle et heureuse année 2025, pleine de projets Scenari ☘️

      Bonne année 2025

      🖥️ Prochain mini-webinaire : « Personnaliser le balisage de son contenu avec les ‘types de’ » 21 janvier

      Mardi 21 janvier 2025 de 17h à 18h heure de Paris, à l’adresse https://scenari.org/visio/miniwebinaire.

      Pour que la session colle au mieux aux besoins de la communauté, tu peux participer à ce fil de discussion sur le forum.

      Documentation sur les « types de ».

      Les enregistrements des mini-webinaires précédents sont sur la page dédiée de scenari.org et dans notre canal peertube.

      Pour proposer des sujets, rends-toi sur ce fil de discussion.

      Parole de scénariste

      💗 Parole de Scenariste

      _J’utilise Scenari dans l’enseignement secondaire général au Bénin pour enseigner les SVT en Terminale D et en formation continue des enseignants.

      Ce que mon expérience m’a permis de réaliser, c’est que malgré les limitations en infrastructures technologiques de mon contexte (accès restreint à Internet, faible disponibilité d’ordinateurs), Scenari m’a permis d’y faire du TICE tout en restant auteur, compositeur et interprète de mes cours (hybride ou online), ce que peu de plateformes offrent._

      Claude Semevo Claude Semevo, doctorant en technologie éducative, professeurs certifié des SVT des lycées et collèges du Bénin, coordonnateur de formation continue, à temps partiel au cerrhud. Cotonou, Bénin.
      Modèles utilisés : Opale, Dokiel, Parcours

      CESI

      📣 Offre emploi d'administrateur plateformes pédagogiques

      L'école d'ingénieurs CESI publie une offre d'emploi où il est demandé d'être familier⋅ère de la chaîne Scenari.
      L'une des mission sera de « participer à la médiatisation des contenus en utilisant la chaîne éditoriale Scenari ».

      Mises à jour

      📣 Beaucoup de mises à jour pour cette nouvelle année !

      Versions de maintenance de la suite Scenari 6.0, 6.2 et 6.3 (principalement des corrections fonctionnelles et sécuritaires).

      Opale passe en version 24.1.2 avec des corrections sur les différents générateurs et une amélioration de l'accessibilité. Détail des améliorations sur le forum. Il est recommandé de mettre à jour les skins utilisés aussi.

      Dokiel passe en version 6.0.9. Au menu, quelques corrections et améliorations sur différentes publications. Retrouve le détail des nouveautés sur le forum.

      Optim et e montent en version aussi. De nouvelles parties font leur appartition dans le scénario papier de OptimPlus.

      Topaze apporte des corrections avec sa version 5.0.3.

      Principale nouveauté dans Process : la possibilité d'intégrer un outil d'analyse de trafic (Google analytics ou Matomo)

      La nouvelle version 3.0.4de Lexico apporte des nouveautés fonctionnelles comme l'inclusion de termes orphelins dans la publication, la diffusion sur un serveur FTP, ou l'url qui inclue la recherche en cours. La version suivante (3.0.5) apporte quelques corrections.

      IDKey passe en version 2.0.3 avec diverses corrections dans l'habillage par défaut.

      Open Education Global

      📣 Liste email Open Education Global Francophone

      Si tu es intéressée par les ressources éducatives ouvertes, alors le réseau francophone de Open Education Global peut t'intéresser.

      Tu peux t'inscrire à leur liste email.

      Coup de pouce sous-titrage

      📣 Coup de pouce : sous-titrage des conférences des Rencontres

      Nous avons besoin d'aide pour réaliser le sous-titrage des conférences enregistrées des Rencontres Scenari.

      Il existe des outils qui font ça automatiquement mais il faut quand même passer derrière et corriger.

      Si tu peux donner un coup de main là-dessus, même un tout petit peu, écris à direction@scenari.org.

      ✨ Le savais-tu ?

      Si tu as beaucoup d'atelier avec desmodèles variés, et que tu as du mal à t'y retrouver, sache que désormais tu peux filtrer ta liste d'atelier en choisissant le modèle qui t'intéresse.

      Par exemple, dans la liste de filtres tu choisis « Dokiel 5 » et ta liste d'ateliers ne montrera que les ateliers Dokiel 5.

      filtre liste d'ateliers

      📊 Le chiffre du mois

      4577 4577, c'est le nombre de chaînes à traduire dans Opale lorsque l'on veut rendre disponible le modèle dans une nouvelle langue. On peut remercier les équipes volontaires de traduction !

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Sortie de LDAP Tool Box Service Desk en version O.6
        LDAP Tool Box Service Desk est une interface Web pour gérer les mots de passe et les statuts des comptes d’un annuaire LDAP standard ou d'un annuaire Active Directory. Il est publié sous licence GPL v3. Ce logiciel sorti en 2020 a bien évolué depuis : système de hook, audit, notifications par courriel, … La version 0.6 parue début décembre 2024 apporte une innovation majeure : la compatibilité native avec Active Directory. lien nᵒ 1 : Dépêche précédente sur la sortie de la version 0.4lien nᵒ 

      Sortie de LDAP Tool Box Service Desk en version O.6

      20 décembre 2024 à 18:56

      LDAP Tool Box Service Desk est une interface Web pour gérer les mots de passe et les statuts des comptes d’un annuaire LDAP standard ou d'un annuaire Active Directory. Il est publié sous licence GPL v3.

      Ce logiciel sorti en 2020 a bien évolué depuis : système de hook, audit, notifications par courriel, …

      La version 0.6 parue début décembre 2024 apporte une innovation majeure : la compatibilité native avec Active Directory.

      Service Desk 0.6

      Active Directory

      C'est peut-être un détail pour vous, mais pour les administrateurs Active Directory cela veut dire beaucoup : plus besoin de passer par les outils d'administration Microsoft pour débloquer un compte, les déactiver ou réinitialiser son mot de passe !

      Service Desk se connecte désormais directement à Active Directory, autorisant ainsi la délégation d'un certain nombre de tâches de support utilisateur au service helpdesk, sans que celui-ci n'accède directement à l'AD.

      OpenLDAP

      Nous n'oublions pas bien entendu OpenLDAP, dont la gestion de la politique des mots de passe a bien évolué entre la version 2.4 et la version 2.5.

      Service Desk intègre les dernières fonctionnalités de l'overlay policy, en particulier la gestion des dates de début et de fin de validité.

      Audit et commentaires

      Chaque action effectuée au travers de l'interface peut être tracée dans un fichier d'audit. Afin d'enrichir ces données, il est possible de forcer la saisie d'un commentaire (pour indiquer par exemple le numéro de ticket concerné). Ce commentaire sera visible dans le fichier d'audit.

      Hooks

      Des scripts peuvent être appelés avant (prehook) ou après (posthook) une action. Ainsi le changement de mot de passe, le déblocage d'un compte, la désactivation d'un compte ou encore la modification des dates de validité peuvent être propagés à d'autres systèmes.

      Politique des mots de passe

      Le composant visuel utilisé dans Self Service Password qui indiquer dynamiquement si les critères de complexité du mot de passe sont respectés ou non est désormais disponible dans Service Desk, facilitant ainsi la réinitialisation du mot de passe.

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • Tuxemon Tower 0 : sortie de la première version !
        Tuxemon Tower 0 est un petit jeu vidéo très sobre. Il est inspiré des jeux Pokémon classiques et consorts, mais il est 100% libre et ne cherche aucunement à être un clone. lien nᵒ 1 : Lien magnet des sources et des binaires (soyez patients et repartagez)lien nᵒ 2 : le wiki de Tuxemon (le projet sur lequel s'est initialement basé Tuxemon Tower 0)Sommaire En bref Qu'est-ce que Tuxemon Tower 0 ? Télécharger Tuxemon Tower 0 Quelques clients BitTorrent libres Images du jeu Images de cartes Imag

      Tuxemon Tower 0 : sortie de la première version !

      Tuxemon Tower 0 est un petit jeu vidéo très sobre. Il est inspiré des jeux Pokémon classiques et consorts, mais il est 100% libre et ne cherche aucunement à être un clone.

      Sommaire

      En bref

      Qu'est-ce que Tuxemon Tower 0 ?

      Tuxemon Tower 0 est un jeu vidéo de combats en tour par tour. Les combattants peuvent avoir un ou des types, ont des statistiques, et une ou plusieurs capacités. En gagnant assez d'expérience, ils montent de niveau et ainsi deviennent plus forts. Un genre simple et classique, mais efficace.

      Et dans le cas de Tuxemon Tower 0, la réalisation est très basique. Cela est vrai autant du point de vue graphique que de celui du moteur. De plus, on accorde qu'on peut parfois juger que l'expérience des joueurs est médiocre (notamment car, hormis être meilleur que nous, vous allez devoir vous fader des combats juste pour avoir un niveau suffisant et on reconnaît qu'il n'y a pas trop d'intérêt ludique à regagner le même combat contre une dresseuse ou commettre un crime contre la biodiversité en enchaînant à gogo les créatures sauvages de la même zone, mais augmenter la vitesse de défilement du texte et garder enfoncé sur le bouton A permet d'écourter le temps de mise à niveau). Mais le jeu est court, donc il est escompté que la découverte et la curiosité qui l'accompagne permettent d'avoir une expérience agréable de ce mini-jeu.

      Télécharger Tuxemon Tower 0

      Le téléchargement des sources (code, images, etc.), de la documentation générée et des constructions pour certaines plateformes (distributions GNU/Linux et Windows) se fait via BitTorrent à travers un lien magnet. On promeut en effet la décentralisation et le fédéralisme, mais aussi la non-disponibilité permanente. De plus, ça oblige tout le monde à partager le coût (hormis les trackers, certes) et à avoir une copie des sources, tout en étant résilient.

      Ce serait sympa de partager pendant l'obtention et aussi après que ce soit fait. Et on prévient : on n'est que rarement à la fois connecté à Internet (on n'a volontairement pas d'accès chez nous) et en mesure de partager via BitTorrent (on ne veut pas faire ça au boulot et il faut que ce soit permis par le réseau), donc ayez de la patience (ou ne vous plaignez pas inutilement). C'est également pour ça qu'on encourage fortement que vous continuez de partager le torrent après l'avoir entièrement obtenu et de préférence sans ratio (puisqu'il n'est pas bien lourd à la vue de la normalité actuelle, et est tout à fait légal, ça ne devrait pas vous être bien problématique).

      Quelques clients BitTorrent libres

      Au cas où vous n'auriez pas de client BitTorrent (ou un qui soit propriétaire), en voici quelques-uns qui sont libres :

      Images du jeu

      Images de cartes

      Images de cartes

      Images de combats

      Images de combats

      Images de menus

      Images de menus

      Comment contribuer ?

      Avant d'éventuellement contribuer, n'oubliez pas plutôt en priorité de faire des choses plus importantes. En effet selon nous, mieux vaut s'activer pour l'émancipation sociale universelle et tendre vers une société écologique que de contribuer à un jeu.

      1. Pour nous, la meilleure manière de contribuer est de mettre à disposition des sprites pour des créatures et des dresseurs. En effet, nous sommes très mauvais pour produire ça et cela ajouterait de la diversité bienvenue (pendant que celle sur Terre s'effondre…). Si ça vous branche, faites-le en respectant le style des actuels, avec une taille adéquate (64×64 et/ou 56×56 et/ou 48×48), et de préférence en faisant l'avant et l'arrière (car avec juste l'avant on ne peut pas jouer la créature ou la personne dresseuse mais juste l'affronter), voire en vous restreignant à 4 couleurs (c'est là la contrainte ultime, mais qui serait utile pour économiser de l'espace et deviendra nécessaire si un jour un port sur GameBoy Color est fait) et alternativement c'est déjà ça si ça ne dépasse pas la barre des 8 (qui va nous servir de transition entre 16 et 4, tout en permettant de réduire l'usage mémoire avec une petite astuce ou de la compression plus poussée que nous ne ferons probablement pas).
      2. Nous n'avons pas l'intention de gérer une communauté autour de ce jeu. C'est pourquoi nous n'avons pas mis le code source sur une forge et nous ne comptons pas le faire. Rien ne vous empêche toutefois de faire une version dérivée et de la publier, peut-être que nous irons y piocher des trucs en vous créditant si nous en avons connaissance.
      3. Bien sûr, si vous voulez que nous intégrions peut-être un jour une contribution, veillez à la mettre sous une licence compatible quand vous n'y êtes pas de toute façon obligé par le gauche d'auteur. Utilisez donc une licence libre, avec de préférence la GNU AGPLv3+ pour le code source et la Creative Commmons BY-SA v4.0 pour le reste.
      4. Mais où mettre ce que vous produisez ? Ça vous regarde. Mais, pour que ce soit visible, le wiki du projet Tuxemon est un bon endroit ou vous pouvez faire un commentaire ci-dessous (pointant par exemple vers votre dépôt sur OpenGameArt).
      5. Si vous vous y connaissez en portage ou en packaging pour votre système favori, n'hésitez pas à faire un joli paquet pour le jeu et à tenter honnêtement de le faire officiellement intégrer. Toutefois, cela ne vaut pas pour Apple iOS, Google Play, Microsoft Store, Steam de Valve, Origin d'Electronic Arts, et consorts.
      6. Évidemment une autre forme de contribution est tout simplement de faire la promotion du jeu. Parlez-en !
      7. Enfin, il existe un moyen rudimentaire : partager le contenu du torrent, pour qu'il soit disponible le plus de temps possible. En effet, nous sommes très loin d'être en permanence avec un accès à Internet et nous n'ouvrons pas systématiquement notre client BitTorrent favori quand nous le sommes.

      Le droit d'auteur

      Les licences utilisées

      Les conséquences

      Remerciements

      En plus long ?

      Le comité éditorial de LinuxFr.org a jugé inappropriée la version longue qui était prévue et qui lui a été soumise. De plus, il a suggéré de feuilletonner l'annonce d'origine. Mais cela ne correspond pas à notre vision éditoriale et plus généralement notre vision anthropologique (le brouhaha communicationnel nous apparaît comme néfaste et donc à ne surtout pas alimenter), et nous n'avons de toute façon pas envie d'y passer du temps (il y a pour nous bien plus important que ce petit jeu vidéo, dont la réalisation est plus pour nous un plaisir coupable qu'autre chose, à fortiori dans une phase très nette de fascisation et d'écocide).

      Néanmoins l'annonce d'origine, qui contient bien plus d'explications, reste disponible. Dans le torrent, il y a les sources (sources.tar.xz) et dans celle-ci il y a l'annonce prévue à la base (news/fr/version-1-0-0_annonce.md). Et si vous voulez la publier ailleurs (en mentionnant que nous en sommes à l'origine et en différenciant bien toute modification), en entier ou sous forme partielle, elle est sous licences libres (vous pouvez choisir celle qui vous convient le mieux) avec gauche d'auteur : Creative Commons BY-SA 3.0, Creative Commons BY-SA 4.0 et GNU GPL 3.0.

      Données du jeu

      Consultation en jeu

      Dans le menu de lancement, proposant de démarrer une nouvelle partie ou d'en charger une existante, appuyez sur Start (ou plutôt l'un des boutons qui y correspond si vous n'utilisez pas une manette ou qu'elle n'est pas reconnue ou pas bien). Cela vous fera changer de menu. Vous aurez alors une entrée « Explorer les données ». Ce n'est pas parce que ça existe que c'est exhaustif.

      Documentation HTML

      Dans le torrent, avec les sources et les constructions, il y a de la documentation sous forme de fichiers HTML, que vous pouvez consulter avec un navigateur web. Vous pouvez aussi la regénérer depuis les sources. Comme pour la consultation en jeu, ce n'est pas nécessairement exhaustif, mais c'est déjà ça.

      Images

      Liste des créatures

      Liste des créatures

      Liste des dresseurs et dresseuses

      Liste des dresseurs et dresseuses

      Annexe : temps et motivation

      Au début d'un projet personnel, la motivation est souvent grande. Mais tant qu'il n'y a pas quelque chose de finalisée, il est à priori courant que la motivation tende à décroitre. En tout cas, c'est notre cas.

      C'est en partie pour cela que le jeu est très simple (système ultra-basique pour les cartes, pas de possibilité d'esclavagir, pas de statut, pas de possibilité de manipulation par le joueur/joueuse d'objets non-visuels, pseudo-aléatoire en guise de non-intelligence artificielle, etc.). L'autre grosse partie de l'explication est la volonté de faire de la basse technologie (d'où entre autres que ce soit graphiquement en niveaux de gris, malgré des sprites avec des couleurs au-delà de ce spectre) et la restante est l'ajout de complexité qui nuise à l'expérience de la mécanique du jeu en ajoutant du « bruit », mais ce n'est là pas le sujet.

      Venir reprocher ou se plaindre de la trop grande simplicité du jeu (qu'il aurait fallu qu'il y ait ceci et cela, etc.) peut être en soi une critique pertinente. Néanmoins, ça ferait totalement fi de l'aspect humain en ce qui concerne la production. En effet, si le jeu n'était pas aussi basique, il ne serait probablement jamais sorti de par la baisse de motivation.

      C'est pourquoi le jeu est volontairement très simple. Mais c'est une fin en soi et une base. Tout ce qui a été fait pour la version 1.0.0 de ce jeu ne sera plus à faire pour une ou des éventuelles versions améliorées et un ou des éventuels autres jeux exploitant tout ou partie de ce qui a été réalisé pour celui-là.

      Approximation de l'évolution de la motivation

      Dans le cadre du développement de ce jeu, on utilise git, un logiciel de gestion de version. Tous les changements y sont consignés et datés. À partir des informations qu'il a enregistrées, il est donc possible d'avoir une idée de l'évolution de la motivation.

      Toutefois, on ne va pas vous livrer le dépôt git (et on a expliqué pourquoi). Vous n'en aurez donc ci-après qu'une vue fort approximative, dont la génération a été faite par git-bars.

      Il fournit une vue par mois du nombre de commits. C'est donc très approximatif. En effet, un commit peut avoir une taille très variable et être pour des changements importants ou mineurs. Néanmoins, ça donne tout de même une image plutôt réaliste de l'évolution de notre motivation.

      On peut notamment bien voir que les débuts sont des périodes fastes. Pour début 2023, on peut constater que c'est assez peu garni, ce qui s'explique par la contre-réforme des retraites. Mais ça montre aussi un biais : en mars et en avril 2023, on n'a fait que des petits trucs pas bien importants, mais ça a engendré pas mal de commits.

      Statistiques de commits par nous pour ce nouveau jeu

      2024-11  61   ▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-10  52   ▀▀▀▀▀▀▀▀▀▀▀
      2024-09  45   ▀▀▀▀▀▀▀▀▀▀
      2024-08  77   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-07  19   ▀▀▀▀
      2024-06  34   ▀▀▀▀▀▀▀
      2024-05  62   ▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-04  126  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-03  59   ▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-02  96   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-01  89   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-12  52   ▀▀▀▀▀▀▀▀▀▀▀
      2023-11  78   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-10  117  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-09  224  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-08  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-07  87   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-06  56   ▀▀▀▀▀▀▀▀▀▀▀▀
      2023-05  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-04  92   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-03  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-02  10   ▀▀
      2023-01  19   ▀▀▀▀
      2022-12  34   ▀▀▀▀▀▀▀
      2022-11  80   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-10  87   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-09  106  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-08  88   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-07  138  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-06  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-05  50   ▀▀▀▀▀▀▀▀▀▀▀
      2022-04  28   ▀▀▀▀▀▀
      2022-03  121  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-02  131  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-01  144  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-12  133  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-11  81   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-10  26   ▀▀▀▀▀
      2021-09  35   ▀▀▀▀▀▀▀
      2021-08  45   ▀▀▀▀▀▀▀▀▀▀
      2021-07  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-06  5    ▀
      2021-05  18   ▀▀▀▀
      2021-04  55   ▀▀▀▀▀▀▀▀▀▀▀▀
      2021-03  79   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-02  112  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-01  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀
      

      Statistiques de commits par nous pour Greycess Knight RPG

      Greycess Knight RPG est la base de ce nouveau jeu. Il part donc du même dépôt git. Puisque des changements sont valables pour les 2 jeux, on les fait dans Greycess Knight RPG, ce qui occasionne des commits de fusion dans le nouveau jeu. De plus, en soustrayant les nombres de commits par mois de Greycess Knight RPG à ceux du nouveau jeu, on peut avoir le nombre de commits qui touchent aux changements nécessaires au nouveau, ou du moins en partie puisqu'on fait parfois le changement dans le nouveau jeu avant de le mettre aussi dans l'ancien ou le (quasi-)même changement dans les 2 pour faciliter la fusion. C'est pour ça qu'on met ci-après les statistiques pour Greycess Knight RPG.

      2024-11  17   ▀▀▀▀▀▀▀
      2024-10  9    ▀▀▀▀
      2024-09  4    ▀
      2024-08  20   ▀▀▀▀▀▀▀▀
      2024-07  1    
      2024-06  8    ▀▀▀
      2024-05  15   ▀▀▀▀▀▀
      2024-04  34   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2024-03  3    ▀
      2024-02  10   ▀▀▀▀
      2024-01  12   ▀▀▀▀▀
      2023-12  16   ▀▀▀▀▀▀▀
      2023-11  15   ▀▀▀▀▀▀
      2023-10  13   ▀▀▀▀▀
      2023-09  29   ▀▀▀▀▀▀▀▀▀▀▀▀
      2023-08  26   ▀▀▀▀▀▀▀▀▀▀▀
      2023-07  25   ▀▀▀▀▀▀▀▀▀▀▀
      2023-06  26   ▀▀▀▀▀▀▀▀▀▀▀
      2023-05  25   ▀▀▀▀▀▀▀▀▀▀▀
      2023-04  35   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2023-03  27   ▀▀▀▀▀▀▀▀▀▀▀▀
      2023-02  4    ▀
      2023-01  3    ▀
      2022-12  9    ▀▀▀▀
      2022-11  22   ▀▀▀▀▀▀▀▀▀
      2022-10  15   ▀▀▀▀▀▀
      2022-09  14   ▀▀▀▀▀▀
      2022-08  27   ▀▀▀▀▀▀▀▀▀▀▀▀
      2022-07  44   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-06  14   ▀▀▀▀▀▀
      2022-05  16   ▀▀▀▀▀▀▀
      2022-04  6    ▀▀
      2022-03  22   ▀▀▀▀▀▀▀▀▀
      2022-02  33   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2022-01  54   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-12  92   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-11  81   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-10  26   ▀▀▀▀▀▀▀▀▀▀▀
      2021-09  35   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-08  45   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-07  85   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-06  5    ▀▀
      2021-05  18   ▀▀▀▀▀▀▀▀
      2021-04  55   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-03  79   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-02  112  ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      2021-01  60   ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀
      

      Par ailleurs, comme vous pouvez le voir, ça a bougé du côté de Greycess Knight RPG. Une version 1.0.2 est en cours. Mais du point de vue de l'expérience de jeu, elle n'apporte rien ou presque. Ce sera une mise à jour technique : elle consistera essentiellement en une amélioration du code source (de diverses manières et à divers endroits) et en une réduction par 3 de la taille du binaire sans la bibliothèque SDL2 statiquement liée (ce qui l'amènera à environ 250 ko grâce à la correction d'une erreur stupide).

      Commentaires : voir le flux Atom ouvrir dans le navigateur

      • ✇LinuxFr.org : les dépêches
      • epub, le convertisseur EPUB3 à la volée de LinuxFr.org
        Le site LinuxFr.org utilise divers logiciels libres pour son fonctionnement et ses services : une large majorité provient de projets tiers (Debian, MariaDB, Redis - version d’avant le changement de licence, nginx, Postfix, conteneurs LXC et Docker, Ruby On Rails, Sympa, etc.) et d’autres composants sont développés pour nos propres besoins. Cette dernière catégorie comprend le code principal du site web en Ruby On Rails, et principalement 5 services autour : le cache d’images img, la tribune boar

      epub, le convertisseur EPUB3 à la volée de LinuxFr.org

      Le site LinuxFr.org utilise divers logiciels libres pour son fonctionnement et ses services : une large majorité provient de projets tiers (Debian, MariaDB, Redis - version d’avant le changement de licence, nginx, Postfix, conteneurs LXC et Docker, Ruby On Rails, Sympa, etc.) et d’autres composants sont développés pour nos propres besoins. Cette dernière catégorie comprend le code principal du site web en Ruby On Rails, et principalement 5 services autour : le cache d’images img, la tribune board, le convertisseur EPUB 3 epub, le partageur sur les réseaux sociaux share et le convertisseur LaTeX vers SVG svg. Cette dépêche va s’intéresser à epub, un code sous AGPLv3.

      Elle est née d’une envie personnelle d’expliquer, documenter et montrer ce qui a été fait sur le convertisseur EPUB3 à la volée de LinuxFr.org, et elle vient accompagner la précédente sur img, le cache d’images sur LinuxFr.org.

        Sommaire

        Des EPUB de vos contenus et commentaires

        LinuxFr.org vous permet de lire les contenus et commentaires du site, au format EPUB3, par exemple dans votre liseuse préférée. Il y a une exception à cela, les liens, parce que certes ça ferait des EPUB tout mignons, mais surtout petits voire un poil inutiles. Le lien EPUB est présent automatiquement sur chaque contenu (hormis les liens donc).

        Le principe est simple : on donne un lien vers un contenu HTML à epub, il le demande à la partie Ruby on Rails du site, ainsi que les images associées, convertit le tout au format EPUB3 et le renvoie à la personne qui l’a demandé. Techniquement epub n'est pas exposé frontalement mais se trouve derrière un nginx.

        Côté code Ruby on Rails

        C’est assez basique : on ajoute juste sur chaque contenu un lien pour télécharger au format EPUB. Ainsi, y compris sur cette dépêche, vous allez trouver un lien à la fin pour récupérer le tout au format EPUB (et un autre pour récupérer le source en Markdown mais c’est un autre sujet).

        app/views/news/_news.atom.builder:    epub = content_tag(:div, link_to("Télécharger ce contenu au format EPUB", "#{url}.epub"))
        app/views/polls/_poll.atom.builder:  epub = content_tag(:div, link_to("Télécharger ce contenu au format EPUB", "#{url}.epub"))
        app/views/posts/_post.atom.builder:  epub = content_tag(:div, link_to("Télécharger ce contenu au format EPUB", "#{url}.epub"))
        app/views/nodes/_actions.html.haml:    = link_to "EPUB", "#{path_for_content node.content}.epub", title: "Télécharger ce contenu au format EPUB", class: "action download"
        app/views/diaries/_diary.atom.builder:  epub = content_tag(:div, link_to("Télécharger ce contenu au format EPUB", "#{url}.epub"))
        app/views/wiki_pages/_wiki_page.atom.builder:  epub = content_tag(:div, link_to("Télécharger ce contenu au format EPUB", "#{url}.epub"))

        Côté epub

        Le service est plutôt simple, par rapport à img, car il n’a pas de dépendance sur redis par exemple, et qu’il a, au final, peu de paramétrage (un couple adresse+port d’écoute, un fichier de trace et un hôte pour aller chercher les contenus).

        Il est possible de faire un GET /status et on obtient une réponse HTTP 200 avec un contenu OK. C’est utile pour tester que le service est lancé (depuis l’intérieur de la plateforme).

        Sinon on lui demande une dépêche, un journal, une entrée de forum, un sondage, une entrée de suivi ou une page wiki en prenant le chemin sur LinuxFr.org et ajoutant un petit .epub à la fin, et il va renvoyer un fichier EPUB. Ou bien il va répondre un contenu non trouvé HTTP 404 s’il y a un souci. Et vu son fonctionnement, si on a un souci de HTML non valide ou si img a un problème avec une image, alors derrière epub pourrait avoir le même souci.

        epub est un binaire dynamique en Go. Il impose le https pour l’hôte (du coup on aura tous les liens en HTTPS en interne normalement). Il ne peut pas vraiment être compilé statiquement (on a besoin de libxml2, libonig2 et de la même version de la libc au déploiement). Il ne gère pas les images in-line.

        Dans les logs on va trouver des infos comme :

        2024/11/03 16:34:02 Status code of http:/example.invalid/exemple.png is: 404
        (…)
        2024/11/03 16:38:23 Fetch https://linuxfr.org/news/capitole-du-libre-2024-au-programme-du-16-et-17-novembre
        2024/11/03 16:38:24 Fetch https://linuxfr.org/users/liberf0rce/journaux/libreast-2006-is-out-of-order
        

        Historique

        epub a été créé par Bruno Michel en 2013 et Bruno est le seul à travailler dessus (48 commits) jusqu’en 2018. Comme img, on peut considérer que epub a fait le job pendant ce temps-là, sans besoin de retouche.

        Mon premier commit de 2021 concerne la gestion d’un cas de collision de nommages des images.

        En 2022, Bruno quitte l’équipe du site, et par ailleurs il y a des montées de versions et des migrations à faire sur les serveurs de LinuxFr.org, et epub fait partie des services à reprendre en main. Ce qui veut dire le comprendre, le documenter et au besoin l’améliorer.

        Bref je décide de me plonger dans epub (2022-2024), dans la foulée de img, car a priori ce n’est pas un composant compliqué du site (il vit dans son coin, il offre une interface, c’est du Go, donc on a un binaire seulement à gérer - divulgâchage en fait non pas seulement).

        Le choix est le même que pour img (cf la dépêche précédente) : ajouter un Dockerfile permettant de recompiler epub dans un conteneur, en contrôlant la version de Go utilisée, en effectuant une détection d’éventuelles vulnérabilités au passage avec govulncheck. Cela me permet de valider que l’on sait produire le binaire d’une part, et que l’on offre à tout le monde la possibilité de contribuer facilement sur ce composant. Et de découvrir qu’une version statique n’est pas facilement envisageable.

        Puis je vais tester le composant pour vérifier qu’il fonctionne comme je le pense et qu’il fait ce qu’on attend de lui. Je vais ajouter une suite des tests qui couvrent les différentes fonctionnalités et les vérifient en IPv4 et en IPv6, en HTTP 1.1 et en HTTP 2.0. Les tests utilisent Hurl et docker-compose, et encore une fois l’idée de donner la possibilité de contribuer facilement. Ils comprennent des tests de types de contenus non pris en charge, le test de la limite à 5 MiB, différents types de contenus, le test de vie, des appels erronés (mauvais chemin, mauvaise méthode, etc). Et surtout de vérifier avec epubcheck que le fichier epub produit est correct. Le choix des cas de tests est basé sur le trafic réellement constaté sur le serveur de production, sur les différents cas dans le code et un peu sur l’expérience du testeur.

        Les différents travaux effectués vont permettre de détecter et corriger quelques soucis :

        Et à la fin, j’écris une dépêche pour parler de tout cela.

        Évolutions récentes

        Dockerfile

        Le fichier Dockerfile du projet permet :

        • de partir d’une image officielle Go d’une version donnée, basée sur une distribution Debian (en raison des dépendances)
        • de l’utiliser pendant la construction en prenant la liste des dépendances de compilation, en les téléchargeant, en prenant l’unique fichier source epub.go et en le compilant dynamiquement avec l’option pour retirer les chemins de compilation
        • de rechercher les éventuelles vulnérabilités avec govulncheck
        • de tester avec golangci/golangci-lint le code (fait à la construction de l’image, car on dispose de toutes les dépendances à ce moment-là)
        • de repartir d’une base Debian en y mettant les autorités de certification, les dépendances de fonctionnement et le binaire issus de la partie construction, de déclarer le port d’écoute et de lancer le binaire avec des variables disposant de valeurs par défaut.

        La suite de tests

        Pour l’utiliser, c’est assez simple, il faut aller dans le répertoire tests et lancer un docker-compose up --build, qui va produire le conteneur contenant epub, et démarrer le nginx-cert qui fournit les certificats et le nginx préconfiguré pour les tests. Si tout va bien, on attend, et au bout d’un moment il s’affiche :

        linuxfr.org-epub-test_1  | All tests look good!
        tests_linuxfr.org-epub-test_1 exited with code 0
        

        Rentrons un peu dans les détails.

        D’abord un fichier docker-compose.yaml qui décrit le réseau IPv4/IPv6 utilisé pour les tests, l’image nginx-cert qui sera utilisée pour créer une autorité de certification et un certificat serveur de test, l’image nginx qui sera utilisée avec sa configuration et ses fichiers à servir pour les tests, l’image epub et son paramétrage (dont l’accès au nginx) ainsi que le répertoire de l’autorité de certification de tests et enfin l’image de la suite de tests qui est construit avec son Dockerfile et son répertoire de dépôt des fichiers EPUB.

        Le Dockerfile de tests est basé sur une image Hurl (un outil pour faire des tests HTTP). On ajoute les fichiers de tests en .hurl, le script shell qui pilote le tout, on prévoit d’avoir les paquets dont on aura besoin : bash (pas par défaut dans les Alpine), curl, openjdk17 (pour epubcheck), openssl, unzip (transitoirement), bind-tools et shellcheck. On installe epubcheck. Et on lance les tests par défaut.

        La configuration nginx de test écoute en HTTP sur le port 80 en IPV4 et IPv6 et permet de définir des chemins avec des réponses en HTTP 301, 302, 308, 400, 401, 403, etc. jusqu’à 530 et même 666 pour les codes invalides, ainsi qu’une redirection infinie.

        Dans les données de tests servies par nginx, on trouve des contenus du mauvais type, des contenus dans divers formats, une image très grande et des images qui ne seront pas accessibles.

        Sont aussi présents deux fichiers de tests avec une extension en .hurl :

        • le test de vie et les chemins hors des contenus autorisés
        • les tests sur les contenus

        Vient enfin le script shell qui pilote le tout :

        • on définit les variables pour les cibles IPv4/IPv6 que l’on veut utiliser dans les autres conteneurs Docker
        • on purge le stockage des EPUB sur disque
        • on lance les premiers tests (en IPv4 et IPv6, en HTTP 1.1 et en HTTP 2.0)
        • sur chaque EPUB produit, on lance epubcheck et on regarde si la validation donne le résultat attendu (succès ou échec)
        • si on est arrivé jusque-là on écrit que tout va bien et on déclenche un sourire de satisfaction.

        Les problématiques restantes

        Il y a quelques entrées encore ouvertes dans le suivi :

        • les images trop grandes (en octet), non récupérables, de format inconnu, etc. : la suite de tests actuelle « couvre » le cas des images de plus de 5 MiB ou non récupérables, avec des tests qui échouent, comme prévu, vu que c’est img qui est censé faire le job de les éviter. Cependant il pourrait être sympa de remplacer toute image non disponible/invalide par une image de remplacement « Image indisponible » du bon Content-Type et du bon nom (vu qu’elle est déclarée dans le MANIFEST).
        • les images trop grandes (en pixel) : globalement on revient à la question des images que laisse passer img
        • les epub non fonctionnels en rédaction et modération : pour des questions de droits, la génération EPUB ne marche pas dans les espaces de rédaction et de modération, à voir si on trouve un contournement ou si on évite de proposer le lien.

        Il y a la question habituelle de la montée de versions des dépendances (pour nous actuellement contraintes celles du code Ruby on Rails). Et des questions à se poser sur l’avenir de nginx ?. Les dépendances pendant le fonctionnement amènent aussi leur lot de contraintes.

        Conclusion ?

        Encore une fois, sans surprise et me répétant, il reste des problématiques et du code à faire pour les gérer (c’est rare un composant sans demandes d’évolution ou de correction). Yapuka (mais probablement plus tard, il faut aussi partager le temps avec les autres composants, ou avoir plus de contributions).

        epub rend la fonction que l’on attend de lui, même si on pourrait faire un peu mieux. Plonger dans ce composant s’est avéré assez intéressant et formateur (et nécessaire) : techniquement cela a été l’occasion de faire du Go, du docker et du docker-compose, du nginx, du hurl, de l’HTTP et de gérer des problématiques statique/dynamique et des dépendances. Il s’agissait encore de comprendre ce que faisait un code écrit par une autre personne, de se poser des questions pour choisir les tests et le contenu de la documentation, de se demander pour quelles raisons tel ou tel choix a été fait, de rendre ce composant plus « contribuable », et de compléter le tout de façon détaillée avec une dépêche.

        Commentaires : voir le flux Atom ouvrir dans le navigateur

        • ✇LinuxFr.org : les dépêches
        • img, le cache d’images sur LinuxFr.org
          Le site LinuxFr.org utilise divers logiciels libres pour son fonctionnement et ses services : une large majorité provient de projets tiers (Debian, MariaDB, Redis - version d’avant le changement de licence, nginx, Postfix, conteneurs LXC et Docker, Ruby On Rails, Sympa, etc.) et d’autres composants sont développés pour nos propres besoins. Cette dernière catégorie comprend le code principal du site web en Ruby On Rails, et principalement 5 services autour : le cache d’images img, la tribune boar

        img, le cache d’images sur LinuxFr.org

        Le site LinuxFr.org utilise divers logiciels libres pour son fonctionnement et ses services : une large majorité provient de projets tiers (Debian, MariaDB, Redis - version d’avant le changement de licence, nginx, Postfix, conteneurs LXC et Docker, Ruby On Rails, Sympa, etc.) et d’autres composants sont développés pour nos propres besoins. Cette dernière catégorie comprend le code principal du site web en Ruby On Rails, et principalement 5 services autour : le cache d’images img, la tribune board, le convertisseur EPUB 3 epub, le partageur sur les réseaux sociaux share et le convertisseur LaTeX vers SVG svg. Cette dépêche va s’intéresser à img, un code sous AGPLv3.

        Elle est née d’une envie personnelle d’expliquer, documenter et montrer ce qui a été fait sur le cache d’images de LinuxFr.org, complétée d’une demande d’un « article technique sur le fonctionnement de ce cache, les choix techniques qui ont été faits, les erreurs commises donc à éviter… ».

          Sommaire

          Des images sur le site

          LinuxFr.org vous permet d’utiliser des images externes dans les contenus et commentaires du site. Ces images sont incluses en syntaxe markdown avec ![description textuelle](adresse "titre optionnel") (soit en saisissant directement du Markdown, soit en cliquant sur l’icône d’ajout d’image dans l’éditeur). Profitons-en pour rappeler que pour utiliser une image sur LinuxFr.org, vous devez vous assurer de respecter sa licence.

          Nous vous encourageons donc à utiliser des images sous licence libre et à citer les auteurs (c’est même obligatoire pour les licences CC-by et CC-by-sa). Cette citation est tirée de la dépêche d’annonce Un nouveau reverse-proxy cache pour les images externes sur LinuxFr.org de 2012.

          Il est aussi recommandé de mettre une vraie description textuelle, qui finira dans l’attribut alt de la balise img utilisée pour l’accessibilité ou si l’image ne peut être chargée. Il peut être utile de lui donner un titre qui apparaîtra l’autre du survol de l’image à la souris par exemple.

          Exemple :

          ![Logo LinuxFr.org](https://linuxfr.org/images/logos/linuxfr2_classic_back.png "L’actualité du logiciel libre et des sujets voisins (DIY, Open Hardware, Open Data, les Communs, etc.), sur un site francophone contributif géré par une équipe bénévole par et pour des libristes enthousiastes.")

          Logo LinuxFr.org

          Buts du cache d’images

          Les raisons évoquées à la mise en place de img (sans ordre particulier) :

          • la sécurité : si une image externe n’est servie qu’en HTTP (en clair donc) et est appelée au milieu d’une page LinuxFr.org elle-même servie en HTTPS, alors le navigateur va râler sur le mélange des genres. img permet de servir toutes les images identiquement (par exemple en HTTPS, et avec le certificat de LinuxFr.org, via le serveur frontal devant img). À noter que ces images ne sont pas servies directement depuis le domaine principal linuxfr.org mais depuis un sous-domaine img.linuxfr.org pour éviter que le JavaScript embarqué dans les images en SVG puisse servir de vecteur d’attaque contre le site.
          • la protection de la vie privée des personnes visitant LinuxFr.org : seul LinuxFr.org voit les informations en provenance de leur navigateur (dont l’adresse IP). Les équipes d’administration des différents sites ne les voient plus (elles voient l’adresse IP du serveur LinuxFr.org).
          • une meilleure gestion du trafic : au lieu d’envoyer tout notre public chercher individuellement chaque image, LinuxFr.org la récupère une fois et la rend disponible. Si le site externe fournissant l’image est un serveur à faibles ressources (liaison ADSL avec faible débit montant par exemple), la mise en cache permet de garantir qu’il ne recevra qu’un faible volume de requêtes (la récupération se faisant initialement toutes les 10 min tant que des demandes arrivent, le cache expirant après 10 min).
          • la conservation des images : les images incluses depuis des sites externes peuvent ne plus être disponibles (l’entité a disparu, le serveur a été arrêté, le domaine a été perdu, l’adresse a changé, etc.). Nous avons donc un mécanisme de cache pour que nous puissions continuer à servir une image même si elle devient indisponible.

          Parmi les conséquences de cette implémentation initiale, on peut citer :

          • si le fichier est changé sur le serveur distant (modifié, converti dans un autre format), l’ancien fichier est servi jusqu’à la prochaine récupération et le nouveau fichier ne sera servi qu’à la prochaine récupération ;
          • si le fichier est supprimé sur le serveur distant, l’image ne sera plus servie après la prochaine récupération (car le serveur a répondu que l’image n’existe plus) ;
          • il est possible de modifier l’image au passage : les images d’avatar sont retaillées pour une hauteur de 64 pixels par exemple ;
          • il est possible de bloquer des images : les images problématiques (pub/spam, contenus pour adultes, images injurieuses, etc.) peuvent être bloquées et ne plus être servies ;
          • par ailleurs img n’accepte de servir que les images connues de LinuxFr.org dont le poids fait moins de 5 MiB.

          À l’utilisation

          Lors de l’écriture d’un commentaire ou d’un contenu sur LinuxFr.org, une personne va ajouter une image externe via la syntaxe Markdown, par exemple ![Logo LinuxFr.org](https://linuxfr.org/images/logos/linuxfr2_classic_back.png)

          Ce qui donne à l’affichage :

          Logo LinuxFr.org

          Et côté code HTML :

          <img src="https://linuxfr.org/images/logos/linuxfr2_classic_back.png" alt="Logo LinuxFr.org">

          OK, mauvais exemple ce n’est pas une image externe, puisqu’elle est hébergée sur LinuxFr.org justement. Prenons un autre exemple ![April - Campagne d’adhésion](https://april.org/campagne-2024/relais/banniereCampagneApril.svg).

          Ce qui donne à l’affichage :

          April - Campagne d’adhésion

          Et côté code :

          <img src="//img.linuxfr.org/img/68747470733a2f2f617072696c2e6f72672f63616d7061676e652d323032342f72656c6169732f62616e6e6965726543616d7061676e65417072696c2e737667/banniereCampagneApril.svg" alt="April - Campagne d’adhésion" title="Source : https://april.org/campagne-2024/relais/banniereCampagneApril.svg">

          Donc on sert l’image via le sous-domaine img.linuxfr.org. On peut aussi noter le titre rempli automatiquement avec la source. Expliquons la nouvelle adresse :

          • // on sert en https si la page est en https et en http si la page est en http (c’est plutôt un oubli qu’autre chose, vu que le site est uniquement en https)
          • img.linuxfr.org on sert depuis un sous-domaine du site
          • 68747470733a2f2f617072696c2e6f72672f63616d7061676e652d323032342f72656c6169732f62616e6e6965726543616d7061676e65417072696c2e737667 est la version en texte-vers-hexadécimal de l’adresse d’origine (68 pour h, 74 pour t (deux fois), 70 pour p, etc.). Il existe des sites et des outils en local pour faire cette conversion, mais cela ne concerne pas la simple utilisation du site.
          • banniereCampagneApril.svg on met à la fin le nom du fichier pour être sympa si vous voulez sauver l’image en local avec un nom plus explicite

          Ceci était le cas où tout se passe bien, comme prévu, comme le voulait la personne qui voulait utiliser une image externe.

          Voyons maintenant ce qui se passe dans le cas pas si rare où la personne a donné une adresse d’image invalide, une adresse ne pointant pas vers une image vers autre chose (cas extrêmement fréquent), une image trop grosse (plus de 5 MiB), etc. Il se passe la même chose côté code, mais côté affichage, pas d’image, et on voit seulement le texte alternatif dans son navigateur. Dans les coulisses, img a répondu 404, cette adresse n’est pas disponible.

          On note donc qu’une même image servie en http:// ou en https:// aura une adresse convertie en hexadécimal différente, donc sera vue comme une autre image par img. Même chose si le serveur externe accepte des adresses sans tenir compte de la casse, ou si on rajoute des paramètres dans l’adresse comme « ?mot_magique=merci ».

          Côté code Ruby on Rails

          Un contenu ou commentaire est en cours de création et une image externe a été mentionnée. Le code de gestion des images va vérifier que l’image est déclarée dans redis (créer l’entrée img/<adresse> avec adresse l’adresse de l’image en clair, ajouter un champ created_at avec l’horodatage, ajouter l’adresse dans la liste des dernières images img/latest) et renvoyer l’adresse via img.

          Le code peut aussi modifier le champ status d’une image dans redis pour mettre ou enlever un blocage (valeur Blocked) par l’équipe du site, et l’ajouter/enlever de la liste des images bloquées img/blocked.

          Côté img

          Les schémas dans la documentation du service img explicitent les possibilités et les comportements.

          Il est possible de faire un GET /status et on obtient une réponse HTTP 200 avec un contenu OK. C’est utile pour tester que le service est lancé (depuis l’intérieur de la plateforme).

          Sinon, on peut envoyer des requêtes GET /img/<adresse_en_hexa> or GET /img/<adresse_en_hexa>/<nom_de_fichier> pour les images, et GET /avatars/<adresse_en_hexa> ou GET /avatars/<adresse_en_hexa>/<nom_de_fichier> pour les avatars.

          En se limitant aux requêtes légitimes, le comportement de img est le suivant :

          • l’adresse demandée a été précédemment déclarée (dans redis par la partie code Ruby On Rails) sinon il répond 404 ;
          • l’adresse demandée n’est pas bloquée par l’équipe du site sinon il répond 404 ;
          • l’adresse est déjà dans le cache disque, alors il renvoie l’image ;
          • l’adresse n’est pas dans le cache disque et la récupération échoue, il renvoie 404 (et va noter temporairement l’échec dans img/err/<uri>) ;
          • l’adresse n’est pas dans le cache disque et la récupération a lieu (noté temporairement dans img/update/<uri>): si le serveur répond positivement à la demande, avec une image comme attendue, pas trop volumineuse, alors on la met en cache disque. Si c’est un avatar, on peut retailler l’image. On aura des champs supplémentaires stockés type avec la nature de l’image (en-tête Content-Type), checksum avec un hachage SHA1 et etag avec la valeur ETag (entête ETag).

          Le cache est rafraîchi régulièrement.

          img est un binaire statique en Go. Il offre des options pour définir le couple adresse:port d’écoute, pour définir où envoyer les logs, pour se connecter à une base redis, pour définir le répertoire du cache disque, pour choisir le User-Agent qui sera utilisé pour les requêtes externes, pour définir l’avatar qui sera renvoyé par défaut, et la possibilité de le lancer uniquement en mode audit interne pour vérifier la cohérence et l’état des données et des fichiers.

          Dans les logs on va trouver des infos comme :

          2024/10/20 20:39:24 Status code of http://example.invalid/exemple1.png is: 404
          2024/10/20 20:39:24 Fail to fetch http://example.invalid/exemple1.png (serve from disk cache anyway)
          2024/10/20 20:44:12 Fetch http://example.invalid/exemple2.png (image/png) (ETag: "be5e-4dba836030980")
          2024/10/20 20:44:12 http://example.invalid/exemple3.png has an invalid content-type: text/html;charset=UTF-8
          2024/10/20 20:44:12 Fail to fetch http://example.invalid/exemple3.png (serve from disk cache anyway)
          

          Ici l’exemple 1 est déjà en cache et peut être servi même si on échoue à le récupérer à ce moment-là. L’exemple 2 vient d’être récupéré. L’exemple 3 a désormais une adresse invalide (qui renvoie une page HTML au lieu d’une image) mais il existe en cache une image précédemment récupérée.

          Historique

          img a été créé par Bruno Michel en 2012. Adrien Kunysz amène 5 commits en novembre 2013, mais globalement Bruno est le seul à travailler dessus (43 commits) jusqu’en 2018. img fait le job et il n’est pas besoin d’y retoucher trop souvent.

          En 2022, Bruno quitte l’équipe du site, et par ailleurs il y a des montées de versions et des migrations à faire sur les serveurs de LinuxFr.org, et img fait partie des services à reprendre en main. Ce qui veut dire le comprendre, le documenter et au besoin l’améliorer.

          Bref je décide de me plonger dans img (2022-2024), car a priori ce n’est pas le composant le plus compliqué du site (il vit dans son coin, il offre une interface, c’est du Go, donc on a un binaire seulement à gérer).

          Étape 1 : je vais commencer par ajouter un Dockerfile permettant de recompiler img dans un conteneur, en contrôlant la version de Go utilisée, en effectuant une détection d’éventuelles vulnérabilités au passage avec govulncheck. Cela me permet de valider que l’on sait produire le binaire d’une part, et que l’on offre à tout le monde la possibilité de contribuer facilement sur ce composant.

          Étape 2 : je vais tester le composant pour vérifier qu’il fonctionne comme je le pense et qu’il fait ce qu’on attend de lui. Je vais ajouter une suite des tests qui couvrent les différentes fonctionnalités et les vérifient en IPv4 et en IPv6, en HTTP 1.1 et en HTTP 2.0. Les tests utilisent Hurl et docker-compose (avec des images redis et nginx), et encore une fois l’idée de donner la possibilité de contribuer facilement. Ils comprennent des tests de types de contenus non pris en charge, le test de la limite à 5 MiB, différents types d’images, le test de vie, des appels erronés (mauvais chemin, mauvaise méthode, etc). Le choix des cas de tests est basé sur le trafic réellement constaté sur le serveur de production, sur les différents cas dans le code et un peu sur l’expérience du testeur.

          Étape 2,5 : l’avatar par défaut renvoie sur le site de production, y compris sur les tests en développement en local et sur le serveur de test du site. J’en profite pour ajouter un paramètre pour cela (et cela permettra de passer du PNG au SVG par défaut).

          Étape 3 : encore une fois essayons de simplifier la vie d’hypothétiques personnes contributrices. Une petite modification pour que hurl et redis soient fournis via docker-compose et ne soient plus nécessaires sur le poste de développement.

          Étape 4 : il est temps de documenter plus le fonctionnement. J’avais déjà décrit les infos stockées dans redis, mais pour comprendre le système de cache, autant fournir des diagrammes pour illustrer ce qui se passe lors d’une requête et comment on passe d’un état à un autre. C’est aussi l’occasion de compléter la suite de tests en ajoutant des tests avant et après expiration du cache, histoire de pouvoir documenter ces cas précis.

          Étape 5 : en cas d’échec de récupération, une image était indisponible jusqu’à la prochaine récupération (donc potentiellement pendant 10 min). Autant servir l’ancienne version en cache lorsque cela se produit : je modifie le code et les tests en conséquence.

          Étape 6 : je sais que certaines images ont été perdues, que des adresses d’images ont toujours été erronées, que des contenus et commentaires ont été supprimés et qu’il n’y a donc plus lieu de garder les images associées. Je décide d’implémenter dans img un audit interne qui indiquera si des anomalies sont présentes dans redis, si des images sont indisponibles ou si des entrées dans le cache disque ne correspondent plus à aucune image. Et j’ajoute cet audit dans la suite de tests.

          Étape 7 : j’écris une dépêche pour parler de tout cela.

          Évolutions récentes

          Dockerfile

          Le fichier Dockerfile du projet permet :

          • de partir d’une image officielle Go d’une version donnée, basée sur une distribution minimale Alpine
          • de l’utiliser pendant la construction en prenant la liste des dépendances, en les téléchargeant, en prenant l’unique fichier source img.go et en le compilant statiquement avec l’option pour retirer les chemins de compilation
          • de rechercher les éventuelles vulnérabilités avec govulncheck
          • d’ajouter le paquet tzdata pour avoir les définitions fuseaux horaires (nécessaire pour les conversions de/vers GMT pour les entêtes type Last-Modified).
          • de repartir d’une base Alpine en y mettant les définitions de fuseaux horaires et le binaire issus de la partie construction, de déclarer le port d’écoute et de lancer le binaire avec des variables disposant de valeurs par défaut.

          La suite de tests

          Pour l’utiliser, c’est assez simple, il faut aller dans le répertoire tests et lancer un docker-compose up --build, qui va produire le conteneur contenant img, et démarrer le redis et le nginx préconfigurés pour les tests. Si tout va bien, on attend, et au bout d’un moment il s’affiche :

          linuxfr.org-img-test_1  | All tests look good!
          tests_linuxfr.org-img-test_1 exited with code 0
          

          Rentrons un peu dans les détails.

          D’abord un fichier docker-compose.yaml qui décrit le réseau IPv4/IPv6 utilisé pour les tests, l’image redis qui sera utilisée (stockage géré par docker), l’image nginx qui sera utilisée avec sa configuration et ses fichiers à servir pour les tests, l’image img et son paramétrage (dont l’accès au redis et au nginx) ainsi que le répertoire du cache et enfin l’image de la suite de tests qui est construit avec son Dockerfile, prévue pour faire du Docker-in-Docker et avoir accès au cache img et aux fichiers nginx.

          Le Dockerfile de tests est basé sur une image Hurl (un outil pour faire des tests HTTP). On ajoute les fichiers de tests en .hurl, le script shell qui pilote le tout, on prévoit d’avoir les paquets dont on aura besoin : bash (pas par défaut dans les Alpine), coreutils, docker et xxd (pour les conversions texte vers hexadécimal). Et on lance les tests par défaut.

          La configuration nginx de test écoute en HTTP sur le port 80 en IPV4 et IPv6 et permet de définir des chemins avec des réponses en HTTP 301, 302, 308, 400, 401, 403, etc. jusqu’à 530 et même 666 pour les codes invalides, ainsi qu’une redirection infinie.

          Dans les données de tests servies par nginx, on trouve des contenus du mauvais type, une image destinée à être bloquée, des images dans divers formats, une image très grande en pixels mais pas trop en octets, une image trop grande en octets, et un avatar à servir par défaut.

          Sont aussi présents cinq fichiers de tests avec une extension en .hurl :

          • le test de vie et les chemins hors img/ et avatars/
          • les tests sur les avatars : adresse valide ou invalide, image inexistante, bon et mauvais types, comportements sur les différents codes HTTP et sur une boucle de redirection infinie
          • les tests sur les images (découpés en trois parties, la partie initiale, la partie entre la récupération initiale et l’expiration du cache et enfin la partie après la récupération et l’expiration du cache.

          Vient enfin le script shell qui pilote le tout :

          • on définit les variables pour les cibles IPv4/IPv6 et les binaires redis et img que l’on veut utiliser dans les autres conteneurs Docker
          • on liste les images dans différentes catégories :
            • celles qui vont échouer et ne comporteront donc qu’une entrée dans redis sans rien dans le cache disque (avec sous-catégories possibles bloquées/non-bloquées)
            • les images devant être en erreur
            • les images qui iront normalement dans le cache
          • on prépare des images qui seront altérées plus tard
          • on purge le cache sur disque, on nettoie redis et on déclare toutes nos images comme le faire le code Ruby on Rails. Certaines sont déclarées bloquées pour les tests.
          • on lance les premiers tests (en IPv4 et IPv6, en HTTP 1.1 et en HTTP 2.0)
          • on modifie certaines images pour simuler un changement sur le serveur externe, une suppression sur le serveur externe ou un blocage par l’équipe de site
          • on lance les tests post-récupération initiale mais avant l’expiration du cache (toujours avec toutes les variantes)
          • on force l’expiration du cache
          • on lance les tests post-expiration du cache (toujours avec toutes les variantes)
          • si on est arrivé jusqu’ici, c’est qu’on a passé tous les tests Hurl, alors maintenant on recompte ce que l’on a dans redis et sur disque et on vérifie si ça correspond à nos attentes
          • on nettoie les images mises volontairement en échec
          • on lance le test d’audit interne qui doit nous dire que tout va bien
          • si on est arrivé jusque-là on écrit que tout va bien et on déclenche un sourire de satisfaction.

          L’audit interne

          L’objectif est de vérifier la cohérence des données dans redis, si des images sont indisponibles ou si des entrées dans le cache disque ne correspondent plus à aucune image.

          Le binaire d’img peut donc être appelé en mode audit et lancer des contrôles internes.

          D’abord il collecte la liste des fichiers dans le cache disque.

          Ensuite il vérifie que toutes les images listées dans les dernières images (img/latest) existent comme entrées individuelles.

          Puis il vérifie s’il existe des images bloquées (il râlera s’il y en a) et si chacune existe comme entrée individuelle le cas échéant.

          Ensuite on parcourt tous les entrées individuelles d’images :

          • on râle si on tombe sur une entrée img/updated/ ou img/err/ sans date d’expiration
          • on râle si on tombe sur une entrée img/ sans champ created_at, sans type ou d’un type inconnu, sans checksum, avec un statut inconnu, une image bloquée non présente dans les images bloquées, un champ inconnu, une présence inattendue dans le cache disque, etc. Et on marque les images que l’on a vu passer comme attendu dans le cache.
          • on râle sur tous les fichiers du cache restants (ne correspondant à aucune image)
          • si on a râlé, on renvoie 1, sinon 0

          Le grand nettoyage

          img a fonctionné pendant 12 ans en production : il a rencontré des bugs, des comportements inattendus, des contenus et commentaires ont été supprimés ou réédités, etc. Il est donc probable qu’il y ait besoin d’aller dépoussiérer un peu tout cela et de retirer ce qui est inutile.

          Les traces du grand nettoyage sont d’abord visibles dans la rétrospective de la première quinzaine de septembre 2024 :

          • une « image » sur sept présente un souci (n’est pas une image, adresse invalide, trop grosse, etc.) et n’est donc pas dans le cache sur disque (ce qui a conduit à pas mal de taf sur la partie gestion des images)
          • les types de contenu (Content-Type) en provenance de sites variés et divers, c’est quelque chose… entre les « image/JPEG » ou « image/PNG » en majuscules parce que, les charset=utf-8 ou UTF-8 ou… sur du binaire, les name= qui ne sont pas dans la norme… Wikimedia renvoie aussi du profile="https://www.mediawiki.org/wiki/Specs/SVG/1.0.0" (pareil ça semble en dehors de tout standard).

          D’abord j’attaque le sujet la fleur au fusil en me disant que ça va passer crème, je fais un joli tableau qui résume l’état initial :

                                        img/<uri>   img/updated/<uri>   img/err/<uri>   blocked
          total                           25565 -21       634               160            5
          
          no created_at                      23 -23         0                 0            0
          created_at                       2857 -3          0                 5            1
          created_at+type                   222             0                 0            0
          total not in cache               3104 -26         0                 0            0
          
          created_at+type+checksum(+etag) 22463 +5        634               155            4
          
          files in cache                  22778 +5
          

          Donc on a officiellement 25 565 images, mais 23 sont mal créées (état théoriquement impossible hors race condition), 222 sont incomplètes (état théoriquement impossible race condition), 22 463 sont attendues en cache et on a 22 778 fichiers dans le cache. Ça part mal. Je nettoie en premier le plus facile (on voit le delta +/- de mes corrections). Et on arrive à une situation où une image sur sept présente alors un souci et il faut gérer un grand volume de corrections à faire.

          Parmi les soucis on trouve des types de contenus inattendus (image/PNG ou image/JPEG avec majuscules, image, des images binaires annoncées avec un charset, des types invalides comme image/jpg au lieu de image/jpeg, etc), des erreurs de notre lectorat (mauvais lien, mauvais copier-coller, lien vers une page web au lieu d’une image), mais aussi des espaces insécables et autres blancs inopportuns, des guillemets convertis, des doubles scheme (http://https:// ou http://file://).

          Après cela se cache une autre catégorie encore plus pénible : les images que l’on a en cache, mais qui ne sont plus utiles au site : par exemple celles qui étaient dans des contenus ou commentaires supprimés (notamment le spam), celles qui étaient dans des commentaires ou contenus réédités depuis, etc.

          Un problème connu est devenu vite pénible : on n’a pas d’association entre les images externes et les contenus/commentaires concernés. Donc il faut d’abord extraire la liste de toutes les déclarations d’images externes des 12 tables SQL où l’on peut trouver des images et des avatars, sous forme HTML ou Markdown.

          Ensuite il faut sortir toutes les entrées dans redis et regarder si on les retrouve en clair ou converties en hexadécimal dans l’extraction SQL.

          Et par sécurité on fera une double vérification pour celles détectées en erreur, en relançant une recherche en base (attention à la casse dans la recherche texte).

          Au final, on peut supprimer des milliers d’entrées redis et de fichiers dans le cache.

          Et un jour l’audit dit :

          Connection 127.0.0.1:6379 0
          2024/10/19 12:11:21 Sanity check mode only
          2024/10/19 12:11:37 Files in cache: 17926
          2024/10/19 12:11:39 Total img keys in redis: 18374
          OK
          

          Ça aura pris un mois et demi (l’audit a été fusionné le 8 septembre 2024), certes pas en continu, mais ça a été long et guère palpitant de faire ce grand ménage. Et j’ai refait une seconde passe du traitement complet la semaine d’après pour vérifier que tout se passait correctement et que les soucis résiduels après tout ça étaient minimes ou nuls.

          Parmi les anecdotes, Web Archive / archive.org a eu sa fuite de comptes utilisateurs et a été indisponible sur la fin (ce qui rendait compliqué la récupération d’images perdues ou leur remplacement par un lien valide par exemple). Et, mentionné dans la rétrospective de la seconde quinzaine de septembre 2024, un compte de spammeur de 2015 supprimé… mieux vaut tard que jamais : détecté parce que comme beaucoup de visiteurs, le spammeur ne fait pas la différence entre un lien vers un document et l’ajout d’une image.

          Les problématiques restantes

          Il y a la question habituelle de la montée de versions des dépendances (pour nous actuellement contraintes celles du code Ruby on Rails) et du remplacement des composants devenus non-libres (migrer vers valkey plutôt que redis ? Questions à se poser sur l’avenir de nginx ?).

          On pourrait aussi ajouter la prise en charge du TLS et d’un certificat X.509 directement dans img plutôt que dans un frontal. Mais ce n’est utile que si on les sépare sur deux serveurs distants, ce qui n’est pas le cas actuellement. Donc même si ça ne paraît pas compliqué à faire, ce n’est pas urgent.

          Ensuite une entrée de suivi existe pour séparer le cache des avatars du cache des autres images : les contraintes pour le cache des avatars étant différentes de celui des autres images, le stockage en cache devrait être différent. Cela reste un problème mineur. Le changement doit d’abord être fait côté Ruby on Rails pour définir les avatars avec des clés redis différentes (genre avatars/ au lieu de img/). Ensuite on peut modifier img pour séparer le traitement des requêtes HTTP /img/<adresse_hexa> vers les clés redis img/<adresse> et le cache disque des images par rapport aux requêtes /avatars/<adresse_hexa> vers les clés avatars/<adresse> et le cache des avatars. Il faudra aussi déplacer les avatars stockés dans l’actuel cache des images dans leur propre cache. Et là on devrait pouvoir avoir la même adresse dans les deux caches mais avec un rendu éventuellement différent.

          Un autre problème concerne la non-association des contenus ou commentaires avec les images externes qu’ils contiennent, ce qui rend l’administration des anciennes images un peu pénible. Le fait que les contenus et commentaires peuvent être réédités ou simplement prévisualisés (donc que des images peuvent être supprimées et d’autres ajoutées) vient compliquer un peu la tâche. Actuellement un ensemble de scripts permettent d’obtenir ces infos et fournissent un contournement, mais ça reste un peu laborieux.

          Un cache rafraîchi périodiquement conserve les images pour éviter de surcharger le site d’origine, pas si le site a changé, déplacé ou perdu l’image. La modification pour servir depuis le cache disque en cas d’échec de récupération couvre le cas de la disparition d’une image avec une erreur sur l’adresse, pas celui où le serveur répond une mauvaise image. Il y a donc une autre entrée de suivi images et disparition du web évoquant l’augmentation des soucis sur les images externes avec un cache rafraîchi, en raison des domaines récupérés par des spammeurs et autres pénibles, ou perdus ou utilisés pour du phishing (imageshack.us, après framapic, pix.toilelibre, etc.). Diverses problématiques sont mentionnées comme la perte d’information et donc la diminution de l’intérêt des contenus anciens, la prime aux pénibles du référencement SEO qui pourrissent le net en récupérant les vieux domaines, la modification possible des images publiées. Pour résoudre cela techniquement, ça nécessite de suivre les images et les domaines perdus, et d’intervenir de façon régulière. Ou bien de ne plus rafraîchir le cache (que cela soit jamais, après la publication ou au bout d’un certain temps après la publication). Pour juste éviter la perte d’info, il est possible de remplacer par une image locale récupérée d’une archive du net type archive.org, avec le côté « pénible à faire » et sans garantie que ça soit toujours possible (merci waybackpy).

          Enfin une troisième entrée de suivi suggère l'hébergement des images des dépêches (et éventuellement des journaux), idéalement en permettant d’avoir une version modifiée d’une image en changeant sa taille. On peut citer en vrac comme problématiques la responsabilité légale, l’éventuelle volumétrie, l’impossibilité de corriger une image publiée facilement par la personne qui l’a soumise, la centralisation et la perte de référencement pour des tiers, l’éventuelle rétroactivité et le traitement de l’historique, le fait qu’il faut traiter tous les autres contenus/commentaires pouvant accueillir des images, etc. Autre question, faut-il différencier les images passées en modération a priori de celles en modération a posteriori ?

          Conclusion ?

          Bref sans surprise, il reste des problématiques et du code à faire pour les gérer (c’est rare un composant sans demandes d’évolution ou de correction). Yapuka (mais probablement plus tard, il faut aussi partager le temps avec les autres composants, ou avoir plus de contributions).

          img apporte les fonctionnalités que l’on attendait de lui même si on pourrait faire mieux. Plonger dans ce composant s’est avéré assez intéressant et formateur (et nécessaire) : techniquement cela a été l’occasion de faire du Go, du docker et du docker-compose, du redis et du nginx, du hurl et de l’HTTP. Et de comprendre ce que faisait un code écrit par une autre personne, de se poser des questions pour choisir les tests et le contenu de la documentation, de se demander pour quelles raisons tel ou tel choix a été fait, de rendre ce composant plus « contribuable », et de compléter le tout de façon détaillée avec une dépêche. Reste à savoir si j’ai répondu à l’attente d’un article technique sur le fonctionnement de ce cache, les choix techniques qui ont été faits, les erreurs commises donc à éviter… et la réponse est à trouver dans les commentaires.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          • ✇LinuxFr.org : les dépêches
          • Sortie de LyX 2.4
            Revenons sur les nouveautés de LyX 2.4 à l’occasion de la sortie de la 2.4.2, qui apporte son lot de correctifs. LyX est un éditeur de documents WYSIWYM (what you see is what you mean) prévu pour l’environnement TeX et disponible sous licence GPL. Contrairement à Word ou LibreOffice, par exemple, l’utilisateur ne voit pas directement à l’écran le même résultat que s’il imprimait le document (WYSIWYG). Ce mécanisme est voulu, car TeX impose de « compiler » les documents avant de les visualiser :

          Sortie de LyX 2.4

          Revenons sur les nouveautés de LyX 2.4 à l’occasion de la sortie de la 2.4.2, qui apporte son lot de correctifs.

          LyX est un éditeur de documents WYSIWYM (what you see is what you mean) prévu pour l’environnement TeX et disponible sous licence GPL. Contrairement à Word ou LibreOffice, par exemple, l’utilisateur ne voit pas directement à l’écran le même résultat que s’il imprimait le document (WYSIWYG). Ce mécanisme est voulu, car TeX impose de « compiler » les documents avant de les visualiser : LyX permet donc de visualiser la sémantique du document avant d’en générer un PDF.

          La version 2.4 est sortie le 1er juin 2024 et apporte un grand lot de nouveautés, après six ans de développement. Cette version est constituée de 8700 commits par 40 personnes et a permis de fermer 800 problèmes connus.

          Logo Lyx

          Fenêtre principale de LyX

          Parmi les changements principaux, LyX utilise désormais UTF-8 en interne pour la représentation des documents, une évolution qui suit de près LaTeX, qui a fait le même mouvement en 2018 (bien après les moteurs modernes comme XeTeX ou LuaTeX).

          Au niveau de l’interface graphique, les thèmes sombres fonctionnent bien mieux qu’avant, notamment au niveau de l’éditeur de formules. Pour Windows, le thème Fusion de Qt est nécessaire pour obtenir une interface sombre.

          Au niveau des exports vers d’autres formats que des dérivés de TeX, LyX 2.4 génère désormais du XHTML 5 (c’est-à-dire du HTML5 mais lisible comme du XML). La sortie DocBook a été entièrement réécrite, de telle sorte qu’elle s’utilise désormais sur la majorité des types de documents LyX (à l’exception notable des présentations Beamer). Précédemment, seuls des documents suivant un modèle spécifique à DocBook pouvaient être exportés en DocBook, mais pas en LaTeX : maintenant, un même document pourra être exporté en DocBook et LaTeX. Cette sortie DocBook a aussi été l’occasion d’implémenter une sortie en ePub 3 (utilisant DocBook et les outils standard de DocBook pour convertir un document en ePub 3).

          Le développement de LyX se poursuit activement, avec la branche 2.5 en préparation parallèlement aux mises à jour de la branche 2.4. Les améliorations et corrections en cours sont détaillées dans le système de suivi du projet, accessible au public.

          Il est remarquable de noter que LyX, lancé initialement en 1995, approche bientôt de ses 30 ans d'existence. Cette longévité témoigne de la qualité et de l'utilité durable de ce logiciel. Il n'a jamais cessé d'évoluer pour répondre aux exigences de ses utilisateurs, en particulier dans le domaine de l'édition scientifique et académique.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          • ✇LinuxFr.org : les dépêches
          • Revue de presse de l’April pour la semaine 38 de l’année 2024
            Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [clubic.com] La secrétaire d'État à l'IA et au Numérique est à la dernière place du gouvernement, un nouvel affront à la Tech [LeMagIT] Open Source Summit: Proxmox se dévoile aux clients de VMware (€) [Le Monde Informat

          Revue de presse de l’April pour la semaine 38 de l’année 2024

          Par : echarp
          25 septembre 2024 à 08:55

          Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

          [clubic.com] La secrétaire d'État à l'IA et au Numérique est à la dernière place du gouvernement, un nouvel affront à la Tech

          ✍ Alexandre Boero, le dimanche 22 septembre 2024.

          Pour la première fois en France, l’intelligence artificielle est représentée au sein du gouvernement, avec le Numérique. Sauf qu’une fois de plus, les disciplines de la Tech n’ont pas droit à leur ministère.

          Et aussi:

          [LeMagIT] Open Source Summit: Proxmox se dévoile aux clients de VMware (€)

          ✍ Yann Serra, le jeudi 19 septembre 2024.

          Le petit éditeur autrichien a vu le nombre d’entreprises intéressées par sa solution de virtualisation exploser depuis que Broadcom a changé les conditions tarifaires de VMware, le leader du domaine.

          [Le Monde Informatique] Linus Torvalds incite les codeurs à miser sur les projets open source utiles (€)

          ✍ Sean Michael Kerner, le mercredi 18 septembre 2024.

          Lors de l’événement Open Source Summit Europe de la Fondation Linux, le créateur de Linux a fait le point sur les dernières mises à jour de Linux et sur l’open source.

          [L'Informaticien] Une initiative pour soutenir les meilleures pratiques open source

          Le mercredi 18 septembre 2024.

          Baptisée Developer Relations Foundation (DRF), cette initiative, annoncée le lundi 16 septembre lors de l’OSSummit de Vienne, vise à soutenir et à unifier les meilleures pratiques au sein de la communauté des développeurs open source.

          [L'usine Nouvelle] Comment l'Inria veut faire avancer l'open source dans l'IA… tout en monétisant ses recherches (€)

          ✍ Léna Corot, le mardi 17 septembre 2024.

          En présentant le 12 septembre le programme de recherche P16 et la start-up Probabl, l’Inria s’attaque à l’intégralité du cycle de la donnée. L’objectif est de développer et maintenir à l’état de l’art des bibliothèques de logiciels open source tout en parvenant à commercialiser ces ressources avec de nouveaux produits et services.

          [ZDNET] La documentation sur Linux et les logiciels libres est un véritable capharnaüm: voici la solution

          ✍ Steven Vaughan-Nichols, le mardi 17 septembre 2024.

          Il ne suffit pas de dire à quelqu’un de se débrouiller tout seul lorsque le manuel est obsolète, illisible ou inexistant. Nous devons améliorer la qualité de la documentation du code, et le moyen d’y parvenir est simple.

          [Le Monde Informatique] AWS place Opensearch sous les auspices de la Fondation Linux

          ✍ Jacques Cheminat, le lundi 16 septembre 2024.

          Après avoir forké le moteur de recherche et d’analyse d’Elasticsearch, AWS a décidé de transférer ce projet à la Fondation Linux avec la création d’une entité dédiée la Fondation Opensearch.

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          • ✇LinuxFr.org : les dépêches
          • Célébrons les 21 ans des Linux-Meetup au Québec
            🎉 Il y a plus de deux décennies, j’ai lancé mon tout premier Linux-Meetup à Montréal en mai 2003. Depuis, chaque premier mardi du mois, nous avons tenu 252 rencontres sans interruption, rassemblant des passionnés du monde Linux. 🚀 Le samedi 21 septembre 2024, nous fêterons 21 ans de partage autour de Linux et des logiciels libres au Québec ! Cet événement coïncide avec la Journée internationale des logiciels libres (SoftwareFreedomDay), offrant une visibilité mondiale inégalée. Ce sera l’occasi

          Célébrons les 21 ans des Linux-Meetup au Québec

          🎉 Il y a plus de deux décennies, j’ai lancé mon tout premier Linux-Meetup à Montréal en mai 2003. Depuis, chaque premier mardi du mois, nous avons tenu 252 rencontres sans interruption, rassemblant des passionnés du monde Linux.

          🚀 Le samedi 21 septembre 2024, nous fêterons 21 ans de partage autour de Linux et des logiciels libres au Québec ! Cet événement coïncide avec la Journée internationale des logiciels libres (SoftwareFreedomDay), offrant une visibilité mondiale inégalée. Ce sera l’occasion de célébrer cette communauté qui s’est agrandie au fil des années et de marquer cette étape importante dans l’histoire du logiciel libre.

          📈 Chaque année, notre événement annuel devient de plus en plus grand grâce à l’appui de nos commanditaires. Avec une participation record de 150 passionnés l’an dernier et le soutien de 23 commanditaires visionnaires.

          🌐 L’événement se tiendra en présentiel à l’école de technologie supérieure (ÉTS), à l’université et en virtuelle sur BigBlueButton, permettant à la communauté Linux francophone de participer d’où qu’elle soit.

          💼 Si votre entreprise utilise Linux ou soutient les logiciels libres, c’est une occasion unique de promouvoir vos solutions et vos services auprès d’une audience ciblée et engagée. Rejoignez-nous comme commanditaire et bénéficiez d’une visibilité accrue au sein de la communauté. Contactez-moi rapidement pour discuter de votre participation !

          🚩 Pour les plus aventureux, la cinquième édition de notre chasse au trésor informatique (CTF : CaptureTheFlag) sera de retour avec des défis inédits, conçus par Dominique Derrier et Pascal Gad. Cet événement interactif mettra vos compétences Linux à l’épreuve et promet des moments captivants pour les participants.

          🗣️ Au programme : des présentations passionnantes des experts Linux, le CTF et des opportunités d’échanges avec la communauté, et bien plus encore.

          🎟️ Ne manquez pas cette opportunité unique de vous inscrire et de découvrir l’agenda complet à https://www.rencontres-linux.quebec/event/21-ans-de-linux-meetup-au-quebec-1/

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          • ✇LinuxFr.org : les dépêches
          • Projets Libres! Episode 32 : Emmabuntüs, Linux et réemploi
            Pour le premier épisode de la troisième saison du podcast, nous découvrons la distribution Emmabuntüs. Avec Patrick, son mainteneur, et Yves, un de ses contributeurs régulier, nous abordons les sujets suivants : la naissance et les évolutions de la distribution le réemploi de matériel informatique et la clef de réemploi du projet le rapport avec Emmaüs les améliorations de la distribution pour les déficients visuels la collaboration avec le projet d'ordinateur à fabriquer soit-même Jerry Do I

          Projets Libres! Episode 32 : Emmabuntüs, Linux et réemploi

          Pour le premier épisode de la troisième saison du podcast, nous découvrons la distribution Emmabuntüs.

          Avec Patrick, son mainteneur, et Yves, un de ses contributeurs régulier, nous abordons les sujets suivants :

          • la naissance et les évolutions de la distribution
          • le réemploi de matériel informatique et la clef de réemploi du projet
          • le rapport avec Emmaüs
          • les améliorations de la distribution pour les déficients visuels
          • la collaboration avec le projet d'ordinateur à fabriquer soit-même Jerry Do It Together
          • le fonctionnement du collectif et sa communauté
          • les défis d'Emmabuntüs

          Bonne écoute !

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          • ✇LinuxFr.org : les dépêches
          • Revue de presse de l’April pour la semaine 34 de l’année 2024
            Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April. [ZDNET] Pas de panique! Il n'y a que 60 bulletins de sécurité CVE Linux par semaine… [Ars Technica] “Something has gone seriously wrong,” dual-boot systems warn after Microsoft update [Next] Sur Wikipédia, 20 % des biog

          Revue de presse de l’April pour la semaine 34 de l’année 2024

          [ZDNET] Pas de panique! Il n'y a que 60 bulletins de sécurité CVE Linux par semaine…

          ✍ Steven Vaughan-Nichols, le jeudi 22 août 2024.

          Dans les milieux de la sécurité informatique, les bulletins de sécurité CVE (Common Vulnerabilities and Exposures) peuvent être carrément effrayants. Avec Linux, cependant, c’est une affaire courante. Explications.

          [Ars Technica] “Something has gone seriously wrong,” dual-boot systems warn after Microsoft update

          ✍ Dan Goodin, le mercredi 21 août 2024.

          Microsoft said its update wouldn’t install on Linux devices. It did anyway.

          [Next] Sur Wikipédia, 20 % des biographies concernent désormais des femmes

          ✍ Mathilde Saliou, le mercredi 21 août 2024.

          Le Wikipédia francophone passe la barre des 20% de biographies consacrées à des femmes, notamment grâce au travail d’associations.

          [ouest-france.fr] À Saint-Quay-Portrieux, un troisième atelier pour prolonger la vie des ordinateurs vieillissants

          Le mercredi 14 août 2024.

          La commune de Saint-Quay-Portrieux (Côtes-d’Armor) organise la troisième édition de l’Install Party, samedi 17 août 2024. Le but de cet atelier: revitaliser ou optimiser des ordinateurs aux systèmes d’exploitation vieillissants.

          [Le Café du Geek] Mais au fait, que signifie IA Open Source?

          ✍ Christiane, le lundi 12 août 2024.

          Vous avez probablement entendu parler de certaines technologies d’IA en Open Source. Mais qu’est-ce que c’est?

          Et aussi:

          Commentaires : voir le flux Atom ouvrir dans le navigateur

          ❌
          ❌