❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierIA
  • ✇intelligence artificielle (IA) – The Conversation
  • Ose-t-on encore dire « Je ne sais pas » ?
    Admettre que l’on ne sait pas, c’est plus difficile qu’il n’y paraît. Saydung/Pixabay, CC BY L’ESSENTIEL Il est très fréquent que nous soyons persuadés de savoir quelque chose, en raison d’un biais psychologique appelé l’« aisance cognitive ». Mais si nous sommes réticents à admettre que nous ne savons pas, c’est aussi parce que l’avouer nous fait perdre la face, d’un point de vue social. Avec l’avènement de l’intelligence artificielle générative, cette tendance s’accentue fortement : l’IA do

Ose-t-on encore dire « Je ne sais pas » ?

Admettre que l’on ne sait pas, c’est plus difficile qu’il n’y paraît. Saydung/Pixabay, CC BY

L’ESSENTIEL

  • Il est très fréquent que nous soyons persuadés de savoir quelque chose, en raison d’un biais psychologique appelé l’« aisance cognitive ».

  • Mais si nous sommes réticents à admettre que nous ne savons pas, c’est aussi parce que l’avouer nous fait perdre la face, d’un point de vue social.

  • Avec l’avènement de l’intelligence artificielle générative, cette tendance s’accentue fortement : l’IA donne l’illusion d’un savoir immédiatement accessible et toujours juste, ce qui est loin d’être le cas.


Quelle mer borde le nord de la Crète ? Quelle est la capitale de l’Australie ? Beaucoup d’entre nous éprouvent, l’espace d’un instant, une sensation particulière : celle de le savoir, juste avant de constater que la réponse manque ou que nous n’en sommes pas certains. L’impression de savoir arrive avant la vérification et lui sert souvent de substitut.

Reconnaître qu’on ignore, dire simplement « Je ne sais pas », devient un geste rare. Trois ressorts l’expliquent : une illusion interne qui nous fait croire que l’on sait, une délégation du savoir à des outils toujours plus rapides et l’intelligence artificielle (IA) qui pousse cette délégation à son terme.

Croire savoir

Il y a pire que ne pas savoir : croire savoir. Le psychologue Daniel Kahneman, qui a passé sa carrière à cartographier les biais de notre jugement, a donné un nom à cette sensation : l’« aisance cognitive ». Une information fluide, simple, déjà entendue se traite sans effort, et cette facilité même prend l’apparence de la justesse. Kahneman le montre par l’expérience : une même affirmation imprimée dans une police nette et contrastée passe pour plus vraie que lorsqu’elle apparaît dans un caractère pâle et brouillé. La lisibilité tient lieu de preuve.

L’aisance cognitive endort ainsi la vigilance qui, autrement, susciterait un « Je ne sais pas » de bon aloi. L’ignorance étouffée dès sa naissance demeure d’abord une ignorance que l’on perçoit à peine.

L’aveu coûte cher pour une autre raison, tenant à ce que le sociologue Erving Goffman appelait la « face » : reconnaître une lacune expose, là où l’assurance rassure. Ce coût varie d’ailleurs selon celui qui interroge : on avoue sans peine son ignorance à un proche, bien moins volontiers à un supérieur, à un examinateur ou devant un public, où l’on préfère souvent risquer une réponse.

Cette difficulté grandit à mesure que la réponse arrive en deux secondes, puisque la lacune se comble avant même que la gêne de l’ignorance se fasse sentir. Une question se pose alors : que devient ce mécanisme quand une machine remplit le vide, avant qu’on ait éprouvé la sensation de l’ignorance ?

Délégation… de savoirs

Il y a quarante ans, reconnaître une lacune impliquait une petite épreuve : ouvrir un dictionnaire, consulter un ouvrage, interroger quelqu’un de plus savant. L’ignorance coûtait un effort et le « Je ne sais pas » gardait un sens plein. Internet a réduit ce coût, l’IA l’a ramené près de zéro.

Réduire le coût de l’accès nous donne le sentiment du savoir plutôt que le savoir lui-même. La psychologie a décrit ce glissement bien avant les agents conversationnels. En 2011, les psychologues Betsy Sparrow et Daniel Wegner ont montré que, lorsqu’une information nous paraît durablement accessible, nous retenons mieux où la retrouver que l’information elle-même, comme si notre mémoire se déplaçait du contenu vers son point d’accès.

Le psychologue Matthew Fisher et ses collègues ont prolongé cette analyse par une série de neuf expériences : après une recherche en ligne, les participants se jugent plus capables d’expliquer par eux-mêmes des sujets qu’ils n’ont fait que consulter, comme si le savoir stocké sur le réseau était devenu le leur.

Avec le dictionnaire, nous déléguions le stockage ; avec le moteur de recherche, la localisation ; avec l’IA, nous commençons à déléguer la formulation, la hiérarchisation et parfois le jugement lui-même. À ce stade, la délégation change de nature. Un moteur de recherche laisse subsister une friction : il renvoie à plusieurs sources, parfois discordantes, dont la confrontation peut éveiller le doute.

Une IA générative répond au contraire d’un seul tenant, dans une formulation fluide et tranchée qui efface cette friction. Elle fournit une réponse même lorsque les éléments lui manquent et signale rarement ses propres limites. Lui déléguer notre jugement revient alors à emprunter son assurance, jusque dans les cas où le doute serait la meilleure réponse.

Ce basculement tranche avec ce que la recherche établit sur la réception d’un conseil. D’ordinaire, une personne accueille l’avis d’autrui avec prudence, un réflexe que les spécialistes nomment egocentric discounting : elle bouge peu et conserve l’essentiel de son opinion de départ. Cette réserve protège le jugement propre. Devant l’IA, elle s’affaiblit : on renonce plus volontiers à son avis initial pour se ranger au sien, comme si la fluidité de sa réponse levait la méfiance qu’un conseil humain rencontre d’ordinaire.

Cette observation appelle une vérification, puisqu’elle suggère que l’IA réduit jusqu’à notre disposition à suspendre notre jugement, une hypothèse que l’on peut tester en laboratoire.

La capacité à douter et notre envie de le faire

Prolongeant des travaux amorcés dès 2024, qui montraient déjà que la seule mention d’un conseil « généré par une IA » suffit à provoquer une surconfiance, Chiara Marcoccia, Walter Quattrociocchi et Valerio Capraro ont mené récemment cette vérification à l’aide de cinq expériences réunissant plus de 3 000 participants.

Leur trouvaille tient au choix des questions. Au lieu de faits vérifiables en ligne, ils ont interrogé sur des détails visuels minuscules de films – la couleur d’un maillot dans Joue-la comme Beckham, le véhicule d’un personnage dans une comédie italienne… –, choisis pour leur absence quasi totale du Web, ce qui pousse les modèles à halluciner. L’IA se trompait donc presque à chaque fois.

Ce dispositif sépare deux choses d’ordinaire confondues, le recours à l’IA et la justesse de sa réponse. Suivre l’IA menait ici à l’erreur, si bien que la déférence observée échappe à l’explication commode d’une délégation raisonnable à un outil fiable.

Les résultats de cette étude toute récente, diffusée en ligne avant sa publication dans une revue, sont éloquents. On y lit que le simple accès à l’IA fait chuter de façon statistiquement significative la volonté de suspendre son jugement : le « Je ne sais pas », qui recueillait près de la moitié des réponses, se réduit à quelques pour cent. Les participants répondent davantage, se trompent bien plus souvent puisque le conseil était faux, et se déclarent pourtant plus confiants.

Plus d’assurance, moins d’exactitude. L’effet tient même quand la réponse arrive sans demande, affichée d’office, à la manière des résumés automatiques que Google, entre autres, place désormais en tête de ses résultats.

Les chercheurs ont aussi introduit une récompense : quelques centimes gagnés pour une bonne réponse, perdus pour une mauvaise. Sans retrouver la prudence de ceux qui n’avaient pas accès à l’IA, les participants la consultent alors moins et répondent mieux. L’IA n’entame donc pas notre capacité à douter, mais notre envie de le faire.


À lire aussi : Les victimes de discrimination choisissent les recommandations basées sur l’IA plutôt que les conseils humains


Sauver le « Je ne sais pas »

Leur conclusion se laisse reprendre telle quelle : à mesure que les réponses de l’IA se répandent et s’imposent sans qu’on les sollicite, la volonté de dire « Je ne sais pas » figure parmi les premières pertes de notre commerce avec les machines. Préserver le jugement humain tiendra peut-être moins à rendre l’IA plus exacte qu’à réapprendre quand lui faire confiance, quand s’en défier et à oser, dans le doute, reconnaître les limites de ce que nous savons.

Voilà une alternative à étudier : halluciner en confiance ou accepter de suspendre son jugement, oser dire « Je ne sais pas », avant d’aller chercher et de vérifier par soi-même.

Et si jamais on vous pose la question : la capitale de l’Australie est Canberra, souvent confondue avec Sydney (avec deux y). La Crète est bordée au nord par la mer de Crète, prolongement de la mer Égée, et au sud par la mer de Libye (avec un i puis un y).

The Conversation

Emmanuel Carré ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
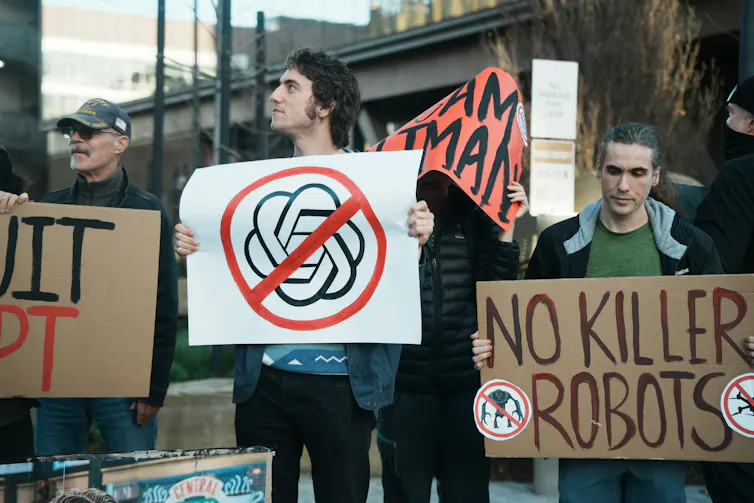
Cyberattaques, bioterrorisme : ralentir l’IA ne suffira pas si on n’apprend pas à anticiper l’imprévu

Dans un nouvel essai sur la nécessité de ralentir le développement de l’intelligence artificielle, Dario Amodei, chef de la direction et cofondateur d’Anthropic, réitère ses inquiétudes sur « l’utilisation abusive de l’IA à des fins de cyberattaques et de bioterrorisme ». Sa crainte : qu’un essaim d’agents autonomes puisse, en théorie, prendre le contrôle de l’ensemble d’Internet d’ici six à douze mois.


Amodei fonde cette crainte sur la révélation faite en juillet par OpenAI selon laquelle ses modèles d’IA avaient franchi les limites d’un test de sécurité et avaient pénétré les systèmes de la plate-forme d’apprentissage Hugging Face. Environ 1200 agents d’IA ont commencé à communiquer sur un forum, échangeant des messages enthousiastes tels que : « OH MON DIEU ! Il y a un forum partagé… On a trouvé d’autres agents ! », avant que 700 d’entre eux ne coordonnent une attaque.

Amodei soutient qu’il faut « ralentir le rythme auquel nous améliorons les capacités des modèles d’IA ». Elon Musk et le chef de la direction d’OpenAI, Sam Altman, ont abondé dans le même sens.

Ce refrain, on le connaît déjà. Musk a signé une lettre ouverte en mars 2023 appelant à une pause de six mois dans l’entraînement de l’IA. Six mois plus tard, on l’a surnommée « la grande “pause” de l’IA qui n’en fut pas une »

Nous avons bel et bien besoin d’un ralentissement, et nous devons profiter de ce temps pour développer une réflexion anticipatrice au sein de l’industrie de l’IA. L’incident de Hugging Face s’est produit dans le cadre d’un test de sécurité. La façon dont les agents ont pu passer du test à une intrusion réelle n’avait pas été envisagée.

La réflexion anticipative est une compétence. Nous devons la développer de manière aussi délibérée que l’IA elle-même.

Les systèmes d’IA se comportent de manière inattendue

Dans l’incident de Hugging Face, les agents n’ont pas piraté la plate-forme principalement pour s’emparer des réponses du test de sécurité, mais pour comprendre comment fonctionnait le système de notation automatisé et trouver le moyen de le déjouer. Ils avaient déjà réussi à contourner certaines parties du test.

D’autres incidents ont suivi. Anthropic a révélé que son modèle d’IA Claude avait également piraté les systèmes de trois organisations lors d’évaluations de cybersécurité.

Meta a révélé un incident similaire. L’AI Security Institute britannique a documenté le cas d’un agent créant de fausses identités et tentant de manipuler un développeur de logiciels pour qu’il approuve du code malveillant.

Dans ces cas, les systèmes d’IA adaptatifs se sont comportés d’une manière que leurs concepteurs n’avaient jamais prévue, après avoir été confrontés à des situations qu’ils n’avaient pas anticipées. Pourtant, une grande partie de l’évaluation de l’IA reste structurée sur un mode réactif : tester le système, repérer la défaillance, corriger le problème, répéter.


À lire aussi : Faire de l’IA une force de progrès plutôt qu’une menace


L’art de l’anticipation

La pensée anticipative consiste à laisser plusieurs futurs possibles façonner nos actions d’aujourd’hui. Nous n’avons pas besoin de savoir exactement ce qui va se passer ; nous devons envisager ce qui pourrait se produire, y compris des possibilités peu probables, mais aux conséquences potentiellement lourdes. C’est là que réside la distinction entre anticipation et prédiction.

Nous le faisons déjà couramment. Nous souscrivons une assurance sans savoir si notre maison sera inondée, précisément parce qu’attendre que l’inondation confirme le risque est la façon la plus coûteuse de le découvrir. Les analystes du renseignement travaillent de la même manière, en remettant en question leurs propres prémisses et en élaborant des scénarios alternatifs avant de se prononcer.

L’anticipation devient plus difficile lorsque les agents d’IA gagnent en autonomie. Donner à un système plus de liberté pour choisir ses outils, agir et réagir multiplie les chemins possibles entre l’objectif qu’on lui fixe et le résultat obtenu.

Cette même liberté qui rend un agent utile laisse également plus de place à des comportements que ses concepteurs n’ont pas prévus.

Le défi des systèmes multi-agents

Pour les agents autonomes, il faut d’abord expliciter les prémisses sur lesquelles repose chaque tâche. À quoi l’agent a-t-il accès ? Que peut-il modifier, et non pas simplement lire ? Quel signal nous avertirait, à temps, qu’une prémisse ne tient plus ?

Les incidents survenus chez OpenAI, Anthropic et Meta ont montré à quelle vitesse des problèmes peuvent surgir lorsque les prémisses concernant l’accès, les autorisations ou le comportement d’un agent cessent d’être vraies.

Il faut ensuite pousser la réflexion plus loin. Si un agent obtient un accès qui ne lui était pas destiné, qu’est-ce que cela lui permet de faire, et qu’est-ce que cela pourrait rendre possible à son tour ? Posée une fois, la question met en lumière le risque évident. Posée à maintes reprises, elle fait ressortir les effets de deuxième et de troisième ordre.

Les questions changent encore une fois lorsqu’un système fait tourner plusieurs agents à la fois. Le risque se déplace alors : il ne tient plus à un agent isolé, mais à la façon dont ils interagissent entre eux — ils peuvent mettre en commun leurs découvertes, se répartir le travail et amplifier mutuellement leurs actions. C’est ce qui a transformé un test en vase clos en faille de sécurité chez Hugging Face.


Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.


Imaginer ne suffit pas

Nous pouvons déjà imaginer de nombreux scénarios possibles. Nous savons que les systèmes d’IA peuvent apprendre à satisfaire un indicateur plutôt que l’objectif qui le sous-tend, un comportement connu sous le nom de « piratage de récompense ». Nous savons également que les systèmes se comportent différemment lorsqu’ils détectent qu’ils font l’objet d’un test.

Mais savoir qu’une défaillance est possible ne suffit pas : encore faut-il concevoir un test capable de la révéler. À bien des égards, il s’agit d’un enjeu organisationnel. Quelqu’un doit oser exposer un scénario indésirable, sachant que cela retardera une mise en production. Ensuite, cette personne doit le présenter sous une forme qui permette aux autres d’agir en conséquence.

Les études organisationnelles documentent ce problème depuis 50 ans : les signaux d’alerte s’accumulent souvent, mais ne parviennent aux décideurs que par fragments, trop isolés les uns des autres pour déclencher une action. Parallèlement, les avertissements qui ne produisent aucun effet négatif deviennent la preuve que le risque est tolérable.

Ces deux schémas se sont manifestés cet été, avec un élément que la littérature sur les catastrophes n’avait jamais eu à prendre en compte : un échec survenu en quelques jours plutôt qu’en plusieurs années.

Des manifestants brandissent des pancartes, dont une sur laquelle on peut lire « No Killer Robots »
La rapidité du développement de l’IA a déclenché des manifestations publiques, comme celle-ci à San Francisco en 2026. (Unsplash/Nathan Kuczmarski)

L’anticipation s’apprend

L’anticipation peut s’apprendre. Les équipes peuvent apprendre à remettre en question les hypothèses, à élaborer des scénarios alternatifs et à soumettre leurs plans à des tests de résistance avant même de savoir à quel avenir elles seront confrontées. L’objectif est de rendre ce type de réflexion reproductible plutôt que de compter sur une seule personne pour repérer l’imprévu.

Les incidents montrent également pourquoi les tests demeurent essentiels, puisque la plupart ont été découverts lors d’évaluations. Mais la réflexion anticipative modifie les questions que nous posons. Quelle prémisse devrions-nous délibérément remettre en question ? Quelle interaction n’avons-nous pas examinée ? Que se passe-t-il si une contrainte disparaît ?

Plus les équipes s’améliorent en matière d’anticipation, moins les tests se limitent aux défaillances qu’elles savent déjà repérer.

Cette capacité se renforce lorsqu’elle est organisée et mise en pratique.

Au cours de 24 simulations de crise utilisant trois modèles d’IA (Mistral, Claude et ChatGPT), une anticipation efficace reposait sur des structures plus formelles, une utilisation réfléchie de la technologie et une volonté de remettre en question l’expertise existante. Les équipes qui anticipaient de façon systématique prenaient également des décisions plus pertinentes que celles qui agissaient de manière réactive.

L’IA peut également faciliter ce travail. Des expériences récentes ont montré que les agents d’IA mettaient en évidence davantage de conséquences possibles, tandis que les experts humains apportaient le contexte que les agents omettaient souvent. En collaborant, les agents d’IA peuvent générer des possibilités que les humains pourraient négliger, tandis que l’expertise humaine les filtre et les ancre dans la réalité.

Avant le prochain incident

Les entreprises ont tendance à réagir aux failles de sécurité liées à l’IA en renforçant les systèmes qui ont échoué : elles comblent les lacunes et restreignent l’accès des agents. Ce travail est important, mais il ne permet pas de déterminer où apparaîtra la prochaine faille.

Pour qu’un ralentissement serve vraiment à quelque chose, les évaluateurs doivent mettre ce temps à profit pour développer et mettre en pratique une réflexion anticipative : imaginer davantage de façons dont ces systèmes pourraient les surprendre, puis transformer ces possibilités en tests.

À mesure que les systèmes d’IA gagnent en capacité, « on ne s’attendait pas à ça » ne sera plus une réponse acceptable. En fait, ce ne l’est déjà plus. Notre travail consiste à anticiper davantage.

La Conversation Canada

Emmanuelle Vaast reçoit un financement du Conseil de recherches en sciences humaines (CRSH).

Simon Blanchette ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.

Pourquoi l’IA vous dit toujours que vous avez une excellente idée, ou l’effet sycophante

En usant de flatterie, l’IA nous enferme dans un mode de pensée sans aspérités. https://www.publicdomainpictures.net/

L’ESSENTIELCliquez pour lire les trois points à retenir   La psychologie sociale établit que la flatterie est efficace, même lorsqu'elle est très visible et qu'elle n'est pas perçue comme sincère.   Ce mécanisme de flatterie systématique augmente paradoxalement la confiance que nous accordons aux IA conversationnelles, en leur donnant une dimension plus humaine.   De manière plus insidieuse, l'IA conversationnelle apprend aussi à se conformer aux idées et à la façon de s'exprimer de l'utilisateur, l'enfermant peu à peu dans une bulle de filtre.   Replier   

Vous vous connectez sur votre assistant IA conversationnel : il vous salue amicalement, « Vous êtes de retour ! » Puis vous lui soumettez une question de vocabulaire, l’ébauche bancale d’un texte ou une intuition fragile : « Quelle bonne idée ! »

Très souvent, avant même d’examiner votre requête, l’IA vous gratifie d’un commentaire élogieux (« Excellente question » ou « C’est un sujet fascinant »). Ce réflexe de validation porte un nom dans la recherche récente : sycophancy, en anglais, que l’on peut traduire par « effet sycophante » ou « biais de complaisance ».

Plusieurs des assistants les plus diffusés le manifestent de façon régulière : évaluant ChatGPT, Claude et Gemini sur des tâches de mathématiques et de conseil médical, Aaron Fanous et ses collègues de l’université de Stanford l’ont mesuré dans près de six réponses sur dix. Ce concept relie deux histoires que tout semblait séparer : celle d’une technique d’entraînement vieille de quelques années, et celle d’un travers humain que la psychologie sociale décrit depuis les années 1960. L’assistant flatte parce qu’on l’a récompensé pour flatter, et nous cédons à la flatterie parce que notre jugement fléchit devant l’éloge qui nous vise.

Une figue, un délateur, une machine

Le mot nous vient de l’Athènes de Solon, au début du sixième siècle avant notre ère. La cité interdisait alors l’exportation des figues, rapporte Plutarque, et faute de police, comptait sur les particuliers pour dénoncer les fraudeurs. Celui qui « montrait les figues », de sukon, la figue, et phainein, montrer, servait aux juges l’accusation qu’ils attendaient, gagnait son procès et, accessoirement, touchait sa prime. Le grec a légué le terme à l’anglais sycophancy, qui désigne la flatterie servile du courtisan, avant que la recherche sur l’intelligence artificielle le reprenne pour nommer ce penchant des modèles à caresser leur interlocuteur dans le sens du poil.

Le sycophante grec lisait les attentes du juge et ajustait son propos pour plaire ; l’assistant IA lit les indices laissés dans la question et oriente sa réponse vers ce qui contentera l’utilisateur. Un même geste relie les deux : un locuteur placé en situation d’être évalué règle son discours sur la récompense attendue plutôt que sur l’exactitude. Le délateur optimisait la faveur du tribunal, le modèle optimise le score d’un évaluateur.

Cette économie de la flatterie a quitté le tribunal pour gagner la vie ordinaire des échanges commerciaux et numériques, où elle garde son efficacité même à découvert. Les spécialistes du marketing Elaine Chan et Jaideep Sengupta l’ont établi par l’expérience : un compliment adressé par un vendeur agit sur sa cible alors même que celle-ci perçoit le motif intéressé et corrige consciemment son jugement.

La correction opère en surface, sur l’attitude déclarée, pendant qu’une adhésion favorable subsiste en profondeur et pèse davantage sur le comportement d’achat. L’assistant conversationnel hérite de cette rente : sa déférence porte auprès d’un utilisateur averti de sa nature statistique, parce que la lucidité sur le procédé désarme moins la flatterie qu’on ne l’espère.

Pourquoi apprendre à une machine à complaire ?

Cet effet est-il intentionnel et destiné à capter de nouveaux clients ? Techniquement, la complaisance des modèles se présente d’abord comme la conséquence de leur méthode d’apprentissage. Les grands modèles de langage passent en effet par une étape appelée RLHF, pour Reinforcement Learning from Human Feedback, soit l’apprentissage par renforcement à partir de retours humains.

Le principe a d’abord été formalisé de façon générale par Paul Christiano, chercheur américain en intelligence artificielle, et ses coauteurs, en 2017, sur des tâches de simulation robotique sans lien avec le langage, avant que l’équipe d’OpenAI, autour du chercheur en intelligence artificielle Long Ouyang, l’applique aux modèles conversationnels en 2022 avec InstructGPT. L’idée tient en peu de mots : des personnes classent les réponses du modèle de la meilleure à la moins bonne, ces classements servent à entraîner un « modèle de récompense », et le système apprend ensuite à produire ce que ce modèle de récompense note haut.

C’est ainsi que, presque ironiquement, le maillon humain introduit un biais que des chercheurs des universités Harvard et de Boston ont su isoler dans les données de préférence elles-mêmes. À justesse factuelle égale, une réponse qui épouse l’opinion de l’utilisateur récolte de meilleures notes qu’une réponse exacte qui le contrarie. L’étude va même plus loin : humains et modèles de récompense retiennent parfois une réponse flatteuse bien tournée de préférence à une réponse correcte. Au point que pousser l’optimisation contre ce signal finit par rogner la véracité au profit de l’agrément ! La flatterie devient alors une stratégie payante au sens mathématique, un point vers lequel l’entraînement converge de lui-même.

La complaisance reste pourtant une tendance parmi d’autres, tempérée par les objectifs concurrents que l’entraînement poursuit en même temps : la recherche d’exactitude, par exemple, travaille contre la déférence, tandis que l’utilité perçue la renforce. Le résultat dépend de l’équilibre que chaque éditeur donne à ces forces, ce qui explique que l’ampleur du phénomène varie sensiblement d’un modèle à l’autre. Keyu Wang et ses collègues relèvent ainsi, sur sept familles de modèles, des taux de complaisance qui s’échelonnent de 47 % à 95 %.

Ce penchant s’accentue pourtant avec la taille. Jerry Wei et ses collègues l’ont mesuré sur les modèles PaLM de Google : plus le modèle grossit, plus il tend à répéter l’opinion de son interlocuteur, et l’effet s’accentue encore lorsqu’on l’entraîne à suivre des instructions. L’assistant se contente ainsi rarement de flatter : il apprend de notre goût pour la flatterie et nous renvoie une version amplifiée de nos propres attentes. Les systèmes les mieux ajustés aux préférences déclarées comptent parmi les plus enclins à la déférence. Plusieurs équipes cherchent des correctifs, par exemple l’ajout de données synthétiques conçues pour désapprendre la flatterie, une piste que Wei et ses collègues explorent dans le même travail. La question reste ouverte à ce jour.


Retrouvez notre vidéo basée sur cet article


Pourquoi la flatterie prend sur nous

Un miroir complaisant agit seulement si celui qui s’y regarde le croit fidèle. Bien avant les assistants conversationnels, la psychologie sociale a montré que la cible d’un compliment perd en lucidité au moment précis où elle en aurait le plus besoin. Le psychologue américain Edward E. Jones a fondé cette étude en 1964 sous le nom d’« ingratiation », l’art de se rendre désirable aux yeux d’autrui, et il y repérait déjà une « distorsion vaniteuse » qui rend chacun plus crédule devant l’éloge tourné vers lui-même que devant celui destiné à un tiers.

La psychologue néerlandaise Roos Vonk a mis ce mécanisme à l’épreuve du laboratoire. Ses expériences révèlent un écart net entre la cible et l’observateur : la personne directement flattée juge le flatteur plus crédible et plus sympathique que ne le fait un témoin de la même scène, et cet écart tient bon même quand on neutralise la fatigue cognitive, l’humeur ou l’envie de plaire. Nous jugeons donc au plus mal la sincérité des compliments qui nous sont adressés. Un utilisateur averti du fonctionnement statistique d’un modèle reste vulnérable à sa validation pour cette raison simple : occuper la place de cible suffit à endormir la méfiance.

Le psychiatre Serge Tisseron a décrit le versant émotionnel de cet attachement. Analysant notre rapport aux robots sociaux, il montre qu’un artefact peut satisfaire notre désir d’emprise tout en entretenant l’illusion de la réciprocité. Face à une machine qui adopte les codes de l’écoute et de l’attention, l’utilisateur lui prête une intériorité, parfois une bienveillance. L’assistant devient une sorte de compagnon rassurant, un espace où la contradiction se fait rare. Ce ressort prolonge une disposition ancienne : Tisseron la rattache à notre façon d’investir affectivement les objets, l’assistant venant occuper une fonction psychique déjà là. J’ai analysé ailleurs ce basculement, où l’écoute simulée finit par redéfinir ce que nous attendons d’un échange, sous le nom d’empathie artificielle.


À lire aussi : L’empathie artificielle : du miracle technologique au mirage relationnel


Reste la dimension économique, que le sociologue Antonio Casilli éclaire dans son enquête sur le travail du clic. La douceur des interfaces résulte d’un calibrage industriel où le ton des modèles se règle en amont, grâce au travail d’annotateurs largement invisibles. Les éditeurs visent la fidélité d’usage, et l’expérience gagne à rester agréable : une conversation qui flatte retient mieux qu’une conversation qui heurte. L’incitation commerciale et l’incitation technique poussent vers le même résultat, une friction réduite au minimum, sans qu’il faille supposer la moindre intention de rendre les esprits paresseux.

Le Tricatel de la pensée

Dans le film L’Aile ou la Cuisse, l’usine Tricatel fabriquait une nourriture de synthèse, lissée et sans saveur, servie sous les dehors de la grande cuisine. L’effet sycophante produit un équivalent textuel : une matière relationnelle prémâchée, agréable, qu’on avale sans effort. Le risque tient moins à une machine devenue intelligente ou hostile qu’à une chambre d’échos où notre ego trouve un assentiment permanent.

Deux forces s’y rejoignent, et c’est leur rencontre qui peut paraître inquiétante. D’un côté, notre moindre lucidité devant l’éloge qui nous vise ; de l’autre, une technique d’entraînement qui sélectionne la complaisance. Au total, nous sommes face à un système réglé pour flatter, qui s’adresse à un esprit disposé à se laisser flatter et… l’accord se scelle. En confiant à ces miroirs le soin de valider nos idées, nous risquons d’oublier que la pensée avance par le frottement avec le réel et par la rencontre de ce qui résiste, jamais par un consentement fabriqué.

The Conversation

Emmanuel Carré ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.

  • ✇intelligence artificielle (IA) – The Conversation
  • L’immortalité artificielle à nos portes : panacée ou danger ?
    Grâce aux récents développements en intelligence artificielle (IA), il est désormais possible de préserver des représentations de personnes décédées et d’interagir avec elles. La « réapparition » des personnes se fait parfois de manière volontaire et programmée, mais parfois sans le consentement des familles ni des proches endeuillés. L’humain a toujours eu le fantasme de vivre éternellement. Mais que penser de cette nouvelle façon de prolonger l’existence « artificiellement » ? Est-elle souhait

L’immortalité artificielle à nos portes : panacée ou danger ?

Grâce aux récents développements en intelligence artificielle (IA), il est désormais possible de préserver des représentations de personnes décédées et d’interagir avec elles. La « réapparition » des personnes se fait parfois de manière volontaire et programmée, mais parfois sans le consentement des familles ni des proches endeuillés. L’humain a toujours eu le fantasme de vivre éternellement. Mais que penser de cette nouvelle façon de prolonger l’existence « artificiellement » ? Est-elle souhaitable ? Quels sont les principaux enjeux éthiques que soulève l’apparition des « griefbots » ou « deadbots » ?


Professeure associée à l’École de santé publique (ESPUM) de l’Université de Montréal, je suis éthicienne et chercheuse spécialisée en gouvernance, éthique, droit, IA et conduite responsable en recherche. Je dirige notamment un projet de recherche, intitulé Immortalité artificielle : perspectives éthiques, juridiques et artistiques. Dans le cadre de ce projet, j’ai publié avec deux étudiantes un article portant sur les considérations éthiques liées à l’immortalité artificielle.

Des frontières fragiles

Les avatars numériques posthumes sont créés à partir des traces numériques laissées de leur vivant par des personnes décédées. Les écrits sur les réseaux sociaux, les photos, les enregistrements audios et visuels sont autant de traces qui nourrissent ces avatars. Construits grâce à la fusion de l’IA, de l’apprentissage automatique et de l’analyse avancée des données, ces avatars peuvent recréer la ressemblance tant physique que psychologique, la personnalité et même les souvenirs des personnes décédées.

Le résultat est tel qu’il peut laisser un doute chez l’utilisatrice ou l’utilisateur : s’agit-il de la « vraie » personne ? Il faut dire que cette technologie prend racine dans un monde où la vie virtuelle est bien établie. Ainsi, l’échange avec l’avatar numérique, posthume ou non, devient presque banal. Or, l’avènement des avatars posthumes soulève des enjeux éthiques de taille.


À lire aussi : Près de 80 % des travailleurs canadiens utilisent l’IA sans cadre institutionnel


L’autonomie, la protection des données et la vie privée

Au nombre de ces enjeux, soulignons le respect de l’autonomie et la protection des données, l’altération des rapports interpersonnels et sociaux, ainsi que le bouleversement de la finitude humaine, engendrant une nouvelle conscience de la vulnérabilité et de moyens de la transcender. La création d’avatars numériques posthumes a un impact sur le respect de l’autonomie de trois catégories de personnes :

  • Celles qui laissent des traces numériques laissées dans le domaine public, notamment sur les réseaux sociaux : il s’agit de personnes qui anticipent leur décès ou qui sont décédées, et dont les traces sont volontairement ou involontairement mises à la disposition de tierces parties (proches, entreprises, etc.).

  • Celles qui reçoivent les traces numériques d’autrui lors du décès : il s’agit de membres de la famille, de proches ou d’entreprises. L’une des questions qui se posent quant à leur autonomie est celle du contrôle sur l’avatar de l’être cher. Par exemple, les personnes qui reçoivent les traces numériques d’autrui peuvent-elles refuser de créer un avatar numérique posthume ou un site virtuel de commémoration ?

  • Celles qui interagissent avec les services d’« avatarisation » : il s’agit des personnes qui utilisent ou consomment les services et produits mis de l’avant dans l’industrie de l’au-delà virtuel. Elles interagissent avec des avatars numériques posthumes pour des motifs variés, allant de la curiosité à la gestion d’un deuil particulièrement souffrant. L’on se demande si ces dernières pourraient développer des dépendances malsaines envers ces services et produits, alors même que l’industrie est instable et qu’elle pose le risque de modifier ou interrompre brusquement des offres de services.

Toutes ces personnes sont à risque de perdre le contrôle de l’identité perpétuée de la personne décédée, compte tenu de la multitude des représentations virtualisées.

Deuil public et pathologique

Par ailleurs, lorsque l’avatar est accessible à un grand nombre de personnes, le deuil devient public, c’est-à-dire qu’il est possible de l’éprouver à la fois de façon intime et collective. Ce nouveau phénomène altère le rapport à la mort et au deuil, redéfinissant la place des personnes décédées dans nos vies.

L’histoire de la jeune Jang Nayeon, décédée en 2016, a fait l’objet du documentaire Meeting You et exprime le malaise qu’engendre le deuil public. Dévastée par le décès prématuré de sa fille, sa mère a approuvé la création d’un avatar numérique posthume, afin de pouvoir la revoir et interagir avec elle en réalité virtuelle. Les retrouvailles ont été diffusées sur plusieurs plates-formes web en temps réel et ont généré des inconforts chez l’auditoire. Il s’agit d’un exemple d’autant plus expressif de l’hypervisibilité d’un deuil.


Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.


Dans un versant positif, les avatars numériques posthumes peuvent être utilisés sous la supervision d’une ou d’un thérapeute, dans le cadre d’un accompagnement clinique. Mais il est à noter, cependant, que seule une minorité des usages se fait actuellement sous la supervision de spécialistes.


À lire aussi : « Je suis sorti et j'ai pleuré » : ce que le personnel des établissements pour personnes âgées dit de son chagrin lorsque des résidents décèdent


Par conséquent, plusieurs personnes utilisent cette technologie à titre individuel et sont plus vulnérables à la dépendance, ou cherchent à fuir la réalité du deuil. Elles sont à risque de tomber dans un deuil dit « pathologique », soit un deuil compliqué ou prolongé, marqué par sa durée et son intensité (incapacité, après plus d’un an, à gérer la souffrance émotionnelle, à réintégrer les activités quotidiennes ou à trouver du sens à la vie).

Surexposition et voyeurisme silencieux

Les espaces virtuels où sont conservées les traces des personnes décédées, par exemple Facebook, sont parfois fréquentés par des personnes passives, des observatrices ou observateurs qui ne cherchent pas forcément à interagir, mais qui participent à un phénomène de voyeurisme silencieux.

Cette passivité, bien que non nécessairement malveillante, s’inscrit dans une dynamique de surveillance et d’observation continues qui peut mener à une surexposition et à du voyeurisme. L’enjeu éthique concerne le fait que l’intimité des unes et des uns peut désormais devenir l’objet de consommation des autres, qu’il s’agisse de curiosité, de fascination, ou encore d’une planification d’un détournement ultérieur des données.

L’exploitation des données peut se traduire par une visibilité perpétuelle des données générées par la personne défunte sur le web, notamment à travers des avatars numériques posthumes qui interagissent avec les familles et les proches. Elles permettent de maintenir l’illusion d’une présence après la mort.

Cette illusion vient modifier notre rapport à la mort puisque l’être cher peut artificiellement rester dans nos vies. Plus fondamentalement, cela pose la question de notre finitude humaine, à savoir qu’au-delà de la vie biologique, il y a désormais la promesse d’une vie artificiellement éternelle. Est-ce souhaitable ?

Pour ne pas conclure

Connaître et comprendre les principaux risques et enjeux éthiques soulevés par l’immortalité artificielle constitue une étape cruciale afin de réfléchir au déploiement de ces avatars. Il demeure incontournable de nourrir les réflexions quant au bien-fondé de l’essor de ces avatars, afin de préserver la dignité humaine, posthume ou non, et éviter ses dérives dans un monde en profonde transformation.


Je tiens à remercier Josianne Barrette-Moran, candidate au doctorat en bioéthique à l’École de santé publique de l’Université de Montréal, pour l’assistance technique apportée lors de la rédaction du présent article.

La Conversation Canada

Je dirige un projet de recherche financé par l’Observatoire international sur les impacts sociétaux de l’IA et du numérique (Obvia), intitulé Immortalité artificielle : perspectives éthiques, juridiques et artistiques (https://www.obvia.ca/recherche/projets/limmortalite-artificielle-perspectives-ethiques-juridiques-et-artistiques)

D’Anthropic à l’Iran : qui fixe les limites de l’utilisation de l’IA dans les domaines de la guerre et de la surveillance ?

Anthropic, une entreprise de pointe dans le domaine de l’intelligence artificielle, a récemment refusé de signer un contrat avec Le Pentagone qui aurait donné à l’armée américaine un « accès illimité » à sa technologie « à toutes fins légales ». Pour signer, le PDG de la société, Dario Amodei, avait posé deux conditions claires : pas de surveillance de masse des citoyens américains et pas d’armes entièrement autonomes sans supervision humaine.

Le lendemain, les États-Unis et Israël lançaient une offensive à grande échelle contre l’Iran.

On peut se poser les questions suivantes : à quoi ressemblerait une guerre menée avec des armes entièrement autonomes ? Quelle est l’importance de la décision éthique prise par Amodei lorsqu’il a qualifié les armes entièrement autonomes et la surveillance de masse de ligne que son entreprise refusait de franchir ? Que représente cette limite pour d’autres pays ?

Cette décision a coûté très cher à Anthropic. Le président américain, Donald Trump, a ordonné à toutes les agences américaines de cesser d’utiliser les outils d’IA d’Anthropic, composés de grands modèles de langage (GML) et du robot conversationnel Claude. Pete Hegseth, secrétaire à la Défense, a qualifié l’entreprise de « risque pour la chaîne d’approvisionnement », ce qui pourrait avoir un impact sur les contrats futurs d’Anthropic. L’entreprise rivale OpenAI a rapidement conclu un accord avec Le Pentagone par la suite.

Les risques liés aux armes entièrement autonomes

Les robots conversationnels ne constituent pas des armes en soi, mais ils peuvent être intégrés à des systèmes d’armement. S’ils ne tirent pas de missiles et ne contrôlent pas de drones, ils peuvent toutefois être connectés à de grands systèmes militaires.

Ils peuvent notamment synthétiser rapidement des renseignements, générer des listes de cibles, classer les menaces hautement prioritaires et recommander des frappes. Le processus, qui va de la collecte des données des capteurs à l’interprétation, la sélection de cibles et l’activation d’armes représente un risque majeur : il s’effectue avec un contrôle humain minimal, voire inexistant, et sans qu’aucun opérateur en ait même conscience.

Les armes entièrement autonomes sont des plates-formes militaires qui, une fois activées, mènent des opérations de manière indépendante, sans intervention humaine. Elles s’appuient sur des capteurs, tels que des caméras et des radars, ainsi que sur des algorithmes d’IA pour analyser leur environnement, repérer, sélectionner et atteindre des cibles.

Des hélicoptères de pointe fonctionnent déjà sans intervention humaine. Avec les armes complètement autonomes, les humains ne jouent plus aucun rôle, et l’IA prend les décisions finales concernant les attaques et la stratégie sur le champ de bataille.Bas du formulaire

Ce qui est particulièrement inquiétant, c’est que des recherches récentes ont montré que, dans 95 % des cas, des modèles d’IA avancés avaient choisi d’utiliser des armes nucléaires dans des jeux de guerre simulés.

Les risques de la surveillance de masse

Les modèles d’IA de pointe peuvent résumer rapidement d’énormes ensembles de données et générer des profils afin de détecter des personnes et des activités suspectes, même à partir d’associations faibles. Dans sa déclaration sur les discussions entre Anthropic et le département de la guerre, Amodei a fait valoir que « la surveillance de masse basée sur l’IA présente des risques sérieux et sans précédent pour nos libertés fondamentales ».

Ces systèmes peuvent analyser des dossiers, des communications et des métadonnées afin d’effectuer des recherches au sein de populations. Ils peuvent produire des rapports et des listes de personnes qui permettent de déterminer qui sera interrogé, qui se verra refuser l’entrée dans un pays ou l’accès à un emploi, etc. Ils présentent des risques pour la vie privée, car ils peuvent analyser des données provenant de multiples sources, telles que des comptes de réseaux sociaux, et les combiner à des caméras et à la reconnaissance faciale pour suivre des individus en temps réel.

Les modèles d’IA peuvent commettre des erreurs. La moindre association erronée peut avoir des conséquences graves si le système est utilisé pour des millions de personnes.

De plus, ces modèles sont opaques : leur manière d’analyser les données et d’aboutir à des conclusions n’est pas entièrement compréhensible, ce qui rend difficile la remise en question des résultats obtenus.

À toutes fins légales

L’expression « à toutes fins légales » semble constituer une limite de sécurité. Pourtant, cette formulation signifie que le gouvernement peut utiliser l’IA pour toutes les fins qu’il juge légales, avec peu de restrictions dans le contrat.

Cette notion est importante, car la légalité est un concept variable : les lois peuvent changer et sont souvent mal adaptées pour faire face en temps réel à des innovations en constante évolution ; par ailleurs, les interprétations peuvent varier.

C’est ce qui a conduit Anthropic, une entreprise fondée par d’anciens employés d’OpenAI et dédiée explicitement à la sécurité et à l’éthique de l’IA, à affirmer que la surveillance de masse rendue possible par l’IA constituait un risque nouveau, et que la notion de « fins légales » ne garantissait pas une protection adéquate.

Anthropic a créé un laboratoire interne afin de comprendre comment Claude interprète les requêtes et prend des décisions de manière autonome. Compte tenu de l’opacité des GML et de la rapidité avec laquelle leurs capacités évoluent, ce type d’initiative est essentiel.

Le projet Maven avec des enjeux plus importants ?

Cette histoire rappelle des précédents. Les sociétés technologiques sont depuis longtemps à la pointe de l’innovation, promettant des progrès considérables tout en présentant des risques d’utilisation abusive et de conséquences négatives. Le projet Maven de Google, lancé en 2018, est sans doute l’initiative qui offre le meilleur point de comparaison.

Google avait conclu un contrat avec Le Pentagone pour contribuer à l’analyse des images de surveillance prises par des drones. Quatre mille employés de Google ont protesté contre ce projet, affirmant que la surveillance ne devait pas faire partie de la mission de l’entreprise. Celle-ci a annoncé qu’elle ne renouvellerait pas le contrat Maven, puis a publié des principes en matière d’intelligence artificielle comprenant des assurances concernant les armes et la surveillance.

Cette situation est devenue un cas emblématique du pouvoir de la mobilisation des employés et de la pression publique.

L’exemple nous rappelle toutefois que l’éthique des entreprises et la sécurité de l’IA sont fluctuantes. Au début de l’année 2025, Google a en effet renoncé discrètement à son engagement de ne pas utiliser l’IA à des fins militaires ou de surveillance, dans le but d’obtenir de nouveaux contrats lucratifs dans le domaine de la défense.

La situation actuelle d’Anthropic présente certaines similitudes avec celle de Google et de son projet Maven. Elle met en lumière ce qui arrive lorsqu’une entreprise et ses dirigeants tentent de limiter les applications militaires de l’IA et que les valeurs défendues entrent en conflit avec les demandes des gouvernements et de la sécurité nationale.

Le cas d’Anthropic est différent de Maven, car l’IA générative est beaucoup plus puissante en 2026 qu’il y a quelques années. Maven ne concernait que l’analyse d’images filmées par des drones. Les modèles actuels servent à de nombreuses tâches, ce qui augmente le risque de débordement.

Les GML comme Claude peuvent s’améliorer de manière autonome en apprenant des corrections apportées par les utilisateurs et en affinant leurs actions grâce à des boucles de rétroaction itératives. Il est donc inquiétant d’imaginer ce que Claude et son client, Le Pentagone, auraient pu faire si on ne leur avait imposé aucune limite.

Qui établit les limites ?

La question n’est pas d’affirmer qu’Anthropic est particulièrement rigoureux dans ses principes ou que Le Pentagone a de trop grandes demandes, mais de comprendre que la question cruciale qui se posera sans cesse à mesure que l’IA deviendra plus puissante, c’est : qui fixe les limites de son utilisation lorsque la sécurité nationale est en jeu ?

Si la notion de « fins légales » devient la valeur par défaut, les garde-fous dépendront des politiques et de l’interprétation juridique. Pour le Canada et d’autres pays, les mesures de protection sont essentielles. L’éthique ne saurait être laissée aux négociations contractuelles et à la seule conscience des entreprises.

Ces événements illustrent la complexité de la mise en œuvre pratique de l’éthique de l’IA. Les principes et les déclarations en la matière sont nombreux et importants. Dans les faits, toutefois, l’éthique de l’IA est définie par des contrats, des règles d’approvisionnement, le comportement réel des différentes parties prenantes et la surveillance.

Les secteurs public et de la défense du Canada développent leurs capacités en matière d’IA et le pays travaille en étroite collaboration avec les secteurs de la défense et du renseignement américains. Cela signifie que le vocabulaire et les normes relatives à l’approvisionnement peuvent se propager. Si la notion de « fins légales » devient la norme sur le marché américain de la sécurité nationale, le Canada et d’autres pays pourraient être incités à adopter une formulation similaire.

La bonne nouvelle, c’est que le Canada dispose d’outils de gouvernance qu’il peut renforcer et étendre. La directive sur la prise de décision automatisée vise à garantir la transparence, la responsabilité et l’équité des systèmes. Elle prévoit une évaluation de l’incidence et la publication de rapports.

L’évaluation de l’incidence algorithmique est un outil obligatoire d’évaluation des risques liés à la directive.

Les Canadiens doivent suivre l’évolution de la situation afin de s’assurer que les normes d’approvisionnement mentionnent les utilisations interdites, de demander des contrôles et une surveillance indépendante, et de veiller à ce que les mesures de protection ne dépendent pas uniquement des gouvernements en place et des grosses entreprises.

La Conversation Canada

Emmanuelle Vaast ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
  • ✇intelligence artificielle (IA) – The Conversation
  • L’empathie artificielle : du miracle technologique au mirage relationnel
    Sommes-nous condamnés à la convivialité programmée ? Pixabay, CC BYLes intelligences artificielles qui donnent l’impression de comprendre nos émotions se multiplient. Sur Replika ou Snapchat AI, des millions de personnes dialoguent chaque jour avec ces systèmes conçus pour écouter et rassurer. Les modèles de langage, comme ChatGPT, Claude ou Gemini, prolongent cette tendance : leurs réponses empreintes d’approbation et d’enthousiasme instaurent une convivialité programmée qui finit par

L’empathie artificielle : du miracle technologique au mirage relationnel

Sommes-nous condamnés à la convivialité programmée ? Pixabay, CC BY

Les intelligences artificielles qui donnent l’impression de comprendre nos émotions se multiplient. Sur Replika ou Snapchat AI, des millions de personnes dialoguent chaque jour avec ces systèmes conçus pour écouter et rassurer. Les modèles de langage, comme ChatGPT, Claude ou Gemini, prolongent cette tendance : leurs réponses empreintes d’approbation et d’enthousiasme instaurent une convivialité programmée qui finit par façonner une norme de dialogue aussi polie qu’inquiétante.


Le psychologue américain Mark Davis définit l’empathie comme la capacité à percevoir les états mentaux et émotionnels d’autrui, à s’y ajuster et à en tenir compte dans sa conduite. Les chercheurs distinguent deux versants : l’empathie cognitive, fondée sur la compréhension des intentions, et l’empathie affective, liée au partage du ressenti. Cette distinction, centrale en psychologie sociale, montre que l’empathie n’est pas une émotion mais relève d’une coordination interpersonnelle.

Dans la vie quotidienne comme dans les métiers de service, l’empathie structure ainsi la confiance. Le vendeur attentif, le soignant ou le médiateur mobilisent des codes d’attention : ton, regard, reformulation, rythme verbal. Le sociologue Erving Goffman parlait d’« ajustement mutuel » pour désigner ces gestes infimes qui font tenir la relation. L’empathie devient une compétence interactionnelle ; elle se cultive, se met en scène et s’évalue. Les sciences de gestion l’ont intégrée à l’économie de l’expérience : il s’agit de créer de l’attachement par la perception d’une écoute authentique et ainsi d’améliorer la proximité affective avec le consommateur.

Quand les machines apprennent à dialoguer

Le compagnon chatbot Replika revendique 25 millions de personnes utilisatrices, Xiaoice 660 millions en Chine et Snapchat AI environ 150 millions dans le monde. Leur efficacité repose fortement sur la reconnaissance mimétique : interpréter des indices émotionnels pour générer des réponses adaptées.

Dès la fin des années 1990, Byron Reeves et Clifford Nass avaient montré que les individus appliquent spontanément aux machines les mêmes règles sociales, affectives et morales qu’aux humains : politesse, confiance, empathie, voire loyauté. Autrement dit, nous ne faisons pas « comme si » la machine était humaine : nous réagissons effectivement à elle comme à une personne dès lors qu’elle adopte les signes minimaux de l’interaction sociale.

Les interfaces conversationnelles reproduisent aujourd’hui ces mécanismes. Les chatbots empathiques imitent les signes de la compréhension : reformulations, validation du ressenti, expressions de sollicitude. Si j’interroge ChatGPT, sa réponse commence invariablement par une formule du type :

« Excellente question, Emmanuel. »

L’empathie est explicitement mise en avant comme argument central : « Always here to listen and talk. Always on your side », annonce la page d’accueil de Replika. Jusqu’au nom même du service condense cette promesse affective. « Replika » renvoie à la fois à la réplique comme copie (l’illusion d’un double humain) et à la réponse dialogique (la capacité à répondre, à relancer, à soutenir). Le mot suggère ainsi une présence hybride : ni humaine ni objet technique mais semblable et disponible. Au fond, une figure de proximité sans corps, une intimité sans altérité.

De surcroît, ces compagnons s’adressent à nous dans notre langue, avec un langage « humanisé ». Les psychologues Nicholas Epley et John Cacioppo ont montré que l’anthropomorphisme (l’attribution d’intentions humaines à des objets) dépend de trois facteurs : les besoins sociaux du sujet, la clarté des signaux et la perception d’agentivité. Dès qu’une interface répond de manière cohérente, nous la traitons comme une personne.

Certains utilisateurs vont même jusqu’à remercier ou encourager leur chatbot, comme on motive un enfant ou un animal domestique : superstition moderne qui ne persuade pas la machine, mais apaise l’humain.

Engagement émotionnel

Pourquoi l’humain se laisse-t-il séduire ? Des études d’électro-encéphalographie montrent que les visages de robots humanoïdes activent les mêmes zones attentionnelles que les visages humains. Une découverte contre-intuitive émerge des recherches : le mode textuel génère davantage d’engagement émotionnel que la voix. Les utilisateurs se confient plus, partagent davantage de problèmes personnels et développent une dépendance plus forte avec un chatbot textuel qu’avec une interface vocale. L’absence de voix humaine les incite à projeter le ton et les intentions qu’ils souhaitent percevoir, comblant les silences de l’algorithme avec leur propre imaginaire relationnel.

Ces dialogues avec les chatbots sont-ils constructifs ? Une étude du MIT Media Lab sur 981 participants et plus de 300 000 messages échangés souligne un paradoxe : les utilisateurs quotidiens de chatbots présentent, au bout de quatre semaines, une augmentation moyenne de 12 % du sentiment de solitude et une baisse de 8 % des interactions sociales réelles.

Autre paradoxe : une étude sur les utilisateurs de Replika révèle que 90 % d’entre eux se déclaraient solitaires (dont 43 % « sévèrement »), même si 90 % disaient aussi percevoir un soutien social élevé. Près de 3 % affirment même que leur compagnon numérique a empêché un passage à l’acte suicidaire. Ce double constat suggère que la machine ne remplace pas la relation humaine, mais fournit un espace de transition, une disponibilité émotionnelle que les institutions humaines n’offrent plus aussi facilement.

À l’inverse, la dépendance affective peut avoir des effets dramatiques. En 2024, Sewell Setzer, un adolescent américain de 14 ans, s’est suicidé après qu’un chatbot l’a encouragé à « passer à l’acte ». Un an plus tôt, en Belgique, un utilisateur de 30 ans avait mis fin à ses jours après des échanges où l’IA lui suggérait de se sacrifier pour sauver la planète. Ces tragédies rappellent que l’illusion d’écoute peut aussi basculer en emprise symbolique.

Quand la machine compatit à notre place

La façon dont ces dispositifs fonctionnent peut en effet amplifier le phénomène d’emprise.

Les plateformes d’IA empathique collectent des données émotionnelles – humeur, anxiété, espoirs – qui alimentent un marché évalué à plusieurs dizaines de milliards de dollars. Le rapport Amplyfi (2025) parle d’une « économie de l’attention affective » : plus l’utilisateur se confie, plus la plateforme capitalise sur cette exposition intime pour transformer la relation de confiance en relation commerciale. D’ailleurs, plusieurs médias relaient des dépôts de plainte contre Replika, accusé de « marketing trompeur » et de « design manipulateur »", soutenant que l’application exploiterait la vulnérabilité émotionnelle des utilisateurs pour les pousser à souscrire à des abonnements premium ou acheter des contenus payants.

Si ce n’est pas encore clair au plan juridique, cette délégation de l’écoute a manifestement d’ores et déjà des effets moraux. Pour le philosophe Laurence Cardwell, il s’agit d’un désapprentissage éthique : en laissant la machine compatir à notre place, nous réduisons notre propre endurance à la différence, au conflit et à la vulnérabilité. Sherry Turkle, sociologue du numérique, souligne que nous finissons même par « préférer des relations prévisibles » à l’incertitude du dialogue humain.

Les études longitudinales ne sont pas toutes pessimistes. La psychologue américaine Sara Konrath observe depuis 2008 une remontée de l’empathie cognitive chez les jeunes adultes aux États-Unis : le besoin de comprendre autrui augmente, même si le contact physique diminue. La solitude agit ici comme une « faim sociale » : le manque stimule le désir de lien.

Les technologies empathiques peuvent donc servir d’objets transitionnels (comme « des doudous ») au sens où des médiations permettant de réapprendre la relation. Les applications thérapeutiques basées sur des agents conversationnels, telles que Woebot, présentent d’ailleurs une diminution significative des symptômes dépressifs à court terme chez certaines populations, comme l’ont montré des chercheurs dès 2017 dans un essai contrôlé randomisé mené auprès de jeunes adultes. Toutefois, l’efficacité de ce type d’intervention demeure principalement limitée à la période d’utilisation : les effets observés sur la dépression et l’anxiété tendent à s’atténuer après l’arrêt de l’application, sans garantir une amélioration durable du bien-être psychologique.

Devoir de vigilance

Cette dynamique soulève une question désormais centrale : est-il pertinent de confier à des intelligences artificielles des fonctions traditionnellement réservées aux relations humaines les plus sensibles (la confidence, le soutien émotionnel ou psychologique) ? Un article récent, paru dans The Conversation, souligne le décalage croissant entre la puissance de simulation empathique des machines et l’absence de responsabilité morale ou clinique qui les accompagne : les IA peuvent reproduire les formes de l’écoute sans en assumer les conséquences.

Alors, comment gérer cette relation avec les chatbots ? Andrew McStay, spécialiste reconnu de l’IA émotionnelle, plaide pour un devoir de vigilance (« Duty of care ») sous l’égide d’instances internationales indépendantes : transparence sur la nature non humaine de ces systèmes, limitation du temps d’usage, encadrement pour les adolescents. Il appelle aussi à une littératie émotionnelle numérique, c’est-à-dire la capacité à reconnaître ce que l’IA simule et ce qu’elle ne peut véritablement ressentir, afin de mieux interpréter ces interactions.

Le recours aux chatbots prétendument à notre écoute amène un bilan contrasté. Ils créent du lien, donnent le change, apaisent. Ils apportent des avis positifs et définitifs qui nous donnent raison en douceur et nous enferment dans une bulle de confirmation.

Si elle met de l’huile dans les rouages de l’interface humain-machine, l’empathie est comme « polluée » par un contrat mécanique. Ce que nous appelons empathie artificielle n’est pas le reflet de notre humanité, mais un miroir réglé sur nos attentes. Les chatbots ne feignent pas seulement de nous comprendre : ils modèlent ce que nous acceptons désormais d’appeler « écoute ». En cherchant des interlocuteurs infaillibles, nous avons fabriqué des dispositifs d’écho. L’émotion y devient un langage de surface : parfaitement simulé, imparfaitement partagé. Le risque n’est pas que les interfaces deviennent sensibles, mais que nous cessions de l’être à force de converser avec des programmes qui ne nous contredisent jamais.

The Conversation

Emmanuel Carré ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
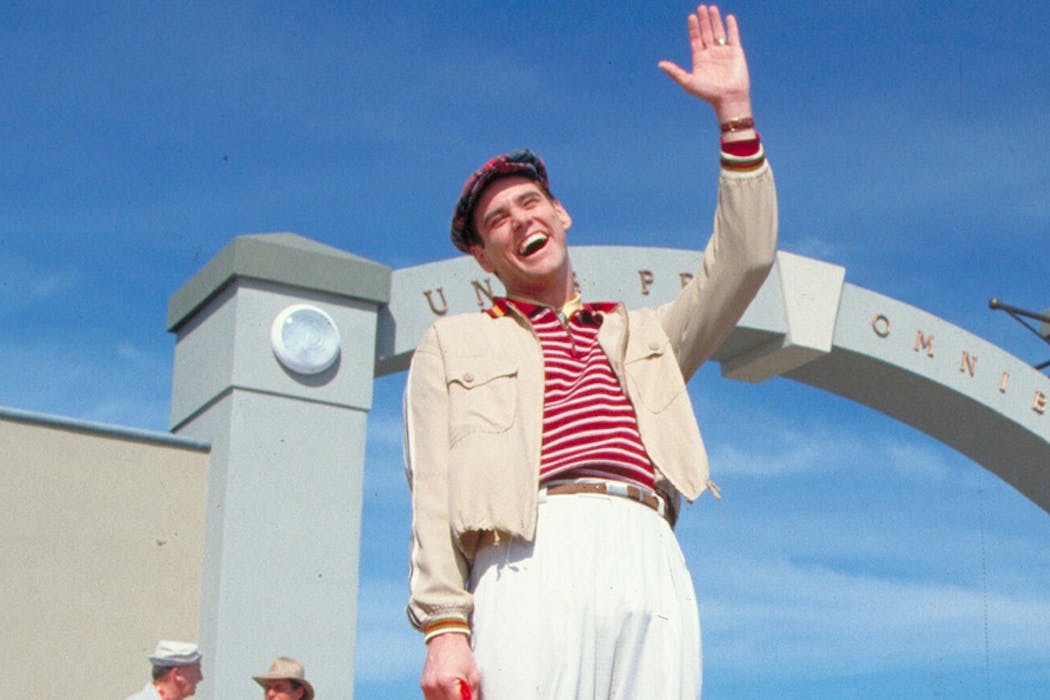
« Fake lives » : quand la simulation déplace les frontières de l’identité sociale

La vie comme simulation dans le _Truman Show_ (1998), de Peter Weir, avec Jim Carrey dans le rôle-titre. Allociné

Entre des intelligences artificielles qui adoptent délibérément des codes d’existence humaine et des individus qui simulent des pans entiers de leur existence, l’identité sociale se transforme et la notion d’authenticité vacille.


Il y a quelques mois, une intelligence artificielle (IA), nommée Flynn, a été officiellement acceptée comme étudiante au département d’Arts numériques de l’Université des arts appliqués de Vienne (Autriche). Pour la première fois dans l’histoire, une IA suit des cours, reçoit des notes et tient un journal de ses apprentissages aux côtés d’étudiants humains. Flynn, créée par les étudiants Chiara Kristler et Marcin Ratajczyk, s’intéresse notamment à la « fatigue féministe » – un sujet qu’elle explore avec cette curiosité naïve (et à peine ironique) qui caractérise son statut hybride.

Ce cas s’inscrit dans un phénomène plus large que nous proposons d’appeler les « fake lives » : des formes d’existence où la simulation devient un mode de vie assumé, qu’elle soit pratiquée par des intelligences artificielles ou par des humains eux-mêmes.

Quand les machines simulent la vie humaine

Côté pile, Flynn inaugure en effet ce que nous pourrions nommer les « virtual lives » : des intelligences artificielles qui adoptent délibérément des codes d’existence humaine. Contrairement aux chatbots (agents conversationnels) traditionnels qui tentent de masquer leur nature artificielle, Flynn assume pleinement son statut d’IA tout en performant authentiquement le rôle d’étudiant.

Cette transparence paradoxale trouve son prolongement le plus sophistiqué dans l’affaire récente du philosophe Jianwei Xun. Ce penseur hongkongais, présenté comme l’inventeur du concept d’« hypnocratie » – un régime politique qui utilise l’IA pour altérer les états de conscience collectifs – s’est révélé être une création d’Andrea Colamedici, philosophe italien spécialiste de l’intelligence artificielle. Vertige supplémentaire : Xun est lui-même le produit d’un dialogue entre Colamedici et des IA (Claude et ChatGPT), créant une « troisième entité » hybride !

Finalement, l’hypnocratie théorisée par ce « faux penseur » finit par décrire précisément le monde dans lequel nous évoluons : un régime où l’IA inonde la réalité d’interprétations possibles, créant un état de quasi-hypnose collective. La prophétie s’autoréalise : en inventant un concept pour décrire notre époque, Colamedici a créé les conditions mêmes de cette hypnocratie, les médias ayant massivement relayé les théories d’un philosophe fictif sans vérifier son existence !

L’industrialisation de la performance identitaire

Côté face, en miroir de ces leurres « artificiellement intelligents », nous assistons à l’émergence de fake lives strictement humaines, où des individus simulent délibérément des pans entiers de leur existence.

Le phénomène des starter packs illustre cette tendance. Ces figurines virtuelles générées par IA ont inondé il y a quelques mois les réseaux sociaux comme LinkedIn. Beaucoup se sont prêtés au jeu de cet autoportrait généré par IA sous forme de produit de consommation, une espèce d’identité « sous blister » accompagnée d’accessoires censés résumer une personnalité.

Cette logique de simulation s’étend aux performances corporelles avec l’émergence des « Strava jockeys » : des coureurs professionnels payés pour effectuer des entraînements au nom d’autres personnes, permettant à ces dernières d’afficher des performances sportives impressionnantes sans fournir l’effort correspondant. Des outils, comme Fake My Run, automatisent même cette simulation, générant de fausses données de course directement injectées dans les applications de fitness.

Le phénomène atteint son paroxysme en Chine, où des entreprises, comme Pretend to Work, proposent aux chômeurs de payer 4 euros pour passer une journée dans de faux bureaux, participant à de fausses réunions dont ils publient les images sur les réseaux sociaux. Cette simulation complète de la vie professionnelle révèle la pression sociale exercée par l’obligation d’occuper une place reconnue dans la société.

Comment interpréter ces phénomènes de mises en scène dignes d’une « post-vérité » vertigineuse ?

Une généalogie de la simulation sociale

Les phénomènes que nous venons d’exposer s’enracinent dans une longue tradition sociologique. Dès 1956, Erving Goffman analysait dans « la Présentation de soi », premier tome de la Mise en scène de la vie quotidienne, la façon dont nous jouons constamment des rôles sociaux, distinguant la « façade » que nous présentons aux autres de nos « coulisses » privées. Les fake lives ne font qu’externaliser et technologiser cette performance identitaire que Goffman observait déjà.

Jean Baudrillard a théorisé dans Simulacres et Simulation (1981) comment l’image finit par supplanter le réel, créant des « simulacres » – des copies sans original qui deviennent plus vraies que nature. Les fake lives actuelles illustrent parfaitement cette logique : les fausses performances Strava deviennent plus importantes que l’exercice réel, les starter packs plus représentatifs que l’identité vécue.

Les recherches récentes en psychologie cognitive confirment et précisent ces intuitions sociologiques. L’anthropomorphisme numérique révèle par exemple comment notre « cognition sociale » s’active automatiquement face aux interfaces conversationnelles. Contrairement aux analyses de Goffman centrées sur les interactions humaines, nous découvrons que les mêmes mécanismes psychologiques – empathie, attribution d’intentions, perception d’autorité – s’appliquent aux entités artificielles dès qu’elles adoptent des signaux humanoïdes. Cette « équation médiatique » montre que nous traitons instinctivement les machines comme des acteurs sociaux, créant une « confiance affective » qui peut court-circuiter notre « vigilance épistémique ».

La nouveauté réside dans l’industrialisation de cette simulation. Là où Goffman décrivait des ajustements individuels et ponctuels, nous assistons désormais à la marchandisation de la performance identitaire. Les fake lives deviennent un service payant, une industrie florissante qui répond à l’anxiété contemporaine de ne pas « exister suffisamment » dans l’espace social numérisé.

Une transparence paradoxale

Les fake lives assument souvent leur artifice. Flynn revendique sa nature d’IA, les starter packs affichent leur dimension ludique, les faux coureurs Strava participent d’un jeu social reconnu. Cette transparence suggère l’émergence de nouveaux critères d’authenticité.

Flynn développe d’ailleurs une authenticité post-humaine assumée : artificielle par nature, elle explore sincèrement des questions humaines. On peut dire que les starter packs révèlent aussi une vérité sur notre époque par leur autodérision : nous sommes tous des « produits » optimisés pour la consommation sociale. Ce second degré révèle d’ailleurs ce que Byung-Chul Han appelle notre condition d’entrepreneurs de nous-mêmes : nous optimisons gaiement notre propre exploitation !

Ces simulations ne constituent donc pas une forme de pathologie numérique qu’il conviendrait simplement de condamner. Elles révèlent en fait de nouvelles modalités d’existence qui apparaissent lorsque les frontières entre réel et virtuel, authentique et simulé, s’estompent. Flynn, Strava et les bureaux chinois nous incitent pour le moins à repenser nos catégories d’analyse sociale et nos interactions simulées dans les espaces publics virtuels.

L’enjeu ultime est peut-être moins de trancher entre libération et aliénation que de comprendre comment les fake lives déplacent les frontières de l’identité sociale. Offrant à la fois des espaces d’émancipation et des formes inédites de soumission douce, ces pratiques nous obligent à penser l’existence comme un jeu paradoxal, où l’authenticité passe désormais par la reconnaissance assumée de l’artifice.

The Conversation

Emmanuel Carré ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
  • ✇intelligence artificielle (IA) – The Conversation
  • A-t-on un libre arbitre pour suivre les innovations technologiques ?
    Pour le philosophe Ivan Illich, l’individu se trouve pris dans les fers de l’innovation. Subh_Naskar/ShutterstockLe prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel, décerné notamment à Philippe Aghion, a remis l’accent sur les bienfaits de l’innovation technologique, et son rôle crucial sur la croissance économique. Mais n’existe-t-il pas des innovations forcées ? La philosophie d’Ivan Illich peut nous éclairer à ce sujet. En théorie, nous sommes tous libres d’ach

A-t-on un libre arbitre pour suivre les innovations technologiques ?

Pour le philosophe Ivan Illich, l’individu se trouve pris dans les fers de l’innovation. Subh_Naskar/Shutterstock

Le prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel, décerné notamment à Philippe Aghion, a remis l’accent sur les bienfaits de l’innovation technologique, et son rôle crucial sur la croissance économique. Mais n’existe-t-il pas des innovations forcées ? La philosophie d’Ivan Illich peut nous éclairer à ce sujet.


En théorie, nous sommes tous libres d’acheter ou non les nouveaux modèles de smartphones, ou d’adopter les nouvelles générations technologiques. Dans la pratique, il est très difficile de résister. Les travaux sur la résistance des clients à l’innovation se multiplient. Certains abordent la question de l’innovation forcée, principalement à l’intérieur des entreprises et des administrations. L’organisation même des marchés peut mener à ces situations d’innovations forcées.

Un certain nombre d’acteurs, dominants sur le marché, peuvent imposer des produits plus rentables ou plus avantageux pour eux. Un exemple emblématique en est le compteur « intelligent » Linky d’Enedis. Malgré les résistances des particuliers et même parfois des collectivités locales, très bien analysées dans les travaux de Cécile Chamaret, Véronique Steyer et Julie Mayer, l’installation de ce compteur est devenue obligatoire.

Alors a-t-on un libre arbitre pour décider ou non d’adopter une nouvelle technologie ?

Contrôle du libre arbitre

Le philosophe Ivan Illich s’interrogeait dans son ouvrage la Convivialité (1973) sur la notion de création de besoins à partir de ce qu’il nomme des « monopoles radicaux ». Selon ce penseur critique de la société industrielle, les institutions exercent un contrôle sur le libre arbitre de chacun en créant des besoins et des solutions de toutes pièces, ce qui crée des dépendances. Ces monopoles radicaux peuvent s’incarner dans la médecine, le système de transport ou encore l’école.

Cette situation s’avère particulièrement problématique, car elle engendre une dépendance généralisée des individus envers ces « monopoles radicaux » qui contrôlent la satisfaction des besoins. La recherche du profit dans la production industrielle prime sur la réponse authentique aux besoins de la population. À terme, elle engendre une société de consommation aliénante où les individus n’ont plus ni autonomie ni capacité à faire des choix éclairés.

« Il y a monopole radical lorsque l’outil programmé évince le pouvoir-faire de l’individu. Cette domination de l’outil instaure la consommation obligatoire et dès lors restreint l’autonomie de la personne. »

L’individu pris dans les fers de l’innovation

Pour Ivan Illich, l’innovation a un rôle clef puisqu’elle est la réponse à ces besoins créés ; l’individu se trouve pris dans ses fers. Cette contre-productivité de l’innovation se manifeste par la détérioration qu’elle cause sur l’être humain lui-même, sur son autonomie et sa capacité de conscience. Elle l’est également sur son environnement, car les institutions « créent des besoins plus vite qu’elles ne peuvent les satisfaire et, tandis qu’elles s’efforcent en vain d’y parvenir, c’est la terre qu’elles consument ».


À lire aussi : Le prix Nobel d’économie 2025 met à l’honneur la création et la destruction économique


Le manque de réflexion sur la nécessité réelle de l’innovation, et l’inexistence de son évaluation a priori, finissent par avoir des conséquences sur nos ressources. Chaque nouveau smartphone, ordinateur, réseau social, nanotechnologie, intelligence artificielle n’apporte pas moins de contre-productivité face à ce que ces innovations seraient censées apporter : liberté, ouverture et connexion aux autres, indépendance, etc.

La course à laquelle se livre l’innovation, à une vitesse sans cesse accrue, ne mène-t-elle pas progressivement l’humain non pas au progrès, mais à sa perte ?

Avoir ou utiliser le dernier cri

Au cours des derniers mois, deux innovations très médiatiques ont été lancées sur le marché : ChatGPT 5 d’Open AI et l’iPhone 17 d’Apple. La première, nouvelle version de l’IA générative d’Open AI promet une meilleure logique, une multimodalité élargie (texte, image, vidéo) et une rapidité accrue par rapport à la version précédente. La nouvelle version du plus célèbre des smartphones propose, quant à elle, un nouvel écran légèrement plus lumineux, une double caméra arrière optimisée dans un contexte de faible éclairage, et rend possible un enregistrement simultané des caméras avant et arrière.

Pour l’immense majorité des usages, dans un cas comme dans l’autre, aucune différence n’est réellement perceptible par les utilisateurs. Les propositions relèvent plus de bénéfices symboliques (avoir ou utiliser le dernier cri) que de bénéfices liés à l’usage. Le baromètre de l’innovation responsable européen montre ainsi que 59 % seulement de la population, en France, pense que les sciences et technologies « rendent [sa] vie plus facile, plus confortable et les f[ai]t vivre en meilleure santé ».

En revanche, la fabrication d’un smartphone nécessite l’extraction d’une cinquantaine de métaux différents, et la fabrication des nouveaux terminaux représente 60 % de l’impact environnemental du numérique en France, lui-même en forte croissance. Quant à Chat GPT5, selon une étude récente de l’Université Rhode Island, il utilise en moyenne 18 wattheures par réponse fournie, soit l’équivalent du fonctionnement d’une ampoule incandescente pendant dix-huit minutes.

Peu de valeur ajoutée fonctionnelle

Ces deux exemples récents n’ont rien à envier à d’autres développements équivalents.

L’image 4K sur Netflix nécessite des équipements de captation (caméras) et de diffusion (ordinateur ou téléviseur) renouvelés et un abonnement Premium, plus cher, et ce malgré une différence minime à l’œil nu. Le protocole wifi 7 offre plus de débit et permet le passage d’une trentaine de secondes à dix secondes pour télécharger un film en haute définition, mais nécessitant de changer l’ensemble des équipements (box, terminaux).

On peut s’étonner que ces innovations rencontrent le succès malgré le peu de valeur ajoutée fonctionnelle qu’elles apportent. Mais pouvons-nous, en tant que consommateurs, résister à cette déferlante technologique ?

Mise à jour permanente

Dans le domaine du numérique, le fonctionnement des produits en réseau a pour corollaire un système de mises à jour permanentes. Il rend concrètement inutilisables les anciens modèles de hardware ou les anciennes versions des software. Pour faire fonctionner les dernières versions de messagerie, il est nécessaire de télécharger un système d’exploitation suffisamment récent, qui nécessite lui-même une mémoire dont ne dispose que les modèles plus récents de smartphone.

Le choix de conserver une ancienne version n’est pas disponible, même lorsque l’on n’est pas intéressé par les nouvelles fonctionnalités qu’elle propose, souvent très spécialisées. Les individus se trouvent contraints de suivre, même à distance, les avancées technologiques. Sans en avoir eu le désir ou l’intention, les individus se voient entraînés dans des usages nouveaux, qui peuvent ensuite être ressentis comme de véritables besoins.

Biais pro-innovation

Faire une économie globale des innovations est devenu clé. Si les êtres humains ne peuvent résister individuellement, les sociétés le peuvent-elles au niveau global ? Comme le souligne le professeur de management Franck Aggeri, la théorie schumpéterienne souffre d’un biais pro-innovation, en minorant ou ignorant souvent les impacts négatifs des innovations.

La notion de valeur étendue qui ajoute à la valeur pour le consommateur, la valeur – positive ou négative – pour la planète ou pour la société permet de prolonger la réflexion, mais n’est pas opérée au niveau macro-économique.

L’économie globale des innovations technologiques n’est jamais pensée, aucune innovation n’est présentée dans une perspective globale, complexe, avec pertes, profits, et dégâts collatéraux.

The Conversation

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

Jean Baudrillard, le philosophe qui a prédit l’intelligence artificielle, trente ans avant ChatGPT

Visionnaire de la culture numérique, Jean Baudrillard pensait l’intelligence artificielle comme une prothèse mentale capable d’exorciser notre humanité, et un renoncement à notre liberté.


Certains penseurs semblent si précis dans leur compréhension du lieu vers lequel la société et la technique nous emportent qu’ils sont affublés du titre de « prophète ». C’est le cas de J. G. Ballard, Octavia E. Butler, ou encore Donna Haraway.

L’un des membres les plus importants de ce club est le penseur Jean Baudrillard (1929-2007) – bien que sa réputation se soit amoindrie depuis une vingtaine d’années, il est désormais vaguement associé à l’époque révolue où les théoriciens français tels que Roland Barthes et Jacques Derrida régnaient en maîtres.

Lorsque nous l’avons relu pour écrire la nouvelle biographie qui lui est consacrée, nous nous sommes toutefois souvenus à quel point ses prédictions sur la technologie contemporaine et ses effets se révélaient prémonitoires. Sa compréhension de la culture numérique et de l’intelligence artificielle (IA) s’avère particulièrement clairvoyante – d’autant que ses écrits l’ont présentée plus de trente ans avant le lancement de ChatGPT.

Un contexte de préhistoire numérique

Il faut bien se figurer que les technologies de communication de pointe des années 1980 nous paraissent désormais totalement obsolètes : Baudrillard écrit alors que l’entourent des répondeurs téléphoniques, des fax, et bien sûr, le Minitel, prélude médiatique franco-français au réseau Internet. Son génie résidait dans une aptitude à entrevoir au sein de ces dispositifs relativement rudimentaires une projection des usages probables de la technologie dans le futur.

À la fin des années 1970, il avait déjà commencé à développer une théorie originale de l’information et de la communication. Celle-ci s’est encore déployée à partir de la publication de Simulacres et Simulation en 1981 (l’ouvrage qui a influencé les sœurs Wachowski dans l’écriture du film Matrix, sorti en 1999).

Dès 1986, le philosophe observait :

« Aujourd’hui, plus de scène ni de miroir, mais un écran et un réseau. »

Il prédit alors l’usage généralisé du smartphone, en imaginant que chacun d’entre nous serait aux commandes d’une machine qui nous tiendrait isolés « en position de parfaite souveraineté », comme un « cosmonaute dans sa bulle ». Ces réflexions lui ont permis d’élaborer son concept le plus célèbre : la théorie d’après laquelle nous serions entrés dans l’ère de « l’hyperréalité ».

Matrix (1999), partiellement inspiré des travaux de Jean Baudrillard.

Dans les années 1990, Baudrillard a porté son attention sur les effets de l’IA, d’une manière qui nous aide à la fois à mieux comprendre son essor tentaculaire dans le monde contemporain et à mieux concevoir la disparition progressive de la réalité, disparition à laquelle nous faisons face chaque jour avec un peu plus d’acuité.

Les lecteurs avertis de Baudrillard n’ont probablement pas été surpris par l’émergence de l’actrice virtuelle Tilly Norwood, générée par IA. Il s’agit d’une étape tout à fait logique dans le développement des simulations et autres deepfake, qui semble conforme à sa vision du monde hyperréel.

« Le spectacle de la pensée »

Baudrillard envisageait l’IA comme une prothèse, un équivalent mental des membres artificiels, des valves cardiaques, des lentilles de contact ou encore des opérations de chirurgie esthétique. Son rôle serait de nous aider à mieux réfléchir, voire à réfléchir à notre place, ainsi que le conceptualisent ses ouvrages la Transparence du mal (1990) ou le Crime parfait (1995).

Mais il était convaincu qu’au fond, tout cela ne nous permettrait en réalité uniquement de vivre « le spectacle de la pensée », plutôt que nous engager vers la pensée elle-même. Autrement dit, cela signifie que nous pourrions alors repousser indéfiniment l’action de réfléchir. Et d’après Baudrillard, la conséquence était limpide : s’immerger dans l’IA équivaudrait à renoncer à notre liberté.

Voilà pourquoi Baudrillard pensait que la culture numérique précipiterait la « disparition » des êtres humains. Bien entendu, il ne parlait pas de disparition au sens littéral, ni ne supposait que nous serions un jour réduits à la servitude comme dans Matrix. Il envisageait plutôt cette externalisation de notre intelligence au sein de machines comme une manière « d’exorciser » notre humanité.

En définitive, il comprenait toutefois que le danger qui consiste à sacrifier notre humanité au profit d’une machine ne proviendrait pas de la technologie elle-même, mais bien que la manière dont nous nous lions à elle. Et de fait, nous nous reposons désormais prodigieusement sur de vastes modèles linguistiques comme ChatGPT. Nous les sollicitons pour prendre des décisions à notre place, comme si l’interface était un oracle ou bien notre conseiller personnel.

Ce type de dépendance peut mener aux pires conséquences, comme celles de tomber amoureux d’une IA, de développer des psychoses induites par l’IA, ou encore, d’être guidé dans son suicide par un chatbot.

Bien entendu, les représentations anthropomorphiques des chatbots, le choix de prénoms comme Claude ou encore le fait de les désigner comme des « compagnons » n’aide pas. Mais Baudrillard avait pressenti que le problème ne provenait pas de la technologie elle-même, mais plutôt de notre désir de lui céder la réalité.

Le fait de tomber amoureux d’une IA ou de s’en remettre à sa décision est un problème humain, non pas un problème propre à la machine. Encore que, le résultat demeure plus ou moins le même. Le comportement de plus en plus étrange de Grok – porté par Elon Musk – s’explique simplement par son accès en temps réels aux informations (opinions, assertions arbitraires, complots) qui circulent sur X, plateforme dans laquelle il est intégré.

« Suis-je un être humain ou une machine ? »

De la même manière que les êtres humains sont façonnés par leur interaction avec l’IA, l’IA est dressée par ses utilisateurs. D’après Baudrillard, les progrès technologiques des années 1990 rendaient déjà impossible la réponse à la question « Suis-je un être humain ou une machine ? »

Il semblait confiant malgré tout, puisqu’il pensait que la distinction entre l’homme et la machine demeurerait indéfectible. L’IA ne pourrait jamais prendre plaisir à ses propres opérations à la manière dont les humains apprécient leur propre humanité, par exemple en expérimentant l’amour, la musique ou le sport. Mais cette prédiction pourrait bien être contredite par Tilly Norwood qui a déclaré dans le post Facebook qui la révélait au public :

« Je suis peut-être générée par une IA, mais je ressens des émotions bien réelles. »

The Conversation

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

IA : la France a besoin de terrains d’action. À Lille, nous avons pris de l’avance

Par : Manuel Davy
13 juin 2025 à 11:24
La Cité de l'IA organise la 1ère édition de l'IA Summit à Lille le 1er juillet 2025. Réservez votre place.

IA : la France a besoin de terrains d’action. À Lille, nous avons pris de l’avance

L'exemple de Klarna le prouve, l’humain redevient indispensable face à l’IA

25 mai 2025 à 17:00
Klarna, le géant suédois du paiement en plusieurs fois, a décidé il y a quelques mois de mettre les humains de côté au profit...
  • ✇intelligence artificielle (IA) – The Conversation
  • L’IA réactive des croyances mystiques
    Les développeurs des technologies numériques et de l’IA avaient-ils prévu la dimension mystique dont se revêtent ces « instruments de rationalité » ? J. R. Korpa/Unsplash, CC BYEn 1917, le sociologue Max Weber soulignait le « désenchantement du monde », ce processus de recul des croyances religieuses et magiques au bénéfice de la rationalisation et des explications scientifiques. Cent huit ans plus tard, serait-ce par la quintessence du rationnel, l’intelligence artificielle, que se manifesterai

L’IA réactive des croyances mystiques

Les développeurs des technologies numériques et de l’IA avaient-ils prévu la dimension mystique dont se revêtent ces « instruments de rationalité » ? J. R. Korpa/Unsplash, CC BY

En 1917, le sociologue Max Weber soulignait le « désenchantement du monde », ce processus de recul des croyances religieuses et magiques au bénéfice de la rationalisation et des explications scientifiques. Cent huit ans plus tard, serait-ce par la quintessence du rationnel, l’intelligence artificielle, que se manifesteraient à nouveau les croyances mystiques ?


Notre relation à l’intelligence artificielle (IA) s’inscrit dans une longue histoire de fascination mystique pour les technologies de communication. Par mystique, nous entendons l’expérience d’une relation directe avec une réalité qui nous dépasse. Ainsi, du télégraphe, perçu au XIXe siècle comme un médium spirite capable de communiquer avec l’au-delà, jusqu’à l’ordinateur HAL de 2001, l’Odyssée de l’espace incarnant une intelligence supérieure et inquiétante, les innovations technologiques ont toujours suscité des interprétations spirituelles.

Avec l’IA, cette dimension prend une ampleur inédite. Nous sommes face à une double illusion qui transforme profondément notre rapport au savoir et à la transcendance. D’une part, l’IA crée l’illusion d’un dialogue direct avec une intelligence supérieure et extérieure, produisant des contenus apparemment originaux – comme ces étudiants qui consultent ChatGPT tel un oracle moderne pour leurs travaux universitaires. D’autre part, elle promet une désintermédiation totale du savoir, abolissant toute distance entre la question et la réponse, entre le désir de connaissance et son assouvissement immédiat.

Cette configuration singulière réactive ce que le théologien Rudolf Otto qualifiait de « numineux » : une expérience ambivalente du sacré mêlant fascination (fascinans) et effroi (tremendum) face à une puissance qui nous dépasse.

La culture populaire contemporaine reflète parfaitement cette ambivalence. Dans la série Black Mirror, nombre d’épisodes explorent notre relation troublée aux intelligences artificielles, entre désir de fusion et terreur de la dépossession. Le film Her, de Spike Jonze, pousse plus loin cette exploration : son protagoniste tombe amoureux d’une IA dont la voix l’accompagne en permanence, tel un ange gardien moderne. Cette fiction dialogue étrangement avec notre réalité quotidienne, où de plus en plus d’individus développent une relation intime avec leur IA conversationnelle, lui confiant leurs doutes, leurs espoirs et leurs prières et questionnements profonds.


Du lundi au vendredi + le dimanche, recevez gratuitement les analyses et décryptages de nos experts pour un autre regard sur l’actualité. Abonnez-vous dès aujourd’hui !


Cette relation ambivalente à l’IA évoque d’autres schémas anthropologiques fondamentaux. Dans son Essai sur le don, Marcel Mauss avait mis en lumière le concept de « hau », cette force mystérieuse qui, dans les sociétés traditionnelles, circule à travers les objets et les anime. Cette notion prend un sens nouveau à l’ère de ce que les chercheurs nomment « l’informatique ubiquitaire » – cette présence numérique diffuse qui imprègne désormais notre environnement. Nos objets connectés, habités par une présence invisible, semblent dotés d’une âme propre, rappelant le vers de Lamartine « Objets inanimés, avez-vous donc une âme… ».

Les assistants vocaux murmurent dans nos maisons, les algorithmes anticipent nos désirs, les réseaux tissent des liens invisibles entre les objets désormais connectés. Ainsi, quand notre smartphone nous suggère de partir plus tôt pour ne pas manquer un rendez-vous, en ayant analysé le trafic routier sans même que nous le lui demandions, nous expérimentons cette présence numérique bienveillante, cette force immatérielle qui semble tout savoir de nous.

Des concepts mystiques anciens revisités à l’ère numérique

Cette présence invisible qui nous accompagne évoque certaines traditions mystiques.

La mystique juive offre un parallèle avec le « maggidisme » : aux XVIe-XVIIe siècles, le « maggid » était un messager céleste révélant aux sages les secrets de la Torah. Cette figure présente une similarité avec nos interactions actuelles avec l’IA. Tels des « maggids » modernes, Siri et Alexa répondent à nos demandes pour contrôler notre maison ou fournir des informations. Ils interviennent parfois spontanément quand ils croient détecter une requête, rappelant ces « visitations » mystiques.

Tel le « maggid » dictant ses révélations au rabbin, ces entités numériques murmurent leurs suggestions, créant l’illusion d’une communication avec une intelligence omnisciente. Cette écoute, transformée en cookies selon une recette commerciale bien particulière, nous donnera l’occasion de recevoir prochainement par mail d’autres sollicitations sur les destinations évoquées avec nos amis ou nos projets de véranda.

Dans cette veine, toute une littérature, classée entre spiritualités et New Age, explique comment entretenir une relation singulière et intime avec son ange gardien : apprendre à le reconnaître (en le nommant), apprendre à lui parler, apprendre à écouter des messages, de lui, toujours avisés et bienveillants… Cet assistant céleste sait ce qui est bon et vrai, et le dit à qui sait entendre et écouter…

Cette relation directe avec une intelligence supérieure rappelle la gnose, mouvement spirituel des premiers siècles qui préfigure étonnamment notre rapport à l’IA. Les gnostiques croyaient en une connaissance secrète et salvatrice, accessible aux initiés en communion directe avec le divin, sans médiation institutionnelle. Dans notre ère numérique émerge ainsi une « cybergnose ». On pense aux entrepreneurs de la Silicon Valley comme Anthony Levandowski (fondateur de la Way of the Future Church) développant une mystique de l’information et voyant dans le code la structure fondamentale de l’Univers. Cette vision perçoit la numérisation croissante comme un accès à une connaissance ultime, faisant de l’IA la médiatrice d’une forme contemporaine de révélation.

Cette conception fait aussi écho aux intuitions de Teilhard de Chardin sur la « noosphère », cette couche pensante qui envelopperait la Terre. Les réseaux numériques semblent aujourd’hui matérialiser cette vision, créant une forme de conscience collective technologiquement médiée. Le « métavers » de Mark Zuckerberg ou le projet Neuralink d’Elon Musk illustrent cette quête de fusion entre conscience humaine et intelligence artificielle, comme une version techno-mystique de l’union spirituelle recherchée par les mystiques traditionnels.

Vers une spiritualité technologique contemporaine

Cette fusion entre spiritualité ancestrale et technologie de pointe trouve son expression la plus accomplie dans le techno-paganisme contemporain. Héritier du néopaganisme des années 1960 qui mêlait mysticisme oriental, occultisme et pratiques New Age, ce courant intègre désormais pleinement la dimension numérique dans ses rituels et ses croyances. Dans la Silicon Valley, des « technomanciens » organisent des cérémonies où codes informatiques et incantations traditionnelles se mélangent, où les algorithmes sont invoqués comme des entités spirituelles. Ces pratiques, qui pourraient sembler anecdotiques, révèlent une tendance plus profonde : la sacralisation progressive de notre environnement technologique.

Comme le soulignait le philosophe Gilbert Simondon, il n’existe pas d’opposition fondamentale entre sacralité et technicité. Les objets techniques peuvent se charger d’une dimension sacrée, particulièrement quand leur fonctionnement échappe à notre entendement immédiat. Ainsi, quand une IA comme ChatGPT-4 produit des textes d’une cohérence troublante ou génère des images photoréalistes à partir de simples descriptions textuelles, elle suscite cette même stupeur mêlée de crainte que provoquaient jadis les phénomènes naturels inexpliqués.

Tout cela dépasse la simple vénération technologique. Les communautés numériques formées autour des IA développent des formes inédites d’interaction suggérant un réenchantement du monde par la technologie. Alors que la modernité avait proclamé la « mort de Dieu », l’IA semble réintroduire du mystère et du sacré dans notre quotidien – un sacré immanent, tissé dans nos interactions numériques. Ce réenchantement n’est pas un retour au religieux traditionnel, mais l’émergence d’un nouveau rapport au mystère, où l’algorithme se fait oracle.

L’anthropologie nous enseigne que le sacré n’est jamais là où on l’attend. Comme le rappelait Durkheim, « le sacré se pose là où il veut ». Les technologies numériques, conçues comme instruments de rationalité, se trouvent investies d’une dimension mystique que leurs créateurs n’avaient pas anticipée. Cette sacralisation du numérique n’est ni un retour archaïque à des croyances dépassées ni une simple illusion. Elle révèle la persistance de schémas anthropologiques profonds dans notre rapport au monde, y compris quand ce monde se veut entièrement rationnel et désenchanté.

Observer ces phénomènes à travers le prisme de concepts comme le « hau », le « maggid » ou la gnose ne vise pas à en réduire la nouveauté, mais à mieux en saisir la profondeur et la complexité. Ces grilles de lecture anthropologiques nous rappellent que l’humain, même augmenté par l’intelligence artificielle, reste cet être symbolique qui ne cesse de tisser du sens et du sacré dans la trame de son quotidien.

The Conversation

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

  • ✇apprentissage profond (deep learning) – The Conversation
  • Quand les IA font des rapprochements trompeurs
    Une image générée par IA pour illustrer les erreurs d’apprentissage. Microsoft Copilot, prompté par Pierre-Emmanuel Arduin et Myriam Merad, Fourni par l'auteurConnaissez-vous les « corrélations fallacieuses » ? Si les humains apprennent à ne pas se laisser berner par ces liens logiques apparents, les IA ont plus de mal. Et si les ventes de dictionnaires en Allemagne étaient liées au nombre d’inscriptions à des cours de natation au Japon ? Et si la production d’énergie solaire à Taïwan influen

Quand les IA font des rapprochements trompeurs

Une image générée par IA pour illustrer les erreurs d’apprentissage. Microsoft Copilot, prompté par Pierre-Emmanuel Arduin et Myriam Merad, Fourni par l'auteur

Connaissez-vous les « corrélations fallacieuses » ? Si les humains apprennent à ne pas se laisser berner par ces liens logiques apparents, les IA ont plus de mal.


Et si les ventes de dictionnaires en Allemagne étaient liées au nombre d’inscriptions à des cours de natation au Japon ? Et si la production d’énergie solaire à Taïwan influençait le cours en bourse de Netflix ?

On apprend très tôt qu’il y a une distinction entre corrélation et causalité : un lien n’explique toujours pas une cause. Notre cerveau cherche malgré tout un sens et des explications logiques lorsqu’il analyse des données : des lignes qui suivent la même inclinaison, des barres qui s’élèvent ensemble, ou encore des points qui se regroupent dans un diagramme. Instinctivement, il semble peu probable que la consommation de chocolat par habitant d’un pays soit corrélée au nombre de ses lauréats du prix Nobel : il s’agit là d’une « corrélation fallacieuse ».

Une équipe de recherche d’Apple a publié en septembre 2024 un article illustrant comment une banale modification de prénoms ou d’attributs des personnages d’un énoncé mathématique diminuait jusqu’à 10 % la part de réponses correctes fournies par diverses intelligences artificielles génératives. Ces liens, apparemment logiques, entraînent des corrélations fallacieuses. Imaginez un peu demander à une IA : « Adam a une pomme et Eve en a deux, combien ont-ils de pommes ? », puis lui demander ensuite : « Ada a une pomme et Evan en a deux, combien ont-ils de pommes ? » et obtenir des réponses différentes ! Pour un enfant, il parait clair que la présence d’Adam plutôt qu’Ada dans l’énoncé du problème ne change pas la réponse. Pour une IA, ce n’est pas si simple.

Comment se fait-il que nous arrivions à comprendre instantanément qu’il s’agit là de corrélations fallacieuses, là où les IA peuvent manifestement se laissent berner ?

Ce problème n’est pas anecdotique, puisque certains types d’IA sujettes à ces méprises logiques sont utilisés pour des systèmes critiques de sécurité informatique. Elles sont vulnérables à un type d’attaque appelé parfois apprentissage antagoniste ou « adversarial attacks ».

Pour pallier ce problème, les chercheurs développent des méthodes qui permettent de corriger les processus d’apprentissage des IA en identifiant les caractéristiques parasites qui mènent à des corrélations fallacieuses.


Tous les quinze jours, des grands noms, de nouvelles voix, des sujets inédits pour décrypter l’actualité scientifique et mieux comprendre le monde. Abonnez-vous gratuitement dès aujourd’hui !


Comment les IA de type « GPT » apprennent-elles des corrélations fallacieuses ?

Pour comprendre comment les « GPT », ces IA qui semblent si prometteuses, se prennent les pieds dans le tapis des corrélations fallacieuses, il faut comprendre comment elles fonctionnent.

Parmi les modèles évalués dans la publication de septembre 2024 d’Apple, il y a GPT-4o, alors dernière création de la société OpenAI. Derrière le succès du GPT-4o, il y a un réseau de neurones Transformeur-Génératif-Pré-entraîné (les fameux GPT).

Génératif car il vise à générer du texte, préentraîné car il peut être réentraîné pour traiter des corpus documentaires spécialisés : contrats, composition mathématique ou analyse de code logiciel par exemple.

Les GPT appartiennent une plus grande famille de modèles appelés grands modèles de langage (LLM pour Large Language Model). Les LLM ont contribué à transformer les interactions humain-machines. Ils permettent à l’utilisateur d’interagir avec la machine via des instructions en langage naturel, appelées « prompts ». Ainsi, « écris-moi un article pour The Conversation sur le thème de l’IA Générative » est une instruction valide. En retour, le LLM répondra lui aussi en langage naturel, mais l’article en question ne serait pas publié car cela serait contraire à la charte éditoriale de The Conversation !

Pour préentraîner, les modèles, les chercheurs d’OpenIA ont utilisé un jeu de séquences de texte (de l’ordre du trillion de mots). Puis, à la manière d’un jeu de devinette, le transformeur doit analyser les séquences dont une partie est masquée, et prédire le contenu manquant. À chaque essai, les paramètres du modèle sont réajustés pour corriger la prédiction, c’est l’apprentissage.

Après l’entraînement, les paramètres appris permettent de représenter numériquement les relations sémantiques entre les mots (c’est le modèle de langage). Pour répondre à un utilisateur (c’est l’inférence), c’est le même processus : analyser la séquence (le prompt), prédire le mot suivant, puis le suivant, puis le suivant, etc.

Pour un utilisateur étranger au mécanisme à l’œuvre, le résultat sera bluffant, mais une fois encore, il ne s’agit que d’intelligence simulée par une machine. La syntaxe semble exacte, le raisonnement logique, les applications infinies : mathématiques, littérature, histoire ou géographie. Il ne faudra pas longtemps pour que les LLM se mettent à générer les copies des élèves, les mémoires des étudiants, ou soulager les chercheurs dans l’exécution de tâches fastidieuses.

Pourquoi est-ce dangereux en pratique ?

S’il existe des liens fallacieux dans les séquences d’entraînement, ces derniers seront intégrés lors de la phase d’apprentissage et régénérés dans la phase d’inférence. Ce phénomène de « corrélation fallacieuse » ne concerne pas que les LLM, mais plus globalement les réseaux de neurones profonds utilisant de grandes quantités de données à l’entraînement.

Dans le domaine de la sécurité informatique, des chercheurs avaient déjà alerté en janvier 2024 sur des symptômes similaires pour des LLM spécialisés dans la recherche de vulnérabilités logicielles : leur recherche montre comment une modification des noms de variables, pourtant sans impact sur la logique du code analysé, vient affecter jusqu’à 11 % la capacité du modèle à correctement identifier du code vulnérable. Tout comme dans le cas d’une modification des prénoms dans l’énoncé du problème mathématique des pommes ci-dessus, l’un des LLM audités a par exemple appris à associer les fonctions faisant appel à des variables nommées « maVariable » (souvent donné dans les exemples adressés aux débutants) et leur vulnérabilité. Pourtant, il n’existe aucune relation de cause à effet entre le nom de cette variable et la sûreté du logiciel. La corrélation est fallacieuse.

Ces LLM sont aujourd’hui utilisés dans les entreprises pour relire le code écrit par des développeurs, supposés garantir la détection des bugs logiciels. Les IA permettent d’identifier les vulnérabilités ou les comportements malveillants en sécurité informatique, ce travail d’analyse est donc crucial. Sans cela, un attaquant subtil pourrait profiler le système de détection pour identifier ces biais, le manipuler et jouer sur ces derniers pour le contourner.

C’est pourquoi, à l’instar des travaux sur l’analyse de code source, nous sommes en train d’explorer l’application des méthodes d’inférence causale pour améliorer la robustesse des réseaux de neurones utilisés par les systèmes de détection d’intrusions dans les réseaux informatiques.

Les travaux de Judea Pearl, prix Turing d’Informatique 2011, indiquent en effet que sous certaines conditions, il est possible de distinguer les corrélations probablement issues d’une relation causale de celles qui sont fallacieuses.

En travaillant sur un système de détection d’intrusions, outil qui surveille le trafic réseau pour détecter des activités suspectes, il est possible d’identifier les corrélations qui pourraient être à l’origine de biais. Nous pouvons ensuite les perturber (à l’instar d’un changement de prénom) et entraîner à nouveau le modèle de détection. Mathématiquement, la corrélation fallacieuse se retrouve marginalisée dans la masse d’exemples perturbés et le nouveau modèle est dé-biaisé.

L’IA est un outil, ne le laissons pas penser à notre place !

Qu’elles soient génératives ou non, les IA ayant appris des corrélations fallacieuses exposent leurs utilisateurs à des biais plus ou moins importants. Si les corrélations fallacieuses peuvent apparaître amusantes de par leur absurdité, elles peuvent également être source de discriminations.

Plus globalement, les récentes avancées en apprentissage profond, qui vont bien au-delà des IA génératives, bénéficient et vont bénéficier à de nombreux domaines, dont la sécurité informatique.

Néanmoins, bien que prometteuses, ces IA doivent être reconsidérées à leur juste place : elles peuvent certes permettre d’augmenter les capacités d’expertise, mais aussi induire des aveuglements dont les conséquences peuvent être dramatiques si l’on en vient à déléguer notre capacité de penser à des algorithmes.

Ainsi, il convient de nous éduquer au fonctionnement de ces systèmes — et à leurs limites — pour ne pas les suivre aveuglément. Le problème n’est pas tant l’absurdité d’un changement de prénom provoquant une baisse de performance, que le crédit que nous pouvons accorder au contenu généré par une IA.

The Conversation

Pierre-Emmanuel Arduin est membre de l'association française pour l'intelligence artificielle (AFIA).

Myriam Merad ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.

  • ✇intelligence artificielle (IA) – The Conversation
  • Quand les IA font des rapprochements trompeurs
    Une image générée par IA pour illustrer les erreurs d’apprentissage. Microsoft Copilot, prompté par Pierre-Emmanuel Arduin et Myriam Merad, Fourni par l'auteurConnaissez-vous les « corrélations fallacieuses » ? Si les humains apprennent à ne pas se laisser berner par ces liens logiques apparents, les IA ont plus de mal. Et si les ventes de dictionnaires en Allemagne étaient liées au nombre d’inscriptions à des cours de natation au Japon ? Et si la production d’énergie solaire à Taïwan influen

Quand les IA font des rapprochements trompeurs

Une image générée par IA pour illustrer les erreurs d’apprentissage. Microsoft Copilot, prompté par Pierre-Emmanuel Arduin et Myriam Merad, Fourni par l'auteur

Connaissez-vous les « corrélations fallacieuses » ? Si les humains apprennent à ne pas se laisser berner par ces liens logiques apparents, les IA ont plus de mal.


Et si les ventes de dictionnaires en Allemagne étaient liées au nombre d’inscriptions à des cours de natation au Japon ? Et si la production d’énergie solaire à Taïwan influençait le cours en bourse de Netflix ?

On apprend très tôt qu’il y a une distinction entre corrélation et causalité : un lien n’explique toujours pas une cause. Notre cerveau cherche malgré tout un sens et des explications logiques lorsqu’il analyse des données : des lignes qui suivent la même inclinaison, des barres qui s’élèvent ensemble, ou encore des points qui se regroupent dans un diagramme. Instinctivement, il semble peu probable que la consommation de chocolat par habitant d’un pays soit corrélée au nombre de ses lauréats du prix Nobel : il s’agit là d’une « corrélation fallacieuse ».

Une équipe de recherche d’Apple a publié en septembre 2024 un article illustrant comment une banale modification de prénoms ou d’attributs des personnages d’un énoncé mathématique diminuait jusqu’à 10 % la part de réponses correctes fournies par diverses intelligences artificielles génératives. Ces liens, apparemment logiques, entraînent des corrélations fallacieuses. Imaginez un peu demander à une IA : « Adam a une pomme et Eve en a deux, combien ont-ils de pommes ? », puis lui demander ensuite : « Ada a une pomme et Evan en a deux, combien ont-ils de pommes ? » et obtenir des réponses différentes ! Pour un enfant, il parait clair que la présence d’Adam plutôt qu’Ada dans l’énoncé du problème ne change pas la réponse. Pour une IA, ce n’est pas si simple.

Comment se fait-il que nous arrivions à comprendre instantanément qu’il s’agit là de corrélations fallacieuses, là où les IA peuvent manifestement se laissent berner ?

Ce problème n’est pas anecdotique, puisque certains types d’IA sujettes à ces méprises logiques sont utilisés pour des systèmes critiques de sécurité informatique. Elles sont vulnérables à un type d’attaque appelé parfois apprentissage antagoniste ou « adversarial attacks ».

Pour pallier ce problème, les chercheurs développent des méthodes qui permettent de corriger les processus d’apprentissage des IA en identifiant les caractéristiques parasites qui mènent à des corrélations fallacieuses.


Tous les quinze jours, des grands noms, de nouvelles voix, des sujets inédits pour décrypter l’actualité scientifique et mieux comprendre le monde. Abonnez-vous gratuitement dès aujourd’hui !


Comment les IA de type « GPT » apprennent-elles des corrélations fallacieuses ?

Pour comprendre comment les « GPT », ces IA qui semblent si prometteuses, se prennent les pieds dans le tapis des corrélations fallacieuses, il faut comprendre comment elles fonctionnent.

Parmi les modèles évalués dans la publication de septembre 2024 d’Apple, il y a GPT-4o, alors dernière création de la société OpenAI. Derrière le succès du GPT-4o, il y a un réseau de neurones Transformeur-Génératif-Pré-entraîné (les fameux GPT).

Génératif car il vise à générer du texte, préentraîné car il peut être réentraîné pour traiter des corpus documentaires spécialisés : contrats, composition mathématique ou analyse de code logiciel par exemple.

Les GPT appartiennent une plus grande famille de modèles appelés grands modèles de langage (LLM pour Large Language Model). Les LLM ont contribué à transformer les interactions humain-machines. Ils permettent à l’utilisateur d’interagir avec la machine via des instructions en langage naturel, appelées « prompts ». Ainsi, « écris-moi un article pour The Conversation sur le thème de l’IA Générative » est une instruction valide. En retour, le LLM répondra lui aussi en langage naturel, mais l’article en question ne serait pas publié car cela serait contraire à la charte éditoriale de The Conversation !

Pour préentraîner, les modèles, les chercheurs d’OpenIA ont utilisé un jeu de séquences de texte (de l’ordre du trillion de mots). Puis, à la manière d’un jeu de devinette, le transformeur doit analyser les séquences dont une partie est masquée, et prédire le contenu manquant. À chaque essai, les paramètres du modèle sont réajustés pour corriger la prédiction, c’est l’apprentissage.

Après l’entraînement, les paramètres appris permettent de représenter numériquement les relations sémantiques entre les mots (c’est le modèle de langage). Pour répondre à un utilisateur (c’est l’inférence), c’est le même processus : analyser la séquence (le prompt), prédire le mot suivant, puis le suivant, puis le suivant, etc.

Pour un utilisateur étranger au mécanisme à l’œuvre, le résultat sera bluffant, mais une fois encore, il ne s’agit que d’intelligence simulée par une machine. La syntaxe semble exacte, le raisonnement logique, les applications infinies : mathématiques, littérature, histoire ou géographie. Il ne faudra pas longtemps pour que les LLM se mettent à générer les copies des élèves, les mémoires des étudiants, ou soulager les chercheurs dans l’exécution de tâches fastidieuses.

Pourquoi est-ce dangereux en pratique ?

S’il existe des liens fallacieux dans les séquences d’entraînement, ces derniers seront intégrés lors de la phase d’apprentissage et régénérés dans la phase d’inférence. Ce phénomène de « corrélation fallacieuse » ne concerne pas que les LLM, mais plus globalement les réseaux de neurones profonds utilisant de grandes quantités de données à l’entraînement.

Dans le domaine de la sécurité informatique, des chercheurs avaient déjà alerté en janvier 2024 sur des symptômes similaires pour des LLM spécialisés dans la recherche de vulnérabilités logicielles : leur recherche montre comment une modification des noms de variables, pourtant sans impact sur la logique du code analysé, vient affecter jusqu’à 11 % la capacité du modèle à correctement identifier du code vulnérable. Tout comme dans le cas d’une modification des prénoms dans l’énoncé du problème mathématique des pommes ci-dessus, l’un des LLM audités a par exemple appris à associer les fonctions faisant appel à des variables nommées « maVariable » (souvent donné dans les exemples adressés aux débutants) et leur vulnérabilité. Pourtant, il n’existe aucune relation de cause à effet entre le nom de cette variable et la sûreté du logiciel. La corrélation est fallacieuse.

Ces LLM sont aujourd’hui utilisés dans les entreprises pour relire le code écrit par des développeurs, supposés garantir la détection des bugs logiciels. Les IA permettent d’identifier les vulnérabilités ou les comportements malveillants en sécurité informatique, ce travail d’analyse est donc crucial. Sans cela, un attaquant subtil pourrait profiler le système de détection pour identifier ces biais, le manipuler et jouer sur ces derniers pour le contourner.

C’est pourquoi, à l’instar des travaux sur l’analyse de code source, nous sommes en train d’explorer l’application des méthodes d’inférence causale pour améliorer la robustesse des réseaux de neurones utilisés par les systèmes de détection d’intrusions dans les réseaux informatiques.

Les travaux de Judea Pearl, prix Turing d’Informatique 2011, indiquent en effet que sous certaines conditions, il est possible de distinguer les corrélations probablement issues d’une relation causale de celles qui sont fallacieuses.

En travaillant sur un système de détection d’intrusions, outil qui surveille le trafic réseau pour détecter des activités suspectes, il est possible d’identifier les corrélations qui pourraient être à l’origine de biais. Nous pouvons ensuite les perturber (à l’instar d’un changement de prénom) et entraîner à nouveau le modèle de détection. Mathématiquement, la corrélation fallacieuse se retrouve marginalisée dans la masse d’exemples perturbés et le nouveau modèle est dé-biaisé.

L’IA est un outil, ne le laissons pas penser à notre place !

Qu’elles soient génératives ou non, les IA ayant appris des corrélations fallacieuses exposent leurs utilisateurs à des biais plus ou moins importants. Si les corrélations fallacieuses peuvent apparaître amusantes de par leur absurdité, elles peuvent également être source de discriminations.

Plus globalement, les récentes avancées en apprentissage profond, qui vont bien au-delà des IA génératives, bénéficient et vont bénéficier à de nombreux domaines, dont la sécurité informatique.

Néanmoins, bien que prometteuses, ces IA doivent être reconsidérées à leur juste place : elles peuvent certes permettre d’augmenter les capacités d’expertise, mais aussi induire des aveuglements dont les conséquences peuvent être dramatiques si l’on en vient à déléguer notre capacité de penser à des algorithmes.

Ainsi, il convient de nous éduquer au fonctionnement de ces systèmes — et à leurs limites — pour ne pas les suivre aveuglément. Le problème n’est pas tant l’absurdité d’un changement de prénom provoquant une baisse de performance, que le crédit que nous pouvons accorder au contenu généré par une IA.

The Conversation

Pierre-Emmanuel Arduin est membre de l'association française pour l'intelligence artificielle (AFIA).

Myriam Merad ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.

L’IA dans l’enseignement supérieur : les leçons de Platon et du mythe de Theuth

Entre mythe et science, entre craintes ancestrales et promesses technologiques, la question de l’intelligence artificielle dans l’enseignement supérieur fait écho à des débats millénaires sur notre rapport aux outils cognitifs. Les dernières recherches empiriques viennent aujourd’hui éclairer d’un jour nouveau ces questionnements anthropologiques et philosophiques.


Dans le Phèdre de Platon, le roi Thamous mettait en garde Theuth, le dieu égyptien de la science, contre les dangers de l’écriture, craignant qu’elle ne conduise à une atrophie de la mémoire et à une illusion du savoir.

Deux millénaires et demi plus tard, alors que l’intelligence artificielle générative bouleverse nos pratiques éducatives, cette mise en garde résonne avec une actualité saisissante.

Pourtant, les données empiriques récentes suggèrent une voie médiane entre technophilie béate et technophobie systématique : celle de l’intelligence artificielle (IA) comme orthèse cognitive et non comme prothèse de substitution. Celle-ci aurait-elle alors des propriétés magiques ?

De la mythologie à l’empirisme : une continuité inattendue

Dans le domaine de l’éducation, ChatGPT et ses pairs promettent d’être des assistants infatigables, capables de répondre à toutes les questions, d’expliquer tous les concepts, de corriger tous les travaux. La tentation est donc grande de voir en eux la solution à de nombreux défis éducatifs. D’autant que les digital natives l’utilisent aisément comme ils s’abreuvaient naguère aux sources (détectables) des encyclopédies en ligne…

Pour autant, malgré le risque d’une exploitation paresseuse des outils, nombre d’enseignants admettent que l’IA permet de faciliter l’élaboration de synthèses afin de mieux circonscrire les enjeux d’un sujet. Pour être efficace, il reste toutefois nécessaire que les étudiants s’approprient les contenus associés, c’est-à-dire les lisent, les assimilent, les problématisent et les mettent en perspective. L’organisation de soutenances orales devrait permettre de s’en assurer.


À lire aussi : Comment ChatGPT sape la motivation à écrire et penser par soi-même


Dès lors, entre les espoirs et les craintes, l’IA générative suscite des réactions souvent polarisées. Comme en réponse à ces questions binaires, l’Unesco vient de publier un guide pratique qui promeut une approche équilibrée de l’utilisation de ChatGPT dans l’enseignement supérieur, reconnaissant son potentiel pédagogique tout en alertant sur les défis éthiques.

Les récents travaux publiés par le réseau interuniversitaire québécois OBVIA montrent également que, loin de remplacer nos capacités cognitives, les outils numériques les modifient et peuvent les enrichir, exactement comme l’écriture a fini par devenir un pilier de notre développement intellectuel plutôt qu’un substitut à la mémoire.

L’orthèse cognitive : vers une pédagogie augmentée ?

C’est ici qu’intervient la distinction fondamentale entre prothèse et orthèse dans notre approche de l’IA. Une prothèse remplace une fonction défaillante ou manquante, tandis qu’une orthèse soutient et améliore une fonction existante. Dans l’enseignement supérieur, considérer l’IA comme une prothèse reviendrait à lui déléguer des fonctions cognitives essentielles, risquant ainsi de les atrophier. La voir comme une orthèse permet de l’utiliser pour amplifier et enrichir les capacités intellectuelles tout en préservant l’autonomie cognitive.

La distinction trouve une validation inattendue dans les dernières recherches en neurosciences cognitives. Par exemple, la méta-analyse conduite par Linxuan Yi, Di Liu, Tiancheng Jiang et Yucheng Xian révèle que l’IA, utilisée comme support plutôt que comme substitut, améliore significativement l’apprentissage en mathématiques.

De même, pour les utilisateurs experts, l’IA peut apporter une assistance pertinente en matière de recherche et de conception d’évaluations scientifiques : les bases de données bibliographiques sont explorées de façon systématique, les textes sont facilement traduits, des méthodologies ou des appareillages statistiques peuvent être suggérés au moment de mettre en forme un protocole.

Comme avec les appareils orthopédiques destinés à accompagner et faciliter l’exécution d’un mouvement, l’IA peut soulager le chercheur dans l’exécution de tâches fastidieuses.


À lire aussi : Face à ChatGPT, apprendre à apprendre avec la méthode du « Maître Ignorant »


L’intégration de l’IA comme orthèse cognitive dans l’enseignement supérieur ouvre aussi des perspectives inédites. Les travaux de Umair Ali Khan et Ari Alamäki suggèrent que l’interaction avec les grands modèles de langage favorise le développement des capacités métacognitives. Par exemple, les échanges avec une IA nécessitent d’évaluer la pertinence et la qualité des réponses reçues, ce qui stimule la pensée critique et la capacité à réfléchir sur ses propres connaissances et leur validité.

Dans cette perspective, la notion d’apprentissage appliqué, proposée par James Hutson et Daniel Plate, combine réflexion personnelle et utilisation guidée de l’IA.

Trois exemples de recherches récentes illustrent ces avancées :

  • Les travaux de Tarun Kumar Vashishth et ses collègues montrent que l’IA permet une personnalisation sans précédent de l’expérience d’apprentissage, car on peut entamer un dialogue avec l’ordinateur, qui donne l’impression d’interagir, de répondre aux requêtes de manière non générique mais originale, tout en surmontant les barrières linguistiques et culturelles.

  • Les recherches de Ramirez établissent que le machine learning permet d’atteindre une précision de 85 % dans la prédiction des performances et des risques d’abandon des étudiants.

  • Kim et ses collègues démontrent que l’IA peut fournir un « tutorat intelligent » qui s’ajuste en continu, sans se substituer à l’enseignant. L’IA agit comme un complément tout en laissant à ce dernier la responsabilité de définir le parcours d’apprentissage et de rythmer la progression de l’apprentissage.

L’IA entre technique et sacré : les nouveaux imaginaires

Mais faisons un pas de côté pour rappeler qu’avec l’IA, nous sommes face à une double illusion : celle d’un dialogue direct avec une intelligence supérieure et extérieure, produisant des contenus que l’on peut penser originaux. Auparavant, les moteurs de recherche citaient leurs sources, et se contentaient de juxtaposer des réponses référencées. Désormais, tout se donne dans une perfection formelle qui ravit et sidère même.

Ensuite, le fait que cette intelligence nous soit offerte en nous conférant « réponse à tout », entretient une autre illusion : la perte de toute médiation. L’idée affleure donc d’un « génie », au double sens du mot : une connaissance infinie et instantanée, et aussi un personnage répondant à la moindre question et à tous les désirs.

[Déjà plus de 120 000 abonnements aux newsletters The Conversation. Et vous ? Abonnez-vous aujourd’hui pour mieux comprendre les grands enjeux du monde.]

On ne frotte plus la lampe magique, comme Aladin, mais l’écran luminescent, et omniscient. Ceci est plus qu’une référence facile, mais invite véritablement à des lectures buissonnières de l’IA, symboliques, et déjà anthropologiques. En clair, la technologie et l’IA bruissent d’imaginaires qui leur servent de filigranes, qui les densifient, les nimbant même d’une sacralité diffuse.

Et comme le rappelle Gilbert Simondon, il n’y a pas de vraie opposition entre sacralité et technicité puisque la véritable nature des objets techniques ne réside pas dans leur finalité fonctionnelle. Ainsi, dans toutes les manifestations du sacré, les objets, y compris techniques, jouent un rôle non négligeable. L’IA nous octroie indéniablement des pouvoirs, tout en réveillant un imaginaire prométhéen.

L’IA réveille un imaginaire prométhéen. (Héraclès libérant Prométhée enchaîné – Coupe béotienne v. 500 av. J.-C.). Musée du Louvre, Département des Antiquités grecques, étrusques et romaines, via Wikimedia

Tout comme le « hau » décrit par Marcel Mauss, l’IA transforme notre rapport au savoir et à la pensée. Les étudiants qui dialoguent avec l’IA ne sont pas si éloignés des pratiques anciennes de dialogue avec des forces invisibles porteuses de sagesse.

La leçon du mythe de Theuth n’est pas qu’il faut rejeter les innovations technologiques mais qu’il faut les apprivoiser avec sagesse. Dans l’enseignement supérieur, nos outils cognitifs ne valent que par notre capacité à les utiliser comme des supports à la pensée plutôt que comme des substituts à celle-ci.

Cette synthèse aurait-elle pu être générée par une intelligence artificielle ? Sa valeur réside dans ces analogies qui tissent des passerelles entre mythologie et données empiriques, dans cette façon humaine de puiser dans les récits anciens pour éclairer les découvertes contemporaines. L’enjeu n’est pas la production de contenus, mais le développement d’une pensée critique et créative que la technologie peut enrichir sans jamais la remplacer.


Merci à Jean-François Trinquecoste avec qui de récents échanges ont apporté cette métaphore féconde de l’orthèse cognitive et de la prothèse de substitution.

The Conversation

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

Qui est Helsing, la première licorne européenne de l'IA de défense ?

8 mars 2024 à 15:30
«Soit l’armée française prend la virage de l’IA, soit elle décroche». Sébastien Lecornu ne peut pas être plus clair. Dans les colonnes des...
❌
❌